

Intel představil své plány pro vysoce výkonné výpočty pro platformu SC26, přičemž ústředním bodem bude Diamond Rapids, její serverová architektura Xeon nové generace. Intel uvádí, že platforma bude škálovatelná na 256 výkonných jader s paměťovou propustností až 1.6 TB/s a až 1.28 GB mezipaměti poslední úrovně. Nástin pochází od Jeffa McVeigha, viceprezidenta a generálního ředitele strategických programů datových center, a zahrnuje také grafické procesory Intel řady D, software HPC, křemíkovou fotoniku a kvantový vývoj. Intel neuvedl datum uvedení platformy Diamond Rapids na trh.
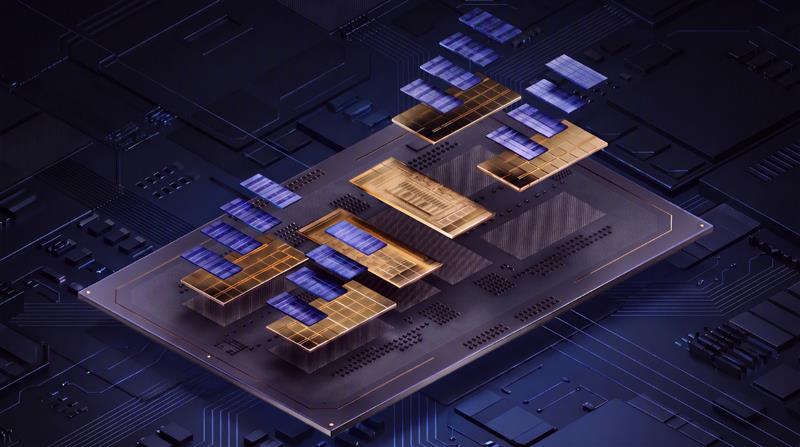
Architektura procesoru Diamond Rapids
Společnost Intel popisuje procesory Diamond Rapids , které na konferenci Hot Chips podrobně popsala jako design 18A-P, jako kombinaci vyšší výpočetní hustoty s větší šířkou pásma paměti, většími mezipaměťmi a rozšířenou akcelerací CPU. Technologie Intel Advanced Performance Extensions (APX) jsou zaměřeny na výkon na vlákno a to, co Intel nazývá unified memory fabric, dosahuje hodnoty 1.6 TB/s. Intel neuvedl, kolik paměťových kanálů ani jaká rychlost paměti se za tímto číslem skrývá, ani zda se vztahuje na jednotlivé sockety.
Architektura také podporuje Intel AVX 10.2 a vylepšená technologii Intel Advanced Matrix Extensions (Intel AMX). Intel označuje Xeon nové generace za jediný serverový procesor x86 s vestavěným maticovým výpočetním systémem pro HPC a AI úlohy. Pro informaci o počtu jader, nejlepší procesory AMD EPYC Venice , které jsme recenzovali, obsahují 256 jader Zen 6c na socket.
McVeigh koncipoval plán pro smíšené systémy, v nichž CPU řídí pracovní postupy a spouštějí paralelní komunikační knihovny, zatímco akcelerátory přebírají práci umělé inteligence, a napsal, že budoucnost HPC je „otevřená, heterogenní a vyvážená“.
Intel GPU řady D a software HPC
Grafická karta Intel GPU řady D kombinuje akceleraci umělé inteligence s výpočetními systémy s dvojitou přesností (FP64) ve vzduchem chlazené kartě PCIe s podporou datových typů od FP4 a MXFP4 až po FP64. Grafická karta Intel GPU D270 obsahuje 160 GB paměti LPDDR5X s propustností paměti 1.5 TB/s a konfigurace navržené partnery lze škálovat až na 480 GB. Argument společnosti Intel pro výzkumná pracoviště se zaměřuje na kapacitu paměti, protože uchovávání větších pracovních datových sad na kartě snižuje dělení a přenosy mezi hostitelem a akcelerátorem, které zpomalují vědecké pracovní postupy. Intel také kartu navrhuje pro neustále zapnuté agenty umělé inteligence, kteří generují kód a spouštějí výpočetní úlohy.
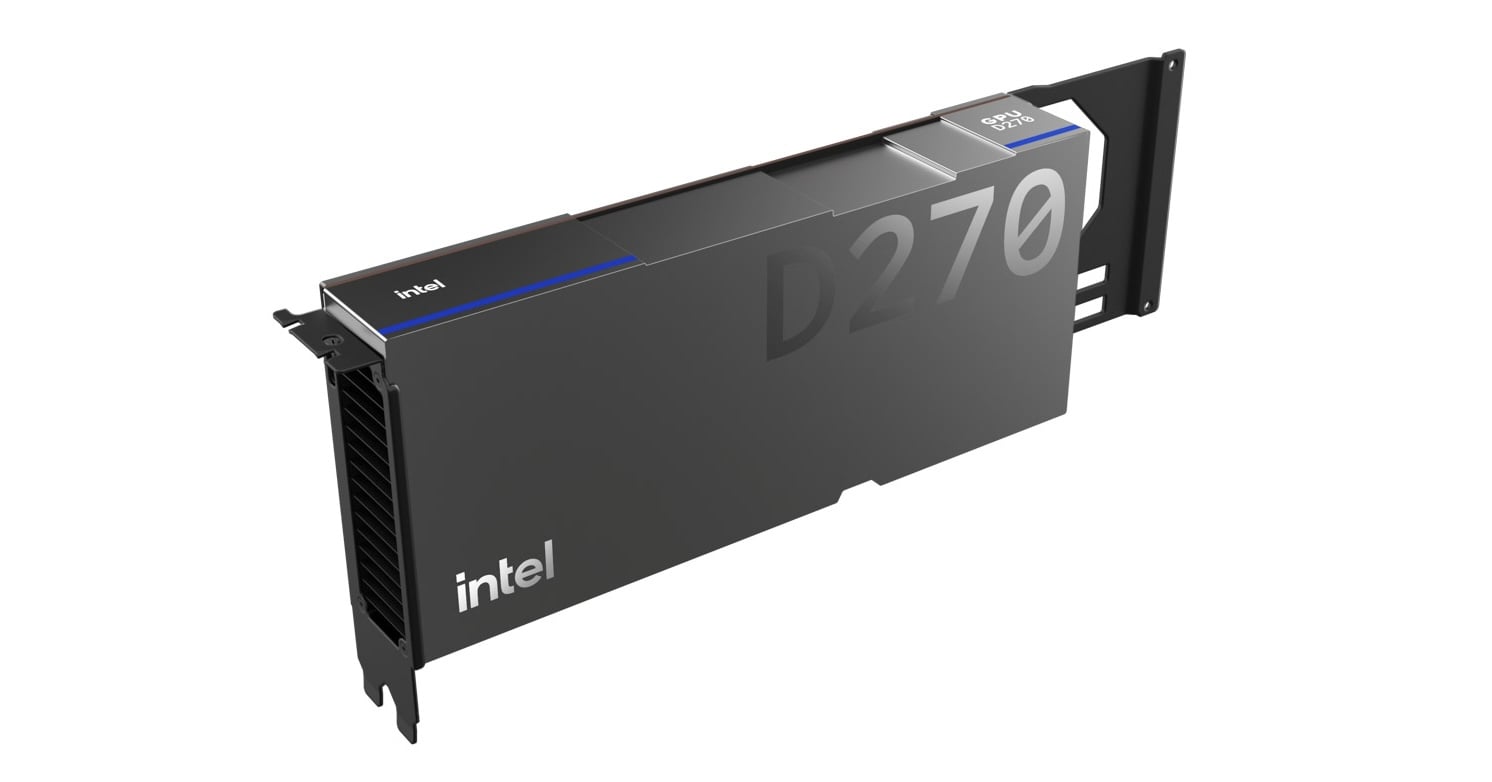
Intel na svém stánku SC26 pořádá dvě živá dema grafické karty GPU D270, dříve kódově označované Crescent Island. První je miniaplikace pro seismické zobrazování od společnosti Veridien, která byla portována z HIP a CUDA do SYCL za méně než měsíc a Intel uvádí, že 90 % jejích jader běželo dobře bez jakékoli optimalizace specifické pro Intel. Druhá dema rozděluje inferenční kanál mezi karty D270, které zpracovávají prefill, a jednotky SambaNova SN50, které zpracovávají dekódování, s orchestrací procesorů Xeon 6 a Xeon 6+.
Společnost Intel také zveřejnila srovnání s grafickou kartou NVIDIA RTX PRO 6000 Blackwell Server Edition. U finančních úloh v FP64 uvádí až 5.9násobnou propustnost na evropském Monte Carlu, 5.6násobnou na evropském Black-Scholesově grafu, 4.6násobnou na binomickém oceňování a 1.92násobnou na americkém Black-Scholesově grafu, s D270 při 350 W a kartou NVIDIA při 600 W. Pro inferenci Intel uvádí až o 29 % nižší latenci na Drex v2.0 a 1.12násobnou propustnost výstupních tokenů na Qwen3-30B-A3B v FP8.
Toto jsou výsledky od dodavatelů na předprodukčních čipech a my jsme je neprovedli ani neauditovali. Konfigurace finančního testu Intelu uvádí osm karet NVIDIA proti jednomu procesoru D270 a neuvádí, zda jsou výsledky normalizovány pro každou kartu, a inferenční běhy NVIDIA používaly virtuální stroj AWS.
Pokud jde o software, Intel uvádí, že bude i nadále investovat do Intel MPI, Fortranu, optimalizací kompilátorů a oneAPI, aby stávající paralelní kódové základny mohly i nadále dobře fungovat na systémech se smíšenými CPU a GPU. Pracuje také na upstreamové integraci s frameworky umělé inteligence, inferenčními běhovými prostředími a prostředími pro nasazení. Uvedeným cílem je, aby standardní modely a nástroje běžely na novém hardwaru, jako je řada D, od prvního dne jeho nasazení.
Optická konektivita a kvantový vývoj
Intel také poukázal na svůj výzkum v oblasti křemíkové fotoniky, která využívá světlo k přenosu dat na delší vzdálenosti s energií, kterou společnost popisuje jako zlomek energie měděných vodičů. Intel k tomuto tvrzení nepřipojil žádné údaje ani časový harmonogram produktu.
V oblasti kvantové technologie Intel zopakoval argumenty pro navrhovanou akvizici společnosti Classiq , která by spojila automatizovanou platformu pro syntézu kvantových algoritmů od Classiq s technologií křemíkových spin-qubitů a výrobou čipů od Intelu. Intel uvedl, že očekává uzavření transakce v první polovině roku 2027, po získání schválení regulačními orgány.


 Amazon