

Systémy umělé inteligence pro stolní počítače postavené na čipu NVIDIA GB10 mají jeden úkol a ten dělají dobře: umístit 128 GB unifikované paměti a petaflop výpočetního výkonu na stůl dostatečně blízko osoby, která jej používá, aby iterace byla okamžitá. Co ale nemají, je připojení k úložišti, které organizace již provozuje. Každá varianta DGX Spark a OEM je dodávána s jedním krátkým slotem M.2, který omezuje lokální kapacitu na přibližně 4 TB a umisťuje každou datovou sadu, model a kontrolní bod na daném počítači mimo systém správy, řízení přístupu, zálohování a auditní stopu, které se nacházejí v datovém centru. Vynásobte to laboratoří, oddělením nebo kampusem a výsledkem jsou desítky izolovaných 4TB ostrovů, z nichž každý obsahuje vlastní kopii stejných modelů a datových sad, každý z nich je zabezpečený jen tak, jak je zabezpečen stůl, na kterém je umístěn.
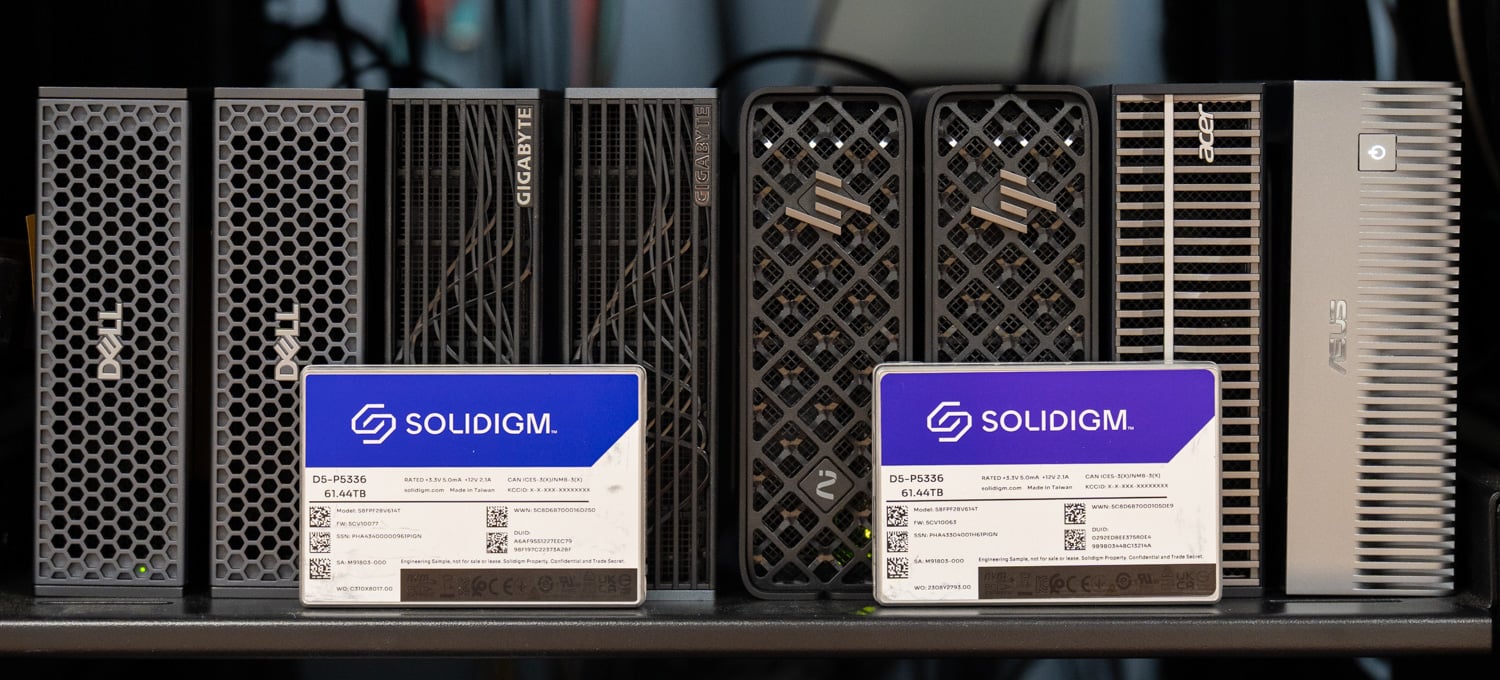
Tento projekt přenáší problém s úložištěm zpět do datového centra. Vytvořili jsme sdílený úložný hostitel DGX Spark z přístupového bodu Dell PowerEdge R770AP, osmi SSD disků Solidigm D5-P5336 QLC v poli Graid SupremeRAID RAID 5, sítě Broadcom 400GbE a serveru Tuxera Fusion obsluhujícího NFS přes RDMA. Poté jsme k jeho 100GbE portům připojili osm úložišť Spark. Každý Spark na fabrice připojuje stejný řízený, paritou chráněný úložný fond s jednou linkou; jedna kopie každého modelu a datové sady obsluhuje všechny, žádná pracovní stanice nepotřebuje více úložiště, než s jakým je dodávána, a samotné úložiště Spark může být umístěno v racku vedle pole, kde se snáze zabezpečuje, chladí a sdílí. Smyslem této sestavy je místo, kde se data nacházejí, a roli by mohl sehrát jakýkoli server NVMe s rychlými síťovými kartami. Oregonská státní univerzita, která zkoumá rozsáhlou laboratoř Spark pro učení umělé inteligence a chce studentům poskytnout přístup k výzkumným datovým sadám o velikosti desítek terabajtů, se s námi podělila o své myšlenky během návrhu sestavy a pro data v tomto rozsahu se ukázalo jako ideální přístup sdílené úložiště.
Key Takeaways
- Jedno pole, osm Sparků, žádný klientský software: Osm desek DGX Spark od pěti výrobců originálního vybavení (OEM) připojuje sdílené složky NFS/RDMA z jediného pole Solidigm D5-P5336 QLC za Graid SupremeRAID a Tuxera Fusion přes stávající 100GbE porty s možností jednořádkového připojení na standardní Ubuntu.
- Hostované modely se načítají stejně jako lokální: 78GB model Qwen3.5-122B-A10B-NVFP4 se na jednom Sparku načetl ze sdíleného pole za 269.6 sekundy, což je do 13 % z 239.6 sekund, které stejný Spark potřeboval ze svého interního NVMe, a osm Sparků, které načítaly stejnou kopii najednou, dokončilo načítání za 232.8 až 326.5 sekundy.
- Jedna kopie nahradí silo na každém stole: Modely a datové sady na řízených, paritně chráněných úložištích datových center nahrazují kopie pro jednotlivé pracovní stanice na 4TB discích M.2, takže využití se zvyšuje, kopie dat klesají a žádný Spark nepotřebuje upgrade úložiště ani místo na stole. Pro rozsáhlou laboratoř pro učení umělé inteligence, jako je ta, kterou zkoumá Oregonská státní univerzita, kde výzkumné datové sady dosahují desítek terabajtů, je to přístup, který odpovídá případu použití v našem hodnocení.
- Disky nastavují strop a síť má rezervu: Při současném čtení všech osmi disků Spark dosáhlo pole RAID 5 s osmi disky maximální rychlosti blízké 25 GiB/s, což je přibližně 214 Gb/s, což využilo 27 % z 800 Gb/s, které dokáží přenést dvě síťové karty Broadcom BCM57608 v hostiteli. Jeden Sparkův odečet z pole s rychlostí 10.8 GiB/s odpovídá nejrychlejšímu internímu M.2, který jsme naměřili v systému GB10.
- Řízení je součástí protokolu: NFS s RDMA umisťuje složky pro jednotlivé uživatele, sdílené datové sady a hostované modely do jednoho jmenného prostoru s využitím Active Directory, Kerberos a LDAP hooků, což umožňuje, aby data zůstala pod kontrolou datového centra, zatímco se servery Sparks přesouvají do racku.
Problém s ostrůvkem umělé inteligence na každém stole
DGX Spark a jeho OEM varianty od společností Dell, GIGABYTE, HP, Acer a ASUS sdílejí platformu GB10 a stejný úložný strop. V naší původní recenzi DGX Spark bylo úložiště nejzřetelnějším omezením platformy. Interní slot pojme krátké disky M.2, takže 8TB klientské SSD disky dodávané ve formátu 2280 se do něj fyzicky nevejdou. Luisuantech GP Spark, který jsme recenzovali v srpnu, na to reaguje čtyřpozicovým M.2 pouzdrem zavěšeným na jednom 100GbE portu, což je čisté řešení pro jeden Spark na jednom stole a v laboratorním měřítku větší silo na každém stole.
Kapacita je polovina problému; druhá polovina spočívá v tom, co se stane s daty, jakmile přistanou na počítači u stolu. Model s kapacitou 78 GB převedený na Spark je kopie, kterou nikdo v IT nevidí. Výzkumná datová sada uložená na lokální flash paměti je kopie mimo plán zálohování, mimo přístupové zásady a mimo institucionální audity. Deset Sparků v laboratoři znamená deset kopií stejné hmotnosti spotřebovávajících 780 GB flash paměti, které by mohly být použity pro něco jiného, a deset míst, kde může datová sada odejít se strojem. Problém se zhoršuje s rostoucími čísly, ať už se jedná o systémy GB10 nebo jakoukoli infrastrukturu umělé inteligence pro stolní počítače. Každá organizace, která spravovala flotilu notebooků, zná tento vzorec a odpověď byla tehdy stejná: uchovávejte data na sdíleném úložišti v datovém centru a nechte koncový bod být koncovým bodem.
Naštěstí NVIDIA navrhla Spark s porty, které to umožňují. Každá jednotka nese dvě klece QSFP56 na integrovaném adaptéru ConnectX-7 s maximálním limitem 200 GB použitelné šířky pásma za dvojicí linek PCIe Gen5 x4. V naší recenzi clusteru DGX Spark jsme popsali konfiguraci s rozdělenými rolami, ve které jedna klec jde k peer Sparku a druhá k úložišti. Tento projekt používá jednu klec na Spark pro úložiště s rychlostí 100 GbE a druhá je volná pro clustering nebo dodatečnou šířku pásma. Při rychlosti 100 GbE má každý Spark teoretickou šířku pásma k hostitelskému úložišti přibližně 12.5 GB/s, což překračuje šířku pásma poskytovanou interním slotem M.2 u většiny těchto systémů.
Jakmile se data dostanou na druhý konec tohoto spojení, role Sparku se změní. Stává se výpočetním koncovým bodem se spouštěcím diskem a lokálním diskem mezipaměti a kapacita se již nekupuje pro každou pracovní stanici. Model nebo datová sada se zapíše jednou a každý klient ji přečte, takže se zvýší využití úložiště a sníží se počet kopií. Ochrana dat se přesouvá do pole chráněného paritou v serverové šasi a řízení přístupu, šifrování v klidovém stavu, zálohování a audit probíhají tam, kde již pro všechno ostatní probíhají. A protože Spark nyní nepotřebuje nic jiného než napájení a 100GbE připojení, není důvod, aby musel stát na stole. Umístěný vedle úložného hostitele je chladnější, tišší, fyzicky zabezpečený a dostupný pro každého, kdo ho příště potřebuje.
Hostitel úložiště
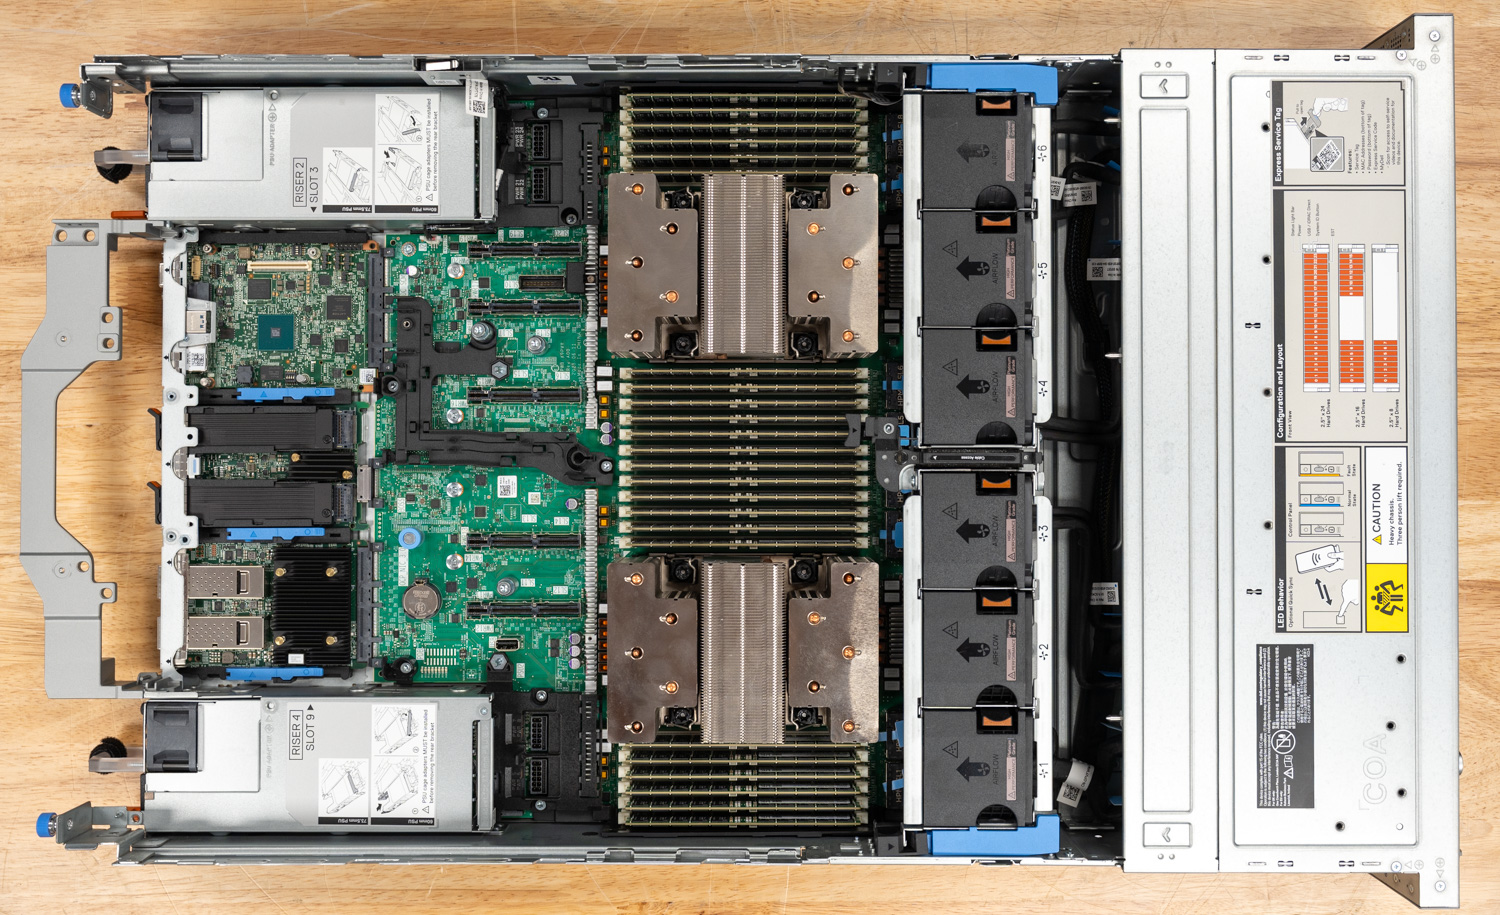
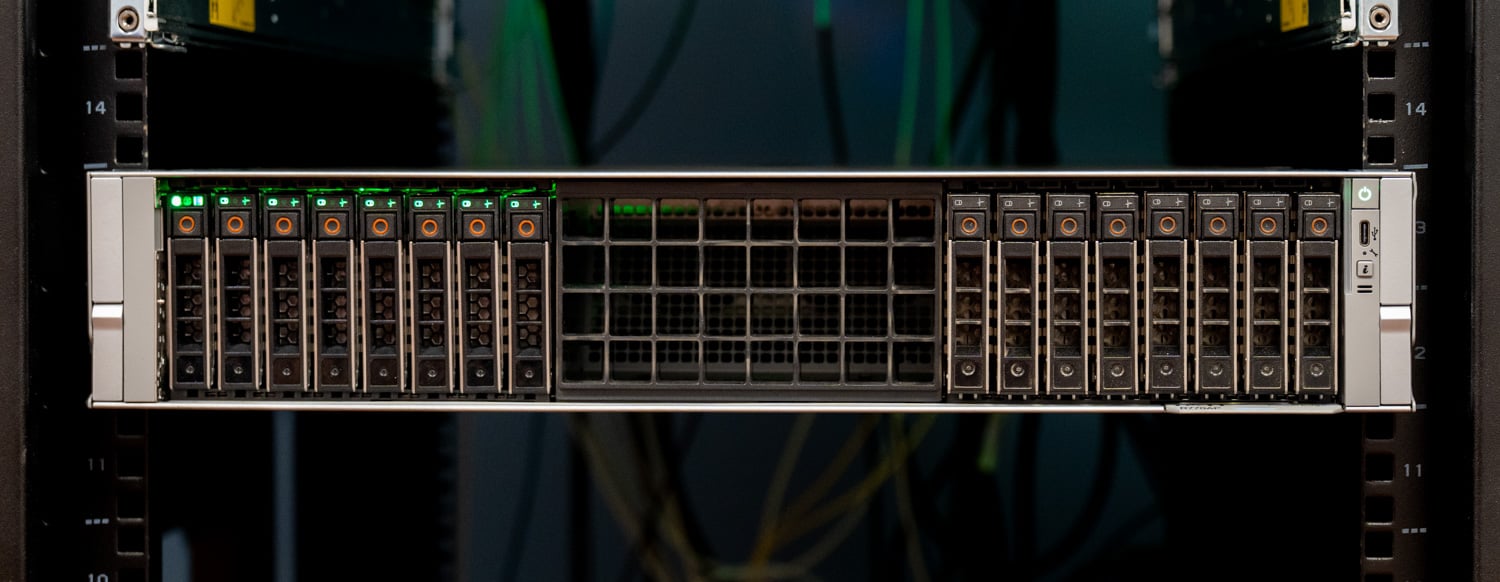
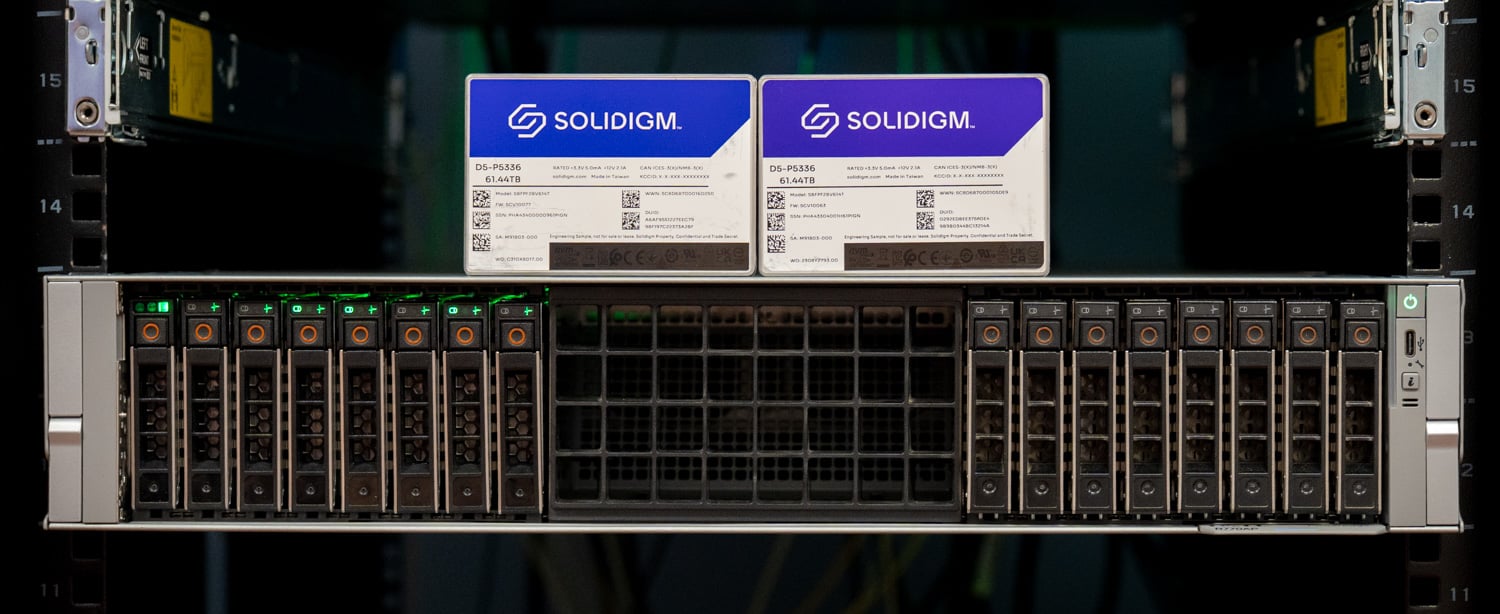
Úložištěm je Dell PowerEdge R770AP , stejná platforma s 2U Xeon 6, kterou jsme recenzovali začátkem tohoto roku, a použili jsme ji, protože byla v laboratoři na začátku projektu volná. Tuto roli by mohl zastávat jakýkoli NVMe server s prostorem pro rychlé síťové karty a malou grafickou kartu a R770AP je jedním ze způsobů, jak ho sestavit, i když je trochu přepracovaný. Náš server běží na dvou procesorech Xeon 6 6978P s 1.5 TB paměti DDR5 na 24 modulech DIMM, používá jednu ze svých dvou bank s osmi pozicemi pro NVMe Gen5 a disky a grafickou kartu Graid jsou umístěny mimo CPU 0, přičemž dva 400GbE adaptéry jsou na CPU 1. Server běží na Ubuntu 24.04.
| Složka | Konfigurace hostitele úložiště |
|---|---|
| Server | Dell PowerEdge R770AP, 2U, 16 2.5palcových pozic Gen5 NVMe |
| Procesor (CPU) | 2x Intel Xeon 6 6978P |
| Memory | 1.5TB DDR5 (24x 64GB) |
| Skladování | 8x Solidigm D5-P5336 61.44 TB U.2 PCIe 4.0 QLC (491.52 TB nezpracovaných) |
| RAID | Graid SupremeRAID, RAID 5 na všech osmi discích, grafická karta NVIDIA RTX A2000 na CPU 0 |
| File System | XFS na virtuálním disku SupremeRAID |
| Souborový server | Tuxera Fusion (Fusion NFS, soukromá preview verze), NFS 4.1 přes RDMA (RPC-RDMA na portu 20049), uživatelský režim |
| networking | 2x Broadcom BCM57608 (Thor 2) jednoportový 400GbE, PCIe Gen5 x16 na CPU 1, RoCEv2 |
| Vypínač | Dell PowerSwitch Z9864F-ON, 64x 800GbE OSFP112, Enterprise SONiC |
| Odkazy klientů | 800G optika rozdělená na 8x100GbE, jeden link na Spark, čtyři Sparky na úložnou síťovou kartu na samostatných VLAN |
| Klienti | 2x Dell Pro Max s GB10, 2x GIGABYTE AI TOP ATOM, 2x HP ZGX Nano G1n, Acer Veriton GN100, ASUS Ascent GX10 |
| OS | Ubuntu LTS 24.04 |
Proč QLC a proč D5-P5336
V našich rozhovorech s Oregonskou státní univerzitou o konceptu laboratoře Spark byla kapacita prvním požadavkem, protože se jedná o rozsáhlé výzkumné datové sady. Úkolem tohoto serveru je uchovávat vše, co by místnost plná Sparků mohla potřebovat, a poskytovat to ve formě, kterou může číst mnoho klientů najednou. To je profil s vysokou kapacitou pro čtení, velké bloky a s velkými bloky, a právě pro tento profil byl QLC postaven. Řada D5-P5336 má kapacitu od 7.68 TB do 122.88 TB; zde použité disky U.2 s kapacitou 61.44 TB jsou společností Solidigm hodnoceny na sekvenční čtení až 7 000 MB/s, sekvenční zápis 3 000 MB/s, 1.005 milionu náhodných IOPS pro čtení 4K dat a výdrž 65.2 PBW, neboli 0.58 zápisů na disk denně po dobu pěti let, na 192vrstvé QLC NAND s 16KB indirekční jednotkou.
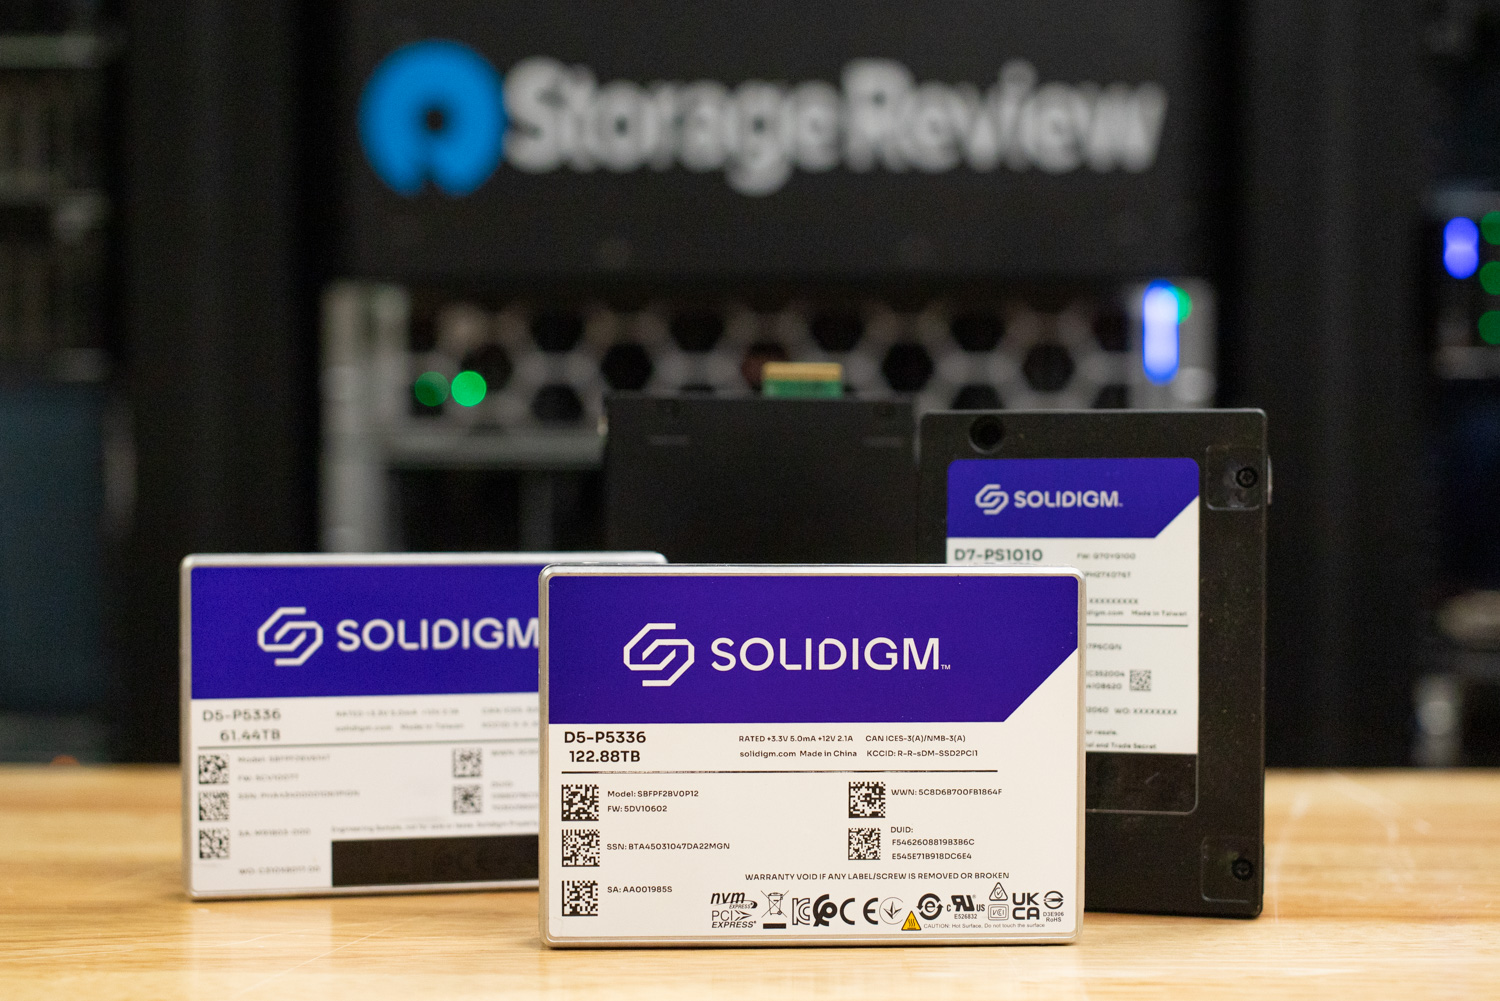
Osm disků s kapacitou 61.44 TB zaplňuje polovinu předních pozic R770AP a produkční sestavení by si mohlo vybrat libovolný kapacitní bod v řadě a libovolný počet pozic. Přesto osm disků v poli RAID 5 poskytuje přibližně 430 TB využitelného prostoru s odolností proti chybám jednoho disku. To je více než 100krát více, než kolik pojme slot M.2 u Sparku, a dostatek prostoru pro knihovnu modelů oddělení, sdílené datové sady, se kterými studenti pracují, a domovské adresáře jednotlivých uživatelů. Zaplnění zbývajících osmi pozic toto množství zdvojnásobí, aniž by se to dotklo návrhu sítě, a čísla dimenzování dále v této recenzi ukazují, proč jsou disky tou součástí, kterou je třeba rozšířit.
16KB indirekční jednotka je pro tuto pracovní zátěž důležitá, protože větší IU Solidigmu vyměňuje malou efektivitu náhodného zápisu za hustotu a náklady a pro sdílení, které obsluhuje modely a datové sady, jsou malé náhodné zápisy menšinovým případem. Načítání modelů probíhá formou rozsáhlých sekvenčních čtení. Streamování datových sad probíhá formou rozsáhlých sekvenčních čtení. Kontrolní body a studentské soubory se zapisují jednou a čtou se často. Dělba práce, která z toho vyplývá, je pro laboratoř Spark správná: sdílené pole QLC uchovává vše, co čte mnoho lidí, a vlastní M.2 disk Sparku zpracovává provoz scratch a swap, který zapisuje jeden.
RAID na GPU: Graid SupremeRAID
NVMe RAID na osmi discích Gen4, z nichž každý je schopen číst rychlostí 7 000 MB/s, je bod, ve kterém se konvenční hardwarová RAID karta stává úzkým hrdlem, protože každý bajt musí projít slotem PCIe karty. Softwarový RAID čelí jiným problémům s využitím zdrojů. Graid SupremeRAID přesouvá výpočty parity na GPU a udržuje datovou cestu na linkách PCIe hostitele, a proto jsme v našem testování SupremeRAID AE se 16 disky zaznamenali škálování na více než 180 GB/s. U tohoto hostitele jsme SupremeRAID spustili na grafické kartě NVIDIA RTX A2000, což je malá grafická karta pro pracovní stanice.
Osm disků D5-P5336 bylo před předáním společnosti Graid zabezpečeně vymazáno a postupně naplněno. Disky byly poté nakonfigurovány jako jedno pole RAID 5. Výsledný virtuální disk byl naformátován pomocí XFS a obsluhován systémem Tuxera. RAID 5 je pro takové sdílení správná úroveň: selhání disku udrží pole online, obnovení se provádí bez odpojení uživatelských dat a ztráta kapacity je jeden disk z osmi. RAID 6 nebo RAID 10 by byly rozumnou volbou pro produkční nasazení, které klade důraz na ochranu v okně obnovení před kapacitou, a SupremeRAID podporuje obojí.
Síť: Broadcom 400GbE a 800G jádro
Úložnou část fabric tvoří dva adaptéry Broadcom BCM57608 Thor 2 v R770AP, každý s jedním portem 400GbE NIC na rozhraní PCIe Gen5 x16. Broadcom pozicionuje BCM57608 jako 400G NIC s nejnižší spotřebou energie v oboru a jeho sada funkcí z něj činí dobrou volbu: RoCEv2 s vylepšenou kontrolou přetížení DCQCN, adaptivním směrováním, zabezpečeným bootováním s křemíkovým kořenem důvěryhodnosti a inline šifrováním kTLS. RoCEv2 v tomto provedení přenáší NFS přes RDMA a kontrola přetížení zabraňuje tomu, aby na sebe více klientů navázalo, když všichni začnou najednou tahat. Během sestavení ovladač bnxt_en hlásil, že optické moduly na 400G portech dosahovaly při trvalém zatížení prahové hodnoty 70 °C. Tento problém jsme vyřešili malým posunem profilu ventilátoru na R770AP a síťové karty poté běžely bez problémů.
Obě síťové karty jsou připojeny k Dell PowerSwitch Z9864F-ON , 800G hlavnímu přepínači z naší laboratoře s operačním systémem Enterprise SONiC. Z9864F-ON má 64 portů OSFP112 s rychlostí 800 GbE a kterýkoli z nich rozděluje na 2x400 G, 4x200 G nebo 8x100 G. Jedna 800G optika rozdělená na 8x100 G připojuje osm Sparků, každý s jedním propojením, ke stejnému přepínači, který ukončuje dvě 400G úložné linky. Každá 400G síťová karta je umístěna na vlastní VLAN a obsluhuje čtyři Sparky, takže úložný hostitel představuje dva cíle RDMA a zátěž je mezi ně rovnoměrně rozdělena. V praxi se jedná o topologii s plnou rychlostí: 8x100 G klientské šířky pásma na jedné straně, 2x400 G úložné šířky pásma na druhé straně a přepínač s kapacitou 102.4 Tb/s uprostřed.
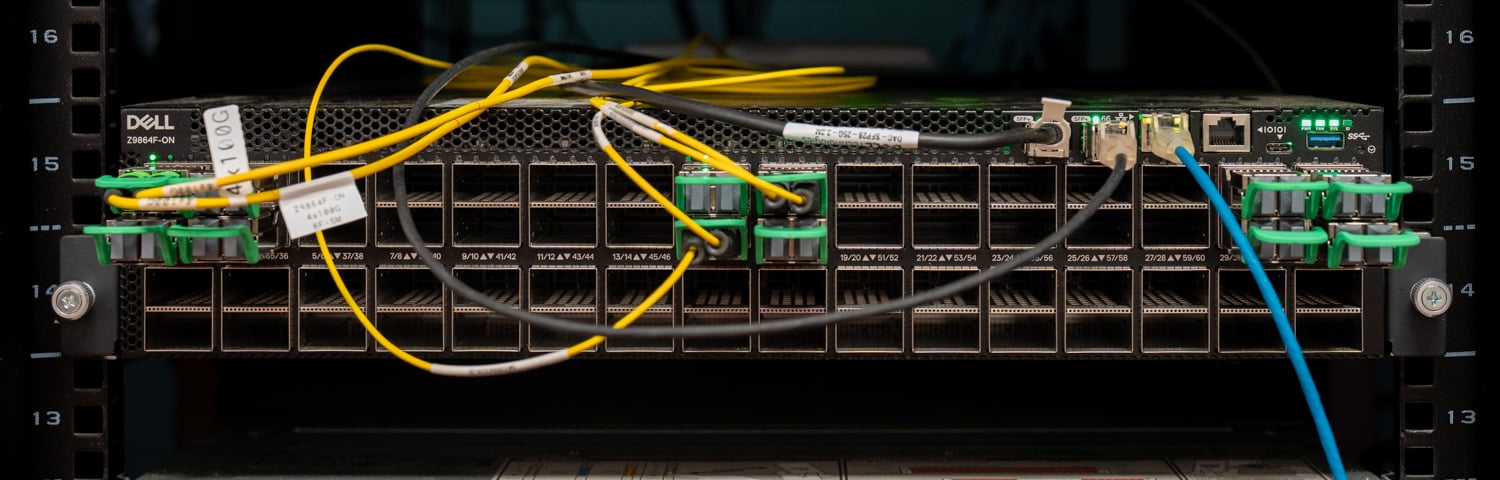
Ověřili jsme funkčnost fabric ještě předtím, než se jí dotkl jakýkoli úložný software. Testy server-to-server mezi R770AP a druhým hostitelem přes 400G linky probíhaly v obou směrech rychlostí linky a provoz RDMA ze Sparků potvrdil, že 100G breakout porty fungovaly plnou rychlostí. Jakmile inženýři společnosti Tuxera spustili sdílení NFS, iperf3 ze Sparků k jejich příslušným síťovým kartám vykázal čistou přenosovou rychlost 99 Gb/s se čtyřmi paralelními streamy a nulovými opakovanými přenosy.
Proč NFS a proč Tuxera
Vzhledem k tomu, že Graid představuje rychlé blokové zařízení, mohl by úložný hostitel sloužit řadičům Spark buď jako cílové bloky NVMe-oF, nebo jako sdílené soubory. Cestu k bloku jsme testovali v recenzi GP Spark a pro jednoho klienta funguje dobře. Pro laboratoř s mnoha Sparky jsme chtěli něco jiného. Blokové svazky jsou typu jeden k jednomu; každý uživatel by potřeboval LUN a v okamžiku, kdy dva uživatelé chtějí stejnou datovou sadu, kopírují ji, což je problém, který má celý tento návrh odstranit. NFS je středem Vennova diagramu: jeden jmenný prostor obsahuje sdílené datové sady, hostované modely a složky pro jednotlivé uživatele. Každé připojení Sparku používá klienta NFS, který je již v Ubuntu, a nástroje Kubernetes a Slurm, které by univerzita nainstalovala na laboratoř Spark, všechny mluví za NFS.
Fusion NFS je NFS polovinou Tuxera Fusion, multiprotokolového souborového serveru, který pokrývá SMB a NFS na jednom uživatelsky řízeném, vícevláknovém jádru; na Fusion SMB jsme se poprvé podívali v roce 2024 v projektu mediálního workflow společností Solidigm a Tuxera. Tuxera uvádí až 22.7 GB/s přes jedno 200GbE připojení s RDMA, nad rámec jádra NFSD a Ganesha ve vlastním testování společnosti, a produkt podporuje NFS 4.1, clustering active-active scale-out, transparentní failover a integraci Active Directory, Kerberos a LDAP. Poslední sada je governance hook: stejný adresář, který řídí, kdo se může přihlásit do Sparku, řídí také to, co mohou vidět ve sdílené složce. Jedna výhrada platí pro každé číslo Tuxery v tomto článku: sestavení, které jsme spustili, je soukromá preview verze Fusion NFS, o které Tuxera tvrdí, že nebyla plně optimalizována pro výkon a software zatím není k dispozici pro komerční prodej. Všeobecná dostupnost je plánována na listopad, po SC'26.
Tuxera nainstaloval na R770AP Fusion, naformátoval svazek Graid pomocí XFS a nakonfiguroval server s NFS na standardním portu a RPC-RDMA na portu 20049, přičemž vynechal posluchače SMB, protože tento projekt je pouze NFS. Počáteční konfigurace vláken byla čtyři protokolová vlákna, každé s osmi vlákny pro transport, odesílání a příjem, data VFS a metadata VFS, což Tuxera popisuje jako výchozí bod pro ladění. Adresářové služby byly z laboratorní sestavy záměrně vynechány; univerzitní nasazení by na něj vrstvilo vlastní služby identity. Na straně Sparku je připojení sdílené složky jedním příkazem:
sudo mount -t nfs -o proto=rdma,port=20049 :/mnt/shares/smbnfs1/ /localnfs
Ten jeden řádek představuje celou integraci klienta, bez ovladače, konfigurace iniciátoru a softwaru od dodavatele na Sparku. Uživatel, který se zítra přihlásí do jiného Sparku, spustí stejný řádek a uvidí stejné soubory.
Důkaz konfigurace: Osm jisker na jedné datové sadě
Před zahájením modelové práce jsme provedli jednotlivou kontrolu správnosti každého Sparku: sekvenční čtení 1 milionu úloh (fio) s 16 úlohami a hloubkou fronty 16 proti jeho vlastní složce v poli. Osm jednotek vrátilo rychlost mezi 10.0 a 11.2 GiB/s, čímž se saturovala 100GbE linka na každé z nich. Poté jsme provedli testování, abychom ověřili, že všech osm jednotek zvládne svůj podíl zátěže. Každé běhové ... Se všemi osmi načtenými disky najednou se sekvenční čtení 1 milionu disků na jednotku pohybovalo v rozmezí od 3.09 do 3.13 GiB/s, náhodné čtení 64 tisíc disků od 6 648 do 6 779 IOPS a náhodné zápisy 4 tisíc disků od 2 136 do 2 155 IOPS, a to napříč pěti OEM na dvou VLAN bez vynucování spravedlivého přístupu. Každý Spark se dostal k poli, každý Spark dostal rovnoměrný podíl a konfigurace byla připravena na pracovní zátěž, na které záleží.
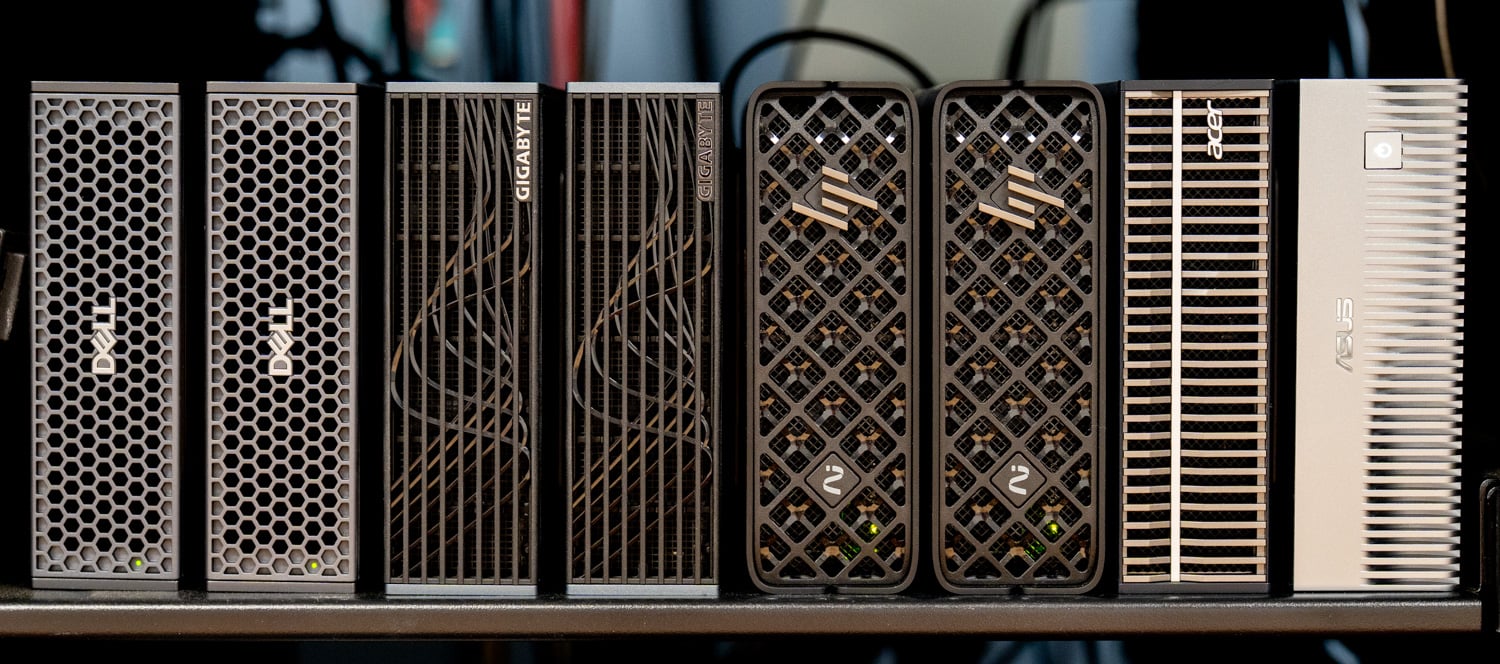
| Spark (osm klientů, 2 vlákna x QD16 každé) | Úložná síťová karta | 1M sekvenční čtení | 64K náhodných IOPS pro čtení | 4K náhodných IOPS pro čtení | 4K náhodných IOPS zápisu |
|---|---|---|---|---|---|
| Dell Pro Max s GB10 (1) | 1 | 3,176 MiB/s | 6,648 | 10,000 | 2,150 |
| GIGABYTE AI TOP ATOM (1) | 1 | 3,195 MiB/s | 6,779 | 10,300 | 2,142 |
| HP ZGX Nano G1n (1) | 1 | 3,201 MiB/s | 6,696 | 10,100 | 2,136 |
| Acer Veriton GN100 | 1 | 3,194 MiB/s | 6,670 | 10,100 | 2,149 |
| Dell Pro Max s GB10 (2) | 2 | 3,184 MiB/s | 6,694 | 10,200 | 2,155 |
| GIGABYTE AI TOP ATOM (2) | 2 | 3,187 MiB/s | 6,667 | 10,100 | 2,141 |
| HP ZGX Nano G1n (2) | 2 | 3,189 MiB/s | 6,678 | 10,100 | 2,151 |
| ASUS Ascent GX10 | 2 | 3,163 MiB/s | 6,734 | 10,300 | 2,145 |
Dimenzování hostitele: Dvě síťové karty a dostatek prostoru
Stejný přehled odpovídá na otázku, kterou si musí laboratoř nebo podnik položit před nákupem: kde je maximální povolená hodnota a která část hostitele ji nastavuje? Čtyři níže uvedené panely ukazují propustnost čtení napříč všemi čtyřmi úlohami, protože fixní zátěž se škáluje od jednoho Sparku do osmi; strana zápisu je popsána v textu a tabulce níže.
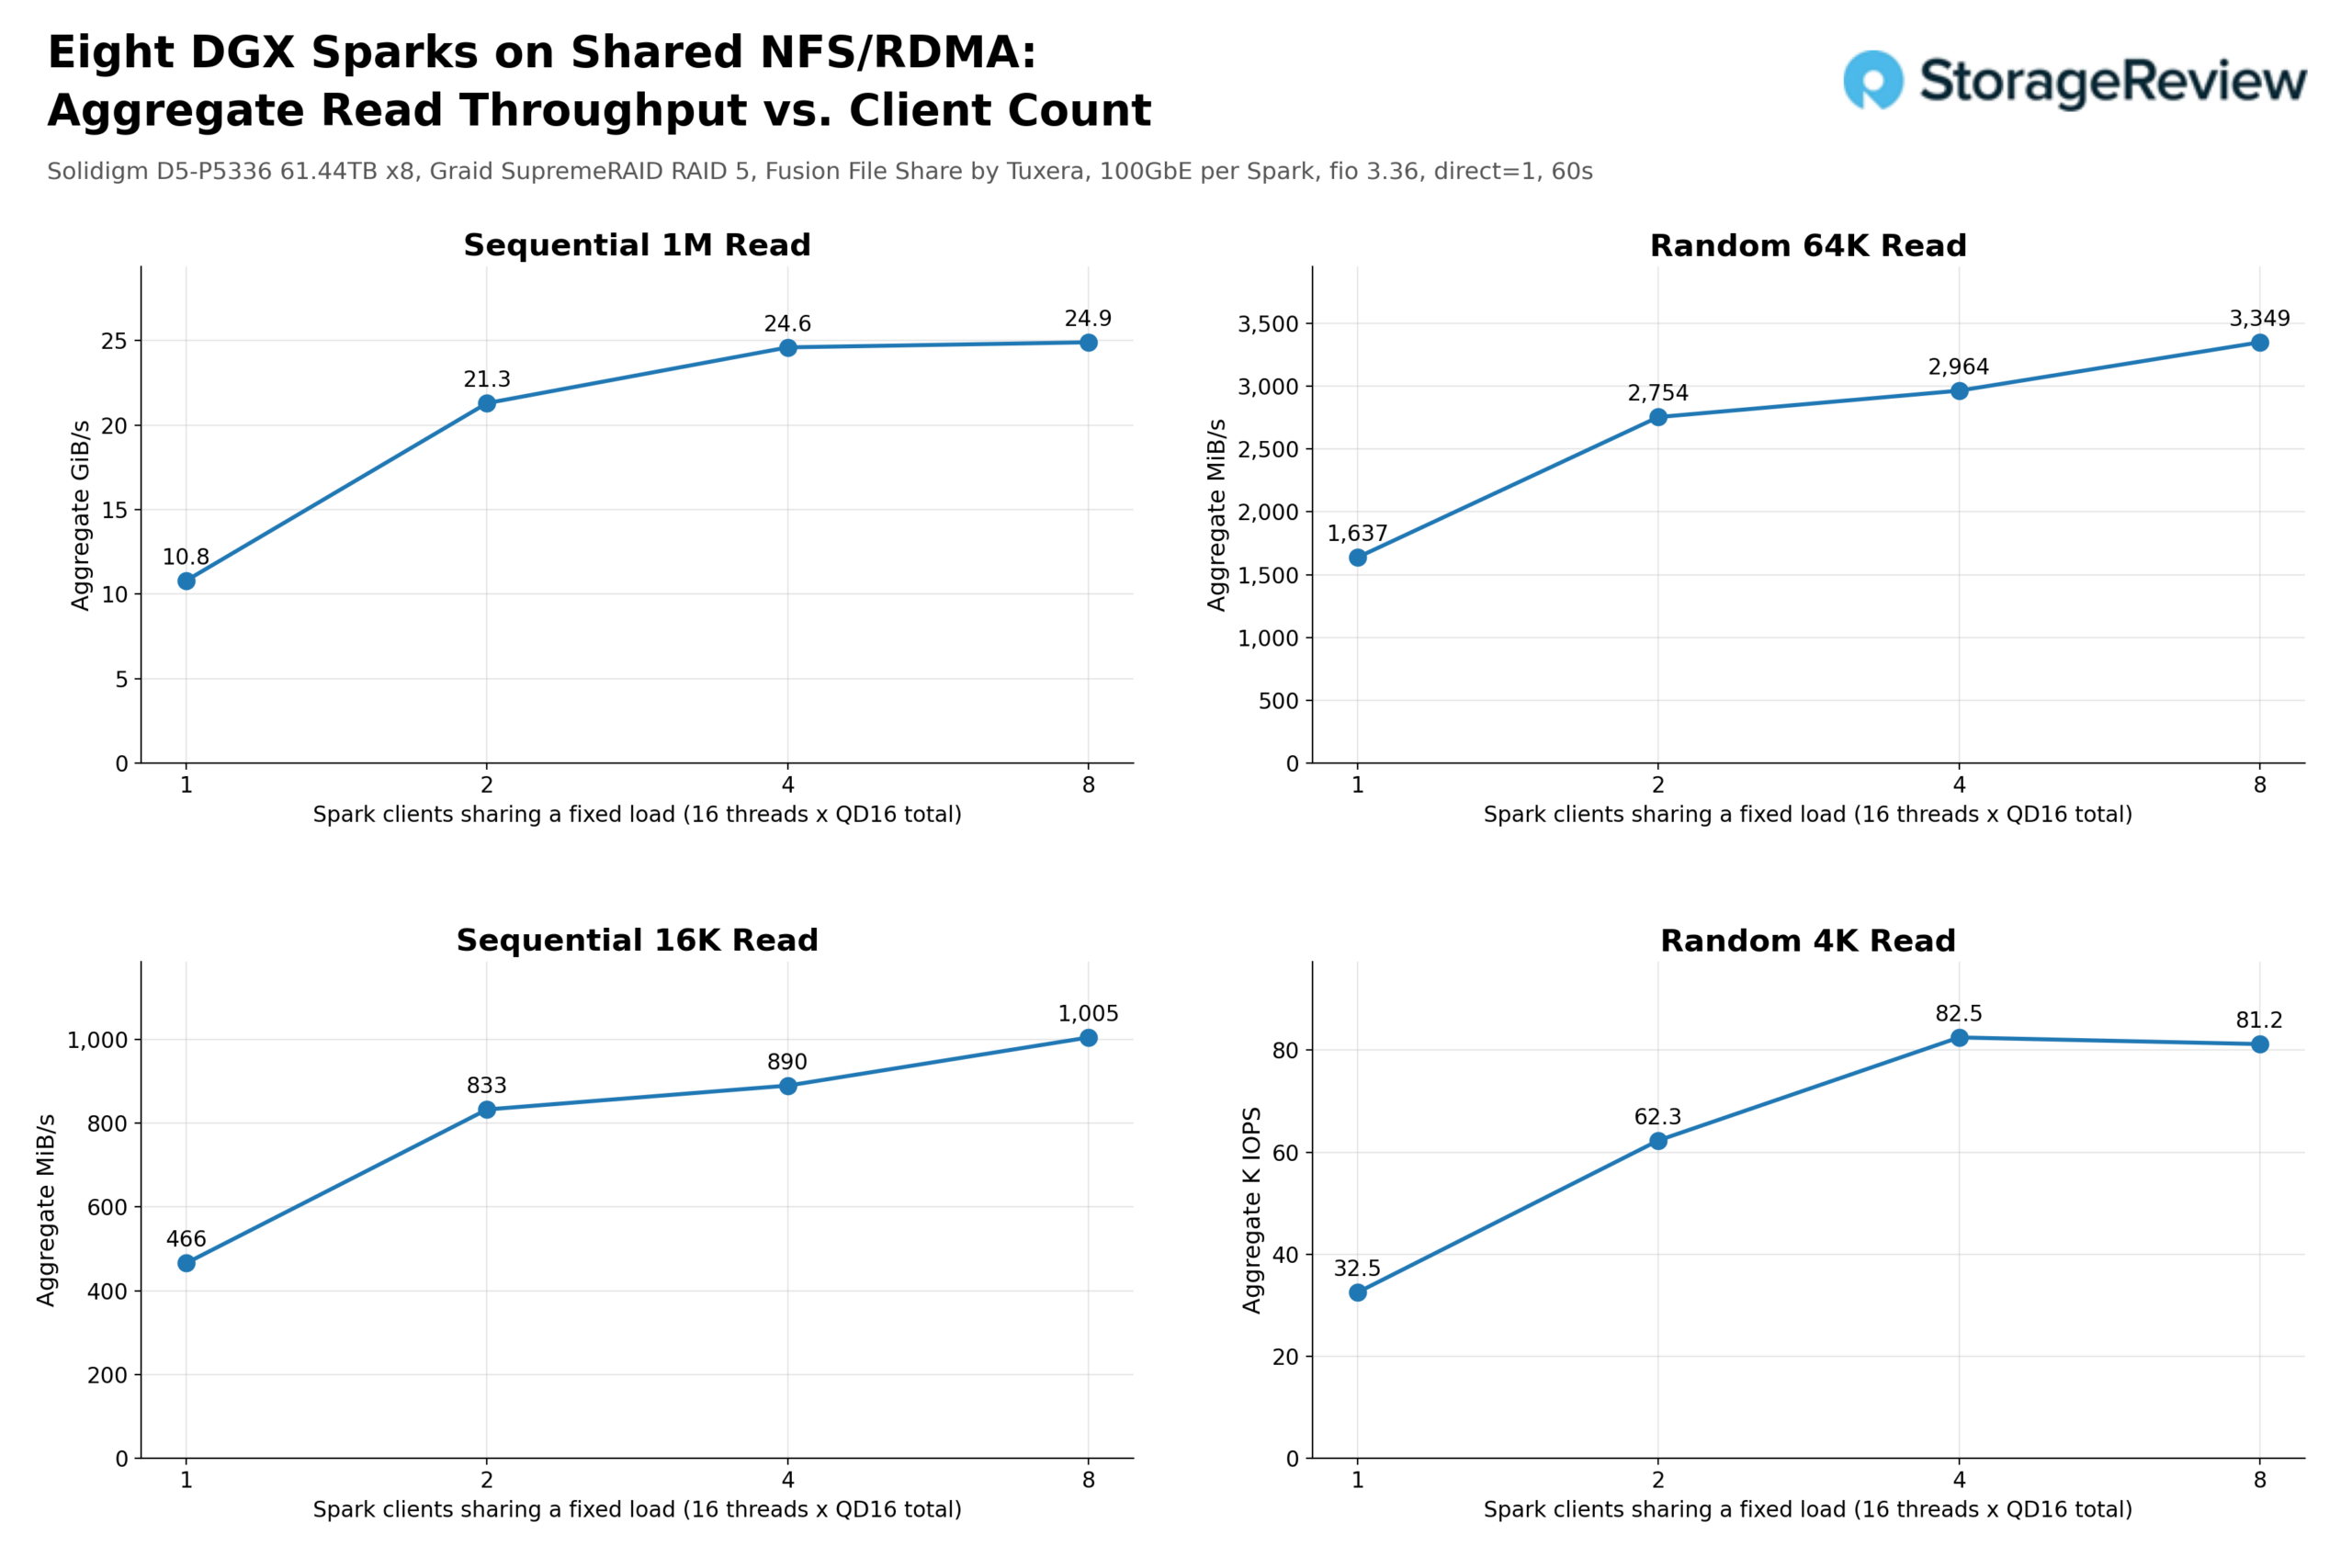
Celková sekvenční rychlost čtení 1 milionu dat vzrostla z 10.8 GiB/s na jednom Sparku na 21.3 GiB/s na dvou, 24.6 GiB/s na čtyřech a 24.9 GiB/s na osmi. Z hlediska sítě to představuje 93 Gb/s, 183 Gb/s, 212 Gb/s a 214 Gb/s oproti 800 Gb/s, které zvládnou dvě 400GbE síťové karty Broadcom, takže při plném zatížení osmi klientů pole využívalo 27 % síťové kapacity hostitele. Plató poblíž 25 GiB/s patří osmidiskovému poli RAID 5 QLC; síťové karty, přepínač a vlastní 100GbE linky Sparku se nikdy nestaly limitem.
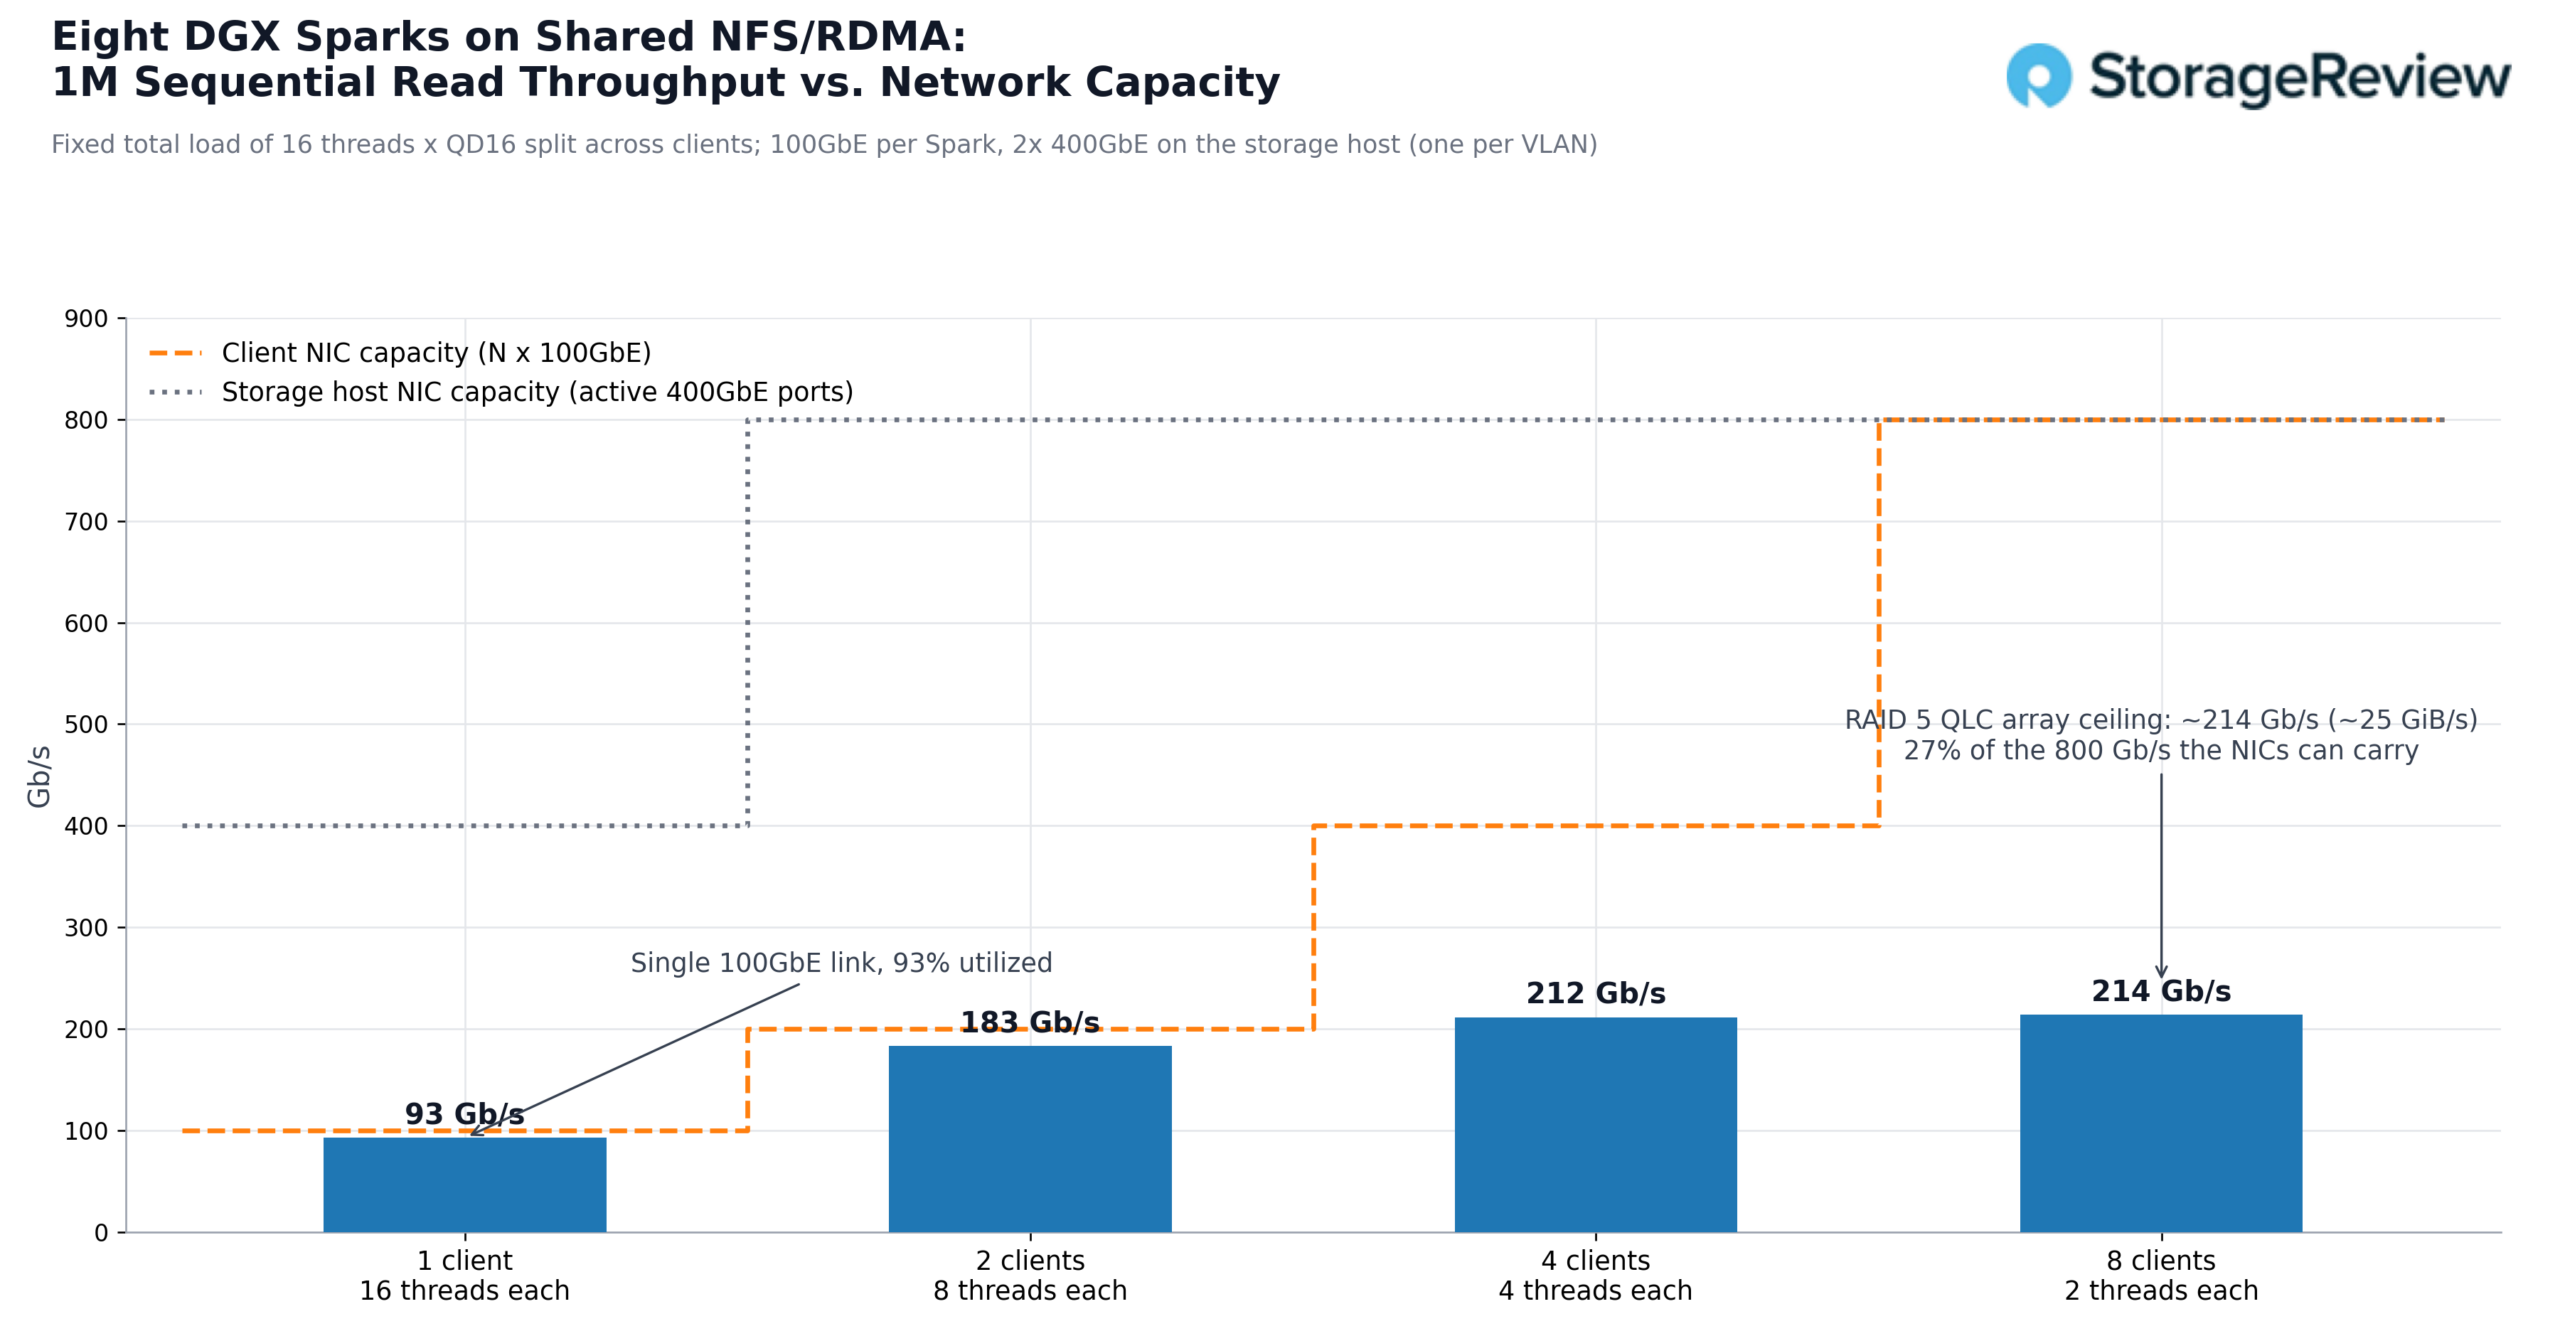
Dvě síťové karty na straně serveru již pokrývají osm Sparků při rychlosti linky a pokryly by i dalších osm pozic v R770AP: zdvojnásobení počtu disků, ať už jako druhé pole nebo širší sada RAID, poskytuje větší šířku pásma pro čtení za stejnými dvěma porty a zbývá prostor. Totéž platí pro I/O. Rychlost náhodného čtení 4K se zvýšila z 32.5K IOPS na jednom klientovi na stabilní hodnotu přibližně 81K IOPS na čtyřech klientech a dále, přičemž latence na I/O klesla ze 7.9 ms na 3.1 ms, jak se fronta každého klienta ztenčovala, a rychlost náhodného čtení 64K se zvýšila z 1 637 na 3 349 MiB/s, přičemž síť v obou případech výrazně nedosáhla svého limitu.
Dalším důležitým srovnáním je srovnání s úložištěm, které Spark již má. V našich individuálních recenzích GB10 dosáhl GDSIO 1M při čtení z interního M.2 maximální rychlosti téměř 11.2 GiB/s u Aceru Veritonu GN100 a GIGABYTE AI TOP ATOM. Dell Pro Max s GB10 a HP ZGX Nano G1n dosáhl rychlosti okolo 5.5 GiB/s, zatímco ASUS Ascent GX10 se blížil 5 GiB/s. Pro srovnání, externí NVMe-oF box Luisuantech GP Spark dosáhl rychlosti 9.5 GB/s přes stejný 100GbE port. Jediné čtení ze sdíleného QLC pole s rychlostí 10.8 GiB/s odpovídá nejrychlejším interním diskům v dané skupině a zhruba zdvojnásobuje nejpomalejší čtení přes jeden kabel z dat, která dokáže číst i každý jiný Spark. Nástroje se liší: GDSIO na interních discích a fio přes NFS, takže se jedná o srovnání rozsahu.
Kompletní přehled je uveden níže, s agregovanými údaji pro všechny čtyři úlohy pro každý počet klientů. Každý řádek pro čtení se zvyšuje s počtem klientů, dokud pole nevyčerpá kapacitu, a každý řádek pro zápis zůstává neměnný od jednoho Sparku do osmi, protože paritní cesta RAID 5 udržuje pole na pevném stropu pro zápis bez ohledu na to, kolik klientů ho sdílí. Pro sdílenou složku vytvořenou tak, aby ji mohlo číst mnoho klientů a aby se do ní při příjmu zapsalo pouze jednou, je tento profil navržen tak.
| Agregát (celkem 16 vláken) | 1 Spark | 2 jisker | 4 jisker | 8 jisker |
|---|---|---|---|---|
| 1M sekvenční čtení | 10.8 GiB/s | 21.3 GiB/s | 24.6 GiB/s | 24.9 GiB/s |
| 1M sekvenční zápis | 2.4 GiB/s | 2.4 GiB/s | 2.4 GiB/s | 2.4 GiB/s |
| 64K náhodné čtení | 1,637 MiB/s | 2,754 MiB/s | 2,964 MiB/s | 3,349 MiB/s |
| 64K náhodný zápis | 722 MiB/s | 719 MiB/s | 723 MiB/s | 703 MiB/s |
| 16K sekvenční čtení | 466 MiB/s | 833 MiB/s | 890 MiB/s | 1,005 MiB/s |
| 16K sekvenční zápis | 57 MiB/s | 60 MiB/s | 62 MiB/s | 28 MiB/s |
| 4K náhodné čtení | 32.5K IOPS | 62.3K IOPS | 82.5K IOPS | 81.2K IOPS |
| 4K náhodný zápis | 17.8K IOPS | 17.7K IOPS | 17.5K IOPS | 17.2K IOPS |
Modely hostování na sdíleném úložišti
Průběh fio dokazuje, že pole i síť jsou více než schopné. Dalším testem, který je pro daný případ použití důležitý, je, zda se model nacházející se na sdíleném poli načítá stejně dobře jako model nacházející se na vlastním NVMe úložišti Sparku, protože to je pracovní postup, na kterém závisí celý návrh: jedna kopie hostovaná centrálně, načtená kýmkoli. V NVFP4 jsme zvolili Qwen3.5-122B-A10B, model se 122 miliardami parametrů a směsí expertů, který zabírá 78 GB na disku a vejde se do 128 GB unifikované paměti jednoho Sparku. Měřili jsme čas od spuštění inferenčního serveru do hlášení, že server je v pořádku, spolu s průměrnou šířkou pásma úložiště v tomto okně, ve třech scénářích: jeden Spark načítání z interního NVMe, stejný Spark načítání přes NFS/RDMA ze sdíleného pole a všech osm Sparků načítání stejné kopie z pole současně.
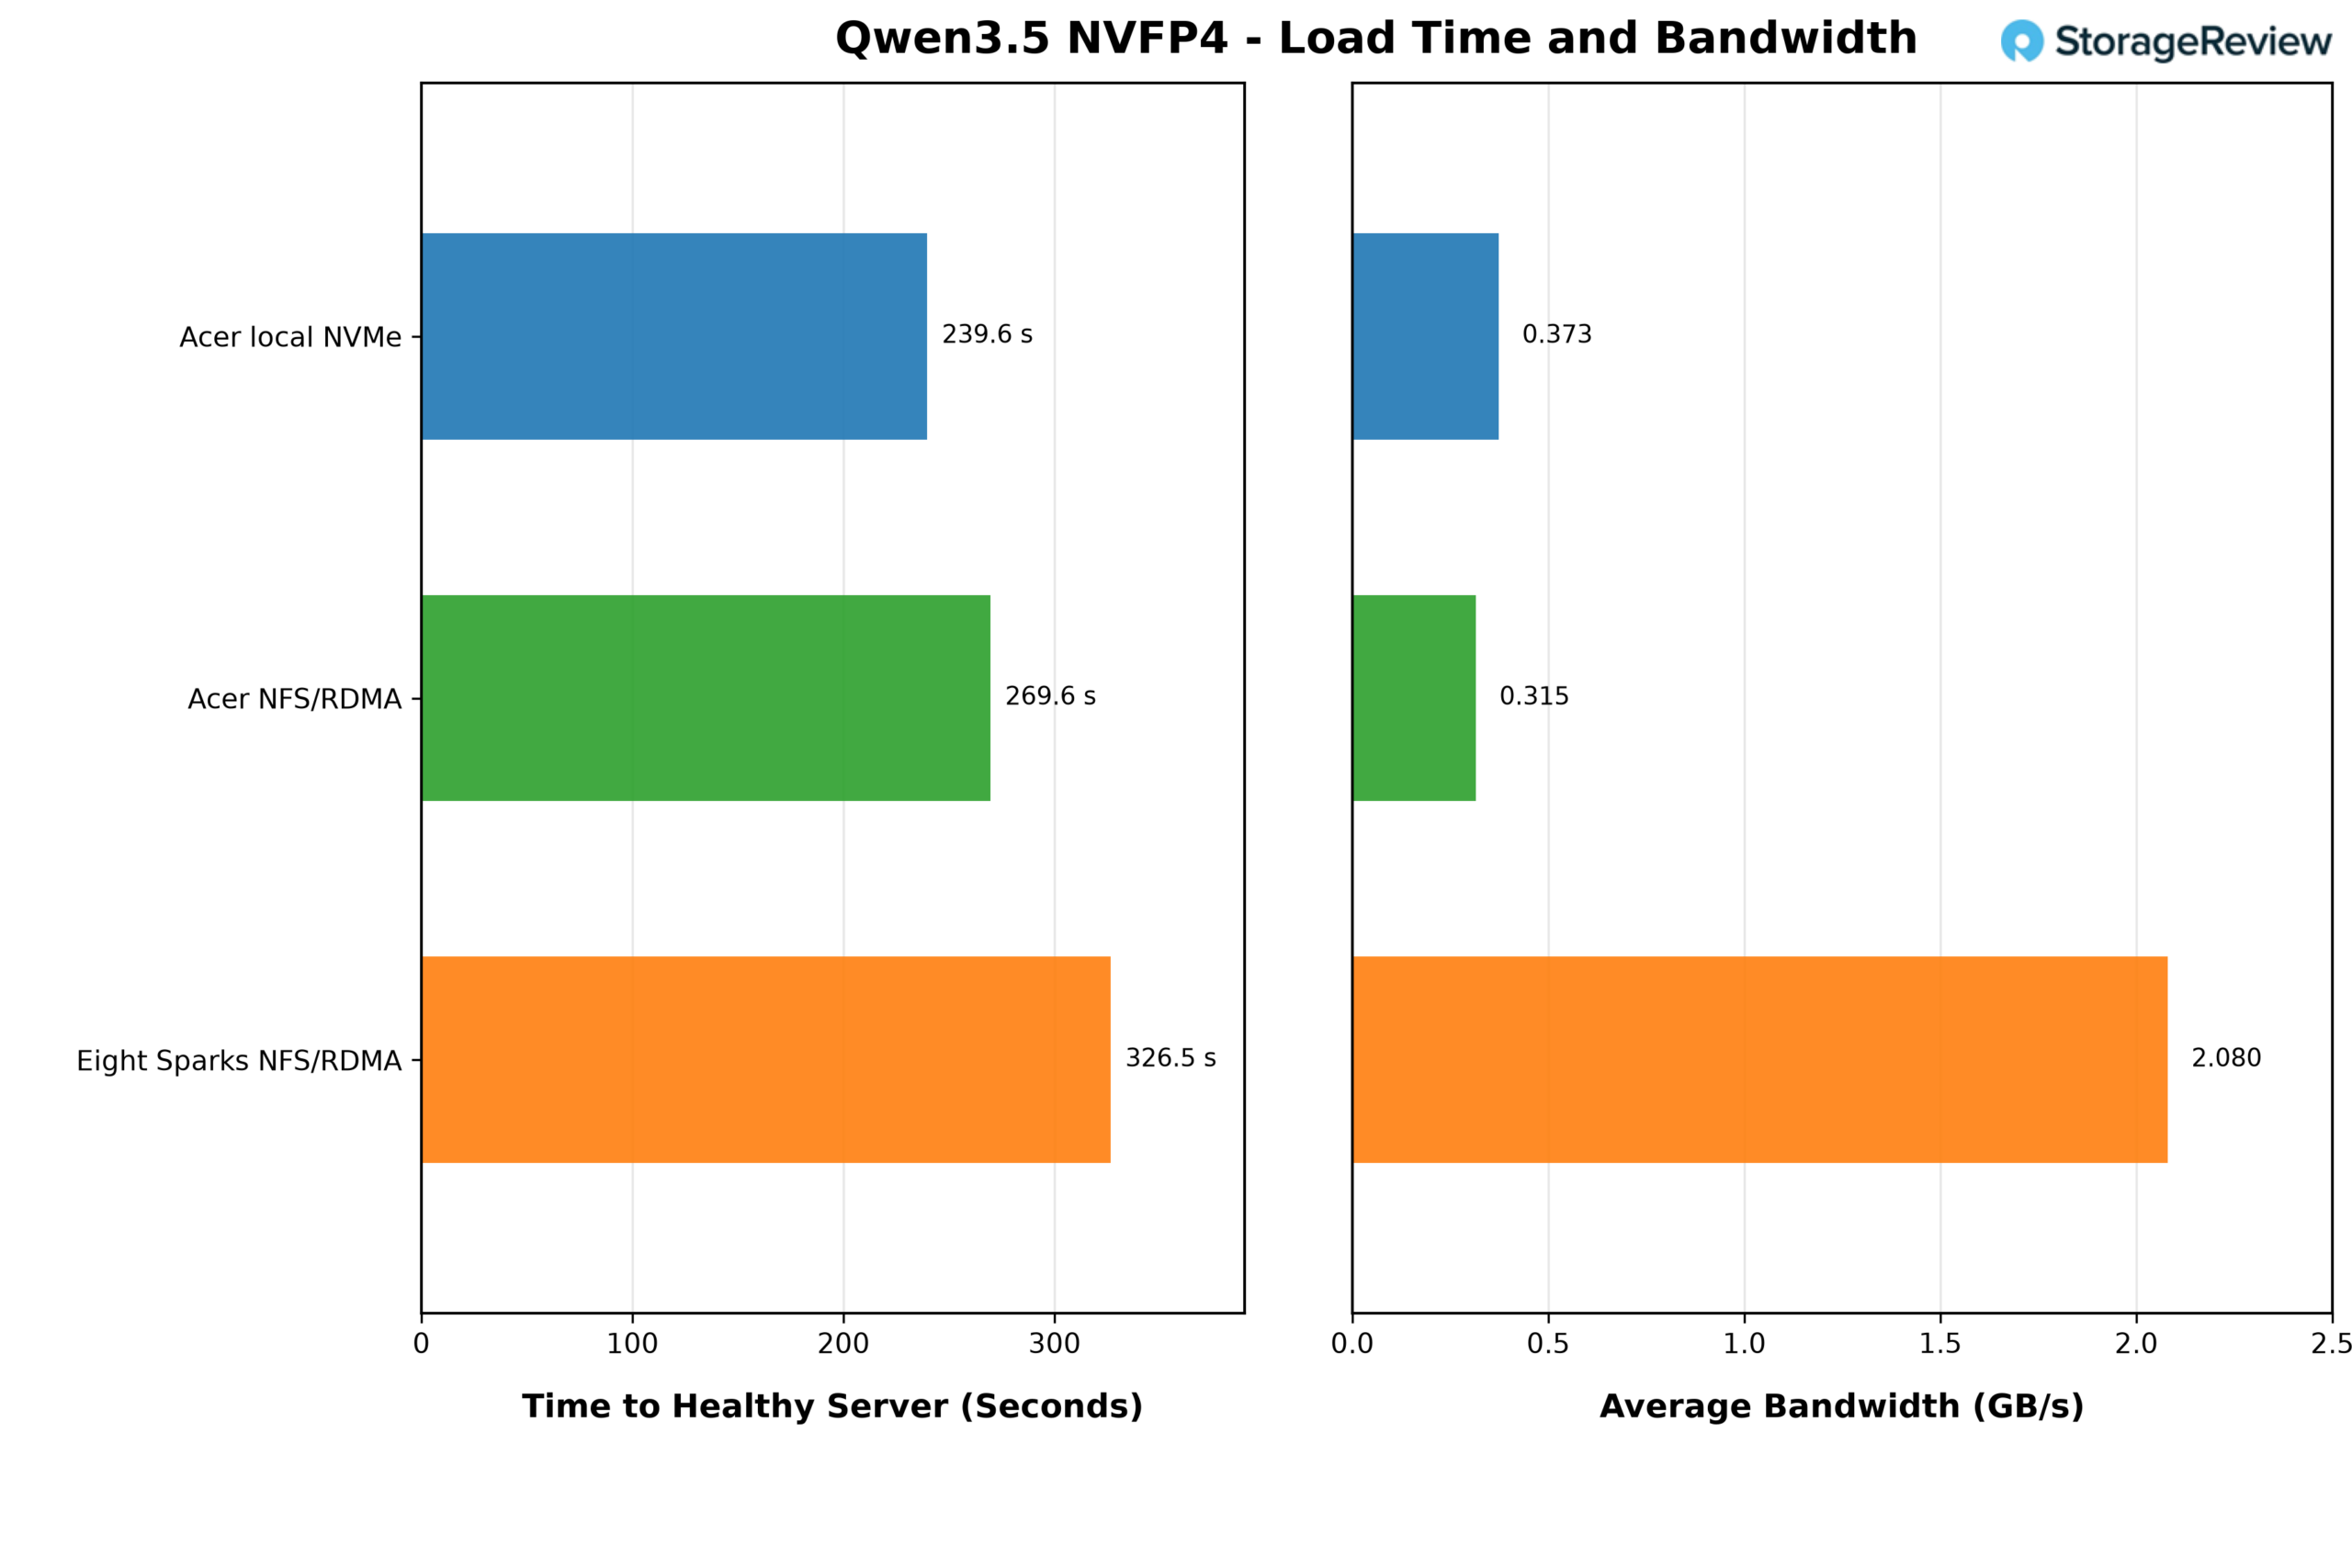
Z interního NVMe se Acer Veriton GN100 dostal na funkční server za 239.6 sekundy s průměrnou rychlostí 0.373 GB/s. Ze sdíleného pole přes NFS/RDMA trvalo stejnému Sparku 269.6 sekundy s rychlostí 0.315 GB/s, což je o 30 sekund, neboli o 13 %, déle. Průměry ukazují, že při 78 GB po dobu čtyř minut není načítání modelu na Sparku v žádném případě omezeno úložištěm. Tempo udává vlastní zpracování vah GB10 a úložiště tráví většinu okna čekáním.
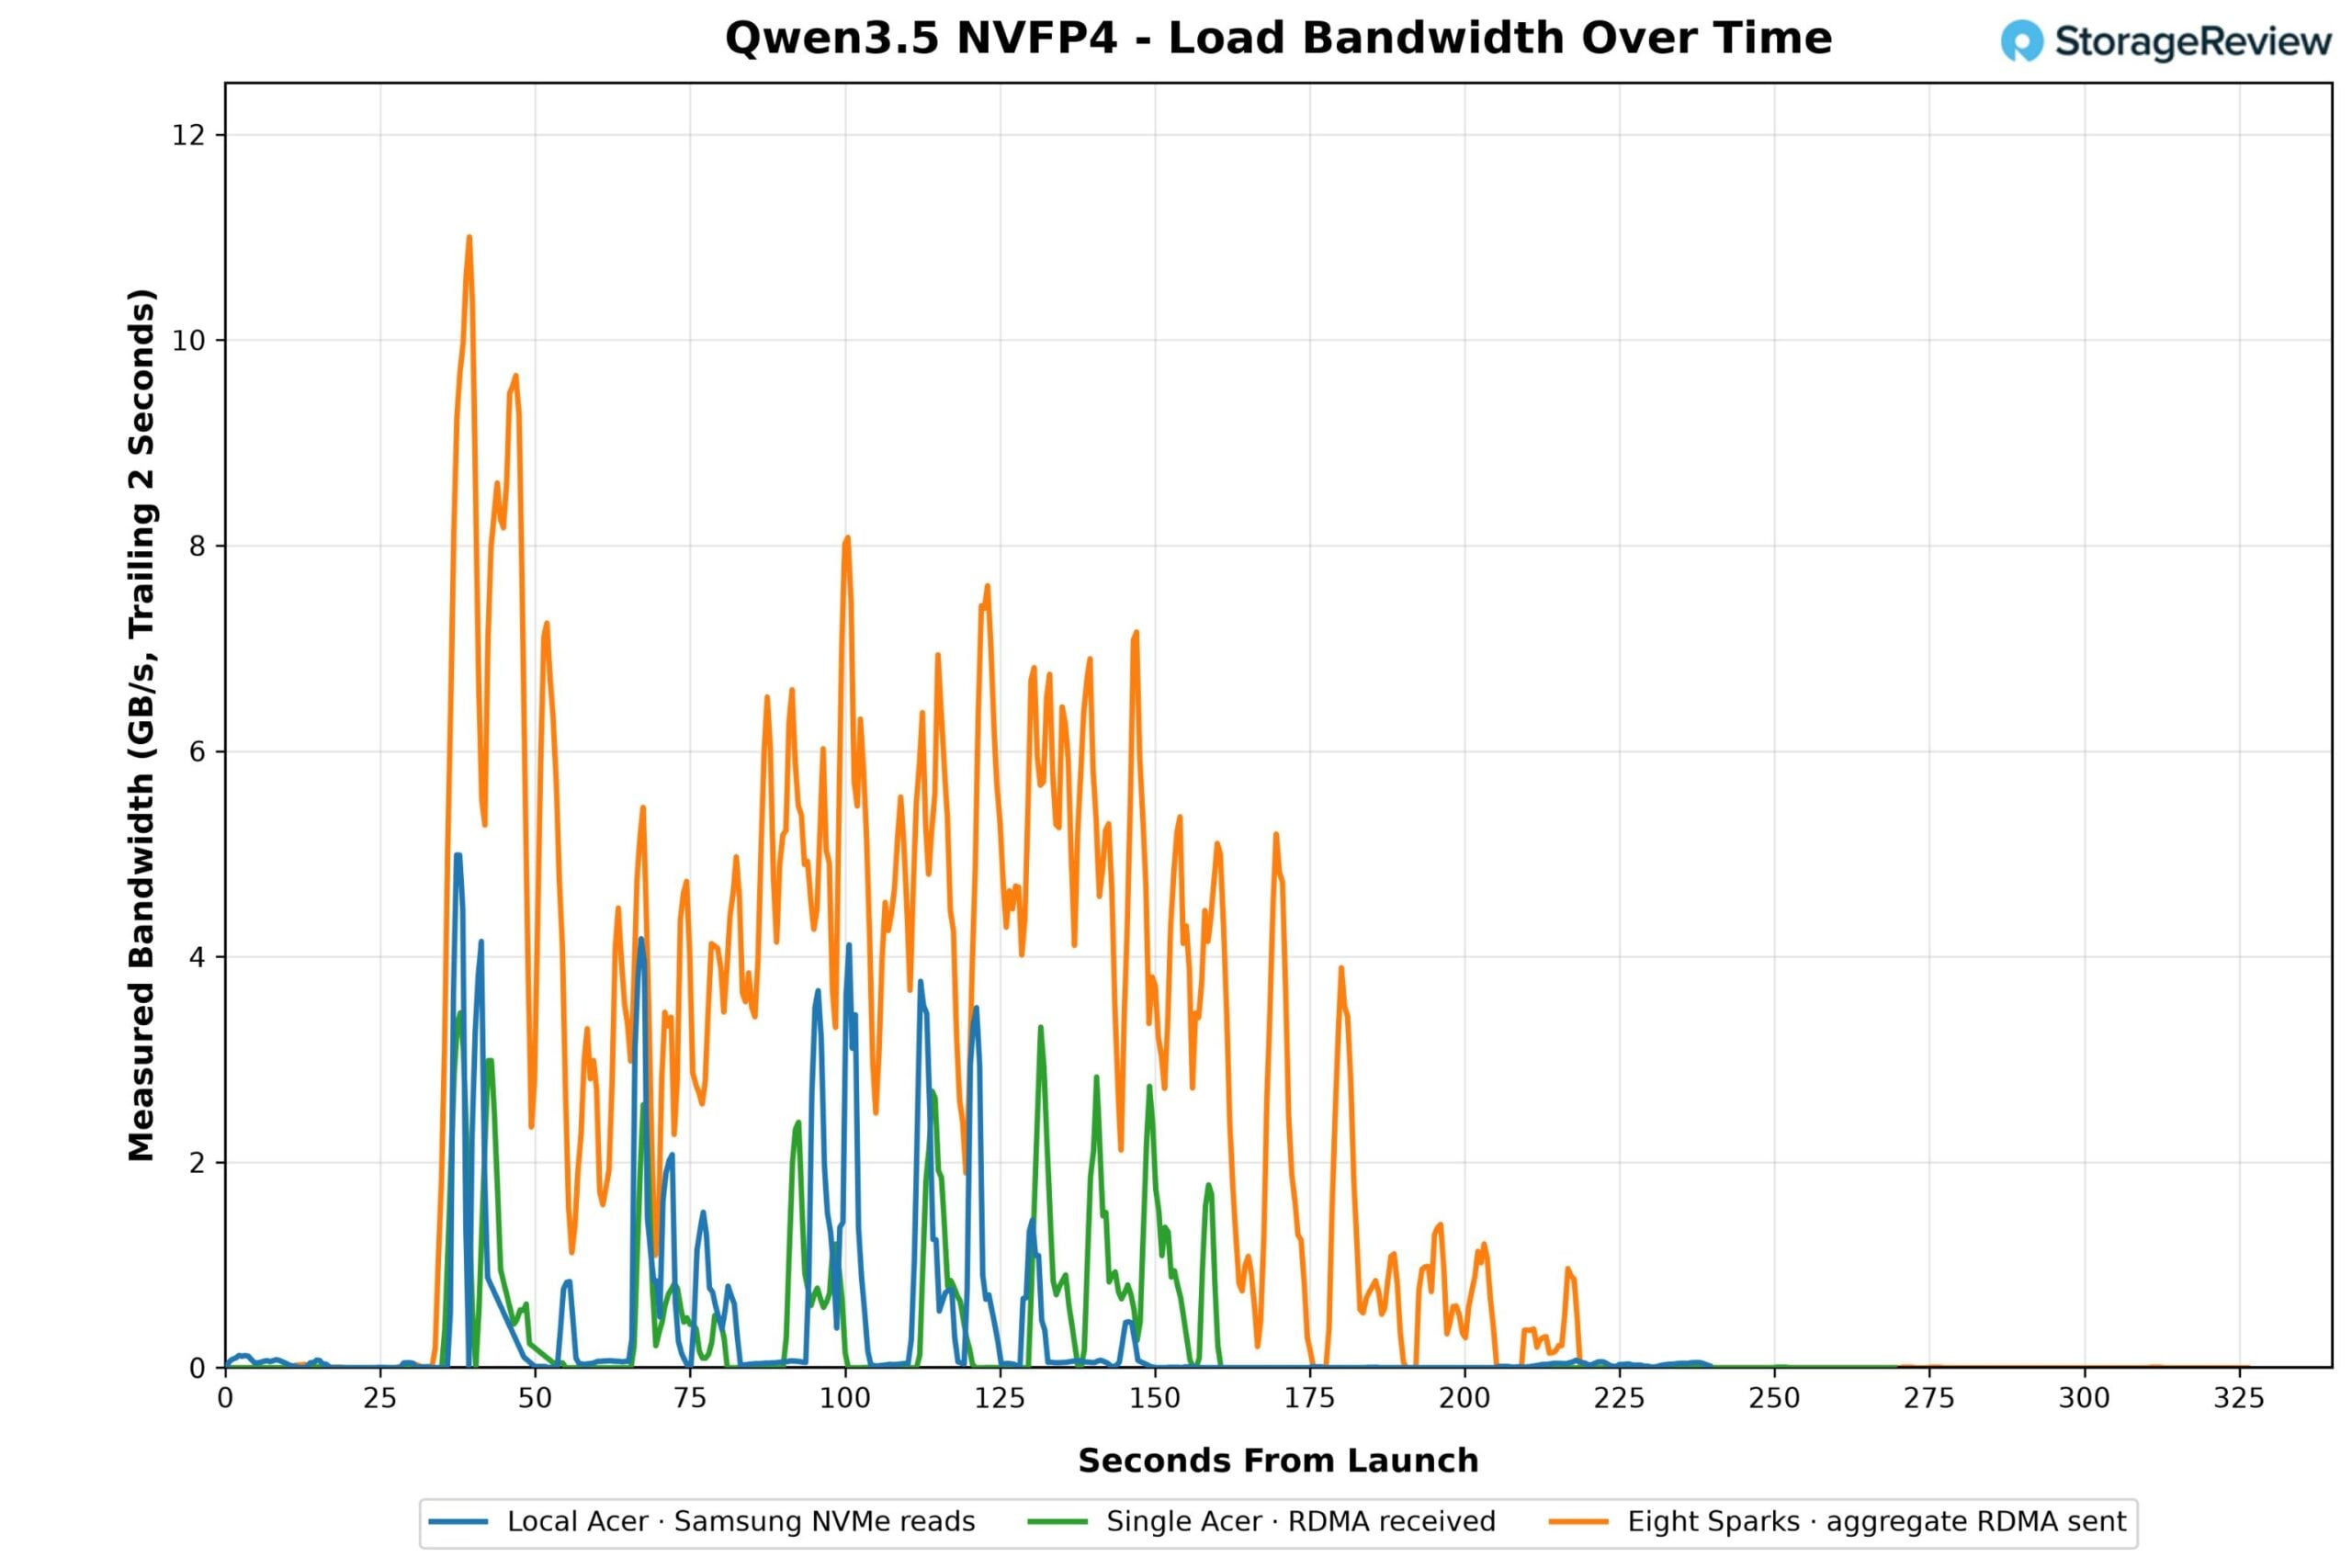
Záznam šířky pásma ukazuje tento vzorec: lokální čtení NVMe přichází v dávkách, které dosahují vrcholu kolem 5 GB/s s dlouhými mezerami mezi nimi; jeden NFS klient vykazuje stejný tvar dávky s mírně nižšími špičkami. Agregovaná čára osmi Sparků ukazuje pole pod souběžnou poptávkou. Vzhledem k tomu, že všech osm Sparků najednou odebíralo stejných 78 GB, pole dosáhlo v první minutě celkového vrcholu 11 GB/s, poté se během následujících dvou minut ustálilo mezi zhruba 4 a 8 GB/s, zatímco Sparky pracovaly se svými vahami, s průměrem 2.08 GB/s v celém okně. Oproti 25 GiB/s, které ukázalo měření fio, pole dokáže poskytnout, osm Sparků načítajících model najednou spotřebovalo zlomek toho, co je k dispozici.
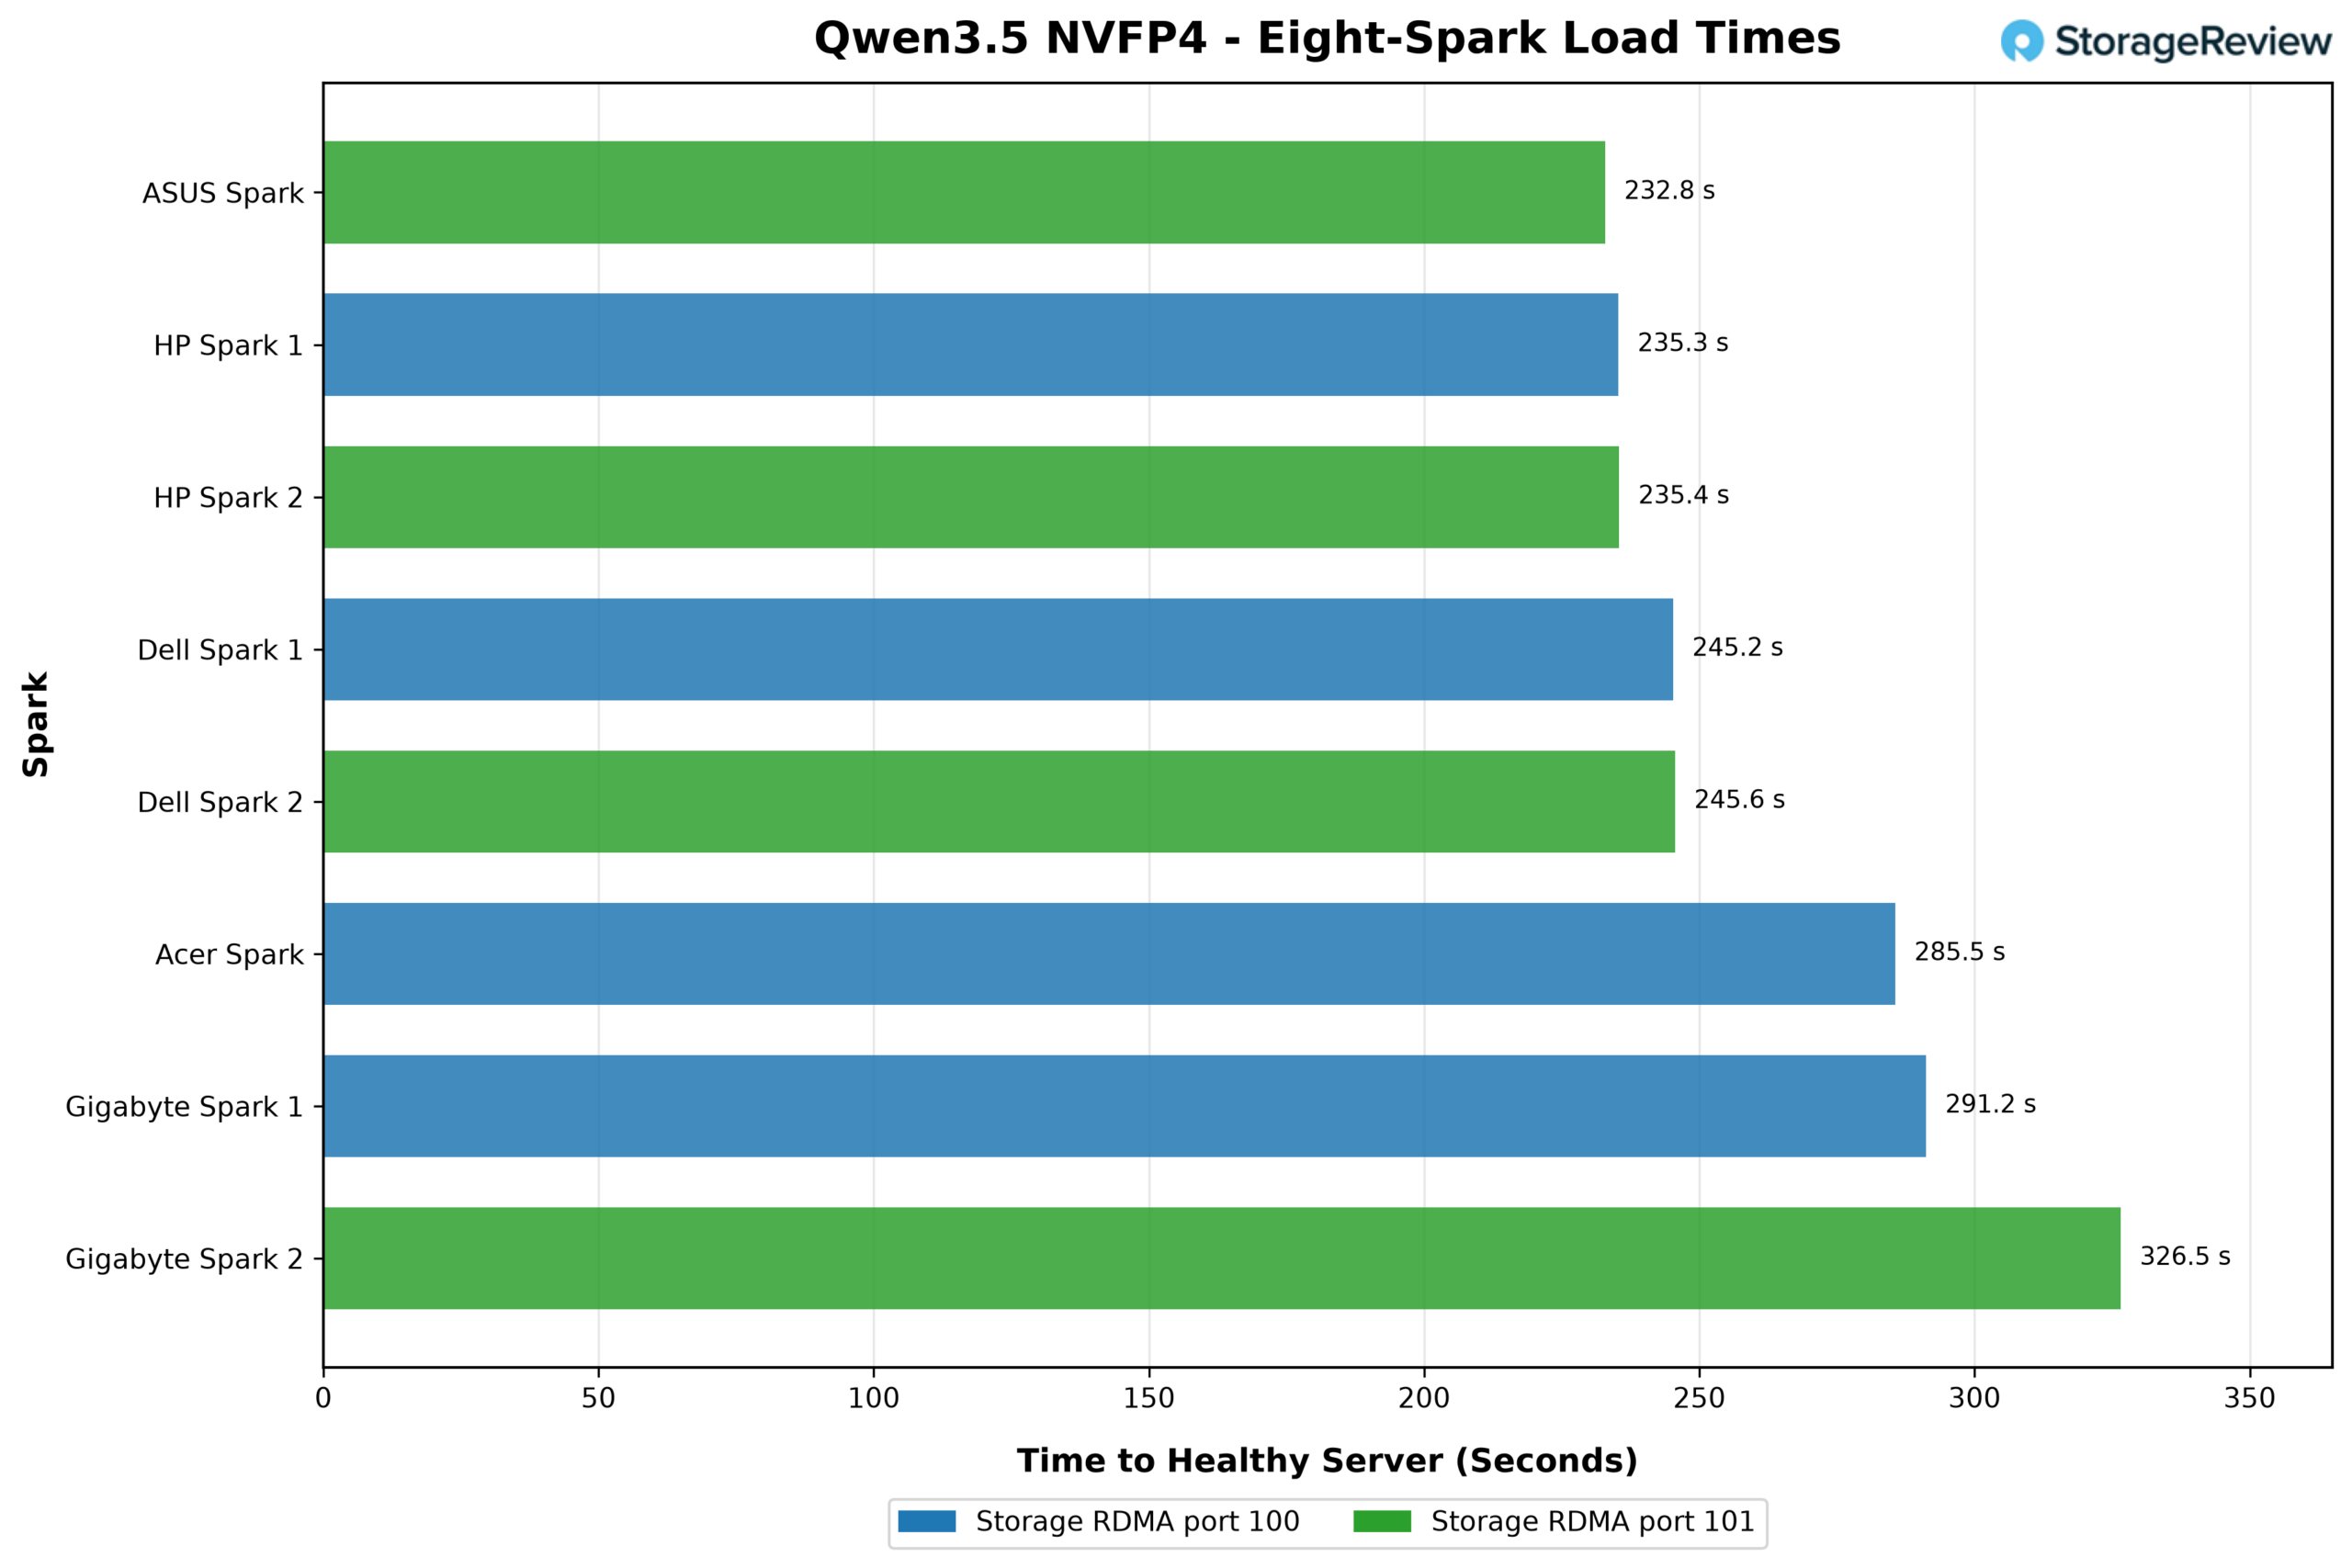
Doby načítání na jednotku v osmiprocesovém testu se pohybovaly od 232.8 sekundy na ASUS Ascent GX10 do 326.5 sekundy na jedné z jednotek GIGABYTE AI TOP ATOM, přičemž dva systémy HP ZGX Nano G1n dosáhly 235.3 a 235.4 sekundy a dva systémy Dell Pro Max s GB10 245.2 a 245.6 sekundy. Pět z osmi Sparků, které se současně načítaly ze sdíleného pole, překonalo jeden Spark načítající se samostatně přes NFS/RDMA a tři z nich překonaly lokální běh NVMe. Rozpětí není otázkou dodavatele; bez QoS ve stacku se jednotka, která v daném okamžiku čeká na pole, přepíná z běhu na běh a dvě jednotky na každé úložné síťové kartě se rovnoměrně rozdělily mezi rychlý a pomalý konec grafu.
Pro laboratoř je výsledkem to, že si může uchovat jednu kopii každého modelu v poli a jakýkoli Spark, nebo každý Spark, ji načte přibližně za dobu, jakou by trvalo načtení lokální kopie, bez nutnosti stahování, bez spotřebování lokální kapacity a bez nutnosti ukládat kopie vah na stůl.
Případová studie státu Oregon
Oregonská státní univerzita College of Earth, Ocean, and Atmospheric Sciences se opakovaně podílí na našich projektech v oblasti infrastruktury umělé inteligence, od výzkumu oceánů v reálném čase na palubě výzkumné lodi až po akademické hodnocení s podporou umělé inteligence s využitím systému Metrum AI . Chris Sullivan, ředitel pro výzkum a akademické výpočty na Oregonské státní univerzitě, a jeho architekt Thomas Olson zkoumají rozsáhlou laboratoř Spark pro učení s využitím umělé inteligence, která by se dala škálovat až na 100 jednotek, a jejich úvahy o úložišti ovlivnily náš návrh dvěma konkrétními způsoby.
Zaprvé, úložiště musí být nezávislé na systémech Sparks. OSU zvažovala souborový systém roztažený přes samotné Sparky a pro učebnu jej odmítla, protože přidání nebo odebrání jediného uzlu by narušilo úložnou službu pro všechny. Centrální pole, které jakýkoli Spark připojuje, znamená, že Spark lze přidávat, odebírat, znovu vytvářet obrazy nebo předávat jinému studentovi, aniž by to ovlivnilo data kohokoli jiného. Zadruhé, úložiště musí následovat uživatele. Požadavek OSU popisujeme jako vylepšenou verzi sdílení souborů pro účely umělé inteligence, kde studenti ukládají trvalé informace při pohybu mezi systémy. U NFS je to složka na studenta; přihlaste se do jakéhokoli Sparku, připojte sdílení a vaše práce je tam.
Právě kvůli datovým sadám je to pro OSU důležitější než pro server s domovským adresářem. Vysoká škola Země, oceánu a atmosférických věd (Fakulta věd o Zemi, oceánu a atmosféře) chce zpřístupnit studentům svá výzkumná data, oceánografické a atmosférické sbírky měřené v desítkách terabajtů pro jejich vlastní výzkum. Na úložišti u stolu neexistuje žádná taková verze: 4TB slot M.2 nepojme ani jednu z těchto sbírek a i laboratoř plná externích skříní by znamenala nákup a naplnění kopie pro každý stůl a následné udržování každé kopie aktuální, což by si žádné oddělení nemohlo dovolit. Hostování dat jednou na poli a jejich připojení přes 100GbE je přístup, který v našem hodnocení splňoval tento požadavek. Stejné pole hostuje knihovnu modelů, takže studenti tráví svou lekci spuštěním Qwen, Llama nebo jakéhokoli jiného modelu bez nutnosti stahování. Stejný princip platí pro podniky, které nasazují stolní systémy umělé inteligence jako vývojářské pracovní stanice: připojte produkční datovou sadu přes rychlou síť a nechte systém na ní pracovat na místě, což eliminuje potřebu vytvářet druhé datové jezero, aby stolní počítače měly co číst. Data zůstávají v datovém centru s existujícími kontrolami přístupu, šifrováním a zálohováním a Spark po odeslání neobsahuje nic důležitého.
Závěr
Hardware pro umělou inteligenci na stole je dobrý v mnoha věcech, ale není skvělý pro to, aby byl součástí datového majetku organizace, a jediný slot M.2 v každém systému GB10 to zajišťuje: cokoli uživatel potřebuje, skončí zkopírováno na lokální flash disk, neviditelné pro IT, nechráněné a duplikované na každém dalším stole, který potřebuje totéž. Pro jeden Spark je externí lokální úložiště rozumným řešením. Pro laboratoř, oddělení nebo podnik, který tyto systémy nasazuje po desítkách, je každý stůl s vlastními daty silo a řešení je stejné, jako v datovém centru před lety: umístit kapacitu do rychlé sítě, spravovat ji jednou a sdílet. Sparky již mají vysokorychlostní síť; tento projekt ukazuje, co se stane, když ji někam dáte, a argumentuje, že samotné Sparky patří do racku vedle ní.
Osm disků Solidigm D5-P5336 QLC v poli Graid RAID 5 na serveru Dell poskytlo osmi diskům Sparks jednu datovou sadu chráněnou paritou. Dvě síťové karty Broadcom 400GbE a jedna Dell Z9864F-ON s 800G breakout poskytly osm disků Sparks 100GbE. Technologie Tuxera Fusion NFS over RDMA umožnila tuto kapacitu připojit na standardní Ubuntu s hooky adresářových služeb pro řízení přístupu na jednu linku. Při fixním zatížení rozloženém na všech osm disků pole poskytovalo agregované sekvenční čtení rychlostí 24.9 GiB/s, rovnoměrně rozdělené bez QoS, a jeden Spark sám saturoval svůj odkaz rychlostí 10.8 GiB/s, což je rychlost nejlepšího interního disku v jakémkoli testovaném systému GB10; tento limit spotřeboval 27 % toho, co zvládnou dvě síťové karty na straně serveru, takže síť je dimenzována pro plnohodnotnější server než tento. Modelový test potvrdil pracovní postup: 78GB model hostovaný jednou na sdíleném poli se na jednom Sparku načítá s odstupem do 13 % lokálního NVMe a na osmi Sparkech najednou, přičemž pět z osmi dokončilo práci rychleji než sólový běh NFS.
QLC flash umožňuje těmto ekonomickým řešením fungovat, protože pracovní zátěž je vysoká z hlediska kapacity a čtení, což je silná stránka D5-P5336, a jeden server pojme to, co by sto Sparků nikdy nemohlo lokálně unést, s jednou kopií všeho a každou kopií pod kontrolou datového centra. Oregonská státní univerzita má úložiště pro výzkum v oblasti produkce pro práci, která nemůže čekat. Koncept, který Chris Sullivan a Thomas Olson zkoumají, je vzdělávací úroveň, kterou dnes vysoká škola nemá: řízený, sdílený fond o velikosti racku nebo více Sparků, sestavený ze serveru a několika vysokokapacitních disků, který by mohl umístit desítky terabajtů skutečných oceánografických a atmosférických dat před rozsáhlou laboratoř pro výuku umělé inteligence na stejné struktuře, jakou používají její Sparky.
Tuto zprávu sponzoruje společnost Solidigm. Veškeré názory a stanoviska vyjádřené v této zprávě vycházejí z našeho nezaujatého pohledu na daný produkt (produkty).
Odkazy na komerční produkty v tomto článku slouží pro informační účely a nepředstavují schválení ze strany Oregonské státní univerzity.



 Amazon