

Největším rozhodnutím v oblasti infrastruktury umělé inteligence, které mnoho podniků v příštím roce učiní, nebude investice do GPU, ale upgrade databáze. Oracle AI Database 26ai je dlouhodobá podporovaná verze, ke které se Oracle zaměřuje ve své instalované základně 19c. 26ai umisťuje vektorové vyhledávání do stejného enginu, který uchovává transakce. Když je vektorový index uložen v databázi, blokové pole a SAN fabric za ním se stávají infrastrukturou umělé inteligence a přenášejí provoz vyhledávání spolu s transakcemi, které již obsluhují.
Databáze se změnila pod vlivem umělé inteligence
Společnost Oracle na této myšlence postavila platformu 26ai: nativní datový typ VECTOR, funkce vektorového vyhledávání v SQL, spouštění modelů v databázi pomocí ONNX a SELECT AI pro dotazy v přirozeném jazyce, to vše v LTS verzi, kterou společnost uvádí na více než 300 nových funkcí. V praxi může správce databází generovat vnoření, ukládat je vedle řádků, které popisují, a spouštět vyhledávání podobnosti v rámci stejného rozsahu transakcí jako vyhledávání objednávek. Není třeba spouštět žádné samostatné vektorové úložiště, udržovat žádný synchronizační kanál ani druhou kopii regulovaných dat mimo auditní stopu.
IBM cituje IDC ohledně tohoto trendu: „Integrované vektorové databáze jsou jasnou platformou volby pro ukládání a dotazování vektorových vnoření, protože organizace upřednostňují unifikovaná, řízená prostředí pro agentní umělou inteligenci.“ Zákazníci společností IBM a Broadcom chtějí rozšířit databázi, které již důvěřují, než k ní postaví novou.
Oracle v tomto směru není sám. Žebříček popularity DB-Engines z října 2026 uvádí čtyři nejvýznamnější relační a multimodelové enginy: Oracle, MySQL, Microsoft SQL Server a PostgreSQL, a všechny čtyři přidaly vektorové typy nebo vektorové vyhledávání, ať už nativně nebo prostřednictvím rozšíření, jako je pgvector. IBM se rozhodla zahájit validační práci s Oraclem především kvůli jeho vedoucímu postavení na trhu, ačkoli argument o úložišti v tomto článku platí i pro ostatní.

Argumenty pro ponechání blokového úložiště v on-premise se s příchodem umělé inteligence nezměnily: data, která činí nasazení umělé inteligence užitečným, jako jsou záznamy o pacientech, žádosti o úhradu, objednávky a obchody, nemohou odejít. Jejich kopírování na vyhrazenou platformu umělé inteligence znamená dvojí placení za úložiště, akceptování toho, že se kopie přesune z produkčního clusteru, a ztrátu kontrolních mechanismů správy a řízení, které originál činily právně obhajitelným. Udržování vyhledávání uvnitř databáze se vyhýbá všem třem. Pole, které slouží k vyhledávání řádků v submilisekundových intervalech, nyní slouží také pro skenování vektorové podobnosti pro lékaře a zároveň pro záložní stream.
Skupina IBM Storage a Broadcom Fibre Channel (FC) se pustila do ověření případu smíšené zátěže a vytvořila prostředí kolem Oracle AI Database 26ai na IBM FlashSystem s Broadcom Brocade Gen 8 SAN fabric a Emulex 64G SecureHBA . Poté se zabývali otázkami, které si kladl tým pro infrastrukturu: jaký je dopad na transakční latenci, když vedle ní začíná vektorová zátěž, vliv rychlosti fabric na propustnost vektorového vyhledávání, kapacita spotřebovaná vkládáním, účinnost detekce ransomwaru při cílení na záložní svazek RMAN a jaké jsou požadavky na přidání hostitele do SAN bez zónovacího lístku?
Data již existují v blokovém úložišti a nyní k nim přichází umělá inteligence
Nic z toho neříká, že úlohy umělé inteligence obecně patří do blokového úložiště. Podniky budou pro nestrukturovaný majetek uchovávat pole souborů a objektů: dokumenty, obrázky, videa, trénovací sady a kontrolní body modelů, které nikdy neexistovaly v databázi a pravděpodobně nikdy nebudou. V následující demonstraci zdravotnictví IBM uchovává nezpracované rentgenové snímky v objektovém úložišti, zatímco v Oracle ukládá pouze vložené soubory a metadata případů. Co se mění, je zátěž pole, které nyní nese několik úloh s velmi odlišnými profily I/O současně.
Relační vrstva je nejznámější: miliony náhodných 4KB až 16KB I/O operací za sekundu, vyhledávání řádků a commity, které musí být dokončeny v mikrosekundách, vysoká souběžnost zápisu z provozu opakování, vrácení a kontrolních bodů a latence ocasu, která zůstává předvídatelná, protože na ni čeká aplikace orientovaná na uživatele. RMAN, zálohovací nástroj od Oracle, je opakem: sekvenční stream, který potřebuje rezervu k dokončení uvnitř svého okna, aniž by narušil první zátěž. Oběma je dobře porozuměno a pole IBM jsou na ně vyladěna.
Vektorovou vrstvu je obtížnější charakterizovat, protože velké tabulky vektorových vnoření mohou způsobit, že vektorové vyhledávání vypadá jako úloha náročná na šířku pásma: rozsáhlé sekvenční skenování. Charakterizace vektorové cesty Oracle 26ai společností IBM se blíží OLTP. Každý skok indexem je zhruba 4KB náhodné čtení; cesta dotazu je vázána na IOPS a citlivá na latenci a čtení dominuje, protože zápisy probíhají v oddělené fázi příjmu a sestavování indexu.
Šířka pásma je důležitá v burstových fázích, kdy se vytváří index nebo znovu vkládá korpus, a tyto burstové fáze bývají poměrně velké. Toto rozdělení je jádrem problému smíšeného I/O: na cestě dotazů vektorová pracovní zátěž soutěží s transakcemi o stejné fronty, což z izolace činí problém s kvalitou služby. A právě v burstových fázích se šířka pásma fabric stává stropem, jak ukazují výsledky 32G versus 64G dále v tomto článku.
Ověřená architektura
Společnosti IBM a Broadcom vytvořily pro toto ověření jedno prostředí v laboratoři umělé inteligence společnosti Broadcom v Coloradu. Úložištěm je pole IBM FlashSystem řady 9000 s operačním systémem IBM Storage Virtualize 9.1.3 s 24 moduly FlashCore, které poskytuje 64G porty Fibre Channel dvojici přepínačů Brocade Gen 8 G820 SAN. Hostitelem databáze je dvoupaticový server Intel Xeon 6767P se dvěma 2portovými adaptéry Emulex LPe38102 64G SecureHBA, na kterém běží Oracle AI Database 26ai na ASM bez GPU v úložné cestě; pole sleduje IBM Storage Insights.

Výsledky analýzy fabric a kapacity, porovnání vektorového vyhledávání 32G versus 64G a měření zastavěné plochy pomocí VectorDBBench jsme spustili pouze na daném hostiteli s datovou sadou BioASQ 1M. Stejná konfigurace podporuje i aplikační zátěž. Aplikaci pro zdravotnictví a její jazykový model hostuje server Supermicro 821GE-TNHR se dvěma procesory Xeon Platinum 8470 a osmi grafickými kartami NVIDIA H100 80GB. Softwarový balík zahrnuje databázové vestavění ONNX od Oracle, Ollama obsluhující Llama 3 a NVIDIA cuVS. Oba servery propojuje přepínač Broadcom Tomahawk 5 a síťové karty Thor 2 400GbE. V tomto prostředí probíhaly demonstrace I/O QoS, multitenancy, detekce ransomwaru a zdravotnických aplikací.

Podle společnosti IBM používá řada FlashSystem ( 5300 a 5600, 7300 a 7600 a 9500 a 9600) stejný software Storage Virtualize a zde demonstrované funkce, včetně omezení I/O, automatického zónování, detekce ransomwaru, vysoké dostupnosti založené na zásadách a migrace oddílů úložiště, fungují stejným způsobem s databází Oracle AI Database 26ai na kterémkoli z těchto polí na stejné úrovni kódu. Výkon a hustota se liší podle modelu a generace modulu FlashCore, takže každý údaj v tomto článku patří systému, na kterém byl měřen.
Zajištění optimálního výkonu OLTP a vektorové zátěže s QoS I/O
První otázka, na kterou se IBM a Broadcom snaží odpovědět, je ta, kterou si klade každý správce databází, když je pro produkční pole navržena vektorová úloha: co se stane s hlavními transakcemi? IBM to provedla jako dvě demonstrace na poli FlashSystem řady 9000 s využitím omezení I/O na úrovni svazků, což je mechanismus, který IBM nazývá I/O QoS. Databáze byla rozdělena do 30 svazků: 15 pro tabulkové prostory OLTP (ORCL16 až ORCL30) pod Swingbench Order Entry s 192 uživateli a 15 pro vektorové tabulky (ORCL31 až ORCL45) pod 200vláknovým syntetickým generátorem, na kterém běžely dotazy na podobnost top-k 500, přičemž Storage Insights mapovaly každou skupinu svazků.
Pokud OLTP běžel samostatně, každý OLTP svazek udržel stabilních 20 500 operací/s. Po spuštění generátoru vektorů se vektorové svazky během minuty zvýšily na přibližně 73 000 operací/s a svazky OLTP klesly na přibližně 13 000, což představuje pokles o 37 procent, přičemž na transakční straně se nic nezměnilo. Cesta vektorového vyhledávání je tvořena náhodnými čteními o velikosti 4 kB se stejnou velikostí bloku jako transakce, takže se dostane do stejných front a bere vše, co mu pole dá.

Limit 45 000 IOPS na každém vektorovém svazku, jeden řádek mkthrottle na CLI zvýšil počet vektorových svazků na limit a zvýšil OLTP zpět na přibližně 17 000 operací/s. Odstranění limitu to obrátilo a po skončení běhu vektoru se OLTP vrátil na 20 500. Dashboard sledoval v souhrnu totéž: 1.28 milionu IOPS bez omezení a zhruba 950 000 pod limitem, což s odchylkou několika procent je rychlost na svazek krát 30 svazků.

Druhá demoverze představuje konfiguraci, kterou IBM očekává pro nasazení v produkčním prostředí: nejprve byly nastaveny limity, 45 000 IOPS na vektorový svazek a 20 000 na svazek OLTP, poté byly obě úlohy spuštěny společně. Vektorové svazky dosáhly svého limitu, svazky OLTP se ustálily na přibližně 12 200 operacích/s a po celou dobu běhu zůstaly stejné a pole udrželo 870 000 IOPS (800 000 čtení, 70 000 zápisů) při 377 mikrosekundách a rychlosti 6.9 GB/s při 25% využití CPU. Limit OLTP byl nastaven nad požadavky úlohy a nikdy nebyl aktivován; je tam proto, aby se případný únik dat na kterékoli straně nemohl navzájem vyhladovět.
Swingbench udržel po celou dobu běhu svých 192 uživatelů na přibližně 1.19 milionu transakcí za minutu, což je zhruba 19 500 TPS. Generátor byl vyladěn tak, aby saturoval své objemy, takže jeho latence na dotaz není benchmarkem pro danou aplikaci. Během 30minutového běhu dokončil 35 672 dotazů rychlostí 19.8 za sekundu, s mediánem latence přibližně 10 sekund a p99 14.3 sekundy oproti 15sekundovému časovému limitu aplikace; 99 dotazů (0.28 procenta) tohoto časového limitu dosáhlo a transakce si toho vůbec nevšimly.


Omezení FlashSystem je strop svazků vynucený na poli bez ohledu na hostitele nebo cestu s volitelným limitem šířky pásma vedle limitu IOPS; omezuje souseda a nic si nerezervuje. Toto omezení je pokus o dimenzování: 15 vektorových svazků s 45 000 IOPS představuje 675 000 IOPS vektorové rezervy, což ponechává OLTP svazkům tohoto pole to, co potřebovaly. Jiné pole nebo mix toto číslo posouvá. Nastavte strop vektorů, kde transakce udržují svou latenci, a vektorová pracovní zátěž dostane vše nad ním.
Detekce ransomwaru na aktivních svazcích Oracle
Průzkum společnosti Sophos z roku 2024, který zahrnoval 2 974 organizací zasažených ransomwarem, zjistil, že 94 procent z nich zaznamenalo útok útočníků na jejich zálohy, že pokus byl v 57 procentech případů úspěšný a že medián nákladů na obnovu byl v těchto případech osmkrát vyšší. IBM postavila test na stejném předpokladu, nejprve zálohy a poté produkční prostředí, a útok zaměřila na cíl záloh RMAN, zatímco databázové svazky ponechala na místě. RMAN zapsal své zálohy na svazky FlashSystem, byl na nich spuštěn simulátor ransomwaru a pole si problému všimlo samo, bez hostitelského agenta v cestě.
Detekce probíhá uvnitř disků: Moduly FlashCore FCM4 a FCM5 počítají entropii a kompresibilitu při každém zápisu, spolu s velikostí bloku, adresou a vzory přepisování, a každé dvě sekundy předávají souhrn pro každý svazek inferenčnímu enginu uvnitř Storage Virtualize (8.6.3 nebo novější s firmwarem FCM 4.1 nebo novějším). Model vyvolává upozornění v grafickém uživatelském rozhraní FlashSystem a IBM Storage Insights Pro, přeposílá je do Storage Defender nebo SIEM a je samostatně patchable, takže přeškolený model je dodáván jako malá aktualizace zabezpečení bez upgradu firmwaru.
Protože analýza běží na modulu, funguje i v případě, že je kompromitován samotný hostitel. Šifrovaný výstup má vysokou entropii a přestane se komprimovat, což se ve statistikách projeví, ať už útočník změní přípony souborů, zašifruje pouze každý druhý blok nebo zpomalí šifrování, aby se skryl před agentem koncového bodu.
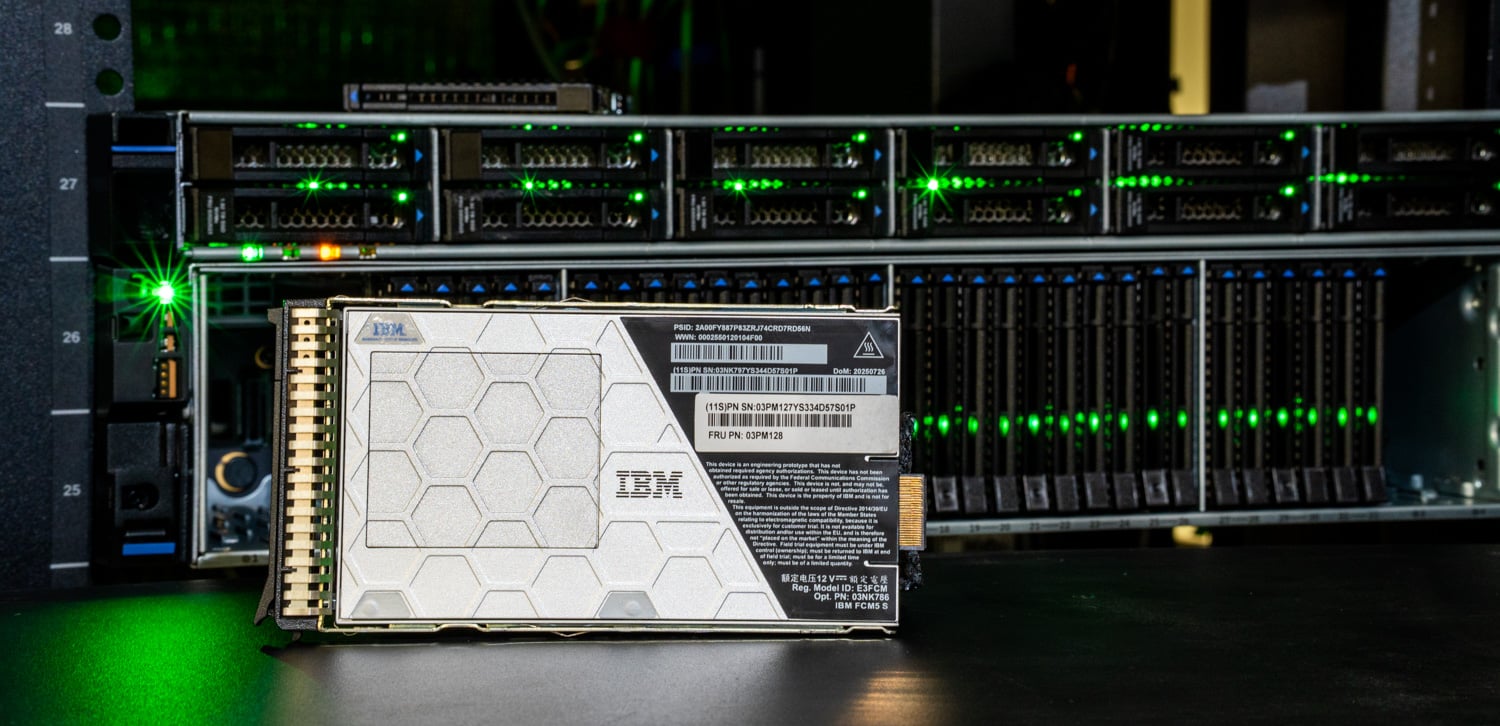
Během validace RMAN zapsal zálohu přes 16 paralelních kanálů, přičemž každá zálohovací sada byla omezena na 150 GB a databáze se nacházela na 15 discích o velikosti 200 GB na skupinu disků ASM pro OLTP a vektorová data. IBM provedla útok proti tomuto cíli zálohy a upozornění dorazilo do Storage Insights za méně než 60 sekund, což je v detekčním okně, které IBM pro tuto funkci publikuje. Storage Insights označil všech 31 svazků ve skupině svazků, protože upozornění na jednom svazku označuje celou skupinu jako hrozbu.
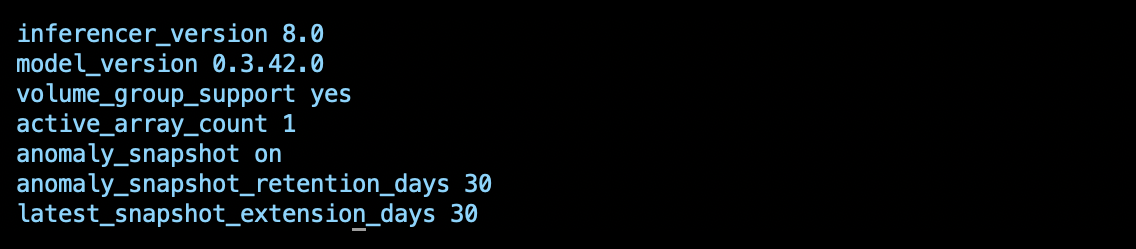
Odpověď je Safeguarded Copy a pole ji zpracovalo bez operátoru: FlashSystem pořídil neměnný snímek postižené skupiny svazků v okamžiku, kdy byla hrozba vyvolána, a zároveň prodloužil dobu uchování posledního známého funkčního snímku. lsanomalydetection Výstup z pole ukazuje konfiguraci, která za tím stojí: inferenční engine 8.0 s modelem 0.3.42.0, zapnutá anomaly_snapshot, 30 dní uchovávání nového snapshotu a 30 dní přidaných k poslednímu dobrému. Storage Virtualize také označí podezřelý snímek, aby z něj nikdo neobnovoval data, a zanechá čistý bod obnovení z doby před zahájením šifrování.
Fabric také nese bezpečnostní vrstvu. Broadcom zabudovává postkvantovou kryptografii do Brocade Gen 8, Emulex SecureHBA šifrují data během přenosu mezi hostitelem a fabric a nový standard FC-SP-3 od FCIA stanovuje základní úroveň kvantově připraveného zabezpečení pro Fibre Channel jako celek.
Růst SAN bez zónování: IBM FlashSystem AutoZoning s využitím Broadcom Target-Driven Zoning
Přidání hostitele do sítě SAN s technologií Fibre Channel obvykle vyžaduje tiket a dva týmy: správce serveru shromáždí názvy WWPN adaptérů HBA, správce sítě SAN ručně vytvoří zóny na obou sítích Fabric a správce úložiště namapuje hostitele na správné cílové porty. Jeden chybně zadaný název WWPN ponechá nový uzel Oracle RAC bez cest. Funkce AutoZoning přesune tuto práci do pole: FlashSystem komunikuje přímo s sítí Fabric, identifikuje iniciační názvy WWPN, vybere cílové porty a sám vytvoří zóny, aniž by se kdokoli musel přihlašovat k přepínači.

Tato funkce je postavena na technologii Brocade Target Driven Zoning (TDZ) a dorazila do softwaru FlashSystem verze 9.1.2. Vyžaduje přepínače Brocade s operačním systémem Fabric OS 9.1.1 nebo novějším a s povolením funkce TDZ správcem sítě Fabric na portech přepínačů směřujících k cílovým portům FlashSystem. Toto povolení je jediným krokem, který zůstává na týmu SAN, a AutoZoning neprovádí na portu žádnou akci, dokud není hotový. Odtud FlashSystem vytváří peer zóny, což umožňuje iniciátorům hostitelů dosáhnout cílového portu, ale ne navzájem, pod předvídatelným názvem IBM_SV_, který je označuje jako spravované polem.
Nastavení začíná v zobrazení portů Fibre Channel, které nyní zobrazuje přepínač, ke kterému se každý port připojuje, zda je port schopen AutoZone a zda je jeho konektivita symetrická, což znamená, že stejné ID portu na každém uzlu připadá na stejnou strukturu fabric. Topologické zobrazení je barevně znázorněno a AutoZoning podporují pouze zelené porty, které jsou aktivní, podporují AutoZone a jsou symetrické. Asymetrické porty zůstávají mimo provoz, i když jsou jinak kompatibilní, protože grafické uživatelské rozhraní varuje, že by to mohlo ohrozit redundanci a failover.

Vytváření hostitele začíná seznamem Nekonfigurované hostitele, který je vyplněn pomocí FDMI a který hlásí název hostitele, operační systém a porty každého HBA do sítě Fabric. V návodu od IBM se otevřelo dialogové okno Přidat hostitele s názvem serveru, operačním systémem a oběma porty HBA hostitele, který dosud neměl žádné zóny. Administrátor vybral sadu portů s povolenou funkcí AutoZone, která definuje cílové porty, ke kterým má hostitel přístup, a klikl na tlačítko Přidat. FlashSystem spároval své cílové porty s iniciátory hostitele, odeslal zóny do obou přepínačů a hostitel se připojil k síti se čtyřmi cestami přes dvě sítě Fabric.

V případě společnosti Oracle IBM využívá funkci AutoZoning pro přidávání uzlů RAC a nahrazování HBA, protože tato funkce sleduje změny v konektivitě hostitele nebo úložiště a přizpůsobuje definice zón tak, aby odpovídaly, takže vyměněný HBA nevyžaduje ruční změnu zónování. Stejná automatizace platí, když hostitelé potřebují cesty k druhému poli pro migraci oddílů úložiště nebo Policy-Based HA (PBHA). Tým SAN stále kontroluje, které cílové porty se účastní, protože na portu se nic neděje, dokud nepovolí TDZ. Přidání hostitele tedy již nečeká na změnu zónování.
Provozní obálka: PBHA, migrace gridu, vícenásobné pronájmy a umístění
Technologie Policy-Based HA (PBHA) synchronně replikuje úložný oddíl mezi dvěma poli FlashSystem v metro vzdálenosti s aktivním přístupem k hostitelům na obou lokalitách. IBM uvádí, že tato funkce je navržena pro nulové RPO a pro failover úložiště, kterým může správně clusterované nasazení Oracle projít bez ztráty dat. Když se porouchaná lokalita obnoví, data se znovu synchronizují a pracovní zátěž se přesune zpět bez výpadku.
Funkce FlashSystem Grid federuje až 32 polí FlashSystem pod jedním zobrazením pro správu a migrace oddílů úložiště přesouvá oddíl i s jeho svazky, skupinami svazků a hostiteli z jednoho pole do druhého bez výpadku aplikace. V případě Oracle IBM zmiňuje obnovu hardwaru, vyčerpání systému před aktualizací firmwaru a přesun vektorového oddílu do systému s větší kapacitou s růstem sady vestavěných modulů. Systém migruje jeden oddíl najednou přes Fibre Channel nebo vysokorychlostní Ethernet; hostitelé se mohou připojit přes Fibre Channel, iSCSI nebo NVMe/TCP a oddíl, který je již nakonfigurován pro PBHA, není pro migraci způsobilý.
Poradce pro umístění Storage Insights se stará o plánování pro stejnou mřížku. Na základě kapacity úlohy, rychlosti růstu, profilu I/O a cílové latence vyhodnotí každý systém v mřížce, před zprovozněním seřadí nejvhodnější a může také doporučit migraci, pokud zjistí nerovnováhu CPU nebo IOPS. Migrace i umístění využívají Storage Insights Pro, přičemž každý gridový systém je registrován u stejného tenanta Storage Insights.

Vícenásobný klientský systém umožňuje týmu správců databází a týmu umělé inteligence sdílet danou mřížku bez sdílení administrace. V návodu od IBM vytvořil administrátor dva klienty na stejném poli (Tenant_Scale a Tenant_oracle_ai) a každému z nich přidělil systém, skupinu uživatelů s rolí klienta a prvního uživatele. Poté pro každého vytvořil úložný oddíl se samostatnou skupinou svazků, svazky a mapováním hostitelů. Grafické uživatelské rozhraní nabízí konfiguraci replikace, jakmile existuje nový oddíl. Po přihlášení jako uživatel Tenant_Scale grafické uživatelské rozhraní zobrazovalo pouze oddíl a zdroje daného klienta, nic nepatřící Tenant_oracle_ai, a stejná kontrola ze strany Tenant_oracle_ai vrátila stejný výsledek.
Dividenda Fabric: 32G vs. 64G Fibre Channel v rámci vektorového vyhledávání
Jedinou proměnnou, kterou IBM a Broadcom v tomto testování záměrně změnily, byla síťová struktura (fabric). Stejné pole, hostitel a Emulex LPe38102 SecureHBA spustili VectorDBBench s datovou sadou BioASQ 1M (jeden milion 1 024rozměrných vektorů z biomedicínského korpusu otázek a odpovědí) dvakrát: jednou se dvěma porty HBA na 32 GB a jednou na 64 GB, prostřednictvím stejných přepínačů Brocade G820. Všechno ostatní, od 16 svazků ASM až po 4GB SGA, zůstalo zachováno, takže rozdíl mezi těmito dvěma testy je pouze v generaci Fibre Channel a v ničem jiném.

Fáze vyhledávání v tomto benchmarku je skenování pouze pro čtení: index IVF_FLAT od Oracle směruje každý dotaz do clusteru oddílů a čte je v plném rozsahu, což s vektory FLOAT32 o rozměrech 1 024 představuje zatížení šířky pásma. Na dvou 32G portech se čtení na straně hostitele vyrovnalo na 6.3 GB/s, rychlost linky u dvojice a křivka vyhledávání se zploštily na 43.7 dotazů za sekundu s 20 vlákny. Na dvou 64G portech stejný hostitel četl rychlostí 12.5 GB/s a udržoval se na 85.0 QPS při 80 vláknech, což je o 95 % vyšší propustnost ze stejného úložiště.

Latence vypráví druhou část příběhu 64G: v jednom vlákně se obě fabric liší o méně než 8 %, 0.107 sekundy oproti 0.099, protože jediný dotaz nikdy nezaplní žádnou z topořivých procesů. Od pěti vláken se však 32G běh zařazuje do fronty: průměrná latence v každém kroku zdvojnásobuje hodnotu 64G a u 80 vláknů dosahuje p99 4.08 sekundy oproti 1.14. Nasycená FC fabric neselže; zařadí každý dotaz do fronty a toto čekání se projeví jako koncová latence.

Fáze načítání se také posunula; načtení milionu vektorů trvalo 94.1 sekundy na 32G a 84.5 sekundy na 64G a sestavení indexu IVF_FLAT trvalo 139.6 sekundy oproti 108.4 sekundám, což je o 28.8 % déle na pomalejší fabrice, což představuje celkové načtení 233.7 sekundy oproti 193.0 sekundám. Hodnoty Recall a NDCG se v obou běhech lišily o více než 0.1 % (83.81 % a 84.42 % na 32G, 83.95 % a 84.56 % na 64G), takže fabrica změnila rychlost doručování odpovědí. Pro databázi, která je od nasazení na 32G, je upgrade HBA a přepínače zřejmou příležitostí k dosažení vyššího výkonu.
Plánování růstu kapacity vektorů
Vektorové vyhledávání mění matematické výpočty kapacity dříve, než ovlivní výkon. Vkládání je numerická kopie bloku zdrojových dat s pevnou šířkou a u textu je tato kopie obvykle větší než blok, který popisuje: pasáž o velikosti 1 000 bajtů se stane vektorem FLOAT32 o rozměrech 1 024 dimenzí a délce 4 096 bajtů, než databáze přidá řádek pro její uložení. Tým to nazývá amplifikace vektorového úložiště a měřil to na stejné datové sadě BioASQ 1M, která byla použita při porovnání tkanin.
Zdrojový text za milionem vektorů má velikost 0.90 GB. V Oracle 26ai se z něj stala vektorová tabulka o velikosti 7.67 GB, včetně přibližně 0.3 GB řádkové režie, a index IVF_FLAT přidal dalších 8.57 GB, protože uchovává druhou, clusterovanou kopii každého vektoru plus zhruba 4 MB centroidů. Trvalá velikost v síti SAN je 16.24 GB, což je 18krát více než zdrojový text, a to před operačním prostorem, který Oracle potřebuje kolem sebe: 15 až 23 GB TEMP prostoru během vytváření indexu a 4 až 8 GB pro UNDO a přibližně 15 GB pro REDO během ingestování.

Multiplikátor se škáluje s modelem vkládání: Broadcom extrapoluje ze stejné metody, přičemž 768-dimenzionní model Cohere v3 (také měřený) uvádí 4.8x oproti zdroji, 384-dimenzionní MiniLM 9.6x a 4 096-dimenzionní model Mistral 32.5x. Velikost bloku je stejně důležitá jako šířka, protože široký vektor v dlouhé pasáži zesiluje méně než stejný vektor v krátké pasáži a kvantované indexy zmenšují podíl indexu.
Nic z toho není specifické pro FlashSystem ani pro Oracle. Amplifikace probíhá uvnitř databáze ještě předtím, než pole vidí bajt, a každý vektorový index na každé platformě nese kopii vektorů, takže patří do kapacitního rozpočtu v den schválení vektorového projektu, spolu s GPU. Pole rozhoduje o tom, kolik z tohoto růstu dokáže pojmout: Modul FlashCore páté generace od IBM má kapacitu 105.6 TB na modul, což u největších modelů FlashSystem ukládá do 2U skříně 3.3 PB raw, podle údajů IBM 11.8 PB efektivně, takže vektorová vrstva může růst na místě roky, než se bude muset oddíl přesunout.
Model dimenzování IBM pro následující aplikaci ve zdravotnictví funguje u obrázků opačně: 100 GB rentgenových snímků zabere v databázi zhruba 2 GB, protože se tam nacházejí pouze vložené údaje a metadata případů. Text je nejnáročnější případ: 100 GB rozděleného klinického textu zabírá 860 GB až 1.2 TB, přičemž většina z něj je index HNSW. Vstupem pro dimenzování je počet bloků a šířka modelu; zdrojový korpus je špatným vodítkem. Vložené údaje také komprimují méně než řádků, 1.2x až 2x oproti 2x až 4x pro relační data, jak ukazují zkušenosti IBM, takže redukce dat modulu FlashCore zotavuje menší část nárůstu a každé opětovné vložení potřebuje znovu prostor TEMP.
Praktickým pravidlem společnosti IBM je provést měření před potvrzením (commit). Načtěte 1 až 5 procent reálného korpusu s produkčním modelem vkládání a nastavením chunkingu, změřte skutečný počet bajtů na vektor, poté lineárně škálujte a opakujte cvičení vždy, když se změní model, počet dimenzí nebo zásady chunkingu.
Komplexní inference umělé inteligence: Aplikace ve zdravotnictví
Společnost IBM vytvořila aplikaci pro toto validační testování jako radiologického a gastroenterologického asistenta s názvem RAD-AI. Jedná se o ukázkovou aplikaci s požadavky produkčního stylu a v tomto článku demonstruje kompletní inferenční proces na stejném poli a struktuře, jakou měřily předchozí řezy. Lékař zadá věk, pohlaví a stížnost pacienta, nahraje rentgenový snímek hrudníku nebo endoskopii a obdrží strukturovanou zprávu sestavenou z nejpodobnějších předchozích případů v archivu.
Archiv obsahuje 112 120 rentgenových snímků hrudníku z datové sady NIH ChestX-ray14 a více než 10 000 snímků gastrointestinální endoskopie z HyperKvasiru, včetně vektorů pro jednotlivé snímky z 367 kompletních endoskopických videí, pro více než 172 000 předem vložených případů. Každý snímek se stává 768rozměrným vektorem z modelu CLIP ViT-L/14 běžícího v databázi Oracle AI Database 26ai prostřednictvím běhového prostředí ONNX, takže vložení se provádí ve stejné transakci jako řádek, který je obsahuje. Nezpracované snímky zůstávají v objektovém úložišti; vektory a metadata případů jsou uloženy v Oracle.

V době dotazu spustí Oracle přibližné vyhledávání nejbližšího souseda podle kosinové vzdálenosti v celém archivu a vrátí nejbližší případy spolu s jejich původními nálezy, diagnózami a výsledky. Tato načtená sada představuje kontext pro Llama 3, obsluhovaný systémem Ollama na jednom z grafických procesorů H100 na serveru Supermicro, který zapíše zprávu: klinickou prioritu, shrnutí nálezů, seřazenou diferenciální diagnózu a doporučené akce, přičemž odpovídající případy jsou uvedeny pod ní. Endoskopie sleduje stejnou cestu a přidává klinickou poznámku; u videa systém vkládá záznamy snímek po snímku, aby mohl sledovat lézi podél gastrointestinálního traktu.
Aplikace spouští dvě úlohy na stejných svazcích FlashSystem. Transakční úloha zahrnuje přihlášení, ukládání sestav, protokolování auditu a relace; vektorová úloha provádí náhodné čtení s vysokou rozptylovou aktivitou napříč tabulkami pro vkládání a metadaty případů, což odpovídá profilu generátoru v demonstraci QoS I/O. Nasazení IBM nastavuje omezení svazků popsaná výše tak, aby úloha dávkového opětovného vkládání nemohla zpomalit lékaře vstupujícího do případu, a detekce ransomwaru a migrace oddílů zobrazené výše se na tyto svazky vztahují beze změny.

Náročným krokem je vytvoření archivu, který IBM měřila dvojitým vložením celé sady rentgenových snímků hrudníku o 112 120 snímcích se stejným modelem a stejným cílem VECTOR(768, FLOAT32). S modelem ONNX běžícím v databázi na hostitelských procesorech si kanál udržel rychlost 3.41 snímků za sekundu s časem 0.272 sekundy na vložení a celá sada trvala 9.1 hodiny. Přesun modelu do kontejneru Oracle Private AI Services na druhém serveru zvýšil propustnost na 8.55 snímků za sekundu (0.097 sekundy na snímek) a stejný příjem byl dokončen za 3.6 hodiny.

Předzpracování (přibližně 0.019 sekundy na obrázek) a vkládání Oracle (méně než milisekunda) byly v obou běhech identické, takže 2.5násobný zisk pochází výhradně z místa, kde se model spouští. Služba vkládání Private AI Services běží na běhovém prostředí CPU ONNX, takže H100 na tomto serveru tento test vynechaly; zisk pochází z odebrání modelu z hostitele databáze a podíl GPU na pipeline je v dalším díle sestavování indexu.
Společnost IBM tyto údaje naměřila v coloradské laboratoři; test jsme nespustili ani neauditovali. Praktickým poznatkem je, že první vložení archivu a každé opětovné vložení po změně modelu je dávková úloha měřená v hodinách, zatímco následující načtení je úloha vyžadující procesor a úložiště měřená v milisekundách.
Stejný kontejner také zpracovává konstrukci indexu. Oracle 26ai může odeslat sestavení HNSW do služby Vector Index Service v kontejneru, která používá NVIDIA cuVS na GPU k sestavení grafu sousedů před vrácením hotového indexu do databáze. Vyhledávání se poté provádí bez zapojení GPU. Podle záznamů IBM trvalo základní sestavení HNSW (32 sousedů, efConstruction 200) 8.47 sekundy v databázi a 2.26 sekundy s odlehčením, což je 3.7násobné zkrácení. Toto spuštění použilo malou demonstrační tabulku, takže potvrzuje, že cesta v této konfiguraci funguje; stále musíme změřit číslo v klinickém měřítku.
Aplikace demonstruje dělbu práce, která je jádrem tohoto článku. Server GPU hostuje jazykový model a během sestavování nebo přestavování archivů také služby vkládání a indexování. Databáze ukládá vektory spolu se záznamy, které popisují, zatímco pole a struktura fabric zpracovávají čtení a transakce při vyhledávání. Žádný krok v cestě vyhledávání nepoužívá externí API a data pacientů nikdy neopouštějí datové centrum.
Společnost IBM si pro dokázání tohoto konceptu zvolila jako vertikální odvětví zdravotnictví a nic v tomto vzoru není pro něj specifické. Vyměňte archiv rentgenových snímků za historii pojistných událostí, záznamy o údržbě nebo katalog produktů a zůstanou stejné tři části: vektory uložené vedle záznamů, které popisují, generování na serveru GPU a načítání a transakce na jednom poli. Jakékoli odvětví, které provádí inferenci na základě dat, která již má, přistane na stejné architektuře.
Co přijde dál
Validace pokračuje na stejném hardwaru: Fáze 2 přesouvá mezipaměť KV inferenčního enginu z paměti GPU do FlashSystem přes stejnou síť Fibre Channel, takže model s dlouhým kontextem udržuje větší část své pracovní sady na dosah ruky; další článek v této sérii se touto prací zabývá. IBM také buduje obnovovací kanál s ohledem na obsah, přičemž IBM Storage Scale AFM a Kafka vkládají nové dokumenty do vektorizace ONNX v databázi, jakmile dorazí, takže vektorový index sleduje své zdroje bez dávkového opětovného vkládání. IBM také plánuje rozšířit stejnou validaci úložiště na další multimodelové databáze, které přidaly vektorové vyhledávání.
Fáze 2 také zavádí bezpečnostní vrstvu do práce s novými daty. Když se mezipaměť KV přesune do FlashSystem, pracovní kontext modelu zdravotní péče (včetně historie pacientů) protíná stejné linky Fibre Channel jako vektorový index a transakční záznamy. Emulex SecureHBA šifrují data během přenosu mezi hostitelem a sítí Fabric, zatímco postkvantová kryptografie Brocade Gen 8 pokrývá stranu přepínače. Každá fáze přidává do sítě Fabric pracovní zátěž, aniž by přidávala cestu, kudy data putují volně.
Žebříček: Profil IBM na naší stránce Nejlepší úložná pole nyní zahrnuje blokové úložiště FlashSystem vedle Storage Scale.
Tuto zprávu sponzoruje společnost Broadcom. Veškeré názory a stanoviska vyjádřené v této zprávě vycházejí z našeho nezaujatého pohledu na daný produkt (produkty).



 Amazon