

Cerebras Systems hat offiziell den CS-4 vorgestellt , die vierte Generation seiner Wafer-Scale-KI-Supercomputing-Plattform. Sie ist für anspruchsvolle Trainings- und Inferenz-Workloads mit hoher Parallelität konzipiert. Das System basiert auf drei neu entwickelten Wafer Scale Engine 3 (WSE-3) Turbo-Prozessoren, die in einer von Grund auf neu entwickelten Rack-Scale-Plattform namens Nexus untergebracht sind. Laut Cerebras bietet das System eine bis zu 30-fach höhere Inferenzleistung als GPU-basierte Lösungen. Diese Angabe stützt sich auf den GPT-OSS-120B- Test, bei dem mehr als 4,400 Token pro Sekunde und Benutzer verarbeitet werden können. Zudem bietet das System eine zehnfach höhere Leistung pro Watt im Vergleich zur Vorgängergeneration CS-3.
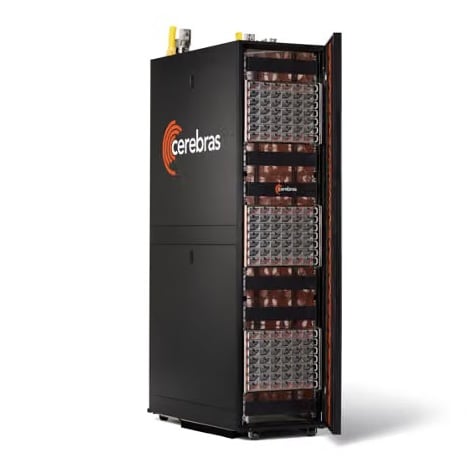
Die CS-4 wurde entwickelt, um die systembedingten Skalierungsbeschränkungen diskreter GPU-Cluster mit mehreren Knoten zu überwinden. Hierbei drosseln häufig die Kommunikation zwischen den Chips, Verluste bei der Stromumwandlung und thermische Grenzwerte die nachhaltige Rechenleistung. Cerebras positioniert die Plattform so, dass sie beide Extreme des Spektrums von Inferenz-Workloads abdeckt: Sie liefert die für komplexe agentenbasierte Workflows und interaktives Schließen erforderlichen Reaktionszeiten im Submillisekundenbereich und bietet gleichzeitig die Gesamtkapazität, die Hyperscaler benötigen, um die Rechendichte pro Gigawatt zu maximieren.
Verbesserungen der Verbindungsarchitektur sind zentral für die Skalierbarkeit der Plattform auf mehrere Prozessoren. Der CS-4 reduziert die Latenz zwischen den Wafern auf bis zu 2 Mikrosekunden und ermöglicht so den Betrieb von Multi-Wafer-Architekturen mit nahezu monolithischer Kohäsion. Dank dieser extrem niedrigen Latenz erreicht der CS-4 Generierungsgeschwindigkeiten von über 1,000 Token pro Sekunde bei Modellen mit mehr als 10 Billionen Parametern. Damit wird die bisherige Leistungslücke geschlossen, in der die Erhöhung der Parameteranzahl die Übertragungsraten interaktiver Token stark beeinträchtigte.

Nexus Rack-Architektur und der Wafer-Scale Backpack
Eine bedeutende technische Neuerung des CS-4 ist die Cerebras Nexus Plattformarchitektur, eine modulare Rack-Implementierung mit unabhängigen Rechen-, Stromversorgungs- und I/O-Domänen. Die Rechenleistung wird durch einen neu entwickelten, rückseitig montierten Wafer-Scale Backpack (WSC) gewährleistet, der vertikal mit dem primären Stromversorgungssystem verbunden ist. Jeder WSC ist eine in sich geschlossene Einheit mit Flüssigkeitskühlung für den Chip, Point-of-Load-Leistungswandlern, Hochgeschwindigkeits-Netzwerkpfaden und integrierter Steuerelektronik direkt hinter dem Siliziumwafer. Durch die Trennung der Rechenkernschicht vom Hauptstromverteilungsrahmen konnte Cerebras die Anzahl der Systemkomponenten um 50 Prozent reduzieren, die automatisierte Montage um 60 Prozent steigern und die Bereitstellungszeit im Rechenzentrum auf wenige Stunden verkürzen.

Die Effizienz der Stromversorgung wurde verbessert, indem die DC/DC-Spannungsreglermodule 100-mal näher an die Siliziumgrenze als bei herkömmlichen Serverplatinen positioniert wurden. Diese Anordnung am Lastpunkt reduziert die Verluste im ohmschen Stromverteilungsnetz (PDN) und ermöglicht es dem Nexus-Gehäuse, jedem WSE-3-Turbo-Prozessor die doppelte Leistung zuzuführen. Dadurch werden höhere, dauerhafte Taktfrequenzen ohne thermische Drosselung erreicht.

Das I/O-Subsystem wurde um ein programmierbares Wafer-I/O-Modul erweitert, das die Bandbreite des gesamten Fabric verdoppelt und gleichzeitig die Übertragungslatenz reduziert. Die Systemvernetzung arbeitet in zwei Modi: Standardmäßige RoCE v2-Schnittstellen (RDMA über konvergiertes Ethernet) für die latenzarme Anbindung an bestehende Unternehmensnetzwerke und Beschleunigerknoten von Drittanbietern sowie proprietäre Direct Wafer Links, die direkte, switchfreie Verbindungspfade zwischen benachbarten Systemen innerhalb und zwischen Racks bereitstellen.
CS-4 und WSE-3 Turbo Spezifikationen
| CS-4-SYSTEM | |
| Architektur | Aktives Stromversorgungs-Rack mit drei modularen Computer-Rucksäcken |
| Wafer Scale Engines | 3x WSE-3 Turbolader pro System |
| KI-Berechnung | 750 PFLOPS* |
| Speicherbandbreite | 129.6 PB/s |
| On-Chip-Fabric-Bandbreite | 160.5 PB/s |
| E/A-Bandbreite | 7.2 Tbit / s |
| E/A-Latenz | 2 µs |
| WSE-3 TURBO (PRO WAFER) | |
| Transistoren / Silizium | 4 Billionen Transistoren; 46,225 mm², TSMC 5 nm |
| KI-Kerne / On-Chip-SRAM | 900,000 Kerne; 44 GB SRAM |
| KI-Berechnung | 250 PFLOPS* |
| Speicherbandbreite | 43.2 PB/s |
| On-Chip-Fabric-Bandbreite | 53.5 PB/s |
| E/A-Bandbreite | 2.4 Tbit / s |
| *KI-Berechnungen werden als spärliche FP16-Werte dargestellt. | |
Disaggregierte Inferenz und Verfügbarkeit
Architektonisch ist der CS-4 mit nativer Unterstützung für disaggregierte Inferenztopologien ausgestattet. In Unternehmens- und Cloud-Umgebungen können Betreiber die Rechenphasen der Inferenz entkoppeln, indem sie spezialisierte externe Prefill-Beschleuniger wie AMD Helios oder AWS Trainium verwenden, um Prompt-Kontexte zu erfassen und Modellzustände zu erstellen. Der rechenintensive KV-Cache wird anschließend über Hochgeschwindigkeitsverbindungen an den massiven SRAM-Speicher des CS-4 weitergeleitet, um eine autoregressive Token-Generierung mit extrem niedriger Latenz zu ermöglichen.
Cerebras bestätigte, dass die ersten Produktionseinsätze und Auslieferungen der CS-4-Plattform in diesem Quartal beginnen sollen.


 Amazon