

CoreWeave hat einen Multi-Rack -NVIDIA-Vera-Rubin-NVL72- Cluster in der CoreWeave Cloud implementiert und Hunderte von Rubin-GPUs zu einer einzigen Scale-Out-Umgebung für agentenbasierte KI-Workloads verbunden. Jedes von Dell gefertigte Rack beherbergt 72 Rubin-GPUs, 36 Vera-CPUs, NVLink 6 als Scale-Up-Fabric, BlueField-4-DPUs und zwei ConnectX-9-SuperNICs pro GPU. Die Racks sind über NVIDIA Spectrum-X Ethernet in einem zweistufigen, nicht-blockierenden Fabric verbunden, das laut CoreWeave auf rund 128,000 GPUs skaliert. CoreWeave ist der erste Cloud-Anbieter, der einen einzelnen Vera-Rubin-NVL72-Cluster validiert und in Betrieb genommen hat und als erster die gemessene Leistung veröffentlicht hat. Die ersten von Experten begutachteten Ergebnisse der Plattform wurden letzte Woche in MLPerf Inference v6.1 veröffentlicht , wobei CoreWeaves eigener Beitrag auf einem GB300 NVL72 lief. Neben der Rechenleistung bietet CoreWeave AI Object Storage auch regionsübergreifende Schreibbeschleunigung und eine neue Archivierungsebene.
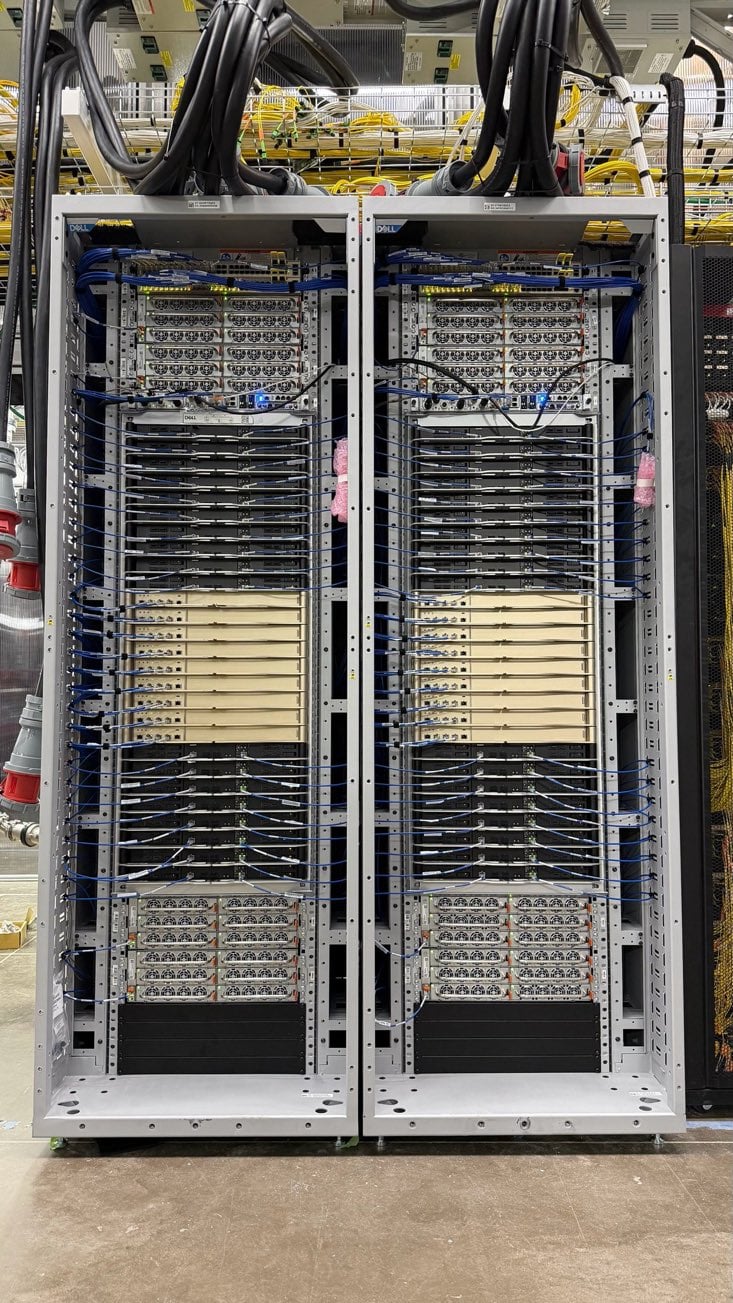
Multi-Rack NVIDIA Vera Rubin NVL72 Architektur
Die Multi-Rack-Architektur zielt auf agentenbasierte Ausführungspfade ab, bei denen serielle Verarbeitungsschleifen und externe Tool-Aufrufe die Datenzugriffslatenz in verteilten Infrastrukturen erhöhen. Die beiden ConnectX-9 SuperNICs jeder Rubin-GPU bieten bis zu 1.6 Tbit/s Backend-Netzwerkkonnektivität pro GPU über Multi-Rail- und Multi-Plane-Pfade. CoreWeave beschreibt die Architektur als modular, sodass zusätzliche NVL72-Racks bei wachsender Kapazität in dieselbe nicht-blockierende Topologie integriert werden können. Die Racks werden mit Flüssigkeitskühlung bei 45 °C betrieben.
CoreWeave verbindet die Racks über seine Mission Control-Software. Ein Rack LifeCycle Controller übernimmt die Bereitstellung und den Lebenszyklus jedes Racks, die Hardwareerkennung durch Firmware-Updates, Validierung sowie die Steuerung von Stromversorgung und Wärmeableitung. Eine Rack-Management-Schicht namens Racky steuert Stromversorgung und Infrastruktur. Ein programmierbarer Kühlungs-Controller namens Valvey ermöglicht die softwaredefinierte Überwachung und Steuerung der Flüssigkeitskühlkreisläufe und Umweltsensoren.
Die Racks erreichen den Produktivbetrieb erst nach einer mehrstufigen Validierungsphase. Auf Knotenebene bedeutet dies stundenlange, wiederholte GPU-Diagnosen, CPU-zu-GPU-Übertragungsprüfungen, Verbindungs- und Wärmevalidierung unter Last sowie realistische Trainingsläufe. Auf Rack-Ebene überprüfen synchronisierte Prozesse auf allen 72 GPUs die NVLink-GPU-zu-GPU-Leistung. Systeme, deren Leistung unterhalb des erwarteten Bereichs liegt, werden einer Fehlerbehebung unterzogen. Rackübergreifend führt CoreWeave verteilte Workloads aus, deaktiviert gezielt die NVLink-Pfade, um den Datenverkehr über das Backend-Netzwerk zu leiten, und überwacht die physische Infrastruktur auf instabile Verbindungen, steigende Fehlerraten, überhitzte Hardware und ungleichmäßigen Datenverkehr. Die Lastmuster simulieren dabei agentenbasierte Anwendungen: plötzliche Nachfragespitzen, wechselnde Parallelität und Kommunikationsspitzen. CoreWeaves Dokumentation zur Inbetriebnahme mehrerer Racks beschreibt jede Phase detailliert und ist eine interessante Lektüre.
Aktualisierungen für KI-Objektspeicher: Regionsübergreifende Schreibvorgänge und Archivierungsebene
Die Speicherlösung basiert auf CoreWeave AI Object Storage und dessen Local Object Transport Accelerator (LOTA), einem Caching-Proxy, der auf jedem GPU- und CPU-Knoten im CoreWeave Kubernetes Service ausgeführt wird und Objekte auf lokalem NVMe-Speicher speichert. CoreWeave berichtet von Lesegeschwindigkeiten von bis zu 7 GB/s pro GPU und p99-Leselatenz, die mehr als achtmal niedriger ist als beim Lesen aus dem Bucket. Ein führender Anbieter setzt LOTA auf über 15,000 GPUs und 20 PB Cache mit einer Trefferrate von 99.7 Prozent ein. LOTA ist kostenlos.
Die regionsübergreifende Schreibbeschleunigung ermöglicht es einer Anwendung, ohne API- oder SDK-Änderungen mit lokaler Latenz in einen Bucket in einer entfernten Region zu schreiben. Die Anwendung sendet einen standardmäßigen S3-Schreibvorgang an den LOTA-Endpunkt. Die Objektdaten werden dauerhaft in der lokalen Region gespeichert, während die Metadaten in der entfernten Region gespeichert werden. Das Objekt ist sofort lesbar, auch für den Job, der es geschrieben hat. Die Datenmigration in die entfernte Region erfolgt im Hintergrund. Anwendungen sehen regionsübergreifend einen einzigen Bucket-Namespace mit einheitlichen IAM-Richtlinien, Lebenszyklusregeln und Zugriffskontrollen. Dadurch entfallen die regionsspezifischen Forks und Replikationspipelines, die für die Checkpoint-Verteilung über verschiedene Standorte hinweg üblicherweise erforderlich sind.
„Unsere Datensätze erstrecken sich über mehrere Regionen, und wir können es uns nicht leisten, dass unser Trainingsplan durch regionsübergreifende Abrufverzögerungen diktiert wird“, sagte Cécile Robert-Michon, Leiterin der internen Infrastruktur bei Cohere. „CoreWeave AI Object Storage bietet uns eine einheitliche Datensatzstruktur über alle Regionen hinweg, wobei Lesevorgänge lokal zwischengespeichert werden, sodass keine Wartezeiten im Netzwerk entstehen.“
Die Archiv-Ebene ist neben Hot, Warm und Cold die vierte Speicherklasse und wurde für Daten entwickelt, die nur einmal geschrieben und selten gelesen werden, wie z. B. ältere Trainings-Checkpoints und Rohdatensätze. Sie bietet niedrigere Preise für die Basiskapazität und verzichtet auf Gebühren für Abruf, Cache, Anfragen, vorzeitiges Löschen, Tiering und ausgehenden Datenverkehr. CoreWeave empfiehlt, aktuelle Checkpoints in den schnelleren Ebenen zu speichern, um sofortige Neustarts zu ermöglichen, und sie nach 60 Tagen ohne Lesezugriff automatisch in die Archiv-Ebene zu verschieben. Sowohl regionsübergreifende Schreibvorgänge als auch die Archiv-Ebene sind ab sofort verfügbar; Konfigurationsdetails finden Sie im CoreWeave- Beitrag zum Thema Speicher .


 Amazon