

Auf dem RAISE Summit in Paris hob DDN seine laufende Zusammenarbeit mit Nebul hervor, einem europäischen Anbieter von souveränen Hybrid-Cloud-Lösungen. Im Fokus steht die Effizienzsteigerung bei groß angelegten KI-Inferenz-Implementierungen. Die vergangene Woche angekündigte Initiative kombiniert Nebuls Inferenzplattform, DDNs Infinia-Datenarchitektur und NVIDIA-Beschleunigungstechnologie, um eine zunehmende Herausforderung im produktiven KI-Einsatz zu bewältigen: die Kosten- und Leistungseinbußen durch Datenübertragung während der Inferenz.
DDN orientiert sich an zentralen Produktionskennzahlen wie GPU-Auslastung, Token-Durchsatz, Kosten pro Token und Latenz. Die Annahme ist, dass das Modelltraining den Wert eines KI-Assets bestimmt, während die Inferenz dessen operative und kommerzielle Rentabilität festlegt. Da agentenbasierte KI, abrufgestützte Generierung und hochgradig parallele Inferenz immer häufiger eingesetzt werden, können Speicher- und Dateninfrastruktur die Beschleunigerauslastung und Reaktionszeit direkt beeinflussen.
Die Arbeit ist ein laufendes Proof-of-Concept-Projekt, und DDN charakterisiert die bisherigen Ergebnisse als vielversprechende erste Daten. Die Unternehmen berichten von messbaren Verbesserungen der Zeit bis zum ersten Token mit aktiviertem KV-Cache und haben die RoCE-basierte Infrastrukturvalidierung abgeschlossen. Die Benchmark-Tests werden mit längeren Inferenzsequenzen fortgesetzt, um weitere Optimierungsmöglichkeiten innerhalb der Infinia-Plattform zu identifizieren. Das Projekt wurde zudem um eine Zusammenarbeit mit NVIDIA bei Benchmark-Methoden, Skalierbarkeitsvalidierung und zukünftigen technischen Publikationen erweitert.
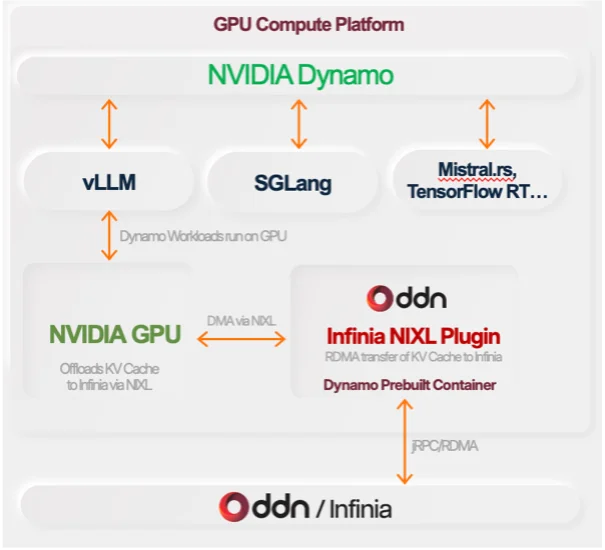
Die Plattform nutzt verteilte KV-Cache-Dienste, GPU-native Datenübertragung, Datenorchestrierung und Hochleistungsspeicherarchitekturen. Die KV-Cache-Beschleunigung ist insbesondere für Inferenzprozesse relevant, da sie zuvor berechnete Aufmerksamkeitszustände speichert und schnell wieder abruft. Dadurch werden wiederholte Berechnungen reduziert und Verzögerungen bei der Datenübertragung minimiert, die GPUs im Leerlauf halten könnten.
Die Führungsrolle von DDN, Nebul und NVIDIA signalisierte einen grundlegenden Branchenwandel: von der GPU-Beschaffung hin zu operativer Effizienz mit Fokus auf die Wertmaximierung der eingesetzten Beschleuniger. DDN-CEO Alex Bouzari und Nebul-CEO Arnold Juffer betonten, dass die Modellskalierung zwar historisch Priorität hatte, die aktuelle Herausforderung jedoch in der Wirtschaftlichkeit der Inferenz und der kommerziellen Rentabilität von KI in der Produktion durch niedrigere Token-Kosten liegt. Rod Evans, Vice President Cloud Infrastructure bei NVIDIA, ergänzte, dass der Erfolg der Infrastruktur bei Unternehmen, die sich zunehmend auf umfangreiche agentenbasierte Workloads konzentrieren, immer stärker an der GPU-Auslastung und Latenz als an der reinen Rechenkapazität gemessen wird.
DDN argumentiert, dass sich die KI-Infrastruktur über herkömmliche Speicheroperationen hinaus weiterentwickeln und aktiv an der KI-Ausführung beteiligt werden muss. Das Unternehmen gibt an, dass seine Plattformen weltweit mehr als eine Million GPUs unterstützen und von Hyperscalern, Cloud-Anbietern, Unternehmen, Regierungen und Forschungseinrichtungen genutzt werden.
Für Infrastrukturteams umfassen die relevanten Produktionskennzahlen zunehmend Folgendes:
- GPU-Auslastung, wobei gemessen wird, wie effektiv teure Beschleuniger während der Inferenz aktiv bleiben.
- Kosten pro Token, wodurch die Effizienz der Infrastruktur mit den Kosten der Modellausgabe verknüpft wird.
- Token pro Watt, Messung der Ausgangseffizienz im Verhältnis zum Stromverbrauch.
- Zeit bis zum ersten Token, was die wahrgenommene Reaktionsfähigkeit interaktiver KI-Anwendungen beeinflusst.
- Die Produktionszeit spiegelt den operativen Aufwand wider, der erforderlich ist, um KI-Dienste von der Testphase in die Produktionsphase zu überführen. Skalierbare Bereitstellung.
Da Inferenzprozesse zur dominierenden KI-Arbeitslast werden, wird die Fähigkeit, zwischengespeicherte Kontext- und Unternehmensdaten mit geringer, vorhersehbarer Latenz an GPUs zu liefern, zunehmend wichtig sein, um die Auslastung aufrechtzuerhalten und die Kosten zu kontrollieren.


 Amazon