

WhiteFiber hat erste Forschungs- und Entwicklungsergebnisse für das Projekt Redwood veröffentlicht, eine verteilte GPU-Supercluster-Architektur, die für den Betrieb über geografisch getrennte Rechenzentren hinweg konzipiert ist. Der vergangene Woche angekündigte Test erreichte einen Durchsatz von 111.2 Tbit/s über 83 km ungenutzte Glasfaserleitungen mit einer garantierten Round-Trip-Latenz von 0.9 ms.
WhiteFiber gab an, die Latenz liege innerhalb von 8 % der physikalischen Ausbreitungsgrenze für Licht in Glasfasern über diese Distanz. Das Unternehmen nutzte im Test nur einen Teil des verfügbaren Faserspektrums. Laut WhiteFiber entspricht dies bereits etwa der doppelten Kapazität vergleichbarer, veröffentlichter Feldversuche mit dem gesamten Spektrum. WhiteFiber plant, das gesamte Spektrum vor der angestrebten Markteinführung im dritten Quartal 2026 zu nutzen.
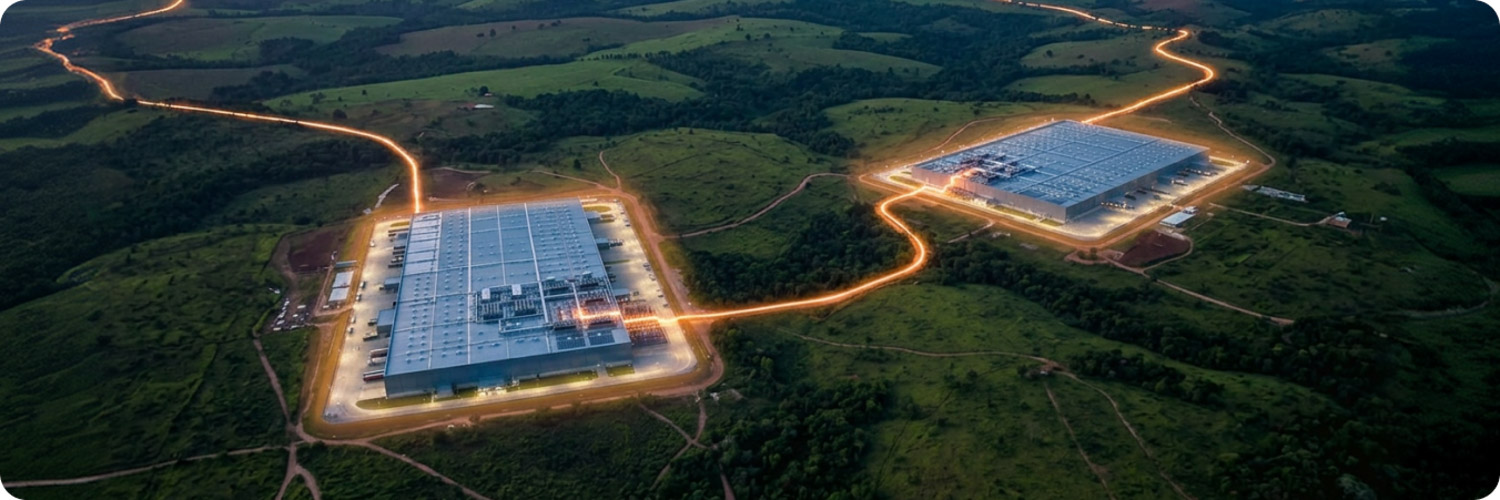
Die Arbeiten wurden in Zusammenarbeit mit DriveNets und WEKA abgeschlossen. DriveNets stellt die Ethernet-basierte KI-Infrastruktur zwischen den Standorten bereit, während WEKA NeuralMesh die Speicher- und Arbeitsspeicherinfrastruktur des Clusters liefert. WhiteFiber hat Patentanmeldungen im Zusammenhang mit der Implementierung eingereicht.
Behandlung mehrerer Standorte als ein GPU-Cluster
Die Architektur ist so konzipiert, dass zwei Rechenzentren als ein logischer GPU-Supercluster fungieren, anstatt als zwei unabhängig voneinander betriebene Cluster, die über eine herkömmliche DCI-Verbindung verbunden sind. Diese Unterscheidung ist wichtig für KI-Trainings- und Inferenz-Workloads, da die GPU-zu-GPU-Synchronisierung, kollektive Operationen und der Zugriff auf eine gemeinsame Dateninfrastruktur die nutzbare Clustergröße bestimmen können.
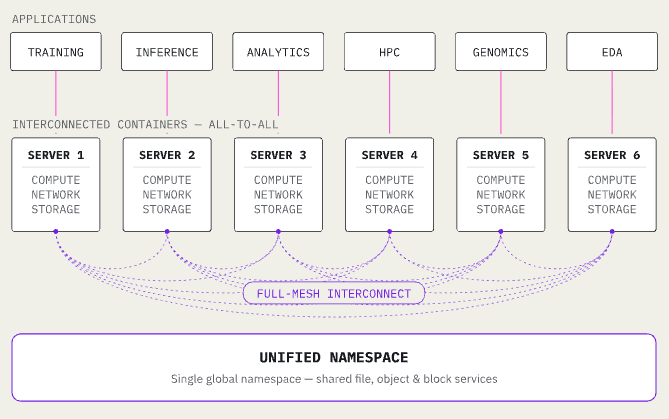
WhiteFiber positioniert die Plattform für Workloads, die die verfügbaren Kapazitäten eines einzelnen Standorts hinsichtlich Stromversorgung, Kühlung, Platzbedarf, Ausfallsicherheit oder Datensouveränität übersteigen. Das Unternehmen sieht zudem Anwendungsbereiche in den Bereichen Edge Computing, Telekommunikation und KI-gestützte Systeme mit Datensouveränität.
Die begleitende Ankündigung von DriveNets beschreibt die Hardware: Das Netzwerk verbindet zwei WhiteFiber NVIDIA H200 GPU-Cluster, die 52 Kilometer voneinander entfernt liegen. DriveNets bezeichnet die Implementierung als branchenweit ersten kommerziellen KI-Supercluster mit großer Reichweite, der im Produktionsmaßstab und nicht im Labor validiert wurde. Im Rahmen der Validierung verglichen die Unternehmen die Rack-zu-Rack-Performance an einem Standort mit der Rack-zu-Rack-Performance über beide Standorte hinweg. Die Methodik wird im Whitepaper von DriveNets detailliert beschrieben.
DriveNets Stoffdesign
Die standortübergreifende Umgebung nutzt redundante Glasfaserleitungen und DriveNets AI Fabric für den GPU- und Speicherdatenverkehr. DriveNets beschreibt die Architektur als ein zeitgesteuertes Ethernet-Fabric, das für vorhersagbare verteilte KI-Kommunikation entwickelt wurde, und nicht als herkömmliche Ethernet-Erweiterung für große Entfernungen.
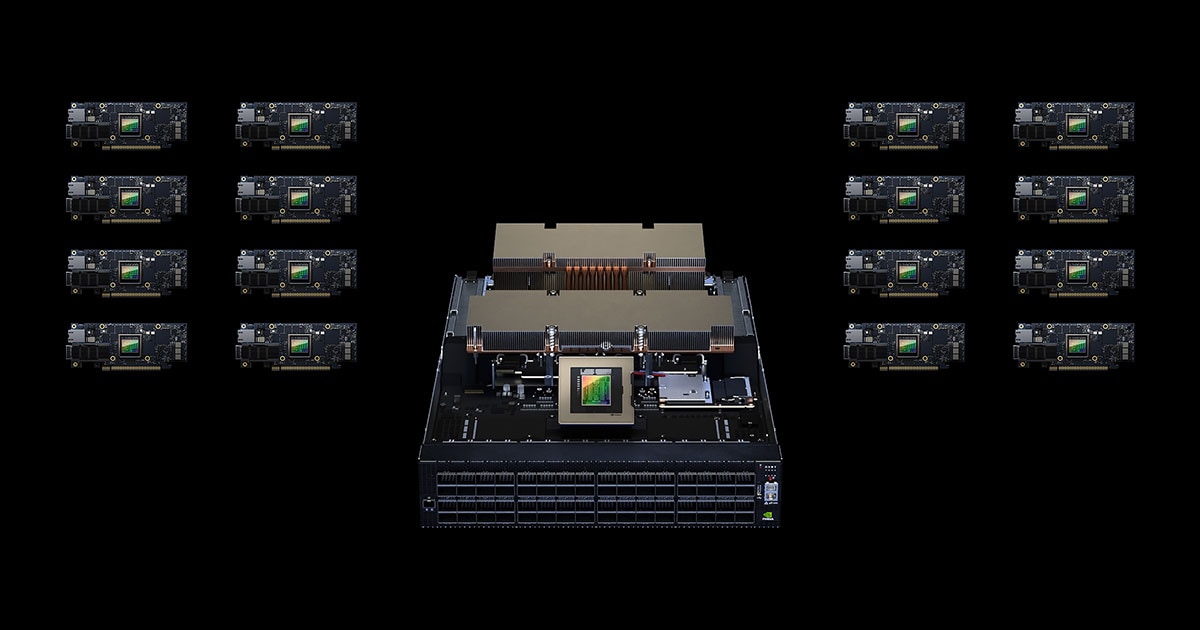
Das Design erweitert die KI-Infrastruktur standortübergreifend mithilfe der Fabric Scheduled Ethernet-Technologie von DriveNets, die auf den Switches 9300F, 5300R und 5301R zum Einsatz kommt. Der Ansatz kombiniert zellenbasiertes Load Balancing, durchgängiges Virtual Output Queuing und Deep-Buffer-Verbindungen, die synchronisierte KI-Datenverkehrsspitzen abfangen, bevor diese zu Engpässen in den Verbindungen zwischen den Standorten führen. Laut DriveNets resultiert dies in einer vorhersehbaren, verlustfreien Konnektivität zwischen den Standorten, die eine hohe GPU-Auslastung gewährleistet – so, als befände sich der gesamte Cluster an einem Ort.
Zusammen zielen diese Mechanismen darauf ab, ein vorhersehbares Verhalten bei der kollektiven Kommunikation über größere Entfernungen zu gewährleisten und gleichzeitig eine einheitliche Rechen- und Speicherinfrastruktur zu unterstützen. Die Mandantenfähigkeit ist Teil des formulierten Designziels.
Das Ergebnis ist eine Architektur, die die Glasfaserstrecke als Teil einer KI-Infrastruktur betrachtet und nicht nur als Transportverbindung zwischen Standorten. Ziel ist es, die operative Bedeutung der physischen Rechenzentrumsgrenze für Workloads, die im gesamten Cluster ausgeführt werden, zu reduzieren.
Ein eigenständiger Ansatz von NVIDIA Spectrum-XGS
Die Testplattform von WhiteFiber unterscheidet sich von NVIDIA Spectrum-XGS Ethernet. Die Arbeit steht jedoch im Einklang mit dem branchenweiten Bestreben nach einer skalierbaren KI-Infrastruktur.
Auf der Hot Chips 2025 beschrieb NVIDIA-CEO Jensen Huang die Notwendigkeit, Rechenzentren über Städte, Länder und Kontinente hinweg zu vernetzen, um großflächige KI-Fabriken zu schaffen. NVIDIAs Spectrum-XGS-Ansatz nutzt distanzabhängige Staukontrolle, präzises Latenzmanagement und Telemetrie, um die Vorhersagbarkeit der verteilten GPU-Kommunikation zu verbessern. CoreWeave gehört zu den von NVIDIA genannten Pionieren.
WhiteFiber hat im Vergleich zu NVIDIA, das die Ergebnisse von Spectrum-XGS-Implementierungen öffentlich bekannt gegeben hat, detailliertere Messergebnisse aus frühen Feldtests geliefert. Der Test über 83 km ergab eine Datenrate von 111.2 Tbit/s und eine Roundtrip-Latenz von 0.9 ms. Da die Systeme jedoch unterschiedliche Architekturen verwenden, sind die Ergebnisse nicht direkt vergleichbar.
Dezentrales Training geht über eine einzelne Einrichtung hinaus
Die Ankündigung von WhiteFiber erfolgt zu einem Zeitpunkt, an dem andere Cloud- und Infrastrukturanbieter Architekturen für KI-Training und -Inferenz an mehreren Standorten untersuchen.
Oracle Cloud Infrastructure und NVIDIA haben eine Studie veröffentlicht, die das NeMo-Framework und Megatron-Core für das Training von LLM-Modellen über einen Abstand von ca. 1,000 km zwischen Rechenzentren nutzt. NVIDIA berichtete von einer Trainingsskalierbarkeit von über 96 % durch hierarchische All-Reduce- und Chunked-basierte Kommunikation zwischen den Rechenzentren. Diese Studie dient primär der Software- und Systemdemonstration und ist kein Benchmark für den Transport im Metropolenmaßstab.
Google hat außerdem TPU Multislice entwickelt, wodurch mehrere TPU-Slices als größere, verteilte Trainingsumgebung über das Rechenzentrumsnetzwerk und die optischen Verbindungen von Google betrieben werden können. Laut Google nutzte das Gemini-Training mehrere Rechenzentren, wobei die Plattform für die Verwaltung der Workload-Partitionierung und die Gewährleistung der Ausfallsicherheit in großem Umfang ausgelegt ist.
WhiteFiber verfolgt das Ziel, ein ähnliches standortübergreifendes Design für GPU-Cloud-Infrastrukturen zu entwickeln, mit einem besonderen Fokus auf Metro-Konnektivität mit hoher Bandbreite und geringer Latenz. Das Unternehmen plant, weitere Details zur Architektur und Verfügbarkeit im Zuge der kommerziellen Einführung im dritten Quartal 2026 bekannt zu geben.


 Amazon