

Google hat mit Google Cloud Dataproc eine weitere neue Cloud-Technologie für seine Cloud-Plattform angekündigt. Diese Technologie vereinfacht die Bereitstellung und Verwaltung von Hadoop und Spark innerhalb der Google Cloud Platform. Ähnlich wie die kürzlich angekündigten Technologien von Dell und Cloudera ermöglicht auch diese Technologie die Nutzung von Hadoop ohne die damit verbundenen hohen Schulungskosten.
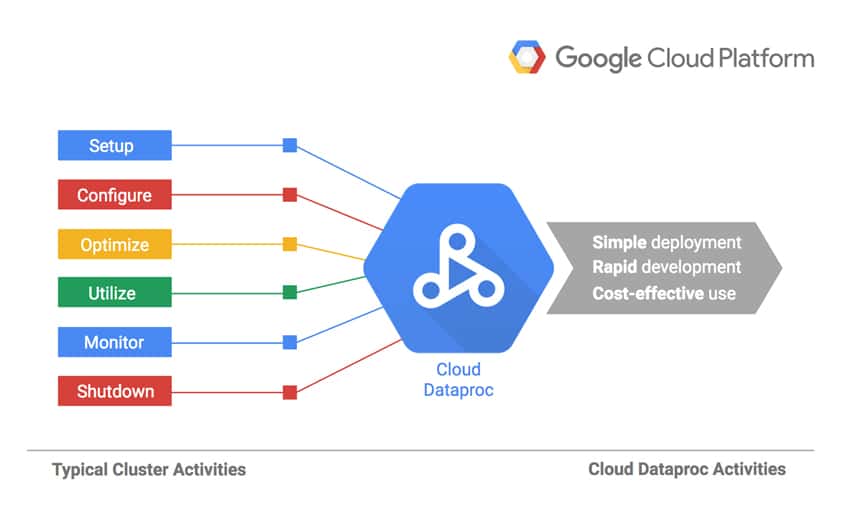
Da Datensätze immer größer und komplexer werden, werden leistungsfähigere Tools zur Analyse dieser Datensätze benötigt. Obwohl die Tools vorhanden sind, erhöhen sie oft die Komplexität und es kann kostspielig sein, Administratoren in neuen Technologien zu schulen oder Berater hinzuzuziehen. Google führt Dataproc ein, einen automatischen und verwalteten Dienst für Hadoop und Spark. Mit Dataproc können Benutzer die Vorteile von Open-Source-Datentools für Stapelverarbeitung, Abfragen, Streaming und maschinelles Lernen nutzen und gleichzeitig die Automatisierung zum schnellen Erstellen und Verwalten von Clustern nutzen. Dataproc ermöglicht außerdem das Abschalten von Clustern, wenn sie nicht verwendet werden, wodurch Kosten gespart werden, da die Abrechnung minutenweise erfolgt.
Die Vorteile umfassen:
- Der Preis für Cloud Dataproc beträgt nur 1 Cent pro virtueller CPU im Cluster eines Kunden und Stunde, zusätzlich zu den anderen genutzten Cloud Platform-Ressourcen. Cloud Dataproc-Cluster können präemptive Instanzen mit niedrigeren Rechenpreisen umfassen, wodurch die Kosten weiter gesenkt werden. Anstatt die Nutzung auf die nächste Stunde aufzurunden, berechnet Cloud Dataproc den Kunden nur die tatsächliche Nutzung mit einer minutengenauen Abrechnung und einem Abrechnungszeitraum von mindestens zehn Minuten.
- Ohne Dataproc kann die Erstellung von Spark- und Hadoop-Clustern vor Ort oder über IaaS-Anbieter zwischen 5 und 30 Minuten dauern. Im Vergleich dazu lassen sich Cloud Dataproc-Cluster schnell starten, skalieren und herunterfahren, wobei jeder dieser Vorgänge im Durchschnitt 90 Sekunden oder weniger dauert. Dies bedeutet, dass Benutzer weniger Zeit mit dem Warten auf Cluster verbringen müssen und mehr Zeit für die praktische Arbeit mit ihren Daten haben.
- Cloud Dataproc verfügt über eine integrierte Integration mit anderen Google Cloud Platform-Diensten, z BigQuery, Cloud-Speicher, Cloud-Bigtable, Cloud Logging und Cloud Monitoring, sodass Kunden mehr als nur einen Spark- oder Hadoop-Cluster haben – sie verfügen über eine vollständige Datenplattform. Sie können beispielsweise Cloud Dataproc verwenden, um mühelos Terabytes an Rohprotokolldaten per ETL direkt in BigQuery für Geschäftsberichte zu übertragen.
- Kunden können über die Google Developers Console, das Google Cloud SDK oder die Cloud Dataproc REST API problemlos mit Clustern und Spark- oder Hadoop-Jobs interagieren. Wenn sie mit einem Cluster fertig sind, können sie ihn einfach ausschalten, damit kein Geld für einen ungenutzten Cluster verschwendet wird. Sie müssen sich keine Sorgen über Datenverluste machen, da Cloud Dataproc in Cloud Storage, BigQuery und Cloud Bigtable integriert ist.
- Für die Verwendung von Cloud Dataproc ist es nicht erforderlich, neue Tools oder APIs zu erlernen, sodass bestehende Projekte problemlos und ohne Neuentwicklung in Cloud Dataproc verschoben werden können. Spark, Hadoop, Pig und Hive werden regelmäßig aktualisiert, sodass Benutzer schneller produktiv sein können.
Verfügbarkeit und Preisgestaltung
Google Cloud Dataproc ist jetzt als Beta-Dienst verfügbar und beginnt bei 0.01 $ pro virtueller CPU.


 Amazon