

Google hat seine TPU-Produktpalette der achten Generation um zwei Systeme erweitert: TPU 8tx, ein auf TPU 8t-Silizium basierendes System für vertrauliches Rechnen, und TPU 8i Max, das zwei TPU 8i-Chips in einem einzigen Gehäuse für Inferenz über lange Kontexte vereint. Sie ergänzen den TPU 8t-Trainingschip und den TPU 8i-Inferenzchip, die Google im April auf der Cloud Next vorgestellt hat. Laut Google ist dies das erste Mal, dass das Unternehmen vier TPU-Systeme innerhalb eines Jahres präsentiert.
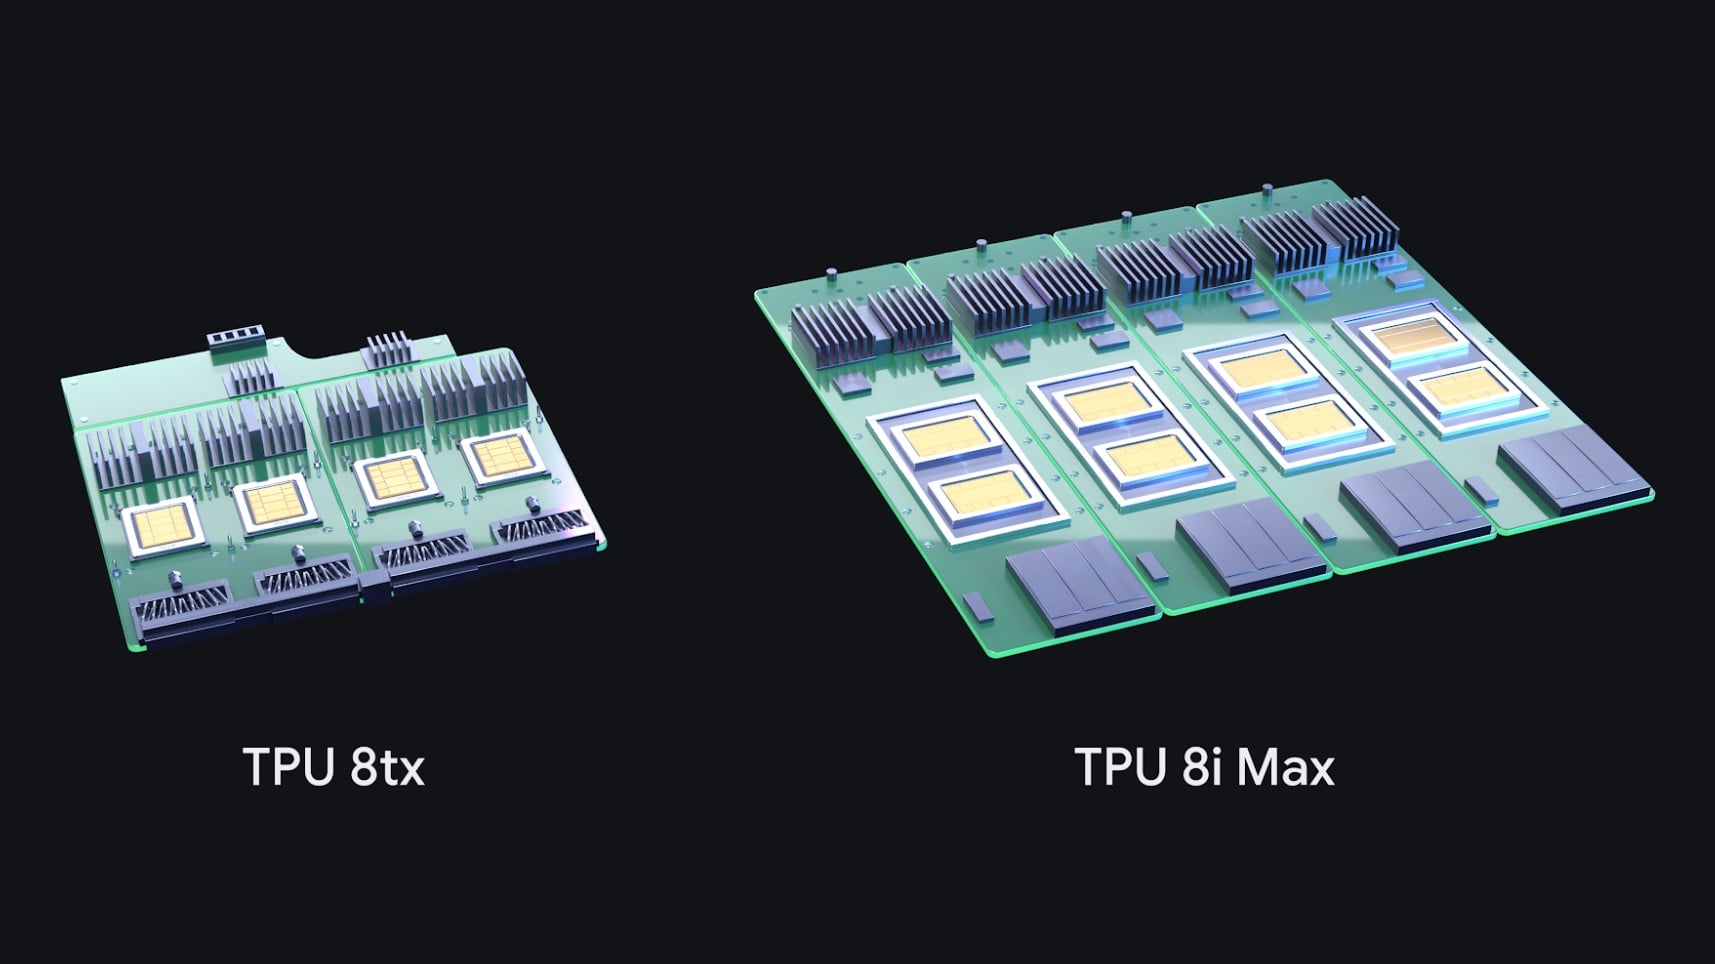
Google beschreibt die beiden Neuerungen als Systeme, die auf bestehenden Chips basieren. Dabei werden Gehäuse, Hochgeschwindigkeitsspeicher, Netzwerkfunktionen und Sicherheitsarchitektur an die jeweilige Arbeitslast angepasst. Google hebt diesen modularen Ansatz hervor, der die Bereitstellung spezialisierter Konfigurationen innerhalb weniger Monate ermöglicht. TPUs haben laut Google mittlerweile fast 100 Kunden, darunter Forschungseinrichtungen, Handelsunternehmen, Einzelhändler und Universitäten. Einige Kunden können TPUs nun direkt in ihren Rechenzentren einsetzen.
TPU 8tx: Vertrauliche Datenverarbeitung auf TPU 8t Silizium
TPU 8tx nutzt denselben Siliziumchip wie TPU 8t, kombiniert ihn mit AMD EPYC-Hostprozessoren der 5. Generation und integriert vertrauliches Rechnen in die Hardware, sodass Daten und Modellgewichte während der Nutzung geschützt und isoliert bleiben. Google nennt PCIe-Link-Verschlüsselung, kryptografische Attestierung und sichere Speicherbereiche als Sicherheitsfunktionen und richtet sich mit dem System an regulierte Unternehmen und Regierungen, die innovative oder proprietäre Modelle und Agenten zusammen mit sensiblen Daten betreiben.

TPU 8tx nutzt außerdem das latenzarme Boardfly-Netzwerk, das Google für TPU 8i entwickelt hat. Laut Google bietet es eine bis zu 2-fach geringere Latenz als TPU 8t bei nahezu null Leistungseinbußen. Google positioniert es für sichere Inferenz und Training in kleinem Umfang, sodass Teams mit privaten Daten feinabstimmen, große Modelle verkleinern und Agenten mittels Reinforcement Learning trainieren können, ohne sensible Daten zwischen verschiedenen Clustern verschieben zu müssen.
TPU 8i Max: Zwei Inferenzchips pro Paket
TPU 8i Max zielt auf Speicherbandbreite für Workloads ab, wie beispielsweise Dutzende von Agenten, die auf einer gesamten Codebasis arbeiten, oder stundenlange Videowiedergabe. Google kombinierte zwei TPU 8i-Chips in einem Gehäuse und verdoppelte so Rechenleistung, On-Chip-SRAM und HBM-Bandbreite gegenüber TPU 8i. Google gab bei Markteinführung 384 MB SRAM für TPU 8i an, die Verdopplung ergibt 768 MB pro 8i Max-Gehäuse. Die HBM-Kapazität des Gehäuses wurde von Google nicht angegeben. Da 8i Max die doppelte Siliziummenge auf der bisherigen Rack-Grundfläche unterbringt, bietet es laut Google mehr Rechenleistung pro Quadratmeter und pro Watt.

Google ordnet die vier Systeme der achten Generation nun verschiedenen Arbeitsstufen der Agenten zu: TPU 8t für Scale-up-Training, TPU 8i für latenzarmes Reasoning, TPU 8tx für vertrauliches Computing und TPU 8i Max für massive Kontextfenster und höchste Rechenleistung pro Rack. Google hat weder bekannt gegeben, wann TPU 8tx und TPU 8i Max für Google Cloud-Kunden verfügbar sein werden, noch die Preise für die Systeme veröffentlicht.

TPU Sync, Cloud Pathways und GKE Dynamic Slicing
Google hat außerdem TPU Sync als Open Source veröffentlicht, eine C++-Bibliothek, die Chip-HBM, Host-DRAM, gemeinsam genutzten Speicher und das Rechenzentrumsnetzwerk als eine einzige Speicherhierarchie behandelt. Sie lagert KV-Caches vom Chip aus, streamt Kontext von Prefill-Knoten zu Dekodierungsknoten und synchronisiert die Gewichte für Reinforcement Learning von Trainern zu Samplern. Laut Google reduziert TPU Sync die KV-Transferlatenz um mehr als 90 Prozent und die Zeit bis zum ersten Token um durchschnittlich 90 Prozent bei Open-Weight-Mixture-of-Experts-Modellen mit 235 bis 480 Milliarden Parametern.
Cloud Pathways, die Google DeepMind-Laufzeitumgebung hinter Gemini, ist jetzt allgemein auf Google Kubernetes Engine verfügbar. Sie verwendet einen einzigen Controller, um TPU-Systeme über mehrere Slices hinweg für Vortraining, Reinforcement Learning und Multihost-Inferenz zu orchestrieren und gewährleistet den Betrieb langlaufender Jobs auch bei Hardwareausfällen durch Hot-Swapping von Slices im Subminutenbereich und elastisches Resharding.
Das ebenfalls allgemein verfügbare dynamische Slicing von GKE nutzt optische Schaltungsschaltungen, um TPU-Cubes zu größeren Topologien zusammenzusetzen oder in kleinere, isolierte Workloads aufzuteilen, ohne Knotenpools neu erstellen zu müssen. Laut Google verkürzt dies die Startzeiten von Jobs um bis zu 5x und beschleunigt die Fehlerbehebung um bis zu 4.5x. Eine TPU-Agentensuite in der Vorschauphase lässt sich in Codierungswerkzeuge wie Claude Code, Cursor und Google Antigravity integrieren, um Workloads einzubinden, Engpässe zu diagnostizieren und Kernel automatisch zu optimieren. Die neue Open-Source-XLA-Serving-Engine stellt Python-trainierte Modelle aus einer C++-Laufzeitumgebung auf TPUs, GPUs und CPUs bereit.


 Amazon