

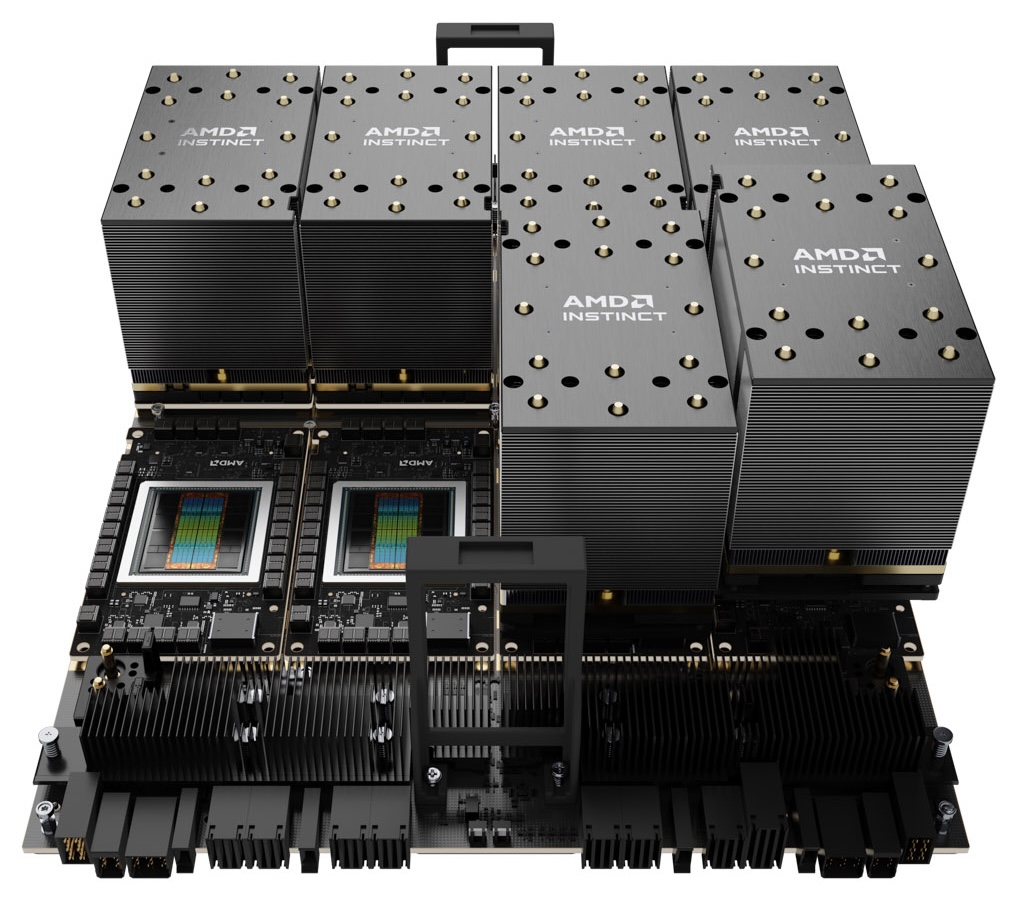
IBM und AMD haben eine mehrjährige Kooperation vereinbart, um Zyphra, einem in San Francisco ansässigen Unternehmen für Open-Source-KI-Forschung und -Produktentwicklung, eine fortschrittliche KI-Infrastruktur bereitzustellen. Im Rahmen der Vereinbarung wird IBM einen großen, dedizierten Cluster von AMD Instinct MI300X GPUs in der IBM Cloud für das Training zukunftsweisender multimodaler Grundlagenmodelle bereitstellen. Damit zählt die Implementierung zu den ambitioniertesten Trainingsumgebungen für generative KI, die derzeit verfügbar sind.
Zusammenarbeit als Impulsgeber
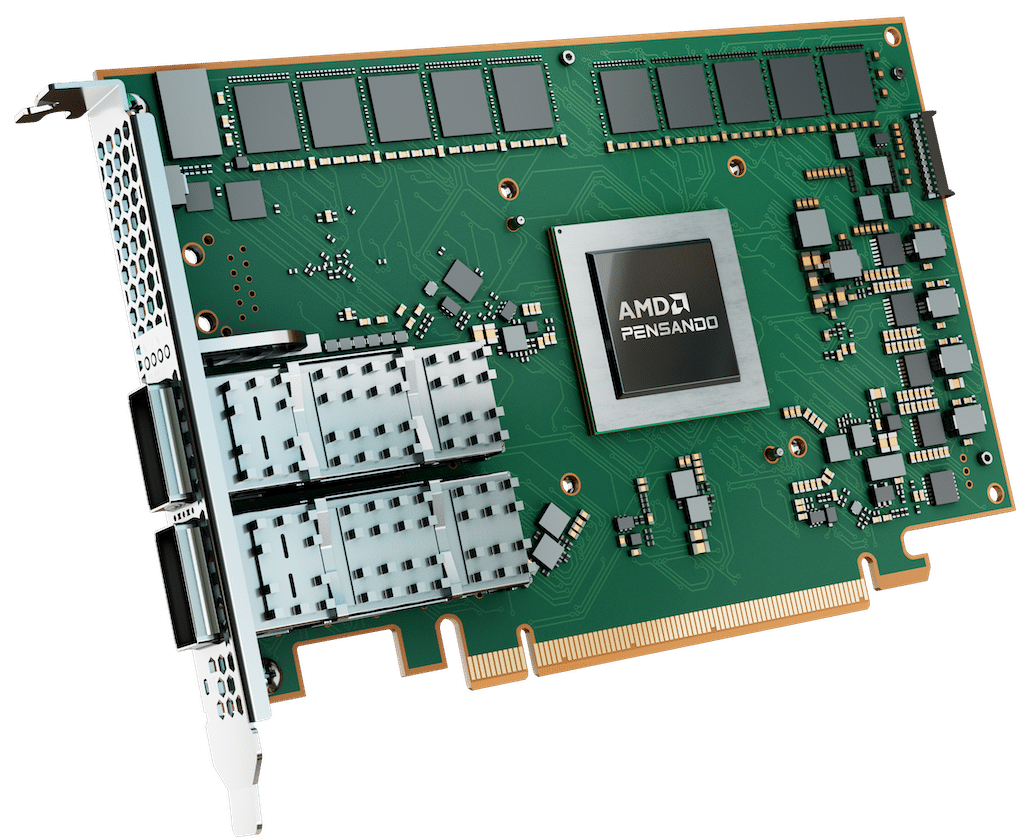
Ein entscheidender Aspekt dieser Zusammenarbeit ist die Skalierung der öffentlichen Cloud-GPU-Infrastruktur auf Unternehmensebene. Diese Initiative stellt den ersten großflächigen, dedizierten Trainingscluster in der IBM Cloud mit AMD Instinct MI300X GPUs dar. Die Integration von AMD Pensando Pollara 400 AI NICs und Pensando Ortano DPUs erweitert die Leistungsfähigkeit zusätzlich durch ein Netzwerk, das für Trainingsworkloads mit hohem Durchsatz optimiert ist und Datenbeschleunigung sowie effiziente Ost-West-Netzwerkverbindungen bietet. Für IT-Administratoren und CTOs zeigt dieses Setup einen Weg auf, GPU-intensive KI-Trainingsjobs als Managed Cloud Service auszuführen, ohne dabei auf die in Unternehmensumgebungen erwartete Skalierbarkeit, Orchestrierung und SLAs verzichten zu müssen.
Ebenso bedeutsam ist die Dynamik des offenen Ökosystems. Zyphra entwickelt nicht isoliert, sondern folgt dem Open-Source- und Open-Science-Ethos. Das Unternehmen nutzt seine Infrastruktur für die Forschung zu neuronalen Architekturen, Langzeitgedächtnissystemen und kontinuierlichen Lerntechniken. Diese Ansätze sind nicht nur für KI im Allgemeinen von Vorteil, sondern bieten Unternehmen auch mehr Transparenz, Reproduzierbarkeit und Lizenzklarheit als herkömmliche Black-Box-Modelle. Die Open-Source-Dimension kann Unternehmen, die KI-Investitionsstrategien prüfen, aber undurchsichtigen, proprietären Lösungen misstrauen, neue Möglichkeiten eröffnen.
Ein weiterer Schlüsselfaktor ist die Abstimmung von Lieferkette und Roadmap. Die Sicherung der GPU-Kapazität im großen Maßstab ist zu einem der größten Engpässe in der KI-Entwicklung geworden. Zyphras Zusammenarbeit mit IBM und AMD umfasste eine frühzeitige Zusammenarbeit bei Produkt-Roadmaps und Lieferplänen, die einen zuverlässigen Zugriff auf Beschleuniger und schnelle Bereitstellungszeitpläne ermöglichte. Der erste Cluster ging im September live, mit einem gezielten Plan zur Kapazitätserweiterung im Jahr 2026. Für Technologieführer in Unternehmen signalisiert dies einen zukunftsorientierten Ansatz bei der Planung der GPU-Roadmap. Ein Ansatz, der kurzfristige Experimente mit der Fähigkeit in Einklang bringt, im Laufe der Zeit in komplexere Modelltrainingszyklen zu skalieren.
Das Zyphra-Programm
Zyphra sicherte sich kürzlich eine Finanzierungsrunde der Serie A mit einer Bewertung von einer Milliarde US-Dollar. Dies ist ein frühes Indiz für das Vertrauen der Investoren in seine Mission. Mit diesem Kapital beabsichtigt das Unternehmen, ein führendes Forschungslabor für „Superintelligenz“ aufzubauen, das auf den Prinzipien von Open Source und Open Science basiert. Die neue Infrastruktur in der IBM Cloud ist dabei von zentraler Bedeutung. Die von AMD Instinct-Beschleunigern angetriebenen Modelle von Zyphra umfassen Sprache, Bild und Audio und laufen in einer Pipeline zusammen, die Maia, dem universellen Superagenten, zugrunde liegt. Das angestrebte Ergebnis ist eine Plattform, die Wissensarbeiter in Unternehmen durch Automatisierung von Arbeitsabläufen, Bereitstellung relevanter Informationen und Steigerung der Gesamtproduktivität unterstützt.
Die technische Vereinbarung mit IBM und AMD stellt sicher, dass Zyphra seinen Rechenbedarf bei steigenden Trainingsanforderungen erweitern kann. Anstatt die Infrastruktur als statisches Asset zu betrachten, legt die Zusammenarbeit den Schwerpunkt auf kontinuierliche Skalierung und die Zusammenführung von GPU-Versorgung, Cloud-Orchestrierung und fortschrittlicher Vernetzung in einer integrierten Lösung. Diese Vorwärtskompatibilität ist ein entscheidendes Unterscheidungsmerkmal für KI-Unternehmen, die größere und anspruchsvollere Modelle trainieren möchten, dabei aber planbare Kosten verursachen und einen zuverlässigen Zugriff auf diese Modelle gewährleisten möchten.
Architektur-Highlights
Im Mittelpunkt der Implementierung steht die Rechenleistung. Die AMD Instinct MI300X GPUs bieten eine leistungsstarke Speicherarchitektur mit hoher Bandbreite, die für die großen Datenströme ausgelegt ist, die für multimodales KI-Training erforderlich sind. Jeder GPU-Cluster ist für dichte Gleitkomma-Workloads optimiert und auf die Leistungskennzahlen pro Watt abgestimmt, die Unternehmen bei der Bewertung der Betriebskosten zunehmend berücksichtigen.
Auch die Vernetzung und die Datenebene spielen eine zentrale Rolle. Durch den Einsatz von AMD Pensando Pollara 400 AI NICs und Ortano DPUs kann die Zyphra-Umgebung Workloads effizienter auf Tausende von GPUs verteilen und so die Engpässe beseitigen, die traditionell mit Ost-West-Verkehr in großen Clustern verbunden sind. Die Hardware-Offloads beschleunigen den Netzwerkdurchsatz, ermöglichen Richtlinienverwaltung, Telemetrie und Sicherheitsdurchsetzung und stellen sicher, dass Workloads auch bei hoher Belastung vorhersehbar ausgeführt werden.
Auf der Substratebene bietet IBM Cloud der Orchestrierungsumgebung unternehmensweite Funktionen für Sicherheit, Governance und Compliance. Diese Funktionen ermöglichen es Zyphra, sich in einer Umgebung zurechtzufinden, in der Unternehmens-KI immer strengere Anforderungen hinsichtlich Datensouveränität, Auditierbarkeit und Servicekontinuität erfüllen muss. Tatsächlich ergänzt IBM Cloud den Rechen- und Netzwerk-Stack von AMD um die operativen Kontrollen, die CTOs bei Bereitstellungen in Produktionsqualität erwarten.
Aus Sicht von Zyphra stellt dieses Engagement die erste erfolgreiche Implementierung eines vollständig integrierten Stacks dar, von Rechenbeschleunigern bis hin zum Netzwerk-Fabric, der vollständig auf IBM Cloud mit AMD-Chip läuft. Die Führung von Zyphra betrachtet diese Infrastruktur als Sprungbrett für die Entwicklung innovativer Modelle in einem offenen und unternehmensfreundlichen Kontext mit dem übergeordneten Ziel, die Entwicklung und Anwendung von Superintelligenz zu beeinflussen.
Krithik Puthalath, CEO und Vorstandsvorsitzender von Zyphra, betonte, dass die Zusammenarbeit mit AMD und IBM Cloud die erste erfolgreiche Integration einer Full-Stack-Trainingsplattform in der IBM Cloud darstellt, die von der Datenverarbeitung bis zum Netzwerk reicht. Zyphra wird die Entwicklung von Spitzenmodellen auf Basis von AMD-Chips leiten, um Open-Source- und Enterprise-Superintelligenz voranzutreiben.
Alan Peacock, GM von IBM Cloud, betonte, wie wichtig es sei, KI-Workloads schnell und effizient zu skalieren, um sowohl etablierten als auch aufstrebenden Unternehmen einen besseren ROI zu erzielen. Er betonte, dass IBM das strategische Wachstum von Zyphra durch die Zusammenarbeit mit AMD bei der Entwicklung einer skalierbaren, kostengünstigen KI-Infrastruktur unterstützt, die das Modelltraining beschleunigt.
AMD wiederum sieht die Zusammenarbeit als Meilenstein in der Entwicklung von KI-Infrastrukturen. Philip Guido, EVP und Chief Commercial Officer, verweist auf die Integration des etablierten Enterprise-Cloud-Ökosystems von IBM mit der Rechenbeschleunigungstechnologie von AMD als Vorbild für die Branche. Für AMD unterstreicht die Vereinbarung die Führungsrolle nicht nur im Bereich Hochleistungsrechnen, sondern auch bei der Ermöglichung realer KI-Ergebnisse durch Systeme, die inferenzeffizientes, multimodales Arbeiten im großen Maßstab ermöglichen.
Betriebsmodell
Die erste Phase dieser Implementierung wurde Anfang September in Betrieb genommen. Damit ist Zyphra eine der ersten Organisationen, die Zugriff auf einen AMD Instinct MI300X-Cluster mit hoher Kapazität in der IBM Cloud hat. Diese sofortige Verfügbarkeit trägt dem kurzfristigen Bedarf an der Schulung großer multimodaler Modelle Rechnung und ermöglicht Zyphra einen schnellen Iterationsbeginn.
Die Zusammenarbeit schafft die Voraussetzungen für erweiterte Rechen- und Netzwerkressourcen im Jahr 2026. Die schrittweise Einführung trägt der Skalierung von KI-Workloads Rechnung: Der Trainingsbedarf wird parallel zur Datensatzgröße, der Modellkomplexität und der Experimentierfrequenz weiter steigen. CTOs, die die Entwicklung multimodaler KI beobachten, betrachten die Erweiterung im Jahr 2026 als strategisches Engagement für die Kapazitätsplanung, um sicherzustellen, dass Zyphra, IBM und AMD langfristig zusammenarbeiten.
Strategie
Das Zyphra-Engagement basiert auf einer breiteren strategischen Ausrichtung zwischen IBM und AMD. Im vergangenen Jahr begannen die beiden Unternehmen mit der Bereitstellung von AMD Instinct MI300X-Beschleunigern als Service in der IBM Cloud und betonten damit ihre Verpflichtungen hinsichtlich zuverlässiger Leistung, Energieeffizienz und unternehmensweiter Bereitstellung. Durch den Übergang von einer serviceorientierten Bereitstellung zu einem dedizierten, groß angelegten Cluster veranschaulicht das Zyphra-Programm den Fortschritt hin zu individuelleren und kapazitätsreicheren Client-Lösungen.
Parallel dazu erweitern IBM und AMD ihre Zusammenarbeit auf Architekturen der nächsten Generation, wie beispielsweise quantenzentriertes Supercomputing. IBM bringt seine weltweit führende Position bei Quantensystemen und -algorithmen ein, während AMD seine Expertise in den Bereichen Hochleistungsrechnen und KI-Beschleunigung beisteuert. Diese gemeinsame Roadmap soll die Grenzen des Möglichen im Bereich Großrechner erweitern und die langfristige Vision einer integrierten Unternehmensinfrastruktur, die die GPUs von heute und die Quantenprozessoren von morgen umfasst, weiter stärken.
Ergebnisse für IT und CTOs
Die wichtigsten Faktoren sind Schulungseffizienz und Gesamtbetriebskosten. Unternehmen sollten genau beobachten, wie effektiv MI300X und Pensando bei großen, multimodalen Workloads skalieren, insbesondere in Bezug auf wichtige Kennzahlen wie Token pro Sekunde pro GPU, Verbindungsleistung und Kostenvorhersagbarkeit pro Auftrag.
Auch Integrationsmuster verdienen Beachtung. Die Zyphra-Bereitstellung zeigt, wie sich Daten-Staging, Checkpointing, Observability und Feature Stores in die IBM Cloud integrieren. Für Unternehmen, die ihre KI-Roadmaps evaluieren, können diese Muster als Referenzarchitekturen dienen.
Sicherheit und Governance spielen ebenfalls eine zentrale Rolle. Da Standardmodelle oft Milliarden von Parametern und Petabyte an Daten umfassen, sollten IT-Verantwortliche prüfen, wie programmierbare Netzwerkkarten und DPUs zur Sicherheitsisolierung, Telemetrie und granularen Richtliniendurchsetzung in Multi-GPU-Clustern beitragen.
Hybrid- und Multicloud-Flexibilität stellen eine weitere Dimension dar. Während Zyphras Umgebung derzeit auf der IBM Cloud läuft, sind die Architekturoptionen, wie optimierte NICs, DPUs und Orchestrierungsebenen, auf hybride Umgebungen ausgelegt. Für Unternehmen bietet dies eine potenzielle Blaupause zur Aufrechterhaltung des ROI durch Workload-Portabilität, Datenlokalität und Ausfallsicherheit über mehrere Clouds hinweg.
Schließlich sollten IT-Entscheider die Open-Source-Veröffentlichungen von Zyphra im Auge behalten. Als Unternehmen, das sich der offenen Wissenschaft verschrieben hat, wird Zyphra voraussichtlich Trainingsrezepte, Modelle und Benchmarks teilen. Diese bieten Unternehmen Evaluierungsmöglichkeiten für die Feinabstimmung domänenspezifischer Modelle, den Aufbau von Retrieval Augmented Generation (RAG)-Pipelines oder die Bewertung der Effizienz multimodaler KI-Ansätze in Produktions-Workloads.
Schlüssel zum Mitnehmen
Für technische Entscheider in der Unternehmens-IT bedeutet die Zyphra-Implementierung mehr als nur einen Kundengewinn. Sie dient als Referenzimplementierung, die zeigt, wie GPU-Versorgung, Netzwerk-Offload und die Cloud-Infrastruktur des Unternehmens zusammenwirken können, um eine nachhaltige Pipeline für das Training innovativer KI-Modelle zu schaffen. Mit der Orchestrierung durch IBM Cloud und AMD-Chips für dichte Rechenleistung und fortschrittliche Vernetzung setzt die Zusammenarbeit neue Maßstäbe hinsichtlich Leistung, Kosten und Zuverlässigkeit im groß angelegten Training.


 Amazon