

IBM hat den IBM Spyre Accelerator vorgestellt, eine Inferenz-Engine mit geringer Latenz für generative und agentenbasierte KI, bei der Reaktionsfähigkeit, Sicherheit und Verfügbarkeit unerlässlich sind. Spyre richtet sich an Unternehmen, die KI in ihre bestehenden Aufzeichnungssysteme integrieren möchten, sodass sensible Daten ohne Leistungseinbußen auf der Plattform verbleiben können.
Die allgemeine Verfügbarkeit von IBM z17 und LinuxONE 5 beginnt am 28. Oktober, Power11 folgt Anfang Dezember. Der Beschleuniger ist ein 5-nm-SoC mit 32 Kernen, verpackt auf einer 75-Watt-PCIe-Karte. IBM unterstützt Cluster mit bis zu 48 Karten pro IBM Z- oder LinuxONE-System und bis zu 16 Karten pro IBM Power-System. Dies ermöglicht die Skalierung für Multi-Modell-Inferenz im Zusammenhang mit transaktionalen Workloads wie Betrugserkennung, Einzelhandelsautomatisierung und Risikobewertung. Spyre stellt die Produktisierung der Forschung des IBM AI Hardware Center dar und ist auf lokale Bereitstellungen abgestimmt, bei denen Datenlokalität, Sicherheit und Energieeffizienz grundlegende Anforderungen sind.
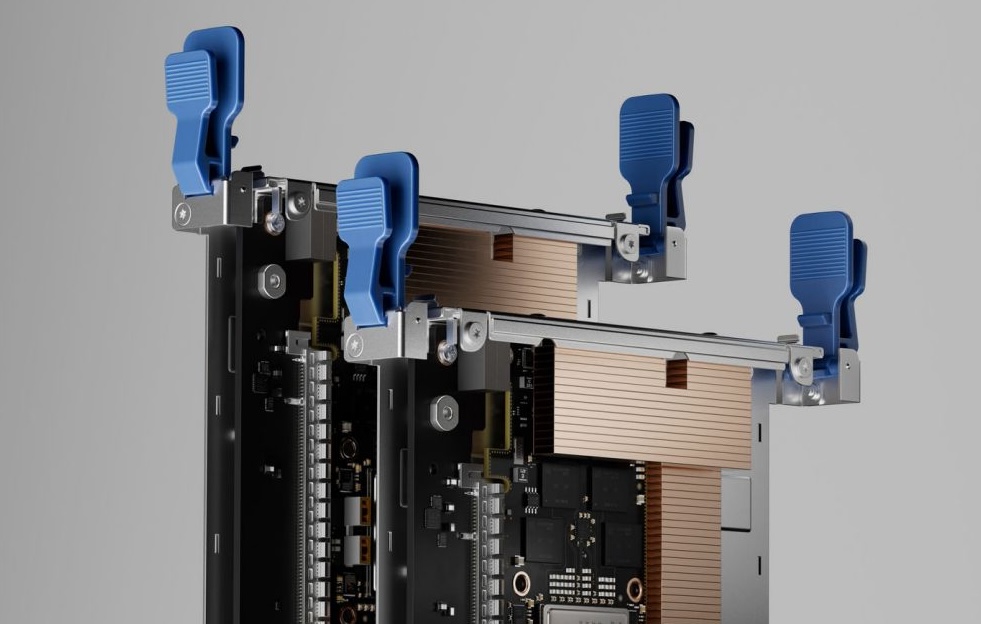
Von Logik-Pipelines zu agentenbasierter KI
Unternehmensabläufe verlagern sich weg von deterministischen Logikketten hin zu agentenbasierter KI, die Kontexte erkennt, plant und in Echtzeit handelt. Diese agentenbasierten Systeme erfordern latenzarme Inferenz und eine vorhersehbare Servicequalität, selbst wenn die Kernsysteme hohe Transaktionsvolumina verarbeiten. IBM setzt dedizierte Inferenzhardware direkt auf den Plattformen ein, auf denen kritische Daten bereits gespeichert sind. Die Speicherung der Daten auf IBM Z, LinuxONE und Power reduziert Risiken und Compliance-Aufwand, indem unnötiger Datenausgang und externe Verarbeitung vermieden werden. Die Ausführung generativer und agentenbasierter Inferenz in der Nähe der Daten minimiert zudem Backhaul und netzwerkbedingte Variabilität, die häufig zu Tail-Latenzen führt. Das übergeordnete Ziel besteht darin, KI-gesteuerte Entscheidungsfindung in bestehende OLTP-, Batch- und Messaging-Flows zu integrieren, ohne Durchsatz, Änderungsfenster oder Servicelevel zu beeinträchtigen.
Spyre-Architektur
Spyre ist ein kommerzielles System-on-a-Chip (SoC), das auf Prototypen von IBM Research basiert. Es basiert auf einem 5-nm-Prozess mit 25.6 Milliarden Transistoren und 32 Beschleunigerkernen und ist für gleichzeitige Inferenz mit geringer Latenz optimiert, nicht für Modelltraining. Das Gerät wird als 75-Watt-PCIe-Erweiterungskarte geliefert und bietet Infrastrukturteams ein vertrautes Bereitstellungs- und Servicemodell.
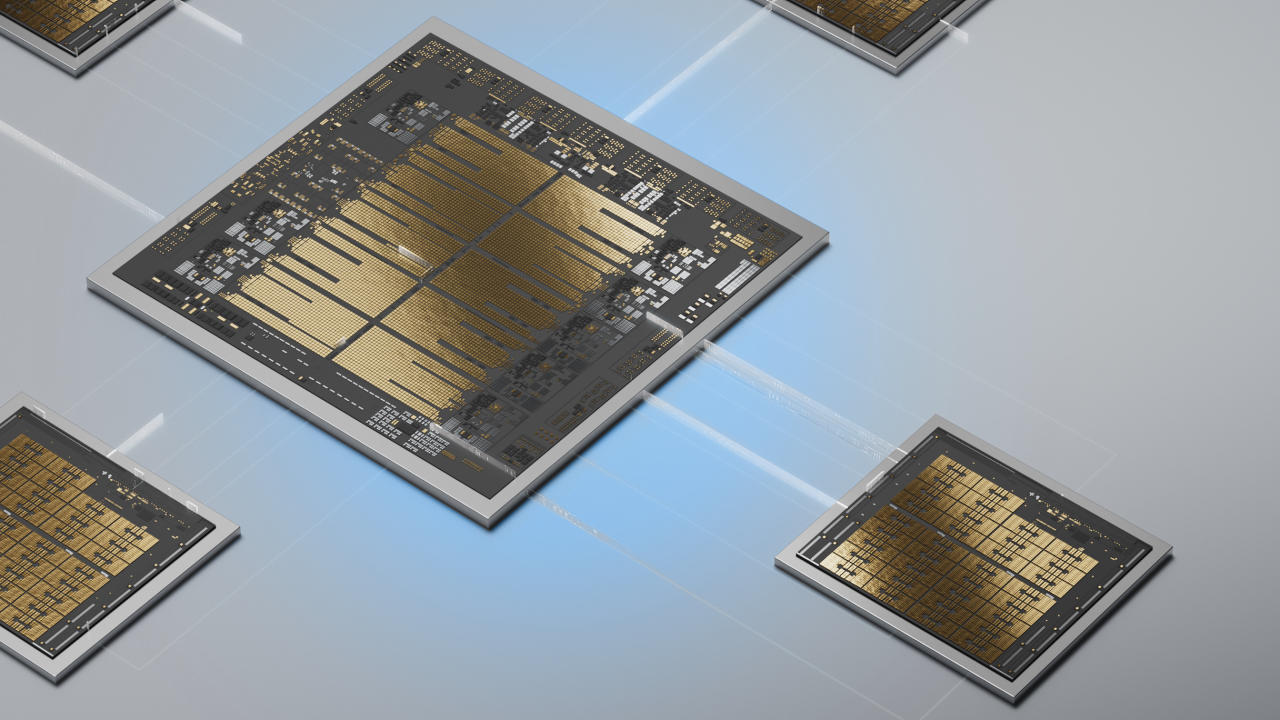
IBM hat Scale-Out-Konfigurationen entwickelt, die bis zu 48 Karten in einem IBM Z- oder LinuxONE 5-System und bis zu 16 Karten in einem IBM Power11-System ermöglichen. Dies ermöglicht Multi-Model-Serving und Mandantenisolierung innerhalb einer einzigen Plattform. Softwareseitig lässt sich Spyre in den IBM Enterprise Stack für Modell-Serving, Sicherheit und Beobachtbarkeit integrieren, während Power einen One-Click-Katalog für eine schnelle Servicebereitstellung hinzufügt. Diese Kombination soll die Time-to-Value beschleunigen und gleichzeitig die KI-Services innerhalb bestehender Betriebs- und Compliance-Grenzen halten.
Plattformintegration
IBM Z und LinuxONE: Co-Location mit Telum II
Auf z17 und LinuxONE 5 arbeitet Spyre parallel zum Telum II-Prozessorkomplex, um die Inferenz mit Transaktionsdaten und Ereignisströmen koresident zu halten. Diese Anordnung bewahrt bestehende Sicherheitsdomänen und Prüfpfade, die in regulierten Umgebungen unerlässlich sind. Durch die lokale Ausführung der Inferenz minimieren Unternehmen den Bedarf an externen Beschleunigern und verhindern, dass zusätzliche Latenzen die Transaktions-SLAs beeinträchtigen. Das System ist auf bis zu 48 Karten skalierbar und unterstützt mehrere Modelle und Workloads gleichzeitig. Es bietet logische Isolation, um verschiedenen Geschäftseinheiten oder regulatorischen Anforderungen gerecht zu werden. Dies ist besonders relevant für Zahlungsströme, Betrugsprävention, Schadensabwicklung und Lieferkettenereignisse, bei denen jede Millisekunde zählt und eine Ausweitung des Compliance-Perimeters nicht wünschenswert ist.
IBM Power11: Kataloggesteuerte KI-Dienste und MMA-Synergie
Auf Power11-Servern integriert sich Spyre in einen KI-Servicekatalog, der für eine schnelle Einführung in bestehende Power-Umgebungen konzipiert ist. Administratoren können Services mit einem einzigen Klick bereitstellen und so die traditionelle Nutzung von Middleware, Analysen und Branchenanwendungen durch Power-Kunden berücksichtigen. Die Kombination von Spyre mit dem On-Chip-MMA-Beschleuniger von Power verbessert die Datenkonvertierung und den Durchsatz der Vorverarbeitung – entscheidende Phasen für generative KI-Pipelines und komplexe Prozessintegrationen.
IBM nennt ein Durchsatzbeispiel: Bei einer Eingabegröße von 128 kann das System über acht Millionen Dokumente für die Wissensdatenbankintegration in etwa einer Stunde verarbeiten. Für Unternehmen, die RAG-Systeme entwickeln oder umfangreiche Unternehmenssuchen durchführen, liegt der Schwerpunkt auf der Beschleunigung der Datenaufbereitung und -aufnahme und nicht nur auf dem Inferenzschritt. Die Gesamtlösung ist auf gemischte Umgebungen ausgerichtet, wie z. B. Fertigung, Einzelhandel, Gesundheitswesen und ERP-lastige Implementierungen, bei denen vorhersehbarer Durchsatz und Wartungsfreundlichkeit entscheidend sind.
Vom IBM AI Hardware Center zum Einsatz vor Ort
Spyre zeigt, wie IBM Forschung in praktische Produkte umsetzt. Die Technologie begann als Prototyp von IBM Research und reifte dann durch iterative Cluster-Implementierungen auf dem Campus Yorktown Heights und die Zusammenarbeit mit dem Center for Emerging Artificial Intelligence Systems der University at Albany heran. IBM Infrastructure entwickelte das Design anschließend für IBM Z, LinuxONE und Power und passte die Chips an Unternehmensanforderungen wie Sicherheit, Zuverlässigkeit, Lebenszyklusmanagement und Wartungsfreundlichkeit an. IBM-Führungskräfte charakterisieren Spyre als Infrastruktur für Multi-Modell-KI und betonen die sichere und robuste Skalierung generativer und agentischer Workloads auf Plattformen, die bereits mit Kerndaten und Transaktionen vertraut sind.
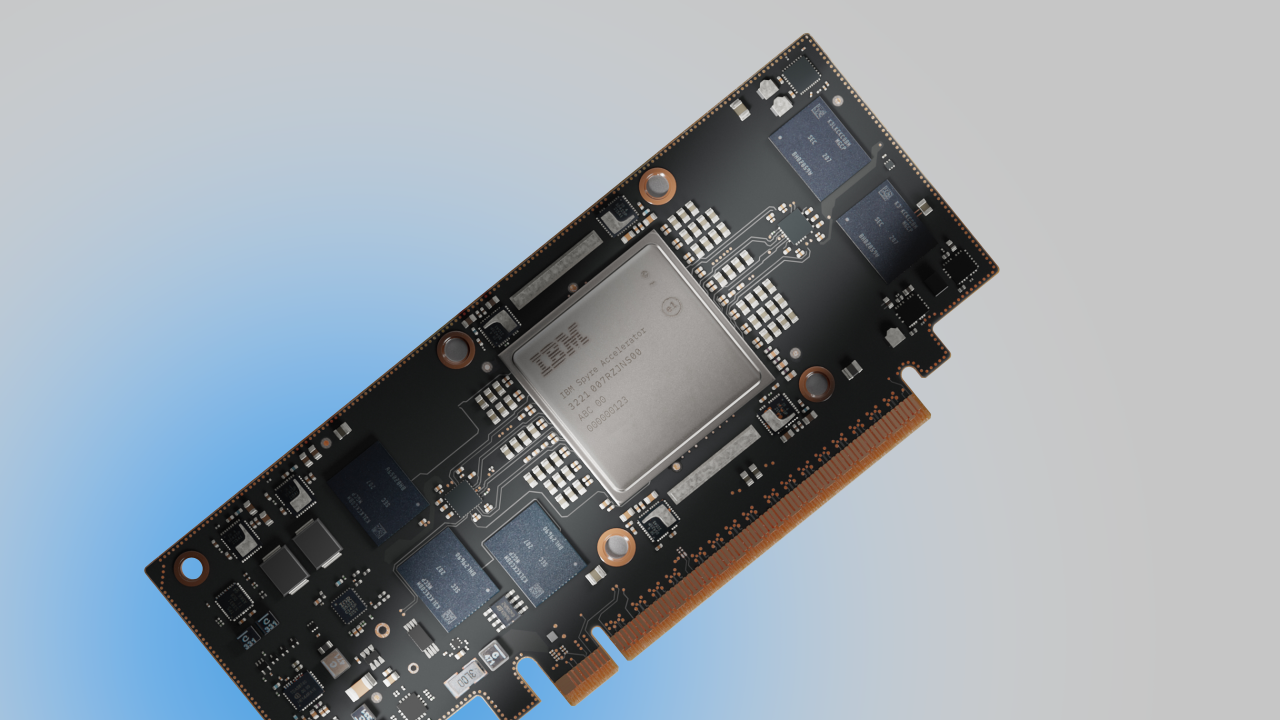
Der Wert von Spyre ist untrennbar mit der operativen Ausrichtung von IBM verbunden. Durch Inferenz dort, wo Daten erstellt und verwaltet werden, begrenzen Unternehmen den Datenabfluss und reduzieren die Compliance-Komplexität. IBM Z und LinuxONE bieten Kryptografie-, Isolations-, Protokollierungs- und Audit-Funktionen, die bereits fester Bestandteil der regulatorischen Rahmenbedingungen vieler Kunden sind. Power steuert einen robusten Sicherheits- und Management-Stack bei, der sich für gemischte Analysen und Transaktionsumgebungen eignet. Clustering-Unterstützung, logische Partitionierung und First-Party-Observability-Tools entsprechen den Betriebsnormen von Mainframes und Power und ermöglichen die Bereitstellung, Überwachung und Wartung von KI-Diensten wie jeder andere Tier-1-Workload. Für viele Käufer im Finanzwesen, Gesundheitswesen und öffentlichen Sektor haben diese operativen Zusicherungen Vorrang vor reinen TOPS- oder synthetischen Benchmarks.
Überlegungen zu Leistung und Skalierbarkeit
Obwohl IBM keine umfassenden Leistungsdetails für jedes Modell veröffentlicht hat, sind die Architekturindikatoren eindeutig. Spyre zielt auf Inferenzpfade mit geringer Latenz ab, die für Agentenschleifen und ereignisgesteuerte Pipelines optimiert sind, bei denen Parallelität und Kontrolle der Latenz wichtiger sind als der reine Spitzendurchsatz. Durch die Skalierung über PCIe-Kartencluster können Teams Bereitstellungen für Multi-Modell-Serving, Mandantenisolierung und zukünftiges Wachstum dimensionieren, ohne dass eine Neugestaltung der Plattform erforderlich ist.
Auf Power beschleunigt die MMA-Spyre-Kombination die Datenaufbereitung und -konvertierung, die oft die End-to-End-Zeit für RAG und Enterprise Search dominiert. Unternehmen sollten Proof-of-Concept-Strukturen so strukturieren, dass sie die Produktionsbedingungen widerspiegeln: Modellgrößen und Token-Fenster, Anforderungsparallelität, Interaktion mit Transaktionslasten und Telemetrie für die Latenzzeit bei Konflikten.
Barry Baker, COO von IBM Infrastructure und GM von IBM Systems, betonte den Fokus des Unternehmens auf die Entwicklung von Infrastruktur für neue KI-Workloads. Er hob die Rolle des Spyre Accelerator bei der Verbesserung von Systemen zur Unterstützung multimodellbasierter KI, einschließlich generativer und agentenbasierter KI, hervor. Er fügte hinzu, dass diese Innovation es Kunden ermöglichen soll, geschäftskritische KI-Workloads sicher, robust und effizient zu skalieren und gleichzeitig den Wert von Unternehmensdaten zu maximieren.
Mukesh Khare, General Manager von IBM Semiconductors, weist darauf hin, dass IBM sein AI Hardware Center bereits 2019 eröffnet hat, um den wachsenden Rechenleistungsanforderungen der KI gerecht zu werden – noch vor dem jüngsten KI-Boom. Er feiert die Kommerzialisierung des ersten Chips des Zentrums, der die Leistung der Mainframe- und Server-Clients von IBM verbessern soll.
Anwendungen
Finanzdienstleistungsteams können Spyre zur Echtzeit-Betrugserkennung nutzen. Spyre arbeitet direkt mit plattforminternen Datensätzen und ermöglicht so Modell- und Richtlinienaktualisierungen, ohne den Prüfumfang zu erweitern. Im Einzelhandel und in der Logistik können agentenbasierte Assistenten Entscheidungen zu Bestand und Auftragsabwicklung mit konsistenten Reaktionszeiten koordinieren, indem sie die Inferenz lokal auf die operativen Systeme beschränken. Gesundheits- und Regierungsorganisationen können generative Zusammenfassungen und Entscheidungsunterstützung unter strengen Datenschutz- und Speicherbeschränkungen bereitstellen und so Datenbewegungen vermeiden, die andernfalls zusätzlichen Compliance-Aufwand verursachen würden. In industriellen und ERP-lastigen Umgebungen kann Spyre die Prozessautomatisierung und Anomalieerkennung in der Nähe von SAP, Oracle und auf Power laufenden Anlagentelemetriesystemen unterstützen und so deterministisches Verhalten und Wartbarkeit gewährleisten.
Die Leitung von IBM Infrastructure präsentiert Spyre als grundlegende Infrastruktur für den KI-Umstieg. Spyre wurde entwickelt, um multimodellbasierte, generative und agentenbasierte Workloads im Unternehmensmaßstab mit starken Sicherheits- und Resilienzgarantien zu unterstützen. Die Leitung von IBM Semiconductors bezeichnet Spyre als ersten Meilenstein der Kommerzialisierung durch das AI Hardware Center und erwartet eine kontinuierliche Entwicklung von Hardware-Innovationen für IBMs Mainframe- und Server-Kunden.
Fazit
Spyre ist IBMs On-Premises-Lösung für Inferenz mit geringer Latenz in Umgebungen, die keine Kompromisse bei Sicherheit, Zuverlässigkeit oder Datenlokalität eingehen. Hardware-Skalierung, plattformnative Integrationen und Betriebsmodell sind auf IBM Z-, LinuxONE- und Power-Umgebungen abgestimmt, die agentenbasierte KI im gleichen Auslastungsbereich wie Kerntransaktionen anstreben. Der nächste Schritt für Käufer sind Belege: Proofs of Concept, die Latenz-, Parallelitäts- und Governance-Vorteile unter realen Workloads validieren. Entspricht die Leistung im Feld den Anforderungen, bietet Spyre einen pragmatischen Weg, generative und agentenbasierte KI direkt in unternehmenskritische Systeme zu integrieren.
Verfügbarkeit
Spyre ist ab dem 28. Oktober für IBM z17 und LinuxONE 5 allgemein verfügbar. IBM Power11-Systeme erhalten Spyre Anfang Dezember. Diese gestaffelte Veröffentlichung ermöglicht Mainframe- und LinuxONE-Kunden den frühesten Zugang zur On-Platform-Inferenz. Power-Systeme folgen kurz darauf.


 Amazon