

Intel hat heute auf dem OCP Global Summit den Produktnamen für Crescent Island bekanntgegeben. Die Intel GPU D-Serie basiert auf der Xe3P-Architektur und kombiniert bis zu 480 GB LPDDR5X-Speicher mit einer Speicherbandbreite von 1.5 TB/s und einer FP8-Rechenleistung von 1.3 Petaflops – alles in einer luftgekühlten PCIe-Karte mit 350 W TDP. Die Angabe von 480 GB gilt für Karten von Partnern; die Intel-eigene Karte verfügt über 160 GB. Laut Intel läuft die Auslieferung von Kundenmustern an Server-OEMs, ODMs, Cloud-Anbieter und unabhängige Softwarehersteller. Das von Intel veröffentlichte Bild trägt die Bezeichnung GPU D270 – die erste Teilenummer, die wir für diese Serie gesehen haben.
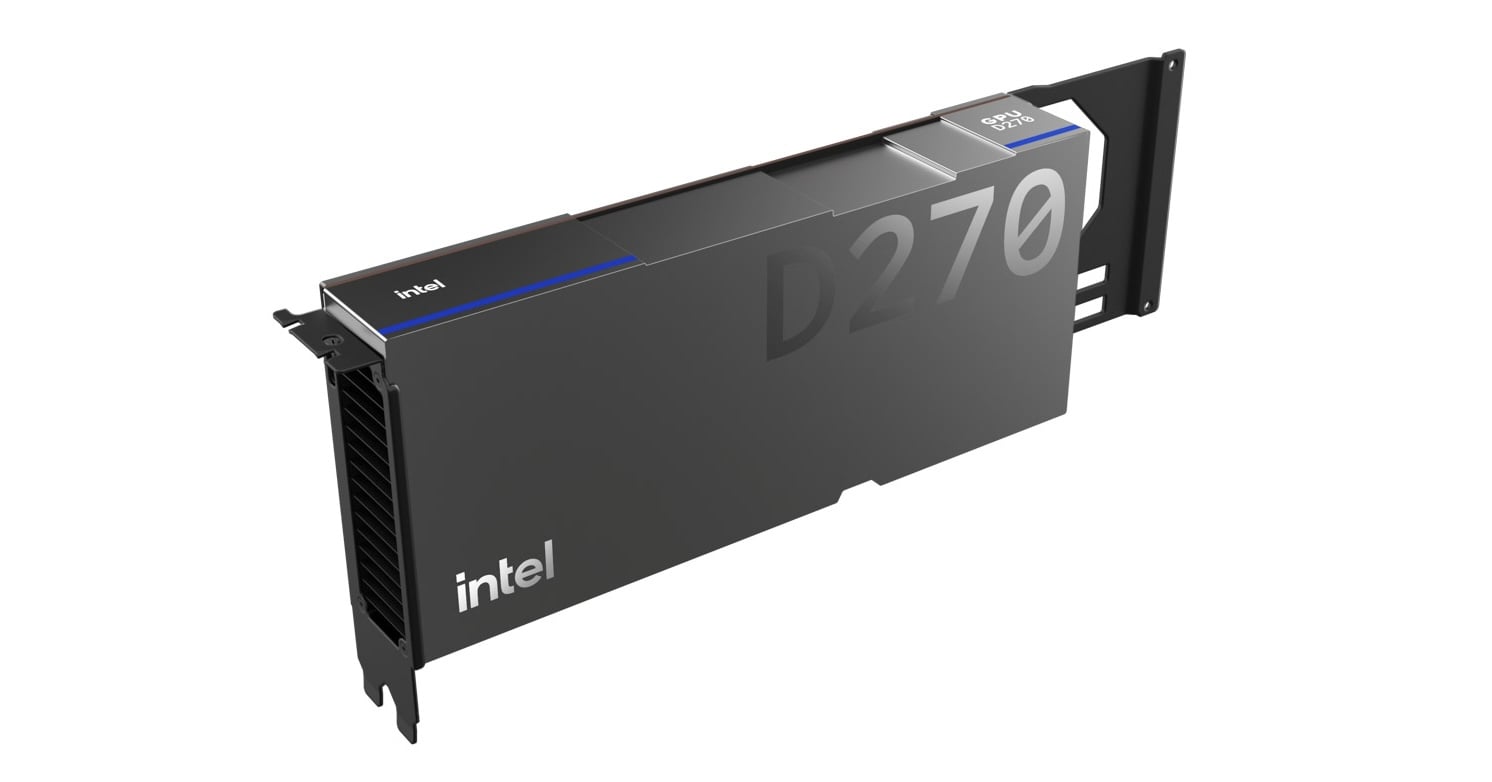
Die Xe3P-Architektur zielt auf speicherintensive Inferenz ab.
Intel beschrieb Crescent Island erstmals auf der OCP 2025 und stellte die Silizium-Architektur im August auf der Hot Chips-Konferenz detailliert vor : 32 Xe-Kerne und 256 XMX-Engines auf Xe3P-Basis, mit LPDDR5X anstelle von HBM, sodass die Karte in bestehende luftgekühlte Racks integriert werden kann. Neu hinzugekommen sind der Produktname, die Bandbreiten- und Rechenleistungswerte sowie die Bestätigung, dass Kunden bereits Hardware-Muster erhalten haben.
Zum Vergleich: Der aktuell von Intel verbaute PCIe-Inferenzbeschleuniger ist Gaudi 3 mit 128 GB HBM2e und 3.7 TB/s. Wir haben diese Karte im Februar im Dell PowerEdge XE7740 ausführlich getestet . Intel kombinierte Crescent Island mit Gaudi-3-Rack-Designs, als die GPU erstmals auf der OCP 2025 vorgestellt wurde. Die D-Serie hingegen geht beim Speicher den umgekehrten Weg: Sie bietet fast die vierfache Kapazität pro Karte bei deutlich weniger als der halben Bandbreite.
Laut Intel kann eine einzelne Grafikkarte der D-Serie Modelle mit bis zu 300 Milliarden Parametern verarbeiten, und ein System mit acht GPUs skaliert sogar auf über eine Billion Parameter. Intel positioniert die Karte für dauerhafte Multi-Tenant-Inferenz und agentenbasierte Workloads mit langem Kontext, bei denen das Wachstum des KV-Caches den Speicherbedarf schneller erhöht als die Rechenleistung. Mit 1.5 TB/s liegt die Karte hinsichtlich der Bandbreite deutlich unter HBM-Beschleunigern. Intel legt bei dekodierintensiven Anwendungen mehr Wert auf die Kapazität pro Watt und pro Dollar als auf die maximale Bandbreite.
„Inferenz wird zur zentralen KI-Anwendung, und Unternehmen benötigen eine Infrastruktur, die die richtige Leistung zu den richtigen Kosten liefert“, so Anil Nanduri, Vice President für KI-Produkte und GTM bei Intels Data Center Group. „Mit der Intel GPU D-Serie konzentrieren wir uns darauf, Inferenz mit hoher Kapazität praktikabel und wirtschaftlich skalierbar zu gestalten.“ Die Software basiert auf der gemeinsamen Xe-Architektur, die laut Intel binäre Portabilität über alle GPU-Linien hinweg gewährleistet. So lässt sich Code, der auf Arc Pro-Karten entwickelt wurde, ohne Kernel-Anpassungen auf die D-Serie übertragen.
Intels Stack integriert Upstream-Laufzeitumgebungen und Bereitstellungsframeworks auf Xeon-Hosts und Beschleunigern der D-Serie. Er bietet von Anfang an Unterstützung für Metas Muse Glimmer, das 30 Milliarden Parameter umfassende Open-Weight-Modell, das Meta für lokale Agentenanwendungen entwickelt hat. Das Intel AI for Enterprise Agent Toolkit, das bereits auf Xeon läuft, nutzt eine Provider-basierte Architektur, die die D-Serie unterstützt, sobald die Hardware verfügbar ist. Dadurch ist die Orchestrierungsschicht bereits vorhanden, bevor die Beschleuniger in größerer Stückzahl verfügbar sind.
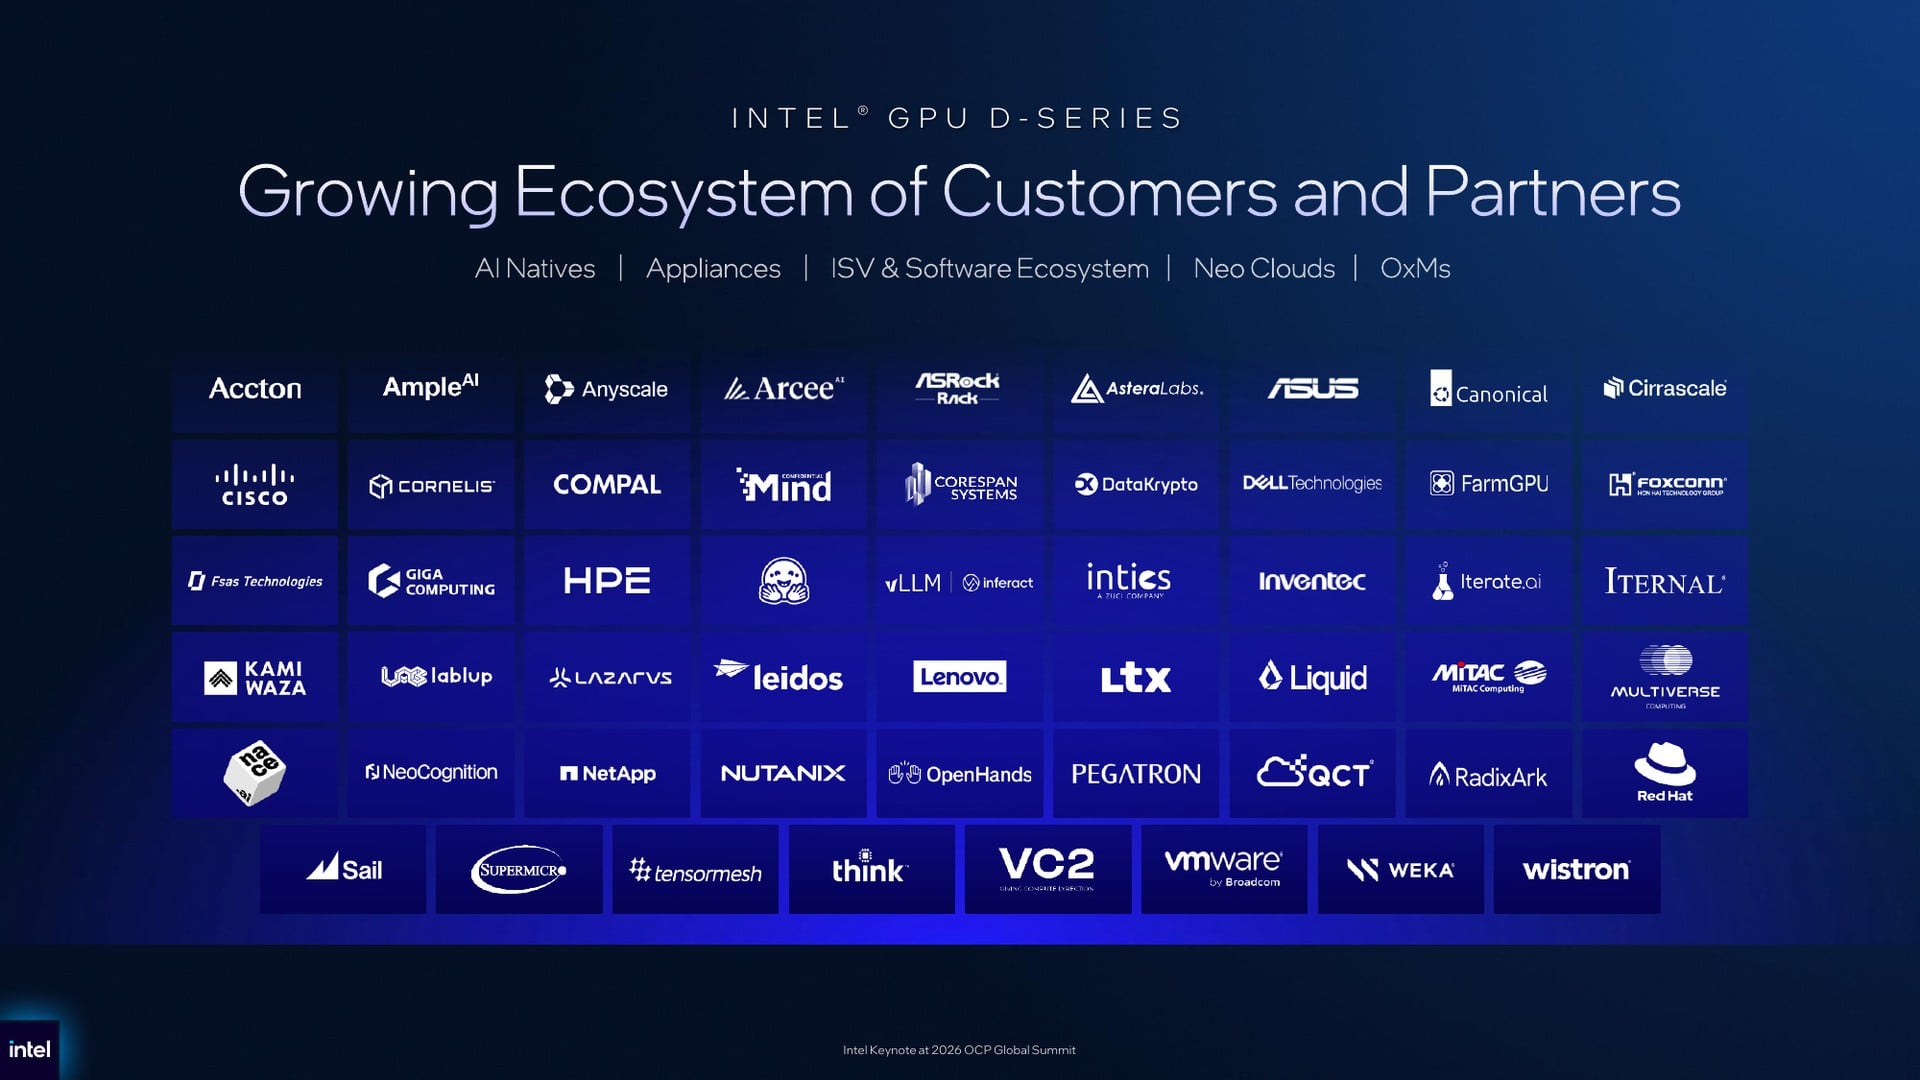
Die von Intel auf der Keynote präsentierte Partnerfolie zeigt 53 Logos aus den Bereichen KI-Unternehmen, Gerätehersteller, Software, Cloud-Anbieter sowie OEMs und ODMs. Die Servernamen sind die erwarteten: Dell, HPE, Lenovo, Supermicro, Cisco, ASUS, ASRock Rack, Giga Computing, MiTAC, Pegatron, QCT, Wistron, Inventec, Compal und Foxconn. Die Softwareliste ist für eine auf Portabilität ausgelegte Karte von größerer Bedeutung: Red Hat, Canonical, VMware by Broadcom, Nutanix, NetApp, WEKA, vLLM, Hugging Face, Anyscale und OpenHands sind vertreten, während Astera Labs und Cornelis im Bereich der Verbindungstechnologie zum Einsatz kommen.
ORv3 Xeon Racks skalieren über 46,000 Kerne hinaus
Neben der Grafikkarte präsentierte Intel Rack-Systeme gemäß der OCP Open Rack v3-Spezifikation mit Xeon 6+ Prozessoren . Laut Intel erreichen die dichtesten Konfigurationen über 46,000 Kerne pro Rack bei einer Gesamtleistungsaufnahme von 133.45 kW. Der 288-Kern-Xeon 6+ kommt mit 160 Sockeln aus, was 80 Dual-Socket-Knoten in einem Rack mit einer Leistungsaufnahme von ca. 834 W pro Sockel entspricht (einschließlich der restlichen Rack-Kapazität). Intel positioniert diese Racks für die CPU-Seite einer Agenten-Pipeline: Token-Routing, -Abruf, Datenbankabfragen, Codeausführung und die Versorgung der Beschleuniger mit E/A-Daten.
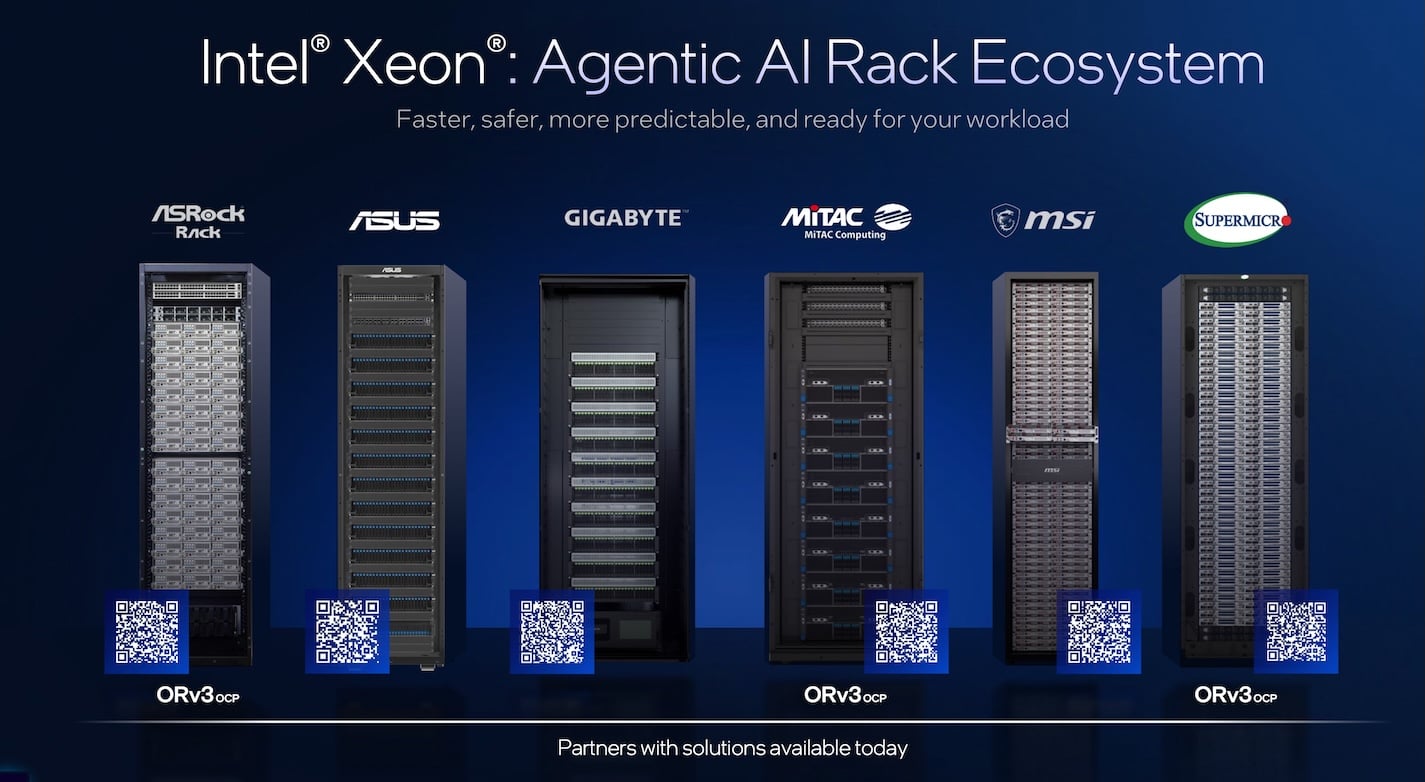
Die Partnerpräsentation nennt ASRock Rack, ASUS, GIGABYTE, MiTAC Computing, MSI und Supermicro als Anbieter aktuell verfügbarer Systeme. Drei der sechs gezeigten Racks sind ORv3-Systeme, die übrigen sind in 19-Zoll-Gehäusen erhältlich. Laut Intel verschiebt sich die Messlatte für KI-Racks hin zur Anzahl der gleichzeitig nutzbaren Agenten bei einer vorgegebenen Latenz. „Agentenbasierte KI verändert die Anforderungen unserer Kunden an ihre Rechenzentren. Schnellere Token-Generierung reicht nicht mehr aus. Die Infrastruktur muss komplexe Workflows orchestrieren, Aufgaben ausführen und effizient und skalierbar nutzbare Ergebnisse liefern“, so Kevork Kechichian, Executive Vice President und General Manager der Data Center Group von Intel.
Die Arbeiten an der offenen Adapterkarte werden bei OCP fortgesetzt.
Intel verwies zudem auf seine Mitarbeit in der OCP Open Adapter Card Arbeitsgruppe, die Anfang des Jahres gemeinsam mit AMD, Dell, NVIDIA und Qualcomm gegründet wurde. Die Gruppe definiert einen Sub-Rack-Beschleuniger-Formfaktor, der zwischen einer Standard-PCIe-Karte und einem vollständigen Rack-System positioniert ist. Standardisierte Schnittstellen für Mechanik, Stromversorgung und Out-of-Band-Management ermöglichen es, Beschleuniger verschiedener Hersteller in dasselbe offene Gehäuse einzusetzen.
Ziel der Arbeitsgruppe sind leistungsstarke Netzteile für Inferenz- und Trainingsplattformen der mittleren Leistungsklasse in 19- und 21-Zoll-Racks. Intel und AMD präsentieren die Fortschritte der Spezifikation auf dem Gipfeltreffen dieser Woche. Intel hat seit 2011 116 Beiträge zum OCP geleistet. Nic Dubés Keynote „Jede Eingabeaufforderung an ihren Platz“ findet am 13. Oktober um 10:30 Uhr PT statt.


 Amazon