

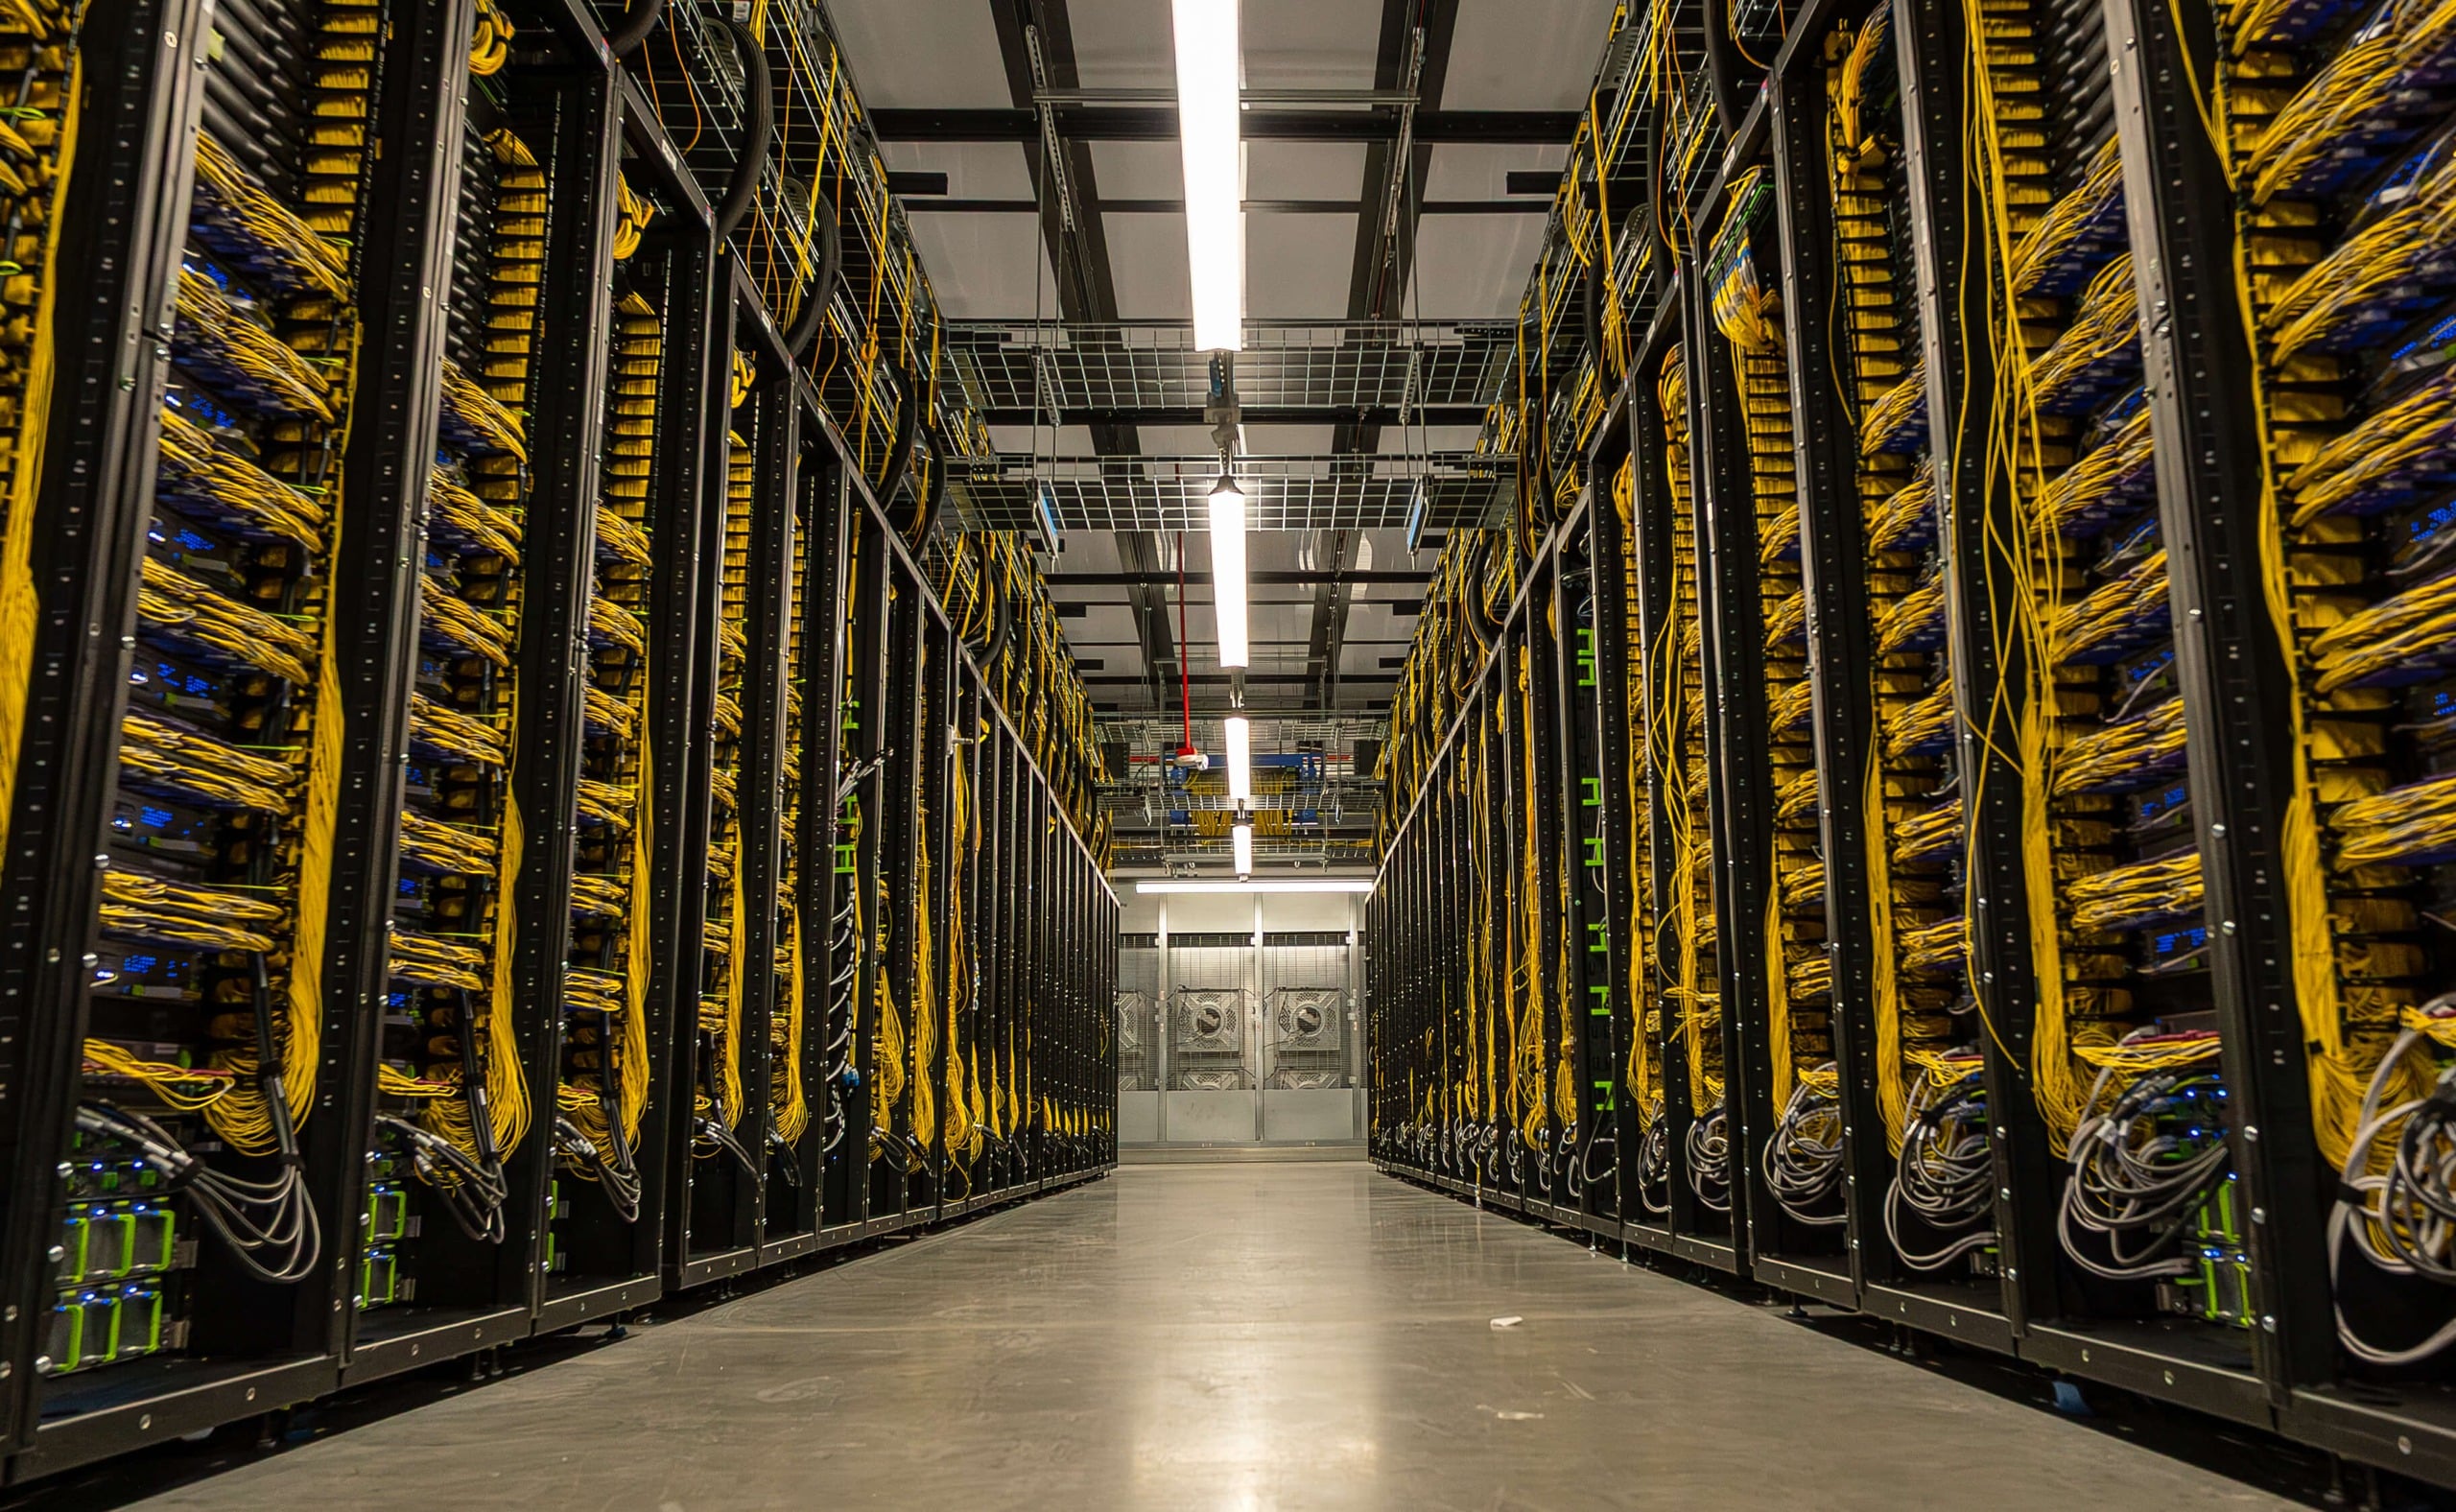
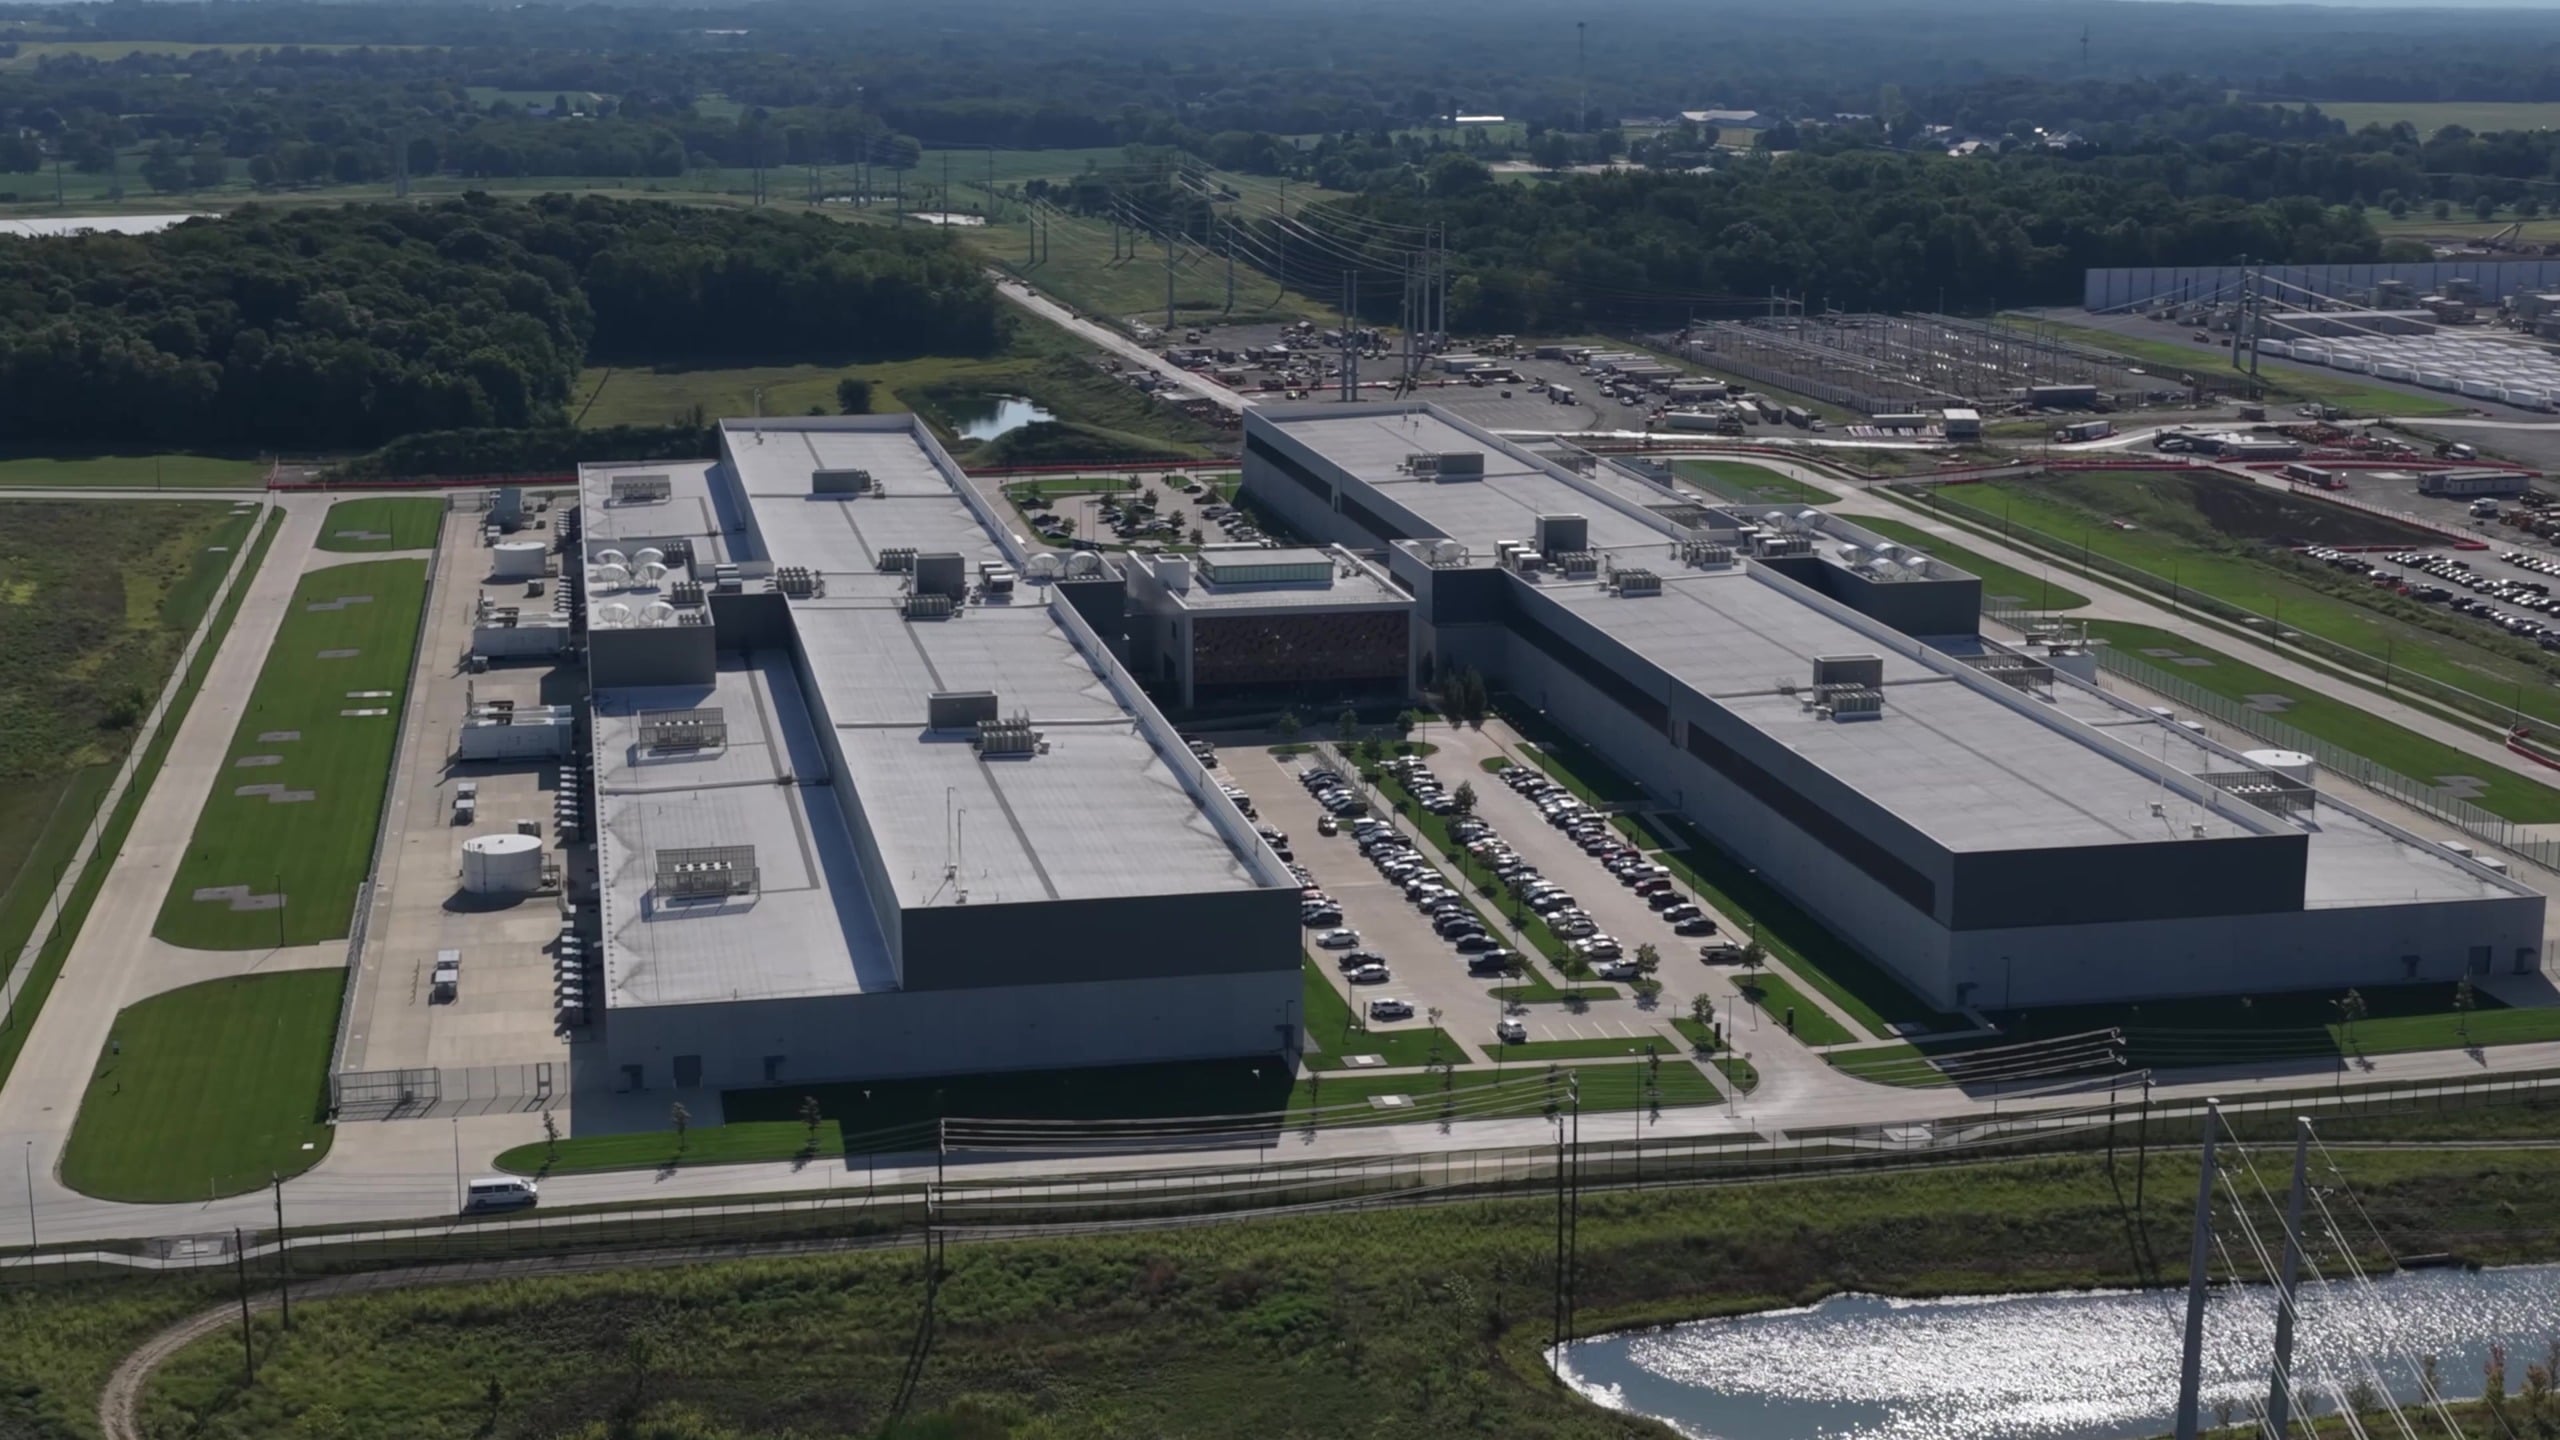
Meta veröffentlichte heute einen detaillierten Einblick in Prometheus, den Gigawatt-großen KI-Supercluster, den das Unternehmen in New Albany, Ohio, aufbaut. Die erste Phase ist abgeschlossen und hat die Muse-Familie von Basismodellen, einschließlich der Muse Wonder-Modelle, trainiert. Laut Meta wird der Standort auf etwa eine Million GPUs skaliert. Vor zwei Jahren war derselbe Campus ein herkömmliches Rechenzentrum, das Webverkehr abwickelte. Der Beitrag der Meta-Ingenieure Kevin Lee, Yashar Bayani, Ahmed Sharif und Yee Jiun Song beschreibt die Hardware, das Netzwerk und die Maßnahmen zur Gewährleistung der Zuverlässigkeit, die den reibungslosen Ablauf der Trainingsprozesse sicherstellen.
Meta hat außerdem einige der interessantesten Daten zum Ausführen umfangreicher Trainingsprozesse veröffentlicht: die Zuverlässigkeitswerte. Meta berichtet von über 85 Prozent gutem Durchsatz bei Muse Wonder-Vortrainingsläufen und über 90 Prozent bei Reinforcement-Learning-Läufen, mit einer mittleren Zeit zwischen Unterbrechungen (MTBI) von etwa 47,000 GPU-Stunden während dieser Läufe. Firmware-Updates haben die MTBI seitdem auf über 54,000 GPU-Stunden erhöht. Metas Zielvorgabe sind zwei Unterbrechungen pro 8,000 GPUs und Tag, was etwa 100,000 GPU-Stunden zwischen Unterbrechungen entspricht.
Zwei NVL72-Generationen in Produktion, Vera Rubin als Nächstes
Prometheus nutzt aktuell zwei NVIDIA-GPU-Plattformen, beide basierend auf der NVL72-Rackarchitektur, bei der sich 72 GPUs eine NVLink-Domäne teilen. Eine dritte Plattform, basierend auf Vera Rubin NVL72, wird in Kürze verfügbar sein. Die erste, von Meta als Catalina bezeichnet, verwendet die GB200 NVL72 in der Ariel-Variante: eine Zwei-Rack-Konfiguration mit 36 GPUs pro Rack, basierend auf Metas Open Rack V3-Hochleistungs-Rackdesign, das zum Open Compute Project beigetragen hat. Jede Blackwell-GPU ist mit einer Grace-CPU und zwei ConnectX-7 400G-Netzwerkkarten gekoppelt – ein CPU-zu-GPU-Verhältnis von 1:1, das jeder GPU eine Scale-Out-Bandbreite von 800 Gbit/s bietet.
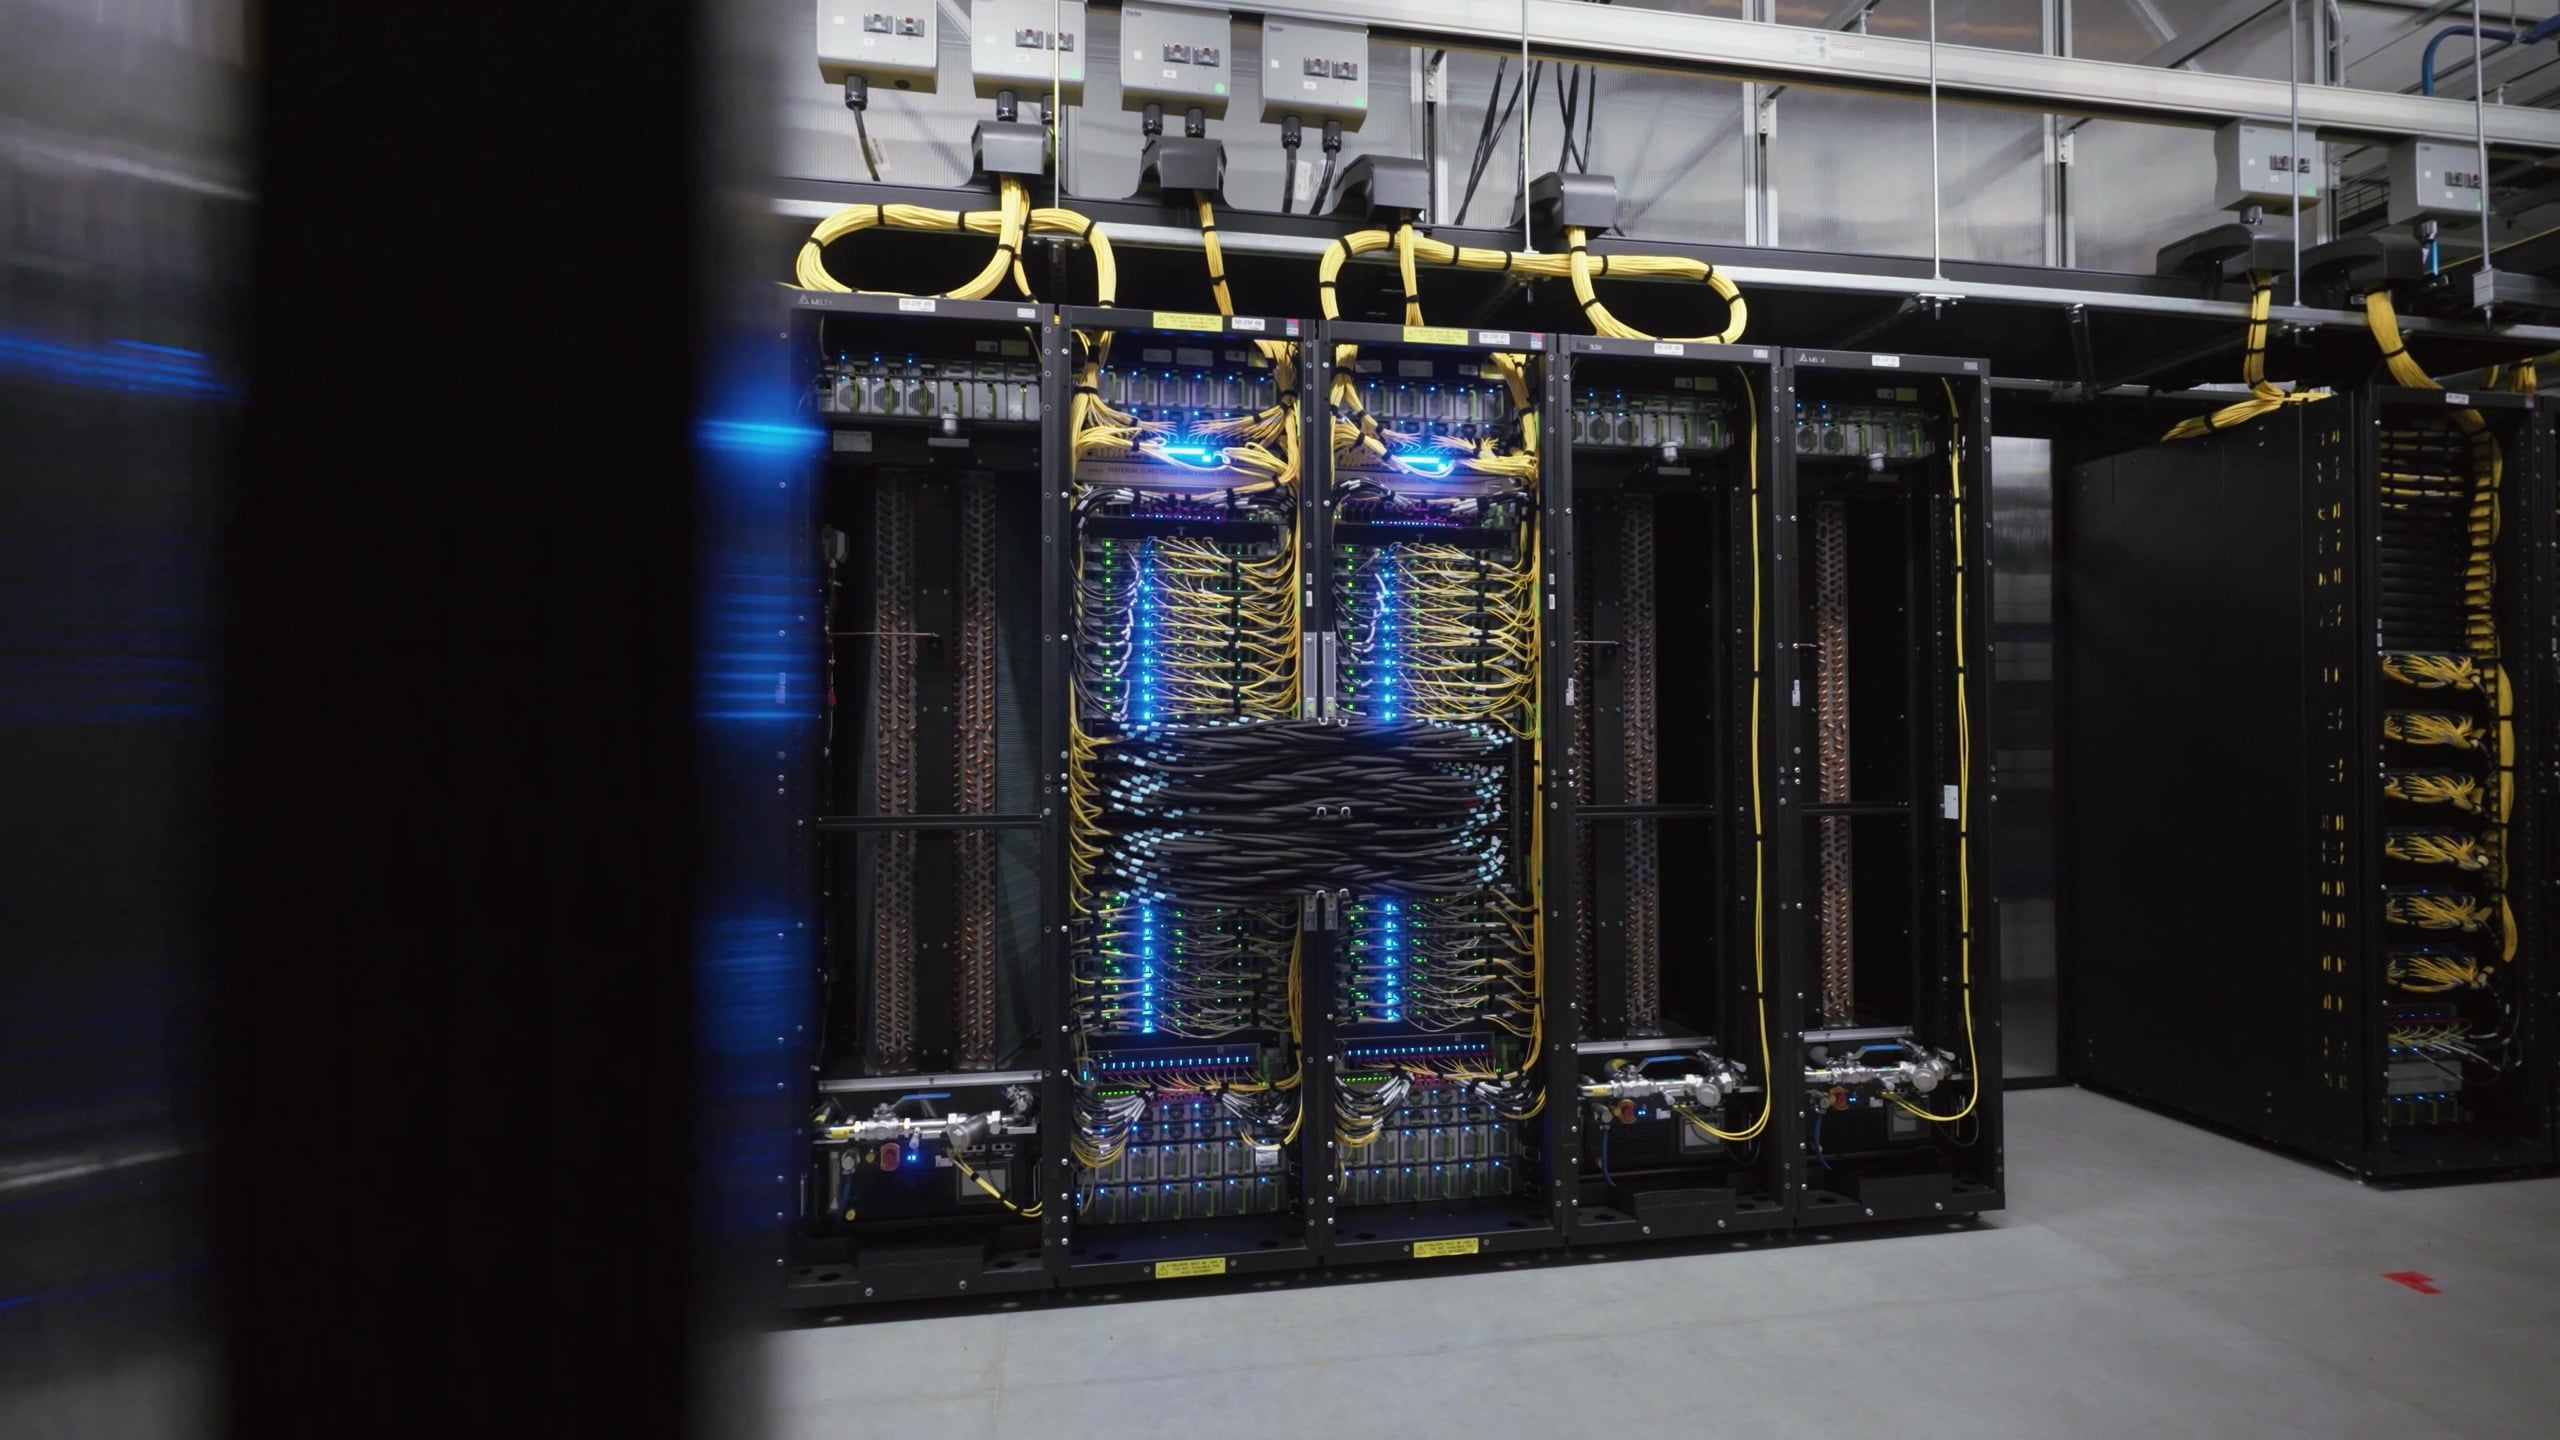
Meta begründet die Wahl von Ariel damit, dass die GB200 NVL72 FLOPS, HBM-Bandbreite, Scale-up-Bandbreite und Domänengröße deutlich über die der H100 hinaus skalieren, während die Standard-Scale-out-Option bei 400 GB pro GPU geblieben wäre. Meta erwartete, dass dieses Ungleichgewicht die Leistung beeinträchtigen würde. Laut Meta verfügt ein Catalina-Paar über 72 Blackwell-GPUs mit 13.4 TB HBM3e (192 GB pro GPU), 720 PFLOPS Spitzenleistung im FP8-Training (1,440 PFLOPS im FP4-Modus), 130 TB/s NVLink-Bandbreite innerhalb der Domäne, 576 TB/s aggregierte Speicherbandbreite und einen Stromverbrauch von ca. 120 kW über die beiden Racks.
Die zweite Plattform, Clemente, wechselt zum GB300 NVL72. Der HBM-Speicher pro GPU steigt um das 1.5-Fache auf 288 GB, der FP4-Durchsatz erhöht sich um einen ähnlichen Faktor, und die Aufmerksamkeitsbeschleunigung verdoppelt sich annähernd. ConnectX-8 SuperNICs liefern nativ 800 Gbit/s pro GPU, sodass die von Meta in Ariel integrierte Skalierbarkeit als Basis dient. Dank eines GPU-zu-CPU-Verhältnisses von 2:1 passt die gesamte 72-GPU-Domäne in ein einzelnes Rack. Meta gibt 20.7 TB HBM3e, mehr als ein ExaFLOP Spitzen-FP4-Rechenleistung, 130 TB/s NVLink-Bandbreite (1.8 TB/s bidirektional pro GPU), etwa 135 kW pro Rack und einen Leistungszuwachs von 5 bis 10 Prozent gegenüber dem GB200 NVL72 an.
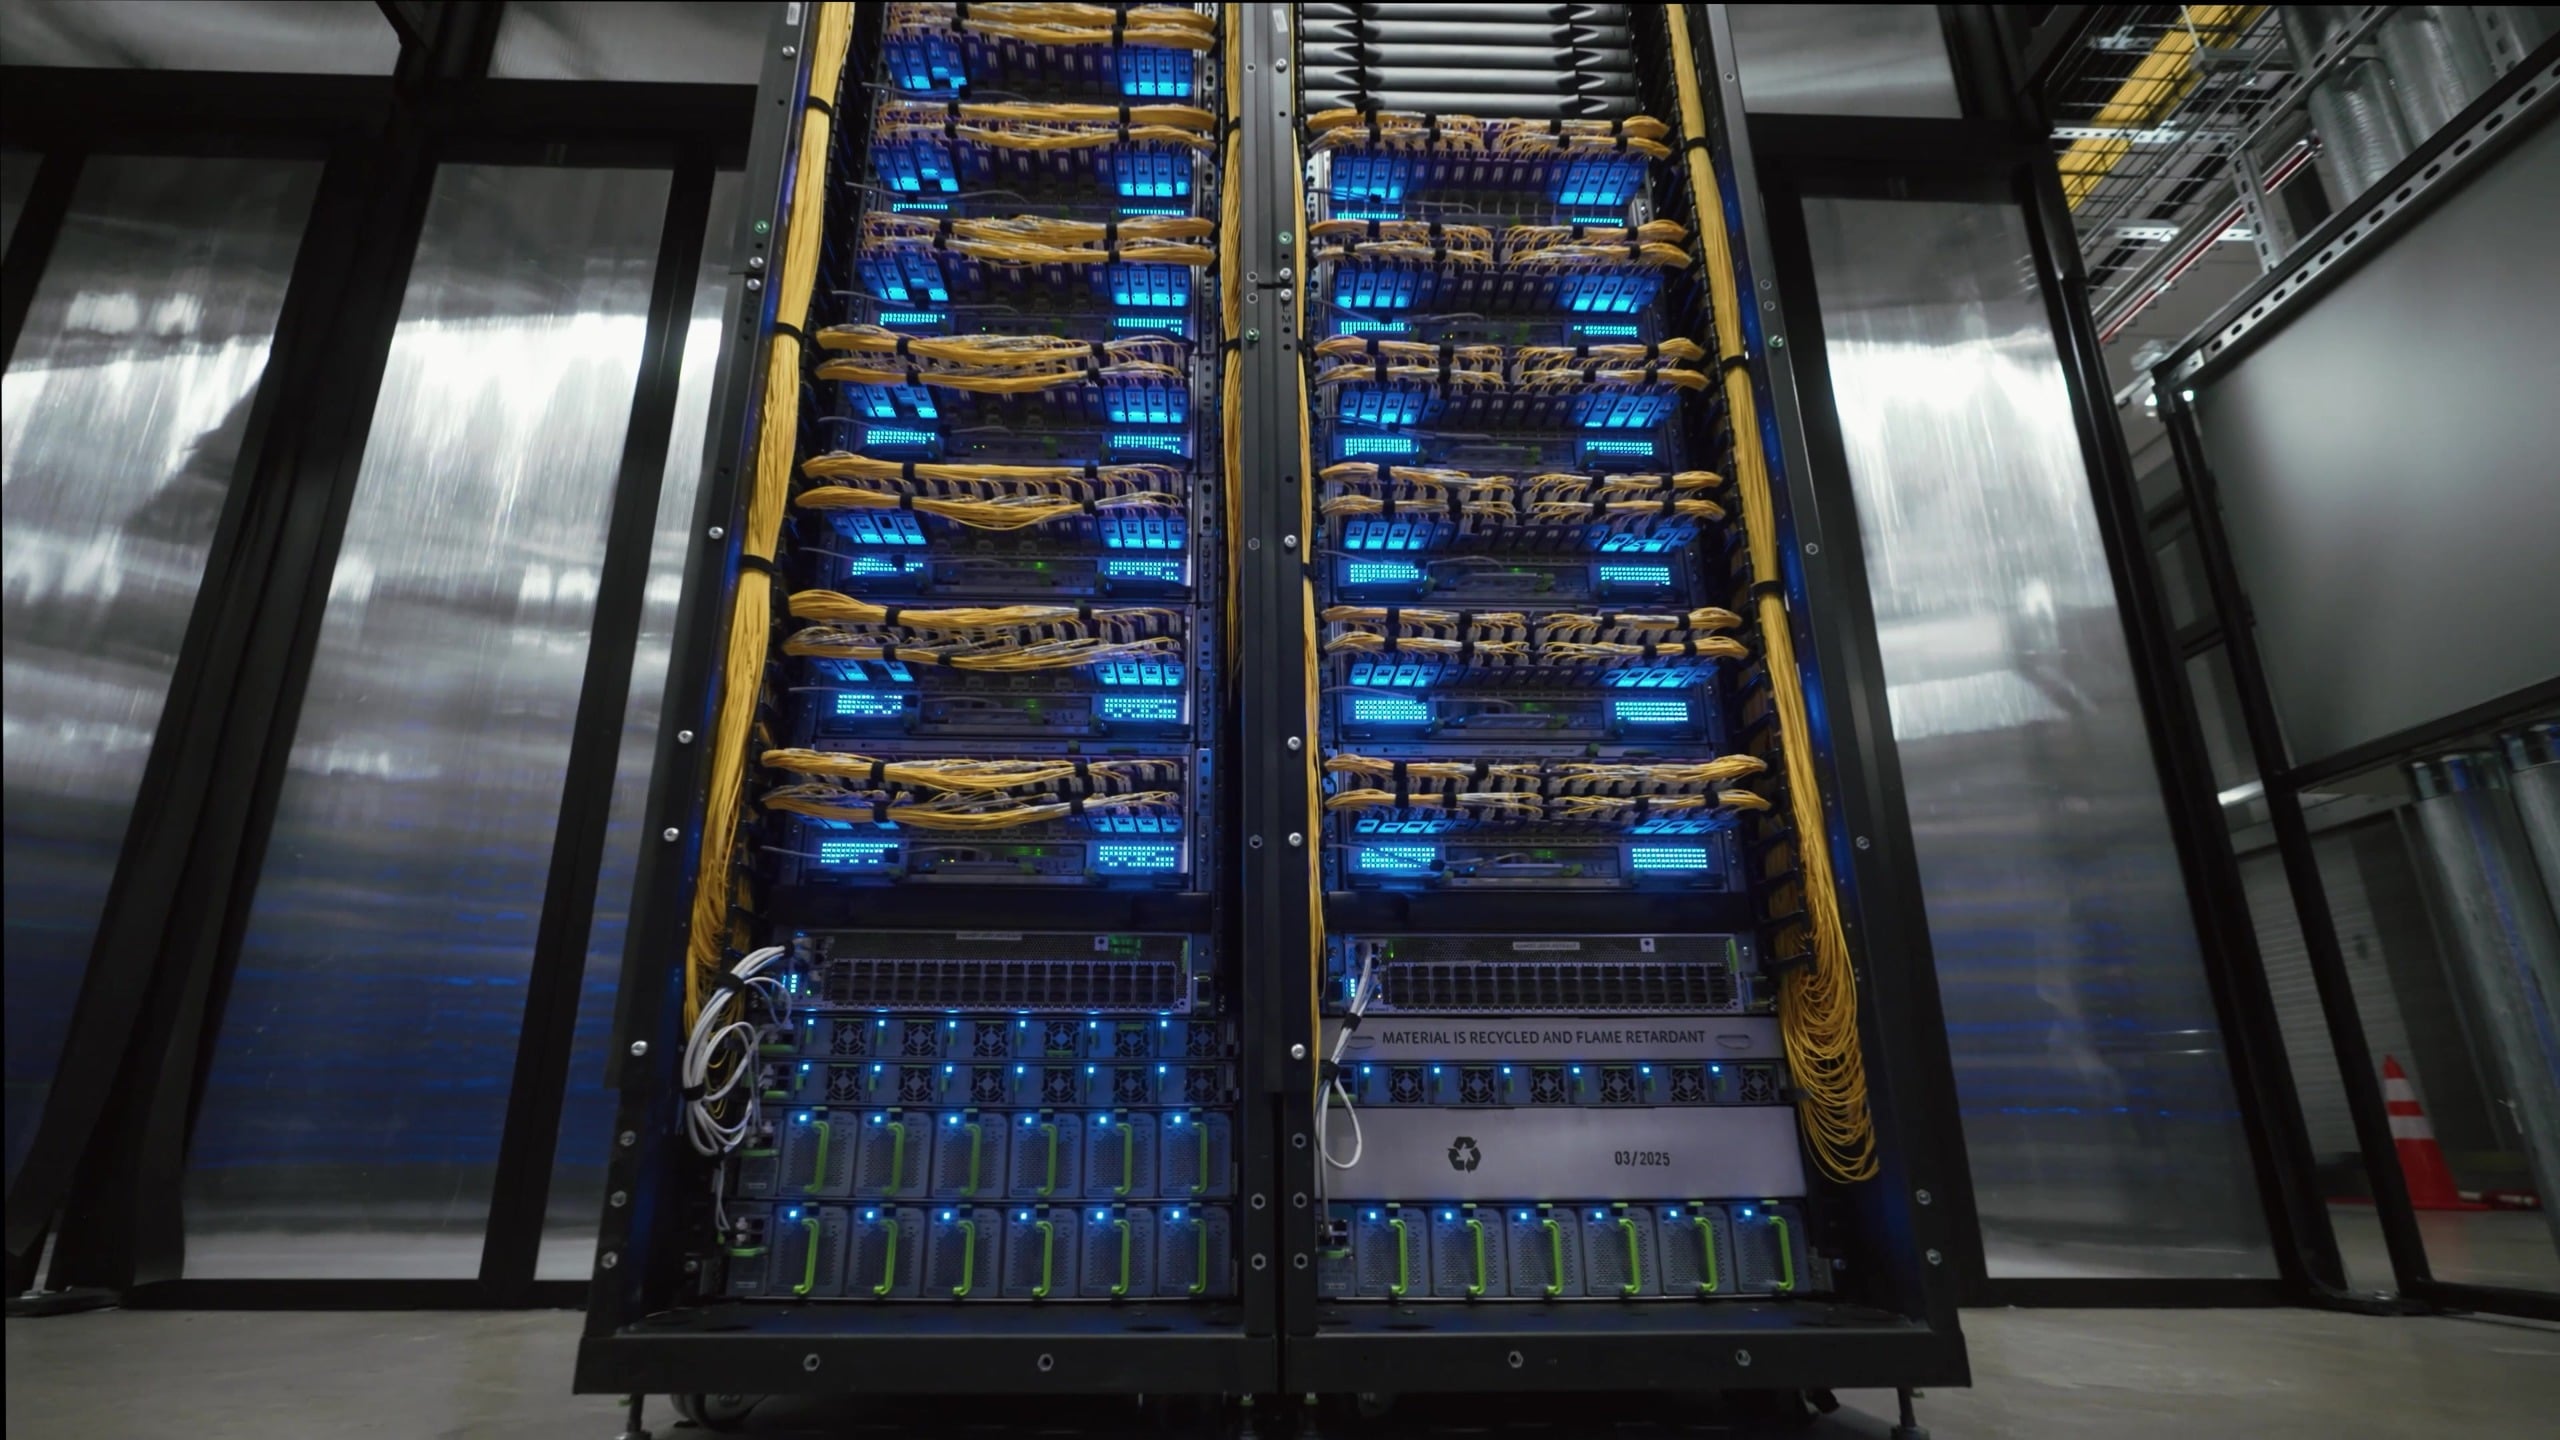
Clemente setzt in seinen neueren, KI-optimierten Gebäuden entweder auf die modulare, luftunterstützte Flüssigkeitskühlung von Meta oder auf die anlageneigene Flüssigkeitskühlung. Meta gibt an, dass sich die Wartungsfreundlichkeit durch die geringere Verkabelung verbessert.
Metas nächste Plattform, San Miguel, integriert Vera Rubin NVL72 in dasselbe Netzwerk-Fabric. Laut Meta bietet dieses Rack 288 GB HBM4-Speicher pro GPU mit 19.2 TB/s, eine Spitzenleistung von 2.52 ExaFLOPS bei FP4-Trainingsberechnungen und 1.26 ExaFLOPS bei FP8, 216 TB/s NVLink-Bandbreite (3 TB/s pro GPU), ca. 1,500 TB/s Gesamtspeicherbandbreite, vollständig flüssigkeitsgekühlte Recheneinschübe mit über 170 kW pro Rack und eine um 10 bis 20 Prozent höhere Leistung pro Watt gegenüber der GB300 NVL72. CoreWeave hat Vera Rubin NVL72 Anfang dieses Monats in Produktion genommen.
Ein dediziertes Ethernet-Backend, das sich über mehrere Gebäude erstreckt
Der Trainingsdatenverkehr läuft über ein zweites, vom regulären Service-Datenverkehr getrenntes Rechenzentrumsnetzwerk via Ethernet. Das Design orientiert sich an der Struktur eines Trainingsprozesses: Datenparallele Replikate halten ihre latenzempfindlichen, bandbreitenintensiven Kollektive innerhalb eines Gebäudekomplexes, während der weniger tolerante Datenverkehr zwischen den Replikaten eine Aggregationsschicht durchläuft, die die Gebäude miteinander verbindet. Meta nutzte dieselbe Hierarchie bereits für seine früheren, gebäudeskaligen Cluster mit 24,000 GPUs und seinen regionalen Cluster mit über 100,000 GPUs, bevor sie auf Prometheus erweitert wurde.
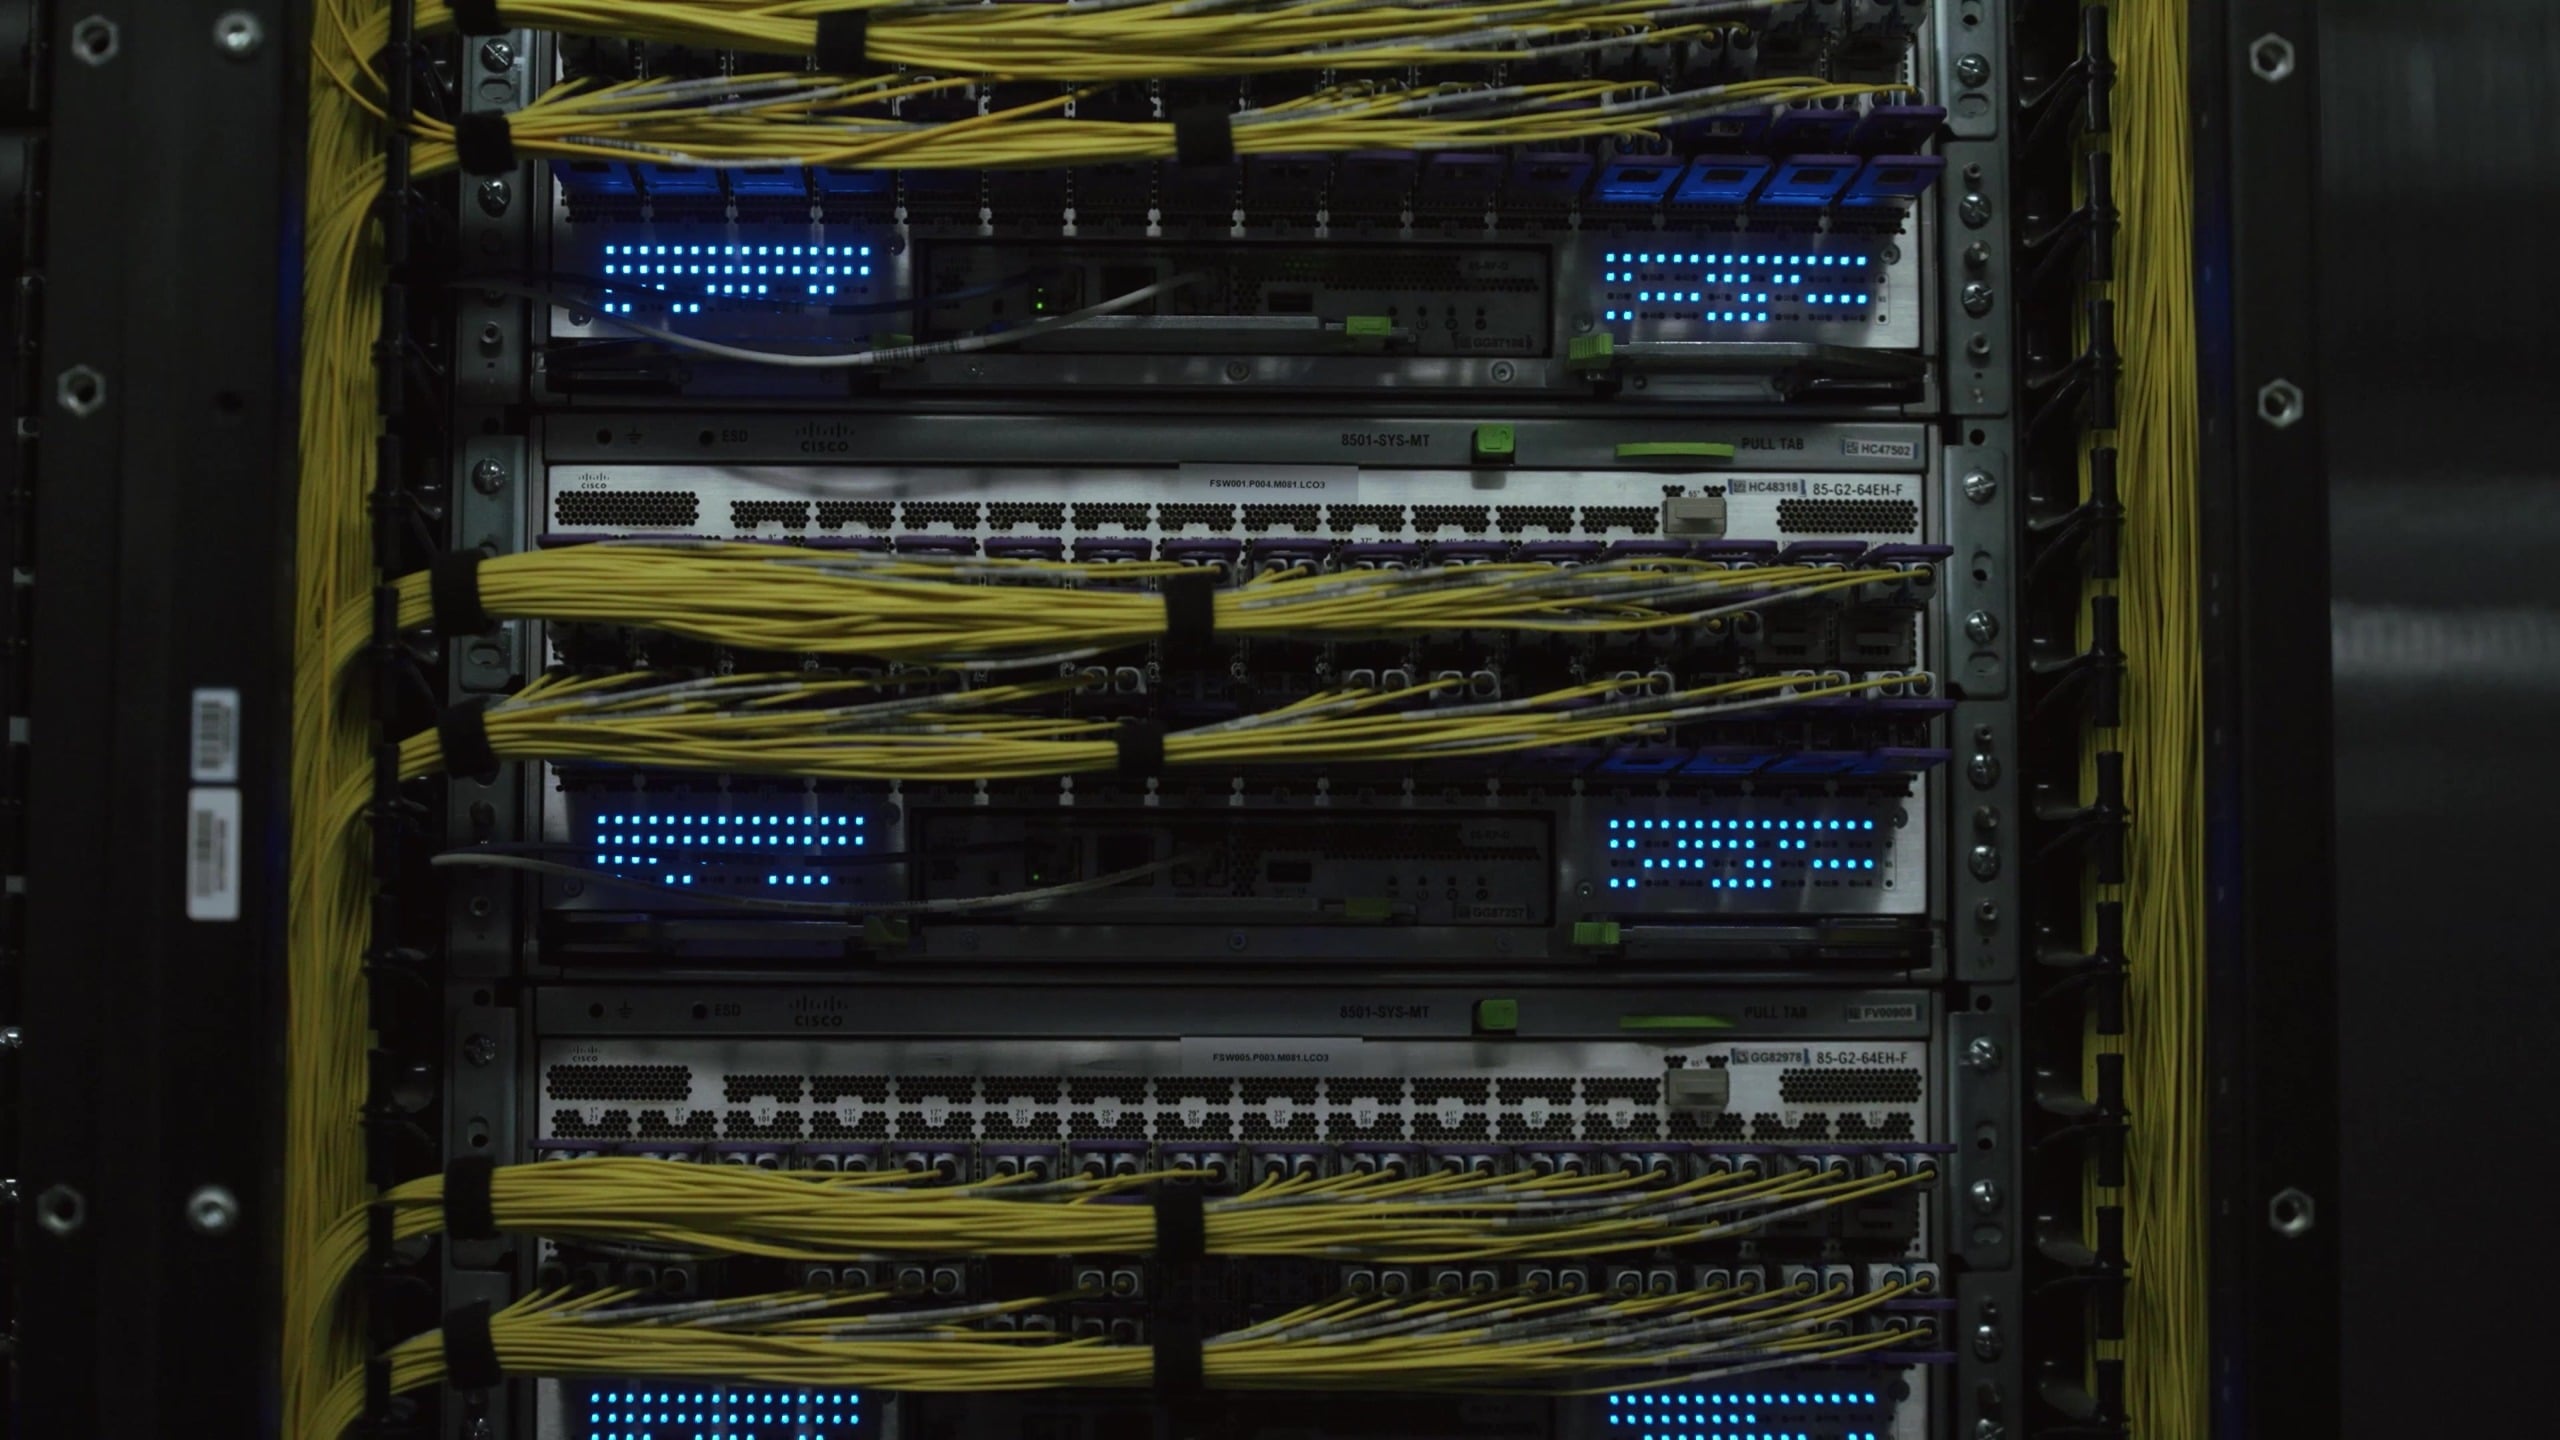
Jedes Gebäudenetzwerk verbindet bis zu 20,736 GPUs. Metas erster Entwurf war ein disaggregiertes, geplantes Netzwerk, das Subpaket-Mehrwege-Routing, interne Paketumordnung, virtuelle Ausgabewarteschlangen und kreditbasierte Flusssteuerung nutzte, um Kollisionen der wenigen großen, langlebigen Datenströme eines Trainingskollektivs zu verhindern. Mit der Einführung der Möglichkeit, Pakete am Endpunkt neu anzuordnen, wechselte Meta zu einem nicht geplanten Netzwerk, das auf flachen 51.2T-Switches basiert: Minipack3 mit dynamischem Lastausgleich und Minipack3N, das den NVIDIA Spectrum-4 ASIC mit adaptivem Routing auf ConnectX-Netzwerkkarten verwendet. Beide nutzen Metas FBOSS-Netzwerkstack.
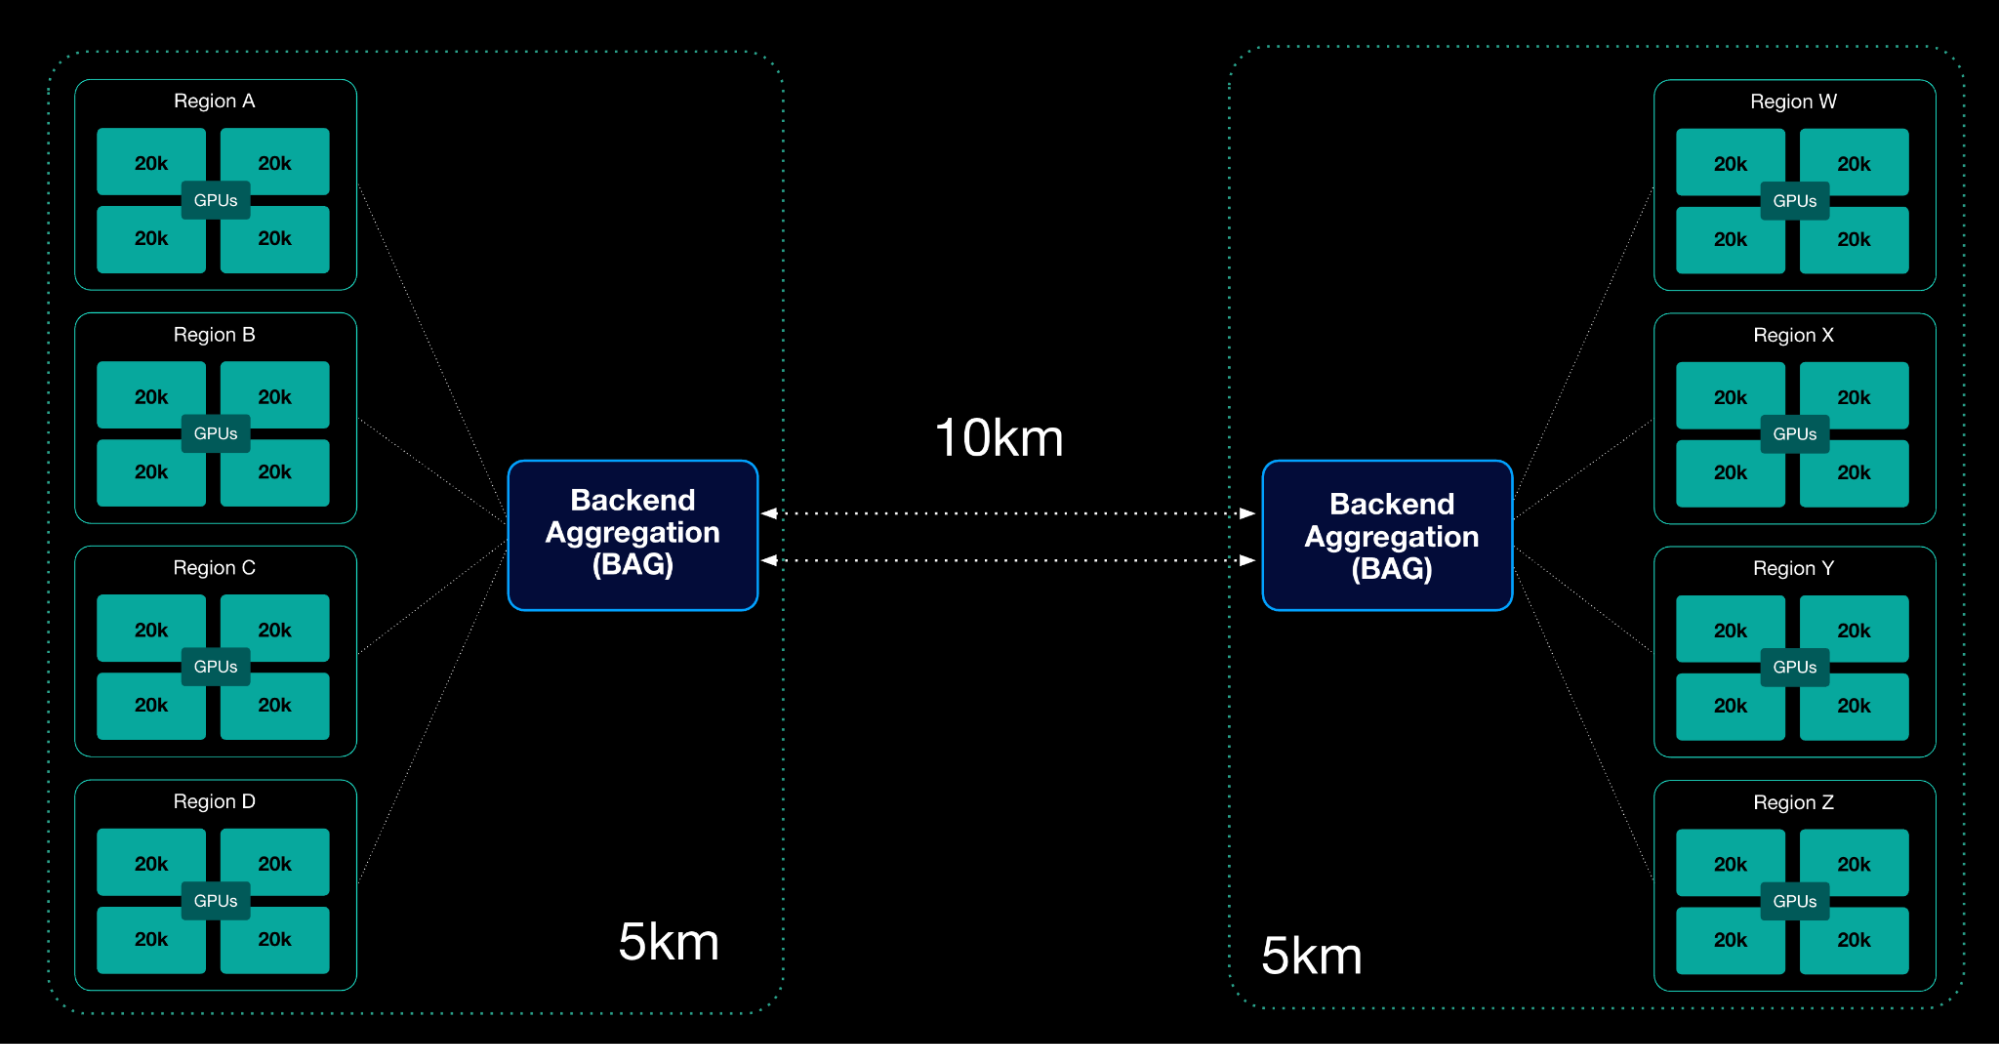
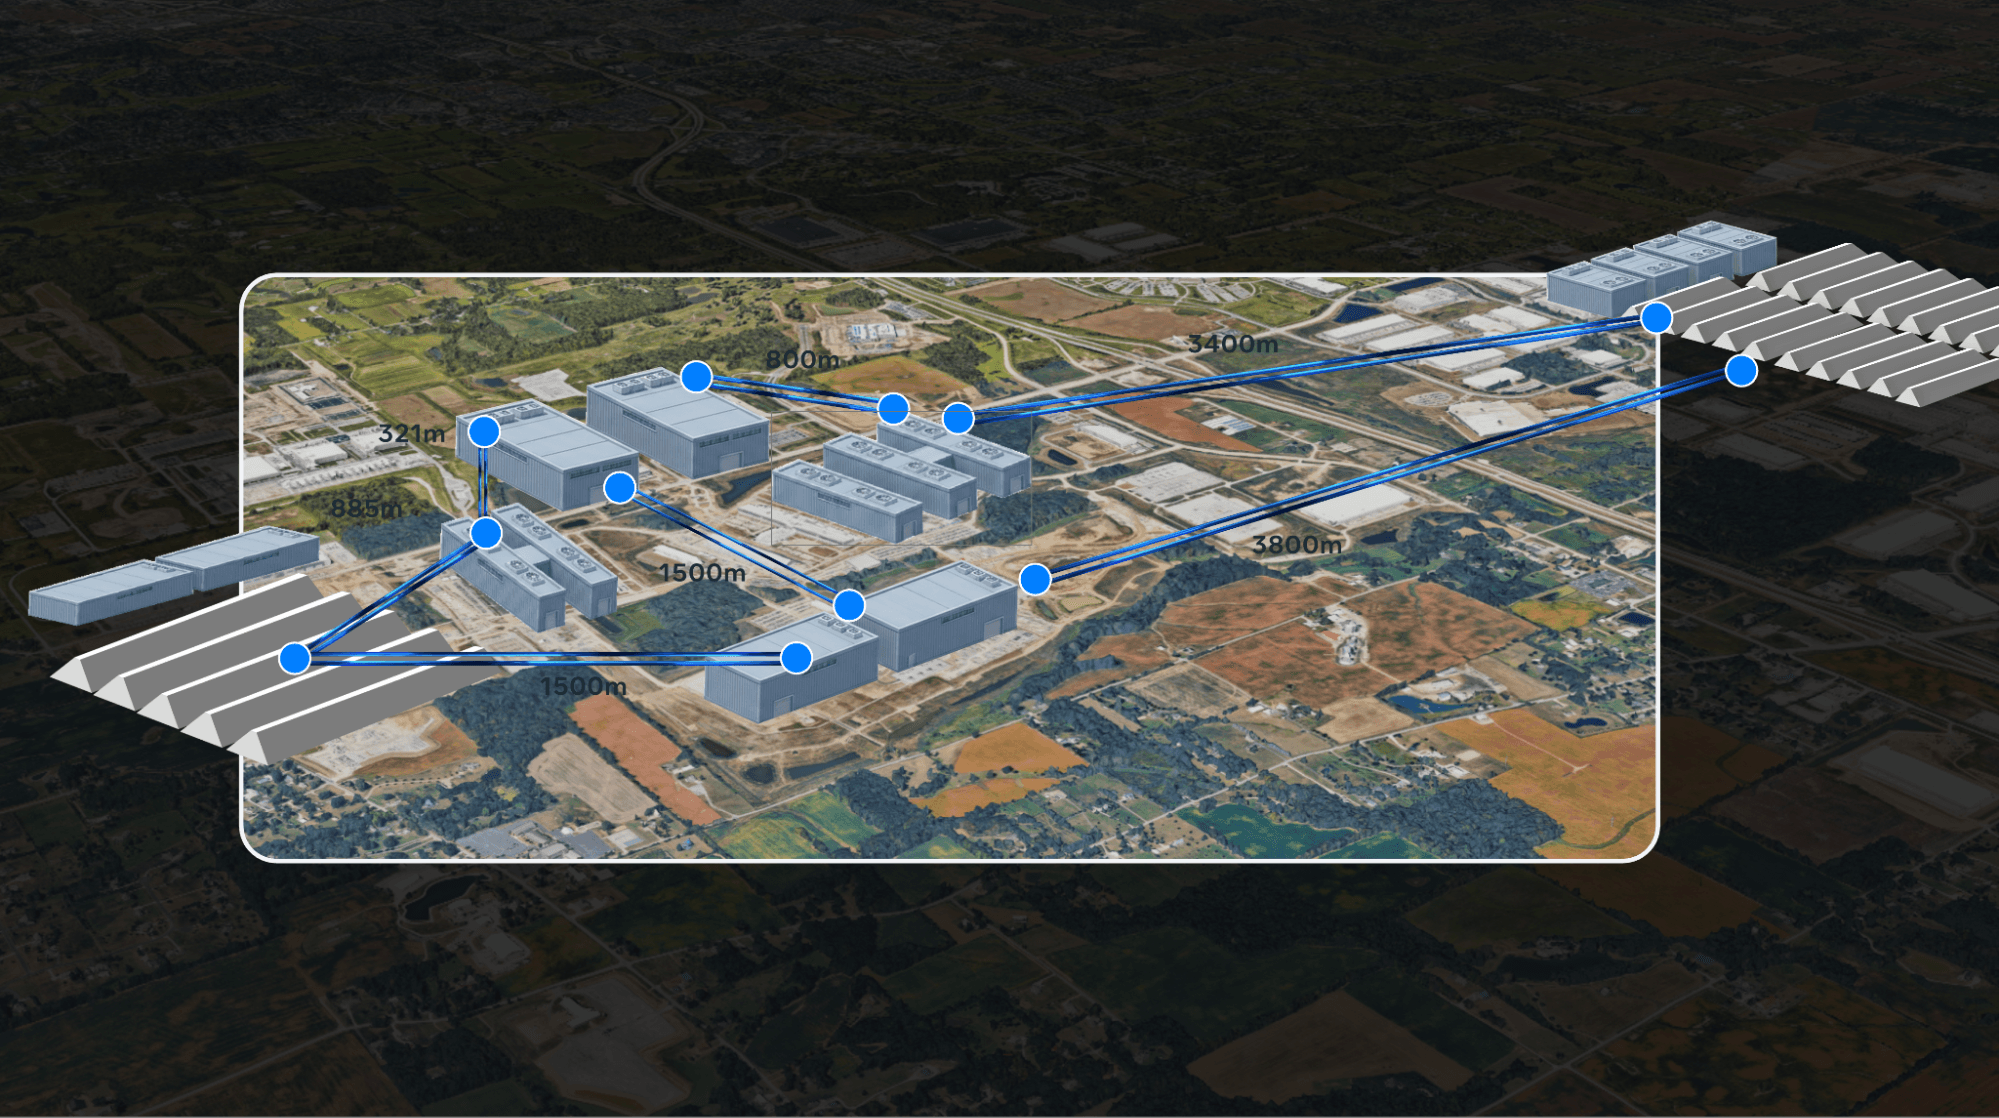
Über den Gebäuden befindet sich das Backend-Aggregationsnetzwerk, eine mehrschichtige Hub-and-Spoke-Architektur auf Basis von Arista-7800-Chassis mit Broadcom Jericho3-Chips mit großem Puffer. Es erstreckt sich über Entfernungen von 2 km bis über 100 km und ermöglicht Datenraten von mehreren Petabit pro Sekunde zwischen den Regionen. Laut Meta erforderte das Vortraining über diese Distanzen aufgrund der extremen Latenzzeiten einen erheblichen Optimierungsaufwand in Zusammenarbeit mit den Meta Superintelligence Labs. Die dahinterliegende Infrastruktur umfasst Millionen Kilometer Glasfaserkabel, Zehntausende Switches und Millionen von optischen Komponenten – von 2x400G FR4 LITE-Steckdosen in Gebäuden bis hin zu kohärenten 800G-ZR-Optiken für Verbindungen über mehr als etwa 10 km.
64 von 72 GPUs erledigen die Arbeit.
Der Wechsel von der NVLink-Domäne mit acht GPUs der H100-Generation zu NVL72 hat das Ausfallrisiko verneunfacht, weshalb Meta die Kapazität nun auf das 72-GPU-Rack ausrichtet. Da sich Trainingsparallelität am besten auf Zweierpotenz-Gruppengrößen abbilden lässt, betreibt jede NVL72-Domäne einen 64-GPU-Slice und hält die restlichen acht GPUs als Reserve im Rack bereit. Fällt eine GPU aus, übernimmt eine Ersatz-GPU, und der Job wird vom letzten Prüfpunkt neu gestartet, ohne auf eine Reparatur warten zu müssen. Für den Fall eines vollständigen Rack-Ausfalls hält Meta zusätzlich etwa 2 Prozent Racks als Reserve bereit.
Für einen Trainingslauf mit 32,768 GPUs werden 523 NVL72-Racks bzw. 37,656 GPUs benötigt, was etwa 13 Prozent über der aktiven Auslastung liegt. Davon entfallen 11 Prozentpunkte auf die 64-von-72-Slice-Geometrie. Die Anforderungen an die Signalintegrität, die diese Zuverlässigkeit gewährleisten, sind beträchtlich: Eine einzelne NVL72-Domäne überträgt 5,184 optimierte Differenzialpaare mit 200 Gbit/s, die jeweils GPU-SerDes, Rechenplatinen, Kabelkassetten und Switch-Schnittstellen kreuzen.
Zwei Wiederherstellungspfade behandeln auftretende Fehler. Lässt sich ein Fehler auf eine datenparallele Replik eingrenzen, nimmt Metas parallelitätsbewusste Fehlertoleranz diese Replik offline, während der Rest des Clusters den Schritt wiederholt und das Training fortsetzt. Der betroffene Bereich wird auf Ersatzhosts neu gestartet und resynchronisiert. Größere Fehler setzen den gesamten Job auf den letzten Checkpoint zurück. Daher erstellt Meta häufig Checkpoints und speichert den Modellzustand, einschließlich Gradienten und Optimierungsdaten, asynchron in einem mehrstufigen Speicher mit Delta-Checkpointing und In-Memory-Staging, um die Auswirkungen auf den Durchsatz zu minimieren.
Ein Rückgang der Unterbrechungen um 99 Prozent
Trotz aller Fortschritte, die diese Zahlen belegen, war Prometheus anfangs nicht stabil. Mitte 2025, in der Anfangsphase, erreichten die Unterbrechungsraten einen Höchststand von fast 1,000 Ereignissen pro 8,000 GPUs und Tag. Nach einem Jahr funktionsübergreifender Zusammenarbeit konnte diese Rate um 99 Prozent gesenkt werden, und der Cluster bewältigt nun parallel mehrere Trainingsprozesse mit jeweils Zehntausenden von GPUs. Meta führt dies auf ein gemeinsames Entwicklungsmodell mit NVIDIA zurück, bei dem NVIDIA-Teams am Standort New Albany arbeiten, Telemetriedaten austauschen und in gemeinsamen Triage-Sitzungen jede Unterbrechung nach ihrer Ursache analysieren. Meta ist dabei für die Planung und die Behebung von Infrastrukturproblemen zuständig, während NVIDIA Firmware, Signaldiagnostik und Speicherverwaltung übernimmt.
Die NVLink-Signalintegrität war der erste Engpass bei GB200. Bei über 600,000 NVLink-Verbindungen im Cluster führten schwache Verbindungen zu häufigen Wiederherstellungszyklen. Daher implementierte Meta kontinuierliche Telemetrie, automatische Kennzeichnung und L11-Diagnosetests, um Schwachstellen vor der Produktion zu identifizieren. Speicherfehler in HBM und LPDDR wurden mit dem größeren Speicher von GB300 zur Hauptursache. Die Reaktion darauf umfasste optimierte HBM-Firmware-Einstellungen, Speicherbereinigung, einen verbesserten LPDDR-Fehlerkorrekturalgorithmus und die vorausschauende Außerbetriebnahme von Geräten mit Leistungsabfall. Der Zustand der Switches wird im Millisekundenbereich überwacht, und Verbindungsereignisse in der Aggregationsschicht werden hardwareseitig umgeleitet, ohne den GPU-Datenverkehr zu unterbrechen.
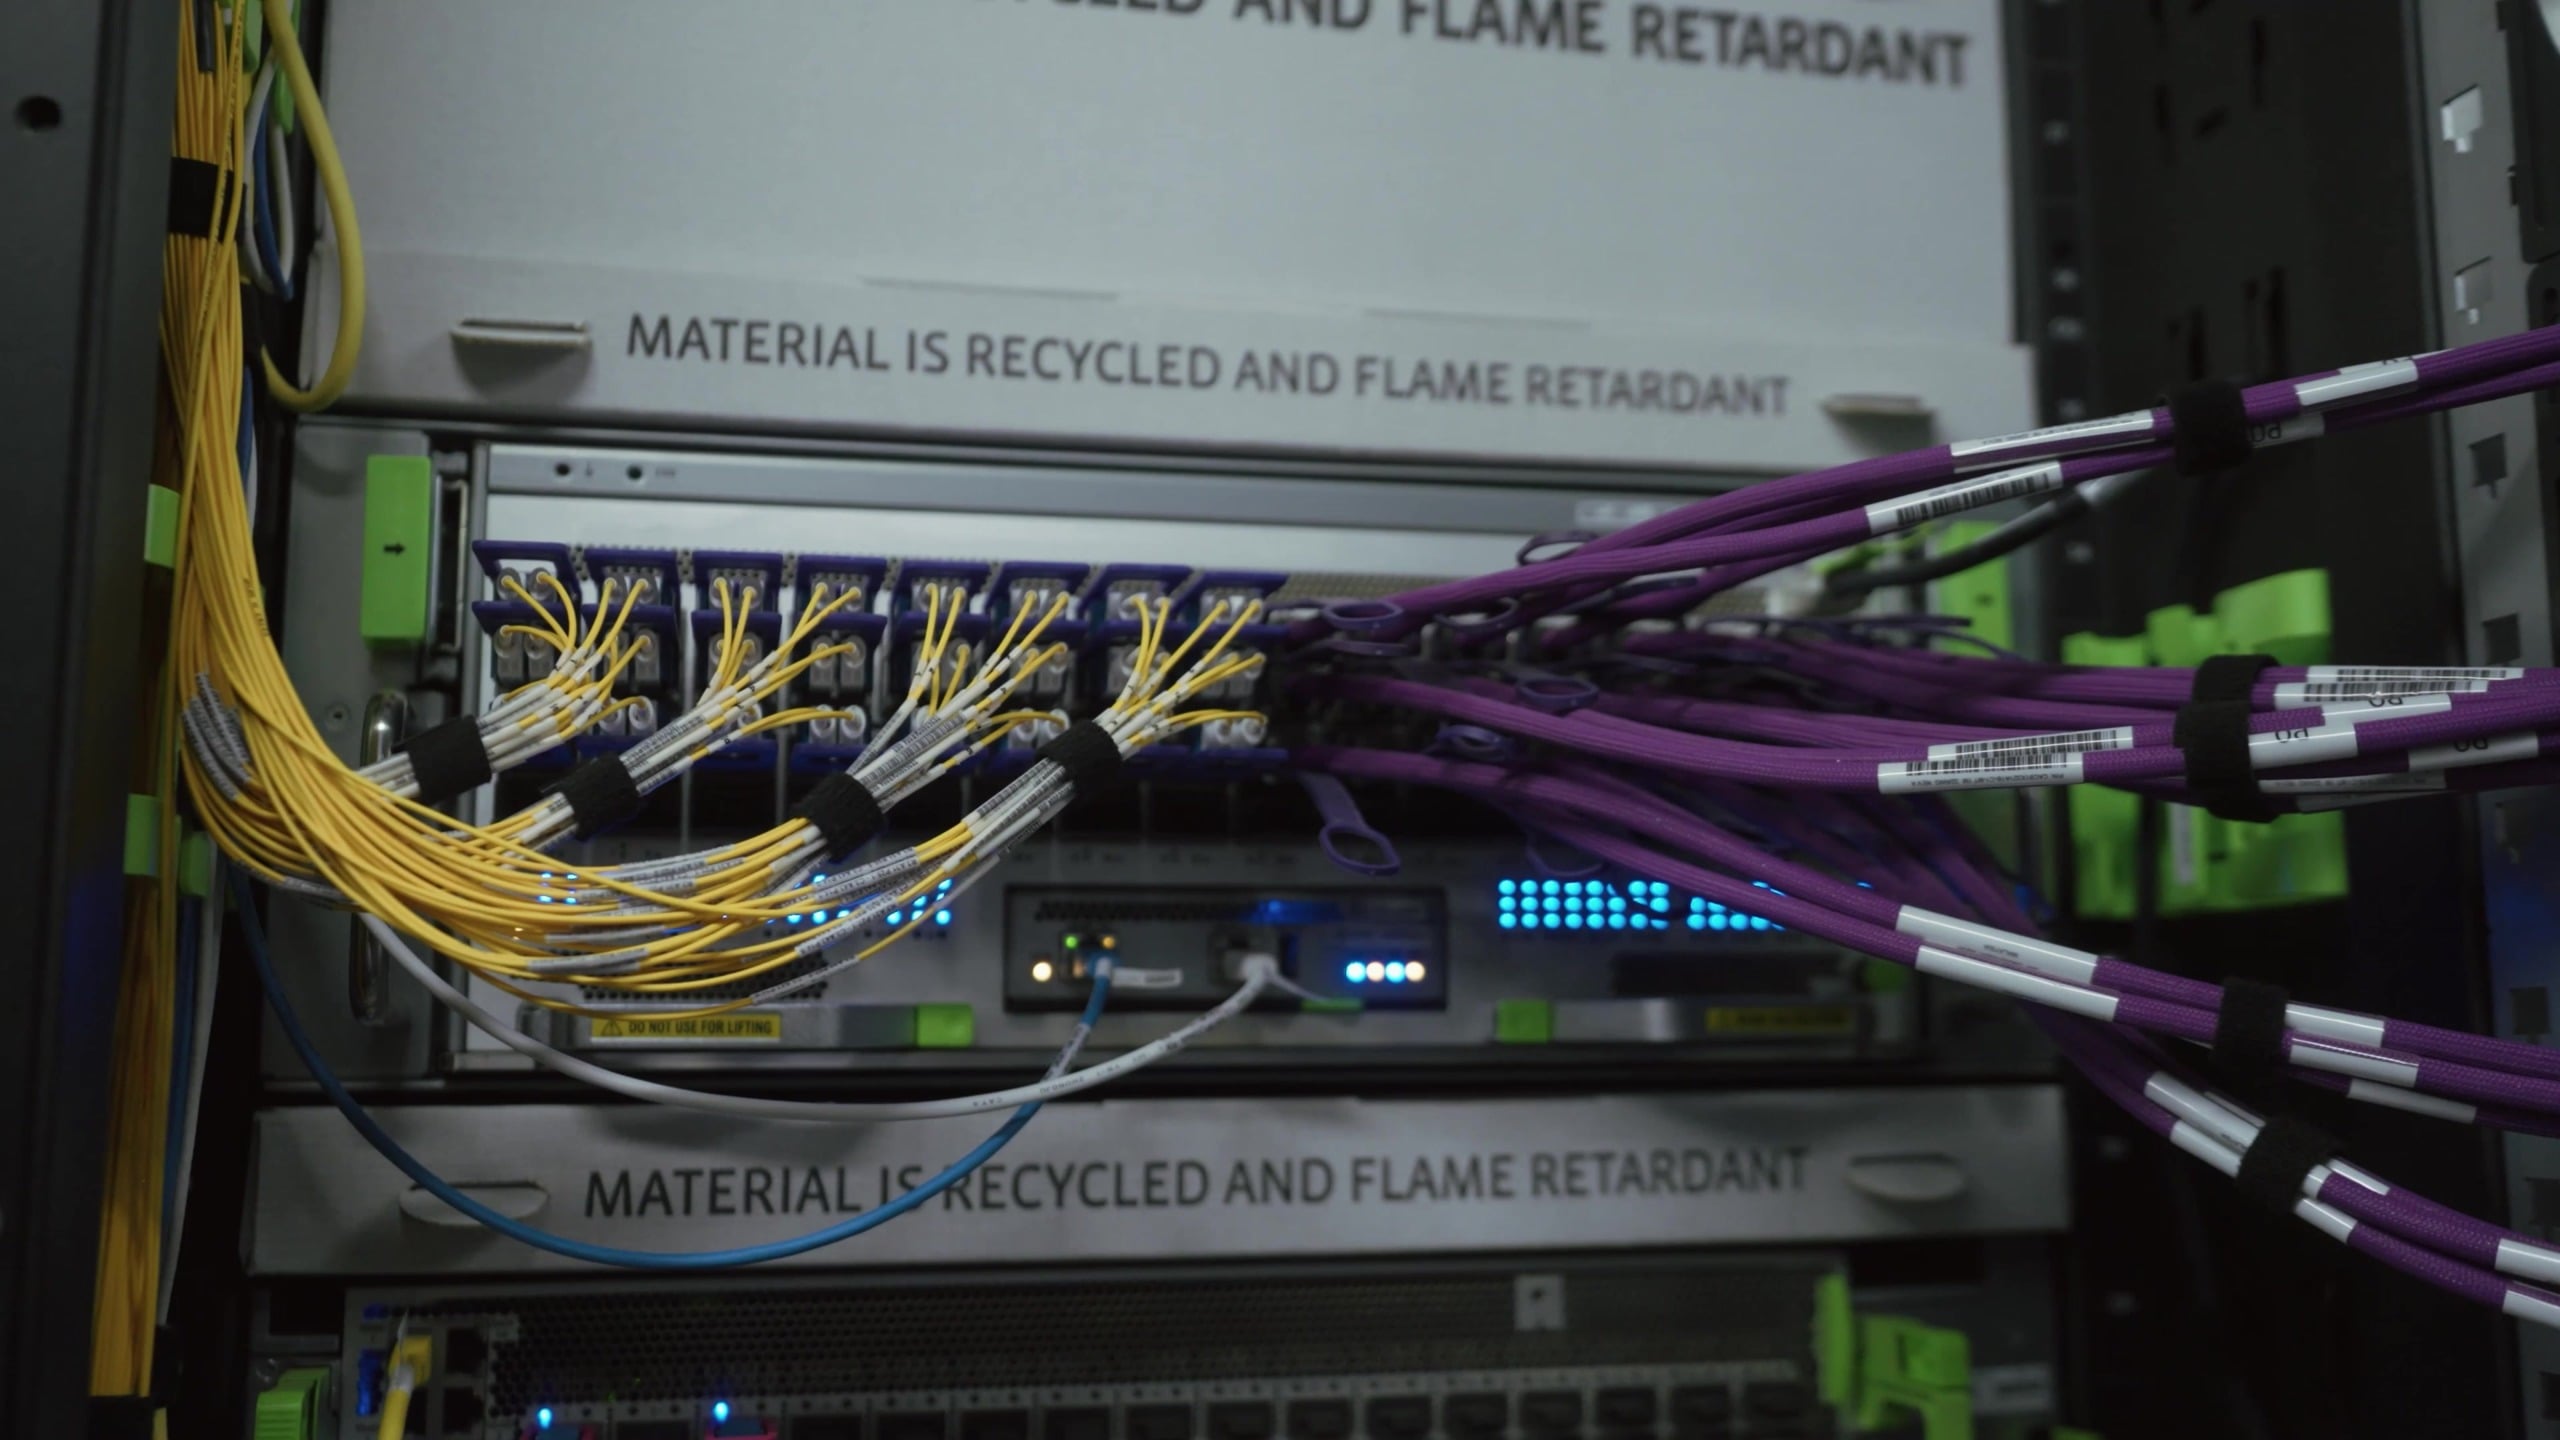
Der Betrieb Hunderttausender Beschleuniger der ersten Generation machte die Hardwareentwicklung zu einer eigenen Disziplin. Metas Firmware-Automatisierung kann Treiber- und Firmware-Korrekturen innerhalb weniger Stunden auf über 100,000 GPUs verteilen, und die Aktualisierungszeit für einen einzelnen Pod des P90 sank von über sieben Stunden zu Beginn der GB200-Einführung auf zwei Stunden. Stresstests der Stromversorgung untersuchen das Verhalten von Netzteilmodulen und Spannungsreglern unter der 1,400-Watt-Last einer einzelnen GPU, und jedes reparierte System wird bis zum erfolgreichen Abschluss der Validierung unter Quarantäne gestellt. Metas Stabilitäts-Sprint im März synchronisierte Korrekturen über den gesamten Stack hinweg.
Leistungstransienten und eine gemischte Kühlflotte
Synchrones Training verschiebt die Leistungsaufnahme synchron, und Zehntausende von GPUs, die gleichzeitig in eine Rechen- oder Kommunikationsphase eintreten, können die Clusterlast um 30 bis 40 Prozent verändern. Das Starten oder Pausieren eines großen Jobs kann innerhalb von Sekunden mehrere zehn Megawatt an Leistung verschieben. Dynamo Dimmer, Metas clusterweites Energiemanagement-Framework, begrenzt die GPU-Leistung schrittweise, sobald der Cluster seine maximale elektrische Kapazität erreicht, um die Ausführung der Jobs zu gewährleisten. Akku-Backup-Module auf Rack-Ebene absorbieren Lastspitzen, Kondensatorträger glätten Lastspitzen, dahinter befindet sich ein Batteriespeicher im Anlagenmaßstab, und Meta stimmt das Lastprofil mit den Energieversorgern ab.
Die Kühlung variiert je nach Gebäude, da Prometheus innerhalb kürzester Zeit in verschiedenen Rechenzentren (ohne Klimaanlage), flexiblen Installationsstrukturen, angemieteten Kapazitäten und einem eigens dafür errichteten KI-Gebäude aufgebaut wurde. Die älteren Räumlichkeiten nutzen modulare, luftunterstützte Flüssigkeitskühlung; das KI-optimierte Gebäude verwendet eine geschlossene Flüssigkeitskühlung, die laut Meta die effizienteste und wassersparendste Methode zur Kühlung von GPU-Servern darstellt. Meta hat Designs wie IcePack, sein flüssigkeitsgekühltes Netzwerk-Rack, über OCP geteilt. Einen Einblick in die Funktionsweise einer deutlich kleineren, flüssigkeitsgekühlten GB300 NVL72-Installation bietet der Testaufbau von Giga Computing (GAIFA).
Als nächstes kommt Hyperion.
Meta wird Prometheus mit einer Kombination aus GB300 NVL72- und Vera Rubin NVL72-Racks weiter ausbauen, wobei Vera Rubin über die San Miguel-Plattform in die bestehende Netzwerkarchitektur integriert wird. Die Erfahrungen aus New Albany fließen in Hyperion ein, den Supercluster, den Meta in Richland Parish, Louisiana, von Grund auf neu entwickelt. Dieser verfügt über eine geschlossene Flüssigkeitskühlung, vollständige Netzanbindung über Entergy und Netzwerkarchitekturen der nächsten Generation. Meta gibt an, die gesamten Energiekosten an beiden Standorten zu tragen und den Eigenverbrauch durch neue, saubere und erneuerbare Energiequellen auszugleichen.
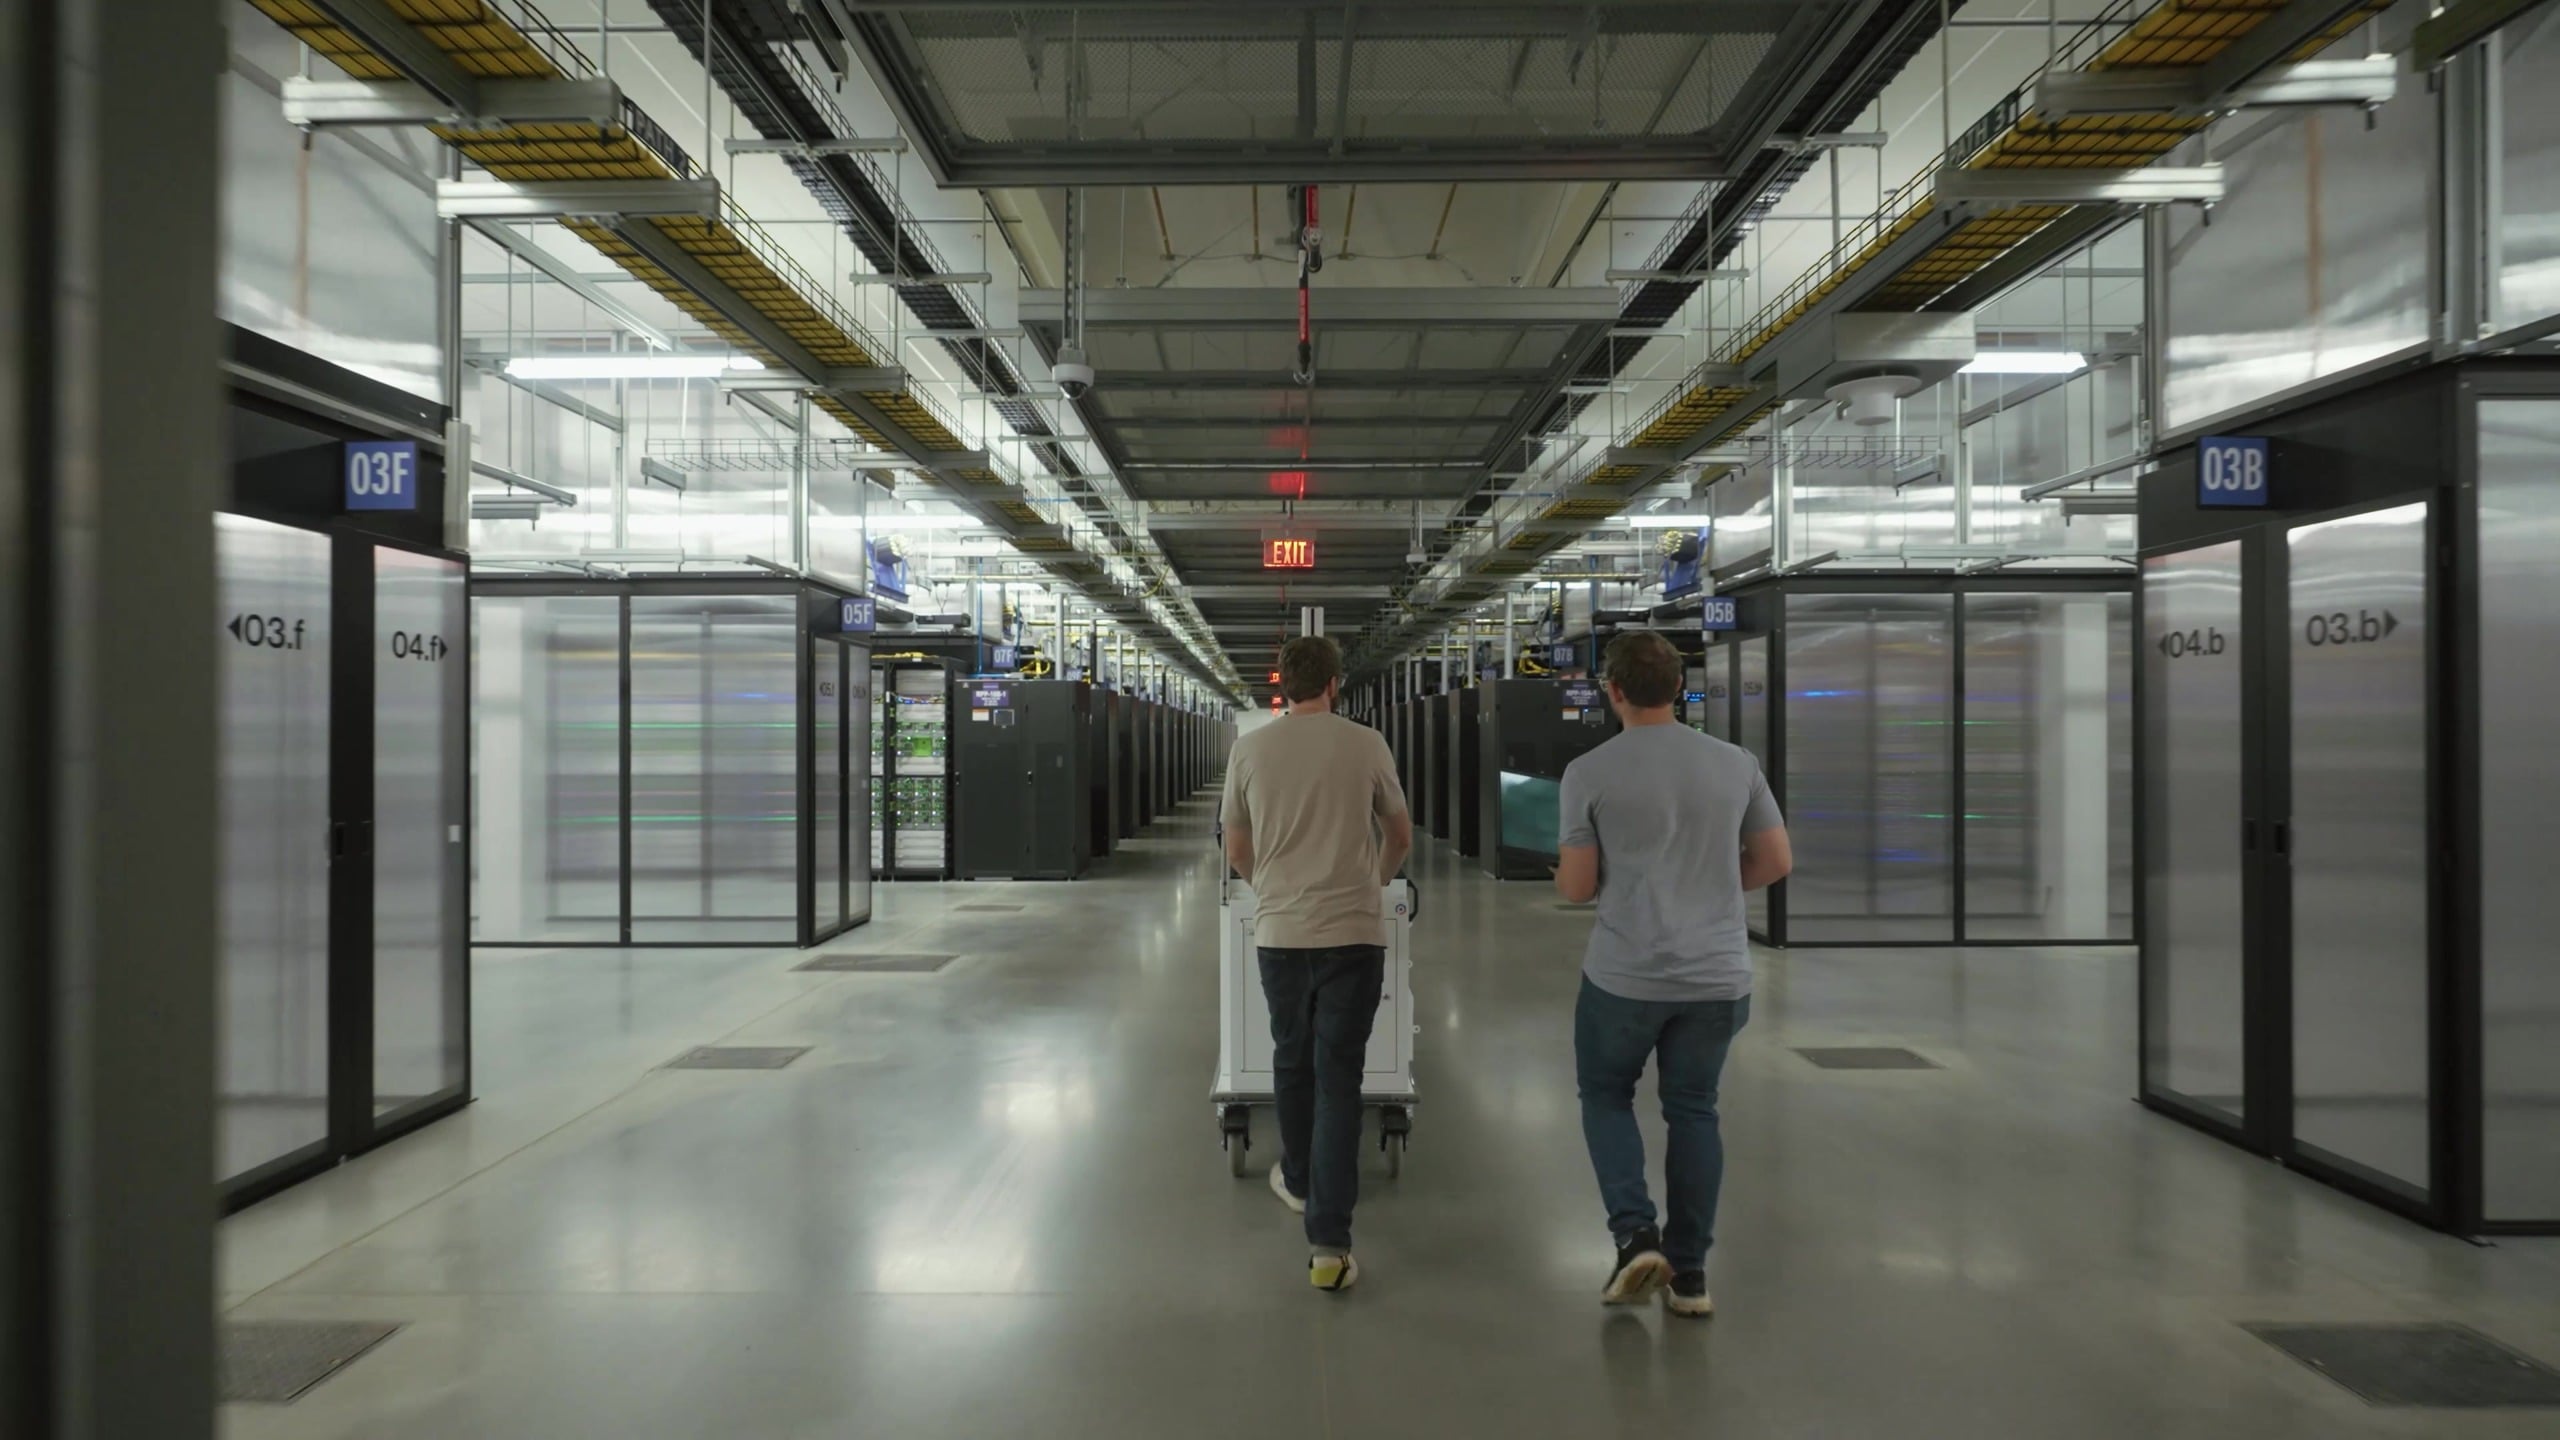
Die meisten von Meta veröffentlichten Informationen betreffen operative Details, die Hyperscaler üblicherweise für sich behalten: die Konfiguration der Ersatz-GPUs, die Ausfallraten, die Firmware-Rollout-Zeiten und die Gründe für die Wahl der Ariel-Konfiguration. Der rote Faden ist, dass die Hardware in diesem Maßstab nur der Ausgangspunkt ist. Die eigentliche Arbeit, die Hunderttausende von GPUs in nutzbare Trainingskapazität verwandelt, liegt im Netzwerk, der Fehlertoleranz und der Telemetrie. Für Unternehmen, die KI in großem Umfang einsetzen möchten, ist diese detaillierte Analyse von Meta ein guter Ausgangspunkt, um zumindest zu verstehen, wo Probleme auftreten können, damit sie ihre gesamte Rechenzentrumsinfrastruktur im Voraus planen können.



 Amazon