

Meta erläuterte die rasante Entwicklung seines Programms „Meta Training and Inference Accelerator“ (MTIA). Das Unternehmen beschrieb vier Chipgenerationen, die innerhalb von rund zwei Jahren entwickelt wurden. Diese Chips lösen ein zentrales Infrastrukturproblem, das Meta für die weltweite KI als essenziell erachtet: die schnelle und kostengünstige Anpassung an sich entwickelnde Modellarchitekturen, ohne auf lange Silizium-Entwicklungszyklen angewiesen zu sein. MTIA ist Teil einer umfassenderen Siliziumstrategie, und Meta bekräftigte seine Zusammenarbeit mit Broadcom bei der Entwicklung dieser Chips.
Laut Meta sind bereits Hunderttausende MTIA-Geräte im Produktiveinsatz, und mehrere interne Modelle wurden integriert. Die Validierung umfasst das Testen großer Sprachmodelle wie Llama. Das Unternehmen veröffentlichte zuvor technische Details zu den ersten beiden MTIA-Generationen, MTIA 100 und MTIA 200, in ISCA-Forschungsberichten. Nun erweitert es die Plattform um MTIA 300, 400, 450 und 500. Diese neuen Komponenten decken den Anwendungsbereich von Ranking- und Empfehlungs-Inferenz (R&R) über R&R-Training bis hin zu allgemeinen GenAI-Workloads, insbesondere Inferenz, ab. Die Implementierung ist für 2026 und 2027 geplant oder bereits im Gange.
Iteration als Gestaltungsprinzip
Ein zentrales Thema ist die Entwicklungsgeschwindigkeit. Meta argumentiert, dass die Modellentwicklung schneller vonstattengeht als die traditionelle Chipentwicklung, die von der Konzeption bis zur Produktion zwei Jahre dauern kann. Meta baut MTIA-Chips auf der Open-Source-RISC-V-Architektur auf, die Fertigung übernimmt die Taiwan Semiconductor Manufacturing Corporation (TSMC). Die Antwort darauf ist ein iterativer, modularer Designansatz. Jede Generation basiert auf wiederverwendbaren Chiplets und wird mithilfe neuester Erkenntnisse über Betreiber und Server optimiert. Das Unternehmen betonte auch die Bedeutung der Wiederverwendung über den Chip selbst hinaus. MTIA 400, 450 und 500 nutzen dasselbe Gehäuse, Rack und dieselbe Netzwerkinfrastruktur. Dies ermöglicht schnelle Upgrades und verkürzt die Zeit von der Chip-Fertigung bis zur Implementierung im Rechenzentrum.
MTIA 300: Netzwerke und Kollektive, die in die Siliziumtechnologie integriert sind
MTIA 300 bildet die Grundlage der neuen Roadmap. Es wurde ursprünglich für das R&R-Training optimiert, Metas Hauptaufgabe vor dem Aufkommen von GenAI. Die Architektur umfasst integrierte Netzwerk-Chiplets, dedizierte Message-Engines für effiziente kollektive Kommunikation und speichernahes Computing zur Reduzierung der Last bei kollektiven Operationen. Obwohl der Fokus auf R&R liegt, unterstützen diese Kommunikationskomponenten in späteren Versionen auch das GenAI-Training und die Inferenzeffizienz.
Auf Blockebene beschrieb Meta MTIA 300 als Multi-Chiplet-Design mit einem Rechen-Chiplet, zwei Netzwerk-Chiplets und mehreren HBM-Stacks. Der Rechenblock ist als Raster von Verarbeitungselementen (PEs) angeordnet, wobei zusätzliche PEs die Ausbeute erhöhen. Jedes PE umfasst zwei RISC-V-Vektorkerne, eine Skalarprodukt-Engine für Matrixoperationen, eine spezialisierte Funktionseinheit für Aktivierungen und elementweise Operationen, eine Reduktions-Engine für Akkumulation und PE-zu-PE-Kommunikation sowie eine DMA-Engine für den lokalen Datentransfer.
MTIA 400: Ein Kurswechsel hin zu GenAI mit wettbewerbsfähigen Durchsatzversprechen
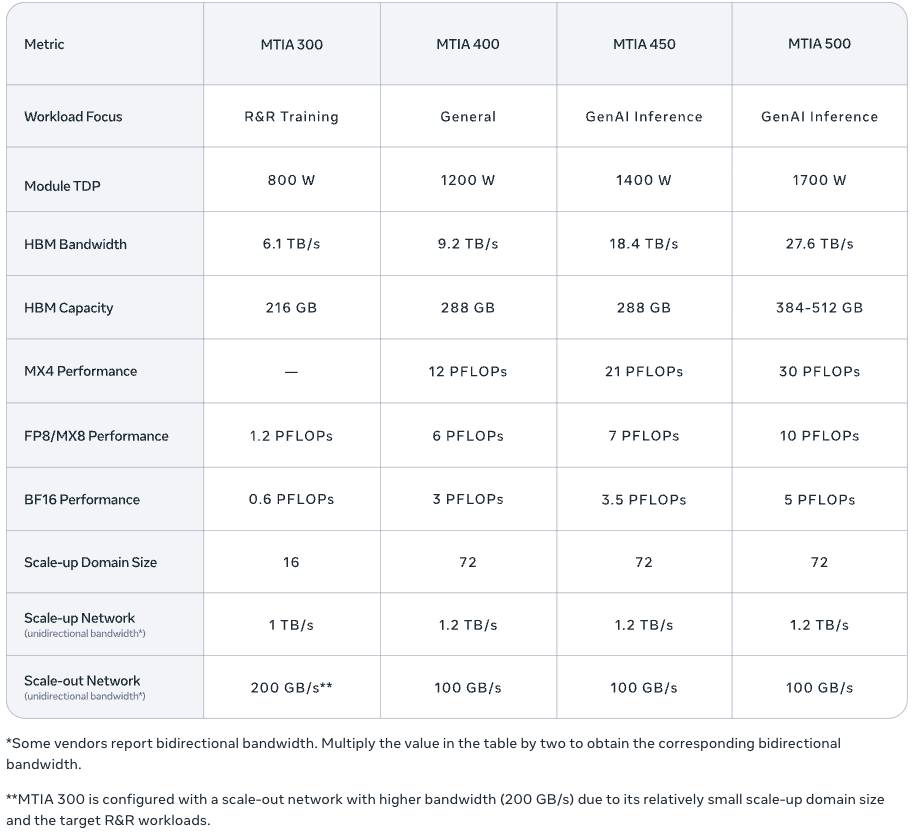
MTIA 400 ist ein Upgrade von MTIA 300 und unterstützt GenAI bei gleichbleibender R&R-Funktionalität. Laut Meta stellt MTIA 400 ein bedeutendes Upgrade dar und bietet 400 % höhere FP8-FLOPS und 51 % höhere HBM-Bandbreite als MTIA 300. Architektonisch kombiniert MTIA 400 zwei Compute-Chiplets, um die Rechendichte zu erhöhen, und unterstützt die verbesserten MX8- und MX4-Formate mit niedriger Präzision, die laut Meta für effiziente GenAI-Inferenz unerlässlich sind.

Systemdesign bleibt ein zentraler Fokus. Meta beschrieb eine Rack-basierte Implementierung, bei der 72 MTIA-400-Geräte über eine geschaltete Backplane verbunden sind und so eine einzige skalierbare Domäne bilden. Für flexible Implementierungen erwähnte Meta AALC-Racks (Air-Assisted Liquid Cooling), um die Einrichtung in bestehenden Rechenzentren zu beschleunigen. Zudem wurde darauf hingewiesen, dass die Plattform Flüssigkeitskühlungslösungen unterstützt.
MTIA 450: GenAI-Inferenzoptimierung beginnt mit Speicherbandbreite
MTIA 450 ist eine verbesserte Version von MTIA 400 mit Fokus auf Inferenz, die auf die gestiegene Nachfrage nach GenAI-Inferenz ausgerichtet ist. Meta identifizierte die HBM-Bandbreite als Hauptfaktor für die limitierende Inferenzleistung und verdoppelte sie von MTIA 400 zu MTIA 450. Das Unternehmen berichtete außerdem von einer Steigerung der MX4 FLOPS um 75 %, um Mixture-of-Experts-Berechnungen zu verbessern, sowie von Hardwarebeschleunigung zur Reduzierung häufiger Engpässe bei Aufmerksamkeits- und Feedforward-Operationen, insbesondere im Verhalten von Softmax und FlashAttention.
Meta hob die Arbeit an Datentypen als wichtigen Faktor hervor. Der MTIA 450 geht über FP8 und MX8 hinaus und erreicht den Durchsatz von MX4 bei der sechsmal höheren Geschwindigkeit von FP16/BF16. Der Chip unterstützt gemischte Berechnungen mit niedriger Präzision ohne Softwarekonvertierungen. Er verfügt über innovative, speziell entwickelte Datentypen, die die Modellqualität erhalten und gleichzeitig die FLOPS bei minimalem Flächenbedarf erhöhen. Die Masseneinführung des MTIA 450 ist für Anfang 2027 geplant.
MTIA 500: Mehr Bandbreite, mehr Kapazität, weitere Chiplet-Zerlegung
MTIA 500 setzt den Fokus auf Inferenz mit weiteren Verbesserungen bei Speicher und Rechenleistung fort. Laut Meta erhöht MTIA 500 die HBM-Bandbreite um 50 % gegenüber MTIA 450, steigert die HBM-Kapazität um bis zu 80 % und erhöht die MX4 FLOPS um 43 %. Das Chiplet-Design wurde mit einer 2×2-Konfiguration aus kleineren Rechenchiplets, umgeben von mehreren HBM-Stacks und zwei Netzwerkchiplets, weiterentwickelt. Es beinhaltet außerdem ein System-on-Chip (SoC)-Chiplet für die PCIe-Anbindung an die Host-CPU und Scale-Out-NICs. Meta erwähnte zusätzliche Hardwarebeschleunigung und Änderungen an Datentypen, um Engpässe bei der Inferenz zu beheben.
Die Masseneinführung von MTIA 500 ist für 2027 geplant.
Einfache Einführung
Meta richtet MTIA auf einfache Implementierung aus und setzt dabei auf branchenübliche Werkzeuge anstelle eines spezialisierten Frameworks. Das Unternehmen beschreibt MTIA als PyTorch-nativ, nahtlos integriert in PyTorch 2.x-Kompilierungsprozesse und unterstützt sowohl die sofortige Ausführung als auch die Graphausführung. Im Graphmodus können Entwickler `torch.compile` und `torch.export` verwenden, um Graphen zu optimieren, ohne MTIA-spezifische Modelle neu schreiben zu müssen. Dies ermöglicht die parallele Bereitstellung auf GPUs und MTIA.
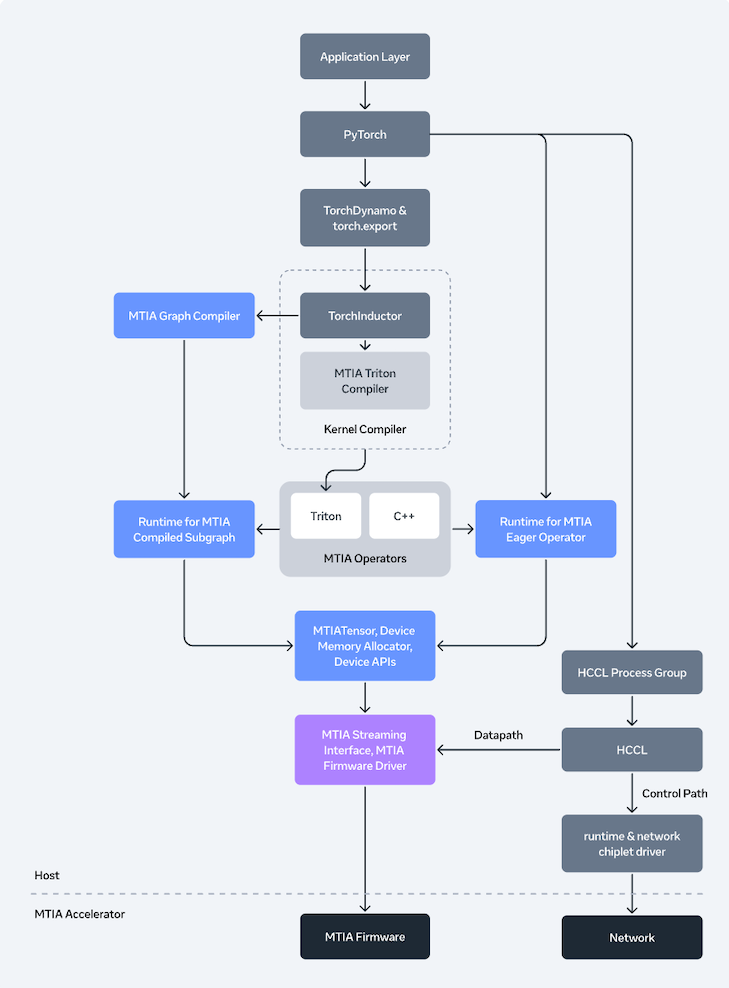
Im Hintergrund erläuterte Meta einen MTIA-Compiler-Stack, der auf Torch FX IR und TorchInductor basiert. Die unteren Schichten nutzen Triton, MLIR und LLVM sowie MTIA-spezifische Optimierungen, darunter Verbesserungen der Kernel-Fusion und Erweiterungen für leistungskritische Komponenten. Autotuning ist eine Schlüsselfunktion zur Auswahl verschiedener Kompilierungsstrategien.
Für die verteilte Ausführung hat Meta die Hoot Collective Communications Library (HCCL) eingeführt. Diese Bibliothek ähnelt GPU-Collective-Stacks, ist aber für die in MTIA integrierten Netzwerk-Chiplets und Message-Engines optimiert. Sie nutzt speichernahe Rechenleistung, um Reduktionsoperationen zu beschleunigen. Meta unterstützt zudem Compute-Collective-Fusion zur Latenzreduzierung und verfügt über einen Transport-Stack, der den Datenpfad verwaltet und den Host-Overhead verringert.
Zur Laufzeit demonstrierte Meta eine Gerätelaufzeitumgebung, die Speicher, Scheduling und Koordination im Eager- und Graph-Modus verwaltet. Zudem wurde ein Rust-basierter Benutzermodustreiber eingeführt, der sich vom traditionellen Linux-Kernel-Treiber abhebt. Die Firmware ist in Bare-Metal-Rust geschrieben, wodurch geringe Latenz und hohe Sicherheit im Vordergrund stehen.
Für GenAI Serving beschrieb Meta die vLLM-Integration mittels eines Plugin-Systems. Dieses ersetzt wichtige Operatoren wie FlashAttention und fused LayerNorm durch MTIA-spezifische Kernel. Zudem ermöglicht es den Graph-Modus über ein benutzerdefiniertes torch.compile-Backend. Darüber hinaus erwähnte Meta Tools zur Verwaltung großer MTIA-Bereitstellungen, darunter Monitoring, Profiling, Debugging und Observability über Hosts und Geräte hinweg.
Was kommt als nächstes
Metas aktualisierte MTIA-Roadmap legt den Fokus auf die Wirtschaftlichkeit von GenAI-Inferenz und hebt HBM-Bandbreite und niedrigpräzise Formate als Schlüsselfaktoren hervor. Sollte Meta seine Bereitstellungspläne einhalten, werden MTIA 450 und 500 als erste groß angelegte Tests dienen, um zu ermitteln, ob eine auf Inferenz basierende Beschleunigerstrategie, die auf schnellen Chiplet-Iterationen und standardisierter Software beruht, gegenüber gängigen GPU-Plattformen Vorteile bei der Bereitstellung von GenAI-Diensten bieten kann.


 Amazon