

MLPerf Inference v5.1 bietet rigorose Benchmarks für KI-Inferenz in LLMs, Vision und multimodalen Aufgaben. Hier finden Sie die technische Analyse der Ergebnisse von NVIDIAs Blackwell Ultra und AMDs Instinct MI300X/MI325X/MI355X. Sie enthält detaillierte Benchmark-Daten, Softwareoptimierungen, Architekturstrategien und Implikationen für Hyperscaler und Unternehmen.
MLPerf-Benchmarking-Framework
MLPerf Inference-Benchmarks dienen als Bewertungsmaßstab für KI-Beschleuniger und bieten eine standardisierte, vergleichbare Methode zur Leistungsmessung bei Bildklassifizierung, Sprachmodellen und Empfehlungssystemen. Für Unternehmen, die GPUs in großem Umfang einsetzen, sind diese Zahlen oft die Grundlage für umfangreiche Kaufentscheidungen.
MLPerf Inference wird von MLCommons gesteuert und definiert die Regeln für geschlossene und offene Divisionen. Mögliche Szenarien:
- Offline: Durchsatzorientiert (so viele Abfragen wie möglich bündeln).
- Server: Latenzkonforme Multi-Stream-Inferenz.
- Interaktives Benutzererlebnis: Strikte TTFT (Time-to-First-Token) und TPS (Token pro Sekunde @ 99. Perzentil).
Die Workload-Suite v5.1 umfasste:
- DeepSeek-R1: Ein 671B-Expertenmischungsmodell (Stresstest für Schlussfolgerungen).
- Llama-3.1-405B und 8B: Neueste LLMs über mehrere Inferenzmodi hinweg.
- Flüstern: ASR ersetzt RNN-T.
- Stabile Diffusion XL (SD-XL): Text-zu-Bild-generierende KI.
- Mixtral, DLRMv2, plus Legacy-Workloads wie ResNet-50.
Diagramme zum Durchsatz (Token/Sekunde oder Samples/Sekunde) zeigen typischerweise die anhaltende Dominanz von NVIDIA in absoluten Zahlen, insbesondere pro GPU. AMDs Fortschritte bei relativer Effizienz und Skalierungsstabilität zeigen jedoch, dass sie den Abstand Runde für Runde verringern, insbesondere in Serverszenarien und Multi-Node-Umgebungen.
NVIDIA Blackwell Ultra-Ergebnisse
Blackwell Ultra-Systeme erzielten bei allen neuen Workloads einen Rekorddurchsatz. Wichtige Faktoren:
- NVFP4-Präzision: benutzerdefinierter 4-Bit-Float, der DeepSeek und Llama beschleunigt.
- FP8 KV-Cache: Speichereinsparungen für Aufmerksamkeitsebenen.
- Disaggregiertes Serving: Aufteilung des Kontexts im Vergleich zu den Generierungsstufen auf 72 GPUs über 1,800 GB/s NVLink.
- Software: CUDA-Graphen, TensorRT-LLM, ADP Balance.
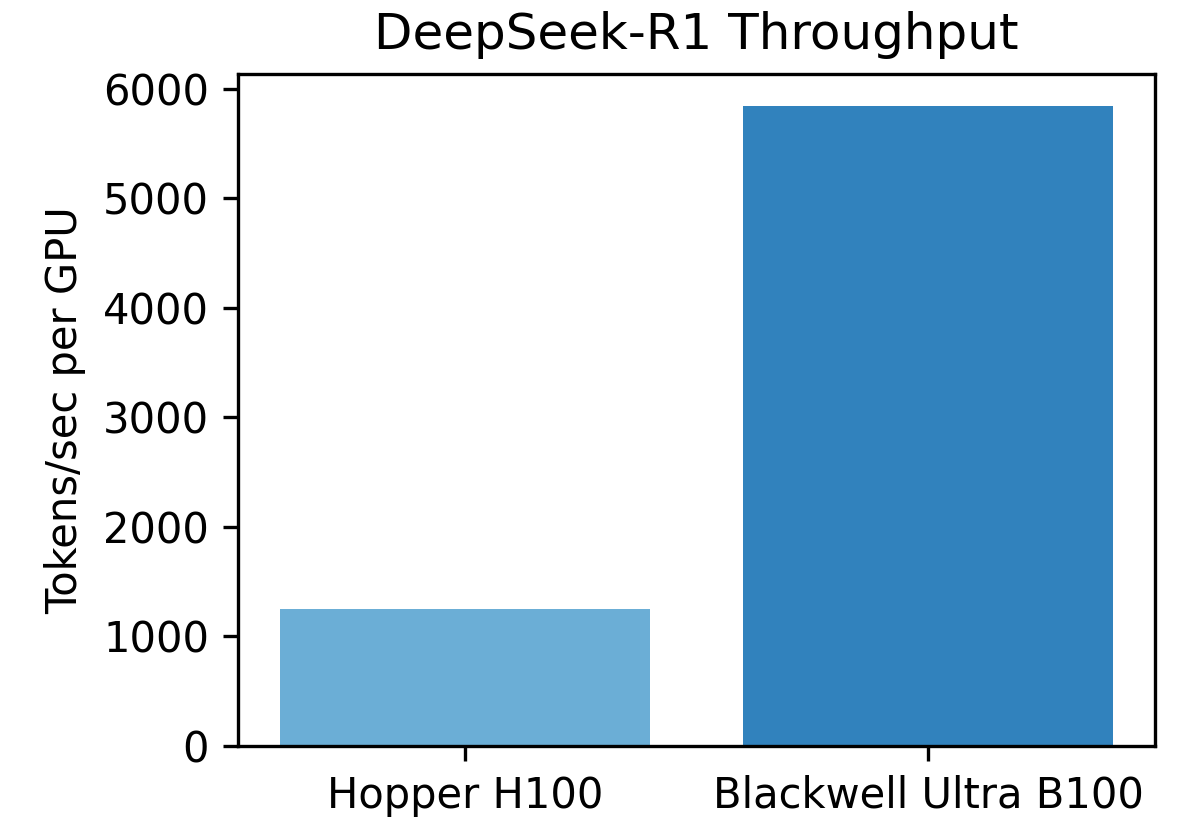
Das untenstehende Balkendiagramm, das Hopper und Blackwell Ultra pro GPU gegenüberstellt, zeigt eine fast fünffache Durchsatzsteigerung bei DeepSeek-R5. Dies bestätigt, dass feingranulare Datenformate (NVFP1) und rackweite Bandbreiten für massive Inferenz-Workloads linear skalieren. Eine weitere Abbildung, die die rekordverdächtigen Ergebnisse des interaktiven Llama-4B veranschaulicht, zeigt, wie NVIDIA NVLink Fabric und disaggregiertes Serving nutzt, um Latenz-SLAs einzuhalten und gleichzeitig bisherige Durchsatzgrenzen zu überschreiten. Fazit: NVIDIA bleibt Branchenführer in Sachen Geschwindigkeit und latenzsensitive Workloads.
AMD Instinct MI300X/MI325X/MI355X-Ergebnisse
AMD zielte auf Effizienz und Flexibilität ab:
- FP4 auf MI355X: liefert 2.7-mal mehr Durchsatz von Llama-2-70B im Vergleich zu MI325X FP8.
- Strukturierter Schnitt: Bei Llama-405B reduzierte das Beschneiden um 21–33 % die FLOPs, ohne die Genauigkeit zu beeinträchtigen, und steigerte den Durchsatz um ~82–90 %.
- Skalierung: Reibungslose lineare Skalierung bis zu 8 Knoten nachgewiesen; erster heterogener Cluster (4 × MI300X + 2 × MI325X) erreichte 94 % Skalierungseffizienz.
- Reproduzierbarkeit des ROCm-Ökosystems: Die Einreichungen der Partner liegen durchweg innerhalb von 1–3 % der eigenen Ergebnisse von AMD.
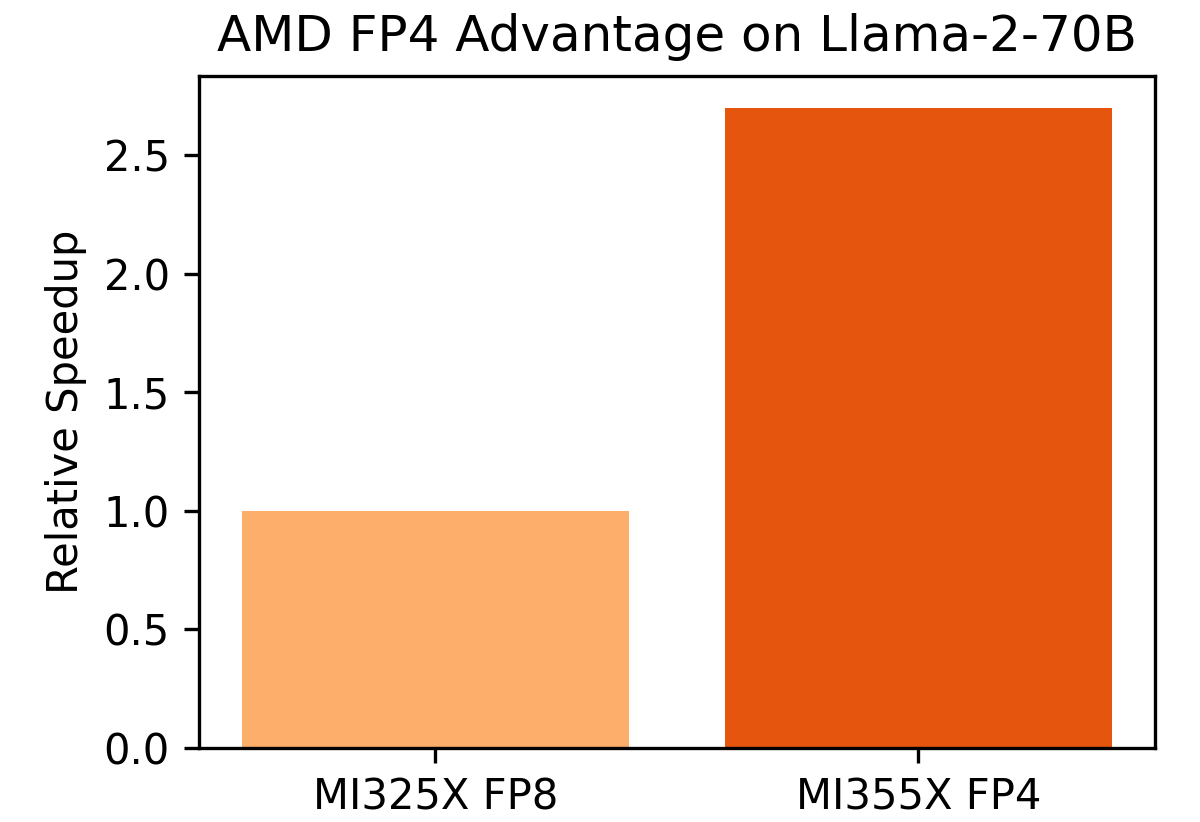
Das obige Diagramm, das MI325X FP8 im Vergleich zu MI355X FP4 zeigt, veranschaulicht die bahnbrechenden Vorteile von FP4, höhere Token/Sek. bei minimalem Genauigkeitsverlust und beweist, dass FP4 kein experimentelles, sondern einsatzbereites Modell ist.
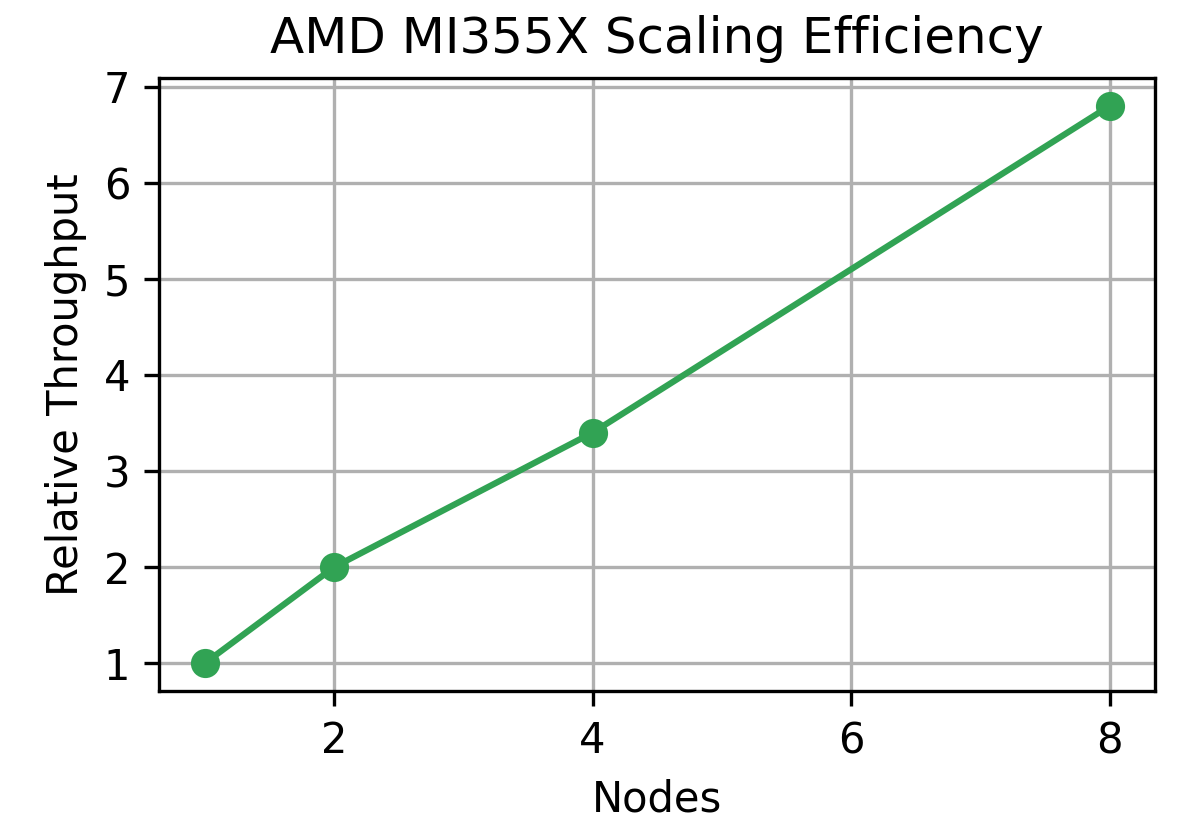
Diese Skalierungskurve (1 → 8 Knoten) verdeutlicht die nahezu lineare Skalierung, was für Hyperscaler von Vorteil ist, da sie planbare Erweiterungskosten ermöglicht. Die schematische Darstellung des strukturierten Prunings zeigt, dass AMD sich nicht nur auf maximale Hardwareleistung konzentriert, sondern auch auf algorithmische Effizienz – entscheidend für reale Inferenzcluster mit begrenztem Platz- und Stromverbrauch.
AMD-NVIDIA Head-to-Head-Vergleich
|
Metrisch |
NVIDIA Blackwell Ultra |
AMD MI355X |
Notizen |
Gewinnschlag |
|
Tokens/Sek. pro GPU |
5842 (DeepSeek-R1) |
~2200 (skaliert FP4) |
Höhere NVIDIA-Rohleistung |
NVIDIA |
|
Speicher pro GPU |
192 GB HBM3e |
288 GB HBM3e |
AMD passt 520B-Modell Single-GPU |
AMD |
|
Präzisionsunterstützung |
FP16, FP8, NVFP4 |
FP16, FP8, FP4 |
Beide 4-Bit-Lead |
Krawatte |
|
Skalierungsgewebe |
72 GPU NVLink |
Lineare Knotenskalierung auf 8 |
Verschiedene Skalierungsstrategien |
Krawatte |
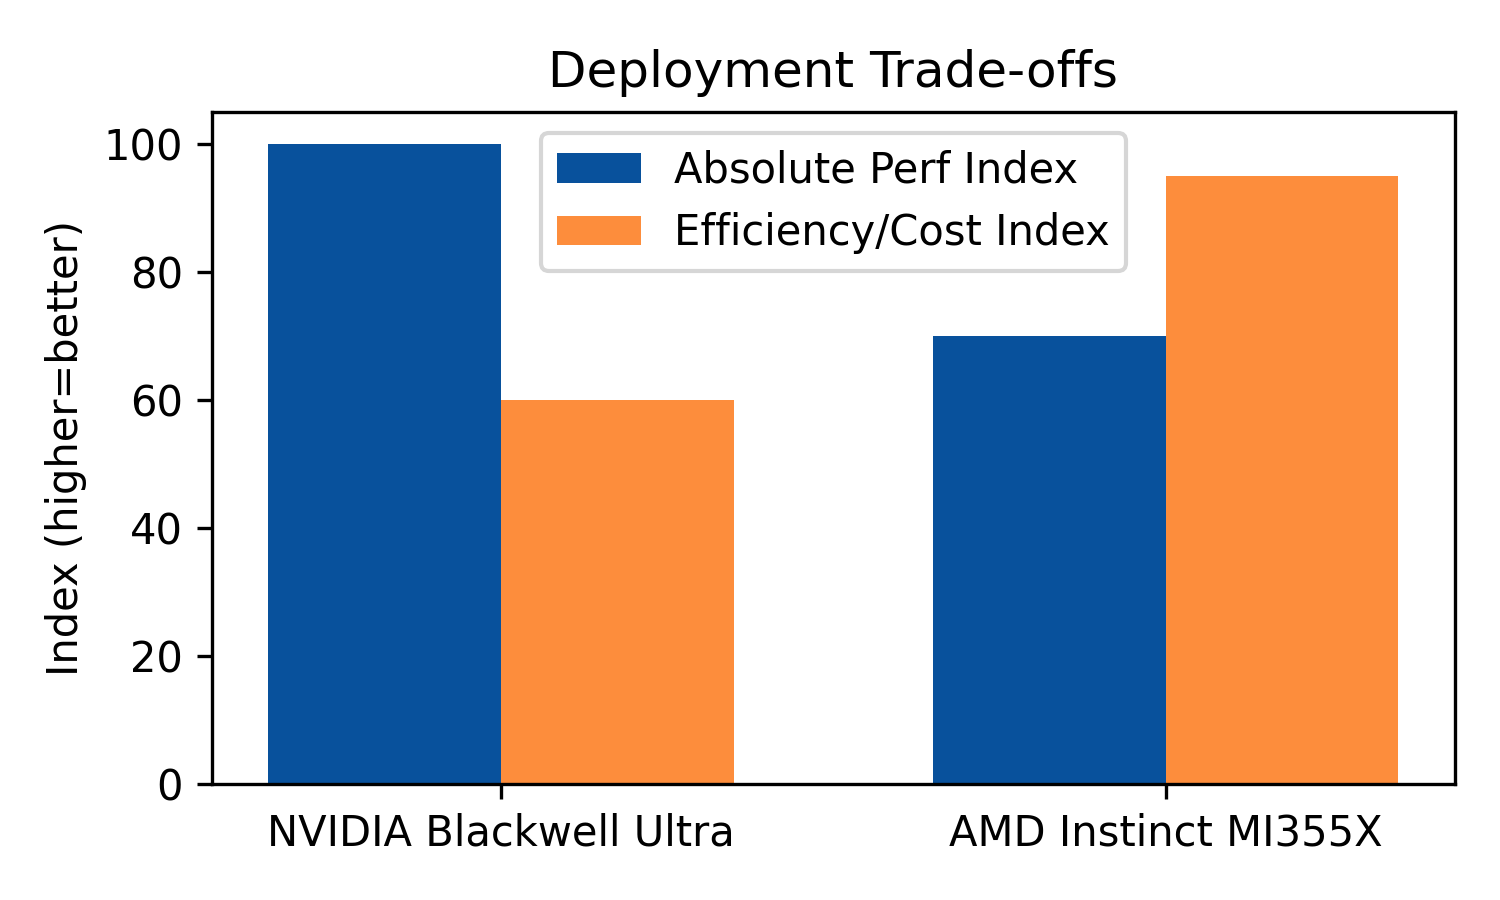
Nebeneinandergestellte Visualisierungen betonen die Kompromisse.
- NVIDIA dominiert den Durchsatz pro GPU und ist daher ideal für KI-Fabriken, bei denen die Flop-Dichte eine Rolle spielt.
- AMD glänzt mit größerem Speicher (288 GB) und FP4-Beschneidung dort, wo Kosten pro Token und Bereitstellungsflexibilität von größter Bedeutung sind.
Auswirkungen auf die Branche
- Hyperscaler: NVIDIA bleibt das Werkzeug der Wahl für KI-Fabriken, die Spitzenleistung anstreben. AMDs wachsende Effizienzinnovationen ermöglichen jedoch eine kostenoptimierte Skalierung und sind für die Verteilung der Arbeitslasten über verschiedene Ebenen hinweg attraktiv.
- Cloud-Anbieter: Erwarten Sie heterogene Angebote, leistungsstarke NVIDIA-Stufen im Vergleich zu kosteneffizienten AMD Kubernetes-Pods.
- Unternehmen: Strukturiertes Pruning, FP4 und heterogene Cluster-Unterstützung ermöglichen AMD die Bereitstellung von 405B+-Modellinferenzen bei geringeren Gesamtbetriebskosten. NVIDIA-Innovationen (disaggregiertes Serving und Dynamo) sind weiterhin vorteilhaft für latenzempfindliche Apps (z. B. Echtzeit-LLM-Chatbots).
- Zukunftsausblick: Erwarten Sie die universelle Einführung der 4-Bit-Inferenz als Basis, eine breitere Nutzung heterogener GPU-Pools und neue Systemdesigns, darunter NVIDIAs Rubin CPX für lange Sequenzen und AMDs ROCm-Erweiterung zur Abdeckung weiterer Frameworks.
NVIDIA gibt weiterhin den Ton beim Rohdurchsatz an. H200-GPUs führen die Inferenz in ResNet-50 und BERT in geschlossenen Benchmarks an. AMDs MI300 liegt jedoch nicht weit zurück und liefert konkurrenzfähige Werte in Server- und Offline-Szenarien sowie deutliche Verbesserungen bei der Energieeffizienz. Entscheidend ist nicht nur, dass NVIDIA weiterhin an der Spitze steht, sondern dass AMD den Abstand im Vergleich zur MLPerf-Runde zuvor deutlich verringert hat. Für Käufer bedeutet dies, dass die Zeiten, in denen nur auf grüne GPUs geachtet wurde, möglicherweise vorbei sind – ROCm reift heran, und der MI300 ist für reale Inferenzanwendungen geeignet.


 Amazon