

Open Compute Project (OCP) hat die Ergänzung seiner Plattform um den Wiwynn ES200 Edge-Server und das NVIDIA HGX-H100 GPU-Baseboard angekündigt.
Der Edge-Server mit kurzer Tiefe von Wiwynn ist darauf ausgelegt, den wachsenden Bedarf an Rechenleistung an Edge-Standorten zu decken, insbesondere für Anwendungen wie sofortige KI-Inferenz, Datenanalyse vor Ort und Mehrkanal-Videoverarbeitung.
Die physische Spezifikation des HGX-H100-GPU-Baseboards von NVIDIA soll dazu beitragen, die Fähigkeit des OAI-Teilprojekts von OCP zu verbessern, HGX zu nutzen und kostengünstige, hocheffiziente, skalierbare Plattform- und Systemspezifikationen für Hochleistungsrechnen in KI- und HPC-Anwendungen zu entwickeln.
Wiwynn ES200 Edgeserver
Wiwynn ES200 ist ein 2U-Edge-Server mit zwei Sockeln, der von einem skalierbaren Intel Xeon-Prozessor der 3. Generation angetrieben wird. Mit NUMA-Balancing kann die Rechenleistung jedes installierten Prozessors bereitgestellt werden, um unterschiedliche Arbeitslasten separat zu erfüllen, ohne dass es zu Kommunikationsengpässen zwischen CPUs kommt.
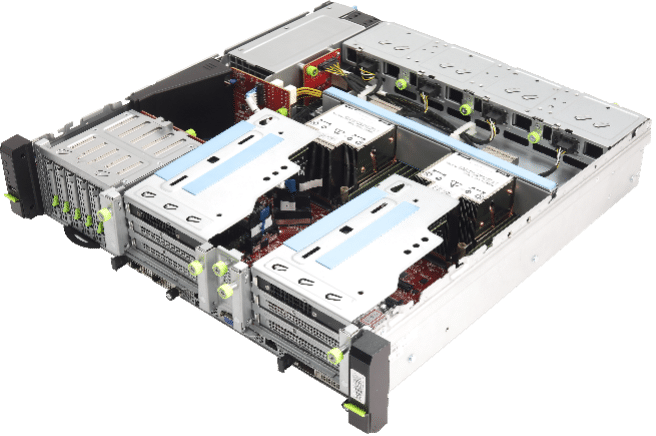
Es verfügt außerdem über zusätzliche PCIe Gen4 x16-Steckplätze, die mit zwei Erweiterungskarten doppelter Breite bestückt werden können. Dies erhöht die Flexibilität des Systems erheblich und macht es ideal für Anwendungsfälle wie KI-Inferenzbeschleunigung, Videotranskodierung und Datenanalyse sowie für Anwendungen, die zusätzliche Netzwerkverbindungen erfordern. Es bietet flexible Speichermodule, darunter EDSFF (E1.S) oder U.2 SSDs und zwei OCP NIC 3.0-Karten, wodurch der ES200 eine beeindruckende lokale Datenverarbeitung und Netzwerkverbindungen mit hoher Bandbreite ermöglicht.
Der ES200 ist außerdem NEBS-3-konform und verfügt über einen kompakten Formfaktor mit geringer Tiefe. Darüber hinaus gibt Wiwynn an, dass es auch unter schwierigen Betriebsbedingungen reibungslos läuft und an verschiedenen Randstandorten Platz findet.
Wiwynn ES200 Edge Server-Knotenspezifikationen
| Knotenspezifikation | |
| Prozessor | Skalierbare Intel Xeon-Prozessoren der 3. Generation, TDP 250 W/270 W |
| Prozessorsockel | 2 |
| Chipsatz | Intel C621A-Serie |
| Sicherheit | TPM v2.0 (Option) |
| Systembus | Intel UltraPath-Verbindung; 11.2GT/s |
| Memory | 16 DIMM-Steckplätze; DDR4 bis zu 3200 MT/s und bis zu 64 GB pro DIMM; 12 DIMM-Steckplätze mit bis zu 2 DCPMMs (Intel Barlow Pass) |
| Lagerung | ‧ Ein integrierter 2280/22110 M.2 SSD-Modulsteckplatz ‧ Sechs U.2 (15/7 mm) oder acht EDSFF E1.S (5.9/9.5 mm) |
| Erweiterungssteckplätze | Bis zu sechs PCIe Gen4-Steckplätze: ‧ Zwei PCIe x16 FHFL mit doppelter Breite + ein PCIe x8 FHHL ‧ Ein PCIe x16 FHHL-Steckplatz + zwei PCIe x8 FHHL ‧ Sechs PCIe x8 FHHL-Steckplätze sind bei Bedarf optional Zwei integrierte OCP 3.0 NIC x16 |
| Management-LAN | ‧ Ein dedizierter GbE-BMC-Port |
| I / O Ports | ‧ Ein-/Aus-Taste mit LED ‧ UID-Taste mit LED ‧ RST-Taste ‧ Drei USB-Anschlüsse ‧ BMC-Management-Port (Vorderseite) ‧ VGA-Anschluss (D-Sub) |
| Fahrgestellspezifikation | |
| Abmessungen | 2U-Rack; 86 (H) x 440 (B) x 450 (T) (mm) |
| PSU | Hot-plug-fähiges, redundantes (1+1) 1600-W-CRPS |
| Ventilator | Vier 8038-Doppelrotoren, redundant (7+1) |
| Gewicht | 14.47 kg |
| Arbeitsumfeld | ‧ Umgebungstemperaturbereich: -5 bis +55 Grad Celsius
‧ Relative Luftfeuchtigkeit bei Betrieb und Lagerung: 10 % bis 90 % (nicht kondensierend) ‧ Lagertemperaturbereich: -40 bis +70 Grad Celsius |
NVIDIA HGX-H100-Basisplatine
Das NVIDIA HGX-H100 ist ein Basisboard, das acht der neuesten Hopper-GPU-Module aufnimmt . Die physikalische Spezifikation des HGX-Basisboards definiert unter anderem die Abmessungen, Host-Schnittstellen sowie Management- und Debugging-Schnittstellen. Das NVIDIA-Paket enthält außerdem die physikalische Spezifikation des Basisboards, eine Liste der Ein-/Ausgangspins und eine Pinbelegung (2D/3D-Zeichnung).
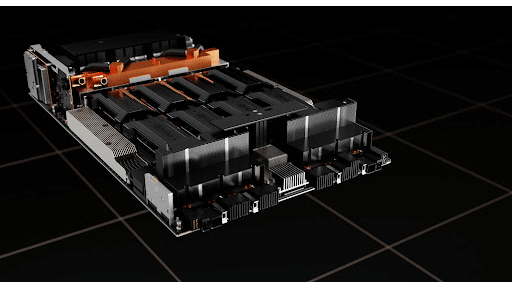
Die folgende Liste von OCP zeigt, wie der Beitrag von NVIDIA HGX auf seinen „vier Grundsätzen“ aufbaut: Effizienz, Skalierbarkeit, Offenheit und Wirkung:
- Effizienz – Dies ist der HGX-Baseboard-Formfaktor der 3. Generation, und jede Generation hat einen etwa 3x-5x höheren KI-Trainingsdurchsatz bei ähnlichem Wirkstromverbrauch ermöglicht. Infolgedessen ist das HGX-Baseboard heute der De-facto-Standard, wobei die meisten globalen Hyperscaler diesen Formfaktor für KI-Training und -Inferenz verwenden.
- Skalierbarkeit – Weltweit sind Hunderttausende HGX-Systeme in Produktion. Die Systeme und Gehäuse für diesen Formfaktor werden stabil und maßstabsgetreu gebaut. Die HGX-Spezifikation umfasst physische Dimensionen, Verwaltungsschnittstellen für Überwachung/Debugging usw. für maßstabsgetreue Dienste.
- Offenheit – HGX-basierte Systeme sind weltweit die am weitesten verbreitete KI-Trainingsplattform. Viele OEMs/ODMs haben HGX-basierte KI-Systeme entwickelt. Mit dem Beitrag dieser physikalischen HGX-Spezifikation wird die OAI-Gruppe UBB2.0 so weit wie möglich mit der HGX-Spezifikation konvergieren. OEMs/ODMs könnten das gleiche Systemdesign mit unterschiedlichen Beschleunigern auf UBB/HGX-ähnlichen Baseboards nutzen, z. B. mit den gleichen Baseboard-Abmessungen, Host-Schnittstellen, Verwaltungsschnittstellen, Stromversorgung usw.
- Auswirkungen – Die NVIDIA HGX-Plattformen sind de facto zum globalen Standard für KI-Trainingsplattformen geworden. Durch die Öffnung dieses HGX-Baseboard-Formfaktors können andere Anbieter von KI-Beschleunigern das HGX-Ökosystem aus Systemen und Gehäusen nutzen. Dadurch dürften andere KI-Anbieter schneller in der Lage sein, die bestehende Infrastruktur zu nutzen und ihre Lösungen früher einzuführen. Dies beschleunigt die Innovation im Bereich KI/HPC weiter.


 Amazon