

NVIDIA hat zahlreiche neue Technologien und Partnerschaften angekündigt, darunter eine neue Version seiner TensorRT-Inferenzsoftware, die Integration von TensorRT in das TensorFlow-Framework von Google und die Tatsache, dass seine Spracherkennungssoftware Kaldi jetzt für GPUs optimiert ist.
Die TensorRT4-Software von VIDIA beschleunigt die Deep-Learning-Inferenz über eine Vielzahl von Anwendungen hinweg mit präziser INT8- und FP16-Netzwerkausführung, was darauf hindeutet, dass sie die Rechenzentrumskosten um bis zu 70 % senken wird. TensorRT4 kann auch zur schnellen Optimierung, Validierung und Bereitstellung trainierter neuronaler Netze in Hyperscale-Rechenzentren sowie eingebetteten und Automotive-GPU-Plattformen verwendet werden. NVIDIA behauptet außerdem, dass die neue Software im Vergleich zu CPUs für gängige Anwendungen eine bis zu 190-mal schnellere Deep-Learning-Inferenz aufweist. Darüber hinaus haben die Ingenieure von NVIDIA und Google TensorRT in TensorFlow 1.7 integriert, was die Ausführung von Deep-Learning-Inferenzanwendungen auf GPUs erleichtert.
NVIDIA hat Kaldi optimiert, um eine schnellere Leistung auf GPUs zu erreichen, was zu genaueren und nützlicheren virtuellen Assistenten für Verbraucher und geringeren Bereitstellungskosten für Rechenzentrumsbetreiber führt.
Weitere Partnerschaftsankündigungen umfassen:
- KI-Unterstützung für Windows 10-Anwendungen, da NVIDIA mit dem IT-Riesen zusammenarbeitete, um GPU-beschleunigte Tools zu entwickeln, damit Entwickler intelligentere Funktionen in Windows-Anwendungen integrieren können.
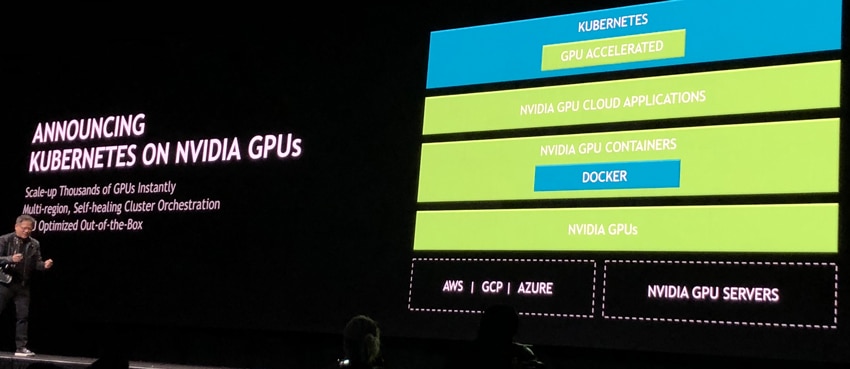
- GPU-Beschleunigung für Kubernetes, um die Bereitstellung von Unternehmensinferenzen auf Multi-Cloud-GPU-Clustern zu erleichtern.
- MathWorks gab heute die Integration von TensorRT in seine Flaggschiff-Software MATLAB bekannt. NVIDIA gibt an, dass Ingenieure und Wissenschaftler jetzt automatisch leistungsstarke Inferenz-Engines aus MATLAB für die Plattformen Jetson, NVIDIA Drive und Tesla generieren können.
Als nächstes gibt NVIDIA an, dass TensorRT auf autonomen NVIDIA DRIVE-Fahrzeugen und eingebetteten NVIDIA Jetson-Plattformen eingesetzt werden kann, während tiefe neuronale Netze auf NVIDIA DGX-Systemen im Rechenzentrum in jedem Framework trainiert und dann in allen Arten von Technologien für Echtzeit-Inferenzen eingesetzt werden können Rand.
TensorRT wird es Entwicklern ermöglichen, sich auf die Entwicklung neuartiger Deep-Learning-basierter Lösungen zu konzentrieren, anstatt sich auf die Leistungsoptimierung für die Inferenzbereitstellung zu konzentrieren. NVIDIA fügt hinzu, dass Entwickler TensorRT nutzen können, um extrem schnelle Inferenz über INTS- oder FP16-Präzision zu liefern. Dadurch wird die Latenz reduziert, was wiederum zu einer Verbesserung von Funktionen wie Objekterkennung und Pfadplanung auf Embedded- und Automotive-Plattformen führt.


 Amazon