

NVIDIA hat zwei bedeutende Schritte im Bereich High-Performance Computing und KI angekündigt: die Übernahme von SchedMD, dem Unternehmen hinter dem Workload-Manager Slurm, und die Einführung der Nemotron-3-Familie offener Modelle, Daten und Tools für Multiagenten-KI. Diese Maßnahmen stärken NVIDIAs Position in den Bereichen HPC, generative KI und KI-Infrastruktur für Unternehmen und unterstreichen gleichzeitig den Fokus auf offene, herstellerneutrale Software.
Slurm und SchedMD: Stärkung offener, herstellerneutraler HPC-Planung
SchedMD ist der Hauptentwickler von Slurm, einem der am weitesten verbreiteten Open-Source-Workload-Manager für HPC- und KI-Cluster. Slurm dient der Warteschlangenverwaltung, Planung und Zuweisung von Rechenressourcen in großen Clustern, die eng gekoppelte parallele Workloads ausführen. Mit zunehmender Clustergröße und Modellkomplexität wird eine effiziente Planung entscheidend für die Aufrechterhaltung von Auslastung und Durchsatz.
Slurm ist im HPC-Bereich weit verbreitet. Es wird in mehr als der Hälfte der Top-10- und Top-100-Systeme der TOP500-Liste eingesetzt, was auf seine Skalierbarkeit, seinen hohen Durchsatz und die Unterstützung komplexer Richtlinienverwaltung zurückzuführen ist. Für KI-Workloads hat sich Slurm zu einer Schlüsselkomponente der Infrastruktur entwickelt, die von Entwicklern grundlegender Modelle und KI-Anwendern genutzt wird, um das Training und die Inferenz umfangreicher Modelle auf GPU-beschleunigten Systemen zu orchestrieren.
Nach der Übernahme plant NVIDIA, Slurm weiterhin als Open-Source-Software zu entwickeln und zu vertreiben. Das Unternehmen versichert, dass Slurm der gesamten HPC- und KI-Community zugänglich bleibt und weiterhin heterogene Umgebungen auf einer Vielzahl von Hardware- und Softwareplattformen unterstützt. NVIDIA arbeitet seit über einem Jahrzehnt mit SchedMD zusammen, und diese formelle Übernahme soll die bestehende Zusammenarbeit beschleunigen und keine strategische Neuausrichtung darstellen.
Die Geschäftsleitung von SchedMD sieht in der Übernahme eine Bestätigung der zentralen Rolle von Slurm im Bereich HPC und KI. Das Unternehmen betonte, dass NVIDIAs Expertise im Bereich beschleunigtes Rechnen Slurm dabei helfen werde, zukünftige Anforderungen im Bereich KI und Supercomputing zu erfüllen und gleichzeitig das Open-Source-Modell und das Engagement in der Community zu bewahren.
Auswirkungen auf den Kunden und Plattformunterstützung
Für bestehende SchedMD-Kunden beabsichtigt NVIDIA, die Kontinuität in Bezug auf Support, Schulungen und Weiterentwicklung von Slurm aufrechtzuerhalten. Aktuelle Slurm-Implementierungen umfassen Cloud-Anbieter, Hersteller, KI-Unternehmen und Forschungseinrichtungen in Branchen wie autonomes Fahren, Gesundheitswesen und Biowissenschaften, Energie, Finanzdienstleistungen, öffentliche Verwaltung und allgemeine Fertigung.
NVIDIA erwartet zudem, den Zugriff von SchedMD auf neue Systeme und Architekturen zu beschleunigen. Für Kunden, die auf NVIDIAs beschleunigte Rechenplattform setzen, bedeutet dies eine schnellere Unterstützung neuer GPU-Generationen und Systemkonfigurationen. Gleichzeitig bekräftigt NVIDIA, dass Slurm weiterhin eine Vielzahl heterogener Umgebungen unterstützen wird, sodass Cluster mit Komponenten verschiedener Hersteller neue Slurm-Funktionen nutzen können, ohne an einen einzigen Hardware-Stack gebunden zu sein.
Die gemeinsame Anstrengung von NVIDIA und SchedMD ist Teil einer umfassenderen Initiative zur Stärkung des Open-Source-Software-Ökosystems in den Bereichen HPC und KI, um Innovationen branchenübergreifend und in unterschiedlichen Einsatzskalen zu ermöglichen.
Nemotron 3: Offene MoE-Modelle für Multiagenten- und agentenbasierte KI
Gleichzeitig hat NVIDIA die Nemotron-3-Familie vorgestellt , ein offenes Ökosystem aus Modellen, Datensätzen und Bibliotheken für die Entwicklung transparenter und effizienter agentenbasierter KI-Systeme. Beim Übergang von Chatbots mit nur einem Modell zu komplexeren Multiagentenarchitekturen stoßen Unternehmen auf Herausforderungen wie Kommunikationsaufwand zwischen den Agenten, Kontextdrift in langen Arbeitsabläufen und steigende Inferenzkosten. Zudem wächst der Bedarf an Transparenz, um Verständnis und Vertrauen in KI-Systeme zu schaffen, die in kritische Geschäftsprozesse eingebettet sind.
Nemotron 3 erfüllt diese Anforderungen mit einer hybriden latenten Mixture-of-Experts-Architektur (MoE), die für Multiagenten-Workloads in großem Umfang ausgelegt ist. Die Modelle sollen kollaboratives Agentenverhalten, spezialisierte Fähigkeiten und effizientes Aufgabenrouting unterstützen und gleichzeitig vorhersehbare Leistungs- und Kostenprofile gewährleisten.
Jensen Huang, Gründer und CEO von NVIDIA, betonte, dass offene Innovation für den Fortschritt der KI unerlässlich sei. Er hob hervor, dass Nemotron modernste KI in eine zugängliche Plattform umwandelt und so Transparenz und Effizienz erhöht, um die Entwicklung groß angelegter agentenbasierter Systeme zu unterstützen.
Nationale und regionale KI-Initiativen in Europa, Südkorea und anderen Regionen nutzen Nemotron bereits als Grundlage für eine offene, lokal gesteuerte KI-Entwicklung. Zu den Vorreitern, darunter Accenture, Cadence, CrowdStrike, Cursor, Deloitte, Palantir, Perplexity und weitere, integrieren Nemotron-Modelle in Arbeitsabläufe, die Fertigung, Cybersicherheit, Softwareentwicklung, Medien und Kommunikation umfassen.
Modellpalette: Nano, Super und Ultra
Nemotron 3 besteht aus drei Hauptebenen des MoE-Modells, die jeweils auf unterschiedliche Arbeitslastklassen ausgerichtet sind:
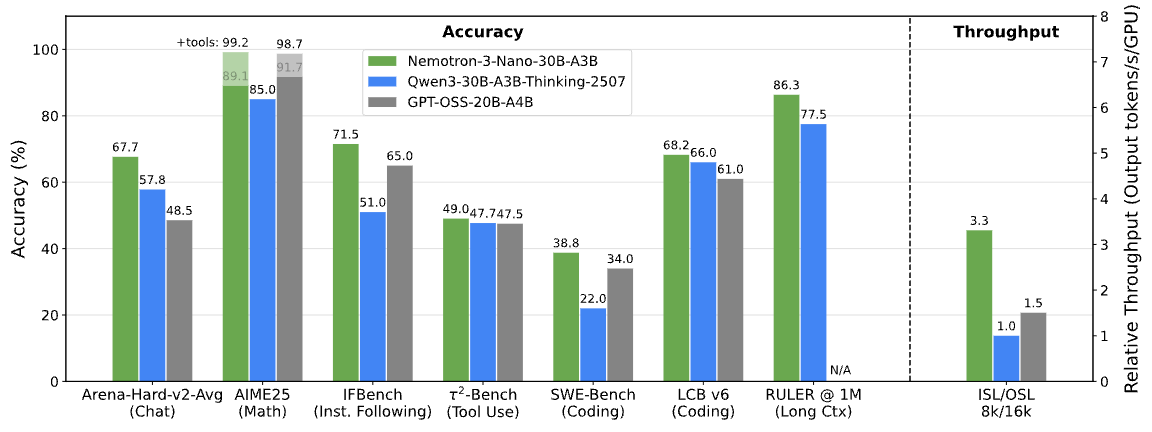
- Nano ist ein kleines Modell mit etwa 30 Milliarden Parametern, aktiviert bis zu 3 Milliarden Parameter pro Token für effizientes Schließen. Es ist geeignet für Aufgaben like Debuggen, Zusammenfassung, KI Pipelinesund Informationsabruf, wo geringe Latenz und kosten Diese entscheidend. Seine Das hybride MoE-Design ermöglicht einen bis zu vierfach höheren Token-Durchsatz als Nemotron 2 Nano und reduziert die Inferenzkosten um bis zu 60 Prozent, wodurch die Gesamtkosten für die Inferenz gesenkt werden.Mit einem Kontextfenster von 1 Million Token, Nemotron 3 Nano bei der Instandhaltungs mehr Bundesstaat über lange Arbeitsabläufe optimieren, die Genauigkeit verbessern und entfernte Zusammenhänge herstellen. Unabhängige Benchmarks stufen es so ein. eines der offensten und effizientesten Modelle seiner Art Klasse, mit Obenverladearme Genauigkeit unter Peers.
- Super ist ein hochpräzises Schlussfolgerungsmodell mit rund 100 Milliarden Parametern und bis zu 10 Milliarden aktiven Parametern pro Token. Es ist für Multiagentensysteme konzipiert, in denen viele Agenten zusammenarbeiten, um komplexe Ziele unter geringen Latenzanforderungen zu erreichen. Super eignet sich für Szenarien, in denen die Schlussfolgerungstiefe, der Werkzeugeinsatz und die Koordination zwischen den Agenten skalierbar sein müssen, ohne die Kosten der größten Modelle zu verursachen.
- Ultra ist das Spitzenmodell und fungiert als leistungsstarke Inferenzmaschine mit ca. 500 Milliarden Parametern und bis zu 50 Milliarden aktiven Parametern pro Token. Es ist für anspruchsvollste KI-Workflows konzipiert, darunter Tiefenanalysen, strategische Planung und komplexe Entscheidungssysteme, die qualitativ hochwertige Schlussfolgerungen über sehr lange Kontexte hinweg erfordern.
Nemotron 3 Super und Ultra werden mit NVIDIAs 4-Bit-NVFP4-Format auf der Blackwell-Architektur trainiert. Dieses Trainingsformat reduziert den Speicherbedarf deutlich und verbessert den Trainingsdurchsatz bei gleichbleibender Genauigkeit im Vergleich zu Formaten mit höherer Präzision. Für Unternehmen und Serviceprovider ermöglicht dies das Training größerer Modelle auf bestehender Infrastruktur oder reduziert den Hardwarebedarf für eine bestimmte Skalierung.
Mit dieser gestaffelten Modellfamilie können Entwickler die Modellgröße und -funktionen an spezifische Arbeitslasten und Kostenziele anpassen und von Dutzenden auf Hunderte von Agenten skalieren, während gleichzeitig ein schnelleres und genaueres langfristiges Schließen über komplexe, mehrstufige Arbeitsabläufe hinweg gewährleistet wird.
Routing, Token-Ökonomie und Hybridmodellstrategien
Mit zunehmender Reife von Multiagentensystemen setzen viele Organisationen auf hybride Modellstrategien. Für besonders komplexe Schlussfolgerungsaufgaben kommen innovative, proprietäre Modelle zum Einsatz, während effiziente, anpassbare Open-Source-Modelle Routineaufgaben oder domänenspezifische Workloads bewältigen. Nemotron 3 ist explizit für diese Art von routingbasierter Architektur konzipiert.
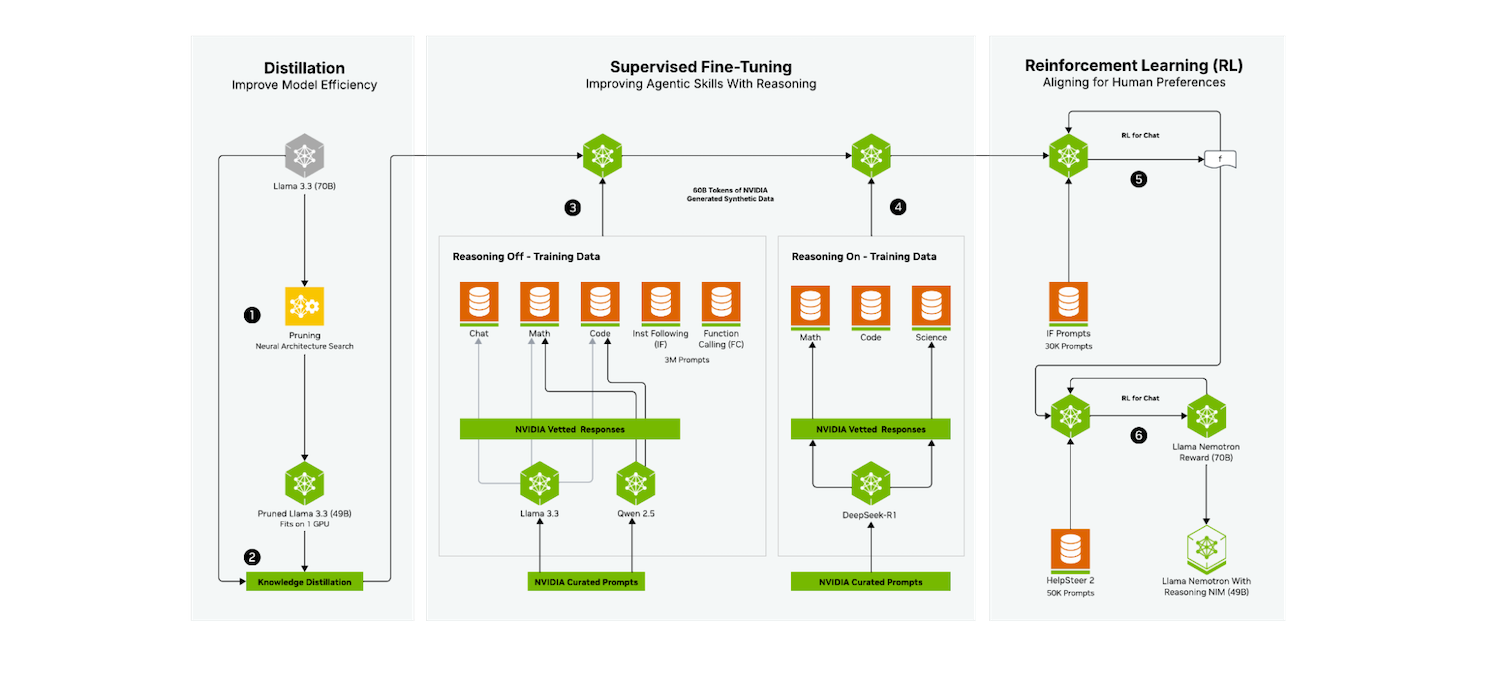
In einer typischen Konfiguration analysiert ein Agent-Router Aufgaben in Echtzeit. Er leitet sie entweder an ein optimiertes Nemotron-Modell, wie beispielsweise Nemotron 3 Ultra, oder an ein proprietäres Modell weiter, wenn dieses einen einzigartigen Mehrwert bietet. Dieser Ansatz optimiert die Token-Ökonomie, indem teure Spitzenkapazität für besonders anspruchsvolle Fälle reserviert und Nemotron für Workloads mit hohem Durchsatz und hoher Effizienz genutzt wird.
Partner, die KI-Assistenten und Agentenplattformen entwickeln, berichten, dass diese Routing-Strategie es ihnen ermöglicht, eine höhere Reaktionsfähigkeit und eine bessere Kostenkontrolle zu bieten und gleichzeitig die Flexibilität zu bewahren, im Laufe der Zeit verschiedene Modellanbieter und Trainingsstrategien zu integrieren.
Offene Daten, Bibliotheken und Sicherheitswerkzeuge
Über die Modelle selbst hinaus stellt NVIDIA eine umfangreiche Sammlung offener Ressourcen zur Unterstützung der Entwicklung benutzerdefinierter Agenten bereit:
Trainings- und RL-Datensätze
NVIDIA stellt 3 Billionen Tokens der Nemotron-Datensätze für Pre-, Post- und Reinforcement Learning bereit. Diese Datensätze umfassen eine Vielzahl von Beispielen zu logischem Denken, Codierung und mehrstufigen Arbeitsabläufen, die zum Trainieren oder Feinabstimmen domänenspezifischer Agenten verwendet werden können. Der Nemotron Agentic Safety Dataset bietet Telemetriedaten aus der Praxis, mit denen Teams die Sicherheit komplexer, autonomer Systeme bewerten und verbessern können.
NeMo Gym und NeMo RL
Um Reinforcement Learning und die Nachbearbeitung zu vereinfachen, hat NVIDIA NeMo Gym und NeMo RL als Open-Source-Bibliotheken veröffentlicht. Diese bieten Trainingsumgebungen und Grundlagen für die Nachbearbeitung, die auf Nemotron-Modelle abgestimmt sind und sich auch für andere Architekturen erweitern oder anpassen lassen. Der NeMo Evaluator ist enthalten, um die Sicherheit und Leistung der Modelle anhand verschiedener Benchmarks und Anwendungsfälle zu bewerten.
Alle diese Tools und Datensätze sind auf GitHub und Hugging Face verfügbar, sodass Teams sie in bestehende MLOps-Pipelines und Trainingsworkflows integrieren können. Anbieter im Ökosystem wie Prime Intellect und Unsloth integrieren bereits NeMo Gym-Trainingsumgebungen in ihre Plattformen, um Reinforcement Learning für Unternehmenskunden zu vereinfachen.
Die Nemotron 3-Modelle sind außerdem mit gängigen Inferenz- und Bereitstellungsframeworks wie LM Studio, llama.cpp, SGLang und vLLM kompatibel, was die Durchführung lokaler Experimente und die Bereitstellung in verschiedenen Umgebungen erleichtert.
Verfügbarkeit
Nemotron 3 Nano ist ab heute über verschiedene Vertriebskanäle erhältlich, die im Folgenden aufgeführt sind.
Modell-Hubs und Inferenzanbieter: Das Nemotron 3 Nano-Modell ist auf Hugging Face und über Inferenzanbieter wie Baseten, DeepInfra, Fireworks, FriendliAI, OpenRouter und Together AI verfügbar. Diese Dienste ermöglichen Teams eine schnelle Evaluierung des Modells und dessen Integration in bestehende Anwendungen.
Unternehmensplattformen: Nemotron-Modelle werden in KI- und Datenplattformen für Unternehmen integriert, darunter Couchbase, DataRobot, H2O.ai, JFrog, Lambda und UiPath. Dadurch können Kunden Nemotron-basierte Funktionen direkt in ihre Daten-, Orchestrierungs- und Automatisierungssysteme einbetten.
Public Cloud und NIM Microservices: Für Public-Cloud-Nutzer wird Nemotron 3 Nano über Amazon Bedrock für serverlose Inferenz auf AWS verfügbar sein und außerdem auf Google Cloud, CoreWeave, Crusoe, Microsoft Foundry, Nebius, Nscale und Yotta verfügbar sein.
Nemotron 3 Nano wird auch als NVIDIA NIM-Mikrodienst für eine sichere, skalierbare Bereitstellung auf NVIDIA-beschleunigter Infrastruktur angeboten und bietet Unternehmen so mehr Kontrolle über Datenschutz, Datenlokalität und Leistung.
Nemotron 3 Super und Ultra werden voraussichtlich in der ersten Hälfte des Jahres 2026 verfügbar sein. Dies gibt Unternehmen Zeit, sich für frühe agentenbasierte Anwendungsfälle auf die Nano-Ebene zu standardisieren und zukünftige Migrationen auf größere Modelle zu planen, wenn die Anforderungen steigen.


 Amazon