

Die LPU (Language Processing Unit) ist ein von Groq, Inc. entwickelter und gebauter KI-Inferenzbeschleuniger. Groq wurde 2016 von Jonathan Ross gegründet, einem ehemaligen Google-Ingenieur und einem der ursprünglichen Erfinder der TPU. Das Unternehmen entwickelte jahrelang eine deterministische, softwaredefinierte Prozessorarchitektur von Grund auf. Im Gegensatz zu GPUs, die auf dynamischer Hardwareplanung und mehrstufigen Cache-Hierarchien basieren, verfolgt die LPU einen radikal anderen Ansatz: Sie eliminiert alle reaktiven Hardwarekomponenten und verlagert die gesamte Steuerungsebene in den Compiler. Dies ermöglicht eine vollständig vorhersagbare Ausführung bis hin zum Taktzyklus.
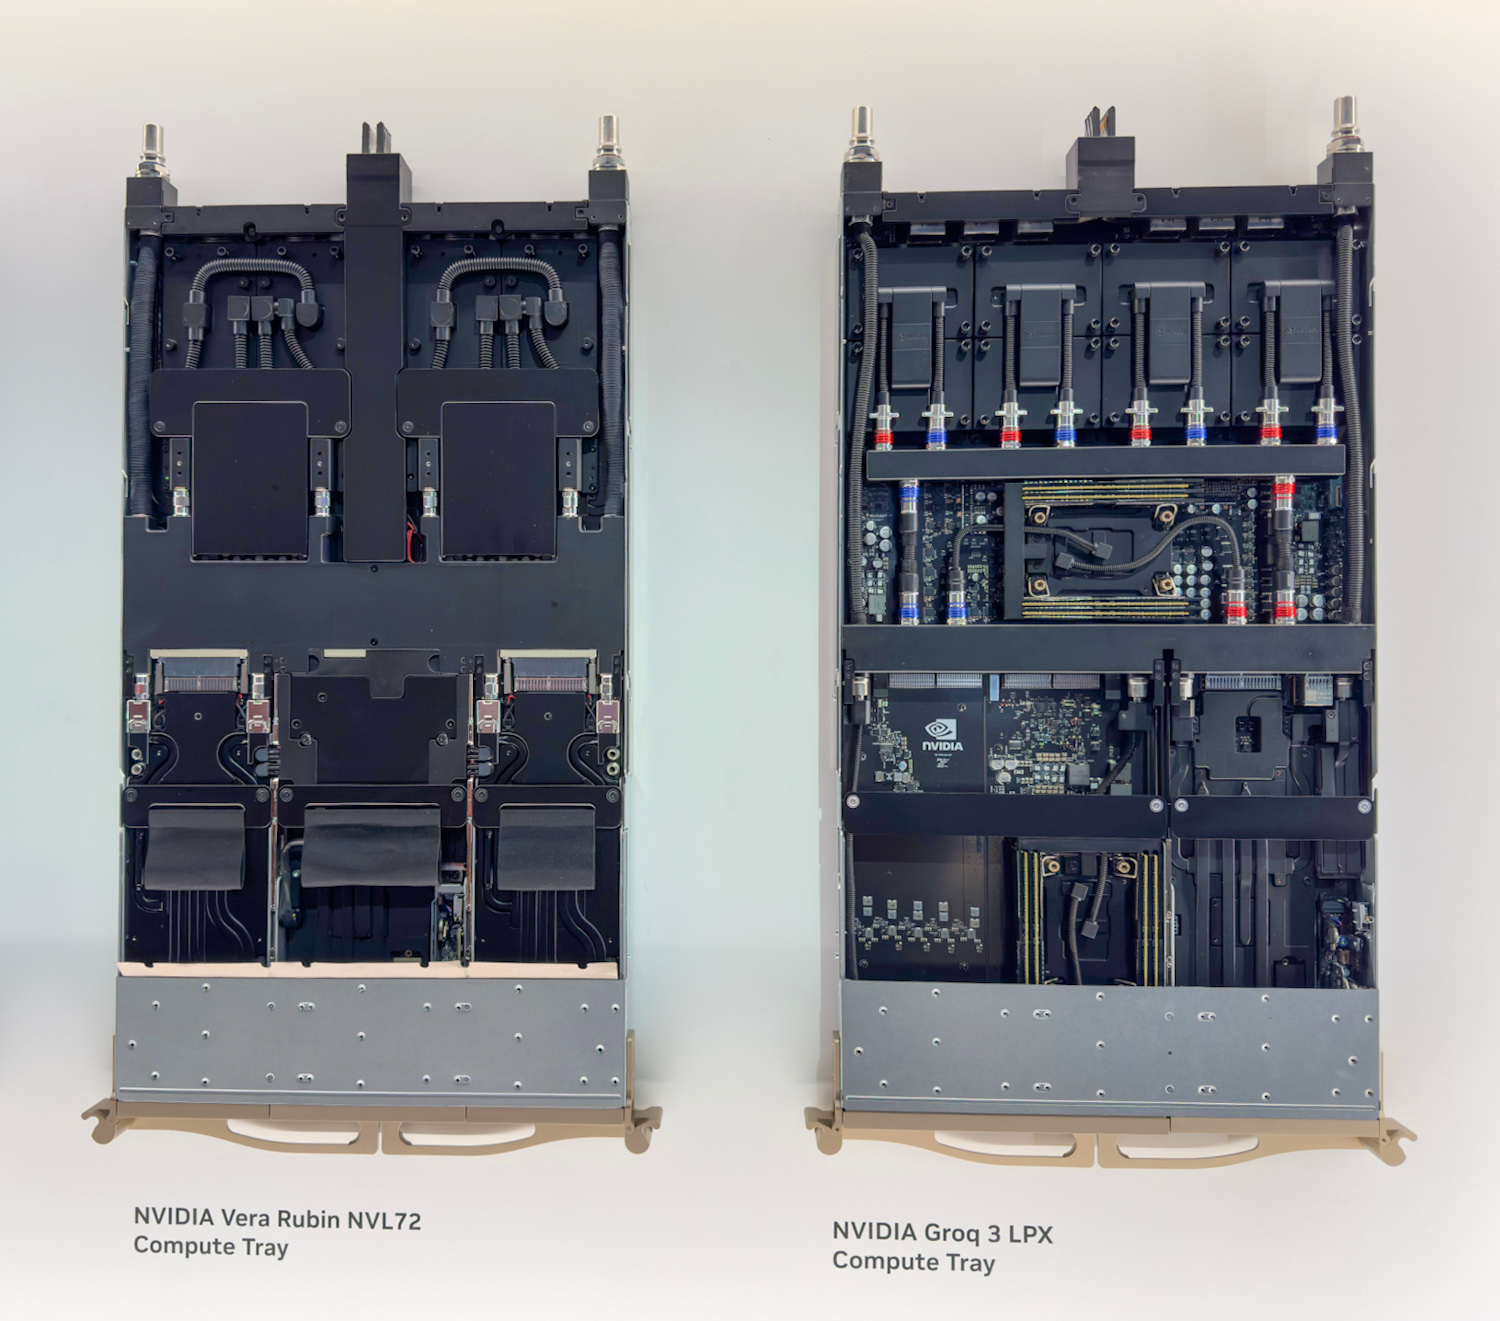
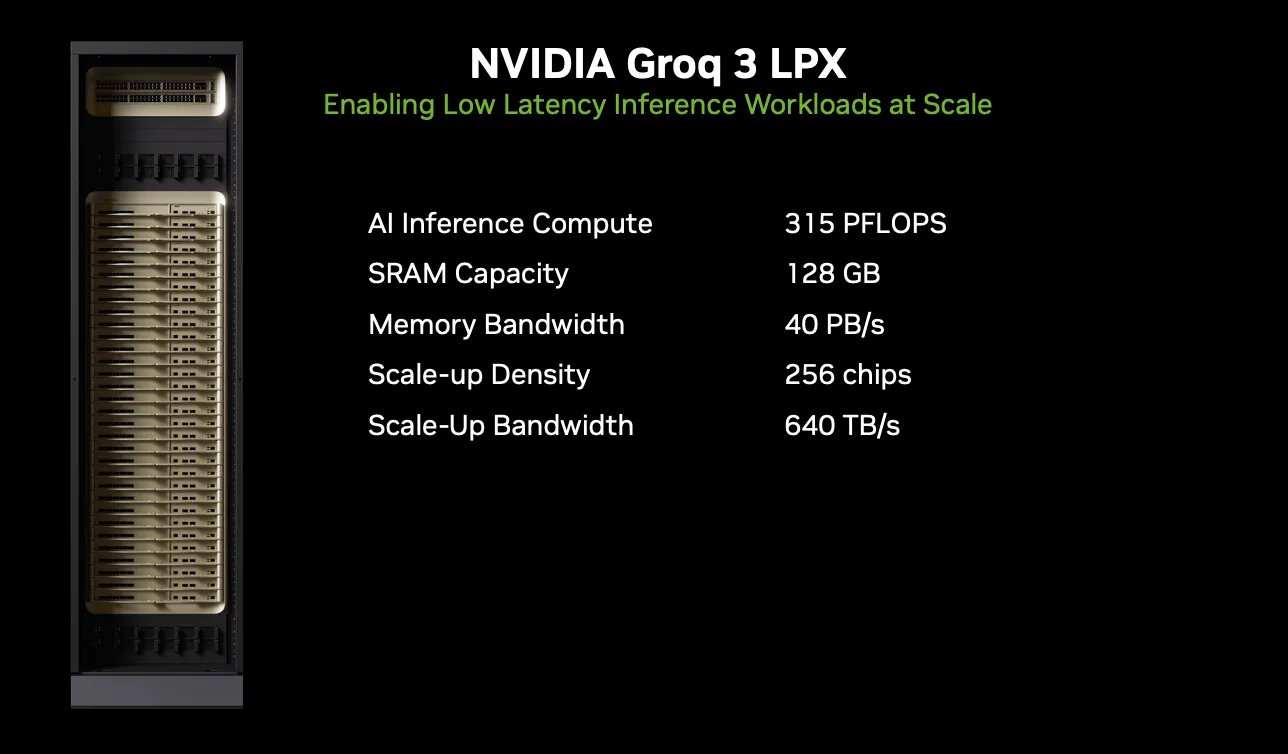
Im Dezember letzten Jahres übernahm NVIDIA Groq und integrierte damit die LPU-Architektur in sein Portfolio. Die Übernahme sorgte in der Branche für großes Aufsehen und löste sofort Spekulationen darüber aus, wie NVIDIA die Groq-Technologie in sein Rechenzentrums-Ökosystem integrieren würde. Diese Fragen wurden schließlich auf der GTC 2026 beantwortet, wo NVIDIA den Groq 3 LPX als siebten Chip der Vera Rubin Plattform vorstellte. Dieser kombiniert 256 LPU-Beschleuniger in einem Rack-System mit dem Vera Rubin NVL72.
Was geschah mit CPX?
Letztes Jahr kündigte NVIDIA auf dem AI Infra Summit das CPX-Rack in verschiedenen Konfigurationen an, das die Bearbeitung von Long-Context-Inferenzabfragen beschleunigen soll. Nach unserer ersten Berichterstattung darüber stellten sich uns einige Fragen zur eigentlichen Funktion des CPX. Auf den ersten Blick schien das CPX, obwohl es ein interessantes Architekturkonzept darstellte, außer einer möglichen zusätzlichen Beschleunigung von Aufmerksamkeitsoperationen keine wesentlichen Neuerungen über die Rubin-GPU selbst hinaus zu bieten. Dann folgte die Übernahme von Groq, die Spekulationen darüber auslöste, wie NVIDIA die LPU-Technologie von Groq in die umfassendere Vera-Rubin-Plattform integrieren würde.
NVIDIA hat auf der GTC 2026 mit der LPX-Ankündigung für Klarheit gesorgt. Demnach hat sich das CPX-Rack-Konzept zum Groq 3 LPX Rack weiterentwickelt. Der Fokus des ursprünglichen CPX auf Kontextverarbeitung weicht einer grundlegend anderen Architektur zur Dekodierungsbeschleunigung, die auf dem Groq-Silizium basiert. Das LPX Rack ist vollständig flüssigkeitsgekühlt, basiert auf der MGX-Infrastruktur und wird in der zweiten Jahreshälfte 2026 zeitgleich mit der breiteren Einführung von Vera Rubin verfügbar sein. NVIDIA verspricht mit dieser neuen Ergänzung einen bis zu 35-fach höheren Inferenzdurchsatz pro Megawatt und bis zu 10-fach höhere Umsatzchancen für Modelle mit Billionen von Parametern.
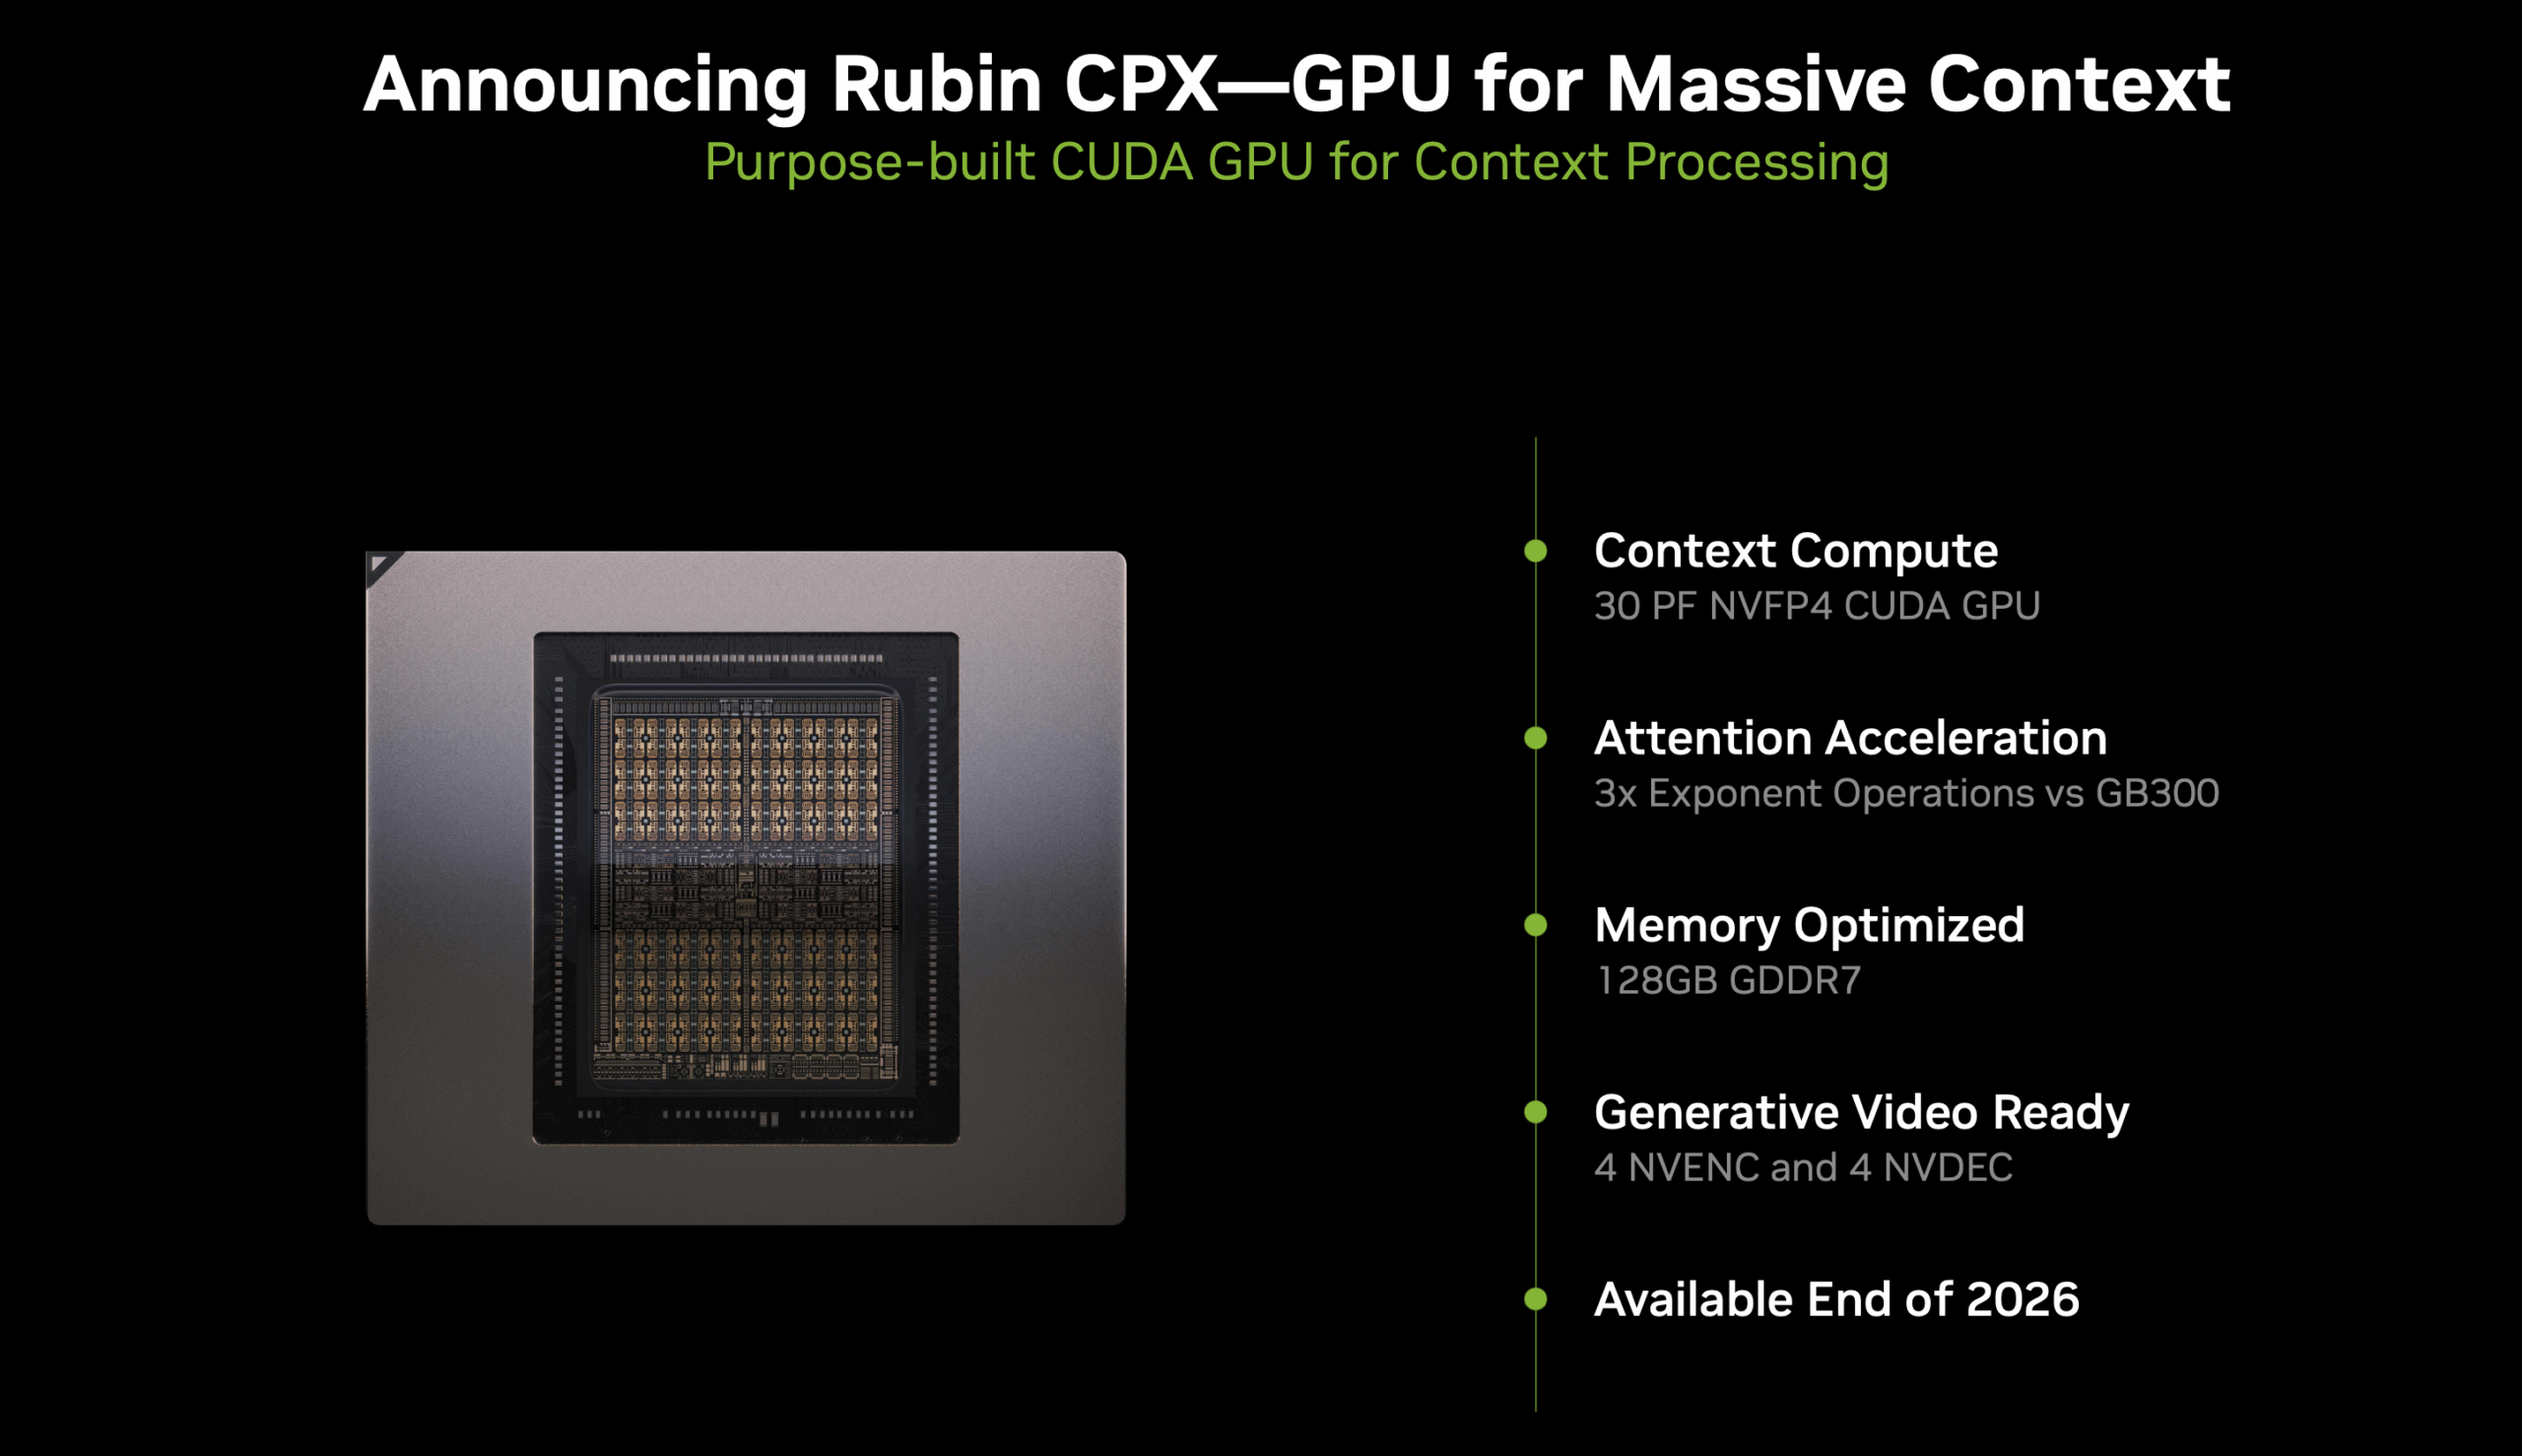
Noch wichtiger ist jedoch, dass NVIDIA bestätigte, dass die LPU als Beschleuniger innerhalb des bestehenden CUDA-Stacks auf den Vera- und NVL72-Plattformen fungiert und die Berechnungen transparent tokenbasiert auslagert. Während der GTC-Fragerunde beschrieb NVIDIA die LPU als „Booster für Dekodierungsmodelle“ und erklärte, dass man eng mit KI-Laboren und führenden Modellentwicklern zusammenarbeiten werde, die Modelle mit Billionen von Parametern einsetzen, um die nächste Generation von Premium-Modellbereitstellungen zu ermöglichen.
Nachdem die CPX-Frage geklärt ist, stellt sich natürlich die Frage: Was genau ist diese LPU, um die NVIDIA ein komplettes Rack-System aufbaut?
Was ist eine LPU?
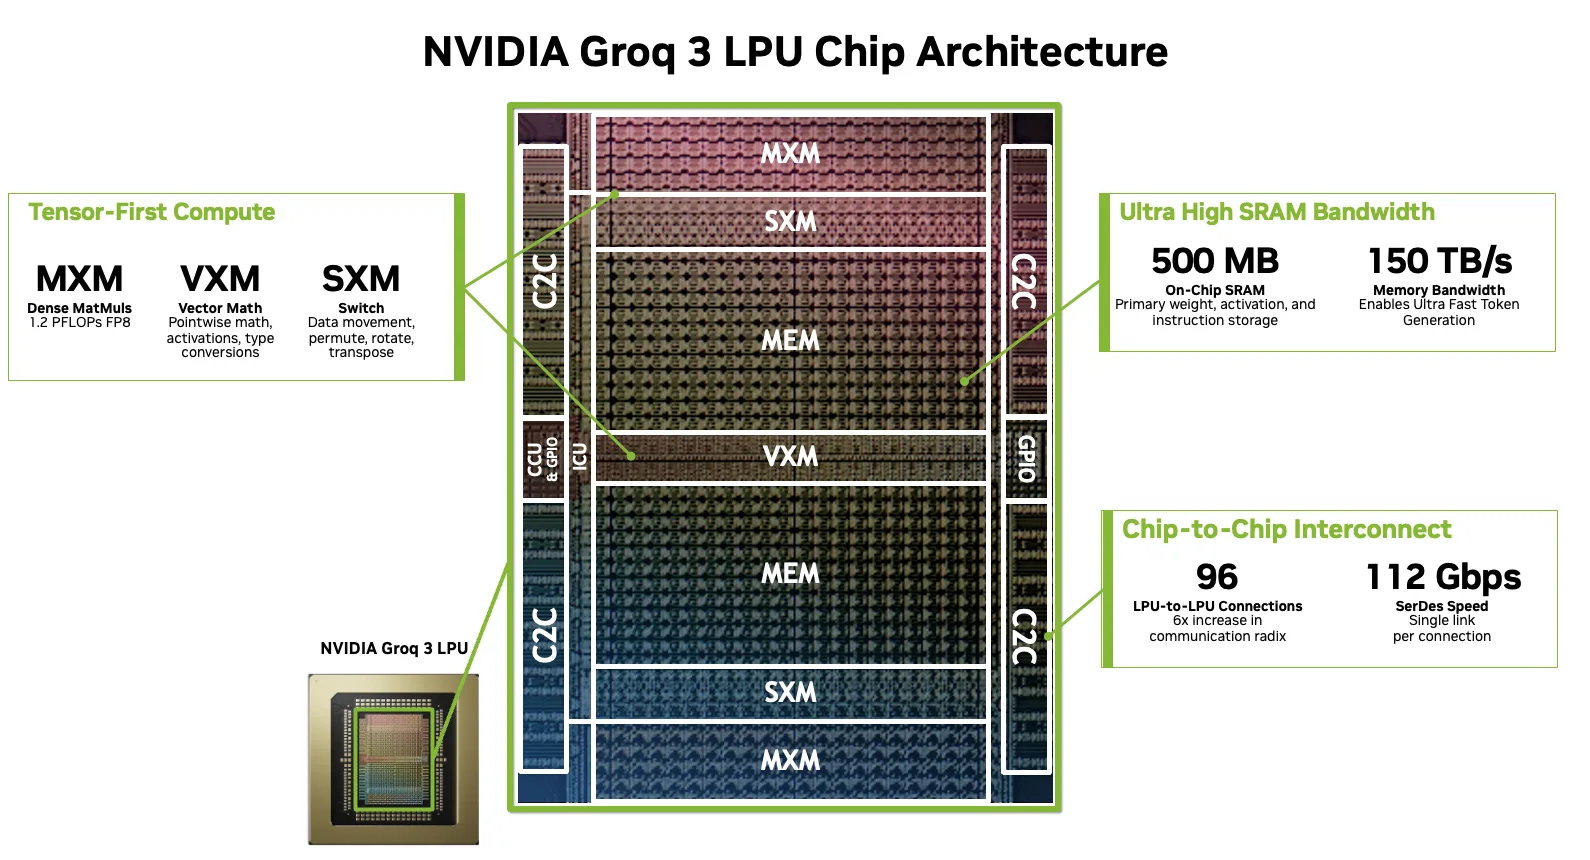
Im Kern ist die LPU ein sehr großer Vektorprozessor. Die grundlegende Rechen- und Kommunikationseinheit ist ein 320-elementiger Vektor, bestehend aus 320 Bytes bei INT8 und 640 Bytes bei FP16. Jede Operation auf dem Chip, ob Arithmetik, Speicherzugriff, Datenumformung oder Datentransfer zwischen Chips, arbeitet mit diesen Vektoren fester Größe.
Quelle: Nvidia
Die Architektur basiert auf einem einzigen grundlegenden Baustein: einer SIMD-Funktionseinheit in Kombination mit einer schlanken Befehlsverteilungseinheit. Groq behandelt dies als Basisklasse, die in vier verschiedene Typen spezialisiert wird, von denen jeder für eine bestimmte Kategorie von Operationen optimiert ist:
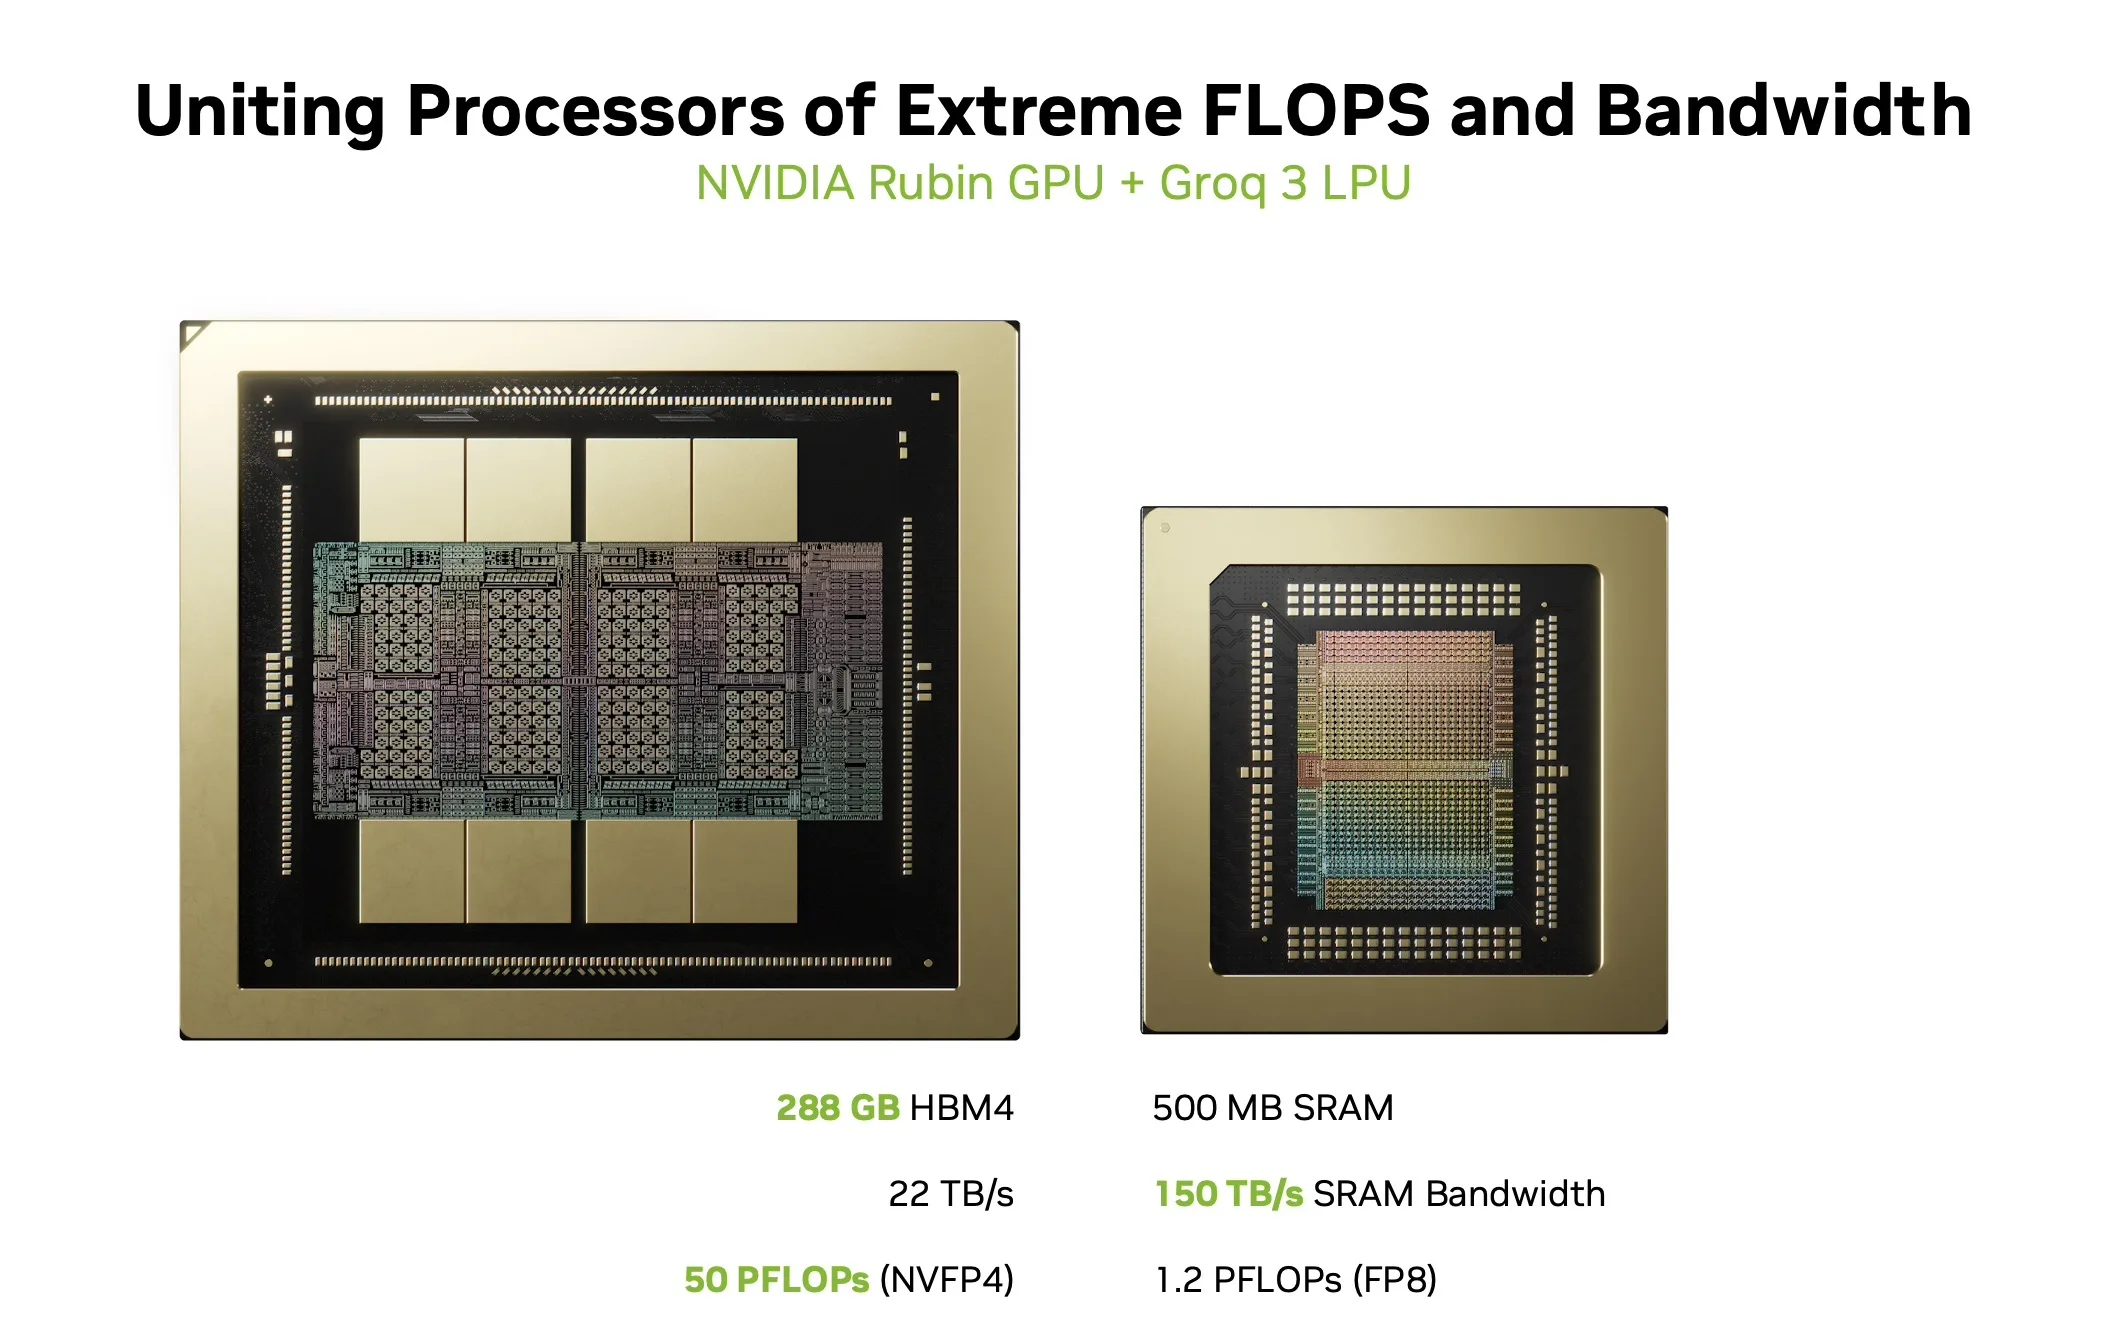
Matrix Execution Modules (MXM): Die primäre Recheneinheit, die eine hohe Multiplikations-Akkumulations-Leistung für Matrix-Vektor- und Matrix-Matrix-Operationen bietet. Jeder der acht Groq 3 LP30-Chips im LPX-Rack von NVIDIA liefert 1.2 PFLOPS FP8-Rechenleistung pro Chip, insgesamt 9.6 PLOPS FP8-Rechenleistung pro LPX-Einschub.
Vektorausführungsmodule (VXM): Sie verarbeiten punktweise Arithmetik, logische Operationen, Typumwandlungen und Aktivierungsfunktionen. Das VXM enthält ein Array von ALUs, die der Compiler automatisch verkettet, um in einem einzigen Durchlauf zusammengesetzte Operationen auszuführen (z. B. Reduktion, gefolgt von Bias-Addierung, Aktivierung und Typumwandlung).
Switch Execution Modules (SXM): Führen strukturierte Datenbewegungen durch, einschließlich Permutation, Rotation, Verteilung und Transposition von Vektoren.
Speichereinheiten (MEM): Eine flache, SRAM-basierte Speicherarchitektur ohne Caches, Hierarchie und ohne Cache-Fehler. Der Groq 3 LP30 bietet 500 MB On-Chip-SRAM mit einer Bandbreite von 150 TB/s. Der Compiler adressiert direkt physische Speicherbänke und kennt somit die exakte Position aller Daten während der gesamten Programmausführung.
Mehrere Kopien jedes Funktionseinheitentyps sind über die horizontale Dimension des Chips angeordnet. Befehle fließen von oben und unten zur Mitte, während Datenströme von Osten nach Westen fließen und die Funktionseinheiten durchlaufen, um Operationen auszuführen.
Die 1D-Verbindung, Stream-Register und Determinismus
Stream-Register und die 1D-Verbindung
Die Kommunikation zwischen den Funktionseinheiten der LPU erfolgt über Stream-Register, eine bewusst einfache, eindimensionale Verbindung. Es existieren zwei Kommunikationspfade: einer in Richtung Osten und einer in Richtung Westen, wobei jedes Stream-Register einen einzelnen Datensprung (Hop) darstellt. Die Daten werden mit genau einem Hop pro Taktzyklus übertragen. Dadurch kann der Compiler die Laufzeit zwischen zwei beliebigen Funktionseinheiten durch einfache Addition oder Subtraktion anhand ihrer physischen Positionen auf dem Chip-Layout berechnen.
Im Verbindungsnetzwerk gibt es weder Warteschlangen noch Konfliktmechanismen. Dadurch wird das Scheduling-Problem von einem komplexen zweidimensionalen Bin-Packing-Problem zu einem deutlich handhabbareren eindimensionalen Problem vereinfacht. Igor Arsovski, Chefarchitekt von Groq, beschreibt es treffend: Der Compiler weiß exakt, wo sich ein Datenelement in zehn Zyklen befindet, da es genau zehn Hops entfernt ist. Es gibt keine Mehrdeutigkeiten, keine Spekulationen und keine Hardware, die unabhängige Routing-Entscheidungen trifft.
Determinismus
Das definierende Merkmal der LPU ist der Determinismus. Im Gegensatz zu herkömmlichen Prozessoren, bei denen dynamische Ablaufplanung, Cache-Verhalten und Speicherzugriffskonflikte Laufzeitschwankungen verursachen, arbeiten LPUs mit Null-Varianz, und jede Funktionseinheit arbeitet synchron.
Dieser Determinismus wird erreicht, indem Funktionen wie Hardware-Verriegelungen entfernt und die gesamte Entscheidungsfindung in den Compiler verlagert wird; die Hardware führt lediglich den resultierenden Ablaufplan aus. Weitere Vorteile dieses Ansatzes sind die durchgängig identische Latenz und der jederzeit vorhersehbare Stromverbrauch.
Determinismus erstreckt sich auch auf den numerischen Bereich durch die von Groq entwickelte TruePoint-Technologie. Die garantierte Operationsreihenfolge der Architektur ermöglicht dabei eine Genauigkeit auf FP32-Niveau bei FP16-Eingaben durch ein 320-elementiges Skalarprodukt mit nur einem Rundungsschritt. Warum numerischer Determinismus für die LLM-Inferenz relevant ist und warum nicht-deterministische Hardware bei verschiedenen Durchläufen leicht unterschiedliche Ergebnisse liefert, wird ausführlich im Whitepaper „Defeating Nondeterminism in LLM Inference“ von Thinking Lab erläutert . Dies ist nicht Gegenstand dieses Artikels, aber Leser, die sich für die Auswirkungen auf die numerische Genauigkeit interessieren, finden die entsprechende Analyse in der technischen Dokumentation zu Groqs TruePoint (Link am Ende).
Wie LPUs verbunden werden: RealScale, die Montagelinie und die Rack-Topologie
Das Fließband: Wie Daten fließen
Im einfachsten Fall funktioniert der Datenaustausch zwischen LPUs wie ein Fließband. Beim Kompilieren eines Modells für das System unterteilt der Compiler dieses in Phasen und ordnet jede Phase einer Gruppe von LPU-Chips zu. Jede Gruppe speichert die benötigten Gewichtungsparameter im lokalen On-Chip-SRAM. Während der Inferenz werden lediglich die Zwischenergebnisse der Aktivierungsausgabe der vorherigen Phase zwischen den Chipgruppen übertragen. Die Daten fließen wie ein Produkt auf einem Förderband von Chip zu Chip, wobei jede Station ihre zugewiesene Berechnung durchführt und das Ergebnis an die nächste weitergibt. Dies unterscheidet sich grundlegend von GPUs, bei denen jede Berechnungsphase den gesamten Gewichtssatz aus dem externen HBM-Speicher abrufen und die Ergebnisse zurückschreiben muss. Auf der LPU sind die Gewichte bereits im SRAM jeder Station vorhanden; nur die Aktivierungstensoren werden übertragen.
Hinweis zu C2C-Verbindungen: RealScale, nicht NVIDIA C2C
Bevor wir auf die Details der Topologie eingehen, ist es wichtig, eine mögliche Fehlerquelle zu klären. Die im gesamten LPX-System verwendeten Chip-zu-Chip-Verbindungen (C2C) sind die RealScale C2C-Verbindungen von Groq. Diese sind nicht mit der C2C-Technologie von NVIDIA identisch, die an anderer Stelle im NVIDIA-Ökosystem zum Einsatz kommt. Die beiden Technologien unterscheiden sich architektonisch.
- NVIDIA C2C ist eine Cache-kohärente Verbindung, die für die Verbindung zweier unterschiedlicher Chiptypen innerhalb eines eng gekoppelten Moduls, wie beispielsweise einer CPU-GPU-Verbindung, entwickelt wurde. Sie verwendet ein kohärentes Protokoll mit schnellerem SerDes und ist für die heterogene Chip-zu-Chip-Kommunikation innerhalb eines einzelnen Gehäuses oder Moduls ausgelegt.
- Groq RealScale C2C ist eine softwaregesteuerte, deterministische Punkt-zu-Punkt-Verbindung. Die Netzwerkverbindungen werden explizit vom Compiler flussgesteuert und als vollwertige Funktionseinheiten eingeplant, genau wie die MXM- oder VXM-Recheneinheiten. Es gibt keine Hardware-Arbitrierung oder adaptives Routing, und Pakete enthalten keine Quell- oder Ziel-Header. Die Verbindungen sind phasenkorrigiert und verhalten sich wie Hochgeschwindigkeits- und latenzarme Verbindungen zwischen den Chips. Ein plesiochrones Protokoll kompensiert deterministisch die natürliche Taktabweichung zwischen den Chips und stellt dem Compiler so eine einheitliche Zeitdomäne für das gesamte Netzwerk zur Verfügung.
Jede C2C-Verbindung im LPX-Rack, ob innerhalb eines Trays, zwischen Trays über die Spine oder zwischen Racks über die Frontpanel-Anschlüsse, nutzt RealScale. Es handelt sich dabei um dieselbe grundlegende Verbindungstechnologie, die Groq seit dem ursprünglichen GroqNode verwendet, mit erhöhter Verbindungsgeschwindigkeit (von 30 Gbit/s auf 112 Gbit/s pro Lane), aber unveränderter Architektur.
Hinweis: Der nächste Abschnitt, der die Konnektivität erläutert, basiert auf unserem Verständnis der Architektur, basierend auf der Dokumentation von Groq (am Ende verlinkt), dem Blogbeitrag von NVIDIA und der uns am GTC-Stand gegebenen Erklärung zum Rack:
- Die von den LPX-Rackeinheiten verwendeten C2C-Verbindungen basieren auf der Technologie von Groq und sind nicht identisch mit den in anderen Rack-Systemen von NVIDIA verwendeten C2C-Verbindungen.
- Die vier C2C-Verbindungen an der Vorderseite jedes LPX-Rackgeräts dienen zur Verbindung mit benachbarten Rackgeräten auf derselben Ebene.
- Innerhalb eines Racks findet eine vollständige Kommunikation zwischen den LPUs statt.
- Der Prozessor im LPX-Rack ist ein x86-Prozessor.
Konnektivität innerhalb des Trays
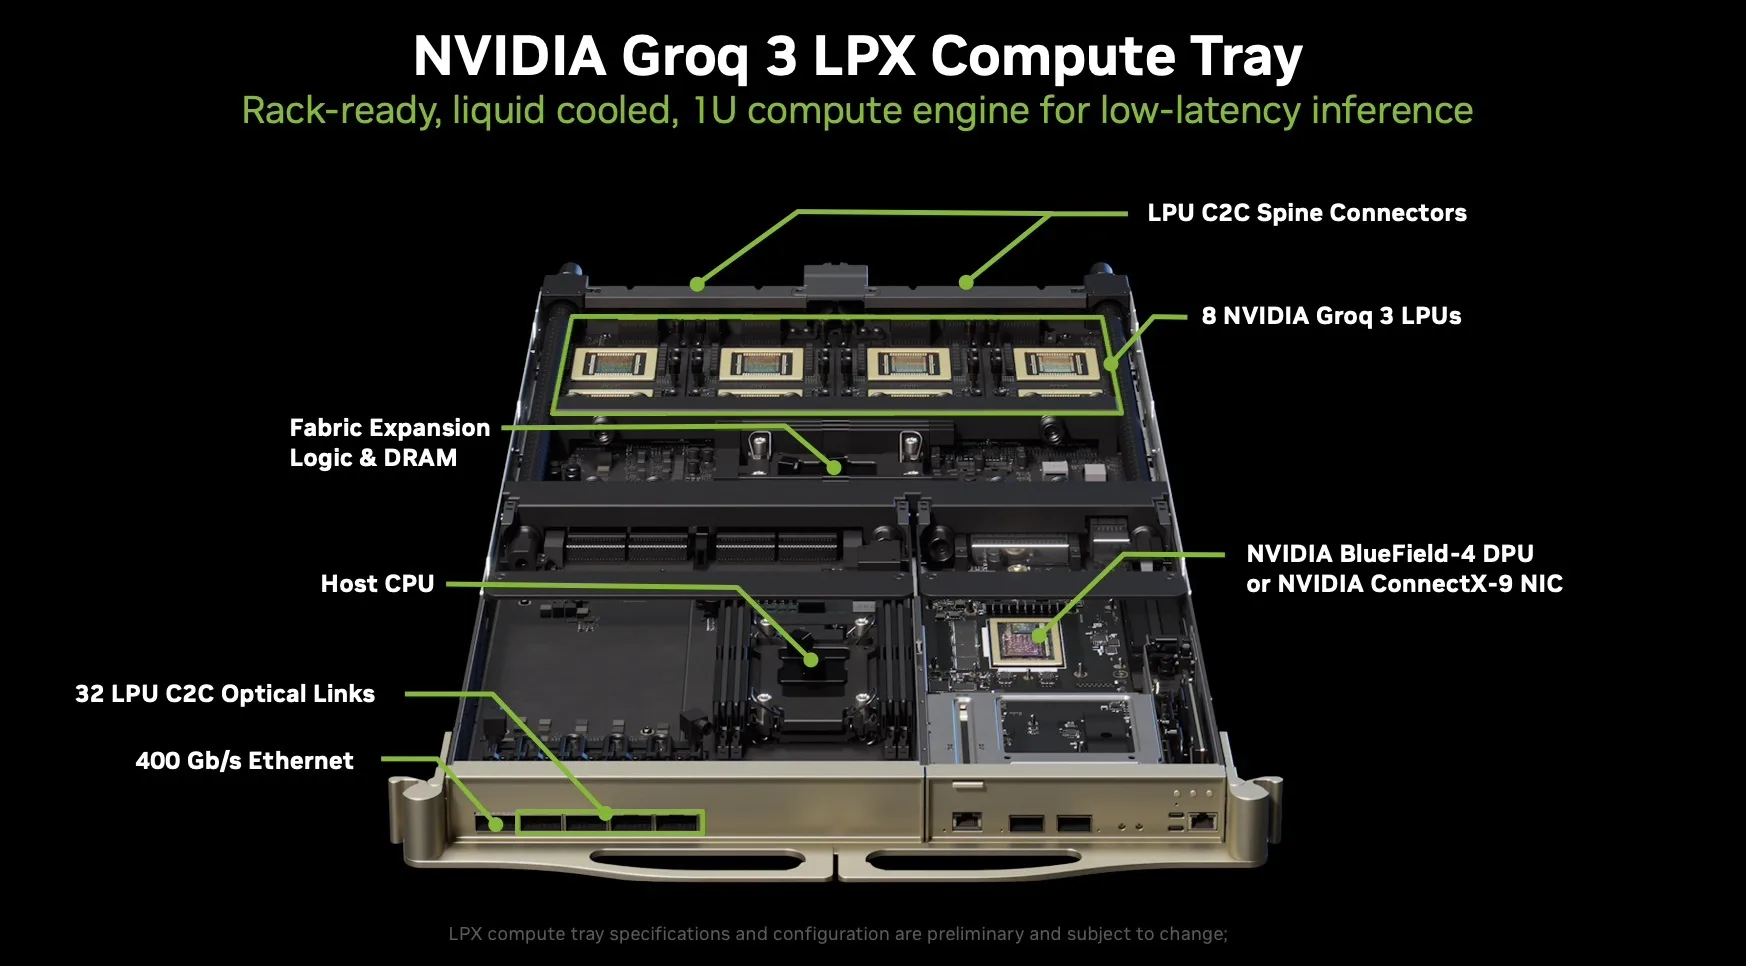
Der grundlegende Baustein der Netzwerktopologie von Groq hat sich vom ursprünglichen GroqNode zum NVIDIA Groq 3 LPX nicht verändert. Jedes 1U-Rechengehäuse enthält genau acht LP30-Chips, die dicht in einem vollständigen Graphen (Alle-zu-Alle) miteinander verbunden sind, wobei jeder Chip direkt und mit der gleichen Geschwindigkeit mit jedem anderen Chip kommunizieren kann.
Quelle: Nvidia
Jeder LP30-Chip verfügt über 96 C2C-Verbindungen mit jeweils 112 Gbit/s, was eine bidirektionale Bandbreite von 2.5 TB/s pro Chip ergibt. In einem vollständigen Graphen mit 8 Chips hat jeder Chip 7 Nachbarn. Die Anzahl der eindeutigen Chip-zu-Chip-Verbindungen innerhalb eines Trays beträgt C(8,2) = 28. Ein Teil der 96 Verbindungen jedes Chips ist für diese All-to-All-Verbindungen innerhalb des Trays reserviert, während die restlichen Verbindungen zur Backplane (für die Rack-Spine) und zum Frontpanel (für Inter-Rack-Verbindungen) geführt werden. Die von NVIDIA veröffentlichten Spezifikationen geben eine Gesamtskalierungsbandbreite von 20 TB/s pro Tray an, die die kombinierte Bandbreite innerhalb des Trays und der Spine darstellt. Dies lässt sich überprüfen: Jedes Tray enthält 8 Chips × 96 Verbindungen = insgesamt 768 Verbindungen. Nach Abzug der 32 Frontpanel-Inter-Rack-Verbindungen verbleiben 736 Verbindungen für die Skalierung. Bei 112 Gbit/s pro Verbindung ergibt das 736 × 112 Gbit/s = 82,432 Gbit/s oder etwa 10.3 TB/s pro Richtung, was bidirektional ungefähr 20.6 TB/s entspricht. Dies deckt sich gut mit den von NVIDIA angegebenen 20 TB/s pro Einschub.
Diese 8-Chip-Gruppe mit All-to-All-Kommunikation bildet die „lokale Gruppe“ einer Dragonfly-Netzwerktopologie. Der ursprüngliche GroqChip 1 verfügte über 11 C2C-Verbindungen pro Karte mit jeweils 30 Gbit/s pro Lane (vier Lanes pro Verbindung), was einer Gesamtübertragungsrate von 330 GB/s pro Karte entspricht. Die 96 Verbindungen des Groq 3 LP30 mit 112 Gbit/s stellen einen enormen Generationssprung in der I/O-Bandbreite pro Chip dar, wobei die topologische Struktur beibehalten wird.
Konnektivität innerhalb des Racks
In einem einzelnen LPX-Rack sind 32 Compute-Trays (insgesamt 256 Chips) über vier ETL-Spines im Backplane miteinander verbunden. Diese Spines übertragen den RealScale C2C-Datenverkehr zwischen den Trays und bilden so die Rack-weite Scale-up-Domäne. Die gesamte Scale-up-Bandbreite des Racks beträgt 640 TB/s (32 Trays × 20 TB/s pro Tray). Aufgeteilt auf die vier Spines, überträgt jeder Spine etwa 160 TB/s bidirektionale Bandbreite.
Konnektivität zwischen den Racks
Jedes 1U-Rechengehäuse verfügt über vier QSFP-C2C-Ports an der Vorderseite mit insgesamt 32 Lanes (8 Lanes pro Port) für die Kommunikation zwischen den Racks. Diese Ports sind symmetrisch mit benachbarten Racks verbunden: Zwei Ports (16 Lanes) sind mit dem linken benachbarten Rack verbunden, und zwei Ports (16 Lanes) mit dem rechten benachbarten Rack. Jede Höheneinheit (U) ist mit der entsprechenden Höheneinheit im benachbarten Rack verbunden (die erste Höheneinheit in Rack A ist mit der ersten Höheneinheit in Rack B verbunden, die zweite mit der zweiten usw.).
Quelle: Nvidia
Bei 112 Gbit/s pro Lane bieten die 32 Interrack-Lanes jedes Trays 32 × 112 Gbit/s = 3,584 Gbit/s bzw. ca. 448 GB/s pro Richtung und Tray an Interrack-Bandbreite. Im gesamten Rack ergeben die 32 Trays 32 × 32 = 1,024 Interrack-Lanes. Daraus resultiert eine Bandbreite von 1,024 × 112 Gbit/s = 114,688 Gbit/s bzw. ca. 14.3 TB/s pro Richtung zu jedem benachbarten Rack (gleichmäßig aufgeteilt: ca. 7.2 TB/s pro Richtung zum linken und ca. 7.2 TB/s pro Richtung zum rechten Nachbarn).
Die Bandbreite zwischen den Racks ist systembedingt geringer als die Bandbreite innerhalb eines Racks. Innerhalb des Racks ermöglicht die skalierbare Domäne mit 640 TB/s eine dichte, vollständige Erreichbarkeit über die Spine-Architektur. Zwischen den Racks stellen die Frontpanel-Anschlüsse die weniger dichten globalen Verbindungen der Dragonfly-Topologie bereit. Dies entspricht dem Architekturmuster des ursprünglichen GroqRack, bei dem vier externe C2C-Verbindungen pro Chip lokale Gruppen (Knoten) zu Multi-Rack-Systemen mit geringem Netzwerkdurchmesser (maximal drei Hops in einer 264-Chip-Konfiguration) verbanden.
Zusammenfassung: Gleiche Architektur, vierfache Dichte
Die ursprüngliche GroqRack-Installation mit vier Racks umfasste 264 GroqChip-Prozessoren. Ein einzelnes LPX-Rack integriert 256 LP30-Chips in ein MGX-ETL-Rack – etwa die vierfache Chipdichte in einem einzigen Rack-Gehäuse mit Flüssigkeitskühlung und kabelloser Backplane. Die lokale All-to-All-Gruppe mit acht Chips, die Dragonfly-Topologie und das softwaregesteuerte Routing-Paradigma bleiben unverändert. Die grundlegende Groq-Netzwerktechnologie ist gleich geblieben; sie wurde lediglich skaliert.
Bei Modellen, deren SRAM-Kapazität die eines einzelnen Racks (insgesamt 128 GB verteilt auf 256 Chips) übersteigt, können mehrere LPX-Racks oder Rackreihen über die C2C-Anschlüsse an der Vorderseite miteinander verbunden werden, um die Montagelinie zu erweitern. Weitere Informationen zu den Auswirkungen auf reale Modellgrößen finden Sie im nächsten Abschnitt.
Warum FFN-Layer? Was NVIDIA auslagert
Warum Decode immer schwieriger zu bedienen ist
Bevor wir uns mit den Details der Auslagerung von Aufgaben an LPX durch NVIDIA und den Gründen dafür befassen, ist es hilfreich, die übergeordneten Trends zu verstehen, die diese Architekturentscheidung – wie NVIDIA selbst hervorhebt – notwendig machen. KI-Inferenz ist keine einheitliche Arbeitslast. Innerhalb einer einzelnen Anfrage stellen die Vorfüllphase (Einlesen der Eingabeaufforderung und Aufbau des KV-Caches) und die Dekodierungsphase (Generierung der Tokens nacheinander) sehr unterschiedliche Anforderungen an die Hardware. Diese Anforderungen ändern sich mit der Batchgröße, der Kontextlänge und der Modellstruktur.
Da Modelle längere Schlussfolgerungen und mehrstufige Gedankengänge erzeugen, verlagert sich ein größerer Anteil jeder Anfrage in die sequentielle Dekodierungsphase. Gleichzeitig reduzieren Techniken wie Präfix-Caching die Kosten des Vorbefüllens durch die Wiederverwendung gemeinsam genutzter Prompt-Zustände über mehrere Anfragen hinweg, wodurch die relativen Kosten der Dekodierung nur noch deutlicher hervortreten. Kontextfenster wachsen zudem auf Hunderttausende von Token an, was den Speicherbedarf während der Aufmerksamkeitsberechnung zunehmend erhöht. In agentenbasierten Workflows summiert sich die Latenz über viele Modellaufrufe, Werkzeuginteraktionen und Verifizierungsschleifen hinweg. Der kumulative Effekt ist, dass die Dekodierungslatenz zunehmend zum spürbaren Flaschenhals für die Nutzer wird und Hardware, die ausschließlich auf maximalen Gesamtdurchsatz optimiert ist, nicht immer die beste Lösung für Arbeitslasten darstellt, die eine schnelle und vorhersagbare Token-Generierung für jede einzelne Anfrage erfordern.
Darüber hinaus zeigt sich bei der Veröffentlichung des Fast Mode von Anthropic , dass geringere Latenz und höherer Token-Durchsatz zu höheren Einnahmen führen. Das Fast-Inference-Angebot von Anthropic kostet das Sechsfache der Kosten regulärer Anfragen.
Mit der Ankündigung von LPX wissen wir, dass NVIDIA den größten Dekodierungsengpass – die Feedforward-Netzwerkschichten (FFN) – auf die LPUs auslagern möchte. Um zu verstehen, warum FFN im Fokus steht und um das Ausmaß dieser Entwicklung zu erfassen, haben wir die Anzahl der FFN-Parameter für die aktuell beliebtesten Open-Source-Modelle analysiert.
Was sind FFN-Layer und warum sind sie so dominant?
Jede Transformer-Schicht besteht aus zwei Hauptblöcken: einem Aufmerksamkeitsblock und einem Feedforward-Block (FFN). Der Aufmerksamkeitsblock ermöglicht es Token, Informationen anderer Token in der Sequenz zu betrachten und zu kombinieren. Der FFN-Block verarbeitet jedes Token unabhängig: Er projiziert die Repräsentation des Tokens in einen höherdimensionalen Raum, wendet eine Nichtlinearität an und projiziert sie wieder zurück. Man kann ihn sich als Wissensspeicher des Modells vorstellen, in dem faktische Assoziationen und gelernte Transformationen gespeichert sind.
Die MoE- oder Mixture-of-Experts-Architektur hat sich als die dominierende Architektur unter den heutigen führenden Open-Source-Sprachmodellen für große Textmengen herauskristallisiert: DeepSeek R1, Kimi K2, Qwen3-235B, GLM-5, MiniMax M2.5 und OpenAI's GPT-OSS 120B.
In diesen MoE-Modellen wird insbesondere der FFN-Block in Hunderte kleiner, unabhängiger Kopien, sogenannte Experten, repliziert, während die Aufmerksamkeit geteilt bleibt. Eine ressourcenschonende, gelernte Routing-Funktion wählt dynamisch für jedes Token eine kleine Teilmenge der Experten zur Aktivierung aus. Das Ergebnis ist ein Modell, das zwar eine enorme Anzahl an Parametern speichert, aber nur einen Bruchteil pro Token aktiviert. Dadurch werden die Qualitätsvorteile der Skalierung ohne den proportionalen Rechenaufwand erzielt.
Wie Sie sicherlich bereits bemerkt haben, stellt dies jedoch eine weitere Herausforderung dar: Die FFN-Schichten machen den größten Teil der Modellgewichtung aus. Insbesondere bei MoE-Modellen können dies bis zu 90 % der Modellgewichtung sein.
DeepSeek R1 im Detail: Ein praktisches Beispiel
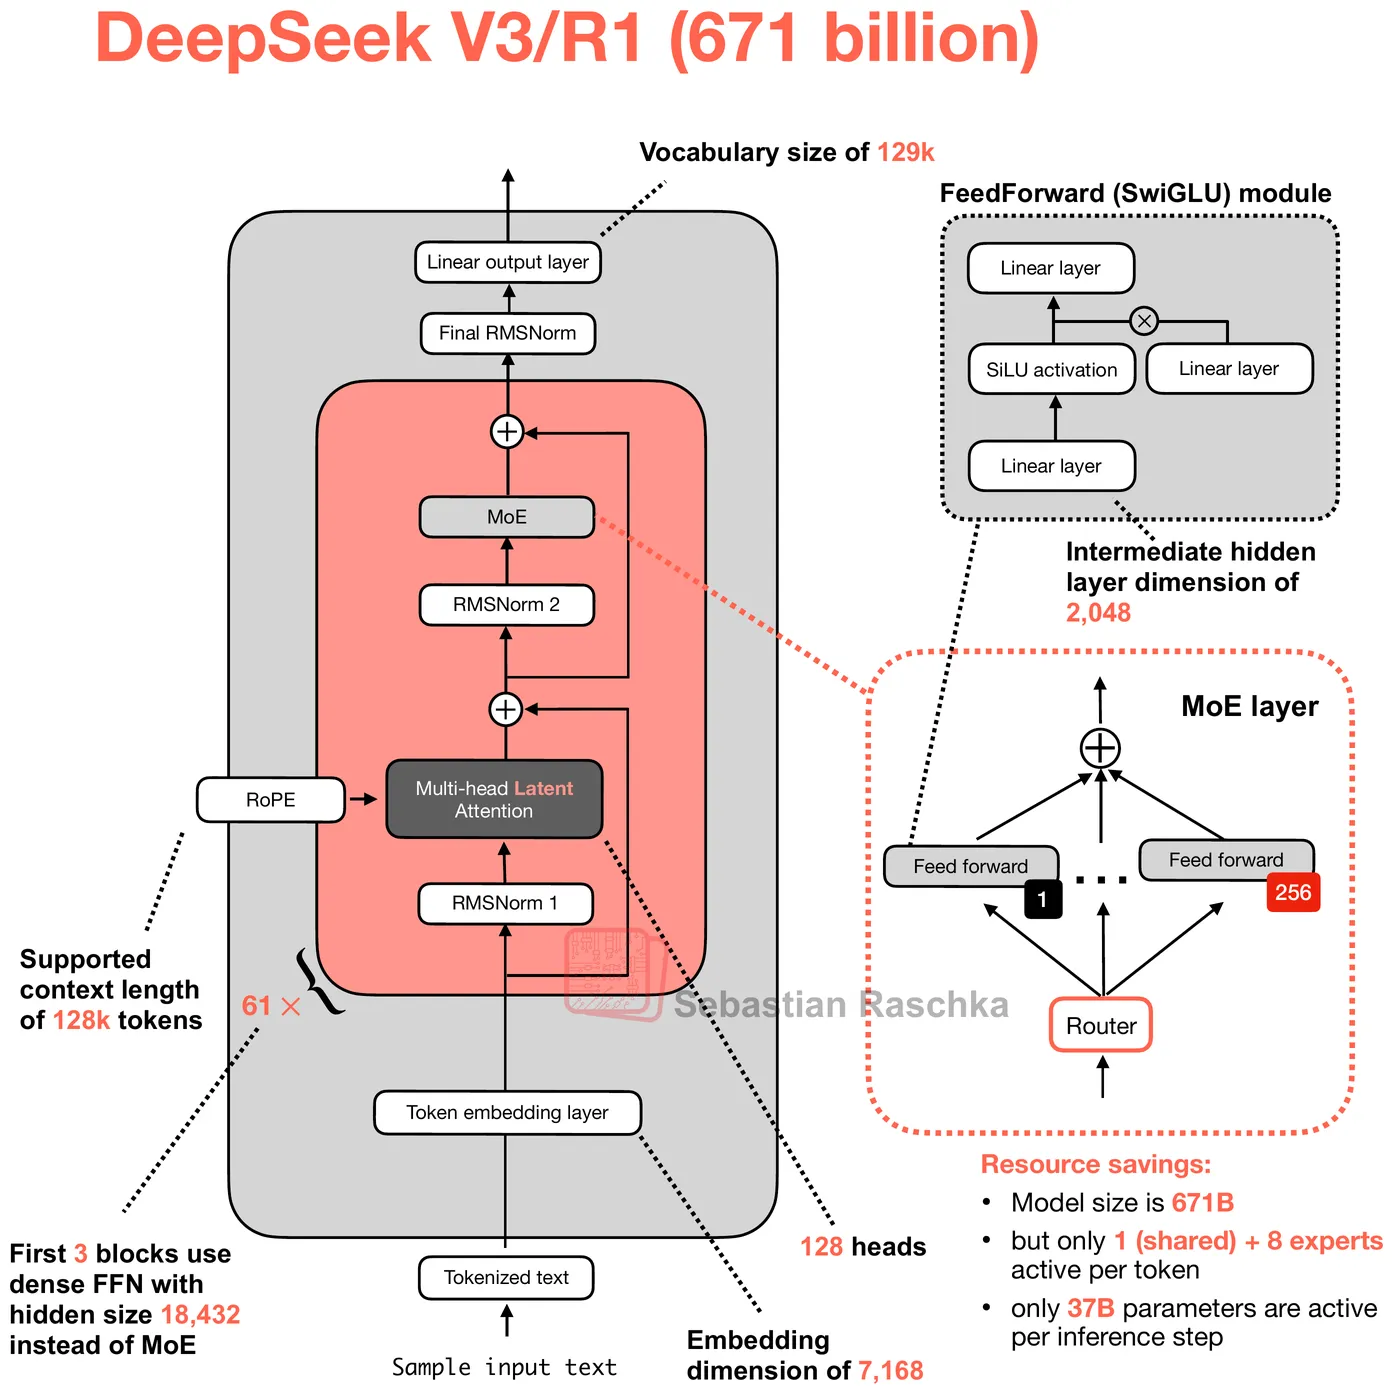
Zur Veranschaulichung betrachten wir DeepSeek R1 genauer. Das Modell verfügt über 61 Transformer-Schichten mit einer verborgenen Dimension (H) von 7,168. Die ersten drei Schichten verwenden ein standardmäßiges dichtes FFN, während die verbleibenden 58 Schichten MoE (plus eine zusätzliche MTP-Schicht mit eigenen Experten, insgesamt also 59 MoE-Schichten) nutzen. Moderne LLMs verwenden eine Variante namens SwiGLU, die drei statt zwei Gewichtsmatrizen verwendet. Der Vorwärtsdurchlauf berechnet w2(SiLU(w1(x)) ⊙ w3(x)), wobei w1 (die Gate-Projektion) und w3 (die Aufwärtsprojektion) die verborgene Dimension von H auf eine Zwischengröße I erweitern und w2 (die Abwärtsprojektion) sie wieder komprimiert. Das ⊙ steht für die elementweise Multiplikation zwischen den Gated- und Ungate-Pfaden. Da keine dieser Matrizen Bias-Terme enthält, besteht jeder SwiGLU-FFN-Block aus genau 3 × H × I Parametern.
Quelle: Sebastian Raschka
Für die dichten Schichten von DeepSeek R1 (die ersten drei) beträgt die Zwischendimension 18,432, was 3 × 7,168 × 18,432 = 396.4 Millionen Parameter pro Schicht ergibt. Bei den MoE-Schichten ist jeder der 256 gerouteten Experten ein vollständiger SwiGLU-Block mit einer kleineren Zwischendimension von 2,048, sodass jeder Experte 3 × 7,168 × 2,048 = 44.0 Millionen Parameter besitzt. Multipliziert man dies mit 256 Experten, erhält man allein in den gerouteten Experten 11.27 Milliarden Parameter pro Schicht. Darüber hinaus verfügt jede MoE-Schicht über einen gemeinsamen Experten (denselben 44M-Parameter-SwiGLU-Block, der für jedes Token immer aktiviert wird), ein Router-Gate (eine lineare Projektion der Form [256, 7168] = 1.8M Parameter) und einen kleinen Bias-Vektor von 256 FP32-Werten, der für den Lastausgleich während des Routings verwendet wird.
Das vollständige FFN umfasst etwa 669.1 Milliarden Parameter. Im FP8-E4M3-Format (1 Byte pro Gewicht) entspricht dies ungefähr 623.1 GB FFN-Daten. Das sind 97.7 % der geschätzten Gesamtgröße des Modells auf der Festplatte. Die verbleibenden ca. 2.3 % bestehen aus Aufmerksamkeitsgewichten, Einbettungen, dem Ausgabekopf, Schichtnormen und FP8-Skalierungsmetadaten.
Dekodierung der Disaggregation
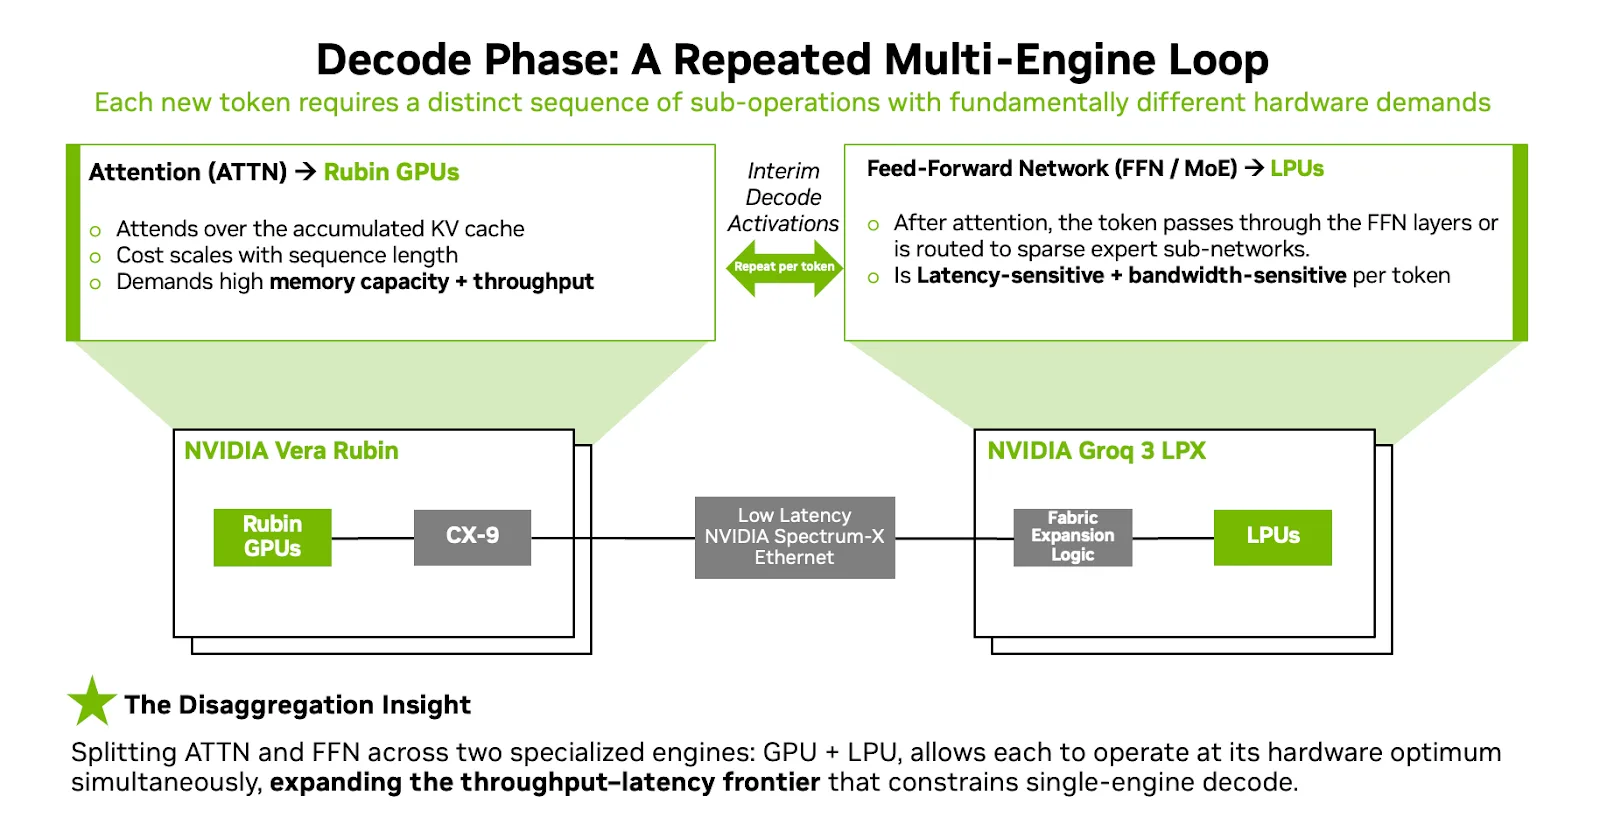
NVIDIA betrachtet die Dekodierungsphase nun nicht mehr als monolithischen Vorgang, sondern als eine sich wiederholende Schleife pro Token, wobei verschiedene Teile unterschiedliche Hardware-Engpässe beanspruchen. Die Vorfüllphase ist hauptsächlich mit dem Einlesen großer Eingabedaten und dem Aufbau des KV-Caches verbunden – eine Arbeitslast, die von dichter paralleler Rechenleistung und großer Speicherkapazität profitiert. Der Vera Rubin NVL72 bewältigt dies effizient, insbesondere bei Arbeitslasten mit langem Kontext, bei denen die Eingabeaufforderung umfangreich und stark variabel sein kann.
Quelle: Nvidia
Die Dekodierung verläuft anders. Für jedes neue Token muss das System die Aufmerksamkeit über den gesamten akkumulierten KV-Cache abfragen und anschließend die FFN/MoE-Berechnung auf dem Aufmerksamkeitsergebnis durchführen. In NVIDIAs Attention-FFN Disaggregation (AFD)-Architektur sind diese beiden Schritte auf zwei Engines verteilt. Rubin-GPUs übernehmen die Dekodierung der Aufmerksamkeit: Sie lesen den KV-Cache aus dem HBM, berechnen die Aufmerksamkeitswerte und erzeugen die Zwischenaktivierung. Dieser Aktivierungstensor (von NVIDIA als „interimistischer Tensorzustand“ bezeichnet) wird dann an die LPX übergeben, die die FFN- oder MoE-Expertenberechnung mit extrem hoher Bandbreite und deterministischer Latenz durchführt, bevor sie das Ergebnis an die GPU zurückgibt, um die Tokengenerierung fortzusetzen.
Dieser Übergabevorgang findet für jedes einzelne Token statt. Die zwischen GPU und LPU ausgetauschten Aktivierungstensoren sind im Verhältnis zu den Gewichtsdaten klein, was genau dem Bereich entspricht, in dem die LPU ihre Stärken im Netzwerkbetrieb mit nahezu keinem Overhead ausspielt. Die Aufteilung nutzt die jeweiligen Stärken der Prozessoren optimal aus: GPUs stellen die für die Aufmerksamkeit variabler Länge über große KV-Caches benötigte HBM-Kapazität und flexible Ausführung bereit, während LPUs die für die bandbreitenbeschränkten, statisch planbaren FFN-Gewichte erforderliche SRAM-Bandbreite und deterministische Planung bereitstellen.
Quelle: Nvidia
Eine subtile, aber wichtige Skalierungseigenschaft ist hier hervorzuheben. Mit zunehmender Kontextlänge steigen auch die Rechen- und Speicheranforderungen der Aufmerksamkeitsoperation: Der KV-Cache wächst linear mit jedem zusätzlichen Kontexttoken, und jeder neue Dekodierungsschritt muss den gesamten akkumulierten Cache berücksichtigen. FFN hingegen wächst nicht mit dem Kontext. Die FFN-Gewichtsmatrizen (w1, w2, w3 in SwiGLU) sind feste Konstanten der Modellarchitektur. Ihre Größe bleibt gleich, egal ob der Kontext 1,000 oder 1,000,000 Token umfasst, und jedes Token durchläuft sie unabhängig. Das bedeutet, dass in der AFD-Architektur die GPU-Seite die steigenden Kosten (mehr HBM für den KV-Cache, mehr Rechenleistung für die Aufmerksamkeit) trägt, während die LPX-Seite statisch bleibt. Die Anzahl der für die FFN eines Modells benötigten LPX-Racks wird ausschließlich durch die Modellarchitektur bestimmt, nicht durch die Kontextlänge der jeweiligen Konfiguration. Dies löst elegant eine der größten Herausforderungen für reine SRAM-Beschleuniger: die Tatsache, dass der wachsende Kontextbedarf die feste Speicherkapazität des Chips irgendwann übersteigt. Bei der AFD-Aufteilung verbleibt die kontextabhängige Arbeit auf Hardware mit erweiterbarem HBM, während die LPU nur die kontextunabhängige Arbeit übernimmt, die sich problemlos in festem SRAM unterbringen lässt.
NVIDIA Dynamo ermöglicht heterogenes Decodieren
Um diese Zwei-Engine-Schleife im Produktivbetrieb zu realisieren, ist mehr als nur Hardware erforderlich. Die Dynamo-Orchestrierungsschicht von NVIDIA ermöglicht die praktische heterogene Dekodierung. Dynamo koordiniert die disaggregierte Bereitstellung über die GPU- und LPU-Backends und übernimmt die tokenbasierte Klassifizierung, das Routing und die Aktivierungsübertragung, die für AFD notwendig sind.
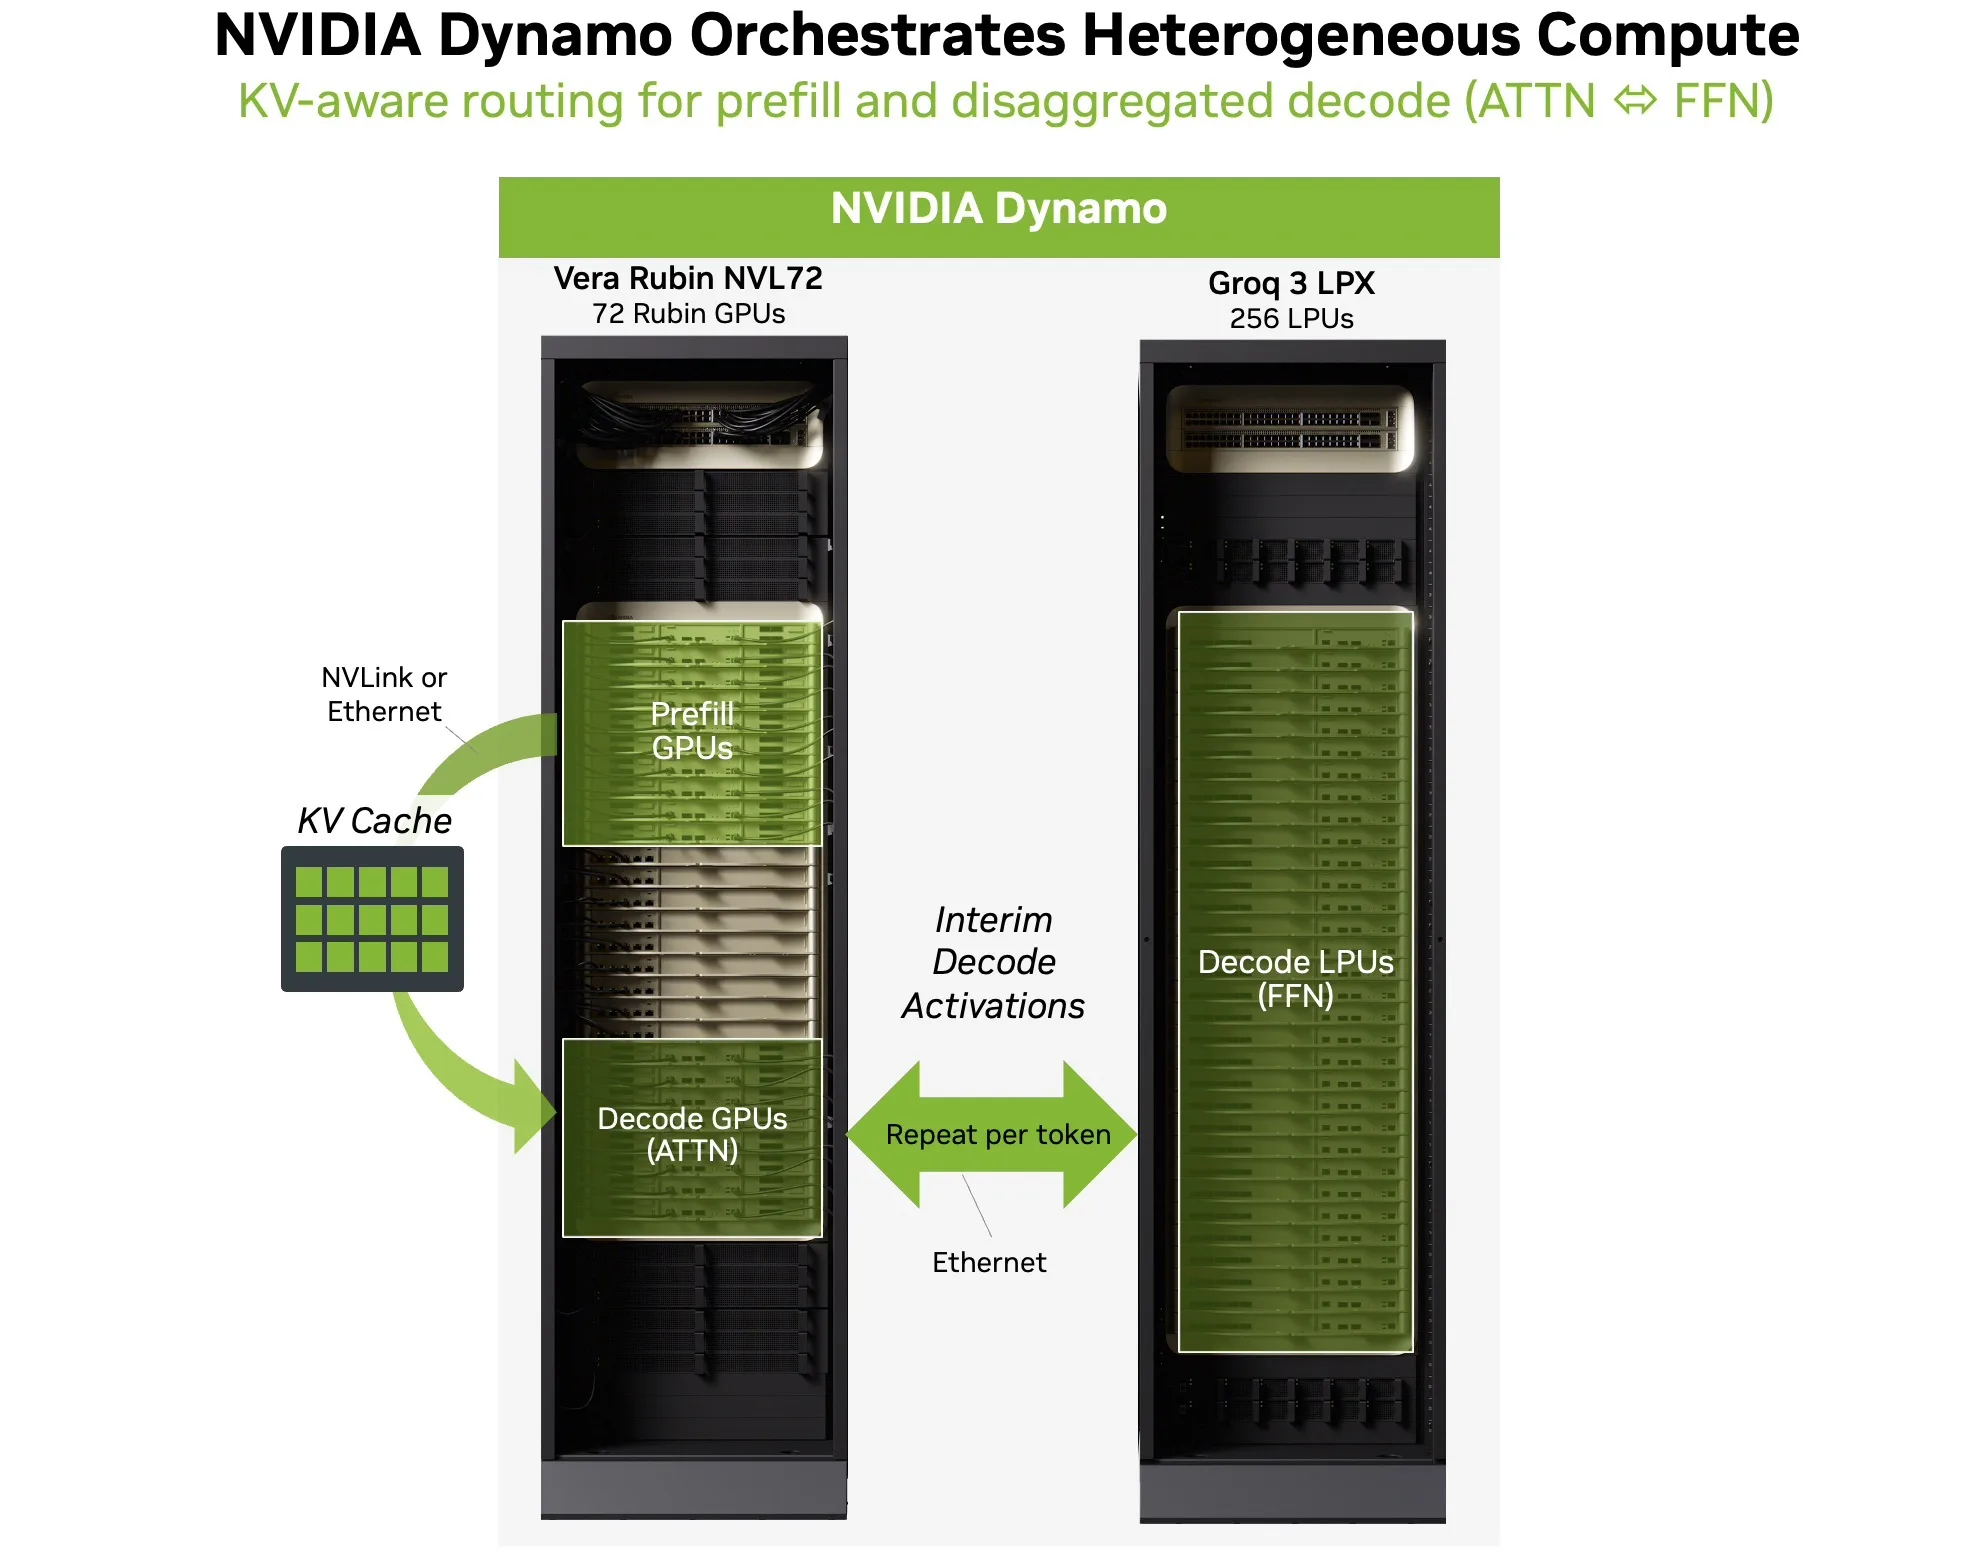
Quelle: Nvidia
In der Praxis leitet Dynamo die Vorverarbeitung an GPU-Worker weiter, um die Eingabe zu verarbeiten und den KV-Cache aufzubauen. Während der Dekodierung orchestriert Dynamo die AFD-Schleife: GPUs führen Aufmerksamkeitsprüfungen über den akkumulierten KV-Cache durch, Zwischenaktivierungen werden an LPUs zur FFN/MoE-Ausführung übergeben, und die Ausgaben kehren zu den GPUs zurück, um die Token-Generierung fortzusetzen. Das Ergebnis ist ein einziger, zusammenhängender Bereitstellungspfad anstelle von zwei getrennten Systemen.
Dynamo bietet außerdem KV-basiertes Routing (sodass Anfragen an Worker weitergeleitet werden, die bereits den relevanten KV-Cache geladen haben), latenzgesteuerte Planung (um zu verhindern, dass interaktive Sitzungen in langen Warteschlangen landen) und ein ressourcenschonendes Transfermanagement. Diese Funktionen sind wichtig, da die Orchestrierungsschicht im realen Produktionsbetrieb mit variabler Kontextlänge, unterschiedlichen Anfragetypen und sprunghafter Parallelität die Latenz stabil hält und verhindert, dass mandantenübergreifende Jitter die Benutzererfahrung beeinträchtigen.
FFN-Größen für alle gängigen Open-Source-Modelle und LPX-Größen
Nachdem wir nun verstanden haben, wie LPX funktioniert und welches Problem es lösen soll, schauen wir uns an, was das in Bezug auf die Hardwareanforderungen bedeutet.
Wir haben die Anzahl der Parameter und die FFN-Größe auf der Festplatte für gängige Modelle anhand der auf Huggingface verfügbaren Dateien config.json und model.safetensors.index.json berechnet.
| Modell | FFN-Parameter | FFN-Größe (auf der Festplatte) | FFN % | Dtyp | Experten |
|---|---|---|---|---|---|
| DeepSeek R1 und DeepSeek V3.2 | 669.1 Mrd | 623.1 GB | 97.7% | FP8 | 256 |
| Kimi K2 | 1.02T | 948.0 GB | 98.9% | FP8 | 384 |
| Kimi K2.5 | 1.02T | 474.0 GB | 98.5% | INT4 | 384 |
| MiniMax M2.5 | 224.7 Mrd | 209.3 GB | 97.7% | FP8 | 256 |
| OpenAI GPT-OSS 120B | 114.7 Mrd | 53.4 GB | 95.4% | MXFP4 | 128 |
| GL 5 | 738.1 Mrd | 1,374.8 GB | 98.0% | BF16 | 256 |
| Qwen3 235B-A22B | 227.2 Mrd | 423.1 GB | 96.6% | BF16 | 128 |
Das Muster bestätigt unsere vorherigen Erkenntnisse: Bei allen Modellen dieser Analyse machen FFN-Parameter 95 % bis 99 % der gesamten Modellgröße auf der Festplatte aus. Kimi K2 stellt den Extremfall dar: Mit 384 gerouteten Experten pro Schicht umfasst das FFN-Netzwerk über eine Billion Parameter und macht fast 99 % der Gesamtgröße aus. Selbst beim kleinsten Modell der Gruppe, OpenAIs GPT-OSS 120B mit 128 in MXFP4 gespeicherten Experten, liegt der FFN-Anteil noch bei 95.4 %. Die Speichergrößen auf der Festplatte reichen von bescheidenen 53 GB für GPT-OSS 120B (dank 4-Bit-Quantisierung) bis hin zu fast 1.4 TB für GLM 5 (gespeichert in BF16 ohne Quantisierung).
Diese Zahlen helfen uns, die Dimensionierung der LPX-Racks zu verstehen. Ein einzelnes LPX-Rack bietet insgesamt 128 GB SRAM verteilt auf seine 256 Chips. Bei einem Modell wie dem OpenAI GPT-OSS 120B mit 53 GB FFN passen die FFN-Gewichte problemlos in ein einzelnes Rack und bieten noch ausreichend Platz. DeepSeek R1 mit 623 GB würde etwa fünf LPX-Racks benötigen, während GLM 5 mit 1.4 TB in BF16 über zehn benötigen würde (wobei die Quantisierung auf FP8 den Bedarf etwa halbieren würde). Genau deshalb sind die C2C-Anschlüsse an der Vorderseite zwischen den Racks erforderlich: Sie ermöglichen die Verkettung mehrerer LPX-Racks und erweitern so die Montagelinie für größere Modelle.
Beschleunigung der spekulativen Dekodierung mit LPX
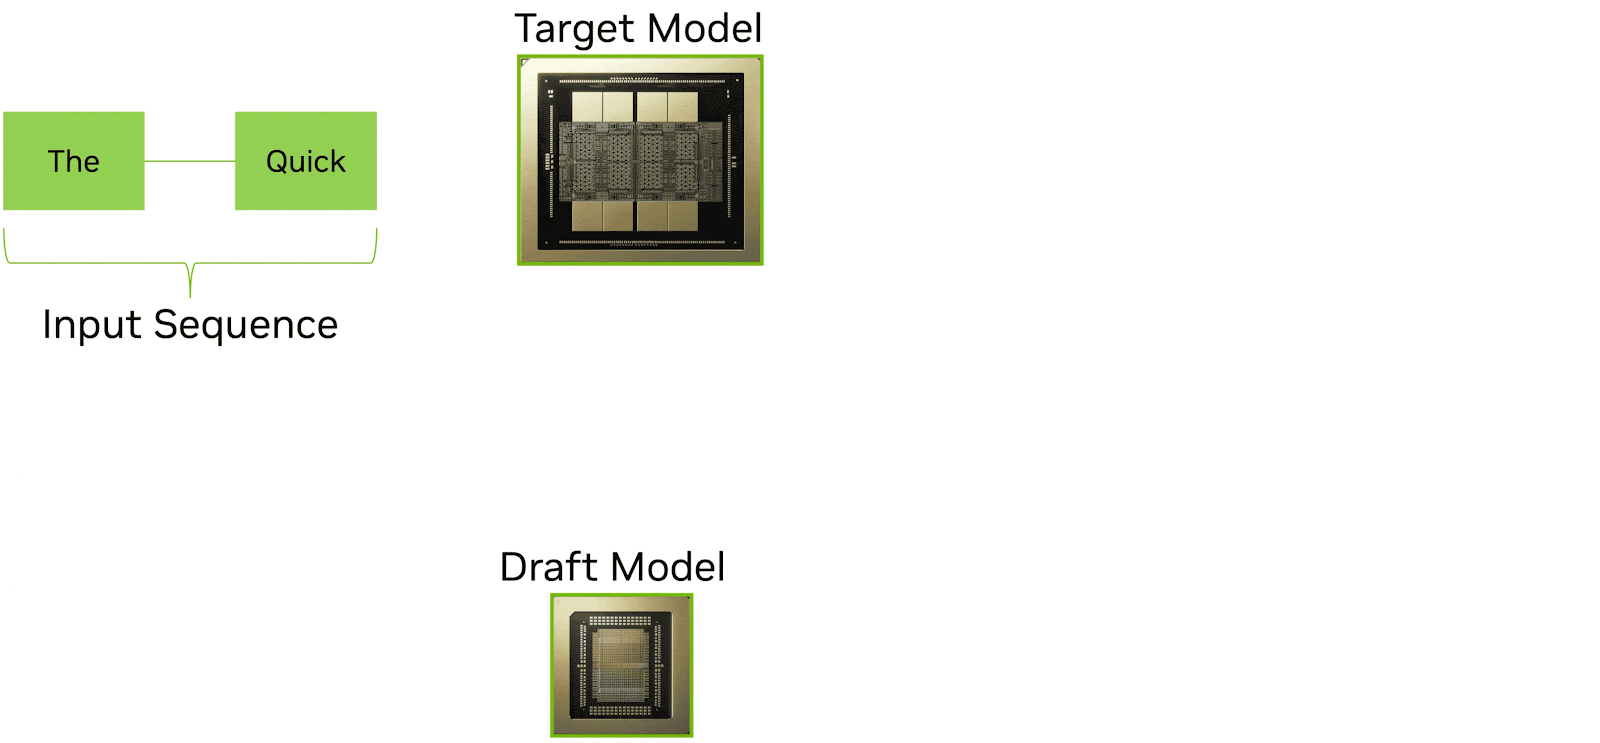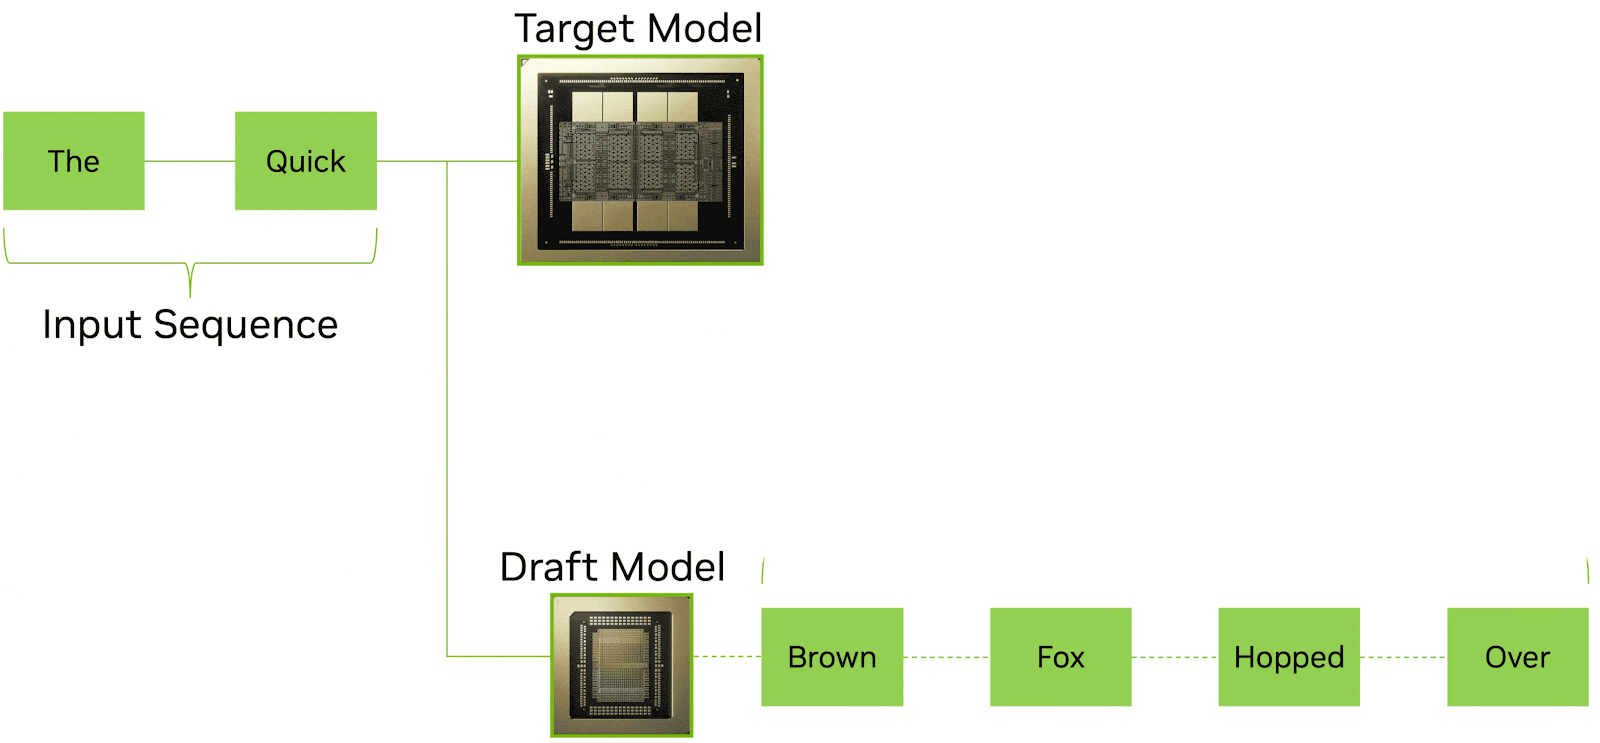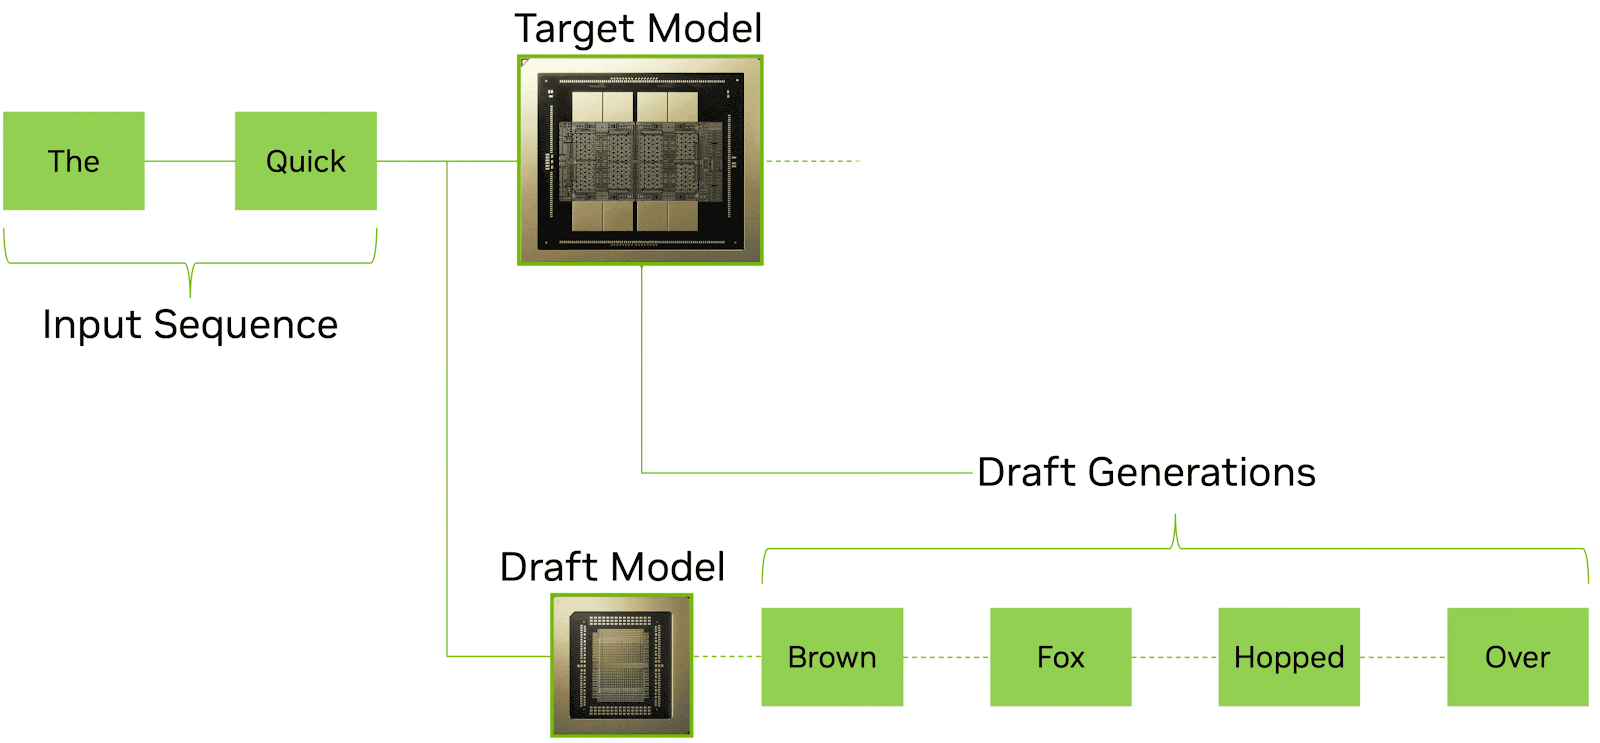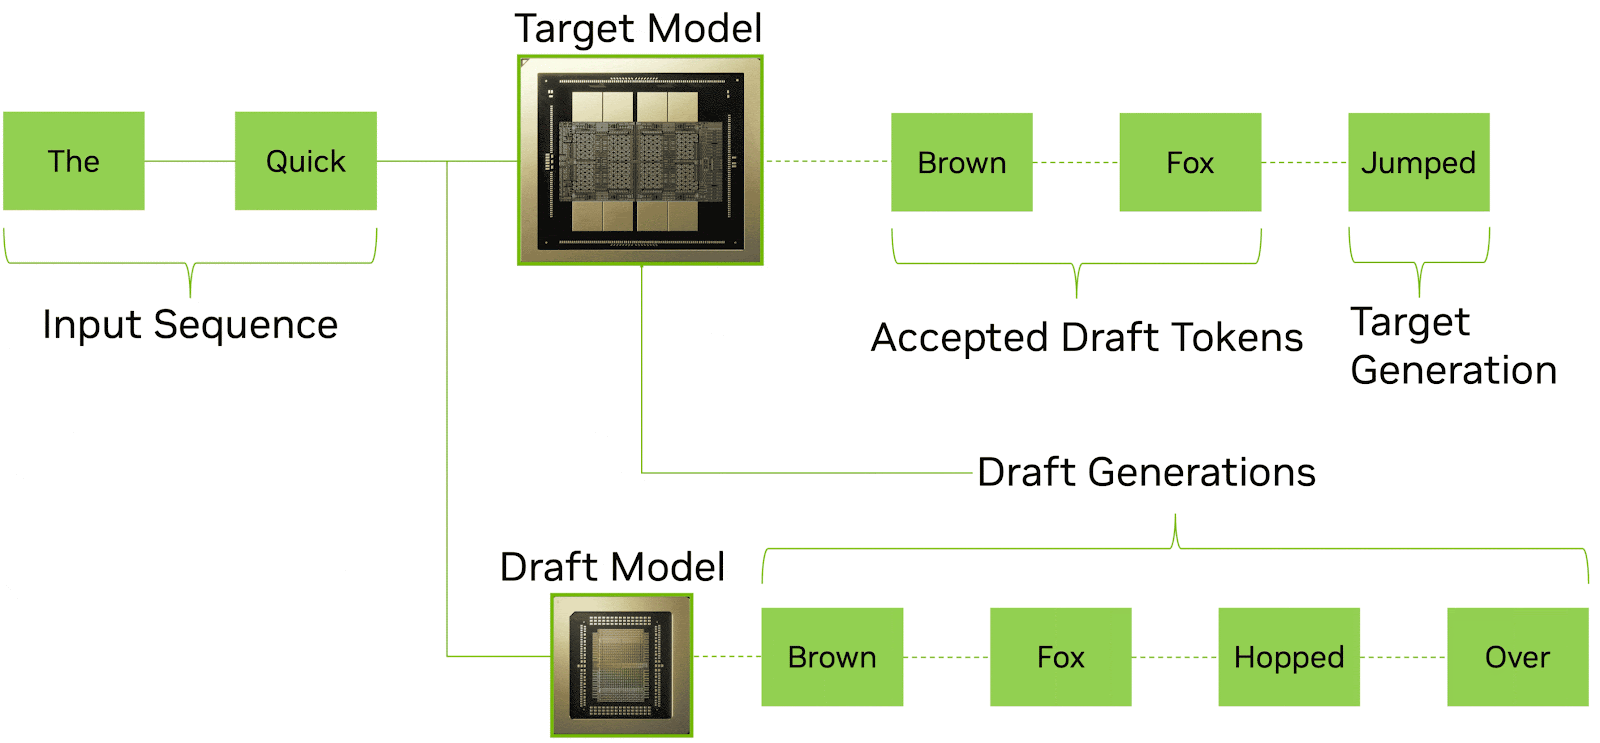
Neben der AFD-Dekodierungsschleife identifiziert NVIDIA einen zweiten wichtigen Anwendungsfall für die LPX: die Funktion als Entwurfsgenerierungs-Engine bei der spekulativen Dekodierung.
Spekulatives Dekodieren ist eine zunehmend wichtige Technik zur Reduzierung der Latenz bei der Inferenz von LLMs. Das Prinzip ist einfach: Ein kleineres, schnelleres Entwurfsmodell generiert im Voraus mehrere Kandidaten-Token, während ein größeres Zielmodell diese parallel verifiziert und akzeptiert. Sind die Vorhersagen des Entwurfsmodells korrekt (was bei Standardtexten häufig der Fall ist), können mehrere Token gleichzeitig in einem einzigen Verifizierungsschritt übernommen werden. Das Ergebnis sind deutlich mehr effektive Token pro Sekunde und eine geringere wahrgenommene Latenz für den Endnutzer.
Quelle: Nvidia
Die Herausforderung besteht darin, dass die spekulative Dekodierung eine extrem schnelle Ausführung des Entwurfsmodells erfordert. Jede Millisekunde, die das Entwurfsmodell für die Generierung von Kandidaten benötigt, ist eine Millisekunde Wartezeit für den Verifizierer. In einer herkömmlichen GPU-basierten Umgebung konkurrieren sowohl das Entwurfsmodell als auch das Zielmodell um dieselben Hardware-Ressourcen, und die Geschwindigkeit des Entwurfsmodells wird durch dieselben HBM-Bandbreitenbeschränkungen begrenzt, die auch alle anderen Komponenten betreffen.
LPX eignet sich hervorragend für diese Aufgabe. Das deterministische Ausführungsmodell und die extrem hohe On-Chip-SRAM-Bandbreite des LP30 ermöglichen eine sehr schnelle und vorhersagbare Generierung von Entwurfstoken. Ein kleineres Entwurfsmodell passt problemlos in den SRAM eines einzelnen LPX-Trays oder in wenige Trays, und die deterministische Planung gewährleistet eine konsistente und vorhersagbare Geschwindigkeit der Entwurfsgenerierung ohne die Varianz, die die Pipeline-Verarbeitung mit dem Verifizierer erschweren würde.
In dieser Konfiguration arbeiten die beiden Prozessoren mit komplementären Aufgaben: LPX generiert mithilfe seiner Architektur mit geringer Latenz schnell Entwurfstoken, während Rubin-GPUs die Token effizient mit ihrer hohen Rechenleistung und großen HBM-Kapazität verifizieren und finalisieren. Diese Trennung ermöglicht die spekulative Dekodierung auf heterogenen Prozessoren, anstatt dass beide Modelle eine einzelne GPU gemeinsam nutzen müssen. Dadurch können Entwurfsgeschwindigkeit und Verifizierungsdurchsatz im Vergleich zu einer homogenen Konfiguration potenziell verbessert werden.
NVIDIA hat neben AFD auch die spekulative Dekodierung als zentrale Aufgabe für den LPX hervorgehoben und deutet damit an, dass dies einen wesentlichen Teil des Wertversprechens des Systems ausmacht. Da immer komplexere Modelle und längere Argumentationsketten entstehen, könnte die Fähigkeit, Token parallel auf spezialisierter Hardware zu generieren und zu verifizieren, ein wichtiger Faktor für die Aufrechterhaltung der interaktiven Reaktionsfähigkeit werden.
Schlussbetrachtung: Extremes Hardware/Software-Co-Design
Was NVIDIAs Ansatz mit der Vera-Rubin-Plattform und LPX besonders auszeichnet, ist die präzise Ausrichtung jeder einzelnen Komponente. Im Consumer-Bereich begegnen wir regelmäßig Produkten, die versuchen, Probleme zu lösen, die tatsächlich niemand hat – von Unternehmen, die die Bedürfnisse ihrer Kunden nicht wirklich verstehen. NVIDIAs Strategie bildet hier einen deutlichen Kontrast. Es ist offensichtlich, dass sie die Probleme der Inferenzpipeline bis ins kleinste Detail verstehen und jedes Segment dieser Pipeline optimieren, um ihren Kunden eine maximale Rendite auf die Hardware zu ermöglichen.
Die Trennung von Aufmerksamkeit und FFN ist kein Marketingkonzept. Sie ist eine direkte Reaktion auf das ermittelte Engpassprofil der Bedienung von MoE-Modellen mit Billionen von Parametern. Die Entscheidung, FFN (und nicht die Aufmerksamkeit) auszulagern und das CPX-Rack zum LPX-Rack weiterzuentwickeln, spiegelt ein präzises Verständnis dafür wider, welche Operationen bandbreiten- bzw. kapazitätsbegrenzt, welche statisch bzw. dynamisch planbar sind und welche Prozessorarchitektur jeweils am besten geeignet ist. Die Dynamo-Orchestrierungsschicht, die transparente CUDA-Integration und das kabellose MGX-Rack-Design zeugen von einem Entwicklungsteam, das den gesamten Bereitstellungslebenszyklus durchdacht hat.
Bei LPX und NVIDIAs neuen Spitzenprodukten gibt es noch viele offene Fragen. Eine der wichtigsten ist, welchen Zweck die „Fabric Expansion Logic and DRAM“ hat, welche Art von Silizium dafür verwendet wird und, da viele bereits den x86-Sockel entdeckt haben, aufgrund der Investition in Intel im letzten Jahr und des Designs der Kühlkörperbefestigung wahrscheinlich ein Intel-Prozessor ist – welches Bauteil genau, ist aber noch völlig unklar.
Die LPX-Implementierung konzentriert sich zunächst auf Modellentwickler und Serviceanbieter, nicht auf eine breite Verfügbarkeit. Die Leistungsfähigkeit unter realen Betriebsbedingungen mit variablen Kontextlängen, unterschiedlichen Anfragetypen und kurzzeitiger hoher Auslastung sowie die Energieeffizienz müssen noch unabhängig validiert werden. Wir freuen uns darauf, für unabhängige Tests Zugang zu diesen Systemen zu erhalten.
Zitierte Quellen:
Groq: Was ist eine Sprachverarbeitungseinheit?
Groq: Die Groq LPU, KI-Inferenztechnologie, sorgt für mehr Energieeffizienz…
Groq: RealScale Chip-zu-Chip-Verbindungstechnologie
Groq: Geringe Latenz für Echtzeit-KI und HPC
Groq: Determinismus und der Tensor-Streaming-Prozessor
Nvidia: Einblicke in Nvidia Groq 3 LPX…


 Amazon