

Portworx von Everpure hat Kube Datastore ab heute allgemein für unterstützte SAN-Arrays verfügbar gemacht. Virtuelle Maschinen auf Kubernetes erhalten damit Single-Replica-Volumes, die von einem gemeinsam genutzten Array unterstützt werden. Die auf der KubeCon 2026 angekündigte Version wird zusammen mit Portworx Enterprise 3.7.2 ausgeliefert und bietet ein erweitertes Operations Center, Unterstützung für Red Hat OpenShift 5 sowie vorkonfigurierte Volumes für KI-Inferenz, die Everpure für das erste Quartal 2027 erwartet.
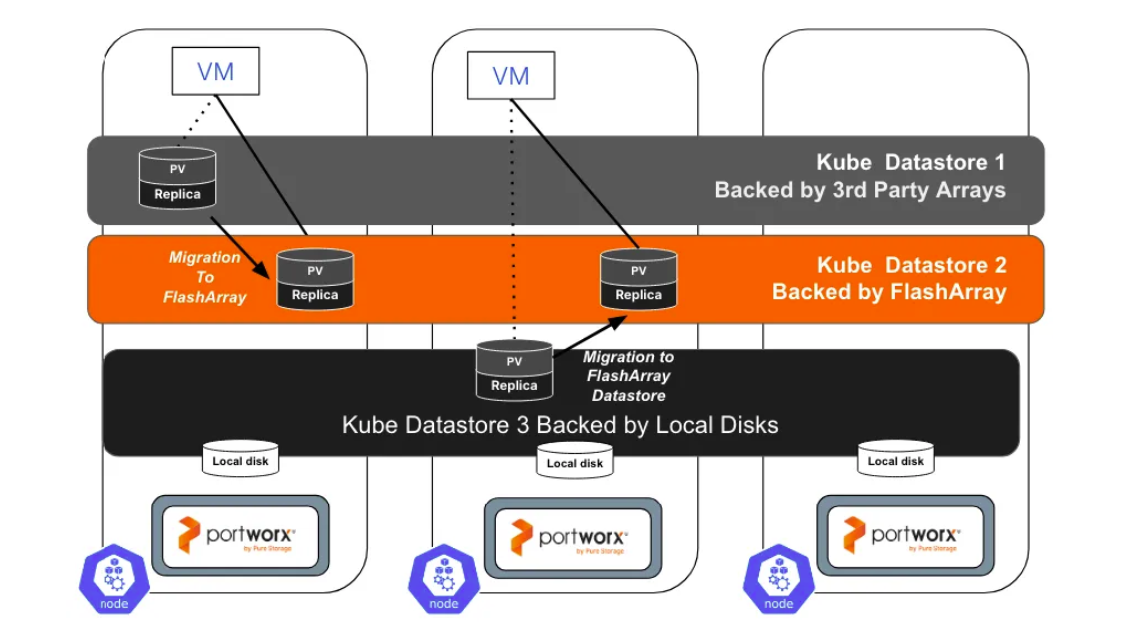
Portworx verwaltet Daten für VMs, Container und KI-Workloads auf Kubernetes über lokale, Cloud- und Edge-Speicherumgebungen hinweg. Kube Datastore (KDS) gruppiert Portworx-Speicherpools mit gemeinsamem Backend zu einem Datenspeicher. Dies ermöglicht VM-Administratoren den Zugriff auf vertraute Datenspeicherkonzepte und Speichermobilität auf Kubernetes, während Plattformingenieure die Kontrolle darüber behalten, wo Volumes gespeichert werden und wie viel Kapazität sie nutzen.
Kube-Datenspeicher für Kubernetes-VMs
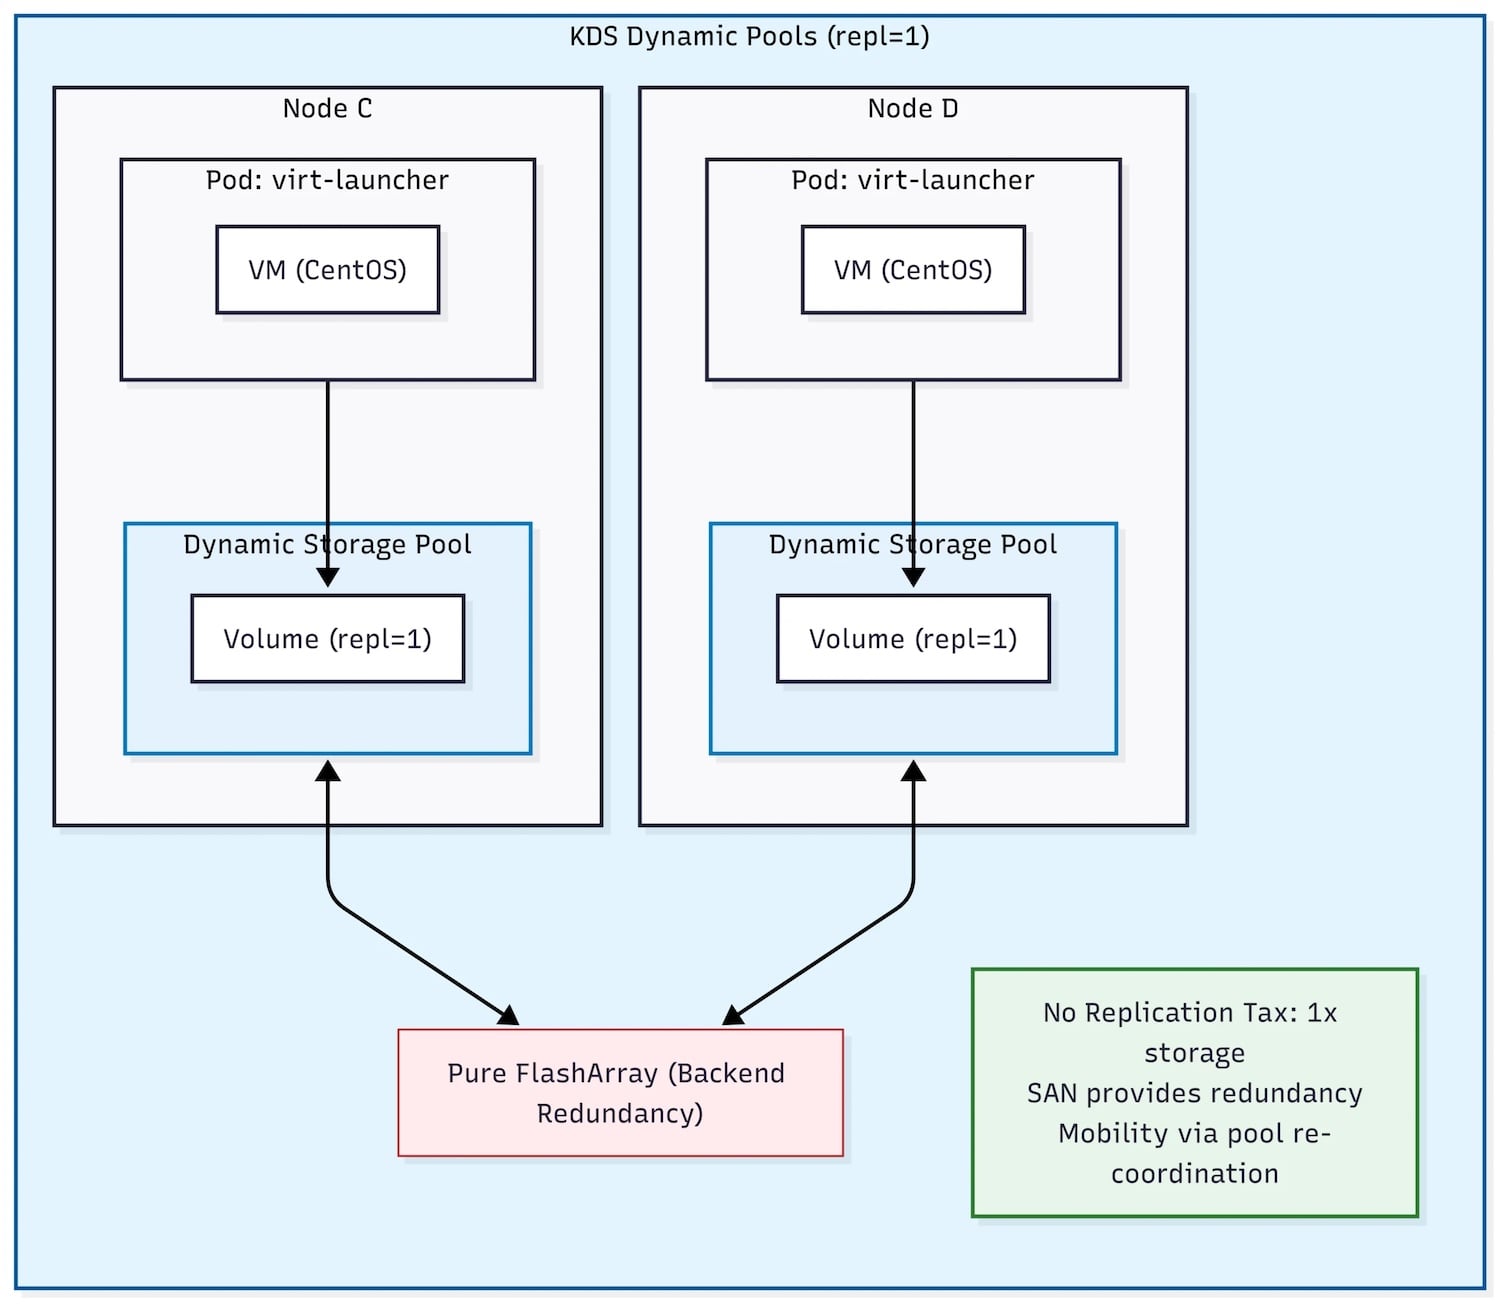
Die GA-Version konzentriert sich auf dynamische Pools: Ein dynamischer Pool ist ein Portworx-Speicherpool, der auf einem gemeinsam genutzten Backend erstellt wird und Volumes mit einem Replikationsfaktor von eins enthält. Der Datenschutz wird vom Array übernommen. Portworx nennt Everpure FlashArray als unterstütztes Backend und listet keine weiteren Arrays auf. Statische Pools bleiben für Workloads erhalten, die replikationsbasierte Verfügbarkeit benötigen, sowie für Volume-Typen, die nicht geeignet sind, wie z. B. SharedV4.
Die Effizienz hängt maßgeblich von der Anzahl der Replikate ab: Portworx beziffert den Speicher-Overhead des traditionellen Shared-Nothing-Modells je nach Replikationsfaktor auf das Zwei- bis Dreifache und die Netzwerk-I/O-Verstärkung auf das Drei- bis Fünffache. Ein Single-Replica-Volume auf einem Array vermeidet beides. Fällt ein Knoten aus oder wird er gewartet, wird der Pool als Einheit auf einen anderen Knoten verschoben. Aufgaben wie das Rebalancing werden dann über Kubernetes-native Workflows ausgeführt. Portworx hat keine Failover-Zeiten veröffentlicht.
Portworx veröffentlicht ein Skalierungsprofil für Enterprise 3.7.2: Empfohlen werden bis zu 12 Speicherpools pro Knoten, maximal 16, bis zu 150 Volumes und 300 Snapshots pro Pool, bis zu 700 angebundene Volumes pro Knoten und bis zu 5,000 angebundene Volumes pro Cluster. KDS ist mit KubeVirt und OpenShift Virtualization kompatibel.
Portworx kombiniert dies mit der nativen Migration von VMware-Arrays mithilfe von FlashArray XCOPY. Laut Herstellerangaben ist dies bis zu 12-mal schneller als der Standardweg und ermöglicht die Migration einer 2-TB-VM in etwa zwei Stunden statt über einem Tag. Diese Angaben stammen vom Hersteller und wurden von uns weder getestet noch überprüft.
„Unsere neuesten Innovationen, darunter Kube Datastore, helfen Kunden dabei, die Speicherverwaltung zu vereinfachen, sich schneller von Infrastrukturausfällen zu erholen und den Speicher effizienter zu nutzen“, sagte Greg Muscarella, General Manager von Portworx bei Everpure.
Vorbereitete Volumes für KI-Workloads
Vorab bereitgestellte Volumes verkürzen die Wartezeit vor dem Start eines Inferenzdienstes, da Modellgewichte, die mehrere zehn oder hundert Gigabyte groß sind, oft erneut heruntergeladen werden müssen, nachdem ein Pod auf einem neuen Knoten gestartet wurde. Ein Plattformteam befüllt ein Quell-Volume mit einem versionierten Modellpaket aus einem freigegebenen Repository, und Portworx verteilt lokale Kopien an die entsprechenden Worker-Knoten und überprüft deren Einsatzbereitschaft.
Ein Inferenz-Pod wird dann nur auf einem Knoten eingeplant, der bereits seine Kopie enthält. Speicherrichtlinien wählen diese Kopie aus, sobald eine Arbeitslast gestartet oder verschoben wird. Laut Everpure reduziert dieser Ansatz speicherbedingte Startverzögerungen und beschleunigt die Wiederherstellung, insbesondere bei KI-Arbeitslasten, die häufig eingeplant, verschoben oder neu gestartet werden. Portworx erwartet vorab bereitgestellte Volumes im ersten Quartal 2027, weist jedoch darauf hin, dass sich Umfang und Zeitplan ändern können und hat noch keine Angaben zu den Startzeiten veröffentlicht.
Betriebszentrale und Backup-Unterstützung
Das Portworx-Operationscenter, eine zentrale Schnittstelle innerhalb des Clusters, bietet nun eine Übersicht über Poolbestand, Live-Migrationsfortschritt und Hyperkonvergenzstatus. Daneben befindet sich eine Topologieansicht, die Speicherknoten, Pools, Volumes, Workloads und VMs mit ihrem jeweiligen Status abbildet, sowie eine Alarmierungsansicht, die Portworx- und Prometheus-Alarme mit Filtern für Schweregrad, Auswirkungsbereich und Ressourcentyp kombiniert.
Portworx öffnet seine Plattform zudem für Backup-Tools von Drittanbietern im Rahmen eines Bring-Your-Own-Backup-Modells (BYOB), das auf Kubernetes Changed Block Tracking (KEP-3314) basiert. Dadurch kann ein Backup-Produkt nur die geänderten Blöcke kopieren. Diese Unterstützung wird mit Portworx Enterprise 3.8.0 eingeführt, das für Anfang 2027 geplant ist. Portworx hat die kompatiblen Backup-Produkte noch nicht benannt. Portworx Backup 3.2.0, dessen allgemeine Verfügbarkeit für November geplant ist, bietet zusätzlich die selektive Dateiwiederherstellung für Windows-VMs sowie IPv6-only- und Dual-Stack-Netzwerke.
Red Hat OpenShift 5-Unterstützung
Red Hat hat OpenShift 5 veröffentlicht, und Everpure gibt bekannt, dass Portworx Launch-Partner ist und ab der allgemeinen Verfügbarkeit sowohl in Portworx Enterprise als auch in Portworx CSI unterstützt wird. Portworx ist bereits in OpenShift-Produkten wie den Edge-KI-Appliances von Supermicro integriert . Everpure teilte außerdem mit, dass IDC Portworx im IDC MarketScape 2026 für Container-Daten- und Infrastrukturmanagement-Software als führendes Unternehmen ausgezeichnet hat.


 Amazon