

Supermicro hat einen neuen DCBBS-Blueprint (Data Center Building Block Solutions) für HPC auf Basis der NVIDIA Vera Rubin NVL4-Plattform vorgestellt. Diese Ankündigung erweitert die DCBBS-Architekturstrategie des Unternehmens über KI-Implementierungen in Unternehmen hinaus auf wissenschaftliche Rechenumgebungen und bietet einen Referenzrahmen für die Bereitstellung großflächiger HPC- und KI-Infrastrukturen.
Das neue Konzept basiert auf den Anfang des Jahres vorgestellten DCBBS-Designs NVIDIA Vera Rubin NVL72 und NVIDIA HGX Rubin NVL8 und wendet denselben integrierten Ansatz auf Forschungseinrichtungen, nationale Labore und Supercomputing-Zentren an. Das DCBBS-Framework von Supermicro vereint Rechenleistung, Netzwerk, Flüssigkeitskühlung, Stromverteilung und Infrastruktur in einem vorkonfigurierten Bereitstellungsmodell, das die Implementierungskomplexität reduziert und die Clusterbereitstellung beschleunigt.
Supermicro-Präsident und CEO Charles Liang erklärte, KI entwickle sich zu einem fundamentalen Bestandteil moderner wissenschaftlicher Forschung. Er betonte, dass Organisationen, die in der Lage seien, schnell fortschrittliche Infrastruktur bereitzustellen, künftige Entdeckungen maßgeblich vorantreiben würden. Die Erfahrung des Unternehmens im Bau großflächiger, flüssigkeitsgekühlter GPU-Cluster sei ein Schlüsselfaktor für das neue Konzept gewesen.
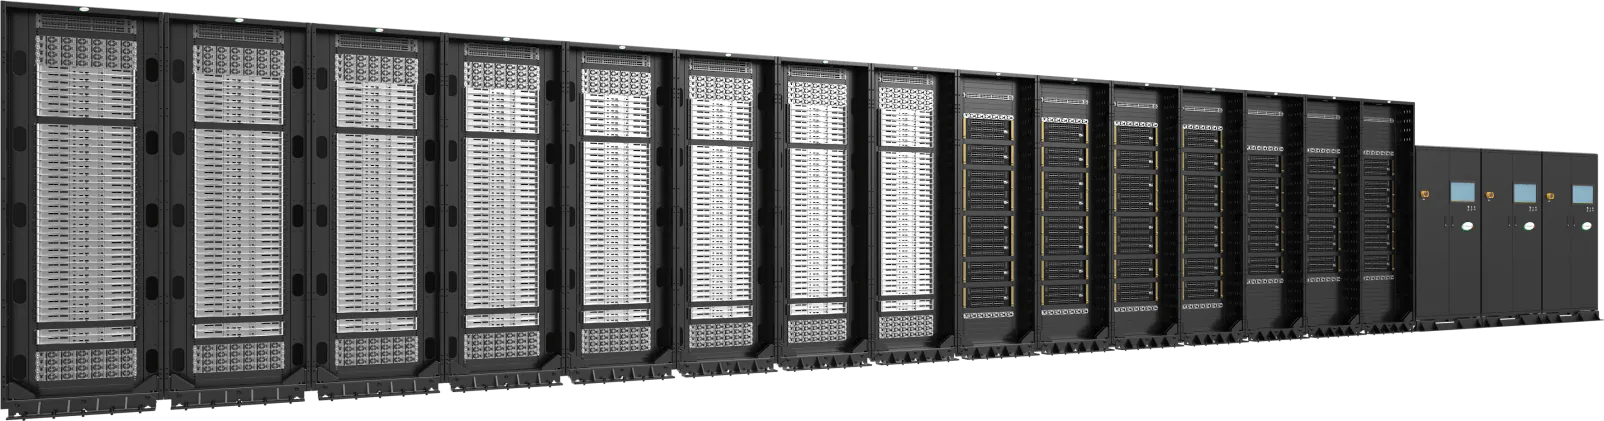
Entwickelt für konvergente HPC- und KI-Workloads
Das Konzept basiert auf der zunehmenden Konvergenz von traditioneller HPC-Simulation und KI-beschleunigtem Rechnen. Forschungseinrichtungen kombinieren vermehrt Simulationsworkloads mit doppelter Genauigkeit mit Modellen des maschinellen Lernens und der KI, um Entwicklungszyklen zu verkürzen und wissenschaftliche Erkenntnisse in Bereichen wie Klimamodellierung, Wirkstoffforschung, Materialwissenschaft und Energieforschung zu beschleunigen.
Supermicro positioniert die NVIDIA Vera Rubin NVL4 -Plattform als Grundlage für diese hybriden Workloads, indem sie großflächige GPU-Beschleunigung mit CPU-Ressourcen und Hochleistungsnetzwerken kombiniert. Das Unternehmen betont, dass seine Implementierungsmethodik auf den Erfahrungen beim Aufbau flüssigkeitsgekühlter Supercomputercluster mit über 100,000 GPUs basiert.
End-to-End-Bereitstellungsmethodik
Der DCBBS Blueprint beschreibt den Bereitstellungsprozess, den Supermicro für groß angelegte flüssigkeitsgekühlte Infrastrukturprojekte verwendet.
Projekte beginnen mit einer Vor-Ort-Begutachtung der Anlagen, bei der die Zugänglichkeit der Laderampe, die Abmessungen des Rechenzentrums, die Belastbarkeit des Bodens sowie die vorhandene Strom- und Kühlinfrastruktur bewertet werden. Die gewonnenen Daten dienen der Entwicklung eines standortspezifischen Implementierungsplans.
Die Systemintegration erfolgt vor dem Versand in den Produktionsstätten von Supermicro und umfasst die Rackmontage, die Verkabelung sowie Validierungstests auf Systemebene (L10) und Clusterebene (L11). Nach der Auslieferung beinhalten die Bereitstellungsdienste die Rackinstallation, die Netzwerkintegration, den Anschluss von Strom und Kühlung, die Inbetriebnahme und die Funktionsprüfung.
Supermicro bietet außerdem fortlaufende Supportleistungen an, darunter Vor-Ort-Reaktionsoptionen, die für unternehmenskritische Forschungs- und Produktionsumgebungen konzipiert sind.
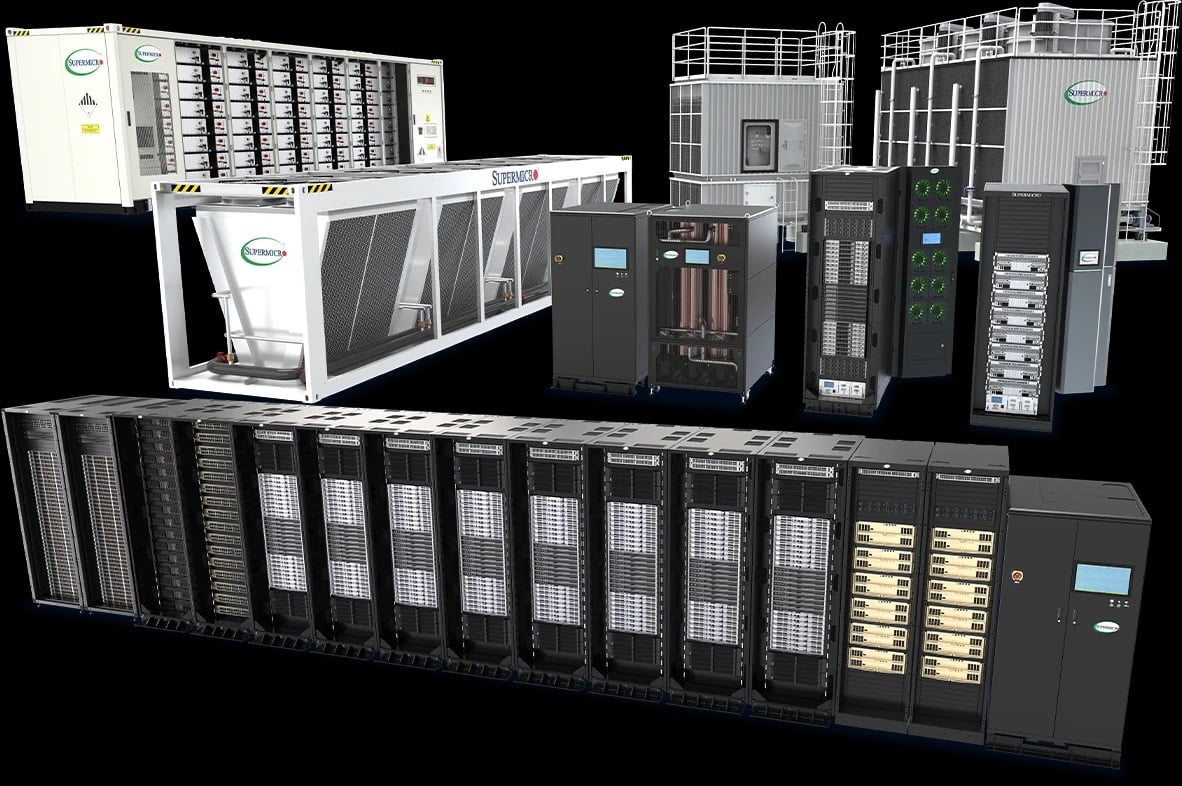
Vera Rubin NVL4 Scalable Unit Architecture
Das Konzept basiert auf einer wiederverwendbaren NVIDIA Vera Rubin NVL4 Scalable Unit, die repliziert werden kann, um Cluster von etwa 3.2 MW bis hin zu Anlagen im Gigawattbereich zu erstellen.
Jede skalierbare Einheit besteht aus acht flüssigkeitsgekühlten Rechenracks in kundenspezifischen 52U-Gehäusen. Die Konfiguration unterstützt 288 NVIDIA Vera Rubin NVL4-Knoten mit bis zu 1,152 NVIDIA Rubin GPUs und 576 NVIDIA Vera CPUs. Die einzelnen Racks arbeiten mit einer Leistungsaufnahme von maximal 362 kW.
Die Kühlung erfolgt über Supermicros DLC-2-Direktflüssigkeitskühlung. Jede skalierbare Einheit umfasst drei in Reihe geschaltete Kühlverteilungseinheiten mit jeweils bis zu 1.8 MW Leistung in einer redundanten 2+1-Konfiguration. Das Kühlkonzept beinhaltet direkt auf dem Chip liegende Kühlplatten, vertikale Kühlmittelverteiler und Supermicros Kühlmittel PG25-A.
Die Netzwerkarchitektur basiert auf der NVIDIA Quantum-X800 InfiniBand-Infrastruktur und bietet die für verteilte HPC- und KI-Workloads erforderliche latenzarme und bandbreitenstarke Verbindung. Flüssigkeitsgekühlte Netzwerkkonfigurationen sind ebenfalls verfügbar.
Die Stromversorgung erfolgt über acht 72-kW-Power-Shelfs pro Rechnerrack, während zwei Top-of-Rack-Management-Switches für Out-of-Band-Überwachung und -Steuerung sorgen.
Sofortige Verfügbarkeit für GB200 NVL4-Implementierungen
Zusätzlich zur Architektur auf Basis von Vera Rubin bietet Supermicro ab sofort auch Konfigurationen auf Basis von NVIDIA GB200 NVL4 für Unternehmen an, die kurzfristige Einsatzmöglichkeiten suchen.
Die Ankündigung spiegelt den anhaltenden Branchentrend hin zu integrierten Rack-Infrastrukturen wider, die Rechenleistung, Netzwerk, Stromversorgung, Kühlung und Management in vorvalidierten Bereitstellungsmodellen vereinen. Angesichts der zunehmenden Konvergenz von KI- und HPC-Workloads konzentrieren sich Anbieter verstärkt darauf, die Bereitstellungskomplexität zu reduzieren und gleichzeitig höhere Rackdichten und flüssigkeitsgekühlte Umgebungen zu unterstützen.


 Amazon