

Supermicro hat heute gemeinsam mit IBM und NVIDIA eine KV-Cache-Speicherlösung vorgestellt, die den Schlüssel-Wert-Status für die Kontextinferenz von der GPU auf einen gemeinsam genutzten All-Flash-Speicher verlagert. Das Paket kombiniert Supermicro Petascale-Speicherserver mit AMD EPYC 9005-Prozessoren, IBM Storage Scale, NVIDIA Dynamo und NVIDIA Spectrum-X Ethernet. Die Unternehmen unterstützen die Lösung mit einer validierten Referenzarchitektur, die IBM als Redbook veröffentlicht hat. Die wichtigste Kennzahl ist eine 56-fache Reduzierung der Zeit bis zum ersten Token bei Abfragen mit 130,000 Token im Vergleich zu einer GPU, die den Kontext von Grund auf neu berechnet.
Warum KV-Cache eine Speicherebene benötigt
Die Inferenz erfolgt in zwei Phasen: Die Vorverarbeitung wandelt die Eingabeaufforderung in Token um und verarbeitet diese im Modell, um die Zwischenzustände der Schlüssel-Wert-Paare zu erzeugen. Die Dekodierung generiert anschließend die Antwort Token für Token anhand dieser Zustände. Durch die Speicherung des Schlüssel-Wert-Paares in einem persistenten Cache kann das System diesen für den nächsten Zug, den nächsten Agentenschritt oder die nächste Anfrage im selben Kontext wiederverwenden und eine erneute Berechnung vermeiden.
Agentische Workflows, Codierungsassistenten, Long-Context-RAG und Multi-Turn-Anwendungen erzeugen so viel von diesem Zustand, dass der GPU- und CPU-Speicher schnell überläuft. Deshalb entwickeln Supermicro, IBM und NVIDIA eine Netzwerkspeicherebene.
In diesem Design verwaltet NVIDIA Dynamo die Cache-Hierarchie und verschiebt Blöcke über NIXL; IBM Storage Scale Erasure Code Edition stellt die gemeinsam genutzte Dateischicht bereit; und die Petascale-Server liefern den Flash-Speicher und die dahinterliegenden PCIe-Gen5-Lanes. Laut Supermicro haben die drei Unternehmen den Stack auf Clusterebene unter hoher Parallelität und mit starkem Netzwerkverkehr getestet. Das Ergebnis wird als schlüsselfertige Lösung mit werkseitiger Rackintegration und Vor-Ort-Installation angeboten, wodurch sich die Bereitstellungszeit von Wochen auf Tage verkürzt.
Die getestete Konfiguration
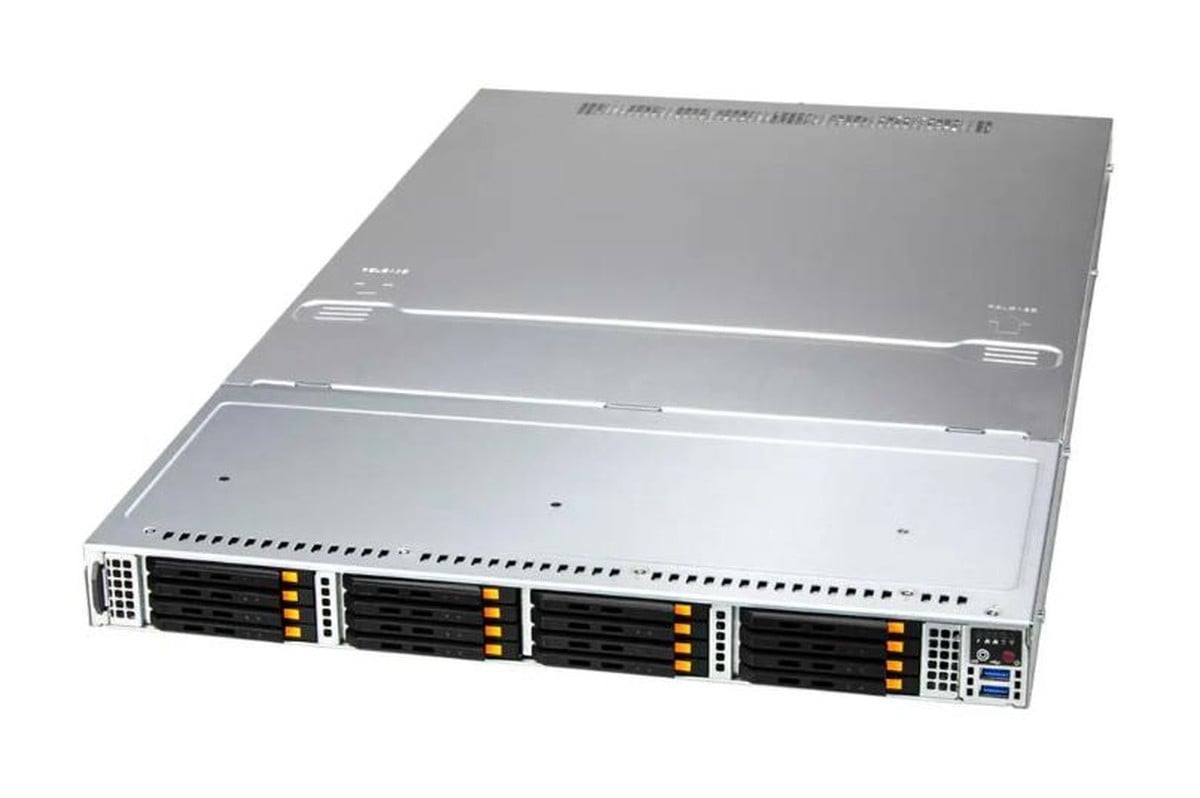
Die Referenzarchitektur verwendet acht Supermicro ASG-1115S-NE316R Petascale-Knoten. Jeder Knoten ist ein 1U-System mit einem einzelnen AMD EPYC 9535 und 16 Micron 7.68 TB E3.S NVMe-Laufwerken. Dies ergibt 122.88 TB Flash-Speicher pro Knoten und insgesamt ca. 983 TB. Jeder Knoten verfügt clientseitig über eine Dual-Port 200-Gb-NVIDIA BlueField-3 B3220 und backend über eine 400-Gb-ConnectX-7. Drei Spectrum-X SN5600-Switches sind in Spine-Leaf-Architektur angeordnet und mit 800-Gb/s-Uplinks ausgestattet.
Auf den Speicherknoten läuft RHEL 9.6 und IBM Storage Scale ECE 6.0.0.1 in einem 8+2P Erasure-Code-Layout. IBM gibt den Lesedurchsatz dieser Acht-Knoten-Ebene aus früheren Tests mit 315 GB/s an.
| Komponente | KV-Cache-Referenzarchitektur (wie getestet) |
|---|---|
| Speicherebene | |
| Speicherknoten | 8x Supermicro ASG-1115S-NE316R (1U, Einzelsockel) |
| CPU pro Knoten | AMD EPYC 9535, 128 PCIe Gen5-Lanes (64 zu NVMe, 64 zu Netzwerk) |
| Blitz pro Knoten | 16x Micron 7.68 TB E3.S NVMe (122.88 TB Rohspeicher) |
| Netzwerk pro Knoten | NVIDIA BlueField-3 B3220, Dual-Port 200Gb (Clientseite) NVIDIA ConnectX-7 400 GB (Speicher-Backend) |
| Umschalten | 3x NVIDIA Spectrum-X SN5600, Spine-and-Leaf, 800-Gbit/s-Uplinks |
| Speichersoftware | IBM Storage Scale Erasure Code Edition 6.0.0.1, 8+2P RHEL 9.6 |
| Inferenzclient | |
| System | Supermicro SYS-212GB-FNR (NVIDIA MGX), Ubuntu 24.04 |
| Für die Benchmarks verwendete GPU | 1x NVIDIA RTX PRO 6000 Blackwell, 19.6 GiB verbleibend für KV-Cache nach Gewichtung und CUDA-Graphen |
| Kundennetzwerke | 2x NVIDIA BlueField-3 B3140H 400 Gbit/s, bis zu 80 Gbit/s clientseitige Bandbreite |
| Modell und Software | openai/gpt-oss-120b (MXFP4) vLLM 0.14.1 NVIDIA Dynamo 0.9.0 mit NIXL NVIDIA AIPerf Benchmark-Client |
| Cache-Tiering | Host- und lokale Ebenen auf Null gesetzt; alle 1.4 Millionen zwischengespeicherten Token werden von der Storage Scale-Ebene bereitgestellt. |
Der Benchmark-Client ist ein einzelnes Supermicro SYS-212GB-FNR MGX-System, und die Ergebnisse stammen von einer NVIDIA RTX PRO 6000 Blackwell GPU in diesem System, die das openai/gpt-oss-120b-Modell in MXFP4 unter vLLM 0.14.1 und Dynamo 0.9.0 ausführt.
Nach der Gewichtung und den CUDA-Graphen verblieben 19.6 GiB GPU-Speicher für den KV-Cache, ausreichend für etwa 1.14 Millionen Token auf der GPU selbst. Für die Tests wurden der Host-Speicher und die lokalen Speicherebenen auf null gesetzt, sodass jeder zwischengespeicherte Block von Storage Scale stammte. Die Ergebnisse messen daher den Speicherpfad isoliert, ohne Berücksichtigung einer gemischten Hierarchie.
56-fache Verbesserung der Zeit bis zum ersten Token, 22-fache Verbesserung des Durchsatzes
Ohne Cache stieg die Zeit bis zum ersten Token (TTFT) beim 120B-Modell von 0.572 Sekunden bei 10,000 Eingabe-Tokens auf 32.14 Sekunden bei 130,000, da die GPU den gesamten Kontext neu berechnete. Mit dem KV-Cache auf Storage Scale blieb die TTFT im gleichen Bereich zwischen 0.193 und 0.57 Sekunden. Dies entspricht dem 56-fachen Wert bei 130,000 Tokens und der von Supermicro in seiner Ankündigung genannten Spanne von 0.377 Sekunden. IBM, Supermicro und NVIDIA führten diese Tests durch; wir haben die Ergebnisse weder durchgeführt noch geprüft.
Der Durchsatztest umfasste 200 Anfragen über 28 parallele Verbindungen, die aus 100 individuellen Eingabeaufforderungen mit insgesamt 24 Millionen Token und 825 GB KV-Cache-Daten generiert wurden. Der Cache war zu Beginn leer. Die Recompute-Baseline erreichte 0.19 Anfragen pro Sekunde in 1,048 Sekunden; die Storage-Scale-Ebene erzielte 4.26 Anfragen pro Sekunde in 46.94 Sekunden – eine 22-fache Steigerung, die die Kosten für das Befüllen des Caches beim Kaltstart berücksichtigt.
In einem dritten Testlauf wurden vier Clients hinzugefügt, die 200 GB/s unabhängigen Netzwerkverkehr über dasselbe Netzwerknetzwerk erzeugten. Die zwischengespeicherte Konfiguration verarbeitete die 200 Anfragen in 55.56 Sekunden mit 3.6 Anfragen pro Sekunde – etwa neun Sekunden langsamer als im Testlauf ohne zusätzliche Anforderungen und immer noch 18-mal so schnell wie der Ausgangswert. IBM führt diese geringe Leistungseinbuße darauf zurück, dass das Spectrum-X-Netzwerk den Cache-Verkehr von der Hintergrundlast isoliert.
„Agentenbasierte KI und Anwendungen mit langem Kontext sind auf die effiziente Wiederverwendung von Kontextinformationen über viele Schritte hinweg angewiesen. NVIDIA Dynamo unterstützt die Orchestrierung verteilter Inferenz, sodass Unternehmen einen höheren nutzbaren Durchsatz aus jeder GPU erzielen können“, so Shruti Koparkar, Produktleiterin für KI-Inferenz bei NVIDIA. „Durch die Kombination von NVIDIA Dynamo und Spectrum-X Ethernet mit Supermicro Petascale-Speicherservern und IBM Storage Scale schafft diese KV-Cache-Lösung eine leistungsstarke, gemeinsam genutzte Speicherebene. Diese reduziert redundante Berechnungen, verbessert die Time-to-First-Token und unterstützt Kunden bei der Skalierung robuster KI-Inferenzdienste.“
Größenangaben und was nicht in den Zahlen steckt
IBMs Dimensionierungsleitfaden sieht für eine Vier-Knoten-Konfiguration (4+2P) eine nutzbare Kapazität von 67 % für Modelle mit 7 bis 34 Byte und bis zu 64 GPUs vor. Die getestete Acht-Knoten-Konfiguration (8+2P) bietet eine nutzbare Kapazität von 80 % für Modelle mit 70 bis 120 Byte und 100 bis 256 GPUs mit einem Lesebandbreitenbedarf von 100 bis 300 GB/s. Für größere Modelle mit 300 oder mehr GPUs und einer Lesebandbreite von 300 GB/s und mehr werden 16 oder mehr Knoten (16+3P) empfohlen. Die Speicherkapazität von ECE selbst skaliert von drei bis 256 Speicherservern.
Die Testkonfiguration mit nur einer GPU ist der größte Schwachpunkt. Die Referenzarchitektur ist für Hunderte von GPUs ausgelegt, doch alle Ergebnisse im Paper stammen von einer einzelnen RTX PRO 6000 gegen einen 983 TB großen Flash-Speicher mit acht Knoten, dessen Geschwindigkeit IBM mit 315 GB/s angibt. Die Speicherkapazität war also weit von einer Auslastung entfernt, und die Tests zeigen nicht, wie sich TTFT verhält, wenn ein vollständiger GPU-Cluster gleichzeitig auf den Cache zugreift.
Supermicro hat weder Preise noch einen Verfügbarkeitstermin für die Komplettlösung veröffentlicht, und die Ankündigung enthält keine Angaben zur GPU-Auslastung. Der Ansatz bewegt sich im selben Bereich wie die Dynamo-integrierte KV-Cache-Beschleunigung von DDN auf dem AI400X3M , mit dem Unterschied, dass dieser Stack auf Standard-Supermicro-Servern und Ethernet unter dem IBM-Dateisystem läuft.
„Da KI-Workloads von der Trainingsphase auf die Inferenzphase ausgeweitet werden, müssen Unternehmen und Neoclouds, die Inferenz-Workloads mit hohem Durchsatz einsetzen, wie sie für agentenbasierte KI und kontextbezogene, mehrstufige generative KI charakteristisch sind, Engpässe beseitigen, um die GPU-Effizienz zu verbessern“, sagte Charles Liang, Präsident und CEO von Supermicro. „Unsere Lösung mit IBM und NVIDIA demonstriert diese Leistungsvorteile deutlich.“



 Amazon