

NVIDIA präsentiert auf der Hot Chips-Konferenz in Stanford eine klare Botschaft: Das Rechenzentrum ist der Computer, und seine Leistungsgrenze wird eher durch die Verbindungsstruktur als durch reine FLOPS bestimmt. In fünf Sessions zeigt NVIDIA, wie Spectrum-XGS Ethernet, NVLink der fünften Generation mit NVLink Fusion, CPO-betriebene Photonic Switches und der neue Desktop-Supercomputer DGX Spark zusammenarbeiten. Diese Integration zielt darauf ab, Zehntausende von GPUs in eine einzige, umsatzgenerierende KI-Fabrik zu verwandeln.
Ein dreischichtiges Gewebe für KI-Fabriken
Moderne LLMs sind implizit verteilte Anwendungen. Sie streamen Billionen von Parametern über GPUs, synchronisieren Gradienten-Updates im Mikrosekundentakt und müssen einem Benutzer in weniger als einem Herzschlag ein erstes Token zurückgeben. Diese Arbeitslast treibt eine Hierarchie von Verbindungen an:
- Skalieren Sie innerhalb eines Racks, sodass GPUs wie Kerne auf einem einzelnen, großen Prozessor funktionieren.
- Skalieren Sie über Racks hinweg, sodass der Cluster als einheitliches System funktioniert.
- Skalieren Sie ganze Rechenzentren, um Georedundanz, Kapazitätsfreigabe und die Einhaltung von Vorschriften zu gewährleisten.
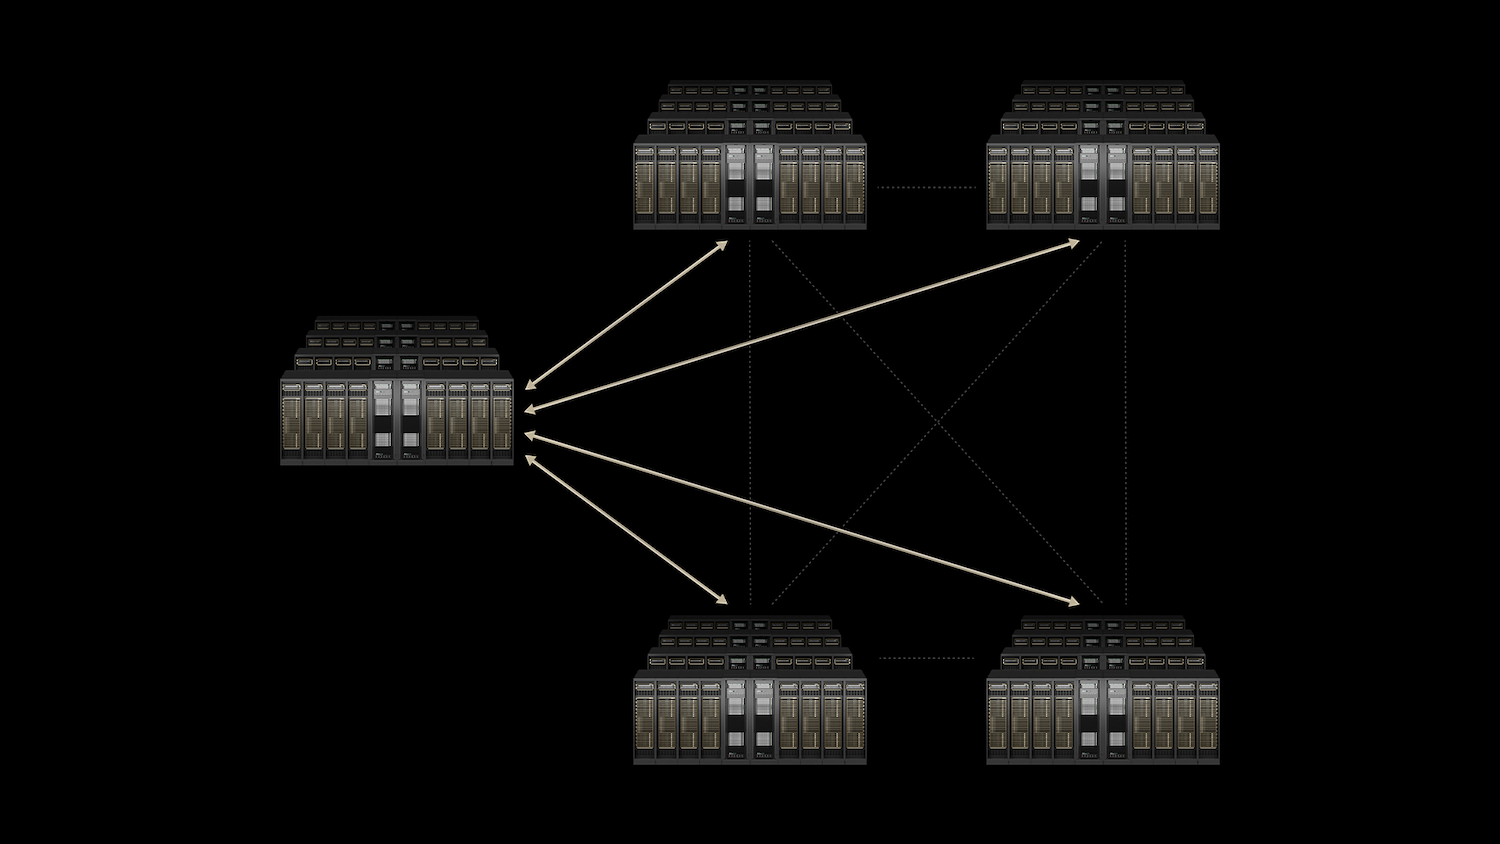
NVIDIAs Antwort ist ein vertikal integrierter Stack. NVLink und NVLink Switch beherrschen die Scale-Up-Domäne; Quantum InfiniBand und Spectrum-X beherrschen die Scale-Out-Domäne; das neue Spectrum-XGS Ethernet erweitert verlustfreie, KI-optimierte Netzwerke über Rechenzentren hinweg. Co-Packaged Optics (CPO) reduziert die Leistungs- und Dichtegrenzen, an die Cluster mit Millionen von GPUs sonst stoßen würden.
Spectrum-XGS Ethernet
Die herkömmliche Ethernet-Technologie war in erster Linie für die Verarbeitung von Best-Effort-Verkehr konzipiert und eignete sich daher gut für einfache Einzelserver-Kommunikation. In einer Welt, die zunehmend auf KI angewiesen ist, stehen wir jedoch vor neuen Herausforderungen.
Mit dem Aufkommen von KI-Kollektiven und mandantenfähigen Inferenzsystemen haben sich die Anforderungen an die Netzwerkleistung deutlich weiterentwickelt. Diese modernen Anwendungen erfordern ein Maß an Zuverlässigkeit und Geschwindigkeit, das herkömmliches Ethernet einfach nicht bieten kann.
Insbesondere ist ein Jitter-freies, also keine Latenzvariation, erforderlich, was für die Echtzeitverarbeitung entscheidend ist. Darüber hinaus gewährleistet die deterministische Latenz vorhersehbare und konsistente Antworten, was für Anwendungen, die auf sofortiges Feedback angewiesen sind, unerlässlich ist. Schließlich ist ein Durchsatz nahe der Leitungsgeschwindigkeit unerlässlich, um das hohe Datenvolumen zu bewältigen, das bei Microburst-Lasten verarbeitet wird, bei denen der Datenverkehr unerwartet stark ansteigen kann.
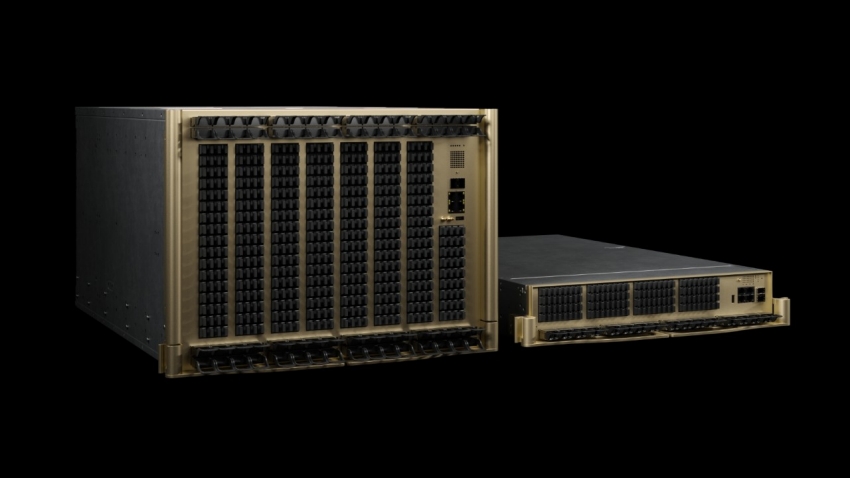
Spectrum-X ist eine Lösung, die nahtlos in ein Rechenzentrum integriert wird, während Spectrum-XGS diese Innovation durch die Erweiterung ihrer Funktionalität auf mehrere Rechenzentren auf die nächste Stufe hebt. Es integriert fortschrittliche Spectrum-6- oder -4-ASIC-basierte Switches mit superschnellen 800-Gbit/s-SuperNICs, insbesondere den Varianten BlueField-3 oder ConnectX-8. Diese Technologien arbeiten zusammen, um Engpässe effizient zu beheben und Pakete neu anzuordnen und so einen reibungslosen Datenfluss zu gewährleisten.
Das Besondere an diesem System ist die intelligente Telemetrie, die Daten von jedem Port sammelt und in die In-Switch-Logik zur Überlastungssteuerung einspeist. Dies ermöglicht eine Verkehrsumgestaltung in Echtzeit. In Produktionsclustern führt dies zu einer bemerkenswerten Leistung und hält den Durchsatz bei über 95 Prozent der theoretischen Kapazität bei einer beeindruckenden 32k-GPU-Skala. Im Gegensatz dazu kämpft herkömmliches 800G-Ethernet mit nur etwa 60 Prozent Durchsatz bei kollektiven Kollisionen.
Darüber hinaus garantiert Spectrum-XGS die Einhaltung von Standards und macht SONiC und Cumulus Linux zu integralen Bestandteilen seines Ökosystems. Das bedeutet, dass Cloud- und Unternehmensbetreiber ihre bestehenden Automatisierungs-Stacks beibehalten und gleichzeitig vom überlegenen Determinismus profitieren können, der typischerweise mit InfiniBand verbunden ist. Die Verbesserungen führen zu einer höheren GPU-Auslastung und reduzierten Latenzen, was sich in mehr Token pro Watt und strengeren Service-Level-Zielen niederschlägt. Darüber hinaus ermöglicht es Betreibern, neue Mieter in dieselbe Flotte aufzunehmen, ohne Leistungseinbußen zu erleben, was die Branche revolutioniert.
NVLink und NVLink Fusion: Das Rack als eine riesige GPU
NVLink der fünften Generation bietet beeindruckende 1.8 TB/s Punkt-zu-Punkt-Bandbreite und beeindruckende 130 TB/s Gesamtbandbreite innerhalb eines NVL72-Racks. Diese verbesserte Konnektivität ermöglicht es jeder GPU, in nur einem Hop direkt mit jeder anderen GPU zu kommunizieren, wodurch das gesamte Rack effektiv zu einer zusammenhängenden Speicherdomäne wird. Dank der NVIDIA Collective Communications Library (NCCL), die über zehn Jahre hinweg optimiert wurde, können Anwendungsentwickler mühelos nahezu leitungsgebundene Geschwindigkeiten erreichen, ohne eigenen Kommunikationscode für unterschiedliche Topologien schreiben zu müssen.
Darüber hinaus eröffnet die kürzlich angekündigte NVLink Fusion spannende Möglichkeiten für Hyperscaler. Diese Innovation ermöglicht die nahtlose Integration von NVLink SERDES oder Chiplets in kundenspezifische CPUs oder XPUs über UCIe (für Beschleuniger) bzw. NVLink-C2C (für CPUs). So können diese Komponenten direkt auf der NVLink-Fabric platziert werden. Ein wesentlicher Vorteil von Fusion ist die modulare MGX-Rack-Spezifikation, die mit einer vollständig qualifizierten Lieferkette einhergeht. Das bedeutet, dass dieselben Anbieter, die derzeit NVL72-Racks liefern, auch Fusion-Racks liefern können. Dies verkürzt die Markteinführungszeit für Unternehmen, die diese Technologie implementieren möchten, erheblich.
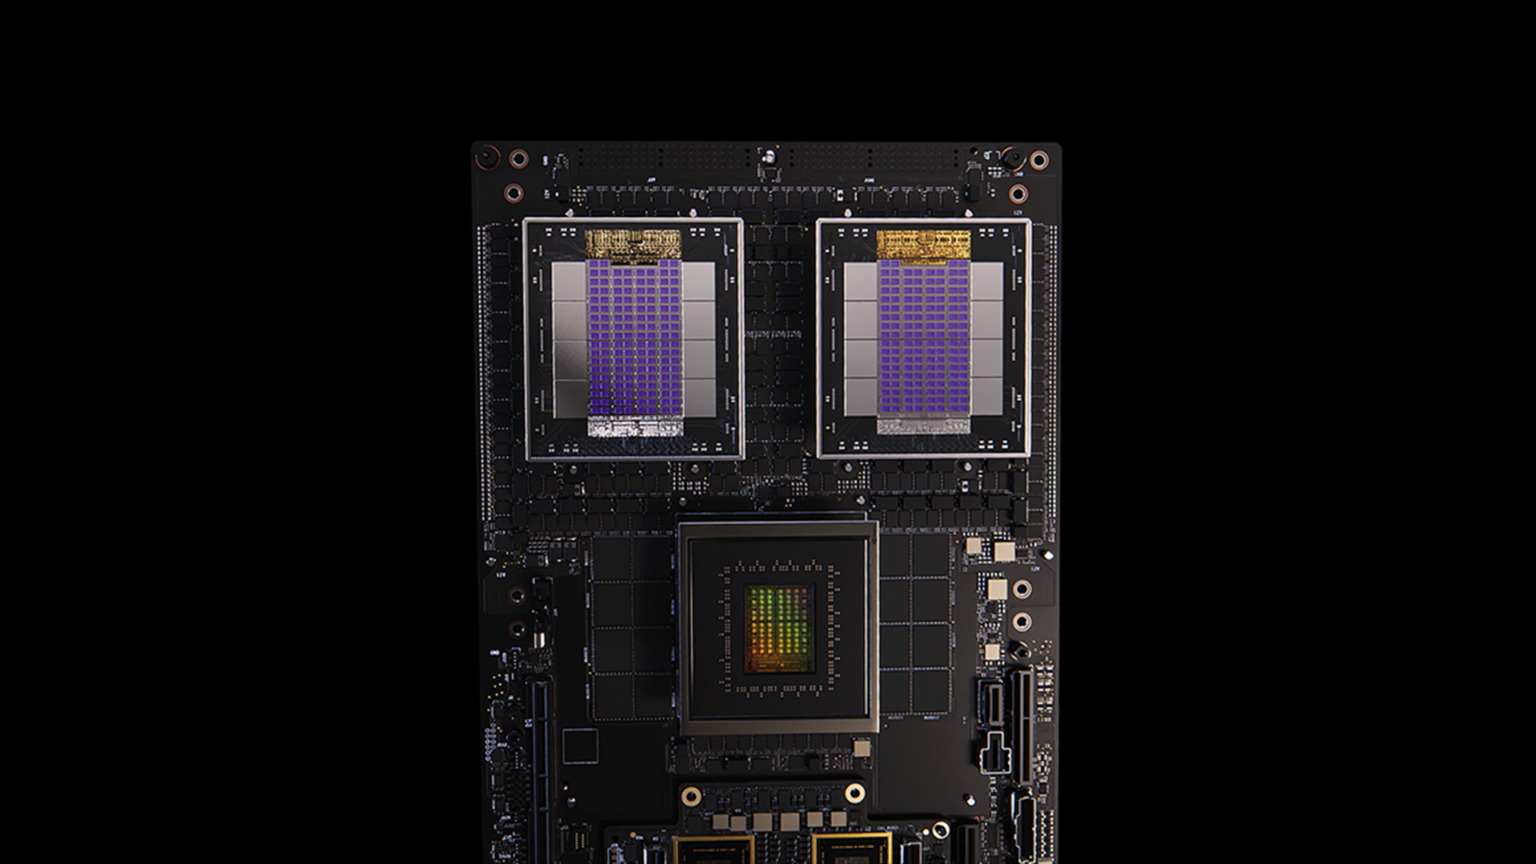
In Bezug auf die Inferenzökonomie zeigt sich der Einfluss von NVLink auf die traditionelle Pareto-Grenze von Durchsatz pro Watt gegenüber Latenz. Durch den Wechsel von einem PCIe-Mesh zu einem NVLink-Switch-Knoten verbessern sich sowohl Durchsatz als auch Latenz. Weitere Verbesserungen sind durch ein Upgrade auf das NVLink-Rack möglich. Dies führt zur Verarbeitung von mehr Benutzeranfragen pro Kilowattstunde und senkt gleichzeitig die amortisierten Investitionskosten pro generiertem Token. NVLink ist somit ein leistungsstarkes Tool zur Steigerung der Betriebseffizienz.
NVLink der fünften Generation bietet 1.8 TB/s Punkt-zu-Punkt-Bandbreite und 130 TB/s Gesamtbandbreite in einem NVL72-Rack. Mit NVLink Switch erkennt jede GPU jede andere in einem einzigen Hop, wodurch das gesamte Rack zu einer zusammenhängenden Speicherdomäne wird. Kollektive Operationen laufen über NCCL, eine Bibliothek, die nun im zehnten Produktionsjahr ist, auf jede erdenkliche Topologie abgestimmt ist und automatisch topologiebewusst arbeitet. Anwendungsentwickler benötigen daher keinen benutzerdefinierten Kommunikationscode, um nahezu kabelgebundene Geschwindigkeiten zu erreichen.
Co-Packaged Optics (CPO): Durchbrechen der Leistungsgrenze bei 800 Gb/s und mehr
Herkömmliche Switches mit steckbaren Modulen sind seit einiger Zeit der Netzwerkstandard. Die diesen Systemen innewohnenden Ineffizienzen werden jedoch zunehmend deutlicher. Wenn Daten den ASIC verlassen, durchlaufen sie lange Leiterbahnen auf der Leiterplatte und mehrere Steckverbinder, bevor sie ein DSP-lastiges optisches Modul erreichen. Dieser Weg führt zu erheblichen Verlusten, oft bis zu 22 dB im elektrischen Bereich, und verbraucht allein für die Signalwiederherstellung satte 30 W pro Port. Mit dem Streben nach höheren Datenraten, wie heute 200G PAM4 und den ehrgeizigen 1.6 T in naher Zukunft, werden die Grenzen dieser Architektur deutlich, was zu explosionsartigen Strombudgets und Einschränkungen der Frontplattendichte führt.
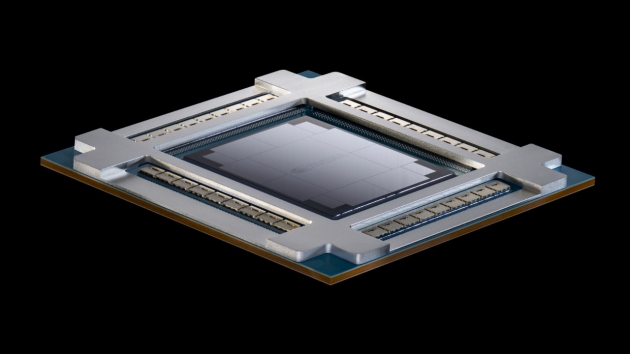
Hier kommen die innovativen Lösungen von NVIDIA zum Einsatz: Quantum-X Photonics für InfiniBand und Spectrum-X Photonics für Ethernet. Durch die direkte Integration der optischen Engines in das Switch-Paket wird die elektrische Pfadlänge drastisch reduziert. Dies minimiert nicht nur den Verlust auf etwa 4 dB, sondern senkt auch den Stromverbrauch des Ports auf ca. 9 W – eine beeindruckende Verbesserung.
Nächste Woche werden zwei hochmoderne flüssigkeitsgekühlte Gehäuse auf den Markt kommen: das 128-Port-Modell mit einem beeindruckenden Durchsatz von 102.4 Tb/s und das 512-Port-Modell, das diese Grenze sogar auf 409.6 Tb/s erhöht. Letzteres Modell verfügt über einen integrierten Fiber Shuffle, der sicherstellt, dass jeder Port nahtlos mit dem richtigen Glasfaserbündel verbunden wird, ohne dass umständliches manuelles Patchen erforderlich ist. Erste Felddaten sind vielversprechend und deuten auf eine bemerkenswerte 3.5-mal bessere Energieeffizienz und eine etwa 10-mal längere mittlere Betriebsdauer zwischen Ausfällen im Vergleich zu herkömmlichen Pluggables hin. Darüber hinaus ist das Startfenster pro Cluster 1.3-mal schneller, was die Bereitstellung vereinfacht.
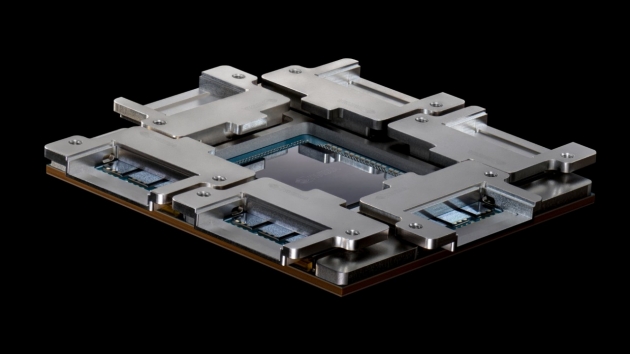
Obwohl diese fortschrittlichen Lösungen erst 2026 verfügbar sein werden, laufen die Design-Ins bereits. Dies ist entscheidend für Betreiber, die Anlagen im Gigawatt-Bereich planen, oder für Regierungen, die nationale Labore mit einer Million GPUs in Betracht ziehen. Die CPO-Technologie (Coherent Photonics Optics) von NVIDIA zeigt klar auf, wie man die Leistungsgrenzen einhält und den gefürchteten Wartungsalptraum der Optik vermeidet. Damit ebnet sie den Weg für eine effizientere und leistungsstärkere Zukunft im Bereich der Hochleistungsnetzwerke.
DGX Spark und das System: Vom Desktop-Prototyp zur Rack-Scale-Produktion
Nicht jede Arbeitslast beginnt im Hyperscale-Bereich. DGX Spark , basierend auf dem neuen GB10 Superchip, komprimiert Blackwell Tensor Cores, NVFP4-Inferenz (4-Bit-Gleitkomma) und alle CUDA-X-Bibliotheken in ein kompaktes Gehäuse. Entwickler trainieren, optimieren und erstellen RAG-Compose-Workloads lokal und verschieben anschließend identische Container per Lift-and-Shift auf GB200- oder GB300-NVL72-Racks, sobald die Arbeitslasten ausgereift sind.
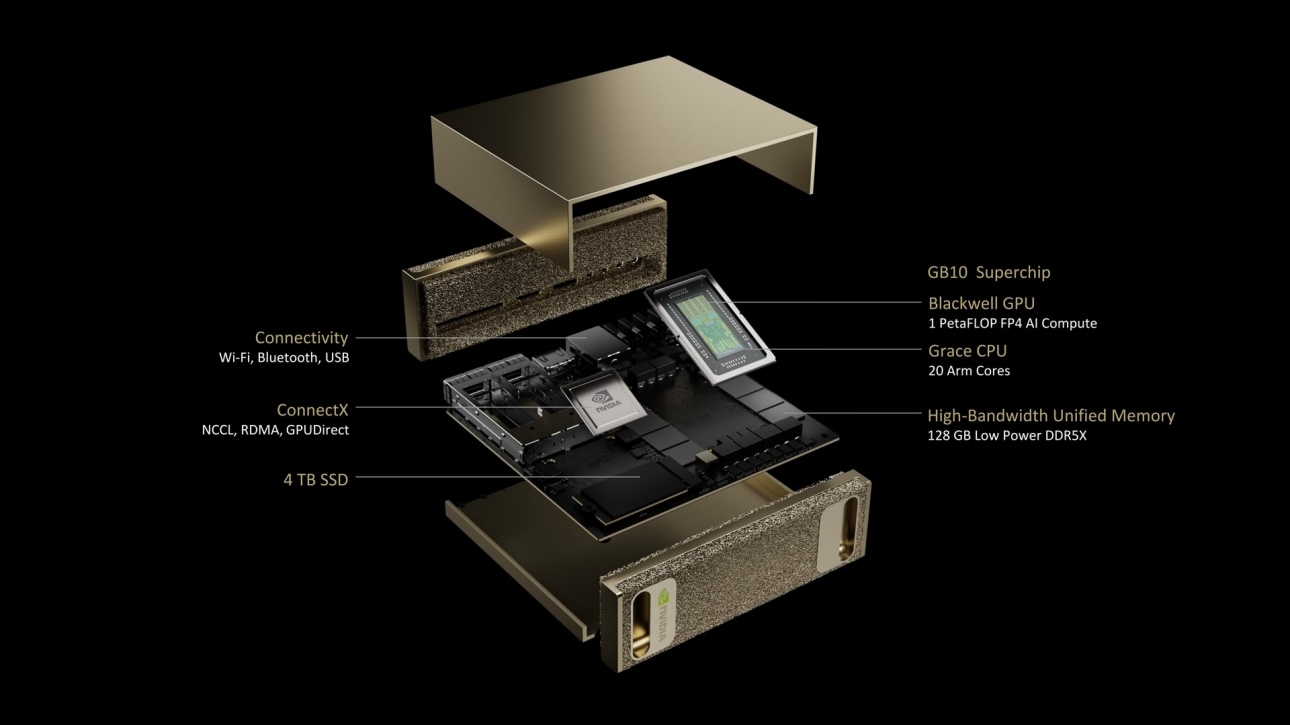
Dieses Kontinuum ermöglicht es Unternehmen, agentenbasierte KI, Roboterwahrnehmung oder multimodale generative Aufgaben zu steuern, ohne Cluster-Slots zu blockieren. Spark ist für die Praxis ein Trojanisches Pferd: Platzieren Sie es im Kundenlabor, lassen Sie die Forscher die 4-Bit-Inferenzbeschleunigung aus erster Hand erleben, und Erweiterungen folgen.
Der Software-Multiplikator: TensorRT-LLM, Dynamo und NIM-Microservices
Hardware-Verbindungen setzen Grenzen; Software bestimmt, wie nahe die realen Workloads herankommen. NVIDIA demonstriert TensorRT-LLM mit dem 120-Milliarden-Parameter-GPT-OSS-Modell in NVFP4 und erreicht damit in langen Kontexten die vierfache Interaktivität des Standard-TorchServe. Auf GB200-Racks erreicht DeepSeek-R1 mit 671 B mit Dynamos disaggregiertem Pipeline-Scheduler einen 2.5-fach höheren Durchsatz pro GPU, ohne die Kosten pro Abfrage zu erhöhen. All dies wird in Form von NIM-Microservices bereitgestellt – containerisierten Endpunkten, die sowohl in Kubernetes-Clustern als auch in lokalen Bare-Metal-Stacks integriert werden können.
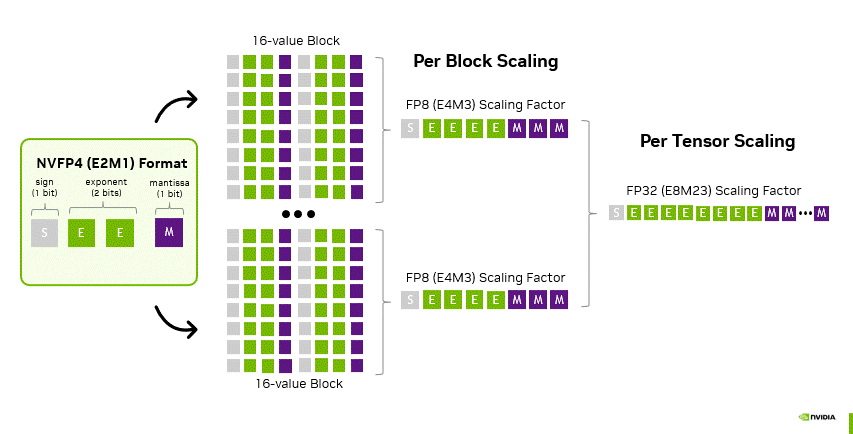
Open Source bildet die Grundlage des Stacks. RAPIDS beschleunigt ETL durchgängig auf GPUs; CUTLASS-Vorlagen ermöglichen benutzerdefinierte Hochleistungskernel; NeMo und BioNeMo erweitern PyTorch für Frontier-LLM- und Proteinfaltungstraining und bleiben dabei 100 Prozent OSS. Die Botschaft an Käufer, die sich vor Lock-in-Strategien hüten: NVIDIA ist „offen, wo es darauf ankommt, optimiert, wo es darauf ankommt“.
Wettbewerbs- und kommerzielle Auswirkungen
NVIDIA hat sich durch seinen vertikal integrierten Ansatz eine einzigartige Position in der Technologielandschaft erarbeitet, insbesondere im Vergleich zu Anbietern von Merchant-Silicon-Switches und disaggregierten Accelerator-Startups. Diese Strategie ermöglicht es NVIDIA, nicht nur einzelne Komponenten, sondern umfassende Lösungen mit einer Referenzarchitektur anzubieten. Diese Architektur wird durch eine bewährte Lieferkette, einen klar definierten Zweijahresplan und eine High-Level-API-Oberfläche (NIM) unterstützt, die die Komplexität der Verkabelung für Entwickler vereinfacht.
Für Hyperscaler sind die Angebote von NVIDIA aufgrund ihres Fokus auf deterministische Service Level Agreements (SLAs) und minimales Betriebsrisiko attraktiv. Durch die Implementierung von NVLink-Racks erreichen diese Unternehmen erstklassige Inferenzfunktionen, die für Anwendungen mit schneller Datenverarbeitung unerlässlich sind. Darüber hinaus erleichtert die Spectrum-X-Technologie die Skalierung der Kapazität und ermöglicht Hyperscalern eine nahtlose Erweiterung ihrer Infrastruktur. Die Einführung von Spectrum-XGS ermöglicht die Föderation von Regionen und verbessert so die Effizienz der Ressourcenzuweisung in geografisch verteilten Rechenzentren. Diese Integration unterstützt den Betrieb von Standard-Ethernet-Steuerungsebenen und gewährleistet Kompatibilität und einfache Verwaltung innerhalb der bestehenden Infrastruktur.
Für Unternehmen liegt der Reiz der NVIDIA-Technologie in der Möglichkeit, den Umsatz pro Rack zu maximieren. Das Spectrum-X-System beispielsweise steigert die Effektivität von GPU-Zyklen deutlich – angeblich um bis zu 35 Prozent. Das bedeutet, dass Unternehmen eine höhere Leistung erzielen können, sei es in Form von Token, Bildern oder automatisierten Aktionen, ohne ihre Investitionsausgaben zu erhöhen. Dadurch können Unternehmen mehr Wert aus ihren bestehenden Investitionen ziehen und den modernen Anforderungen an Effizienz und Kosteneffizienz in einem wettbewerbsintensiven Markt gerecht werden.
Fazit
Die Geschichte um Hot Chips markiert einen bemerkenswerten Wandel in der Computertechnologie, insbesondere im Bereich der künstlichen Intelligenz (KI). Sie unterstreicht, dass die Vernetzung heute als grundlegender Beschleuniger in der Computertechnik gilt und in ihrer Bedeutung mit Fortschritten wie Tensorkernen vergleichbar ist.
Technologien wie NVLink sind entscheidend, da sie ein Server-Rack in einen zusammenhängenden logischen Chip verwandeln und so Leistung und Effizienz steigern. Spectrum-X spielt eine entscheidende Rolle bei der Ermöglichung von Sub-Millisekunden-Kollektiven über ausgedehnte Netzwerke, während Spectrum-XGS diese Hochleistungsstruktur global erweitert. Darüber hinaus ist CPO darauf ausgelegt, die Anforderungen an Leistung und Dichte zukunftssicher zu gestalten und den sich entwickelnden Anforderungen von KI-Anwendungen gerecht zu werden. DGX Spark hingegen trägt maßgeblich zur Förderung der Einführung dieser Technologien bei und ermutigt Unternehmen, innovative Lösungen zu nutzen.
Zusammengenommen haben diese Fortschritte das Potenzial, die wirtschaftliche Dynamik sowohl von Inferenz- als auch von Trainingsprozessen zu verändern. Dies ist besonders relevant, da Unternehmen derzeit an einem Scheideweg stehen und ihre Optionen zwischen dem Aufbau einer neuen Infrastruktur, der Anmietung bestehender Lösungen oder der Verzögerung von Investitionen in groß angelegte KI-Kapazitäten abwägen. Die Position von NVIDIA ist eindeutig: Unternehmen sollten in den Aufbau ihrer eigenen Infrastruktur investieren, wobei der Schwerpunkt auf einem Netzwerk-Framework liegen sollte, das – vom Kupfer-Spinne bis zum photonischen Switch – sorgfältig konzipiert ist, um die kommende Ära der KI-gesteuerten Fabriken zu unterstützen.


 Amazon