

VAST Data hat eine neue Inferenzarchitektur vorgestellt, die die NVIDIA Inference Context Memory Storage Platform unterstützt. Dieses System ist auf KI-Anwendungen mit fortlaufenden, mehrstufigen, agentengesteuerten Sitzungen ausgerichtet. VAST präsentiert diese Plattform als speziell für KI entwickelte Speicherklasse, die den Zugriff auf den Key-Value-Cache (KV-Cache) verbessert, die schnelle gemeinsame Nutzung des Inferenzkontexts zwischen Knoten ermöglicht und die Energieeffizienz steigert. Das Design nutzt NVIDIA BlueField-4 DPUs und Spectrum-X Ethernet-Netzwerke, während das VAST AI Operating System (AI OS) die notwendige Software zur effizienten Verwaltung dieser gemeinsam genutzten Infrastruktur bereitstellt.
Mehr über die Bedeutung des KV-Caches erfahren Sie in unserer ausführlichen Analyse mit Pliops.
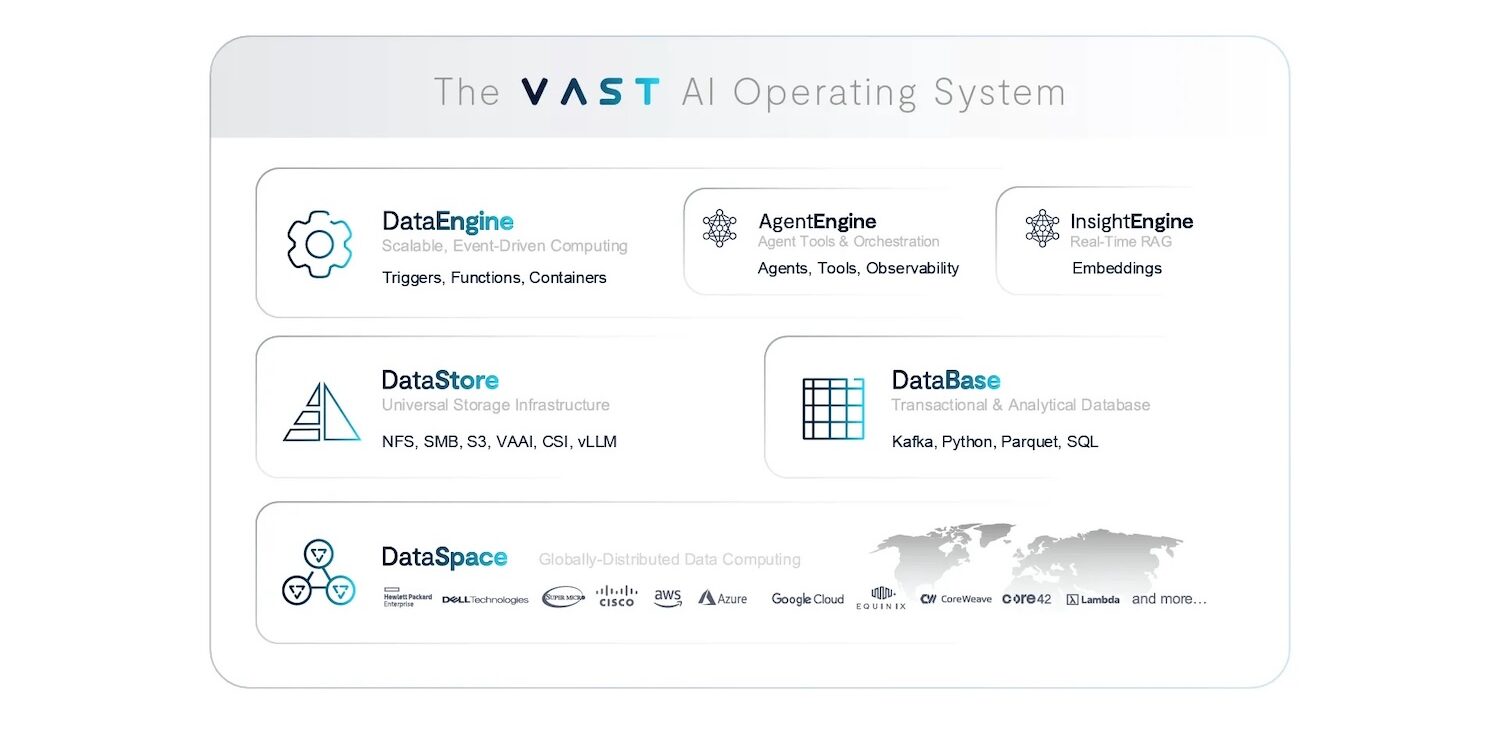
Die Ankündigung signalisiert eine Veränderung der Faktoren, die die Inferenzleistung in realen Anwendungen einschränken. Da sich die Inferenz von einfachen Eingabeaufforderungen hin zu kontinuierlichem Schließen über mehrere Agenten und Benutzer hinweg entwickelt, verliert die Vorstellung, dass der Kontext auf einen einzelnen GPU-Server beschränkt bleibt, an Bedeutung. In diesen Situationen hängt die Gesamtleistung zunehmend davon ab, wie gut die Inferenzhistorie während des laufenden Betriebs gespeichert, wiederhergestellt, wiederverwendet, erweitert und geteilt wird. Der KV-Cache entwickelt sich von einer internen Optimierung zu einem primären Datenpfad und beeinflusst die Zeit bis zum ersten Token (TTFT), die GPU-Auslastung und die Clustereffizienz.
Neuaufbau des Inferenzdatenpfads um DPUs herum
Die Strategie von VAST besteht darin, die VAST AI OS-Software direkt auf NVIDIA BlueField-4 DPUs auszuführen. Anstatt Speicher- und Kontextdienste als externe Komponenten zu betrachten, auf die über ein typisches Client-Server-Modell zugegriffen wird, integriert die Architektur diese Datendienste direkt in den GPU-Server, wo die Inferenz stattfindet. Gleichzeitig werden dedizierte Datenknotenkonfigurationen unterstützt. Dieser Ansatz zielt darauf ab, Engpässe zu minimieren und unnötige Kopien und Verzögerungen zu eliminieren, die die Leistung bei zunehmender Parallelität beeinträchtigen.
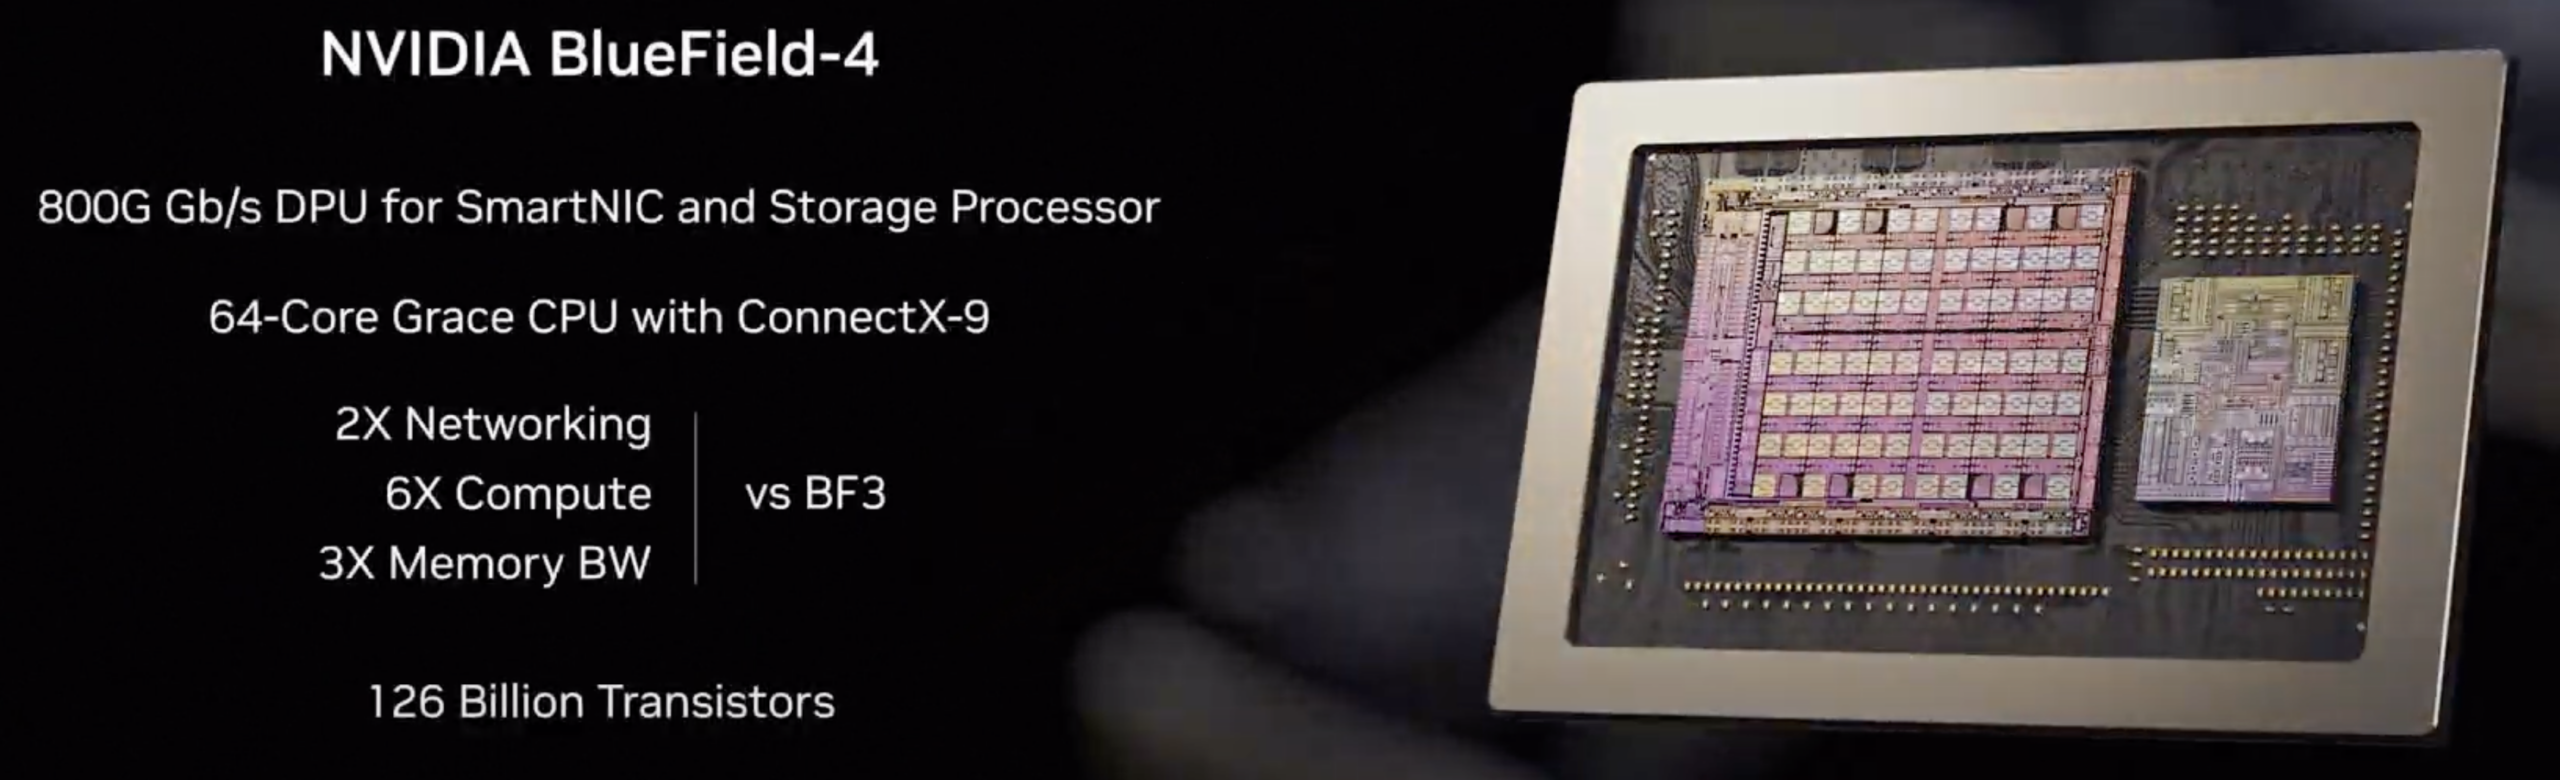
Dieses DPU-native Design geht explizit auf die praktischen Anforderungen großer Inferenzsysteme ein. Wenn Hunderte oder Tausende von Sitzungen gleichzeitig ausgeführt werden, wird die Verwaltung des KV-Caches zu einer kontinuierlichen Ein-/Ausgabeoperation (E/A). Das System muss den Kontext schnell lesen, um die Sitzungen aufrechtzuerhalten, ihn langfristig speichern und zwischen den Workern teilen, um doppelte Verarbeitung zu vermeiden, wenn die Infrastruktur Operationen über langsamere Pfade leitet oder eine umfangreiche Koordination erfordert. Die TTFT (Time-to-Flight) steigt, wodurch GPUs warten müssen, anstatt zu verarbeiten. VAST argumentiert, dass die Verlagerung der Datenebene auf den Server mittels BlueField-4 einen effizienteren Kontextverkehr, einen höheren Durchsatz und eine zuverlässigere Latenz näher an die GPU-Verarbeitungsschleife ermöglicht.
VAST legt zudem Wert auf einen effizienten Datenpfad vom GPU-Speicher zum persistenten NVMe-Speicher mittels RDMA-Fabrics. Dies ermöglicht einen reibungslosen Kontexttransfer zwischen GPU-Servern und Speicher und reduziert die in herkömmlichen Systemen übliche, wiederholte Datenverarbeitung. Ziel ist es, die Kontextübertragung im Einklang mit der Hochleistungsnetzwerkarchitektur zu gewährleisten und gleichzeitig die CPU-Belastung und den clientseitigen Overhead zu minimieren.
Gemeinsamer, kohärenter Kontext in großem Umfang
Die neue Architektur arbeitet mit dem parallelen DASE-Design (Disaggregated Shared Everything) von VAST zusammen. VAST erklärt, dass dies jedem Host den Zugriff auf einen gemeinsamen, global konsistenten Kontext-Namensraum ermöglicht, ohne die üblicherweise bei großen Datenmengen auftretenden Koordinationskosten. Bei langlebigen, agentengesteuerten Inferenzprozessen ist dieses Detail entscheidend. Der Kontext ist nicht nur umfangreich, sondern wird auch zunehmend gemeinsam genutzt.
Agentenbasierte Systeme erfordern häufig die gleichzeitige Nutzung von Werkzeugen, die Übergabe zwischen mehreren Agenten und ein speicherähnliches Verhalten während der Interaktionen. Dies bedingt die Wiederverwendung von Kontextdaten anstatt deren Neuerstellung und die gemeinsame Nutzung durch Inferenzprozesse anstatt der Bindung an einen einzelnen Knoten. Können Systeme die Kontextlokalität aufgrund von Scheduling, Verdrängung oder Fehlerbehebung nicht aufrechterhalten, müssen sie Sitzungen schnell wiederherstellen und fortsetzen, ohne umfangreiche Eingabeaufforderungsverläufe erneut zu verarbeiten. Dadurch wird der KV-Cache zu einer wichtigen Clusterressource, wodurch die Herausforderung darin besteht, ihn breit zugänglich zu machen, ohne zu einem Synchronisierungsengpass zu werden.
VAST verfolgt den Ansatz, dass die Kombination von DPU-basierten Datendiensten mit einem gemeinsam genutzten Speichersystem eine global zugängliche Kontextschicht schafft, die auch bei steigender Anzahl gleichzeitiger Sitzungen effizient bleibt. Anstatt durch das Hinzufügen isolierter Kontextabschnitte zu skalieren, ermöglicht die Plattform die Erweiterung von Clustern unter Beibehaltung der Vorteile von Wiederverwendung und gemeinsamer Nutzung.
Kontext als neuer Leistungsraum
John Mao, ein leitender Angestellter von VAST, merkte an, dass sich der Wettbewerbsvorteil großer Inferenzsysteme von reiner Rechenleistung hin zu Speicher- und Kontextsystemen verlagert. Er fasste zusammen, dass die leistungsstärksten Cluster nicht nur diejenigen mit der höchsten Spitzenleistung (FLOPS) sein werden, sondern diejenigen, die Kontext in Echtzeit teilen und verwalten können. Er hob außerdem die Bedeutung des sofortigen, bedarfsgerechten Zugriffs auf Kontext als zentralen Leistungsfaktor hervor und warnte davor, dass GPUs ohne schnellen Kontextabruf und -wiederverwendung ungenutzt bleiben und die Effizienz leidet.
Diese Sichtweise deckt sich mit den Erfahrungen vieler Betreiber bei wachsenden Modellen und längeren Sitzungen. Inferenzflotten sind oft auf maximale Token-Produktion ausgelegt, doch die tatsächliche Leistung wird unter Last durch Tail-Latenz und TTFT (Time-to-Flight) beeinträchtigt. Mit zunehmender Dauer der Eingabeaufforderungen und Sitzungen steigt der Zeitaufwand für das Kontextmanagement. Kann der Kontext nicht schnell wiederhergestellt oder wiederverwendet werden, gehen GPU-Zyklen für die Wiederherstellung des Zustands oder das Warten auf Datenbewegungen verloren. Der Architekturansatz von VAST behandelt den KV-Cache als gemeinsam genutzte Infrastruktur, wodurch diese Probleme reduziert und die Gesamteffizienz des Clusters gesteigert wird.
Vom Experimentieren zur gesteuerten Produktion: Rückschlüsse
VAST präsentiert die Plattform auch als Übergang von experimentellen Implementierungen zu produktionsreifen Inferenzdiensten, auch in regulierten Umgebungen. Da Inferenz zu einem umsatzgenerierenden Dienst mit spezifischen Sicherheits- und Compliance-Anforderungen wird, erfordert die Verwaltung des KV-Caches mehr als nur Geschwindigkeit; sie erfordert Überwachung.
In längeren Sitzungen kann der Kontext sensible Eingabeaufforderungen, Schlussfolgerungsschritte, Tool-Ausgaben und benutzerseitig bereitgestellte Informationen umfassen. Unternehmen benötigen daher zunehmend Richtlinienkontrollen, Isolationsmaßnahmen, Audit-Trails und Lebenszyklusmanagement für diesen Kontext. VAST behauptet, dass diese KI-nativen Datendienste in das KI-Betriebssystem integriert sind, sodass Unternehmen den KV-Cache als verwaltbare Ressource und nicht als temporären Zustand behandeln können.
Aus operativer Sicht zielt VAST darauf ab, häufige Herausforderungen in großen Inferenzumgebungen zu bewältigen: Kontext-Neuaufbau-Stürme, die auftreten, wenn Caches verloren gehen oder nicht gemeinsam genutzt werden können, und verschwendete GPU-Zeit, wenn der Kontext anstelle der Berechnung zum Flaschenhals wird. Das Unternehmen ist überzeugt, dass eine verbesserte Kontextpersistenz und -wiederverwendung die Neuberechnung reduziert und die Nutzung erhöht, wodurch sowohl der Durchsatz pro Watt als auch der Durchsatz pro Dollar mit zunehmender Kontextgröße und Sitzungskonkurrenz verbessert werden.
NVIDIA: Kontextmanagement treibt Skalierungseffekte voran
Kevin Deierling, Senior Vice President Networking bei NVIDIA, betonte die Bedeutung des Kontextes in der KI und verglich ihn mit dem menschlichen Gedächtnis. Er erklärte, dass ein effektives Kontextmanagement unerlässlich für die Skalierung von Multi-Turn- und Multi-User-Inferenz sei, was wiederum die Handhabung des Kontextspeichers im großen Maßstab verändere. Er merkte an, dass VAST Data AI OS in Kombination mit NVIDIA BlueField-4 dies durch einen stabilen Datenpfad mit hohem Durchsatz auch bei steigender Arbeitslast unterstütze. Diese Partnerschaft sei wichtig, da sie DPUs und Ethernet-Fabric in den Kernkontext der Inferenz integriere, nicht nur für den primären Speicherzugriff oder die Netzwerkkommunikation. Der entscheidende Punkt sei, dass Kontext nun neben der GPU-Problematik auch eine Herausforderung für Netzwerk und Speicher darstelle und moderne Inferenz-Setups gezielte Beschleunigung und zuverlässige Datenübertragung erforderten, um einen effizienten GPU-Betrieb zu gewährleisten.
Wenn die Architektur von VAST die versprochenen Vorteile bietet, wird der tatsächliche Effekt weniger in Spitzenwerten von Benchmarks liegen, sondern vielmehr in einer konsistenten Serviceleistung: geringere TTFT bei vielen aktiven Sitzungen, weniger Leistungseinbrüche bei zunehmendem Kontext, bessere Auslastung durch reduzierten Kontextneuaufbau und ein direkterer Weg zur Multi-Node-Inferenz, bei der die gemeinsame Nutzung des Kontexts ein Vorteil und kein Nachteil ist. Sie treibt außerdem die Inferenzinfrastruktur in Richtung eines stärker „KI-nativen“ Modells voran, indem sie den KV-Cache als verwaltete Speicherebene behandelt, die von persistentem NVMe unterstützt und mit engen Latenzgrenzen von allen Knoten gemeinsam genutzt wird.
VAST Forward Konferenz
VAST Data wird seine Strategie auf der ersten VAST Forward-Anwenderkonferenz vorstellen, die vom 24. bis 26. Februar 2026 in Salt Lake City, Utah, stattfindet. Das Unternehmen plant, detaillierte technische Sitzungen, praktische Workshops und Zertifizierungsprogramme anzubieten, an denen Führungskräfte , Kunden und Partner von VAST teilnehmen werden.


 Amazon