

Die NVIDIA RTX PRO 4500 Blackwell Server Edition ist die Grafikkarte, die NVIDIA für die Server entwickelt hat, die die meisten Unternehmen bereits im Einsatz haben. Es handelt sich um eine passiv gekühlte Single-Slot-Karte mit 165 W TDP, 32 GB GDDR7-Speicher und dem vollen Funktionsumfang der Blackwell-Architektur: Tensor-Kerne der fünften Generation mit FP4, RT-Kerne der vierten Generation, drei Encoder und drei Decoder sowie Multi-Instance-GPU-Unterstützung, die den Speicher in zwei isolierte 16-GB-Partitionen aufteilen kann. Sie ersetzt die L4 als Einstiegsmodell in NVIDIAs RTX PRO-Server-Produktreihe und passt problemlos in 2U-Gehäuse von PowerEdge, ProLiant oder ThinkSystem, ohne dass Leistungs- oder Kühlungsprobleme auftreten.

NVIDIAs Argument für die Karte ist die optimale Dimensionierung: Die meisten Unternehmen bauen keine KI-Fabriken, sondern betreiben luftgekühlte, bestehende Rechenzentren mit begrenzter Rack-Leistung und benötigen einen ersten Schritt zu beschleunigtem Computing, der keine neue Serverklasse erfordert. Oder sie arbeiten am Netzwerkrand, wo die RTX PRO 4500 besser auf die Workloads und Leistungsbeschränkungen abgestimmt ist, die typischerweise die Einsatzmöglichkeiten bestimmen.
Die RTX PRO 6000 Blackwell deckt mit 96 GB Speicher und bis zu 600 W die Spitze dieses Marktsegments ab. Die 4500er-Serie basiert auf derselben Architektur, bietet aber in allen anderen Bereichen etwa die Hälfte weniger Leistung. Kunden mit kleineren Modellen, vielen kleineren Aufgaben oder einem Budget, das auf ein optimales Preis-Leistungs-Verhältnis pro Watt abzielt, erhalten mit Blackwell eine Grafikkarte, ohne für ungenutzte Leistungsreserven zu bezahlen.
Die Anwendungsbereiche dieser GPU-Klasse sind gut erforscht: Inferenz kleiner Sprachmodelle, KI-gestützte Bildverarbeitung und Videoanalyse, Vektorsuche und Einbettungsgenerierung, Transkodierung und virtuelle Workstations unter vGPU 20. Sie bietet mehr als die fünffache Leistung der L4-Architektur für die Inferenz kleiner und mittelgroßer Modelle und bis zu die zehnfache Leistung bei Nemotron-Modellen. Zu den Launch-Partnern gehören NTT DATA für Edge-Video, Pacific Biosciences für Sequenzierung und Nokia für AI-RAN-Basisstationen. AWS hat seine neuen G7-Instanzen als Nachfolger der G6-Architektur darauf aufgebaut.
Wir haben die Karte bereits in unserem Test der RTX PRO 4500 edge gegen die L4 in einem HPE ProLiant DL145 Gen11 getestet , wo sie die 2.7-fache Leistung der L4 erreichte. Dieser Test beantwortet die Frage, wie nahe sie an die 350-Watt-L40S mit zwei Steckplätzen herankommt, die zwei Jahre lang die Standardkarte für Mainstream-Anwendungen war, und welche zusätzlichen Speicher- und Leistungsvorteile die darüber liegende RTX PRO 6000 bietet.
Um das herauszufinden, haben wir die 4500 in einem Dell PowerEdge R770 gegen einen L40S und einen L4 eingesetzt, die Daten der RTX PRO 6000 Blackwell aus unserem Dell Pro Max Tower T2 sowohl bei der Standardleistung von 600 W als auch bei einer Leistungsaufnahme von 450 W, entsprechend der maximalen Leistungsaufnahme eines GPU-Steckplatzes im R770, hinzugefügt und vLLM Online-Serving auf vier Modellen bei zwei Kontextlängen ausgeführt.
Zur kurzen Vorschau: Bei typischen Chat- und Agentenkontextlängen hält die 4500 mit der L40S auf den FP8- und BF16-Modellen mit, und das bei weniger als der Hälfte des Stromverbrauchs; bei 8K-Eingabe zeigt der 32 GB große Framebuffer seine Grenzen; und NVFP4, die Präzision, mit der NVIDIA seine Blackwell-Plattform anführt, schneidet auf diesem vLLM-Build im Einklang mit dem Rest der Produktpalette ab.
Wichtige Erkenntnisse
- L40S-Durchsatz bei 165 W in einem Steckplatz: Bei einer Eingabe und Ausgabe von 512 Token erreichte die 4500 auf allen von uns getesteten FP8- und BF16-Modellen die gleiche oder sogar eine leichtere Leistung als die L40S (1,107 gegenüber 995 Token/s auf Ministral 3 14B FP8 und 2,006 gegenüber 1,988 auf Ministral 3 3B), und das mit einer Karte, die nur für 47 Prozent der Leistung der L40S und die Hälfte ihrer Steckplätze ausgelegt ist.
- Etwa das Dreifache des L4, den es ersetzt: 2.8- bis 3.6-facher Durchsatz der L4-Karte bei kurzem Kontext, bei 2.3-facher Leistungsaufnahme der L4-Karte.
- 32 GB haben eine Obergrenze: Bei 8K-Eingangsrate lag die 4500 um 17 bis 33 Prozent hinter der L40S zurück, und ihre Kurven flachten bei 8 gleichzeitigen Zugriffen ab, während die L40S bis 16 weiter anstieg. Die Abflachung ist auf das Auslaufen des KV-Caches zurückzuführen, und 32 GB setzen diese Grenze.
- NVFP4 ist eine Softwaregeschichte, die auf jeder Karte steckt: Auf Qwen3.8-27B NVFP4 erreichte die 4500 bei 32 gleichzeitigen Verarbeitungsschritten 320 Token/s, die L40S ohne FP4-Hardware 480 und die RTX PRO 6000 621. Der NVFP4-Pfad skaliert in dieser vLLM-Version bei keiner der Karten mit der Speicherbandbreite, während der MAMF-Sweep zeigt, dass die FP4-Hardware der 4500 568.6 TFLOPS erreicht, verglichen mit 280.1 TFLOPS in FP8.
- Was Ihnen die größere Karte bietet: Die auf 450 W begrenzte Leistungsaufnahme, die durch einen Dell R770-GPU-Steckplatz maximal möglich ist, erreichte bei kurzen Kontextsimulationen etwa die doppelte Leistung der 4500 und bei 8K die 2.5- bis 3.2-fache. Ihre volle Leistungsaufnahme von 600 W brachte bei kurzen Kontextsimulationen zusätzlich 1 bis 2 Prozent und bei langen Kontextsimulationen 4 bis 9 Prozent mehr Leistung. Der größte Vorteil der 6000 gegenüber der 4500 liegt also im Speicher.
NVIDIA RTX PRO 4500 Blackwell Server Edition Spezifikationen
Zwei Grafikkarten tragen den Namen RTX PRO 4500 Blackwell und sind zwar ähnlich, aber nicht identisch. Die Workstation Edition, die auf der GTC 2025 vorgestellt wurde, ist eine 200-Watt-Karte mit Dual-Slot-Belegung, aktiver Kühlung, vier DisplayPort-Anschlüssen und 896 GB/s Speicherbandbreite. Die hier getestete Server Edition wurde auf der GTC 2026 präsentiert. Sie ist eine 165-Watt-Karte mit Single-Slot-Belegung, passiver Kühlung und Headless-Design mit 800 GB/s. Im Gegensatz zur ersten Karte bietet sie weniger DisplayPort-Anschlüsse und etwas weniger Taktreserven, dafür aber mehr Funktionen für Rechenzentren: MIG, Confidential Computing, ein dritter NVENC- und NVDEC-Chip sowie vGPU-20-Unterstützung. Beide Karten verfügen über dieselbe 10,496-Kern-GPU und 32 GB GDDR7-Speicher mit ECC-Unterstützung.
Laut NVIDIAs Daten verfügt der Chip über 45.6 Milliarden Transistoren auf 378 mm² TSMC-4-nm-Custom-Silizium mit 82 RT-Kernen der vierten Generation, was 82 SMs und 328 Tensor-Kernen entspricht. Diese Werte stammen vom GB203-Chip, der gleichen Chipfamilie wie die RTX 5080, jedoch mit reduzierter Leistung. Die unten aufgeführten Tensor-Werte stellen NVIDIAs Spitzenwerte mit reduzierter Dichte dar; die volle Dichte entspricht der Hälfte, was NVIDIAs eigenes peakTOPS-Binary mit 805 TFLOPS FP8 und 403 TFLOPS FP16 bestätigt, gemessen auf dieser Karte.
| Normen | Blackwell RTX PRO 4500 SE | L4 | L40 | Blackwell RTX PRO 6000 SE |
|---|---|---|---|---|
| Plattformübersicht | ||||
| Architektur | NVIDIA Blackwell | NVIDIA Ada Lovelace | NVIDIA Ada Lovelace | NVIDIA Blackwell |
| CUDA-Kerne | 10,496 | 7,424 | 18,176 | 24,064 |
| RT-Kerne | 82 (4. Generation) | 58 (3. Generation) | 142 (3. Generation) | 188 (4. Generation) |
| GPU-Speicher | 32 GB GDDR7 mit ECC | 24GB GDDR6 | 48 GB GDDR6 mit ECC | 96 GB GDDR7 mit ECC |
| Speicherschnittstelle | 256-bit | 192-bit | 384-bit | 512-bit |
| Speicherbandbreite | 800GB / s | 300GB / s | 864GB / s | 1,597GB / s |
| Leistung (NVIDIA-Spitzenwerte, Tensorraten mit Sparsity) | ||||
| FP32 | 51 TFLOPS | 30.3 TFLOPS | 91.6 TFLOPS | 120 TFLOPS |
| FP16 / BF16 Tensor | 406 TFLOPS | 242 TFLOPS | 733 TFLOPS | 1 PFLOPS |
| FP8 Tensor | 811 TFLOPS | 485 TFLOPS | 1,466 TFLOPS | 2 PFLOPS |
| FP4 Tensor | 1.6 PFLOPS | Nicht unterstützt | Nicht unterstützt | 4 PFLOPS |
| RT-Kernleistung | 154 TFLOPS | Nicht aufgeführt | 209 TFLOPS | 355 TFLOPS |
| Leistung und Formfaktor | ||||
| Maximale Platinenleistung | 165W | 72W | 350W | Bis zu 600 W (konfigurierbar) |
| Formfaktor | Einzelsteckplatz, FHFL 4.4" x 10.5" |
Einzelsteckplatz, HHHL | Doppelsteckplatz, FHFL 4.4" x 10.5" |
Dual-Slot, FHFL (Air) Einzelsteckplatz, FHXL (Flüssigkeit) |
| Thermische | Passive Kunden | Passive Kunden | Passive Kunden | Passiv (Luft) oder Flüssigkeit |
| Stecker | 1x PCIe CEM5 16-polig | Slot-betrieben | 1x 16-Pin | 1x PCIe CEM5 16-polig |
| Interconnect | PCIe 5.0 x16 | PCIe 4.0 x16 | PCIe 4.0 x16 | PCIe 5.0 x16 |
| Gewicht | 1,055 g | Nicht aufgeführt | Nicht aufgeführt | Nicht aufgeführt |
| Eigenschaften | ||||
| GPU mit mehreren Instanzen | Bis zu 2 x 16 GB | Nein | Nein | Bis zu 4 x 24 GB |
| NVENC / NVDEC | 3x / 3x | 2x / 4x | 3x / 3x | 4x / 4x |
| Vertrauliche Datenverarbeitung | Unterstützt | Nein | Nein | Unterstützt |
| vGPU-Unterstützung | Ja (vGPU 20) | Ja | Ja | Ja |
Designen und Bauen
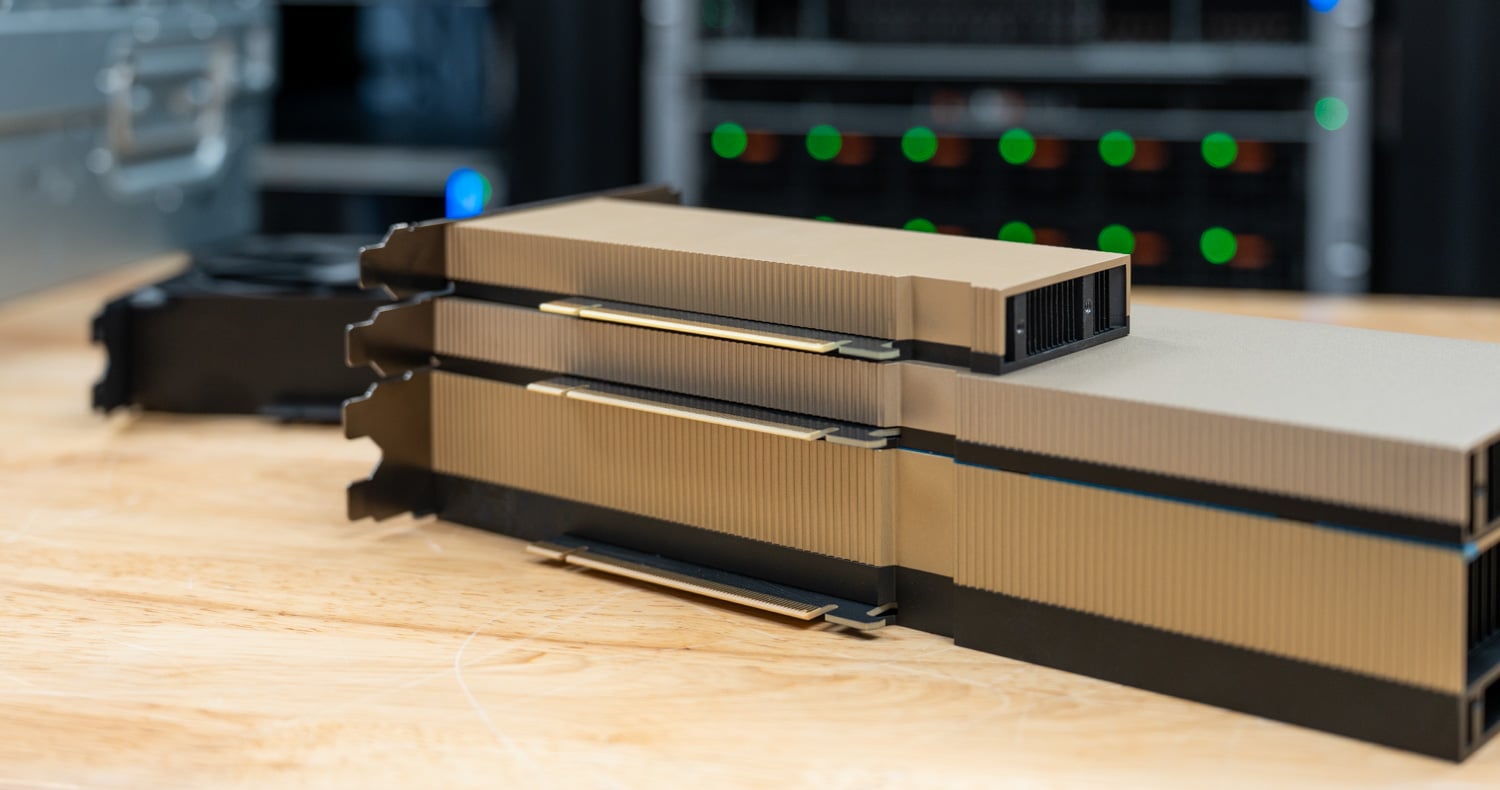
Die 4500 Server Edition ist eine vollwertige Grafikkarte (4.4 Zoll hoch und 10.5 Zoll lang) und belegt einen Steckplatz. Dies ist ein wichtiger Unterschied zur L4, die eine halbhohe und halblange Karte war. Die L4 dient weiterhin als Vergleichsmodell, jedoch wurde der Formfaktor auf FHFL geändert, um Platz für den Arbeitsspeicher, den 16-Pin-Stromanschluss und einen Kühlkörper zu schaffen, der allein durch die Gehäusebelüftung 165 W abführen kann.

Dieses Formfaktor ist der einzige wesentliche Unterschied zum L4, der in jeden HHHL-Steckplatz passte und seine 72 W über diesen Steckplatz bezog, weshalb er in 1U-Servern und kleinen Edge-Gehäusen zum Einsatz kam. Der 4500 hingegen ist in voller Höhe und Länge ausgeführt und benötigt das 16-polige Kabel. Die gängigen 1U-Server, mit denen wir arbeiten – darunter Dells aktuelle 1U-PowerEdge-Serie – unterstützen maximal HHHL- oder FHHL-Karten ohne diesen Anschluss.
In der Praxis handelt es sich dabei um eine 2U-Karte oder um eine Karte für die wenigen Whitebox-1U-Gehäuse, die um FHFL-Steckplätze herum gebaut wurden. Ein Händler, der L4-Karten für 1U- oder Edge-Boxen gekauft hat, erhält also keinen direkten Ersatz.
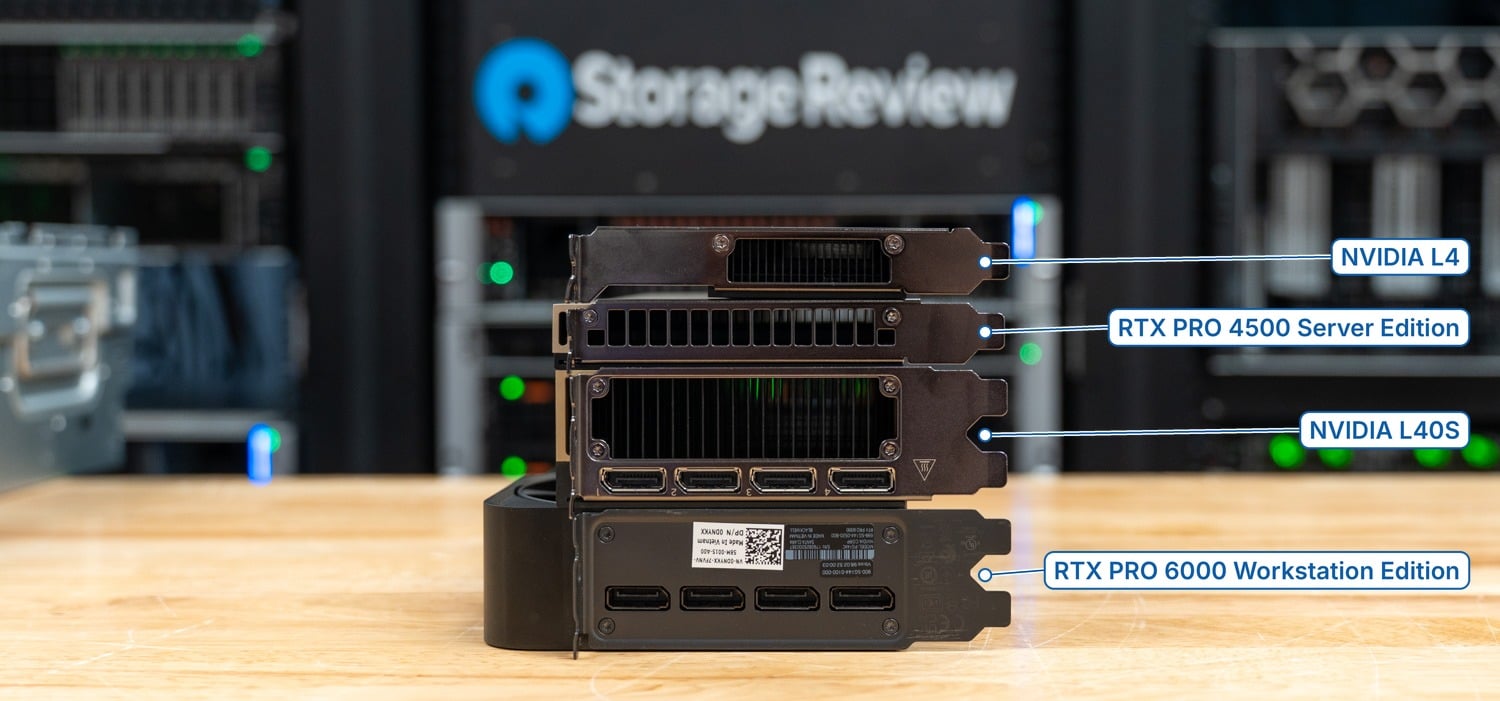
Wenn die 4500 mit der Kante nach oben, die L4 darüber und die L40S darunter gestapelt wird, benötigt sie einen Steckplatz, während die L40S zwei benötigt. Aus diesem Grund kann ein 2U-Server, der vier doppelt breite Karten aufnimmt, acht davon aufnehmen, und aus diesem Grund können die G7-Instanzen von AWS bis zu acht davon pro Host betreiben.
Die Stromversorgung erfolgt über einen einzelnen PCIe CEM5 16-Pin-Anschluss, denselben Anschluss, der auch bei der RTX PRO 6000 verwendet wird. Ein zusätzlicher 8-Pin-Anschluss ist nicht vorhanden. Die Kühlung ist rein passiv, daher ist die Karte auf die Lüfter des Servers angewiesen und drosselt ihre Leistung in Gehäusen, die keine ausreichende Luftzirkulation ermöglichen. Dies ist in dieser Klasse üblich, und alle anderen GPUs haben die gleichen Anforderungen.
Die Karte besitzt keine Display-Ausgänge, daher werden Grafikprozesse, egal ob vGPU-basierte virtuelle Workstations oder Rendering, über das Netzwerk übertragen. Die Halterung ist belüftet. Die drei NVENC- und drei NVDEC-Engines der neunten Generation bieten im Vergleich zur L4-Generation 4:2:2-H.264- und HEVC-Codierung und -Decodierung. NVIDIA gibt die doppelte H.264-Decodierungsleistung pro NVDEC-Engine im Vergleich zur L4 an. Die Abbildung der Halterung unten verdeutlicht den Unterschied: Die L4 und die 4500 verfügen lediglich über Lüftungsschlitze, während die L40S und die RTX PRO 6000 Workstation Edition jeweils vier DisplayPort-Ausgänge besitzen.
Wo die RTX PRO 4500 Blackwell Server Edition passt
NVIDIA beschreibt die Karte als „zentralen Mehrwert durch die Kombination von KI, Rechenleistung, Grafik und Videobeschleunigung in einem passiven 165-Watt-Single-Slot-Design“, das für Server entwickelt wurde, „bei denen Rackdichte, Stromverbrauch und Kühlung die wichtigsten Einsatzbeschränkungen darstellen“. Sie positioniert sich im sogenannten Mainstream-Segment für Rechenzentren und Edge-PCs des RTX PRO-Serverportfolios, unterhalb der RTX PRO 6000 Blackwell Server Edition und darüber hinaus; sie bildet den Einstieg in die Blackwell-Serverlinie.
Im Vergleich zur L4-Architektur erzielt NVIDIA mit seinen Nemotron Nano-Modellen (NVFP4 auf der 4500 gegenüber FP8 auf der L4) eine bis zu 10-fache Steigerung bei der Inferenz kleiner Modelle, mit Cosmos Reason 2 eine bis zu 4-fache Steigerung bei der Videozusammenfassung, mit SPECviewperf 15 in 4K eine bis zu 1.9-fache Steigerung und mit der Streaming-Dichte eine bis zu 1.8-fache Steigerung. Im Vergleich zu CPUs bietet NVIDIA mit cuVS CAGRA in Milvus eine bis zu 50-fache Steigerung bei der Verarbeitung von Vektordatenbanken und mit KI-gestützter Bildverarbeitung eine bis zu 100-fache Steigerung. Diese Werte wurden jeweils auf Servern der 4500-Architektur mit acht Grafikkarten im Vergleich zu Systemen mit zwei EPYC 9654-Prozessoren gemessen.
Das Serverteam von Dell teilte uns mit, dass die 4500er-Karte in gängigen Serverracks eingesetzt wird, da drei 32-GB-Karten der 4500er-Serie etwa so viel kosten wie eine 96-GB-Karte der 6000er-Serie. In diesem Fall ist die größere Karte meist die bessere Wahl. Diese Karte eignet sich für Server ohne dedizierte GPU oder L4-Prozessor und ist für Server, die für eine oder mehrere Grafikkarten der 6000er-Serie ausgelegt sind, nicht optimal.
Test-Setup
Wir installierten die 4500, die L40S und die L4 in unserem Dell PowerEdge R770, der mit zwei Intel Xeon 6787P Prozessoren (je 86 Kerne) und 2 TB DDR5-6400 RAM auf 32 DIMM-Steckplätzen konfiguriert ist. Als Treiber diente der NVIDIA-Treiber 595.71.05. Die Tests wurden mit dem NGC vLLM 26.08-py3 Container durchgeführt, der vLLM 0.27.1 auf CUDA 13.4.1 ausführt. Der Software-Stack ist daher auf allen Karten identisch. Jede Karte wurde einzeln mit ihrer Standard-Leistungsaufnahme getestet, und der R770 liefert jeder Karte ihre volle Nennleistung: Dell gibt für dieses Gehäuse 72 W für die L4, 165 W für die 4500 und 350 W für die L40S an.
Die RTX PRO 6000 Blackwell ist die Workstation-Grafikkarte in unserem Dell Pro Max Tower T2 und verwendet denselben Container und Treiber. NVIDIA gibt für die Workstation- und Server-Editionen identische 600 W an, und auch in unseren Tests weisen sie die gleichen Leistungsprofile auf. Daher dient sie als Stellvertreter für die Server-Karte. Übrigens haben wir auch einen Test der RTX PRO 6000 Server- Karten in einem XE7740, falls Sie sich näher mit der Skalierbarkeit dieser Karten befassen möchten.
Wir haben die 6000 zweimal getestet: einmal mit der standardmäßigen Leistungsaufnahme von 600 W und einmal mit einer verifizierten Leistungsbegrenzung von 450 W, die über nvidia-smi aktiviert wurde. 450 W ist die maximale Leistung, die die R770 an eine 6000 im GPU-Steckplatz liefert. Dieser Wert sollte für Käufer, die sich zwischen einer 4500 und einer 6000 für einen typischen 2U-Server entscheiden, als Vergleichswert dienen. Die Host-Plattform ist bei der 6000 zwar anders, aber bei diesen GPU-lastigen Serverlasten beeinflussen die CPU- und PCIe-Topologie das Ergebnis deutlich weniger als die Leistungsbegrenzung.
Wir verwendeten vLLMs Online-Serving-Benchmark mit Parallelitätsstufen von 1, 2, 4, 8, 16 und 32 und zwei Anfrageformen: 512 Eingabe- und 512 Ausgabetoken, was Chat- und kurzen Agentengesprächen entspricht, und 8,192 Eingabe- und 1,024 Ausgabetoken, was RAG- und Dokumentenverarbeitung mit überwiegender Vorbelegung und KV-Cache-Füllung simuliert. Die Modelle wurden nach Möglichkeit so gewählt, dass sie auf die kleinste Grafikkarte der jeweiligen Gruppe passen. Die 24 GB der L4-Karte bilden die Untergrenze: Ministral 3 3B Reasoning und Ministral 3 8B Reasoning in BF16, Ministral 3 14B Instruct in FP8 und Qwen 3.8-27B in NVFP4. Diese Modelle passen auf 32-GB-Karten und größer, jedoch nicht auf die L4-Karte.
Wir berichten über den Durchsatz der Ausgabetoken auf jeder Parallelitätsstufe und geben den Gesamtdurchsatz einschließlich der vorab gefüllten Token an, wo sich das Bild ändert.
Was hier nicht enthalten ist: größere Modelle, die nur von Karten mit 48 GB und mehr unterstützt werden können, MIG-Partitionierung, vGPU, Videotranskodierung, gemessene Leistung, die Zwei-Karten-Konfiguration 4500 und die Rechenzentrumskarten oberhalb dieser Klasse.
Maximal erreichbare Matmul-FLOPS (MAMF)
MAMF ist ein kontinuierlicher, dichter GEMM-Test, der den besten matmul-Durchsatz einer Karte in jeder Präzisionsstufe ermittelt. Dadurch lässt sich am einfachsten überprüfen, ob die FP4-Hardware funktioniert, sobald der Server-Stack nicht mehr aktiv ist. Die 4500 erreichte 135.9 TFLOPS in BF16, 280.1 in FP8 und 568.6 in NVFP4, wobei jede Reduzierung der Präzision den Durchsatz nahezu verdoppelte. Verglichen mit den von NVIDIA ermittelten Spitzenwerten von 202, 406 und 811 TFLOPS entspricht dies 67 % bis 70 % des jeweiligen Spitzenwerts in jeder Präzisionsstufe und deckt sich mit den von NVIDIA selbst ermittelten cuBLAS-Werten für die Karte von 133, 275 und 534 TFLOPS.
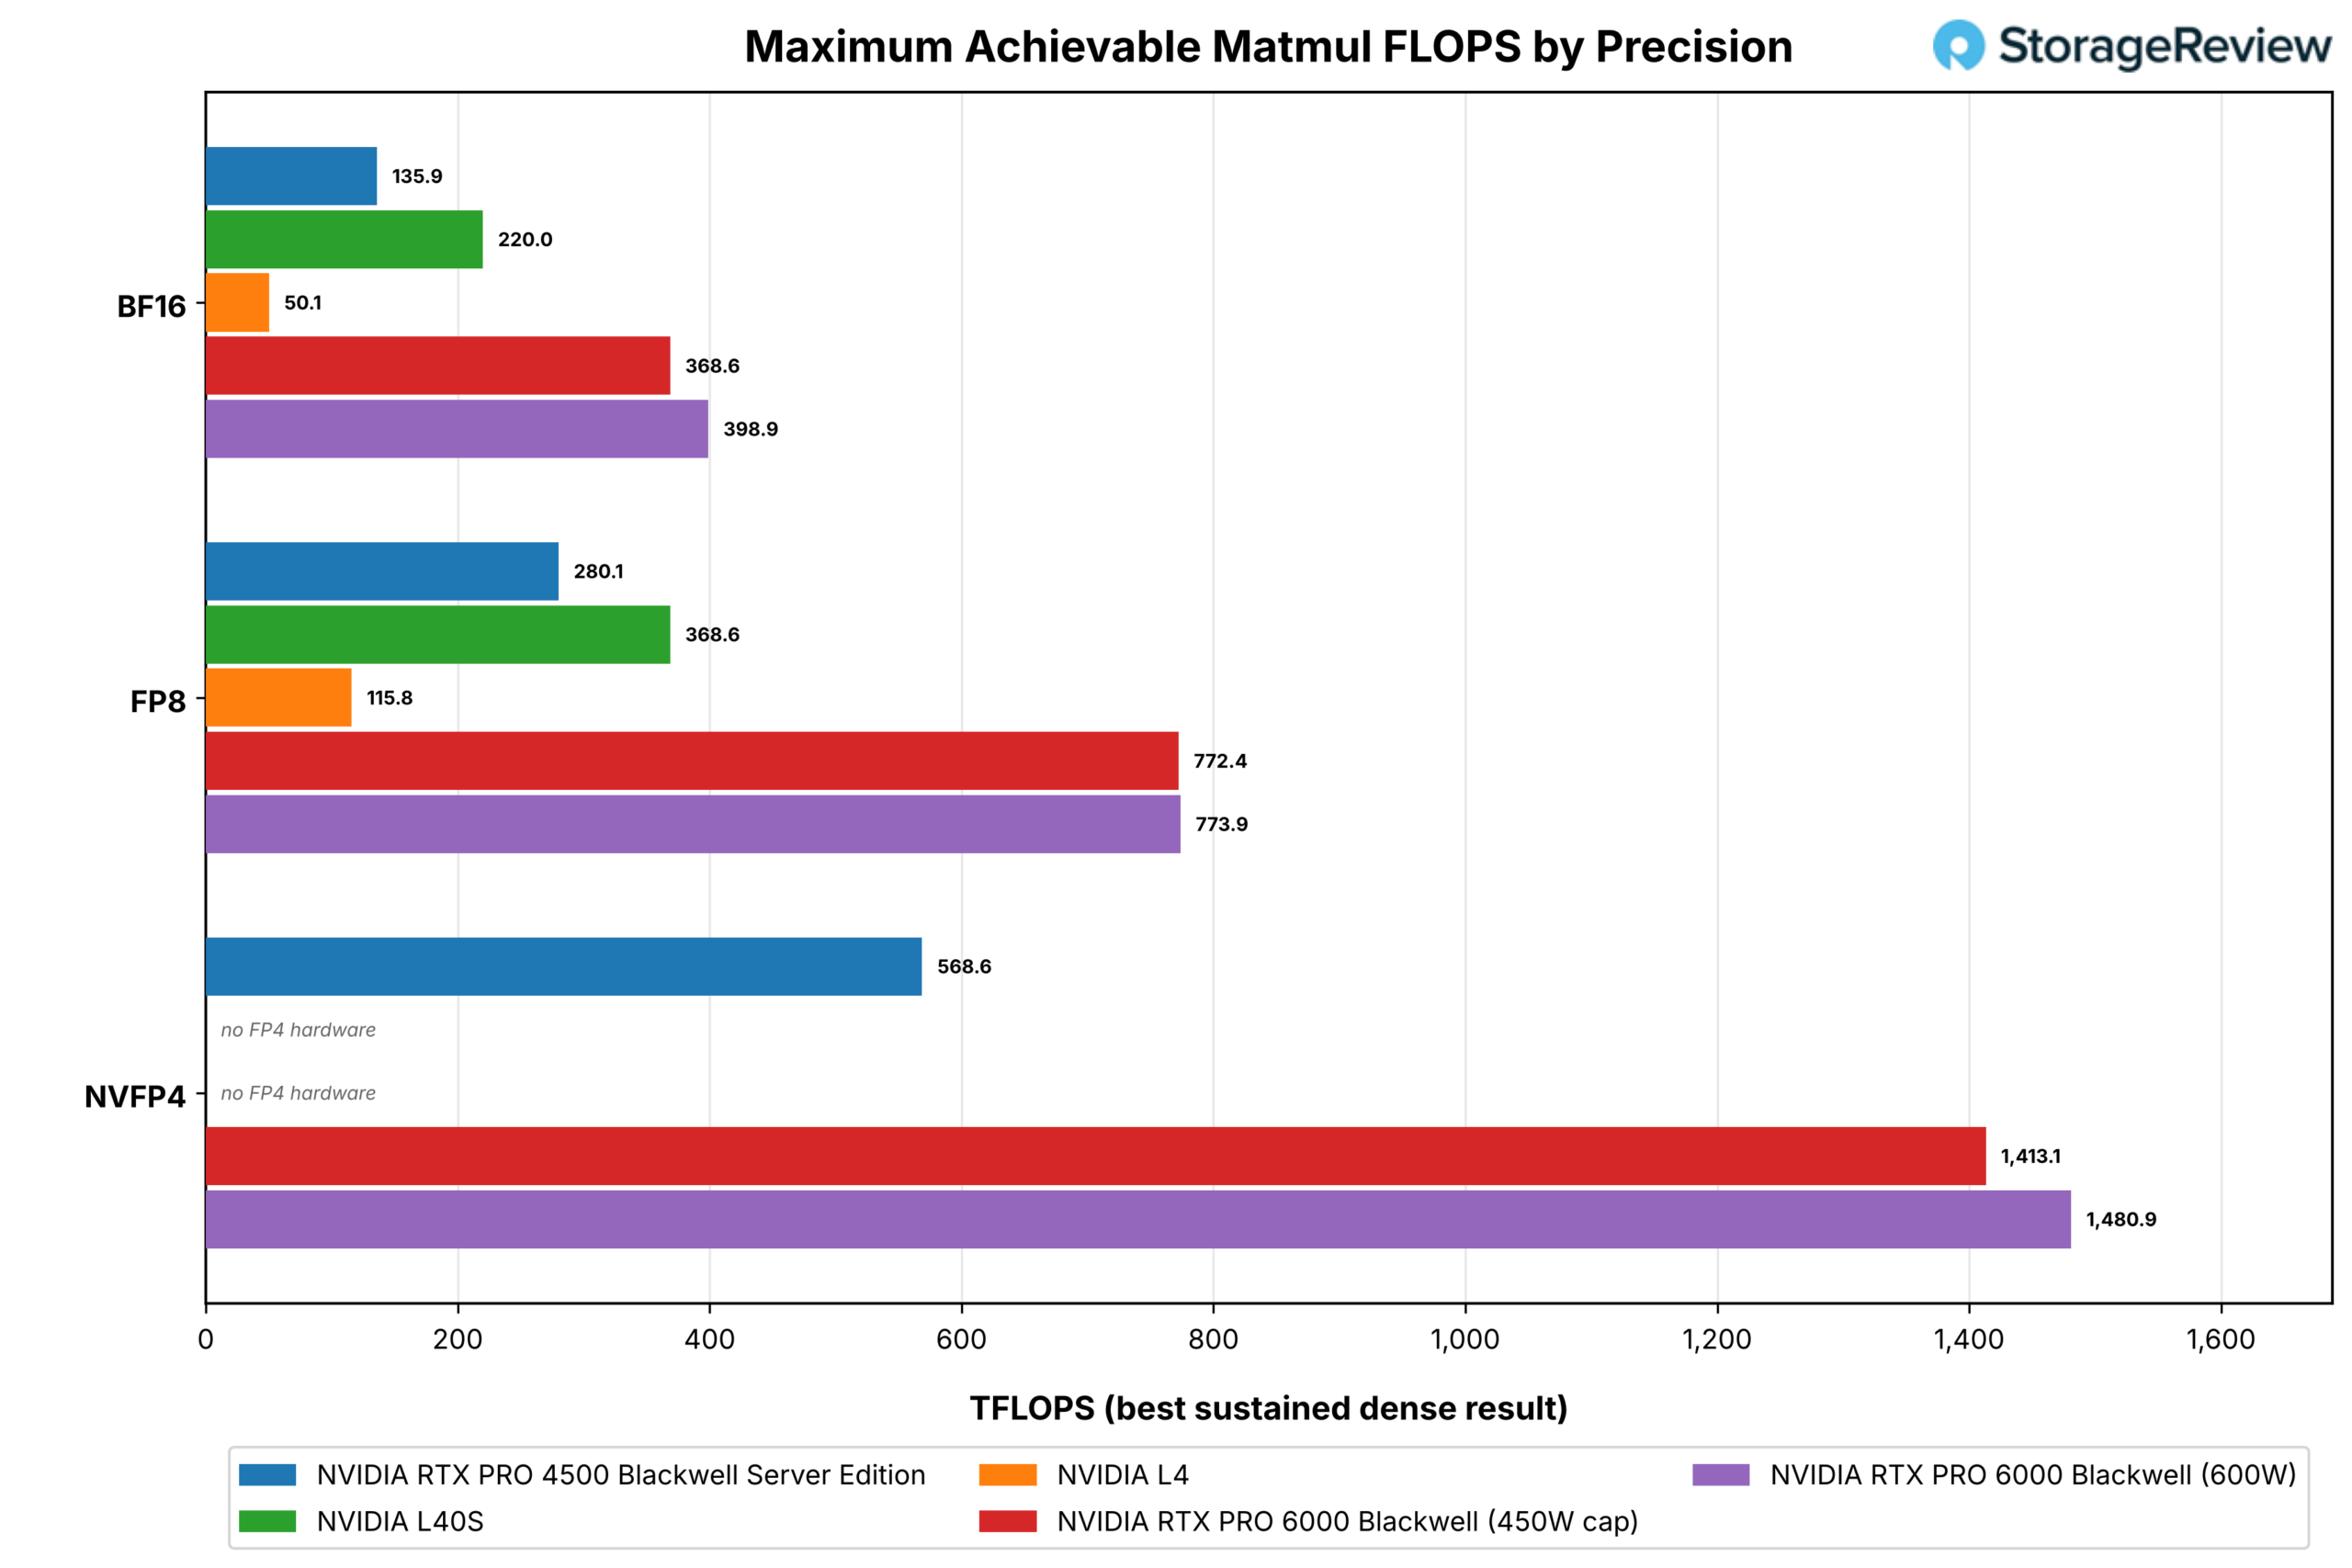
Die RTX PRO 6000 skalierte ähnlich und erreichte bei 600 W 398.9, 773.9 und 1,480.9 TFLOPS, was dem 2.6- bis 2.9-Fachen der 4500 über alle drei Präzisionsstufen hinweg entspricht und somit den Erwartungen aufgrund der Chipgröße und des Leistungsbudgets gerecht wird. Bei der maximalen Leistungsaufnahme von 450 W erreichte sie 368.6, 772.4 und 1,413.1 TFLOPS: FP8 blieb unverändert, BF16 verlor 8 Prozent und NVFP4 5 Prozent. Dies deutet darauf hin, dass der FP8-Tensorpfad der 6000 in diesem Test unter 450 W liegt und die anderen beiden Präzisionsstufen die maximale Leistung nur knapp erreichen. Die L40S erreichte 220.0 und 368.6 TFLOPS in BF16 und FP8, die L4 50.1 und 115.8 TFLOPS. Keine der Ada-Karten verfügt über FP4-Tensor-Hardware.
Ein aussagekräftiger Vergleich ist das NVFP4-Ergebnis der 4500er-Serie im Vergleich zu den FP8-Ergebnissen aller anderen: 568.6 TFLOPS entsprechen dem 1.5-Fachen des FP8-Maximums der L40S und 74 % des maximalen Wertes der 6000er-Serie – und das mit einer 165-W-Karte. Das ist der FP4-Vorteil, der bereits auf GEMM-Ebene erkennbar ist. Die nachfolgenden vLLM-Serving-Ergebnisse zeigen, dass die Serving-Stack-Ebene in dieser Version noch nicht erreicht ist, und das MAMF-Ergebnis deutet darauf hin, dass die Serving-Zahlen weiter steigen werden, sobald die NVFP4-Kernel aufholen.
vLLM Online-Bereitstellung: Kurzer Kontext (512/512)
Der kurze Kontext zeigt, wo der 4500 seine Stärken ausspielt: Auf den drei FP8- und BF16-Modellen erreichte er bei 32 Parallelverarbeitungsstufen einen Durchsatz von 1,107 Token/s auf Ministral 3 14B gegenüber 995 Token/s auf dem L40S, 1,017 Token/s gegenüber 1,005 auf Ministral 3 8B und 2,006 Token/s gegenüber 1,988 auf Ministral 3 3B. Jede dieser Karten entspricht einer Blackwell-Karte mit 165 W, die mit einer Ada-Karte mit 350 W mithalten kann oder diese sogar übertrifft. Die Kurven verlaufen von 1 bis 32 Parallelverarbeitungsstufen deckungsgleich, es handelt sich also nicht nur um einen Spitzenwert. Der L4 erreichte auf denselben Modellen Werte von 364, 279 und 704 Token/s, womit der 4500 das 2.8- bis 3.6-Fache seines Vorgängers erreicht.

Die RTX PRO 6000 zeigt, was die übrigen Blackwell-Grafikkarten leisten. Mit einer maximalen Leistungsaufnahme von 450 W erreichte sie auf denselben drei Modellen 2,161, 2,042 und 4,069 Token/s, was dem 1.95- bis 2.03-Fachen der 4500 entspricht. Bei voller Leistungsaufnahme von 600 W erzielte sie 2,283, 2,139 und 4,155 Token/s, also das 2.06- bis 2.1-Fache. Die beiden Leistungskurven der 6000er-Serie liegen bei 16 parallelen Prozessoren auf jedem Modell deckungsgleich übereinander und unterscheiden sich bei 32 parallelen Prozessoren nur um 2 bis 5 Prozent. Daher trägt die zusätzliche Leistung von 150 W im Kurzzeitkontext kaum etwas bei. Im Vergleich zur 4500 bietet sie jedoch den doppelten Durchsatz einer Karte mit dreimal so viel Speicher und, im Fall der R770, der 2.7-fachen Steckplatzleistung.

Der Gesamtdurchsatz, der auch die 512 Prefill-Token pro Anfrage berücksichtigt, ergibt dieselbe Reihenfolge: 2,215 Token/s für das 4500er-Modell (14B) gegenüber 1,990 Token/s für das L40S-Modell und 727 Token/s für das L4-Modell. Das 6000er-Modell erreicht maximal 4,323 Token/s und 4,566 Token/s bei 600 W. Der Unterschied zum L4-Modell ist beim 8B-Modell mit 3.6-facher Durchsatzleistung am größten und beim 3B-Modell mit 2.8-facher am geringsten. Der Unterschied zum L40S beträgt nie mehr als 12 Prozent zugunsten des 4500er-Modells.

vLLM Online-Bereitstellung: Langer Kontext (8K/1K)
Bei 8,192 Eingabetoken ändert sich das Bild, und der Grund dafür wird im Kurvenverlauf deutlich. Auf Ministral 3 14B FP8 folgt die 4500 der L40S bis zu einer Parallelität von 8, flacht dann bei etwa 180 Token/s ab, während die L40S bis zu einer Parallelität von 16 weiter auf 230 Token/s ansteigt und dort bleibt. Das 8B-Modell verhält sich analog: 185 Token/s für die 4500 bei 32 Parallelitäten gegenüber 277 Token/s für die L40S, wobei die 4500 bei 8 und die L40S bei 16 ein Plateau erreicht. Auf dem 3B-Modell erreichen beide Karten ein Plateau bei 16 Parallelitäten, 384 Token/s gegenüber 475 Token/s.

Der Grund liegt in der KV-Cache-Kapazität: Jede gleichzeitige 8K-Anfrage benötigt ihren Kontext auf der Karte, und sobald die Gewichte geladen sind, kann ein 32-GB-Framebuffer weniger davon speichern als ein 48-GB-Framebuffer. Wenn vLLM nicht mehr genügend KV-Speicherplatz hat, wird keine zusätzliche Parallelität mehr erzeugt, und der Durchsatz stagniert. Allein aus diesem Grund verliert die 4500 bei 32 Parallelitätsanfragen auf diesen Modellen 17 bis 33 Prozent an Leistung gegenüber der L40S; die Rechenleistung ist nicht der Flaschenhals, wie die Ergebnisse mit kurzem Kontext zeigen. Die L4 mit 24 GB und 300 GB/s bleibt ab 4 Parallelitätsanfragen auf allen Modellen konstant und erreicht 34 bis 130 Token/s.

Die 96 GB des 6000er-Modells reichen in diesem Test nie aus, und die Leistungskurven steigen bei jedem Modell bis auf 32. Bei einer Leistungsaufnahme von 450 W erreichte es 552, 589 und 973 Token/s, das 2.5- bis 3.2-Fache des 4500er-Modells; bei 600 W waren es 608, 639 und 1,033 Token/s, also das 2.7- bis 3.5-Fache. Hier macht sich die Leistungsaufnahme bemerkbar: Durch das Vorbelegen des Speichers für lange Kontexte bleibt der 6000er länger rechenintensiv, sodass die Karte mit der Leistungsaufnahmebegrenzung bei 16 und 32 gleichzeitigen Prozessen 4 bis 9 Prozent weniger Leistung hat als bei kurzen Kontexten. In beiden Fällen vergrößert sich das Verhältnis zum 4500er-Modell von 2 auf etwa 3, wobei der Speicher und nicht die Leistungsaufnahme der Hauptgrund dafür ist.

Bei Dokumenten-Fragen und -Antworten, RAG-Systemen in langen Kontexten oder Agenten mit großen Tool-Ausgaben ist der Arbeitsspeicher das wichtigste Kriterium, und die 32 GB des 4500er-Modells stellen eine Beschränkung für die gleichzeitige Nutzung dar. Bei Chat, Klassifizierung oder kurzen Agentenrunden ist dies nicht der Fall. Der Gesamtdurchsatz bei 8K/1K wird maßgeblich durch die Vorbefüllung bestimmt und zeigt die gleiche Reihenfolge: 1,713 Token/s beim 4500er-Modell (14B) gegenüber 2,070 beim L40S und 381 beim L4, wobei der 6000er-Prozess bei 4,971 Token/s (maximal) bzw. 5,474 Token/s (600W) liegt.
NVFP4: Wo die Software die Grenzen setzt
Die Qwen3.8-27B in NVFP4 ist das einzige Modell der Gruppe, das die von Blackwell eingeführte FP4-Tensor-Hardware nutzt, was zu den flachsten Leistungskurven im Test führt. Bei 32 gleichzeitigen Verarbeitungsschritten im Kurzzeittest erreichte die 4500 320 Ausgabetoken/s; die L40S, 480 und RTX PRO 6000 erzielten 621 Token/s (maximal) bzw. 616 Token/s bei 600 W. Bei 1 gleichzeitigen Verarbeitungsschritt lagen alle Karten mit einem 27B-Modell zwischen 17 und 22 Token/s, einschließlich der 6000 mit 1.6 TB/s GDDR7, wo dieselbe Karte mit dem 14B-FP8-Modell 99 Token/s im Single-Stream-Test liefert.

Da die L40S keine FP4-Tensor-Hardware besitzt, führt vLLM einen NVFP4-Checkpoint durch, indem es die Gewichte dequantisiert und mit höherer Präzision rechnet – ein speicher- und bandbreitenbeschränkter Pfad. Dadurch übertrifft sie die 4500 um das 1.5-Fache. Die 6000, die dieselbe FP4-Hardware wie die 4500 besitzt und die doppelte Bandbreite aufweist, erreicht ebenfalls eine etwa doppelt so hohe Leistung wie die 4500, die den Unterschied zwischen den beiden Karten in allen anderen Bereichen ausmacht. Ihre Leistungsaufnahme bei 450 W und 600 W liegt bei jeder Parallelität innerhalb von 1 Prozent beieinander, sodass auch der Kernel nicht leistungslimitiert ist.
Das Muster über alle vier Serien hinweg, mit einem Durchsatz im Einzelstream, der sich nicht mit der Speicherbandbreite ändert, und einer Concurrency-32-Obergrenze von 480 bis 621 unabhängig von der zugrunde liegenden GPU, deutet darauf hin, dass der NVFP4-Kernelpfad in diesem vLLM-Build die Grenze für jede Karte darstellt.

Bei 8K/1K erreichte die 4500 bei 32 gleichzeitigen Zugriffen 153 Token/s, verglichen mit 190 Token/s bei der L40S und 402 bzw. 425 Token/s bei der 6000 (mit und ohne Limit). Dies entspricht den durch den KV-Cache begrenzten Werten der FP8- und BF16-Modelle. Die 96 GB des 6000 sind erneut der Grund für dessen stetig steigende Werte, während die der anderen stagnieren.
NVIDIA erreicht auf dieser Karte FP4-Werte von 1,221 Token/s auf Llama 3.1 8B bei 2K/256 und 905 Token/s auf Nemotron 3 Nano 30B A3B unter TensorRT-LLM. Die Hardware liefert also unter NVIDIAs Stack die erwartete Leistung. Die aktuellen Daten zeigen, dass NVFP4 auf dieser Karte ein Softwareproblem von vLLM ist, das bei allen von uns getesteten GPUs auftritt. Käufer, die auf hohen FP4-Durchsatz angewiesen sind, sollten daher ihren Server-Stack vorab testen.
Durchsatz pro Nennwatt
In dieser Runde wurde die Leistungsaufnahme nicht gemessen, daher beziehen sich die Effizienzberechnungen diesmal auf die getestete Leistungsgrenze jeder Karte. Auf Ministral 3 14B FP8 mit 32 gleichzeitigen Prozessen liefert die 4500 6.7 Ausgabetoken/s pro Nennwatt, im Vergleich zu 2.8 für die L40S, 5.1 für die L4, 4.8 für die RTX PRO 6000 bei ihrer Leistungsgrenze von 450 W und 3.8 für die 6000 bei 600 W. Beim 3B-Modell bleibt das Verhältnis gleich: 12.2 für die 4500, 5.7 für die L40S, 9.8 für die L4, 9.0 für die leistungsbegrenzte 6000 und 6.9 für die 6000 bei 600 W.
Die 4500 ist in dieser Hinsicht im Kurzzeitkontext die effizienteste Karte der Gruppe, und nur die gedrosselte 6000 kommt annähernd an sie heran. Durch die Reduzierung der Leistungsaufnahme der 6000 auf 450 W sinkt der Durchsatz um 2 bis 5 Prozent, gleichzeitig werden 25 Prozent des Leistungsbudgets wieder genutzt, wodurch sich ihre Effizienz um ein Viertel erhöht. Die L4 bleibt in dieser Hinsicht konkurrenzfähig, da 72 W ein sehr kleiner Nenner sind. Allerdings benötigt sie dreimal so viele Steckplätze und Server, um den gleichen Durchsatz zu erreichen – genau das Problem, das die 4500 lösen sollte.
Bei 8K/1K ändert sich die Reihenfolge: Die 4500 erreicht 1.2 Token/s pro Nennwatt auf dem 14B-Modell, die gedeckelte 6000 ebenfalls 1.2 und die 600-Watt-Version der 6000 1.0, während die L40S bei 0.7 liegt. Sobald der KV-Cache der 4500 erschöpft ist, stagniert ihr Durchsatz, während ihre Leistungsaufnahme gleich bleibt. Daher erreicht die 6000 mit 450 Watt bei längeren Kontextzeiten die gleiche Effizienz und liefert die 2.9-fache Leistung pro Slot.
Fazit
Die RTX PRO 4500 Blackwell Server Edition hält, was NVIDIA verspricht: Sie integriert Blackwell in einen Steckplatz, ein Leistungsbudget und eine Gehäuseklasse, die bisher maximal L4-Standard boten. Auf den Modellen, die in den meisten gängigen Servern, kleinen und mittelgroßen Servern sowie in anspruchsvollen Umgebungen zum Einsatz kommen, erreicht sie die Leistung einer L40S-Grafikkarte mit nur einem Steckplatz und einer Nennleistung von weniger als der Hälfte der L40S-Leistung – und das Dreifache der Leistung einer L4-Grafikkarte.
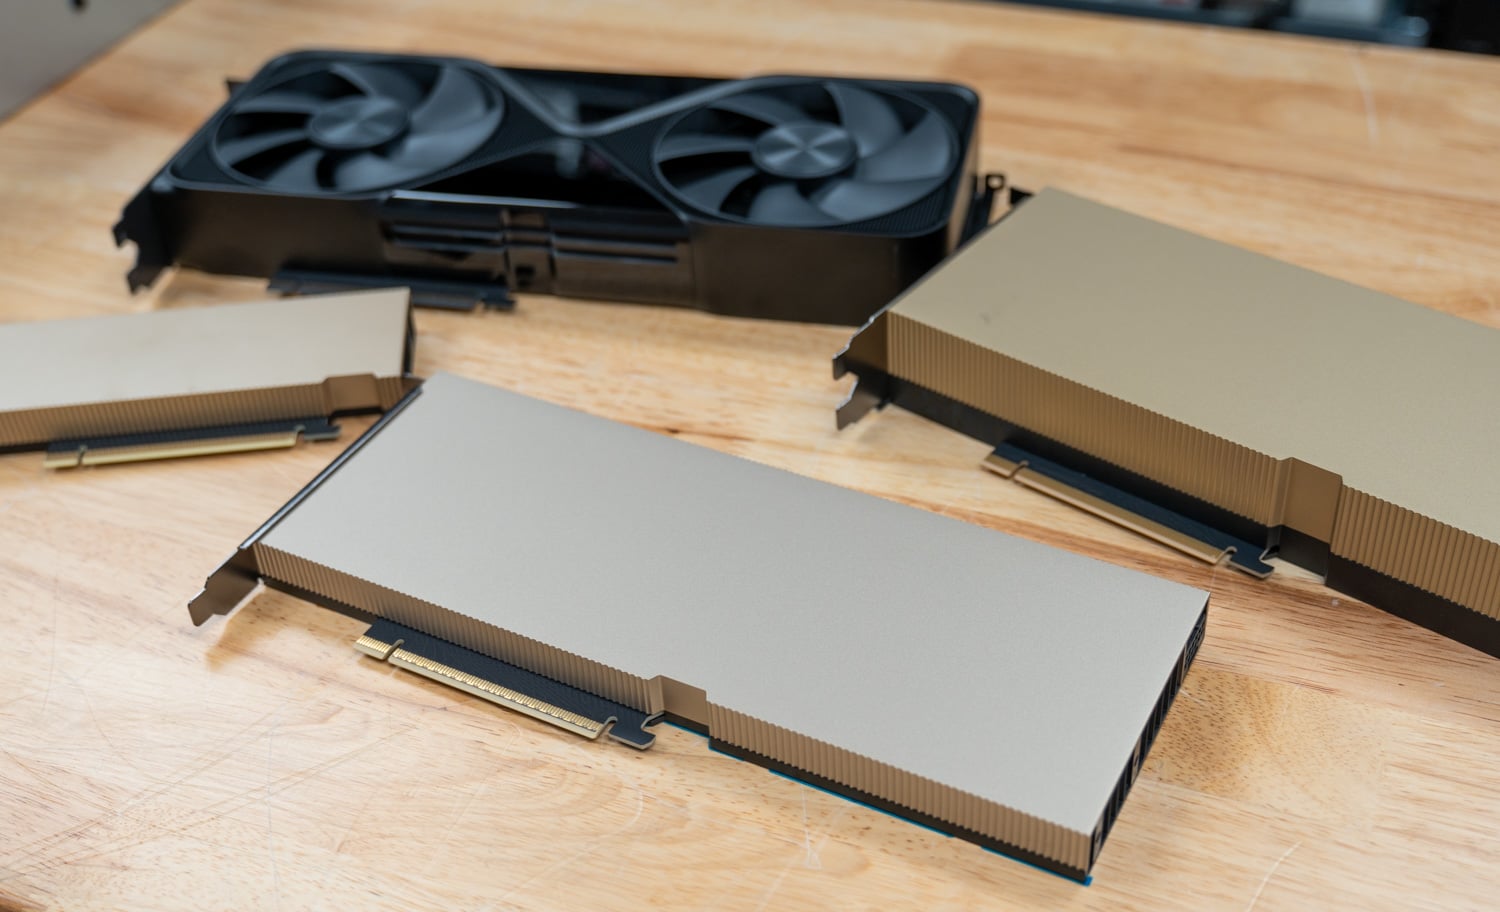
Natürlich gibt es Grenzen. Angefangen beim Speicher: 32 GB sind zwar für die von dieser Karte anvisierten Modelle ausreichend, begrenzen aber die gleichzeitige Verarbeitung bei längeren Kontexten. Hier spielen die 48 GB der L40S und insbesondere die 96 GB der 6000 eine deutlich größere Rolle. Die 6000 erreicht bei gleicher Anfragestruktur etwa die dreifache Leistung der 4500, selbst wenn die Leistungsaufnahme auf die des gleichen Servers beschränkt ist.
NVFP4, das Aushängeschild von Blackwell Precision, liefert in diesem vLLM-Build eine Leistung, die mit Karten ohne FP4-Hardware vergleichbar ist, obwohl der MAMF-Sweep zeigt, dass die FP4-Hardware auf GEMM-Ebene die doppelte FP8-Rate der Karte erreicht. Der Vorteil von FP4 muss also auf dem eigenen Stack überprüft werden, aber es gibt eindeutig noch mehr Potenzial durch Software.
Für alle, die 2U-Server oder ein 1U-Gehäuse mit FHFL-Kartensteckplatz nutzen und Inferenz, KI-gestützte Bildverarbeitung, Transkodierung oder virtuelle Workstationskapazität benötigen, ohne die Stromversorgung oder Kühlung zu verändern, ist die RTX PRO 4500 eine hervorragende Lösung. Auch für alle, die noch L4-Server betreiben und mit 24 GB RAM nicht mehr auskommen, dürfte die 4500 eine attraktive Option sein. Für Unternehmen, deren Workloads so umfangreich oder mandantenfähig sind, dass sie 48 GB oder mehr pro Karte benötigen, ist die RTX PRO 6000 die bessere Wahl.
NVIDIA hat mit der Zuweisung zweier klar definierter Swimlanes für diese Karten gute Arbeit geleistet, und die 4500 schließt die Lücke im Bereich Edge-KI zwischen der L4 und der 6000 bei einer Leistungsaufnahme von nur 165 W.
Bestenliste: Die RTX PRO 4500 Blackwell Server Edition belegt den ersten Platz in unserer Bestenliste der Enterprise-GPUs als beste Single-Slot-GPU . Dort sind auch die Daten der L40S und der RTX PRO 6000 aus diesem Test aufgeführt.



 Amazon