

Cerebras Systems ha presentado oficialmente el CS-4 , la cuarta generación de su plataforma de supercomputación de IA a escala de oblea, diseñada para el entrenamiento de vanguardia y cargas de trabajo de inferencia de alta concurrencia. El sistema está diseñado en torno a tres procesadores WSE-3 Turbo (Wafer Scale Engine 3) de nuevo desarrollo, alojados en una plataforma Nexus de escala de rack completamente rediseñada. Cerebras afirma que el sistema ofrece hasta 30 veces el rendimiento de inferencia de las soluciones basadas en GPU, una cifra que la compañía basa en GPT-OSS-120B , donde cita más de 4,400 tokens por segundo por usuario, junto con un aumento de 10 veces en el rendimiento por vatio en comparación con la generación anterior, el CS-3.
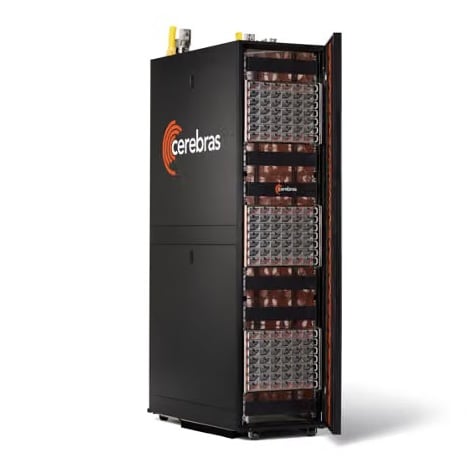
El CS-4 está diseñado para abordar las limitaciones de escalabilidad sistémicas inherentes a los clústeres de GPU multinodo discretos, donde la comunicación entre chips, las pérdidas por conversión de energía y los límites térmicos suelen reducir la eficiencia de cómputo sostenida. Cerebras posiciona la plataforma para cubrir ambos extremos del espectro de cargas de trabajo de inferencia, ofreciendo los tiempos de respuesta inferiores al milisegundo necesarios para flujos de trabajo complejos y razonamiento interactivo, al tiempo que proporciona la capacidad agregada que los proveedores de servicios en la nube a gran escala necesitan para maximizar la densidad de cómputo por gigavatio.
Las mejoras en la interconexión son fundamentales para las capacidades de escalado multiprocesador de la plataforma. El CS-4 reduce la latencia de interconexión entre obleas a tan solo 2 microsegundos, lo que permite que las interconexiones entre obleas operen con una cohesión casi monolítica. Esta interconexión de latencia ultrabaja permite que el CS-4 mantenga velocidades de generación superiores a 1,000 tokens por segundo en modelos con más de 10 billones de parámetros, lo que elimina la brecha de rendimiento histórica en la que el aumento del número de parámetros comprometía gravemente las tasas de entrega de tokens interactivos.

Arquitectura de rack Nexus y mochila a escala de oblea
Una importante transición de ingeniería en el CS-4 es la arquitectura de plataforma Cerebras Nexus, una implementación de rack modular basada en dominios independientes de computación, alimentación y E/S. La densidad de computación se basa en una nueva mochila a escala de oblea, montada en la parte posterior, que se conecta verticalmente a la matriz de alimentación principal. Cada mochila es una unidad autónoma que alberga colectores de refrigeración líquida directos al chip, etapas de conversión de energía en el punto de carga, rutas de red de alta velocidad y electrónica de control integrada, ubicada directamente detrás de la oblea de silicio. Al aislar la capa de computación central del bastidor de distribución de energía, Cerebras redujo el número de componentes del sistema en un 50 %, aumentó el ensamblaje automatizado en un 60 % y redujo los tiempos de implementación del centro de datos a tan solo unas horas.

La eficiencia de suministro de energía se ha mejorado al reubicar los módulos de regulación de voltaje CC-CC 100 veces más cerca del límite del silicio que en las implementaciones típicas de placas de servidor. Esta disposición en el punto de carga reduce las pérdidas resistivas de la red de distribución de energía (PDN) y permite que el chasis Nexus suministre el doble de energía a cada procesador WSE-3 Turbo, lo que posibilita frecuencias de reloj sostenidas más altas sin limitación térmica.

El subsistema de E/S también se ha ampliado con un módulo de E/S de oblea programable que duplica el ancho de banda de la estructura de extremo a extremo, a la vez que reduce la latencia de tránsito. La red del sistema funciona en dos modos: interfaces RoCE v2 estándar (RDMA sobre Ethernet convergente) para la conexión de baja latencia a redes empresariales heredadas y nodos aceleradores de terceros, y enlaces de oblea directos propietarios que proporcionan rutas de interconexión directas y sin conmutadores entre sistemas adyacentes dentro y entre racks.
Especificaciones de los turbocompresores CS-4 y WSE-3
| SISTEMA CS-4 | |
| Arquitectura de interiores | Rack de potencia activo con tres mochilas de computación modulares |
| Motores a escala de oblea | 3 turbos WSE-3 por sistema |
| Computación IA | 750 PFLOPS* |
| ancho de banda de memoria | 129.6 PB/s |
| Ancho de banda de la estructura en el chip | 160.5 PB/s |
| Ancho de banda de E/S | 7.2 Tbit / s |
| Latencia de E/S | 2 microsegundos |
| WSE-3 TURBO (POR OBLEA) | |
| Transistores / Silicio | 4 billones de transistores; 46,225 mm2, TSMC 5 nm |
| Núcleos de IA / Memoria SRAM integrada | 900,000 núcleos; 44 GB de SRAM |
| Computación IA | 250 PFLOPS* |
| ancho de banda de memoria | 43.2 PB/s |
| Ancho de banda de la estructura en el chip | 53.5 PB/s |
| Ancho de banda de E/S | 2.4 Tbit / s |
| *El cálculo de IA se muestra como FP16 disperso | |
Inferencia y disponibilidad desagregadas
Desde el punto de vista arquitectónico, el CS-4 está diseñado con soporte nativo para topologías de inferencia desagregadas. En entornos empresariales y en la nube, los operadores pueden separar las fases computacionales de la inferencia mediante aceleradores de precarga externos especializados, como AMD Helios o AWS Trainium, para ingerir contextos de solicitud y construir estados del modelo. La caché KV, que requiere capacidad de cómputo, se enruta a través de enlaces de alta velocidad a la enorme memoria SRAM del CS-4 para la generación de tokens autorregresivos de latencia ultrabaja.
Cerebras confirmó que los primeros despliegues de producción y envíos de la plataforma CS-4 comenzarán este trimestre.


 Amazon