

La MSI XpertStation WS300 se basa en la arquitectura DGX Station más reciente de NVIDIA, la generación más potente hasta la fecha, que coloca un nodo completo GB300 Grace Blackwell Ultra junto a su escritorio. La cifra principal es de 20 petaFLOPS de computación FP4, proporcionados por una única GPU Blackwell Ultra conectada a una CPU Grace de 72 núcleos a través de un enlace NVLink-C2C de 900 GB/s. Ambos procesadores se abastecen de un grupo de memoria coherente de 748 GB; 252 GB de HBM3e junto con 496 GB de LPDDR5X, suficiente para mantener un modelo de un billón de parámetros residente en la memoria local.
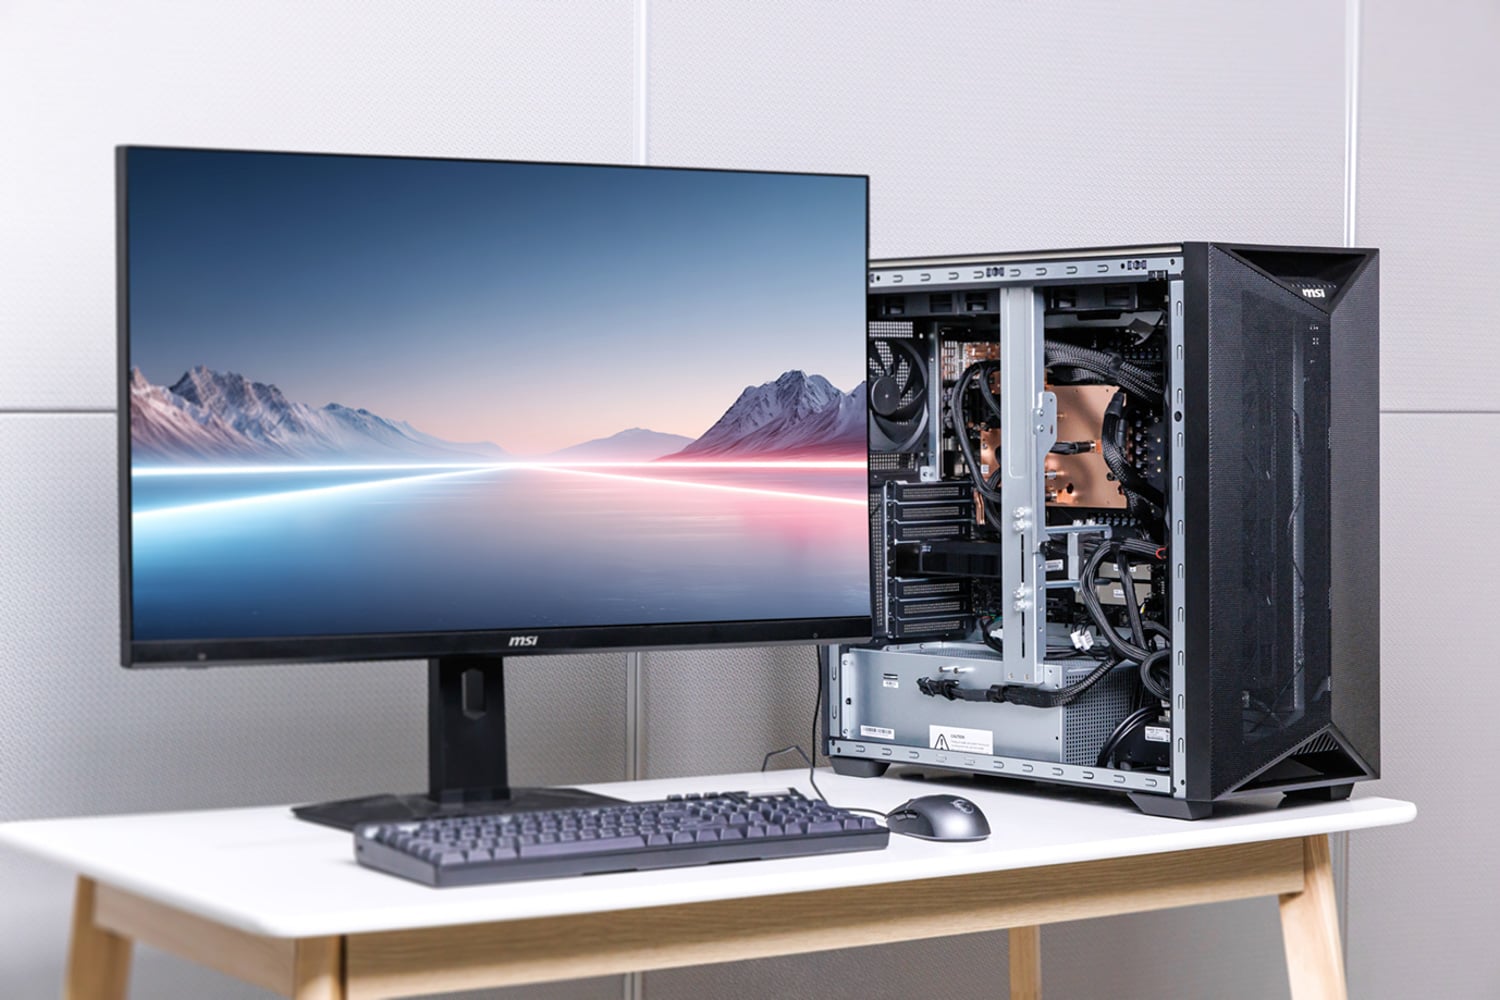
La estación DGX también admite la agrupación de varias unidades mediante su tarjeta de red ConnectX-8 SuperNIC, que ofrece dos puertos 400GbE para una comunicación de 800 Gb/s. El resultado es un equipo de clase centro de datos que puede funcionar en un hogar u oficina en lugar de en una sala de servidores.
Especificaciones técnicas de NVIDIA DGX Station
La XpertStation WS300 es la implementación de MSI de la plataforma GB300 DGX Station de NVIDIA. NVIDIA proporciona la placa base Grace Blackwell Ultra y el entorno de software, mientras que MSI proporciona el chasis, la refrigeración líquida, la alimentación, la configuración de almacenamiento, las E/S externas y el modelo de servicio que convierten la plataforma en un sistema completo para escritorio. Dado que la CPU Grace, la GPU Blackwell Ultra, la interconexión NVLink-C2C y la red ConnectX-8 son fijas, la verdadera diferenciación del fabricante de equipos originales (OEM) radica en la eficacia con la que el sistema circundante soporta, gestiona y expone dicho hardware. MSI configuró este sistema con cuatro SSD Micron 4600 Gen5 M.2 de 2 TB para las pruebas. Dos SSD se configuraron en RAID1 para el almacenamiento de arranque, mientras que los otros dos eran SSD independientes para espacio de trabajo o para otros usos.
| Especificación | Detalles |
|---|---|
| Arquitectura de interiores | |
| CPU | NVIDIA Grace, Arm Neoverse V2 de 72 núcleos |
| GPU | NVIDIA Blackwell Ultra (B300) |
| Núcleos tensoriales | 5th Generación |
| Interconexión CPU-GPU | NVLink-C2C, bidireccional de 900 GB/s |
| Salud Cerebral | |
| Memoria coherente | Hasta 748 GB |
| Memoria de la GPU | Hasta 252 GB HBM3e |
| Ancho de banda de memoria GPU | 7.1 TB / s |
| Memoria de la CPU | Hasta 496 GB LPDDR5X (4 x SOCAMM) |
| Ancho de banda de la memoria de la CPU | 396 GB / s |
| Almacenaje | |
| Unidades de arranque | 2 x M.2 2280 PCIe 5.0 x4 NVMe (conectado a la CPU), con 2 x 2TB Micron 4600 Gen5 en RAID 1 |
| Unidades de expansión | 2 x M.2 2280 PCIe 5.0 x4 NVMe (conectado a ConnectX-8), instalado para pruebas con 2 x 2TB Micron 4600 Gen5 |
| Networking | |
| NIC | NVIDIA ConnectX-8 SuperNIC, 2 x 400G QSFP112 (800 Gb/s agregados) |
| Ethernet | 1 conector RJ45 10GBase-T (Marvell AQC113) |
| Puerto de administración | 1 x RJ45 1000Base-T (dedicado fuera de banda) |
| Conectividad | Ranura M.2 2230 Key-E, PCIe 2.0 x1 (Wi-Fi 6E / Wi-Fi 7, Bluetooth) |
| Expansión | |
| Ranuras PCIe | 1 x PCIe 5.0 x16 FHFL de doble ancho; 2 x PCIe 5.0 x16 FHFL de ancho simple (señales x8) |
| GPU adicionales compatibles | NVIDIA RTX PRO 2000 Blackwell, RTX PRO 4000 Blackwell SFF, RTX PRO 6000 Blackwell Workstation / Max-Q |
| Entradas y salidas frontales/superiores | |
| USB | 2 puertos USB 3.2 Gen 2 Tipo A; 2 puertos USB 3.2 Gen 2 Tipo C (5V/3A) |
| Audio | 2 conectores jack (salida de línea/micrófono) |
| E / S trasera | |
| USB | 4 puertos USB de 10 Gbps tipo A; 1 puerto Micro-USB COM (consola serie) |
| Mostrar | 1 x Mini DisplayPort (vídeo BMC, máx. 1024 x 768, sin DP++) |
| Audio | 3 conectores jack (entrada de línea / salida de línea / micrófono) |
| Gestión y seguridad | |
| BMC | ASPEED AST2600 con firmware AMI MegaRAC, IPMI 2.0 y Redfish, almacenamiento local eMMC |
| Seguridad | TPM 2.0, intrusión en el chasis, raíz de confianza de hardware Microchip CEC1736 (ERoT) |
| Enfriamiento | |
| Refrigeración líquida | Módulo de refrigeración líquida con capacidad para 1400 W de CPU + GPU, con bloques en GPU, CPU, memoria y ConnectX-8. |
| Radiadores / Ventiladores | 2 radiadores de 360 mm; 1 ventilador del sistema 12025 |
| Potencia | |
| Alimentación eléctrica | 1 fuente de alimentación ATX de 1600 W, 80 PLUS Platinum (150 x 86 x 210 mm) |
| Entrada de CA | 100-114 V CA, 15 A, 47-63 Hz (potencia máxima de salida: 1300 W); 115-240 V CA, 15-8 A, 47-63 Hz (potencia máxima de salida: 1600 W) |
| Factor de forma | |
| Dimensiones | 245.7 x 529.0 x 570.4 mm (9.67 x 20.83 x 22.46 pulgadas), Ancho x Alto x Profundidad |
Diseño y construcción
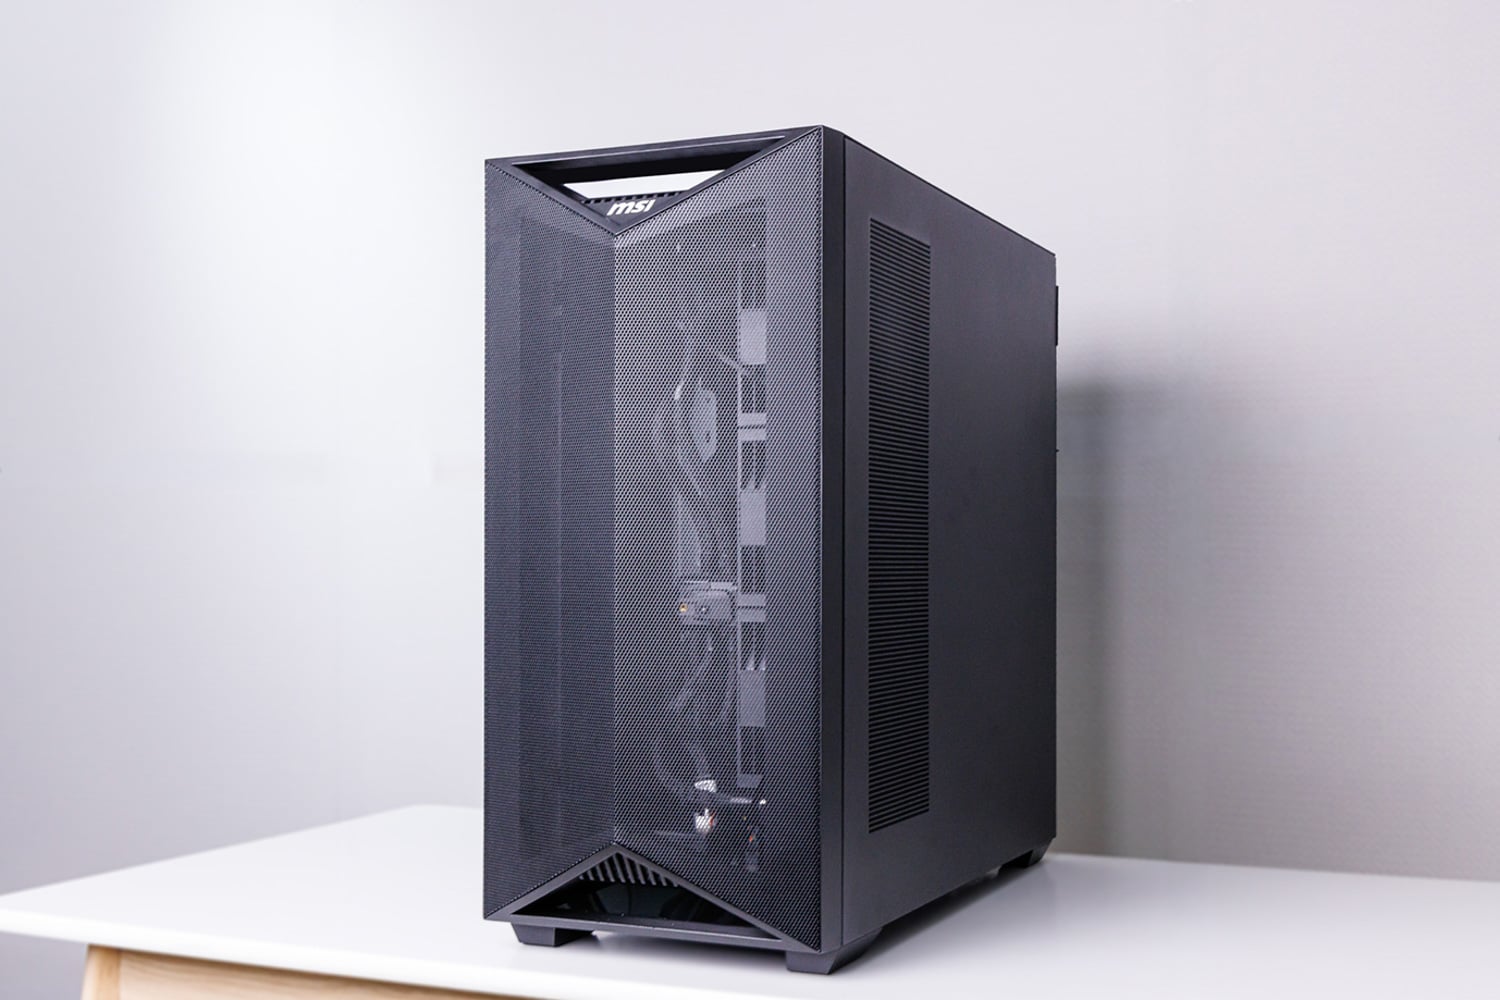
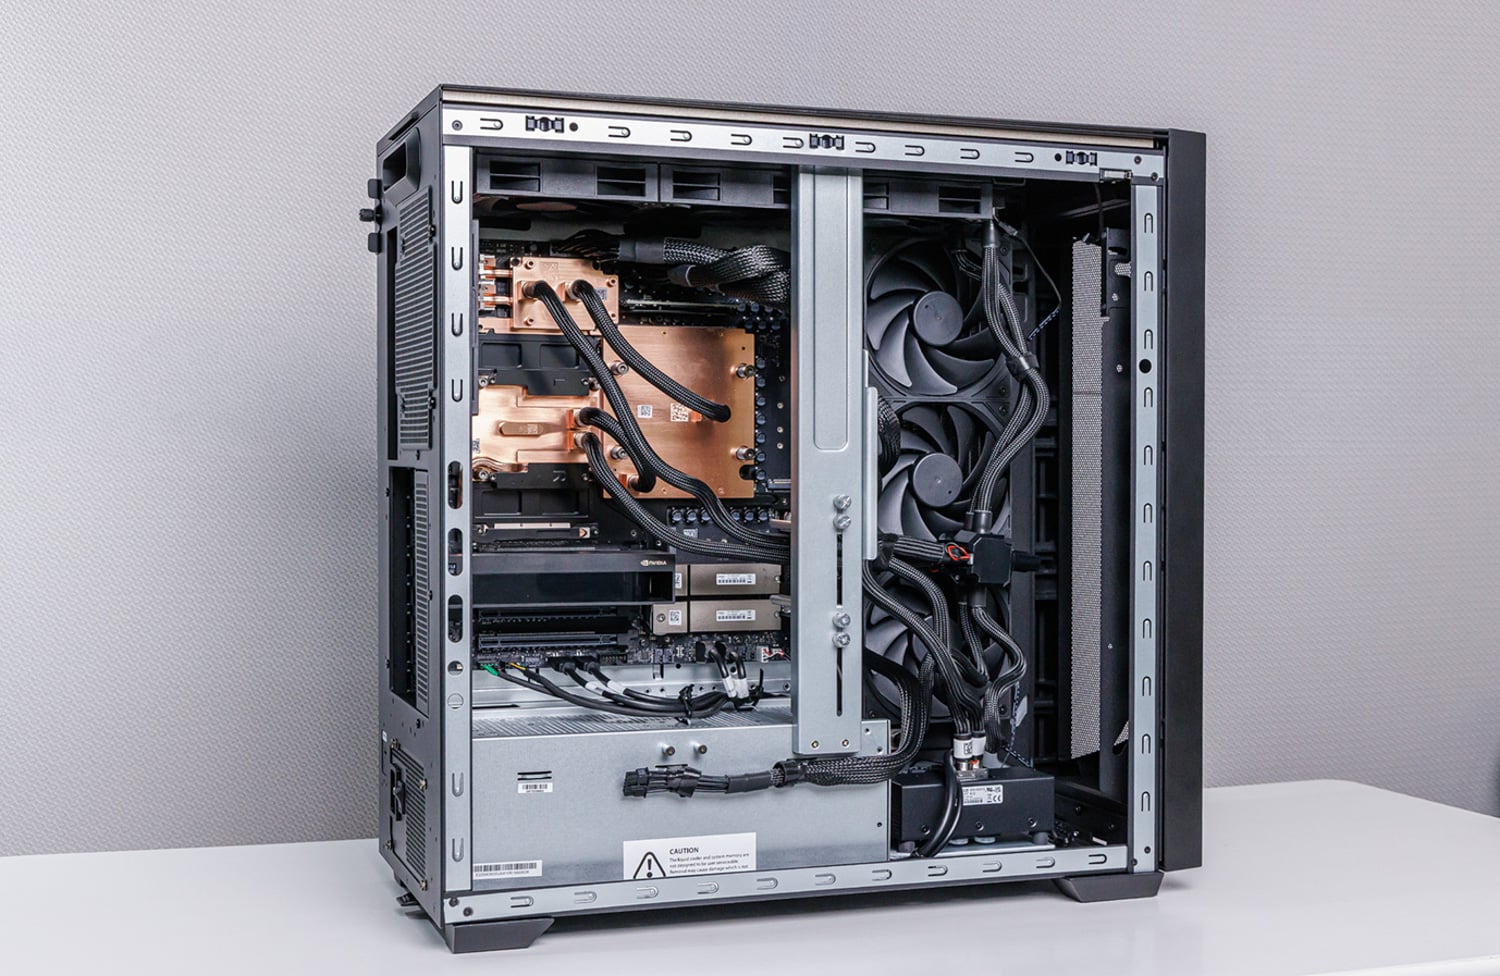
A primera vista, la XpertStation parece una estación de trabajo moderna estándar con un diseño elegante y profesional. Pero si se retira el panel lateral, el parecido termina ahí.
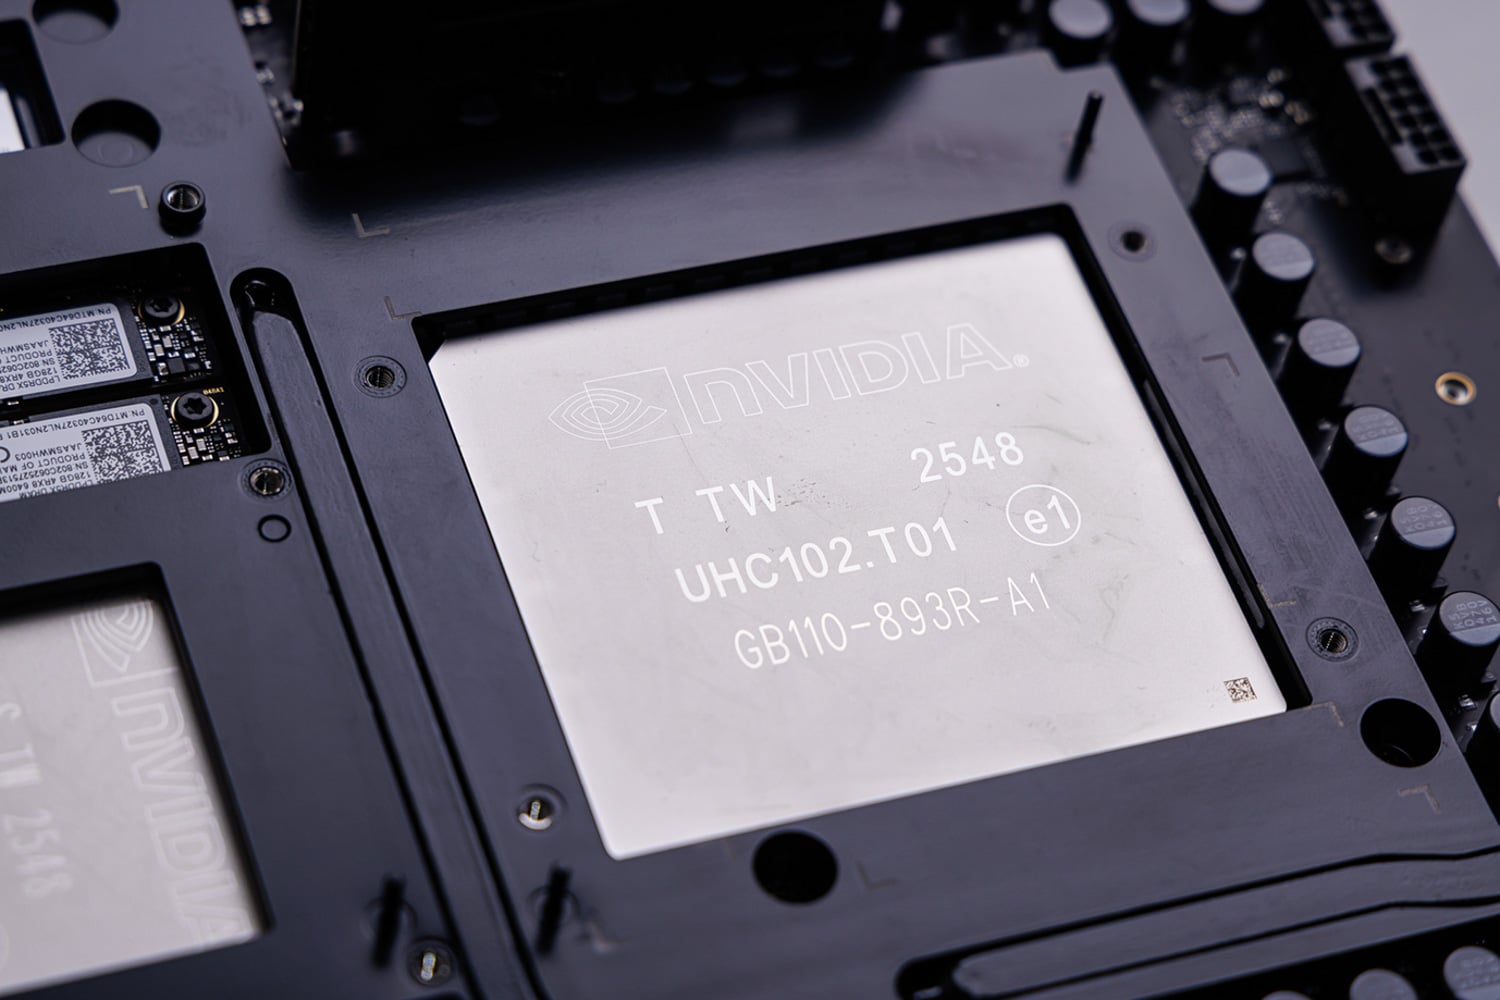
GB300 Grace Blackwell Ultra Desktop Superchip
En el centro del WS300 se encuentra la estrella del espectáculo: la GPU B300 de NVIDIA, construida sobre la arquitectura Blackwell Ultra.
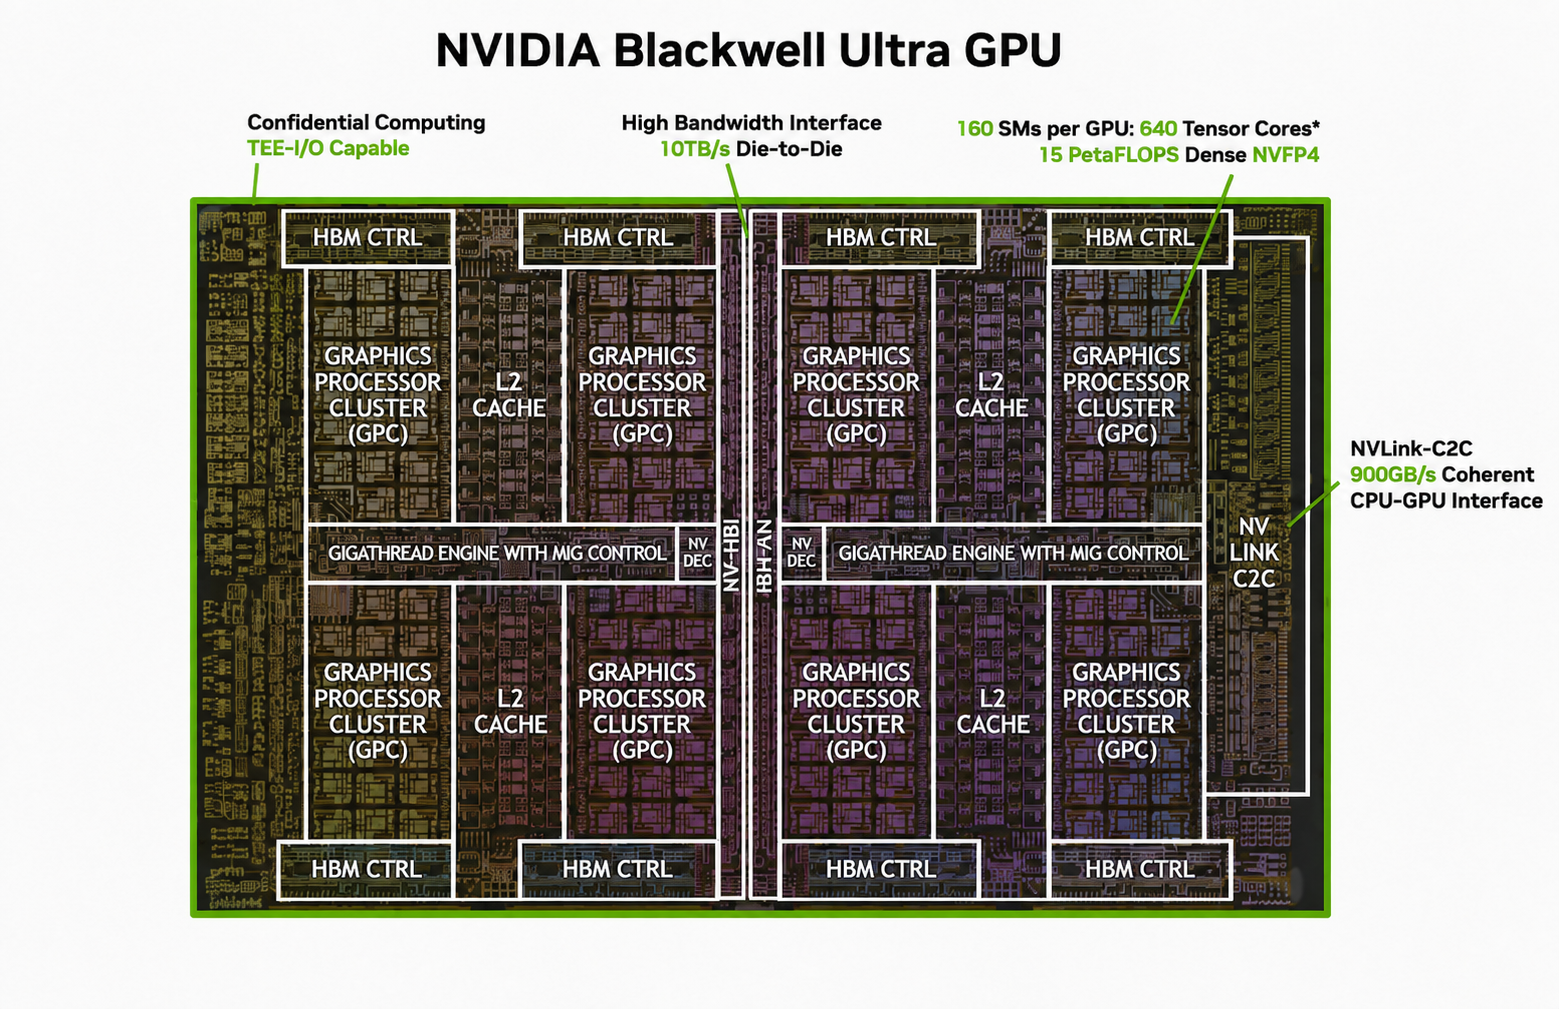
Fuente: NVIDIA, con anotaciones de StorageReview.
La B300 es una de las GPU más avanzadas disponibles actualmente, con un diseño de doble retícula basado en el proceso 4NP de TSMC. Los dos chips están conectados mediante la interfaz de comunicación entre chips NV-HBI de NVIDIA de 10 TB/s, lo que permite que la GPU funcione como un único acelerador CUDA. La B300 utilizada en DGX Station se basa en el diseño Blackwell Ultra de 208 mil millones de transistores, con hasta 160 SM y 640 Tensor Cores de quinta generación. También cuenta con 252 GB de HBM3e con un ancho de banda de memoria de 7.1 TB/s. Como componente para centros de datos, la B300 carece de salida de vídeo estándar y codificadores de hardware NVENC. Sin embargo, incluye siete motores NVDEC y siete decodificadores nvJPEG. La GPU también admite MIG, lo que permite dividirla en hasta siete instancias aisladas. En cuanto a la capacidad de cómputo, la B300 ofrece:
| Precisión | Peak Performance |
|---|---|
| Rendimiento de computación B300 | |
| Núcleo tensorial NVFP4 | 20 PFLOPS disperso / 15 PFLOPS denso |
| FP8 / Núcleo Tensor FP6 | 10 PFLOPS |
| Núcleo tensor INT8 | 330 TOPS |
| Núcleo tensorial FP16 / BF16 | 5 PFLOPS |
| Núcleo tensor TF32 | 2.5 PFLOPS |
| FP32 | 80 TFLOPS |
| FP64 / Núcleo Tensor FP64 | 1.3 TFLOPS |
| Las tasas máximas se basan en la frecuencia de impulso de la GPU. Las especificaciones de Tensor Core utilizan la dispersión a menos que se indique lo contrario. | |
Junto con el B300 se encuentra Grace, la primera CPU de NVIDIA para centros de datos. Utiliza 72 núcleos Arm Neoverse V2, pero el procesador circundante es de diseño propio de NVIDIA, incluyendo la jerarquía de caché, los controladores de memoria, la E/S del sistema, la estructura de coherencia escalable y la interfaz NVLink-C2C. Grace expone 72 núcleos y 72 hilos de hardware, con cada núcleo implementando Armv9 con extensiones de criptografía y cuatro unidades vectoriales SVE2 de 128 bits. El núcleo tiene un decodificador de instrucciones de seis vías capaz de enviar hasta ocho instrucciones por ciclo de reloj, seis ALU escalares, 64 KB de caché L1 de instrucciones y datos, y 1 MB de caché L2 privada. En todo el chip, la CPU comparte 114 MB de caché L3.
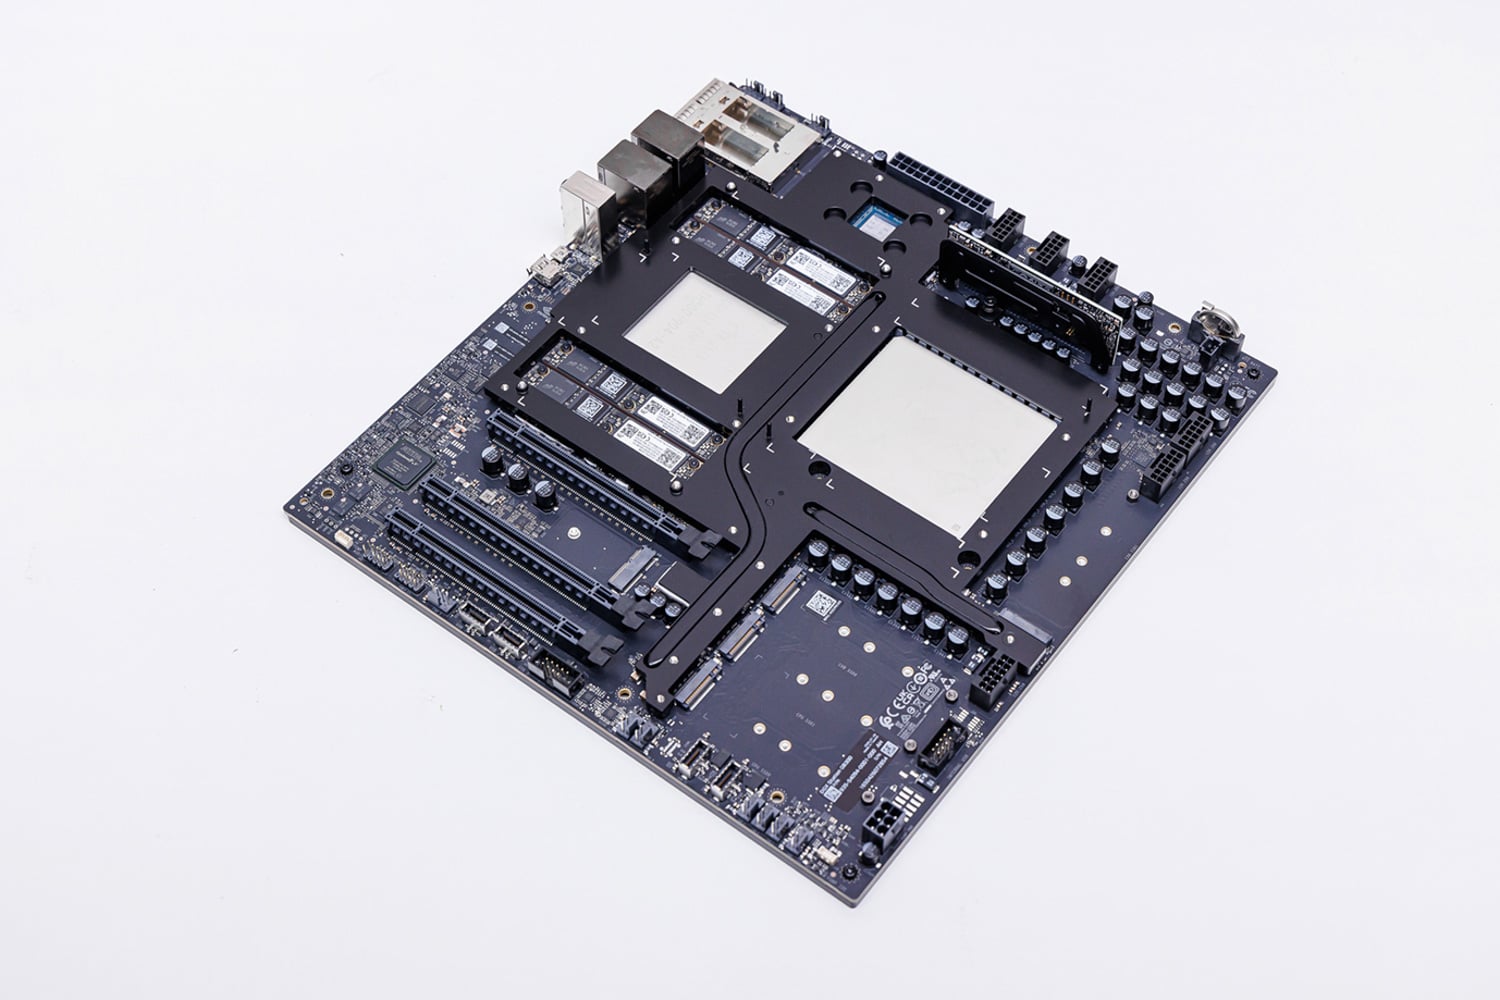
Los núcleos y las secciones de caché L3 están conectados a través de NVIDIA Scalable Coherency Fabric, una interconexión de malla con un ancho de banda de bisección de 3.2 TB/s. Esta estructura también conecta los núcleos de la CPU con la memoria, la E/S del sistema y la interfaz NVLink-C2C, lo que proporciona a Grace el ancho de banda de transferencia de datos necesario para alimentar el B300. En el WS300, Grace gestiona el trabajo del lado de la CPU relacionado con el acelerador: lanzamiento de kernels de GPU, carga de datos, preprocesamiento, tokenización y orquestación de modelos. La vista de topología que se muestra a continuación ofrece una visión clara del diseño de un solo socket, con una CPU Grace de 72 núcleos y los dispositivos de la plataforma conectados a su alrededor.
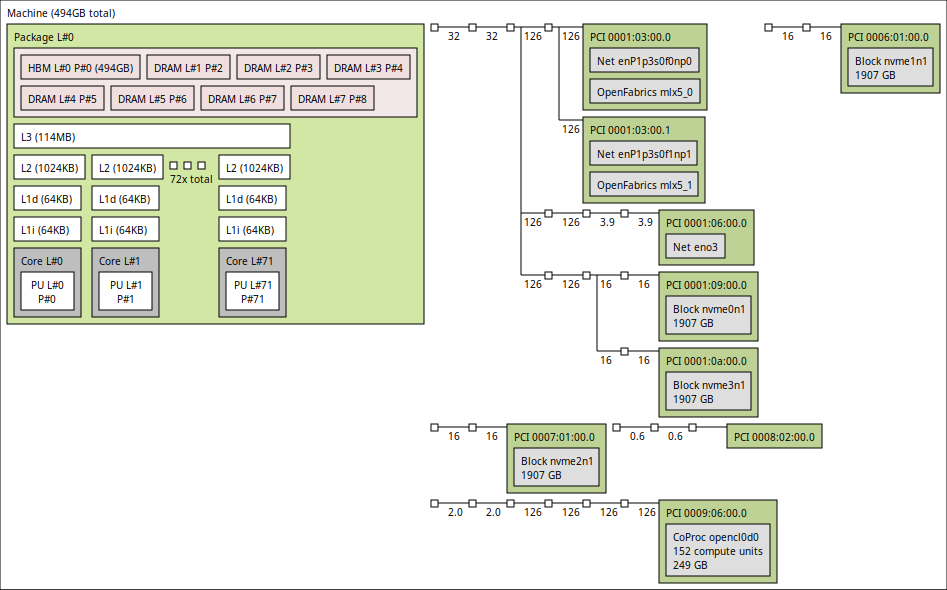
Grace viene equipada con 496 GB de memoria LPDDR5X, que ofrece un ancho de banda de 396 GB/s. En lugar de soldar la memoria directamente a la placa base, DGX Station utiliza cuatro módulos SOCAMM. SOCAMM, o Módulo de Memoria Avanzada en Chip, integra la memoria LPDDR5X en un formato compacto y extraíble. Esto permite que la plataforma conserve las ventajas de ancho de banda y eficiencia energética de la LPDDR5X, a la vez que facilita el mantenimiento de la memoria. Un módulo defectuoso puede reemplazarse sin necesidad de sustituir toda la placa base.
La interfaz NVLink-C2C de NVIDIA conecta Grace y la B300, ofreciendo una interconexión a nivel de paquete con un ancho de banda bidireccional de 900 GB/s, aproximadamente siete veces superior al de una conexión PCIe Gen5 x16. La diferencia más importante radica en la coherencia de la memoria. En una estación de trabajo convencional, la CPU y la GPU dedicada mantienen espacios de memoria separados, con datos que se copian entre ellas a través de PCIe. Con NVLink-C2C, Grace y la B300 comparten un espacio de direcciones coherente, lo que permite que cada procesador acceda directamente a la memoria conectada al otro.
El resultado es un espacio de direcciones coherentes de 748 GB, no un bloque de HBM de 748 GB. La B300 cuenta con 252 GB de HBM3e que ofrece 7.1 TB/s, mientras que Grace aporta 496 GB de LPDDR5X a 396 GB/s. Los datos almacenados en la memoria Grace deben seguir atravesando el enlace C2C, por lo que HBM sigue siendo la mejor opción para los pesos, tensores y búferes de modelos a los que se accede con frecuencia. La memoria Grace, en cambio, actúa como una capa de gran capacidad, lo que permite que las cargas de trabajo que superan los 252 GB de memoria local de la B300 permanezcan en un solo sistema en lugar de distribuirse entre varias GPU. Mediremos el impacto en el rendimiento de pasar a esa segunda capa de memoria más adelante en la sección de pruebas.
Topología del sistema
Partiendo del paquete GB300, el diagrama de bloques de MSI muestra cómo se conecta el resto del sistema alrededor de Grace. La CPU se ubica en el centro de la topología de E/S, con dos ranuras M.2 PCIe 5.0 x4 conectadas directamente a ella. MSI equipa estas ranuras con un par de SSD Micron 4600 de 2 TB configurados en RAID 1 para el sistema operativo y el software de NVIDIA. Las tres ranuras de expansión de tamaño completo también se conectan directamente a Grace, con un enlace PCIe 5.0 x16 y dos enlaces PCIe 5.0 x8.
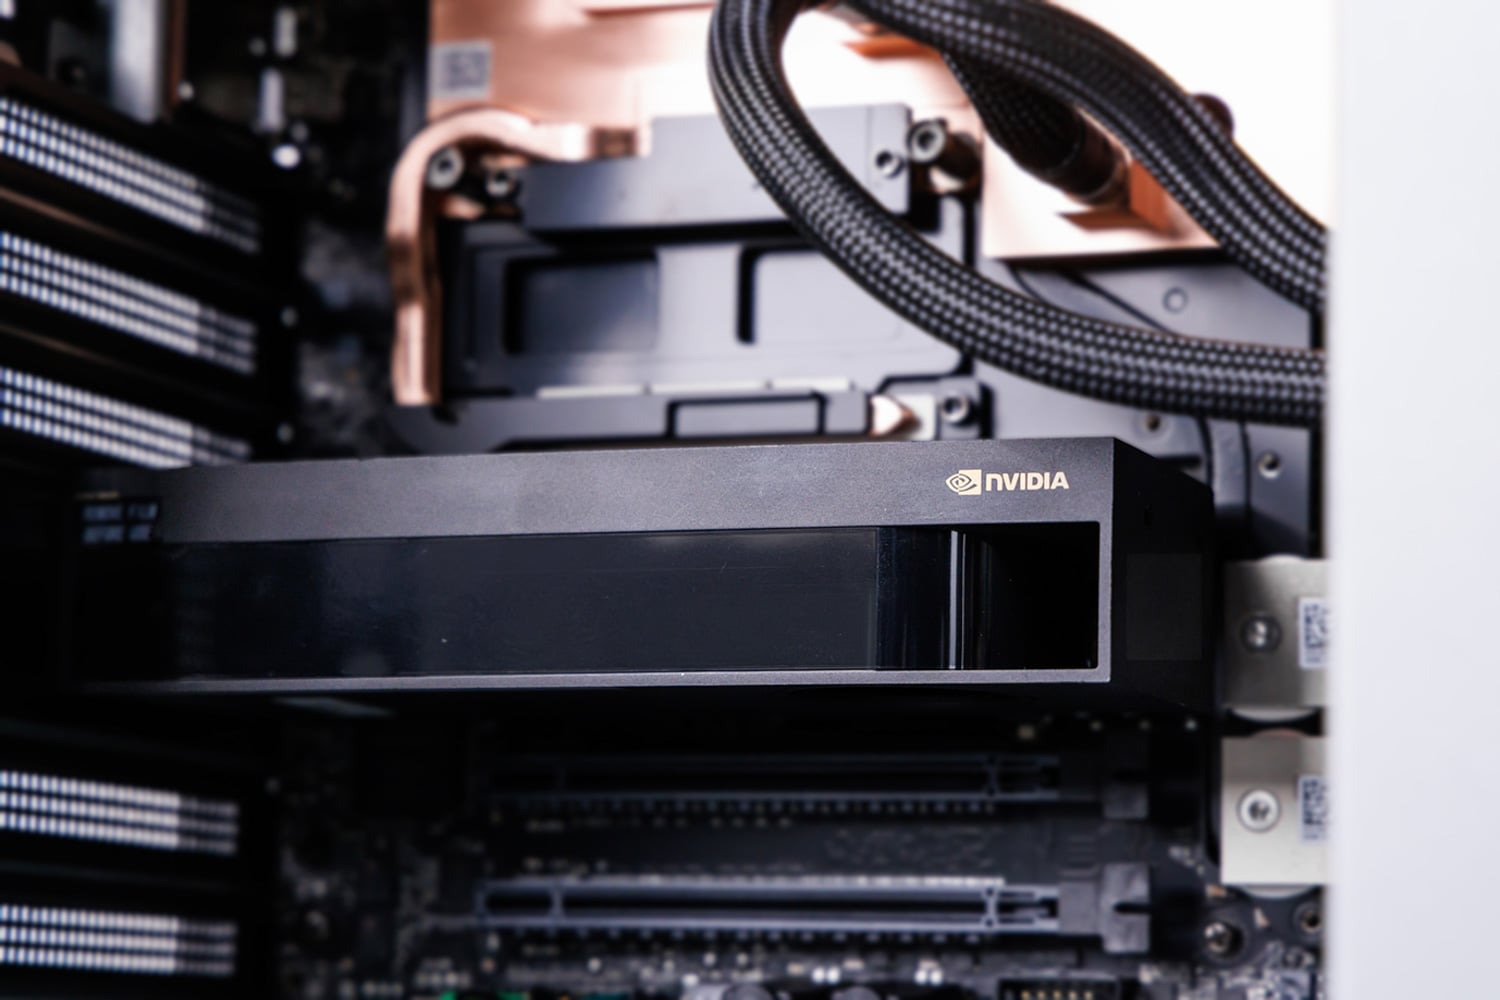
MSI también ha preparado el chasis para una tarjeta gráfica de gran tamaño. El cable de alimentación HPWR de 12 V preinstalado es de fácil acceso en la parte frontal del chasis, evitando la necesidad de pasar otro cable por el sistema. El soporte metálico vertical que rigidiza el chasis incorpora además un soporte antivibración para sujetar tarjetas RTX PRO largas y pesadas.
Un controlador USB en el lado de Grace gestiona los puertos USB principales frontal y trasero del sistema, junto con el códec de audio. Grace también se conecta al BMC ASPEED AST2600, que proporciona un puerto de gestión dedicado de 1 GbE, una salida Mini DisplayPort limitada a 1024 x 768 y una consola serie Micro-USB. El Mini DisplayPort está diseñado para la configuración inicial y la resolución de problemas, no como la salida de vídeo principal del sistema. Quienes planeen usar el WS300 como un ordenador de sobremesa convencional necesitarán una de las tarjetas de expansión RTX PRO opcionales.
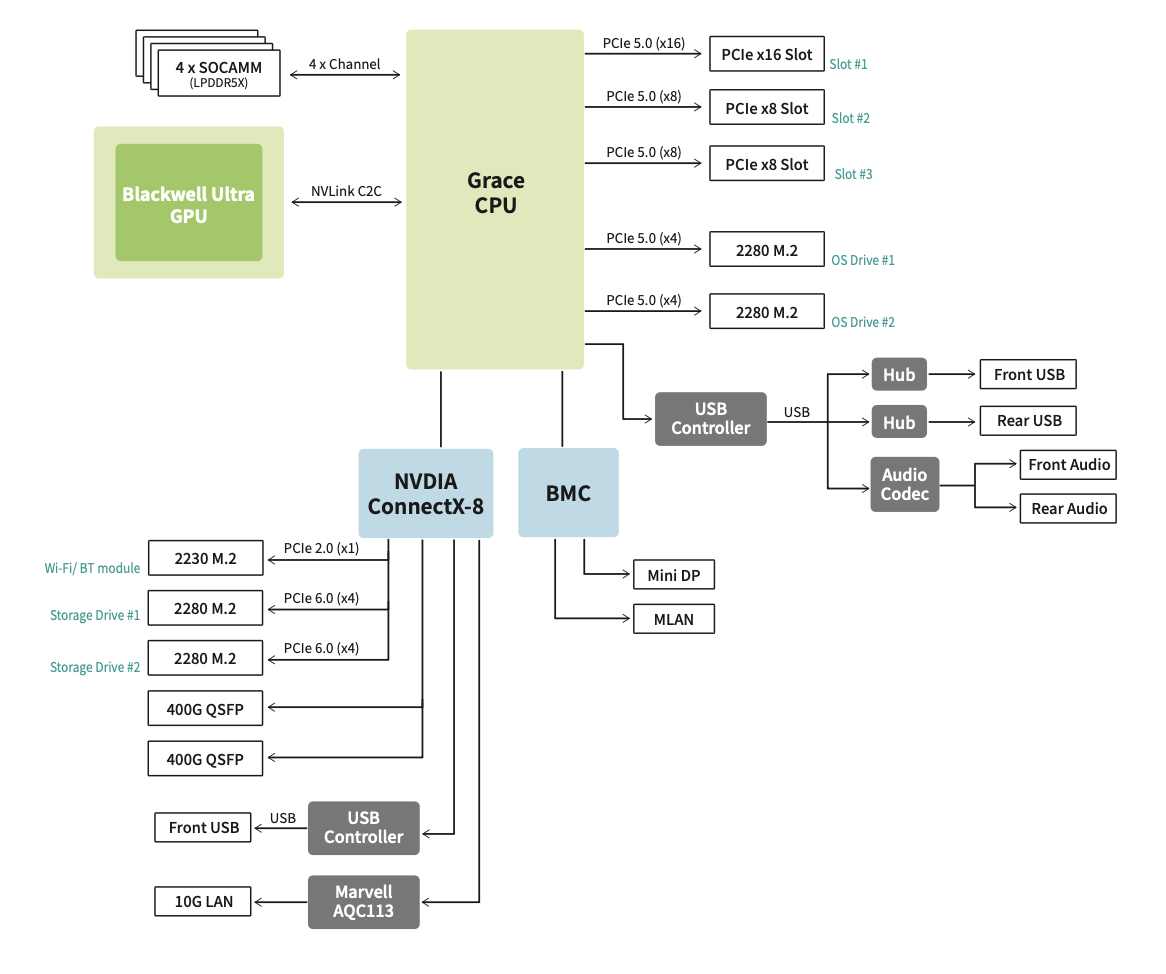
La otra rama principal es la tarjeta de red ConnectX-8 SuperNIC de NVIDIA. Su característica más visible son los dos puertos QSFP112 de 400 GbE en el panel posterior, que proporcionan un ancho de banda de red agregado de hasta 800 Gb/s. ConnectX-8 también incluye un conmutador PCIe integrado con 48 carriles; su enlace ascendente es compatible con PCIe Gen6, pero los puertos descendentes que expone a los dispositivos funcionan con PCIe 5.0, lo que permite a MSI utilizarla como un concentrador de E/S secundario en lugar de simplemente como un adaptador de red.
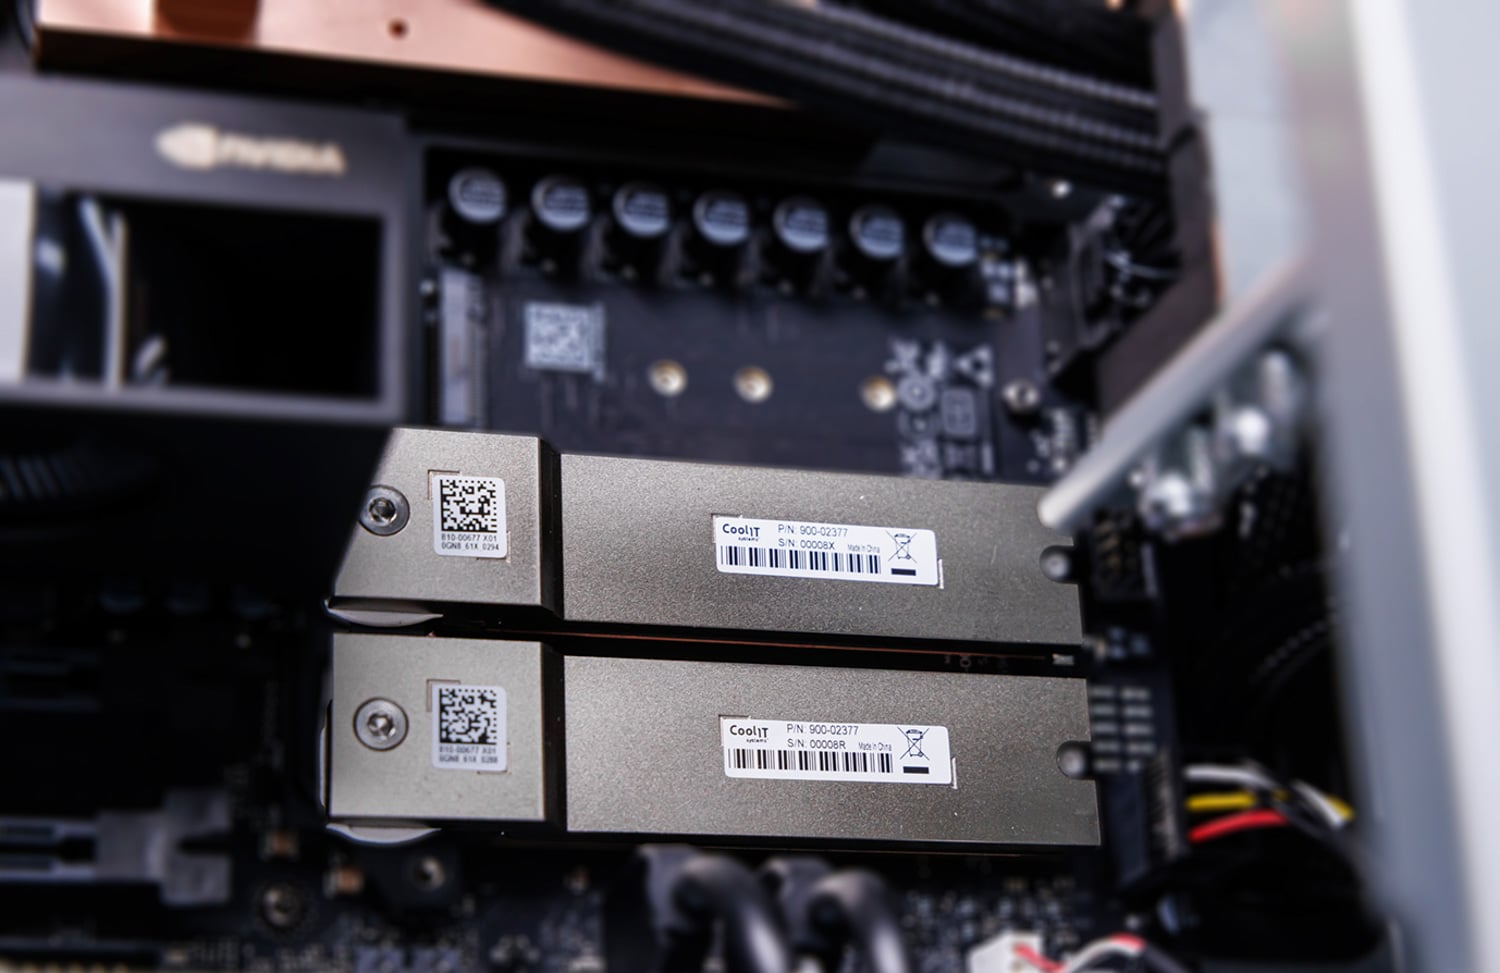
Dos enlaces PCIe 5.0 x4 del ConnectX-8 alimentan las ranuras M.2 2280 restantes, que MSI deja libres para futuras ampliaciones. El mismo enlace también conecta la ranura M.2 2230 para Wi-Fi y Bluetooth a través de PCIe 2.0 x1, el controlador Marvell AQC113 para el puerto 10GBase-T y un segundo controlador USB que proporciona una ruta USB adicional en el panel frontal.
Energía y refrigeración
El WS300 se alimenta con una única fuente de alimentación ATX 80 PLUS Platinum de 1,600 W con entrada C19. Para instalaciones en Norteamérica, la estación DGX requiere un circuito dedicado de 20 A para proporcionar al sistema toda su potencia.
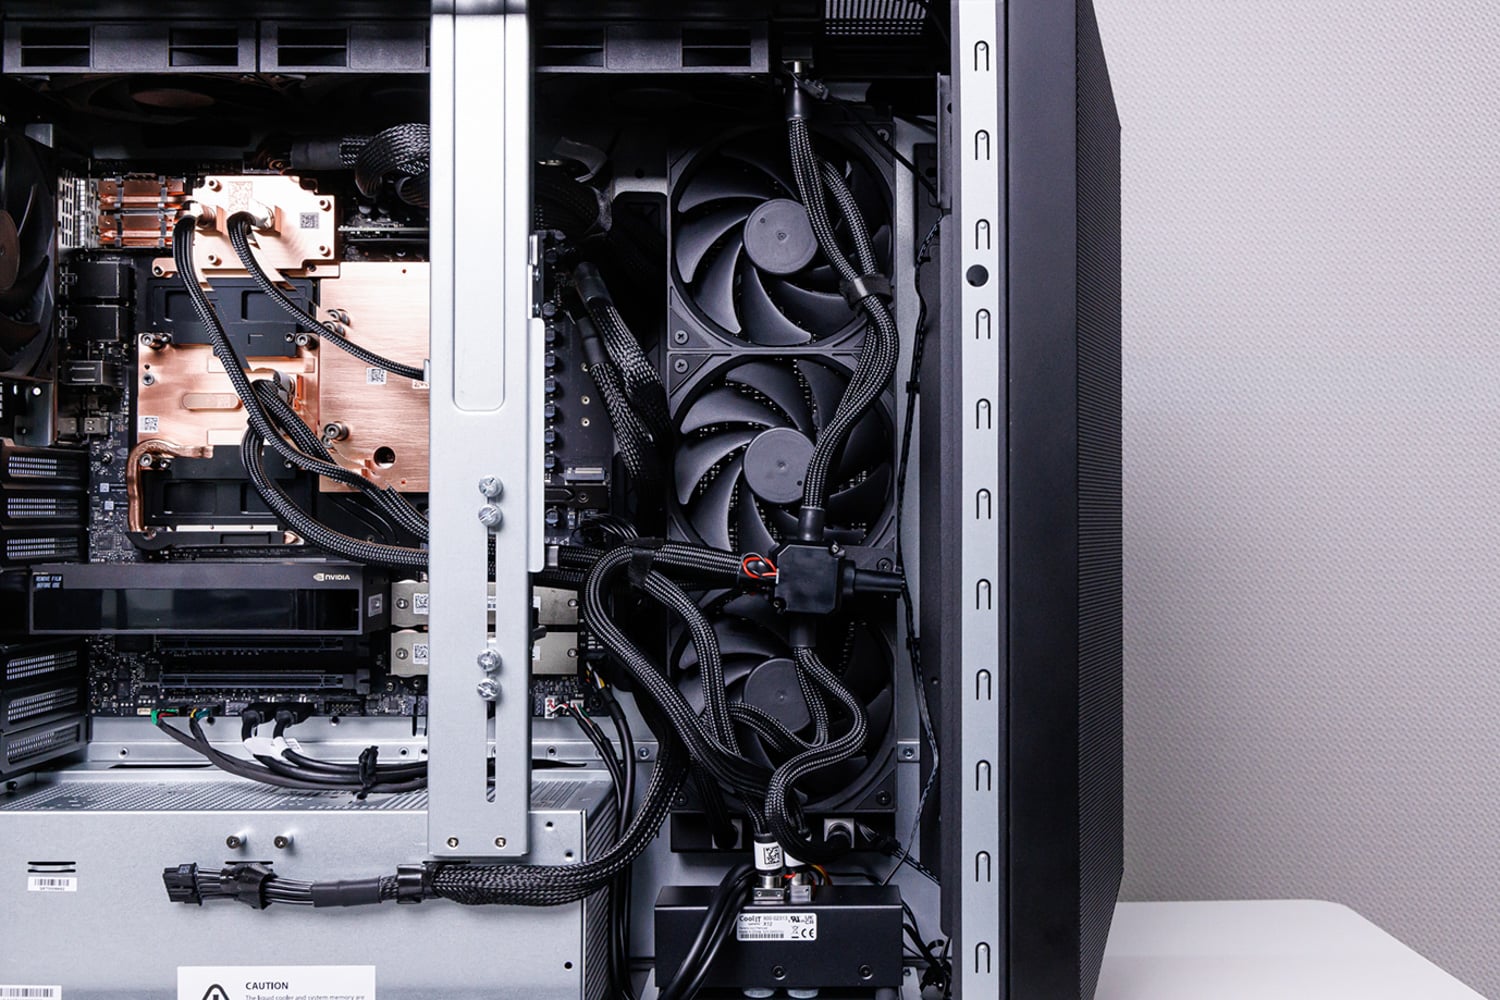
La potencia nominal de 1,600 W es el límite máximo para todo el sistema. Grace, la placa base B300, el almacenamiento, las bombas, los ventiladores y cualquier tarjeta RTX PRO opcional se alimentan de la misma fuente de alimentación. Añadir una tarjeta gráfica de alta potencia amplía las capacidades de la WS300, pero no consume energía de una fuente independiente. Cuando la B300 y la tarjeta RTX están bajo carga, deben compartir la energía disponible, lo que puede reducir el rendimiento de la GPU de la B300.
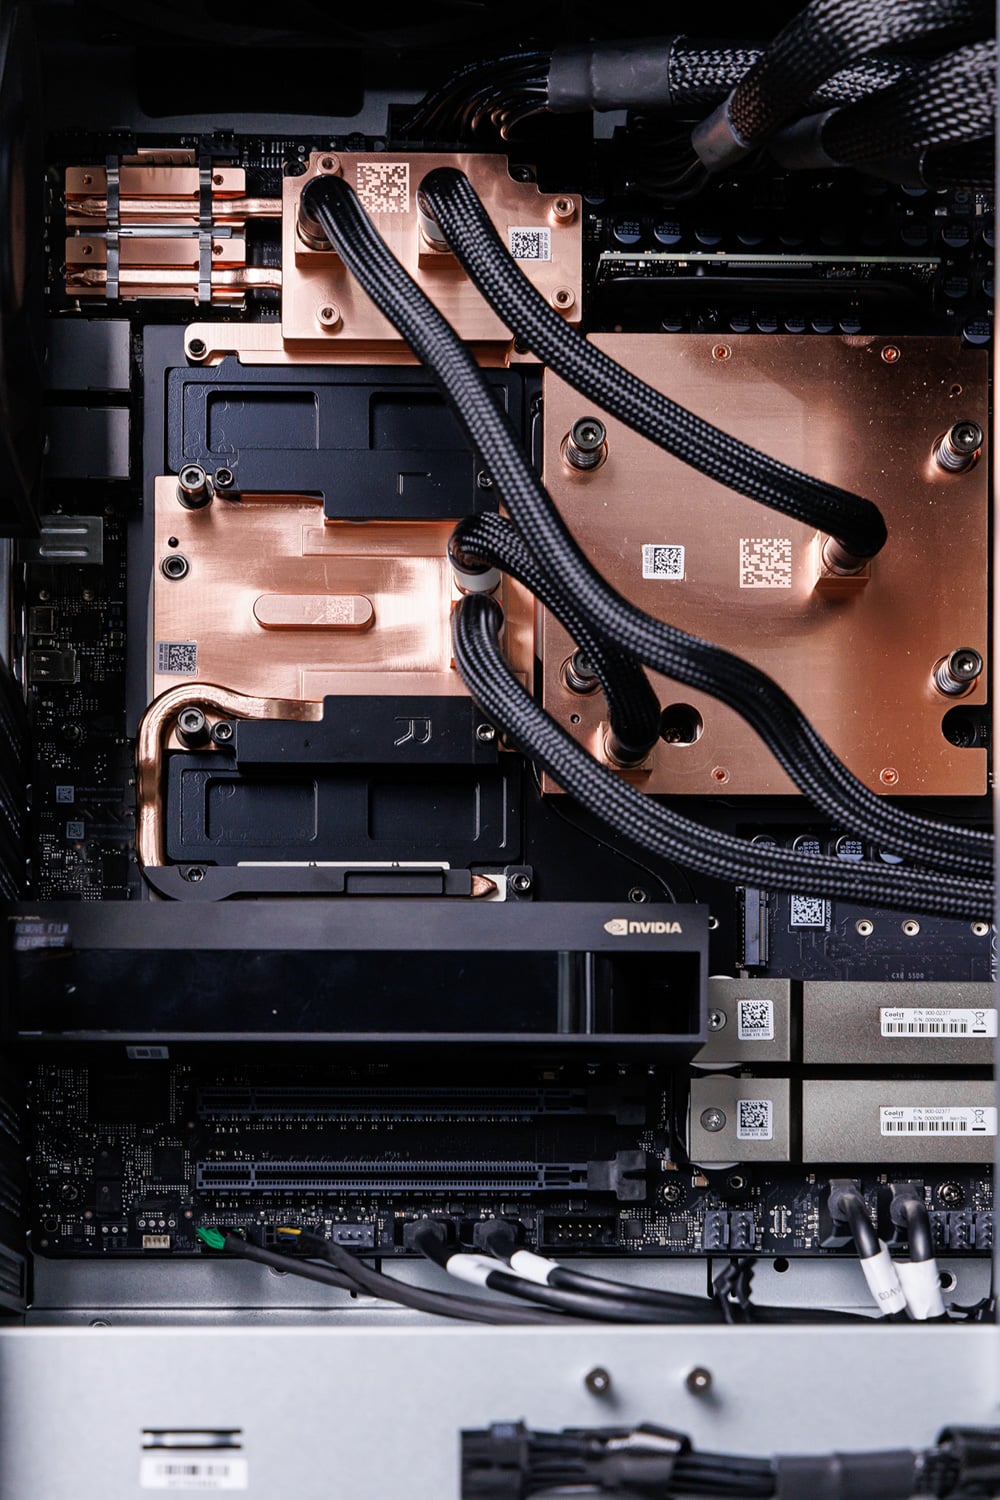
MSI gestiona la carga térmica resultante con un sistema de refrigeración líquida personalizado que cubre la placa base B300, la CPU Grace, la memoria SOCAMM y el ConnectX-8, incluyendo las bahías para unidades ópticas. El calor se disipa mediante dos radiadores de 360 mm, mientras que un ventilador independiente de 120 mm distribuye el aire por el resto del chasis. MSI especifica que el sistema de refrigeración soporta hasta 1,400 W entre la CPU y la GPU. Durante nuestras pruebas, la temperatura de la placa base B300 alcanzó un máximo de 71 °C, mientras que la CPU nunca superó los 65 °C con un consumo de 1292 W por parte de la GPU.
Salpicaduras de potencia
NVIDIA gestiona ese presupuesto compartido mediante el servicio vsloshd. En su modo dinámico predeterminado, el servicio monitoriza el consumo de energía en tiempo real del módulo GB300 y de una tarjeta RTX PRO opcional, distribuyendo el margen disponible entre ellos en lugar de mantener cada dispositivo con un límite fijo. Según la política actual, la tarjeta RTX tiene prioridad, por lo que cuando necesita más energía, el sistema primero reduce el límite de potencia del GB300 antes de aumentar el de la RTX. Sin una tarjeta RTX instalada, el presupuesto total de la política permanece disponible para el módulo GB300.
Esto significa que la RTX PRO 6000 opcional no es simplemente un rendimiento adicional sobre la B300. Cuando ambas GPU están ocupadas, la energía asignada a la tarjeta RTX proviene directamente del presupuesto de la GB300 y puede reducir la frecuencia y el rendimiento de la B300.
La plataforma también incluye un freno de potencia por hardware para los casos en que el sistema detecta una degradación en el suministro de energía. Pudimos comprobarlo durante nuestras pruebas prácticas, cuando unos conectores de alimentación sueltos provocaron que el WS300 redujera su límite de potencia en lugar de apagarse o seguir consumiendo energía a plena potencia a través de una conexión defectuosa. El equipo permaneció en línea en el estado de potencia reducida hasta que se solucionó el problema de conexión.
Conectividad
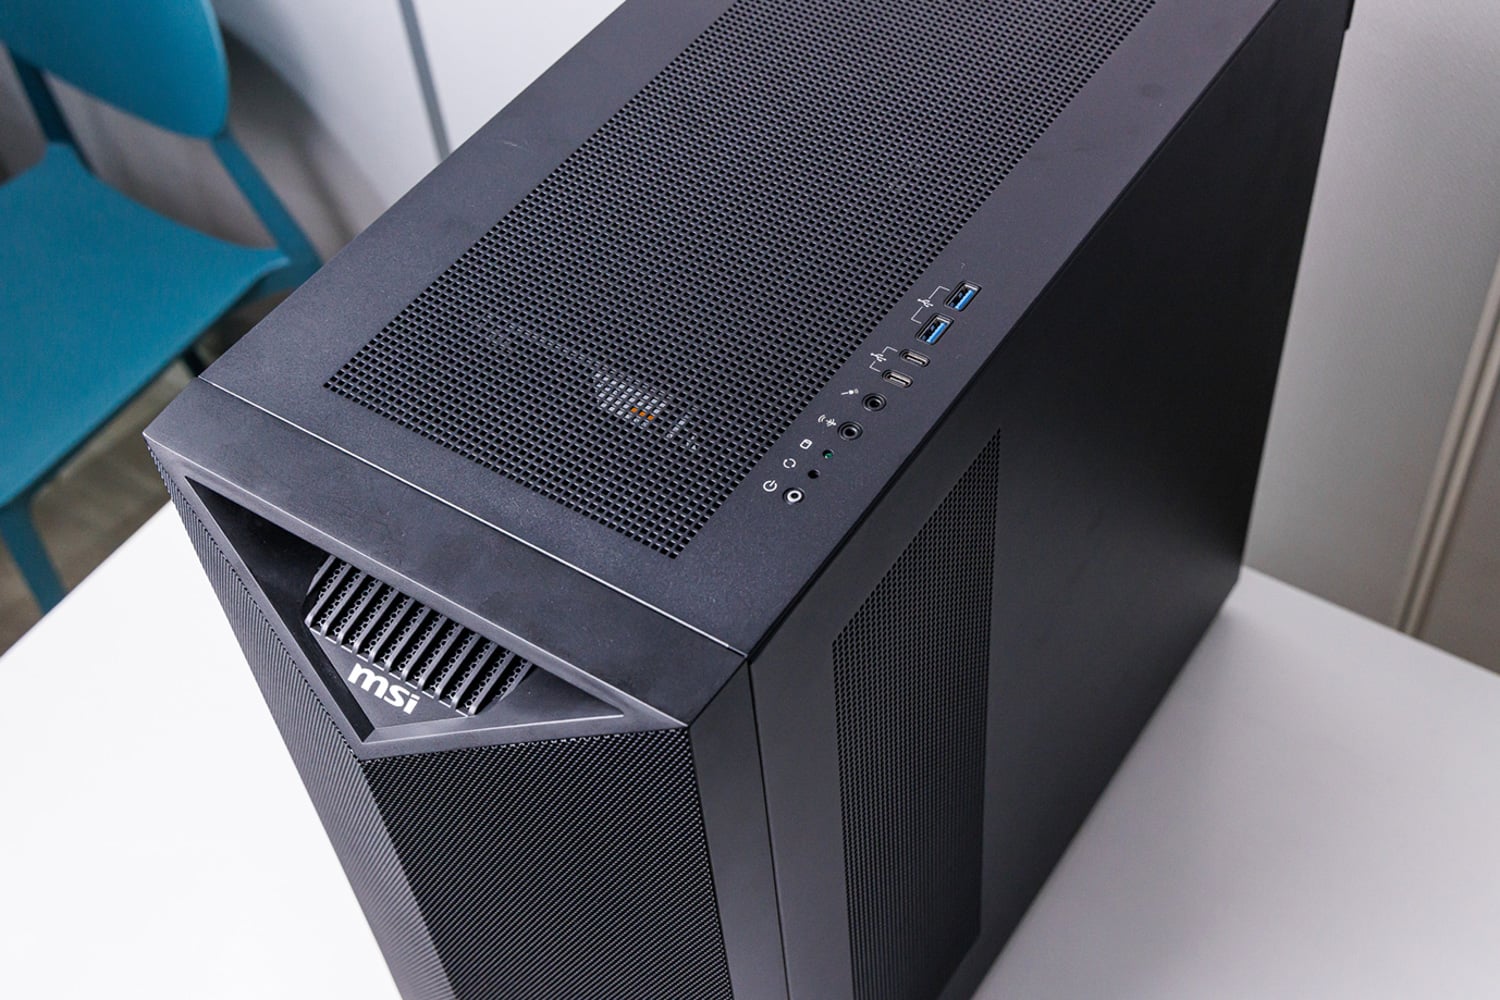
Antes de continuar, conviene echar un vistazo a los puertos de entrada/salida frontales y traseros. El panel frontal incluye dos puertos USB 3.2 Gen 2 Tipo A, dos puertos USB 3.2 Gen 2 Tipo C, conectores independientes para salida de línea y micrófono, y los controles de encendido y reinicio.
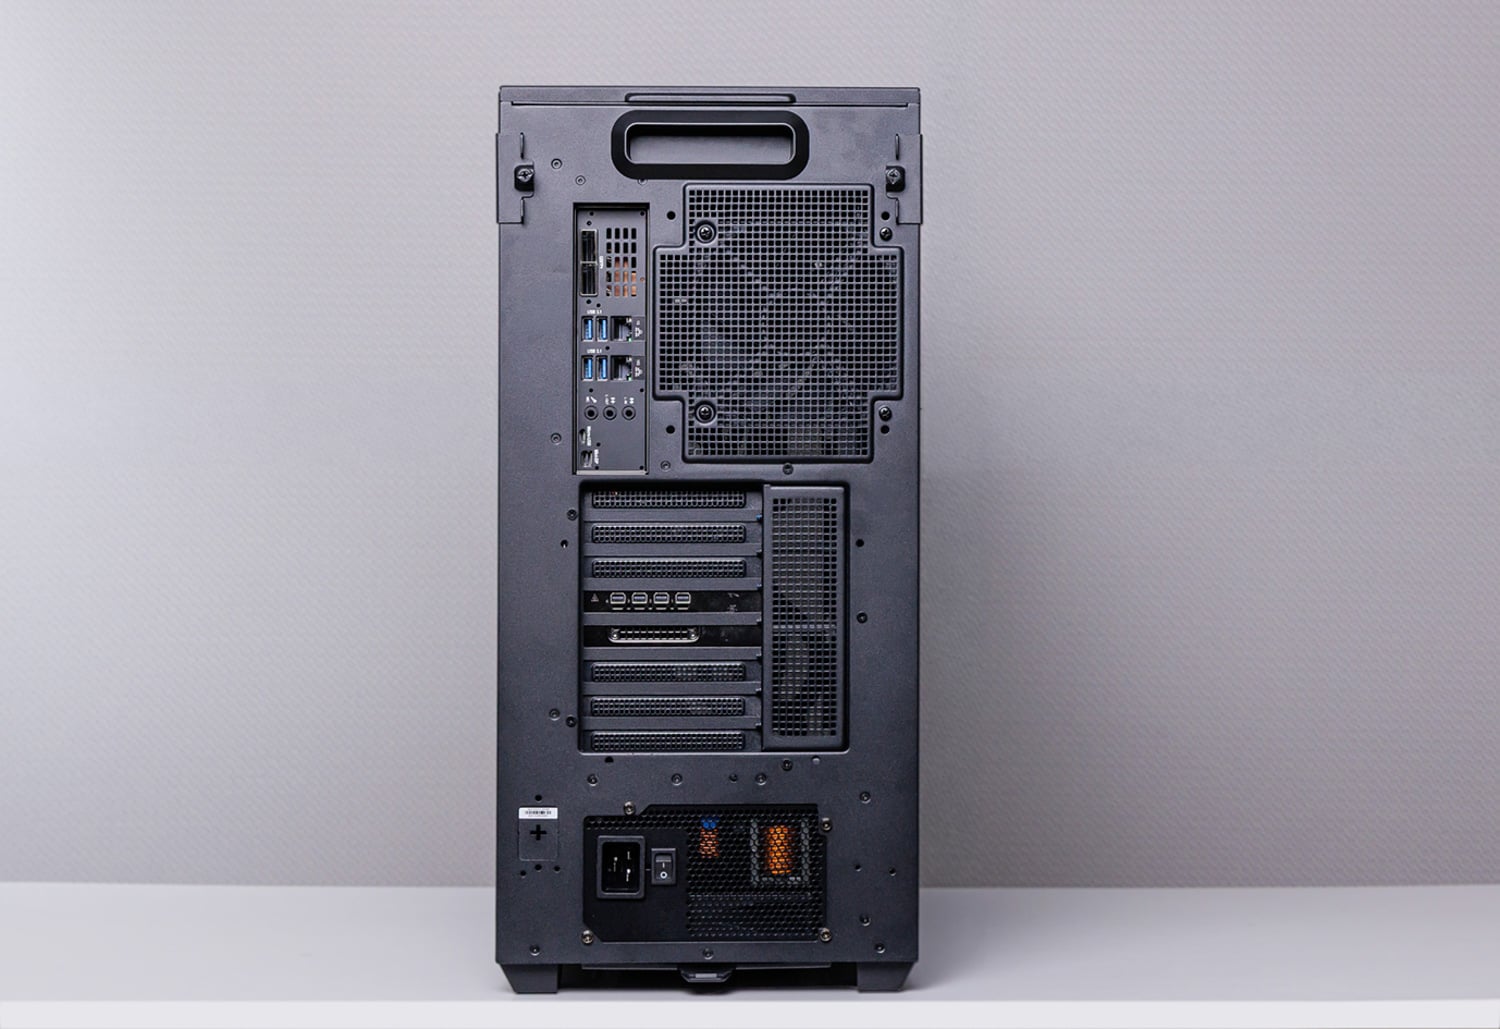
El panel trasero se divide entre la conectividad de la estación de trabajo y el hardware del servidor subyacente. ConnectX-8 proporciona dos puertos QSFP112 de 400 GbE, mientras que un puerto 10GBase-T independiente gestiona la red host estándar y un puerto 1GbE dedicado se conecta al BMC. Cuatro puertos USB tipo A de 10 Gbps y tres conectores de audio cubren los periféricos locales. El BMC también incluye una consola serie Micro-USB y un Mini DisplayPort. La entrada de alimentación C19 se encuentra en la parte inferior del chasis, y se puede agregar Wi-Fi 6E o Wi-Fi 7 con Bluetooth a través de la ranura interna M.2 2230 Key-E.
Cargas de trabajo del centro de datos en el escritorio
Hasta ahora, todo lo que hemos dicho ha descrito sobre la DGX Station; la pregunta más útil para los compradores es qué permite hacer la XpertStation a un equipo. El valor de la WS300 se hace más evidente al considerarla como una plataforma de desarrollo, en lugar de simplemente un sistema de inferencia de alta capacidad. Su GPU B300, CPU Grace, compatibilidad con MIG, gráficos RTX PRO opcionales y software para centros de datos permiten ejecutar en un único nodo local diversos flujos de trabajo que normalmente dependerían de hardware de clúster compartido.
MIG como herramienta de desarrollo
Imagina ejecutar varias tareas completamente independientes en una sola GPU simultáneamente, cada una aislada de las demás. Eso es lo que hace Multi-Instance GPU (MIG): segmenta espacialmente el hardware de la B300 en hasta siete segmentos o instancias de igual tamaño. Cada instancia recibe su propia asignación fija de SM, HBM, caché y ancho de banda de memoria, posee su propia identidad de dispositivo y se presenta ante CUDA como una GPU independiente.
Esto permite desarrollar, probar y validar cargas de trabajo multi-GPU; entrenar scripts; y desarrollar para herramientas como Dynamo, LLM-D, etc.
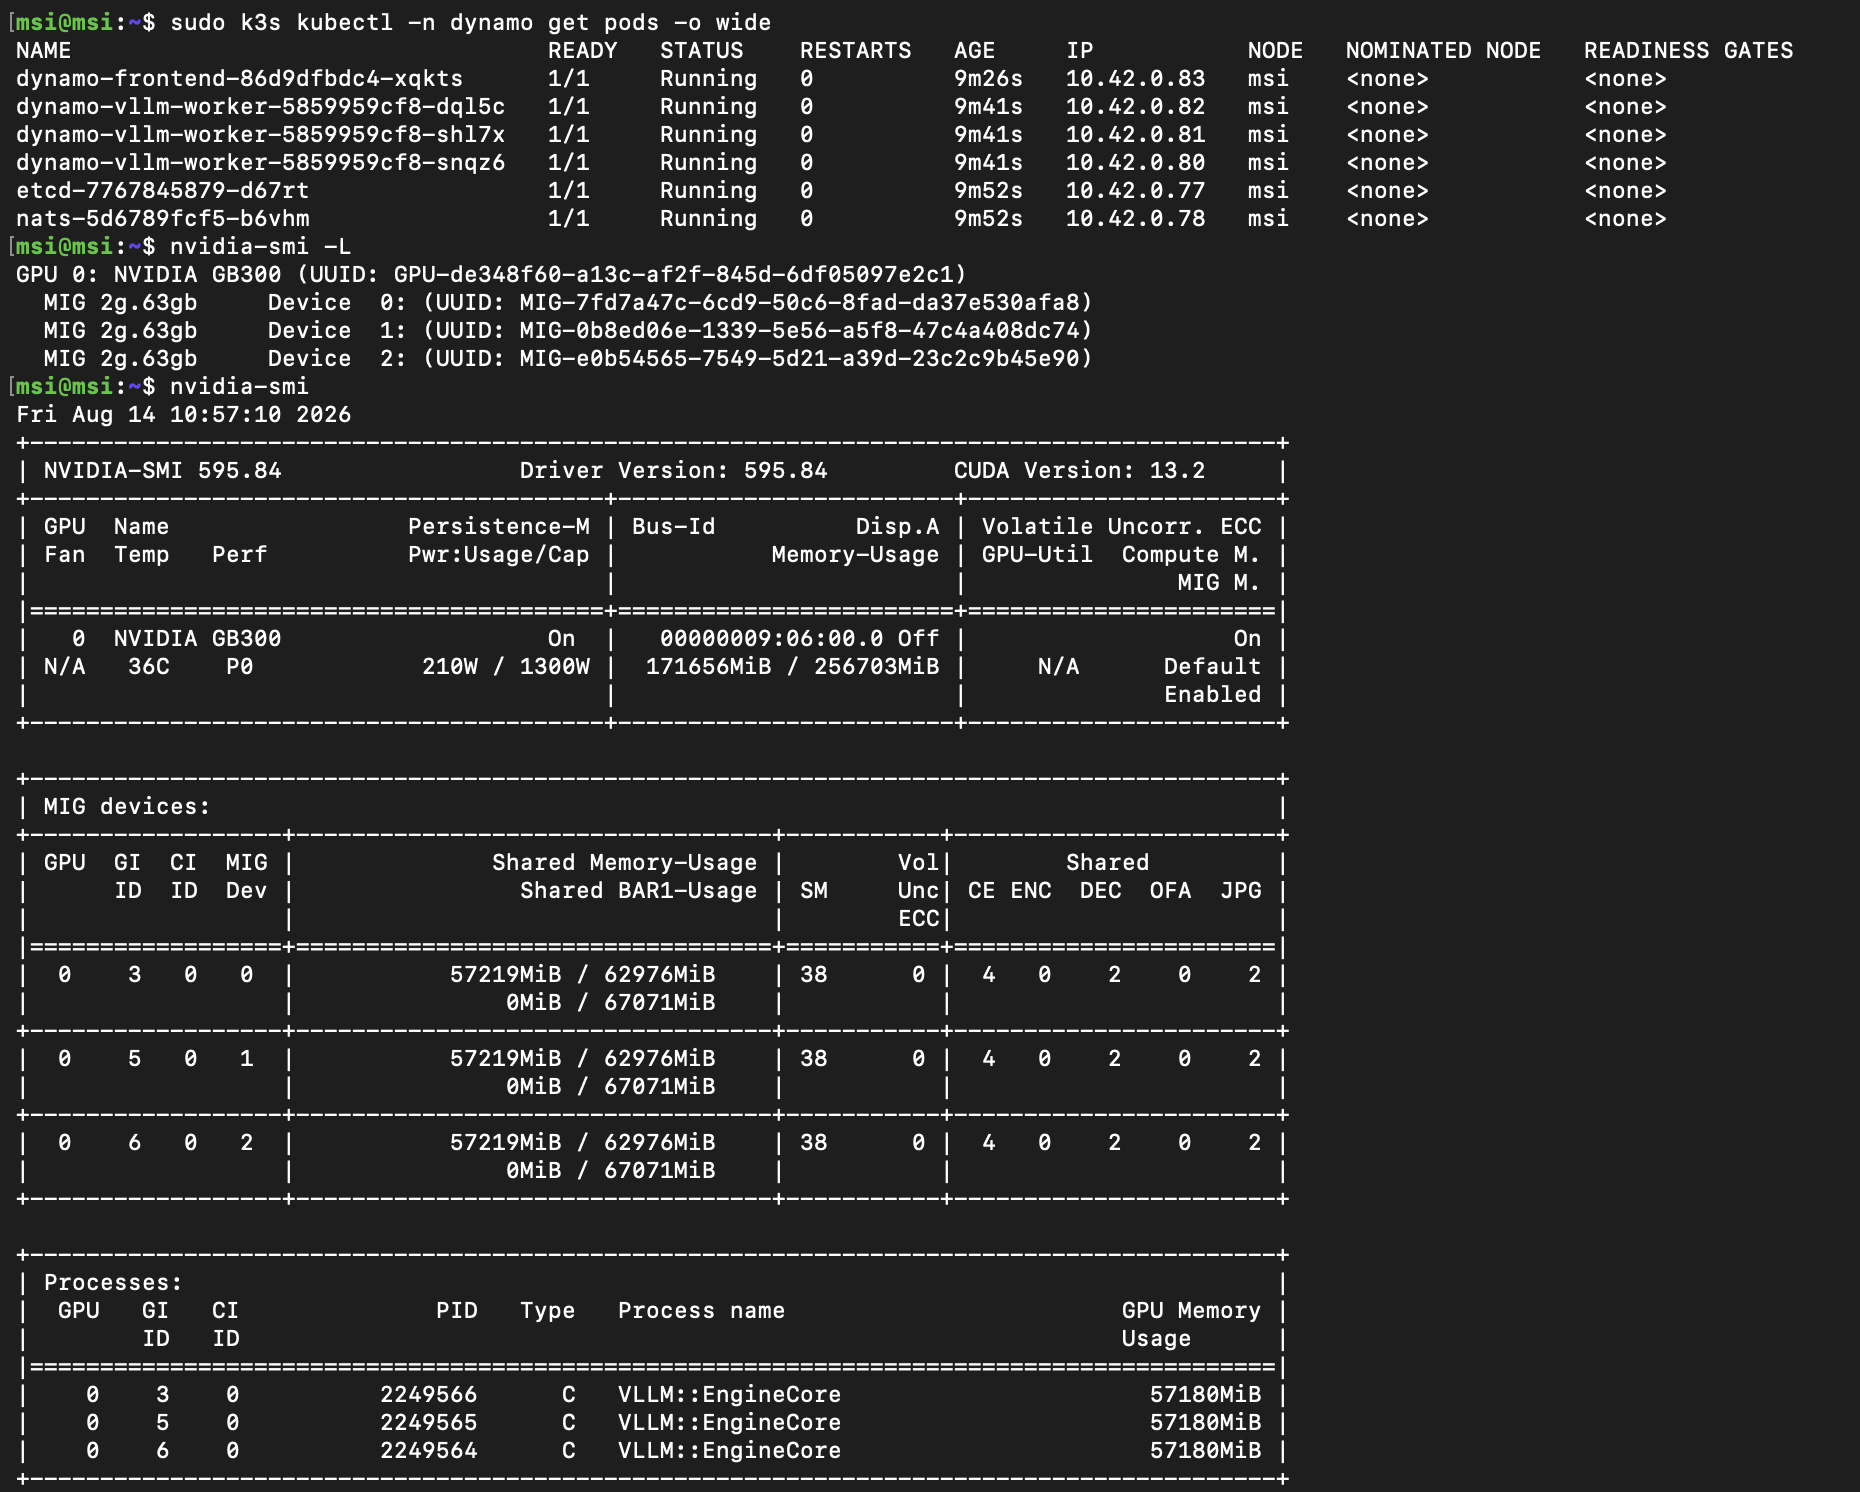
Para nuestras pruebas, configuramos el B300 con tres instancias MIG y las utilizamos para activar componentes NVIDIA Dynamo en dispositivos CUDA independientes. Esto refleja el proceso de creación de gran parte de nuestras herramientas de evaluación comparativa: validar su correcto funcionamiento implica realizar iteraciones repetidas con hardware real. Disponer de un B300 local que podemos dividir y reconfigurar, sin necesidad de reservar tiempo en un servidor compartido y sin el consumo de energía, el calor ni el ruido de un rack en la sala, reduce considerablemente la carga de trabajo iterativa.
Isaac GR00T y el bucle de IA física
Otro flujo de trabajo que se adapta particularmente bien a la estación DGX es la IA física.
Ya habíamos probado este tipo de flujo de trabajo , pero requería varios sistemas equipados con diferentes tipos de GPU. La estación DGX reúne esas etapas, antes separadas, en una sola máquina de sobremesa.
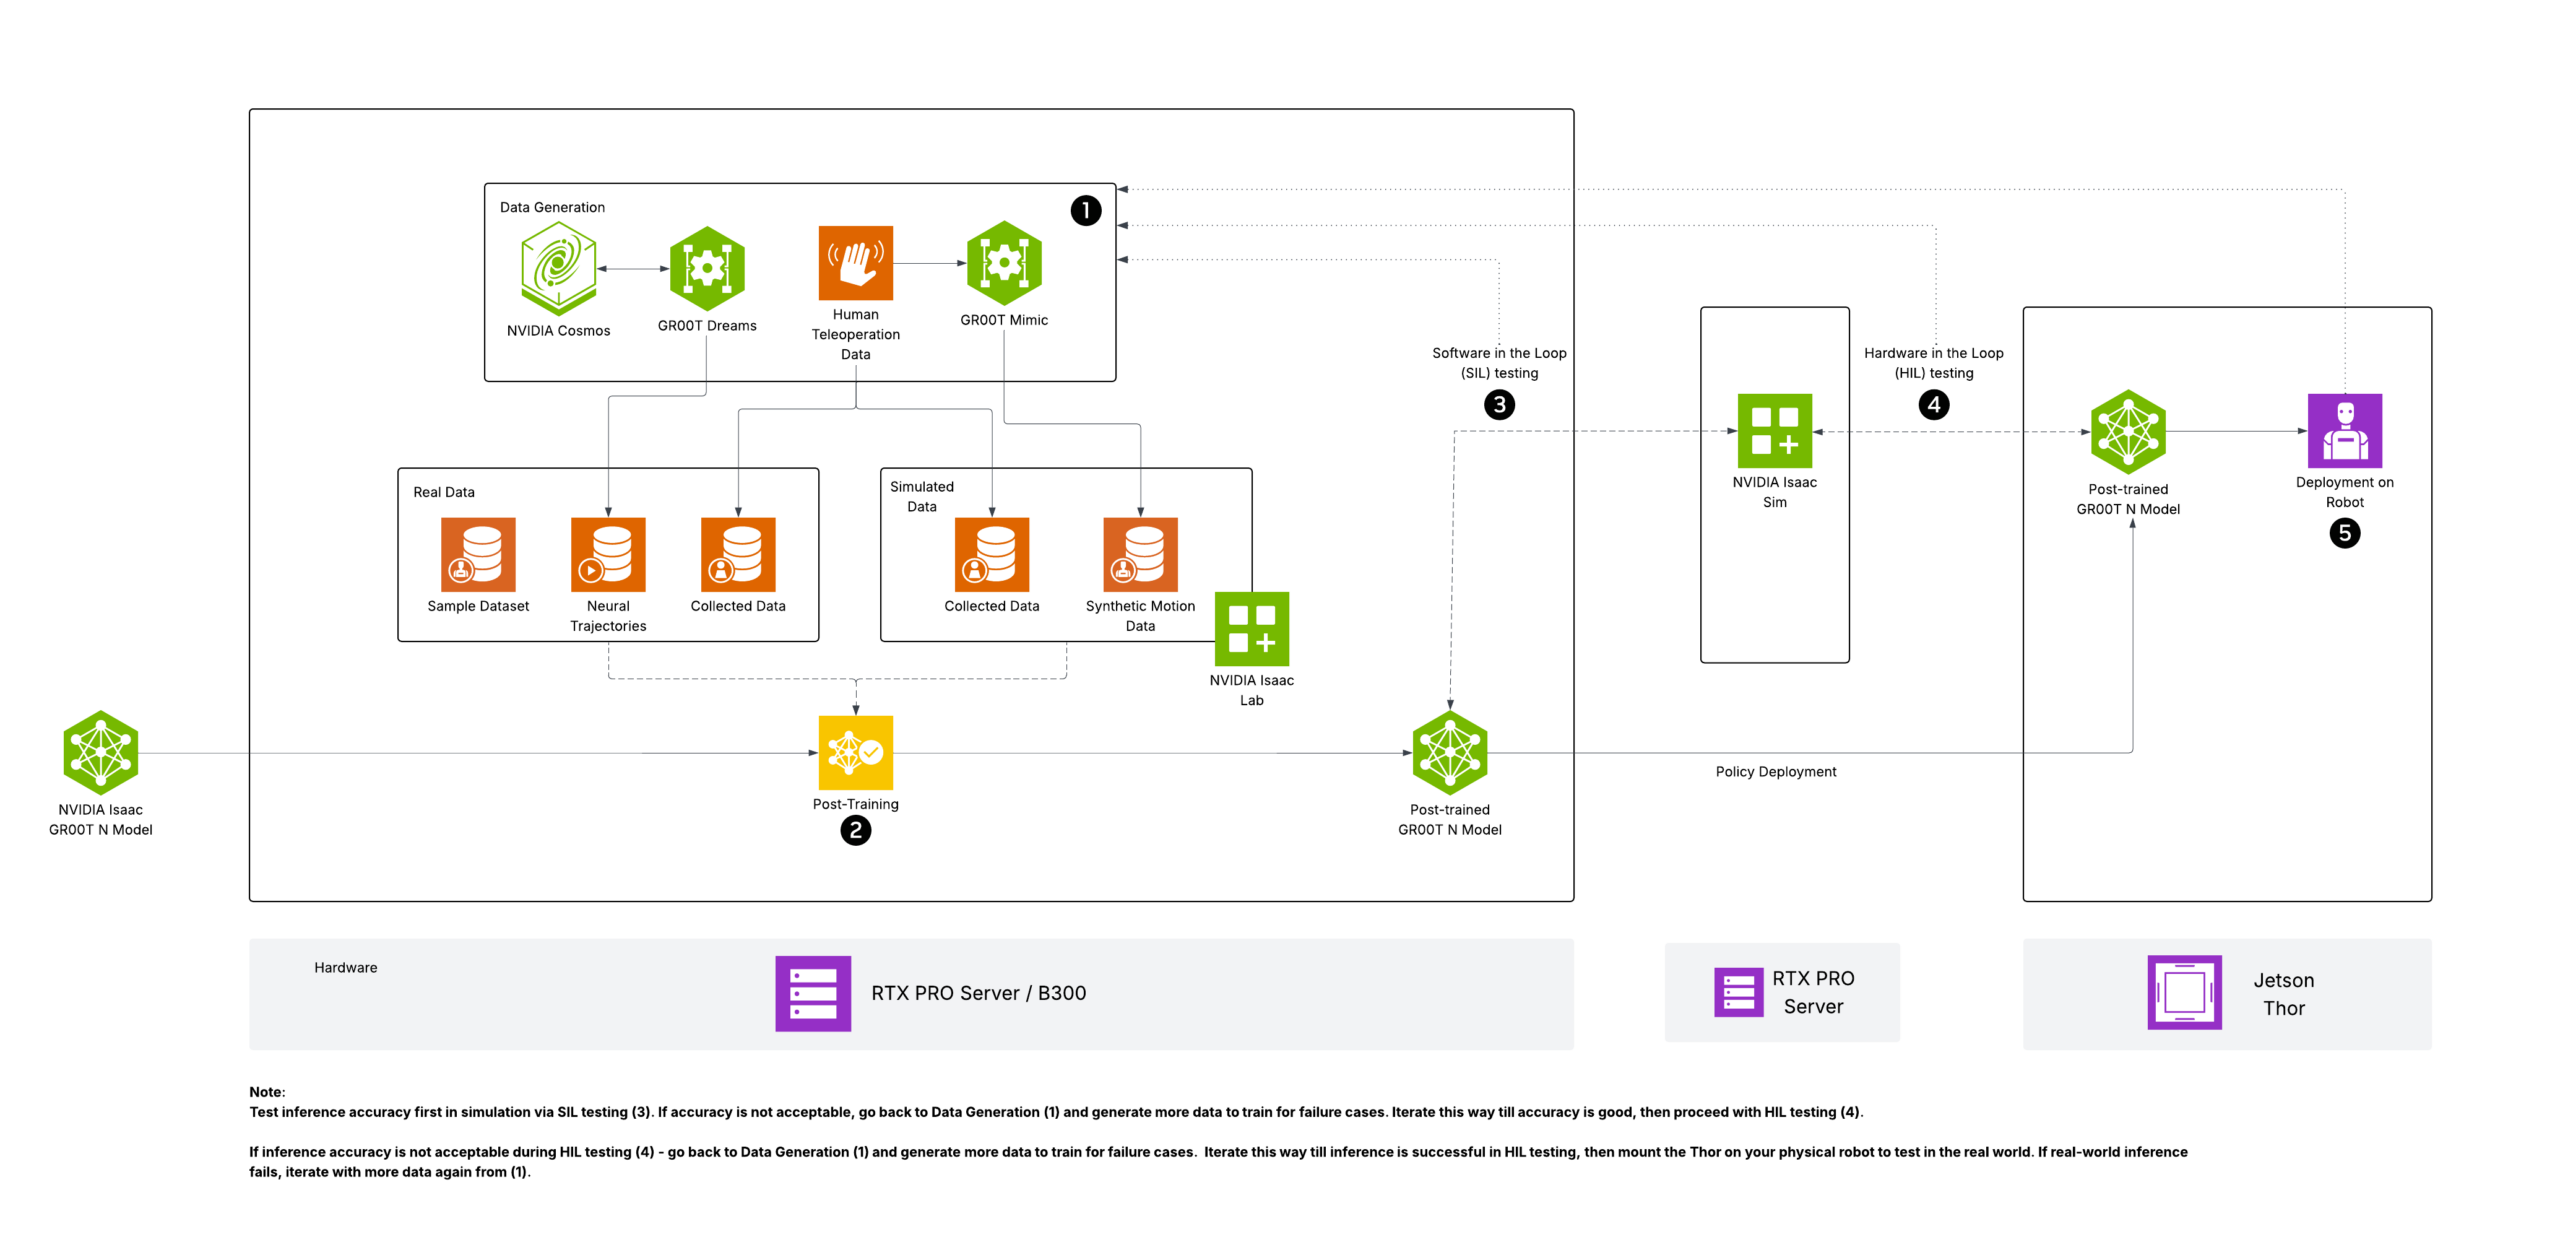
El proceso comienza con la teleoperación: un operador guía al robot a través de una tarea para capturar un pequeño conjunto de demostraciones del mundo real. Estos ejemplos se incorporan al flujo de trabajo de Isaac GR00T. La GPU RTX PRO opcional gestiona los requisitos gráficos y de trazado de rayos de Isaac Sim, mientras que Isaac Lab y GR00T-Mimic amplían las demostraciones originales a una colección mucho mayor de trayectorias sintéticas físicamente plausibles. Finalmente, el B300 ajusta el modelo GR00T utilizando el conjunto de datos combinado, tanto reales como sintéticos.
Fuente: NVIDIA
Tras el ajuste fino, la política resultante puede validarse en una simulación antes de implementarse en el robot para su evaluación en un entorno real. Esto crea un ciclo de desarrollo eficiente: se captura una demostración real, se reproduce y varía en la simulación, se reentrena el modelo y se prueba la política actualizada en el hardware. Para los equipos con acceso limitado a robots, operadores o ventanas de recopilación de datos, consolidar la simulación, la generación de datos sintéticos y el entrenamiento del modelo en un único sistema de escritorio puede reducir significativamente la complejidad de cada iteración.
Desarrollo del kernel de Blackwell Ultra
Sin embargo, podría decirse que el mejor caso de uso para la DGX Station es la optimización del kernel. Cuando un equipo escribe kernels CUDA o Triton para Blackwell Ultra, no hay nada como ejecutarlos en la arquitectura de destino. La WS300 pone un B300 y 252 GB de HBM3e al alcance del desarrollador, lo que permite perfilar cargas de trabajo reales, inspeccionar el comportamiento de la memoria, ajustar las rutas de Tensor Core, fusionar operaciones e iterar sin necesidad de un servidor de ocho GPU o un sistema a escala de rack.
Los sistemas de mayor tamaño siguen siendo importantes, pero pueden reservarse para tareas que los requieran: escalado de NVLink, operaciones colectivas de NCCL, núcleos de comunicación, inferencia multi-GPU y validación del rendimiento final. El WS300 gestiona localmente el trabajo del núcleo de una sola GPU, lo que permite que esos costosos sistemas compartidos estén disponibles para pruebas a mayor escala. Para un equipo centrado en la optimización de Blackwell Ultra, esta es una de las máquinas de desarrollo más directas que ofrece el mercado.
Si la estación DGX se hubiera distribuido junto con los primeros sistemas Blackwell Ultra, sospechamos que el suministro inicial se habría agotado casi de inmediato entre laboratorios de IA, equipos de compiladores, desarrolladores de motores de inferencia y otros grupos que se apresuraban a optimizar el software para B300. Incluso ahora, el acceso directo a la GPU de destino puede ser la razón más clara para que una organización adquiera una.
Rendimiento
Nota sobre las pruebas: Las pruebas se realizaron de forma remota en un sistema alojado por MSI, con StorageReview controlando todo el entorno de software durante el período de evaluación. El sistema se probó sin una GPU RTX PRO ni ninguna otra tarjeta de expansión PCIe instalada. Esto permitió que el GB300 Superchip utilizara toda la potencia de aceleración disponible del sistema durante las pruebas.
Máximos FLOPS alcanzables de Matmul (MAMF)
En primer lugar, para contextualizar la capacidad de cálculo del B300, ejecutamos MAMF en tres sistemas de la generación Blackwell. MAMF (Maximum Achievable Matmul FLOPS) es una métrica de rendimiento práctica diseñada para medir el número máximo real de operaciones de coma flotante por segundo que se pueden lograr en aceleradores de aprendizaje automático durante las operaciones de multiplicación de matrices, ofreciendo una referencia más precisa que el pico teórico de FLOPS que se suele anunciar en las especificaciones de hardware.
Para esta prueba, analizamos cada uno de los 3 sistemas en BF16, FP8 y NVFP4, e informamos el mejor resultado sostenido (denso) por precisión.
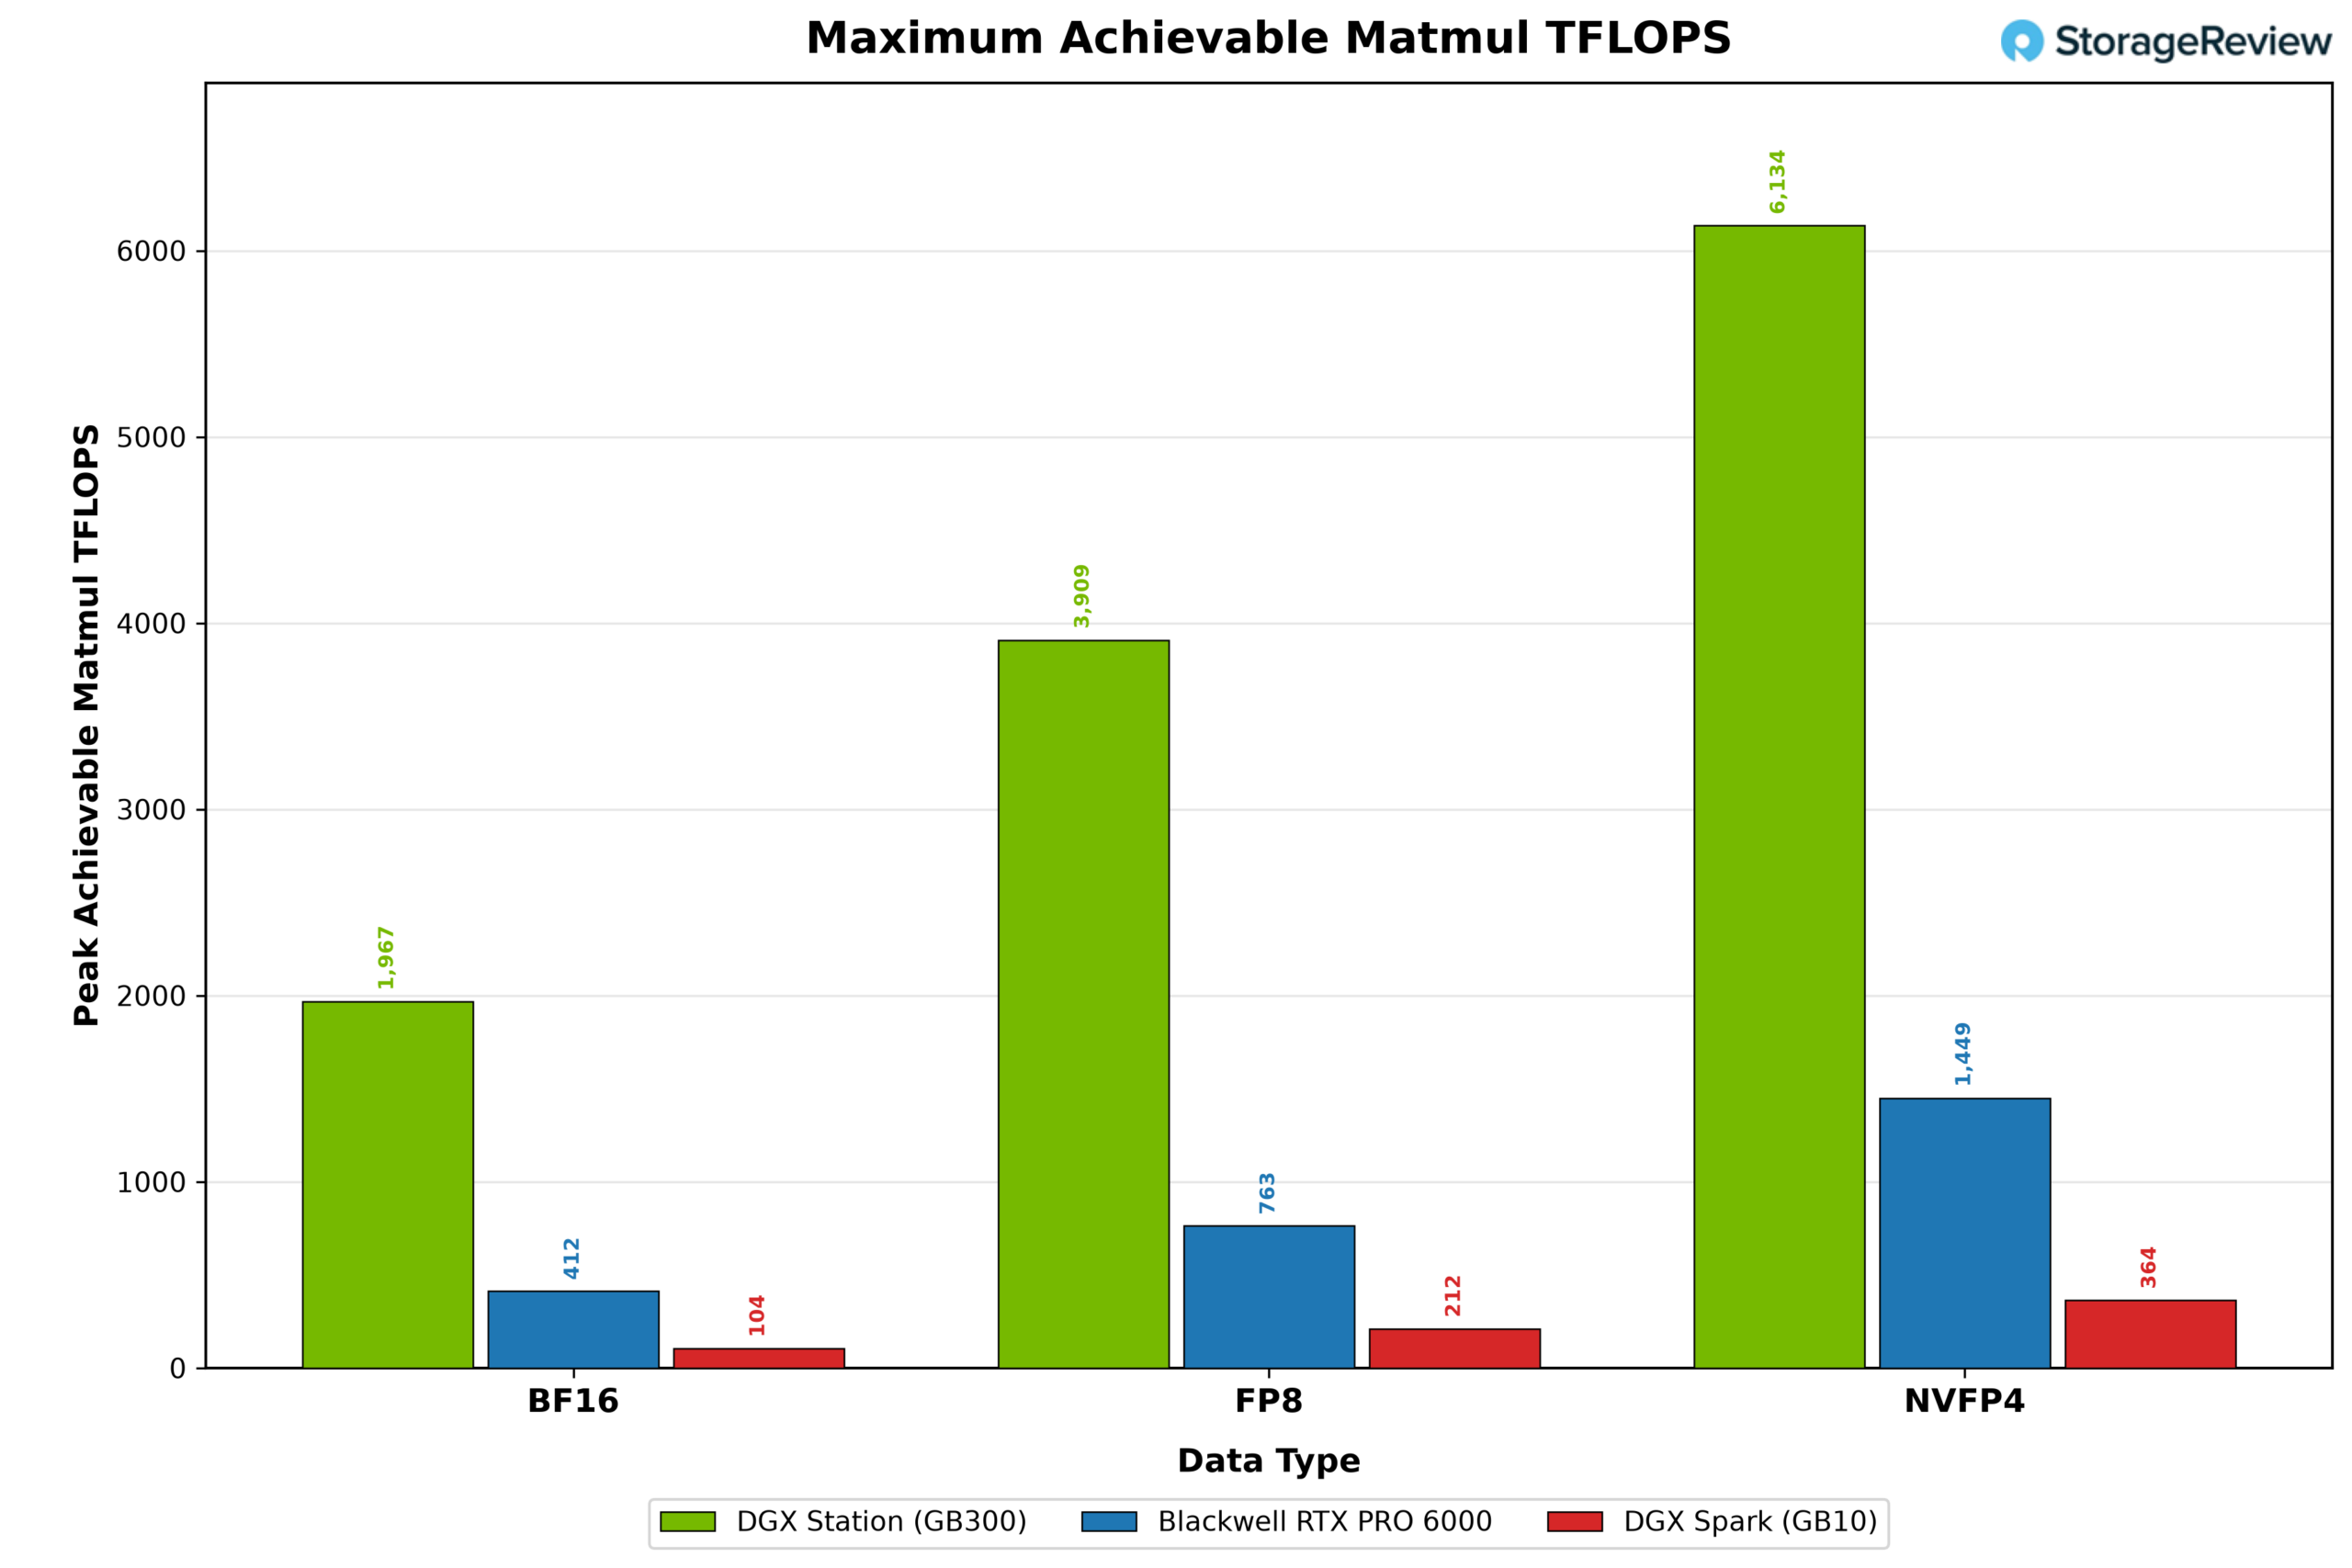
La GB300 lidera en todas las precisiones. En BF16, alcanza 1,967 TFLOPS frente a 412 en la RTX PRO 6000 y 104 en la DGX Spark . FP8 sigue el mismo patrón: 3,909, 763 y 211. NVFP4 lleva a la GB300 a 6,134 TFLOPS, con la RTX PRO 6000 en 1,449 y la Spark en 364. Las proporciones son notablemente estables en las tres precisiones: la GB300 mantiene una ventaja de 4 a 5 veces sobre la RTX PRO 6000 y de 17 a 19 veces sobre la Spark, mientras que la RTX PRO 6000 mantiene aproximadamente 4 veces sobre la Spark.
Ancho de banda NV
El rendimiento de cálculo bruto solo es útil si el acelerador puede suministrar datos a sus unidades de ejecución. Esto es especialmente importante para la inferencia de IA, donde la generación de tokens durante la fase de decodificación suele estar más limitada por el ancho de banda de la memoria que por las operaciones de punto flotante (FLOPS) disponibles.
En el GB300 Superchip, esa jerarquía abarca la memoria HBM3e local del B300, la memoria LPDDR5X de Grace y la interconexión NVLink-C2C que las conecta. La utilidad NVBandwidth de NVIDIA prueba las diferentes rutas de copia a través de esos componentes, mostrando tanto el ancho de banda disponible dentro de la GPU como el costo de mover datos entre los dominios de memoria de la GPU y la CPU.
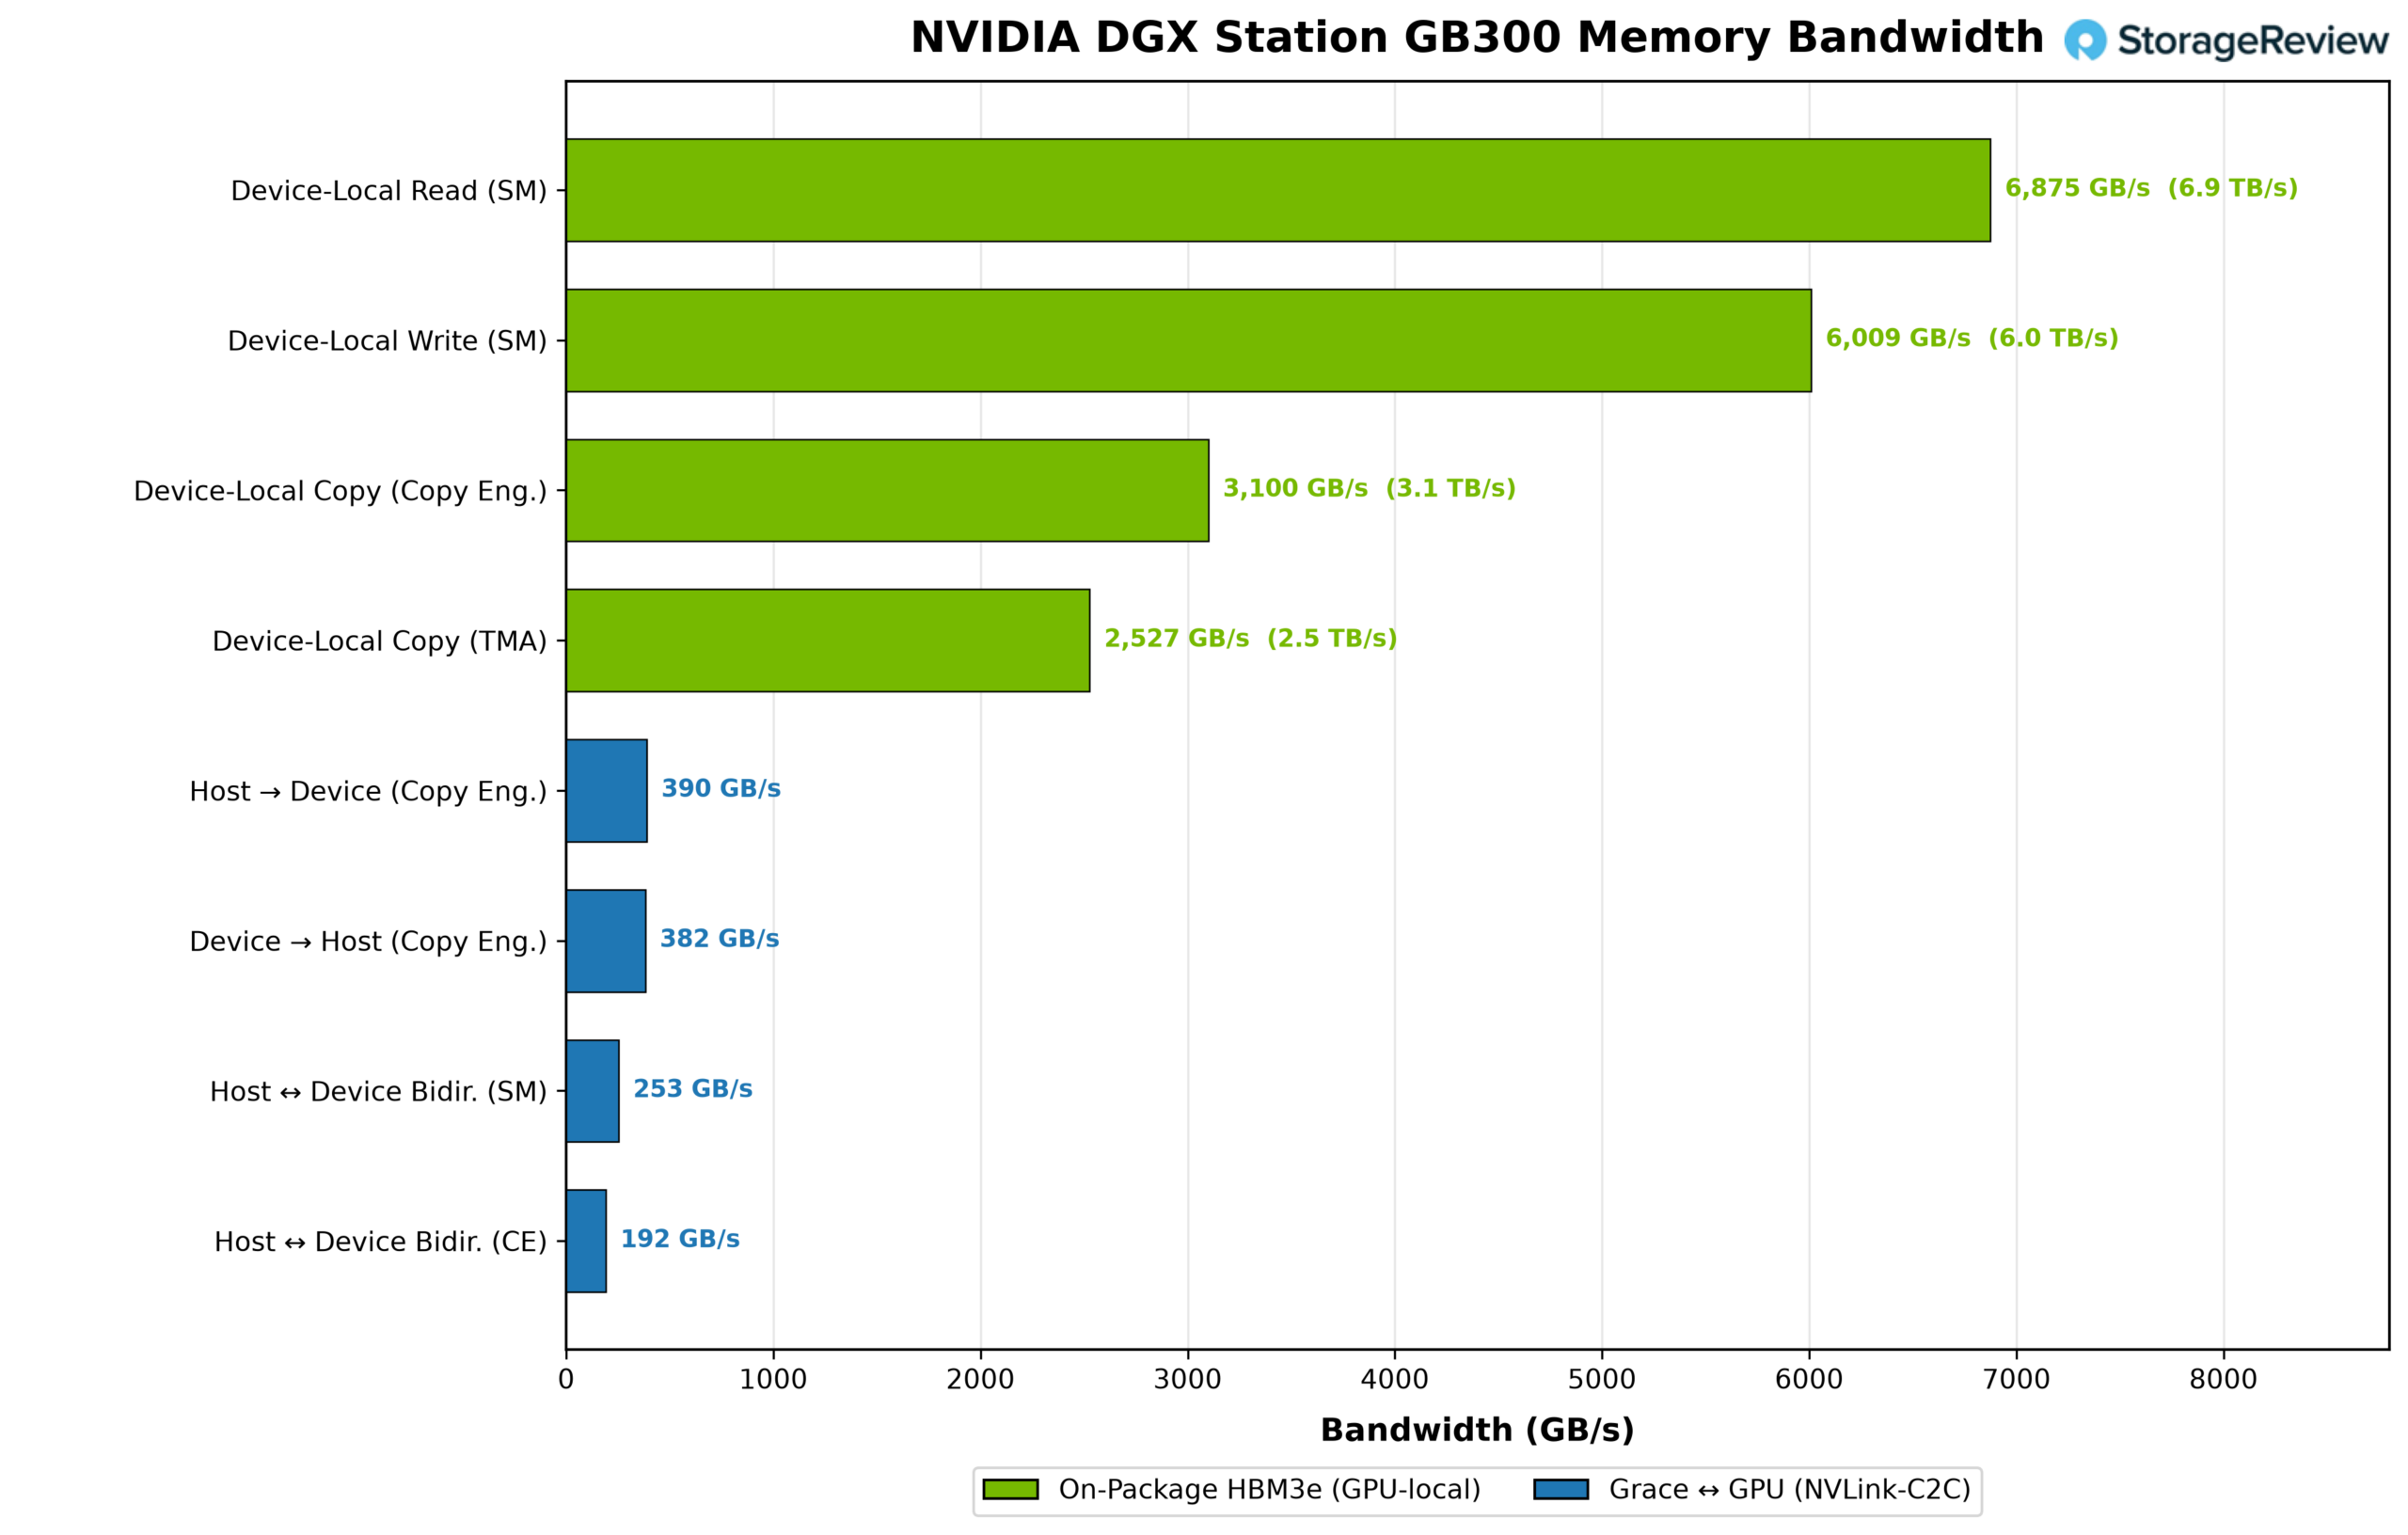
Las primeras cuatro pruebas miden el movimiento de datos dentro de los 252 GB de HBM3e de la B300. Las lecturas locales del dispositivo alcanzan los 6,875 GB/s, o aproximadamente 6.9 TB/s, lo que sitúa el resultado a pocos puntos porcentuales del ancho de banda de memoria nominal de la GPU de 7.1 TB/s. Las escrituras locales del dispositivo alcanzan los 6,009 GB/s.
Las operaciones de copia de HBM a HBM son más lentas porque cada copia consume ancho de banda dos veces: una para leer el origen y otra para escribir en el destino. Los motores de copia dedicados alcanzan los 3,100 GB/s, mientras que el acelerador de memoria Tensor registra 2,527 GB/s.
Las pruebas restantes atraviesan NVLink-C2C y acceden a los 496 GB de memoria LPDDR5X de Grace. Las transferencias desde la memoria Grace a la HBM B300 alcanzan los 390 GB/s, mientras que las transferencias en sentido contrario alcanzan los 382 GB/s. Aunque NVLink-C2C proporciona hasta 900 GB/s de ancho de banda coherente entre la CPU y la GPU, las transferencias medidas están limitadas por el ancho de banda de la memoria LPDDR5X de Grace (396 GB/s). Las transferencias bidireccionales evidencian aún más esta limitación. El tráfico simultáneo alcanza los 253 GB/s mediante copias basadas en SM y los 192 GB/s a través de los motores de copia.
Inferencia
Una vez realizadas las pruebas de bajo nivel, pasamos a la inferencia LLM. Aquí, el enfoque cambia de los valores máximos a los tokens por segundo, el tiempo hasta el primer token y la latencia bajo carga, lo que nos permite comprender mejor cómo se comporta el WS300 como sistema de servidor.
Comencemos con la capacidad principal del GB300 Superchip: dar servicio a modelos que se encuentran a ambos lados del límite de capacidad de 252 GB de HBM3e del B300. Aquí es donde su grupo de memoria coherente de 748 GB cobra mayor importancia. Los cinco puntos de control progresan desde dos modelos que se ajustan cómodamente a la HBM, pasando por uno que nominalmente se ajusta pero deja muy poco margen para la caché de tiempo de ejecución y KV, hasta llegar a dos que deben descargar porciones sustanciales de sus pesos a la memoria Grace.
Nota: En los casos en que se menciona, los modelos se ejecutaron con decodificación especulativa para obtener un mayor rendimiento de decodificación, con la cantidad de tokens de aceptación forzada establecida en la cantidad de tokens de decodificación especulativa. Por lo tanto, los resultados muestran el mejor rendimiento posible; en el servicio real, el rendimiento es dinámico y depende de la calidad de los tokens de decodificación especulativa.
Modelos que se ajustan completamente a HBM
DeepSeek v4 Flash (0731)
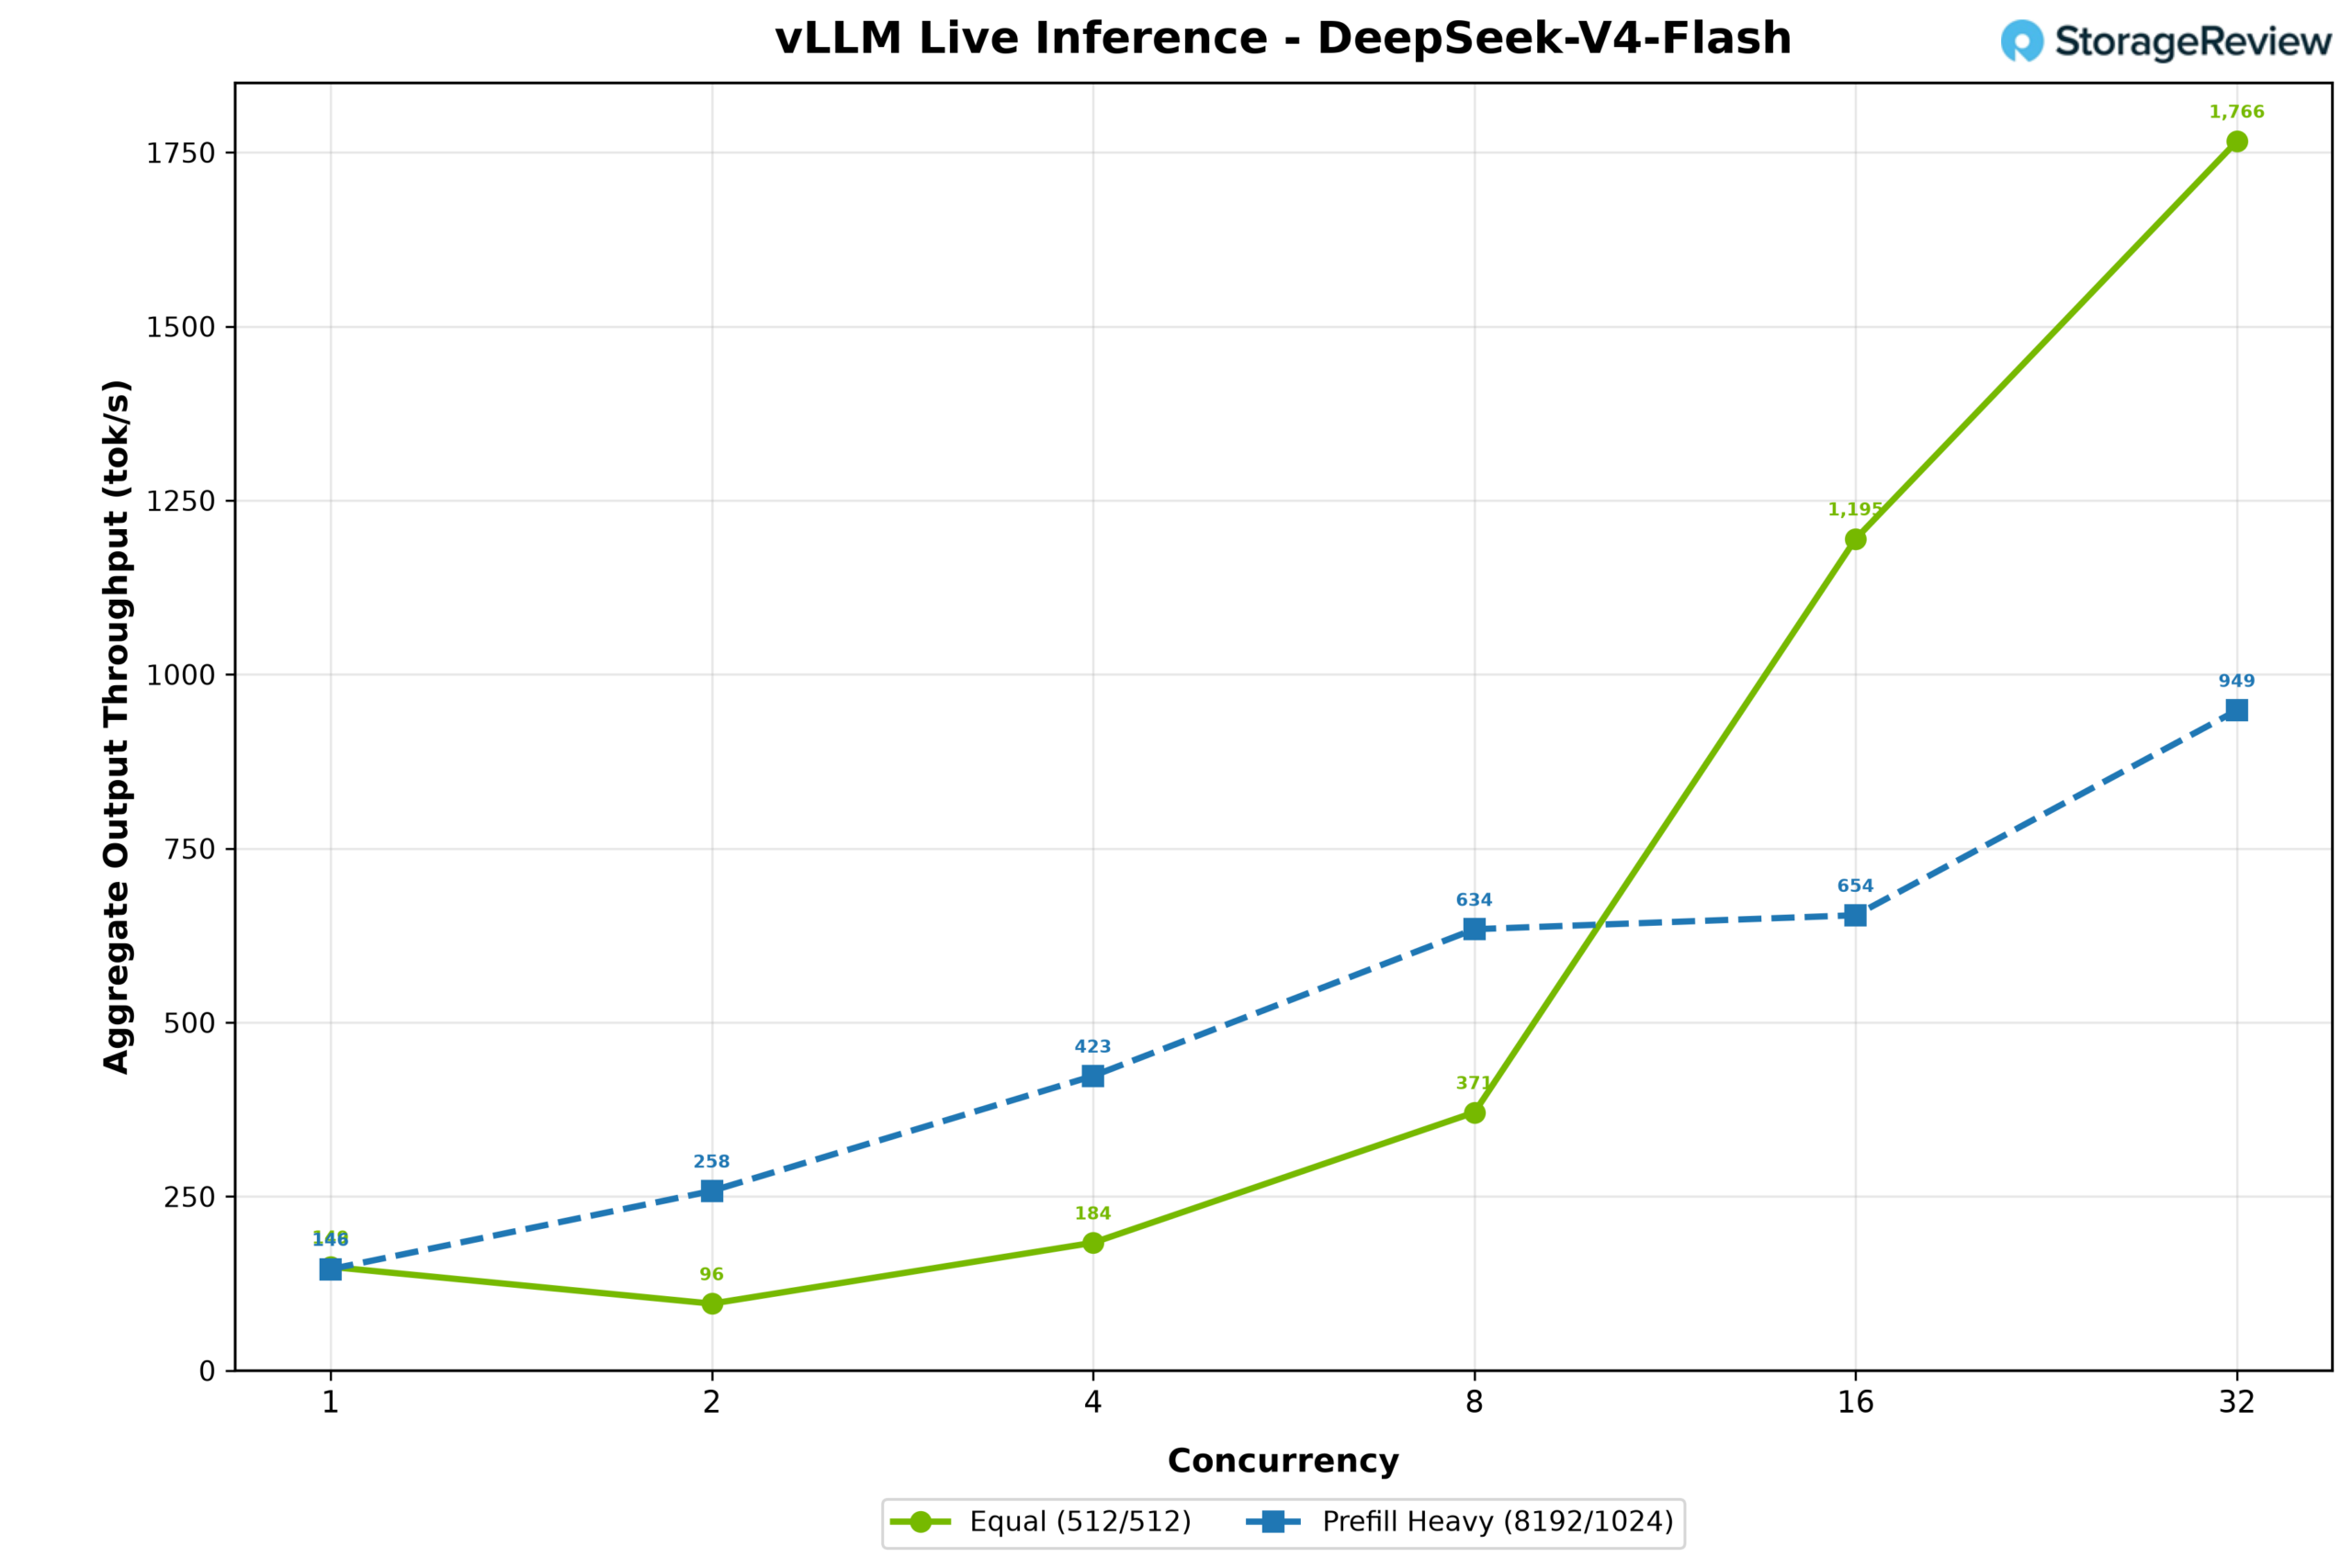
En primer lugar, probamos la popularísima DeepSeek v4 Flash (0731), que consume 14+6 GB de memoria como punto de control FP8 nativo. Este modelo es conocido por su gran eficiencia y facilidad de ejecución, tal como pudimos comprobar en la estación DGX. En la carga de trabajo 512/512, el rendimiento inicial fue de 149 tokens por segundo con una concurrencia de 1, aumentando rápidamente hasta 1,766 con una concurrencia de 32. La carga de trabajo con precarga de datos escaló de 146 a 949 tokens por segundo.
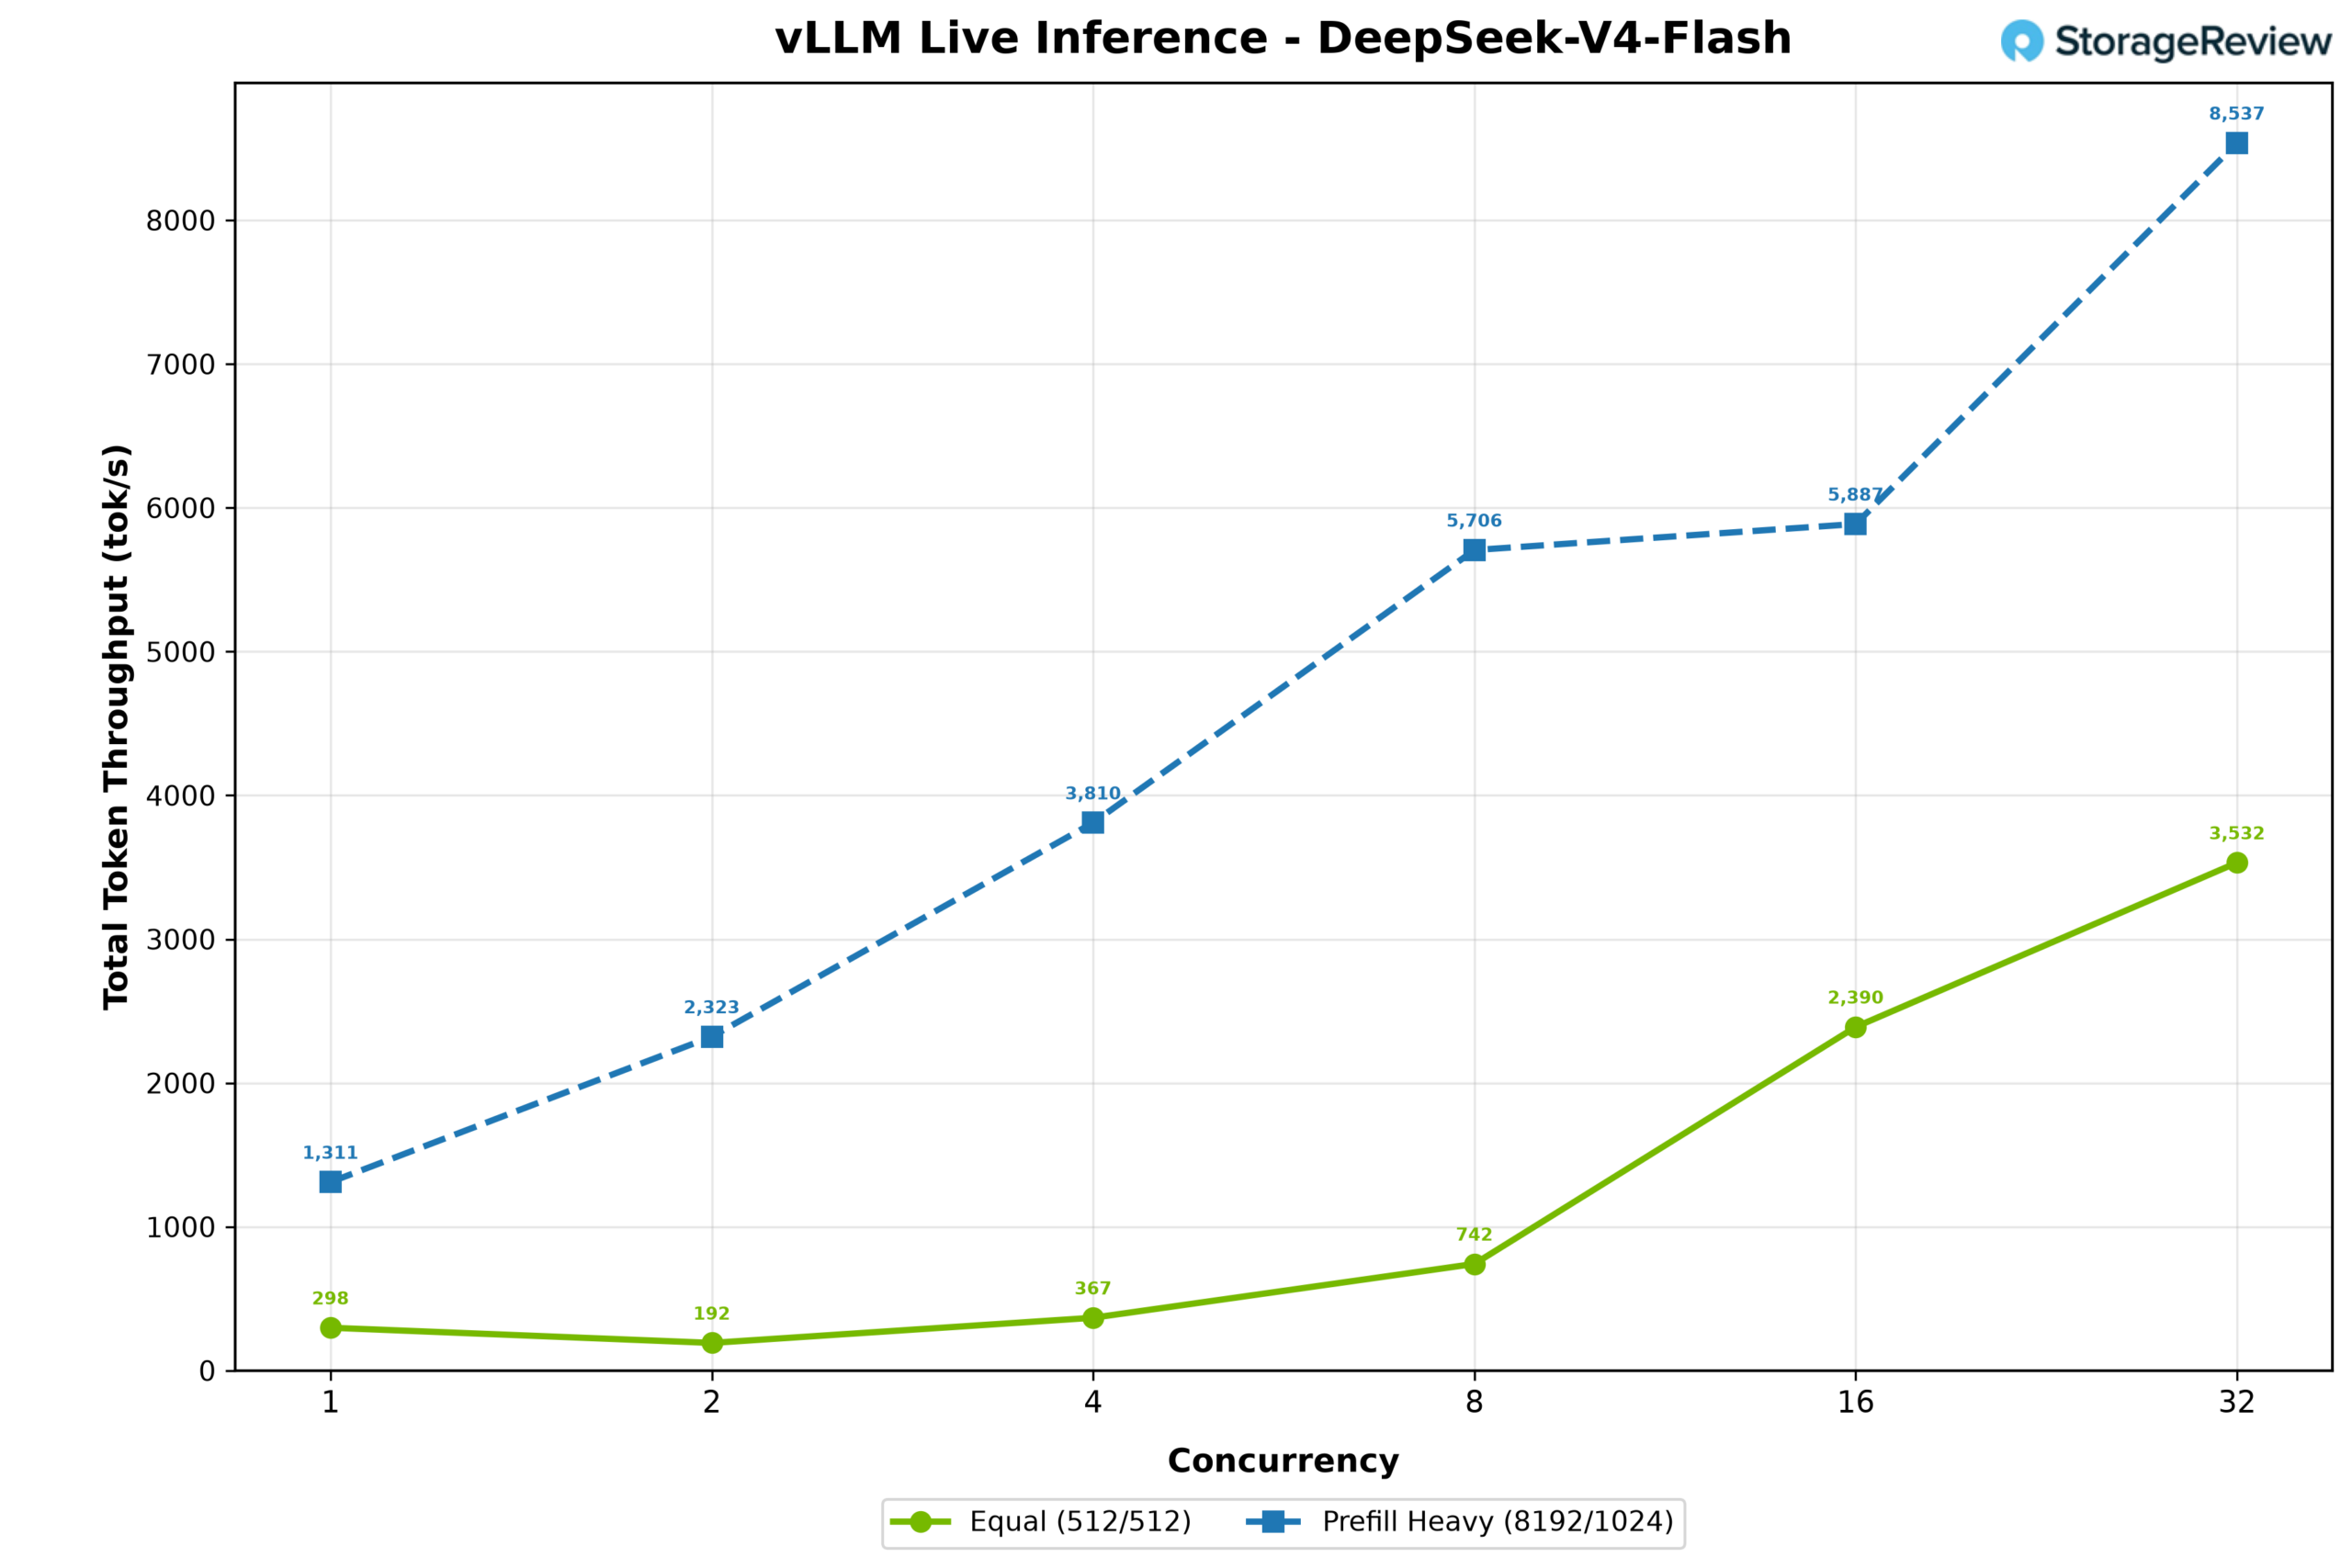
El rendimiento total de tokens aumentó al mismo ritmo, con la carga de trabajo 512/512 pasando de 298 a 3,532 tokens por segundo y la carga de trabajo con prellenado aumentando de 1,311 a 8,537.
MiniMax M2.7 (NVFP4)
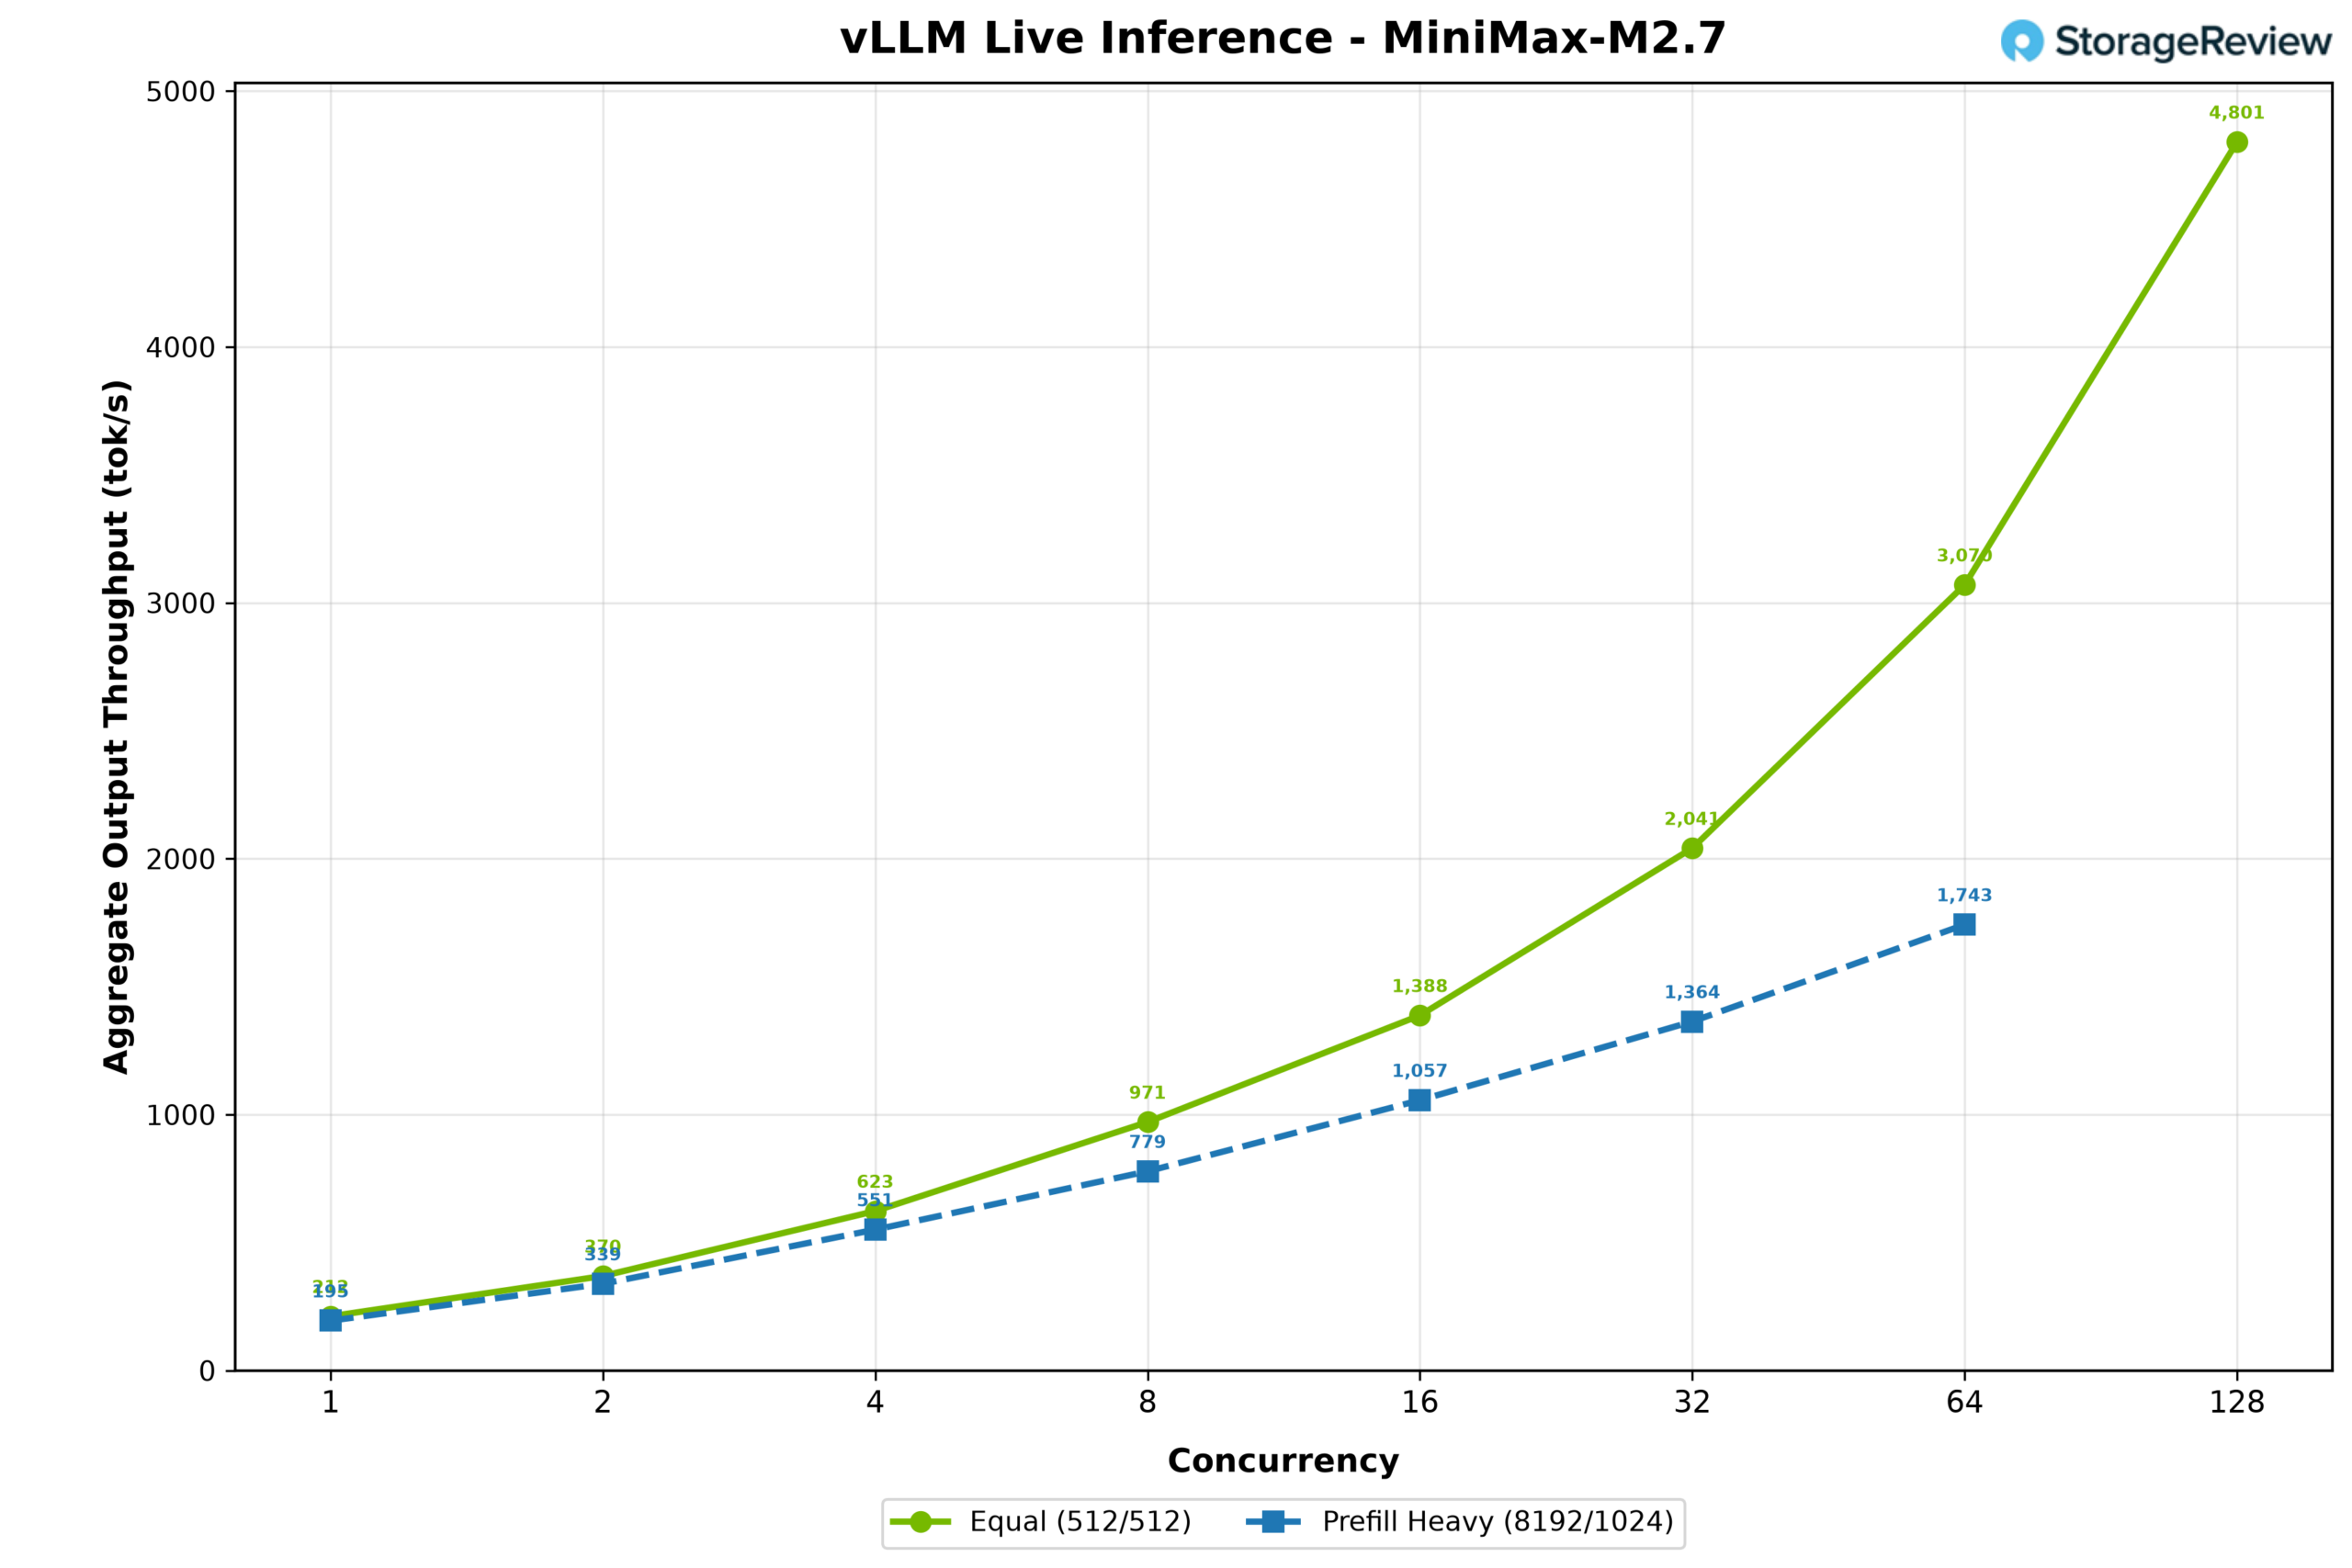
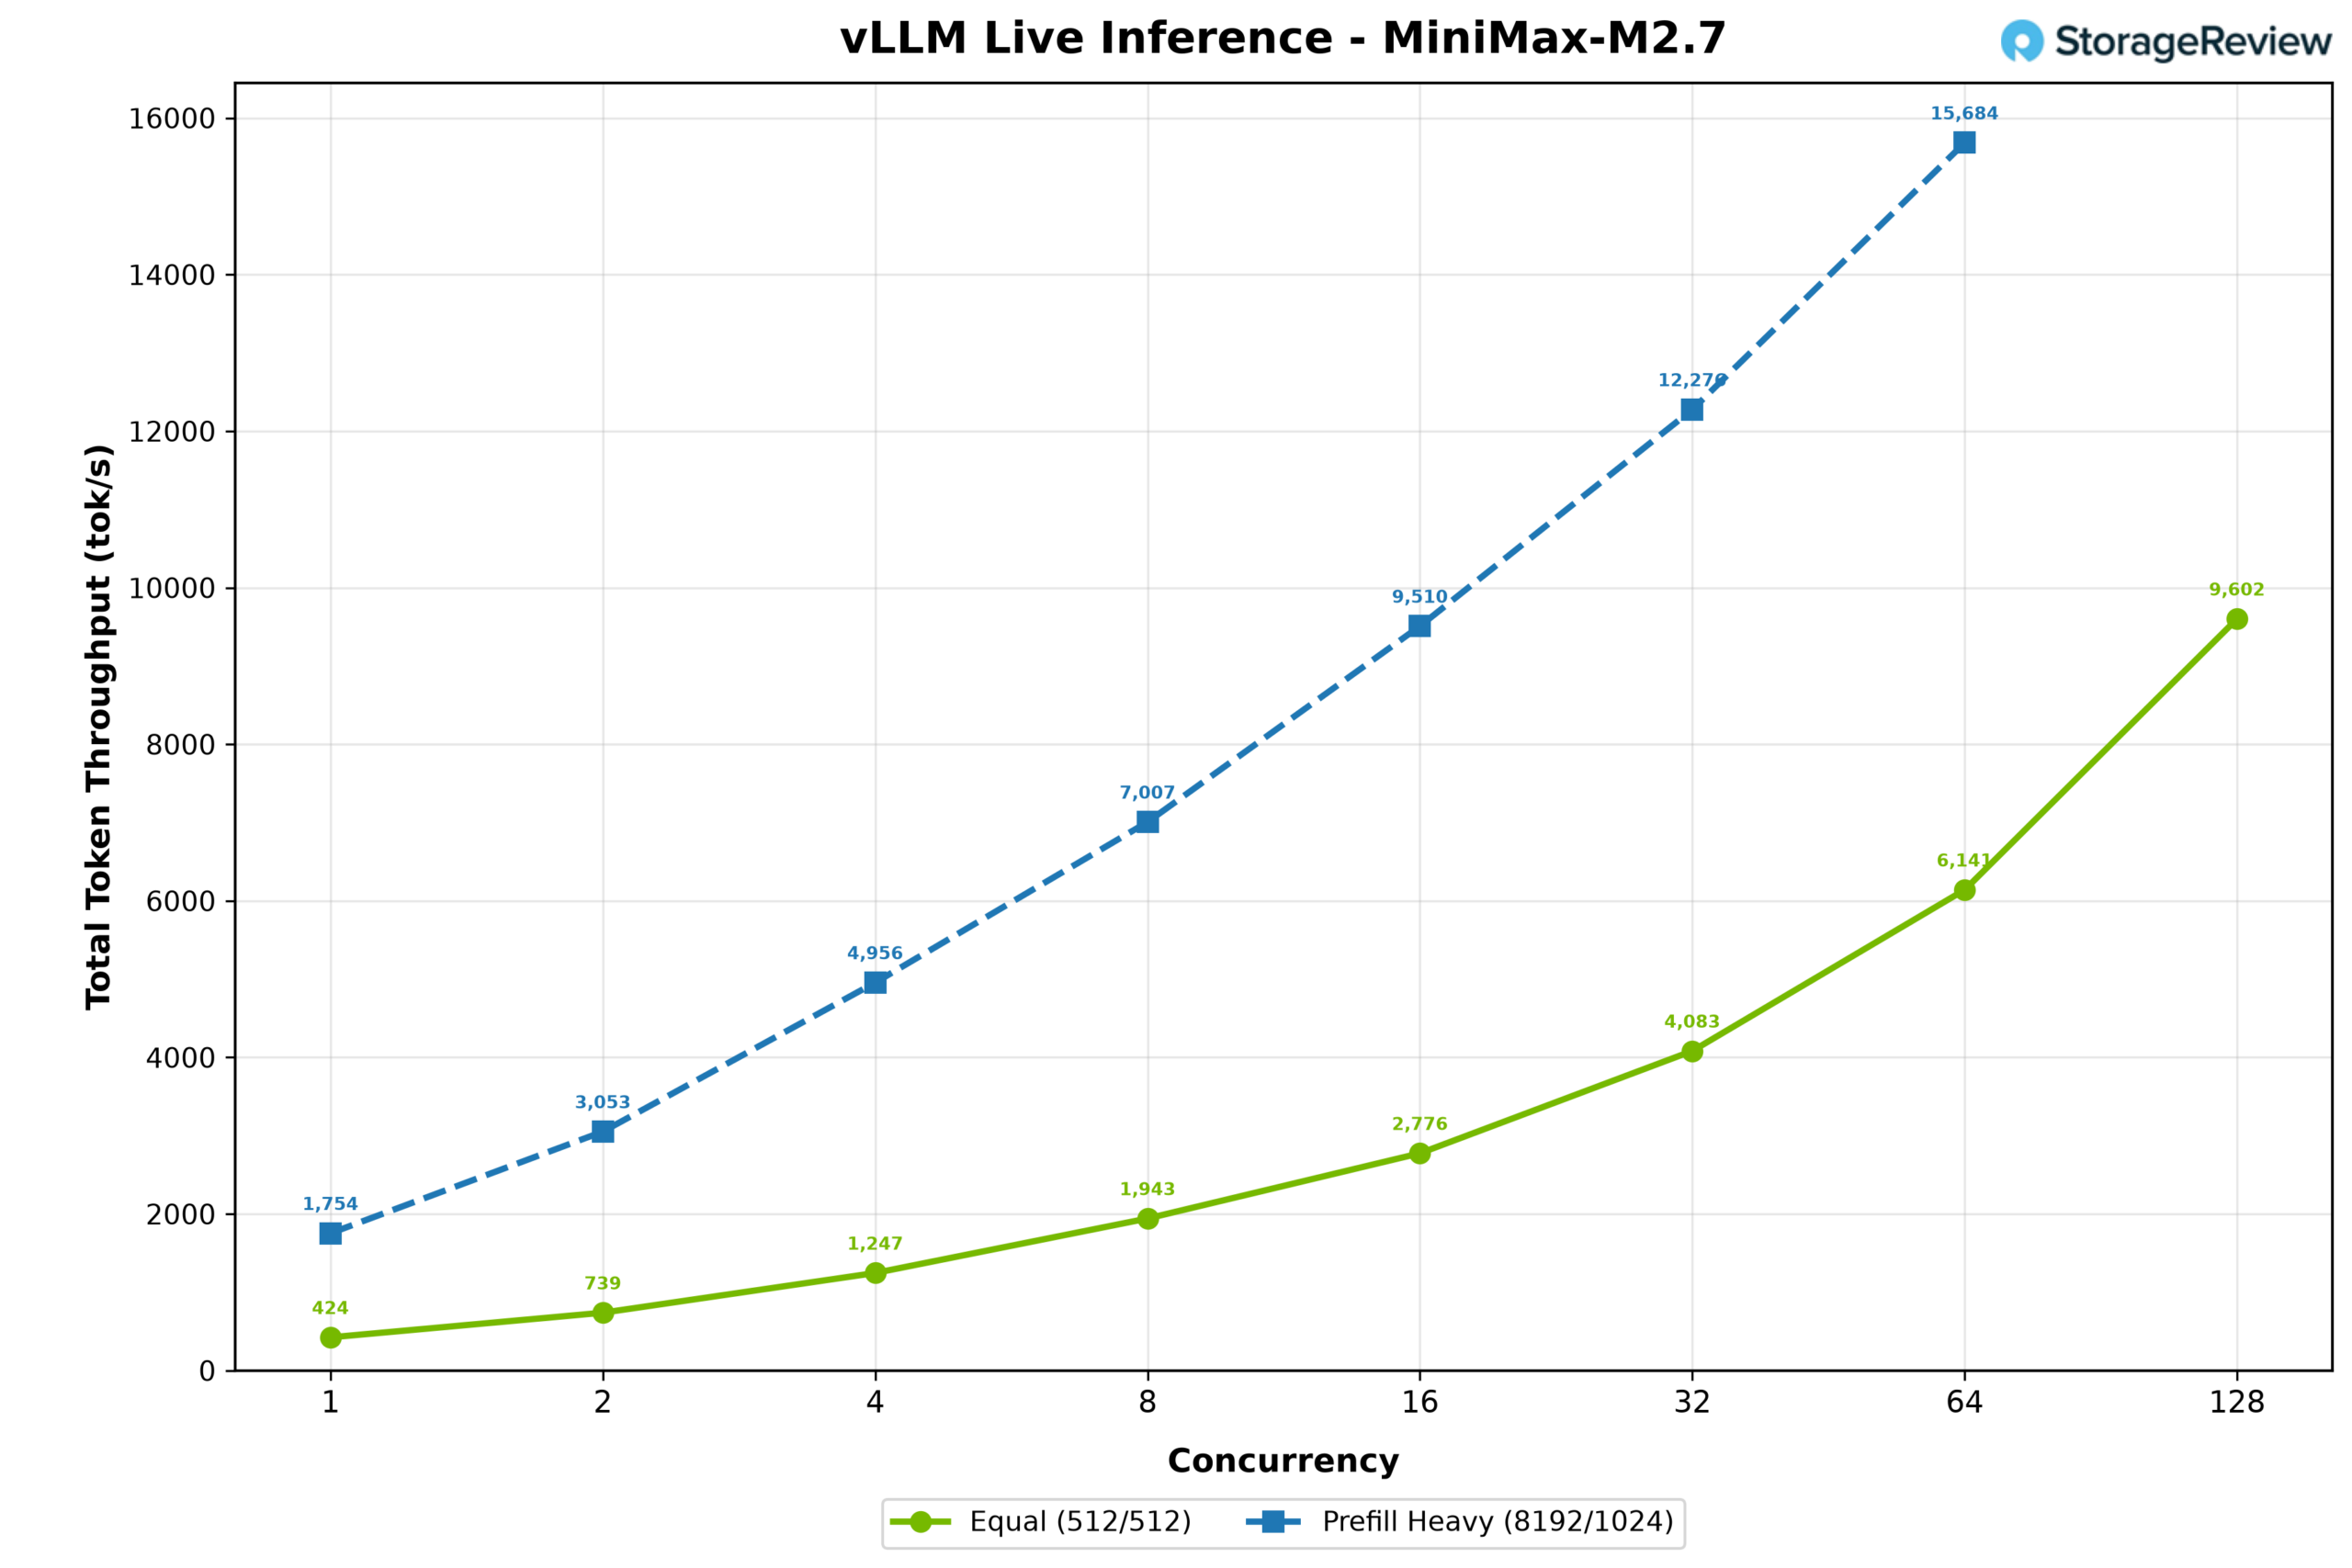
A continuación, presentamos MiniMax M2.7, uno de nuestros modelos favoritos, probado con la tecnología NVFP4 quant de NVIDIA, que ocupa 125 GB de VRAM. En la carga de trabajo 512/512, el rendimiento de salida comenzó en 193 tokens por segundo con una concurrencia de 1 y escaló rápidamente a 4,801 tokens por segundo con una concurrencia de 128. La carga de trabajo con precarga aumentó de 195 tokens por segundo con una concurrencia de 1 a 1,743 tokens por segundo con una concurrencia de 64. El rendimiento total de tokens mostró la tendencia opuesta: la carga de trabajo con precarga aumentó de 1,754 a 15 684 tokens por segundo con una concurrencia de 64, mientras que la carga de trabajo 512/512 escaló de 424 a 9,602 tokens por segundo con una concurrencia de 128.
El rendimiento total de tokens mostró la tendencia opuesta: la carga de trabajo con precarga aumentó de 1,754 a 15 684 tokens por segundo con una concurrencia de 64, mientras que la carga de trabajo 512/512 escaló de 424 a 9,602 tokens por segundo con una concurrencia de 128.
Modelos que apenas caben en HBM
MiniMax M3 (NVFP4)
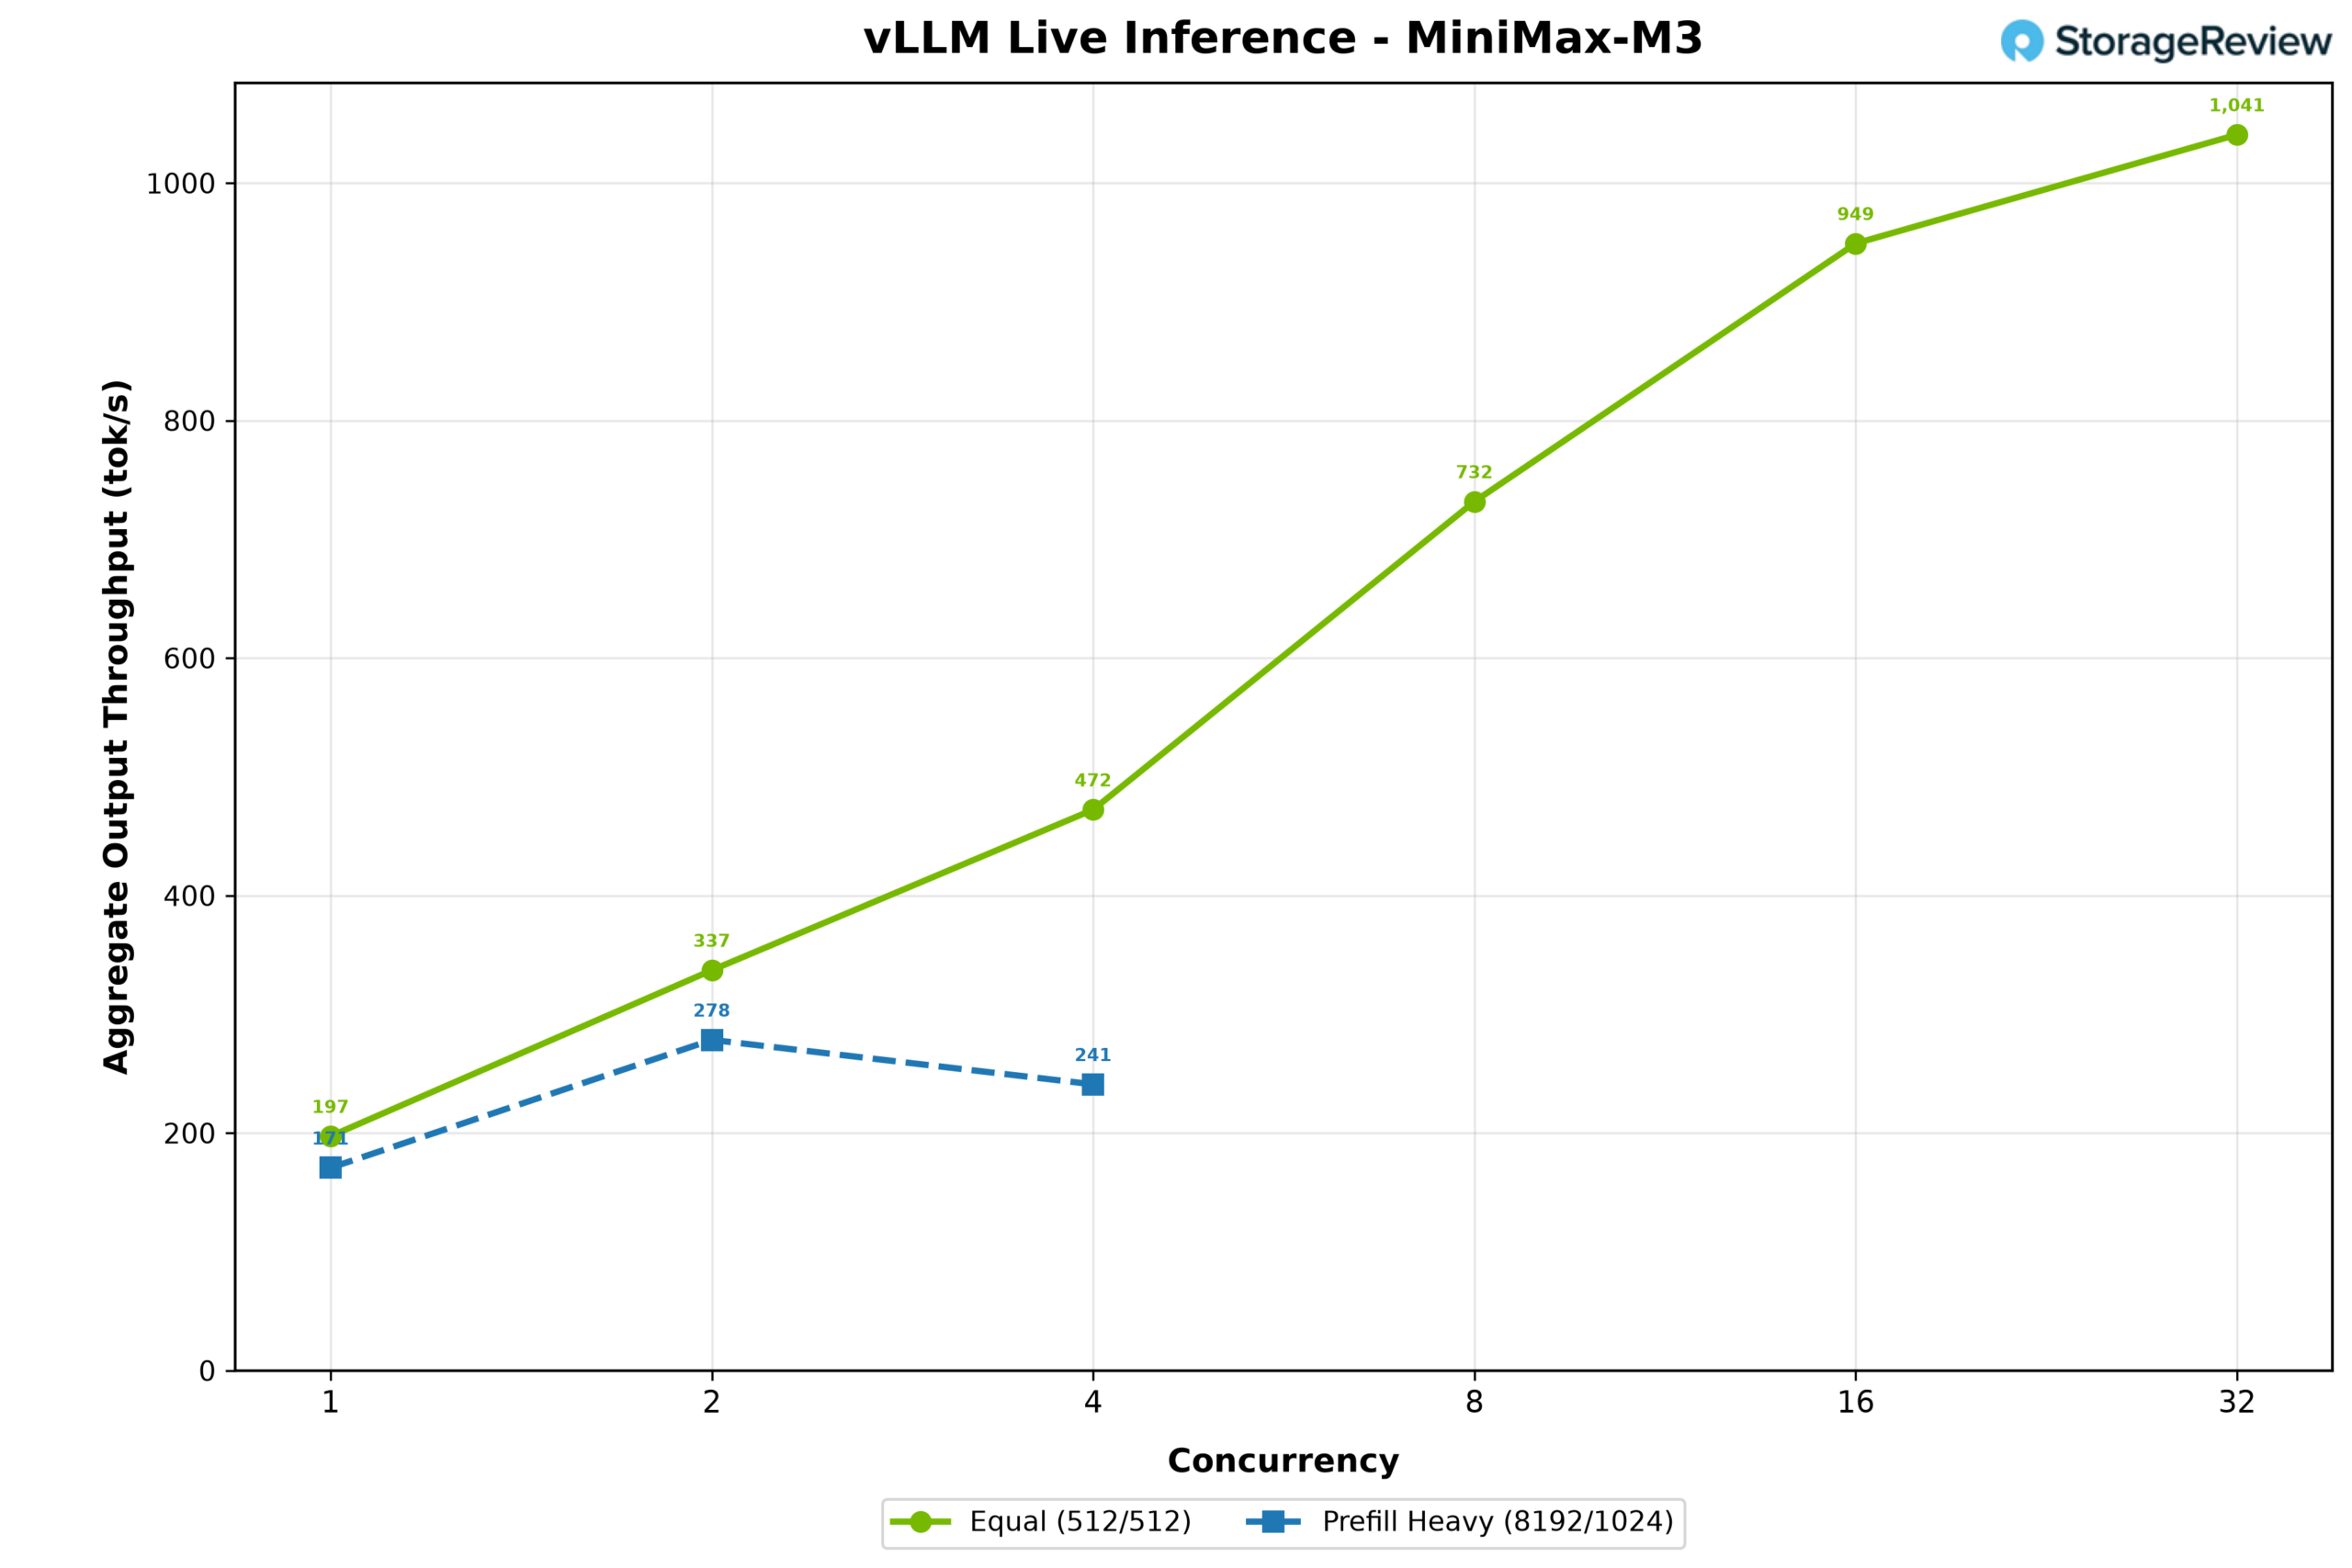
MiniMax M3 muestra lo que significa apenas caber en la práctica. Su punto de control NVFP4 de 233 GB es más pequeño que los 252 GB de HBM del B300, pero el modelo aún necesita espacio para el tiempo de ejecución y la caché KV. Finalmente ocupó 223 GB de HBM, con 21 GB de expertos descargados a Grace. Se utilizó la decodificación especulativa EAGLE3-GQA con una longitud de aceptación sintética de 3 tokens. En la carga de trabajo 512/512, el rendimiento de salida comenzó en 197 tokens por segundo en concurrencia 1 y escaló constantemente a 1,041 tokens por segundo en concurrencia 32. La carga de trabajo con prellenado intensivo aumentó de 171 tokens por segundo en concurrencia 1 a un pico de 278 en concurrencia 2 antes de disminuir a 241 en concurrencia 4.
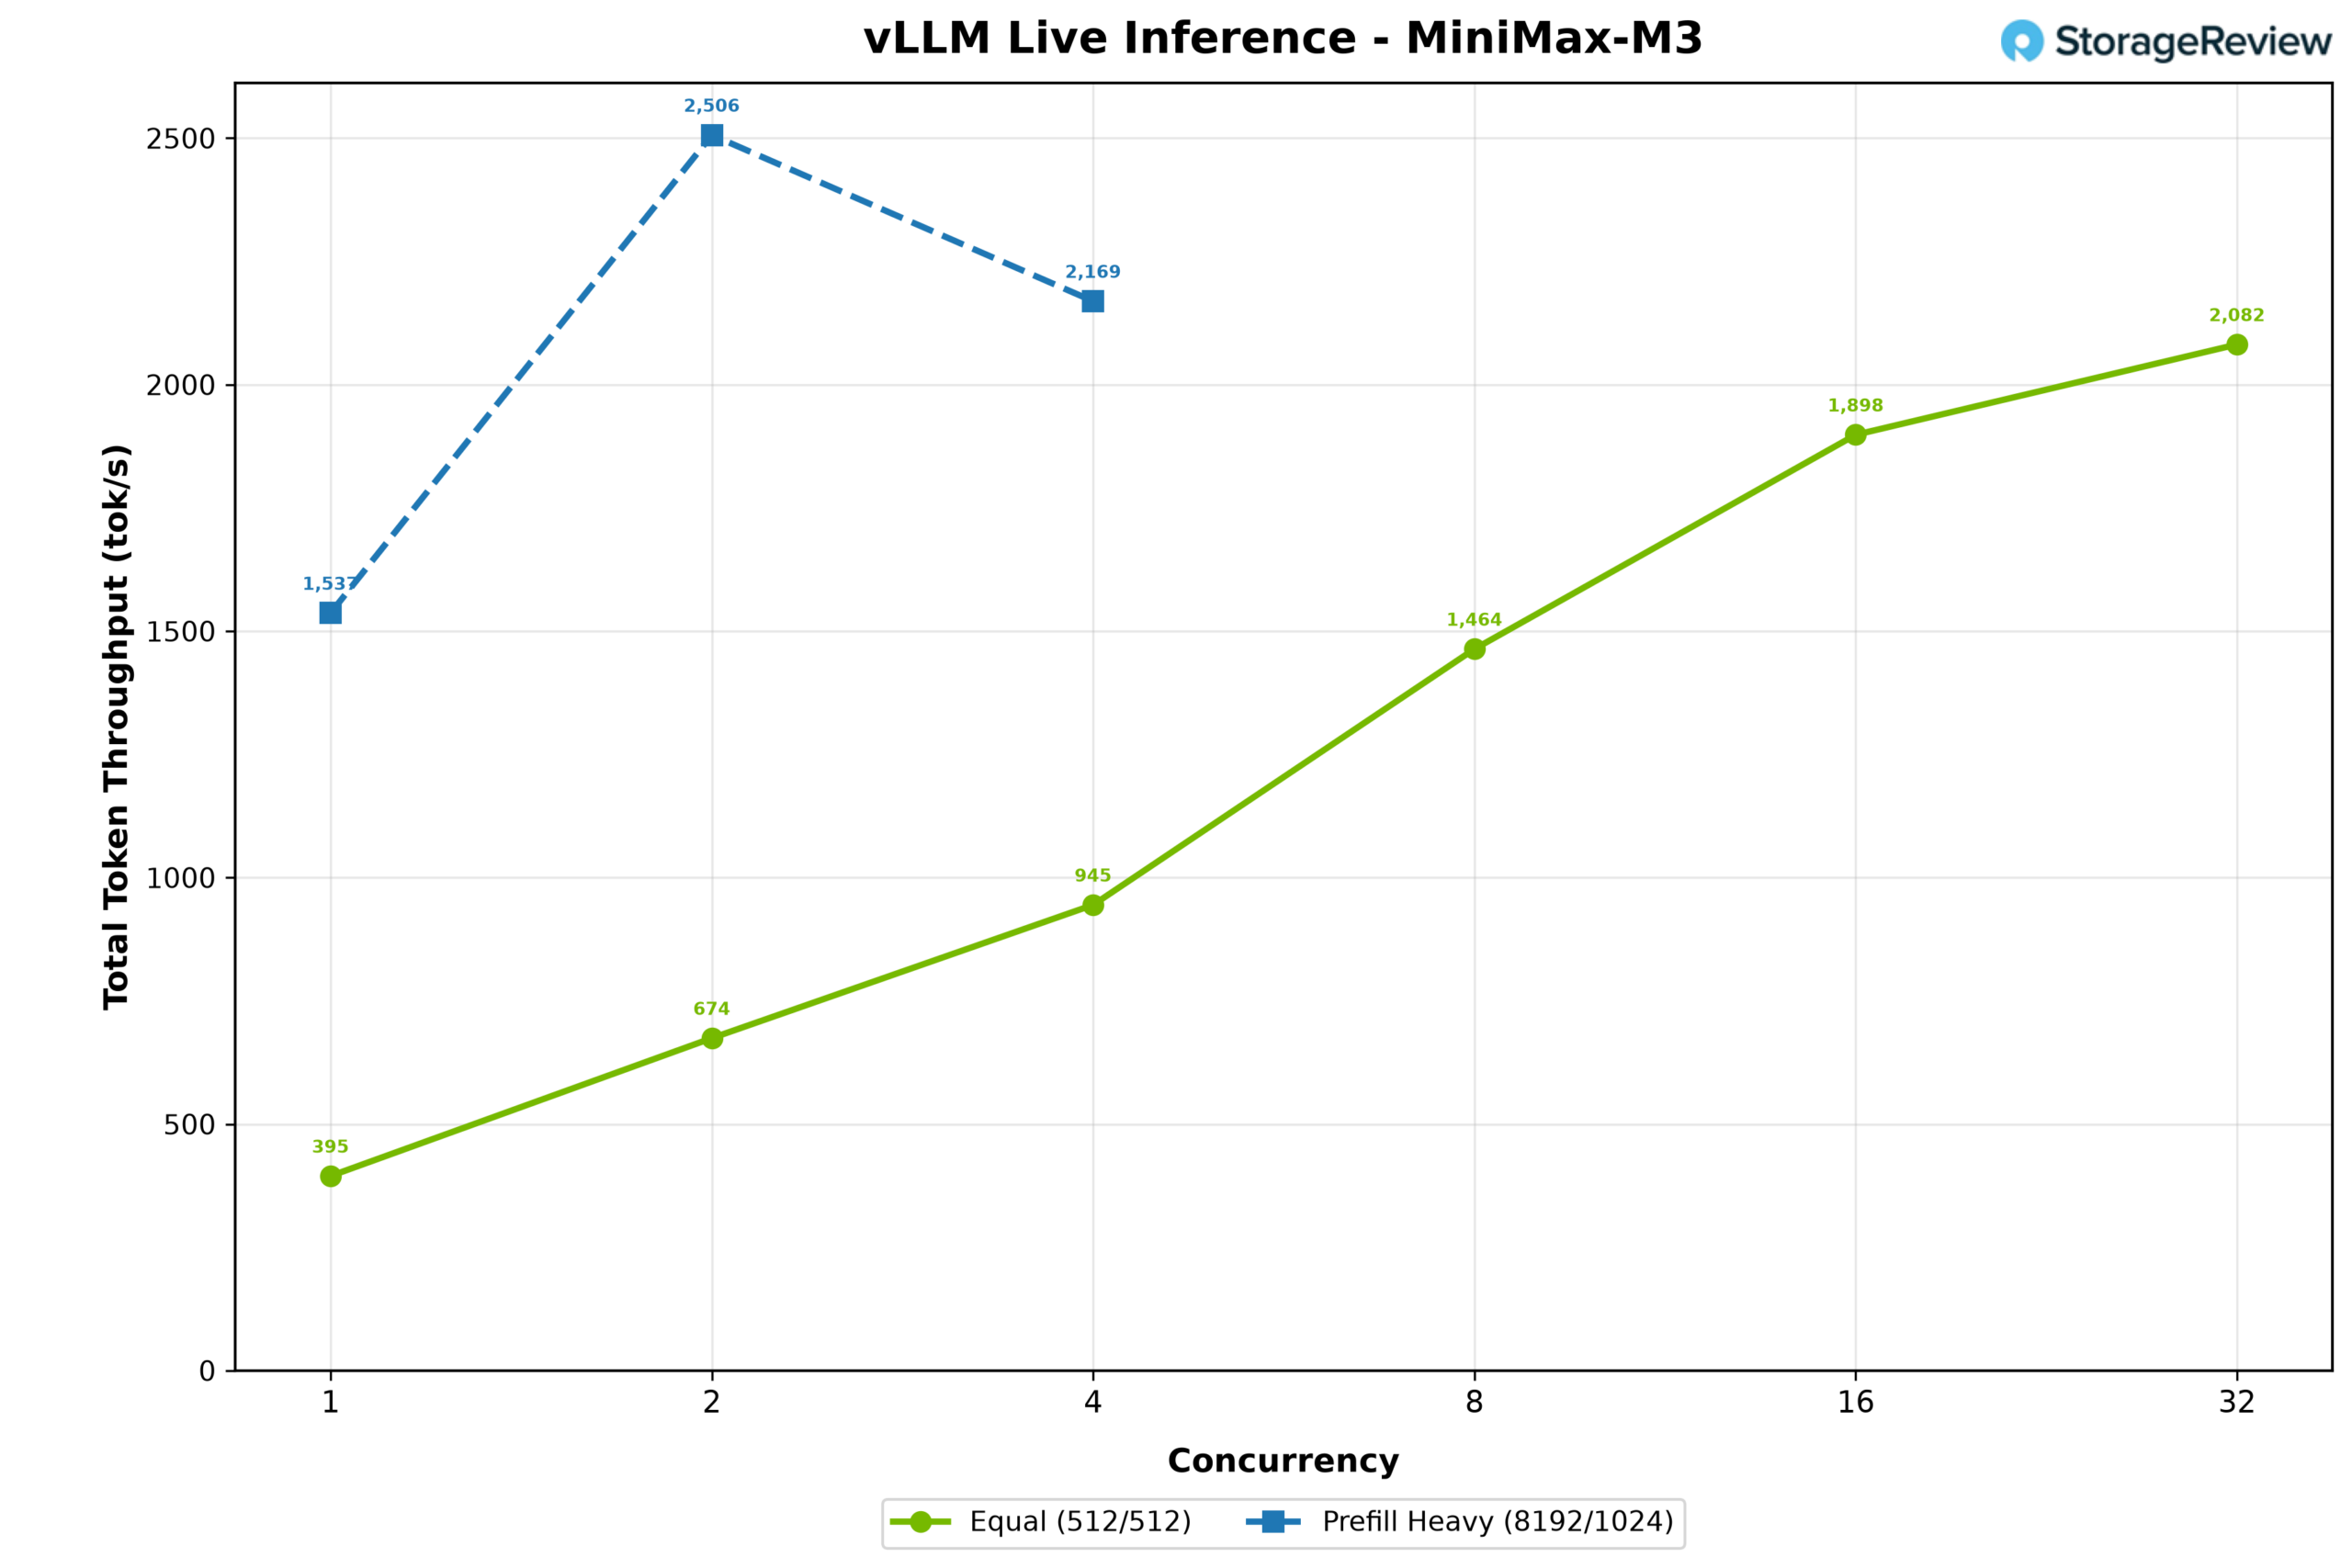
El rendimiento total de tokens siguió un patrón similar, con la carga de trabajo 512/512 aumentando de 395 a 2,082 tokens por segundo, mientras que la carga de trabajo con precarga alcanzó un pico de 2,506 tokens por segundo en la concurrencia 2 antes de caer a 2,169 en la concurrencia 4.
Modelos que no se ajustan a HBM
GLM-5.2 (NVFP4)
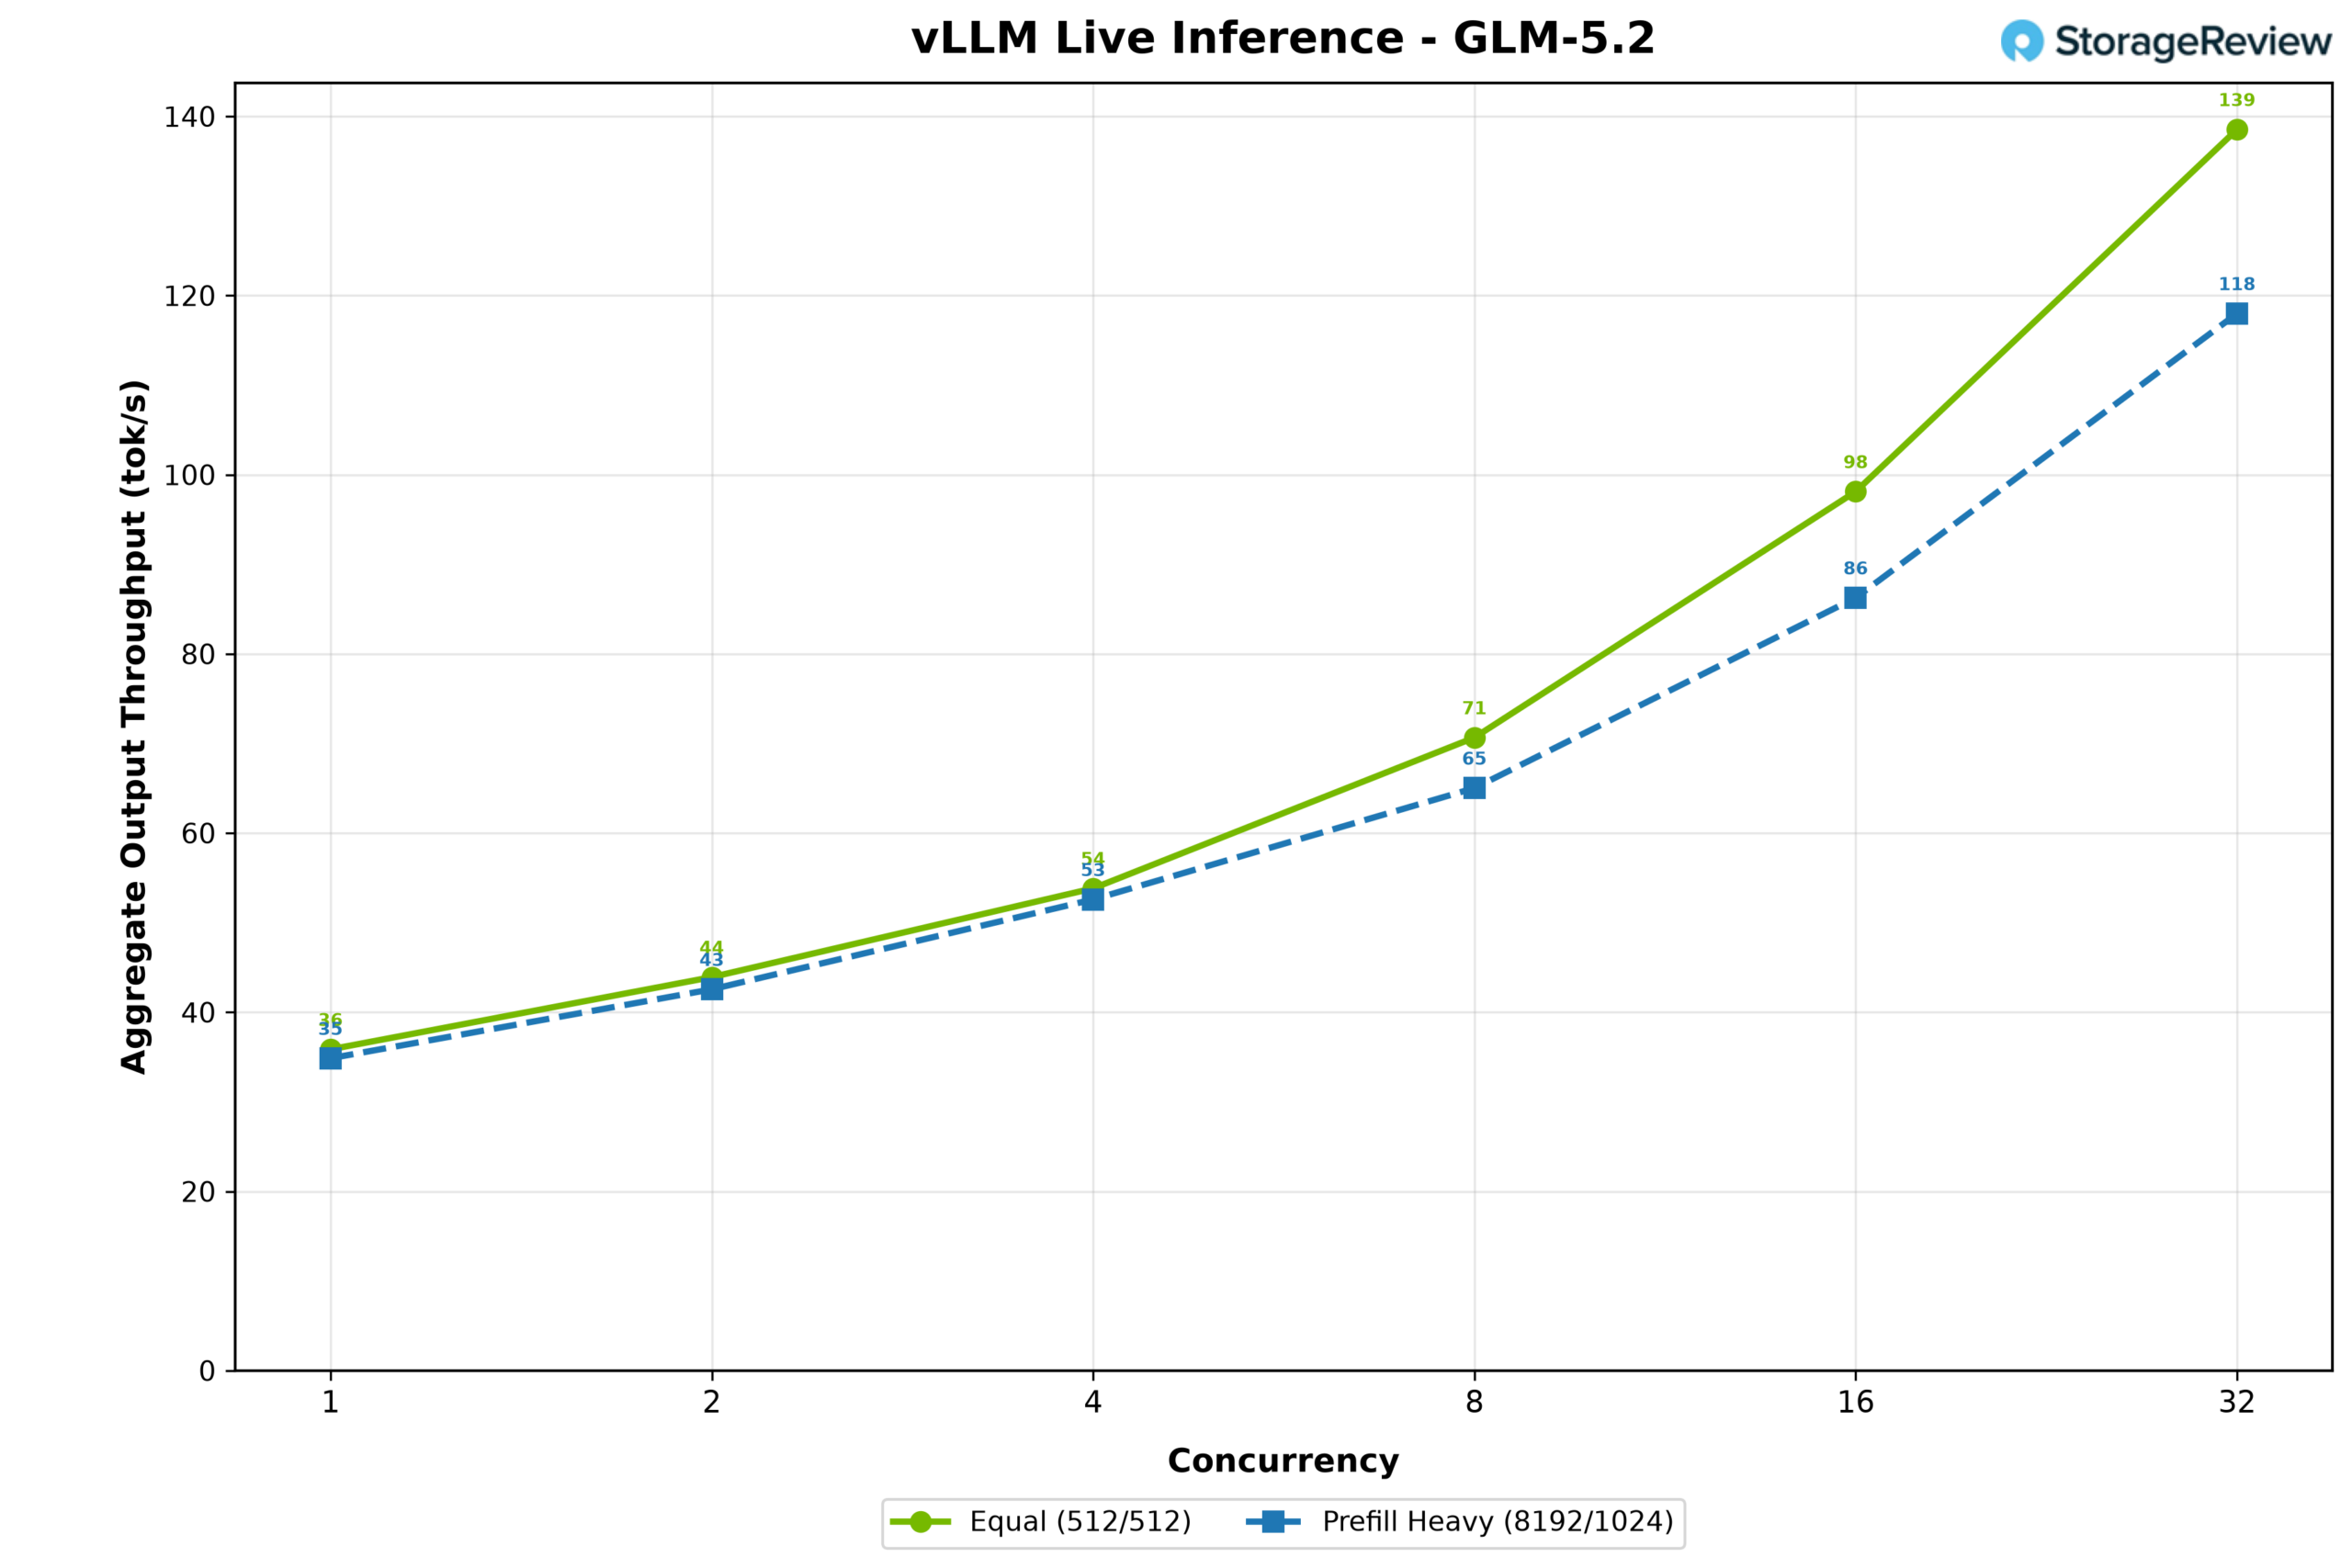
GLM-5.2 se probó utilizando la memoria cuantitativa NVFP4 de NVIDIA. Su punto de control de 433 GB utilizó 218 GB de HBM, con 216 GB de pesos de expertos descargados a la memoria Grace. Se utilizó la decodificación especulativa MTP con una longitud de aceptación sintética de 3 tokens. El rendimiento de salida en la carga de trabajo 512/512 aumentó de 36 tokens por segundo en la concurrencia 1 a 139 en la concurrencia 32. La carga de trabajo 8,192/1,024 siguió de cerca, aumentando de 35 a 118 tokens por segundo. Los resultados similares entre los dos perfiles muestran que la generación se mantuvo limitada principalmente por el movimiento de los expertos descargados entre la memoria Grace y la GPU. El barrido terminó en la concurrencia 32 porque no había suficiente HBM disponible para contexto adicional.
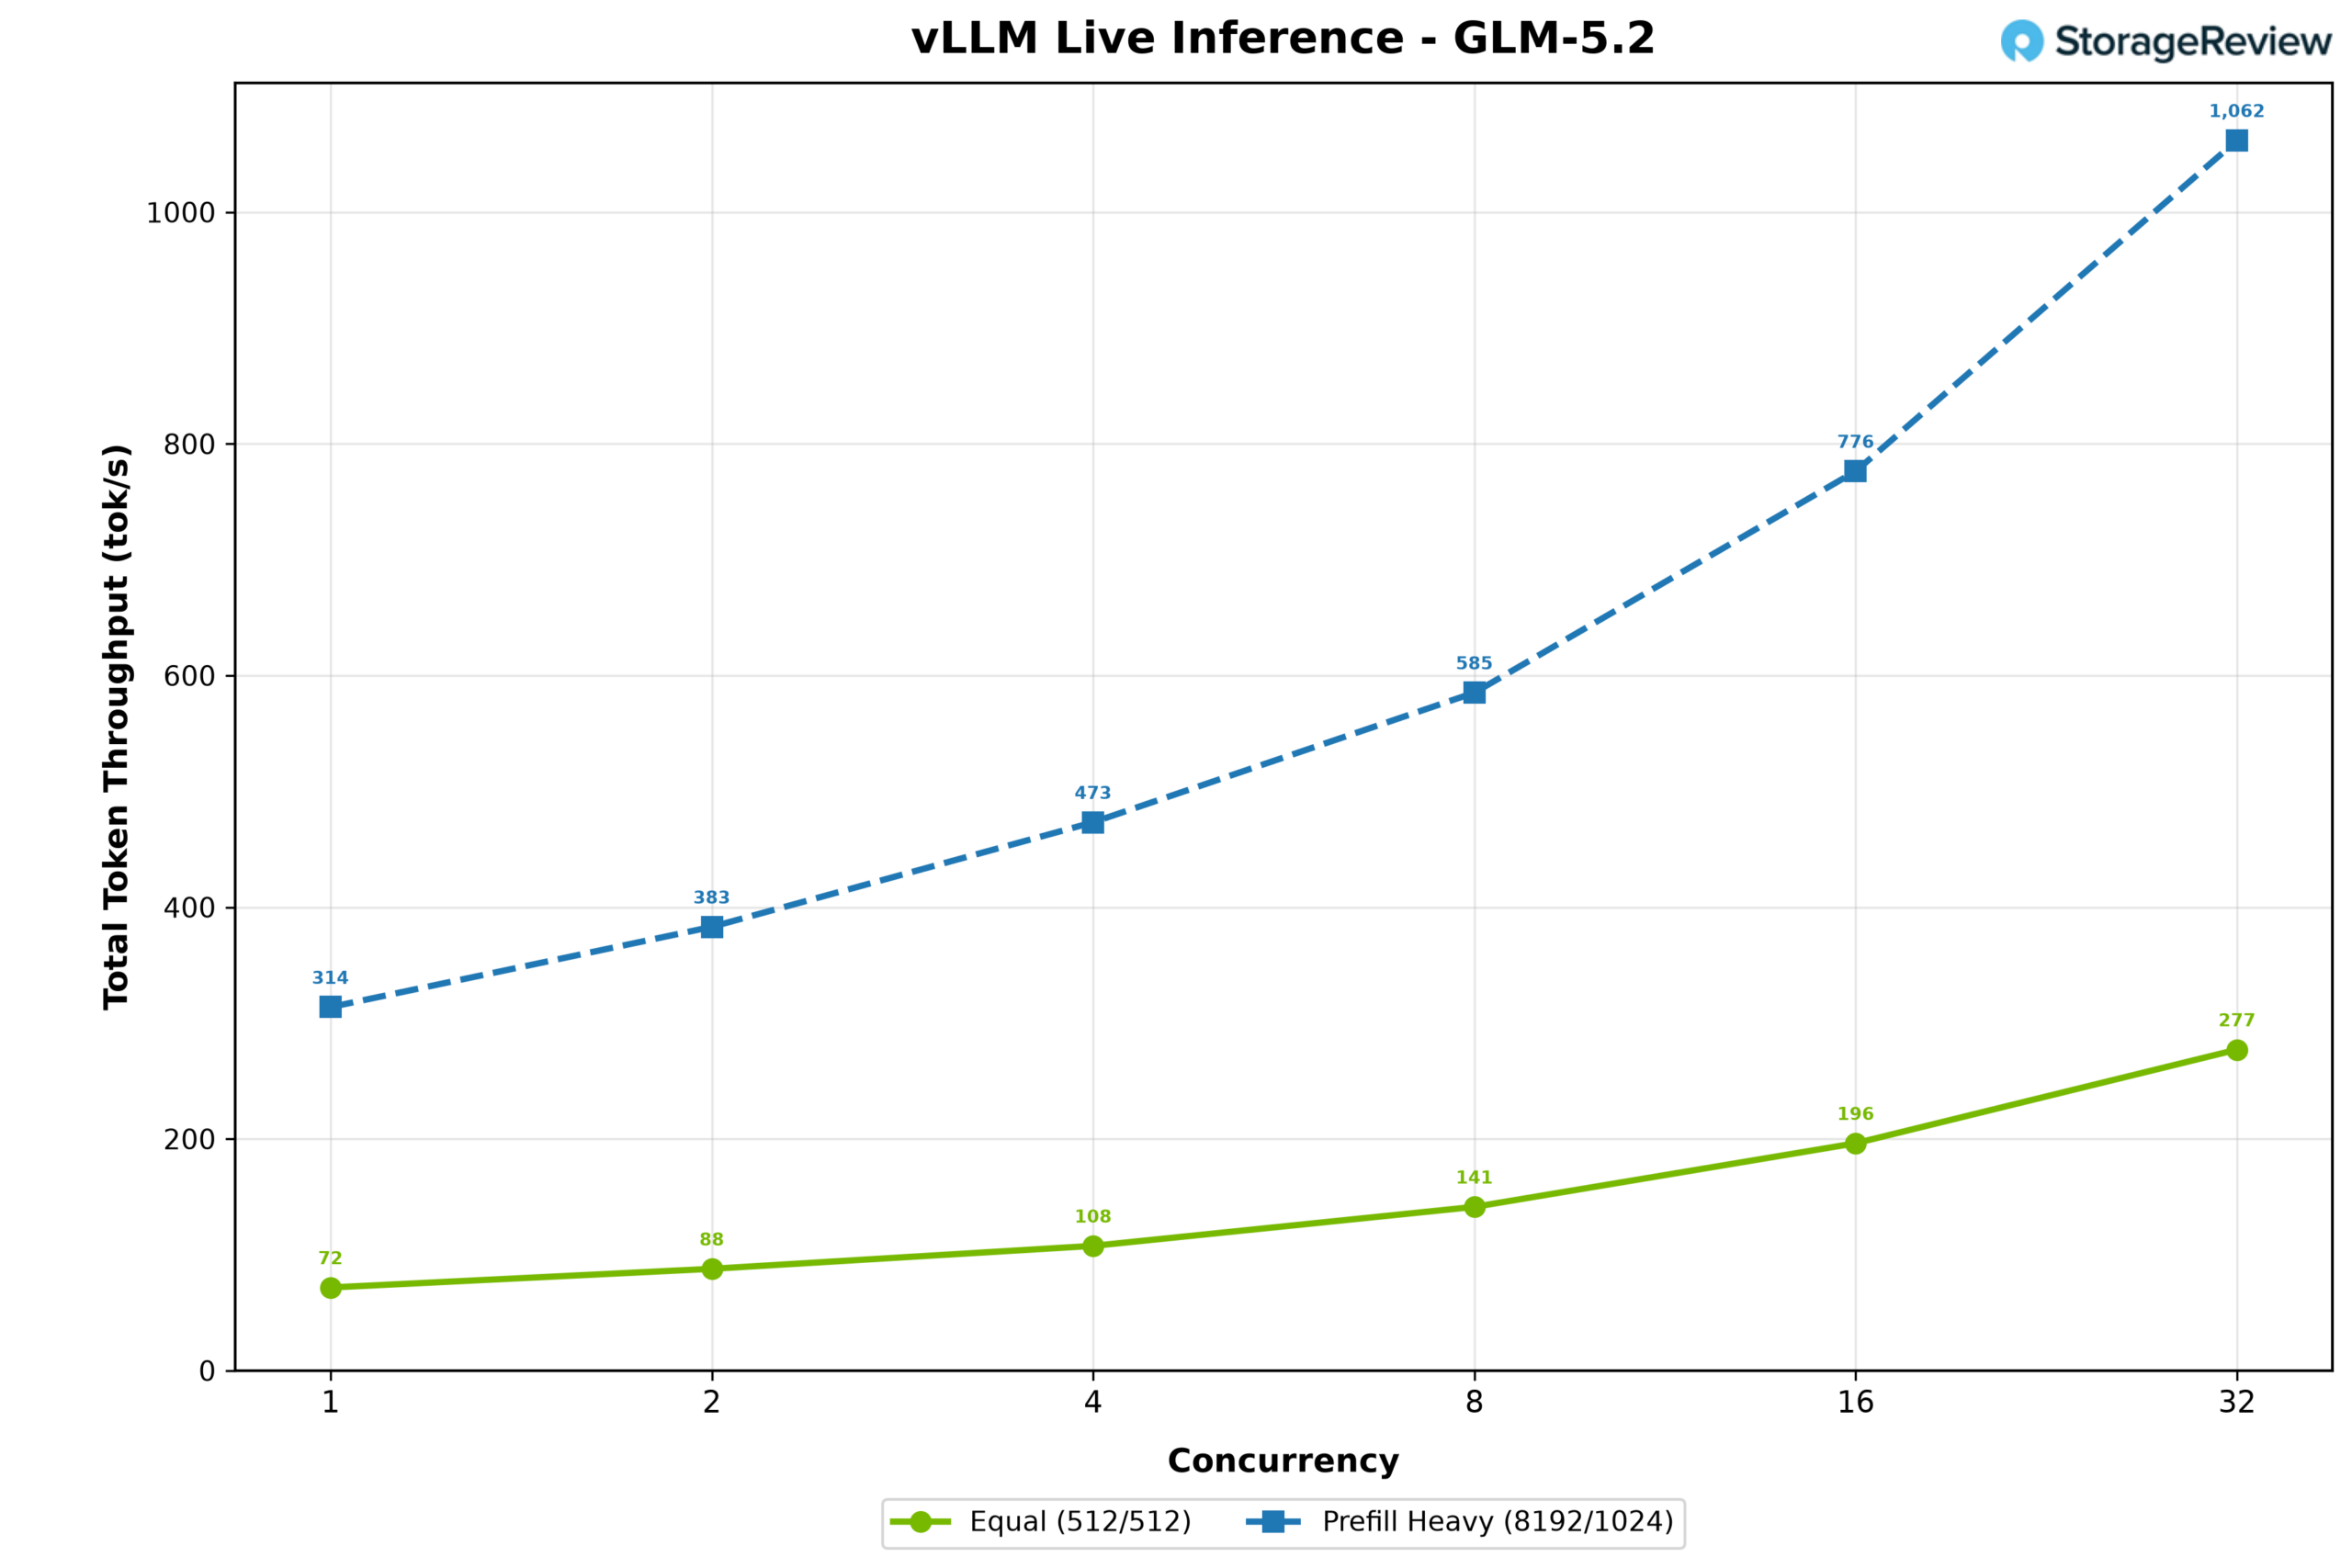
El rendimiento total de tokens siguió el mismo patrón, con la carga de trabajo 512/512 aumentando de 72 a 277 tokens por segundo y la carga de trabajo con prellenado aumentando de 314 a 1,062; aquí, las indicaciones más largas finalmente separan los dos perfiles, ya que los tokens de prellenado en sí mismos cuentan para el total.
Nemotron-3-Ultra 550B (NVFP4)
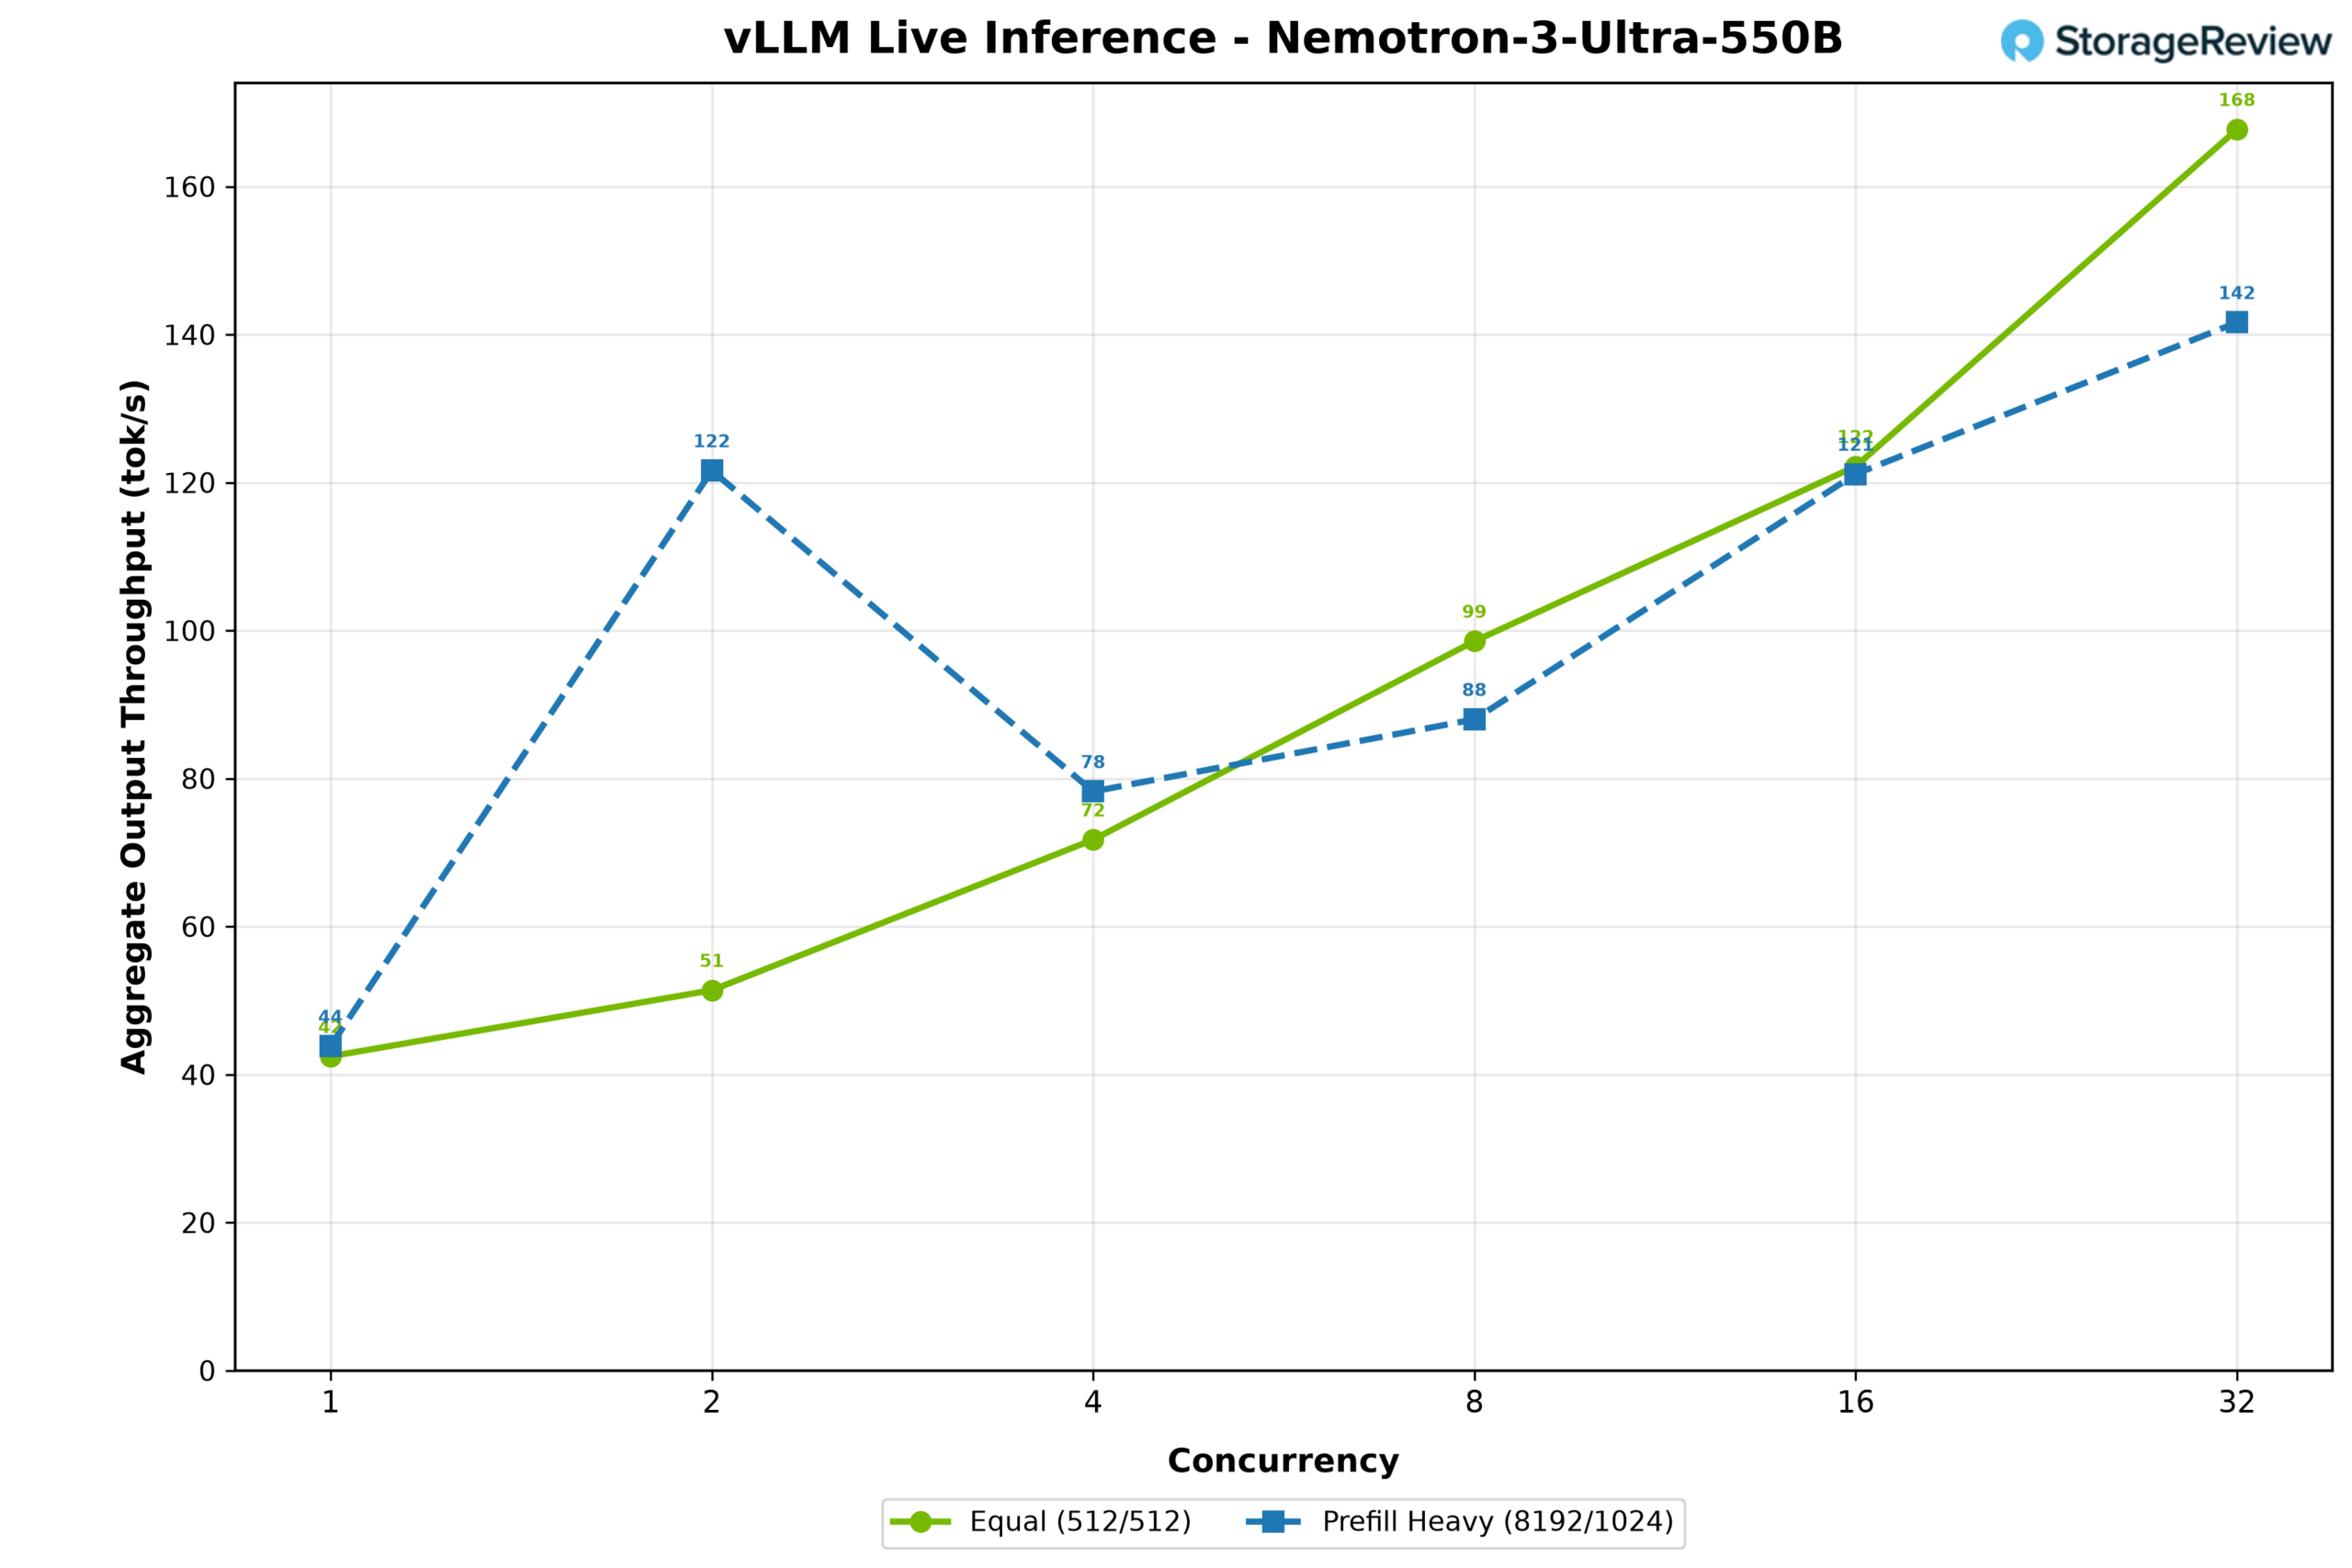
Nemotron-3-Ultra 550B es el modelo más grande que ejecutamos y el que ejercita más directamente el pool coherente completo. Es un modelo híbrido Transformer-Mamba NVFP4 de 307 GB, demasiado grande para HBM solo, con 114 GB de sus pesos descargados a la memoria Grace. Se utilizó la decodificación especulativa MTP con una longitud de aceptación sintética de 5 tokens. El rendimiento de salida en la carga de trabajo 512/512 comenzó en 43 tokens por segundo en concurrencia 1 y subió a 168 en concurrencia 32. La carga de trabajo con prellenado pesado contó una historia más interesante: el rendimiento aumentó de 44 tokens por segundo en concurrencia 1 a un pico de 122 en concurrencia 2, pero luego cayó a 78 en concurrencia 4 a medida que las indicaciones largas llenaban la caché KV limitada. Al igual que con GLM-5.2, ambos perfiles se corresponden estrechamente, lo que vuelve a indicar que la migración experta entre Grace y la GPU es el factor limitante, en lugar de la capacidad de cómputo. El análisis finalizó en la concurrencia 32 por la misma razón: no quedaba suficiente memoria HBM para obtener información adicional.
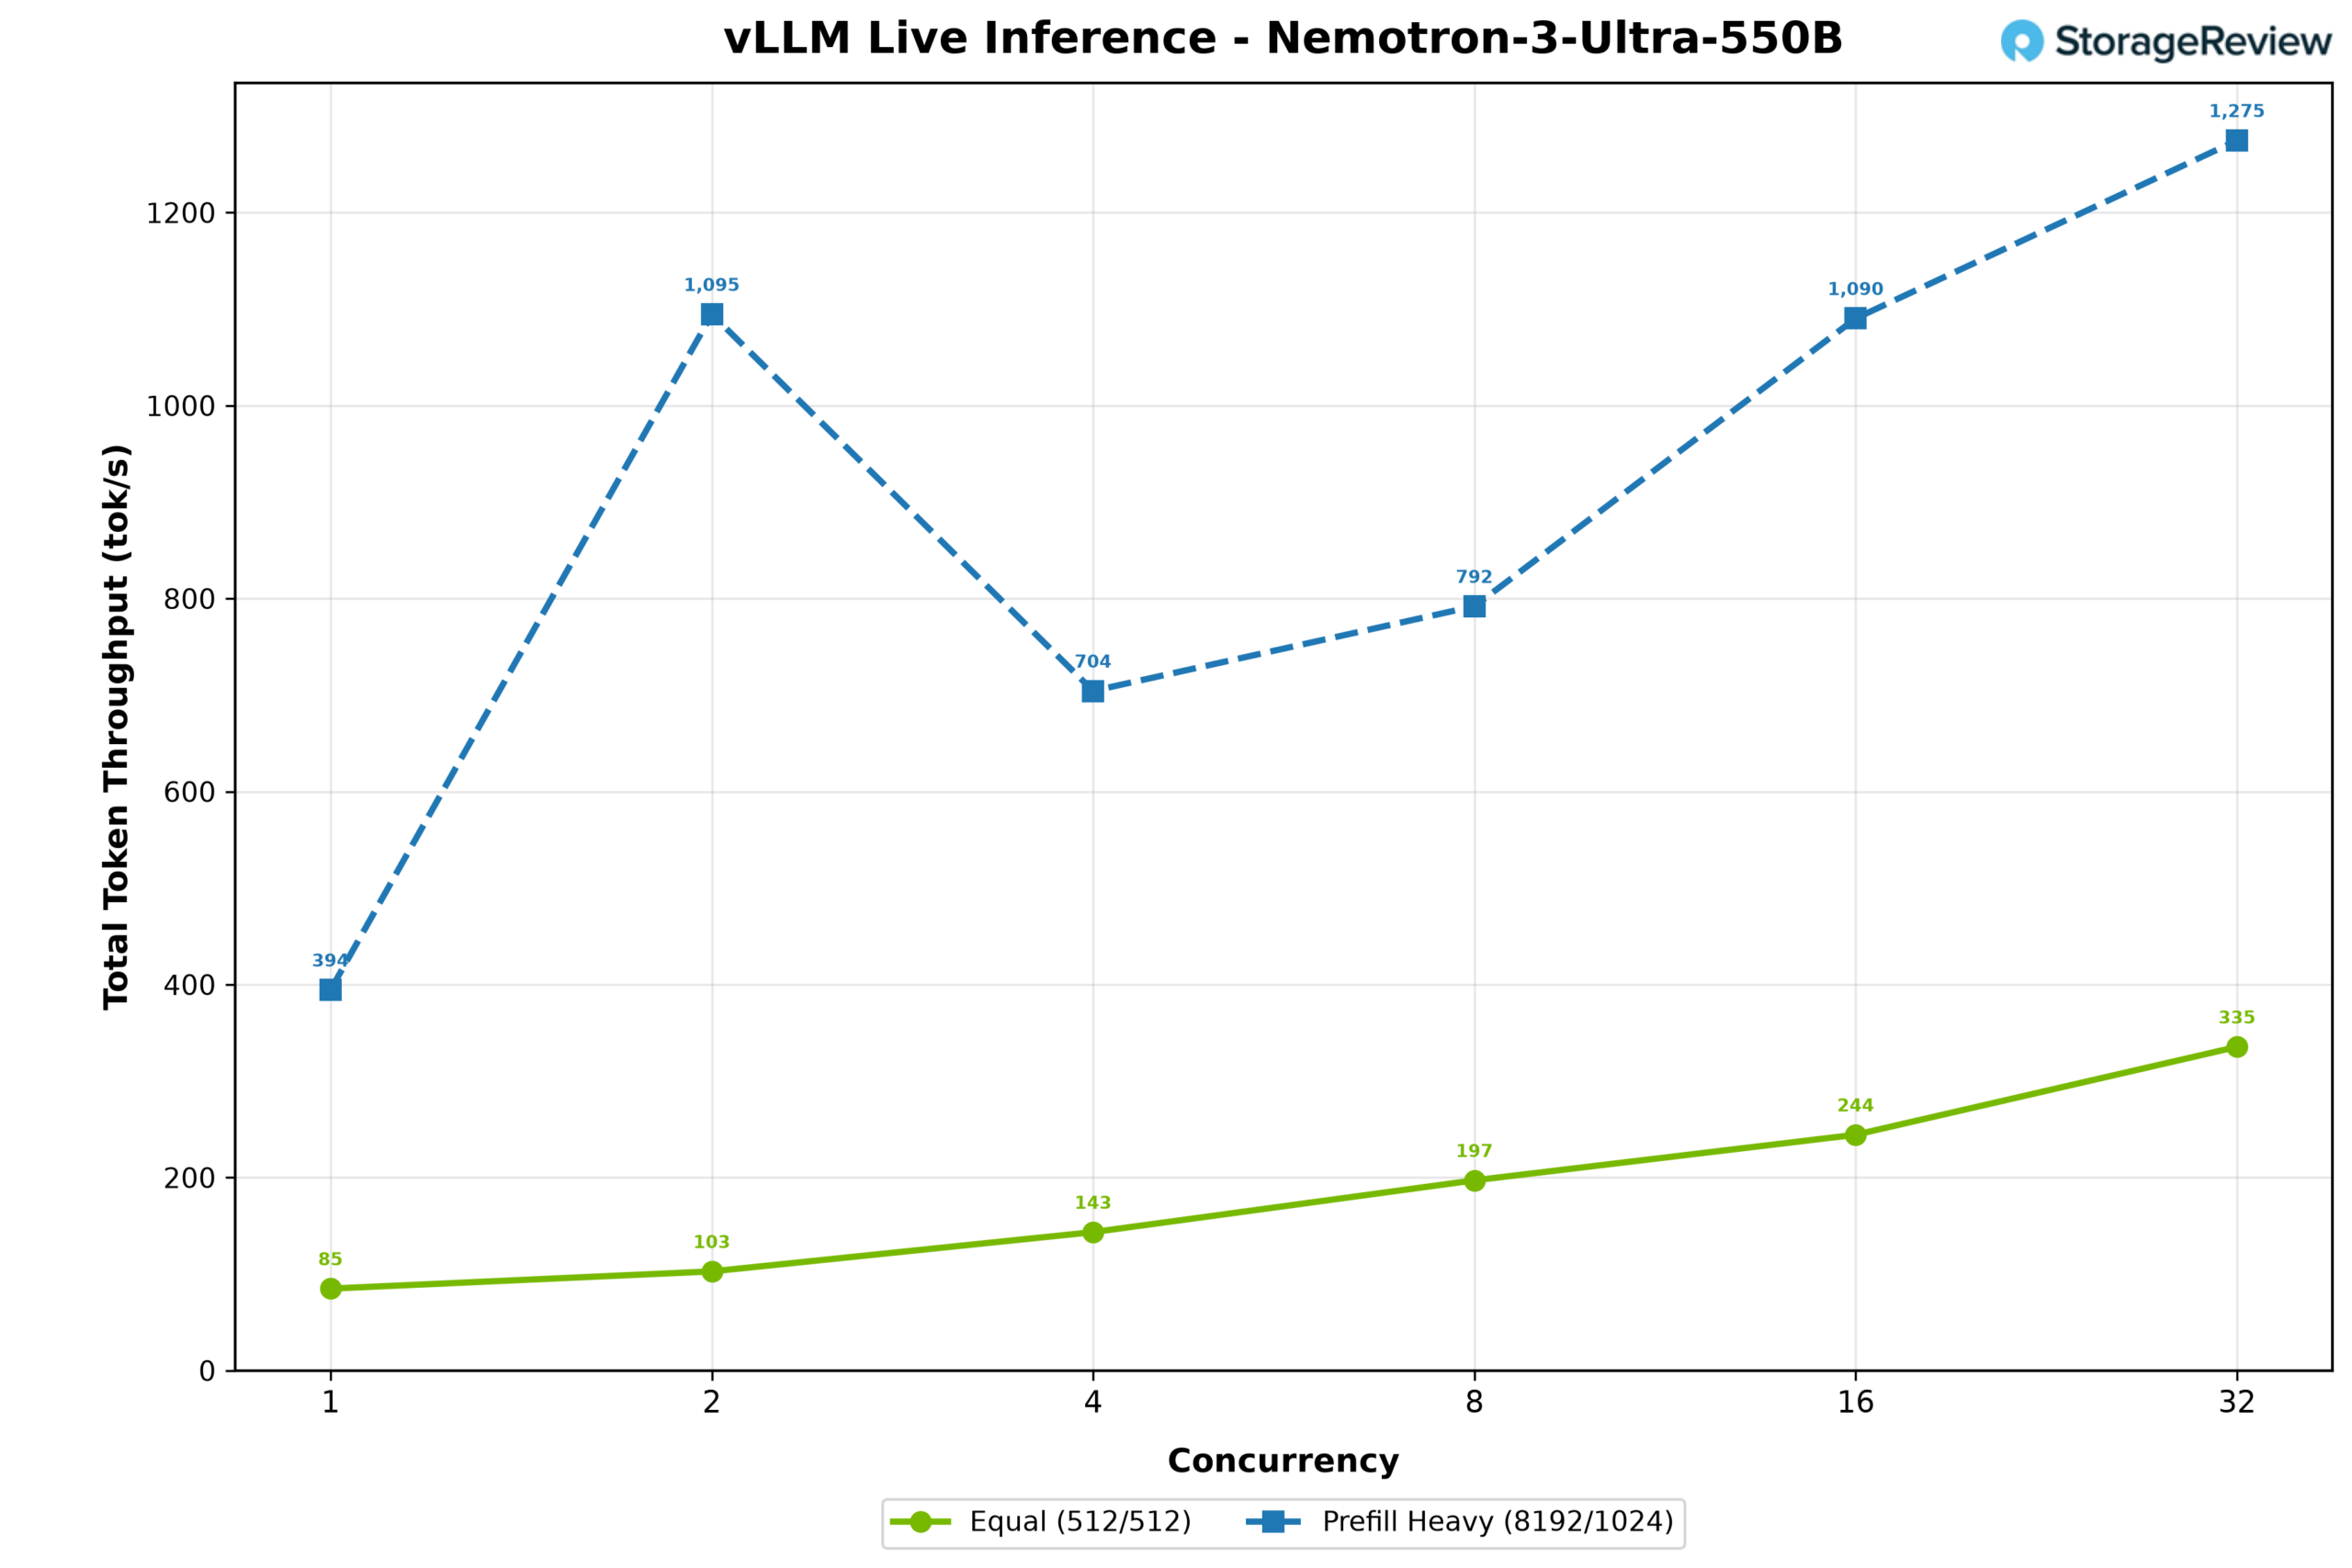
A continuación se muestra el rendimiento total de tokens, con la carga de trabajo intensiva en precarga alcanzando un pico de 2,506 tokens por segundo con una concurrencia de 2, antes de disminuir a 2,169 con una concurrencia de 4, mientras que la carga de trabajo 512/512 escaló de 85 a 336 tokens por segundo.
WS300 vs. Blackwell RTX PRO 6000 vs. DGX Spark
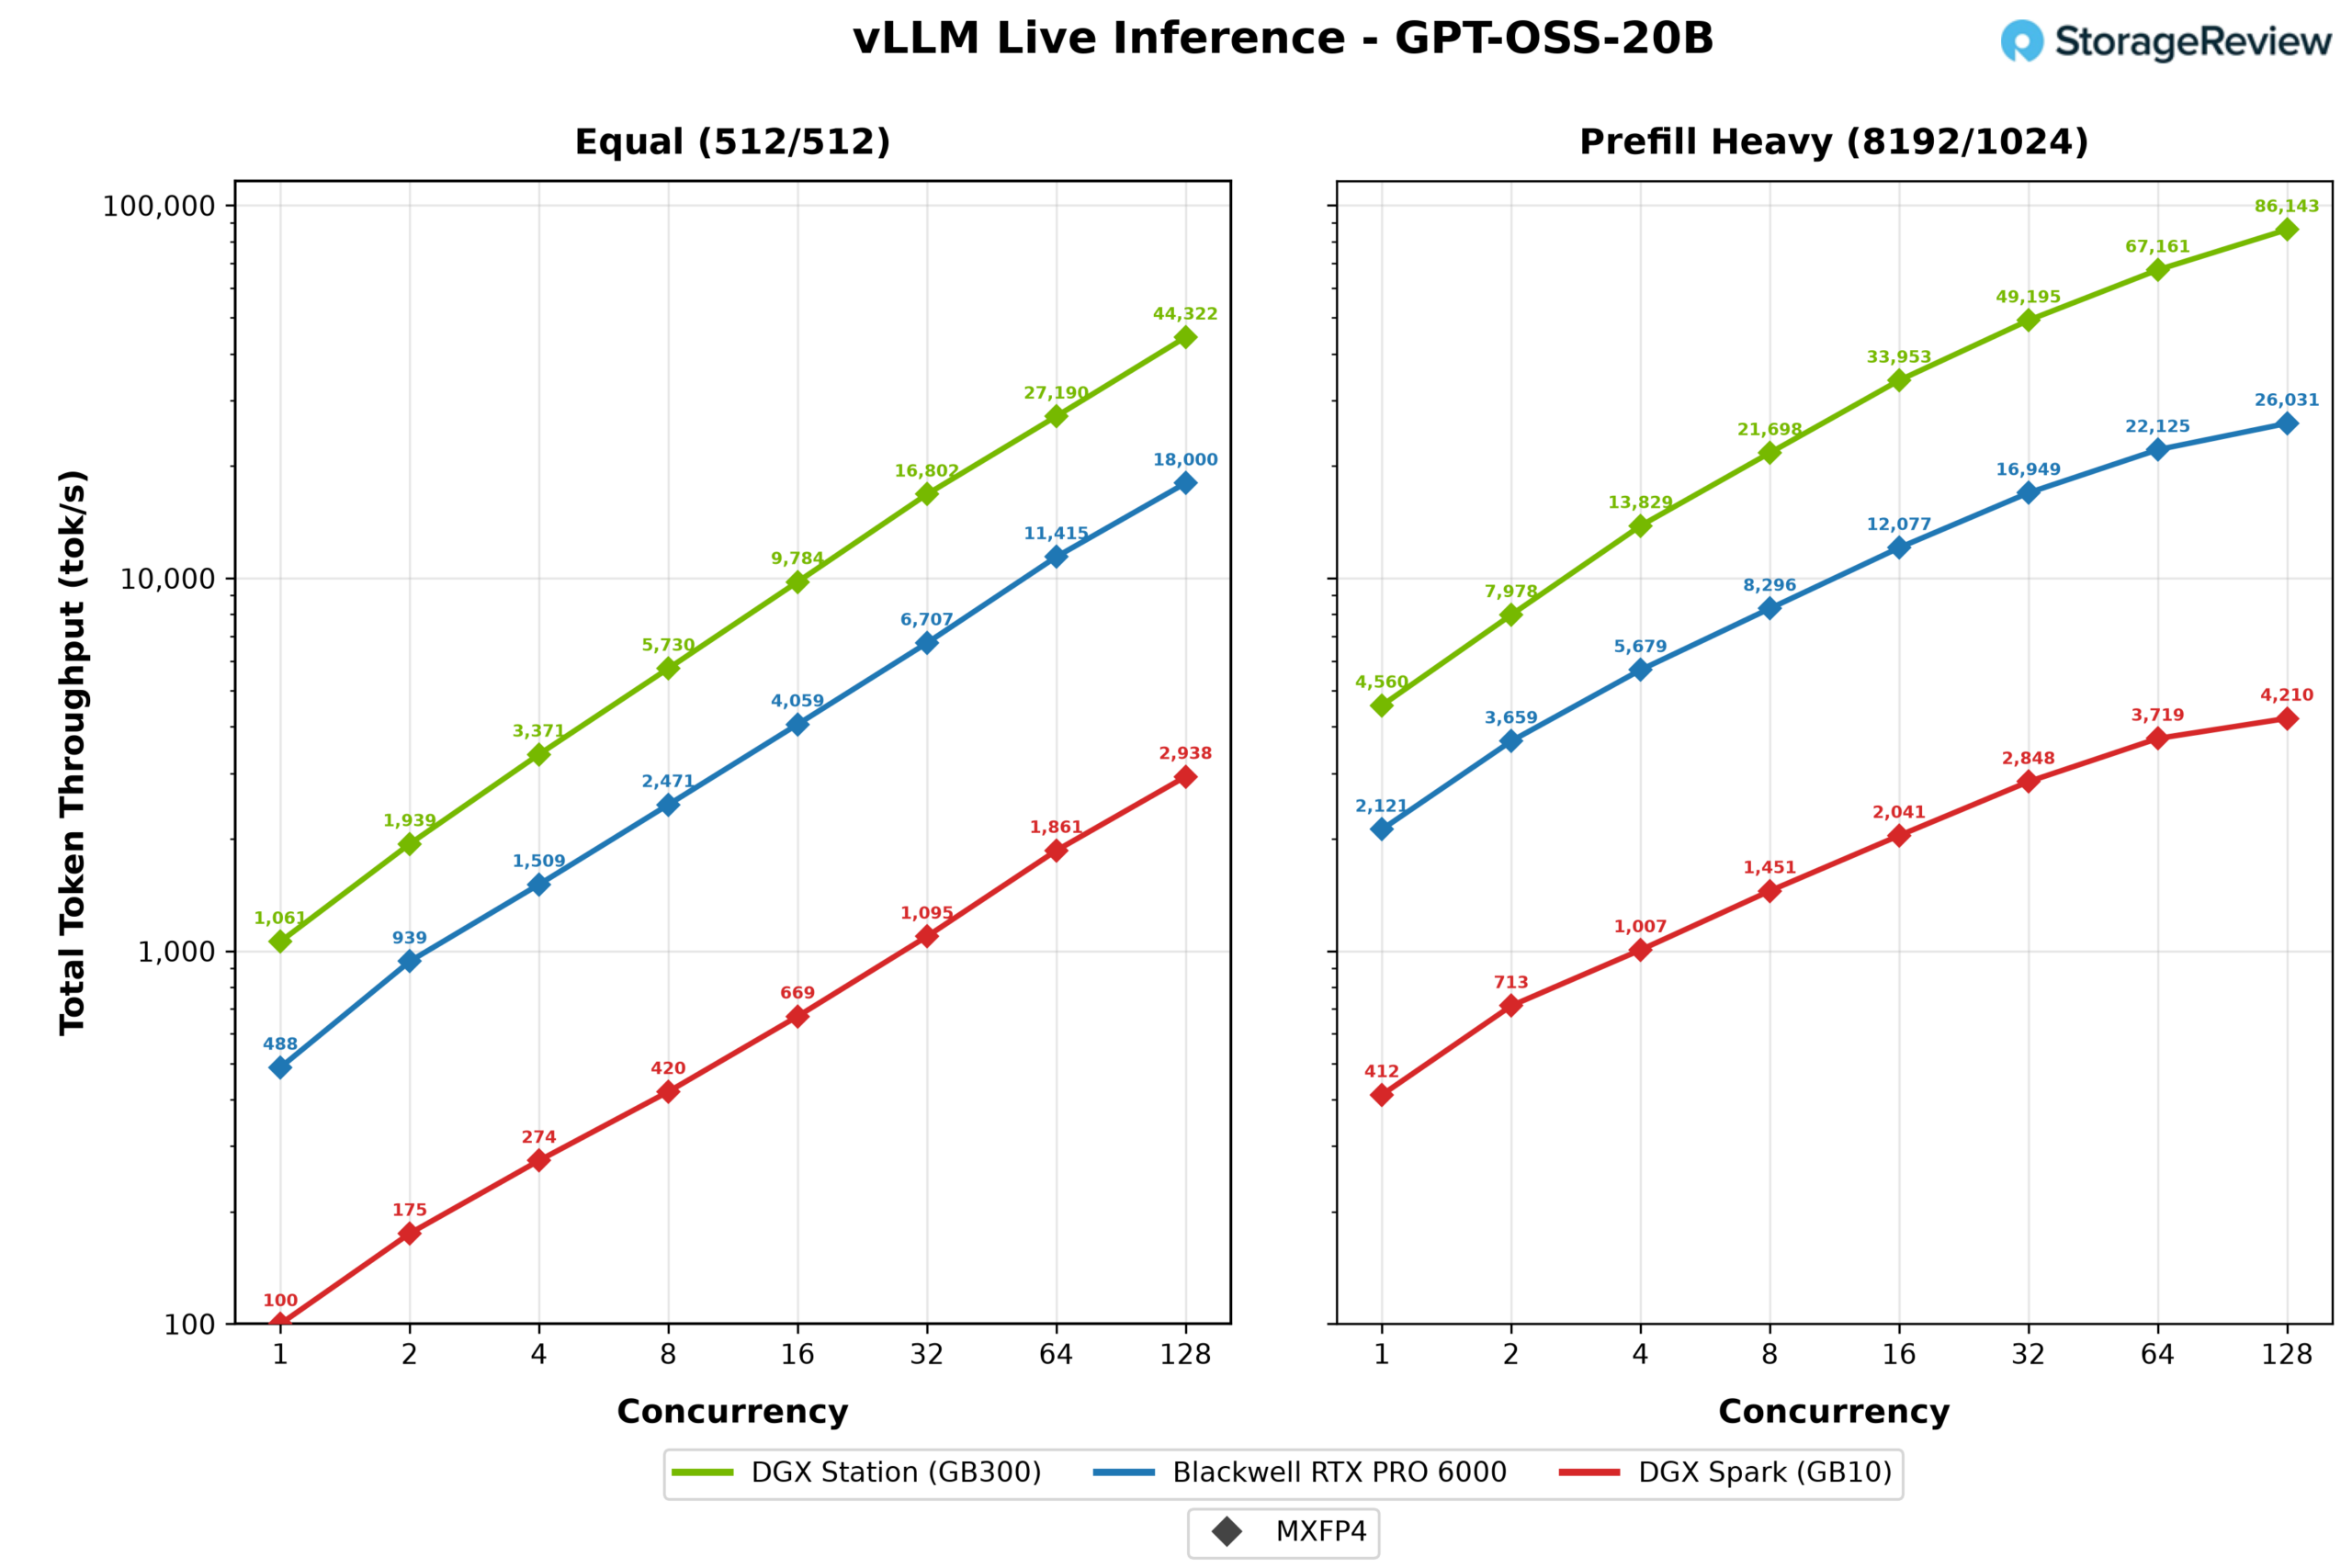
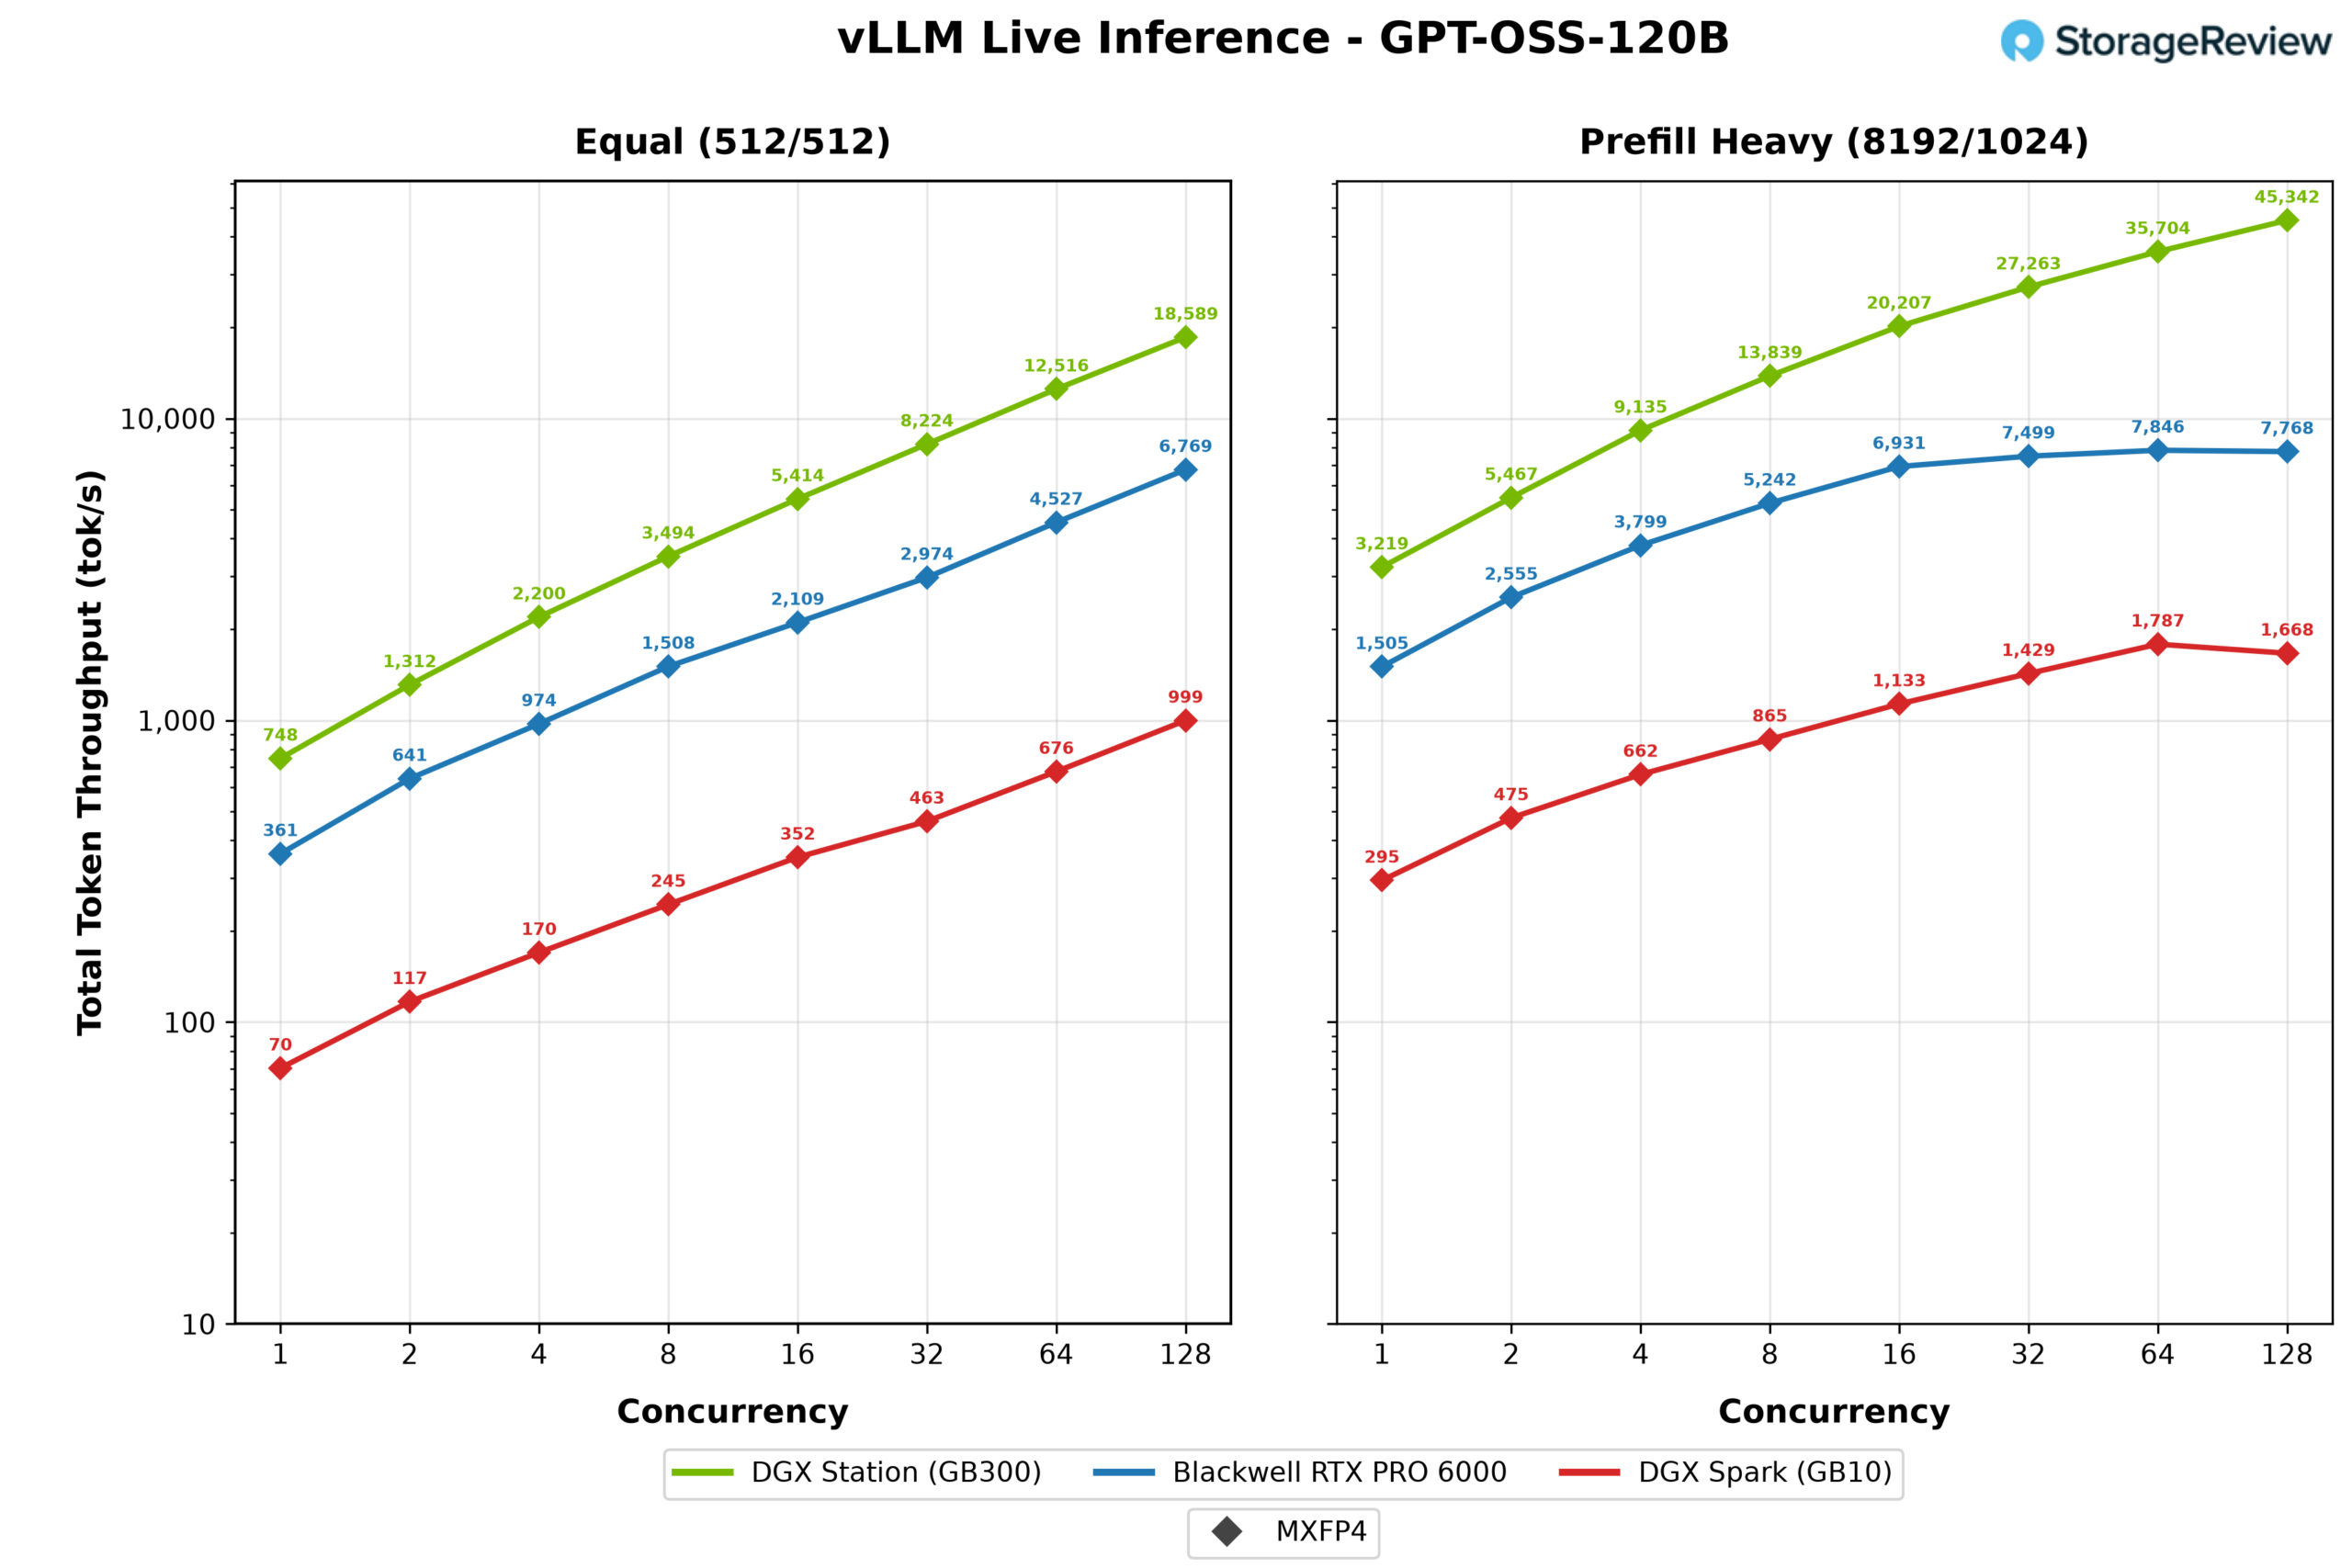
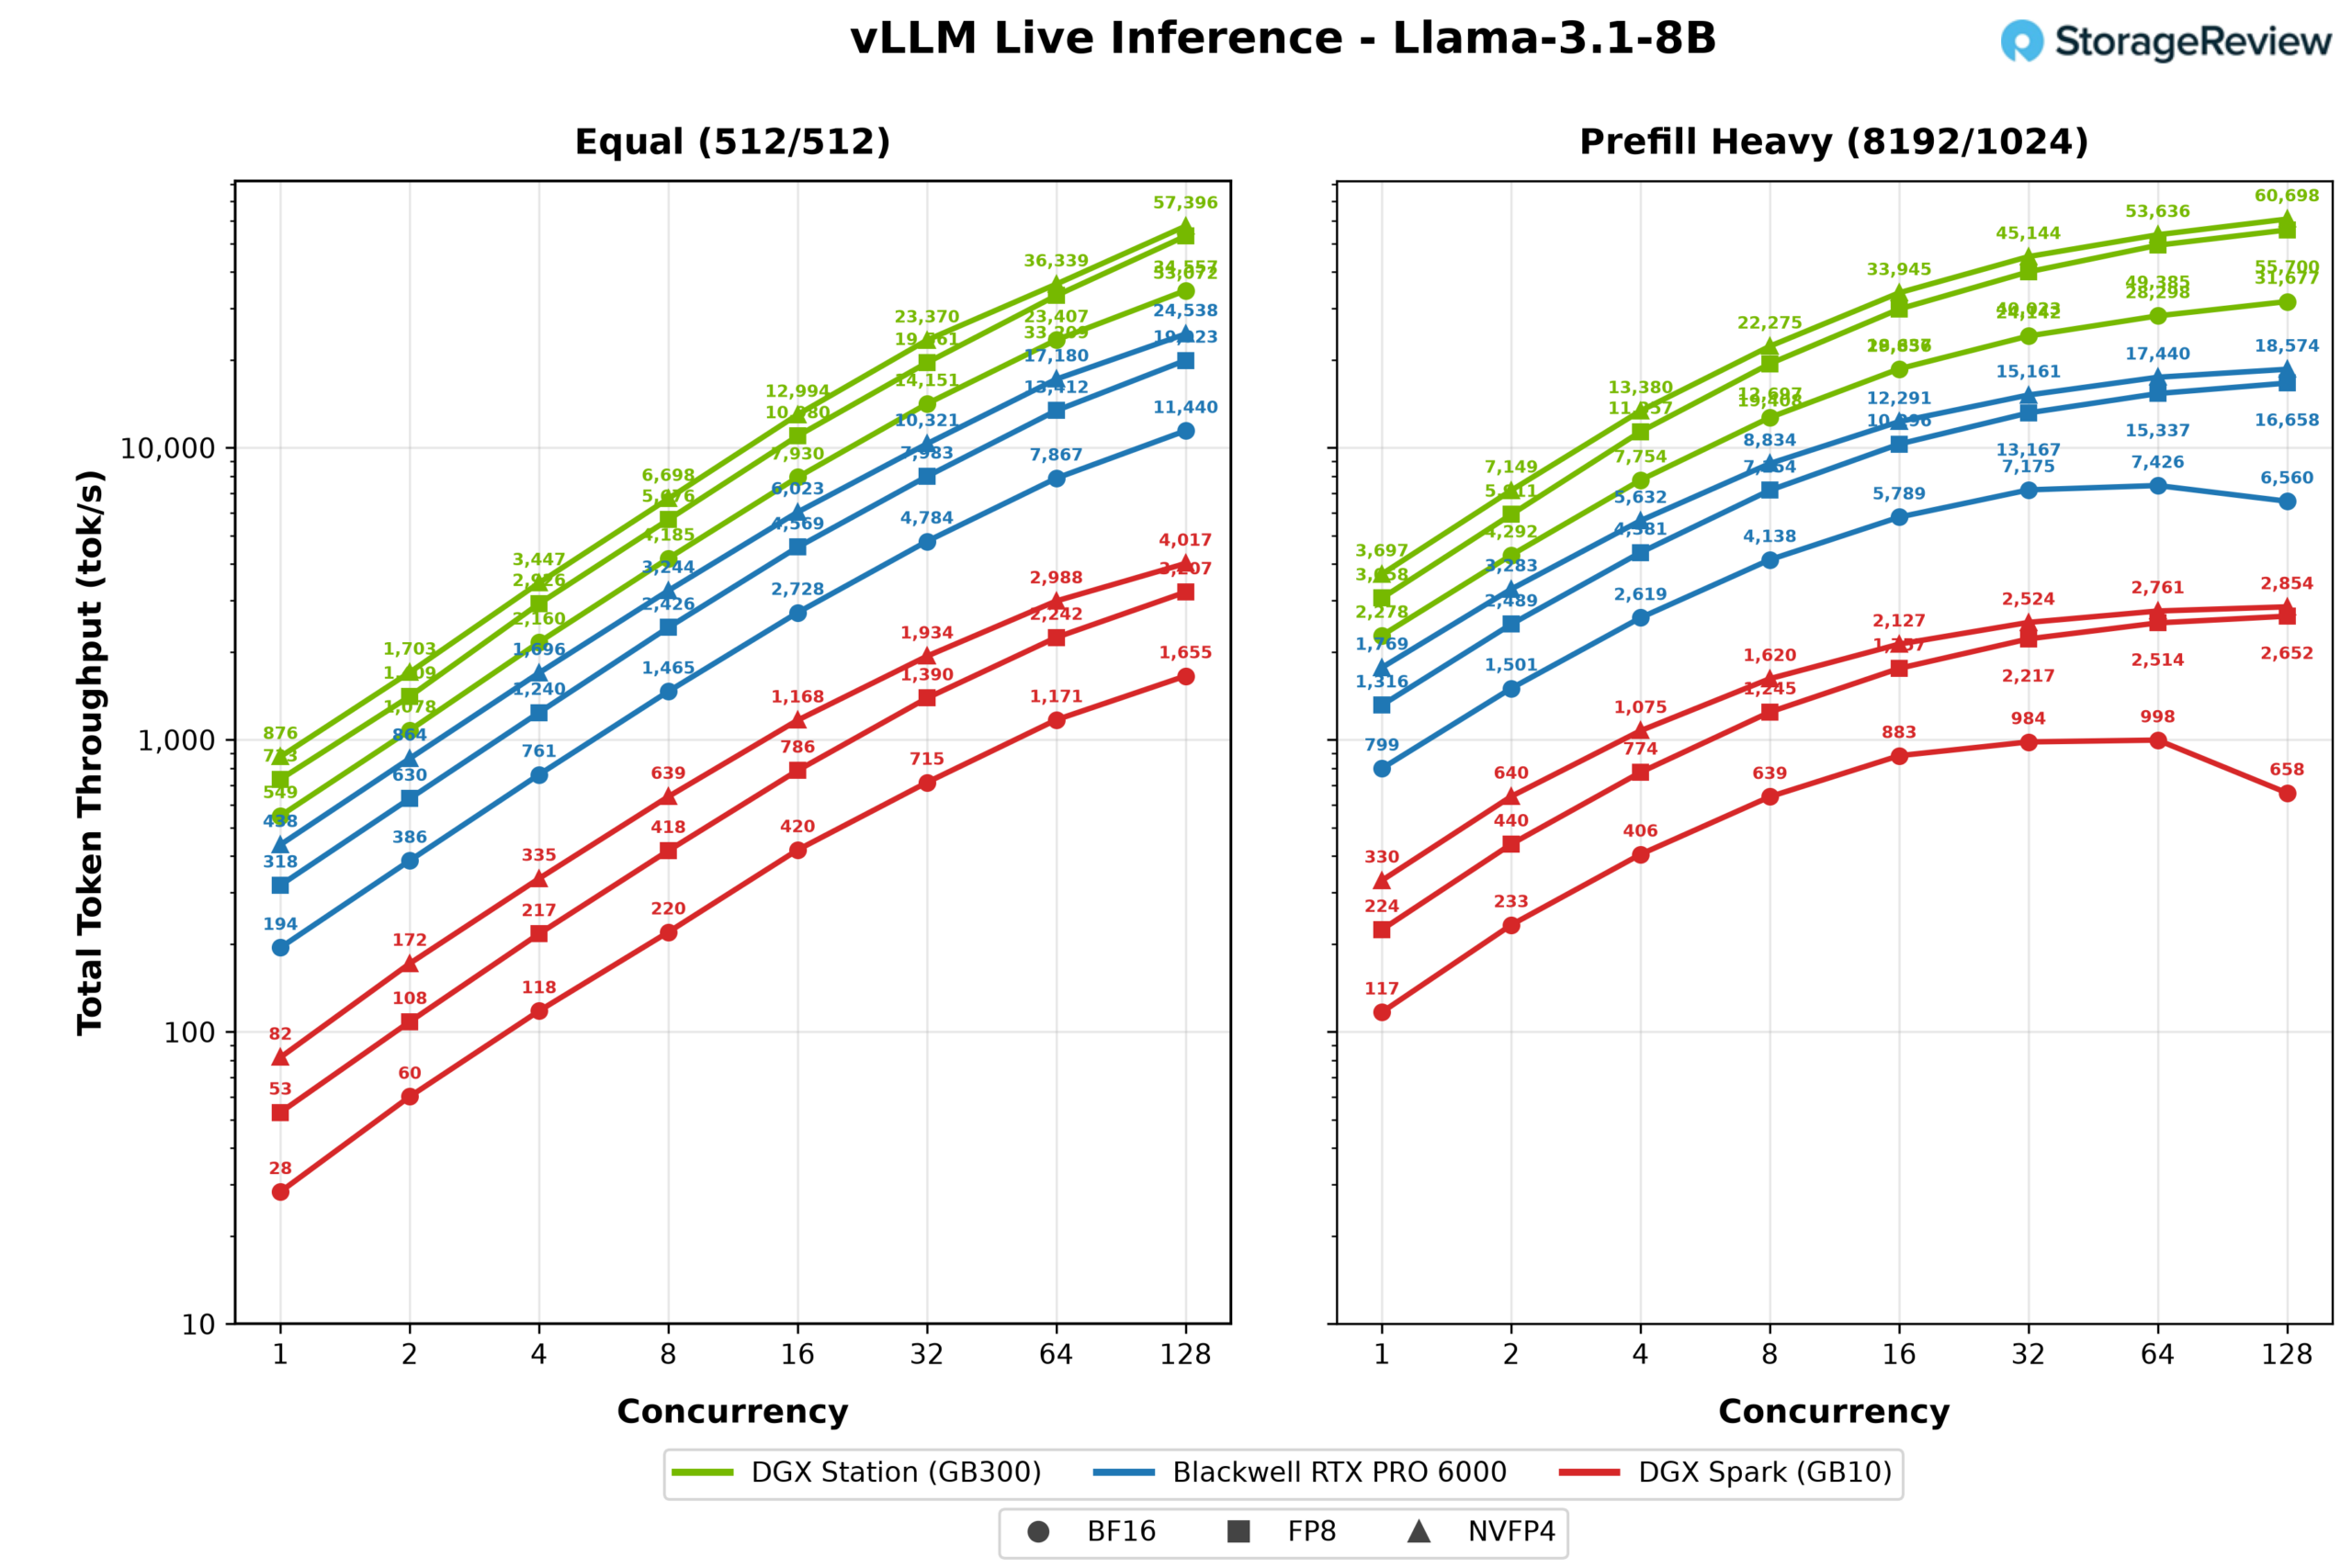
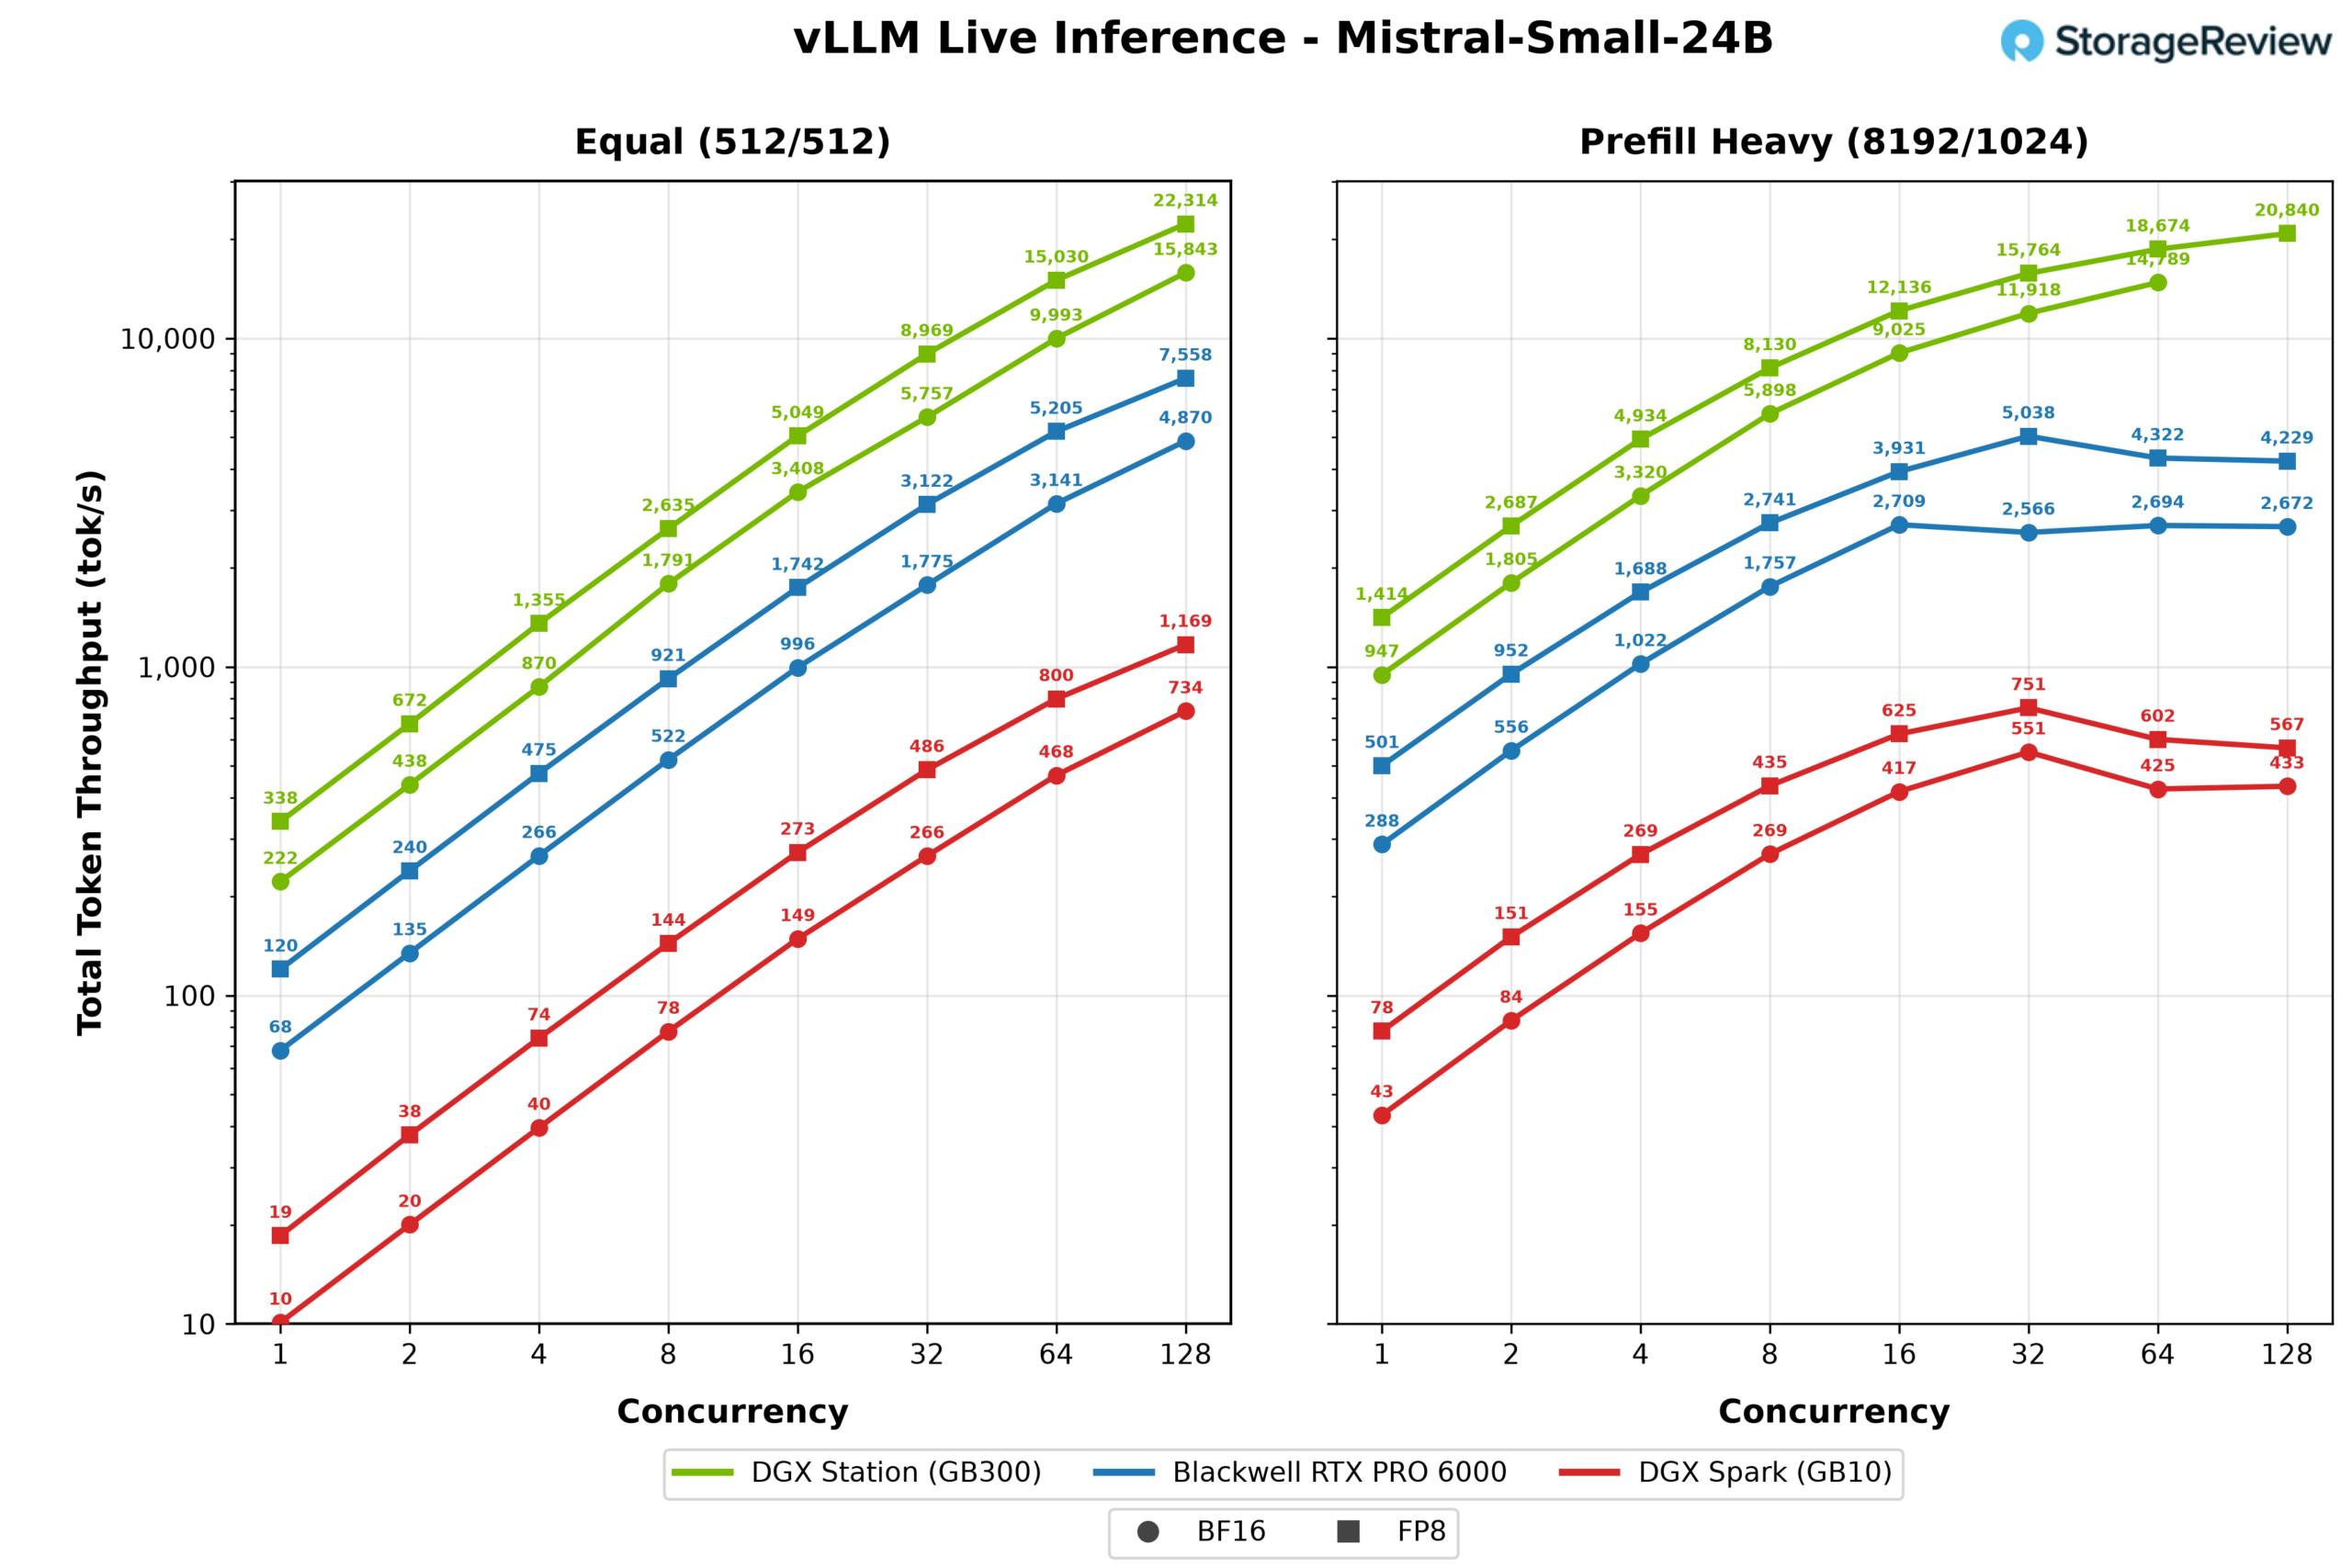
Esta segunda parte de nuestras pruebas de inferencia enfrenta al WS300 con las otras dos formas de tener Blackwell sobre o cerca de un escritorio: la Blackwell RTX PRO 6000, la tarjeta de estación de trabajo de 600 W de NVIDIA, alojada en la Dell Pro Max Tower T2 que analizamos anteriormente, y la DGX Spark basada en GB10, representada aquí por el Acer Veriton GN100 . Cada sistema ejecutó las mismas cargas de trabajo de inferencia en vivo de vLLM bajo dos escenarios, una carga de trabajo igual con 512 tokens de entrada y 512 de salida y una carga de trabajo pesada de prellenado con 8,192 tokens de entrada y 1,024 de salida, en niveles de concurrencia de 1 a 128. Graficamos la salida agregada y el rendimiento total para cada modelo que los tres sistemas pueden servir en común: GPT-OSS-20B y GPT-OSS-120B en su MXFP4 nativo, Llama 3.1 8B en BF16, FP8 y NVFP4, y Mistral Small 24B y Qwen3 Coder 30B en BF16 y FP8.
GPT-OSS-20B
GPT-OSS-20B es la prueba más sencilla del conjunto, un punto de control que se adapta fácilmente a los tres sistemas. Con la misma carga de trabajo, el WS300 escaló sin problemas a 22 161 tokens de salida por segundo con 128 flujos concurrentes, aproximadamente 2.5 veces más que el RTX PRO 6000 (9,000) y 15 veces más que el DGX Spark (1,469). Los resultados de un solo flujo muestran lo mismo a menor escala: 530 tokens por segundo en la Station, 244 en la tarjeta y 50 en la Spark.
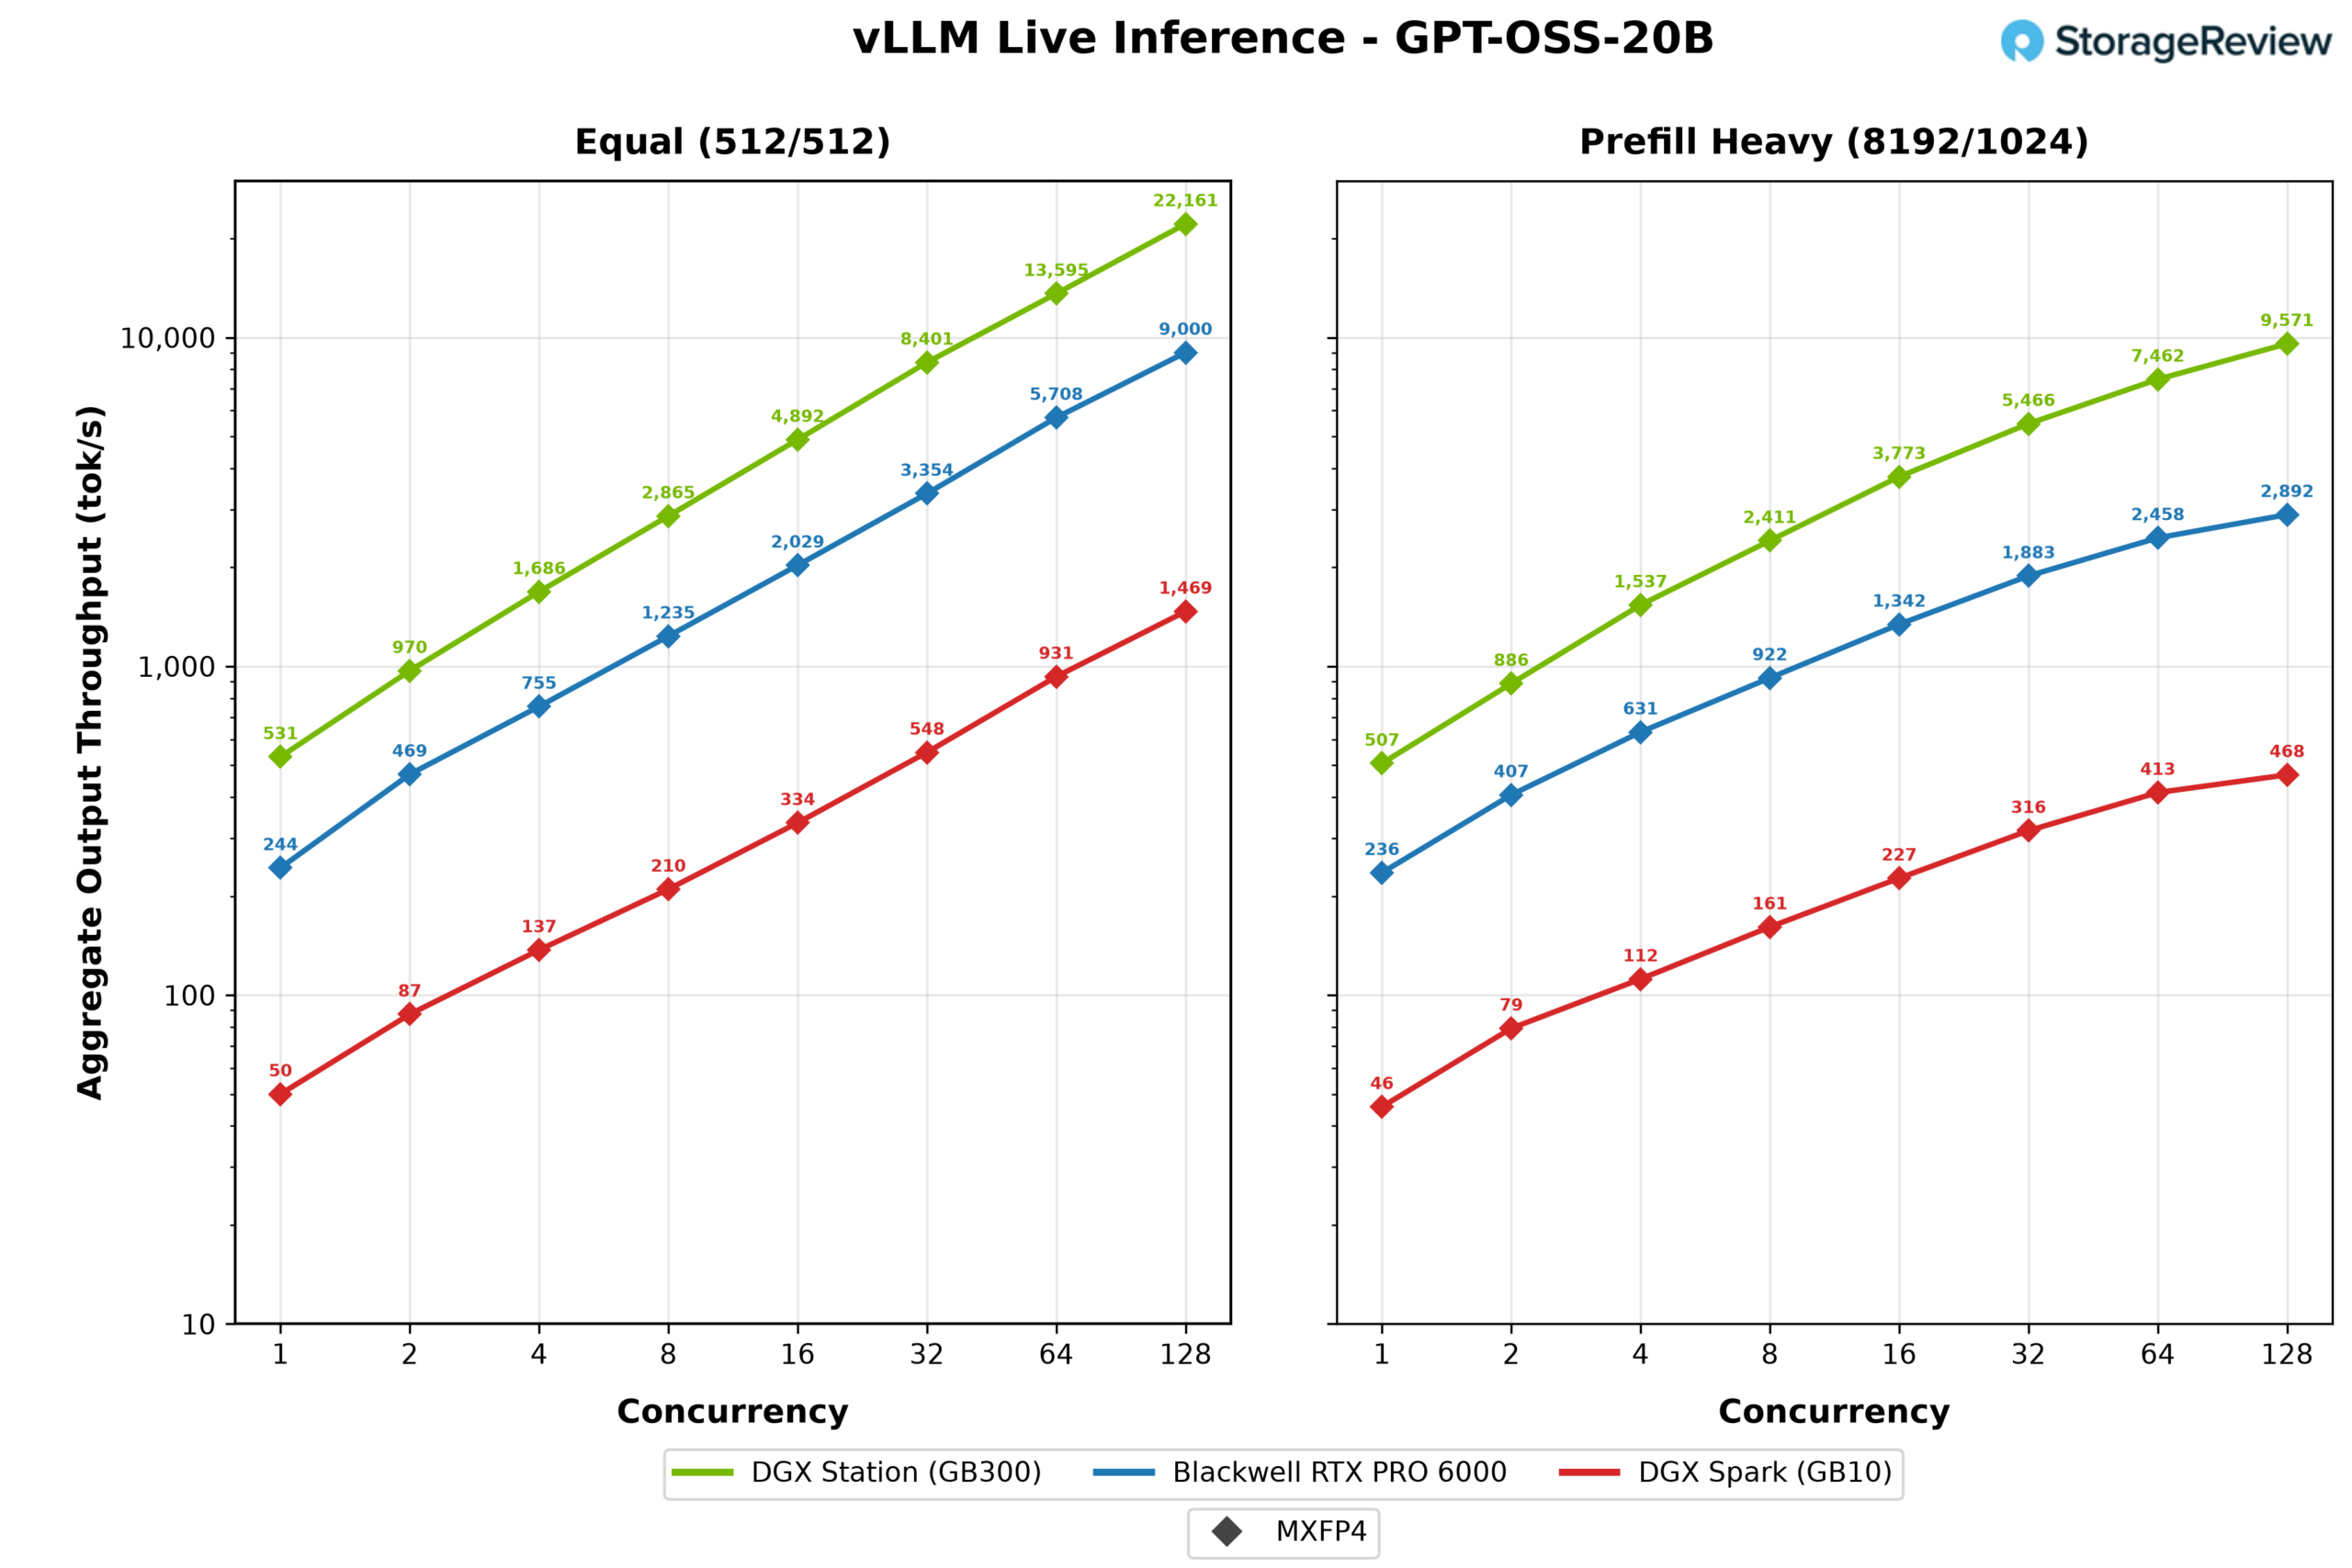
El escenario con gran cantidad de precarga marca aún más la diferencia. Al enviar 8,192 solicitudes de token, el WS300 aún entregó 9,572 tokens de salida por segundo en su pico máximo, lo que equivale a más de 86 000 tokens totales por segundo una vez que se cuenta la precarga, mientras que el RTX PRO 6000 alcanzó un máximo de 2,892 y el Spark de 468.
GPT-OSS-120B
Al pasar a GPT-OSS-120B, los tres sistemas aún pueden cargar el modelo, pero la jerarquía de memoria comienza a ser importante. El WS300 alcanzó un pico de 9,294 tokens de salida por segundo bajo la misma carga de trabajo, 2.7 veces más que el RTX PRO 6000 (3,384) y casi 19 veces más que el DGX Spark (500).
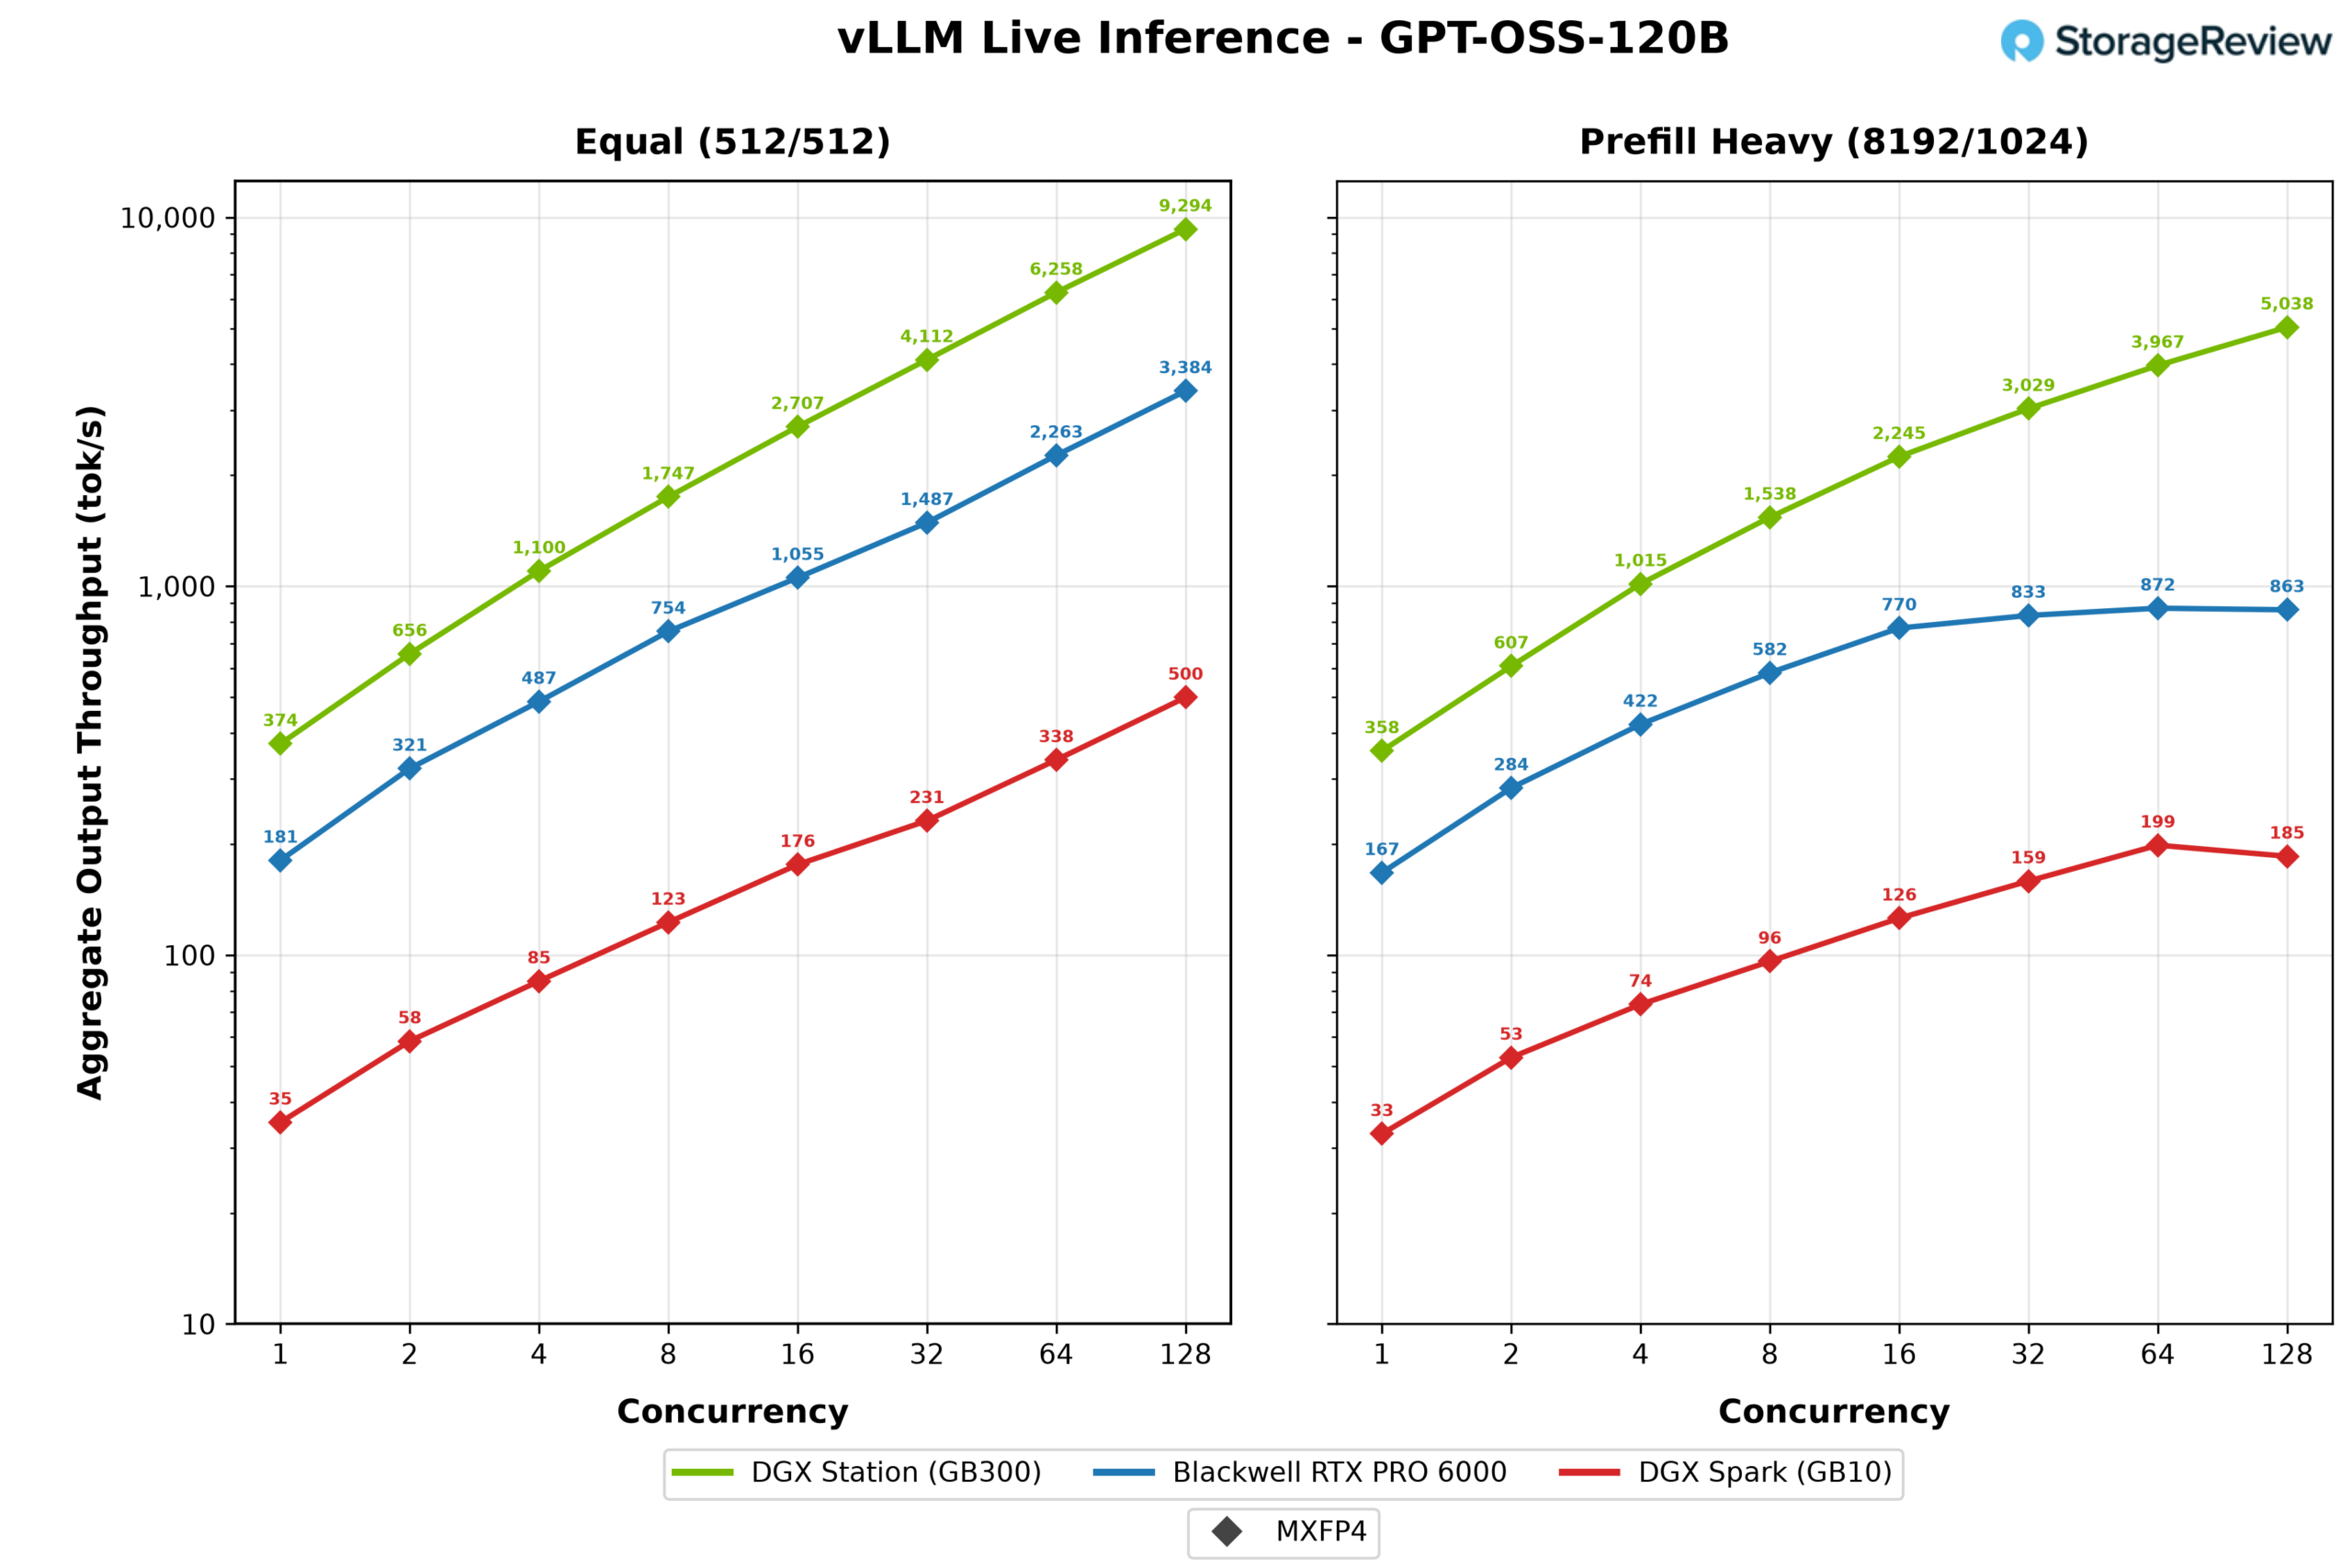
La ejecución intensiva de precarga es donde los sistemas más pequeños alcanzan sus límites. La RTX PRO 6000 se estancó en 872 tokens de salida por segundo con 64 flujos concurrentes, y la Spark en 199, mientras que la WS300 seguía aumentando con 128 flujos y finalizó en 5,038, una diferencia de casi 6 veces con respecto a la tarjeta. Las solicitudes largas saturan la caché KV, y los sistemas con menos capacidad de memoria se quedan sin espacio para el procesamiento por lotes mucho antes que la Station.
Llama 3.1 8B
Llama 3.1 8B es lo suficientemente pequeño como para que pudiéramos ejecutarlo en BF16, FP8 y NVFP4 en cada sistema, lo que permite observar con mayor claridad el rendimiento de la cuantización en cada máquina. Con 128 flujos concurrentes y la misma carga de trabajo, el WS300 pasó de 17 278 tokens de salida por segundo en BF16 a 28 698 en NVFP4, una ganancia del 66 %. El RTX PRO 6000 obtuvo una ganancia del 114 % con el mismo cambio, de 5,720 a 12 269, y el DGX Spark obtuvo una ganancia del 143 %, de 828 a 2,009. Es importante recordar el patrón: cuanto más pequeña es la máquina, mayor es el beneficio de la cuantización.
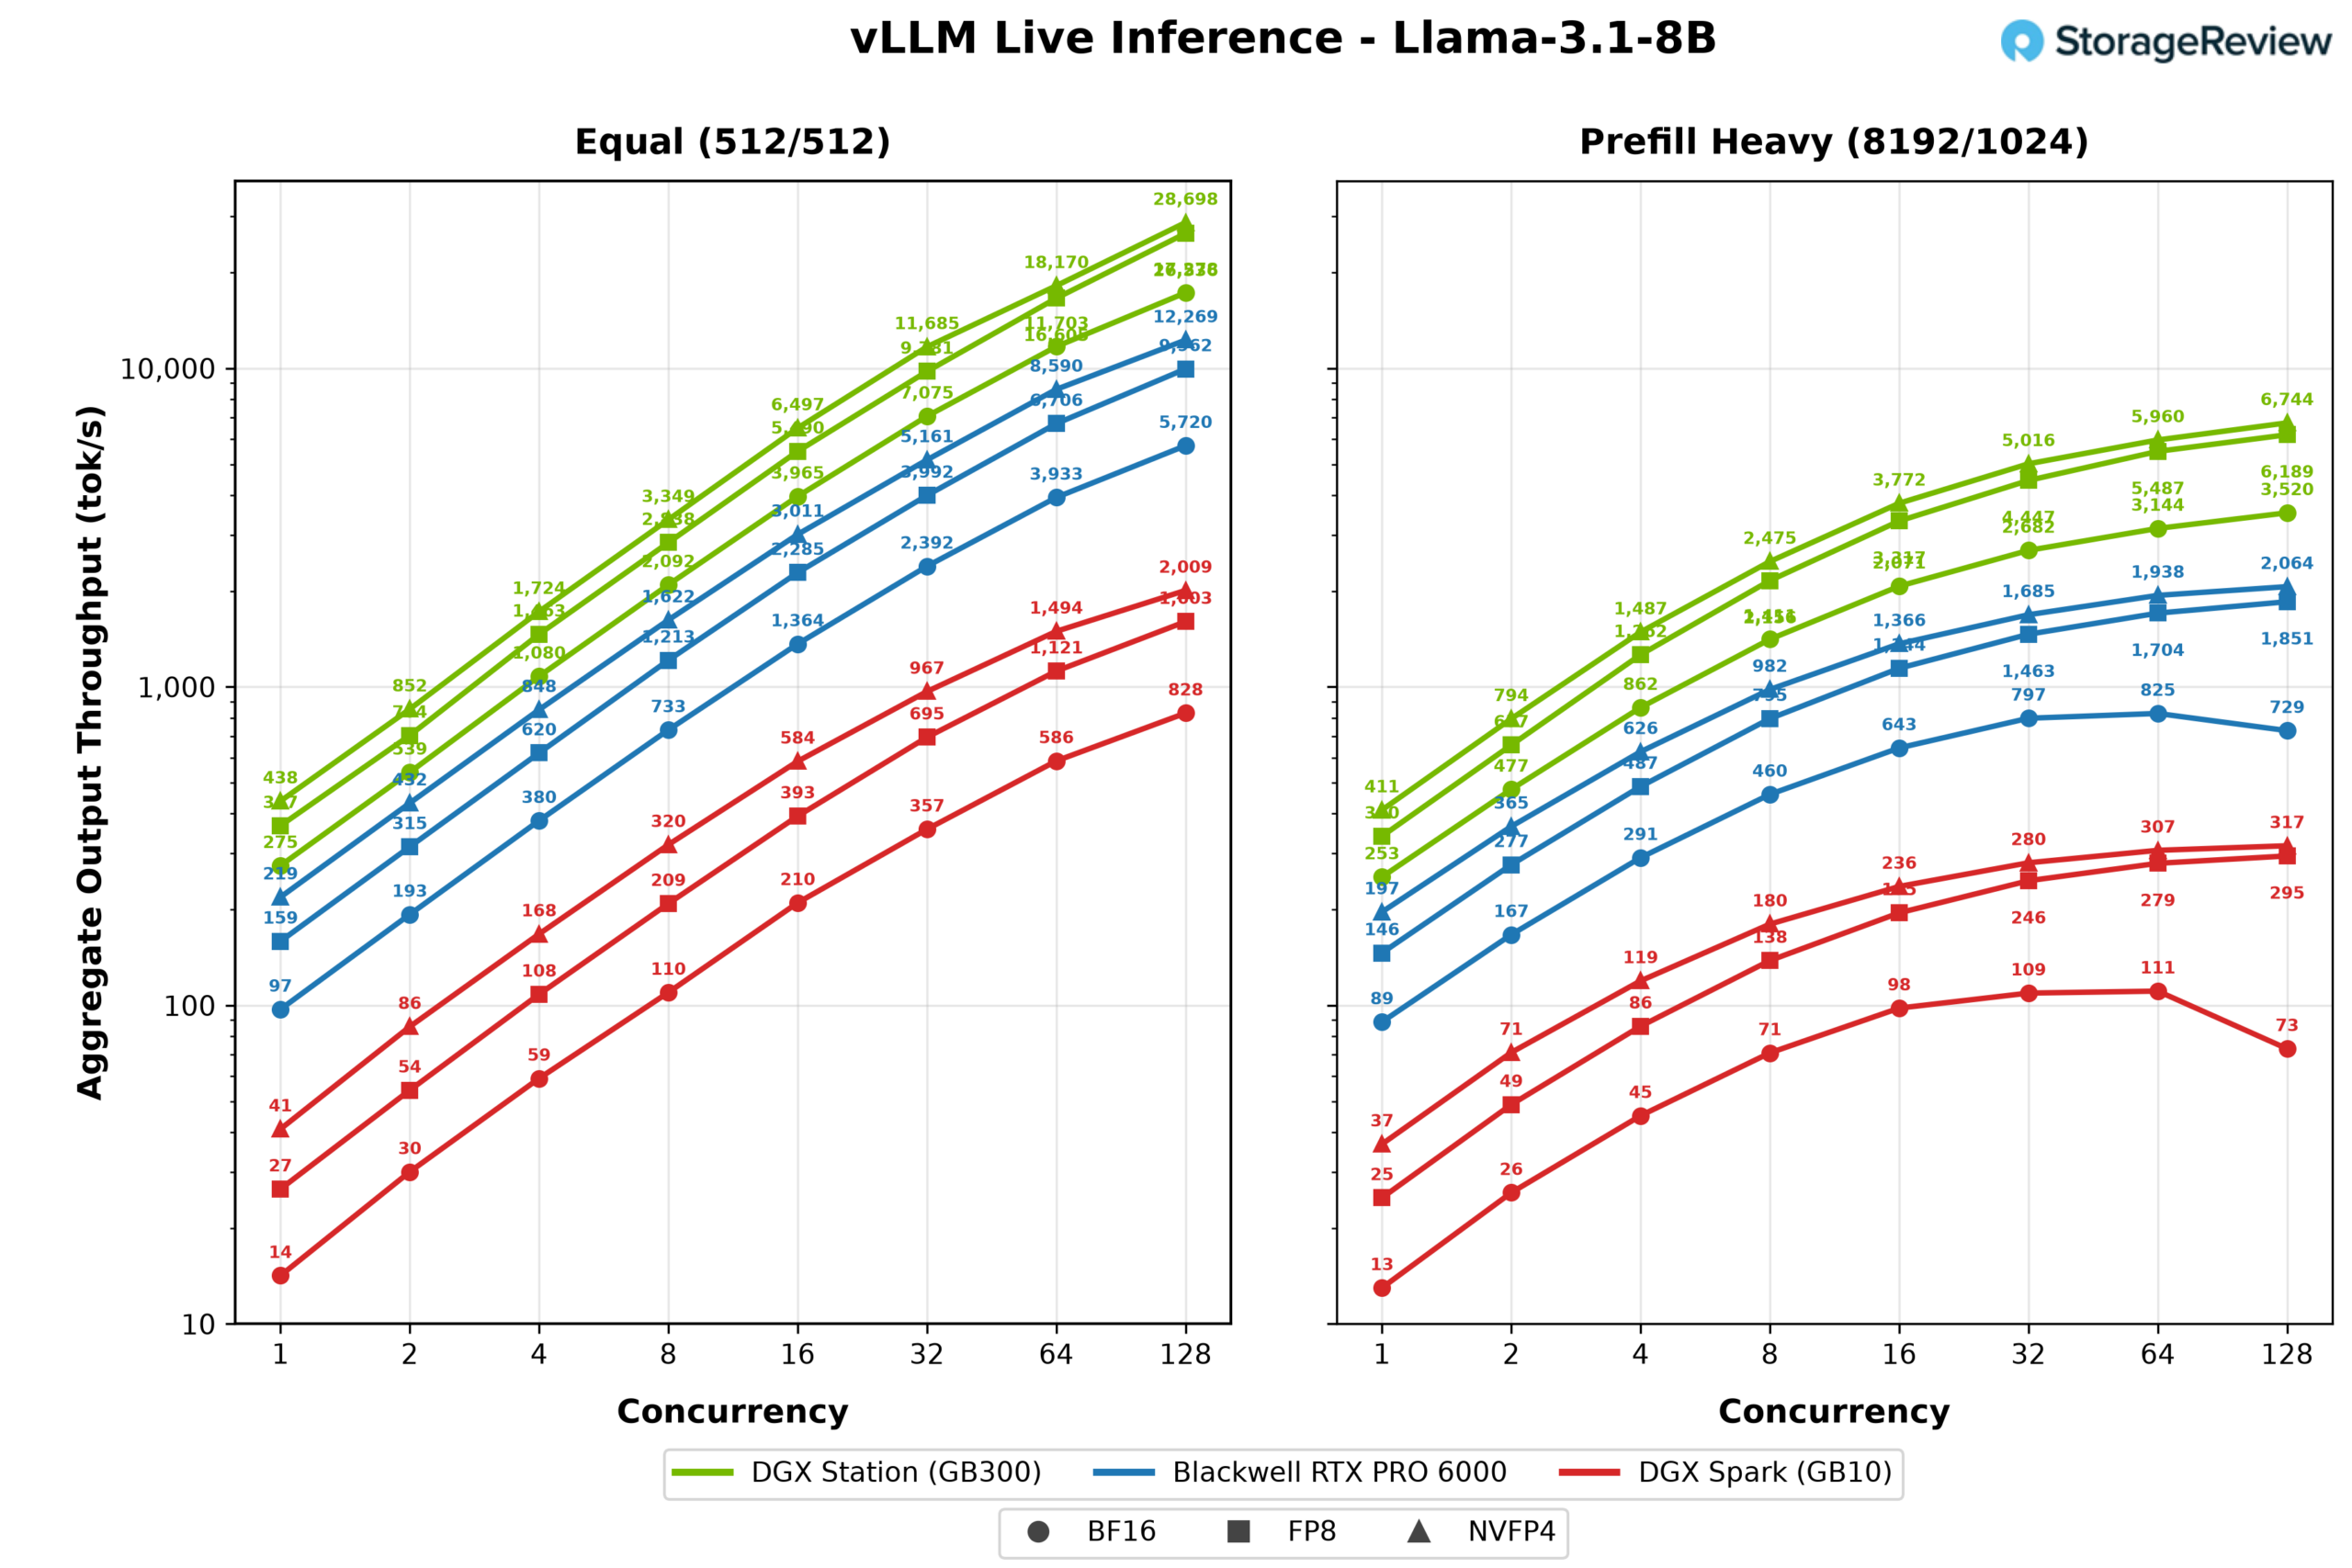
Los resultados de prellenado intensivo comprimen todo el campo, con la ejecución NVFP4 del WS300 alcanzando un pico de 6,744 tokens de salida por segundo frente a 2,064 para la tarjeta y 317 para el Spark.
Mistral Pequeño 24B
Mistral Small 24B produjo las mayores brechas del conjunto. En FP8 con la misma carga de trabajo, el WS300 alcanzó un pico de 11,157 tokens de salida por segundo, tres veces más que el RTX PRO 6000 (3,779) y 19 veces más que el DGX Spark (585). En una sola transmisión, los 169 tokens por segundo de la Station se acercan mucho más a la comodidad interactiva que los 9 del Spark.
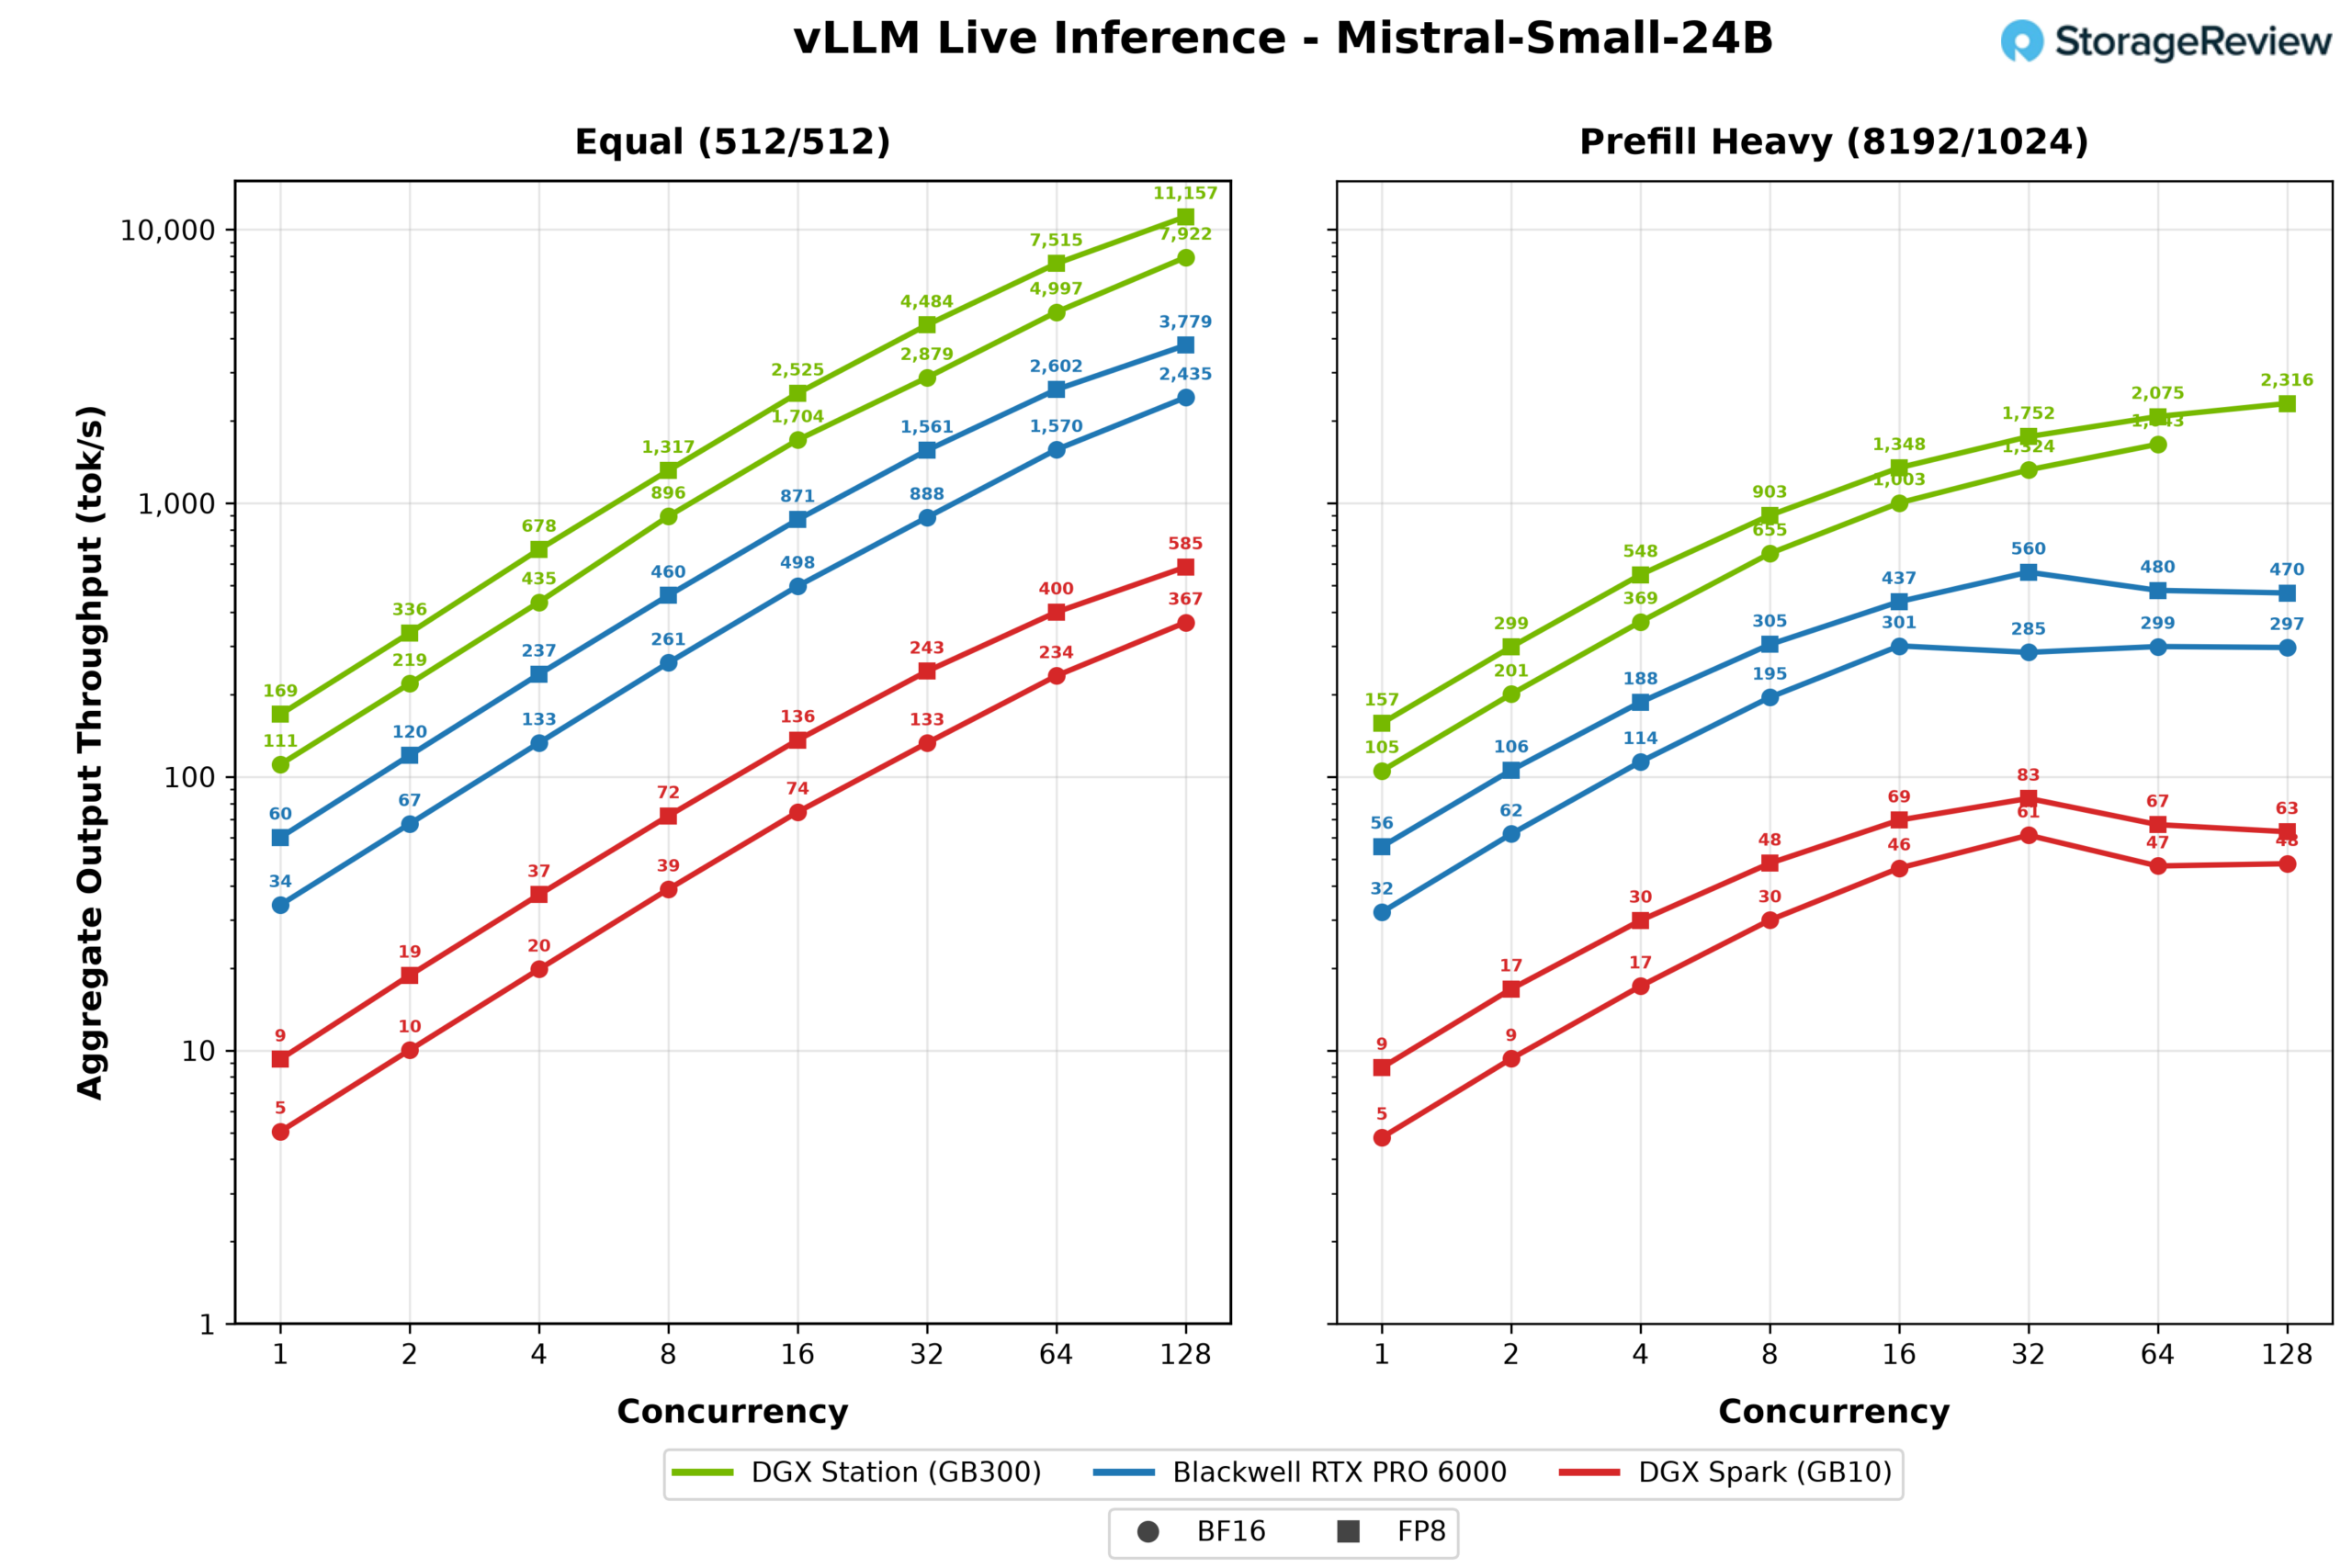
Bajo una carga pesada de prellenado, la RTX PRO 6000 alcanzó un pico de solo 32 transmisiones simultáneas y 560 tokens de salida por segundo antes de disminuir, mientras que la WS300 continuó hasta 2,316 con 128 transmisiones.
Codificador Qwen3 30B
Qwen3 Coder 30B, un modelo de mezcla de expertos con un pequeño número de parámetros activos, es la única prueba donde los sistemas más pequeños reducen la brecha de un solo flujo. Con una solicitud concurrente bajo la misma carga de trabajo, la RTX PRO 6000 entregó 208 tokens de salida por segundo frente a los 310 de la WS300, el resultado más cercano a la Station en esta comparación, e incluso la Spark logró un valor utilizable de 55. El procesamiento por lotes restablece el orden habitual: con 128 flujos, los 12,425 tokens de salida por segundo de la Station en FP8 son 2.4 veces superiores a los de la tarjeta y casi 16 veces superiores a los de la Spark.
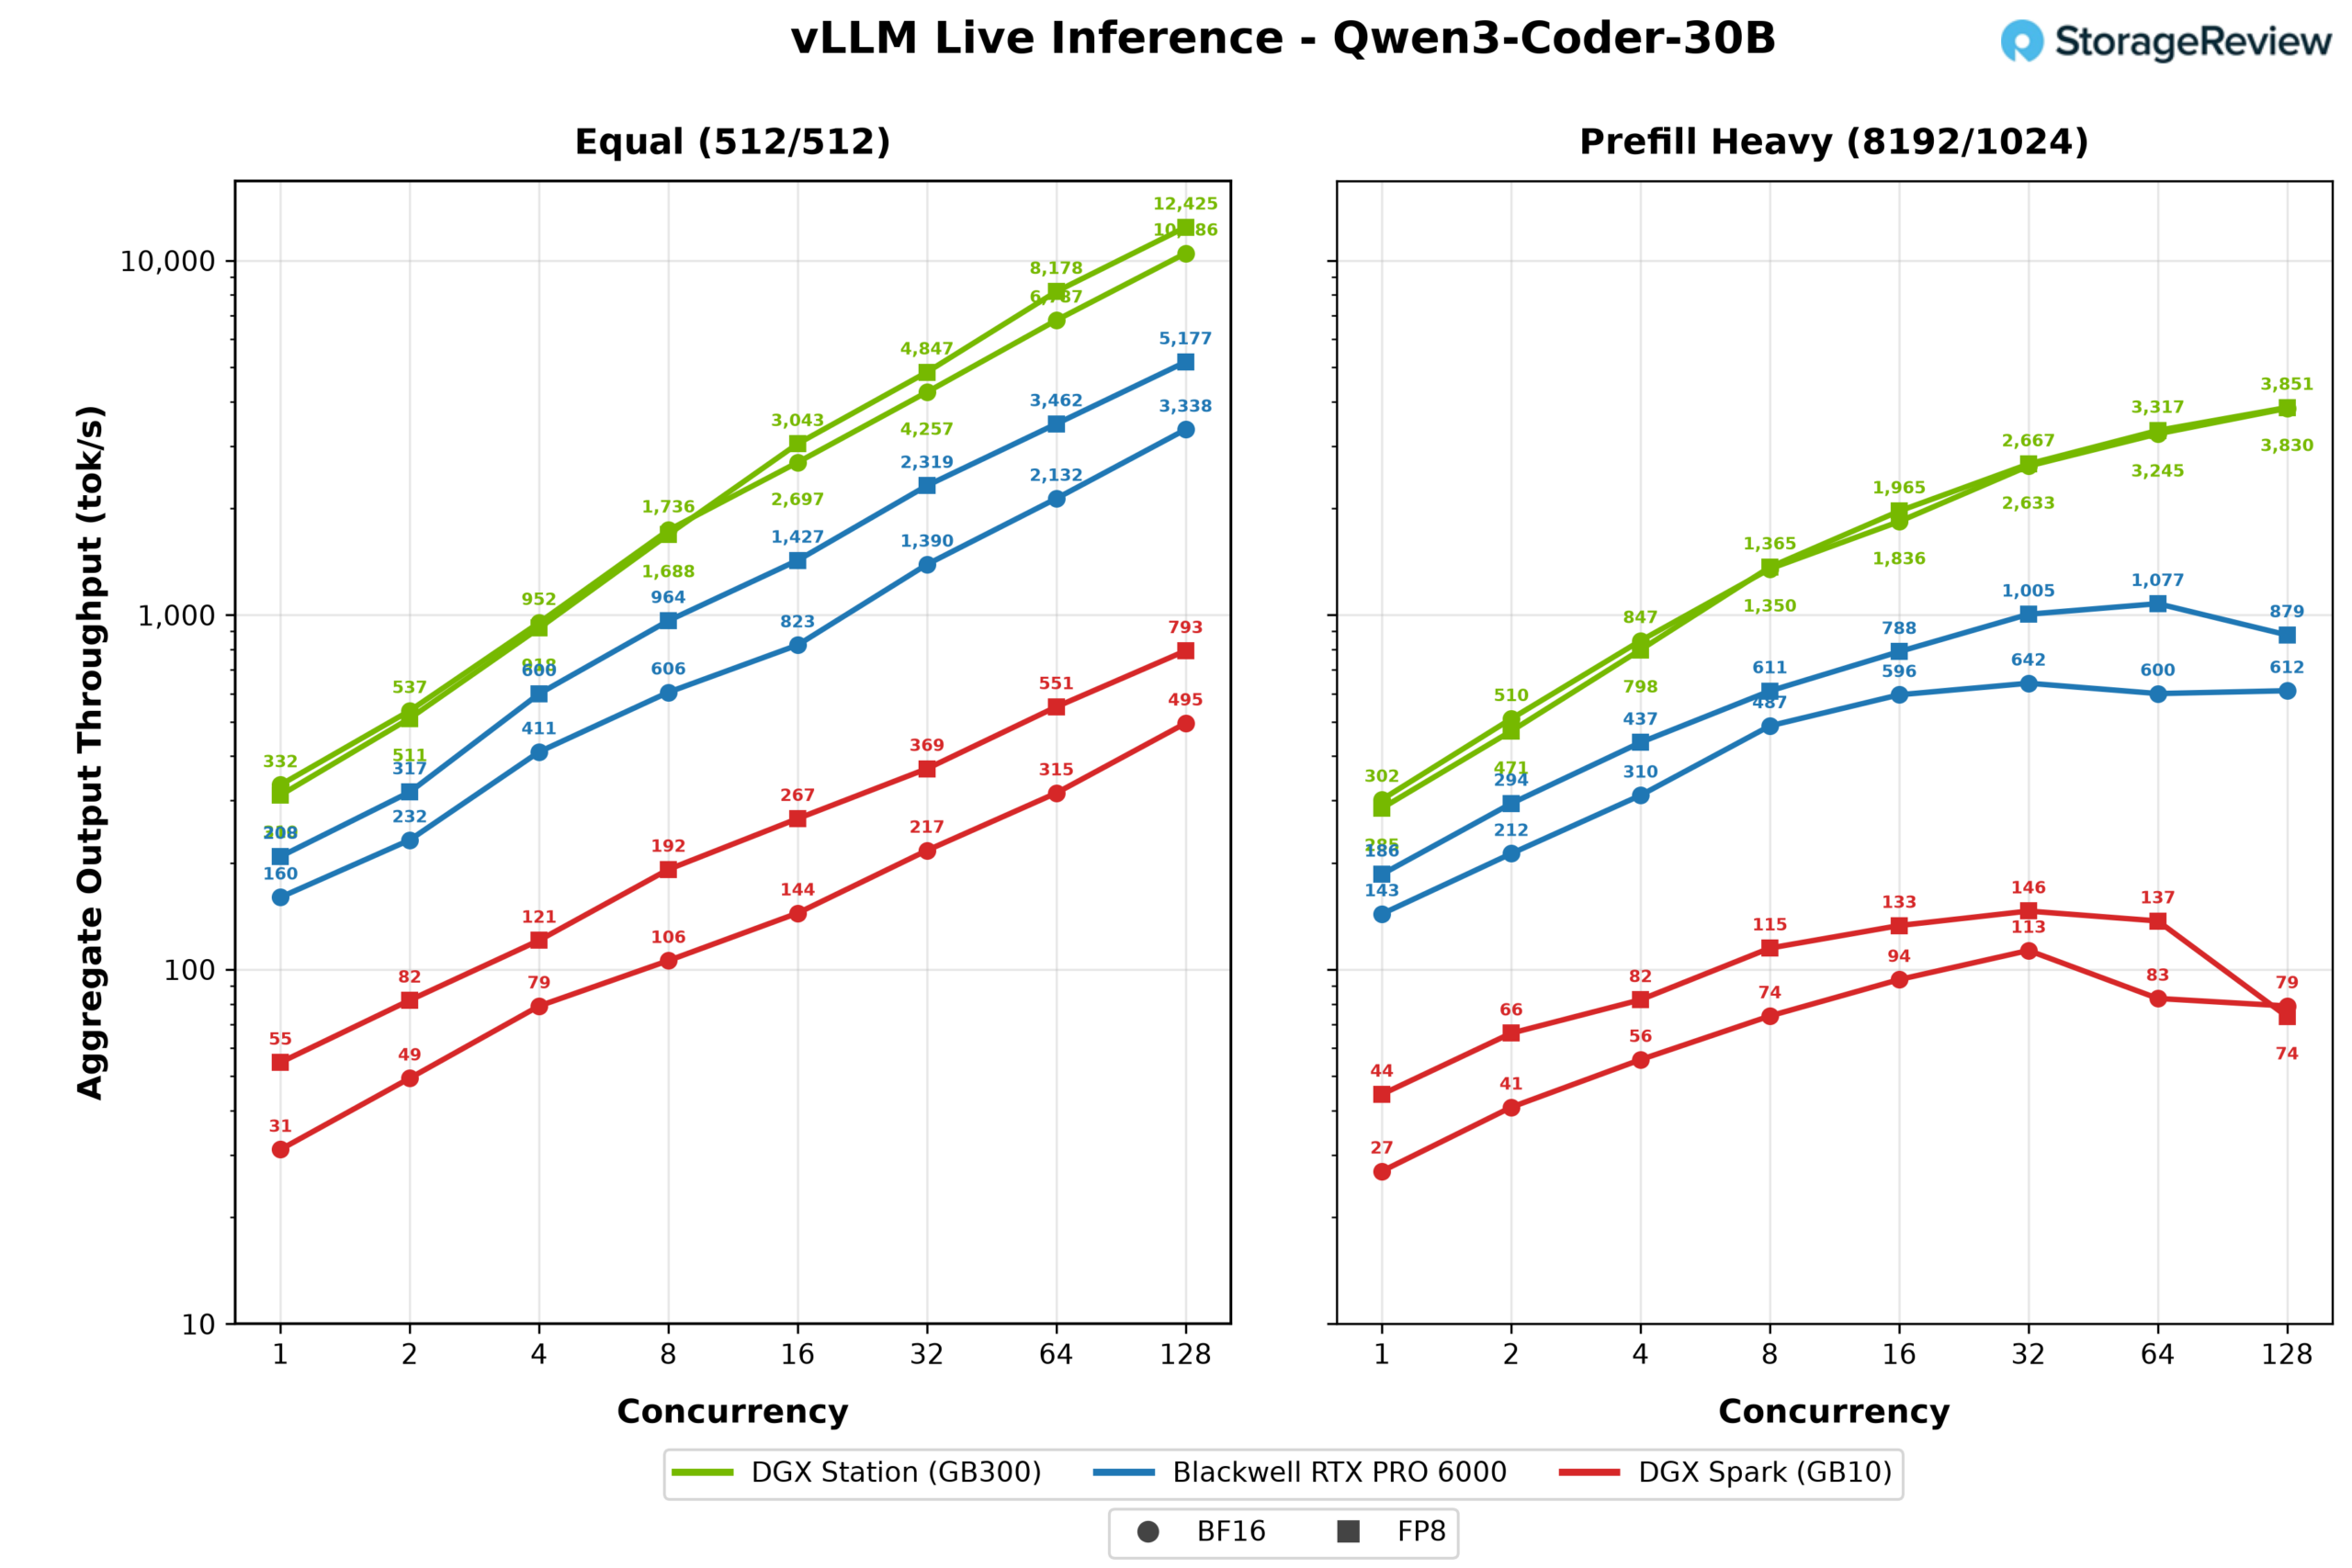
El prefill pesado siguió el patrón establecido, con el WS300 alcanzando 3,851 tokens de salida por segundo, mientras que la tarjeta llegó a un máximo de 1,077 y el Spark a 146.
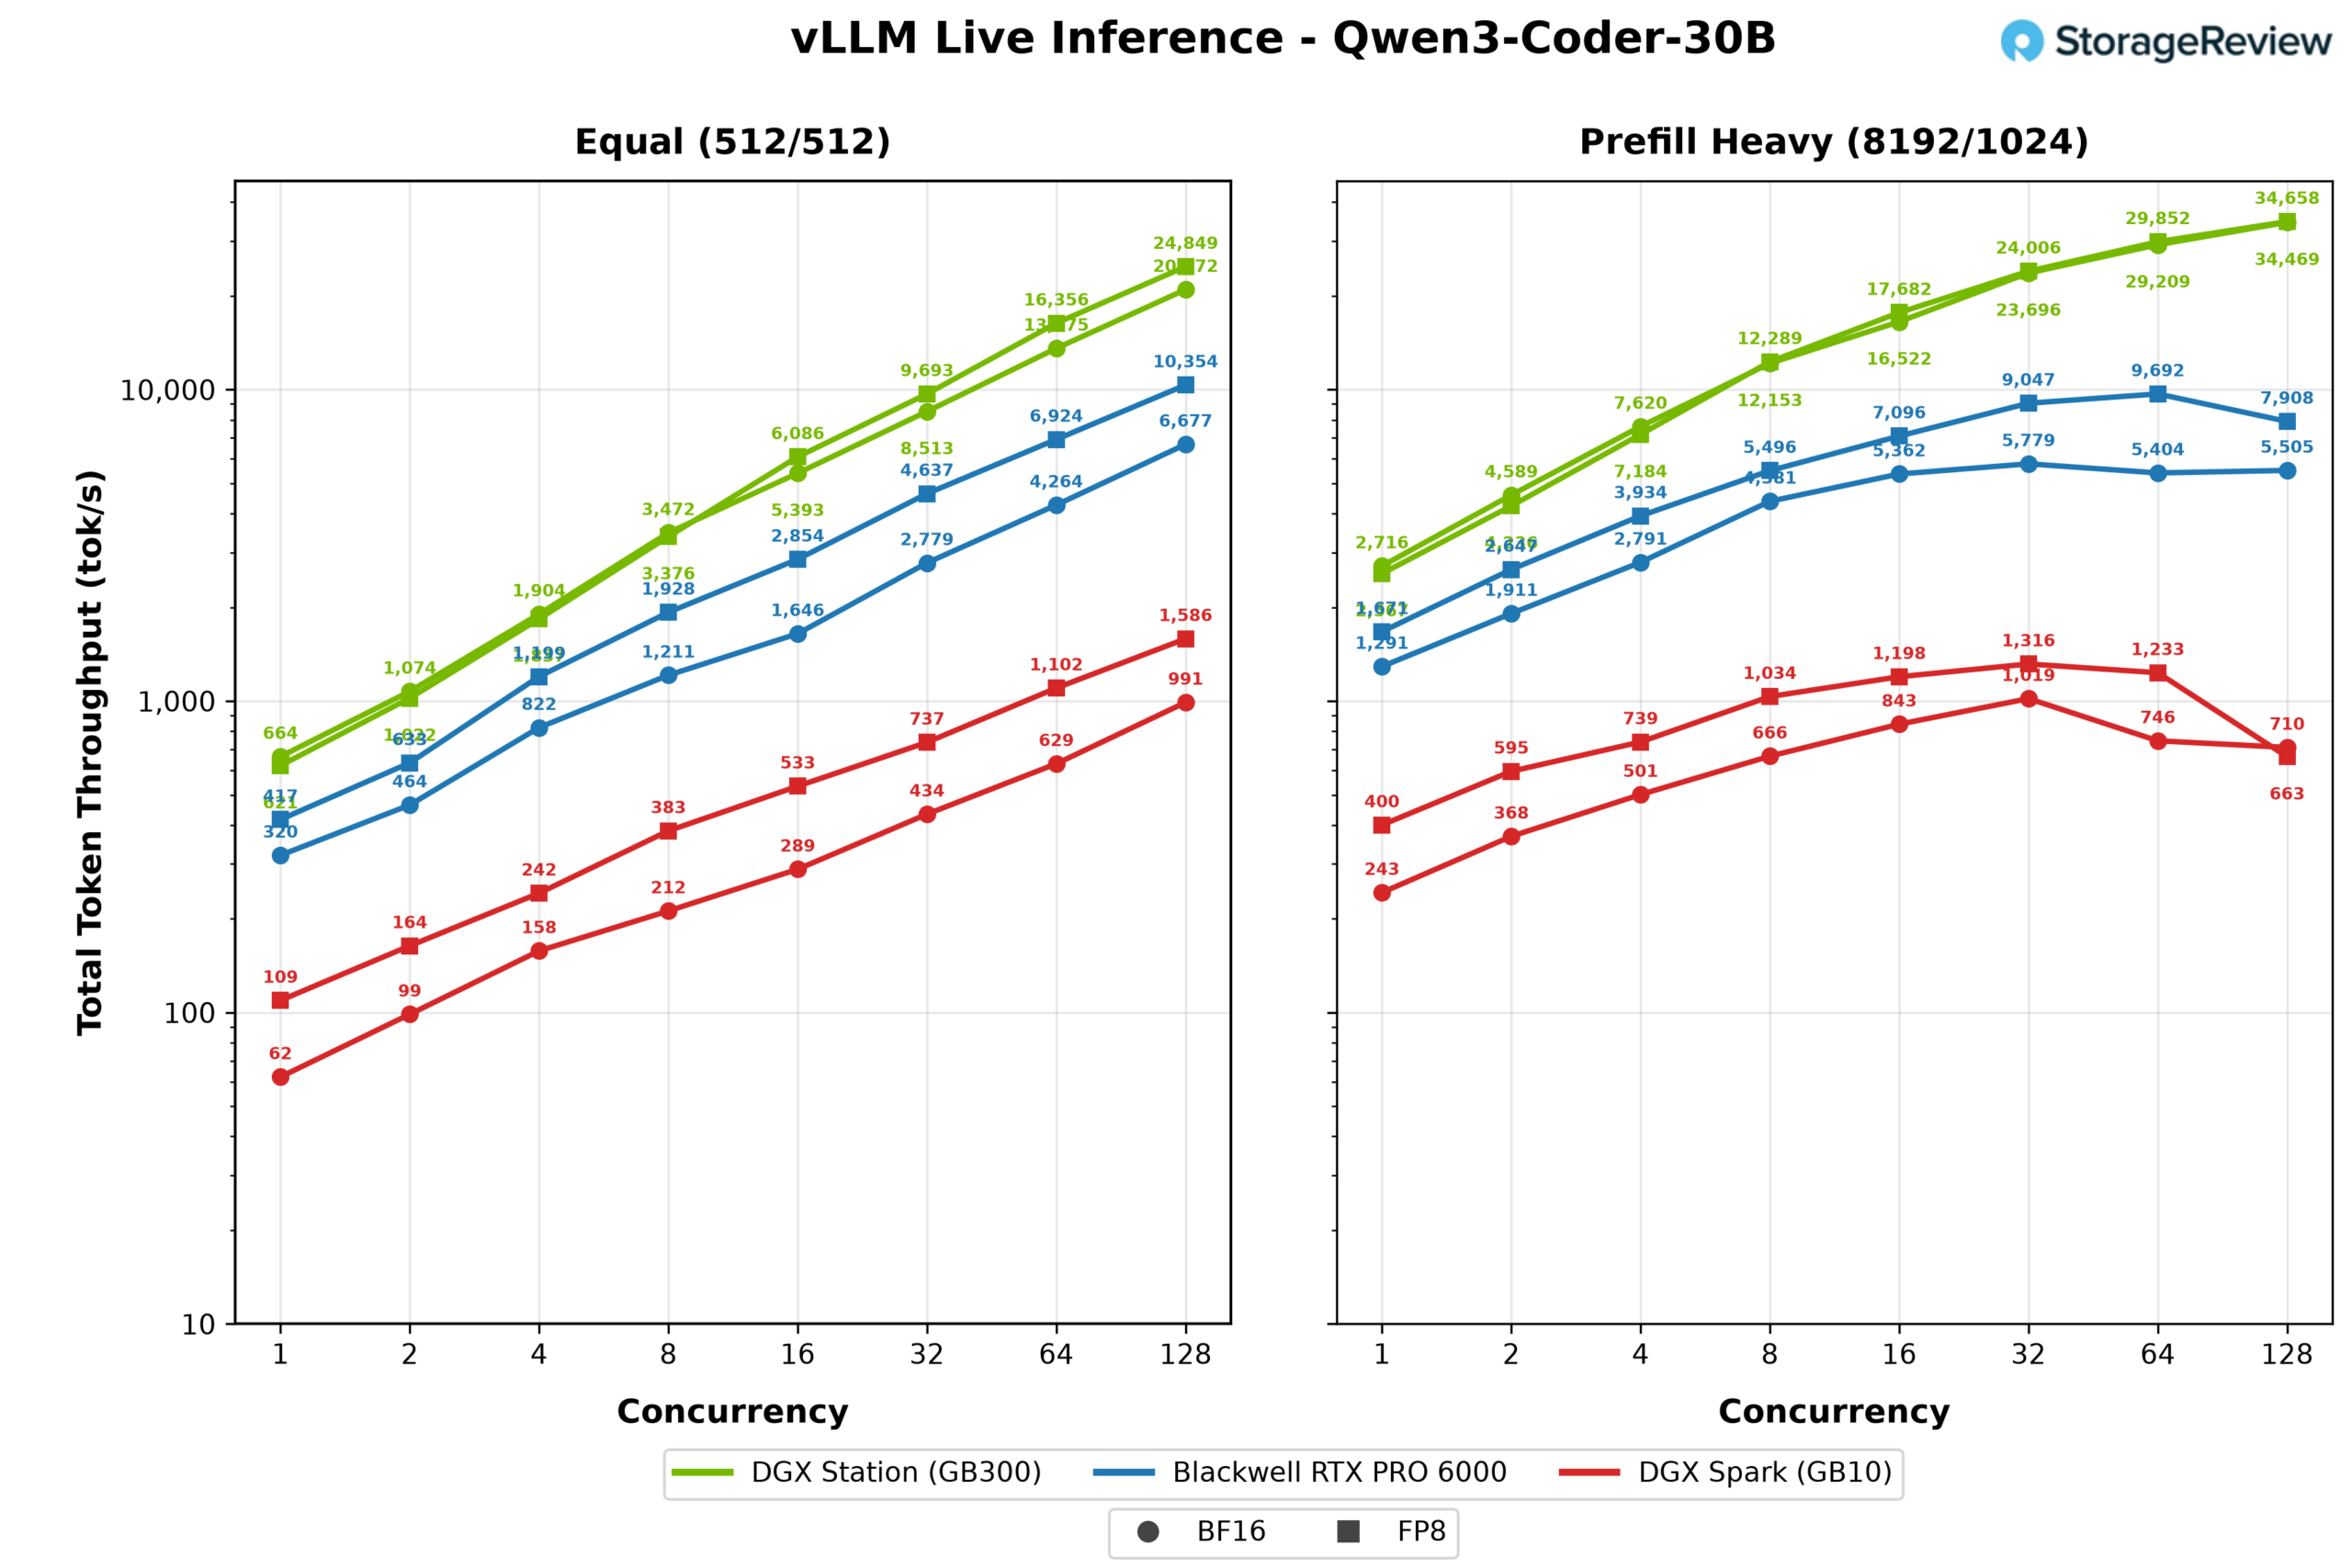
En los cinco modelos compartidos, el WS300 alcanzó entre 2.3 y 3 veces el rendimiento del Blackwell RTX PRO 6000 y entre 14 y 19 veces el del DGX Spark a plena concurrencia, con un margen que se amplía hasta 6 veces sobre la tarjeta cuando las solicitudes largas ponen a prueba la caché KV. Las tres máquinas ejecutan la misma pila CUDA y las mismas rutas de cuantización; lo que la Station adquiere es capacidad de memoria y ancho de banda, que se muestran aquí como margen de concurrencia y tolerancia a contextos largos. Igual de importante es lo que estos gráficos no pueden mostrar: ninguno de los modelos de escala fronteriza de las secciones anteriores siquiera se cargará en los otros dos sistemas.
GDSIO
Las cargas de trabajo de IA modernas dependen de transferir lotes de datos, ponderaciones de modelos y puntos de control desde el almacenamiento a la memoria de la GPU con la suficiente rapidez para mantener el acelerador ocupado. NVIDIA GPUDirect Storage elimina el método tradicional de doble copia, en el que los datos se leen primero desde una unidad SSD a la memoria del sistema y luego se copian a la memoria de la GPU.
La estación GB300 DGX implementa esto de manera diferente a un servidor GPU PCIe convencional. El Micron 4600 utilizado para nuestra prueba está conectado al conmutador PCIe integrado en ConnectX-8. ConnectX-8 se conecta a la CPU Grace, mientras que la GPU B300 se conecta a Grace a través de NVLink-C2C. La unidad SSD y la GPU no se encuentran bajo el mismo conmutador PCIe. El tráfico de almacenamiento pasa a través del conmutador ConnectX-8, ingresa al complejo raíz PCIe de Grace, atraviesa la estructura de coherencia de Grace y cruza NVLink-C2C para llegar a la memoria HBM3e de la B300.
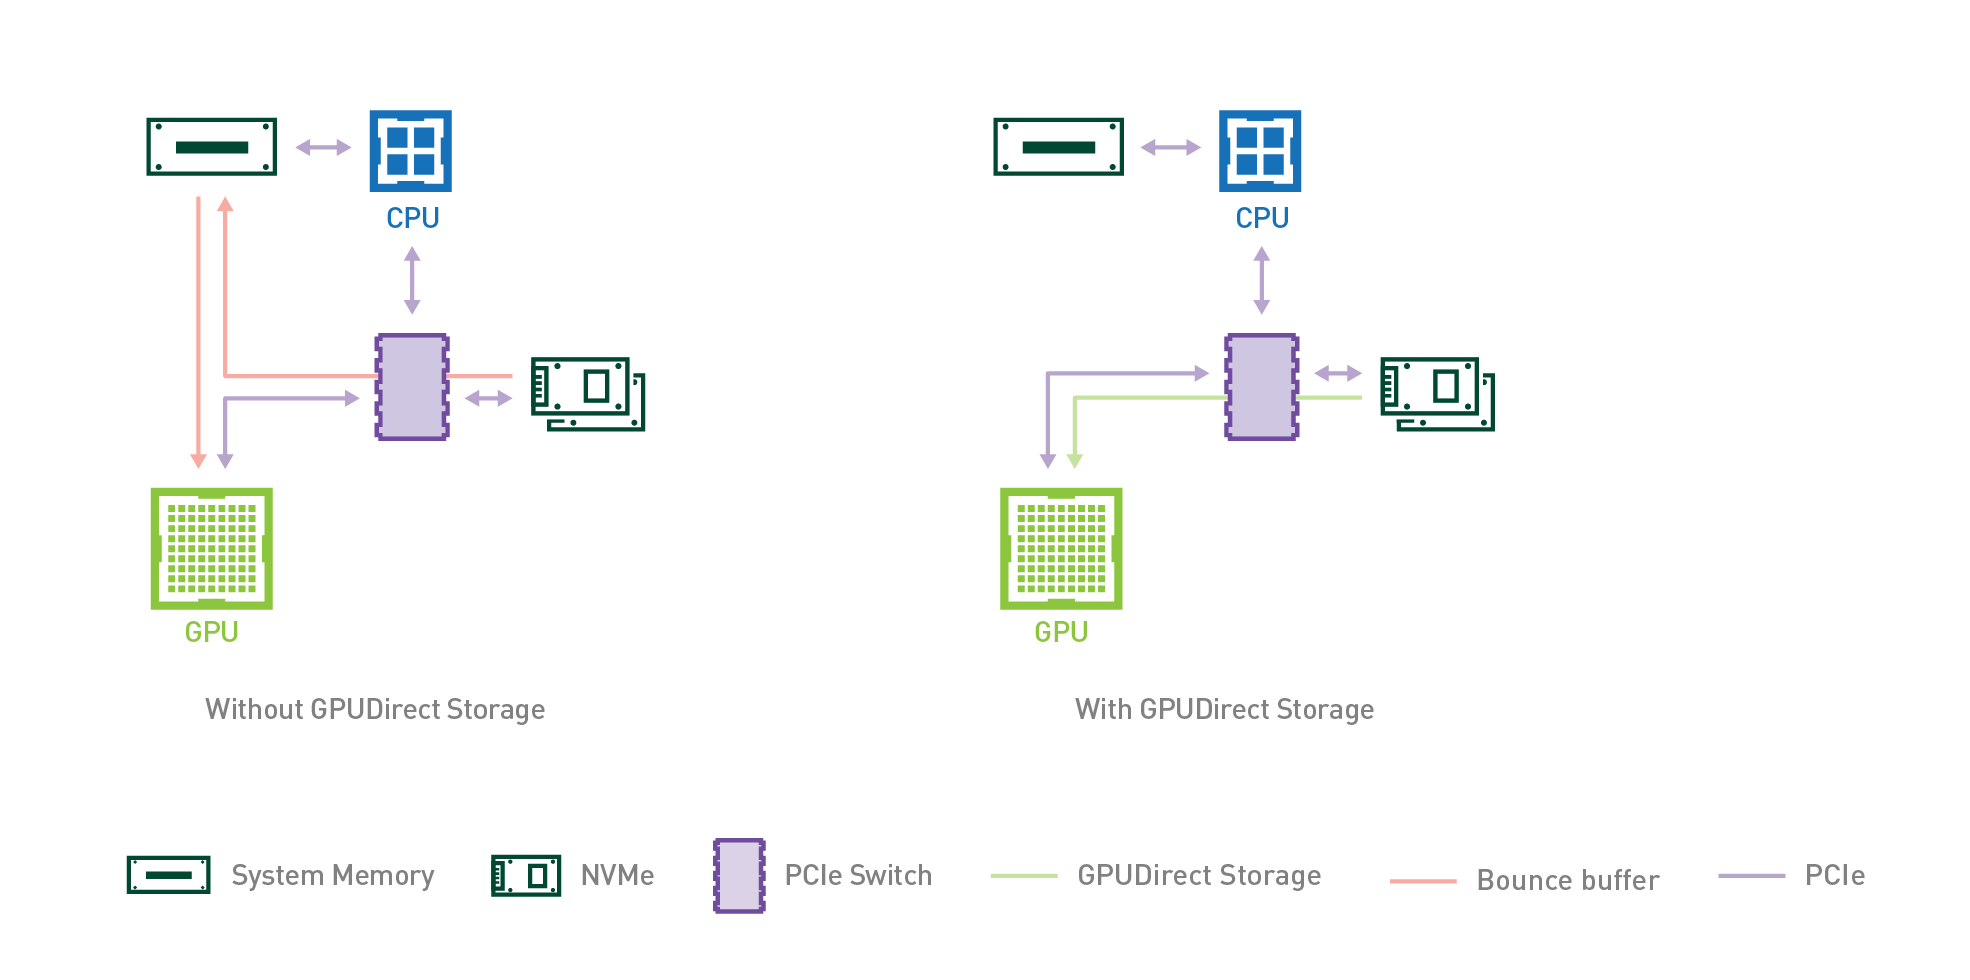
Con GPUDirect Storage, cuFile registra un búfer asignado en B300 HBM3e como origen o destino para E/S de almacenamiento. En una lectura, el controlador del Micron 4600 usa DMA para colocar datos en HBM3e; en una escritura, recupera datos de HBM3e. Ambas operaciones siguen la ruta Grace y NVLink-C2C descrita anteriormente sin almacenar la carga útil en la memoria LPDDR5X de Grace. Grace sigue gestionando el sistema de archivos y el plano de control NVMe, incluyendo el envío de comandos y la traducción de direcciones, pero no copia los datos. Por lo tanto, GPUDirect Storage elimina el paso de almacenamiento en memoria del sistema, aunque el tráfico sigue pasando por Grace en su camino entre la SSD y la memoria B300. Para cargas de trabajo de IA, las lecturas secuenciales corresponden a la transmisión de conjuntos de datos, la carga de modelos y las restauraciones de puntos de control, mientras que las escrituras secuenciales corresponden a los guardados de puntos de control y otras transferencias de vuelta al almacenamiento. Para probar el rendimiento de GDSIO, medimos el rendimiento del almacenamiento utilizando una SSD secundaria independiente.
Configuración de prueba de GDSIO
- Almacenamiento de arranque: 2 x Micron 4600 de 2 TB en RAID1
- Almacenamiento secundario: 2 x Micron 4600 de 2 TB
En cuanto al rendimiento de lectura secuencial GDSIO, la unidad escala de forma consistente tanto con el número de subprocesos como con el tamaño del bloque. Con un tamaño de bloque de 16 KB, el rendimiento aumenta de 16 MiB/s con 1 subproceso a 250 MiB/s con 16 subprocesos, alcanzando los 2.0 GiB/s con 128 subprocesos. Los tamaños de bloque mayores aumentan mucho más rápido: con 256 KB, se alcanzan los 11.8 GiB/s con 64 subprocesos y se llega a un máximo de 12.9 GiB/s con 128 subprocesos. Los mejores resultados se obtienen con tamaños de bloque de 512 KB y 1 MB, donde el rendimiento máximo alcanza los 13.1 GiB/s. La carga de trabajo de 1 MB alcanza ese nivel con tan solo 32 subprocesos y lo mantiene hasta los 128 subprocesos.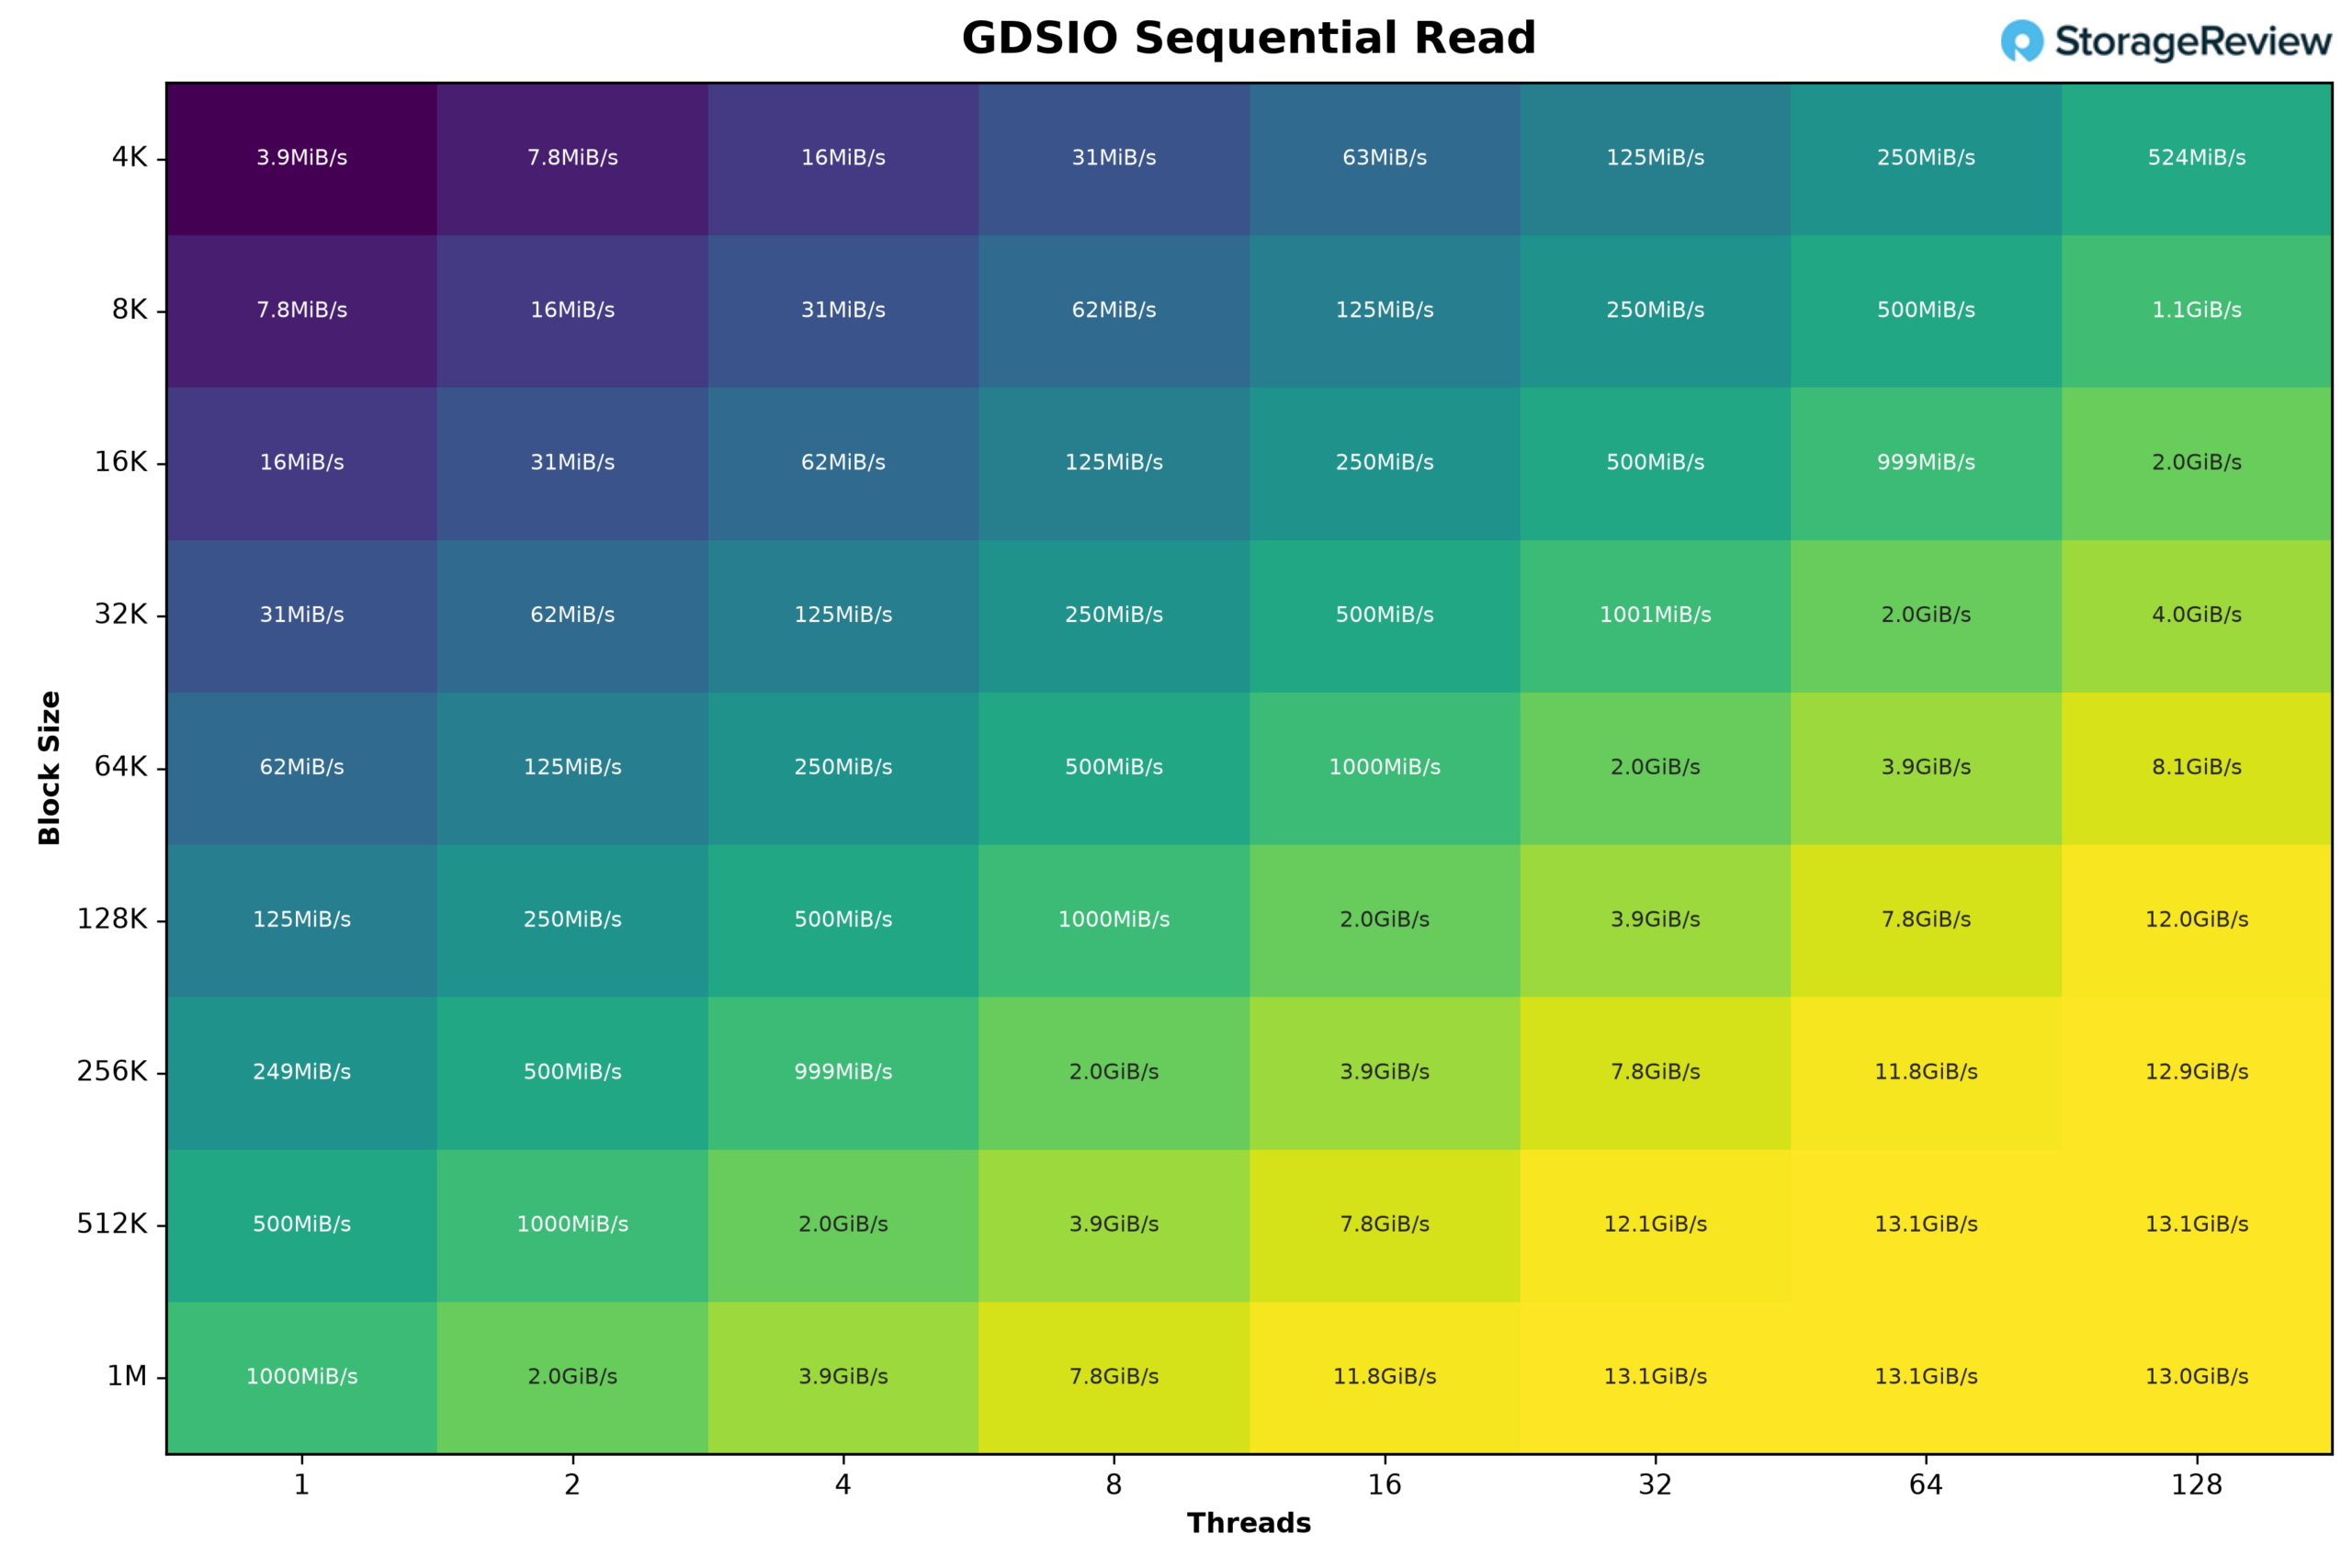
En cuanto al rendimiento de escritura secuencial GDSIO, la unidad escala de forma consistente tanto con el número de subprocesos como con el tamaño del bloque. Con un tamaño de bloque de 16 KB, el rendimiento aumenta de 16 MiB/s con 1 subproceso a 250 MiB/s con 16 subprocesos, alcanzando los 2.0 GiB/s con 128 subprocesos. Los tamaños de bloque mayores aumentan mucho más rápido: con 256 KB se alcanzan los 7.5 GiB/s con 32 subprocesos y los 12.0 GiB/s con 64 subprocesos. El mejor resultado se obtiene con la carga de trabajo de 1 MB, que alcanza el límite de 12.0 GiB/s con tan solo 16 subprocesos y mantiene ese rendimiento hasta los 128 subprocesos. 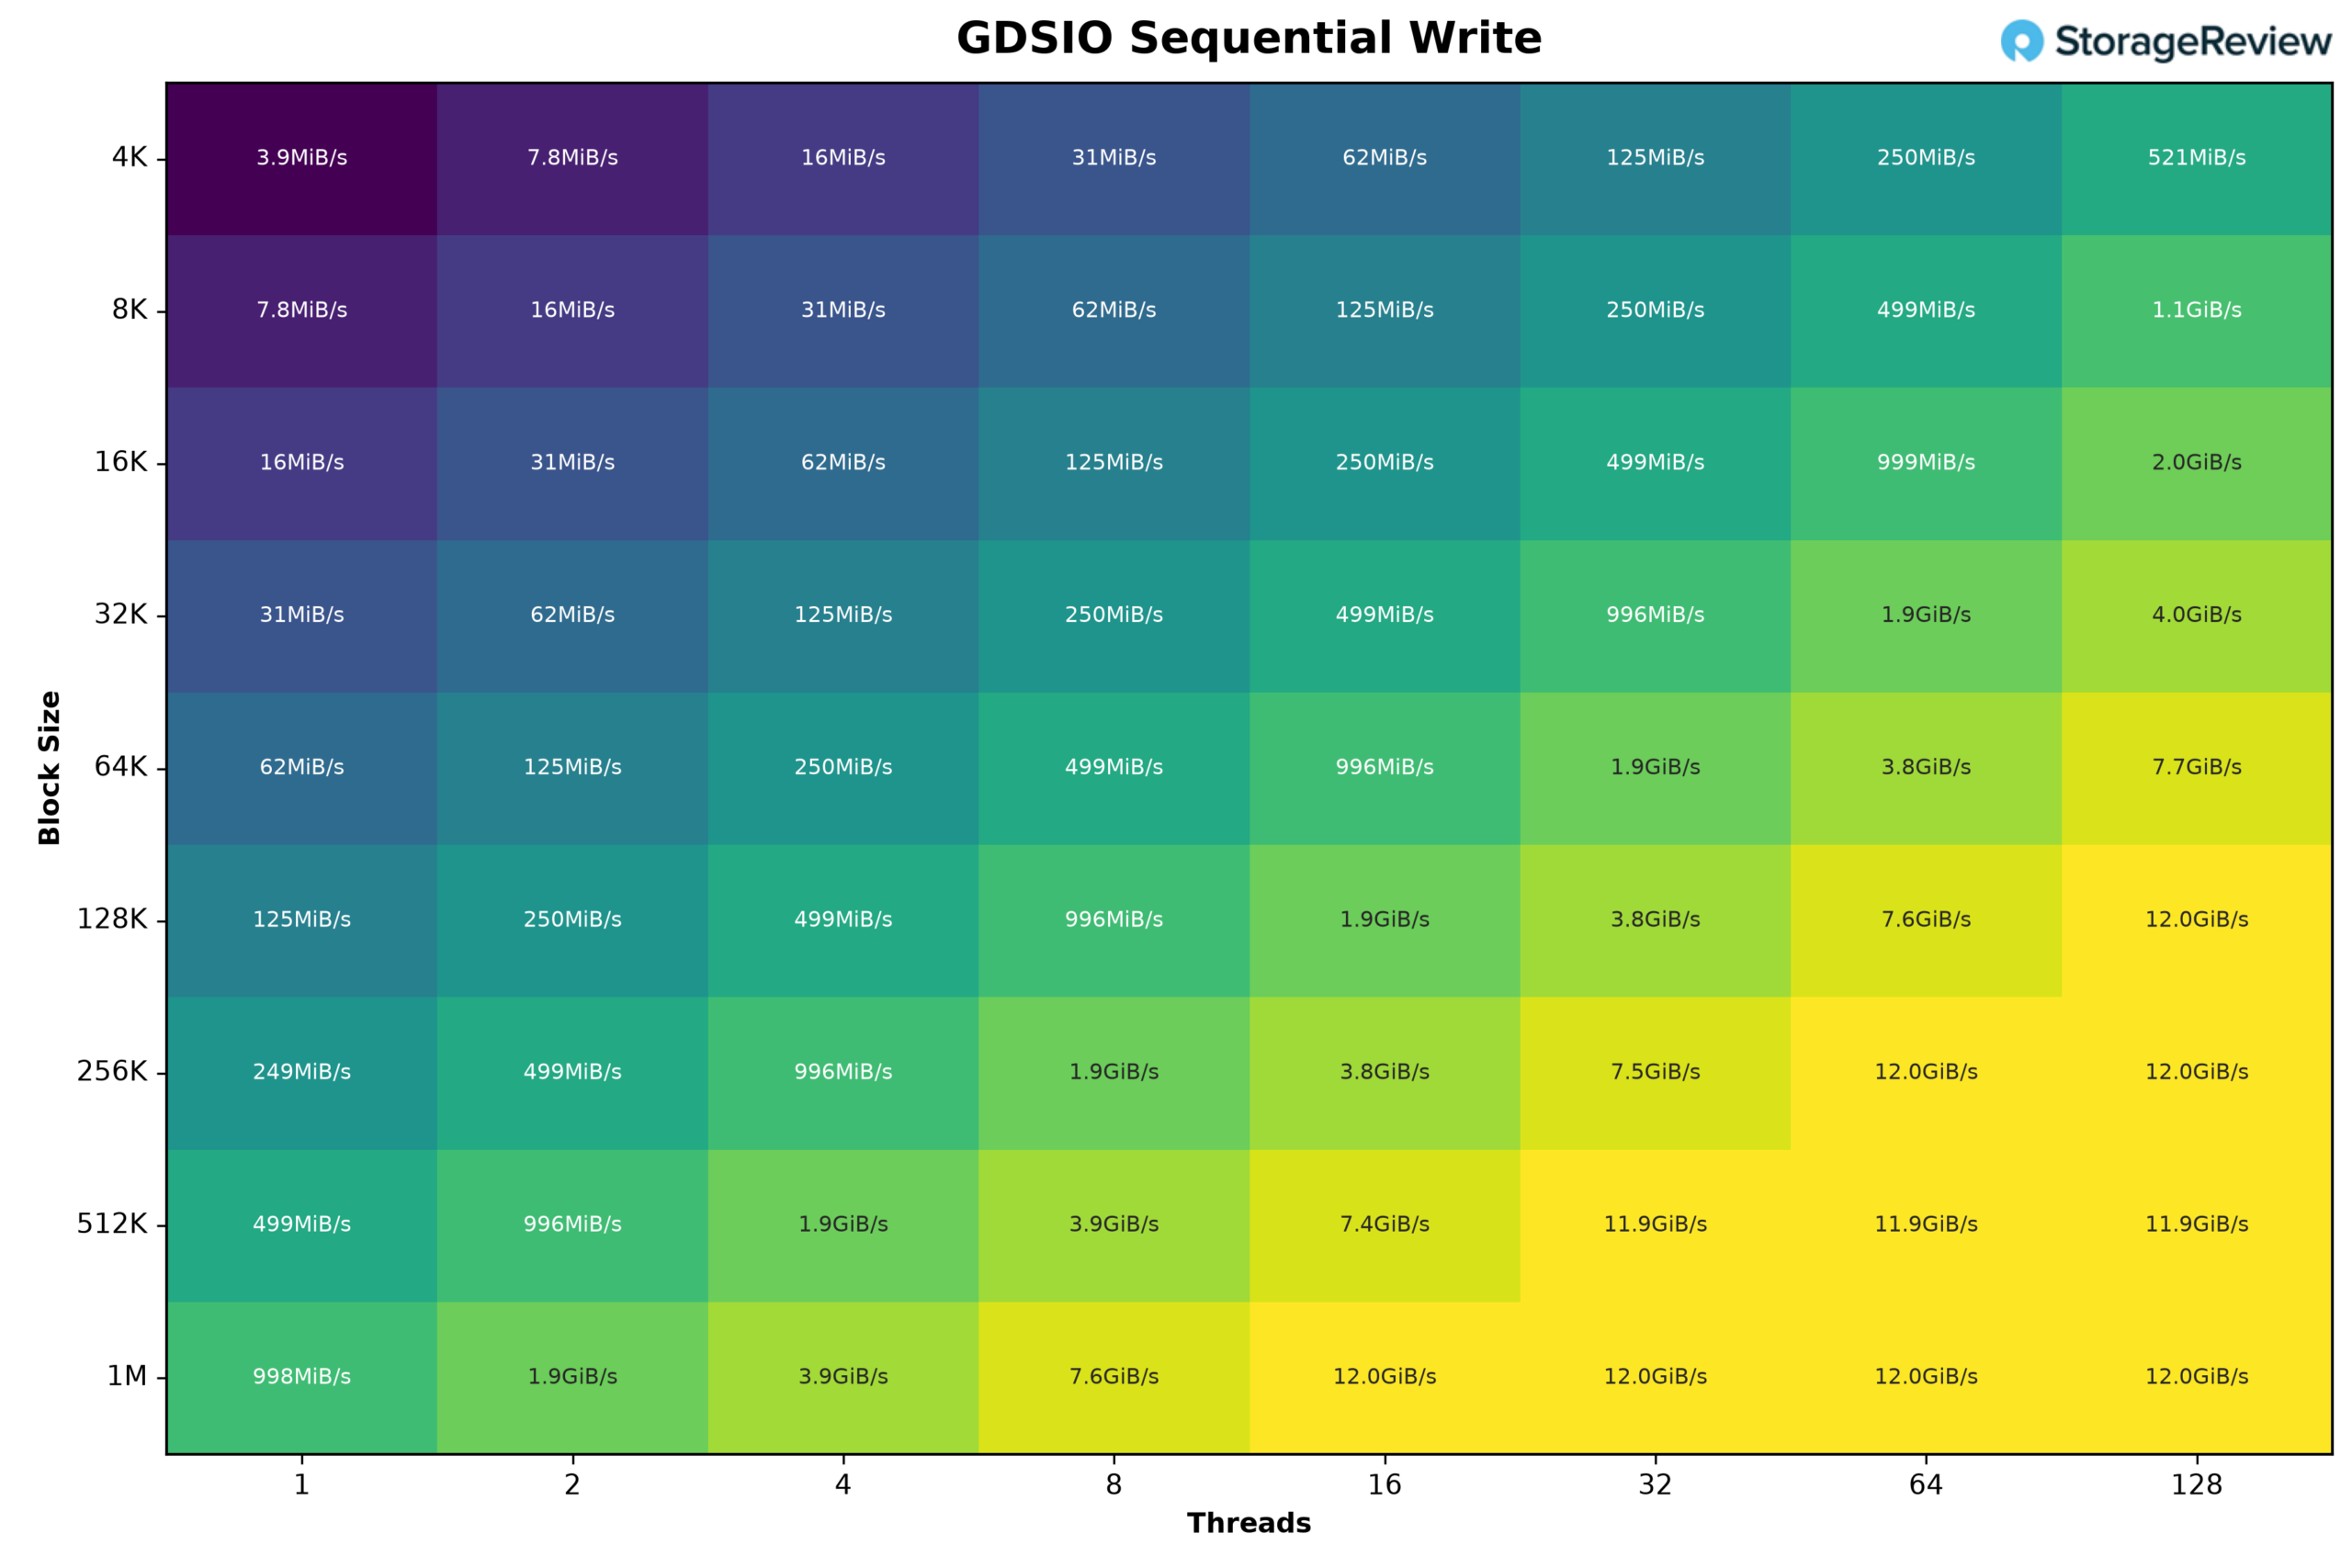
¿Para quién está diseñada la MSI XpertStation WS300?
El WS300 está diseñado para organizaciones que necesitan acceso directo a Blackwell Ultra, pero no desean que cada experimento comience con una reserva de clúster o una solicitud en la nube. Los laboratorios de IA, los desarrolladores de motores de inferencia, los equipos de frameworks y compiladores, los grupos de robótica y los equipos de IA empresarial pueden usarlo como nodo de desarrollo local para los flujos de trabajo mencionados. MIG permite a los desarrolladores probar y desarrollar para una configuración multi-GPU, y el BMC facilita la gestión remota del sistema.
También resulta útil para desarrolladores de IA experimentados que necesitan un sistema listo para usar. Su valor no reside únicamente en la placa base B300, sino en la plataforma completa que la rodea: 252 GB de HBM3e, Grace y 496 GB de LPDDR5X, ConnectX-8, almacenamiento de arranque en espejo, refrigeración líquida, gestión remota y soporte de MSI, todo en una sola torre. Las limitaciones prácticas son el sistema operativo Arm, la necesidad de un circuito dedicado de 20 A y el consumo compartido de 1,600 W al instalar una tarjeta RTX PRO de gran tamaño.
Para sacar el máximo partido al WS300, también depende del software que lo acompañe. NVIDIA ofrece una amplia colección de manuales y guías de implementación diseñadas para ayudar a los equipos a poner el sistema en línea y aprovechar sus recursos rápidamente. En futuras publicaciones, analizaremos varias de estas herramientas, incluyendo Brev, que simplifica el acceso compartido a la estación de trabajo y mejora su utilización, evitando que un recurso tan costoso permanezca inactivo.
En cuanto al precio, MSI no lo ha publicado, y las máquinas de esta categoría rara vez tienen precio de lista; se trata de una conversación importante con el equipo de ventas, no de un simple botón para añadir al carrito. La comparación justa no es con otras estaciones de trabajo, sino con lo que un equipo de IA ya está pagando: tiempo de clúster reservado, compromisos de GPU en la nube y el coste de la espera por hardware compartido.
Conclusión
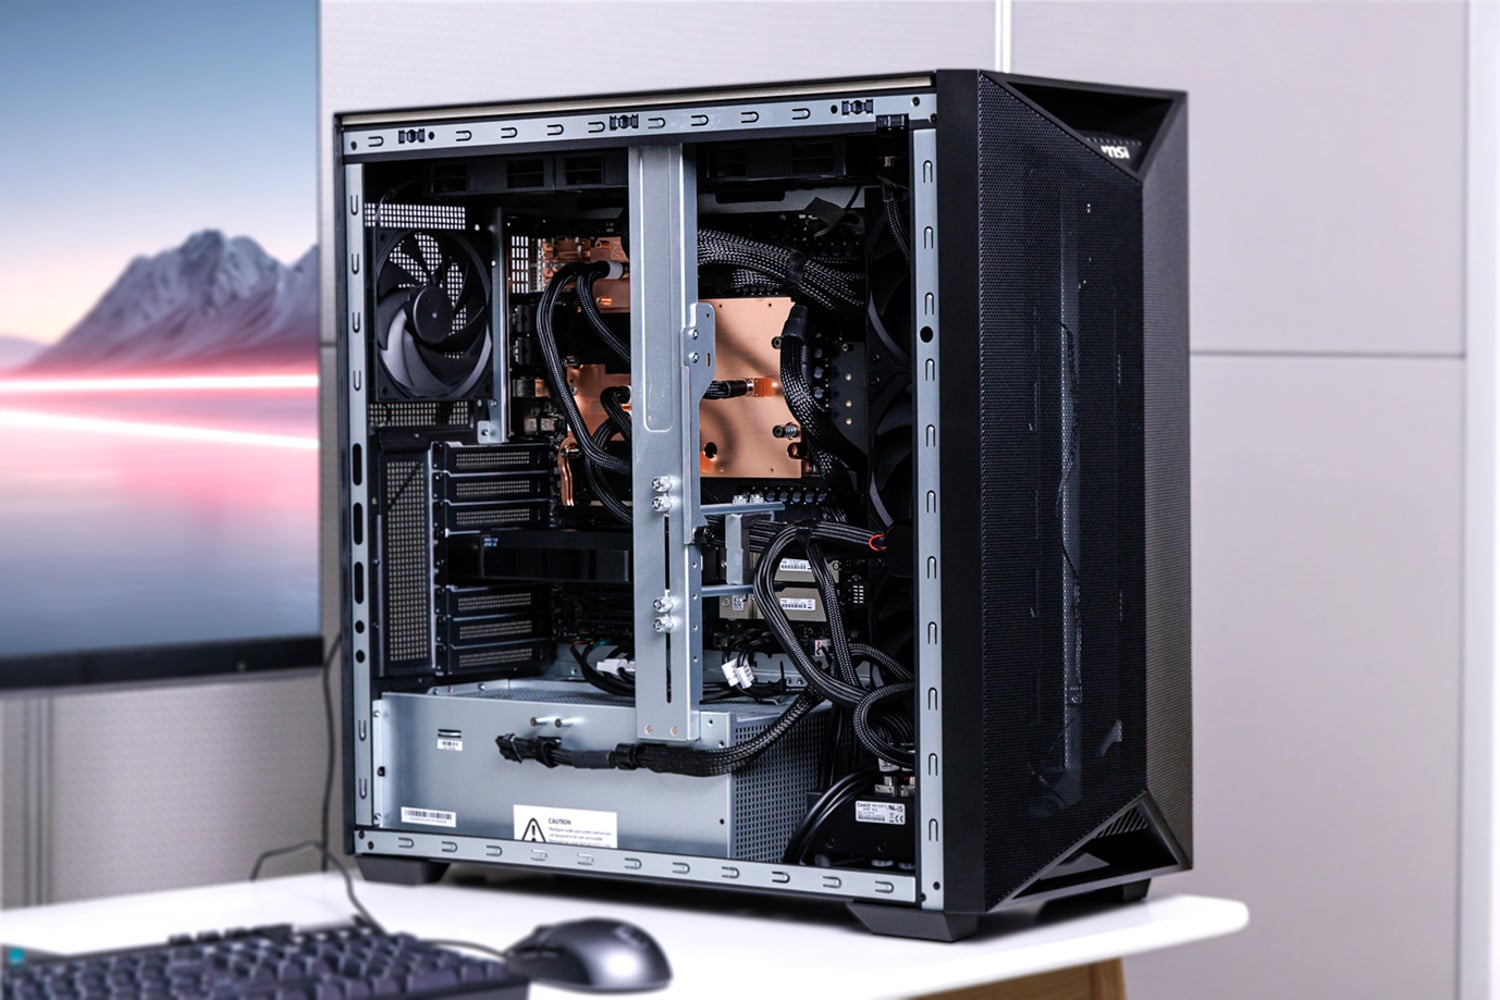
La MSI XpertStation WS300 es la estación de trabajo más potente que jamás hayamos analizado, y uno de esos productos excepcionales que revolucionan las capacidades de un profesional. Puntos de control de gran escala que normalmente requieren una reserva de clúster, como GLM-5.2 con 433 GB y Nemotron-3-Ultra con 550 mil millones de parámetros, se cargan y ejecutan en un equipo junto al escritorio, de forma privada y siempre disponible. Ese es el motivo de nuestro entusiasmo por este sistema.
La estación DGX está dirigida a desarrolladores: desarrolladores de kernels que trabajan con Blackwell Ultra, equipos de motores de inferencia y frameworks, grupos de robótica que ejecutan el ciclo completo de Isaac y, en general, usuarios frustrados con la planificación de experimentos en torno a hardware compartido. Fuera de este nicho, los argumentos para adquirir estos sistemas son bastante limitados. El host Arm excluye algunas cadenas de herramientas; el circuito de 20 A es un requisito de instalación en circuitos de 120 V; no hay salida de vídeo sin una tarjeta adicional; y una estación de trabajo RTX PRO 6000 cuesta mucho menos, cubriendo el trabajo de un solo usuario en modelos que caben en sus 96 GB.
Los aspectos económicos también limitan el tamaño óptimo de la implementación. Un WS300 se justifica fácilmente con el tiempo de clúster reservado, y un par por equipo sigue siendo viable. A partir de cierto punto, la configuración en paralelo deja de tener sentido: cuando una organización compra cuatro torres GB300, por ejemplo, con el mismo dinero puede adquirir un servidor B300 de ocho vías con más memoria por GPU, particionamiento MIG más denso y NVLink entre cada GPU. El punto óptimo es uno en el escritorio, quizás dos en el laboratorio, complementando la inversión en el centro de datos.
NVIDIA proporciona la placa base, por lo que la diferenciación entre los fabricantes de equipos originales (OEM) se reduce a la implementación, y la ejecución de MSI en este aspecto es sólida. Un circuito de refrigeración líquida de 1,400 W refrigera la B300, Grace, SOCAMM y ConnectX-8, y la plataforma se mantuvo estable durante las pruebas. Este análisis más profundo ya está publicado: nuestro análisis térmico de la WS300 combina los datos de la placa fría y el radiador de MSI con una prueba instrumentada de 2.8 horas que muestra que el chip se mantuvo a 60 °C y una frecuencia plana de 2.07 GHz a plena carga. El presupuesto de energía de 1,600 W se distribuye automáticamente entre los componentes, y cuando probamos el freno de potencia de hardware con una conexión comprometida, se redujo la velocidad en lugar de apagarse. Un cable HPWR de 12 V precableado y un soporte antivibración admiten la ruta de expansión RTX PRO. Tras probar la primera GB300 DGX Station que llegó a nuestras manos, podemos afirmar que la XpertStation WS300 establece un alto estándar para la plataforma.
La XpertStation WS300 ocupa ahora el primer puesto en la categoría de Mejores Sistemas GB300 de nuestra clasificación de Mejores Ordenadores de Sobremesa para IA Local , y es el tema central de la discusión sobre memoria en nuestra guía sobre RAM, GPU y almacenamiento para IA agente.


 Amazon