

CTERA ha presentado Fusion Direct, una arquitectura de datos federada diseñada para superar la brecha existente entre los sistemas de archivos empresariales y el almacenamiento de objetos. Esta nueva solución amplía la familia CTERA Fusion, que ya incluye CTERA Fusion Gateway, y se posiciona como un componente central de la plataforma de datos inteligentes de CTERA. El objetivo es ofrecer una única infraestructura de datos de alto rendimiento que pueda gestionar tanto cargas de trabajo de archivos centradas en el usuario como flujos de trabajo de IA automatizados, sin duplicar datos ni refactorizar aplicaciones.
Unificación de archivos y objetos bajo un mismo espacio de nombres
Tradicionalmente, los equipos de TI empresariales se han visto obligados a operar con dos dominios de almacenamiento separados. Los sistemas NAS proporcionan acceso SMB y NFS para la colaboración de usuarios y aplicaciones heredadas o de línea de negocio. El almacenamiento de objetos, al que se accede normalmente a través de S3, se utiliza para cargas de trabajo de análisis, nativas de la nube y a gran escala. Conectar estos entornos a menudo ha implicado la implementación de infraestructuras paralelas, la copia de datos entre ellas o el uso de pasarelas que traducen las llamadas a archivos en API de objetos. Estas capas de traducción pueden generar latencia, complejidad y riesgos operativos adicionales, especialmente a gran escala.
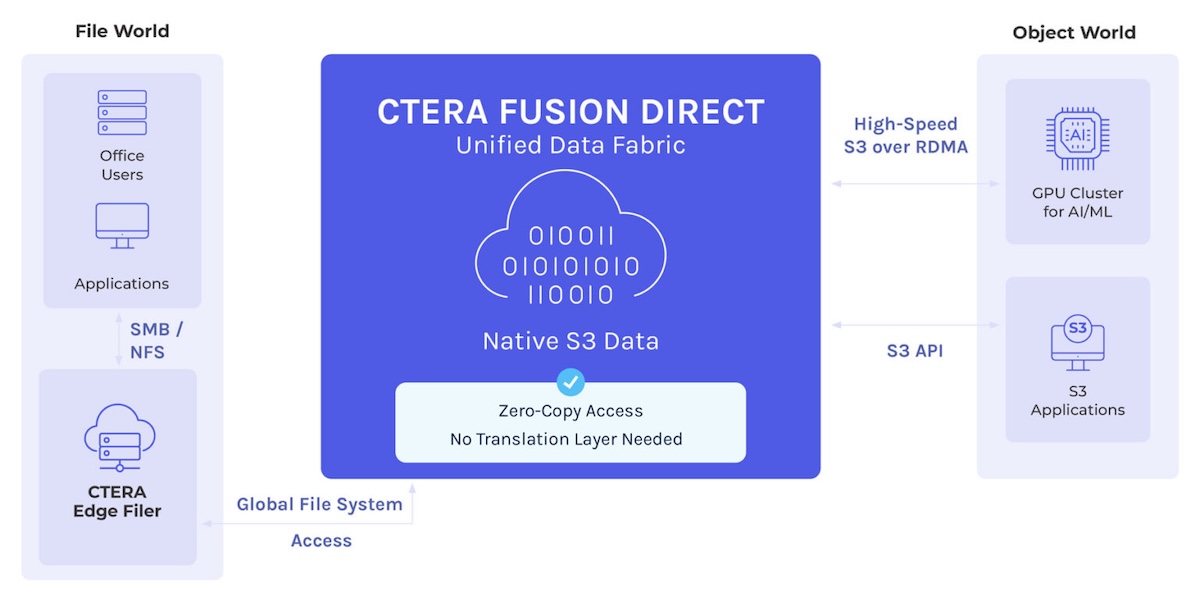
Fusion Direct aborda este problema al exponer un único espacio de nombres global federado en el que archivos y objetos coexisten de forma nativa. Los datos se pueden escribir en la plataforma como archivos y leerse como objetos, o escribirse como objetos y leerse como archivos. El sistema admite lectura y escritura bidireccional completa sin convertir archivos en fragmentos de objetos propietarios ni enrutar el acceso a través de una puerta de enlace de traducción independiente. CTERA deja claro que no existe ningún cuello de botella en la conversión de archivos a objetos ni ningún esquema de encapsulación propietario.
Desde la perspectiva del acceso, las aplicaciones y los usuarios empresariales existentes continúan operando a través de SMB y NFS como lo hacen actualmente. Al mismo tiempo, los clústeres de entrenamiento de IA, los entornos HPC y los servicios nativos de la nube pueden acceder a los mismos conjuntos de datos a través de S3 y S3 over RDMA, que está diseñado para ofrecer un rendimiento a velocidad de línea a clústeres de GPU y otros entornos de computación de alto rendimiento.
Aprovechamiento de los almacenes de objetos existentes y la computación perimetral distribuida.
Un aspecto clave del diseño es la capacidad de conectar los buckets de S3 existentes directamente a la estructura de datos de Fusion Direct. En lugar de migrar o reutilizar los datos de objetos en un nuevo sistema, las organizaciones pueden presentar sus espacios de nombres de almacenamiento de objetos actuales como parte del espacio global de archivos/objetos. Una vez conectados, se puede acceder a los objetos de esos buckets como archivos estándar en ubicaciones perimetrales e implementaciones multinube.
Este enfoque permite a los equipos de TI exponer los datos de objetos como archivos a usuarios y aplicaciones de todo el mundo, al tiempo que los presenta de forma nativa como S3 para cargas de trabajo de IA y análisis. Además, reduce la necesidad de infraestructura duplicada que, de otro modo, se implementaría en múltiples regiones o sitios periféricos para almacenar o reformatear datos. El resultado es una huella de almacenamiento más sencilla para conjuntos de datos distribuidos que abarcan múltiples ubicaciones geográficas.
Arquitectura para el rendimiento en la era de la IA
CTERA Fusion Direct aprovecha la plataforma de datos inteligentes existente de CTERA y está respaldada por la patente estadounidense 12,007,9521. La arquitectura hace hincapié en la compatibilidad simultánea con cargas de trabajo de archivos colaborativas y el consumo de datos a gran escala y alto rendimiento.
Una de sus principales funcionalidades es el acceso nativo sin copias. Los datos escritos en la plataforma CTERA como archivos están disponibles de inmediato como objetos S3 estándar, sin copias secundarias ni conversiones en segundo plano. A la inversa, los buckets de S3 se pueden conectar directamente y su contenido se vuelve accesible de inmediato como archivos en el espacio de nombres global. Esto tiene como objetivo evitar tanto la latencia como la sobrecarga de almacenamiento asociadas con las copias duplicadas o las cachés intermedias.
La transmisión de archivos a alta velocidad es otro aspecto clave. Los archivos multimedia de gran tamaño, los conjuntos de datos de entrenamiento y otros contenidos que requieren mucha capacidad de almacenamiento pueden transmitirse directamente desde el almacenamiento de objetos a las aplicaciones basadas en archivos. Este enfoque elimina la necesidad de descargas locales masivas o pasos de almacenamiento intermedio, que pueden ralentizar los flujos de trabajo y consumir almacenamiento adicional en el borde de la red o en los clústeres de computación.
En cuanto al rendimiento, Fusion Direct expone objetos nativos de forma compatible con S3-over-RDMA y el acceso directo a la GPU. Para los clústeres de IA, esto significa que las GPU pueden leer y escribir datos a una velocidad cercana a la de la red desde conjuntos de datos basados en objetos, sin necesidad de traducción de protocolo adicional en la ruta de datos. Esto resulta especialmente relevante para las tareas de entrenamiento e inferencia, donde el rendimiento de E/S es limitado, en lugar de la capacidad de cálculo bruta.
CTERA también destaca las consideraciones relativas a la soberanía de los datos. Dado que los datos residen en buckets S3 estándar sin encapsulamiento propietario ni pasarelas que controlen los metadatos, las organizaciones conservan el control de su información tanto en implementaciones locales como en nubes públicas. La arquitectura está diseñada para minimizar la dependencia de la capa de datos y preservar la flexibilidad a medida que evolucionan las estrategias de infraestructura.
El colapso de los silos de datos humanos y de máquinas
Oded Nagel, CEO de CTERA, afirma que la principal barrera para la adopción de la IA en las empresas no es la escasez de datos, sino el reto de utilizarlos eficazmente. Destaca que separar los datos para uso humano de los datos para análisis automático genera fricción. Mantener entornos y conjuntos de datos separados ralentiza la implementación de la IA. Nagel propone combinarlos en una única plataforma compatible con SMB/NFS y S3 a través de RDMA, ofreciendo a las empresas una vía directa desde los datos brutos hasta los conjuntos de datos preparados para la IA. Una plataforma unificada puede ayudar a las organizaciones a aprovechar mejor los datos y a mantenerse competitivas en un mercado impulsado por el aprendizaje automático y la automatización.
Disponibilidad
CTERA Fusion Direct ya está disponible como parte de la plataforma de datos inteligentes CTERA y se posiciona como un componente clave de la familia CTERA Fusion para la unificación de archivos y objetos. Para obtener más información, visite CTERA.


 Amazon