

Google añadió dos sistemas a su gama de TPU de octava generación: TPU 8tx, un sistema de computación confidencial basado en el silicio TPU 8t, y TPU 8i Max, que integra dos chips TPU 8i en un único paquete para inferencia de contexto extenso. Estos se suman al chip de entrenamiento TPU 8t y al chip de inferencia TPU 8i que Google presentó en Cloud Next en abril, y Google afirma que esta es la primera vez que introduce cuatro sistemas TPU en un solo año.
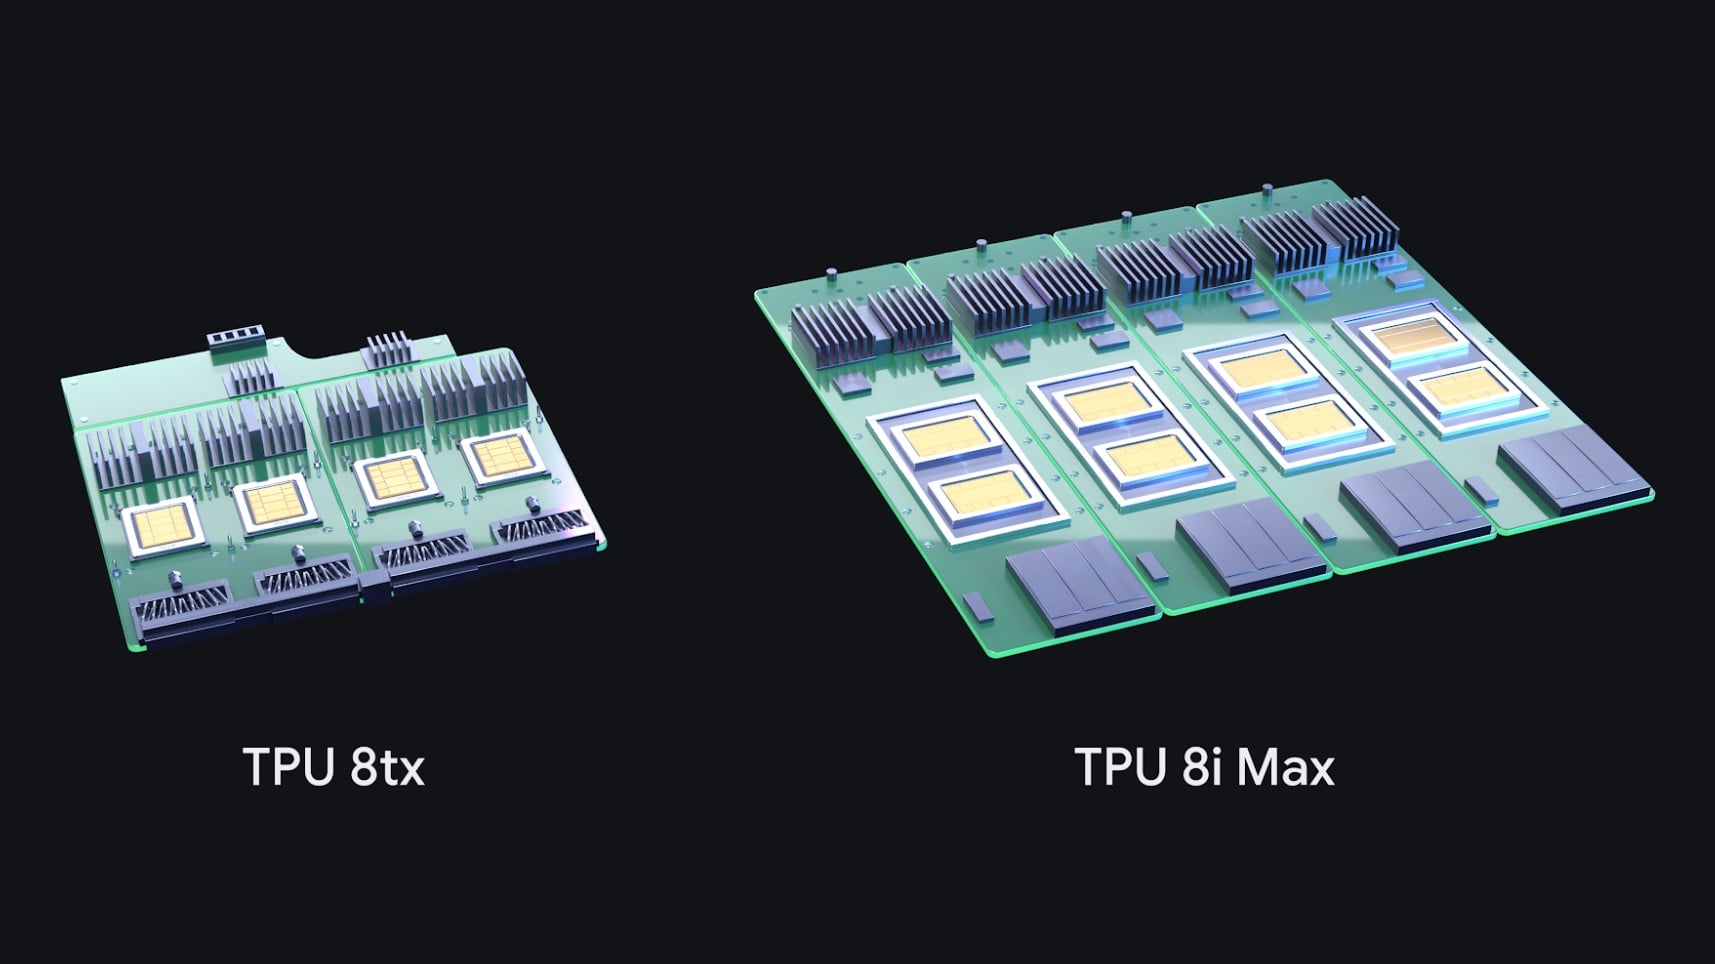
Google describe estas dos incorporaciones como nuevos sistemas construidos alrededor de chips existentes, modificando el empaquetado, la memoria de alta velocidad, la conectividad y la seguridad del silicio para adaptarlos a la carga de trabajo. Atribuye a este enfoque modular la capacidad de ofrecer configuraciones especializadas en cuestión de meses. Según Google, las TPU cuentan ahora con casi 100 clientes, entre los que se incluyen laboratorios de vanguardia, empresas comerciales, minoristas y universidades, y algunos clientes ya pueden implementarlas directamente en sus centros de datos.
TPU 8tx: Computación confidencial en el silicio TPU 8t
TPU 8tx utiliza el mismo chip que TPU 8t, lo combina con procesadores AMD EPYC de quinta generación e integra computación confidencial en el hardware para que los datos y los pesos de los modelos permanezcan protegidos y aislados durante su uso. Google incluye entre sus características de seguridad el cifrado de enlaces PCIe, la certificación criptográfica y los enclaves de memoria seguros, y dirige el sistema a empresas reguladas y gobiernos que ejecutan modelos y agentes de vanguardia o propietarios junto con datos confidenciales.

TPU 8tx también adopta la red Boardfly de baja latencia que Google desarrolló para TPU 8i, la cual, según Google, ofrece una latencia hasta dos veces menor que TPU 8t con una penalización de rendimiento prácticamente nula. Google la posiciona para la inferencia segura y el entrenamiento a pequeña escala, de modo que un equipo pueda realizar ajustes precisos con datos privados, reducir un modelo grande a uno más pequeño y entrenar agentes mediante aprendizaje por refuerzo sin transferir datos confidenciales entre clústeres separados.
TPU 8i Max: Dos chips de inferencia por paquete
El TPU 8i Max está diseñado para ofrecer un ancho de banda de memoria óptimo para cargas de trabajo como docenas de agentes operando en un código fuente completo o horas de vídeo. Google combinó dos chips TPU 8i en un solo paquete, duplicando la capacidad de procesamiento, la memoria SRAM integrada y el ancho de banda de la memoria HBM con respecto al TPU 8i. Google indicó 384 MB de SRAM para el TPU 8i en su lanzamiento, por lo que la cifra duplicada equivale a 768 MB por paquete 8i Max. Google no ha especificado la capacidad de la memoria HBM del paquete. Dado que el 8i Max permite alojar el doble de silicio en el espacio disponible para racks, Google afirma que ofrece mayor capacidad de procesamiento por metro cuadrado y por vatio.

Google ahora asigna los cuatro sistemas de octava generación a las etapas de trabajo de los agentes: TPU 8t para entrenamiento escalable, TPU 8i para razonamiento de baja latencia, TPU 8tx para computación confidencial y TPU 8i Max para ventanas de contexto masivas y la mayor densidad de cómputo por rack. Google no ha indicado cuándo TPU 8tx y TPU 8i Max estarán disponibles para los clientes de Google Cloud ni ha publicado los precios de ninguno de los dos sistemas.

Sincronización de TPU, Cloud Pathways y segmentación dinámica de GKE
Google también liberó el código fuente de TPU Sync, una biblioteca de C++ que trata la memoria HBM del chip, la DRAM del host, el almacenamiento compartido y la red del centro de datos como una única jerarquía de memoria. Organiza las cachés KV fuera del chip, transmite el contexto desde los nodos de precarga a los nodos de decodificación y sincroniza los pesos del aprendizaje por refuerzo desde los entrenadores a los muestreadores. Google afirma que TPU Sync reduce la latencia de transferencia KV en más del 90 % y disminuye el tiempo hasta el primer token en un promedio del 90 % en modelos de mezcla de expertos con pesos abiertos de 235 mil millones a 480 mil millones de parámetros.
Cloud Pathways, el entorno de ejecución de Google DeepMind que impulsa Gemini, ya está disponible de forma general en Google Kubernetes Engine. Utiliza un único controlador para orquestar sistemas TPU en múltiples particiones para el preentrenamiento, el aprendizaje por refuerzo y la inferencia multihost, y mantiene en marcha las tareas de larga duración a pesar de las interrupciones del hardware gracias al intercambio en caliente de particiones en menos de un minuto y la redistribución elástica de particiones.
La segmentación dinámica de GKE, también disponible de forma general, utiliza la conmutación de circuitos ópticos para ensamblar cubos de TPU en topologías más grandes o dividirlos en cargas de trabajo aisladas más pequeñas sin recrear grupos de nodos. Google afirma que reduce los tiempos de inicio de las tareas hasta en 5 veces y acelera la recuperación de fallos hasta en 4.5 veces. Un conjunto de agentes de TPU en versión preliminar se integra con herramientas de codificación como Claude Code, Cursor y Google Antigravity para incorporar cargas de trabajo, diagnosticar cuellos de botella y ajustar automáticamente los kernels, y un nuevo motor de servicio XLA de código abierto sirve modelos entrenados en Python desde un entorno de ejecución de C++ a través de TPU, GPU y CPU.



 Amazon