

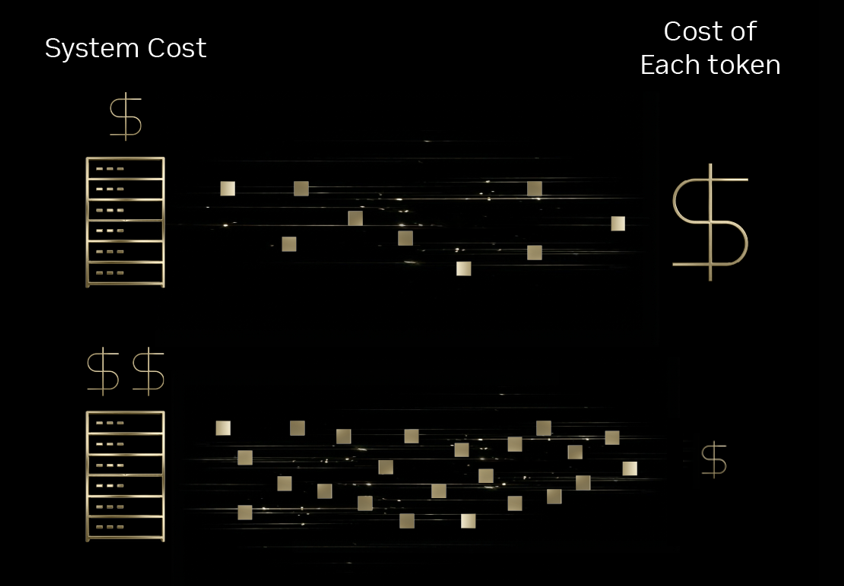
La unidad fundamental de inteligencia en las interacciones modernas de IA es el token. Ya sea para impulsar diagnósticos clínicos, diálogos interactivos en juegos o agentes de atención al cliente autónomos, la escalabilidad de estas aplicaciones depende en gran medida de la tokenómica. Datos recientes del MIT indican que los avances en infraestructura y eficiencia algorítmica están reduciendo los costos de inferencia hasta diez veces al año. Los principales proveedores de inferencia, como Baseten, DeepInfra, Fireworks AI y Together AI, utilizan ahora la plataforma NVIDIA Blackwell para lograr estas eficiencias, superando a menudo a la generación anterior de Hopper por un orden de magnitud.
Eficiencia en la atención médica mediante Baseten y Sully.ai
En el sector sanitario, las tareas administrativas como la codificación y la documentación médica reducen significativamente la atención al paciente. Sully.ai soluciona este problema mediante el uso de agentes de IA para automatizar estas tareas rutinarias. Anteriormente, la empresa se enfrentaba a cuellos de botella, como una latencia impredecible y costes de inferencia que superaban el crecimiento de los ingresos al utilizar modelos propietarios de código cerrado.
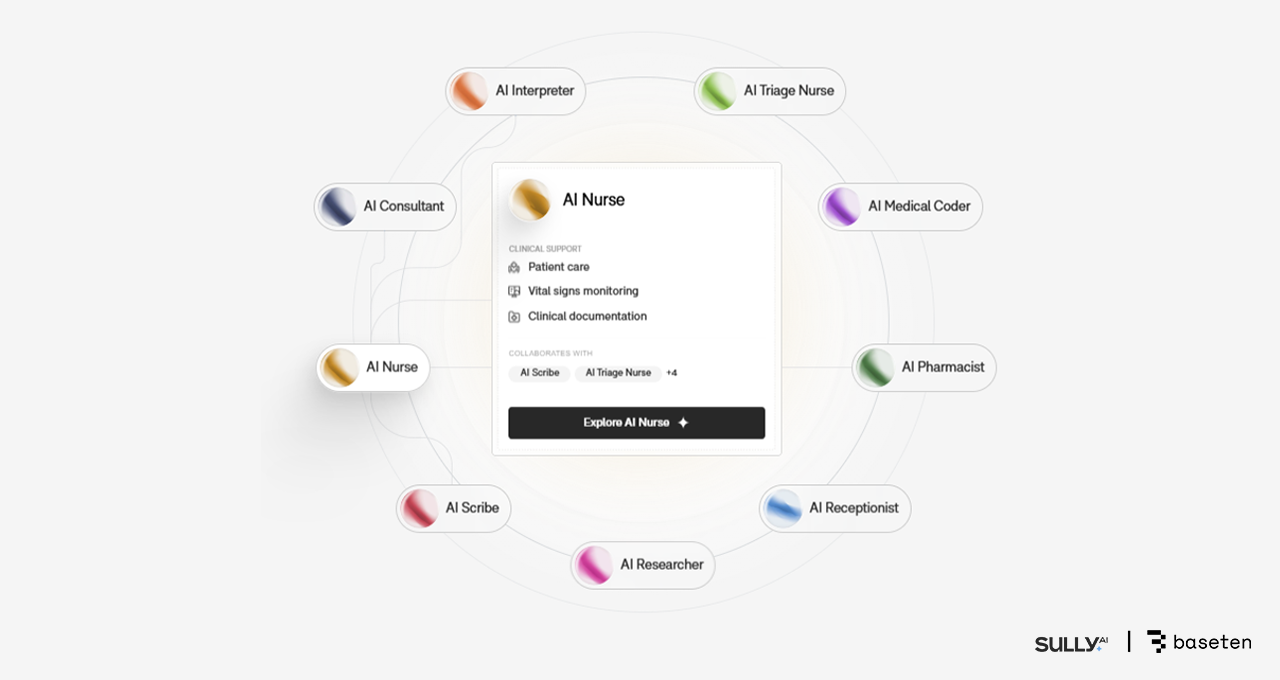
Al migrar a la API de modelos de Baseten, que utiliza modelos de código abierto en GPU NVIDIA Blackwell, Sully.ai logró una reducción del 90 % en los costos de inferencia. Baseten optimizó la plataforma con el formato de datos NVFP4, TensorRT-LLM y el marco de inferencia NVIDIA Dynamo. Esta transición ofreció un rendimiento 2.5 veces superior por dólar en comparación con Hopper y una mejora del 65 % en los tiempos de respuesta. Hasta la fecha, la implementación ha ahorrado a los médicos más de 30 millones de minutos al automatizar la entrada manual de datos.
Rendimiento de juego con DeepInfra y Latitude
Latitude, la desarrolladora de AI Dungeon y la plataforma de rol Voyage, se enfrenta a desafíos de escalabilidad únicos, ya que cada acción del jugador requiere una solicitud de inferencia. Mantener una experiencia de juego fluida exige baja latencia y una entrega de tokens rentable. Al ejecutar modelos Mixture-of-Experts (MoE) a gran escala en la infraestructura Blackwell de DeepInfra, Latitude ha logrado mejoras significativas en los costos.
DeepInfra redujo el costo por millón de tokens de 20 centavos en Hopper a 10 centavos en Blackwell. Al aprovechar el formato NVFP4 nativo de baja precisión de Blackwell, los costos se redujeron aún más a la mitad, a 5 centavos por millón de tokens. Esta mejora de cuatro veces permite a Latitude implementar modelos más sofisticados y gestionar picos de tráfico sin comprometer la experiencia del usuario ni la precisión.
Escalado de flujos de trabajo agenciales con Fireworks AI y Sentient
Sentient Labs desarrolla sistemas de IA de razonamiento de código abierto, como Sentient Chat, que coordina flujos de trabajo multiagente. Estas interacciones complejas suelen desencadenar una cascada de tareas autónomas, lo que genera una importante sobrecarga de infraestructura. Al utilizar la plataforma de inferencia de Fireworks AI en NVIDIA Blackwell, Sentient logró un aumento de entre el 25 y el 50 por ciento en la eficiencia de costos en comparación con las implementaciones basadas en Hopper.
El mayor rendimiento por GPU permitió a Sentient gestionar una concurrencia masiva. Durante su fase de lanzamiento, que tuvo un gran éxito, la plataforma procesó a 1.8 millones de usuarios en lista de espera en 24 horas y gestionó 5.6 millones de consultas en una sola semana. La arquitectura optimizada por Blackwell mantuvo una latencia baja y constante a pesar del elevado volumen de consultas.
Soporte de voz empresarial a través de Together AI y Decagon.
Decagon proporciona agentes de IA para la atención al cliente empresarial, donde las interacciones de voz requieren tiempos de respuesta inferiores a un segundo para ser viables. Together AI aloja la pila de voz multimodal de Decagon en NVIDIA Blackwell, implementando optimizaciones como la decodificación especulativa y el almacenamiento en caché de elementos de conversación repetidos.
Estas mejoras técnicas redujeron los tiempos de respuesta a menos de 400 milisegundos, incluso para consultas que involucran miles de tokens. Al combinar modelos de código abierto y propios con el codiseño de hardware y software de Blackwell, Decagon redujo el costo por consulta en un factor de 6 en comparación con las alternativas propietarias de código cerrado.
El futuro de la tokenómica
La transición a NVIDIA Blackwell, en particular al sistema GB200 NVL72, marca un punto de inflexión en la implementación a gran escala de los modelos de razonamiento MoE. La capacidad de la plataforma para lograr una reducción de 10 veces en el costo por token se debe a una profunda integración entre las capas de computación, redes y software. De cara al futuro, se espera que la próxima plataforma NVIDIA Rubin continúe esta trayectoria, ofreciendo una mejora adicional de 10 veces en el rendimiento y la eficiencia del costo por token en comparación con la arquitectura Blackwell.


 Amazon