

En la Cumbre Global OCP 2025, Intel enfatizó la inferencia de IA al revelar dos avances clave: una nueva GPU para centros de datos llamada "Crescent Island" y un diseño de referencia a escala de rack para Gaudi 3. Ambos desarrollos se alinean con la creciente transición del entrenamiento de modelos a la inferencia generalizada en tiempo real, donde factores como la latencia, el ancho de banda de la memoria, la eficiencia y la simplicidad operativa ahora son cruciales.
Del entrenamiento estático a la inferencia generalizada en tiempo real
Sachin Katti, director de tecnología de Intel, resumió la transición señalando que, a medida que la IA con agentes se generaliza, la inferencia se vuelve continua, contextualizada y cada vez más intensiva en el sistema. Para gestionar el creciente volumen de tokens, las complejas combinaciones de modalidades y los estrictos requisitos de los acuerdos de nivel de servicio (SLA), se hace necesaria una infraestructura heterogénea que combine silicio óptimo con una pila de software abierta y centrada en el desarrollador. En este entorno, las GPU para centros de datos con arquitectura Xe de Intel ofrecen la capacidad y la fiabilidad necesarias a medida que aumentan las longitudes de secuencia y las tasas de tokens, mientras que Gaudi 3 respalda un ecosistema de inferencia abierto y escalable con un coste total de propiedad (TCO) predecible.
La clave no se limita a "chips más rápidos". El éxito de la inferencia depende de la integración de sistemas: memoria con reconocimiento de topología, interconexiones flexibles, alimentación y refrigeración que se ajusten a los perfiles de uso, y una orquestación que trate los modelos, tokens y flujos como ciudadanos de primera clase. Las empresas no quieren depender de un único sistema justo cuando necesitan iterar entre modelos, marcos y pilas de servidores.
Abarcando PC, Edge y centro de datos
Intel afirma estar en una posición privilegiada para ofrecer una gama completa de soluciones, con PC con IA, edge industrial y racks para centros de datos basados en CPU Xeon 6, aceleradores Gaudi 3 y GPU Intel. Los temas comunes incluyen:
- La flexibilidad de PCIe en la diversidad permite la reutilización de huellas existentes cuando sea adecuado y permite escalar a racks centrados en la estructura si es necesario.
- Los diseños a escala de rack garantizan un rendimiento por vatio predecible e incluyen opciones de refrigeración líquida cuando los requisitos térmicos y de alta densidad lo requieren.
- Una plataforma de software integral y completa destinada a garantizar un desarrollo sin inconvenientes en distintos tipos de silicio y niveles de implementación.
La asociación con OCP respalda la preferencia de la empresa por diseños abiertos y referenciables, que son más fáciles de adquirir, validar y escalar en las operaciones.
Crescent Island: una GPU para centros de datos optimizada para la economía de inferencia
Crescent Island es la próxima GPU de Intel para centros de datos, diseñada para servidores empresariales refrigerados por aire que requieren un alto rendimiento de tokens sin requerir soluciones avanzadas de alimentación o refrigeración. Su enfoque es práctico: priorizar la rentabilidad y el rendimiento energético, a la vez que ofrece la capacidad de memoria y el ancho de banda esenciales para las tareas de inferencia modernas.
Destacan:
- La microarquitectura Xe3P se centra en el rendimiento por vatio. Esto se alinea bien con la inferencia de estado estacionario, donde la utilización es sostenida y la sensibilidad al coste es alta.
- 160 GB de memoria LPDDR5X en tarjeta. Para el servicio LLM/RAG, el resumen de contexto largo y las canalizaciones multimodales, la capacidad de memoria y el ancho de banda suelen limitar el QPS y la latencia de cola más que el TOPS sin procesar.
- Amplia compatibilidad con tipos de datos, diseñada para proveedores de tokens como servicio. La flexibilidad de precisión/cuantización combinada es crucial para optimizar el rendimiento y preservar la precisión en los puntos finales de producción.
- Disponibilidad de software mediante la pila abierta y unificada de Intel. La optimización temprana de las GPU Arc Pro Serie B busca optimizar los flujos de trabajo de los desarrolladores y minimizar la fricción en la portabilidad.
- Cronograma: Se espera que el muestreo de clientes para Crescent Island tenga lugar en la segunda mitad de 2026. Para los compradores que planean ciclos de actualización entre 2026 y 2027, esto brinda una ventana práctica para probar la pila de software y los patrones de servicio de modelos ahora.
Crescent Island se centra en la economía de inferencia a escala. Está refrigerada por aire, optimizada para la capacidad y enfocada en el rendimiento/W. Supongamos que sus cargas de trabajo están dominadas por un servicio con un alto consumo de tokens y con SLO de latencia estrictos. En ese caso, los 160 GB integrados y los tipos de datos eficientes deberían traducirse en más sesiones simultáneas por vatio y menos sorpresas en el clúster a medida que aumenta la longitud de las secuencias.
Gaudi 3: Escala de rack referenciable para modelos grandes e inferencia en tiempo real
Gaudi 3 abarca desde implementaciones PCIe hasta configuraciones completas a escala de rack, ofreciendo una vía de escalabilidad sin necesidad de apostar por una arquitectura integral desde el principio. El nuevo diseño de referencia a escala de rack está dirigido a empresas que estandarizan sistemas de inferencia de modelos complejos y sistemas en tiempo real con baja latencia.
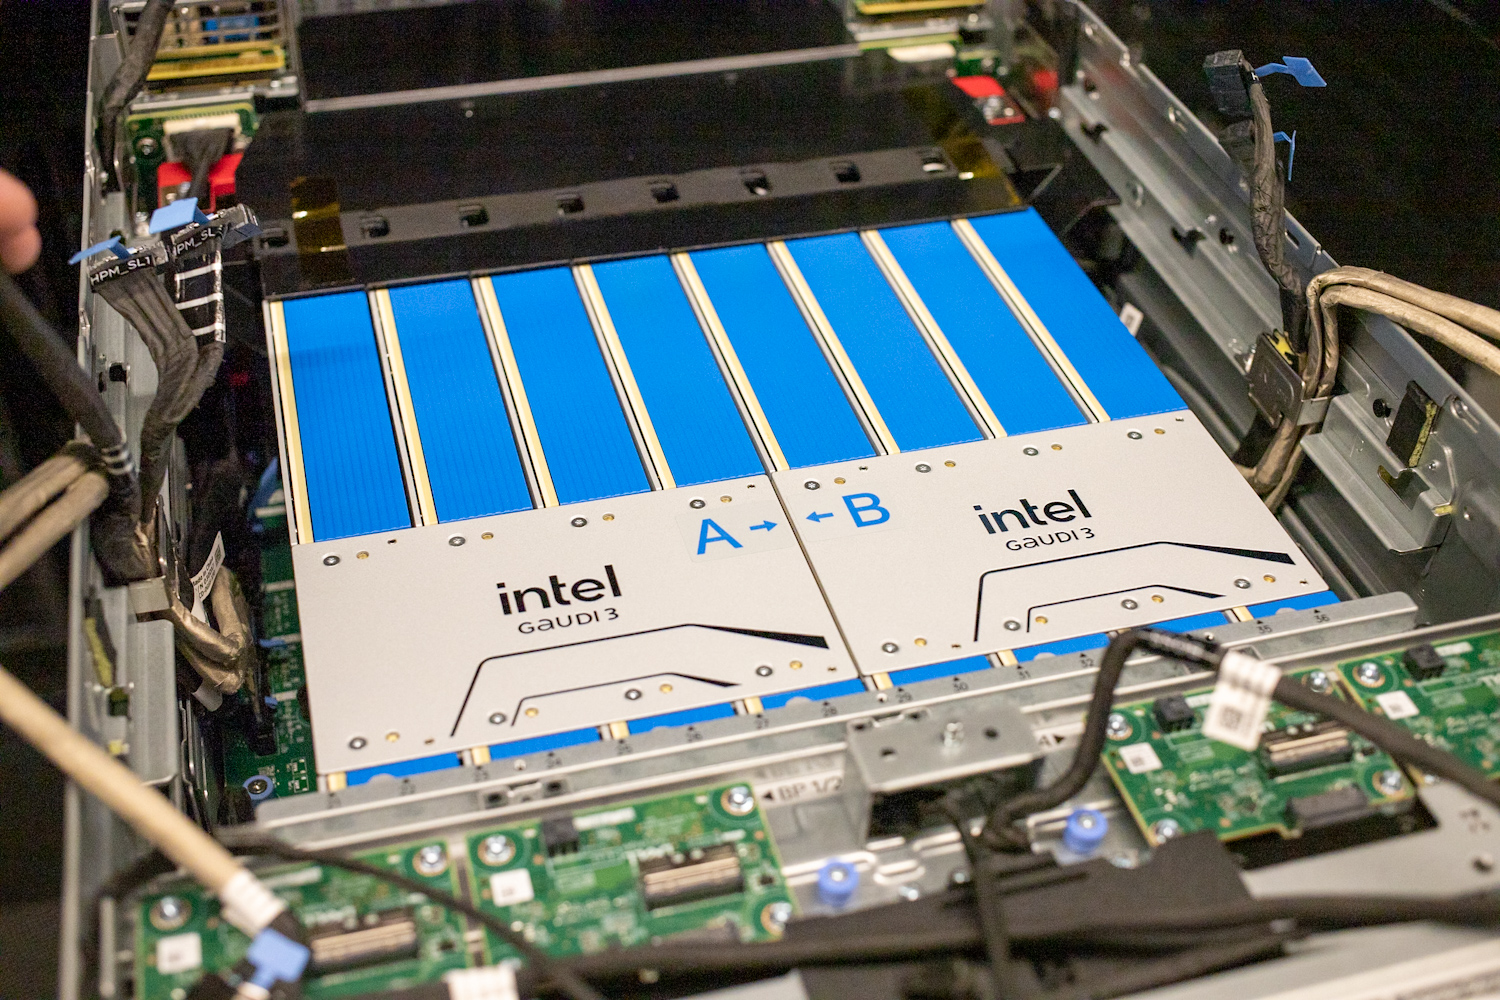
Elementos clave:
- La secuencia PCIe a rack comienza con las tarjetas PCIe en los servidores actuales y se extiende a los racks, según lo dicten los tamaños de los modelos, la concurrencia y los perfiles de SLA. Este enfoque, una estrategia empresarial común, ayuda a minimizar el riesgo del proyecto.
- Admite hasta 64 aceleradores por rack con 8.2 TB de memoria de alto ancho de banda. Su característica clave, el dominio de memoria (HBD), permite más parámetros y contextos de memoria más largos, lo que se traduce en menores caídas de rendimiento y una latencia de cola más consistente.
- Las opciones de enfriamiento líquido son esenciales en densidades de acelerador donde el enfriamiento por aire por sí solo limita la inferencia sostenida.
- La orquestación implica una pila de software abierta, como Kubernetes, servidores de modelo estándar y marcos populares, lo que simplifica la integración con MLOps existentes y arquitecturas de malla de servicios.
En la inferencia de producción, factores como la topología de memoria y la gestión térmica consistente superan el rendimiento teórico máximo. El rack Gaudi 3, que cuenta con 8.2 TB de HBM en 64 aceleradores, satisface necesidades prácticas como la carga de múltiples variantes de gran tamaño, la gestión de solicitudes largas y la gestión de ráfagas sin causar thrashing. La refrigeración líquida no es solo opcional a estas densidades; es esencial para mantener el QPS y la latencia bajo estrés térmico.
Cronograma
- SoftwareLa pila de software abierta y unificada de Intel se está preparando en las GPU Arc Pro Serie B para brindarles a los desarrolladores una ventana temprana para la optimización y la integración de CI/CD.
- Isla de la media lunaMuestreo de clientes proyectado para el segundo semestre de 2026. Planifique evaluaciones en función de la disponibilidad del software, los perfiles de servicio basados en memoria y las limitaciones de los centros de datos refrigerados por aire.
- Gaudí 3 racks:Los diseños de referencia especifican hasta 64 aceleradores/rack, 8.2 TB de HBM y refrigeración líquida, alineando las instalaciones y los límites de energía/refrigeración de manera temprana con sus equipos de DC/colo.


 Amazon