

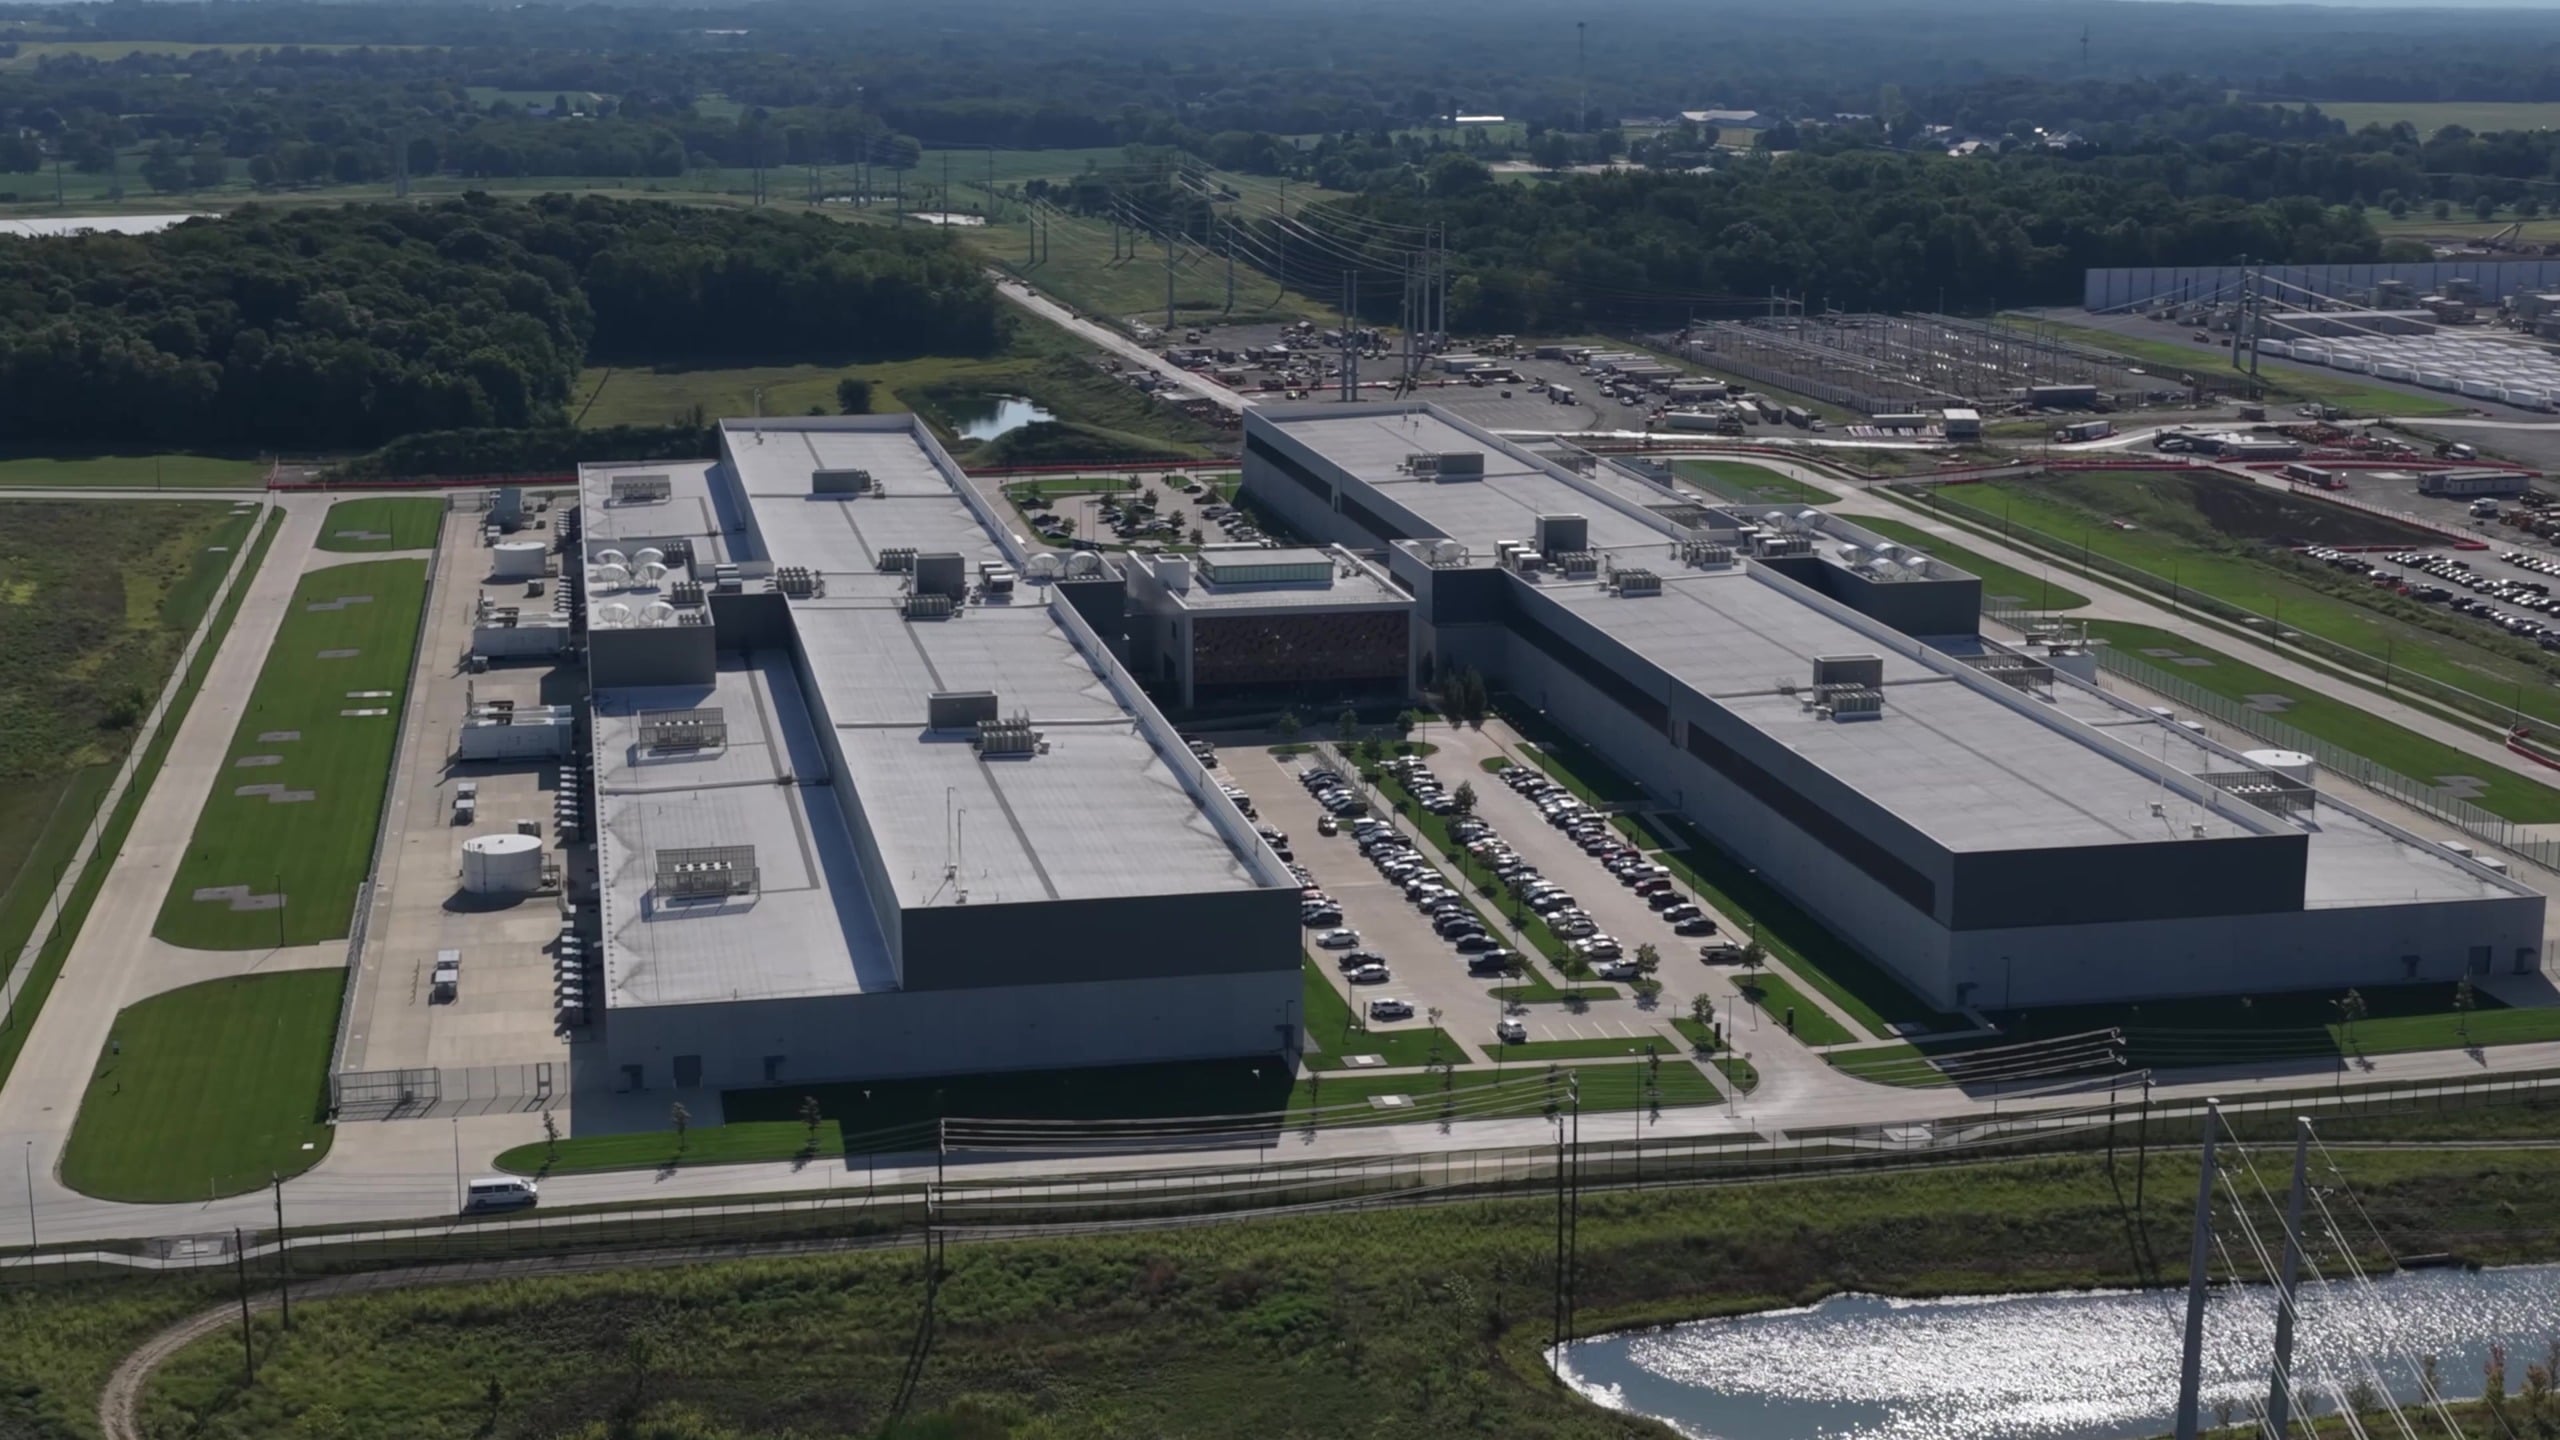
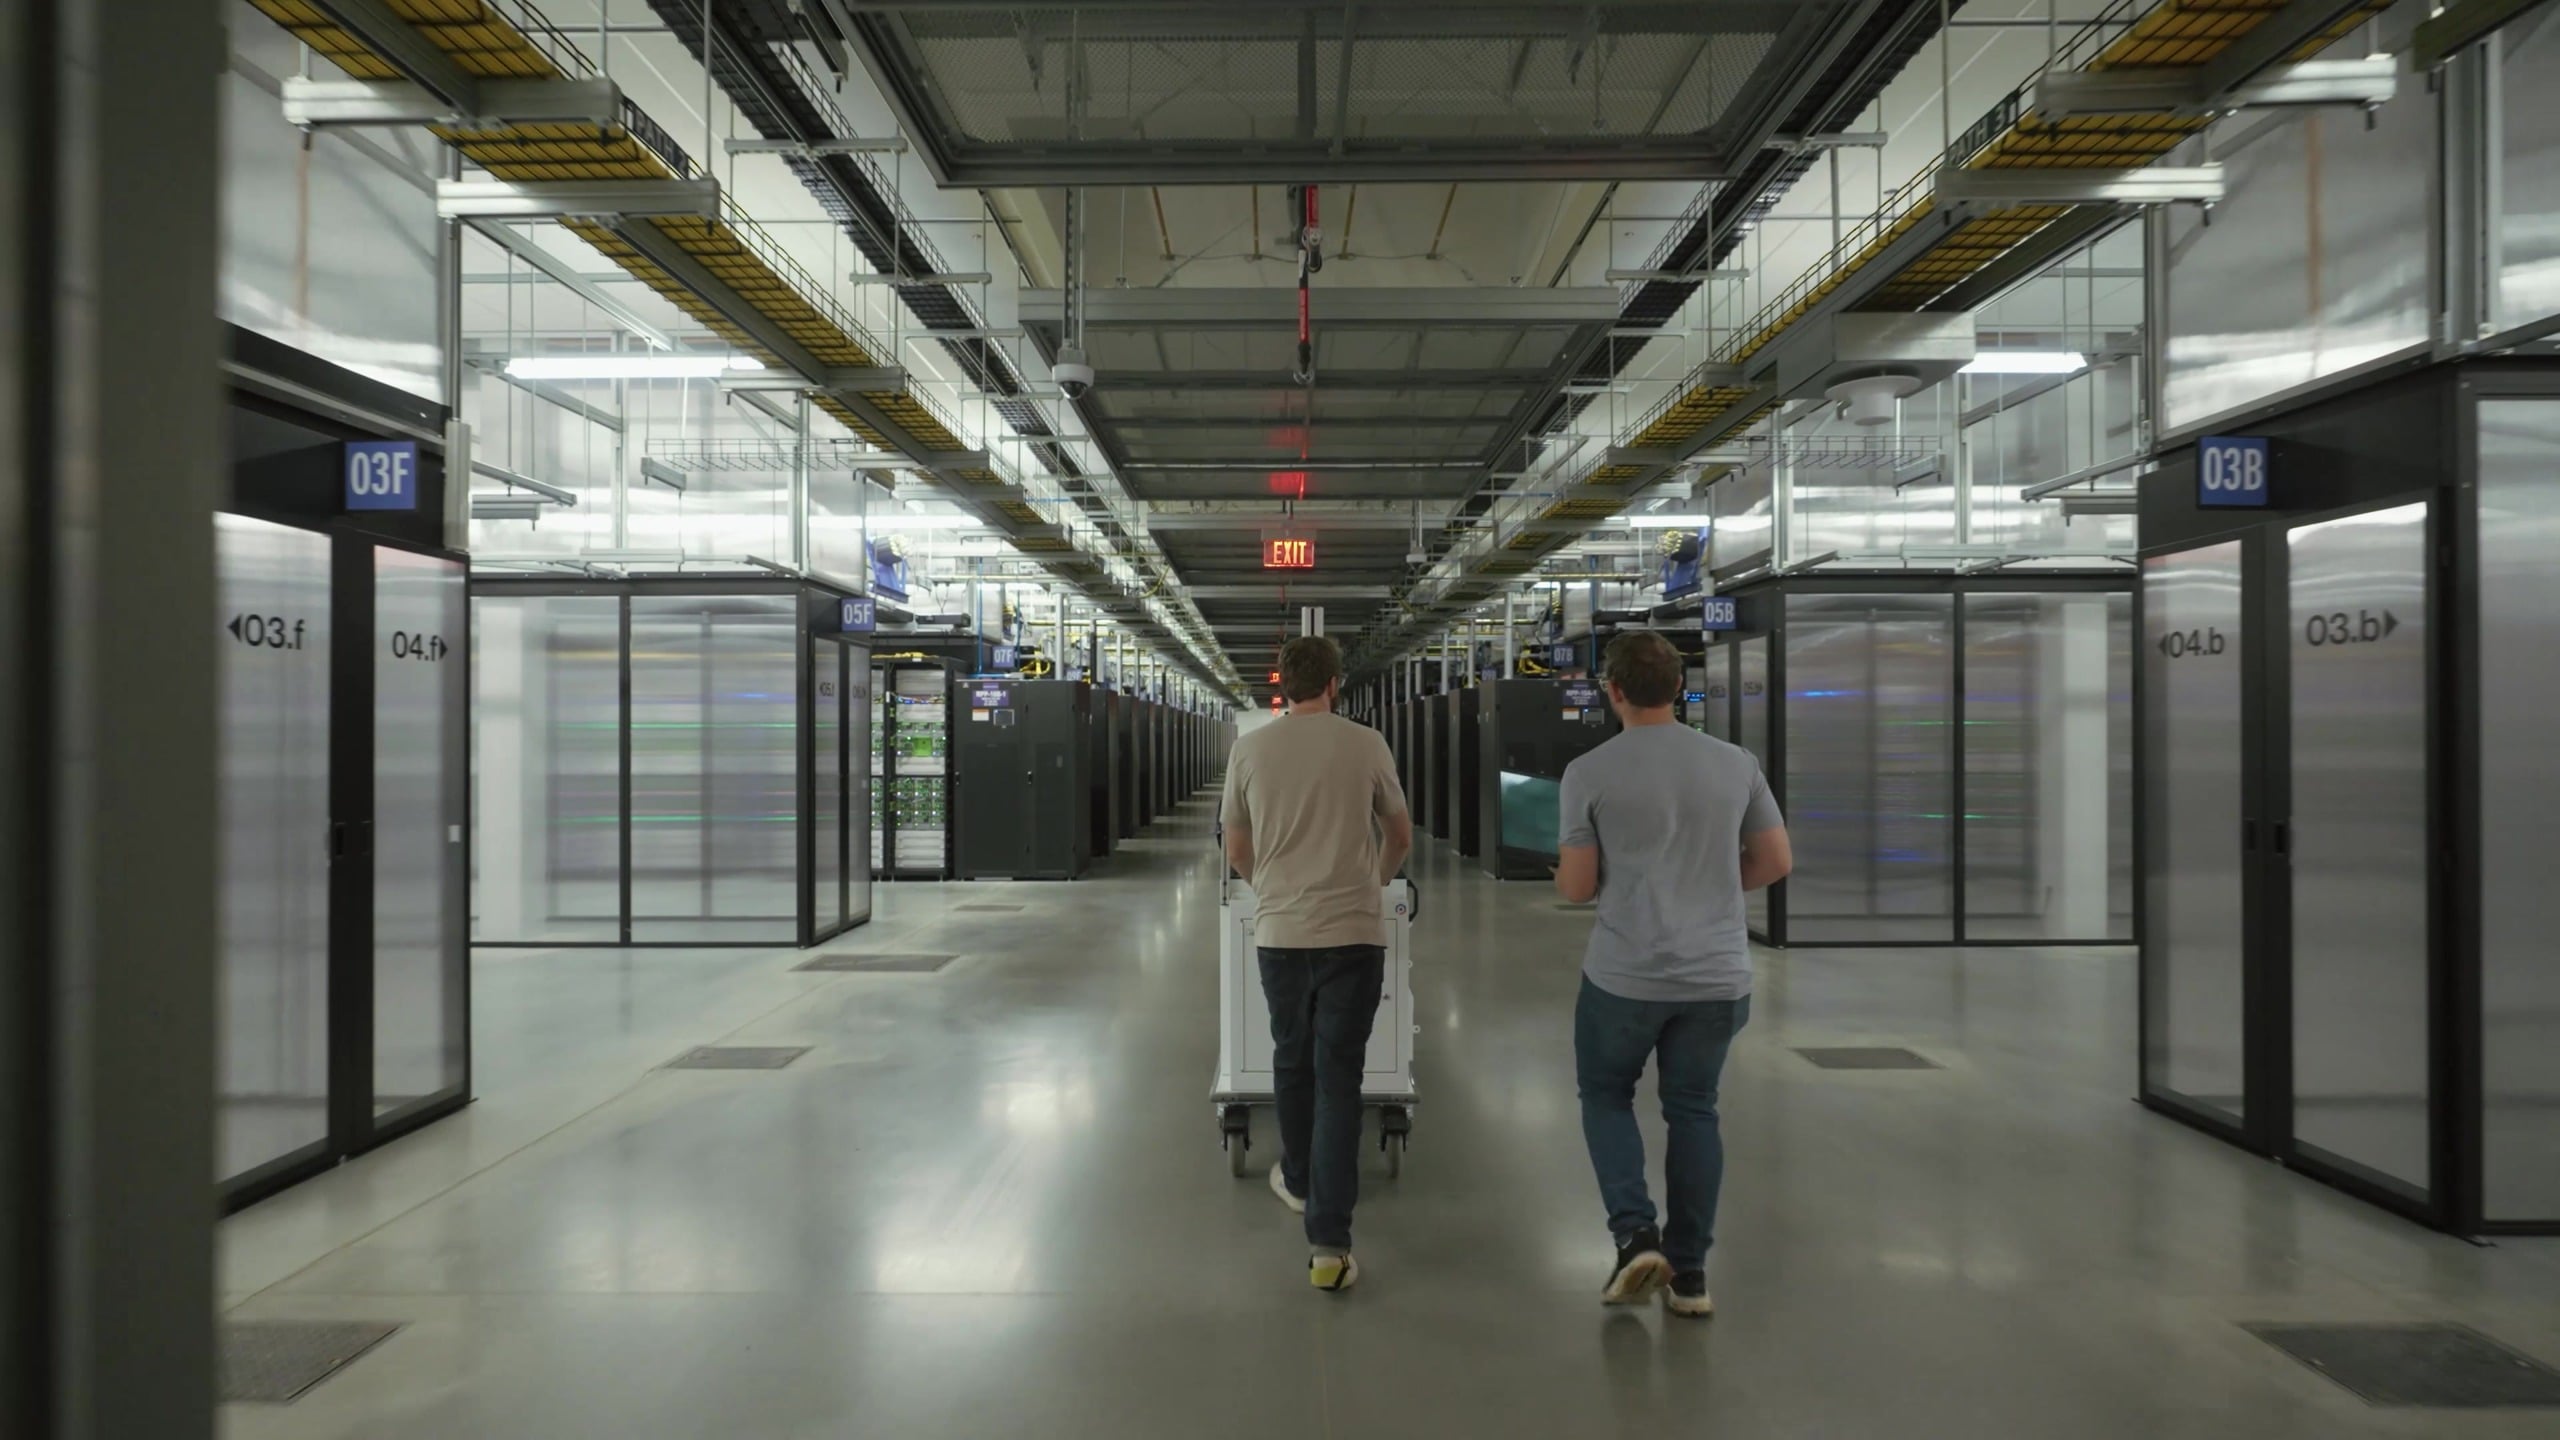
Meta publicó hoy un análisis detallado de Prometheus, el superclúster de IA a escala de gigavatios que está construyendo en New Albany, Ohio. La primera fase ya está completa y ha entrenado la familia de modelos básicos Muse, incluidos los modelos Muse Wonder. Meta afirma que el sitio se está ampliando para alcanzar aproximadamente un millón de GPU. Hace dos años, este mismo campus era un centro de datos convencional que gestionaba el tráfico web. La publicación, de los ingenieros de Meta Kevin Lee, Yashar Bayani, Ahmed Sharif y Yee Jiun Song, abarca el hardware, la red y el trabajo de fiabilidad que mantiene en marcha los procesos de entrenamiento.
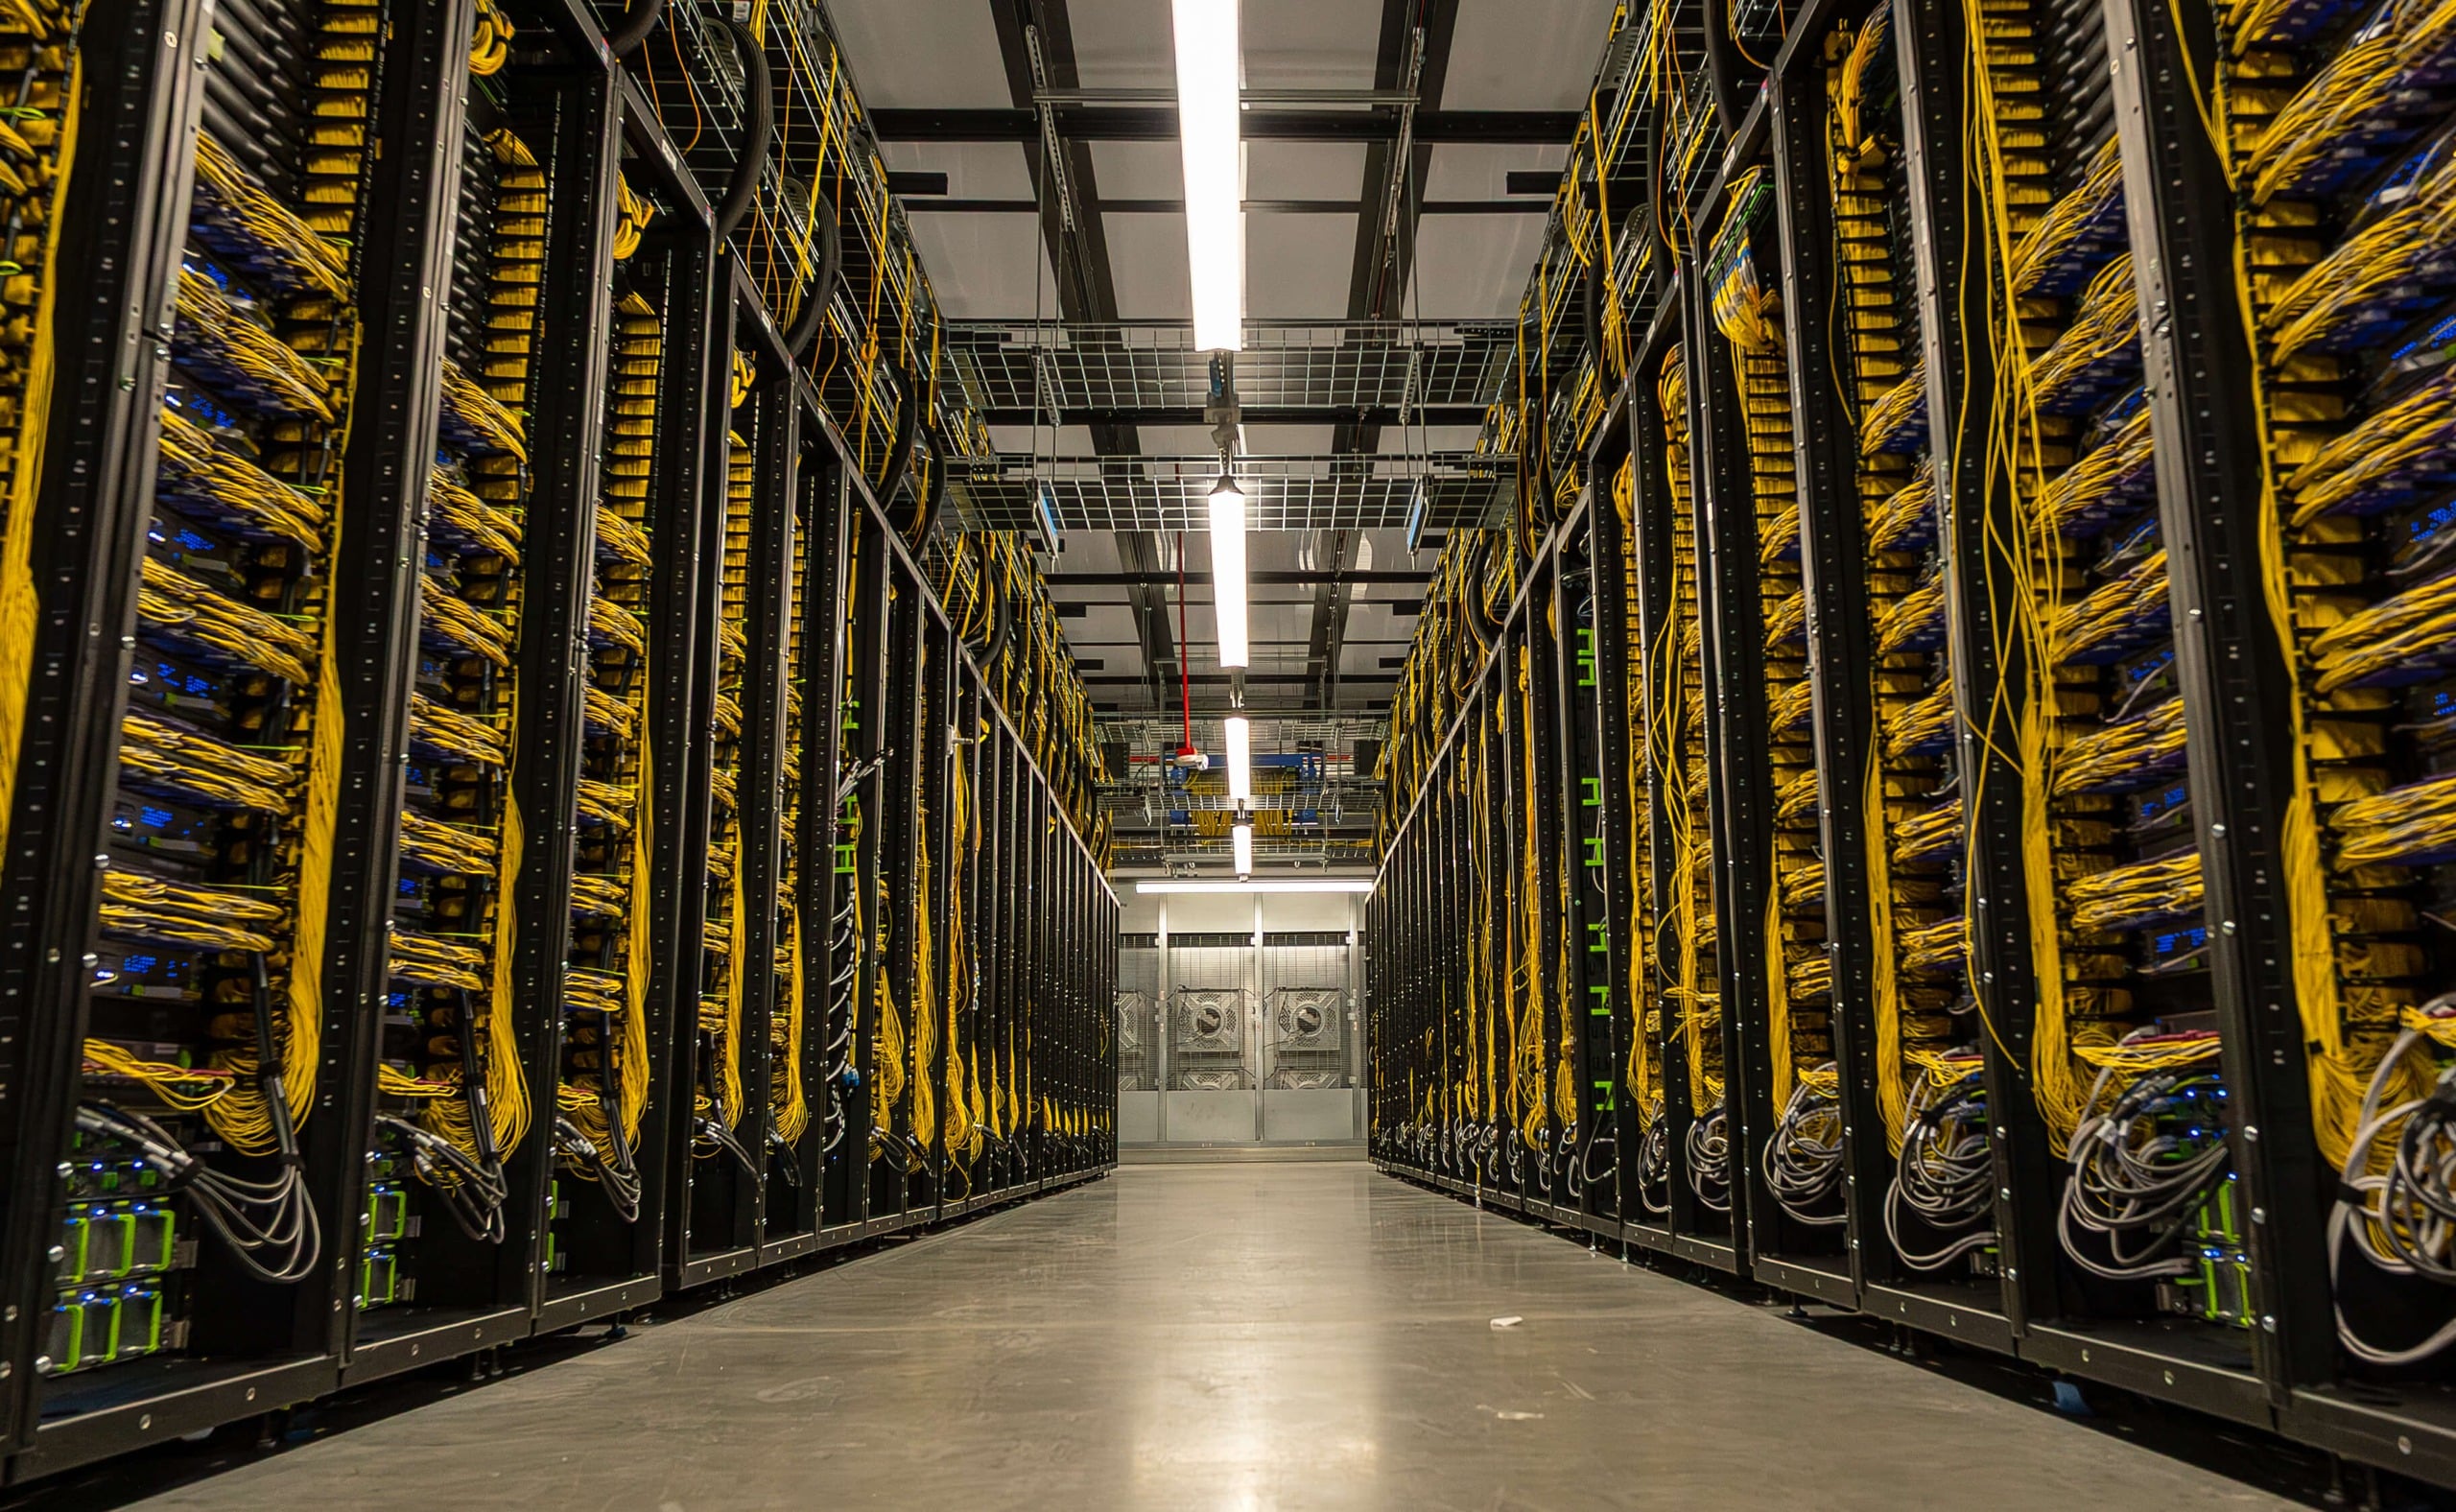
Meta también ha revelado algunos de los datos más interesantes sobre la ejecución de grandes tareas de entrenamiento: las cifras de fiabilidad. Meta informa de un rendimiento superior al 85 % en las ejecuciones de preentrenamiento de Muse Wonder y superior al 90 % en las ejecuciones de aprendizaje por refuerzo, con un tiempo medio real entre interrupciones de aproximadamente 47 000 horas de GPU durante dichas ejecuciones. Las correcciones de firmware implementadas desde entonces han elevado el MTBI a más de 54 000 horas de GPU. El objetivo declarado de Meta es de dos interrupciones por cada 8 000 GPU al día, lo que equivale a aproximadamente 100 000 horas de GPU entre interrupciones.
Dos generaciones del NVL72 en producción, Vera Rubin Next
Prometheus ejecuta actualmente dos plataformas de GPU NVIDIA, ambas basadas en la arquitectura de rack NVL72, donde 72 GPU comparten un dominio NVLink, con una tercera basada en Vera Rubin NVL72 que llegará próximamente. La primera, que Meta denomina Catalina, utiliza la GB200 NVL72 en la variante Ariel: una configuración de dos racks con 36 GPU por rack, basada en el diseño de rack de alta potencia Open Rack V3 de Meta, aportado al Open Compute Project. Cada GPU Blackwell se combina con una CPU Grace y dos NIC ConnectX-7 de 400 G, una relación CPU-GPU de 1:1 que proporciona a cada GPU un ancho de banda escalable de 800 G.
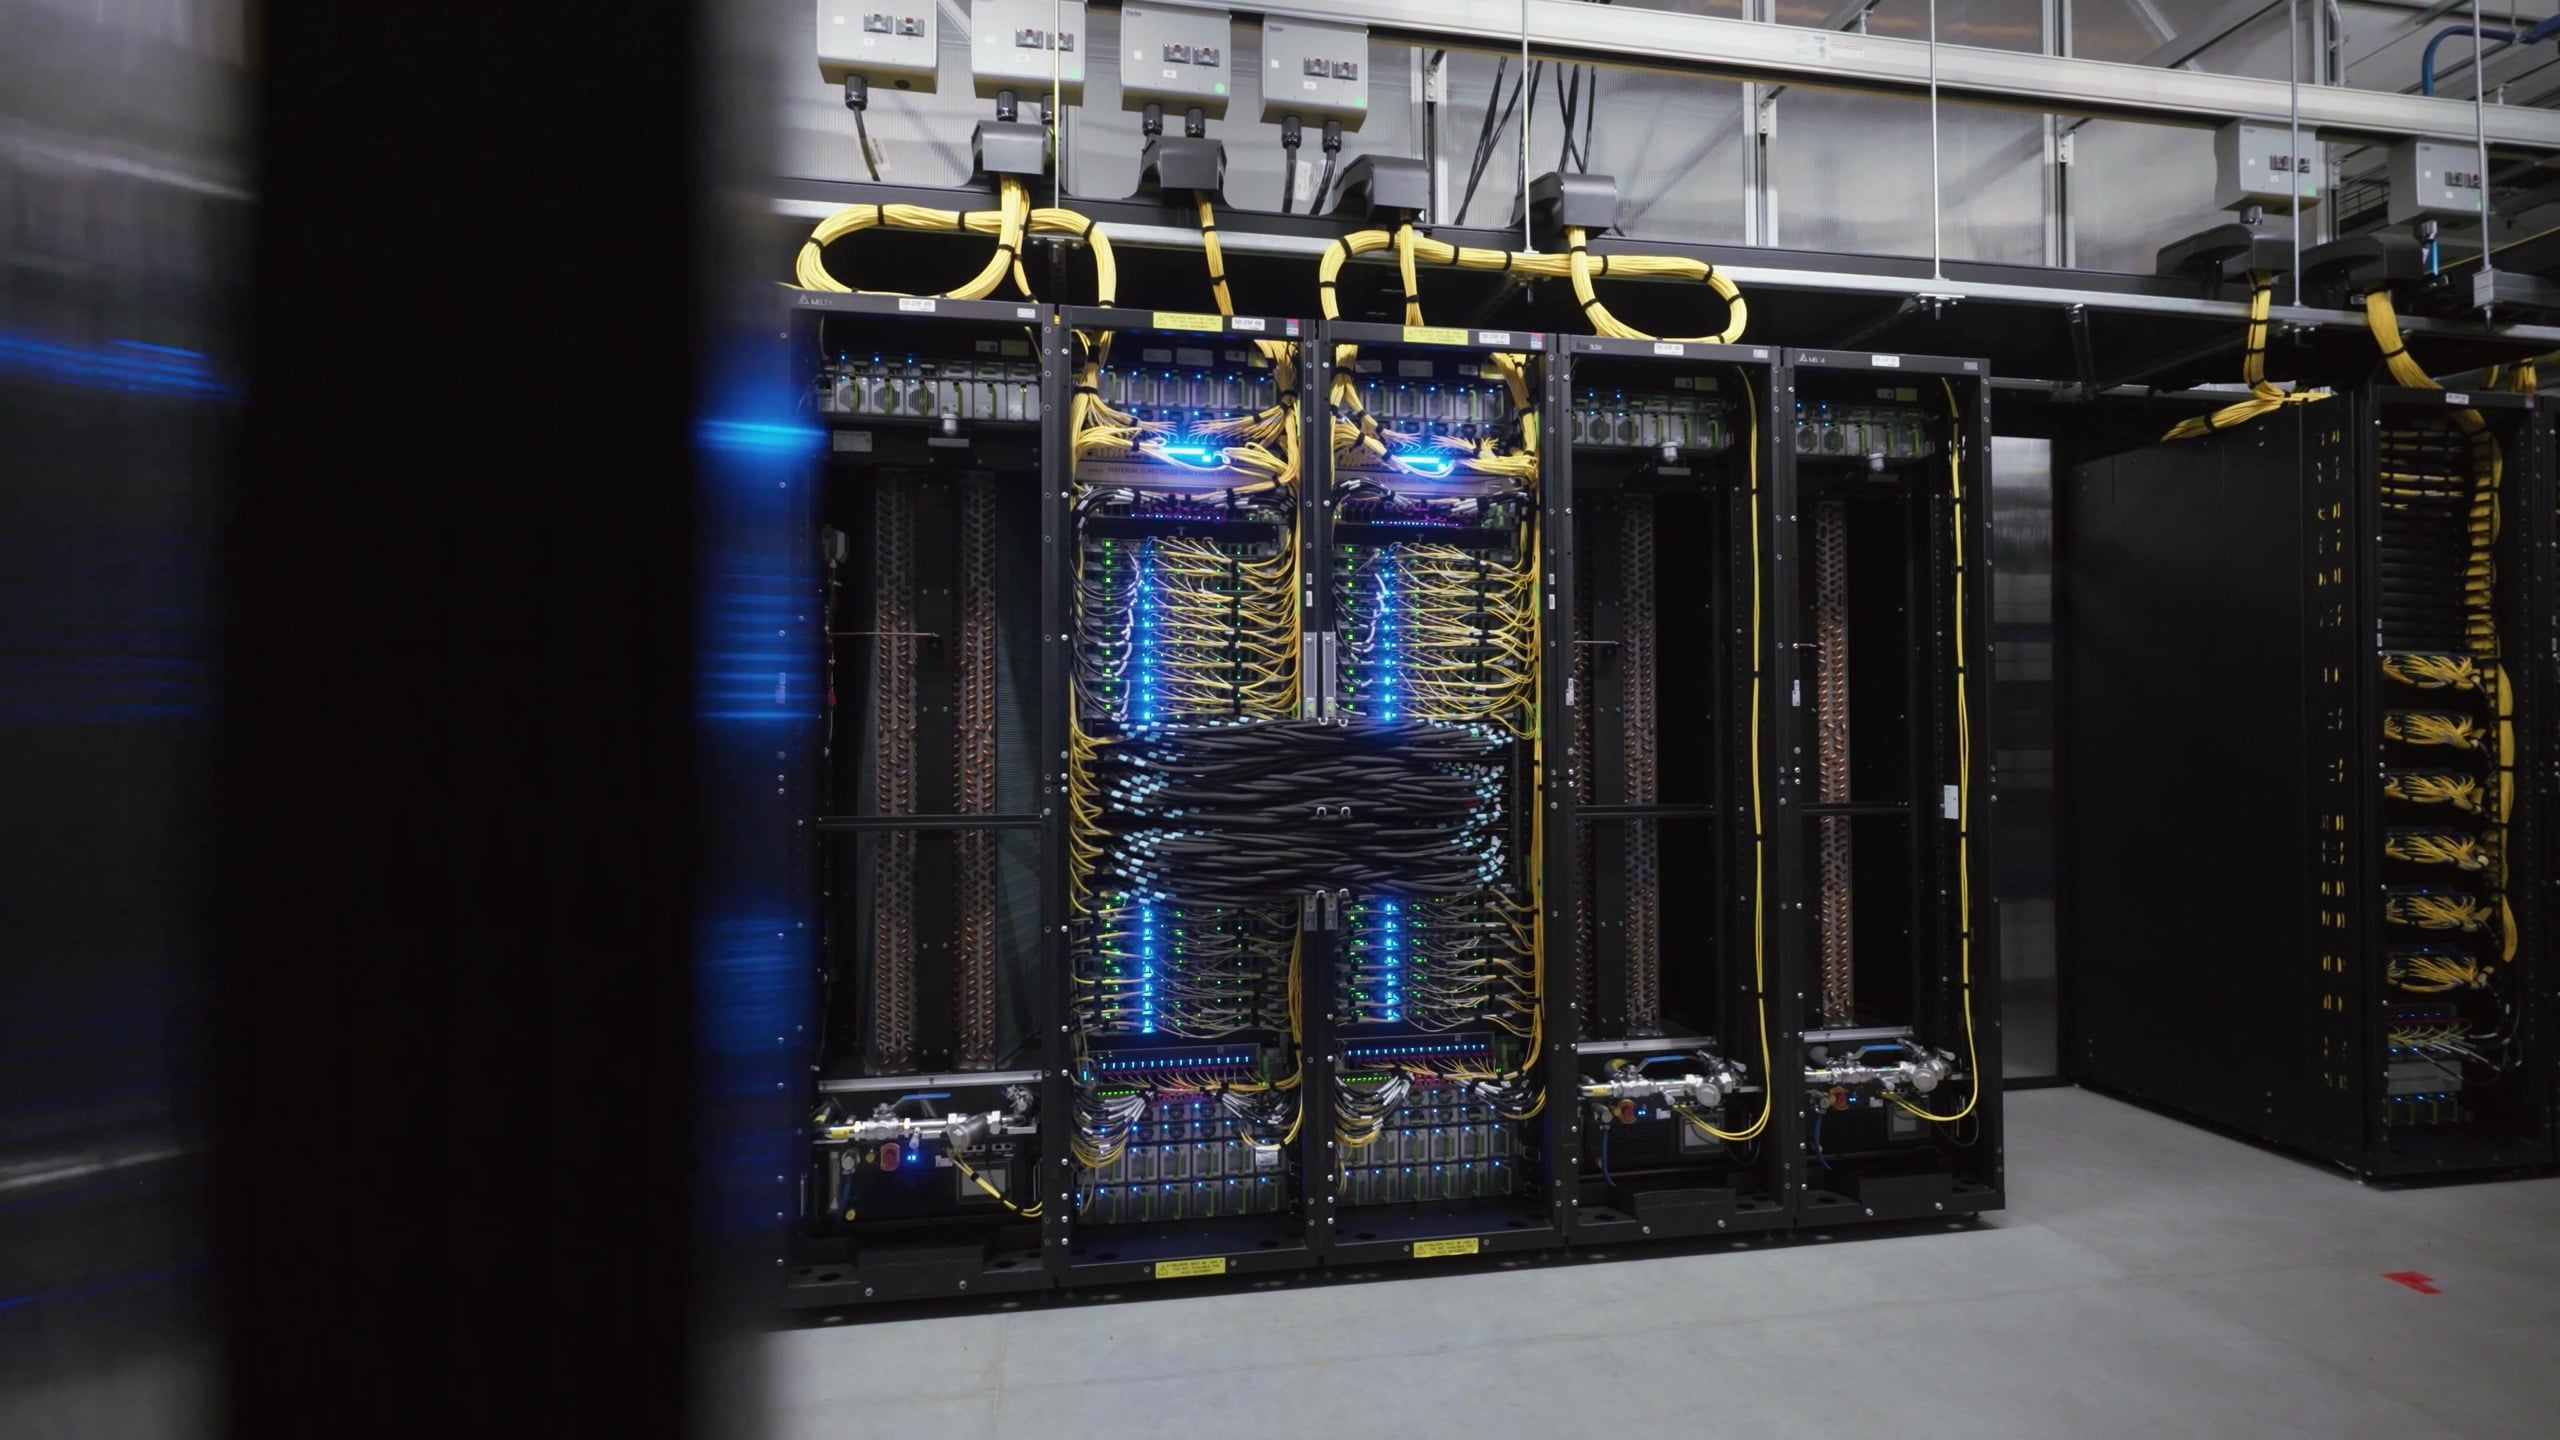
Meta afirma que eligió Ariel porque el GB200 NVL72 escalaba los FLOPS, el ancho de banda HBM, el ancho de banda de escalado ascendente y el tamaño del dominio mucho más allá del H100, mientras que el escalado horizontal estándar se habría mantenido en 400G por GPU, y esperaba que ese desequilibrio afectara negativamente al rendimiento. Según Meta, un par de Catalina lleva 72 GPU Blackwell con 13.4 TB de HBM3e (192 GB por GPU), 720 PFLOPS de cómputo de entrenamiento FP8 máximo (1,440 PFLOPS en FP4), 130 TB/s de ancho de banda NVLink dentro del dominio, 576 TB/s de ancho de banda de memoria agregada y consume unos 120 kW en los dos racks.
La segunda plataforma, Clemente, se traslada al GB300 NVL72. La memoria HBM por GPU aumenta 1.5 veces hasta 288 GB, el rendimiento de FP4 denso aumenta en un factor similar y la aceleración de atención prácticamente se duplica. Las tarjetas ConnectX-8 SuperNIC ofrecen 800G por GPU de forma nativa, por lo que la capacidad de escalabilidad horizontal que Meta diseñó para Ariel se convierte en la base, y una relación GPU-CPU de 2:1 permite que el dominio completo de 72 GPU quepa en un solo rack. Meta enumera 20.7 TB de HBM3e, más de un exaFLOP de cómputo FP4 máximo, 130 TB/s de ancho de banda NVLink (1.8 TB/s bidireccional por GPU), alrededor de 135 kW por rack y una ganancia de rendimiento del 5 al 10 por ciento con respecto al GB200 NVL72.
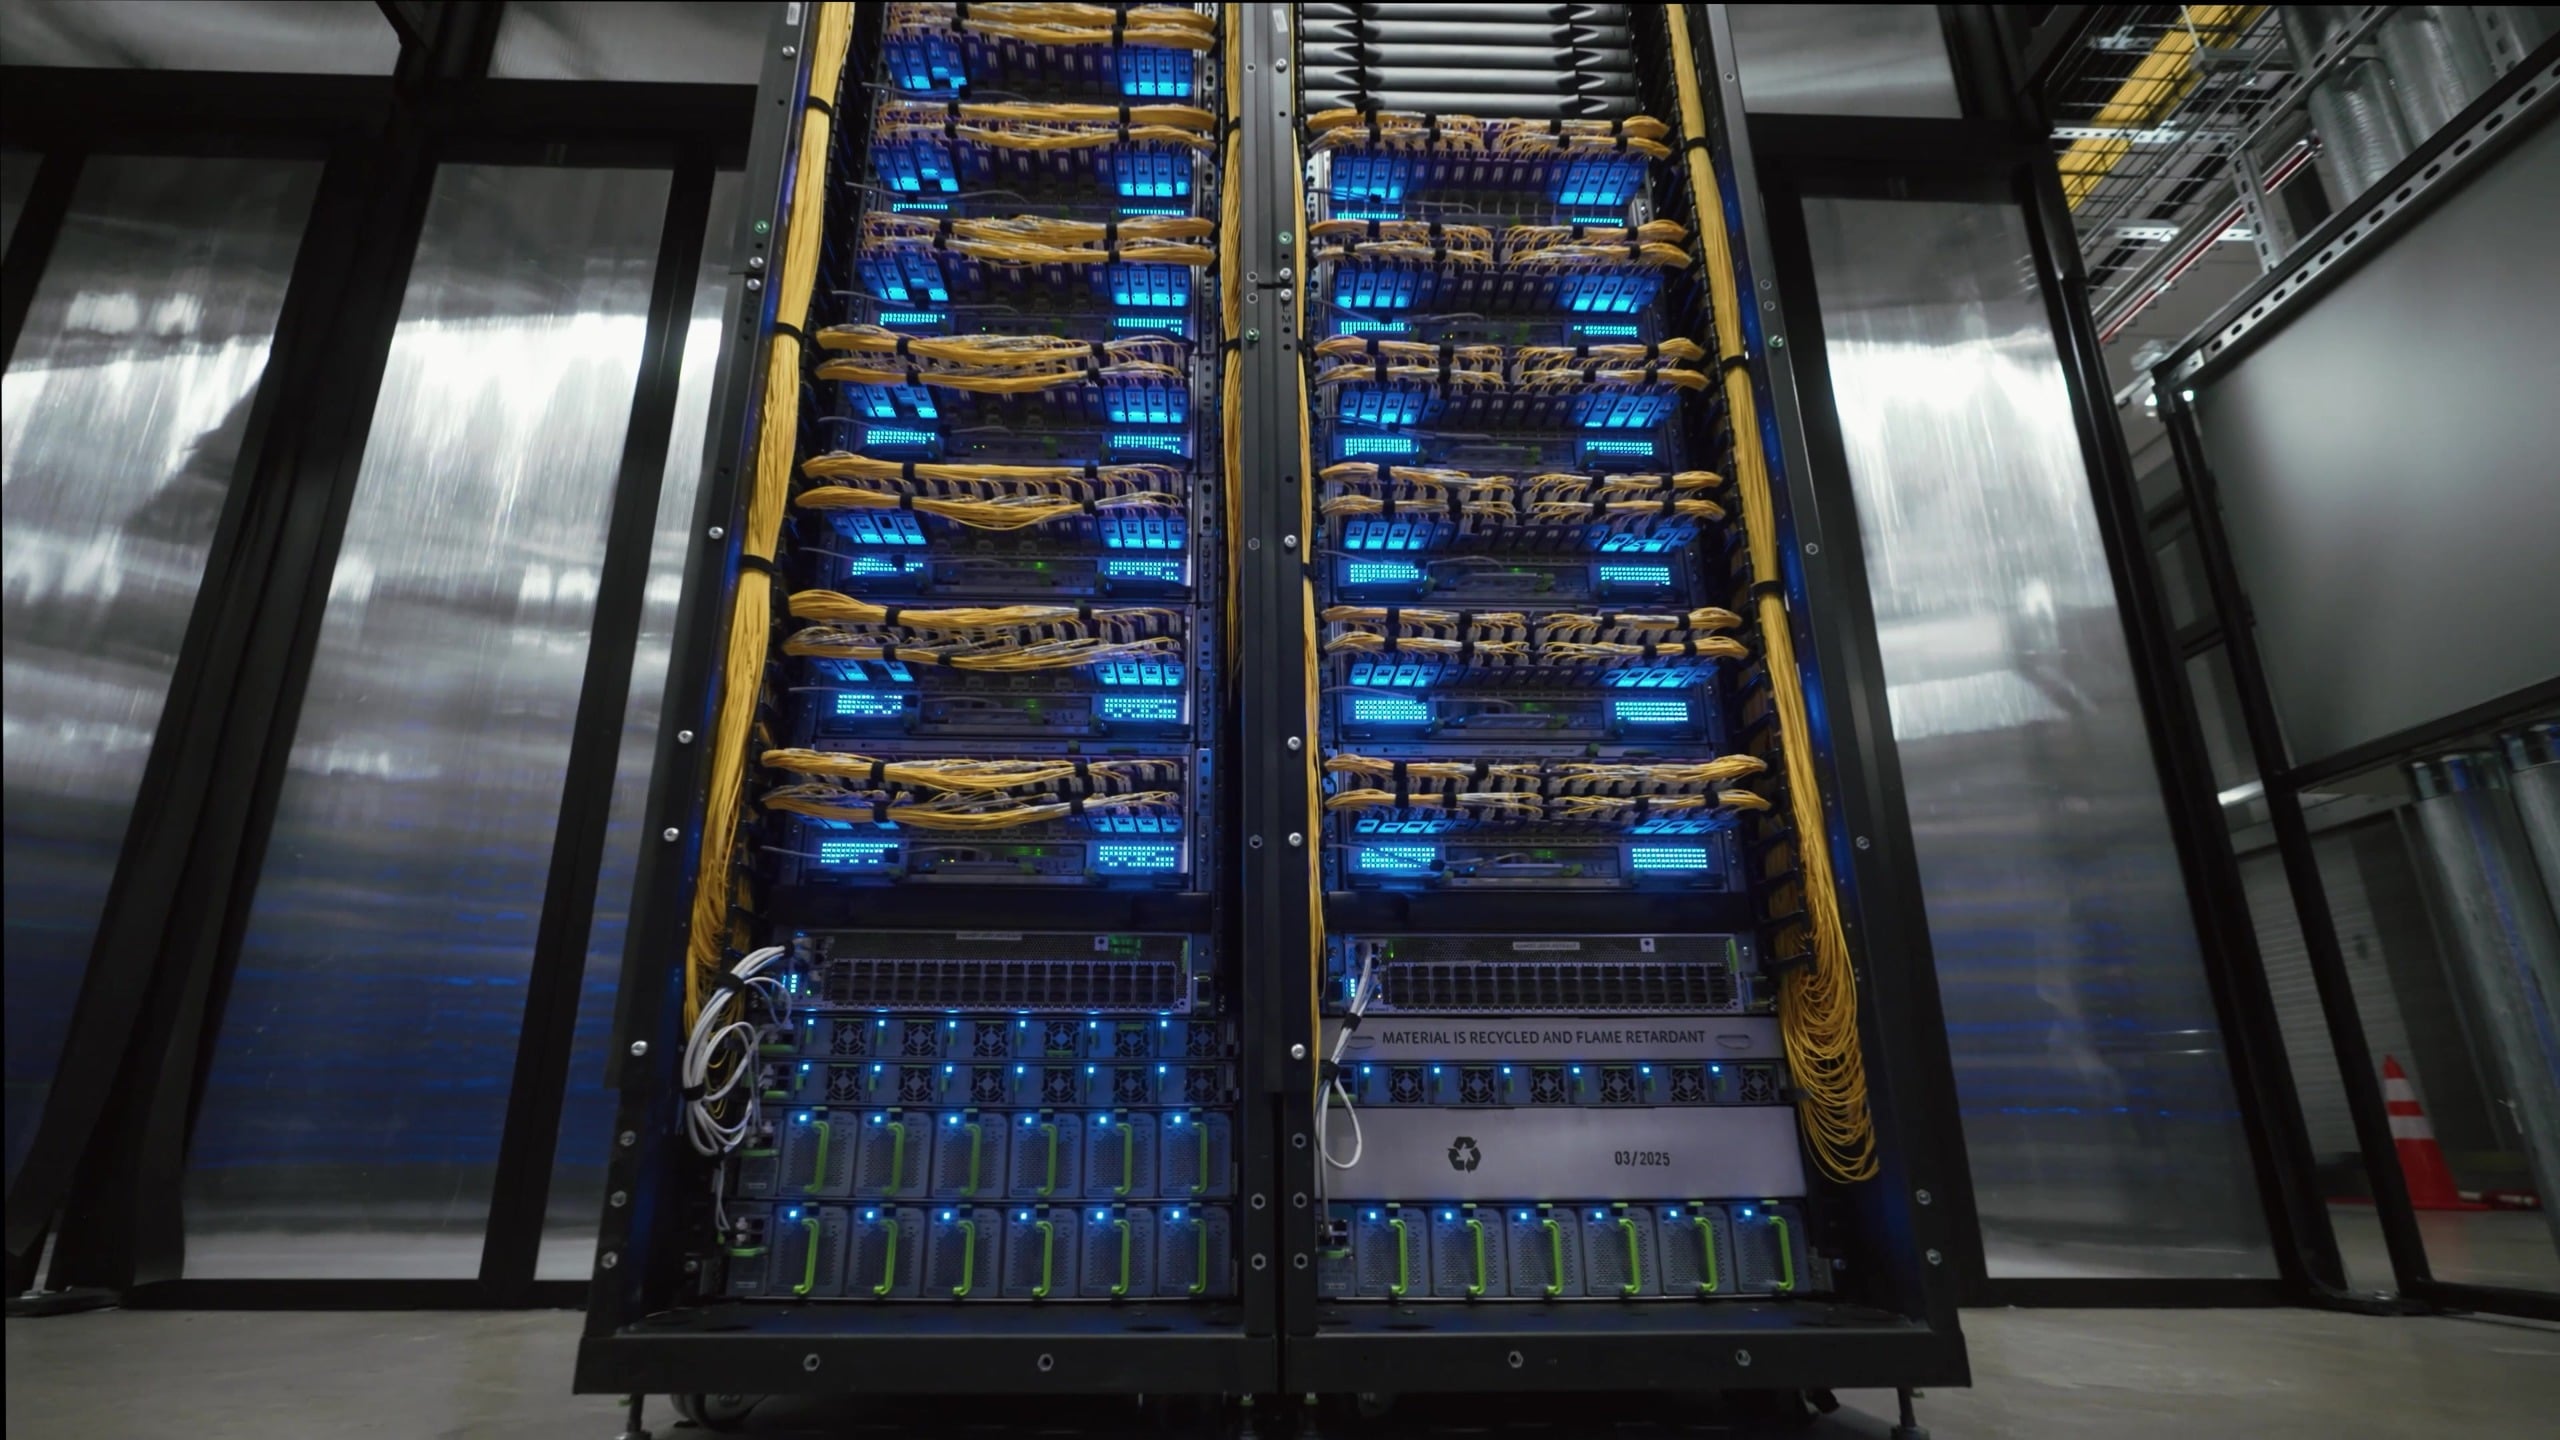
Clemente utiliza el sistema modular de refrigeración líquida asistida por aire de Meta o el sistema de refrigeración líquida para instalaciones en sus edificios más nuevos optimizados con IA, y Meta afirma que la facilidad de mantenimiento mejora con menos cableado.
La próxima plataforma de Meta, San Miguel, integrará Vera Rubin NVL72 en la misma red. Las cifras de Meta para ese rack son: 288 GB de HBM4 por GPU a 19.2 TB/s, 2.52 exaFLOPS de rendimiento máximo de entrenamiento FP4 y 1.26 exaFLOPS en FP8, 216 TB/s de ancho de banda NVLink (3 TB/s por GPU), aproximadamente 1,500 TB/s de ancho de banda de memoria agregada, bandejas de computación totalmente refrigeradas por líquido a más de 170 kW por rack y una mejora del rendimiento por vatio del 10 al 20 por ciento con respecto al GB300 NVL72. CoreWeave puso en producción Vera Rubin NVL72 a principios de este mes.
Un sistema Ethernet dedicado que abarca varios edificios.
El tráfico de entrenamiento se ejecuta en una segunda red de centro de datos a través de Ethernet, separada de la red frontal que transporta el tráfico de servicio habitual. El diseño sigue la estructura de una tarea de entrenamiento: las réplicas paralelas de datos mantienen sus conjuntos de datos, sensibles a la latencia y con alto consumo de ancho de banda, dentro de una estructura de edificios, mientras que el tráfico más tolerante entre réplicas atraviesa una capa de agregación que conecta los edificios. Meta implementó la misma jerarquía en sus clústeres anteriores a escala de edificios con 24 000 GPU y en su clúster regional con más de 100 000 GPU antes de extenderla a Prometheus.
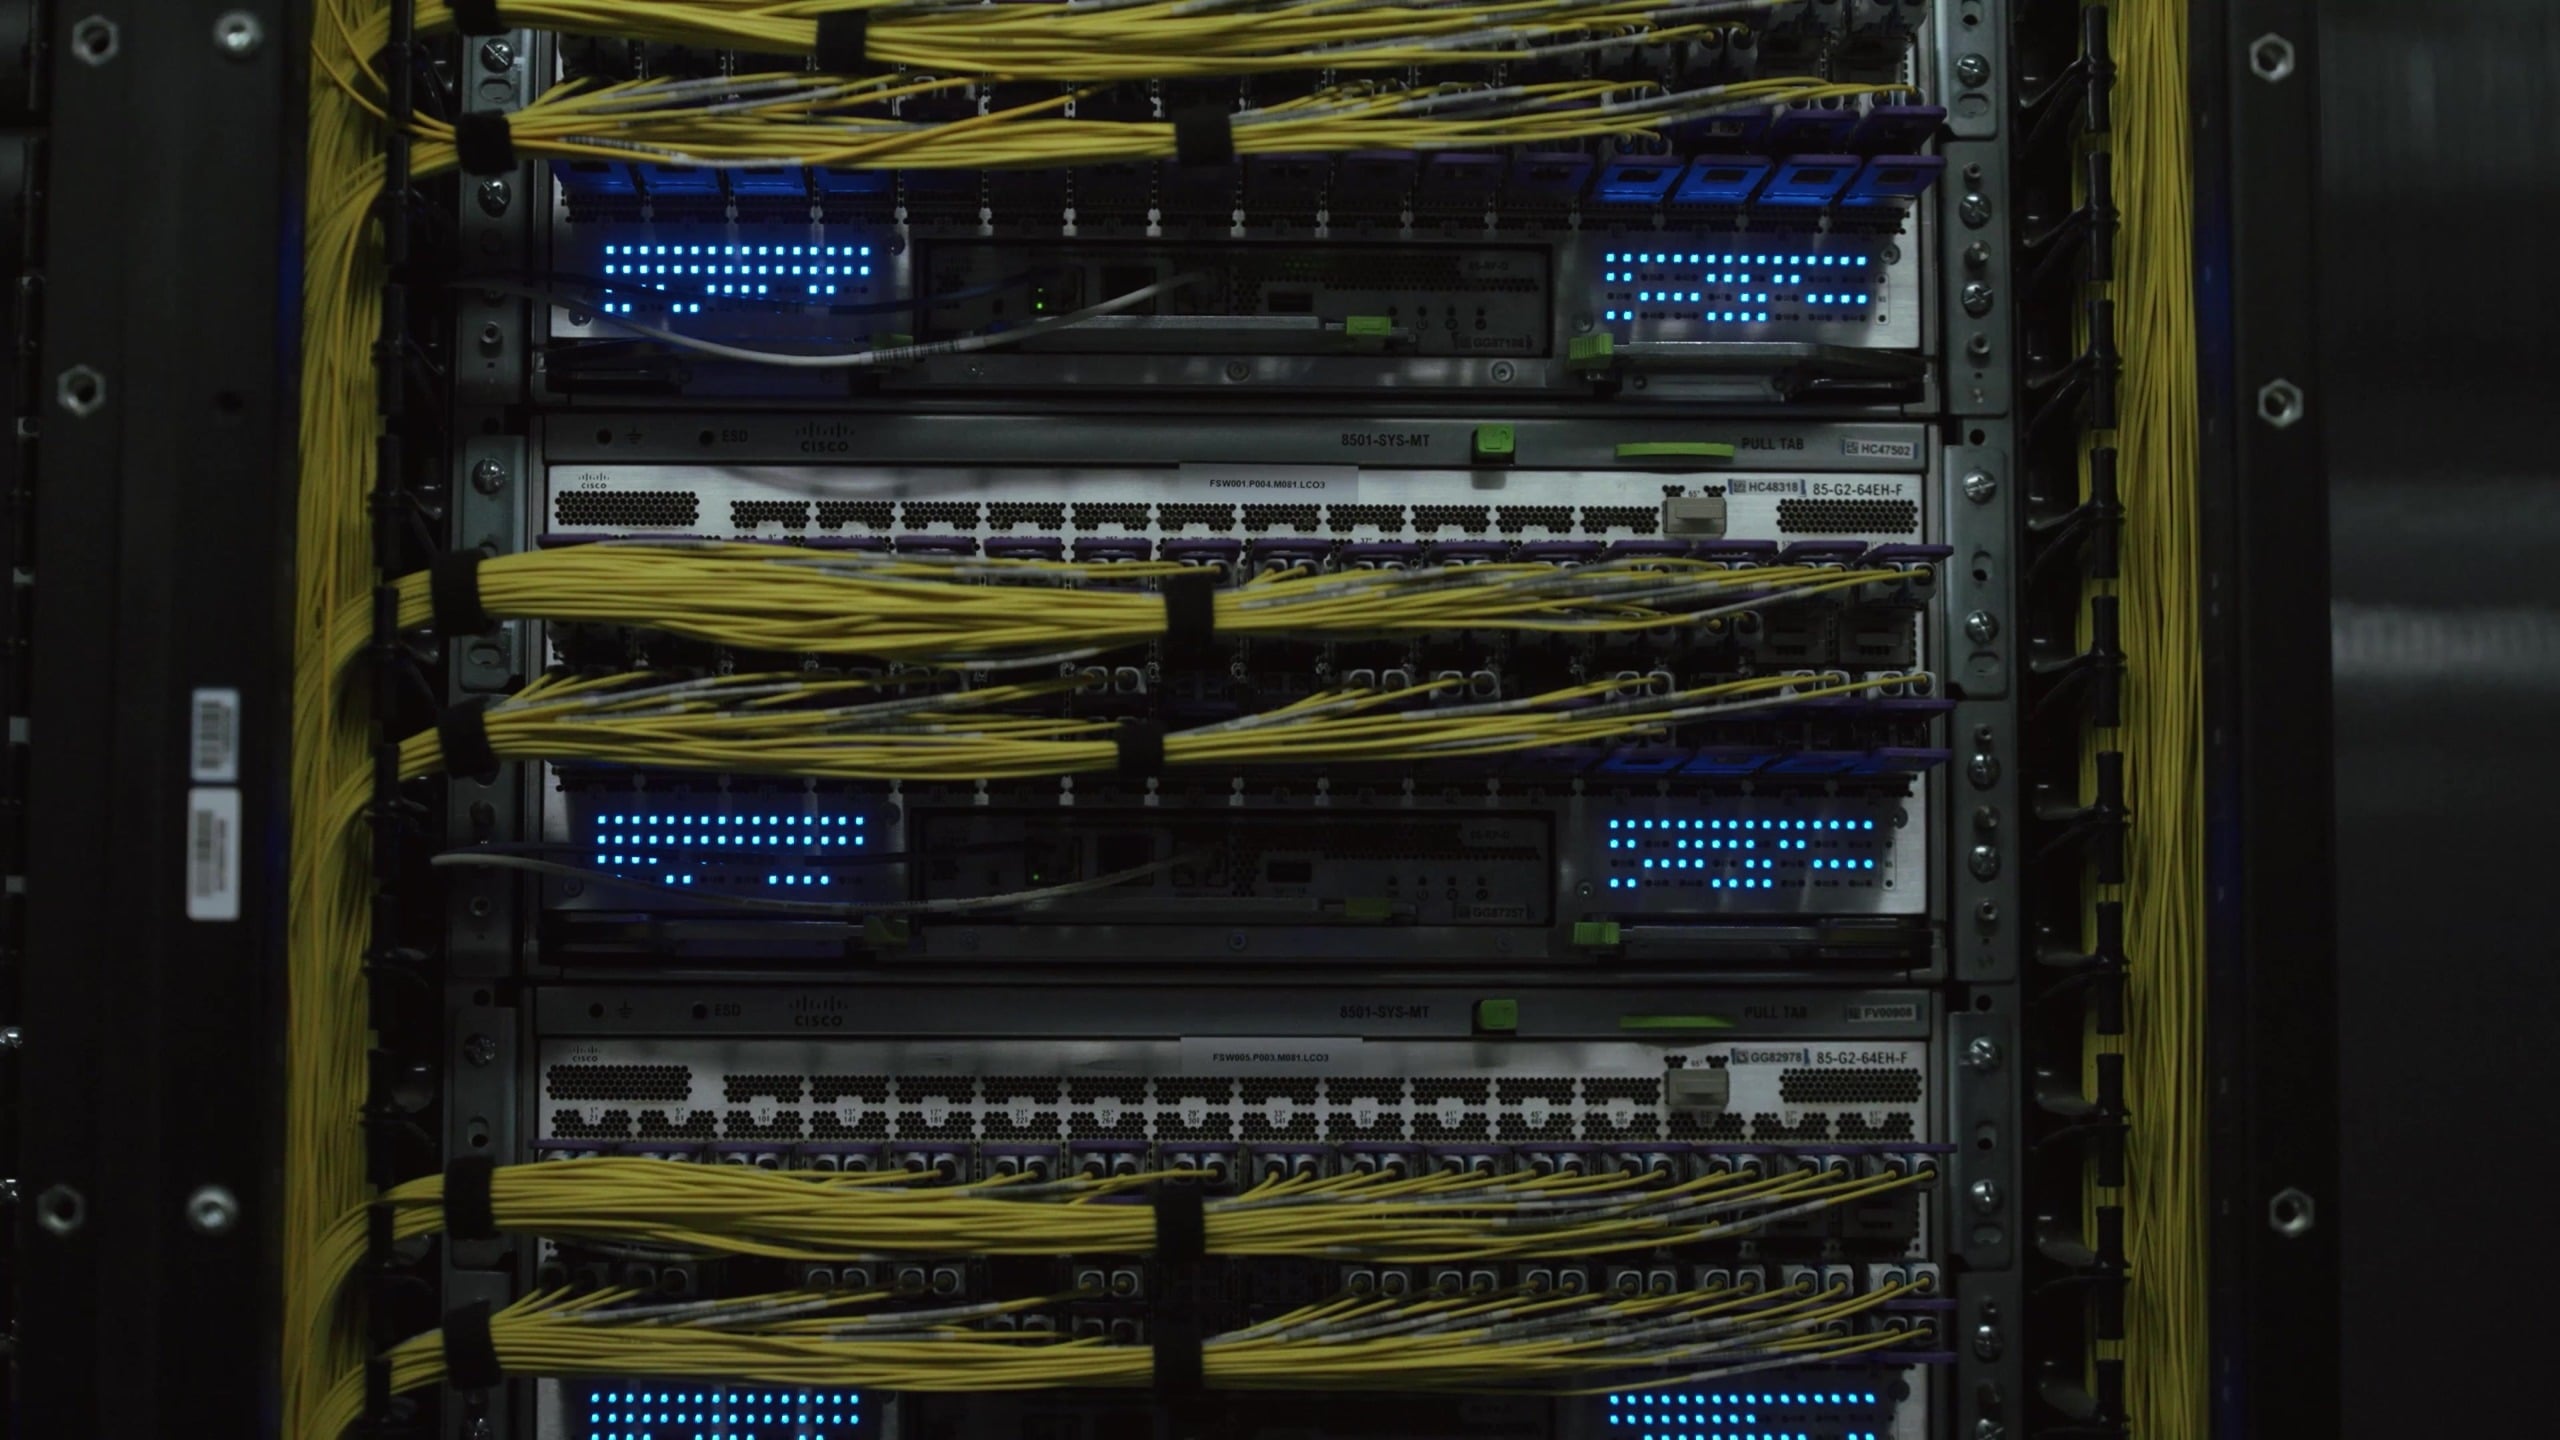
Cada estructura de edificios conecta hasta 20,736 GPU. El primer diseño de Meta fue una estructura programada desagregada que utilizaba enrutamiento multipath de subpaquetes, reordenamiento dentro de la estructura, colas de salida virtuales y control de flujo basado en créditos para evitar colisiones entre los pocos flujos grandes y de larga duración de un colectivo de entrenamiento. A medida que las NIC adquirieron la capacidad de reordenar paquetes en el punto final, Meta pasó a una estructura no programada basada en conmutadores de búfer poco profundo de 51.2 T: Minipack3 con equilibrio de carga dinámico y Minipack3N, que utiliza el ASIC NVIDIA Spectrum-4 con enrutamiento adaptativo en NIC ConnectX, ambos ejecutando la pila de red FBOSS de Meta.
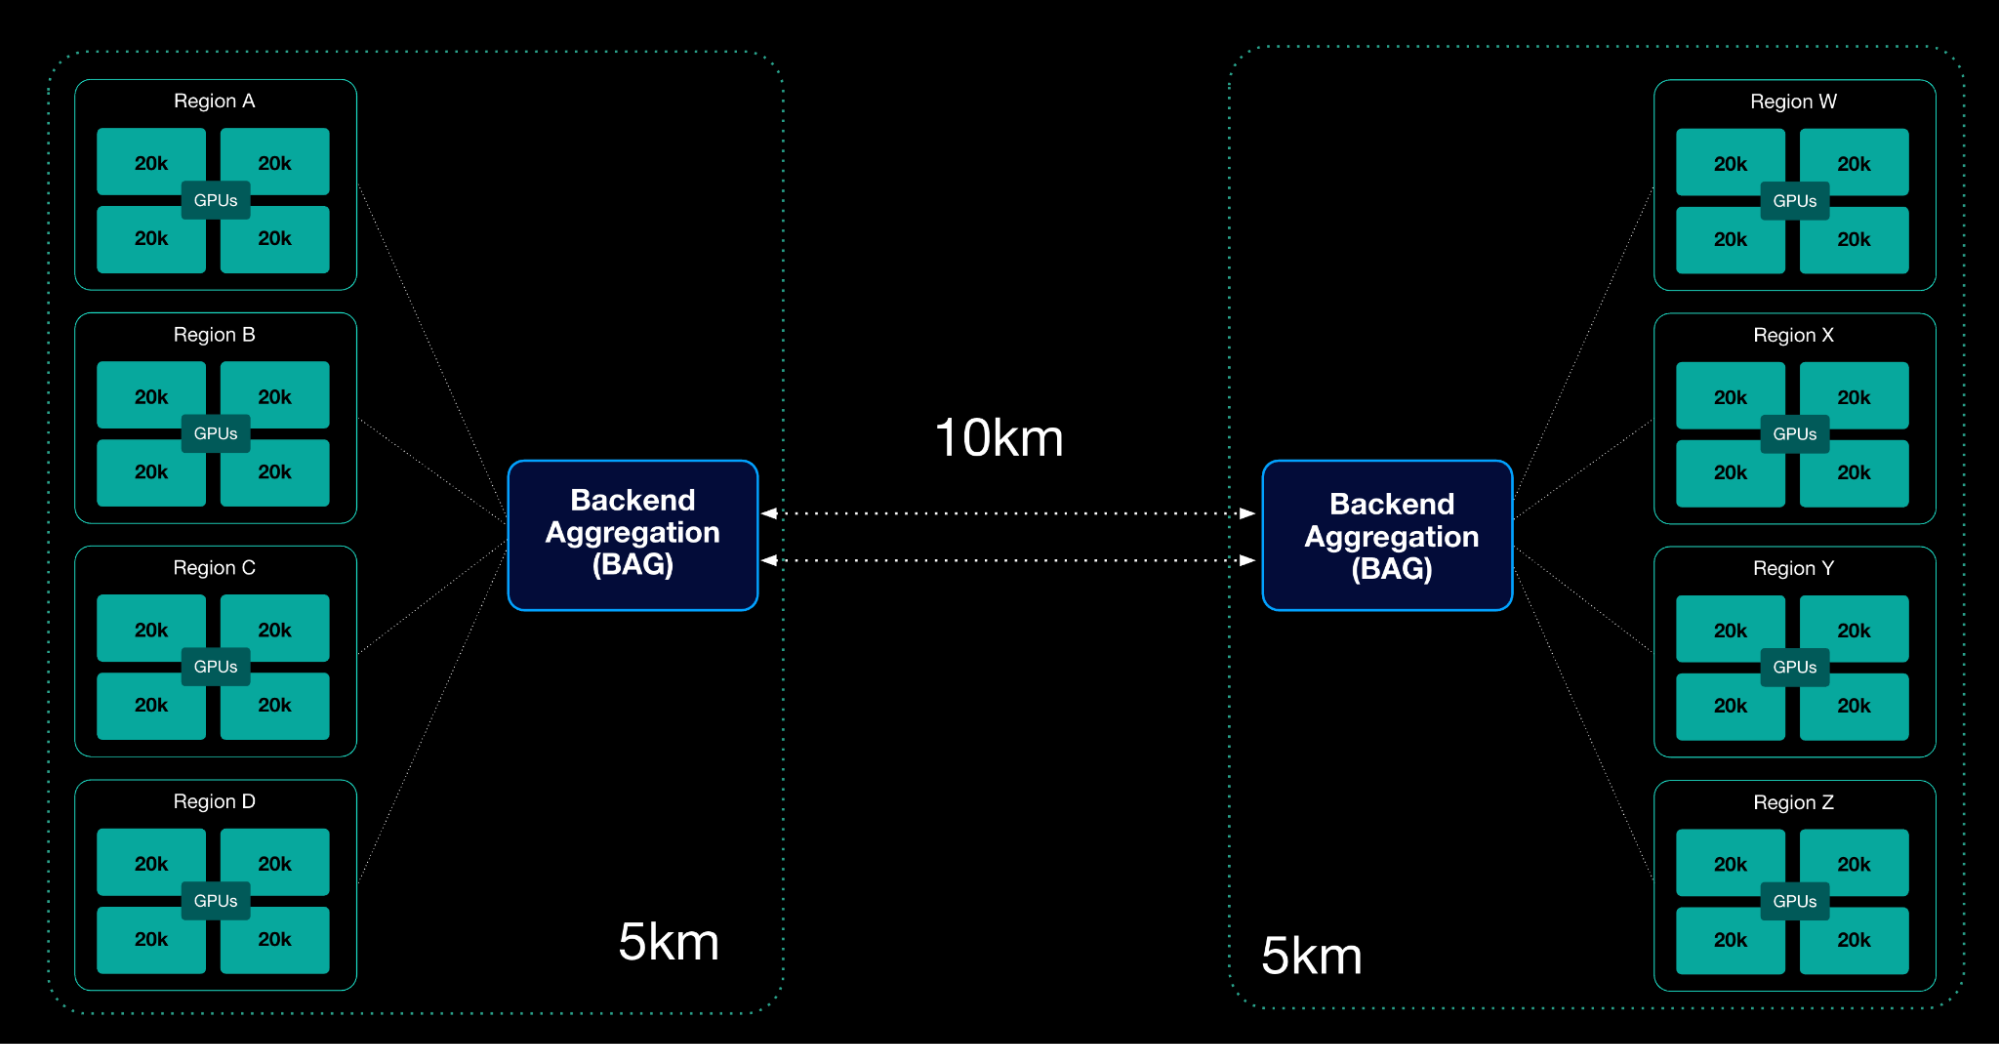
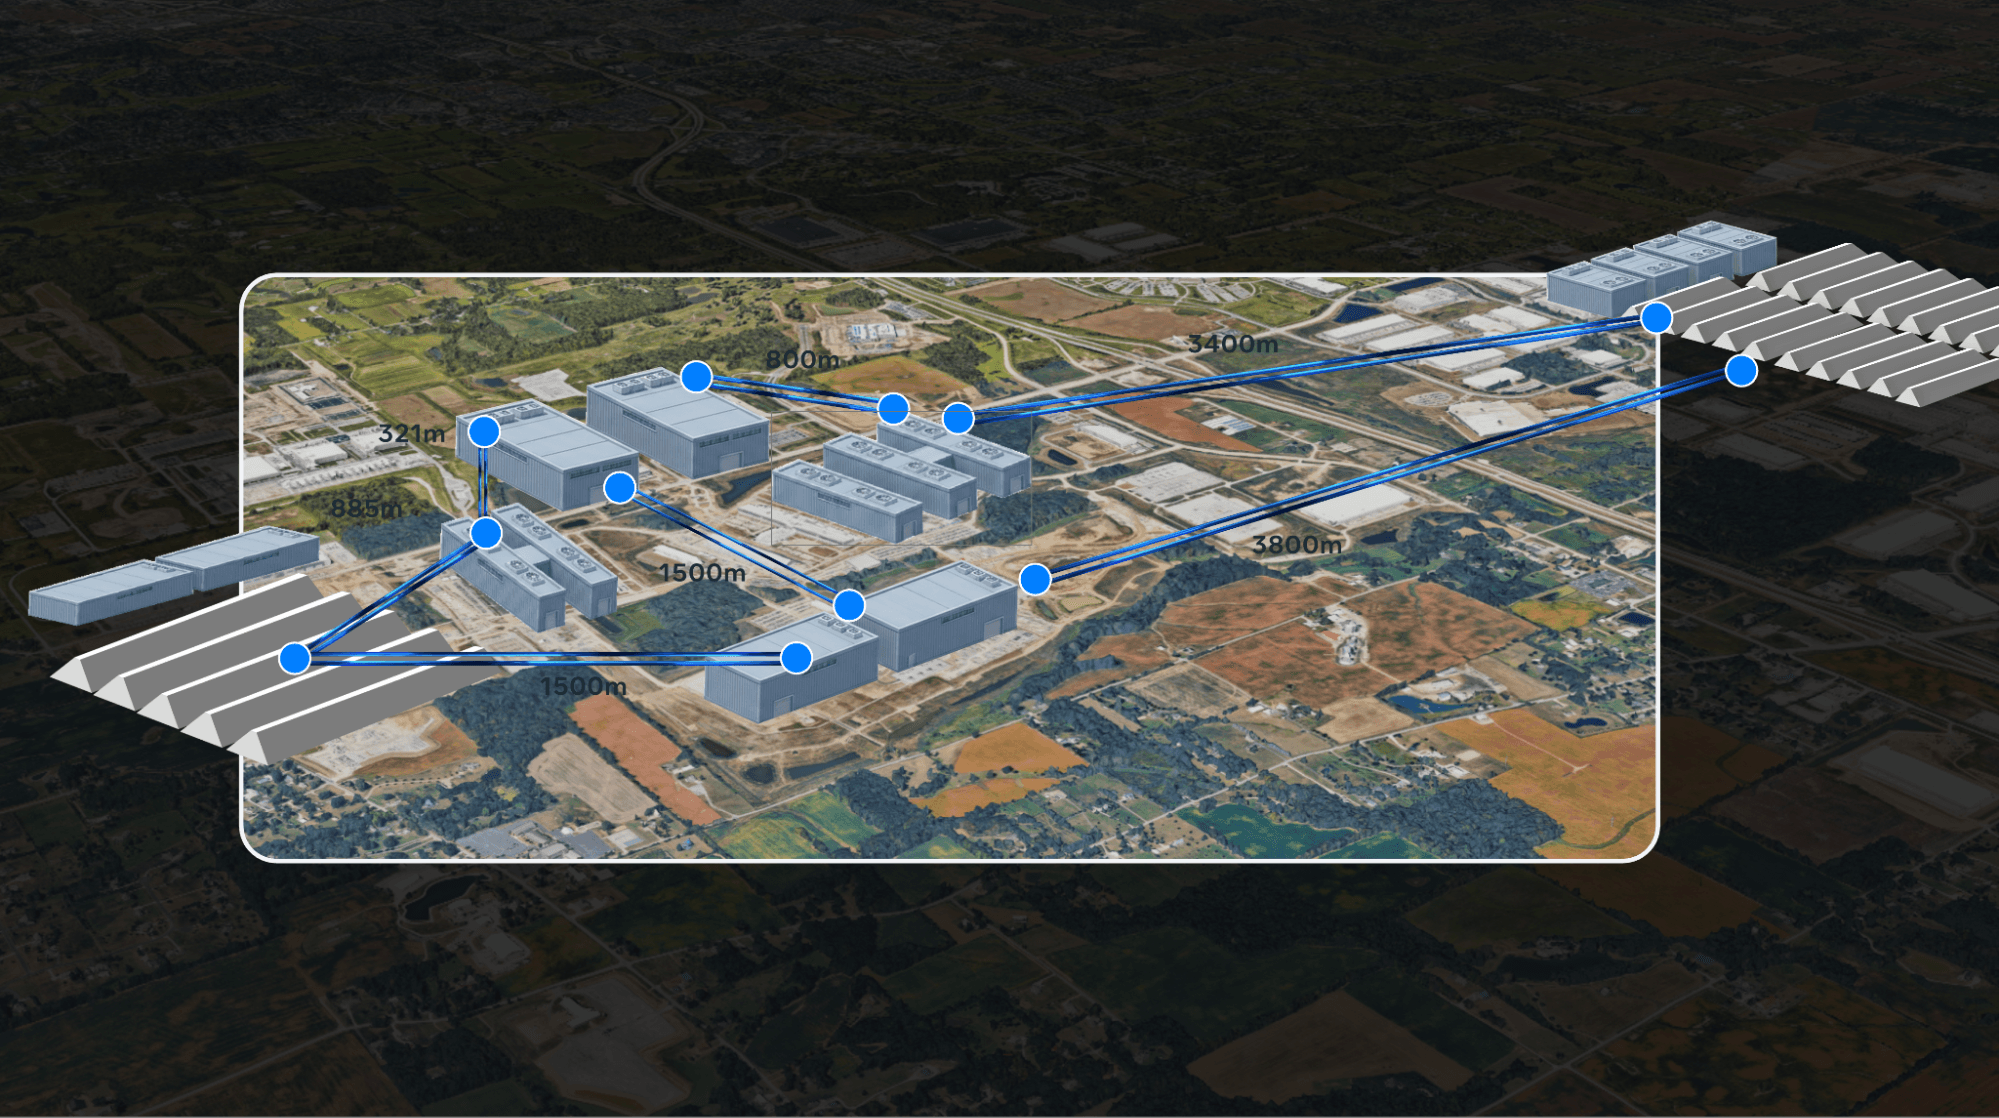
Sobre los edificios se ubica la red de agregación de backend, un diseño multicapa de tipo hub-and-spoke construido sobre chasis Arista serie 7800 con silicio Broadcom Jericho3 de búfer profundo. Se extiende desde 2 km hasta más de 100 km y ofrece múltiples petabits por segundo entre pares de regiones. Meta afirma que ejecutar el preentrenamiento en esas distancias requirió un esfuerzo de optimización dedicado con Meta Superintelligence Labs debido a la latencia ultrarrápida. La infraestructura subyacente incluye millones de kilómetros de fibra óptica, decenas de miles de conmutadores y millones de componentes ópticos, desde conectores enchufables 2x400G FR4 LITE dentro de los edificios hasta óptica coherente 800G-ZR para enlaces de más de 10 km.
64 de cada 72 GPU realizan el trabajo.
El cambio del dominio NVLink de ocho GPU de la generación H100 a NVL72 multiplicó por nueve el radio de impacto de fallos, y Meta ahora planifica la capacidad en torno al rack de 72 GPU. Dado que el paralelismo de entrenamiento se adapta mejor a tamaños de grupo que son potencias de dos, cada dominio NVL72 ejecuta una partición de 64 GPU y mantiene las otras ocho como repuestos en el rack. Si una GPU falla, una de repuesto toma el relevo y el trabajo se reinicia desde su último punto de control sin esperar a que se repare. Para fallos de todo el rack, Meta mantiene aproximadamente un 2 % de racks adicionales en reserva.
Para una prueba de entrenamiento con 32 768 GPU: 523 racks NVL72, o 37 656 GPU, aproximadamente un 13 % por encima de la huella activa, de los cuales 11 puntos provienen de la geometría de 64 de 72 segmentos. La carga de integridad de la señal que respalda esa fiabilidad es considerable; un solo dominio NVL72 transporta 5,184 enlaces de pares diferenciales optimizados a 200 Gbps, cada uno de los cuales atraviesa SerDes de GPU, PCB de bandejas de cómputo, cartuchos de cables e interfaces de bandejas de conmutación.
Dos rutas de recuperación gestionan los fallos que se producen. Cuando un fallo se puede aislar en una réplica de datos en paralelo, la tolerancia a fallos con reconocimiento de paralelismo de Meta desconecta esa réplica mientras el resto del clúster repite el paso y continúa el entrenamiento, y la sección se reinicia en hosts de reserva y se resincroniza. Los fallos mayores hacen que todo el trabajo vuelva a su último punto de control, por lo que Meta realiza puntos de control con frecuencia, guardando el estado del modelo, incluidos los gradientes y los datos del optimizador, de forma asíncrona en un almacenamiento de múltiples niveles con puntos de control delta y almacenamiento en memoria para limitar el impacto en el rendimiento.
Una caída del 99 por ciento en las interrupciones.
A pesar de los avances que muestran estas cifras, Prometheus no comenzó siendo estable. A mediados de 2025, durante la fase inicial, las tasas de interrupción alcanzaron un máximo de casi 1,000 eventos por cada 8,000 GPU al día. Un año de trabajo interdisciplinario ha reducido esta cifra en un 99 %, y el clúster ahora soporta múltiples tareas de entrenamiento de decenas de miles de GPU cada una en paralelo. Meta atribuye este éxito a un modelo de coingeniería con NVIDIA, en el que los equipos de NVIDIA se ubican en el sitio de New Albany, comparten telemetría y realizan sesiones conjuntas de análisis de incidencias para desglosar cada interrupción según su causa raíz. Meta se encarga de la programación y las correcciones de infraestructura, mientras que NVIDIA cubre el firmware, el diagnóstico de señales y la gestión de la memoria.
La integridad de la señal NVLink fue el primer cuello de botella en GB200. Con más de 600 000 conexiones NVLink en el clúster, los enlaces débiles activaban ciclos de recuperación frecuentes, por lo que Meta añadió telemetría continua, marcado automático y pruebas de diagnóstico L11 para detectar enlaces débiles antes de la producción. Los fallos de memoria en HBM y LPDDR se convirtieron en la causa principal cuando GB300 llegó con mayor memoria, y la respuesta en ese caso es una configuración de firmware HBM refinada, limpieza de memoria, un algoritmo de corrección de errores LPDDR mejorado y la retirada predictiva de dispositivos degradados. El estado del conmutador se monitoriza con una resolución de milisegundos, y los eventos de enlace en la capa de agregación se redirigen por hardware sin interrumpir el tráfico de la GPU.
Operar cientos de miles de aceleradores de primera generación convirtió la maduración del hardware en una disciplina propia. La automatización del firmware de Meta puede implementar correcciones de controladores y firmware en más de 100 000 GPU en pocas horas, y el tiempo de actualización de un solo pod P90 se ha reducido de más de siete horas al inicio de la introducción de GB200 a dos horas. Las pruebas de estrés de suministro de energía analizan cómo se comportan los módulos de la fuente de alimentación y los reguladores de voltaje bajo la carga de 1,400 W de una sola GPU, y cada sistema reparado permanece en cuarentena hasta que supera la validación. El sprint de estabilidad de Meta en marzo sincronizó las correcciones en toda la pila.
Transitorios de potencia y una flota de refrigeración mixta
El entrenamiento síncrono distribuye la energía al unísono, y decenas de miles de GPU que entran en una fase de cálculo o de comunicación simultáneamente modifican la carga del clúster entre un 30 y un 40 por ciento. Iniciar o pausar una tarea grande puede desplazar decenas de megavatios en segundos. Dynamo Dimmer, el marco de gestión de energía para todo el clúster de Meta, limita gradualmente la potencia de las GPU a medida que el clúster se acerca a su límite eléctrico para que las tareas sigan ejecutándose. Los módulos de respaldo de batería a nivel de rack absorben los picos, las bandejas de condensadores suavizan los picos, el almacenamiento de energía de baterías a escala de instalación se encuentra detrás de ellos, y Meta se coordina con las compañías eléctricas en función del perfil de carga.
La refrigeración varía según el edificio, ya que Prometheus se ensambló rápidamente en centros de datos al aire libre, estructuras de despliegue rápido, capacidad alquilada y un edificio de IA construido específicamente para ello. Los espacios más antiguos utilizan refrigeración líquida modular asistida por aire; el edificio optimizado para IA utiliza refrigeración líquida de las instalaciones en un circuito cerrado, que Meta describe como la forma más eficiente de refrigerar servidores GPU y la que consume más agua. Meta ha compartido diseños como IcePack, su rack de red refrigerado por líquido, a través de OCP. Para ver en qué consiste un despliegue mucho más pequeño de refrigeración líquida GB300 NVL72, consulte el banco de pruebas GAIFA de Giga Computing.
Hyperion viene después
Meta continuará expandiendo Prometheus con una combinación de racks GB300 NVL72 y Vera Rubin NVL72, con Vera Rubin llegando a través de la plataforma San Miguel en la estructura de red existente. Las lecciones aprendidas en New Albany están sirviendo de base para Hyperion, el superclúster que Meta está diseñando desde cero en Richland Parish, Luisiana, con refrigeración líquida de circuito cerrado, conectividad total a la red eléctrica a través de Entergy y diseños de red de última generación. Meta afirma que paga el costo total de la energía en ambos sitios y compensa su consumo con nueva generación limpia y renovable.
La mayor parte de la información publicada por Meta se centra en detalles operativos que los proveedores de servicios en la nube suelen mantener en secreto: la configuración de las GPU de reserva, las tasas de interrupción, los tiempos de implementación del firmware y los motivos de la elección de la configuración de Ariel. En resumen, a esta escala, el hardware es solo el punto de partida, y el trabajo que transforma cientos de miles de GPU en capacidad de entrenamiento útil reside en la red, la tolerancia a fallos y la telemetría. Para las empresas que buscan implementar IA a gran escala, este análisis exhaustivo de Meta es un buen punto de partida para comprender, al menos, dónde pueden surgir problemas, de modo que las organizaciones puedan planificar con antelación en toda su infraestructura de centros de datos.



 Amazon