

Meta describió el rápido desarrollo de su programa Meta Training and Inference Accelerator (MTIA). Presentó cuatro generaciones de chips creadas en aproximadamente dos años. Estos chips resuelven un problema clave de infraestructura que Meta considera esencial para la IA a nivel mundial: la rápida adaptación a arquitecturas de modelos en constante evolución a bajo costo, sin depender de largos ciclos de desarrollo de silicio. MTIA forma parte de una estrategia de silicio más amplia, y Meta reafirmó su colaboración con Broadcom para el desarrollo de estos chips.
Según Meta, ya ha desplegado cientos de miles de dispositivos MTIA en producción y ha integrado varios modelos internos. El trabajo de validación incluye pruebas de grandes modelos de lenguaje como Llama. La compañía publicó previamente detalles técnicos sobre las dos primeras generaciones de MTIA, MTIA 100 y MTIA 200, en artículos de investigación de ISCA. Ahora está ampliando la plataforma con MTIA 300, 400, 450 y 500. Estos nuevos componentes extienden la cobertura desde la inferencia de clasificación y recomendación (R&R) hasta el entrenamiento de R&R y, cada vez más, a cargas de trabajo generales de GenAI, especialmente inferencia, con despliegues en curso o planificados para 2026 y 2027.
La iteración como principio de diseño
Un tema clave es la cadencia. Meta argumenta que la evolución del modelo es más rápida que el desarrollo tradicional de chips, que puede tardar dos años desde el diseño hasta la producción. Meta fabrica los chips MTIA sobre la arquitectura de código abierto RISC-V, con Taiwan Semiconductor Manufacturing Corporation (TSMC) a cargo de la fabricación. La respuesta es un enfoque de diseño iterativo y modular. Cada generación se basa en chiplets reutilizables y se optimiza utilizando los últimos conocimientos sobre operadores y servicios. La compañía también enfatizó la importancia de la reutilización más allá del propio chip. Los MTIA 400, 450 y 500 comparten el mismo chasis, rack e infraestructura de red. Esto permite actualizaciones rápidas, reduciendo el tiempo desde la disponibilidad del silicio hasta su implementación en el centro de datos.
MTIA 300: Redes y colectivos integrados en el silicio
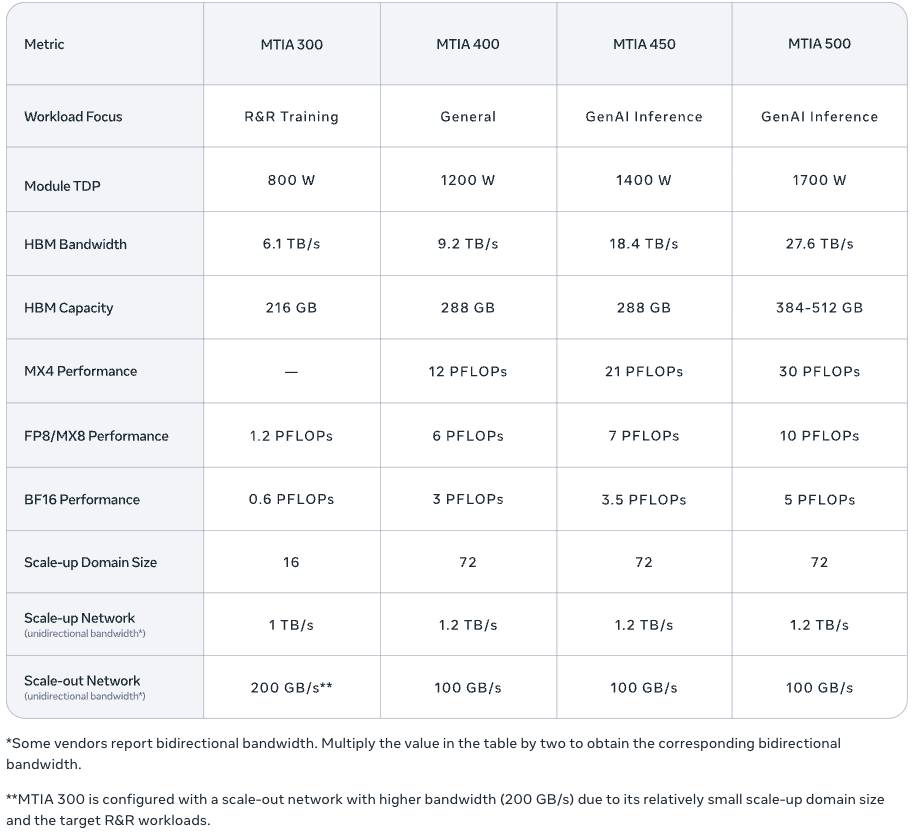
MTIA 300 constituye la base de la nueva hoja de ruta. Inicialmente, se optimizó para el entrenamiento R&R, la principal carga de trabajo de Meta antes del auge de GenAI. La arquitectura incluye chiplets de red integrados, motores de mensajería dedicados para una comunicación colectiva eficiente y computación cercana a la memoria para reducir la carga en las operaciones colectivas. Si bien se centra en R&R, estos componentes de comunicación también respaldan la eficiencia del entrenamiento y la inferencia de GenAI en versiones posteriores.
A nivel de bloque, Meta describió MTIA 300 como un diseño multichiplet que incluye un chiplet de cómputo, dos chiplets de red y múltiples pilas HBM. El bloque de cómputo está organizado como una cuadrícula de elementos de procesamiento (PE), con PE adicionales para mejorar el rendimiento. Cada PE incluye dos núcleos vectoriales RISC-V, un motor de producto escalar para operaciones matriciales, una unidad de función especializada para activaciones y operaciones elemento a elemento, un motor de reducción para la acumulación y la comunicación entre PE, y un motor DMA para la transferencia local de datos.
MTIA 400: Un giro hacia la IA general con afirmaciones de rendimiento competitivo
MTIA 400 actualiza MTIA 300 para ofrecer un mejor soporte a GenAI, manteniendo las capacidades de recuperación y replicación (R&R). Meta describe MTIA 400 como una actualización importante, con un rendimiento de FLOPS FP8 un 400 % superior y un ancho de banda HBM un 51 % mayor que MTIA 300. Desde el punto de vista arquitectónico, MTIA 400 combina dos chiplets de cómputo para aumentar la densidad de procesamiento y añade soporte para los formatos de baja precisión MX8 y MX4 mejorados, que Meta considera esenciales para una inferencia GenAI eficiente.

El diseño del sistema sigue siendo un aspecto clave. Meta describió una implementación a escala de rack en la que 72 dispositivos MTIA 400 se conectan mediante un backplane conmutado, formando un único dominio escalable. Para implementaciones flexibles, Meta mencionó los racks de refrigeración líquida asistida por aire (AALC) para acelerar la configuración en centros de datos existentes. También señaló que la plataforma admite soluciones de refrigeración líquida.
MTIA 450: La optimización de la inferencia GenAI comienza con el ancho de banda de la memoria.
MTIA 450 es una versión mejorada de MTIA 400, centrada en la inferencia e impulsada por la creciente demanda de inferencia GenAI. Meta identificó el ancho de banda de HBM como el principal factor que limitaba el rendimiento de la inferencia y lo duplicó de MTIA 400 a MTIA 450. La compañía también informó de un aumento del 75 % en los FLOPS de MX4 para mejorar los cálculos de mezcla de expertos, junto con la aceleración por hardware para reducir los cuellos de botella comunes en las operaciones de atención y realimentación, en particular en el comportamiento de Softmax y FlashAttention.
Meta destacó su trabajo en tipos de datos como un factor importante. MTIA 450 va más allá de FP8 y MX8, logrando un rendimiento MX4 seis veces superior al de FP16/BF16. El chip admite cálculos mixtos de baja precisión sin necesidad de conversiones de software. Incorpora innovaciones personalizadas para tipos de datos diseñadas para preservar la calidad del modelo y aumentar las operaciones de punto flotante (FLOPS) con un impacto mínimo en el área. El despliegue masivo de MTIA 450 está previsto para principios de 2027.
MTIA 500: Mayor ancho de banda, mayor capacidad, mayor descomposición de chiplets.
MTIA 500 continúa centrándose en la inferencia con mejoras adicionales en memoria y procesamiento. Meta afirmó que MTIA 500 aumenta el ancho de banda de HBM en un 50 % con respecto a MTIA 450, incrementa la capacidad de HBM hasta en un 80 % y aumenta los FLOPS de MX4 en un 43 %. El diseño del chiplet avanza con una configuración 2x2 de chiplets de procesamiento más pequeños, rodeados por múltiples pilas HBM y dos chiplets de red. También incluye un chiplet de sistema en chip (SoC) para la conectividad PCIe con la CPU host y NIC escalables. Meta mencionó aceleración de hardware adicional y cambios en los tipos de datos para abordar los cuellos de botella de la inferencia.
El despliegue masivo de MTIA 500 está programado para 2027.
Fácil adopción
Meta está alineando MTIA con el objetivo de facilitar su adopción, haciendo hincapié en herramientas estándar de la industria en lugar de un marco especializado. La compañía describió MTIA como nativa de PyTorch, que funciona a la perfección con los procesos de compilación de PyTorch 2.x y admite tanto la ejecución inmediata como la de grafos. En el modo de grafos, los desarrolladores pueden usar torch.compile y torch.export para optimizar los grafos sin necesidad de reescribir los modelos específicos de MTIA, lo que permite la implementación paralela en GPU y MTIA.
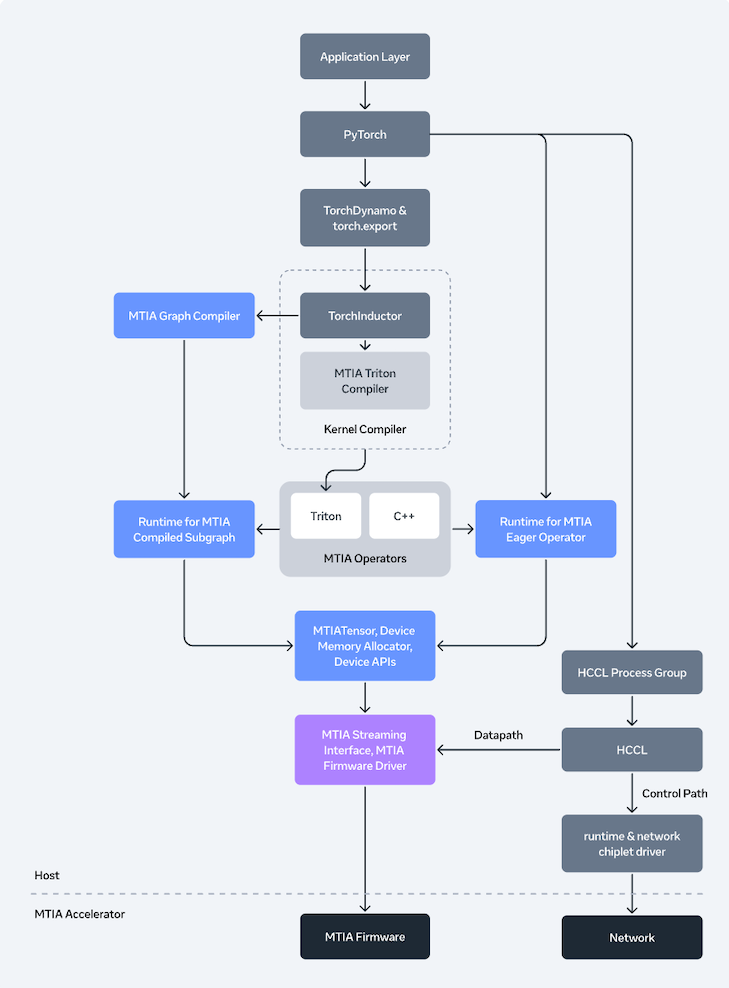
Entre bastidores, Meta detalló una pila de compilación MTIA basada en Torch FX IR y TorchInductor. Las capas inferiores utilizan Triton, MLIR y LLVM, junto con optimizaciones específicas de MTIA, incluyendo mejoras en la fusión de kernels y extensiones para partes críticas para el rendimiento. La optimización automática es una característica clave para seleccionar entre diferentes estrategias de compilación.
Para la ejecución distribuida, Meta presentó su biblioteca de comunicaciones colectivas Hoot (HCCL). Esta biblioteca es similar a las pilas colectivas de GPU, pero está optimizada para los chiplets de red y los motores de mensajes integrados de MTIA. Utiliza computación cercana a la memoria para acelerar las operaciones de reducción. Meta también admite la fusión de computación colectiva para reducir la latencia y cuenta con una pila de transporte diseñada para gestionar la ruta de datos y reducir la sobrecarga del host.
En tiempo de ejecución, Meta demostró un entorno de ejecución de dispositivos que gestiona la memoria, la planificación y la coordinación en los modos eager y gráfico. También introdujo un controlador de espacio de usuario basado en Rust, alejándose del controlador tradicional de Linux integrado en el kernel. El firmware está escrito en Rust para hardware físico, priorizando la baja latencia y la seguridad.
Para el servicio GenAI, Meta describió su integración vLLM mediante un sistema de complementos. Este reemplaza operadores clave como FlashAttention y LayerNorm fusionado con kernels específicos de MTIA. También habilita el modo gráfico a través de un backend torch.compile personalizado. Además, Meta mencionó herramientas para gestionar grandes implementaciones de MTIA, incluyendo monitorización, creación de perfiles, depuración y observabilidad en distintos hosts y dispositivos.
Que Viene Próximamente?
La hoja de ruta actualizada de Meta para MTIA hace hincapié en la economía de la inferencia GenAI, destacando el ancho de banda de HBM y los formatos de baja precisión como factores clave. Si Meta cumple con sus plazos de implementación, MTIA 450 y 500 servirán como las primeras pruebas a gran escala para determinar si una estrategia de acelerador centrada en la inferencia, basada en iteraciones rápidas de chiplets y software estandarizado, puede mantener ventajas sobre las plataformas GPU convencionales para la prestación de servicios GenAI.


 Amazon