

NVIDIA ha anunciado dos importantes iniciativas orientadas a la computación de alto rendimiento y la IA: la adquisición de SchedMD, la empresa creadora del gestor de cargas de trabajo Slurm, y el lanzamiento de la familia Nemotron 3 de modelos, datos y herramientas abiertos para IA multiagente. En conjunto, estas iniciativas refuerzan la posición de NVIDIA en HPC, IA generativa e infraestructura de IA empresarial, a la vez que mantienen un fuerte énfasis en el software abierto e independiente del proveedor.
Slurm y SchedMD: Fortalecimiento de la programación HPC abierta e independiente del proveedor
SchedMD es el desarrollador principal de Slurm, uno de los gestores de cargas de trabajo de código abierto más utilizados para clústeres de HPC e IA. Slurm se utiliza para poner en cola, programar y asignar recursos informáticos en clústeres a gran escala que ejecutan cargas de trabajo paralelas estrechamente acopladas. A medida que aumenta el tamaño de los clústeres y la complejidad de los modelos, una programación eficiente se vuelve crucial para mantener la utilización y el rendimiento.
La presencia de Slurm en HPC es considerable. Se utiliza en más de la mitad de los 10 y 100 sistemas principales de la lista TOP500, gracias a su escalabilidad, alto rendimiento y compatibilidad con la gestión de políticas complejas. Para las cargas de trabajo de IA, Slurm se ha convertido en un componente clave de la infraestructura que utilizan los desarrolladores de modelos básicos y los desarrolladores de IA para orquestar el entrenamiento y la inferencia de modelos a gran escala en sistemas acelerados por GPU.
Tras la adquisición, NVIDIA planea continuar desarrollando y distribuyendo Slurm como software de código abierto e independiente del proveedor. La compañía afirma que Slurm seguirá siendo accesible para la comunidad de HPC e IA en general y seguirá ofreciendo soporte para entornos heterogéneos en una amplia gama de plataformas de hardware y software. NVIDIA ha colaborado con SchedMD durante más de una década, y esta adquisición formal pretende acelerar esa hoja de ruta, en lugar de representar un cambio estratégico.
La dirección de SchedMD considera este acuerdo como una validación del papel central de Slurm en HPC e IA. La compañía señaló que la experiencia de NVIDIA en computación acelerada debería impulsar a Slurm para satisfacer las futuras necesidades de IA y supercomputación, preservando al mismo tiempo su modelo de código abierto y la participación de la comunidad.
Impacto en el cliente y soporte de la plataforma
Para los clientes actuales de SchedMD, NVIDIA pretende mantener la continuidad del soporte, la formación y el desarrollo de Slurm. Las implementaciones actuales de Slurm abarcan proveedores de nube, fabricantes, empresas de IA y organizaciones de investigación de sectores como la conducción autónoma, la salud y las ciencias de la vida, la energía, los servicios financieros, la administración pública y la fabricación en general.
NVIDIA también espera acelerar el acceso de SchedMD a nuevos sistemas y arquitecturas. Para los clientes que estandarizan la plataforma de computación acelerada de NVIDIA, esto debería traducirse en una compatibilidad más rápida con las nuevas generaciones de GPU y configuraciones de sistema. Al mismo tiempo, NVIDIA reitera que Slurm seguirá ofreciendo compatibilidad con una amplia gama de entornos heterogéneos, lo que permitirá que los clústeres de varios proveedores adopten las nuevas capacidades de Slurm sin depender de una única pila de hardware.
El esfuerzo combinado entre NVIDIA y SchedMD se enmarca como parte de una iniciativa más amplia para fortalecer el ecosistema de software de código abierto en HPC e IA, lo que permite la innovación en todas las industrias y escalas de implementación.
Nemotron 3: Modelos MoE abiertos para IA multiagente y agéntica
Al mismo tiempo, NVIDIA ha presentado la familia Nemotron 3 , un ecosistema abierto de modelos, conjuntos de datos y bibliotecas para la creación de sistemas de IA con agentes, transparentes y eficientes. A medida que las organizaciones transitan de chatbots de un solo modelo a arquitecturas multiagente más complejas, se enfrentan a desafíos como la sobrecarga de comunicación entre agentes, la pérdida de contexto en flujos de trabajo extensos y el aumento de los costos de inferencia. Además, existe una creciente demanda de transparencia para facilitar la comprensión y la confianza en los sistemas de IA integrados en procesos empresariales críticos.
Nemotron 3 aborda estos requisitos con una arquitectura híbrida de mezcla latente de expertos (MoE), diseñada para cargas de trabajo multiagente a escala. Los modelos están diseñados para respaldar el comportamiento colaborativo de los agentes, las habilidades especializadas y el enrutamiento eficiente de tareas, manteniendo al mismo tiempo perfiles de rendimiento y costes predecibles.
Jensen Huang, fundador y director ejecutivo de NVIDIA, enfatizó que la innovación abierta es esencial para el avance de la IA. Destacó que Nemotron transforma la IA de vanguardia en una plataforma accesible, mejorando la transparencia y la eficiencia para respaldar el desarrollo de sistemas de agentes a gran escala.
Iniciativas nacionales y regionales de IA en Europa, Corea del Sur y otras regiones ya consideran Nemotron como base para el desarrollo de IA abierto y controlado localmente. Empresas pioneras, como Accenture, Cadence, CrowdStrike, Cursor, Deloitte, Palantir, Perplexity y otras, están incorporando modelos de Nemotron en flujos de trabajo que abarcan la fabricación, la ciberseguridad, la ingeniería de software, los medios de comunicación y las comunicaciones.
Gama de modelos: Nano, Super y Ultra
Nemotron 3 consta de tres niveles principales de modelo MoE, cada uno orientado a diferentes clases de cargas de trabajo:
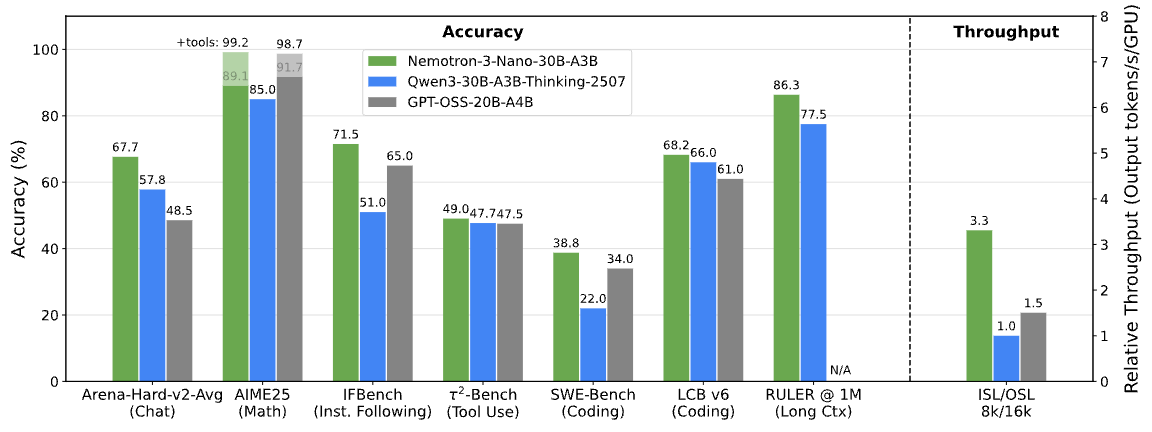
- Nano es un modelo pequeño, de aproximadamente 30 mil millones de parámetros, que activa hasta 3 mil millones de parámetros por token por la inferencia eficiente. Es adecuado Para tareas like depuración, resumen, IA tuberías, y recuperación de información, donde la baja latencia y costo son crucial Su El diseño híbrido de MoE ofrece hasta 4 veces el rendimiento de tokens de Nemotron 2 Nano y reduce los costos de razonamiento hasta en un 60 por ciento, lo que disminuye los costos generales de inferencia.Con una ventana de contexto de 1 millón de tokens, Nemotron 3 Nano manteners más estado en todo long flujos de trabajo, mejorando la precisión y conectando contextos distantes. Los índices de referencia independientes lo clasifican entre los modelos más abiertos y eficientes en su clase, en el que top precisión entre paress.
- Super es un modelo de razonamiento de alta precisión con aproximadamente 100 mil millones de parámetros y hasta 10 mil millones de parámetros activos por token. Está diseñado para aplicaciones multiagente donde muchos agentes colaboran para lograr objetivos complejos con requisitos de baja latencia. Super es ideal para escenarios donde la profundidad de razonamiento, el uso de herramientas y la coordinación entre agentes deben escalarse sin incurrir en el perfil de costos de los modelos más grandes.
- Ultra es el modelo de gama alta y funciona como un gran motor de razonamiento, con aproximadamente 500 mil millones de parámetros y hasta 50 mil millones de parámetros activos por token. Está diseñado para los flujos de trabajo de IA más exigentes, como la investigación profunda, la planificación estratégica y los sistemas complejos de apoyo a la toma de decisiones que requieren un razonamiento de alta calidad en contextos muy extensos.
Nemotron 3 Super y Ultra se entrenan con el formato NVFP4 de 4 bits de NVIDIA en la arquitectura Blackwell. Este formato de entrenamiento reduce significativamente el consumo de memoria y mejora el rendimiento, manteniendo una precisión comparable a la de formatos de mayor precisión. Para empresas y proveedores de servicios, esto permite entrenar modelos más grandes en la infraestructura existente o reducir el consumo de hardware necesario para una escala determinada.
Con esta familia escalonada, los desarrolladores pueden adaptar el tamaño y las capacidades del modelo a cargas de trabajo específicas y objetivos de costos, escalando de docenas a cientos de agentes y manteniendo un razonamiento a largo plazo más rápido y preciso en flujos de trabajo complejos de varios pasos.
Enrutamiento, economía de tokens y estrategias de modelos híbridos
A medida que los sistemas multiagente maduran, muchas organizaciones adoptan estrategias de modelos híbridos. Los modelos propietarios de Frontier se utilizan para las tareas de razonamiento más complejas, mientras que los modelos abiertos, eficientes y personalizables gestionan cargas de trabajo rutinarias o especializadas en cada dominio. Nemotron 3 está diseñado específicamente para este tipo de arquitectura basada en enrutamiento.
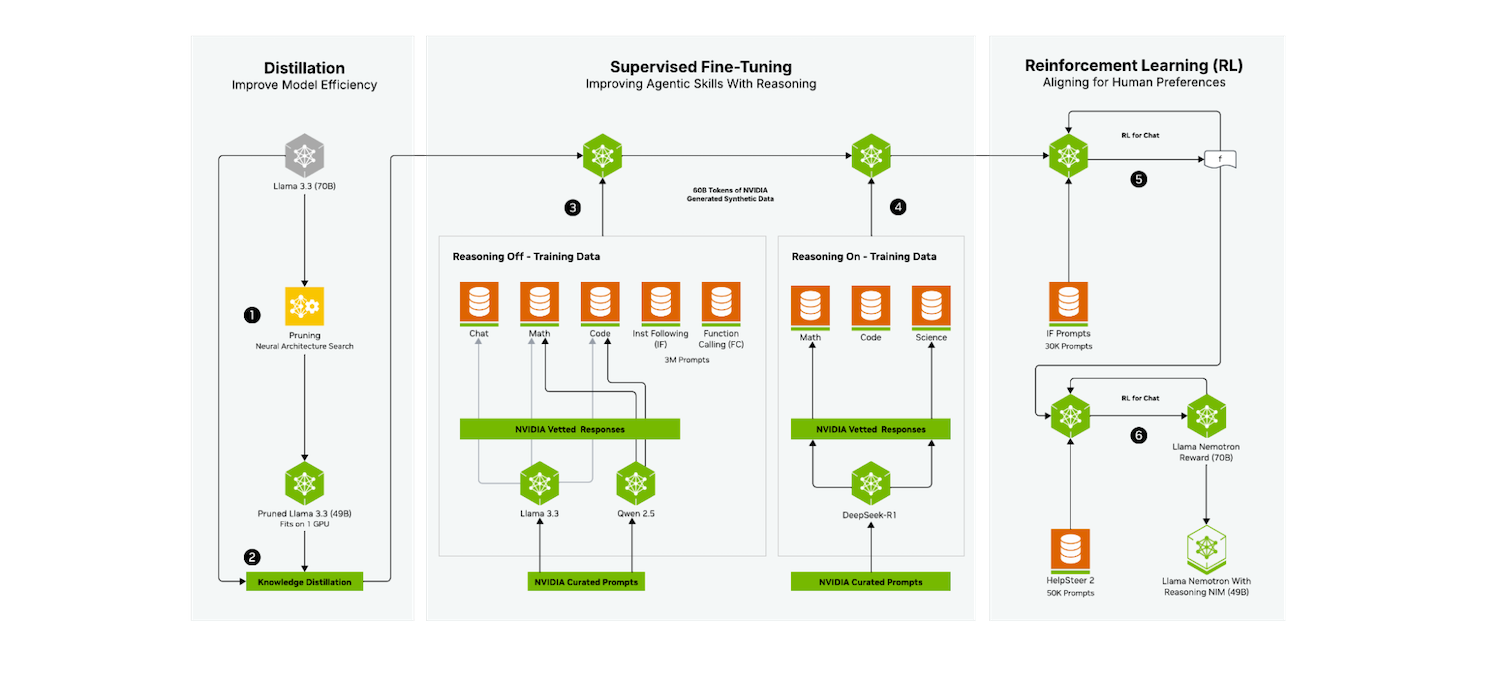
En una configuración típica, un enrutador de agente analiza las tareas en tiempo real. Las envía a un modelo Nemotron optimizado, como Nemotron 3 Ultra, o a un modelo propietario cuando este ofrece un valor único. Este enfoque ayuda a optimizar la economía de tokens al reservar la costosa capacidad de frontera para los casos más exigentes y aprovechar Nemotron para cargas de trabajo de alto rendimiento y alta eficiencia.
Los socios que crean asistentes de IA y plataformas de agentes informan que esta estrategia de enrutamiento les permite ofrecer una mayor capacidad de respuesta y un mejor control de costos, manteniendo al mismo tiempo la flexibilidad para integrar diferentes proveedores de modelos y estrategias de capacitación a lo largo del tiempo.
Datos abiertos, bibliotecas y herramientas de seguridad
Más allá de los modelos en sí, NVIDIA está lanzando un conjunto sustancial de recursos abiertos para respaldar el desarrollo de agentes personalizados:
Conjuntos de datos de entrenamiento y RL
NVIDIA proporciona 3 billones de tokens de conjuntos de datos de Nemotron para el aprendizaje previo, posterior y de refuerzo. Estos conjuntos de datos incluyen una amplia gama de ejemplos que involucran razonamiento, codificación y flujos de trabajo de varios pasos que pueden usarse para entrenar o perfeccionar agentes específicos del dominio. El conjunto de datos de seguridad agenética de Nemotron ofrece datos de telemetría reales que los equipos pueden usar para evaluar y mejorar la seguridad de sistemas autónomos complejos.
NeMo Gym y NeMo RL
Para simplificar el aprendizaje de refuerzo y el postentrenamiento, NVIDIA ha lanzado NeMo Gym y NeMo RL como bibliotecas de código abierto. Estas proporcionan entornos de entrenamiento y bases de postentrenamiento compatibles con los modelos de Nemotron, que también pueden ampliarse o adaptarse a otras arquitecturas. NeMo Evaluator se incluye para evaluar la seguridad y el rendimiento del modelo en una variedad de pruebas de rendimiento y casos de uso.
Todas estas herramientas y conjuntos de datos están disponibles en GitHub y Hugging Face, lo que permite a los equipos integrarlos en los flujos de trabajo de entrenamiento y pipelines de MLOps existentes. Participantes del ecosistema como Prime Intellect y Unsloth ya están integrando entornos de entrenamiento de NeMo Gym en sus plataformas para simplificar el aprendizaje por refuerzo para usuarios empresariales.
Los modelos de Nemotron 3 también son compatibles con los marcos de inferencia e implementación más populares, incluidos LM Studio, llama.cpp, SGLang y vLLM, lo que facilita la realización de experimentos locales y la implementación en diversos entornos.
Disponibilidad
Nemotron 3 Nano está disponible hoy a través de múltiples canales de distribución que se describen a continuación.
Plataformas de modelos y proveedores de inferencia: El modelo Nemotron 3 Nano está disponible en Hugging Face y a través de proveedores de inferencia como Baseten, DeepInfra, Fireworks, FriendliAI, OpenRouter y Together AI. Estos servicios ofrecen a los equipos una vía rápida para evaluar el modelo e integrarlo en aplicaciones existentes.
Plataformas empresariales: Los modelos de Nemotron se están integrando en plataformas de IA y datos empresariales, como Couchbase, DataRobot, H2O.ai, JFrog, Lambda y UiPath. Esto permite a los clientes incorporar las capacidades de Nemotron directamente en sus sistemas de datos, orquestación y automatización.
Nube pública y microservicios NIM: Para los usuarios de la nube pública, Nemotron 3 Nano estará disponible en AWS a través de Amazon Bedrock para inferencia sin servidor, y también estará disponible en Google Cloud, CoreWeave, Crusoe, Microsoft Foundry, Nebius, Nscale y Yotta.
Nemotron 3 Nano también se ofrece como un microservicio NVIDIA NIM para una implementación segura y escalable en la infraestructura acelerada por NVIDIA, lo que brinda a las empresas más control sobre la privacidad, la ubicación de los datos y el rendimiento.
Se espera que Nemotron 3 Super y Ultra estén disponibles en la primera mitad de 2026, lo que dará a las organizaciones tiempo para estandarizar el nivel Nano para los primeros casos de uso de agentes y planificar futuras migraciones a modelos más grandes a medida que crezcan los requisitos.


 Amazon