

NVIDIA anunció el lanzamiento de producción de NVIDIA Groq 3 LPX , un acelerador de inferencia interactiva dedicado, diseñado para complementar la plataforma Vera Rubin NVL72. A medida que las cargas de trabajo de IA empresarial evolucionan desde el preentrenamiento de modelos en bruto hacia el razonamiento en tiempo real y la orquestación de agentes autónomos, los requisitos de infraestructura están cambiando. Los flujos de trabajo basados en agentes requieren una ejecución iterativa de múltiples pasos, donde la latencia durante la generación de tokens puede acumularse en las rutas de razonamiento automatizado, las consultas a herramientas externas y las comunicaciones entre múltiples agentes.
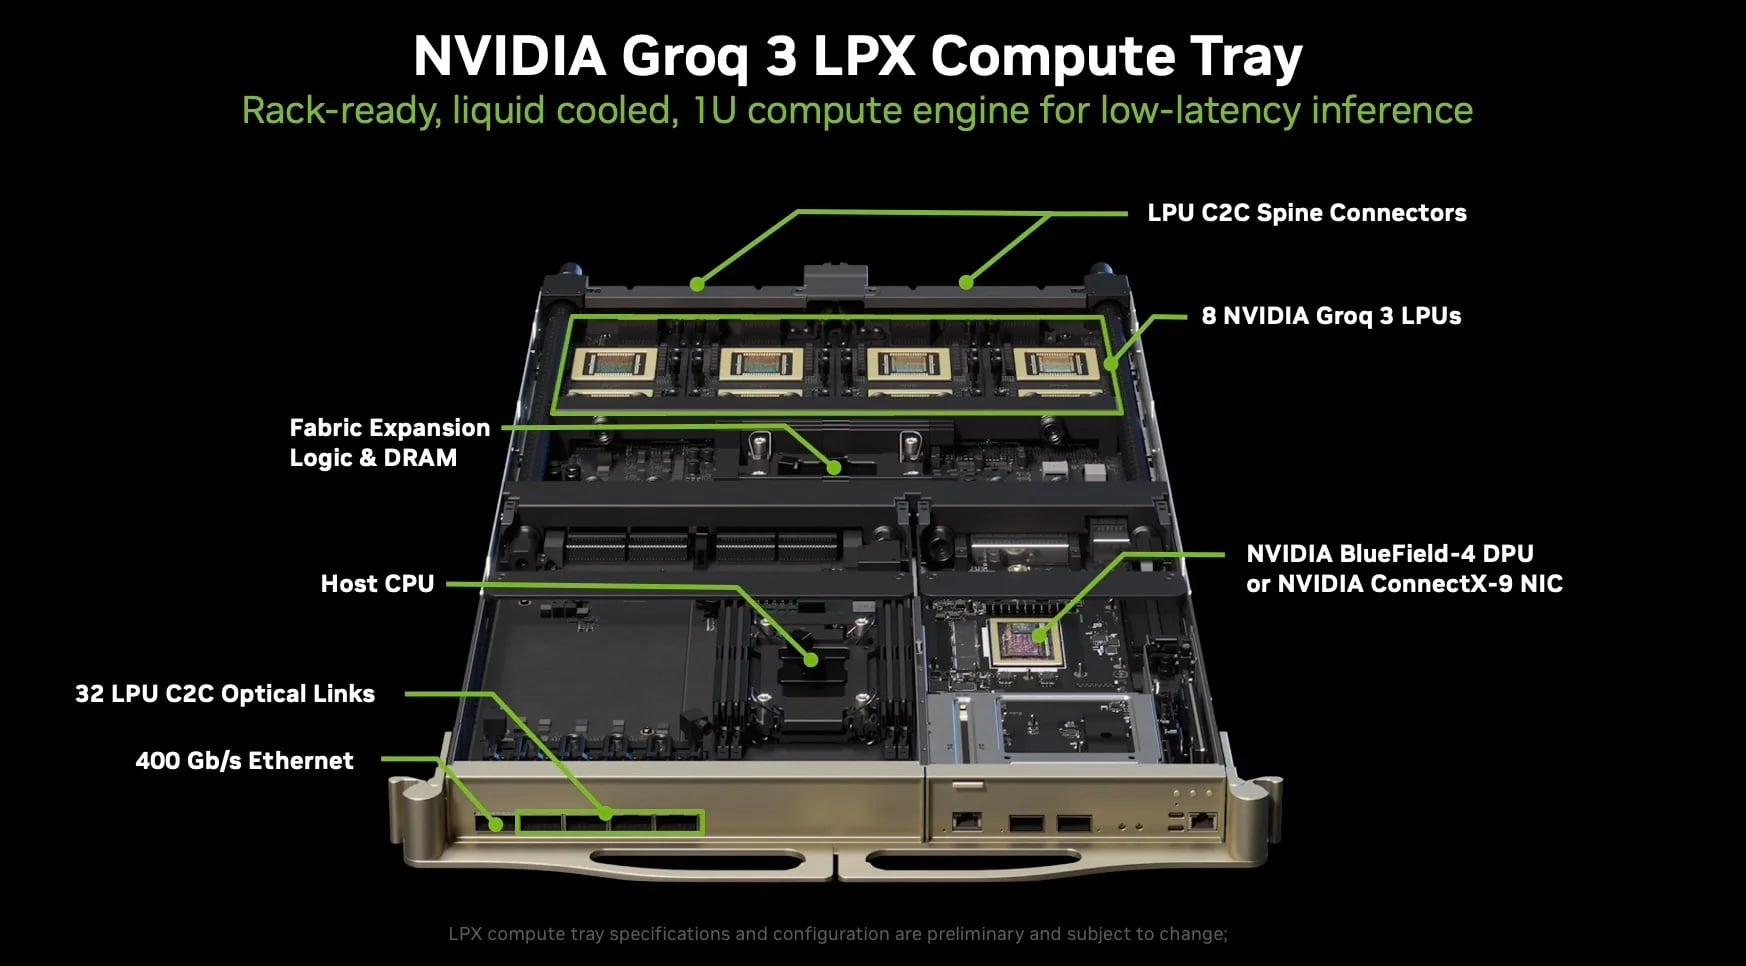
La arquitectura Groq 3 LPX destaca especialmente en esta fase de decodificación. Cada bandeja de computación refrigerada por líquido de 2U alberga dieciséis LPU Groq 3 junto con una CPU principal, lógica de expansión de tejido y DRAM, y una DPU BlueField-4 o una NIC ConnectX-9, con 32 enlaces ópticos de chip a chip LPU y Ethernet de 400 Gb/s en el frontal. En una implementación heterogénea junto con sistemas Vera Rubin NVL72, las GPU NVIDIA Rubin gestionan la ingesta de contexto y los cálculos de prellenado en conjuntos de datos de entrada masivos, mientras que las unidades Groq 3 LPX procesan la generación de salida de tokens sensibles a la latencia.
Arquitectura y rendimiento de referencia
En las evaluaciones de rendimiento estándar de Artificial Analysis, al ejecutar el modelo de código abierto Gemma 4 31B con una ventana de contexto activa de 100 000 tokens, Groq 3 LPX alcanzó una tasa de salida de 3,400 tokens por segundo. NVIDIA señala que este nivel de rendimiento es cuatro veces más rápido que el de la plataforma alternativa más cercana con parámetros de contexto largo idénticos, y Artificial Analysis lo registra como el resultado más rápido medido para el modelo. Es importante leer atentamente la comparación: la cifra de NVIDIA proviene de un punto final privado de pre-lanzamiento medido el 21 de agosto, mientras que las cifras de la competencia corresponden a puntos finales de producción sin servidor en vivo. Mantener una velocidad de generación extrema en ventanas de 100 000 tokens es esencial para las arquitecturas de agentes empresariales que analizan continuamente extensos repositorios de código, esquemas de API complejos y documentación técnica densa.
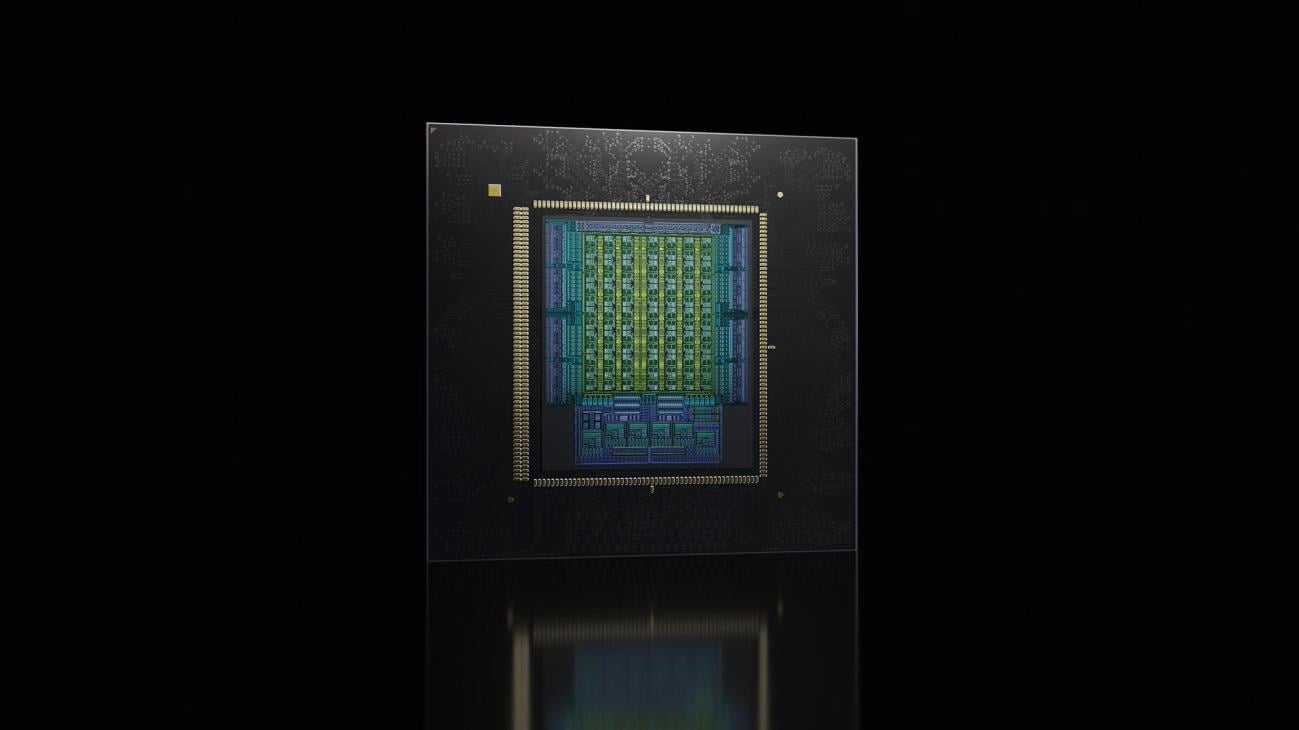

Desde la perspectiva de la arquitectura del sistema físico, una implementación Groq 3 LPX a escala de rack incorpora hasta 256 aceleradores LP30 conectados mediante interconexiones directas de alta velocidad entre chips.
Ecosistema de sistemas e implementaciones en la nube
La adopción comercial inicial ya está en marcha entre los proveedores de servicios en la nube especializados. Nebius ha sido designado como el primer socio de IA en la nube para implementar Groq 3 LPX, con planes de integrar el hardware en su servicio de inferencia de producción Nebius Token Factory. Esta arquitectura está diseñada para permitir a los desarrolladores acceder a la aceleración de inferencia en tiempo real a través de las interfaces API existentes sin migrar sus bases de código a nuevas abstracciones de marco. El proveedor de inferencia Groq espera estar entre los primeros en adoptar la plataforma.


NVIDIA acompaña el lanzamiento con una actualización de los cálculos de la plataforma para el rack en el que se conecta, afirmando que Vera Rubin NVL72 ofrece hasta 30 veces más rendimiento de tokens por megavatio que GB300 NVL72 en una carga de trabajo de codificación de agentes de 140 000 tokens, y que la ventaja se amplía a medida que aumentan los objetivos de interactividad por usuario. La implementación del hardware se integra en la infraestructura completa de la fábrica de IA Rubin de NVIDIA, que abarca siete chips independientes en cinco configuraciones de rack diseñadas específicamente para este fin.
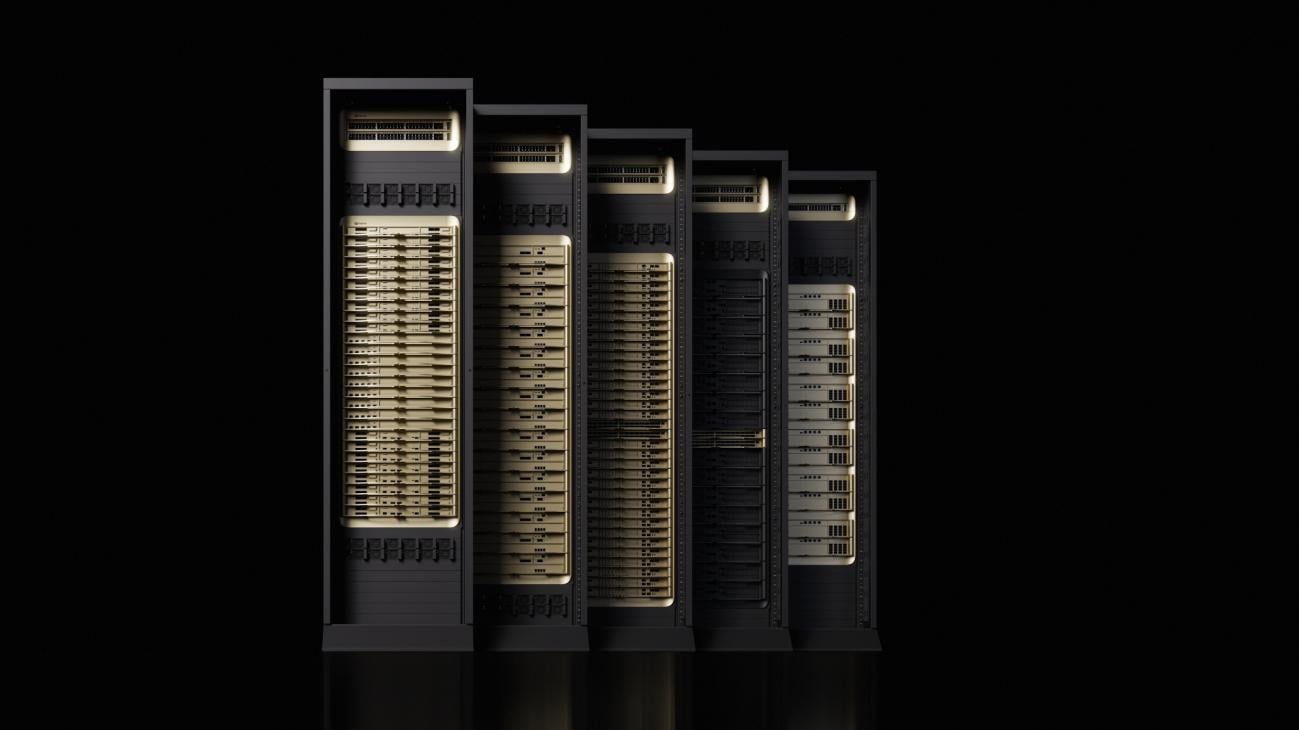
Los elementos del sistema que operan junto con los clústeres de computación Rubin y LPX incluyen bastidores de CPU NVIDIA Vera, matrices de almacenamiento Vera BlueField-4 STX y redes NVIDIA Spectrum-6 SPX.
Lo que dicen NVIDIA y Nebius
«La inferencia es el motor de crecimiento de la IA. NVIDIA Grace Blackwell y NVL72 revolucionaron la inferencia de modelos de lenguaje a gran escala con un salto sin precedentes en rendimiento y eficiencia», afirmó Jensen Huang, fundador y director ejecutivo de NVIDIA. «Vera Rubin amplía esa visión con configuraciones de fábrica de IA optimizadas para cargas de trabajo, diseñadas para la era de la IA agente, impulsando el rendimiento con LPX para la generación ultrarrápida de tokens».
Nebius definió el valor en términos de dónde se produce realmente la latencia para los usuarios. «La generación es la fase de inferencia que determina la capacidad de respuesta de un sistema de IA, y eso es precisamente lo que NVIDIA Groq 3 LPX está diseñado para acelerar», afirmó Danila Shtan, director de tecnología de Nebius. «Como la primera nube de IA que lo implementa en producción a través de Nebius Token Factory, nos aseguramos de que cada paso del ciclo de un agente sea instantáneo, mediante la misma API que los desarrolladores ya utilizan, sin necesidad de migrar a una nueva plataforma».
Infraestructura multiplano y de escalabilidad Spectrum-X
Para dar soporte a las enormes necesidades de red de estos centros de inferencia, NVIDIA presentó su arquitectura Ethernet multiplano Spectrum-X. La expansión tradicional de clústeres más allá de los límites de densidad actuales suele requerir la adición de una tercera capa de conmutación, lo que genera latencia, costes de cableado óptico y un mayor consumo energético. Spectrum-X Multiplane evita este problema dividiendo las interfaces de red del host en múltiples planos independientes, cada uno de los cuales ejecuta una red plana de dos niveles que se adapta a 512 000 GPU.

La gestión del tráfico y la mitigación de fallos se gestionan en silicio mediante la NVIDIA ConnectX-9 SuperNIC, que admite velocidades de red de hasta 1,600 Gb/s por GPU cuando se combina con ASICs Ethernet Spectrum-6 de 102.4 Tb/s. Spectrum-XGS Ethernet extiende el mismo diseño compartido entre instalaciones, lo que, según NVIDIA, acelera los colectivos NCCL multisitio en 1.9 veces. En una topología de ocho planos, la conmutación por error de hardware redirige el tráfico instantáneamente para evitar las rutas fallidas, manteniendo aproximadamente el 90 % del ancho de banda total de la red. NVIDIA afirma que la recuperación por hardware es 11 veces más rápida que el balanceo de carga multiplano basado en software, lo que, según la compañía, se traduce en una producción de fábrica de IA 1.6 veces mayor.

Paralelamente, NVIDIA presentó su pilar de redes Scale-In, que combina las unidades de procesamiento de datos BlueField-4 con la pila de software DOCA . Scale-In se centra en la infraestructura norte-sur, descargando a los procesadores host las tareas de aislamiento multiusuario, cifrado en silicio a velocidad de línea, telemetría y rutas de datos de almacenamiento de alto rendimiento.
NVLink Fusion para la integración personalizada de silicio
NVIDIA también presentó NVLink Fusion para operadores de hiperescala que requieren arquitecturas híbridas. Este marco permite que las XPU y CPU personalizadas de terceros se integren directamente con las redes escalables NVLink y NVLink-C2C de sexta generación de NVIDIA. Al aprovechar los planos de chasis modulares NVIDIA MGX y el software de gestión, los operadores de centros de datos pueden estandarizar los diseños de racks de alimentación, refrigeración y red compartidos, ajustando la proporción específica de GPU, LPU y silicio personalizado según evolucionen las cargas de trabajo.
NVIDIA hizo un segundo anuncio sobre Vera Rubin en Hot Chips: SpaceXAI está adoptando las CPU Vera para las cargas de trabajo de agentes que se ejecutan detrás de Grok, y planea poner en órbita una Vera Rubin NVL72 optimizada a bordo de su satélite Starmind de primera generación.


 Amazon