

En la conferencia GTC 2026 celebrada en San José, el CEO de NVIDIA, Jensen Huang, ofreció una presentación magistral en la que describió la plataforma de infraestructura de IA de próxima generación de la compañía y una serie de anuncios trascendentales que abarcan silicio, sistemas, software y alianzas con el ecosistema. Con más de 30 000 asistentes de más de 190 países, la GTC 2026 sirvió como escenario para la renovación de plataforma más completa de NVIDIA desde la introducción de Blackwell, impulsada por el lanzamiento a producción de la arquitectura Vera Rubin y la integración de la tecnología LPU Groq 3 en el ecosistema de centros de datos de NVIDIA. Como señaló Huang en el escenario, el punto de inflexión de la IA con agentes ha llegado, y Vera Rubin está dando inicio a lo que NVIDIA describe como el mayor desarrollo de infraestructura de la historia.
El tema central de la presentación fue el surgimiento de una cuarta ley de escalado de la IA: el escalado agéntico, en el que los sistemas de IA se comunican no solo con humanos, sino también con otros agentes de IA, lo que impulsa una demanda exponencial de inferencia de baja latencia y gran contexto a una escala sin precedentes. NVIDIA posicionó la plataforma Vera Rubin como la infraestructura fundamental para dar servicio a esta nueva frontera. Esta plataforma combina siete chips codiseñados en cinco nuevos sistemas a escala de rack, diseñados específicamente para la fábrica de IA. La plataforma también recibió el respaldo de laboratorios de IA de vanguardia: Dario Amodei, CEO y cofundador de Anthropic, señaló: «Las empresas y los desarrolladores están utilizando Claude para razonamientos cada vez más complejos, flujos de trabajo agénticos y decisiones de misión crítica. Esto exige una infraestructura capaz de mantenerse al día. La plataforma Vera Rubin de NVIDIA nos proporciona la capacidad de cómputo, la conectividad de red y el diseño del sistema necesarios para seguir ofreciendo resultados, al tiempo que mejoramos la seguridad y la fiabilidad de las que dependen nuestros clientes». Sam Altman, CEO de OpenAI, declaró: «La infraestructura de NVIDIA es la base que nos permite seguir impulsando la frontera de la IA. Con NVIDIA Vera Rubin, ejecutaremos modelos y agentes más potentes a gran escala y ofreceremos sistemas más rápidos y fiables a cientos de millones de personas».
Plataforma Vera Rubin: Abriendo la frontera de la IA agente
Partiendo de la arquitectura Vera Rubin NVL72, presentada por primera vez en CES 2026, GTC 2026 amplió la plataforma para convertirla en un ecosistema integral de fábrica de IA a escala de pod. NVIDIA lo presenta como un cambio de chips discretos y servidores independientes a sistemas totalmente integrados a escala de rack, implementaciones a escala de pod y fábricas de IA soberanas. La plataforma Vera Rubin reúne CPU NVIDIA Vera, GPU Rubin, conmutadores NVLink 6, SuperNIC ConnectX-9, DPU BlueField-4, conmutadores Ethernet Spectrum-6 y una LPU NVIDIA Groq 3 recientemente integrada, todo diseñado para operar como una única supercomputadora de IA unificada con un profundo codiseño en computación, redes y almacenamiento, respaldado por un ecosistema de más de 80 socios MGX con una cadena de suministro global.

NVIDIA afirma que la plataforma ofrece hasta 10 veces más rendimiento de inferencia por vatio y un coste por token diez veces menor que la generación Blackwell en todo el espectro de cargas de trabajo de IA. Para entrenar grandes modelos Mixture-of-Experts, Vera Rubin requiere solo una cuarta parte de las GPU para lograr un rendimiento equivalente. El NVL72 se integra a la perfección con NVIDIA Quantum-X800 InfiniBand y Spectrum-X Ethernet para mantener una alta utilización en clústeres de GPU masivos, al tiempo que reduce el tiempo de entrenamiento y el coste total de propiedad.
Comparación generacional: Blackwell Ultra vs. Vera Rubin NVL72
| Especificación | GB300 NVL72 (Blackwell Ultra) | VR NVL72 (Vera Rubin) |
|---|---|---|
| Arquitectura computacional | ||
| Cantidad de GPU | 72 GPU Blackwell Ultra | 72 GPU Rubin |
| Recuento de CPU | 36 CPU Grace | 36 CPU Vera |
| Núcleos de CPU | 72 núcleos ARM por CPU | 88 núcleos Olympus ARM por CPU |
| Rendimiento de IA | ||
| Rendimiento de inferencia del FP4 | 1.44 exaFLOPS | 3.6 exaFLOPS |
| NVFP4 por GPU (inferencia) | 20 PFLOPS | 50 PFLOPS |
| NVFP4 por GPU (Entrenamiento) | 10 PFLOPS | 35 PFLOPS |
| Salud Cerebral | ||
| Tipo de memoria de GPU | HBM3e | HBM4 |
| Ancho de banda de memoria GPU | ~8 TB/s | ~22 TB/s |
| Inteligencia de | ||
| Generación NVLink | Enlace NV 5 | Enlace NV 6 |
| Ancho de banda de NVLink (por GPU) | 1.8 TB / s | 3.6 TB / s |
| Ancho de banda NVLink a escala de rack | 130 TB / s | 260 TB / s |
| Networking | ||
| NIC de escalabilidad horizontal | ConnectX-8 (800 Gb/s) | ConnectX-9 (1.6 TB/s) |
| Interconexión CPU-GPU | NVLink-C2C (900 GB/s) | NVLink-C2C (1.8 TB/s) |
Los productos basados en Vera Rubin estarán disponibles a través de socios a partir de la segunda mitad de 2026. Entre ellos se incluyen proveedores líderes de servicios en la nube como Amazon Web Services, Google Cloud, Microsoft Azure y Oracle Cloud Infrastructure, así como socios de NVIDIA Cloud como CoreWeave, Crusoe, Lambda, Nebius, Nscale y Together AI. Se espera que fabricantes de sistemas globales como Dell Technologies, HPE, Lenovo y Supermicro ofrezcan servidores basados en productos de Vera Rubin, además de ASUS, Foxconn, GIGABYTE, Inventec, Pegatron, QCT, Wistron y Wiwynn.
De CPX a LPX: cómo la adquisición de Groq por parte de NVIDIA transformó la aceleración de la decodificación.
El año pasado, en la Cumbre de Infraestructura de IA, NVIDIA anunció el rack CPX en varias configuraciones diseñadas para acelerar las consultas de inferencia de contexto extenso. Cuando cubrimos ese anuncio, nos surgieron varias preguntas sobre la función real del CPX. A primera vista, aunque era un concepto arquitectónico interesante, el CPX no parecía ofrecer nada sustancial más allá de la propia GPU Rubin, aparte quizás de una aceleración adicional para las operaciones de atención.
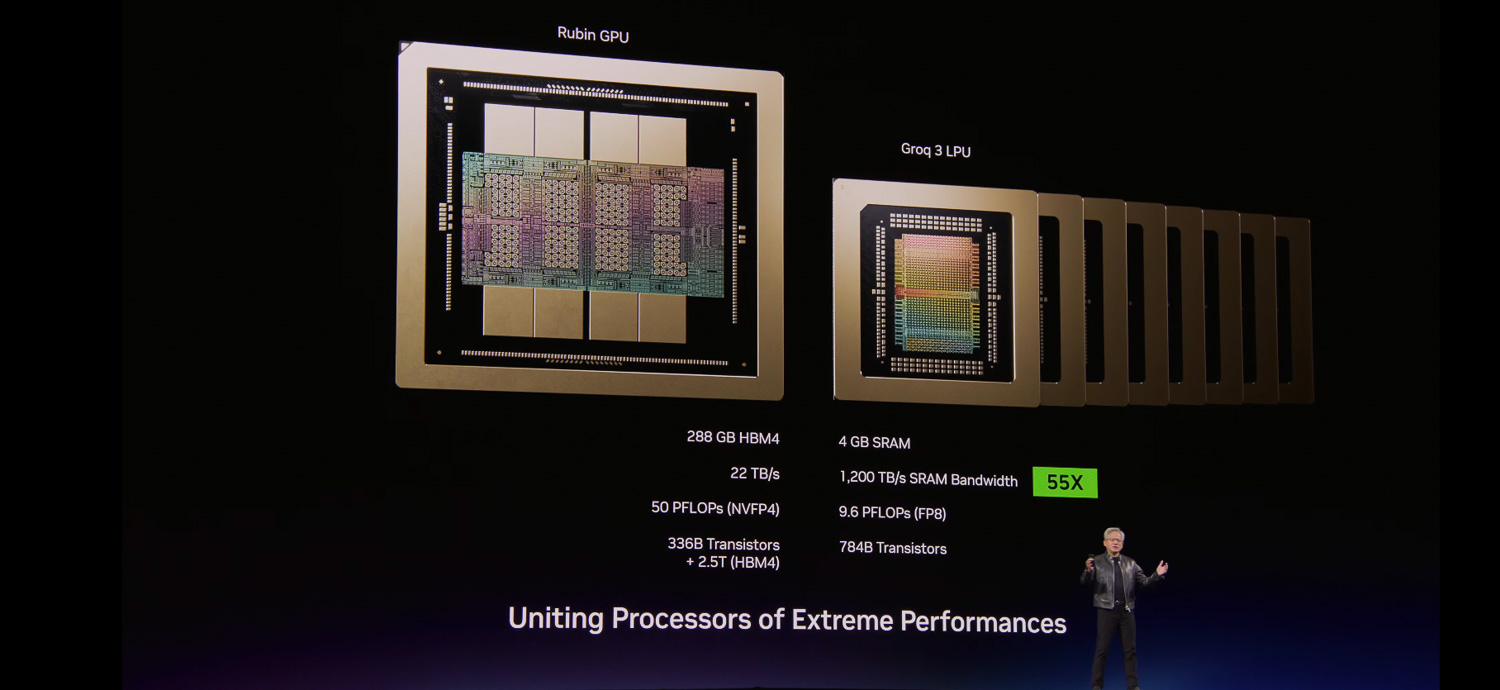
Luego llegó la adquisición de Groq, que tuvo un éxito arrollador en la industria y generó especulaciones sobre cómo NVIDIA integraría la tecnología LPU de Groq en la plataforma Vera Rubin. En GTC 2026, NVIDIA aclaró la situación con el anuncio de LPX. Según lo presentado, el concepto de rack CPX ha evolucionado hacia el Groq 3 LPX Rack, donde el enfoque original de procesamiento de contexto del CPX da paso a una arquitectura de aceleración de decodificación fundamentalmente diferente, basada en el chip de Groq.
GPU Rubin frente a LPU Groq 3: Arquitecturas complementarias
| Especificación | GPU Rubin | Groq 3 LPU (LP30) |
|---|---|---|
| Tipo de memoria | HBM4 | SRAM apilada |
| Capacidad de memoria (por chip) | 288 GB | 500 MB |
| ancho de banda de memoria | 22 TB / s | 150 TB / s |
| Solidez | Entrenamiento y prellenado de alto rendimiento | Decodificación de tokens de latencia ultrabaja |
| Despliegue | VR NVL72 (72 por rack) | Rack LPX (256 unidades por rack) |
| Memoria agregada en rack | ~20.7 TB HBM4 | 128 GB de SRAM |
| Ancho de banda escalable (Rack) | NVLink 6 de 260 TB/s | 640 TB / s |
Un único rack LPX alberga 256 LPU Groq 3. Cada LPU contiene aproximadamente 500 MB de SRAM apilada, lo que proporciona unos 128 GB de SRAM integrada agregada y un ancho de banda escalable de 640 TB/s, diseñado específicamente para la aceleración de decodificación de latencia ultrabaja. El contraste entre los dos tipos de procesador es marcado: una GPU Rubin proporciona 288 GB de HBM4 con un ancho de banda de 22 TB/s, mientras que la LPU sacrifica capacidad por ancho de banda bruto, ofreciendo 150 TB/s de su pool de SRAM por chip. Al implementarse conjuntamente con VR NVL72 mediante una interconexión personalizada basada en Spectrum X, se supone que los dos racks procesan cada token de decodificación de forma cooperativa, con la decodificación de atención en Rubin y las capas de realimentación directa descargadas a las LPU. Optimizada para modelos de billones de parámetros y contextos de millones de tokens, la arquitectura LPX, diseñada conjuntamente, se combina con Vera Rubin para maximizar la eficiencia en términos de energía, memoria y computación. El rack LPX cuenta con refrigeración líquida integral, está construido sobre la infraestructura MGX y estará disponible en la segunda mitad de 2026, coincidiendo con el lanzamiento general de Vera Rubin.

Es importante destacar que NVIDIA confirmó que no se requieren cambios en CUDA. La LPU funciona como un acelerador para la pila CUDA existente que se ejecuta en la plataforma Vera y NVL72, con la computación descargada de forma transparente por token. Durante la sesión de preguntas y respuestas de GTC, NVIDIA describió la LPU como un "potenciador de modelos de decodificación" y explicó que trabajarán estrechamente con los laboratorios de IA y los creadores de modelos de vanguardia que implementan estos modelos de billones de parámetros para habilitar la próxima generación de servicios de modelos premium y ultra premium. Muchos de los fundadores e ingenieros de Groq se han unido a NVIDIA, y la colaboración entre ambos equipos ha sido excelente, impulsando la hoja de ruta de Groq para integrarla en la infraestructura MGX. La implementación de LPX se centrará inicialmente en los creadores de modelos y proveedores de servicios, en lugar de una amplia disponibilidad para fabricantes de equipos originales (OEM). Esperamos con interés ver las mejoras de rendimiento reales que se derivan de la integración de NVIDIA y Groq.
Rack de CPU Vera: Computación diseñada específicamente para el aprendizaje por refuerzo y cargas de trabajo basadas en agentes.
Por qué la IA agente requiere una nueva clase de CPU
Para comprender por qué NVIDIA construyó un rack de CPU dedicado, es útil entender cómo funciona el aprendizaje por refuerzo (RL) en la fase posterior al entrenamiento del desarrollo de IA moderna. El post-entrenamiento es la etapa posterior al pre-entrenamiento de un modelo con un conjunto de datos masivo, donde el modelo se refina y se especializa para casos de uso específicos.
En un sistema de aprendizaje por refuerzo, el ciclo de entrenamiento consta de tres componentes principales: un modelo de política (el modelo que se entrena), un entorno en el que el modelo realiza acciones y recibe retroalimentación, y una señal de recompensa que evalúa la calidad de dichas acciones. El modelo de política genera posibles resultados, que luego se ejecutan en el entorno, son evaluados por el modelo de recompensa, y los gradientes resultantes se utilizan para actualizar la política.
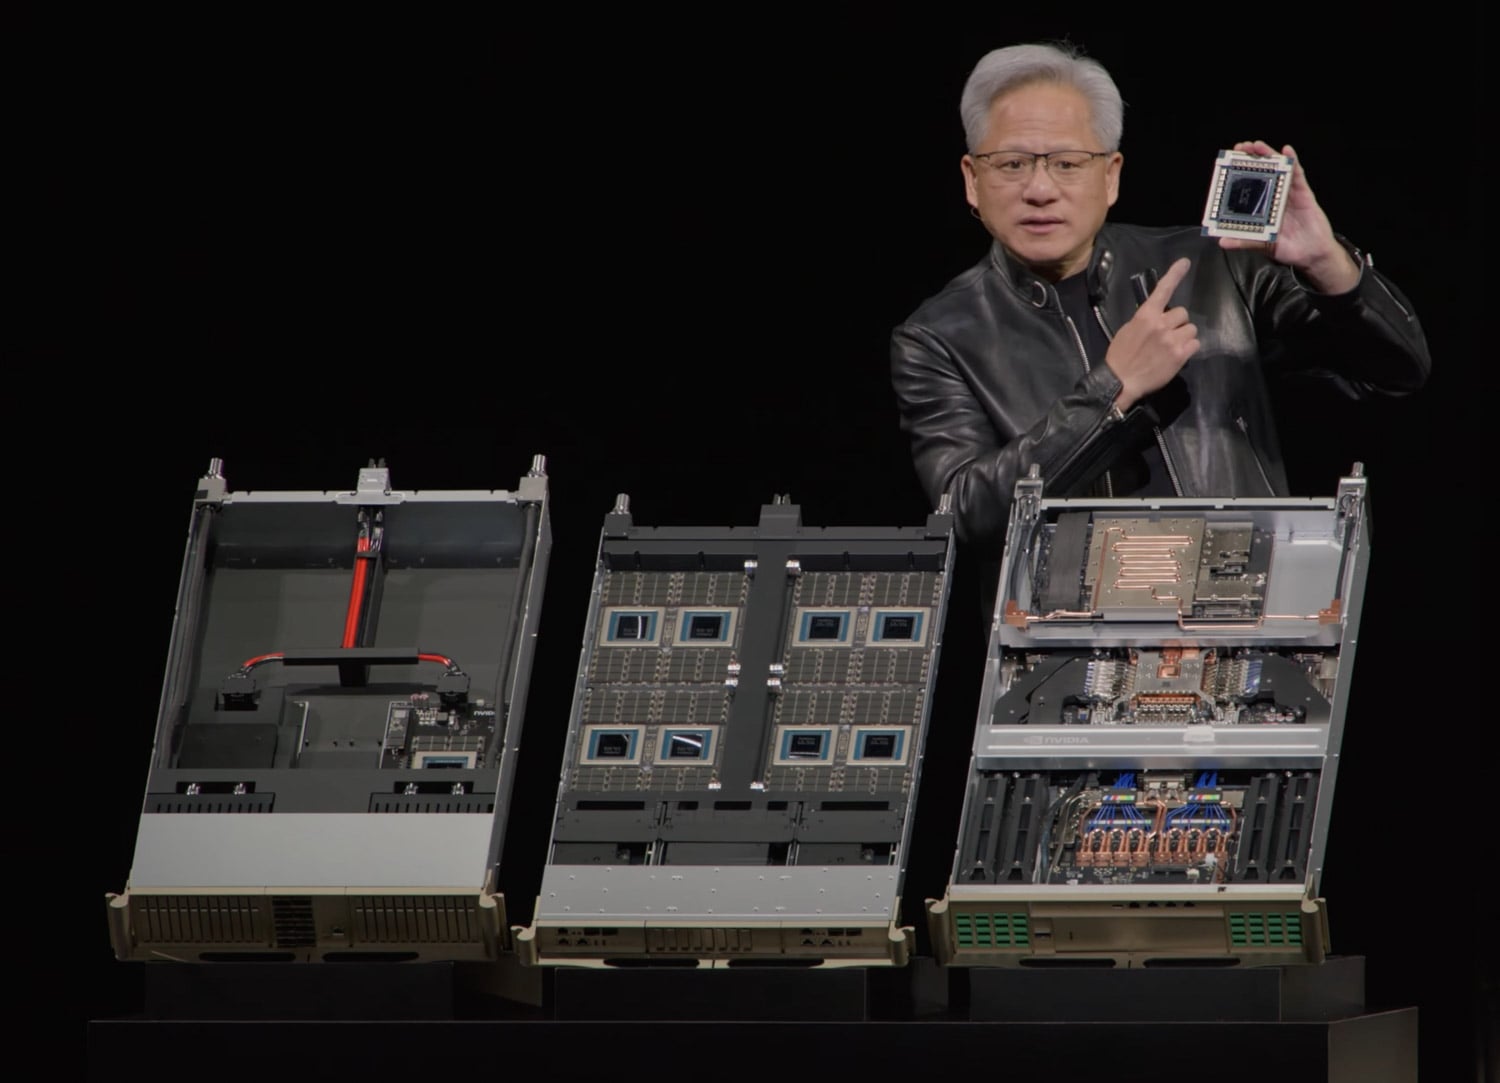
Para cargas de trabajo de IA agente, este entorno de aprendizaje por refuerzo no es una simulación abstracta, sino un entorno de pruebas computacional real. Consideremos, por ejemplo, el postentrenamiento de un modelo de codificación agente con herramientas como Claude Code o agentes de codificación autónomos similares. En este caso, se necesitan tres grupos de computación distintos que operen simultáneamente. Primero, un grupo de entrenamiento con aceleradores de GPU que actualizan los pesos del modelo de políticas. Segundo, aceleradores de inferencia que ejecutan el punto de control actual del modelo de políticas para generar acciones candidatas (ediciones de código, llamadas a herramientas, operaciones de archivos) a gran escala. Tercero, y fundamental, un gran grupo de computación convencional con CPU donde se ejecutan los entornos de aprendizaje por refuerzo. En estos entornos, los agentes ejecutan el código generado, realizan pruebas, llaman a herramientas, emiten consultas SQL, compilan binarios, interactúan con sistemas de archivos y llevan a cabo todas las operaciones del entorno de pruebas que producen las señales de recompensa que retroalimentan el ciclo de entrenamiento.
La magnitud de este requisito de computación convencional es considerable. Cada ejecución del modelo de políticas puede desencadenar docenas de llamadas secuenciales a herramientas, cada una de las cuales debe ejecutarse, evaluarse y devolverse antes de que pueda continuar el siguiente paso. Al generar miles de puntos de datos en paralelo durante la ejecución del entrenamiento, se necesita una enorme flota de CPU rápidas para evitar que el clúster de entrenamiento de GPU se bloquee durante la ejecución del entorno. Cualquier latencia en el grupo de CPU del entorno aislado se traduce directamente en ciclos de GPU inactivos y computación de entrenamiento desperdiciada. La misma dinámica se aplica en el momento de la inferencia para los sistemas agénicos implementados. Cada llamada a herramienta, compilación de código y ejecución en el entorno aislado que realiza un agente es trabajo de CPU que debe completarse con la suficiente rapidez para mantener la capacidad de respuesta de la canalización agénica de extremo a extremo. Como lo expresan los materiales de prensa de NVIDIA, la CPU ya no solo da soporte al modelo, sino que lo impulsa.
El rack de CPU Vera: la respuesta de NVIDIA
Para satisfacer este requisito, NVIDIA lanzó la CPU Vera, que la compañía denomina el primer procesador del mundo diseñado específicamente para la era de la IA agente y el aprendizaje por refuerzo. El Vera CPU Rack es un sistema dedicado a escala de rack que contiene 256 procesadores Vera refrigerados por líquido, capaces de soportar más de 22 500 entornos de CPU concurrentes, cada uno funcionando de forma independiente a pleno rendimiento. Las fábricas de IA pueden implementar y escalar rápidamente a decenas de miles de instancias simultáneas y herramientas agente en un solo rack. El rack ofrece 400 TB de memoria total, 300 TB/s de ancho de banda de memoria agregada y 64 DPU BlueField-4, todos compatibles con los ecosistemas Vera Rubin y DGX y construidos sobre la arquitectura de referencia modular NVIDIA MGX.
La CPU Vera se basa en 88 núcleos Olympus personalizados diseñados por NVIDIA, con compatibilidad total con Armv9.2. Cada núcleo admite dos tareas simultáneas mediante la tecnología NVIDIA Spatial Multithreading. El subsistema de memoria de bajo consumo de segunda generación se basa en LPDDR5X, que ofrece un ancho de banda de hasta 1.2 TB/s, el doble con la mitad de consumo que las CPU de propósito general.
Más allá de sus características de rendimiento, el Vera Rack también aborda un problema práctico de la cadena de suministro: las organizaciones que operan fábricas de IA con decenas de miles de GPU necesitan flotas igualmente masivas de CPU para la ejecución del entorno, y obtener ese volumen de procesadores x86 de alto rendimiento de AMD o Intel en la escala y el plazo requeridos puede plantear importantes desafíos de adquisición y disponibilidad. Un rack de CPU NVIDIA integrado verticalmente simplifica esta dependencia.
Entre los clientes que colaboran con NVIDIA para implementar la CPU Vera se encuentran Alibaba, ByteDance, Meta y Oracle Cloud Infrastructure, así como CoreWeave, Crusoe, Lambda, Nebius, Nscale, Cloudflare, Together AI y Vultr. Los socios fabricantes incluyen a Dell Technologies, HPE, Lenovo, Supermicro, ASUS, Cisco, Foxconn, GIGABYTE y QCT, entre otros.
BlueField-4 STX y NVIDIA CMX: La arquitectura de referencia detrás del almacenamiento de memoria de contexto de inferencia
En CES 2026, NVIDIA anunció la plataforma Inference Context Memory Storage (ICMS), una nueva clase de infraestructura de almacenamiento nativa para IA diseñada específicamente para la gestión de caché KV en inferencia LLM a gran escala. En GTC 2026, NVIDIA presentó la arquitectura de referencia que la impulsa: BlueField-4 STX, un diseño modular que extiende sin problemas la memoria de la GPU en todo el pod para el contexto de agentes y los datos de caché KV. La primera implementación a escala de rack de STX es la nueva plataforma de almacenamiento de memoria de contexto NVIDIA CMX, que amplía la memoria de la GPU con una capa de contexto de alto rendimiento para sistemas de inferencia y agentes escalables.
La necesidad de una capa de almacenamiento dedicada se hace evidente al analizar la escalabilidad de la inferencia basada en transformadores. Cada token generado debe interactuar con todos los tokens anteriores mediante el mecanismo de atención, y la caché de clave-valor (KV) almacena matrices de atención precalculadas para su reutilización, evitando así el recálculo. El problema radica en que el tamaño de la caché KV aumenta con la longitud de la secuencia y el tamaño del lote. En entornos multiusuario que gestionan miles de solicitudes concurrentes en ventanas de contexto de millones de tokens, la memoria HBM de la GPU se satura. Los operadores deben reducir el tamaño de los lotes, acortar las ventanas de contexto o añadir más GPU, lo que reduce la rentabilidad y la capacidad.
El BlueField-4 STX aborda este problema proporcionando una capa de almacenamiento compartido de alto ancho de banda, diseñada específicamente para patrones de acceso a caché KV, que se sitúa entre la memoria HBM de la GPU y el almacenamiento convencional. Está acelerado por la plataforma Vera Rubin y aprovecha un procesador BlueField-4 optimizado para almacenamiento que combina la CPU Vera con la tarjeta de red ConnectX-9 SuperNIC, junto con la red Ethernet Spectrum-X, NVIDIA DOCA y el software NVIDIA AI Enterprise. NVIDIA afirma que la plataforma CMX ofrece hasta 5 veces más tokens por segundo que el almacenamiento tradicional, una eficiencia energética 4 veces superior a la de las arquitecturas de CPU tradicionales para almacenamiento de alto rendimiento y una ingesta de datos 2 veces más rápida para datos de IA empresariales.
NVIDIA también presenta DOCA Memos, un nuevo marco de trabajo DOCA que optimiza el almacenamiento BlueField-4 con procesamiento de caché KV dedicado para aumentar el rendimiento de la inferencia y mejorar significativamente la eficiencia energética. El resultado es un contexto global del POD que permite interacciones más rápidas con agentes de IA en múltiples etapas, servicios de IA más escalables y una mayor utilización general de la infraestructura. Esto se integra con el proyecto de código abierto NVIDIA Dynamo, que proporciona el marco de software para fases de precarga/decodificación desagregadas, enrutamiento inteligente y descarga de almacenamiento por niveles.
La arquitectura STX es una arquitectura de referencia que NVIDIA no vende directamente, sino que proporciona a sus socios del ecosistema de almacenamiento. Entre los proveedores de almacenamiento que participan en el diseño de infraestructura de próxima generación basada en STX se encuentran Cloudian, DDN, Dell Technologies, Everpure, Hitachi Vantara, HPE, IBM, MinIO, NetApp, Nutanix, VAST Data y WEKA. Los socios fabricantes que desarrollan sistemas basados en STX incluyen a AIC, Supermicro y QCT. Entre los principales laboratorios de IA y proveedores de servicios en la nube que planean adoptar STX para el almacenamiento de memoria contextual se encuentran CoreWeave, Crusoe, IREN, Lambda, Mistral AI, Nebius, Oracle Cloud Infrastructure y Vultr. Las plataformas basadas en STX estarán disponibles a través de los socios en la segunda mitad de 2026.
Diseño de referencia de Vera Rubin DSX AI Factory y plano general de Omniverse DSX
Más allá de los racks y módulos individuales, NVIDIA anunció el diseño de referencia Vera Rubin DSX AI Factory y la disponibilidad general del NVIDIA Omniverse DSX Blueprint, que en conjunto proporcionan un marco integral para diseñar, construir y operar infraestructuras de IA de diseño conjunto que maximizan el rendimiento energético y aceleran la puesta en marcha de la primera producción. Gracias a la estrecha integración de la computación, las redes, el almacenamiento, la alimentación y la refrigeración, la arquitectura aumenta la eficiencia energética y garantiza que las fábricas de IA puedan escalar de forma fiable bajo cargas de trabajo continuas y de alta intensidad, manteniendo al mismo tiempo el máximo tiempo de actividad.
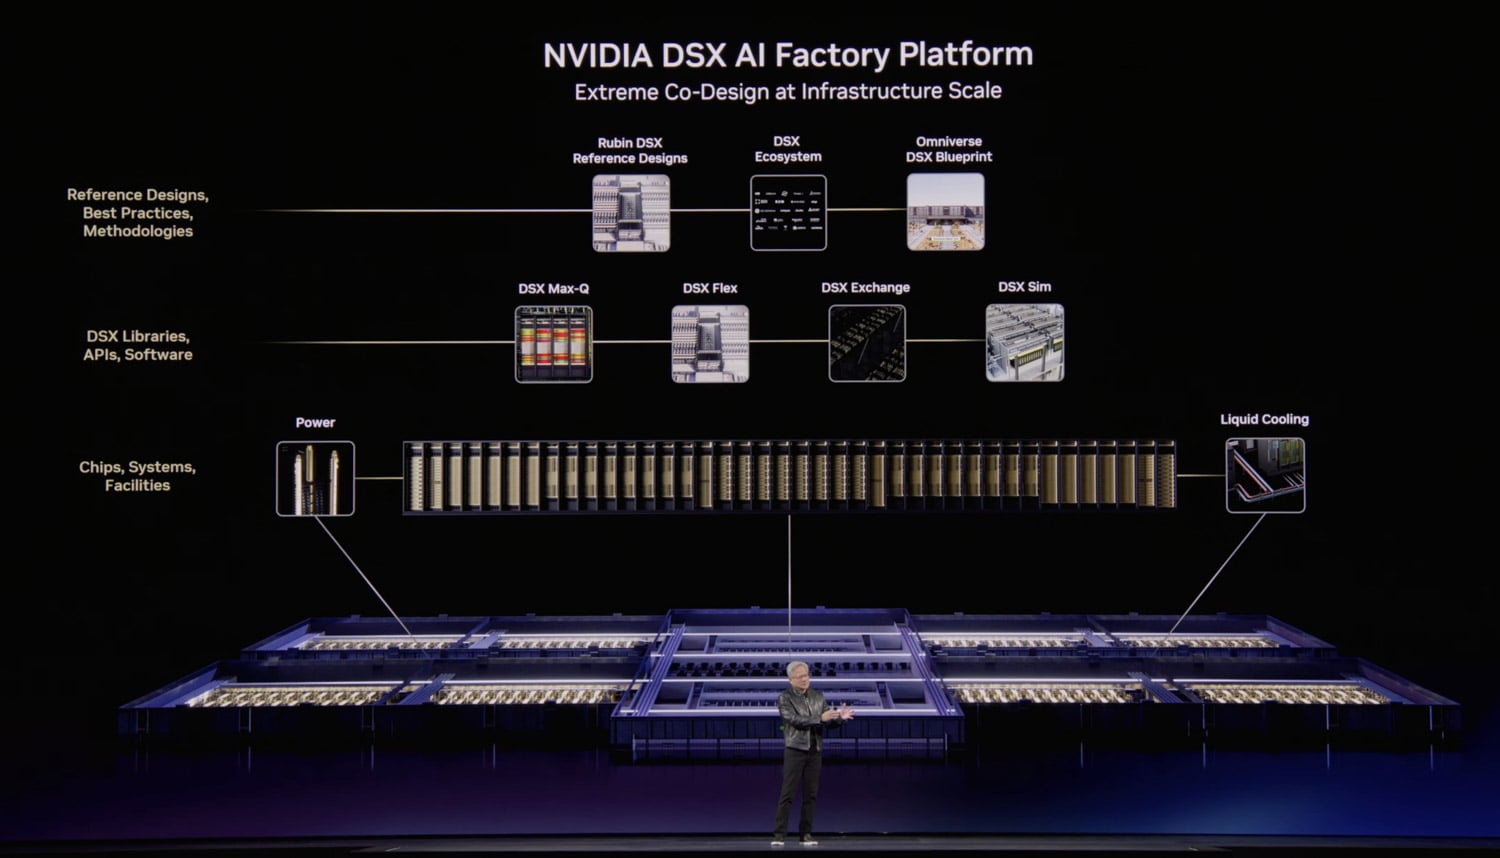
El conjunto de software Rubin DSX es abierto, modular y componible, y conecta el hardware del clúster con los sistemas de alimentación y refrigeración. Incluye varias bibliotecas de componentes: DSX Max-Q permite el aprovisionamiento dinámico de energía en toda la fábrica de IA, lo que resulta en el despliegue de un 30 % más de infraestructura de IA dentro de un centro de datos de alimentación fija. DSX Flex permite que las fábricas de IA se conviertan en activos flexibles a la red, liberando lo que NVIDIA estima en 100 gigavatios de energía de red sin utilizar, una capacidad crítica dado que la energía es ahora el mayor cuello de botella para la construcción de infraestructura de IA, con más de 300 mil millones de dólares en retrasos en equipos y más de 200 GW de proyectos esperando en las colas de interconexión de EE. UU. DSX Exchange permite la integración escalable y segura de señales de computación, red, energía, alimentación y refrigeración entre TI, tecnología operativa y agentes de operaciones. Los modelos DSX Sim validan las fábricas de IA como gemelos digitales de alta fidelidad utilizando la plataforma NVIDIA DSX Air.
El plano Omniverse DSX, ya disponible en build.nvidia.com y totalmente compatible con el diseño de referencia Vera Rubin DSX, permite a los desarrolladores crear réplicas digitales físicamente precisas de sus fábricas de IA, simular operaciones en tiempo real y optimizar el rendimiento antes de que comience la construcción o la implementación. Esto unifica la alimentación, la refrigeración, la red y las operaciones en un único entorno para acelerar la obtención de ingresos y la eficiencia de la IA.
Entre los líderes de la industria que contribuyen a la arquitectura y el diseño de DSX se encuentran Cadence, Dassault Systèmes, Eaton, Jacobs, Nscale, Phaidra, Procore Technologies, PTC, Schneider Electric, Siemens, Switch, Trane Technologies y Vertiv. Cabe destacar que Nscale y Caterpillar están implementando los diseños de referencia DSX Vera Rubin en Virginia Occidental, en una planta multigigavatio descrita como una de las fábricas de IA más grandes del mundo. En el ámbito energético, Emerald AI, GE Vernova, Hitachi y Siemens Energy están utilizando la arquitectura de referencia DSX para liberar capacidad de la red eléctrica y suministrar la energía necesaria para la construcción de nuevas fábricas de IA. Phaidra ha integrado DSX Max-Q en un agente de IA de autoaprendizaje que ofrece aproximadamente un 10 % más de capacidad de procesamiento al reducir los picos de refrigeración sin comprometer la seguridad.
NVIDIA Agent Toolkit y OpenCLAW: El conjunto de software para agentes autónomos
TC 2026 también puso de relieve el rápido auge de las cargas de trabajo de IA con agentes, y NVIDIA describió a los agentes autónomos como la carga de trabajo de más rápido crecimiento que la compañía haya visto jamás. Un elemento central de los anuncios de software fue OpenCLAW, descrito como probablemente el lanzamiento de software más importante de la historia y un marco de orquestación para agentes autoevolutivos de larga duración llamados CLAW, sistemas autónomos que pueden planificar, actuar y ejecutar misiones completas en lugar de tareas individuales. NVIDIA caracterizó a los CLAW como la nueva capa de aplicación para la IA, señalando que hemos pasado de preguntar "¿qué, cómo o por qué?" a preguntar "¿construir, crear o fabricar?".
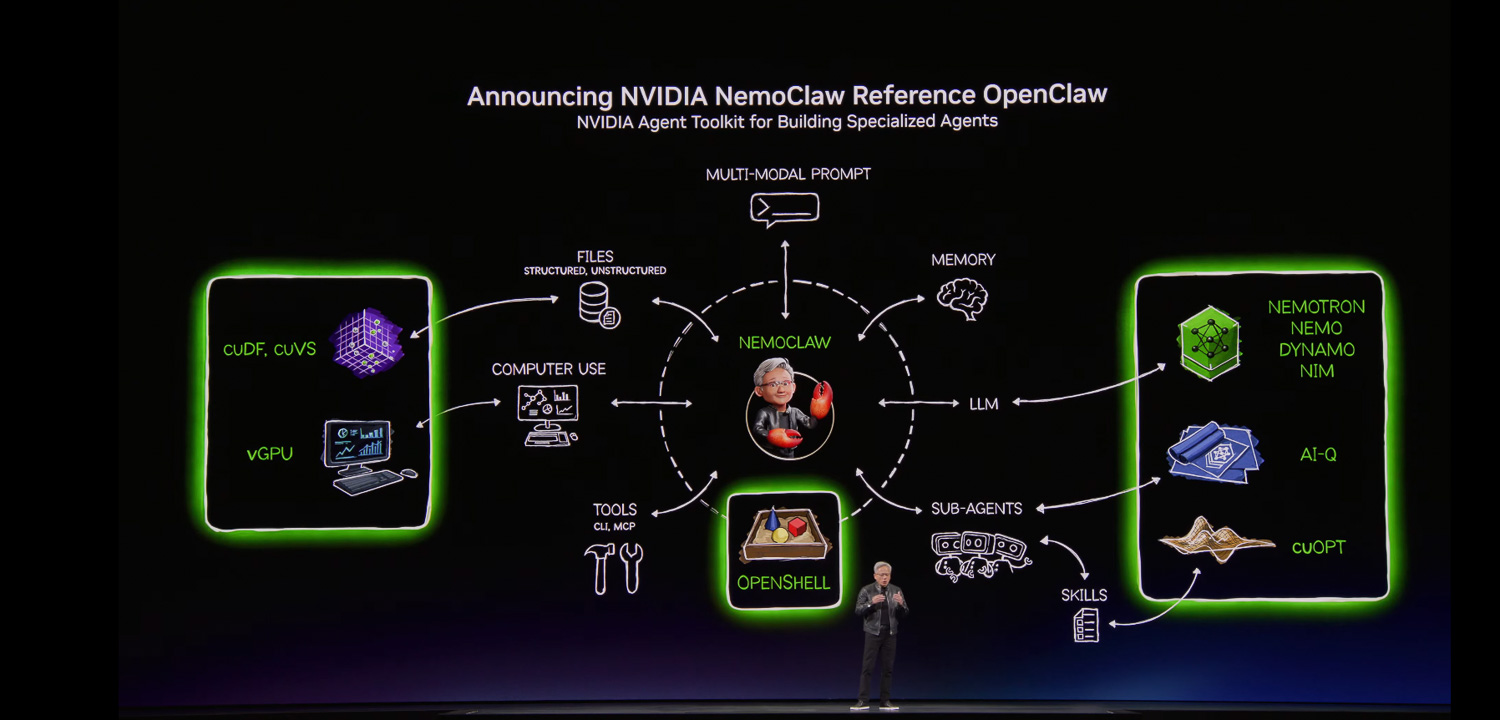
NVIDIA anunció NVIDIA Agent Toolkit, una colección totalmente de código abierto de modelos, entornos de ejecución y planos para construir, evaluar y optimizar agentes autónomos de larga duración. Los componentes clave incluyen los modelos abiertos Nemotron para razonamiento, codificación y voz; Nemo para la creación de perfiles y personalización de agentes; NIM para la inferencia de modelos; y Dynamo 1.0 para el servicio escalable. Las nuevas incorporaciones incluyen NVIDIA OpenShell, un entorno de ejecución de seguridad de código abierto que proporciona límites de red, privacidad y seguridad basados en políticas para la ejecución de agentes, e IQ, un plano de código abierto que combina inteligencia de vanguardia y de modelos abiertos para agentes de investigación profunda, el primer sistema de investigación en superar los benchmarks Deep Research Bench 1 y Complex Deep Research Bench 2. Una nueva habilidad de cuOPT aporta experiencia en problemas de optimización descritos en lenguaje natural.
NVIDIA también anunció Nemo CLAW, su contribución a la comunidad OpenCLAW, desarrollada en colaboración con Peter Steinberger, creador de OpenCLAW. Nemo CLAW instala OpenCLAW, junto con los modelos Nemotron y el entorno de ejecución OpenShell, con un solo comando, proporcionando una base para que los agentes desarrollen y adquieran nuevas habilidades operando dentro de límites definidos de privacidad y seguridad. Puede ejecutarse en cualquier plataforma, desde infraestructura en la nube hasta PC RTX locales, DGX Station y DGX Spark.
DGX Spark y DGX Station: Plataformas de desarrollo CLAW locales
Consciente de que muchos desarrolladores prefieren entornos de desarrollo locales con control total sobre sus recursos informáticos, NVIDIA ha presentado dos nuevas plataformas diseñadas específicamente para el desarrollo de agentes CLAW. DGX Spark es una plataforma de alto rendimiento y bajo consumo energético para ejecutar agentes autónomos seguros y siempre activos. Los sistemas DGX Spark y los sistemas OEM de socios basados en GB10 ya están disponibles a nivel mundial. DGX Station, posicionada como la plataforma definitiva para el desarrollo local de CLAW, permite a los desarrolladores ejecutar modelos con inteligencia de vanguardia completamente en sus instalaciones, sin necesidad de conectividad en la nube, lo cual es fundamental para el desarrollo, ya que todo permanece local para un control y una seguridad completos. Los sistemas DGX Station estarán disponibles para su compra a través de socios OEM a partir del 16 de marzo de 2026.
Módulos espaciales de Vera Rubin: Infraestructura de IA más allá de la Tierra
NVIDIA anunció que sus plataformas de computación acelerada más recientes están impulsando una nueva era de innovación espacial, llevando la computación de IA a los centros de datos orbitales (ODC), la inteligencia geoespacial y las operaciones espaciales autónomas. El módulo espacial NVIDIA Vera Rubin ofrece hasta 25 veces más capacidad de computación de IA para inferencia espacial que la GPU NVIDIA H100, lo que permite que grandes modelos de lenguaje y modelos básicos avanzados operen directamente en órbita. Su arquitectura CPU-GPU altamente integrada proporciona el rendimiento y la memoria necesarios para procesar flujos de datos masivos provenientes de instrumentos espaciales en tiempo real.
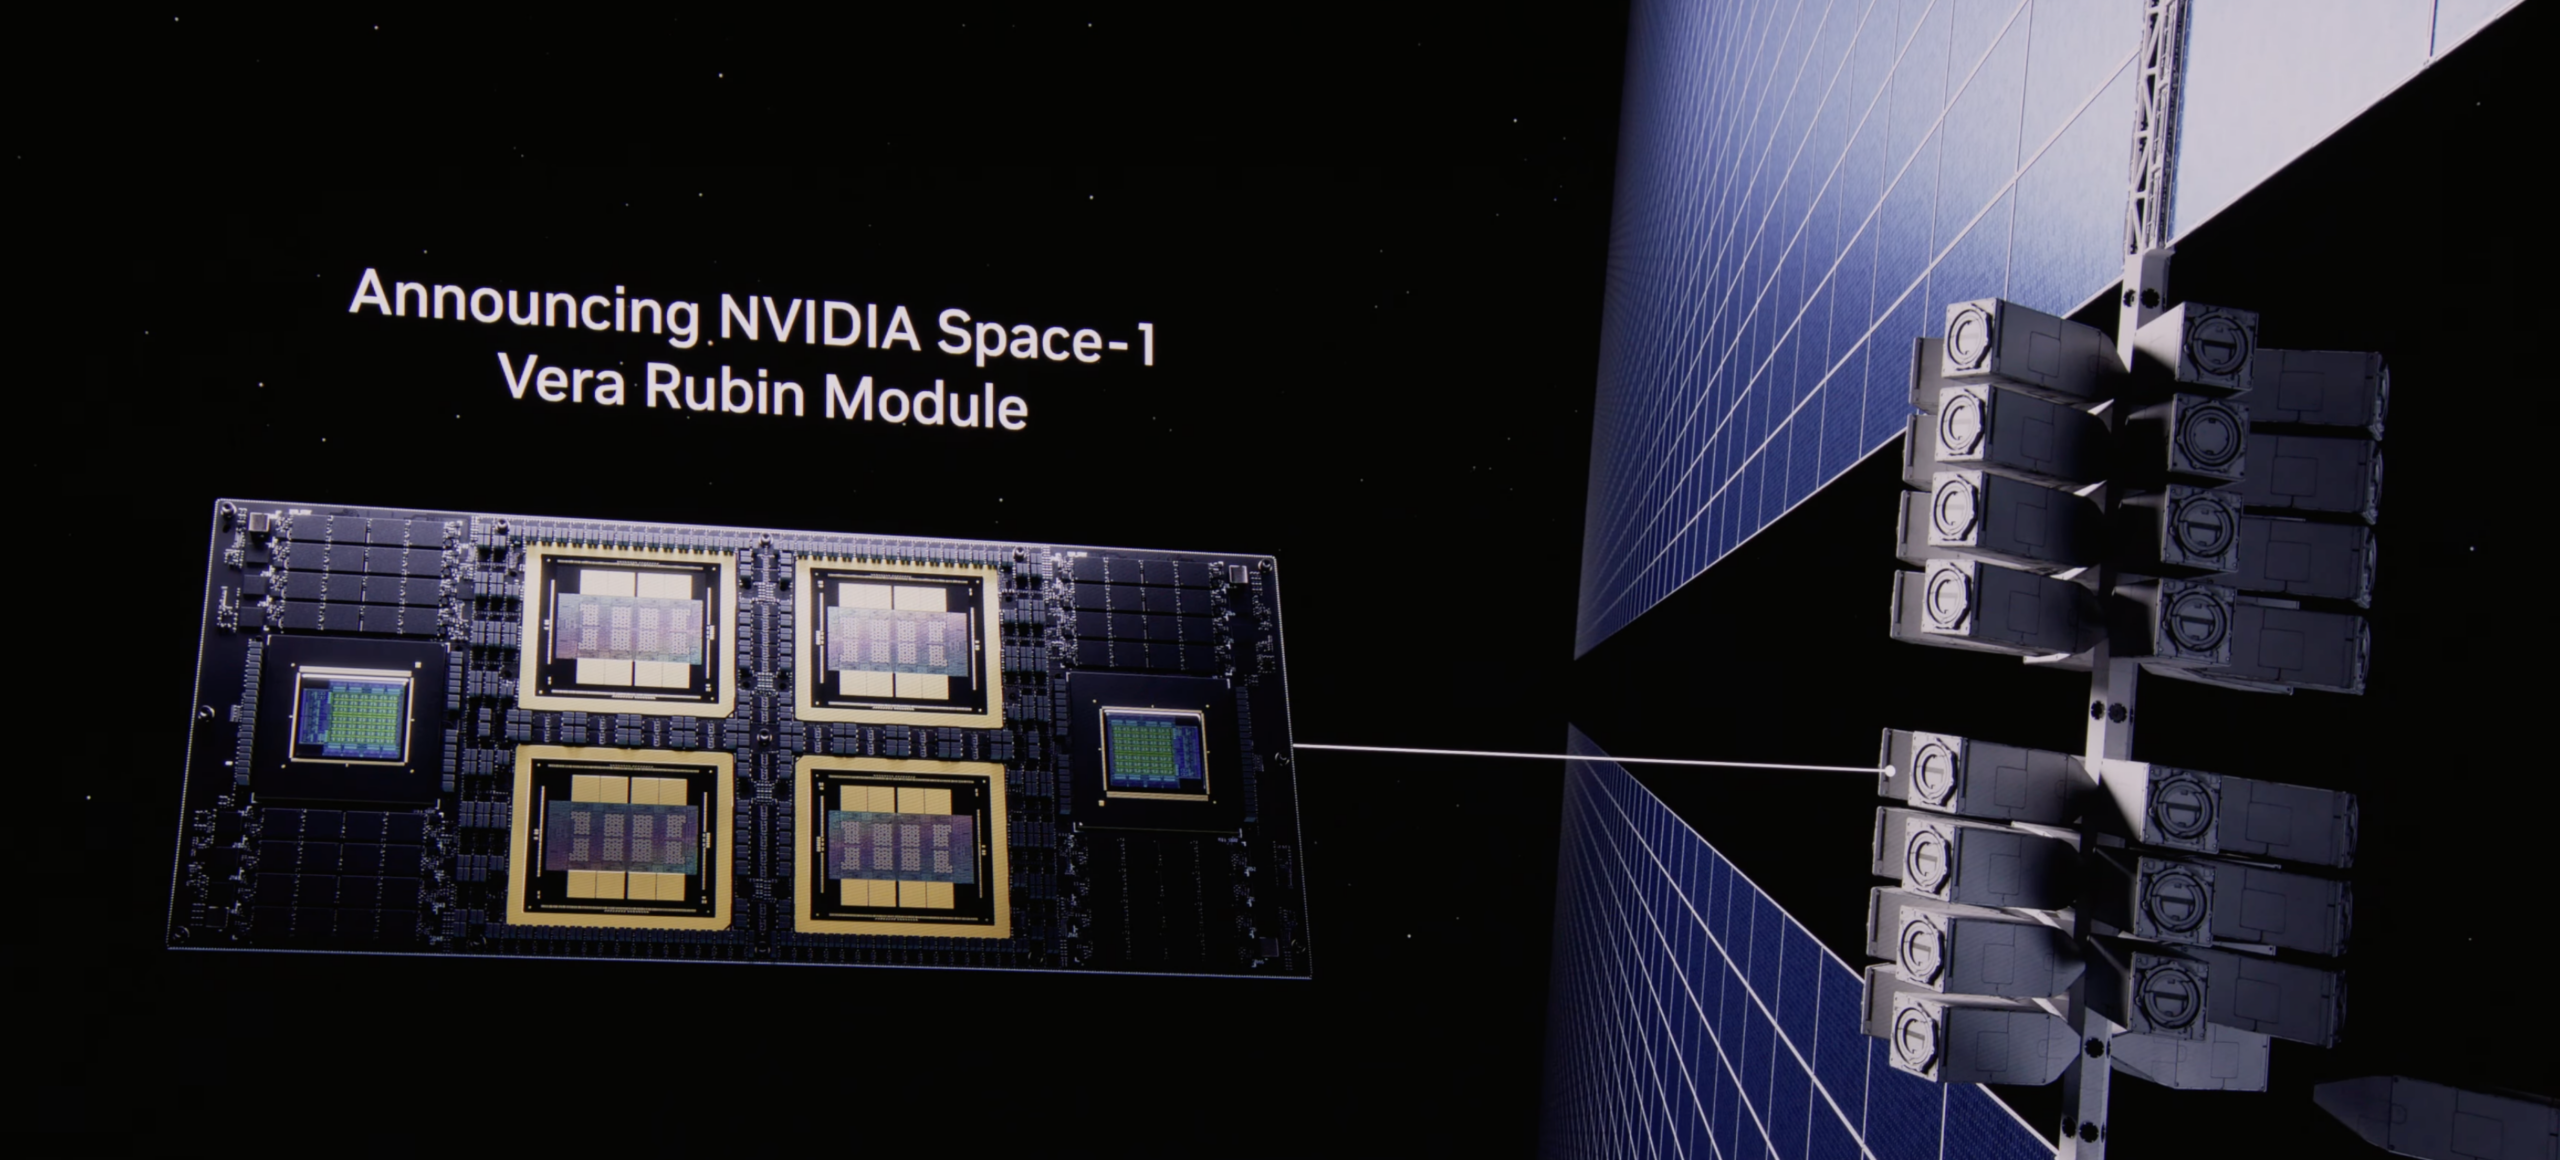
Junto con el módulo espacial Vera Rubin, NVIDIA IGX Thor proporciona durabilidad de grado industrial para entornos críticos en órbita, mientras que Jetson Orin ofrece inferencia de IA de alto rendimiento en un módulo ultracompacto optimizado para naves espaciales con limitaciones de tamaño, peso y consumo de energía. En tierra, la GPU RTX PRO 6000 Blackwell Server Edition ofrece un rendimiento hasta 100 veces superior al de los sistemas de procesamiento por lotes basados en CPU tradicionales para el procesamiento de inteligencia geoespacial. Socios como Aetherflux, Axiom Space, Kepler Communications, Planet Labs, Sophia Space y Starcloud están desarrollando estas plataformas para misiones espaciales de próxima generación que abarcan centros de datos orbitales, operaciones espaciales autónomas y observación de la Tierra en tiempo real.
NVIDIA Dynamo 1.0: El sistema operativo de inferencia para fábricas de IA
Para completar los anuncios de la GTC 2026, NVIDIA lanzó Dynamo 1.0, un software de código abierto que la compañía posiciona como el primer sistema operativo distribuido para la inferencia en entornos de IA. Al igual que el sistema operativo de una computadora coordina el hardware y las aplicaciones, Dynamo 1.0 funciona como la capa de orquestación distribuida para entornos de IA, gestionando sin problemas los recursos de GPU y memoria en todo el clúster para potenciar cargas de trabajo de IA complejas y heterogéneas a gran escala.
Dynamo 1.0 distribuye el trabajo de inferencia entre las GPU con enrutamiento inteligente y la capacidad de mover datos entre GPU y niveles de almacenamiento de menor costo, lo que reduce el desperdicio de computación y alivia las limitaciones de memoria. Para la IA agente y las cargas de trabajo de contexto extenso, Dynamo puede enrutar las solicitudes a las GPU que ya contienen los datos de caché KV más relevantes de pasos anteriores, y luego descargar esa memoria cuando no sea necesaria, una capacidad que se integra directamente con la arquitectura de almacenamiento BlueField-4 STX/ICMS. En recientes pruebas de rendimiento de la industria, Dynamo aumentó el rendimiento de inferencia de las GPU NVIDIA Blackwell hasta 7 veces, lo que redujo el costo de los tokens y aumentó las oportunidades de ingresos para millones de GPU implementadas, todo con software libre y de código abierto.
NVIDIA está impulsando el ecosistema de código abierto mediante la integración de las optimizaciones de Dynamo y TensorRT-LLM en marcos de inferencia populares, como LangChain, llm-d, LMCache, SGLang y vLLM. Los componentes básicos de Dynamo, KVBM para la gestión de memoria, NIXL para la transferencia rápida de datos entre GPU y Grove para una escalabilidad simplificada, también están disponibles como módulos independientes. NVIDIA también aporta kernels CUDA de TensorRT-LLM al proyecto FlashInfer para su integración nativa en marcos de código abierto.
La adopción es notable. La plataforma de inferencia de NVIDIA ahora está integrada con proveedores de nube como AWS, Microsoft Azure, Google Cloud y Oracle Cloud Infrastructure, así como con socios de NVIDIA como Alibaba Cloud, CoreWeave, Crusoe, DigitalOcean, Nebius, Nscale y Together AI. Empresas especializadas en IA como Cursor, Hebbia y Perplexity han adoptado la plataforma, al igual que proveedores de endpoints de inferencia como Baseten, Deep Infra y Fireworks. Empresas globales como Amazon, AstraZeneca, BlackRock, ByteDance, Coupang, Instacart, Meituan, PayPal, Pinterest, Shopee y SoftBank Corp. han adoptado el conjunto de herramientas de inferencia de NVIDIA. Dynamo 1.0 ya está disponible para desarrolladores de todo el mundo.


 Amazon