

Portworx by Everpure lanzó hoy Kube Datastore para el público general en matrices SAN compatibles, lo que proporciona a las máquinas virtuales en Kubernetes volúmenes de réplica única respaldados por una matriz compartida. Anunciada en KubeCon 2026, esta versión se distribuye con Portworx Enterprise 3.7.2 y llega junto con un centro de operaciones ampliado, compatibilidad con Red Hat OpenShift 5 y volúmenes preconfigurados para inferencia de IA que Everpure prevé lanzar en el primer trimestre de 2027.
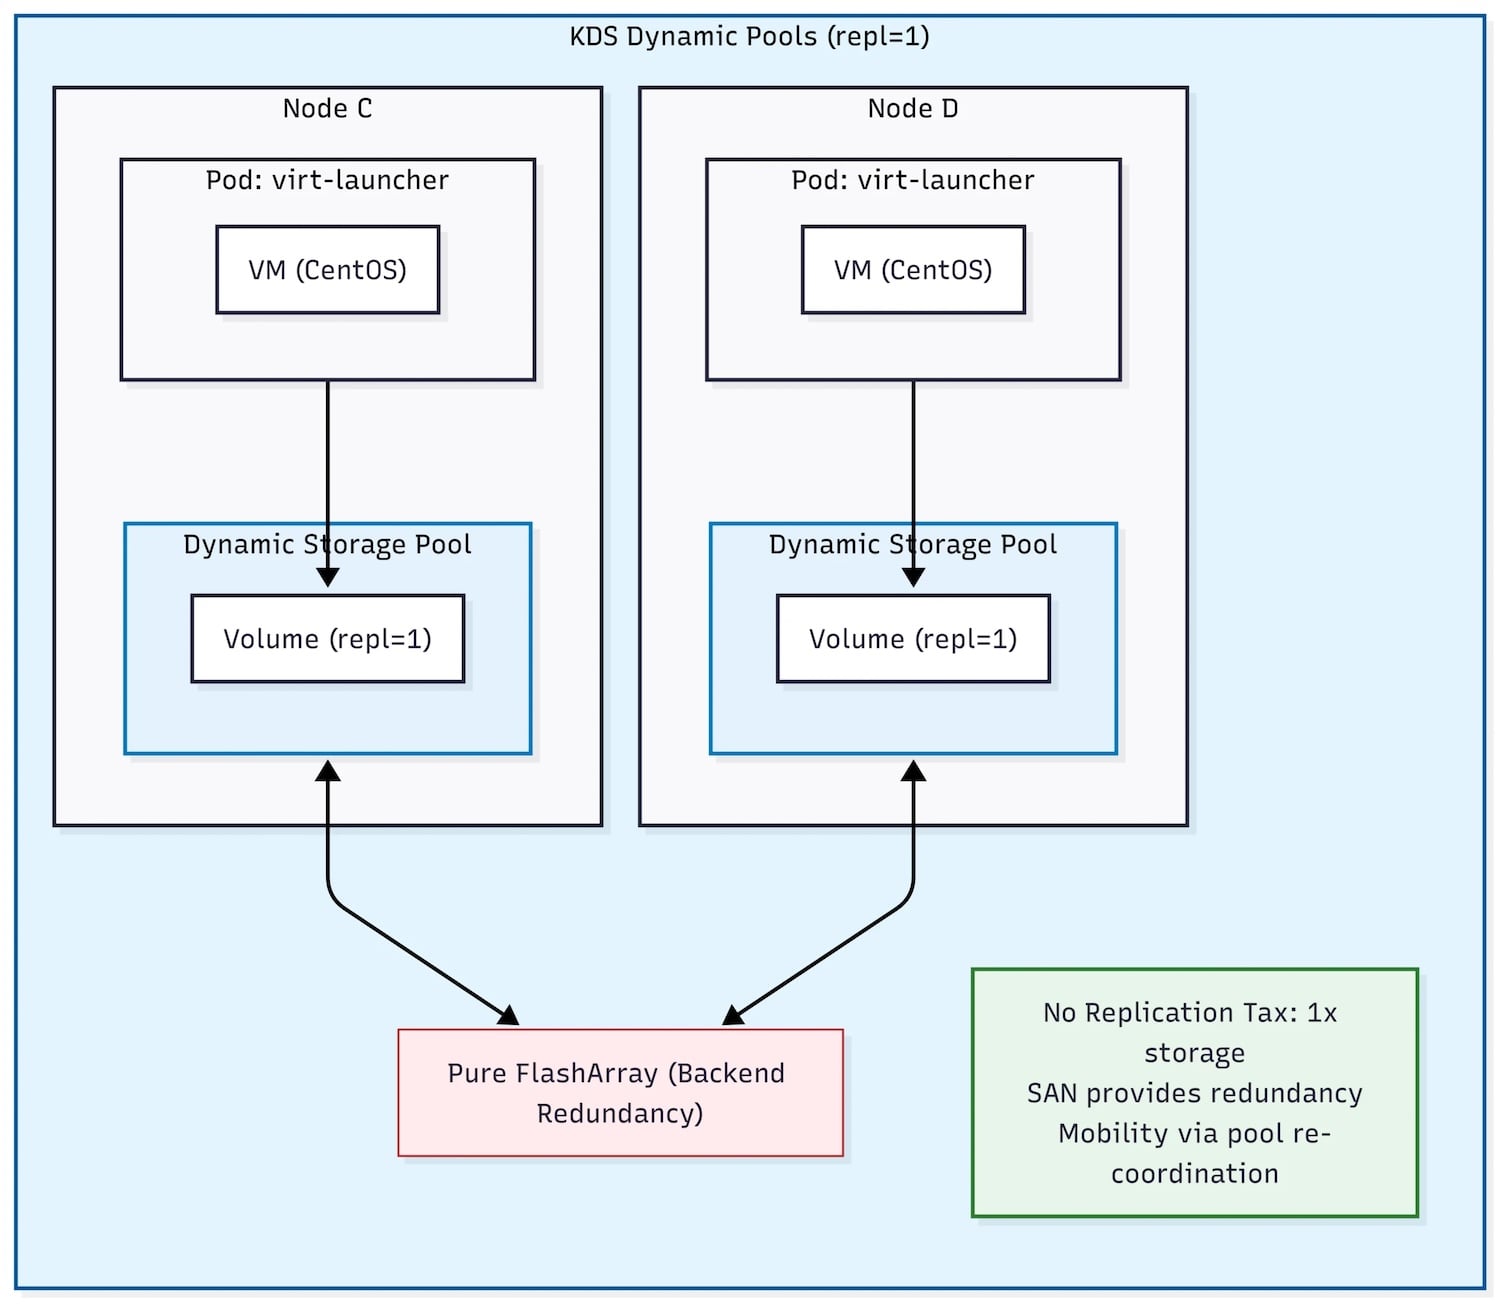
Portworx gestiona los datos de máquinas virtuales, contenedores y cargas de trabajo de IA en Kubernetes, tanto en almacenamiento local como en la nube y en el borde de la red. Kube Datastore (KDS) agrupa los grupos de almacenamiento de Portworx que comparten un backend en un almacén de datos, lo que proporciona a los administradores de máquinas virtuales conceptos de almacén de datos familiares y movilidad de almacenamiento en Kubernetes, y permite a los ingenieros de plataforma controlar dónde se ubican los volúmenes y cuánta capacidad utilizan.
Almacén de datos de Kube para máquinas virtuales de Kubernetes
La versión GA se centra en los grupos dinámicos: un grupo dinámico es un grupo de almacenamiento de Portworx creado en un backend compartido, que contiene volúmenes con un factor de replicación de uno, dejando la protección de datos a cargo del array. Portworx menciona Everpure FlashArray como un backend compatible y no ha incluido otros arrays. Los grupos estáticos se mantienen para cargas de trabajo que requieren disponibilidad basada en replicación y para tipos de volumen que no son elegibles, como SharedV4.
La eficiencia depende del número de réplicas: Portworx estima que el modelo tradicional sin recursos compartidos genera entre 2 y 3 veces más sobrecarga de almacenamiento y entre 3 y 5 veces más amplificación de E/S de red, según el factor de replicación. Un volumen de réplica única en un array evita ambos problemas. Cuando un nodo falla o entra en mantenimiento, el pool se traslada a otro nodo como una unidad, y las tareas posteriores, como el reequilibrio, se ejecutan mediante flujos de trabajo nativos de Kubernetes. Portworx no ha publicado los tiempos de conmutación por error.
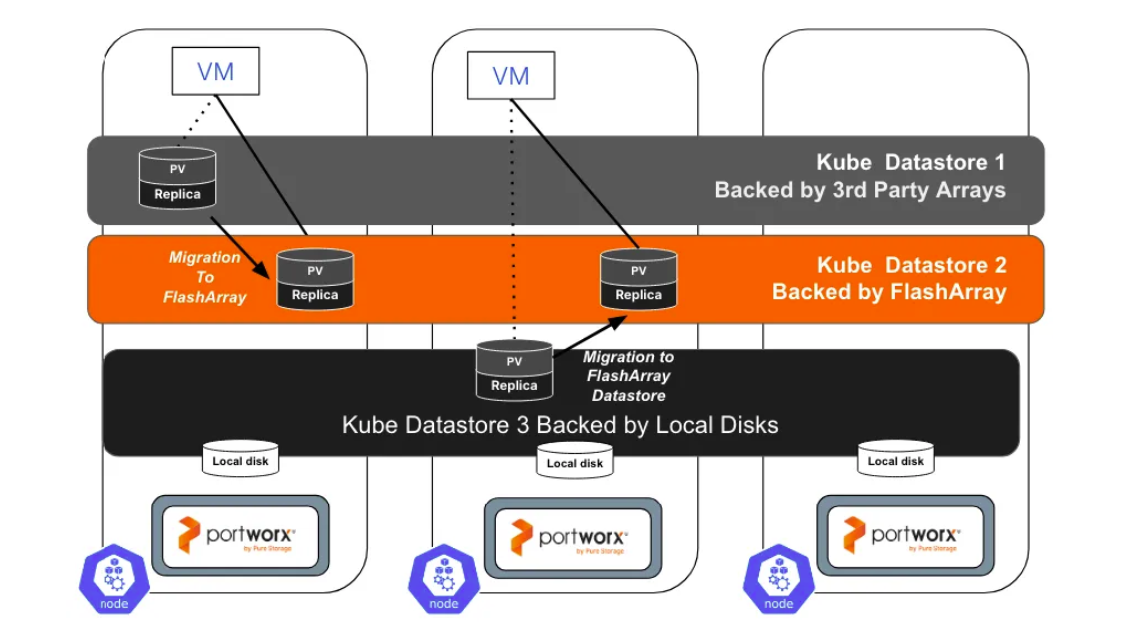
Portworx publica un perfil de escalabilidad para Enterprise 3.7.2: se recomiendan hasta 12 grupos de almacenamiento por nodo, con un límite máximo de 16; hasta 150 volúmenes y 300 instantáneas por grupo; hasta 700 volúmenes conectados por nodo; y hasta 5,000 volúmenes conectados por clúster. KDS funciona con KubeVirt y OpenShift Virtualization.
Portworx lo combina con la migración nativa de matrices desde VMware mediante FlashArray XCOPY, que según la compañía es hasta 12 veces más rápida que la ruta predeterminada, migrando una máquina virtual de 2 TB en aproximadamente dos horas en lugar de más de un día. Estas cifras son del proveedor y no las hemos realizado ni auditado.
“Nuestras últimas innovaciones, incluido Kube Datastore, ayudan a los clientes a simplificar la gestión del almacenamiento, recuperarse más rápidamente de los fallos de infraestructura y utilizar el almacenamiento de forma más eficiente”, afirmó Greg Muscarella, director general de Portworx en Everpure.
Volúmenes preconfigurados para cargas de trabajo de IA
Los volúmenes preconfigurados se utilizan para minimizar el tiempo de espera antes de que se inicie un servicio de inferencia, ya que los pesos del modelo, que suelen ocupar decenas o cientos de gigabytes, a menudo se vuelven a descargar después de que un pod se instala en un nuevo nodo. Un equipo de plataforma carga un volumen fuente con un paquete de modelos versionado procedente de un repositorio aprobado, y Portworx distribuye copias locales a los nodos de trabajo elegibles y confirma que cada una esté lista.
Un pod de inferencia se programa únicamente en un nodo que ya contiene su copia, y las políticas de almacenamiento seleccionan dicha copia cuando se inicia o se mueve una carga de trabajo. Everpure afirma que este enfoque reduce los retrasos de inicio relacionados con el almacenamiento y acelera la recuperación en entornos donde las cargas de trabajo de IA se programan, mueven o reinician con frecuencia. Portworx prevé tener volúmenes preconfigurados en el primer trimestre de 2027, aunque indica que el alcance y los plazos podrían variar, y no ha publicado cifras sobre el tiempo de inicio.
Centro de operaciones y soporte de respaldo
El centro de operaciones de Portworx, una única interfaz dentro del clúster, ahora cuenta con una vista de observabilidad que abarca el inventario de grupos, el progreso de la migración en vivo y el estado de la hiperconvergencia. Se complementa con una vista de topología que asigna nodos de almacenamiento, grupos, volúmenes, cargas de trabajo y máquinas virtuales con el estado de salud de cada objeto, y una vista de alertas que combina las alertas de Portworx y Prometheus con filtros de gravedad, radio de impacto y tipo de recurso.
Portworx también está abriendo la plataforma a herramientas de copia de seguridad de terceros bajo un modelo BYOB (Bring Your Own Backup) basado en el seguimiento de bloques modificados de Kubernetes (KEP-3314), que permite que un producto de copia de seguridad copie solo los bloques que han cambiado. Esta compatibilidad llegará con Portworx Enterprise 3.8.0, previsto para principios de 2027, y Portworx no ha especificado los productos de copia de seguridad con los que funcionará. Portworx Backup 3.2.0, previsto para su disponibilidad general en noviembre, añade la restauración selectiva de archivos para máquinas virtuales de Windows y redes IPv6 y de doble pila.
Soporte para Red Hat OpenShift 5
Red Hat ha lanzado OpenShift 5, y Everpure afirma que Portworx es socio de lanzamiento, con soporte disponible desde el lanzamiento general tanto para Portworx Enterprise como para Portworx CSI. Portworx ya forma parte de OpenShift en productos como los dispositivos de IA de borde de Supermicro . Everpure también mencionó que IDC la nombró líder en el IDC MarketScape 2026 para software de gestión de infraestructura y datos de contenedores.


 Amazon