

Qualcomm Technologies tuvo una agenda muy apretada durante su Día del Inversor 2026, presentando una ambiciosa estrategia para centros de datos basada en tres anuncios clave: la adquisición de la empresa de software de IA Modular Inc., la presentación de la CPU Dragonfly C1000 y la ampliación de su cartera de aceleradores de inferencia, y el fortalecimiento de sus alianzas con Hugging Face y Meta. En conjunto, estas iniciativas demuestran la intención de Qualcomm de competir en toda la infraestructura de IA, desde el silicio hasta el software y el ecosistema.
Qualcomm adquirirá Modular Inc.
Qualcomm ha firmado un acuerdo definitivo para adquirir Modular Inc., una empresa de software de IA cuya plataforma está diseñada para permitir una ejecución eficiente de la IA en arquitecturas de hardware heterogéneas. Se espera que la transacción se cierre en la segunda mitad de 2026, sujeta a las aprobaciones regulatorias y a las condiciones de cierre habituales.
Modular fue fundada por ingenieros que contribuyeron a proyectos fundamentales de infraestructura de IA y ha creado una pila de software abierta y nativa de IA que funciona en arquitecturas de CPU, GPU, NPU y ASIC personalizadas sin que los desarrolladores tengan que reescribir el código para cada plataforma. La portabilidad de la plataforma es un factor diferenciador clave, que permite a las organizaciones desarrollar una vez e implementar en cualquier entorno, reduciendo así el coste total de propiedad.
Esta adquisición aborda una limitación creciente en la implementación de la IA. Según Qualcomm, la eficiencia, y no la capacidad bruta, se está convirtiendo en el factor limitante: el rendimiento por vatio determina el coste de la inferencia, y la eficiencia del software se está convirtiendo en una palanca fundamental para escalarla económicamente. La plataforma de Modular está diseñada precisamente para aprovechar esta palanca, transformando el rendimiento del silicio en una inferencia eficiente en entornos de computación heterogéneos y desagregados.
Para la estrategia de centros de datos de Qualcomm, este acuerdo refuerza su capacidad de ofrecer inferencia, orquestación e implementación optimizadas en una amplia gama de plataformas, desde dispositivos periféricos hasta proveedores de hiperescala que requieren un rendimiento constante en diversos entornos de hardware. La comunidad de desarrolladores de Modular, que Qualcomm describe como abierta, orientada a la industria e independiente de proveedores, amplía aún más su alcance en el ecosistema de desarrolladores de IA.
Plataforma de centro de datos y CPU Dragonfly C1000
Qualcomm presentó el Dragonfly C1000, una CPU para centros de datos diseñada específicamente en torno a sus núcleos Oryon personalizados, orientada a la orquestación de IA automatizada, cargas de trabajo de servidor de propósito general y aplicaciones de nodo principal de IA. El procesador se basa en una arquitectura multichiplet con más de 250 núcleos, opera a frecuencias superiores a 5 GHz y está diseñado para ofrecer un rendimiento por vatio más del doble que el de las CPU para servidores de la competencia, según las especificaciones publicadas.
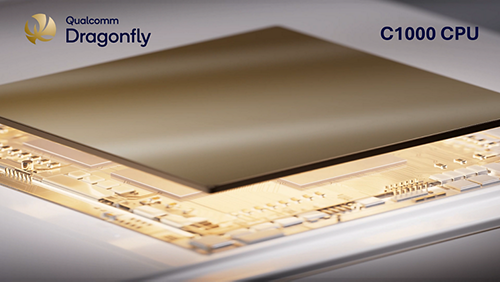
El C1000 admite conectividad PCIe Gen 7 a más de 2 TB/s, además de compatibilidad con CXL para la desagregación de memoria y la integración de almacenamiento y redes de alta velocidad. Su subsistema de memoria está diseñado para ofrecer un alto ancho de banda, capacidad y eficiencia energética mediante tecnología de memoria de bajo consumo de vanguardia. La plataforma admite refrigeración por aire y líquida, y cumple con los estándares OCP ORv3 para racks y servidores. Entre sus características de fiabilidad se incluyen ECC, aislamiento de fallos y recuperación de errores para un funcionamiento robusto a gran escala. Su disponibilidad comercial está prevista para 2028.
El C1000 se ofrece en tres configuraciones: una CPU agencial optimizada para la orquestación de alto rendimiento y la IA interactiva de baja latencia; una CPU de propósito general orientada al rendimiento por TCO para cargas de trabajo propias y elasticidad de vCPU para uso de terceros; y una CPU de nodo principal de IA diseñada para maximizar la utilización de XPU a través del procesamiento del host de baja sobrecarga sobre interconexiones de alta velocidad.
Computación de alto ancho de banda (HBC) de Qualcomm
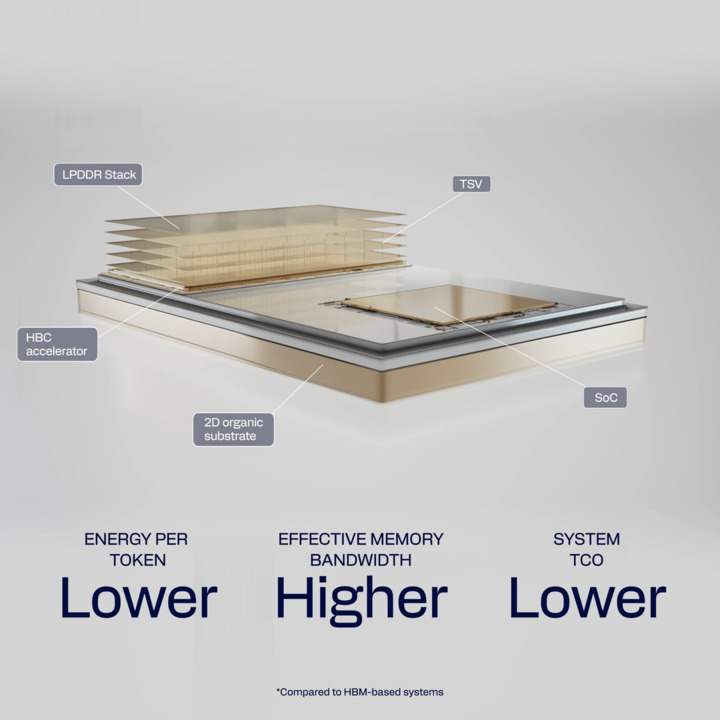
La arquitectura High Bandwidth Compute (HBC) de Qualcomm, un diseño de computación cercana a la memoria que combina la computación con un ancho de banda de memoria acelerado en una solución de silicio apilada en 3D, es un elemento central en la hoja de ruta de aceleradores de inferencia de Qualcomm. HBC se posiciona como una alternativa directa a HBM, y Qualcomm afirma que ofrece un ancho de banda por vatio 6 veces mayor que HBM y una capacidad por vatio 200 veces mayor que SRAM, según comparaciones normalizadas a nivel de tarjeta y rack con respecto a las especificaciones publicadas por la competencia.
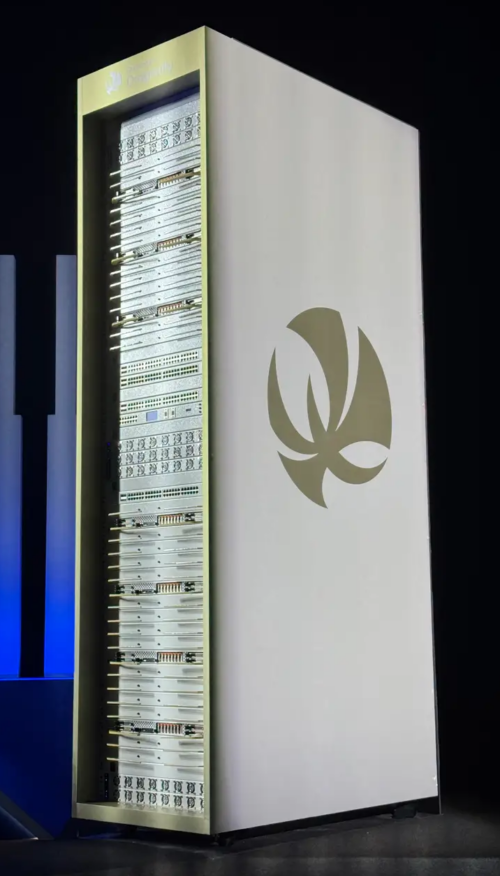
La HBC Gen 1, integrada en la Dragonfly AI250, ofrece un ancho de banda de memoria efectivo de 133 TB/s por tarjeta, lo que representa un aumento de 18 veces con respecto a la AI200 con LPDDR5X. La HBC Gen 2, integrada en la recién anunciada AI300, ofrece un aumento de 54 veces con respecto a la AI200. Se espera que las muestras comerciales de HBC Gen 1 con la AI250 estén disponibles a mediados de 2027.
Libélula AI300
La AI300 es la tercera generación de la plataforma de inferencia de IA a escala de rack de Qualcomm, tras la AI200 y la AI250, anunciadas en octubre de 2025. Integra HBC Gen 2 para la aceleración de la computación con mayor ancho de banda y capacidad de memoria efectiva, orientada a la inferencia de modelos de lenguaje y modelos multimodales de gran tamaño, así como a cargas de trabajo de IA agentes. Qualcomm prevé un ancho de banda de memoria por vatio y por tarjeta entre 4 y 8 veces superior al de las arquitecturas basadas en GPU existentes. La AI300 admite la escalabilidad vertical mediante UALink y ESUN, y la escalabilidad horizontal mediante interconexiones de cobre y ópticas. Se espera que las muestras comerciales estén disponibles en 2028.
Conectividad
La cartera de conectividad para centros de datos de Qualcomm abarca interconexiones de chip a chip, cobre, ópticas y de alcance de campus, compatibles con anchos de banda de 800G y 1.6T en aplicaciones ópticas, AOC y AEC, con un alcance de hasta 20 km. Esta cartera se basa en las capacidades de Qualcomm de SerDes, PAM4, DSP coherent-lite e integridad de señal para abordar los cuellos de botella en el movimiento de datos que definen cada vez más el rendimiento en infraestructuras de IA distribuidas y desagregadas.
Silicona personalizada
Qualcomm también presentó una oferta de chips personalizados dirigida a proveedores de servicios en la nube y grandes empresas, con diseños a medida para IA automatizada y cargas de trabajo especializadas. El programa abarca el codiseño integral de chips, sistemas y software, con encapsulados avanzados y arquitecturas modulares diseñadas para reducir el tiempo de comercialización y el riesgo de ejecución mediante el soporte de fabricación a gran escala.
Colaboraciones: Hugging Face y Meta
Abrazando la cara
Qualcomm anunció la ampliación de su alianza estratégica con Hugging Face, estructurada en torno a tres pilares que abarcan sus familias de productos Snapdragon, Dragonwing y Dragonfly. Esta colaboración busca conectar las plataformas de Qualcomm para la integración de dispositivos y centros de datos con la comunidad de desarrolladores de Hugging Face, compuesta por 16 millones de personas, y su biblioteca de más de 3 millones de modelos abiertos.
El primer pilar conecta los servicios de almacenamiento e inferencia de Hugging Face con la infraestructura de centros de datos basada en Qualcomm Dragonfly, creando una ruta directa desde la experimentación de modelos hasta el despliegue en producción de aplicaciones y agentes. El segundo pilar se centra en la automatización del despliegue de modelos: se prevé que los modelos de IA del ecosistema de Hugging Face se integren en las plataformas de Qualcomm mediante un flujo de trabajo basado en agentes que gestiona la configuración, la optimización y el despliegue sin necesidad de integración manual. Esto tiene como objetivo simplificar el despliegue en smartphones, PC, dispositivos portátiles, sistemas industriales, plataformas automotrices e infraestructura de centros de datos desde un único flujo de trabajo.
El tercer pilar se centra en la orquestación de IA basada en agentes en entornos híbridos. Qualcomm y Hugging Face planean respaldar un marco de IA distribuida en el que los agentes operen en sistemas locales y en la nube, enrutando dinámicamente modelos y flujos de trabajo según los requisitos de rendimiento, coste, privacidad y latencia. Como parte de la colaboración, Hugging Face ofrecerá a los clientes que utilicen dispositivos o sistemas en la nube con tecnología Qualcomm acceso a Hugging Face PRO. Los desarrolladores también podrán acceder a los componentes y herramientas de software de IA de Modular a través del ecosistema de Hugging Face, conectando directamente la adquisición de Modular con esta alianza.
Meta
Qualcomm y Meta anunciaron una colaboración estratégica multigeneracional en la que Qualcomm suministrará procesadores para centros de datos a Meta. El Dragonfly C1000 impulsará la flota de servidores de próxima generación de Meta, lo que representa un importante logro de diseño para las ambiciones de Qualcomm en el ámbito de los procesadores para centros de datos y valida el posicionamiento de la plataforma para implementaciones a gran escala y escalables en términos de rendimiento y eficiencia.
Además de Meta, más de 35 socios del ecosistema en toda la cadena de suministro de tecnología e IA han expresado su apoyo a la visión de Qualcomm sobre los centros de datos, incluidos Arista, Lenovo, Micron Technology, Samsung SDS, SK hynix America, Supermicro, VAST Data y otros que abarcan fabricantes de diseño original, proveedores de memoria, proveedores de redes y proveedores de infraestructura de IA.
Qualcomm se ha comprometido con una hoja de ruta para centros de datos de varias generaciones con una periodicidad anual, en la que el Dragonfly AI300 se une al AI200 y al AI250 en una línea de aceleradores de inferencia que seguirá evolucionando junto con la plataforma de CPU C1000 y el conjunto de software de Modular.


 Amazon