

Supermicro anunció la ampliación de su capacidad de fabricación a escala de rack y la mejora de sus capacidades de refrigeración líquida directa para dar soporte a las próximas plataformas NVIDIA Vera Rubin NVL72 y NVIDIA HGX Rubin NVL8. La compañía está optimizando esta estrategia para acortar los plazos de implementación de infraestructuras de IA de alta densidad mediante la combinación de diseño y fabricación propios en EE. UU. con su enfoque de Soluciones de Bloques de Construcción para Centros de Datos (DCBBS) y una pila de tecnología integral de refrigeración líquida.
Charles Liang, director ejecutivo de Supermicro, enfatizó que la colaboración de la compañía con NVIDIA y su metodología de diseño de bloques de construcción buscan acelerar la entrega de plataformas avanzadas de IA. También destacó la expansión de la capacidad de fabricación de Supermicro y su experiencia en refrigeración líquida como factores clave para implementaciones eficientes, fiables y a gran escala de los sistemas Vera Rubin y Rubin en entornos empresariales y de hiperescala.
Buque insignia a escala de rack: NVIDIA Vera Rubin NVL72 SuperCluster
En el extremo superior, Supermicro soportará el SuperCluster NVIDIA Vera Rubin NVL72. Este sistema a escala de rack integra 72 GPU NVIDIA Rubin y 36 CPU NVIDIA Vera, además de SuperNIC NVIDIA ConnectX-9 y DPU NVIDIA BlueField-4. La plataforma utiliza NVIDIA NVLink 6 para la coherencia intrarack. Está diseñada para escalar horizontalmente sobre NVIDIA Quantum-X800 InfiniBand y NVIDIA Spectrum-X Ethernet, en línea con la tendencia actual de la industria hacia diseños de rack como sistema para entrenamiento, inferencia e IA agente a escala.
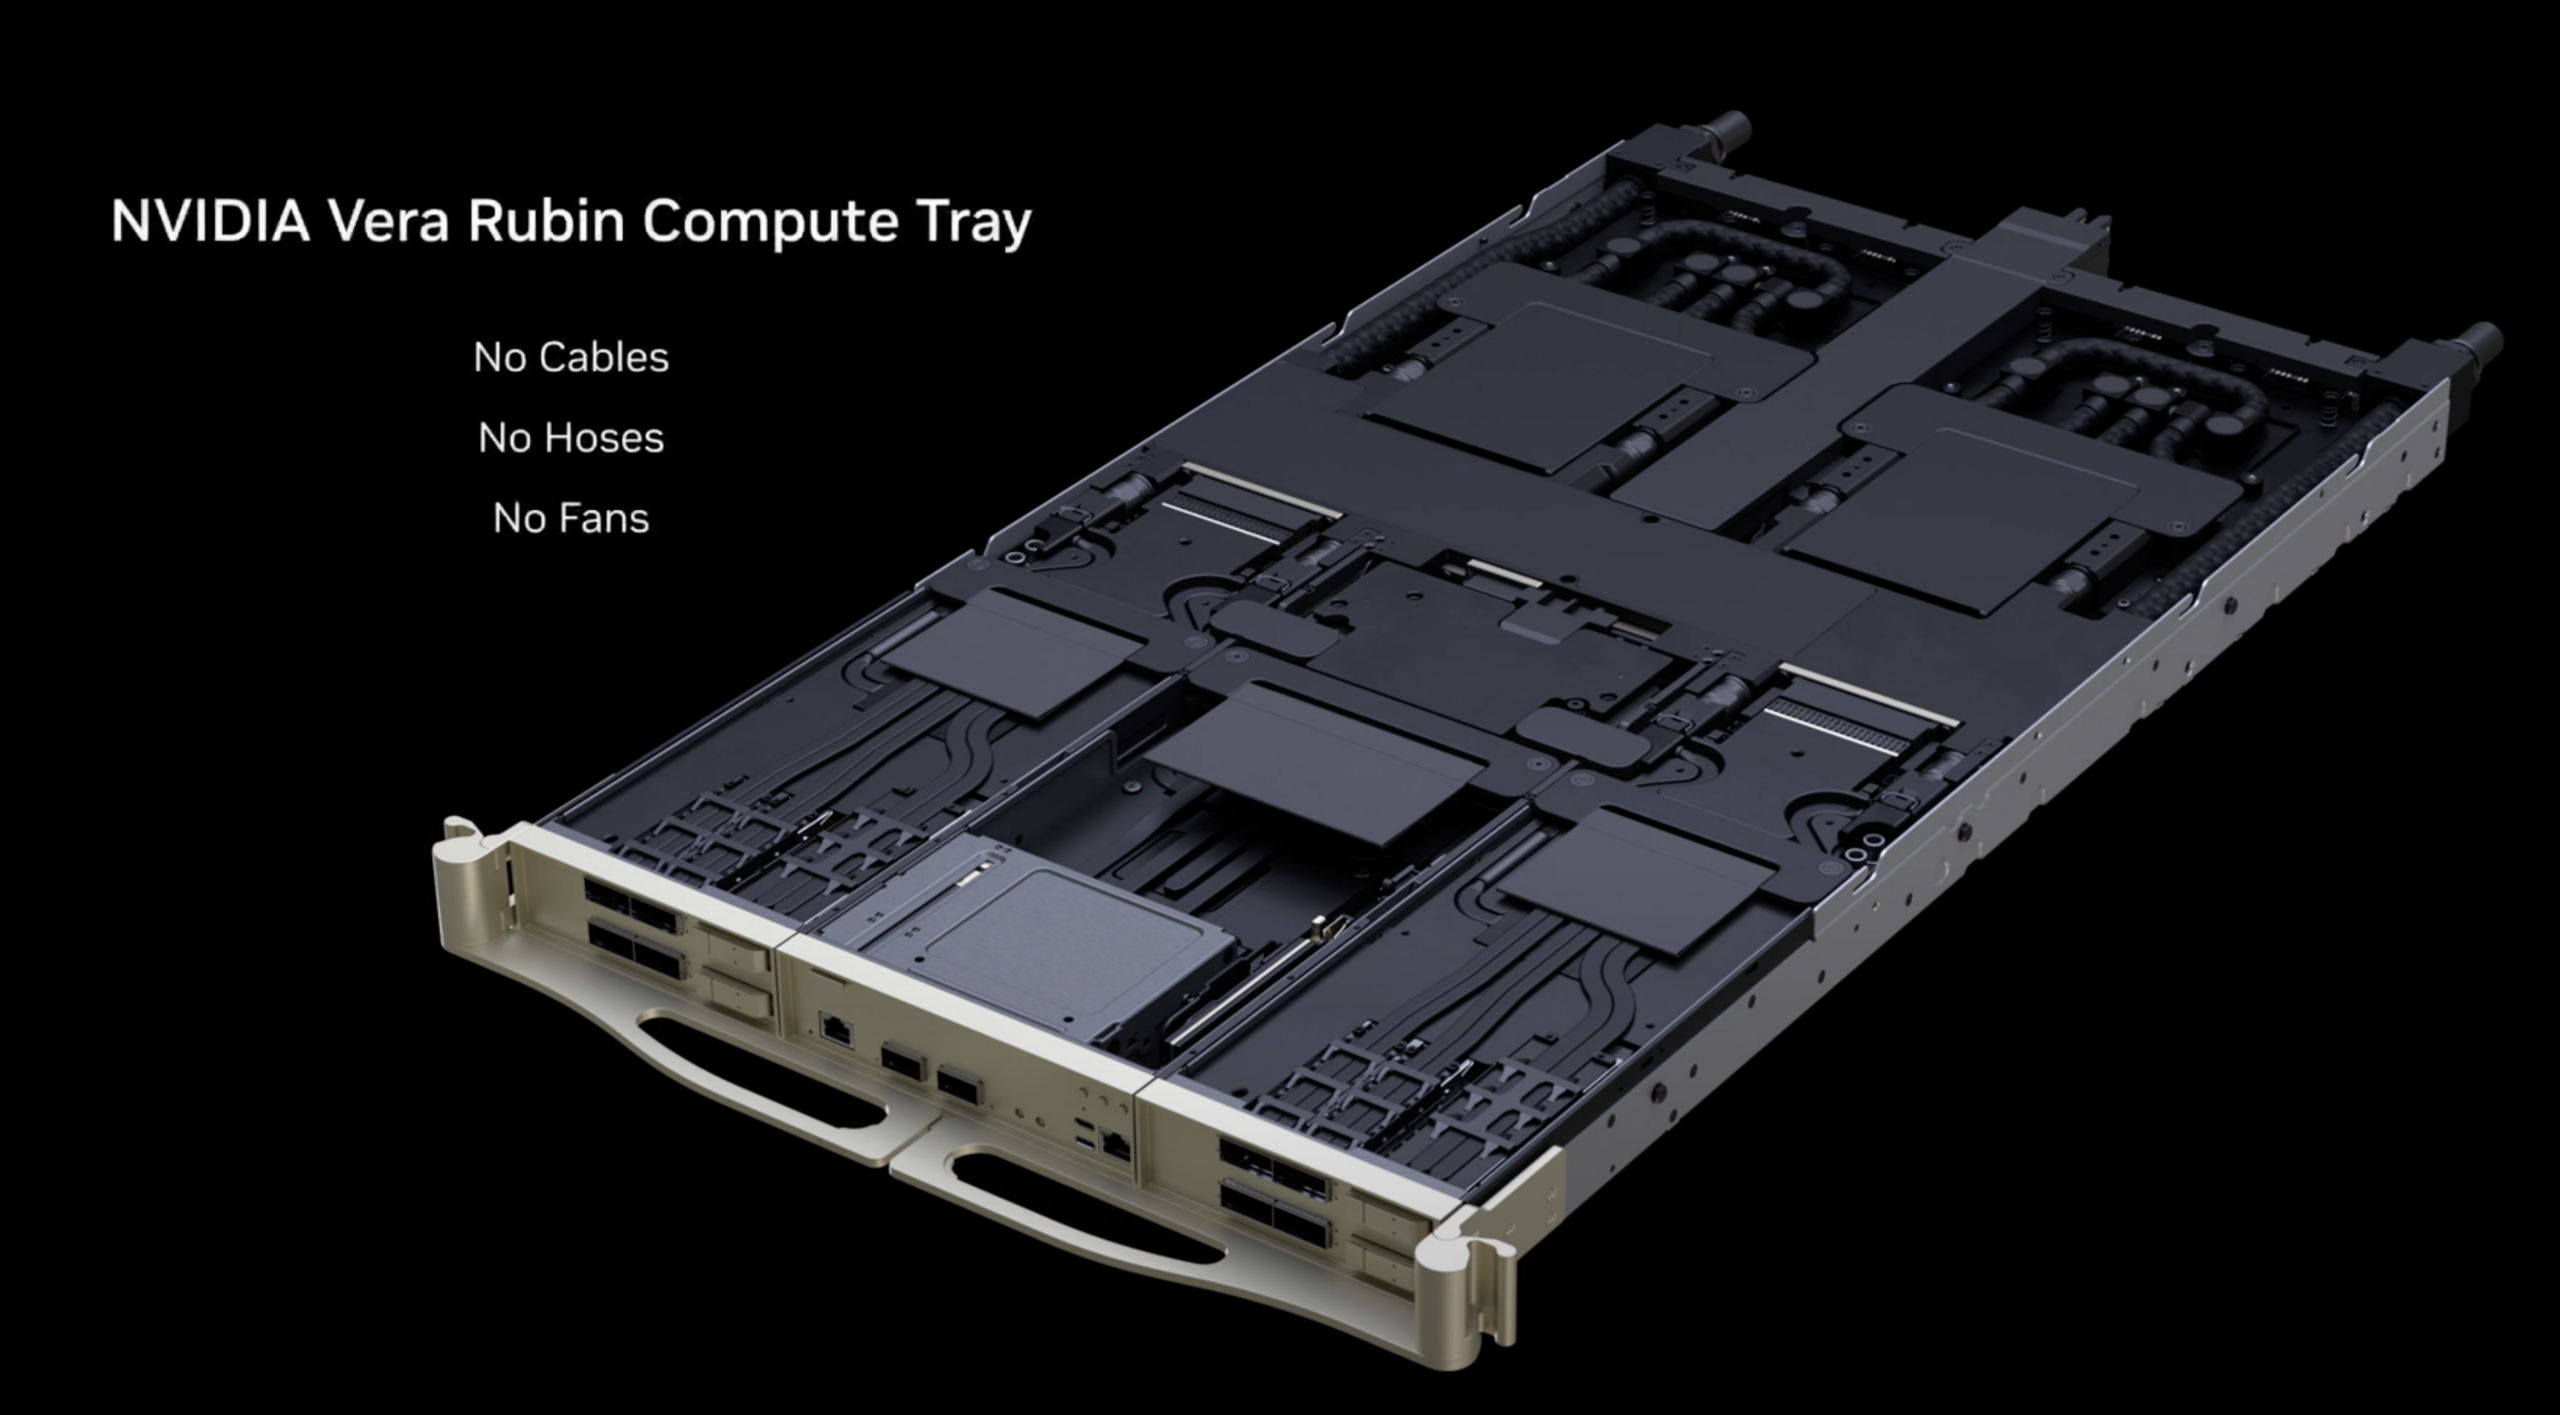
NVIDIA estima la configuración NVL72 en 3.6 exaflops de rendimiento NVFP4, respaldado por 1.4 PB/s de ancho de banda HBM4 y 75 TB de memoria rápida. La implementación de Supermicro se basa en la arquitectura de rack NVIDIA MGX de tercera generación, priorizando la facilidad de mantenimiento, la fiabilidad y la disponibilidad para soportar operaciones sostenidas del clúster.
La refrigeración es fundamental en el diseño. Supermicro incorpora una pila de refrigeración líquida mejorada a escala de centro de datos con unidades de distribución de refrigerante (CDU) en fila. El objetivo es permitir una refrigeración por agua caliente escalable que reduzca el consumo de energía y agua, manteniendo la densidad y un rendimiento predecible bajo cargas de trabajo intensas de IA.
Computación densa compacta: NVIDIA HGX Rubin NVL8 de 2U con refrigeración líquida
Para empresas y proveedores de servicios que buscan un componente más modular, Supermicro también presentó los sistemas NVIDIA HGX Rubin NVL8 2U con refrigeración líquida. Esta plataforma de 8 GPU está diseñada para cargas de trabajo de IA y HPC, y NVIDIA ofrece un rendimiento NVFP4 de 400 petaflops. La plataforma ofrece 176 TB/s de ancho de banda HBM4 y 28.8 TB/s de ancho de banda NVLink, con 1600 Gb/s de conectividad de red NVIDIA ConnectX-9 mediante SuperNIC.
Supermicro ofrece un diseño a escala de rack diseñado para preservar la flexibilidad de implementación, con opciones de configuración que incluyen CPU x86 de gama alta, incluyendo procesadores Intel Xeon y AMD EPYC de última generación. La compañía también destacó un diseño de busbar 2U de alta densidad para integración en rack, combinado con la tecnología de refrigeración líquida directa (DLC) de Supermicro para soportar mayores niveles de potencia sostenida sin sacrificar la facilidad de mantenimiento.
Características de la plataforma Vera Rubin
El soporte de la plataforma de Supermicro se alinea con varias capacidades clave de la era Vera Rubin que impactan directamente en el diseño del clúster y la planificación operativa, entre ellas:
- NVIDIA NVLink 6 es una estructura de interconexión de alta velocidad que permite un mayor ancho de banda y una menor latencia para la comunicación entre GPU y CPU. Esto es especialmente relevante para el entrenamiento y la inferencia de modelos de mezcla de expertos muy grandes, donde los patrones de comunicación pueden determinar el rendimiento a gran escala.
- La CPU NVIDIA Vera incorpora núcleos ARM diseñados por NVIDIA y, según se afirma, duplica el rendimiento de la generación anterior. Esta CPU admite multihilo espacial con 88 núcleos y 176 hilos, además de un ancho de banda de memoria LPDDR5X de 1.2 TB/s y una mayor capacidad de memoria. Vera también mejora el acoplamiento entre CPU y GPU con un ancho de banda NVLink-C2C de 1.8 TB/s a las GPU, lo que se considera el doble que la generación anterior.
- El motor Transformer de tercera generación de NVIDIA se centra en la aceleración de contexto largo y precisión limitada, lo cual se ha vuelto crucial a medida que la inferencia moderna migra hacia sesiones persistentes, pipelines multiagente y mayor concurrencia. La plataforma también incorpora computación confidencial de tercera generación, descrita como computación confidencial a escala de rack con un entorno de ejecución confiable unificado a nivel de GPU que protege y aísla modelos, datos e indicaciones. Para los operadores que implementan IA en flujos de trabajo regulados, la computación confidencial y el aislamiento de los límites de ejecución de la GPU son criterios de selección de plataforma cada vez más importantes.
- El motor RAS de segunda generación permite mejoras en la confiabilidad, que incluyen monitoreo avanzado del estado y verificaciones en tiempo real para reducir el tiempo de inactividad. En entornos densos con refrigeración líquida, la detección de fallas y la facilidad de mantenimiento son esenciales, ya que las ventanas de mantenimiento son costosas y la tolerancia operativa a la inestabilidad es baja.
Redes: fotónica Ethernet Spectrum-X y rendimiento a escala de rack
Supermicro también vinculó el soporte de su plataforma Rubin con la tecnología Spectrum-X Ethernet Photonics de NVIDIA, basada en el ASIC Ethernet Spectrum-6. NVIDIA especifica una conmutación de 102.4 Tb/s en TSMC de 3 nm, con óptica SerDes de 200 G en paquete conjunto y búferes totalmente compartidos.
El objetivo declarado es mejorar la eficiencia y la estabilidad operativa en comparación con los sistemas ópticos enchufables tradicionales. NVIDIA menciona una eficiencia energética 5 veces mayor, una confiabilidad 10 veces mayor y un tiempo de actividad de las aplicaciones 5 veces mayor. NVIDIA presentó varios modelos de conmutadores, incluyendo el SN6800 con refrigeración líquida (CPO de 409.6 Tb/s con 512 puertos de 800 G), el SN6810 (CPO de 102.4 Tb/s con 128 puertos de 800 G) y el SN6600 (sistema óptico enchufable, 128 puertos de 800 G, disponible en configuraciones de refrigeración por aire o por líquido). Para los operadores de centros de datos, estos diseños apuntan hacia estructuras Ethernet de 800 G de mayor densidad con características térmicas y energéticas mejoradas, lo cual es cada vez más relevante a medida que la potencia de la red front-end se convierte en una parte medible de los presupuestos de rack.
Integración de almacenamiento para fábricas de IA
En cuanto al almacenamiento, Supermicro destacó soluciones complementarias basadas en su servidor de almacenamiento all-flash a petaescala y sistemas JBOF. Estas plataformas son compatibles con las DPU NVIDIA BlueField-4 y una gama de soluciones de gestión de datos, integrando el almacenamiento y la red con la misma arquitectura acelerada a escala de rack que utiliza la capa de computación.
Si bien Supermicro no proporcionó cifras de rendimiento de las plataformas de almacenamiento en este anuncio, el énfasis en la integración señala un movimiento continuo hacia diseños de pila completa validados en los que la computación, la red y el almacenamiento están calificados juntos para implementaciones de fábricas de IA.
Escala de fabricación y tiempo de puesta en línea
El tema operativo del anuncio es el rendimiento de fabricación y la velocidad de implementación. Las instalaciones ampliadas y el sistema de refrigeración líquida de Supermicro están diseñados para optimizar la producción y la entrega de las plataformas Vera Rubin y Rubin con refrigeración líquida. Al mismo tiempo, la arquitectura modular DCBBS permite una rápida configuración, validación y escalabilidad. Para los compradores técnicos empresariales, el factor diferenciador reside menos en una única especificación de chasis y más en la previsibilidad de la entrega, la repetibilidad de la construcción de racks y la reducción del tiempo desde la recepción del equipo hasta la puesta en servicio de producción estable.
Supermicro apuesta a que, a medida que la refrigeración líquida se convierta en la opción predeterminada para la densidad de IA de primer nivel, los proveedores que puedan industrializar la fabricación y validación a escala de rack estarán mejor posicionados para respaldar implementaciones a gran escala sin ciclos de integración extendidos.


 Amazon