

Supermicro anunció hoy, junto con IBM y NVIDIA, una solución de almacenamiento en caché KV que traslada el estado clave-valor de la inferencia de contexto largo de la GPU a una capa compartida totalmente flash. El paquete combina servidores de almacenamiento Supermicro Petascale con procesadores AMD EPYC 9005, IBM Storage Scale, NVIDIA Dynamo y NVIDIA Spectrum-X Ethernet, y las compañías lo respaldan con una arquitectura de referencia validada que IBM publicó como Redbook. El dato más destacado es una reducción de 56 veces en el tiempo para obtener el primer token en solicitudes de 130 000 tokens, en comparación con una GPU que recalcula el contexto desde cero.
¿Por qué KV Cache necesita una capa de almacenamiento?
La inferencia se ejecuta en dos fases: la precarga convierte la solicitud en tokens y los procesa a través del modelo para generar los estados clave-valor intermedios; y la decodificación genera la respuesta token a token en función de esos estados. Mantener el estado clave-valor en una caché persistente permite que el sistema lo reutilice para el siguiente turno, el siguiente paso del agente o la siguiente solicitud que comparta el mismo contexto, evitando así el recálculo.
Los flujos de trabajo basados en agentes, los asistentes de codificación, las aplicaciones RAG de contexto largo y las aplicaciones de múltiples turnos generan suficiente estado como para saturar rápidamente la memoria de la GPU y la CPU, razón por la cual Supermicro, IBM y NVIDIA están creando una capa de almacenamiento en red.
En este diseño, NVIDIA Dynamo gestiona la jerarquía de caché y transfiere bloques a través de NIXL; IBM Storage Scale Erasure Code Edition proporciona la capa de archivos compartidos; y los servidores Petascale suministran la memoria flash y los carriles PCIe Gen5 que la respaldan. Supermicro afirma que las tres compañías probaron la pila a nivel de clúster con alta concurrencia y tráfico de red con vecinos ruidosos, y presenta el resultado como una solución llave en mano con integración en rack de fábrica e implementación in situ que, según afirma, reduce el tiempo de implementación de semanas a días.
La configuración probada
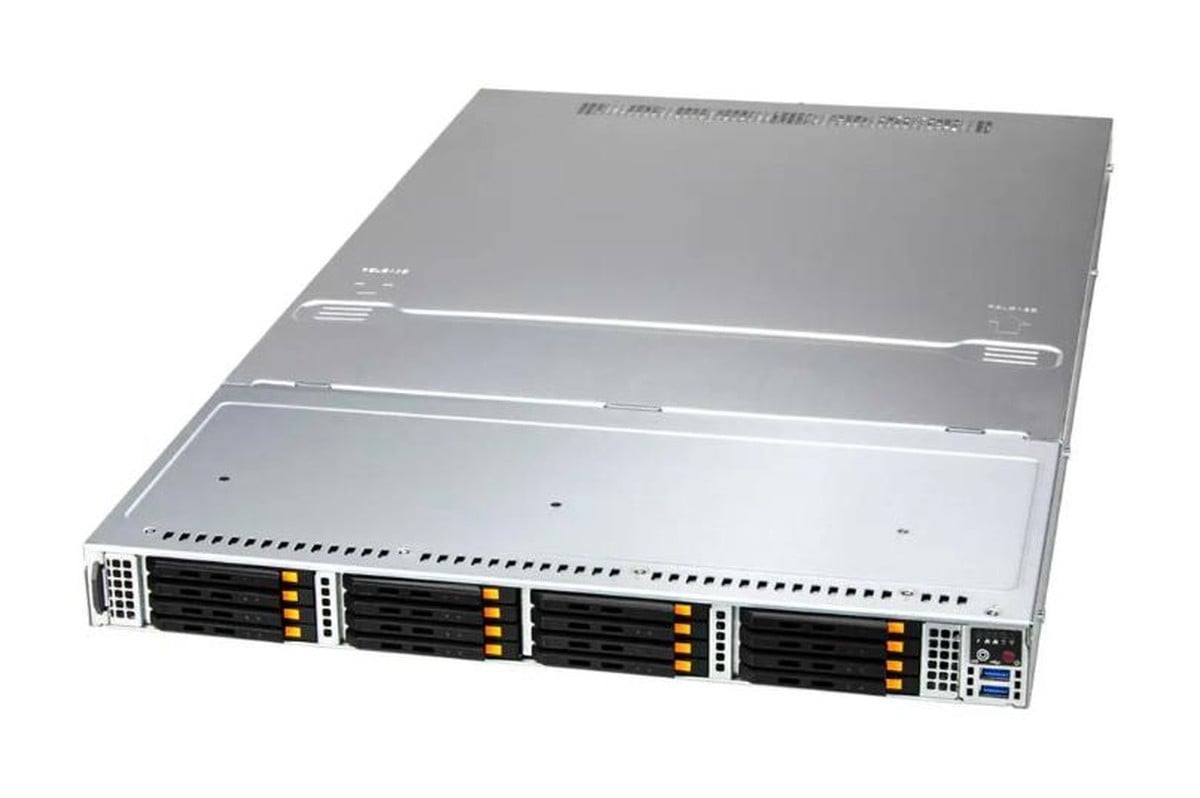
La arquitectura de referencia utiliza ocho nodos Supermicro ASG-1115S-NE316R Petascale, cada uno un sistema 1U con un único AMD EPYC 9535 y 16 unidades NVMe Micron E3.S de 7.68 TB, lo que proporciona 122.88 TB de memoria flash bruta en cada nodo y aproximadamente 983 TB en total entre los ocho. Cada nodo cuenta con un NVIDIA BlueField-3 B3220 de doble puerto y 200 Gb en el lado del cliente y un ConnectX-7 de 400 Gb para el almacenamiento, con tres conmutadores Spectrum-X SN5600 en una configuración spine-and-leaf y enlaces ascendentes de 800 Gb/s.
Los nodos de almacenamiento ejecutan RHEL 9.6 e IBM Storage Scale ECE 6.0.0.1 en una configuración de código de borrado 8+2P, e IBM sitúa el rendimiento de lectura de este nivel de ocho nodos en 315 GB/s según pruebas anteriores.
| Componente | Arquitectura de referencia de caché KV (según las pruebas realizadas) |
|---|---|
| Nivel de almacenamiento | |
| Nodos de almacenamiento | 8x Supermicro ASG-1115S-NE316R (1U, un solo zócalo) |
| CPU por nodo | AMD EPYC 9535, 128 líneas PCIe Gen5 (64 para NVMe, 64 para red) |
| Memoria flash por nodo | 16 discos Micron E3.S NVMe de 7.68 TB (122.88 TB brutos) |
| Red por nodo | NVIDIA BlueField-3 B3220, doble puerto de 200 Gb (lado del cliente) NVIDIA ConnectX-7 de 400 GB (sistema de almacenamiento) |
| Cambio | 3x NVIDIA Spectrum-X SN5600, arquitectura spine-and-leaf, enlaces ascendentes de 800 Gb/s |
| Software de almacenamiento | IBM Storage Scale Erasure Code Edition 6.0.0.1, 8+2P RHEL 9.6 |
| Cliente de inferencia | |
| Sistema | Supermicro SYS-212GB-FNR (NVIDIA MGX), Ubuntu 24.04 |
| GPU utilizada para las pruebas de rendimiento | 1x NVIDIA RTX PRO 6000 Blackwell, 19.6 GiB restantes para caché KV después de pesos y gráficos CUDA. |
| Red de contactos con clientes | 2x NVIDIA BlueField-3 B3140H de 400 Gb/s, hasta 80 GB/s de ancho de banda orientado al cliente. |
| Modelo y software | openai/gpt-oss-120b (MXFP4) vLLM 0.14.1 NVIDIA Dynamo 0.9.0 con NIXL Cliente de evaluación comparativa NVIDIA AIPerf |
| Niveles de caché | Los niveles de host y local se establecen en cero; los 1.4 millones de tokens almacenados en caché se sirven desde el nivel de escala de almacenamiento. |
El cliente de referencia es un único sistema Supermicro SYS-212GB-FNR MGX, y los resultados provienen de una GPU NVIDIA RTX PRO 6000 Blackwell en ese equipo, que ejecuta el modelo openai/gpt-oss-120b en MXFP4 bajo vLLM 0.14.1 y Dynamo 0.9.0.
Tras los pesos y los gráficos CUDA, quedaron 19.6 GiB de memoria de GPU para la caché KV, suficiente para aproximadamente 1.14 millones de tokens en la propia GPU. Para las pruebas, la memoria del host y los niveles locales se establecieron en cero, de modo que cada bloque en caché provenía de Storage Scale, por lo que los resultados miden la ruta de almacenamiento por sí sola, sin la ayuda de una jerarquía mixta.
56x en tiempo para el primer token, 22x en rendimiento
Sin caché, el tiempo hasta el primer token para el modelo 120B aumentó de 0.572 segundos con 10 000 tokens de entrada a 32.14 segundos con 130 000, ya que la GPU recalculó el contexto completo. Con la caché KV en Storage Scale, el TTFT se mantuvo entre 0.193 y 0.57 segundos en el mismo rango, que es la cifra de 56x en la marca de 130 000 tokens y la dispersión de 0.377 segundos que Supermicro cita en su anuncio. IBM, Supermicro y NVIDIA realizaron estas pruebas, y nosotros no realizamos ni auditamos los resultados.
La prueba de rendimiento envió 200 solicitudes a través de 28 conexiones simultáneas, extraídas de 100 solicitudes únicas que sumaban un total de 24 millones de tokens y 825 GB de datos de caché KV, con la caché inicialmente vacía. La línea base de recálculo finalizó a 0.19 solicitudes por segundo en 1,048 segundos; el nivel de escala de almacenamiento finalizó a 4.26 solicitudes por segundo en 46.94 segundos, una mejora de 22 veces que incluye el coste de arranque en frío para llenar la caché.
En una tercera prueba, se añadieron cuatro clientes que generaban 200 GB/s de tráfico de red no relacionado a través de la misma estructura. La configuración con caché procesó 3.6 solicitudes por segundo y tardó 55.56 segundos en procesar las 200 solicitudes, aproximadamente nueve segundos más lento que la prueba inicial y aún 18 veces más lento que la configuración de referencia. IBM atribuye esta pequeña penalización a que la estructura Spectrum-X aísla el tráfico de caché de la carga en segundo plano.
«Las aplicaciones de IA génica y de contexto extenso dependen de la reutilización eficiente del contexto en múltiples pasos, y NVIDIA Dynamo ayuda a orquestar la inferencia distribuida para que las empresas puedan obtener un mayor rendimiento útil de cada GPU», afirmó Shruti Koparkar, Directora de Producto de Inferencia de IA de NVIDIA. «Al combinar NVIDIA Dynamo y Ethernet Spectrum-X con servidores de almacenamiento Supermicro Petascale e IBM Storage Scale, esta solución de caché KV crea una capa de almacenamiento compartido de alto rendimiento que puede reducir la computación redundante, mejorar el tiempo de respuesta inicial y ayudar a los clientes a escalar servicios de inferencia de IA resilientes».
Tallas y lo que no se refleja en las cifras
La guía de dimensionamiento de IBM establece una configuración de cuatro nodos en 4+2P con un 67 por ciento de capacidad utilizable para modelos de 7B a 34B y hasta 64 GPU; la configuración probada de ocho nodos en 8+2P y un 80 por ciento utilizable para modelos de 70B a 120B y de 100 a 256 GPU que necesitan de 100 a 300 GB/s de ancho de banda de lectura; y 16 o más nodos en 16+3P y un 84 por ciento utilizable para modelos más grandes y 300 o más GPU a 300 GB/s o más. Storage Scale ECE se escala desde tres servidores de almacenamiento hasta 256.
La configuración de prueba con una sola GPU es la principal limitación. La arquitectura de referencia está dimensionada para cientos de GPU, pero todos los resultados del artículo provienen de una sola RTX PRO 6000 frente a una capa flash de ocho nodos y 983 TB que IBM califica a 315 GB/s, por lo que el almacenamiento no estaba ni cerca de la saturación, y las pruebas no muestran cómo se comporta el TTFT cuando un clúster completo de GPU accede a la caché simultáneamente.
Supermicro no ha publicado precios ni fecha de disponibilidad para la solución empaquetada, y el anuncio no proporciona cifras de utilización de la GPU. Este enfoque se sitúa en el mismo terreno que la aceleración de caché KV integrada en Dynamo de DDN en el AI400X3M , con la diferencia de que esta pila se ejecuta en servidores Supermicro estándar y Ethernet bajo el sistema de archivos de IBM.
«A medida que las cargas de trabajo de IA se expanden desde el entrenamiento hasta la inferencia, las empresas y las neoclouds que implementan cargas de trabajo de inferencia de alto rendimiento, características de la IA agente y la IA generativa de contexto extenso y múltiples turnos, necesitan eliminar los cuellos de botella para mejorar la eficiencia de la GPU», afirmó Charles Liang, presidente y director ejecutivo de Supermicro. «Nuestra solución con IBM y NVIDIA demuestra claramente estas ventajas de rendimiento».



 Amazon