

Podría decirse que AMD llegó primero: los mini PC y portátiles Strix Halo se enviaban con 128 GB de memoria unificada mucho antes de que NVIDIA entrara en escena. Pero la categoría de ordenador de sobremesa con IA local es una que NVIDIA creó de facto cuando metió un superchip Grace Blackwell en una caja de un litro y lo llamó DGX Spark . La propuesta era sencilla: una máquina de clase desarrolladora con suficiente memoria unificada para albergar modelos potentes, ubicada en un escritorio en lugar de depender de la nube. El AMD Ryzen AI Halo es la respuesta de AMD a esa máquina. AMD lo anunció junto con la serie Ryzen AI Max PRO 400 en mayo de 2026; las reservas anticipadas se abrieron en junio exclusivamente a través de Micro Center , con disponibilidad en tienda el 10 de julio. El Ryzen AI Halo llega con un tamaño similar, 128 GB de memoria unificada, un precio de 3,999 dólares y una breve lista de decisiones que lo convierten en una propuesta significativamente diferente a la del Spark.
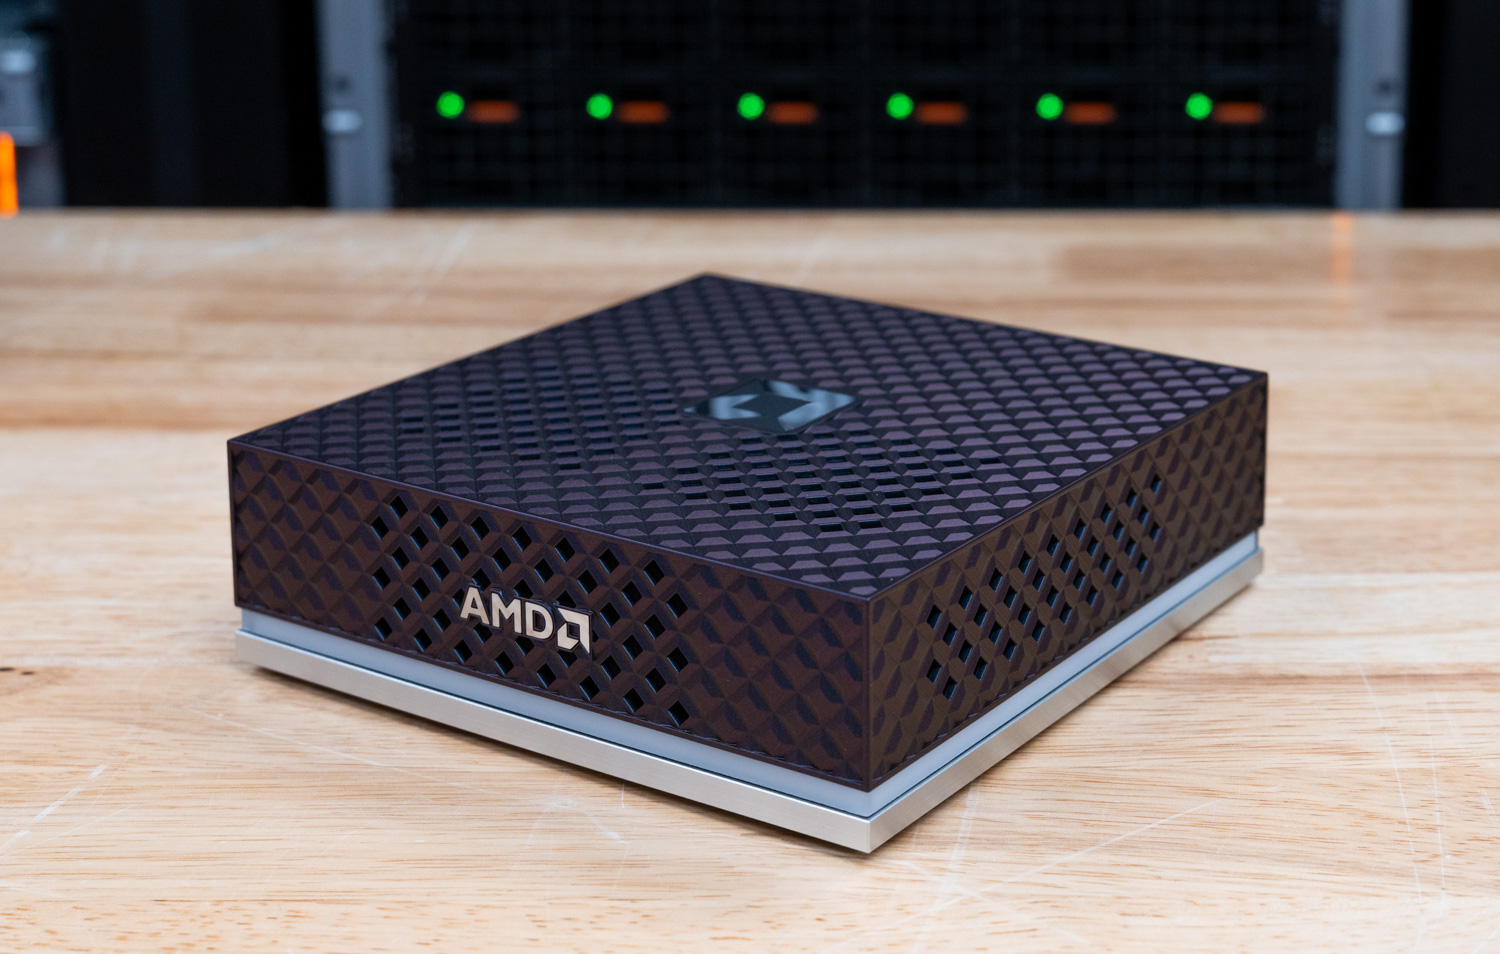
AMD presenta Halo como su primera plataforma de desarrollo de IA, ofreciendo a los desarrolladores una vía rápida y sencilla para crear y ejecutar IA localmente. En su interior se encuentra el Ryzen AI Max+ 395, un procesador "Zen 5" de 16 núcleos y 32 hilos con gráficos integrados Radeon 8060S (40 unidades de cómputo RDNA 3.5) y una NPU XDNA 2 con una potencia nominal de 50 TOPS, todo ello dentro de una plataforma que AMD comercializa con un rendimiento de IA combinado de hasta 126 TOPS. Los 128 GB de LPDDR5x funcionan a 8000 MT/s, proporcionando un ancho de banda de 256 GB/s, y toda la plataforma se alimenta mediante una única entrada USB-C de 120 W. AMD afirma que la memoria es suficiente para almacenar modelos con hasta 200 mil millones de parámetros en la memoria del dispositivo. Se trata de una miniestación de trabajo x86 completa, que es la clave de la diferencia más importante.
La diferencia radica en Windows. El Spark ejecuta el sistema operativo DGX de NVIDIA, basado en Linux, y nada más; el Halo arranca Windows 11 o la imagen de desarrollo de Linux de AMD en el mismo hardware. La compatibilidad nativa con Windows fue la petición más frecuente que escuchamos de quienes consideraban adquirir un Spark, y esto redefine el público objetivo de este dispositivo. El posicionamiento de AMD subraya lo mismo: Windows y Linux frente a la compatibilidad exclusiva con Linux del Spark ( al menos por ahora ).
Tres decisiones más distinguen al Halo del Spark, y cada una aborda una queja que hemos escuchado sobre el modelo anterior. El Halo utiliza una unidad SSD M.2 2280 estándar en lugar de la unidad 2242 menos común que incorpora el Spark, lo que ofrece una gama mucho más amplia de opciones de terceros, incluyendo capacidades de 8 TB, para quienes deseen reemplazar la unidad. Viene con la memoria gráfica variable preconfigurada a su asignación máxima en ambos sistemas operativos, por lo que los modelos grandes se cargan sin necesidad de ajustes manuales. Además, el chasis está rodeado por un anillo de estado iluminado, una pequeña corrección respecto a las unidades Spark oscuras y sin iluminación que algunos compradores recibieron, dependiendo del fabricante. El coste del enfoque de AMD se refleja en la parte posterior de la caja, donde no hay interconexión de alta velocidad, solo 10 GbE, lo que limita las posibilidades de la agrupación en clústeres multinodo. Estas son las ventajas y desventajas, y definen las cargas de trabajo para las que está diseñada esta máquina antes de ejecutar cualquier prueba de rendimiento.
En cuanto al precio, los matices son importantes. El Halo tiene un precio de lista de $3,999 con una SSD de 2 TB, lo que lo sitúa en el rango de precios habitual para un sistema Spark básico. La comparación depende de a qué Spark te refieras. El DGX Spark de NVIDIA, con la unidad de mayor capacidad, ahora ronda los $4,700, un cambio vinculado a la escasez de suministro de LPDDR5X y NAND. Los sistemas Grace Blackwell básicos de ASUS y otras marcas todavía se venden por alrededor de $4,000 y están disponibles en Amazon hoy (enlace de afiliado). Comparado con el estándar de la categoría, el Halo está a la par, y su éxito se basa en las decisiones anteriores, más que en ofrecer precios más bajos que la competencia.
Sometimos el Halo a la prueba de la suite de IA local de StorageReview tanto en Windows como en Linux, y los resultados se presentan junto con el análisis de diseño y software a lo largo de esta reseña.
Puntos Clave
- La alternativa x86 de doble sistema operativo: El Ryzen AI Halo es el único dispositivo de la categoría Spark que arranca Windows 11 o Linux en una plataforma x86 completa, con un precio de 3,999 dólares con una unidad SSD de 2 TB, frente a los 4,699 dólares de la DGX Spark Founders Edition.
- Memoria para almacenar modelos grandes: Los 128 GB de memoria unificada LPDDR5x-8000 a 256 GB/s admiten modelos de hasta 200 mil millones de parámetros localmente, con memoria gráfica variable preajustada para que los modelos grandes se carguen sin configuración manual.
- El Ryzen AI Max+ 395 más potente que hemos probado: El Halo superó al HP Z2 Mini G1a y al ZBook Ultra G1a en casi todas las cargas de trabajo de Windows, incluyendo 37,316 en Cinebench R23 multinúcleo, 184.2 GIPS en 7-Zip y las puntuaciones líderes en generación de texto (Phi 1,192) y generación de imágenes (SD 1.5 FP16 937) de Procyon AI.
- La CPU gana, la inferencia pierde frente a Spark: En Linux, el Halo superó al DGX Spark en rendimiento de CPU, comprimiendo un 11 % más rápido y descomprimiendo un 38 % más rápido en 7-Zip, y finalizando la compilación de LLVM un 14 % antes, pero se quedó atrás entre 2 y 4 veces en la mayoría de los escenarios de servicio vLLM con mayor concurrencia, llegando a ser 8.8 veces más lento en el trabajo de GPT OSS 120B con gran cantidad de prellenado.
- Almacenamiento funcional, red modesta: Una bahía M.2 2280 estándar permite actualizaciones posteriores de hasta 8 TB, aunque la plataforma, por diseño, reduce la velocidad del Micron 4600 Gen5 incluido a Gen4, y el único puerto 10GbE sin interconexión de alta velocidad descarta la agrupación en clústeres de varios nodos que permite el ConnectX-7 de 200 G del Spark.
Especificaciones
| Especificación | Sistema AMD Ryzen AI Halo |
|---|---|
| Procesador | |
| CPU | Procesador AMD Ryzen™ AI Max+ 395 16 núcleos / 32 hilos (arquitectura Zen 5) |
| GPU | Gráficos integrados AMD Radeon™ 8060S 40 unidades de cómputo (arquitectura RDNA™ 3.5) |
| NPU | NPU AMD XDNA™ 2 |
| Salud Cerebral | |
| Tipo de memoria | LPDDR5x |
| Capacidad de memoria | 128GB |
| velocidad de la memoria | 8000 MT / s |
| ancho de banda de memoria | 256GB / s |
| Almacenaje | |
| Almacenaje | SSD M.2 NVMe de 2 TB (SED) |
| Redes y conectividad | |
| Ethernet | 1 × 10 GbE |
| Wi-Fi | Wi-Fi 7 |
| Bluetooth | Bluetooth 5.4 |
| I / O | |
| USB | 3 × USB-C, 1 × USB-C (Entrada de alimentación) |
| Salida de pantalla | 1 × HDMI 2.1b |
| Sistema | |
| TDP | 120 W |
| Sistema operativo | Linux o Windows 11 |
| Dimensiones | 150 × 150 × 45.4 mm (5.9 × 5.9 × 1.79 pulgadas) |
| Peso | Menos de 1.2 kg (2.65 libras) |
Diseño y montaje de AMD Ryzen AI Halo
El sistema AMD Ryzen AI Halo utiliza un formato compacto, similar al de la NVIDIA Spark, con unas dimensiones de tan solo 150 × 150 × 45.4 mm y un peso inferior a 1.2 kg. El chasis de aluminio presenta un agresivo patrón de ventilación geométrica en la parte superior y frontal, lo que le confiere un aspecto distintivo y maximiza el flujo de aire hacia el sistema de refrigeración. A pesar de su reducido tamaño, la plataforma está diseñada como una estación de trabajo de IA de escritorio completa, capaz de gestionar aplicaciones de estación de trabajo, inferencia LLM local y cargas de trabajo de desarrollo de IA.
Frente
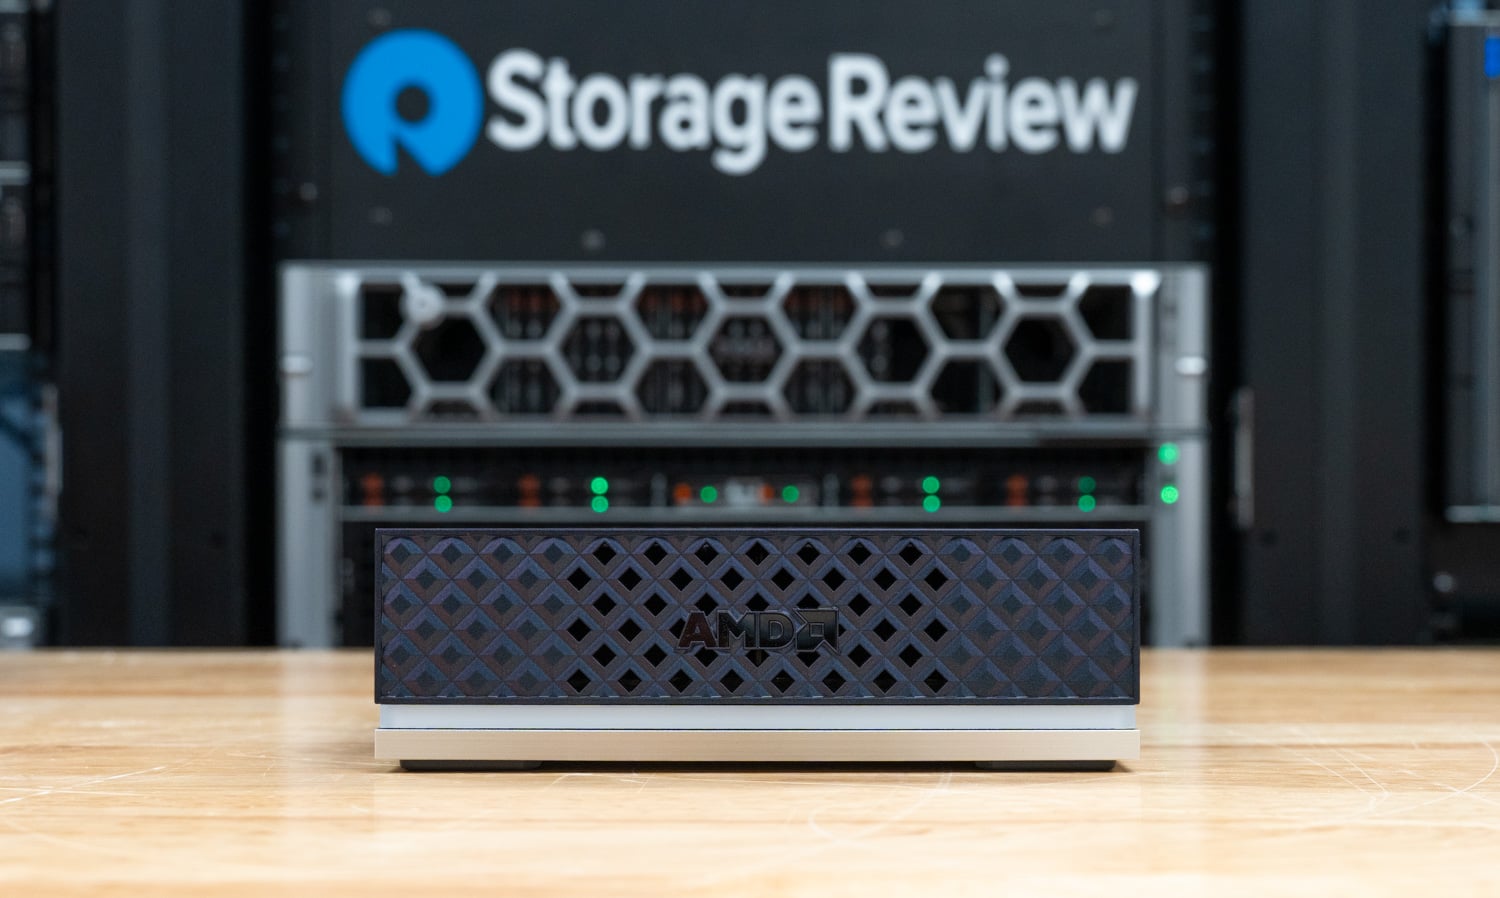
El frontal del sistema presenta un diseño minimalista, compuesto casi en su totalidad por una gran rejilla de ventilación que abarca todo el ancho del chasis. En lugar de ubicar puertos en el frontal, AMD dedica esta área al flujo de aire, permitiendo que el aire frío entre al sistema a través de la amplia entrada de aire con diseño especial, manteniendo así el frontal despejado. Un detalle plateado en la parte inferior del chasis proporciona un sutil contraste visual con la carcasa, que por lo demás es de color negro mate.
E / S trasera
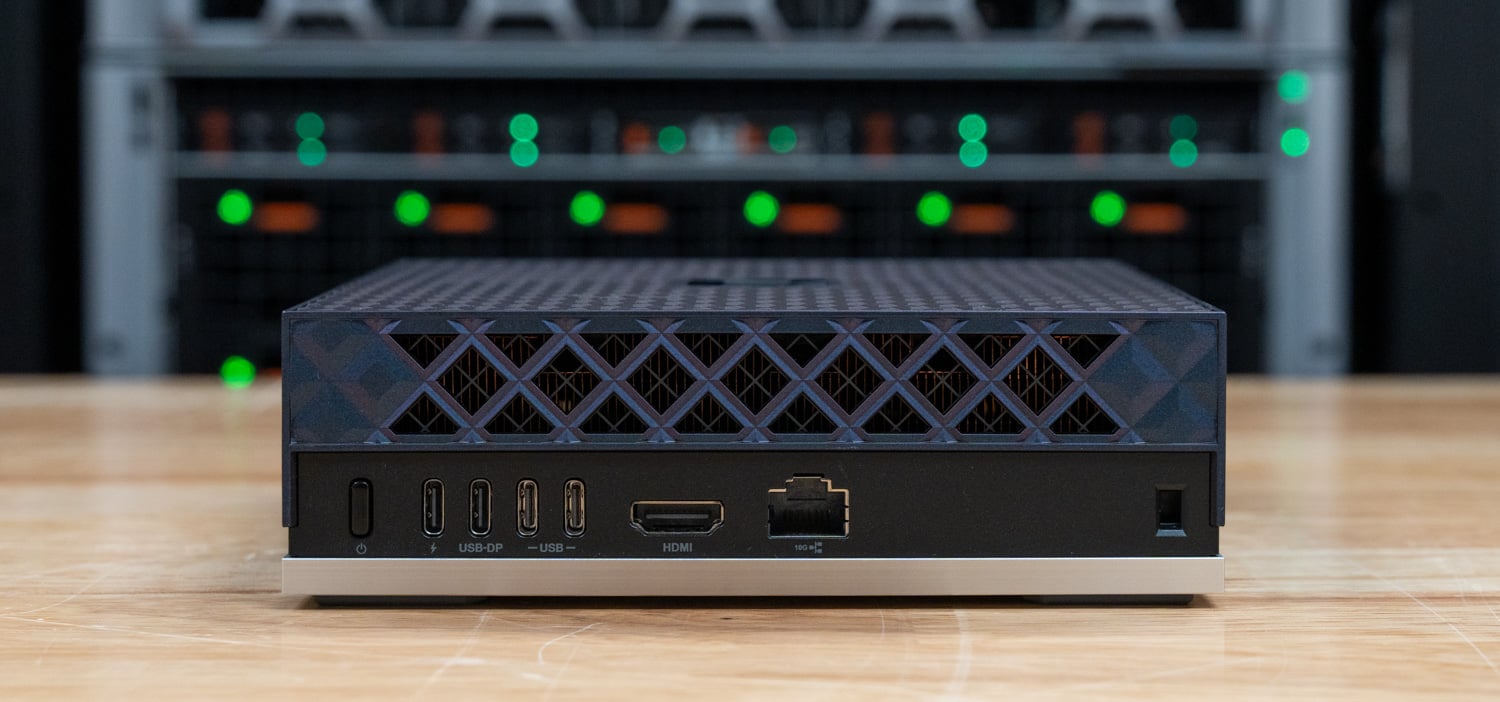
Todas las conexiones externas se encuentran en la parte posterior del sistema. De izquierda a derecha, el panel posterior incluye lo siguiente:
- Entrada de alimentación USB-C
- Puerto USB-C con modo alternativo DisplayPort
- Dos puertos USB-C adicionales
- Salida HDMI 2.1b
- Ethernet RJ45 de 10 GbE
- Ranura de bloqueo de seguridad Kensington
El sistema cuenta con tres puertos de datos USB-C y un conector de alimentación USB-C dedicado, lo que permite conectar simultáneamente varios periféricos y pantallas de alta velocidad. La salida de vídeo nativa HDMI 2.1b, junto con la interfaz Ethernet de 10 GbE integrada, hace que la plataforma sea ideal para la conectividad NAS de alta velocidad, la transferencia de conjuntos de datos de IA y entornos de desarrollo local.
Diseño interno
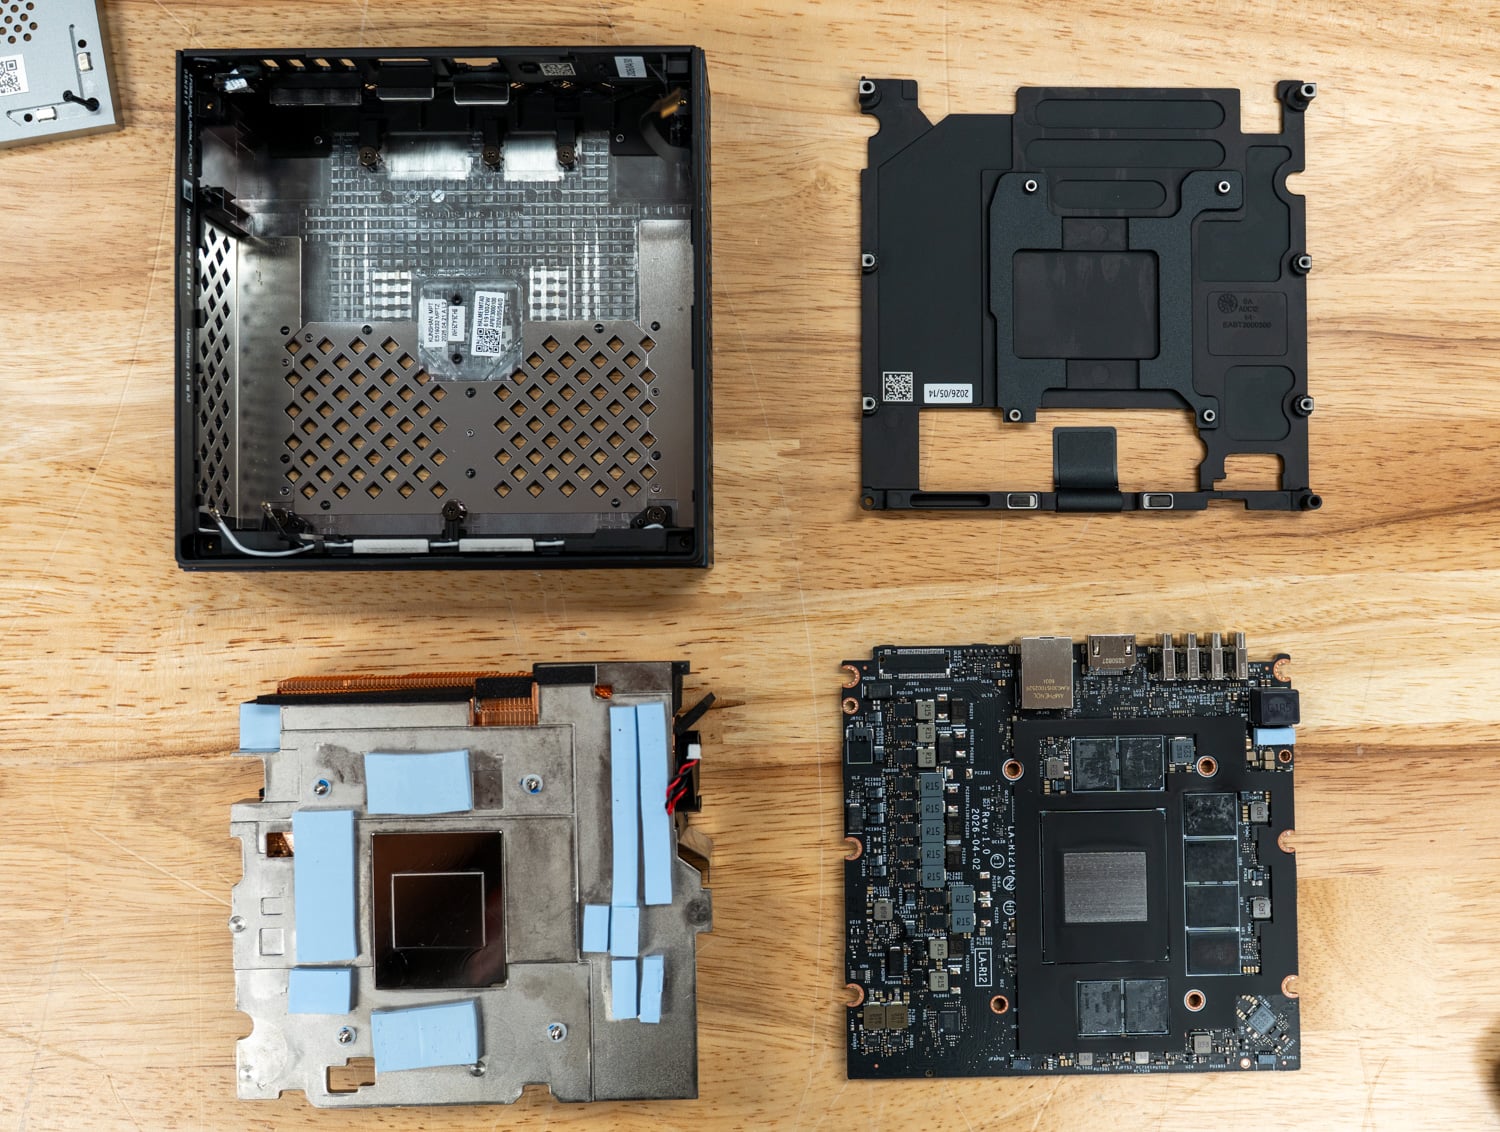
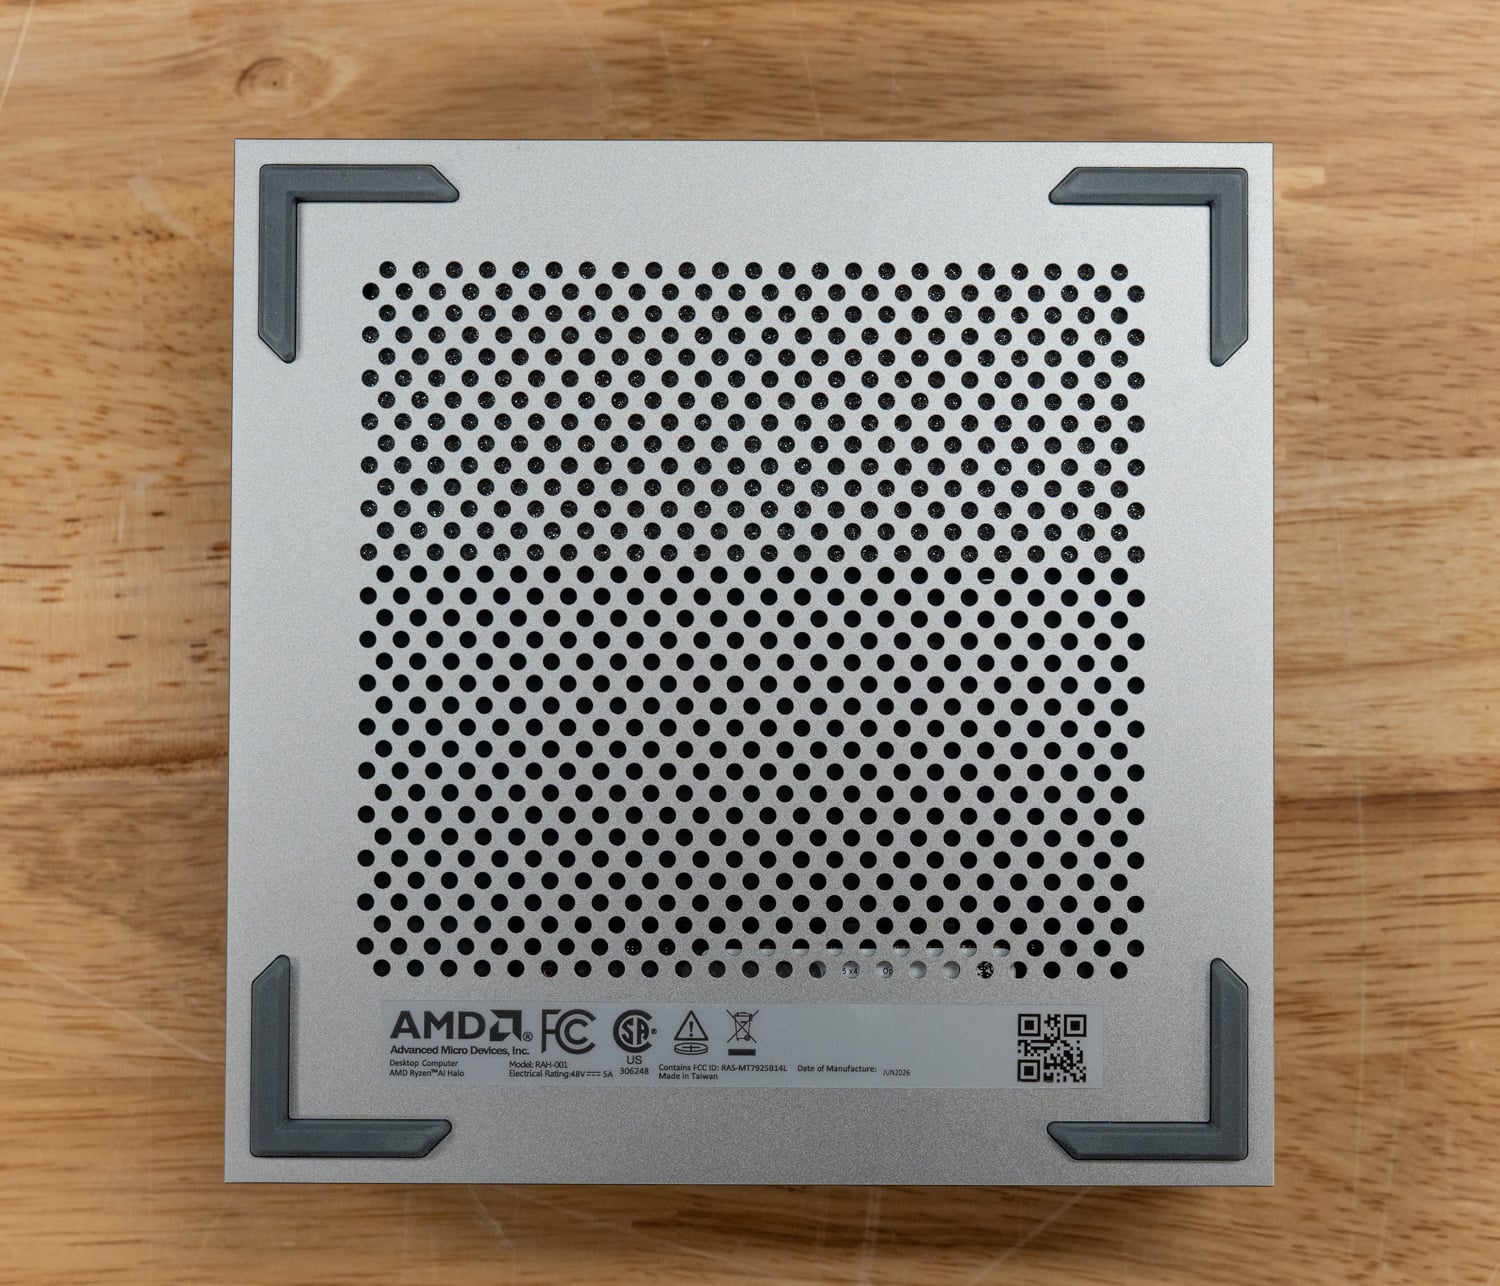
La parte inferior del Ryzen AI Halo cuenta con una gran rejilla de ventilación perforada que aspira aire para enfriar los componentes montados en la parte inferior de la placa, y cuatro patas de goma en las esquinas mantienen la unidad estable sobre un escritorio o estante.
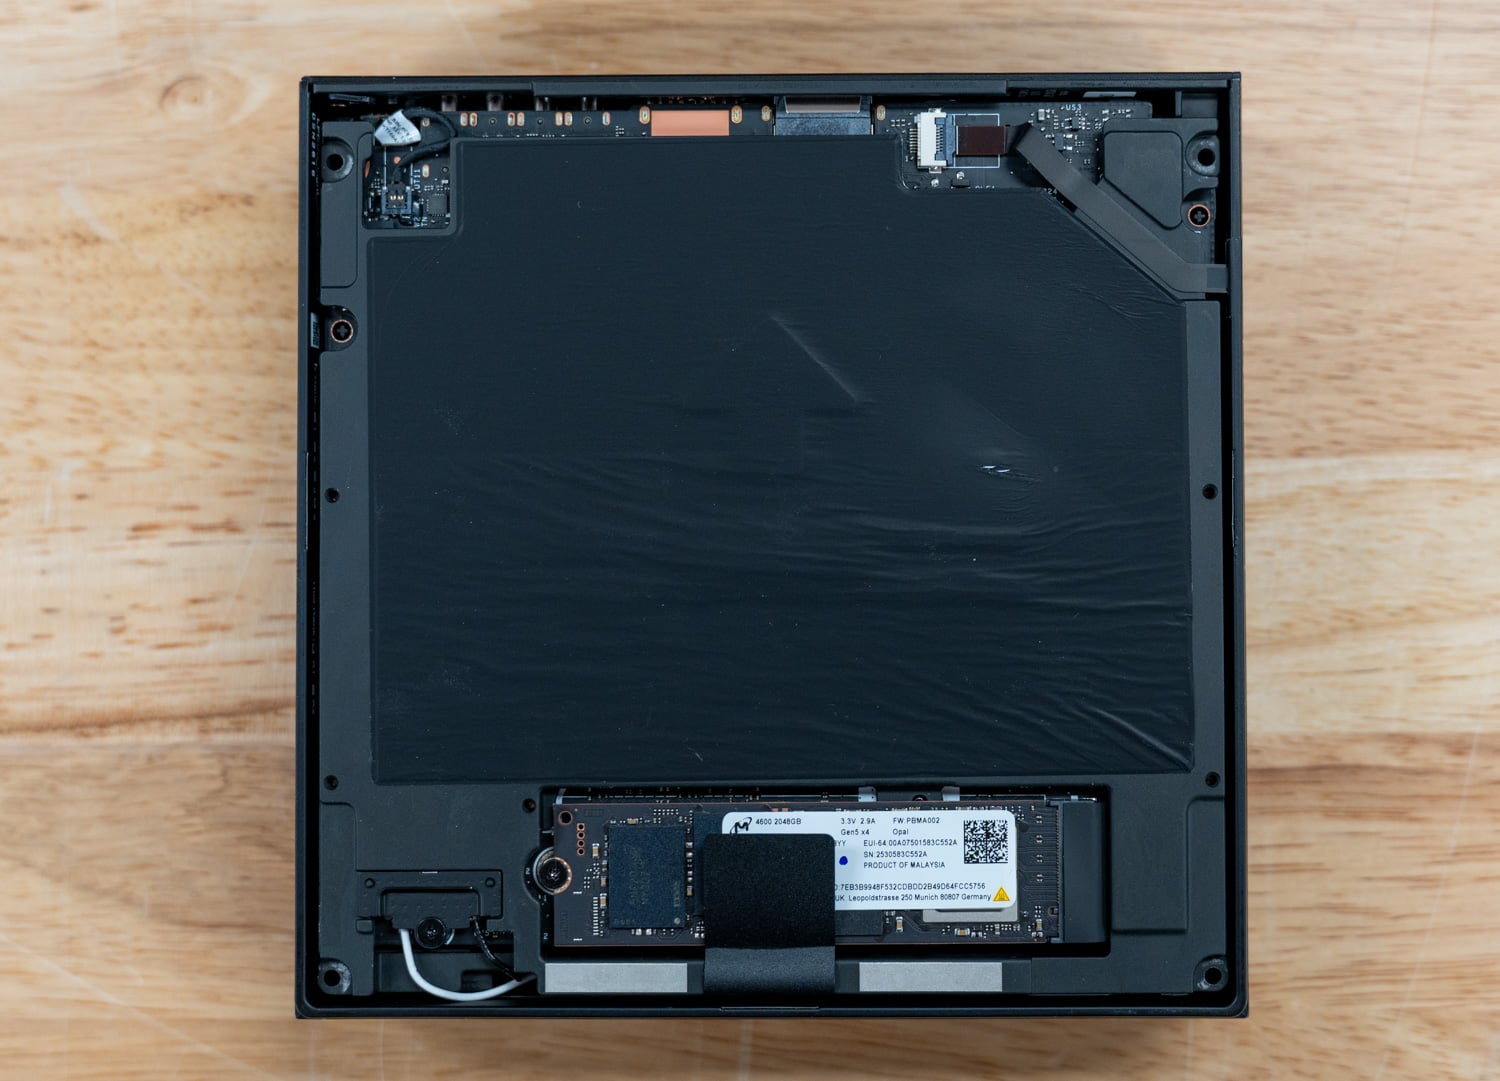
Al retirar los cuatro tornillos que sujetan el panel inferior, se descubre la bahía para SSD M.2 y algunos componentes de la placa base, incluido el conector de la tarjeta Wi-Fi. En la unidad que analizamos, esta ranura aloja una unidad SSD Micron 4600 de 2 TB Gen5 x4, mientras que una lámina adhesiva negra protege el resto de la placa de la parte inferior expuesta.
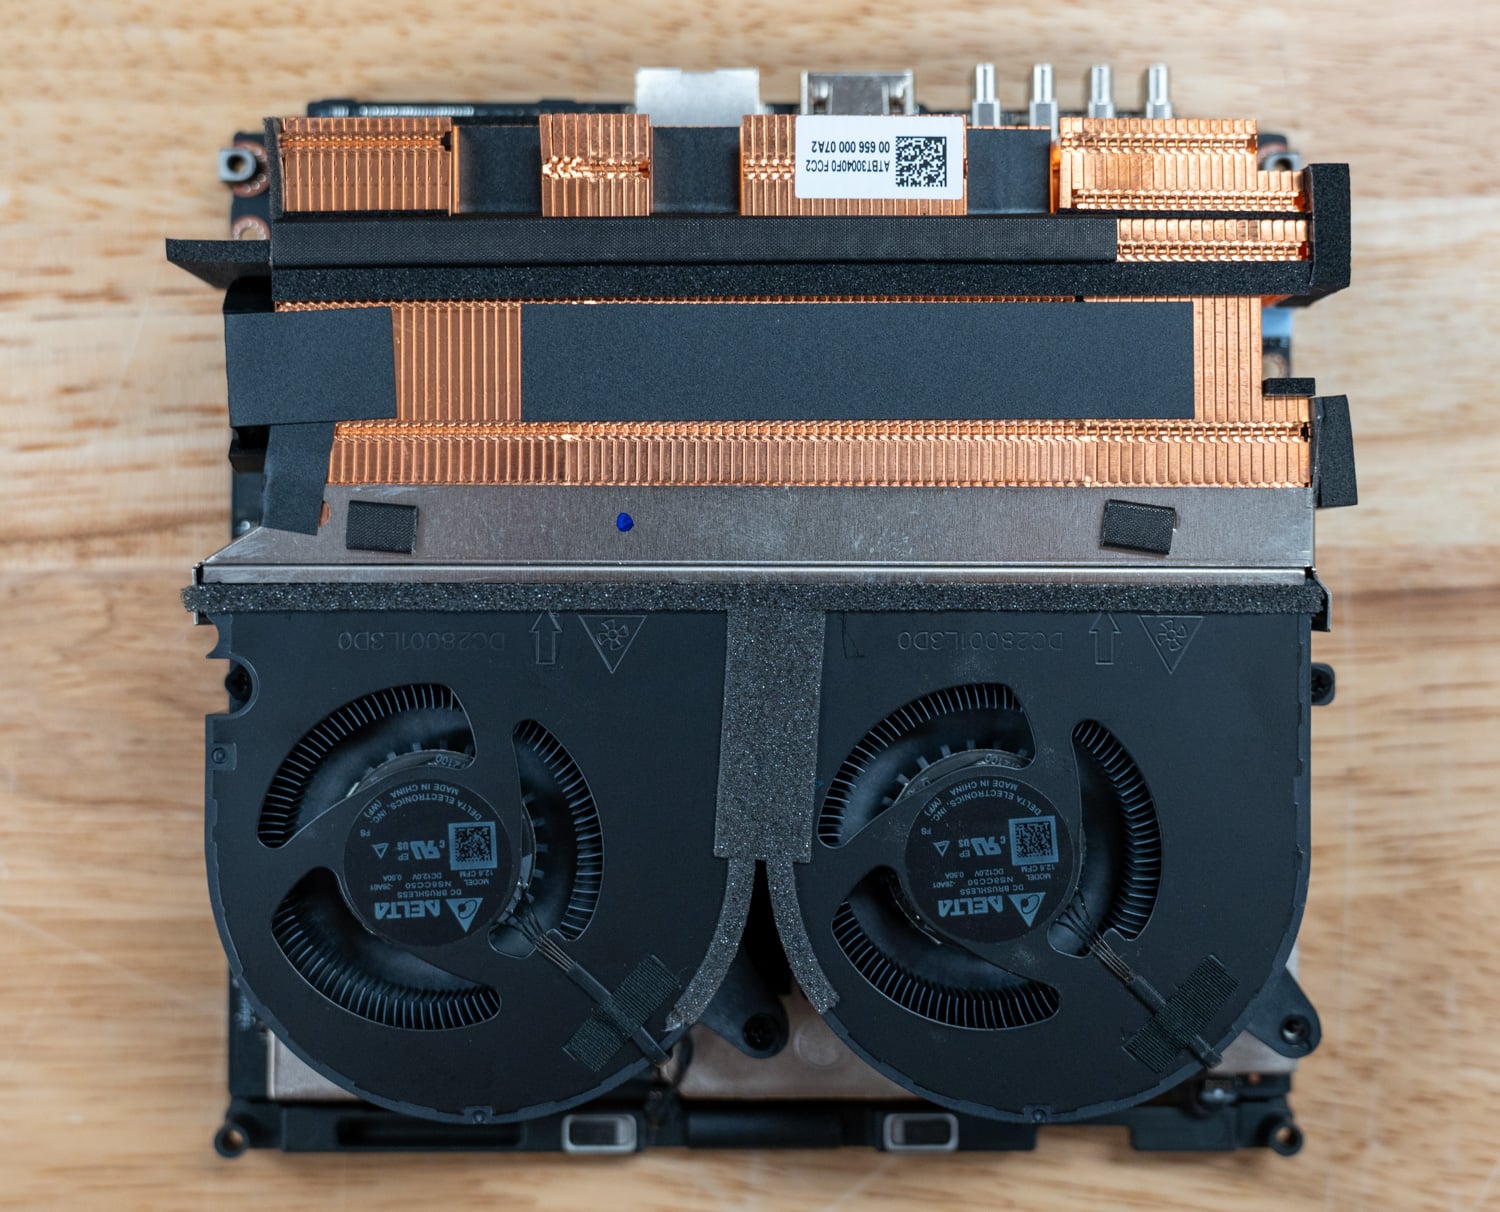
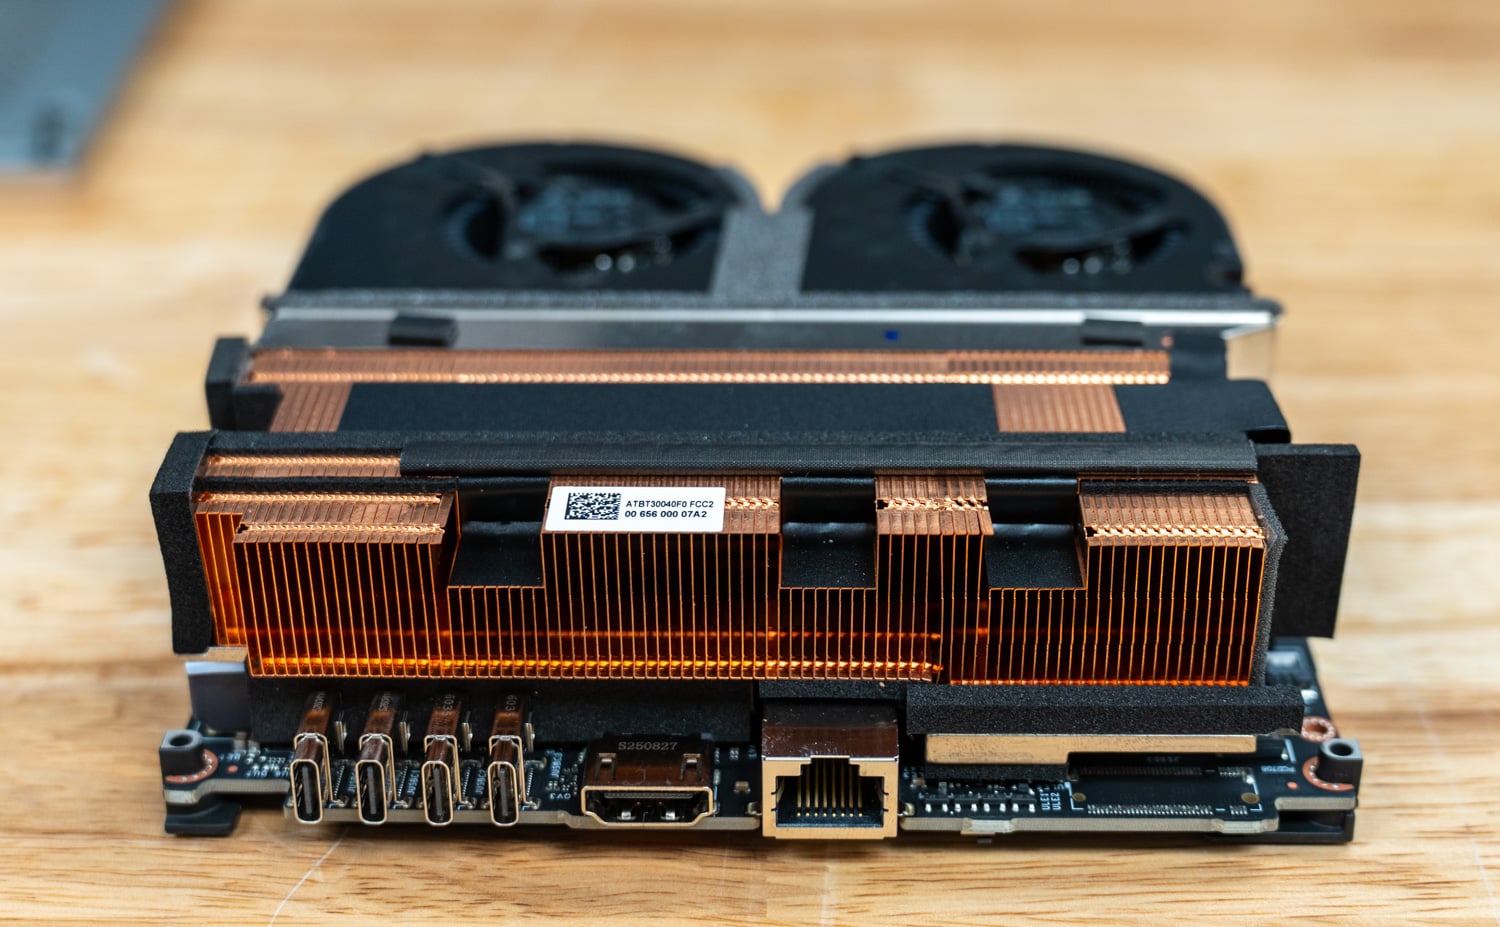
Para la refrigeración, AMD adoptó un enfoque similar al de la NVIDIA DGX Spark, utilizando ventiladores duales que aspiran el aire a través de un disipador de calor con aletas y lo expulsan por la parte trasera del chasis.
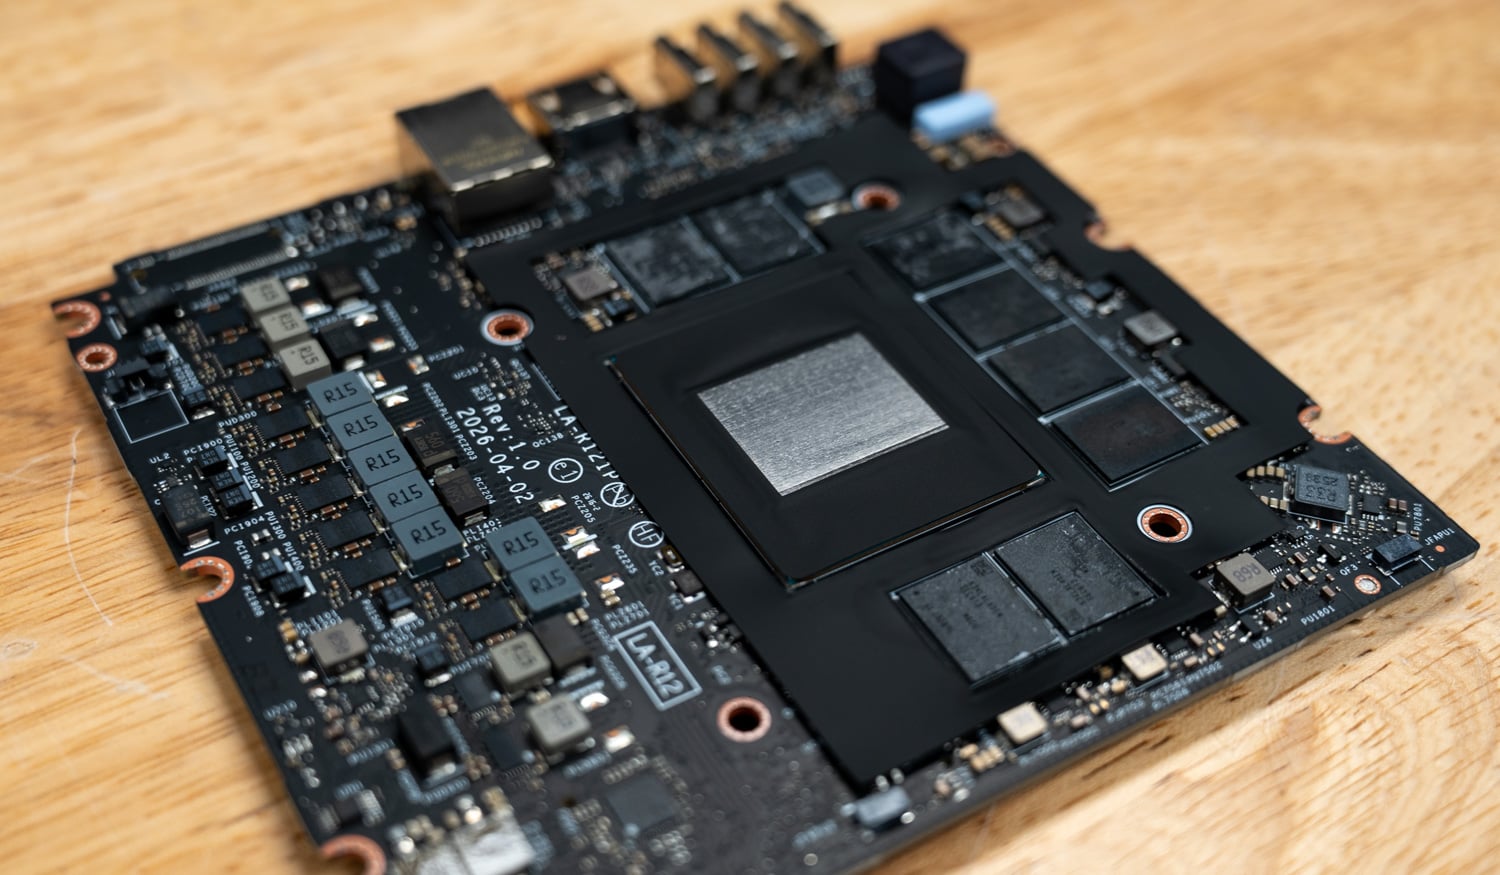
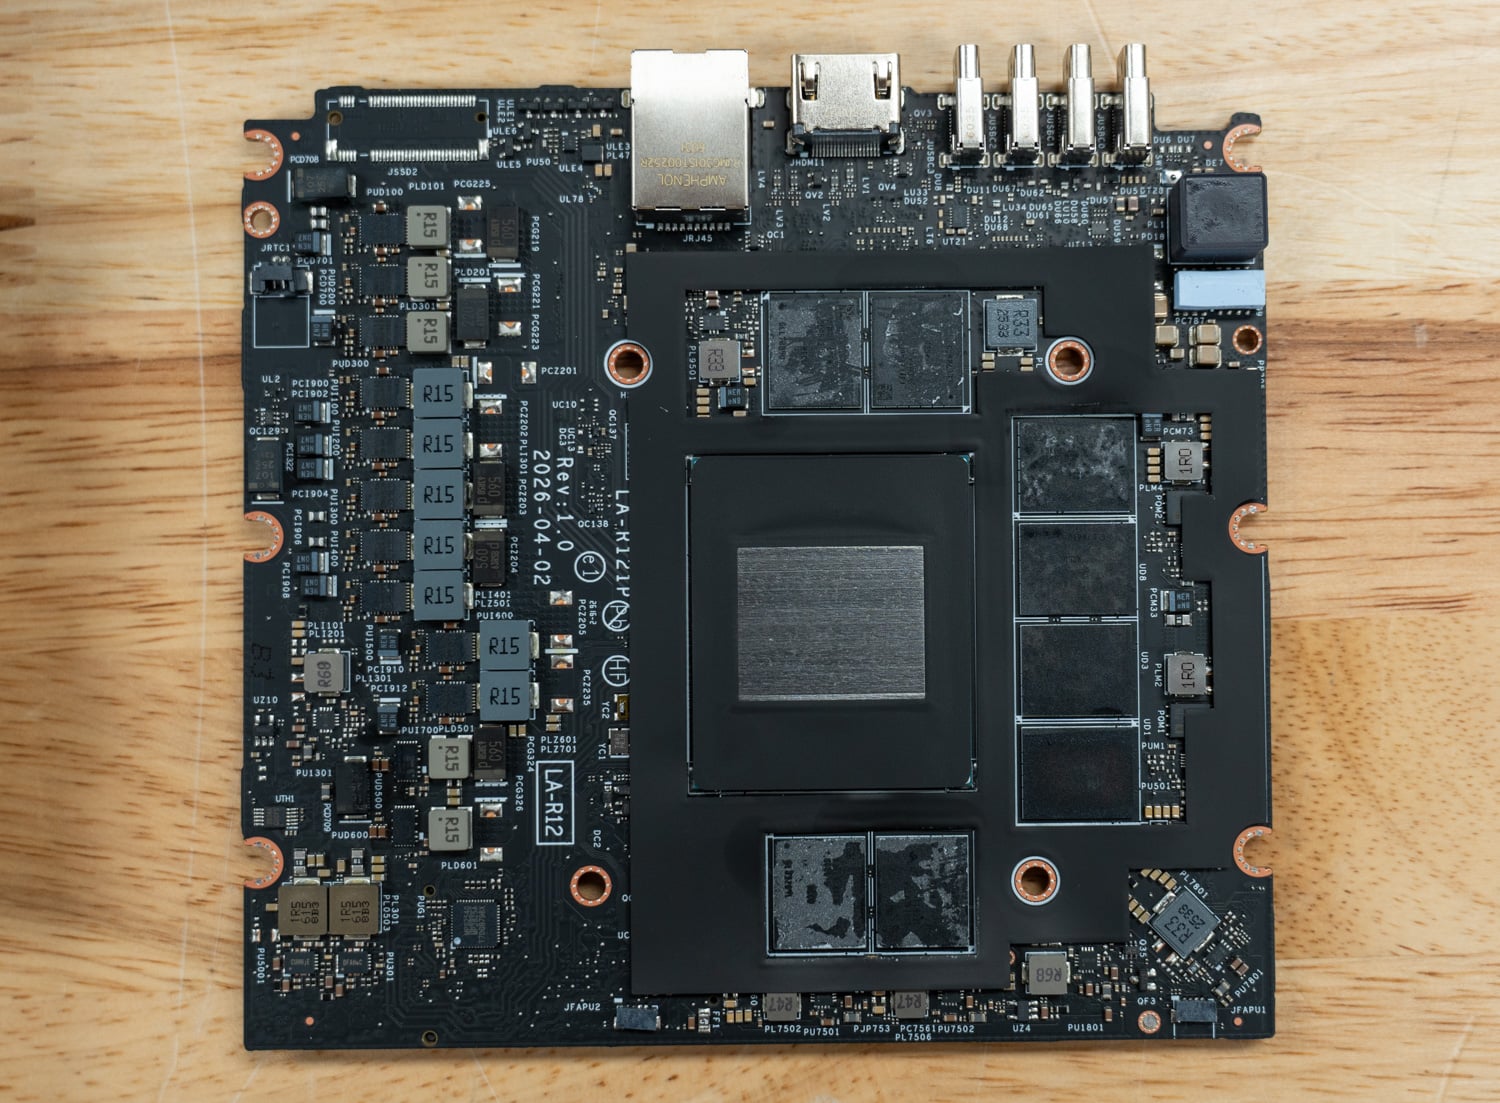
Una vez retirado el conjunto de refrigeración, se puede ver la placa base, que revela el chip APU en el centro, flanqueado por módulos de memoria a ambos lados y el circuito VRM que recorre el borde izquierdo. El cuadrado plateado visible en el chip no es metal líquido ni una pasta; es el residuo de una almohadilla térmica sólida o un recubrimiento que AMD aplicó como interfaz entre el chip y el disipador, lo que explica su aspecto uniforme y seco, en lugar del aspecto húmedo y manchado que suelen dejar la pasta o el metal líquido.
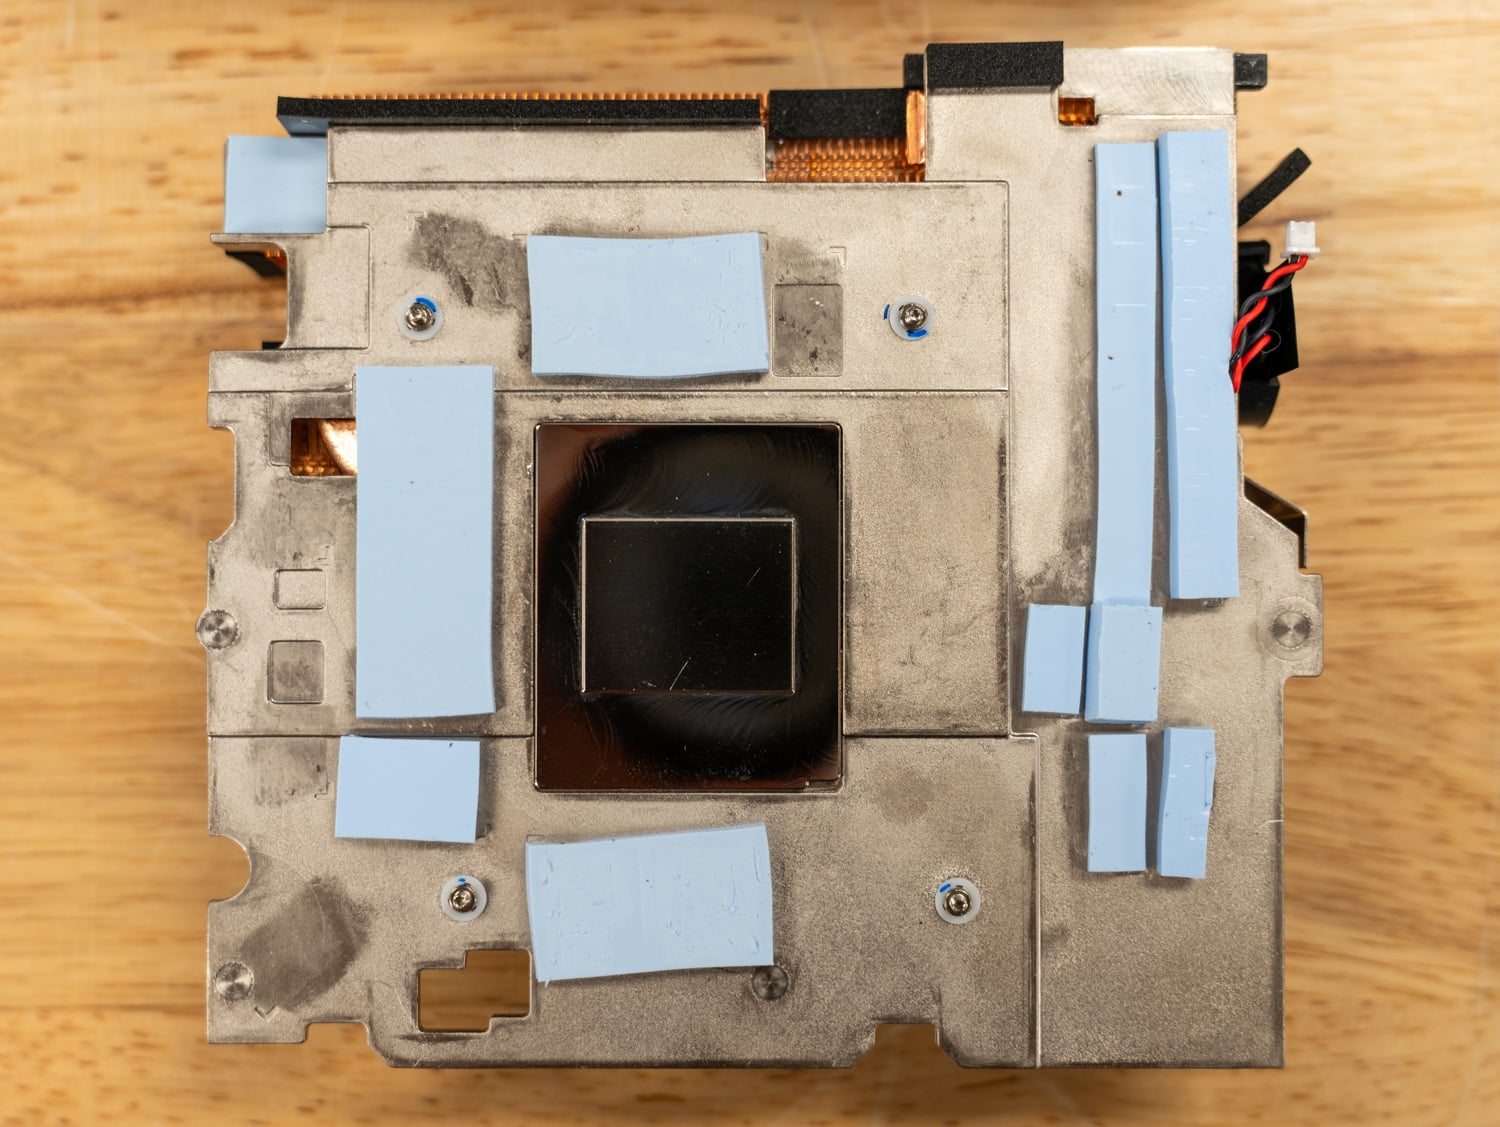
Al darle la vuelta al disipador, se descubre la parte inferior de su placa fría, donde una sección pulida a espejo hace contacto directo con el chip. Al mismo tiempo, las zonas circundantes de memoria y suministro de energía están cubiertas con almohadillas térmicas preaplicadas de diferente grosor.
Pruebas de rendimiento de AMD Ryzen AI Halo
Evaluamos la plataforma AMD Ryzen AI Halo en Windows y Linux para analizar su rendimiento en aplicaciones de estaciones de trabajo y cargas de trabajo centradas en IA. Para las pruebas en Windows, comparamos el sistema AMD Ryzen AI Halo con dos sistemas comerciales equipados con el procesador Ryzen AI Max+ PRO 395: el HP Z2 Mini G1a, una estación de trabajo compacta de escritorio, y el HP ZBook Ultra G1a de 14 pulgadas, una estación de trabajo móvil. Dado que los tres sistemas comparten la misma arquitectura de procesador y la tarjeta gráfica integrada Radeon 8060S, estas comparaciones permiten apreciar el rendimiento de la plataforma Halo en diferentes entornos térmicos y diseños de sistema.
Para las pruebas en Linux, nos centramos en el desarrollo de IA y las cargas de trabajo de almacenamiento, comparando el sistema Ryzen AI Halo con el NVIDIA DGX Spark. Estas pruebas se enfocaron en la evaluación comparativa del almacenamiento FIO y el rendimiento de la inferencia vLLM, comparando la plataforma de desarrollo basada en Ryzen AI Halo de AMD con el sistema de desarrollo de IA diseñado específicamente por NVIDIA para la inferencia local de modelos de lenguaje a gran escala.
Unidades probadas
UL Procyon: Visión artificial por inteligencia artificial
La herramienta de evaluación comparativa de visión artificial Procyon AI ofrece información detallada sobre el rendimiento de los motores de inferencia de IA a nivel profesional. Al integrar motores de diversos proveedores, proporciona puntuaciones de rendimiento que reflejan con precisión las capacidades de cada dispositivo. Esta herramienta evalúa modelos de redes neuronales de última generación comparando su rendimiento de aceleración de IA en distintos tipos de hardware (CPU, GPU y NPU), lo que permite a los usuarios evaluar la eficiencia relativa en diversas cargas de trabajo y condiciones.
Para reflejar las cargas de trabajo de IA del mundo real, la herramienta de evaluación comparativa utiliza seis modelos de redes neuronales diferentes, cada uno seleccionado por su relevancia para las tareas modernas de visión artificial. MobileNet V3 es un modelo compacto, enfocado en dispositivos móviles y diseñado para la identificación de sujetos en imágenes, mientras que Inception V4 realiza la misma tarea con una arquitectura más profunda y compleja.
YOLO V3 (You Only Look Once) se especializa en la detección de objetos en tiempo real mediante la estimación de probabilidades de objetos. DeepLab V3, basado en MobileNet V2, se centra en la segmentación semántica de imágenes y la agrupación de píxeles. Real-ESRGAN, la prueba que requiere mayor capacidad computacional, amplía las imágenes de 250×250 a 1,000×1,000 píxeles. Por último, ResNet 50 es un modelo de clasificación robusto que permite un entrenamiento más eficaz de las redes neuronales profundas.
La plataforma Ryzen AI Halo ofreció un rendimiento de inferencia de IA consistentemente sólido en cargas de trabajo de CPU y GPU. En las pruebas de CPU, obtuvo una puntuación general de 216, ligeramente por debajo de los 227 del HP Z2 Mini y superando cómodamente los 186 del HP ZBook Ultra. La inferencia de GPU fue aún más impresionante, con el sistema Halo obteniendo la puntuación general más alta de 553, por delante del ZBook Ultra (528) y el Z2 Mini (528). También registró la inferencia MobileNet V3 más rápida en 0.38 ms y completó la exigente carga de trabajo REAL-ESRGAN en 185.08 ms, en comparación con los 211.76 ms del Z2 Mini y los 200.40 ms del ZBook Ultra.
| UL Procyon: Inferencia de visión artificial por computadora (Cuanto menor, mejor) | AMD Ryzen AI Halo (Ryzen AI Max+ 395 | Radeon 8060S) | HP Z2 Mini G1a (Ryzen AI Max+ PRO 395 | Radeon 8060S) | HP ZBook Ultra G1a de 14″ (Ryzen AI Max+ PRO 395 | Radeon 8060S) |
|---|---|---|---|
| Tiempos de CPU | |||
| Puntuación general de visión artificial por computadora (cuanto más alto, mejor) | 216 | 227 | 186 |
| MóvilNet V3 | 0.73 ms | 0.75 ms | 1.09 ms |
| Red 50 | 6.02 ms | 5.99 ms | 6.84 ms |
| Inicio V4 | 17.18 ms | 17.12 ms | 19.80 ms |
| Laboratorio profundo V3 | 29.21 ms | 21.20 ms | 28.27 ms |
| Yolo V3 | 35.60 ms | 36.58 ms | 41.64 ms |
| REAL-ESRGAN | 1,931.13 ms | 1,892.10 ms | 2,138.97 ms |
| Tiempos de GPU | |||
| Puntuación general de visión artificial por computadora (cuanto más alto, mejor) | 553 | 528 | 583 |
| MóvilNet V3 | 0.38 ms | 0.42 ms | 0.46 ms |
| Red 50 | 4.04 ms | 3.85 ms | 3.27 ms |
| Inicio V4 | 13.26 ms | 15.15 ms | 11.62 ms |
| Laboratorio profundo V3 | 12.72 ms | 10.98 ms | 10.72 ms |
| Yolo V3 | 11.17 ms | 12.64 ms | 10.57 ms |
| REAL-ESRGAN | 185.08 ms | 211.76 ms | 200.40 ms |
UL Procyon: Generación de texto con IA
El benchmark de generación de texto con IA de Procyon optimiza las pruebas de rendimiento de modelos LLM de IA mediante un método de evaluación conciso y consistente. Permite realizar pruebas repetidas en múltiples modelos LLM, minimizando la complejidad de los modelos de gran tamaño y los factores variables. Desarrollado en colaboración con líderes en hardware de IA, optimiza el uso de aceleradores de IA locales para obtener evaluaciones de rendimiento más fiables y eficientes. Los resultados que se muestran a continuación se obtuvieron con TensorRT.
La plataforma de referencia Ryzen AI Halo lideró todos los modelos de lenguaje probados en Procyon AI Text Generation. Obtuvo la puntuación Phi general más alta con 1,192, en comparación con 965 para el HP Z2 Mini y 922 para el HP ZBook Ultra. Mistral siguió una tendencia similar con una puntuación de 998, por delante de 850 y 829, mientras que Llama3 terminó con 847, superando a los sistemas de la competencia con 766 y 756, respectivamente. La plataforma Halo también redujo el tiempo hasta el primer token en todos los modelos, produciendo el primer token Phi en solo 0.996 segundos, casi la mitad de la latencia de los sistemas HP. Aunque el rendimiento de generación de tokens favoreció ocasionalmente al Z2 Mini, la latencia de inicio significativamente menor de la plataforma Halo resultó en las mejores puntuaciones de referencia generales.
| UL Procyon: Generación de texto con IA | Halo de IA AMD Ryzen (Ryzen AI Max+ 395 | Radeon 8060S) |
HP Z2 Mini G1a (Ryzen AI Max+ PRO 395 | Radeon 8060S) | HP ZBook Ultra G1a de 14″ (Ryzen AI Max+ PRO 395 | Radeon 8060S) |
|---|---|---|---|
| Puntuación general de Phi | 1,192 | 965 | 922 |
| Tiempo de salida de Phi hasta el primer token | 0.996 segundos | 1.898 segundos | 1.956 segundos |
| Tokens de salida Phi por segundo | 55.271 fichas/s | 68.967 fichas/s | 64.986 fichas/s |
| Duración total de Phi | 56.237 segundos | 52.666 segundos | 55.501 segundos |
| Puntuación general de Mistral | 998 | 850 | 829 |
| Tiempo de salida de Mistral hasta el primer token | 1.603 segundos | 2.734 segundos | 2.783 segundos |
| Tokens de salida de Mistral por segundo | 35.027 fichas/s | 43.358 fichas/s | 41.992 fichas/s |
| Duración total del Mistral | 88.582 segundos | 81.716 segundos | 84.065 segundos |
| Puntuación general de Llama3 | 847 | 766 | 756 |
| Tiempo de salida de Llama3 al primer token | 1.963 segundos | 2.545 segundos | 2.578 segundos |
| Tokens de salida por segundo de Llama3 | 34.630 fichas/s | 36.752 fichas/s | 36.243 fichas/s |
| Duración total de Llama3 | 92.026 segundos | 91.987 segundos | 93.200 segundos |
| Puntuación general de Llama2 | N/A | 936 | 929 |
| Tiempo de salida de Llama2 al primer token | N/A segundos | 3.813 segundos | 3.860 segundos |
| Tokens de salida por segundo de Llama2 | N/A tokens/s | 24.685 fichas/s | 24.619 fichas/s |
| Duración total de Llama2 | N/A segundos | 136.077 segundos | 136.720 segundos |
UL Procyon: Generación de imágenes de IA
El benchmark de generación de imágenes Procyon AI ofrece una forma consistente y precisa de medir el rendimiento de la inferencia de IA en hardware que abarca desde NPU de bajo consumo hasta GPU de gama alta. Incluye tres pruebas: Difusión estable XL (FP16) para GPU de gama alta, Difusión estable 1.5 (FP16) para GPU de potencia moderada y Difusión estable 1.5 (INT8) para dispositivos de bajo consumo. El benchmark utiliza el motor de inferencia óptimo para cada sistema, lo que garantiza resultados justos y comparables.
La generación de imágenes demostró ser una de las cargas de trabajo más fuertes de Ryzen AI Halo. En Stable Diffusion 1.5 FP16, la plataforma Halo alcanzó una puntuación general de 937, en comparación con 725 para el Z2 Mini y 648 para el ZBook Ultra, mientras que redujo el tiempo de generación a 106.7 segundos, en comparación con 137.8 y 154.2 segundos, respectivamente. Stable Diffusion XL mostró una ventaja igualmente fuerte, con el sistema Halo finalizando en 878.5 segundos, aproximadamente 174 segundos más rápido que el Z2 Mini y más de 450 segundos más rápido que el ZBook Ultra. La plataforma también completó la prueba de rendimiento Stable Diffusion 1.5 INT8 con una puntuación general de 9,158, una carga de trabajo no disponible en ninguno de los sistemas de comparación de HP.
| UL Procyon: Generación de imágenes con IA | Halo de IA AMD Ryzen (Ryzen AI Max+ 395 | Radeon 8060S) |
HP Z2 Mini G1a (Ryzen AI Max+ PRO 395 | Radeon 8060S) | HP ZBook Ultra G1a de 14″ (Ryzen AI Max+ PRO 395 | Radeon 8060S) |
|---|---|---|---|
| Difusión estable 1.5 (FP16) – Puntuación general | 937 | 725 | 648 |
| Difusión estable 1.5 (FP16) – Tiempo total | 106.7 segundos | 137.815 segundos | 154.203 segundos |
| Difusión estable 1.5 (FP16): velocidad de generación de imágenes | 6.670 s/image | 8.613 s/image | 9.638 s/image |
| Difusión estable 1.5 (INT8) – Puntuación general | 9,158 | N/A | N/A |
| Difusión estable 1.5 (INT8) – Tiempo total | 27.298 segundos | N/A | N/A |
| Difusión estable 1.5 (INT8): velocidad de generación de imágenes | 3.412 s/image | N/A | N/A |
| Stable Diffusion XL (FP16): puntuación general | 682 | 570 | 451 |
| Difusión estable XL (FP16): tiempo total | 878.493 segundos | 1,052.468 segundos | 1,329.592 segundos |
| Stable Diffusion XL (FP16): velocidad de generación de imágenes | 54.906 s/image | 65.779 s/image | 83.100 s/image |
SPECestación de trabajo 4
La herramienta de evaluación comparativa SPECworkstation 4.0 es una herramienta integral para evaluar todos los aspectos clave del rendimiento de las estaciones de trabajo. Proporciona una medición realista del rendimiento de la CPU, los gráficos, el acelerador y el disco, ofreciendo a los profesionales los datos necesarios para tomar decisiones informadas sobre sus inversiones en hardware. La herramienta incluye un conjunto específico de pruebas centradas en cargas de trabajo de IA y aprendizaje automático, como tareas de ciencia de datos y pruebas de inferencia basadas en ONNX Runtime, lo que refleja la creciente importancia de la IA y el aprendizaje automático en los entornos de estaciones de trabajo. Cubre siete sectores verticales y cuatro subsistemas de hardware, proporcionando una medición detallada y relevante del rendimiento de las estaciones de trabajo actuales.
SPECworkstation 4 puso de manifiesto las capacidades equilibradas de la plataforma Ryzen AI Halo como estación de trabajo. Obtuvo las puntuaciones más altas en Servicios Financieros (2.92), Medios y Entretenimiento (2.97), Diseño de Producto (2.22) y Productividad y Desarrollo (1.27), superando tanto al HP Z2 Mini como al HP ZBook Ultra en estas categorías. El Z2 Mini mantuvo una ligera ventaja en Energía (2.50 frente a 2.35) y Ciencias de la Vida (2.60 frente a 2.33). En general, la plataforma de referencia Halo demostró un sólido rendimiento en todas las cargas de trabajo profesionales evaluadas y se mantuvo competitiva en todas las categorías analizadas.
| SPECworkstation 4.0.0 (Cuanto más alto, mejor) | Halo de IA AMD Ryzen (Ryzen AI Max+ 395 | Radeon 8060S) |
HP Z2 Mini G1a (Ryzen AI Max+ PRO 395 | Radeon 8060S)
|
HP ZBook Ultra G1a de 14″ (Ryzen AI Max+ PRO 395 | Radeon 8060S) |
|---|---|---|---|
| Energía | 2.35 | 2.50 | 2.20 |
| Servicios Financieros | 2.92 | 2.35 | 1.60 |
| Ciencias de la vida | 2.33 | 2.60 | 2.20 |
| Medios y entretenimiento | 2.97 | 2.22 | 1.90 |
| Diseño de Producto | 2.22 | 2.00 | 1.74 |
| Productividad y desarrollo | 1.27 | 1.00 | 1.03 |
luxmark
Luxmark es una prueba de rendimiento de GPU que utiliza LuxRender, un motor de renderizado de trazado de rayos de código abierto, para evaluar el rendimiento de un sistema con escenas 3D de gran detalle. Esta prueba resulta útil para evaluar las capacidades de renderizado gráfico de servidores y estaciones de trabajo, especialmente en aplicaciones de efectos visuales y visualización arquitectónica, donde la simulación precisa de la luz es fundamental.
Los resultados de Luxmark mostraron una separación mínima entre las tres plataformas Ryzen AI Max+ 395. El sistema de referencia Halo obtuvo la puntuación más alta en Food, con 4,158 puntos, superando al Z2 Mini (3,943) y al ZBook Ultra (3,915). En la prueba Hallbench, obtuvo 8,014 puntos, ligeramente por debajo de los 8,477 del Z2 Mini, pero por delante de los 7,833 del ZBook Ultra. En general, los resultados sugieren que los sistemas basados en la Radeon 8060S ofrecen un rendimiento de trazado de rayos muy similar, independientemente del formato.
| Luxmark (más alto es mejor) | Halo de IA AMD Ryzen (Ryzen AI Max+ 395 | Radeon 8060S) |
HP Z2 Mini G1a (Ryzen AI Max+ PRO 395 | Radeon 8060S) | HP ZBook Ultra G1a de 14″ (Ryzen AI Max+ PRO 395 | Radeon 8060S) |
|---|---|---|---|
| Banco de salón | 8,014 | 8,477 | 7,833 |
| Comida | 4,158 | 3,943 | 3,915 |
Compresión de 7 cremalleras
La prueba de rendimiento de compresión 7-Zip evalúa el desempeño de la CPU durante la compresión y descompresión, midiendo el rendimiento en GIPS (gigainstrucciones por segundo) y el uso de la CPU. Un mayor valor de GIPS y un uso eficiente de la CPU indican un rendimiento superior.
La plataforma Ryzen AI Halo lideró todas las categorías principales en la prueba de rendimiento 7-Zip. Alcanzó una tasa de compresión de 176.7 GIPS, en comparación con los 139.3 GIPS del HP Z2 Mini y los 139.6 GIPS del ZBook Ultra. El rendimiento de descompresión se mantuvo igualmente sólido en 191.6 GIPS, superando los 164.0 GIPS del Z2 Mini y los 174.0 GIPS del ZBook Ultra. En conjunto, la plataforma Halo logró la calificación general más alta de 184.2 GIPS, superando a los sistemas de la competencia en aproximadamente un 20 % y demostrando un excelente rendimiento de enteros para cargas de trabajo de creación y extracción de archivos.
| Punto de referencia de compresión 7-Zip (cuanto más alto, mejor) | Halo de IA AMD Ryzen (Ryzen AI Max+ 395 | Radeon 8060S) |
HP Z2 Mini G1a (Ryzen AI Max+ PRO 395 | Radeon 8060S) | HP ZBook Ultra G1a de 14″ (Ryzen AI Max+ PRO 395 | Radeon 8060S) | |||
|---|---|---|---|---|---|---|
| Apresamiento | ||||||
| Uso actual de la CPU | 2,741% | 2,734% | 2,868% | |||
| Clasificación actual/Uso | 6.370 gips | 5.136 gips | 4.883 gips | |||
| Calificación actual | 174.589 gips | 140.405 gips | 140.061 gips | |||
| Uso de CPU resultante | 2,751% | 2,718% | 2,855% | |||
| Valoración/Uso resultante | 6.424 gips | 5.126 gips | 4.890 gips | |||
| Calificación resultante | 176.742 gips | 139.298 gips | 139.617 gips | |||
| Descomprimiendo | ||||||
| Uso actual de la CPU | 2,568% | 2,343% | 2,904% | |||
| Clasificación actual/Uso | 7.670 gips | 6.805 gips | 6.029 gips | |||
| Calificación actual | 196.986 gips | 159.451 gips | 175.104 gips | |||
| Uso de CPU resultante | 2,469% | 2,414% | 2,887% | |||
| Valoración/Uso resultante | 7.766 gips | 6.793 gips | 6.028 gips | |||
| Calificación resultante | 191.645 gips | 163.969 gips | 174.046 gips | |||
| Puntuación total | ||||||
| Uso total de la CPU | 2,610% | 2,566% | 2,871% | |||
| Valoración total/Uso | 7.095 gips | 5.959 gips | 5.459 gips | |||
| Puntuación total | 184.194 gips | 151.634 gips | 156.832 gips | |||
Punto de referencia de la licuadora
Blender es una aplicación de modelado 3D de código abierto. Esta prueba de rendimiento se realizó con la utilidad Blender Benchmark. La puntuación se mide en muestras por minuto, y los valores más altos indican un mejor rendimiento.
El renderizado por CPU fue otra área donde Ryzen AI Halo sobresalió. En la escena Monster, alcanzó 244.7 muestras por minuto, superando al HP Z2 Mini (224.3) y al HP ZBook Ultra (189.3). Junkshop le siguió con 159.4 muestras por minuto, en comparación con 149.5 y 129.4, mientras que Classroom finalizó con 131.6 muestras por minuto, superando al Z2 Mini (116.3) en aproximadamente un 13 % y al ZBook Ultra (94.1) en casi un 40 %. Estos resultados demuestran que el Ryzen AI Max+ 395 ofrece un excelente rendimiento de renderizado multihilo a pesar de su tamaño compacto.
| Blender Benchmark CPU (muestras por minuto, cuanto más alto, mejor) | Halo de IA AMD Ryzen (Ryzen AI Max+ 395 | Radeon 8060S) |
HP Z2 Mini G1a (Ryzen AI Max+ PRO 395 | Radeon 8060S) | HP ZBook Ultra G1a de 14″ (Ryzen AI Max+ PRO 395 | Radeon 8060S) |
|---|---|---|---|
| Monster | 244.7 muestras/m | 224.3 muestras/m | 189.29 muestras/m |
| chatarrería | 159.4 muestras/m | 149.5 muestras/m | 129.42 muestras/m |
| Aulas | 131.6 muestras/m | 116.3 muestras/m | 94.14 muestras/m |
Los resultados de renderizado de GPU fueron mucho más similares entre los sistemas. La plataforma de referencia Halo renderizó la escena Monster a 704.2 muestras por minuto, por detrás del Z2 Mini (745.6) pero por delante del ZBook Ultra (661.5). En Junkshop, el rendimiento fue prácticamente idéntico entre la plataforma Halo (366.6) y el Z2 Mini (366.5). Al mismo tiempo, el sistema Halo obtuvo la puntuación más alta en Classroom con 361.5 muestras por minuto, superando ligeramente al Z2 Mini (359.0) y al ZBook Ultra (333.3). Estos resultados indican que la Radeon 8060S ofrece un rendimiento de renderizado de GPU notablemente consistente en todas las implementaciones.
| Blender Benchmark GPU (muestras por minuto, cuanto más alto, mejor) | Halo de IA AMD Ryzen (Ryzen AI Max+ 395 | Radeon 8060S) |
HP Z2 Mini G1a (Ryzen AI Max+ PRO 395 | Radeon 8060S) | HP ZBook Ultra G1a de 14″ (Ryzen AI Max+ PRO 395 | Radeon 8060S) |
|---|---|---|---|
| Monster | 704.2 muestras/m | 745.55 muestras/m | 661.50 muestras/m |
| chatarrería | 366.6 muestras/m | 366.54 muestras/m | 341.92 muestras/m |
| Aulas | 361.51 muestras/m | 359.01 muestras/m | 333.26 muestras/m |
trituradora
y-cruncher es un programa multihilo y escalable capaz de calcular Pi y otras constantes matemáticas con billones de dígitos. Desde su lanzamiento en 2009, se ha convertido en una popular herramienta de evaluación comparativa y pruebas de estrés para entusiastas del overclocking y del hardware.
Los resultados de y-cruncher se dividen según el tamaño del cálculo. En las ejecuciones de 1 millones y 2.5 millones de dígitos, los tres sistemas terminaron con una diferencia de unas décimas de segundo, con los sistemas HP ligeramente por delante. A medida que la carga de trabajo aumentaba, el Halo se distanció, completando el cálculo de 5 millones de dígitos en 71.948 segundos, en comparación con los 75.021 segundos del Z2 Mini y los 78.19 segundos del ZBook Ultra. Con 10 millones de dígitos, el Halo terminó en 151.409 segundos, aproximadamente un 6 % por delante del Z2 Mini y un 12 % por delante del ZBook Ultra, lo que sugiere que el chasis de escritorio soporta mejor la carga multihilo pesada a medida que los tiempos de ejecución se alargan.
| Y-Cruncher (tiempo total de cálculo) | Halo de IA AMD Ryzen (Ryzen AI Max+ 395 | Radeon 8060S) |
HP Z2 Mini G1a (Ryzen AI Max+ PRO 395 | Radeon 8060S) | HP ZBook Ultra G1a de 14″ (Ryzen AI Max+ PRO 395 | Radeon 8060S) |
|---|---|---|---|
| 1 mil millones | 13.193 segundos | 12.965 segundos | 12.93 segundos |
| 2.5 mil millones | 34.578 segundos | 34.533 segundos | 34.91 segundos |
| 5 mil millones | 71.948 segundos | 75.021 segundos | 78.19 segundos |
| 10 mil millones | 151.409 segundos | 160.252 segundos | 171.72 segundos |
Geekbench 6
Geekbench 6 es una herramienta de evaluación comparativa multiplataforma que mide el rendimiento general del sistema.
Geekbench 6 confirmó el rendimiento equilibrado de la plataforma Halo. Alcanzó la puntuación más alta en un solo núcleo, 2,986, superando al HP Z2 Mini (2,862) y al ZBook Ultra (2,825). El rendimiento multinúcleo también lideró la comparación con 18 068. La Radeon 8060S registró la puntuación más alta en OpenCL GPU, 92 883, superando ligeramente al Z2 Mini (91 591) y con creces al ZBook Ultra (85 337). El liderazgo constante en las pruebas de CPU y GPU demuestra el rendimiento integral de la plataforma Ryzen AI Max+ 395.
| Geekbench 6 (cuanto más alto, mejor) | Halo de IA AMD Ryzen (Ryzen AI Max+ 395 | Radeon 8060S) |
HP Z2 Mini G1a (Ryzen AI Max+ PRO 395 | Radeon 8060S) | HP ZBook Ultra G1a de 14″ (Ryzen AI Max+ PRO 395 | Radeon 8060S) |
|---|---|---|---|
| CPU de un solo núcleo | 2,986 | 2,862 | 2,825 |
| CPU multinúcleo | 18,068 | 17,210 | 17,562 |
| GPU OpenCL | 92,883 | 91,591 | 85,337 |
Cinebench R23
Cinebench R23 es una herramienta de evaluación comparativa ampliamente reconocida para analizar el rendimiento de la CPU en tareas de renderizado 3D. Impulsada por el motor Cinema 4D, mide la eficacia con la que un procesador gestiona tareas de un solo hilo y de múltiples hilos, ofreciendo información sobre la capacidad de respuesta general y las capacidades de procesamiento paralelo.
Cinebench R23 mostró una competencia muy reñida entre las dos implementaciones de escritorio Ryzen AI Max+ 395. La plataforma de referencia Halo obtuvo una puntuación multinúcleo de 37,316, superando ligeramente los 37,156 del HP Z2 Mini, mientras que ambas superaron cómodamente los 29,112 del HP ZBook Ultra. El rendimiento de un solo núcleo siguió el mismo patrón, con la plataforma Halo obteniendo 2,047 puntos, en comparación con los 2,020 del Z2 Mini y los 1,984 del ZBook Ultra. Aunque los márgenes sobre el Z2 Mini fueron pequeños, el sistema Halo se mantuvo consistentemente en la cima de la prueba de rendimiento.
| Cinebench R23 (Cuanto más alto, mejor) | Halo de IA AMD Ryzen (Ryzen AI Max+ 395 | Radeon 8060S) |
HP Z2 Mini G1a (Ryzen AI Max+ PRO 395 | Radeon 8060S) | HP ZBook Ultra G1a de 14″ (Ryzen AI Max+ PRO 395 | Radeon 8060S) |
|---|---|---|---|
| Multi-Core | 37,316 | 37,156 | 29,112 |
| Núcleo simple | 2,047 | 2,020 | 1,984 |
Cinebench 2024
Cinebench 2024 se basa en la versión R23 e introduce pruebas de renderizado basadas en GPU, manteniendo su enfoque en el rendimiento de la CPU. En este segmento, analizamos únicamente las puntuaciones de la CPU, que ofrecen información actualizada sobre el desempeño de cada sistema en las tareas modernas de renderizado 3D.
La nueva prueba de rendimiento Cinebench 2024 reflejó los resultados de la versión R23. Ryzen AI Halo registró la puntuación multinúcleo más alta, con 1,916 puntos, superando ligeramente a la HP Z2 Mini (1,906) y manteniendo una ventaja considerable sobre la HP ZBook Ultra (1,579). El rendimiento de un solo núcleo también favoreció a la plataforma Halo, con 116 puntos en comparación con los 112 de la Z2 Mini y los 111 de la ZBook Ultra. Si bien las diferencias entre los sistemas de escritorio siguieron siendo pequeñas, los resultados refuerzan la capacidad del Ryzen AI Max+ 395 para ofrecer un rendimiento de renderizado de CPU de primer nivel de forma constante.
| Cinebench 2024 (Cuanto más alto, mejor) | Halo de IA AMD Ryzen (Ryzen AI Max+ 395 | Radeon 8060S) |
HP Z2 Mini G1a (Ryzen AI Max+ PRO 395 | Radeon 8060S) | HP ZBook Ultra G1a de 14″ (Ryzen AI Max+ PRO 395 | Radeon 8060S) |
|---|---|---|---|
| Multi-Core | 1,916 | 1,906 | 1,579 |
| Núcleo simple | 116 | 112 | 111 |
Puntos de referencia de Phoronix
Phoronix Test Suite es una plataforma de evaluación comparativa automatizada de código abierto que admite más de 450 perfiles de prueba y más de 100 conjuntos de pruebas a través de OpenBenchmarking.org. Se encarga de todo, desde la instalación de dependencias hasta la ejecución de pruebas y la recopilación de resultados, lo que la hace ideal para comparaciones de rendimiento, validación de hardware e integración continua. Analizaremos el rendimiento en pruebas de Stream, 7-Zip y LLVM.
Al analizar el conjunto de pruebas de rendimiento Phoronix, observamos una distribución bastante equitativa entre la plataforma AMD Ryzen AI Halo y la NVIDIA DGX Spark. El sistema Ryzen AI Halo lideró consistentemente las cargas de trabajo centradas en la CPU, superando a la DGX Spark en un 11 % en compresión 7-Zip, un 38 % en descompresión 7-Zip y completando la prueba de compilación LLVM un 14 % más rápido. La DGX Spark, por otro lado, mostró un ancho de banda de memoria sostenido superior, liderando las pruebas STREAM Scale, Triad y Add en un 17 %, 13 % y 15 %, respectivamente. Halo mantuvo una ventaja del 18 % en la prueba de rendimiento STREAM Copy, lo que demuestra que, si bien ambos sistemas son altamente capaces, la plataforma Ryzen AI Halo favorece el rendimiento de computación de propósito general, mientras que la DGX Spark demuestra un mayor rendimiento en cargas de trabajo centradas en el ancho de banda de la memoria.
| Prueba | Halo de IA AMD Ryzen | NVIDIA DGX Spark | Ganador |
|---|---|---|---|
| Compresión 7-Zip (MIPS) | 186,921 | 169,052 | Halo (+11%) |
| Descompresión 7-Zip (MIPS) | 146,109 | 106,084 | Halo (+38%) |
| Copia de STREAM (MB/s) | 145,363 | 123,730 | Halo (+18%) |
| Escala de transmisión (MB/s) | 110,611 | 128,970 | Chispa (+17%) |
| Tríada de flujo (MB/s) | 107,105 | 121,433 | Chispa (+13%) |
| STREAM Agregar (MB/s) | 107,022 | 122,815 | Chispa (+15%) |
| Compilación LLVM (Make, segundos) | 431.8 | 504.3 | Halo (14% más rápido) |
Punto de referencia de rendimiento de FIO
Para medir el rendimiento del almacenamiento según las métricas habituales del sector, utilizamos fio. Nuestra prueba tradicional de SSD preacondiciona cada unidad con dos cargas completas como unidad secundaria; en este caso, probamos cada unidad dentro del sistema, a través del sistema de archivos. Anteriormente, probamos los sistemas NVIDIA con GDSIO, pero AMD no ofrece una prueba de almacenamiento directa a la GPU comparable, por lo que ejecutar fio a nivel de sistema de archivos en ambas plataformas las pone en igualdad de condiciones, lo cual es más importante que realizar pruebas de rendimiento de las unidades de forma individual.
Tanto la NVIDIA DGX Spark (Founders Edition) como la AMD Ryzen AI Halo incluyen una unidad PCIe Gen5, por lo que, en teoría, ambas plataformas tienen límites de ancho de banda de unidad idénticos. Sin embargo, en la práctica, la unidad de la Halo funciona a velocidades de enlace PCIe Gen4 en este sistema, lo que limita el ancho de banda disponible muy por debajo de la capacidad real de la unidad. Es importante tener en cuenta esta limitación de velocidad de enlace a lo largo de esta sección, ya que explica una parte significativa de la diferencia de ancho de banda entre ambas plataformas.
En esta sección nos centraremos en los siguientes puntos de referencia de FIO:
- 128K secuencial
- 64K aleatorio
- 16K secuencial
- 16K aleatorio
- 4K aleatorio
Lectura secuencial de 128K
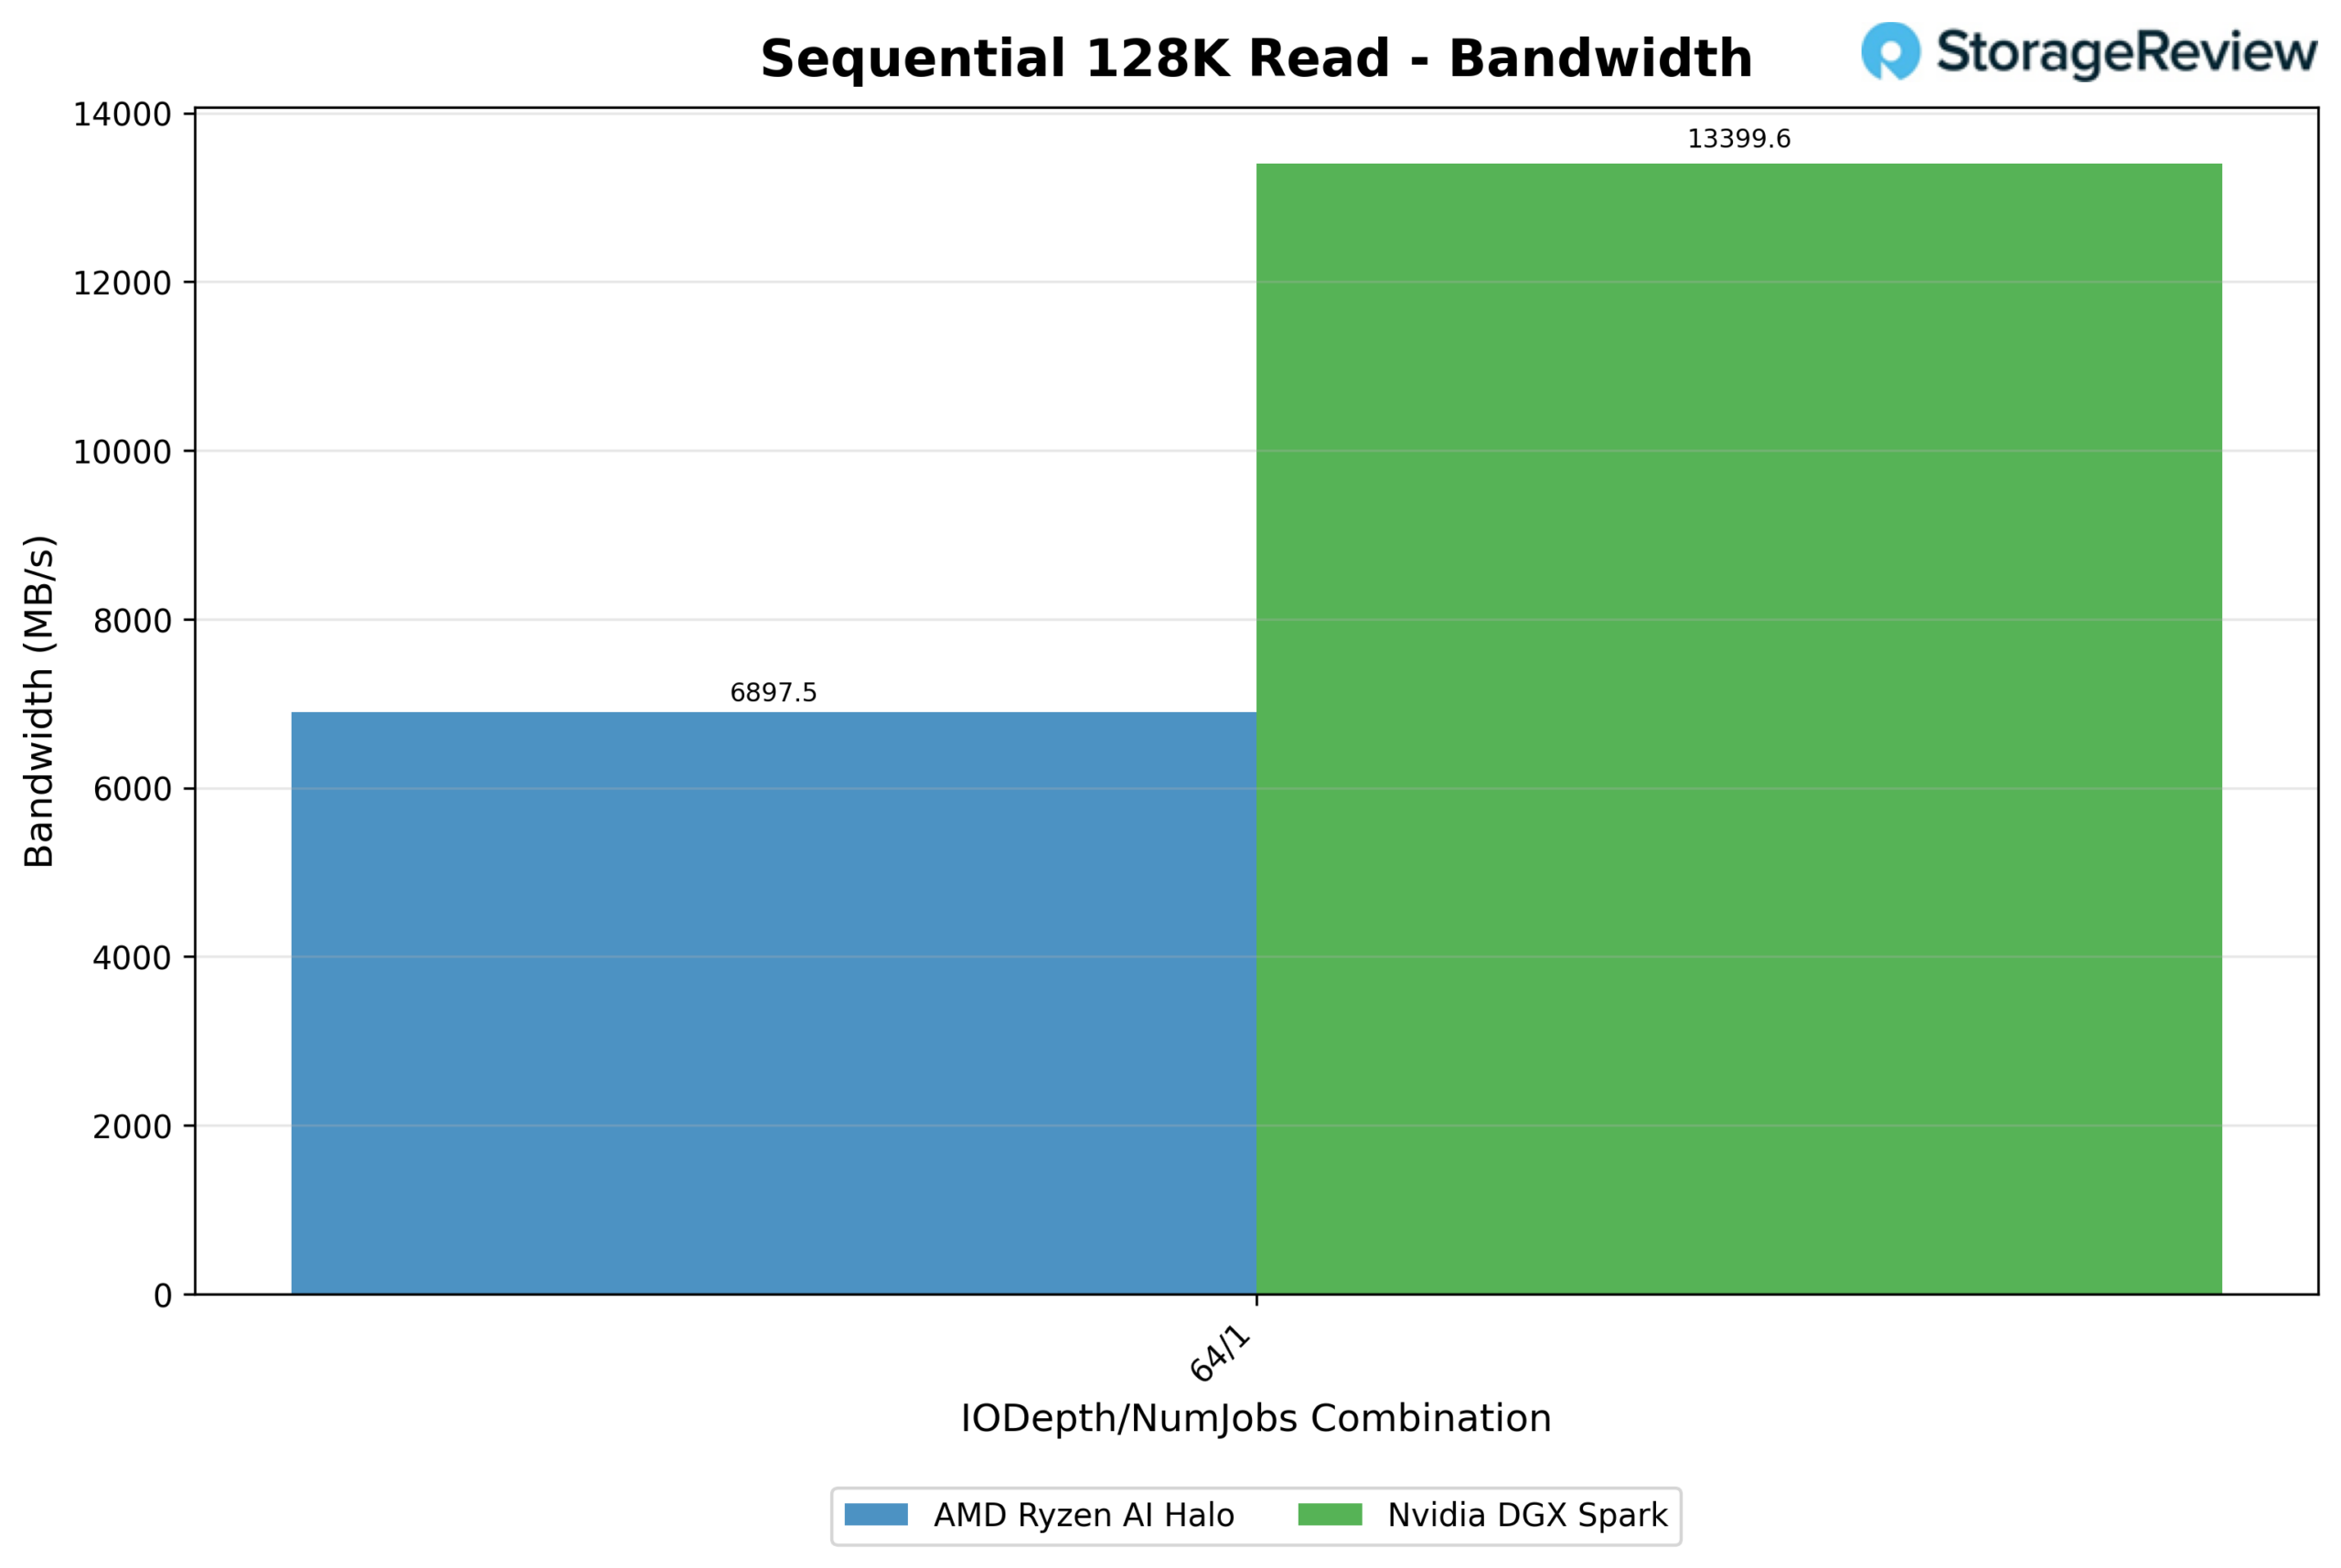
En una lectura secuencial de 128 KB con una sola capa y cola profunda (64/1), el NVIDIA DGX Spark registró 13 399,6 MB/s, casi el doble que los 6,897.5 MB/s del AMD Ryzen AI Halo. La latencia siguió el mismo patrón: la latencia media del Spark a esta profundidad fue de 0.597 ms, mientras que la del Halo fue de 1.159 ms, casi el doble de lenta por solicitud a pesar de transferir la mitad de los datos. Esta es la diferencia más clara en toda la prueba, lo que sugiere que la arquitectura de almacenamiento del Spark está diseñada para un mayor rendimiento secuencial sostenido a este tamaño de bloque.
Escritura secuencial de 128K
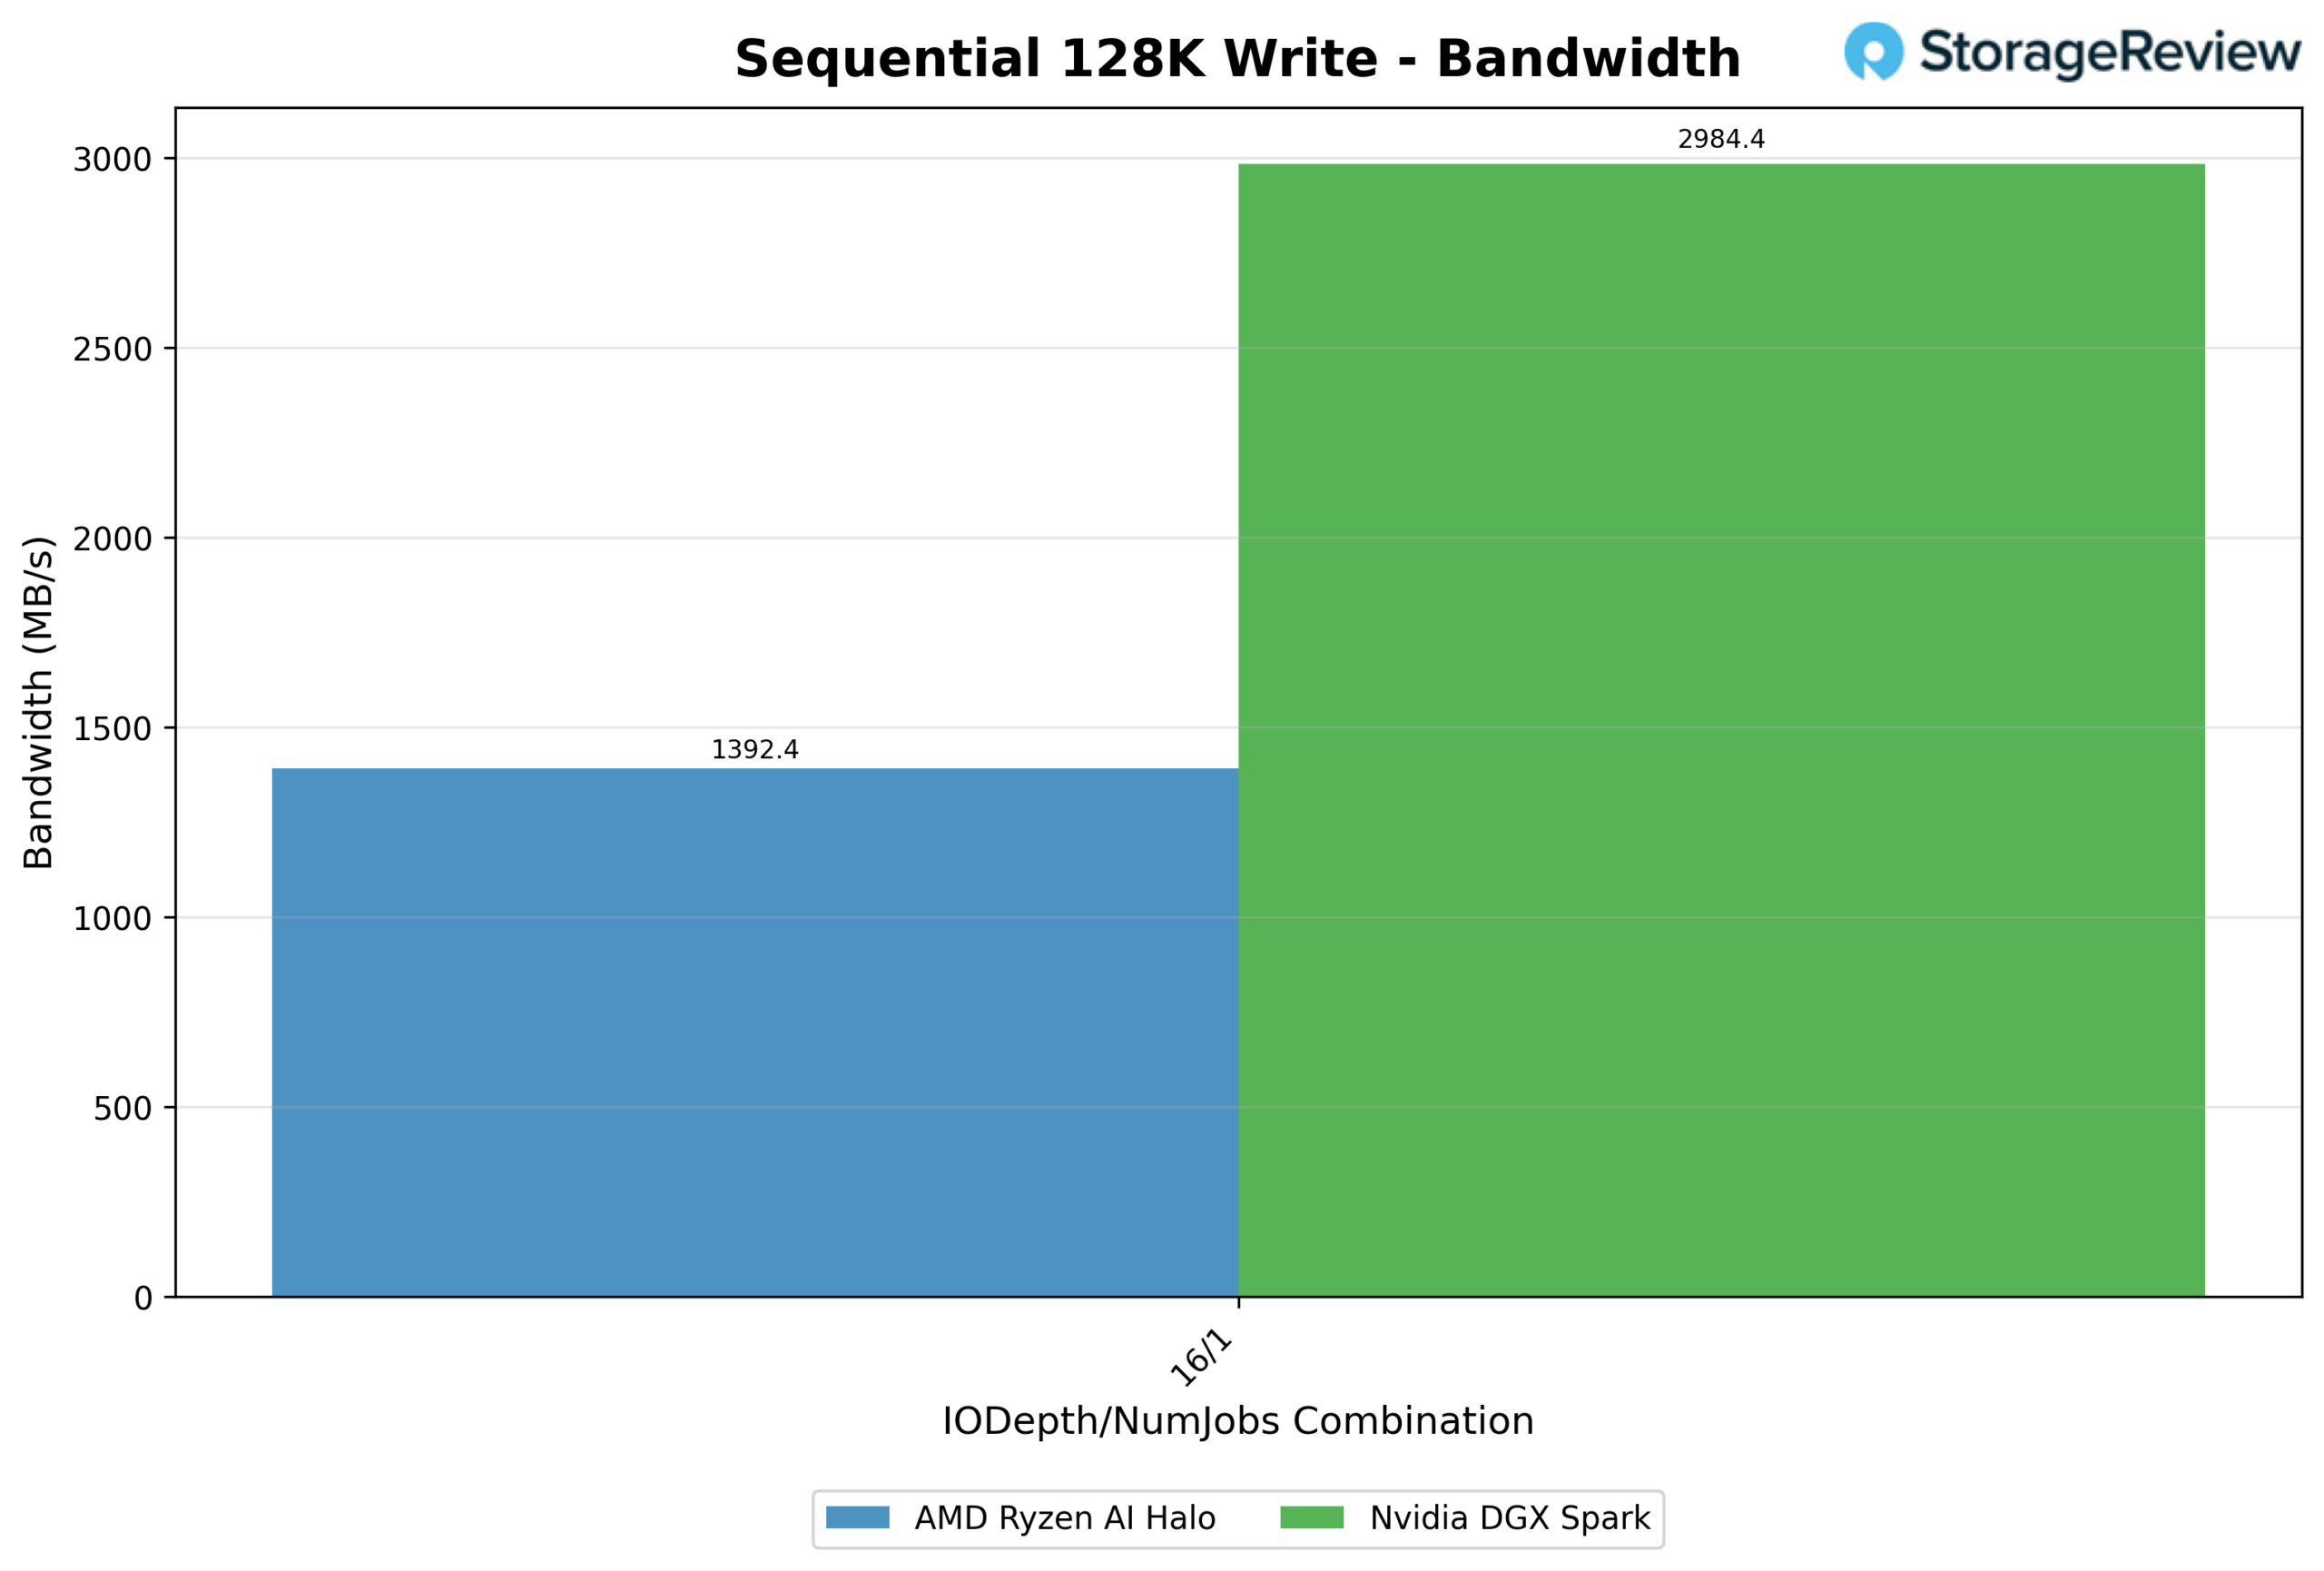
En cuanto a la escritura, la situación es similar. Con una profundidad de E/S de 16/1, Spark alcanzó los 2,984.4 MB/s, frente a los 1,392.4 MB/s de Halo, lo que supone una ventaja del 114 % para NVIDIA. La latencia también favoreció a Spark, con 0.67 ms frente a los 1.436 ms de Halo. En combinación con los resultados de lectura, la lectura secuencial de 128 KB representa, sin duda, el mejor desempeño de Spark en comparación con Halo.
Lectura aleatoria 64K
Aquí es donde se evidencia la ventaja de Halo en latencia baja en colas. Con una tasa de 1/1, Halo respondió en tan solo 0.051 ms, frente a los 0.275 ms de Spark, más de 5 veces más rápido para una sola solicitud pendiente. Esta diferencia se mantiene en colas de profundidad baja a media, con Halo registrando tiempos muy inferiores a 0.2 ms, mientras que Spark se sitúa en el rango de 0.2 a 0.45 ms durante la mayor parte del análisis.
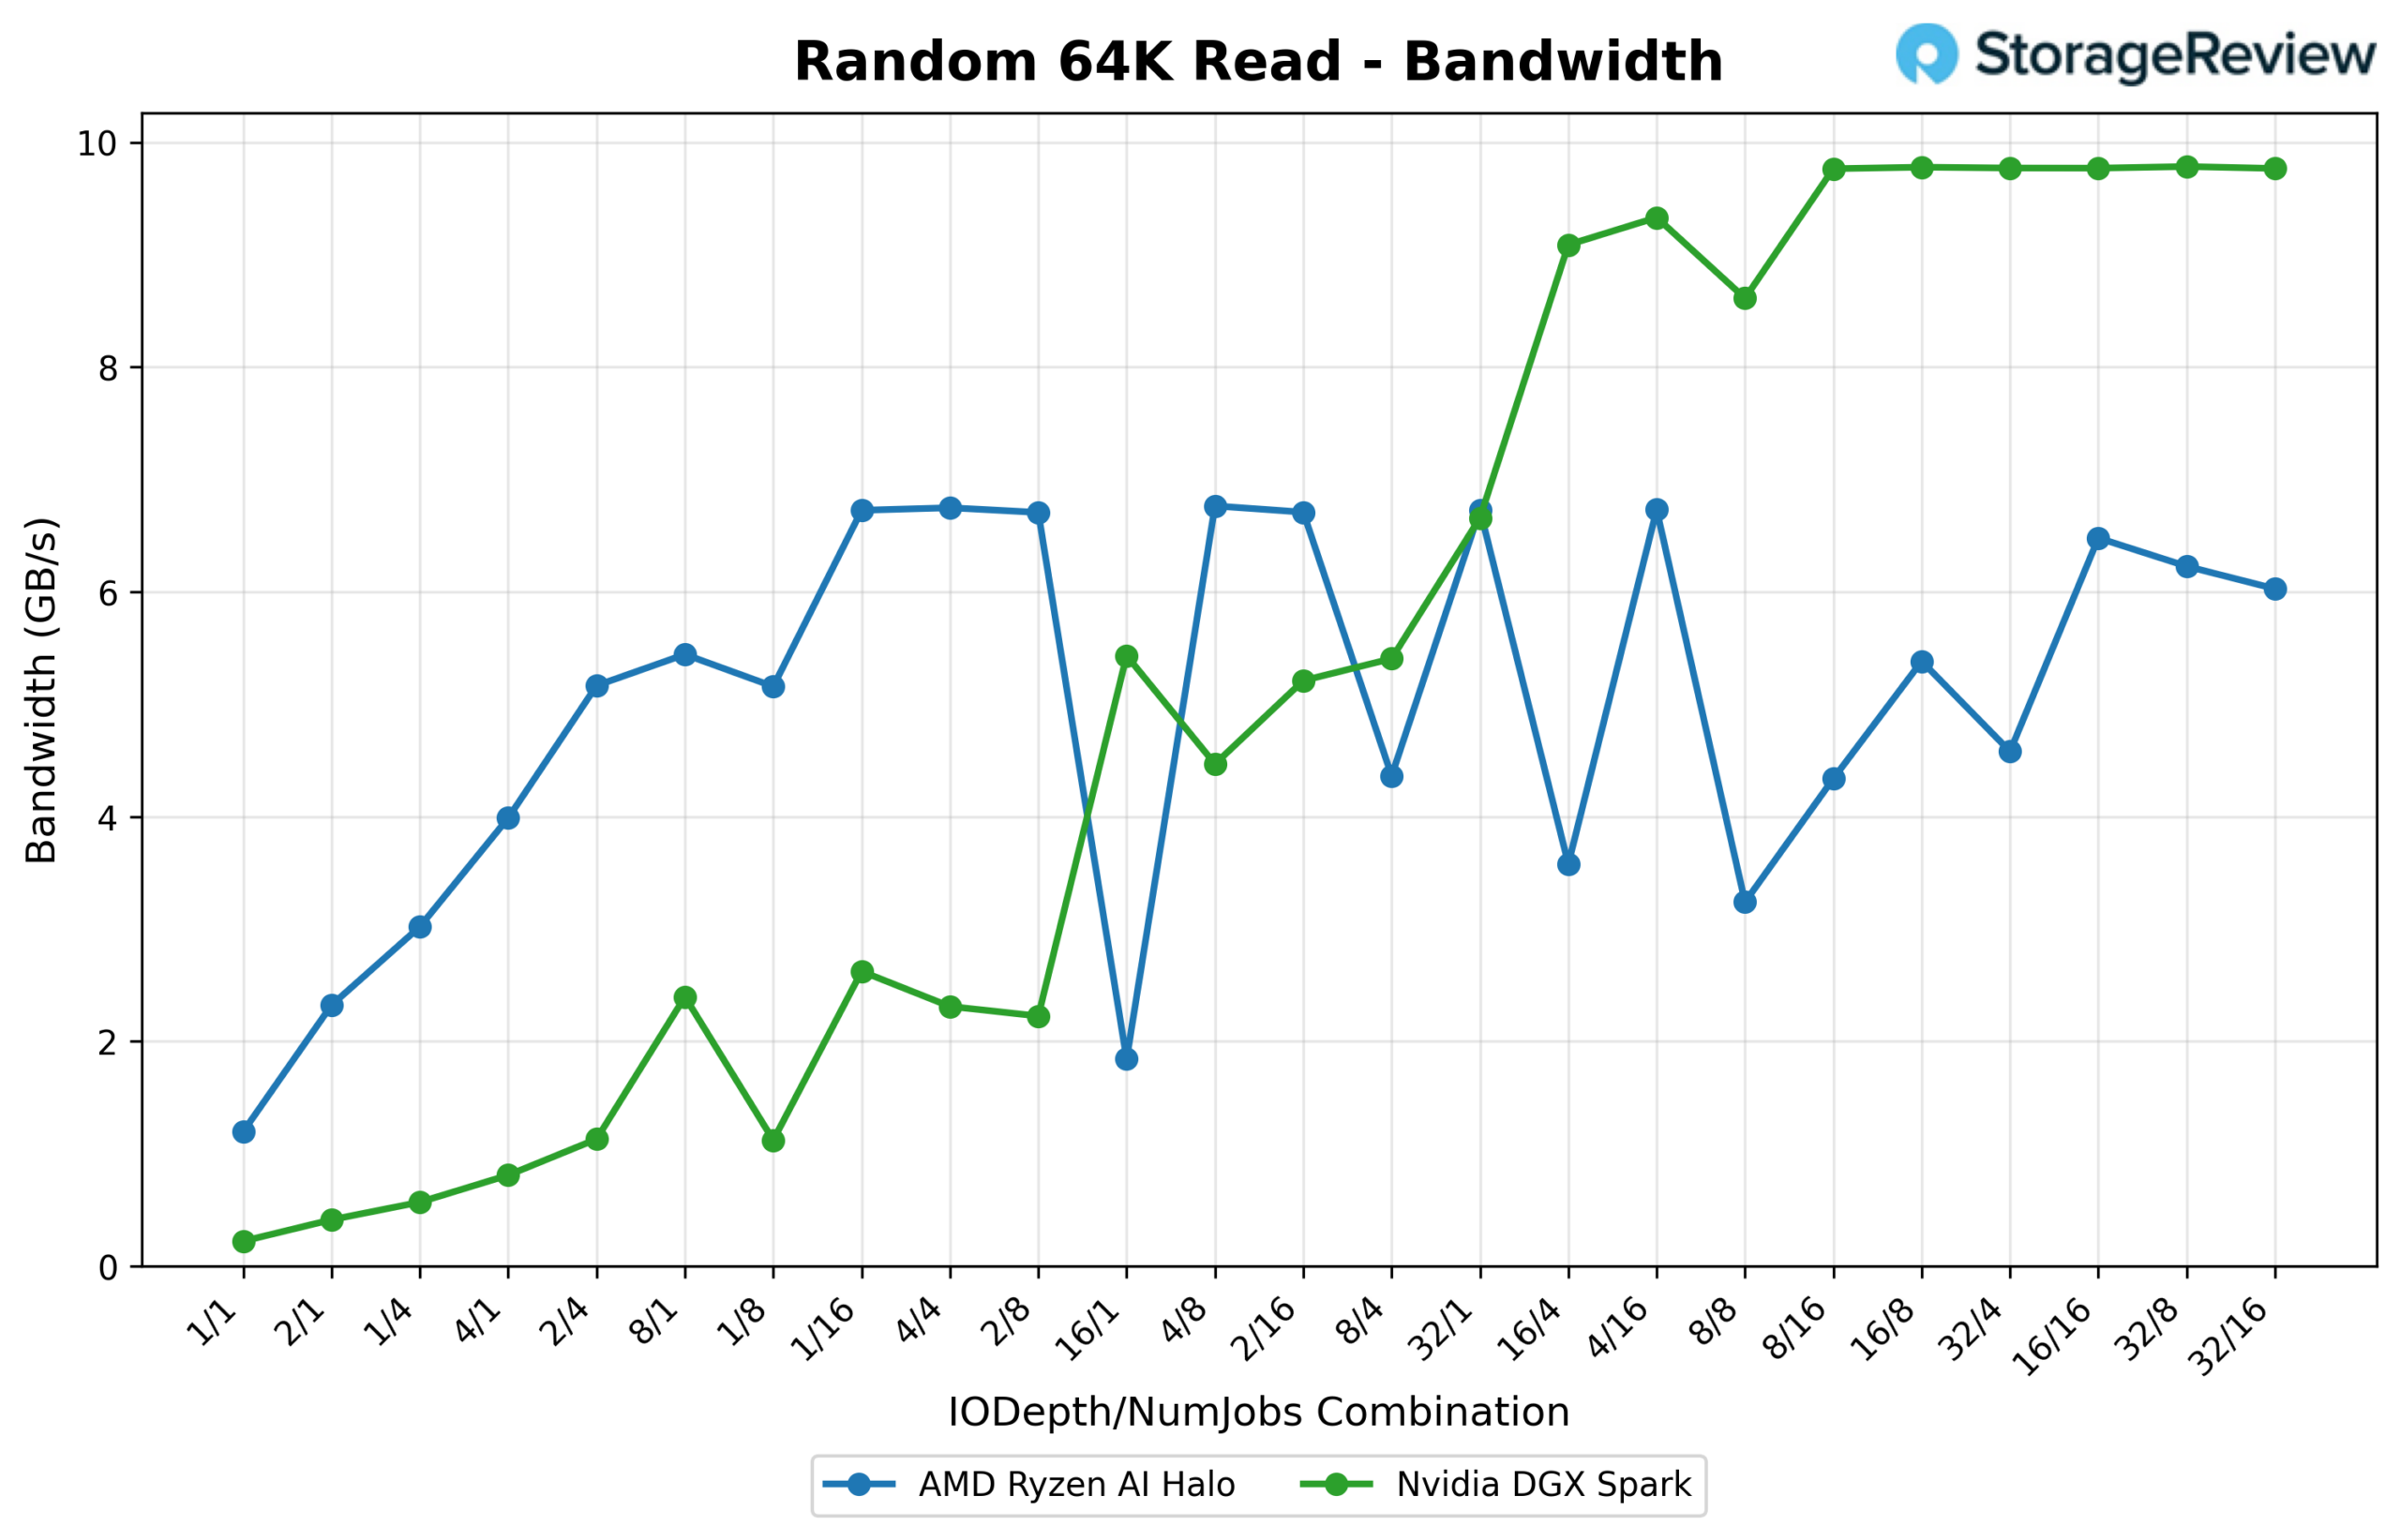
Sin embargo, la situación cambia radicalmente a gran escala. A medida que la profundidad de la cola y el número de subprocesos superan aproximadamente los 16/4, el ancho de banda del Spark se estabiliza en torno a los 9.8 GB/s a partir de 8/16, alcanzando un máximo de 10 019,1 MB/s (160 300 IOPS) a 32/8. El Halo nunca llega a ese límite: se satura en el rango de 6.0 a 6.9 GB/s, con un pico de 6,926.5 MB/s (110 800 IOPS) a 4/8. Su curva de ancho de banda es notablemente más errática, oscilando entre aproximadamente 2 y 6.8 GB/s dependiendo de la combinación de profundidad/subprocesos, en lugar de aumentar de forma continua.
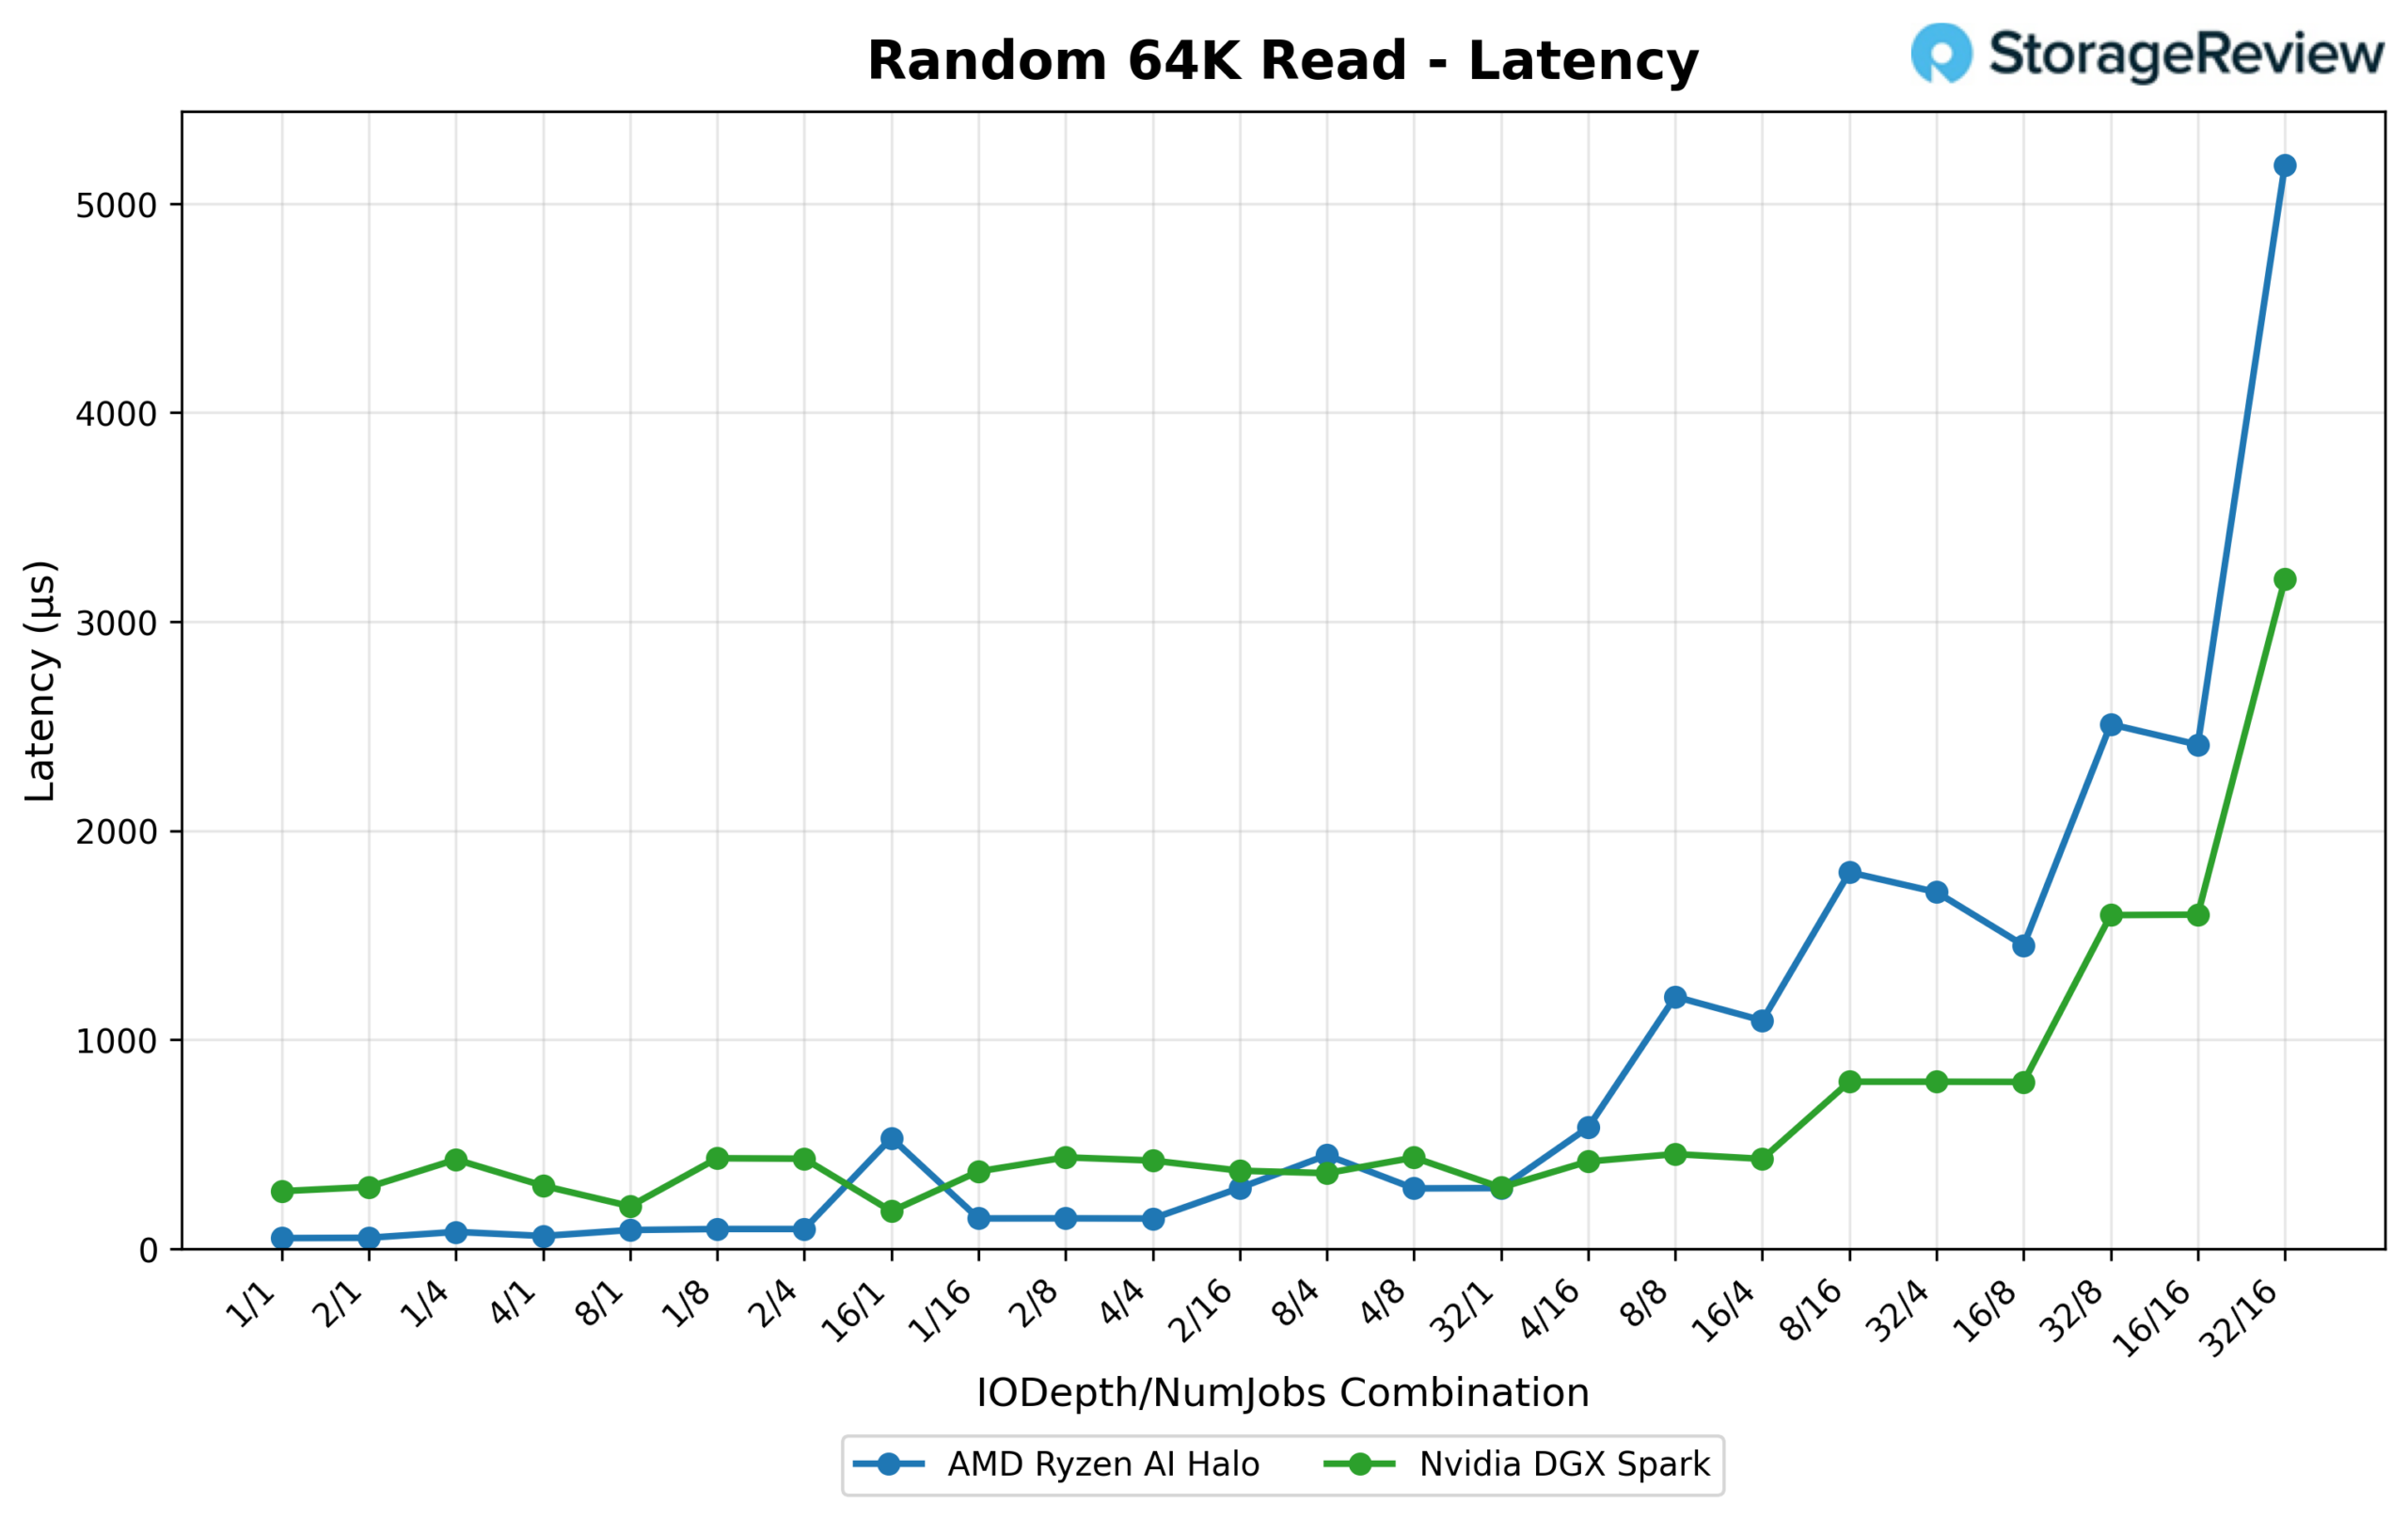
La latencia a plena saturación también favorece a Spark: a 32/16, la latencia media de Halo se dispara a 5.185 ms, en comparación con los 3.204 ms de Spark, lo que significa que Halo paga su capacidad de respuesta con poca profundidad de cola con un peor comportamiento en la cola una vez que esta está completamente cargada.
Escritura aleatoria 64K
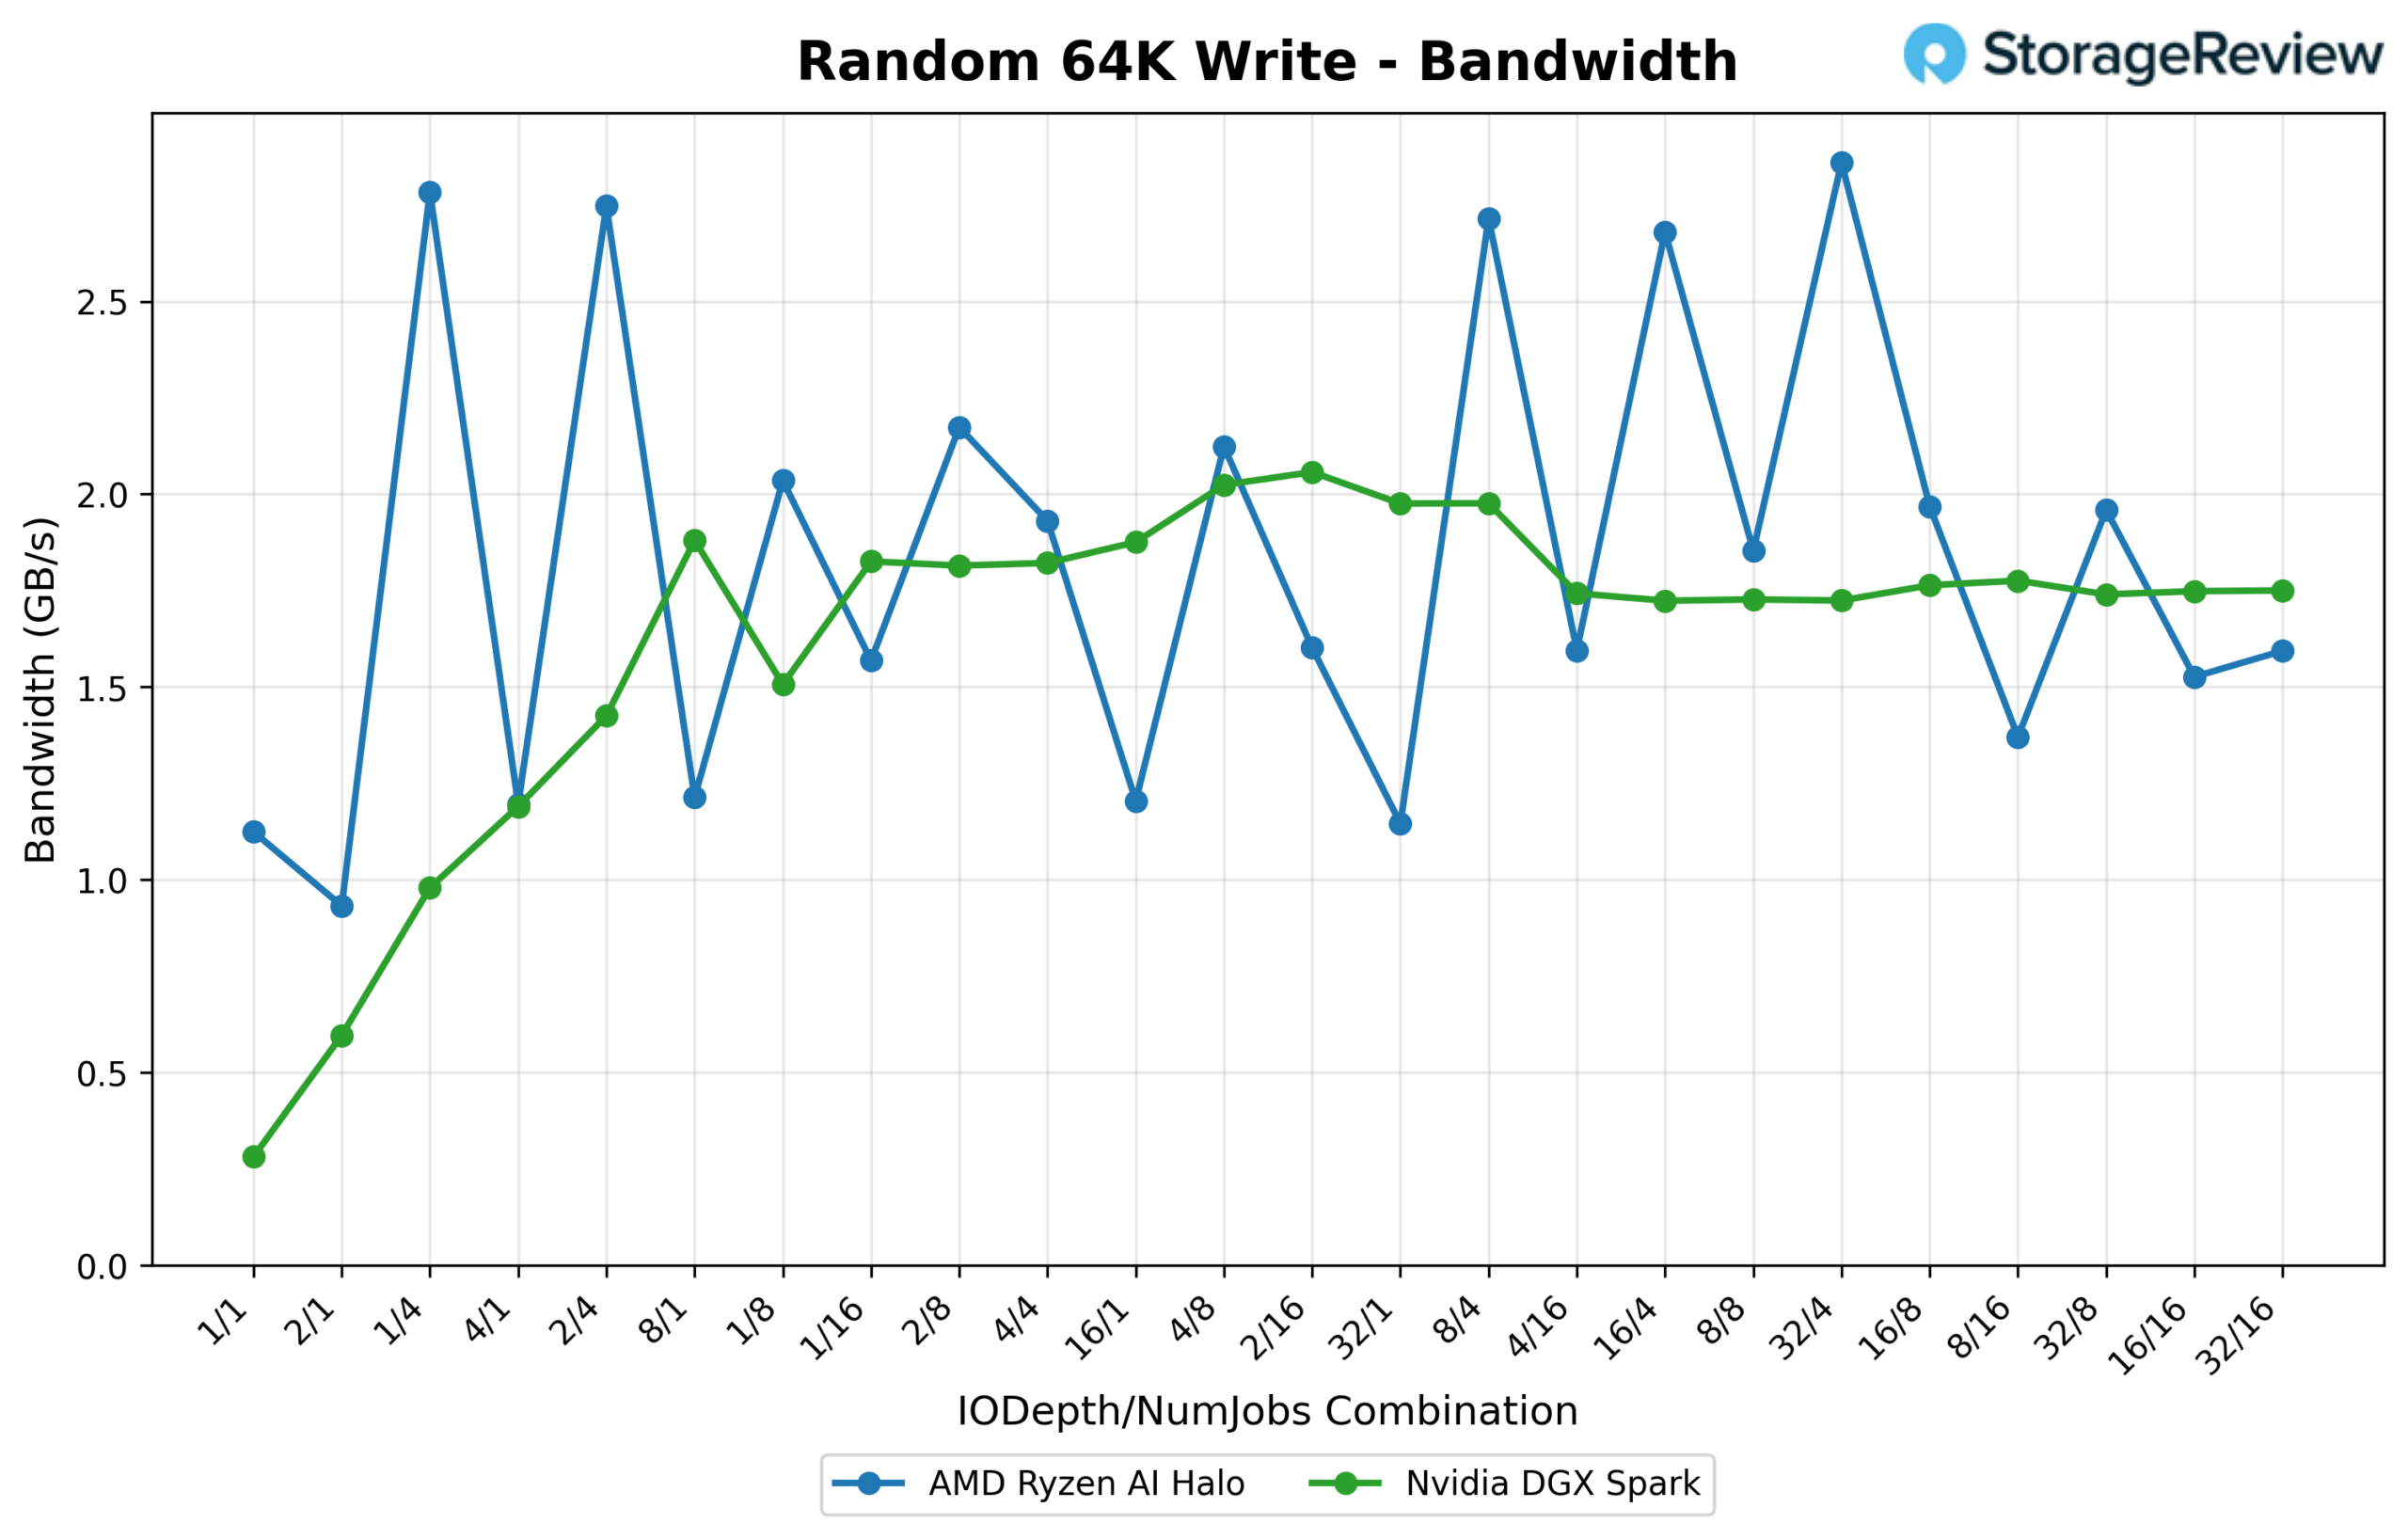
El ancho de banda de escritura aleatoria de 64K es más similar entre las dos plataformas que el de lectura, aunque las formas de las curvas son muy diferentes. El ancho de banda del Halo es más irregular: salta repetidamente por encima de 2.5 GB/s (con un pico de 2,929.1 MB/s / 46.9K IOPS a 32/4) antes de volver al rango de 1.1–1.5 GB/s en combinaciones adyacentes. El Spark es comparativamente más estable, manteniéndose en una banda de 1.7–2.0 GB/s durante la mayor parte del barrido y alcanzando un pico de 2,106.6 MB/s (33.7K IOPS) a 2/16.
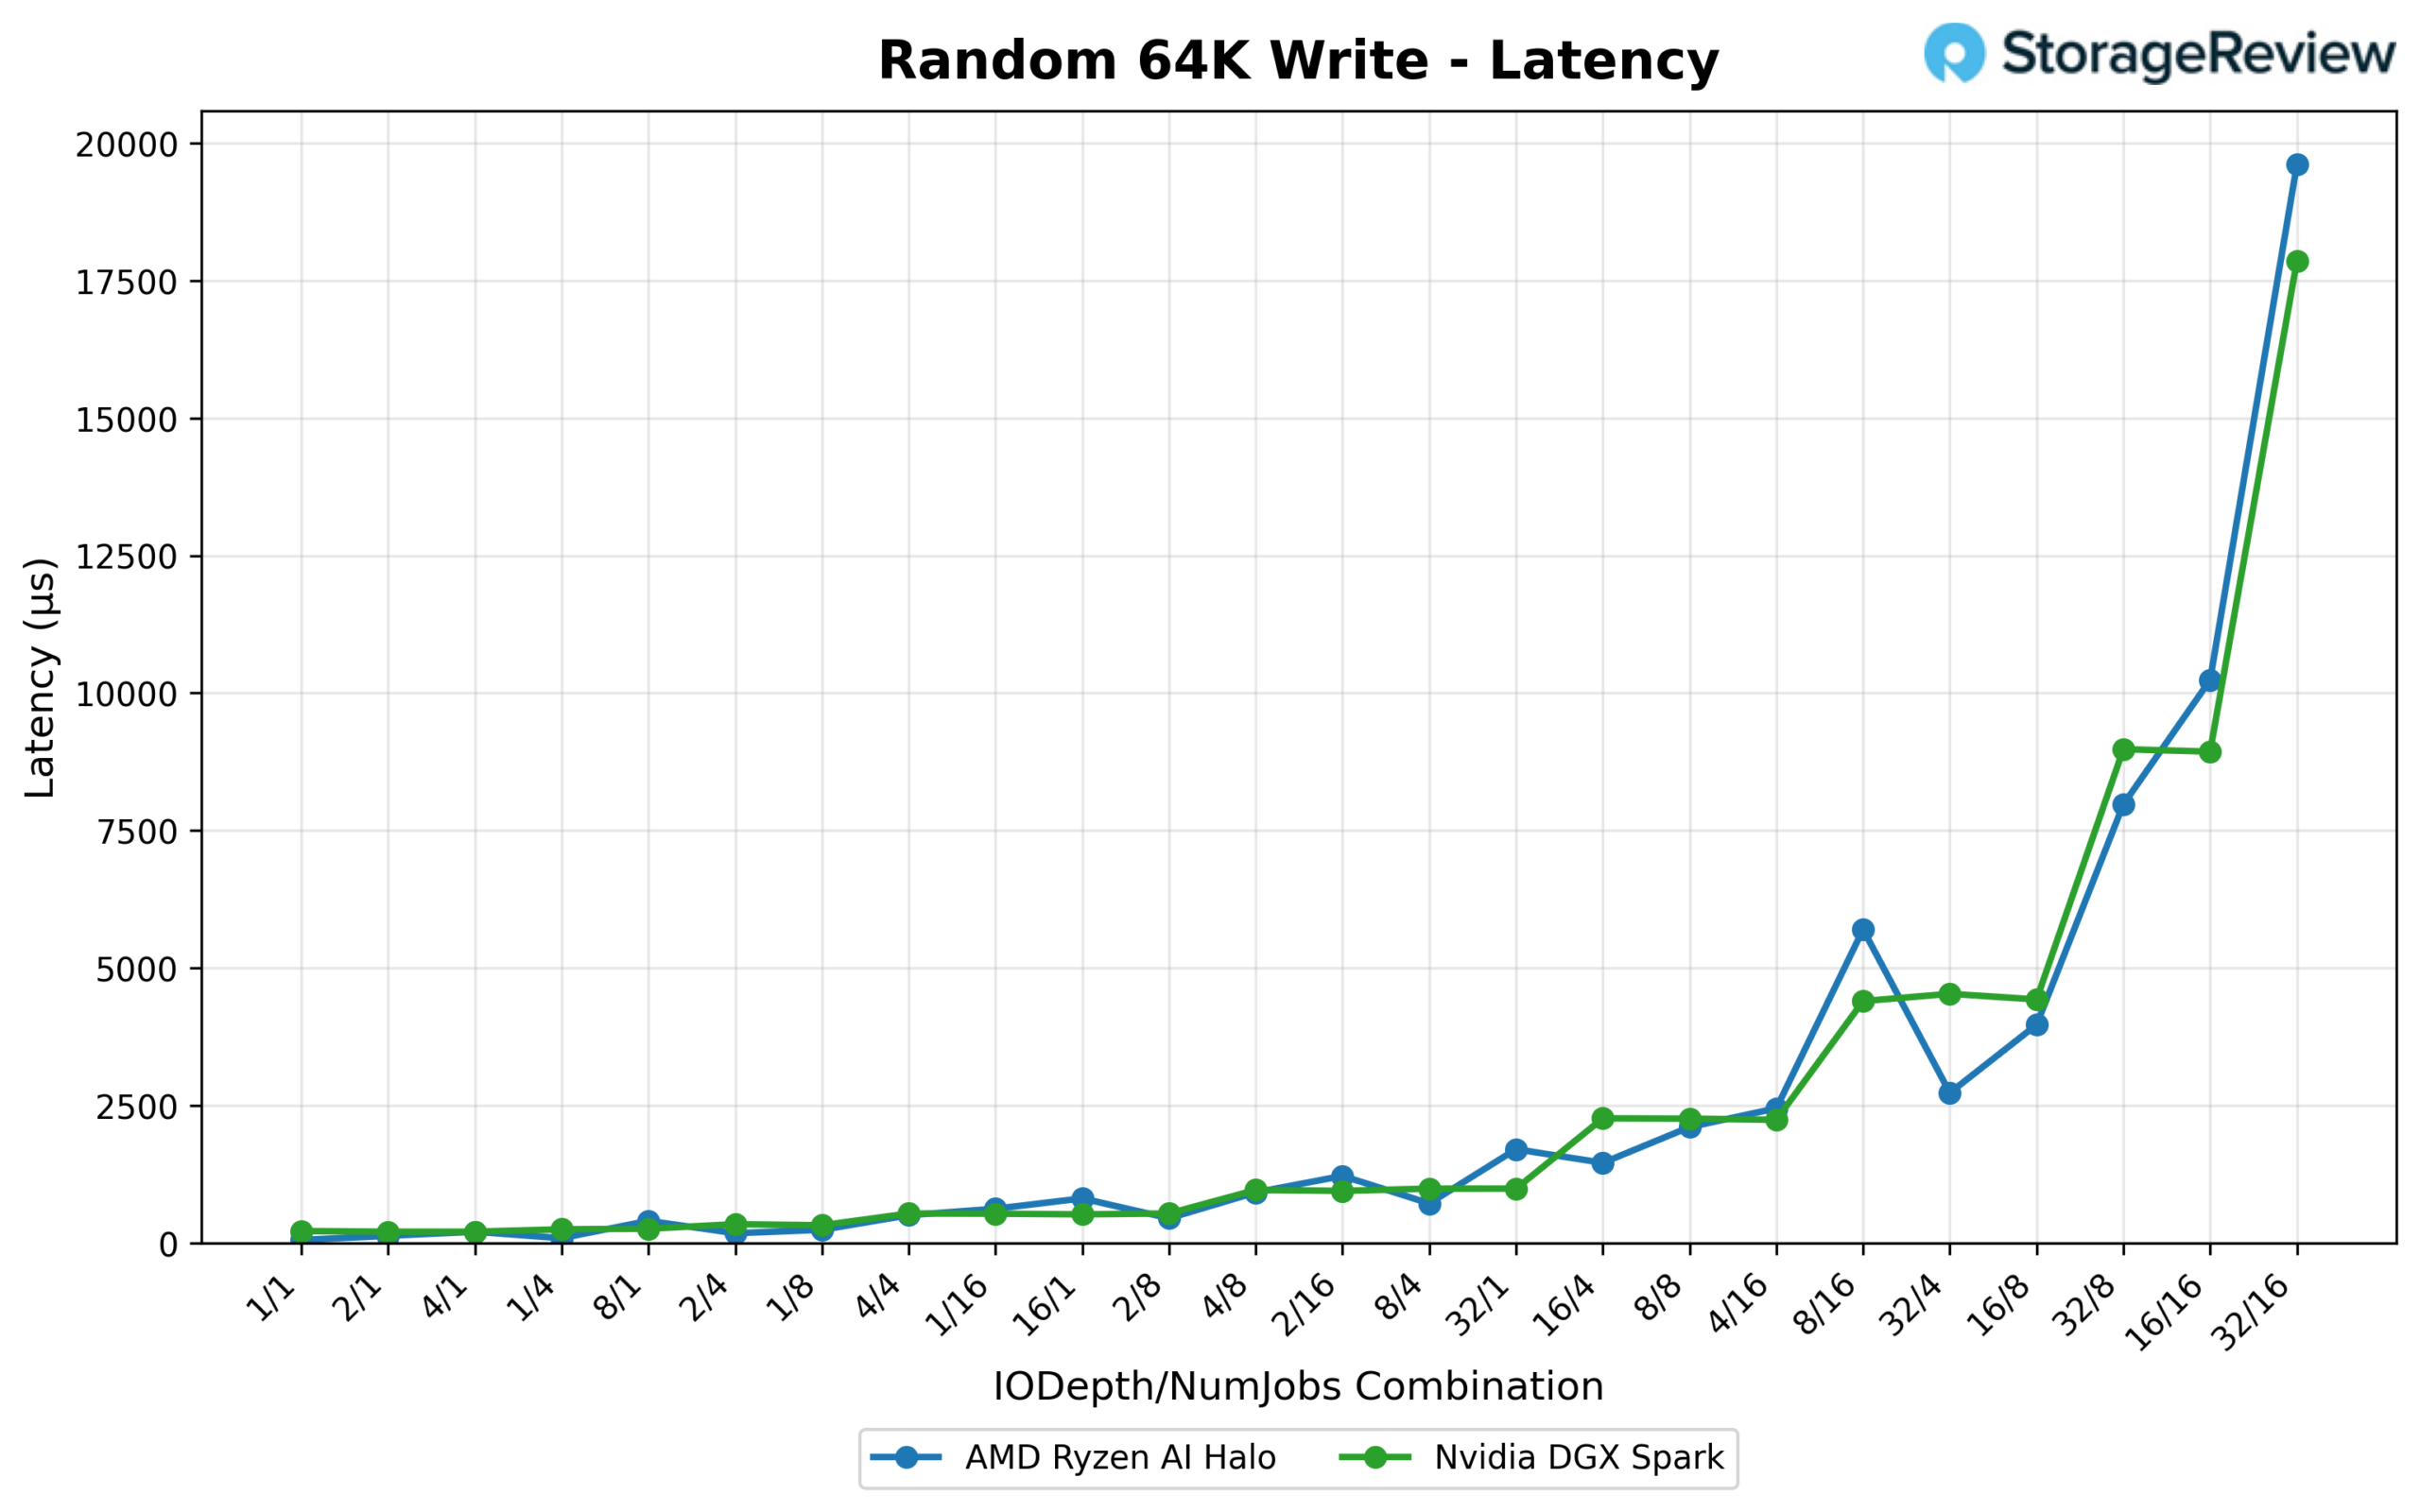
La latencia refleja el patrón de lectura de 64K: el Halo es notablemente más rápido con una profundidad de cola baja (0.054 ms en 1/1 frente a 0.217 ms para el Spark), y ambos discos se degradan drásticamente a medida que la profundidad de la cola y el número de hilos aumentan a dos dígitos. Con la saturación completa (32/16), la latencia del Halo alcanza los 19.611 ms, en comparación con los 17.857 ms del Spark. Ambos discos están claramente sometidos a una fuerte carga de amplificación de escritura en este punto, y el Halo vuelve a ser ligeramente peor en la parte superior de la curva.
Lectura secuencial de 16K
El ancho de banda se mantiene alto durante la mayor parte del análisis, con ambas unidades oscilando entre aproximadamente 1 y 8 GB/s dependiendo de la combinación de profundidad/hilos. El Spark supera ligeramente el pico más alto, alcanzando 8,069.3 MB/s (516.4K IOPS) a 32/1, mientras que el Halo alcanza un máximo de 6,715.8 MB/s (429.8K IOPS) a 8/4.
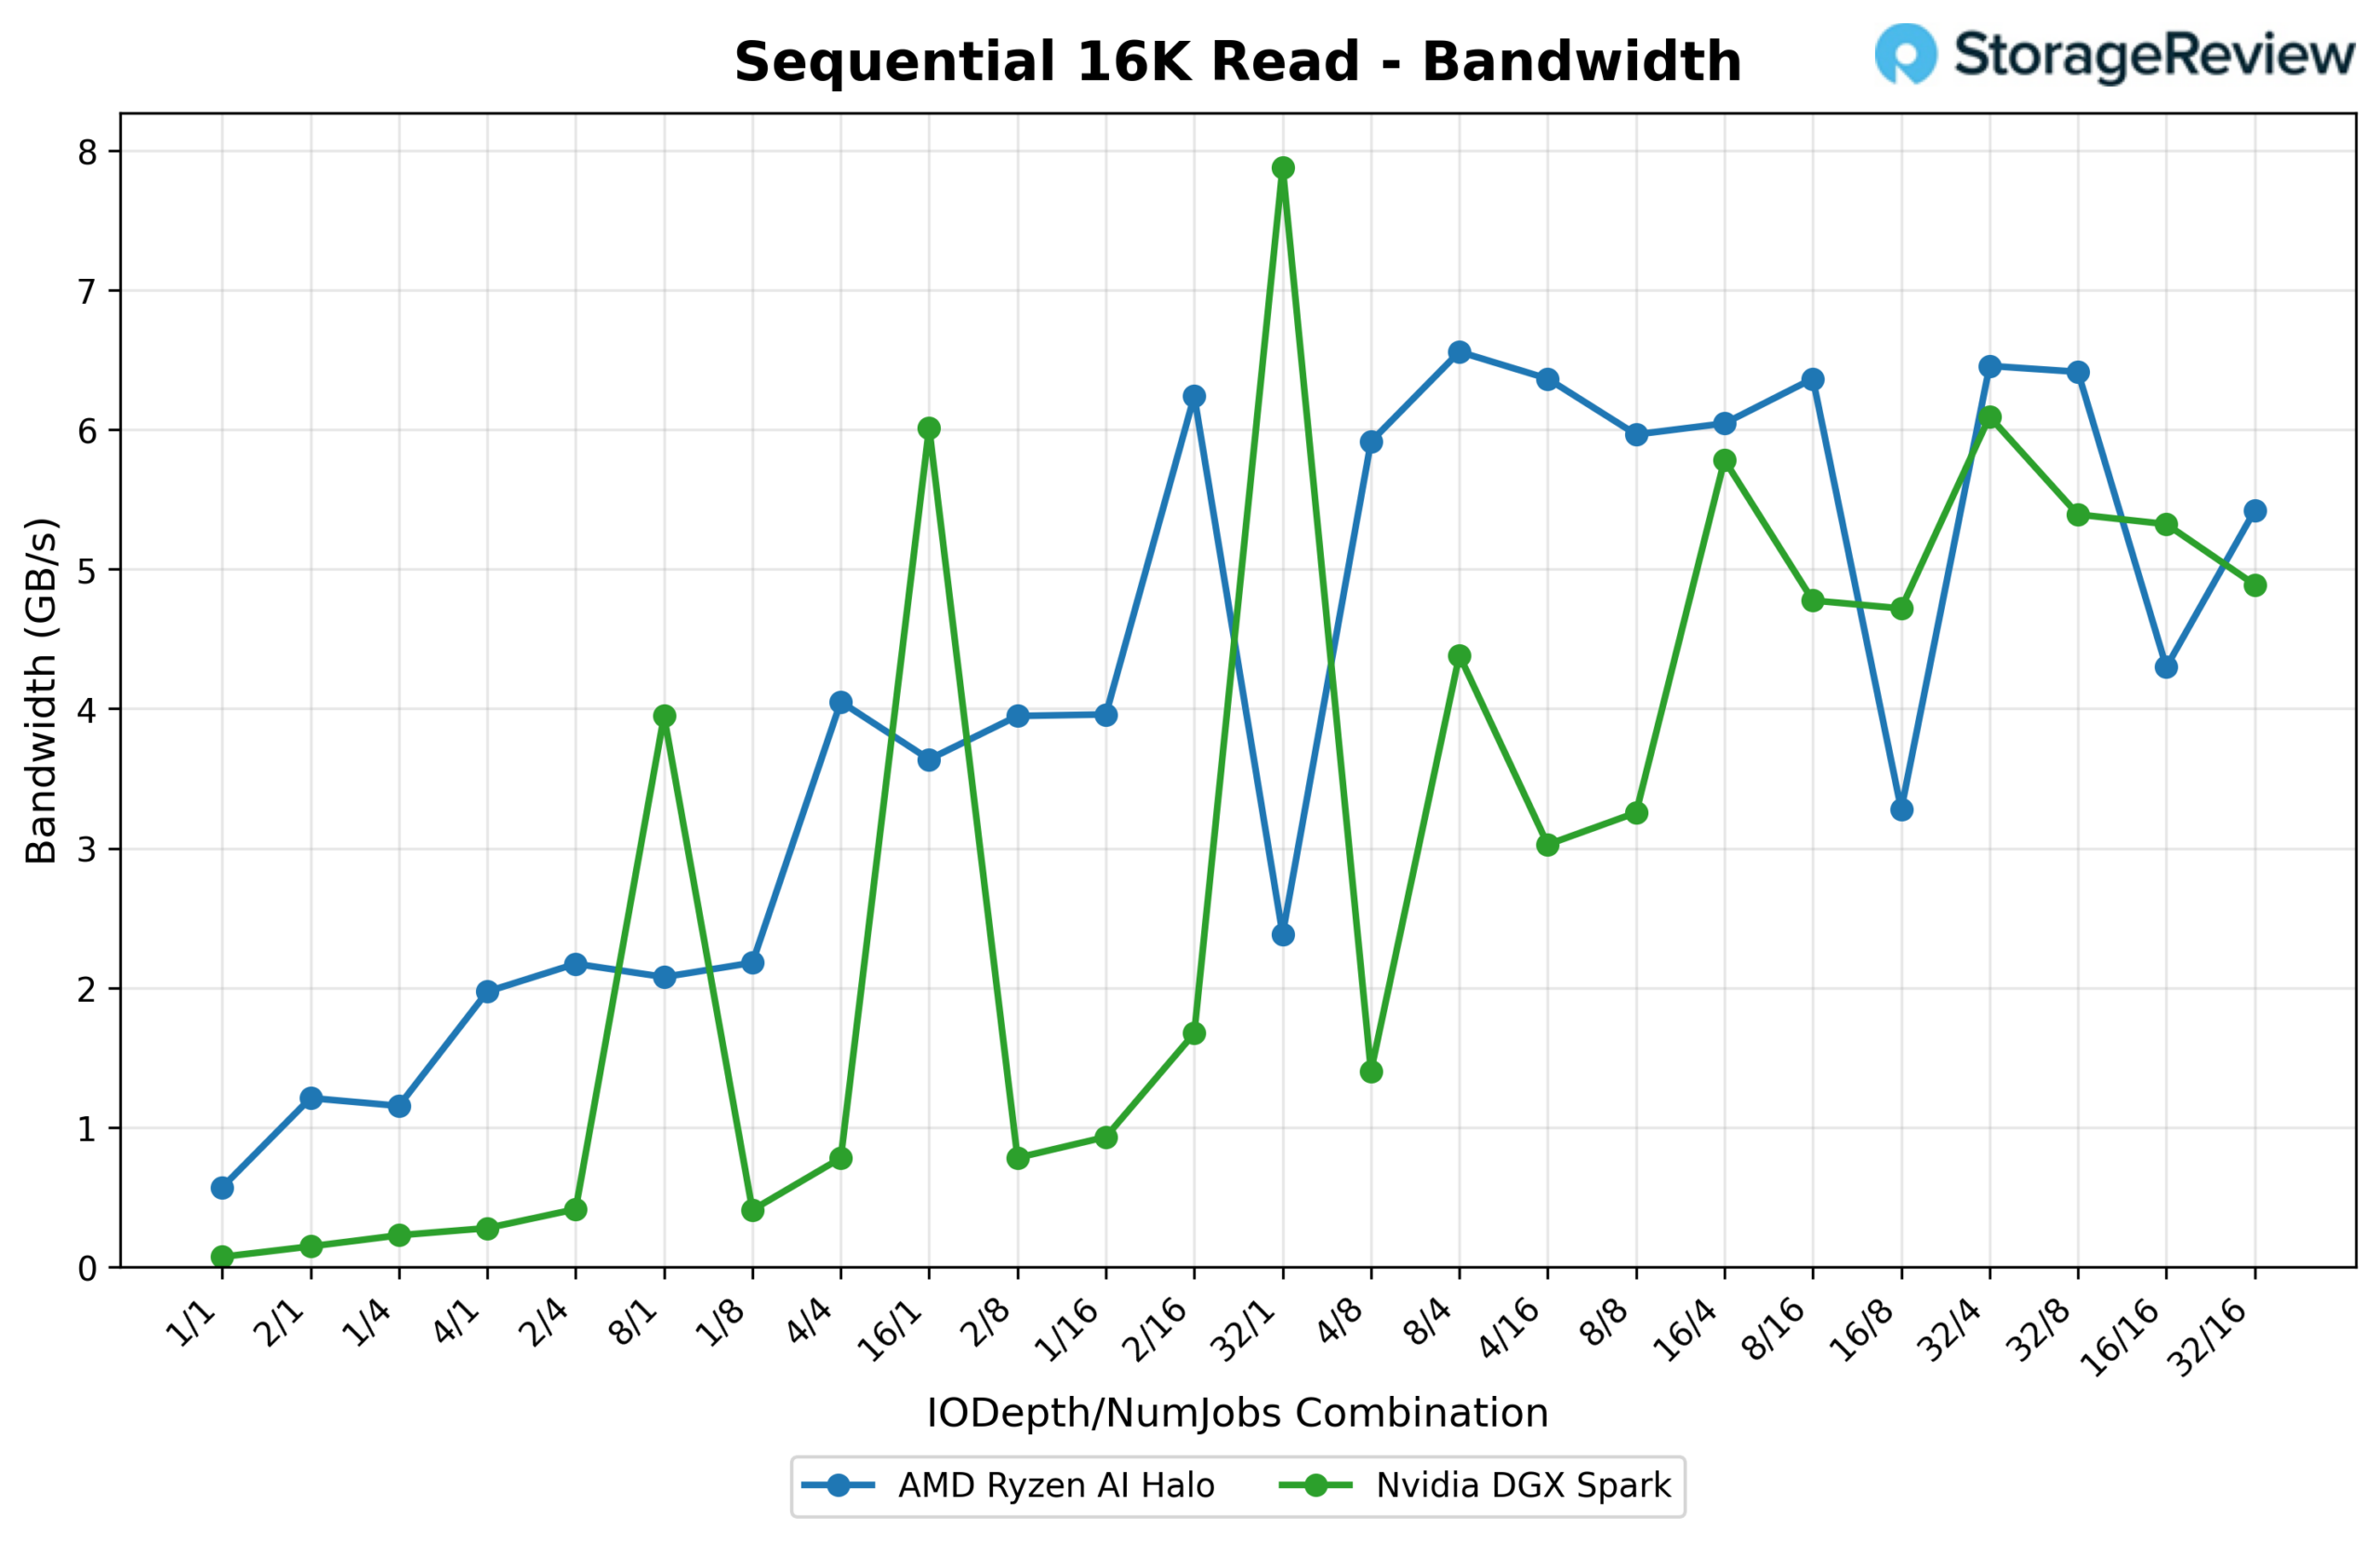
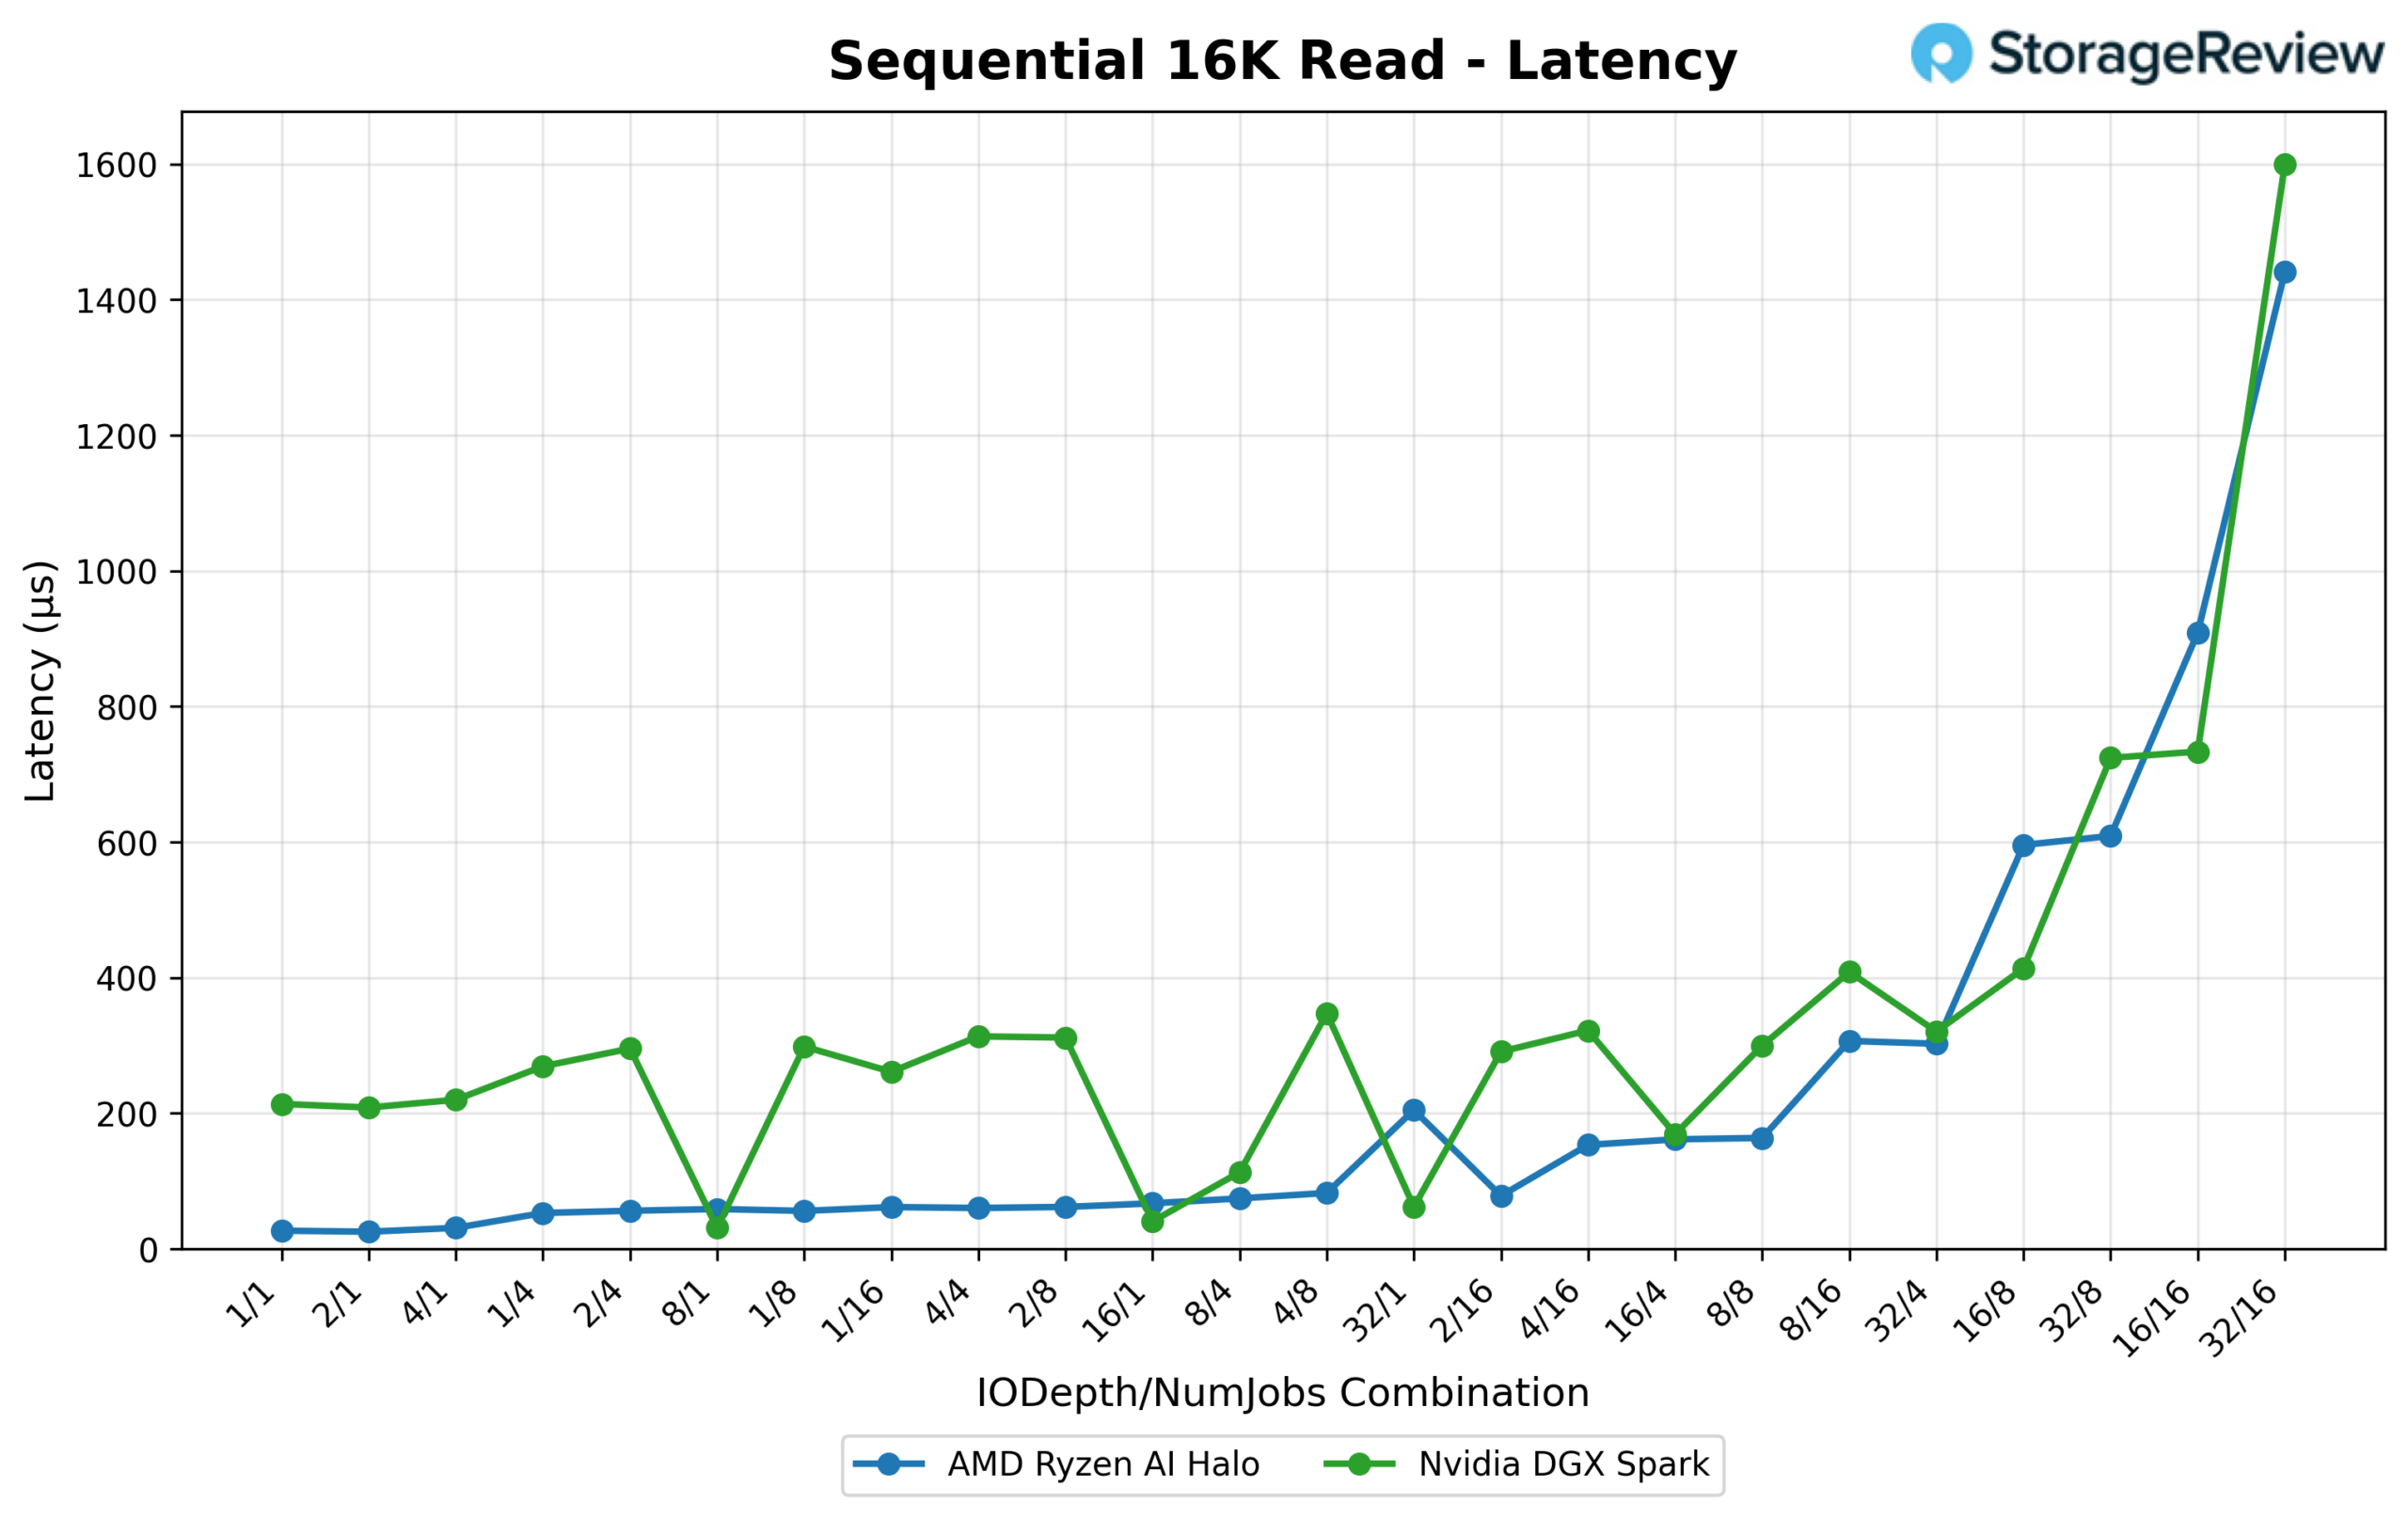
La latencia vuelve a favorecer al Halo en todas partes, excepto en la parte superior de la cola. En 1/1, el Halo responde en 0.027 ms frente a los 0.214 ms del Spark, y el Halo mantiene una latencia menor durante la mayor parte del barrido. Solo en las combinaciones más profundas se cierra la diferencia. En 32/16, la latencia media del Halo de 1.441 ms se sitúa justo por debajo de los 1.599 ms del Spark, lo que convierte a este en uno de los pocos puntos donde la curva de latencia del Halo no supera con creces la del Spark al alcanzar la saturación.
Escritura secuencial de 16K
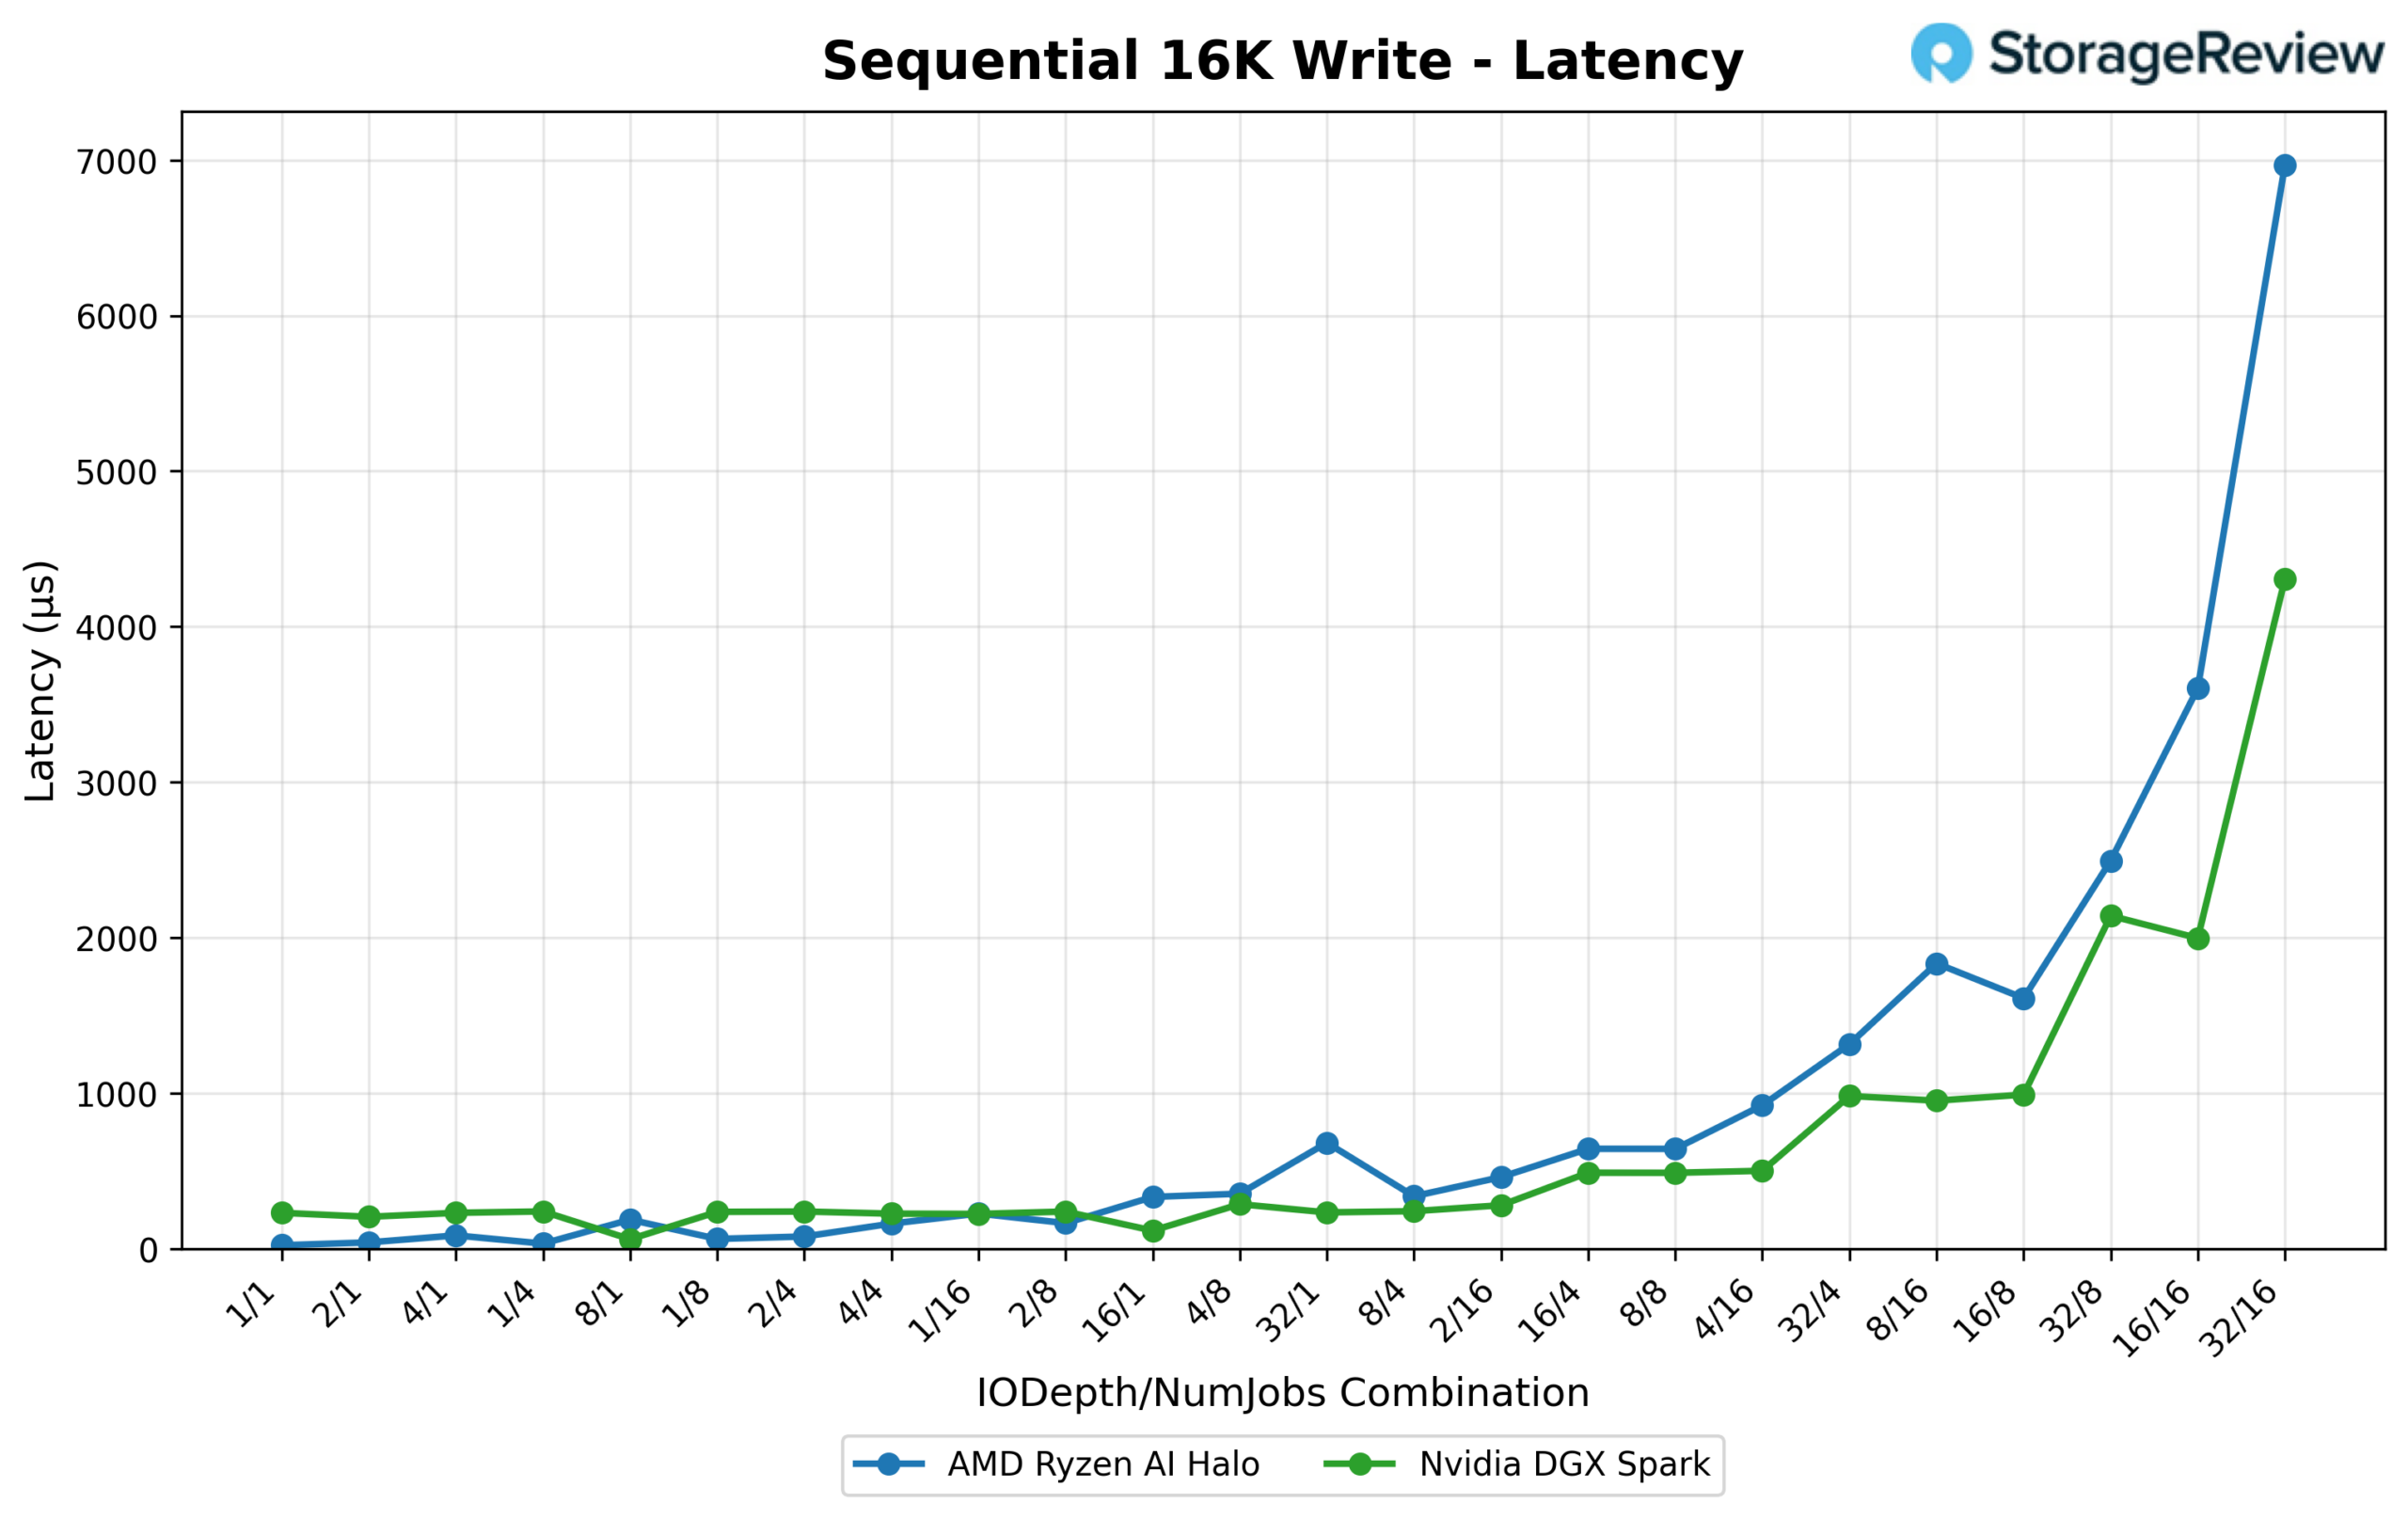
El ancho de banda también es similar en este caso: el Spark alcanza un máximo de 2,141.6 MB/s (137.1 IOPS) a 16/1, y el Halo no se queda atrás con 1,970.9 MB/s (126.1 IOPS) a 1/8.
La latencia es donde ambos dispositivos divergen notablemente. El Halo comienza muy por delante con poca profundidad de cola (0.022 ms en 1/1 frente a los 0.231 ms del Spark), pero su curva de latencia aumenta drásticamente a medida que la cola se llena. Para 32/16, la latencia media del Halo ha subido a 6.967 ms, muy por encima de los 4.306 ms del Spark en el mismo punto. La curva del Halo también es mucho menos predecible a lo largo del proceso, con picos pronunciados en varias combinaciones de rango medio donde el Spark se mantiene relativamente plano.
Lectura aleatoria 16K
Este es uno de los mejores resultados de Halo. De hecho, registra un ancho de banda máximo superior de 6,609.4 MB/s (423.0 IOPS) a 32/16, frente a los 6,082.6 MB/s (389.3 IOPS) del Spark con la misma combinación.
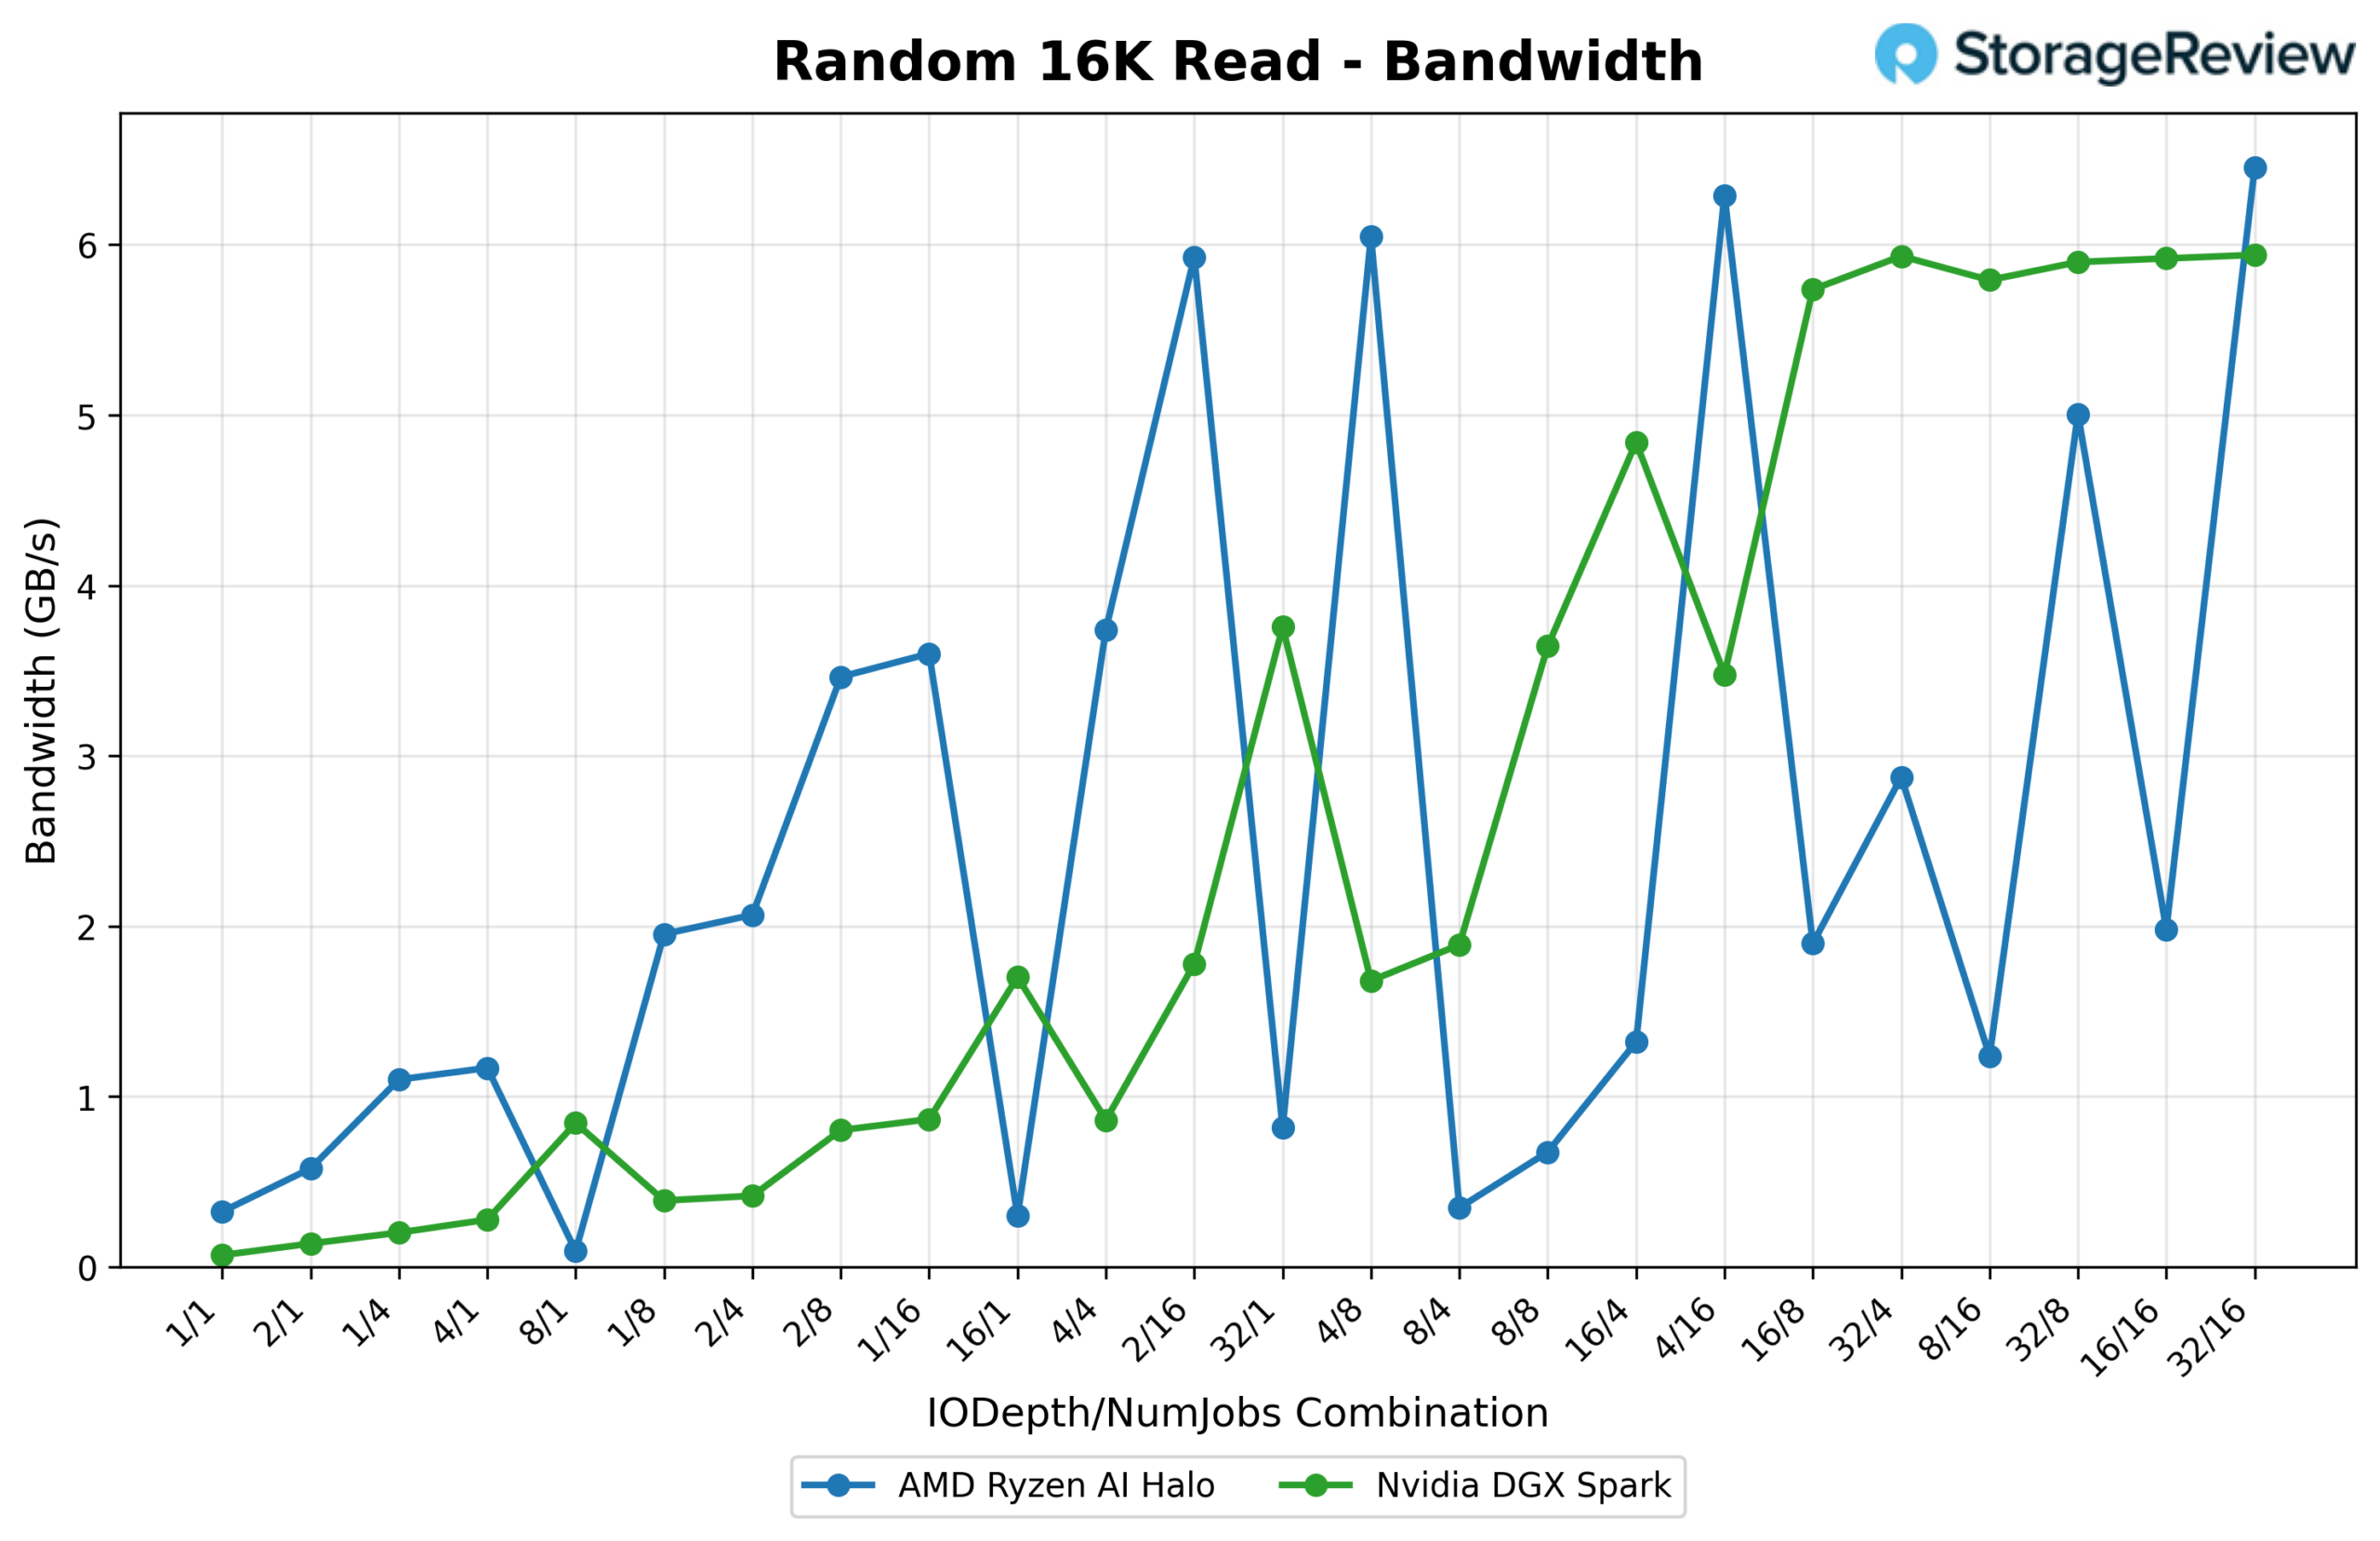
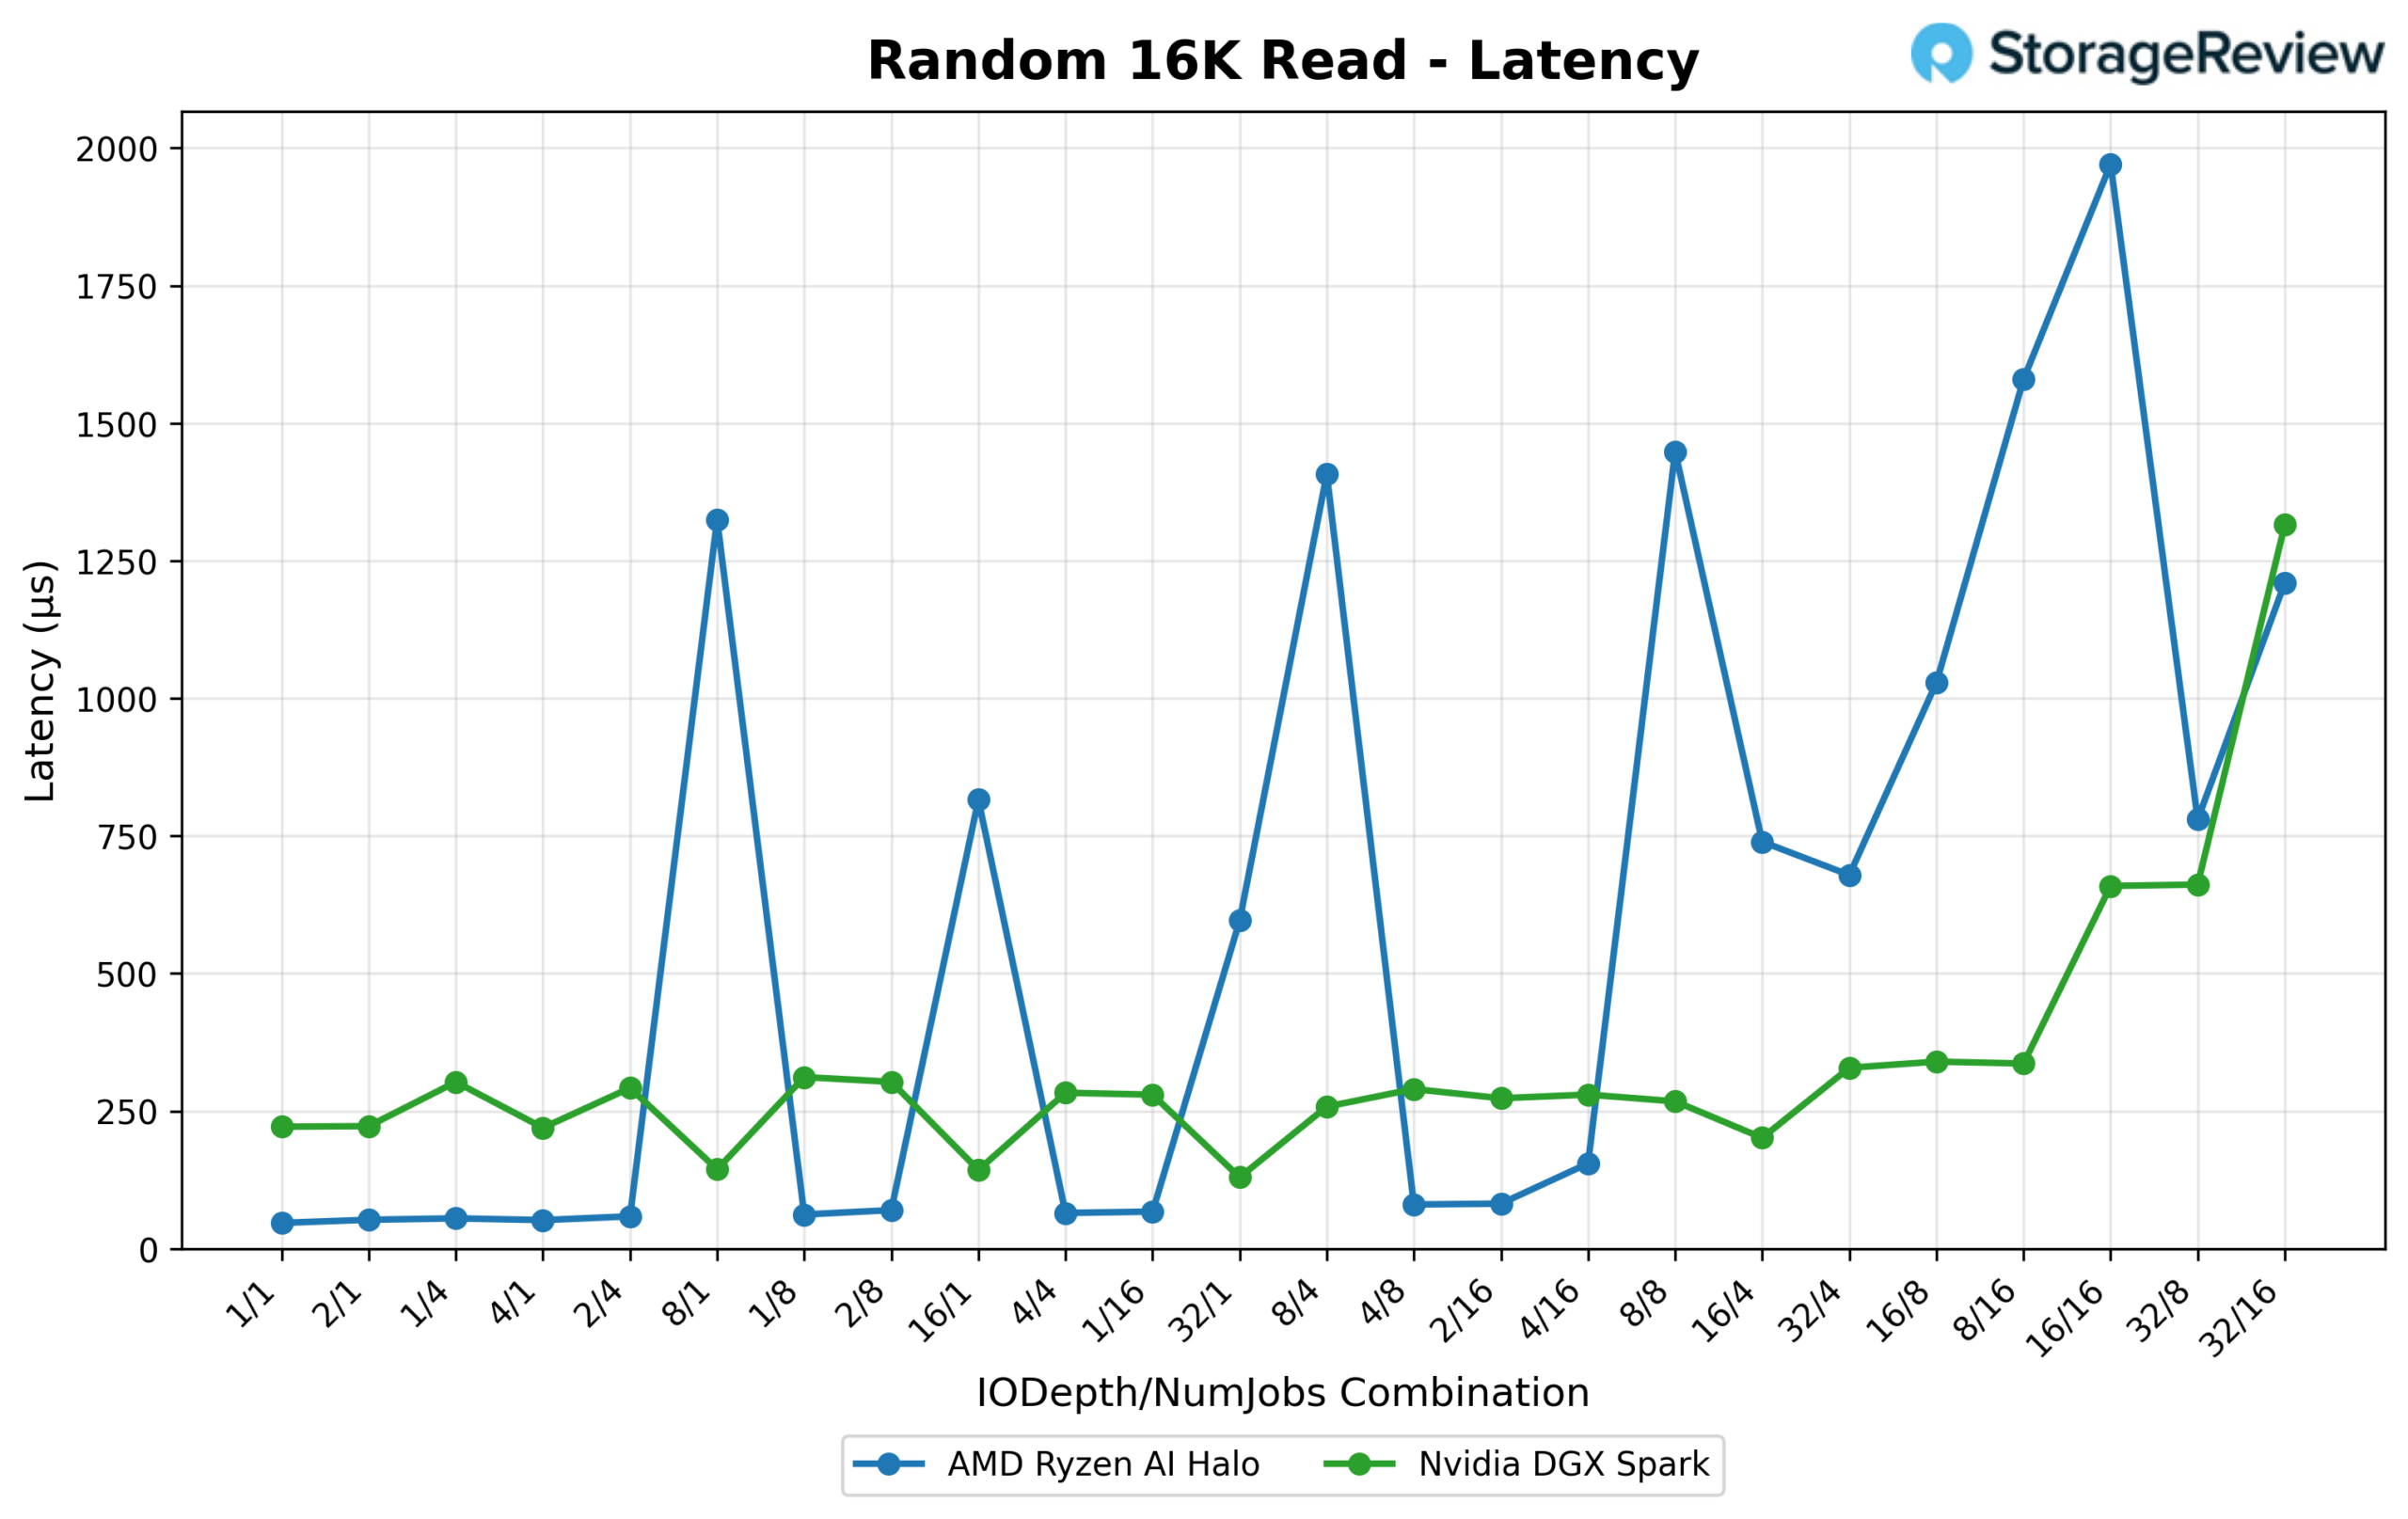
La latencia comienza de nuevo muy a favor del Halo (0.047 ms en 1/1 frente a 0.222 ms para el Spark). Sin embargo, la curva de latencia del Halo es mucho más volátil a lo largo del barrido, con picos pronunciados en 8/1, 16/1, 8/4 y 8/8 que se disparan muy por encima de la curva comparativamente suave (aunque de base más alta) del Spark. En la parte superior de la cola, la latencia máxima del Halo de 1.971 ms (en 16/16) supera la máxima del Spark de 1.315 ms (en 32/16), por lo que el Halo sacrifica consistencia por una velocidad bruta con poca profundidad de cola.
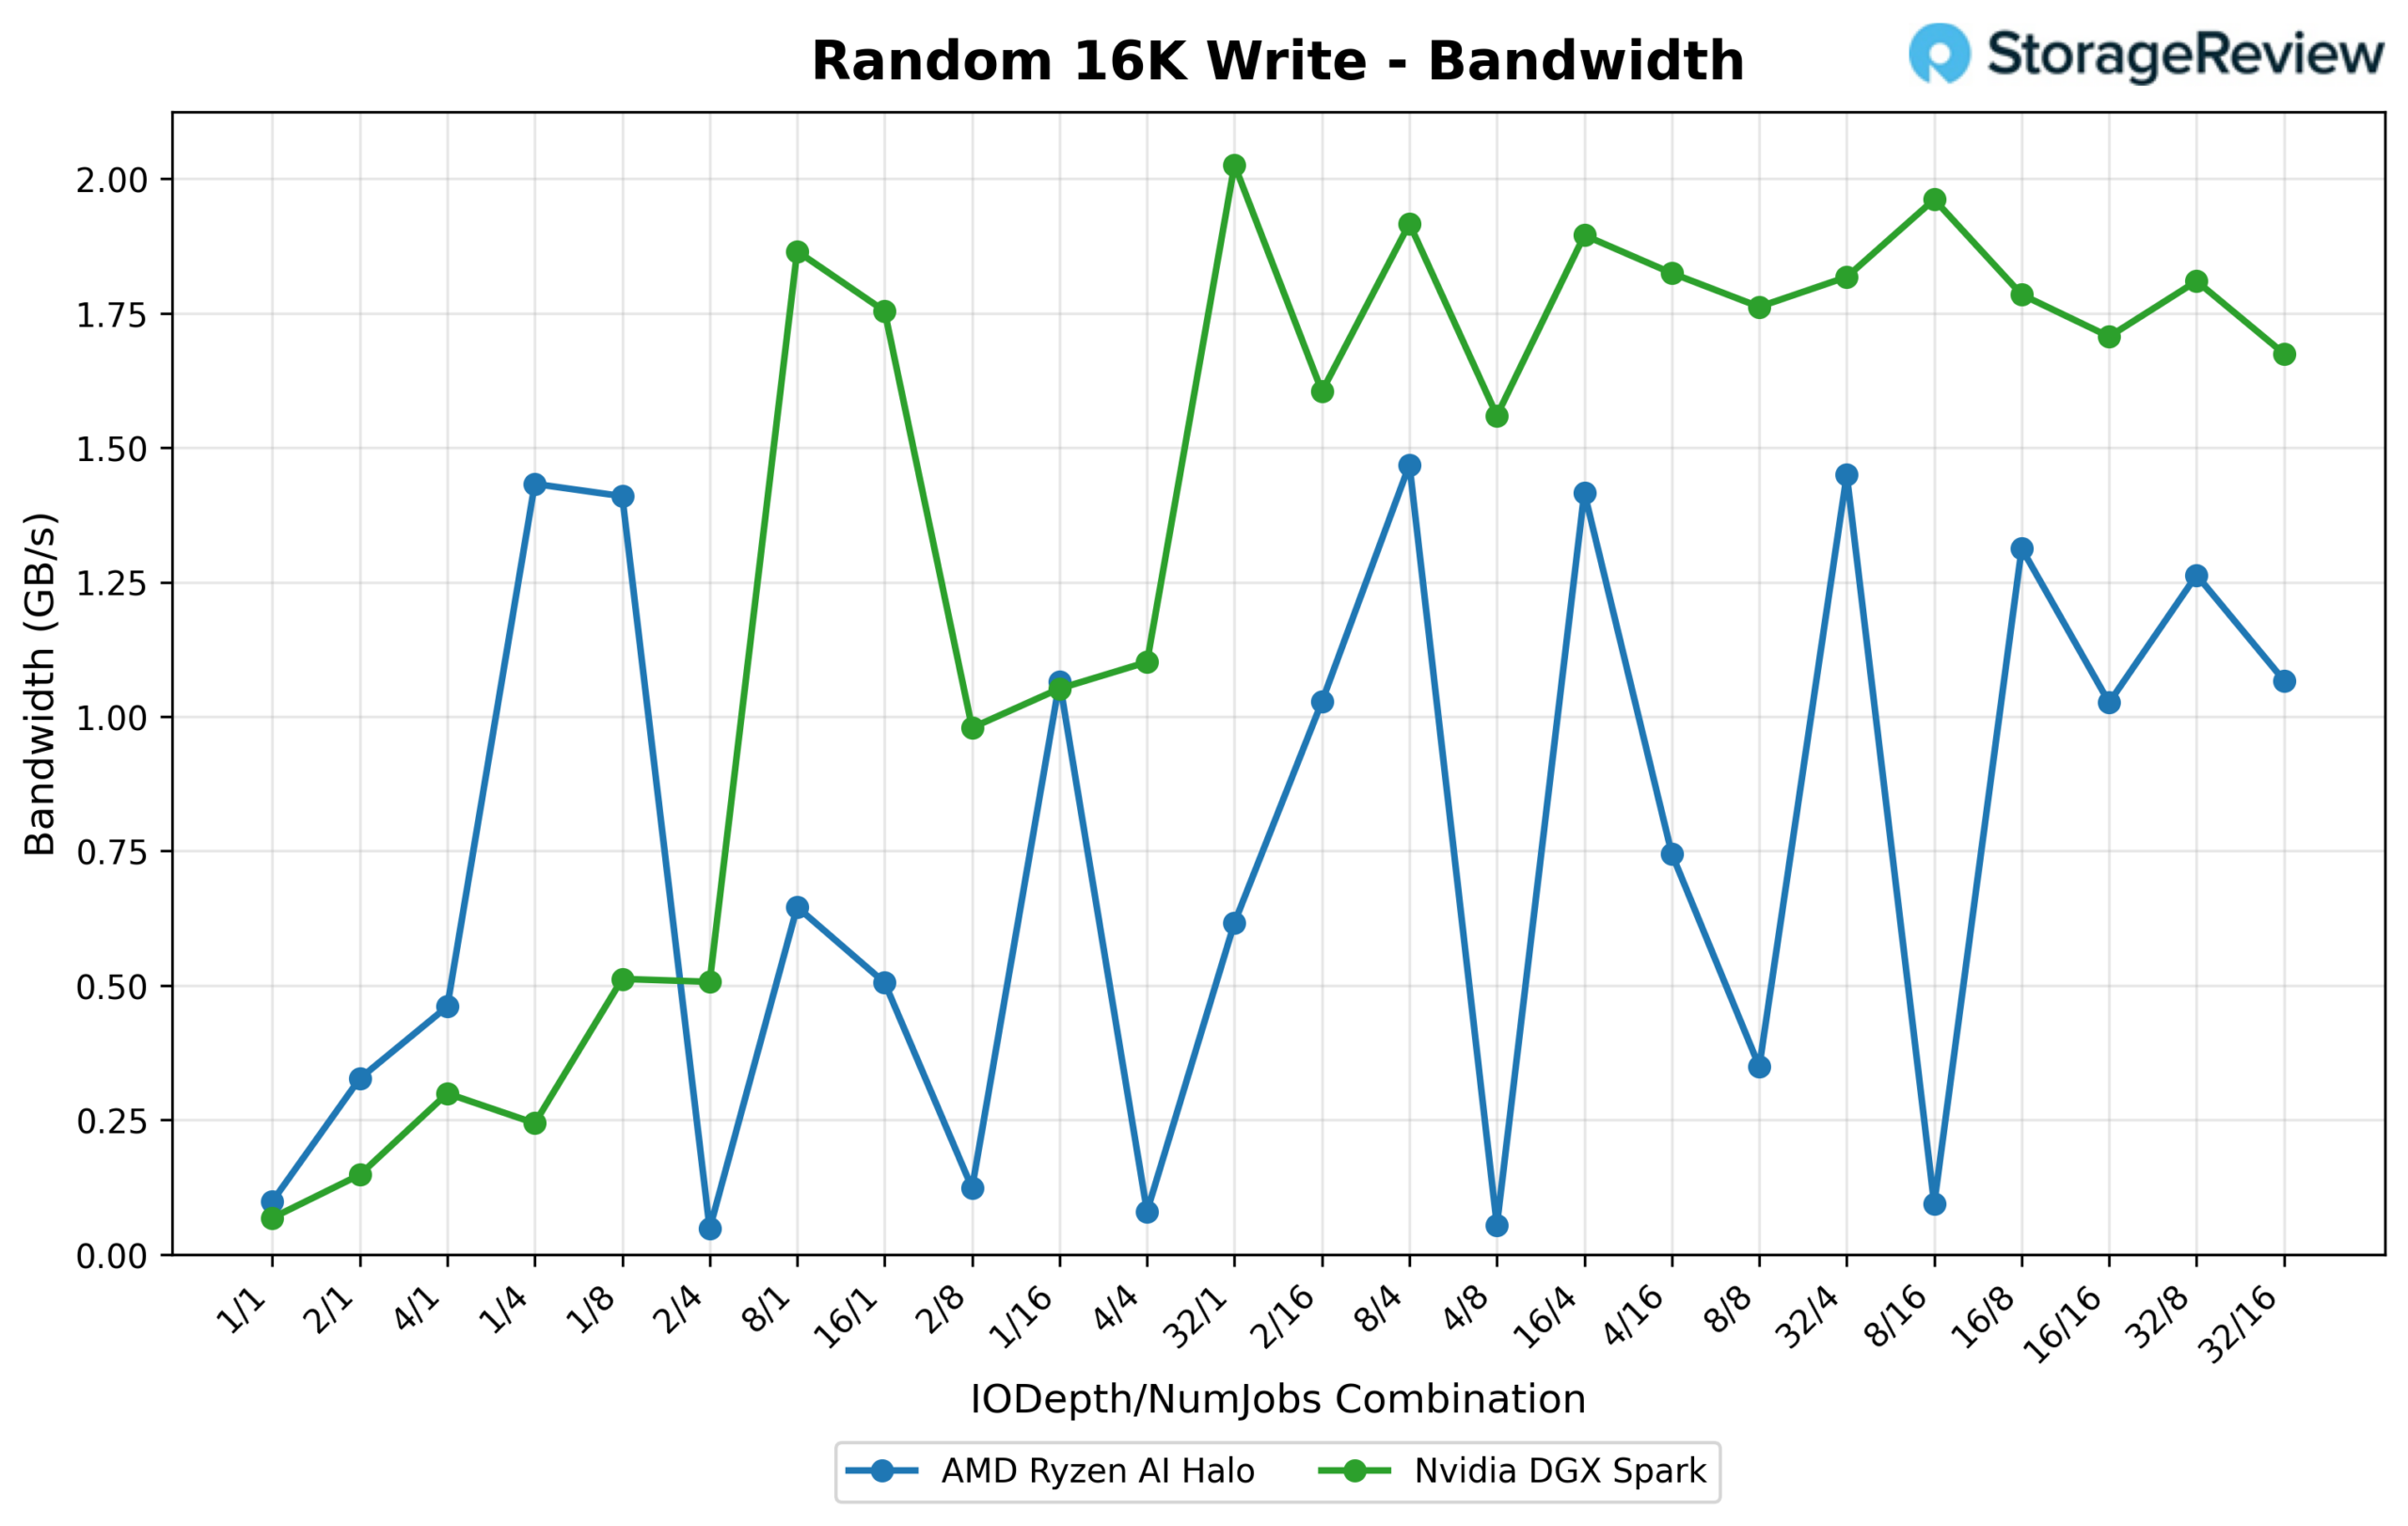
Escritura aleatoria 16K
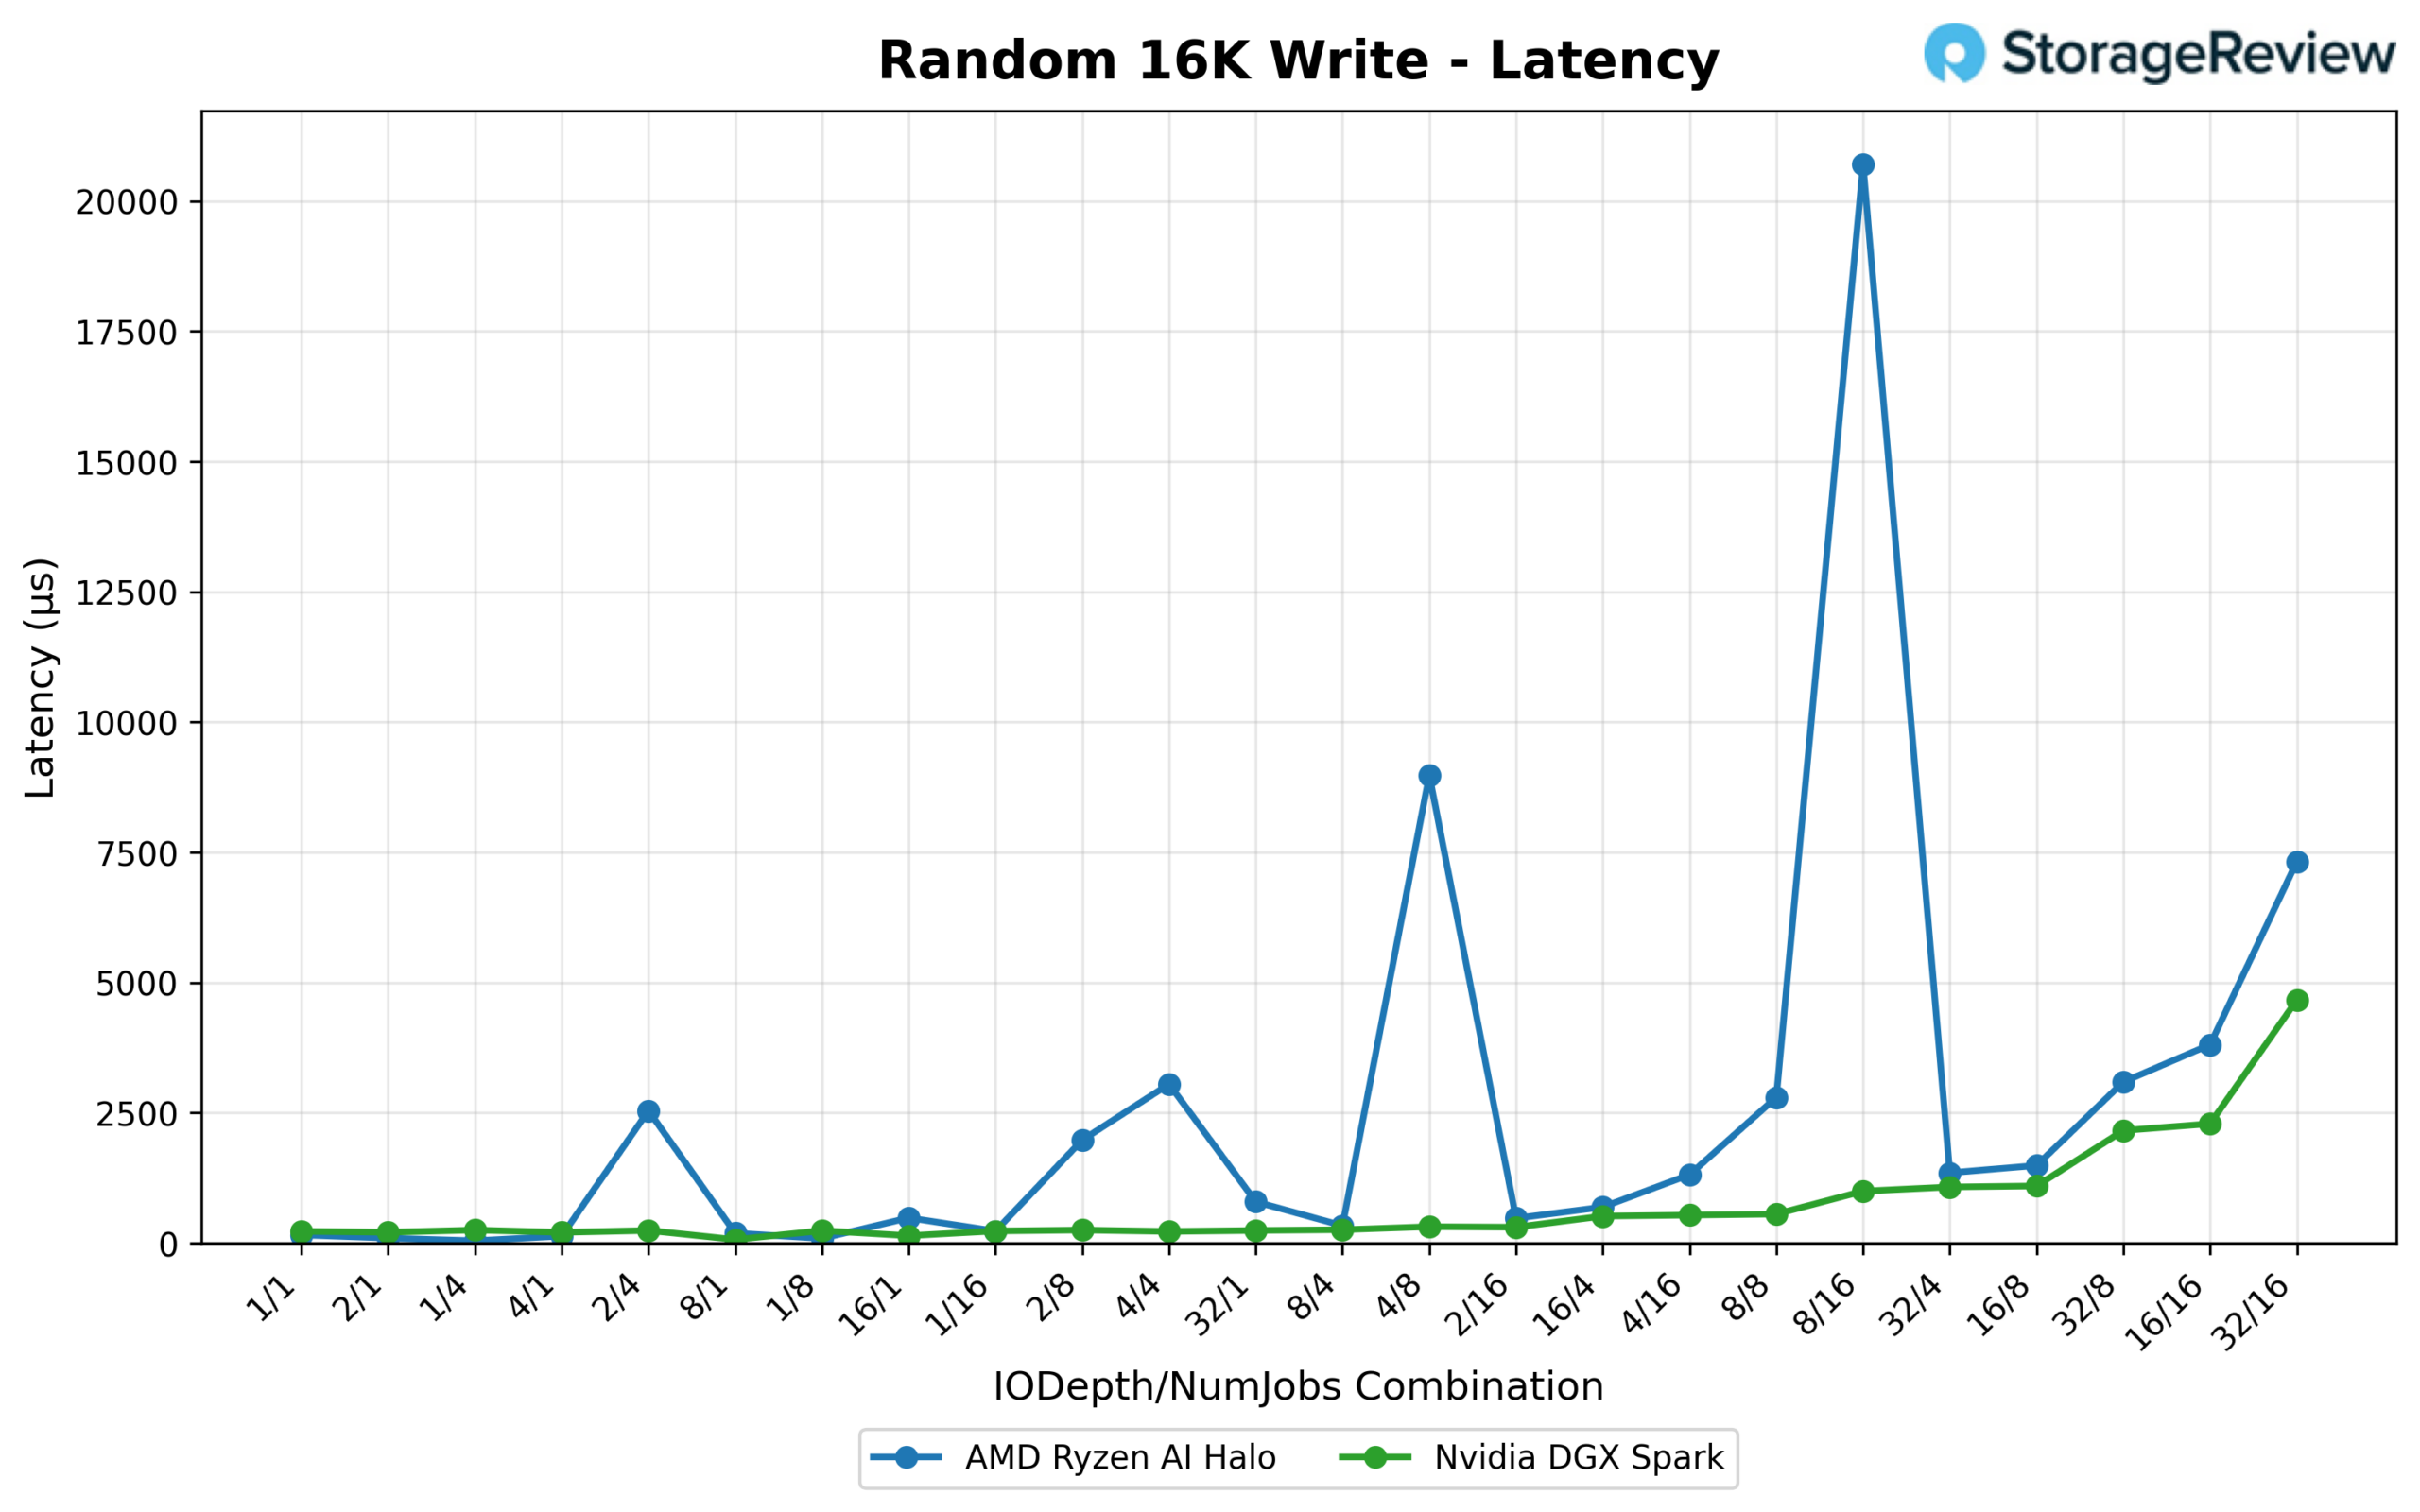
El ancho de banda favorece al Spark en este caso, alcanzando 2,074.1 MB/s (132 700 IOPS) a 32/1, en comparación con los 1,503.5 MB/s (96 200 IOPS) del Halo a 8/4. La curva de ancho de banda del Spark también es considerablemente más consistente, manteniéndose en el rango de 1.6 a 2.0 GB/s durante la mayor parte del barrido tras el aumento inicial. En comparación, el Halo presenta fluctuaciones bruscas entre aproximadamente 0.1 y 1.5 GB/s entre una combinación y otra.
La latencia es donde esta prueba destaca: Halo comienza con una latencia menor en 1/1 (0.154 ms frente a 0.224 ms), pero en 8/16 su latencia media se dispara a un valor extremo de 20.698 ms, casi 4.5 veces superior al peor caso de Spark (4.664 ms) en cualquier punto de la prueba. Aparte de ese pico puntual, la latencia de Halo es razonable, pero se trata de un valor atípico significativo que conviene tener en cuenta para cualquier carga de trabajo que pueda utilizar esa combinación específica de profundidad e hilos.
Lectura aleatoria 4K
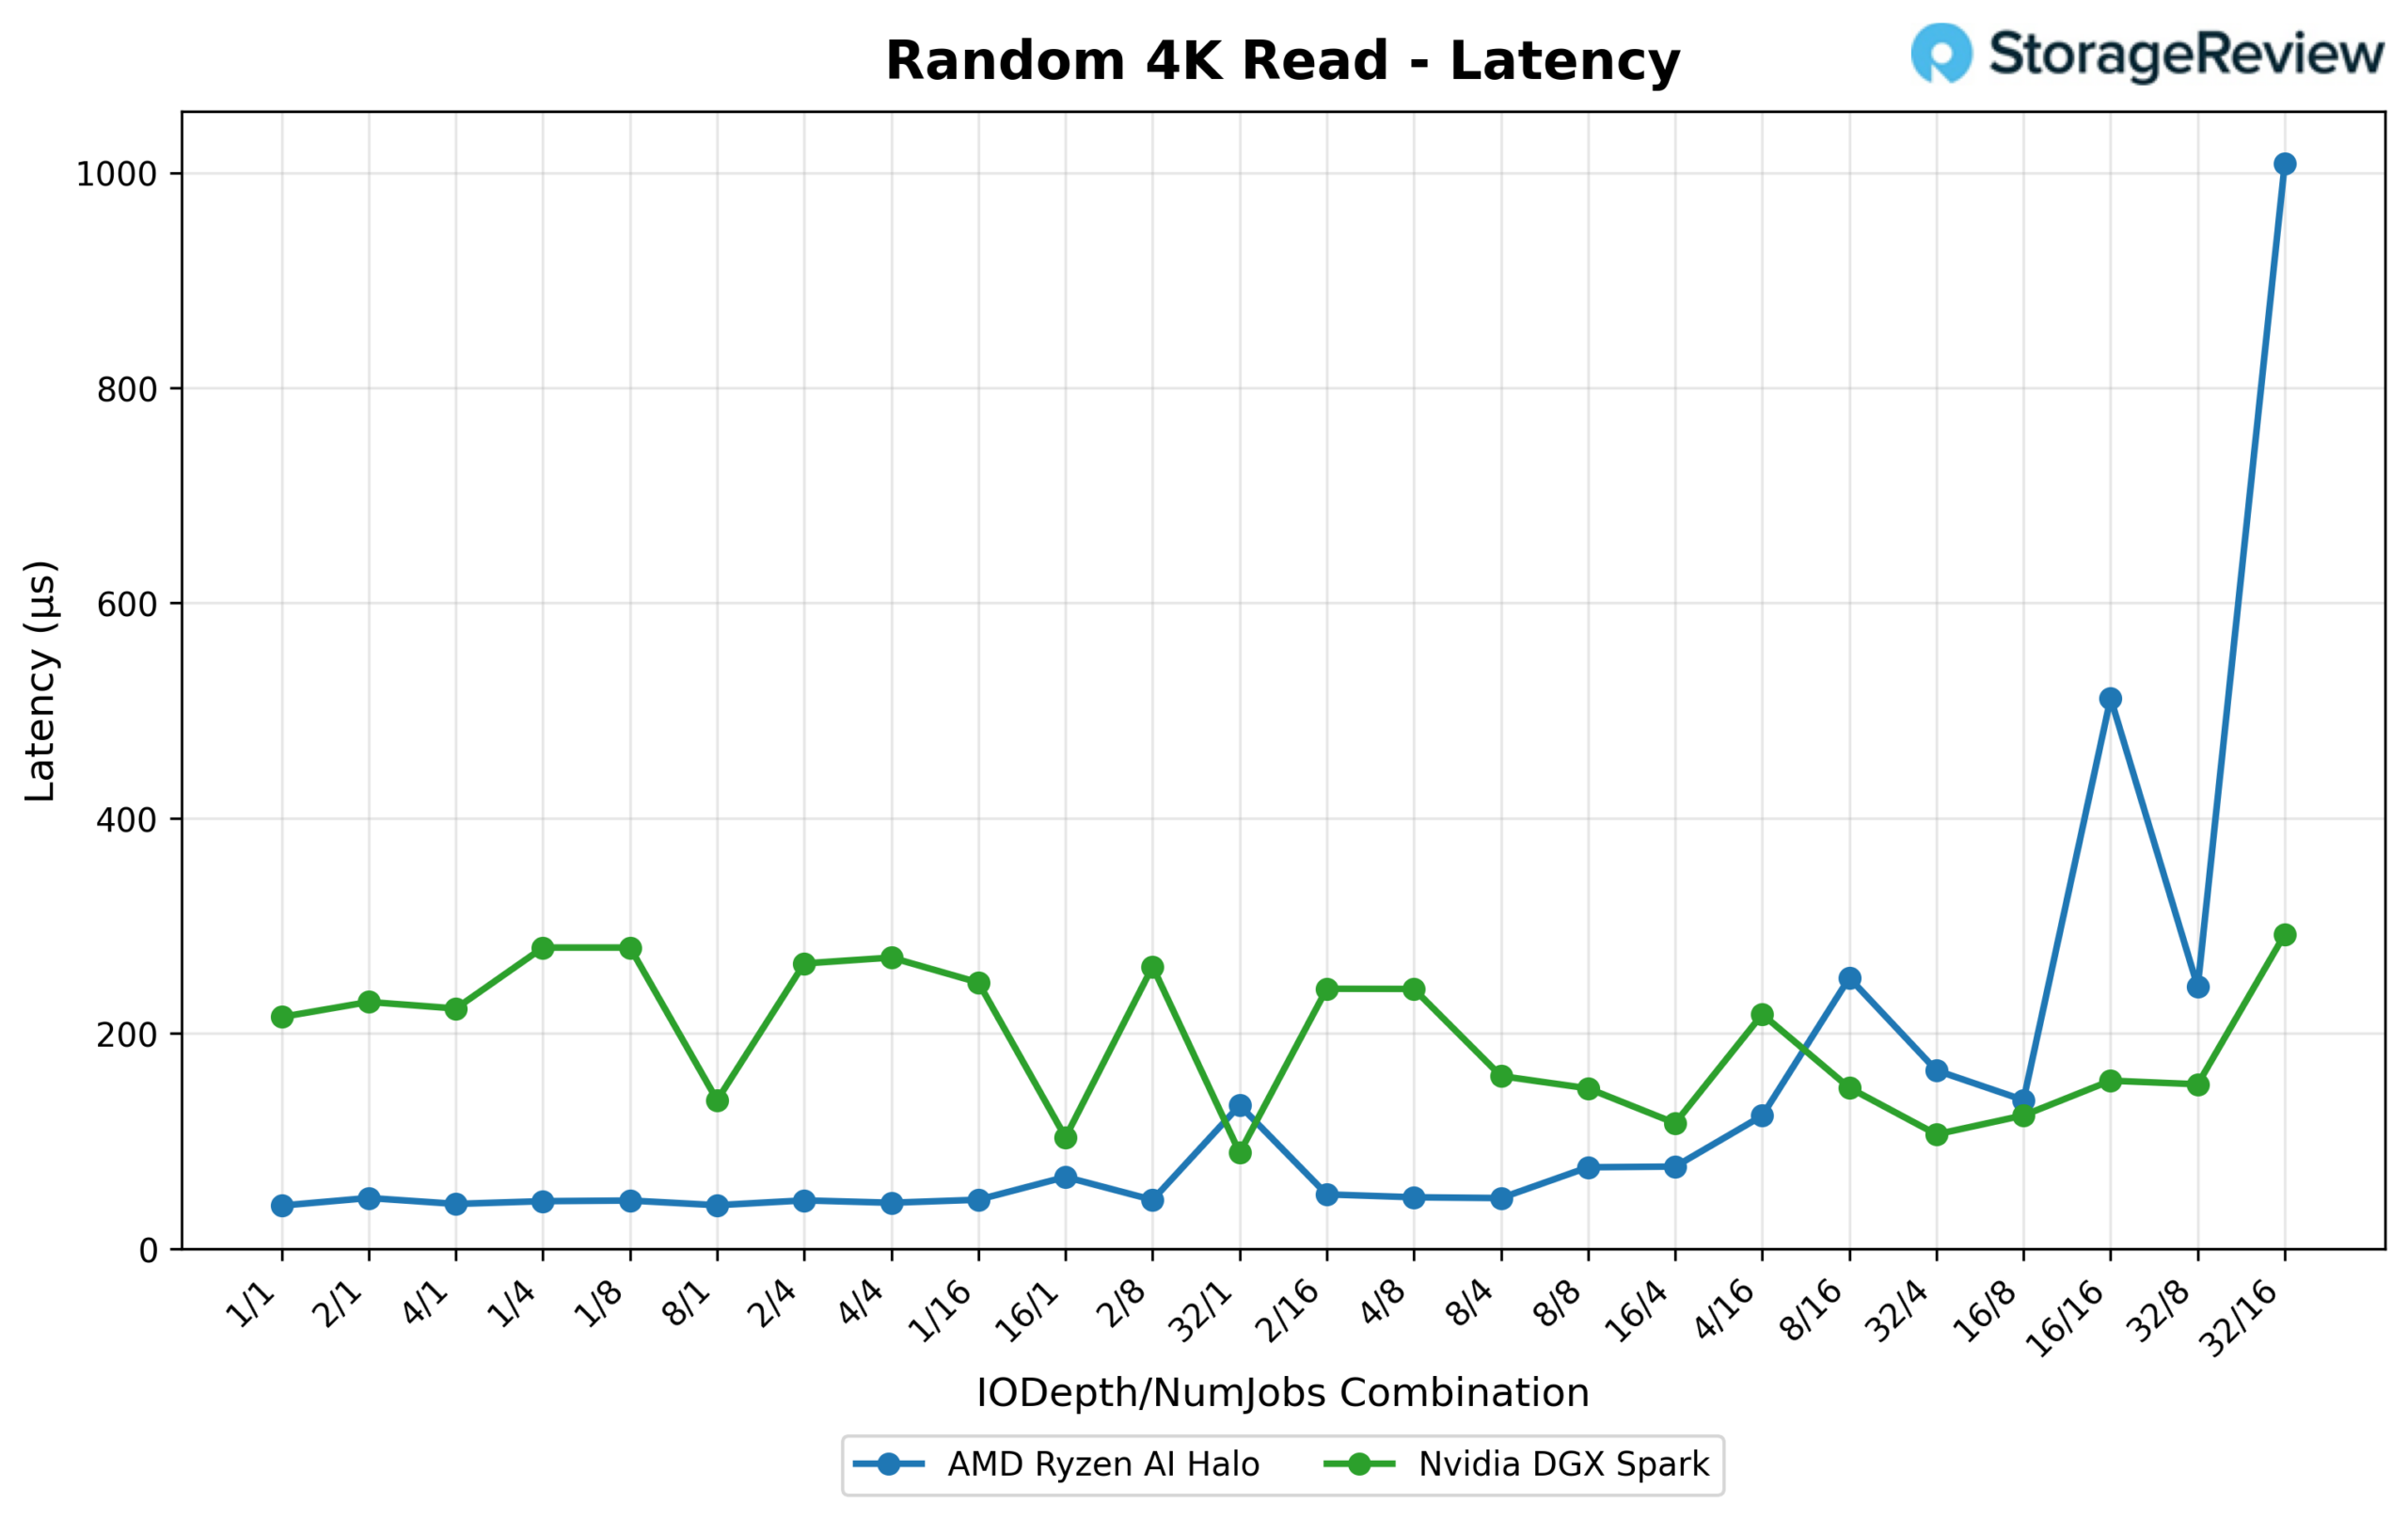
Con una baja profundidad de cola, el Halo responde mucho más rápido (0.04 ms a 1/1 frente a los 0.215 ms del Spark) y mantiene una ventaja de latencia en la mayor parte del rango bajo a medio de la prueba. Pero el Spark se impone decisivamente en rendimiento a gran escala: su pico de IOPS alcanza los 1,750.7K (6,838.8 MB/s) a 32/16, muy por encima del pico del Halo de 1,050.4K IOPS (4,103.2 MB/s) a 32/8.
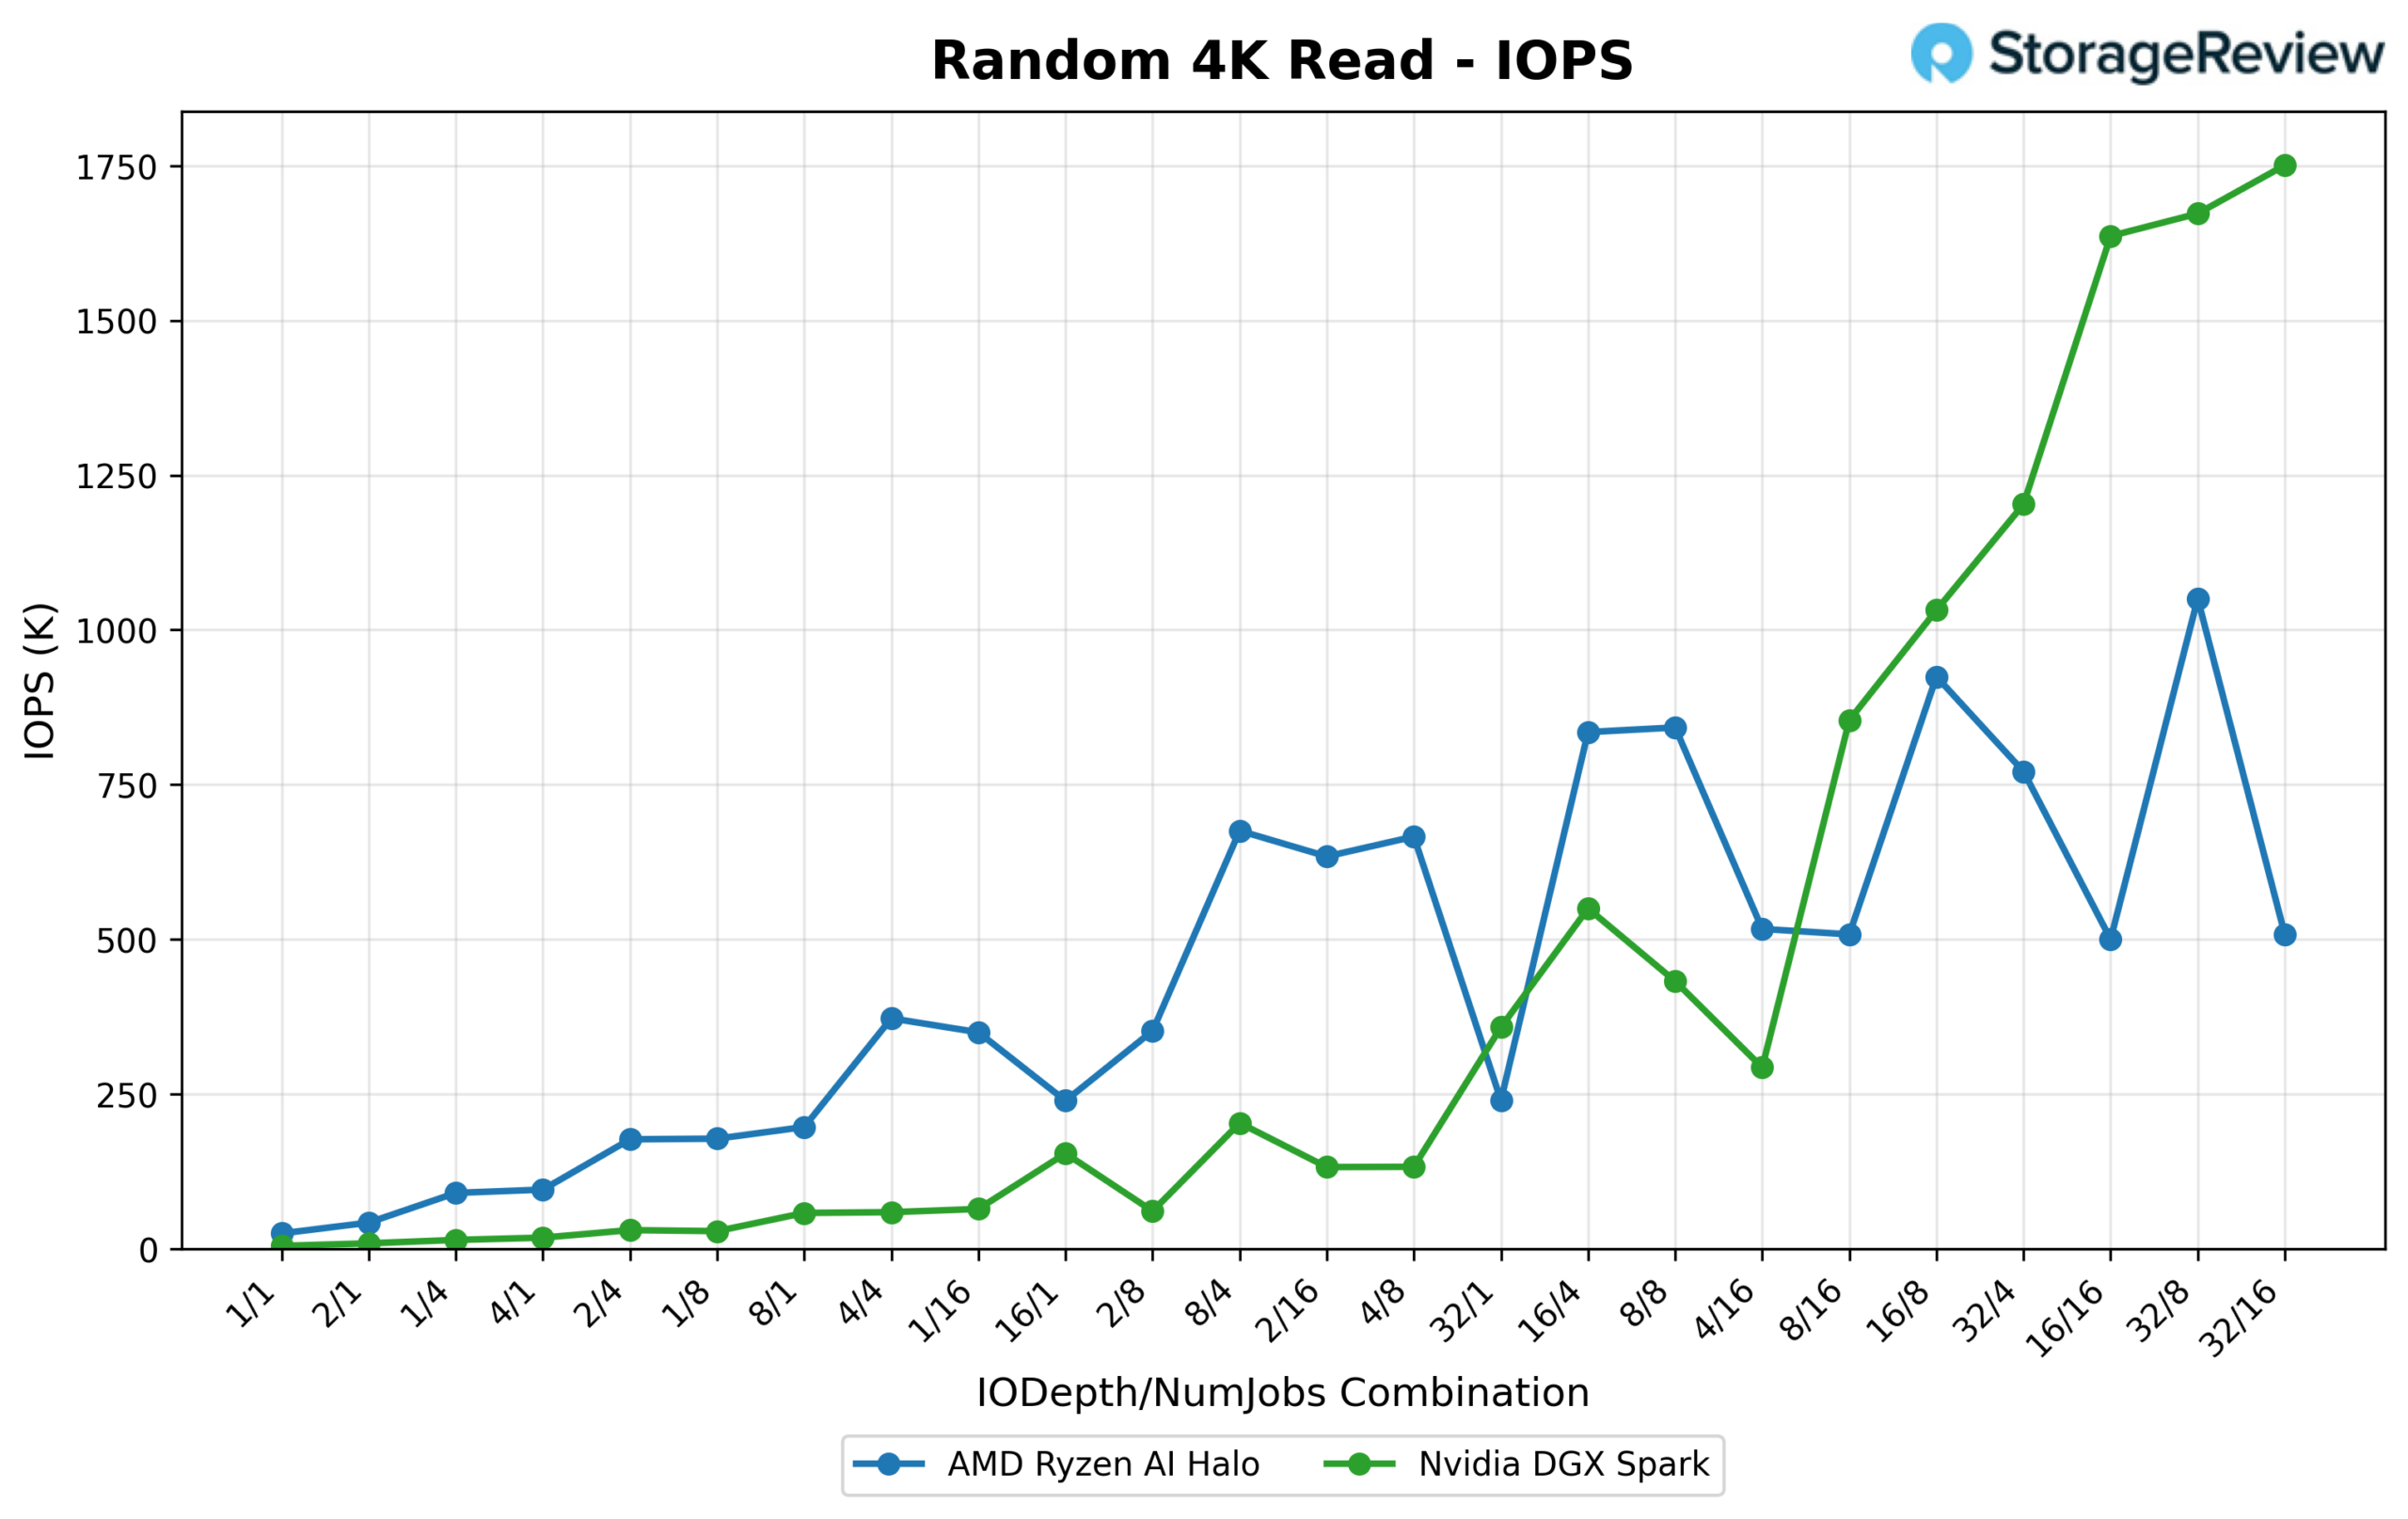
Curiosamente, la latencia se invierte a medida que aumenta la profundidad de la cola. La curva de latencia de Spark se mantiene relativamente constante incluso a medida que aumenta la profundidad y el número de hilos, alcanzando un pico de tan solo 0.292 ms. Por el contrario, Halo experimenta picos pronunciados a 16/16 (0.513 ms) y nuevamente a 32/16 (1.009 ms), superando su valor de referencia en estado estacionario en más del triple, lo que significa que su excelente capacidad de respuesta a baja profundidad de cola no se mantiene hasta la saturación total.
Escritura aleatoria 4K
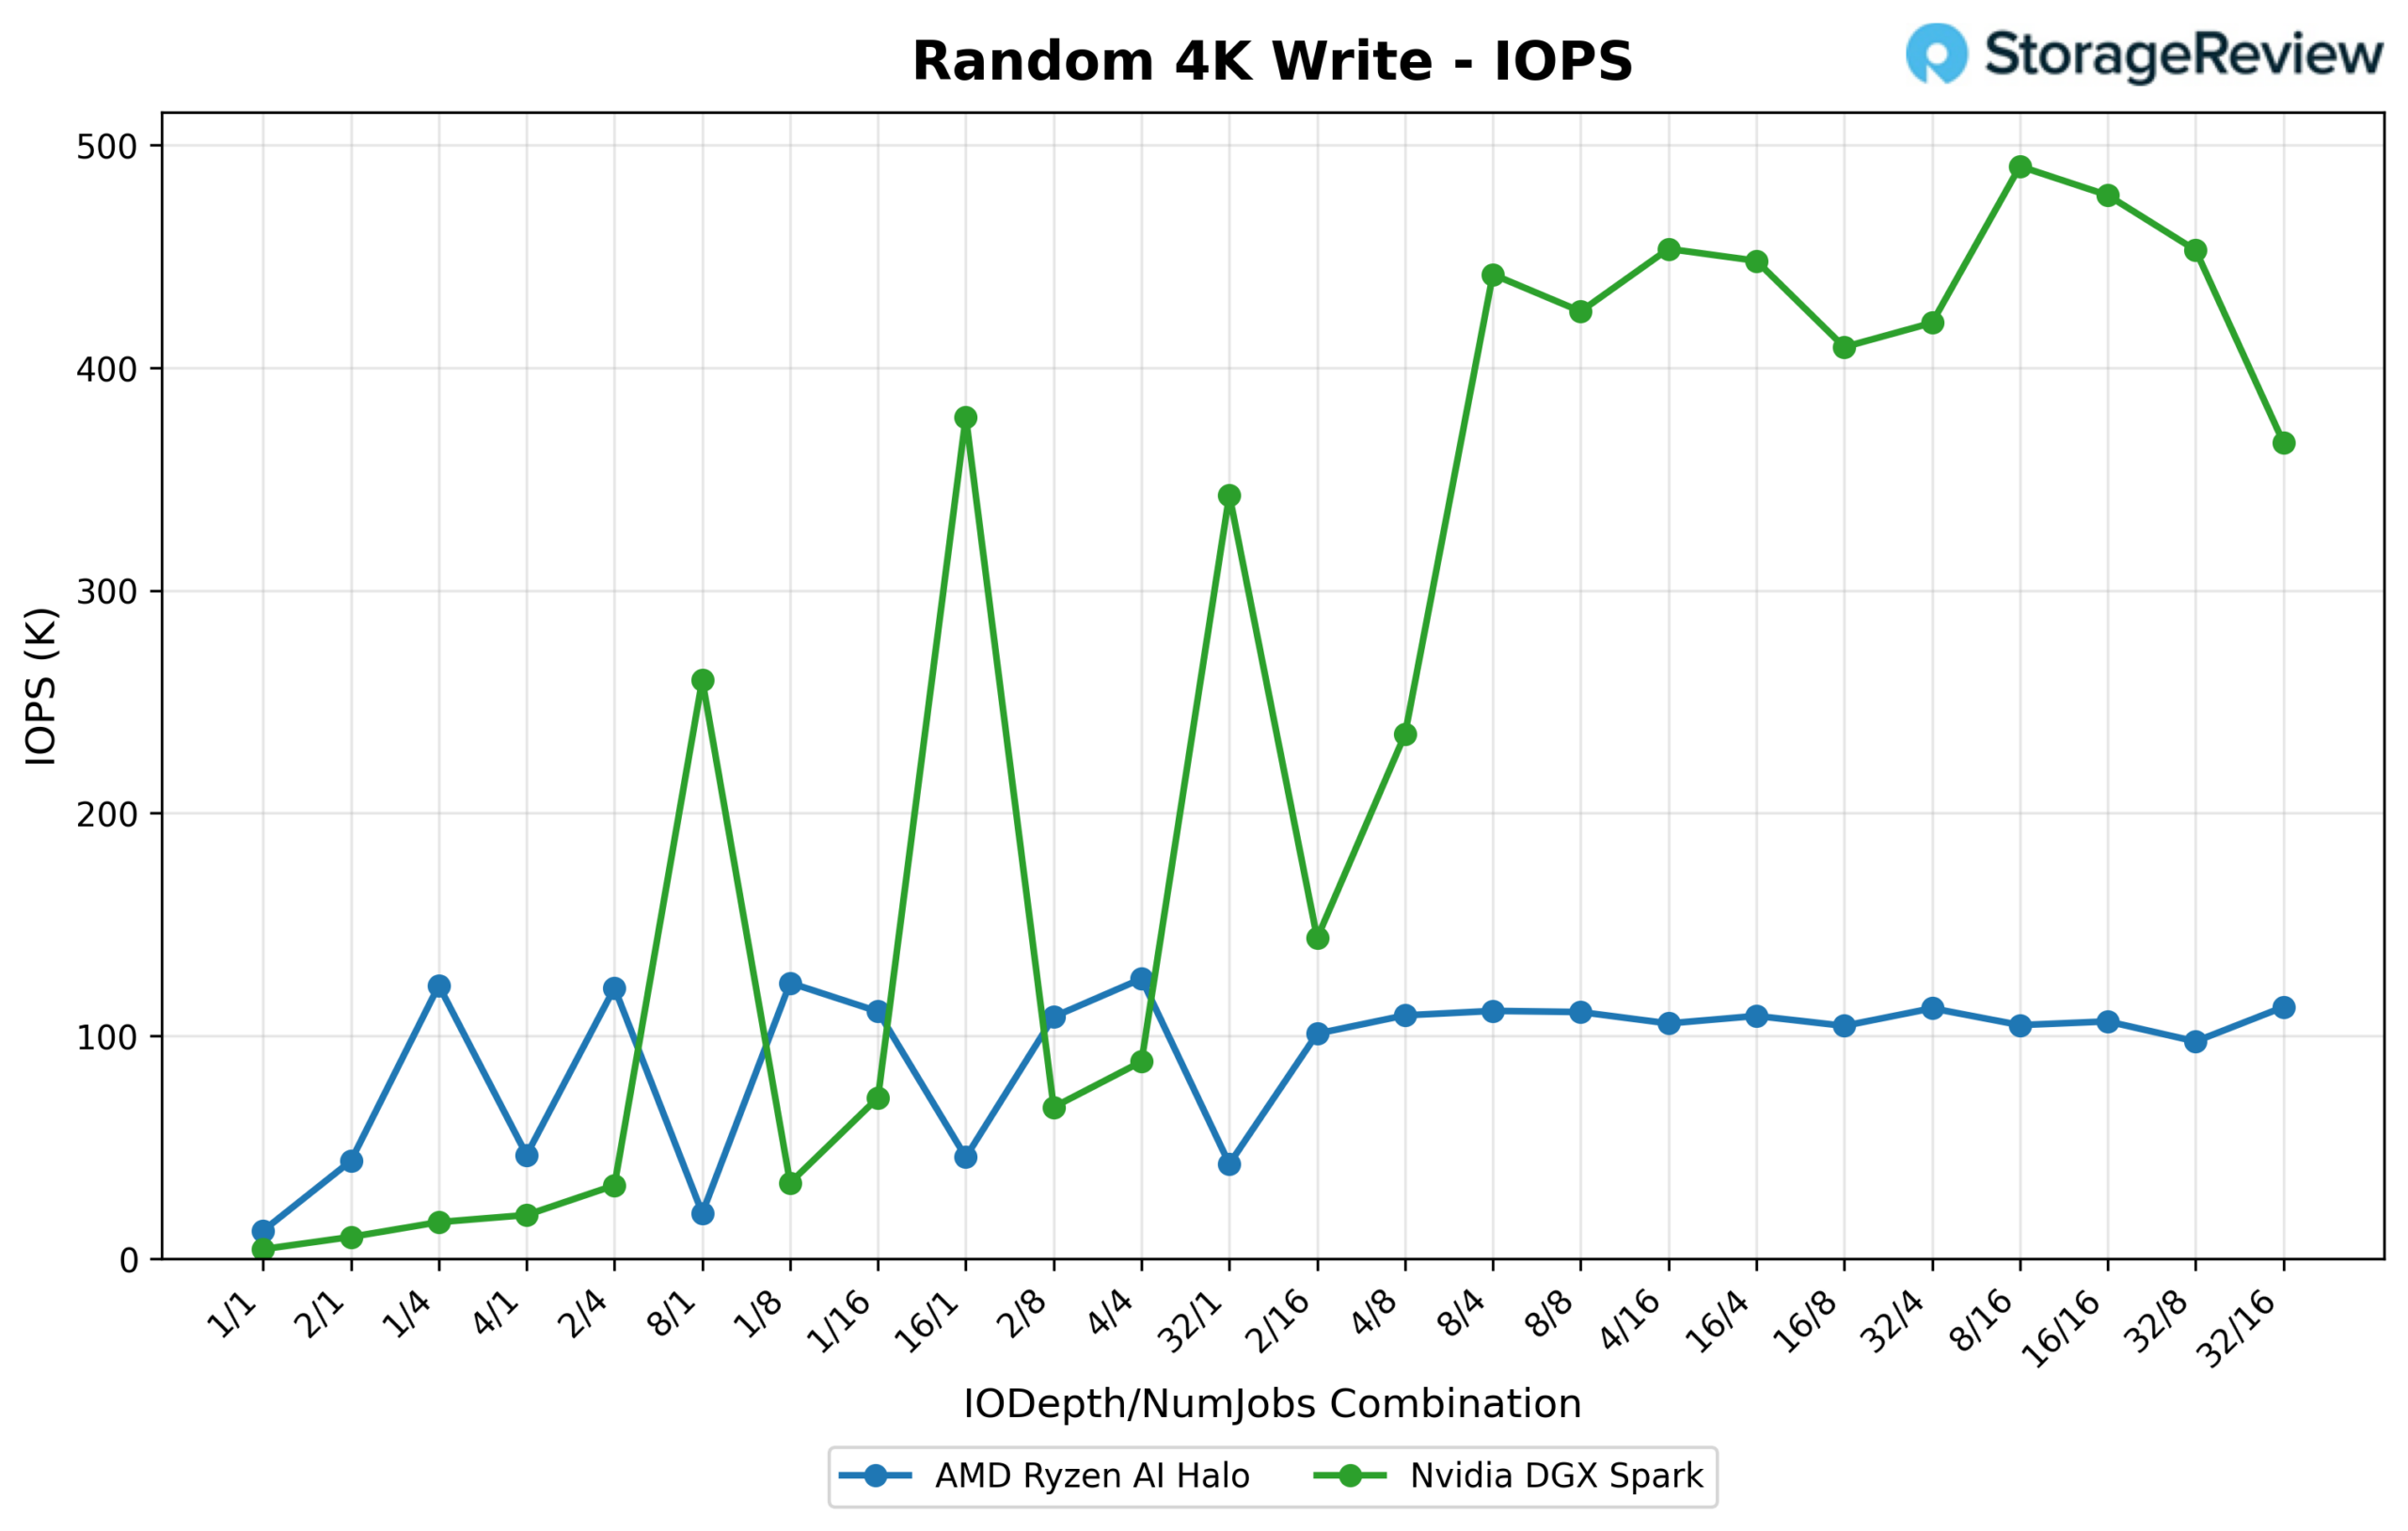
Esta es la mayor diferencia de IOPS en la prueba. El rendimiento de escritura aleatoria de 4K del Spark aumenta bruscamente a medida que aumenta la profundidad de la cola y el número de subprocesos, alcanzando 490.4K IOPS (1,915.6 MB/s) en 8/16. El Halo, por su parte, se estabiliza mucho antes y a un nivel mucho más bajo, llegando a un máximo de 125.6K IOPS (490.7 MB/s) en 4/4 y sin superar nunca aproximadamente 110–115K IOPS durante el resto de la prueba. El Spark está funcionando a casi 4 veces el límite del Halo en este punto.
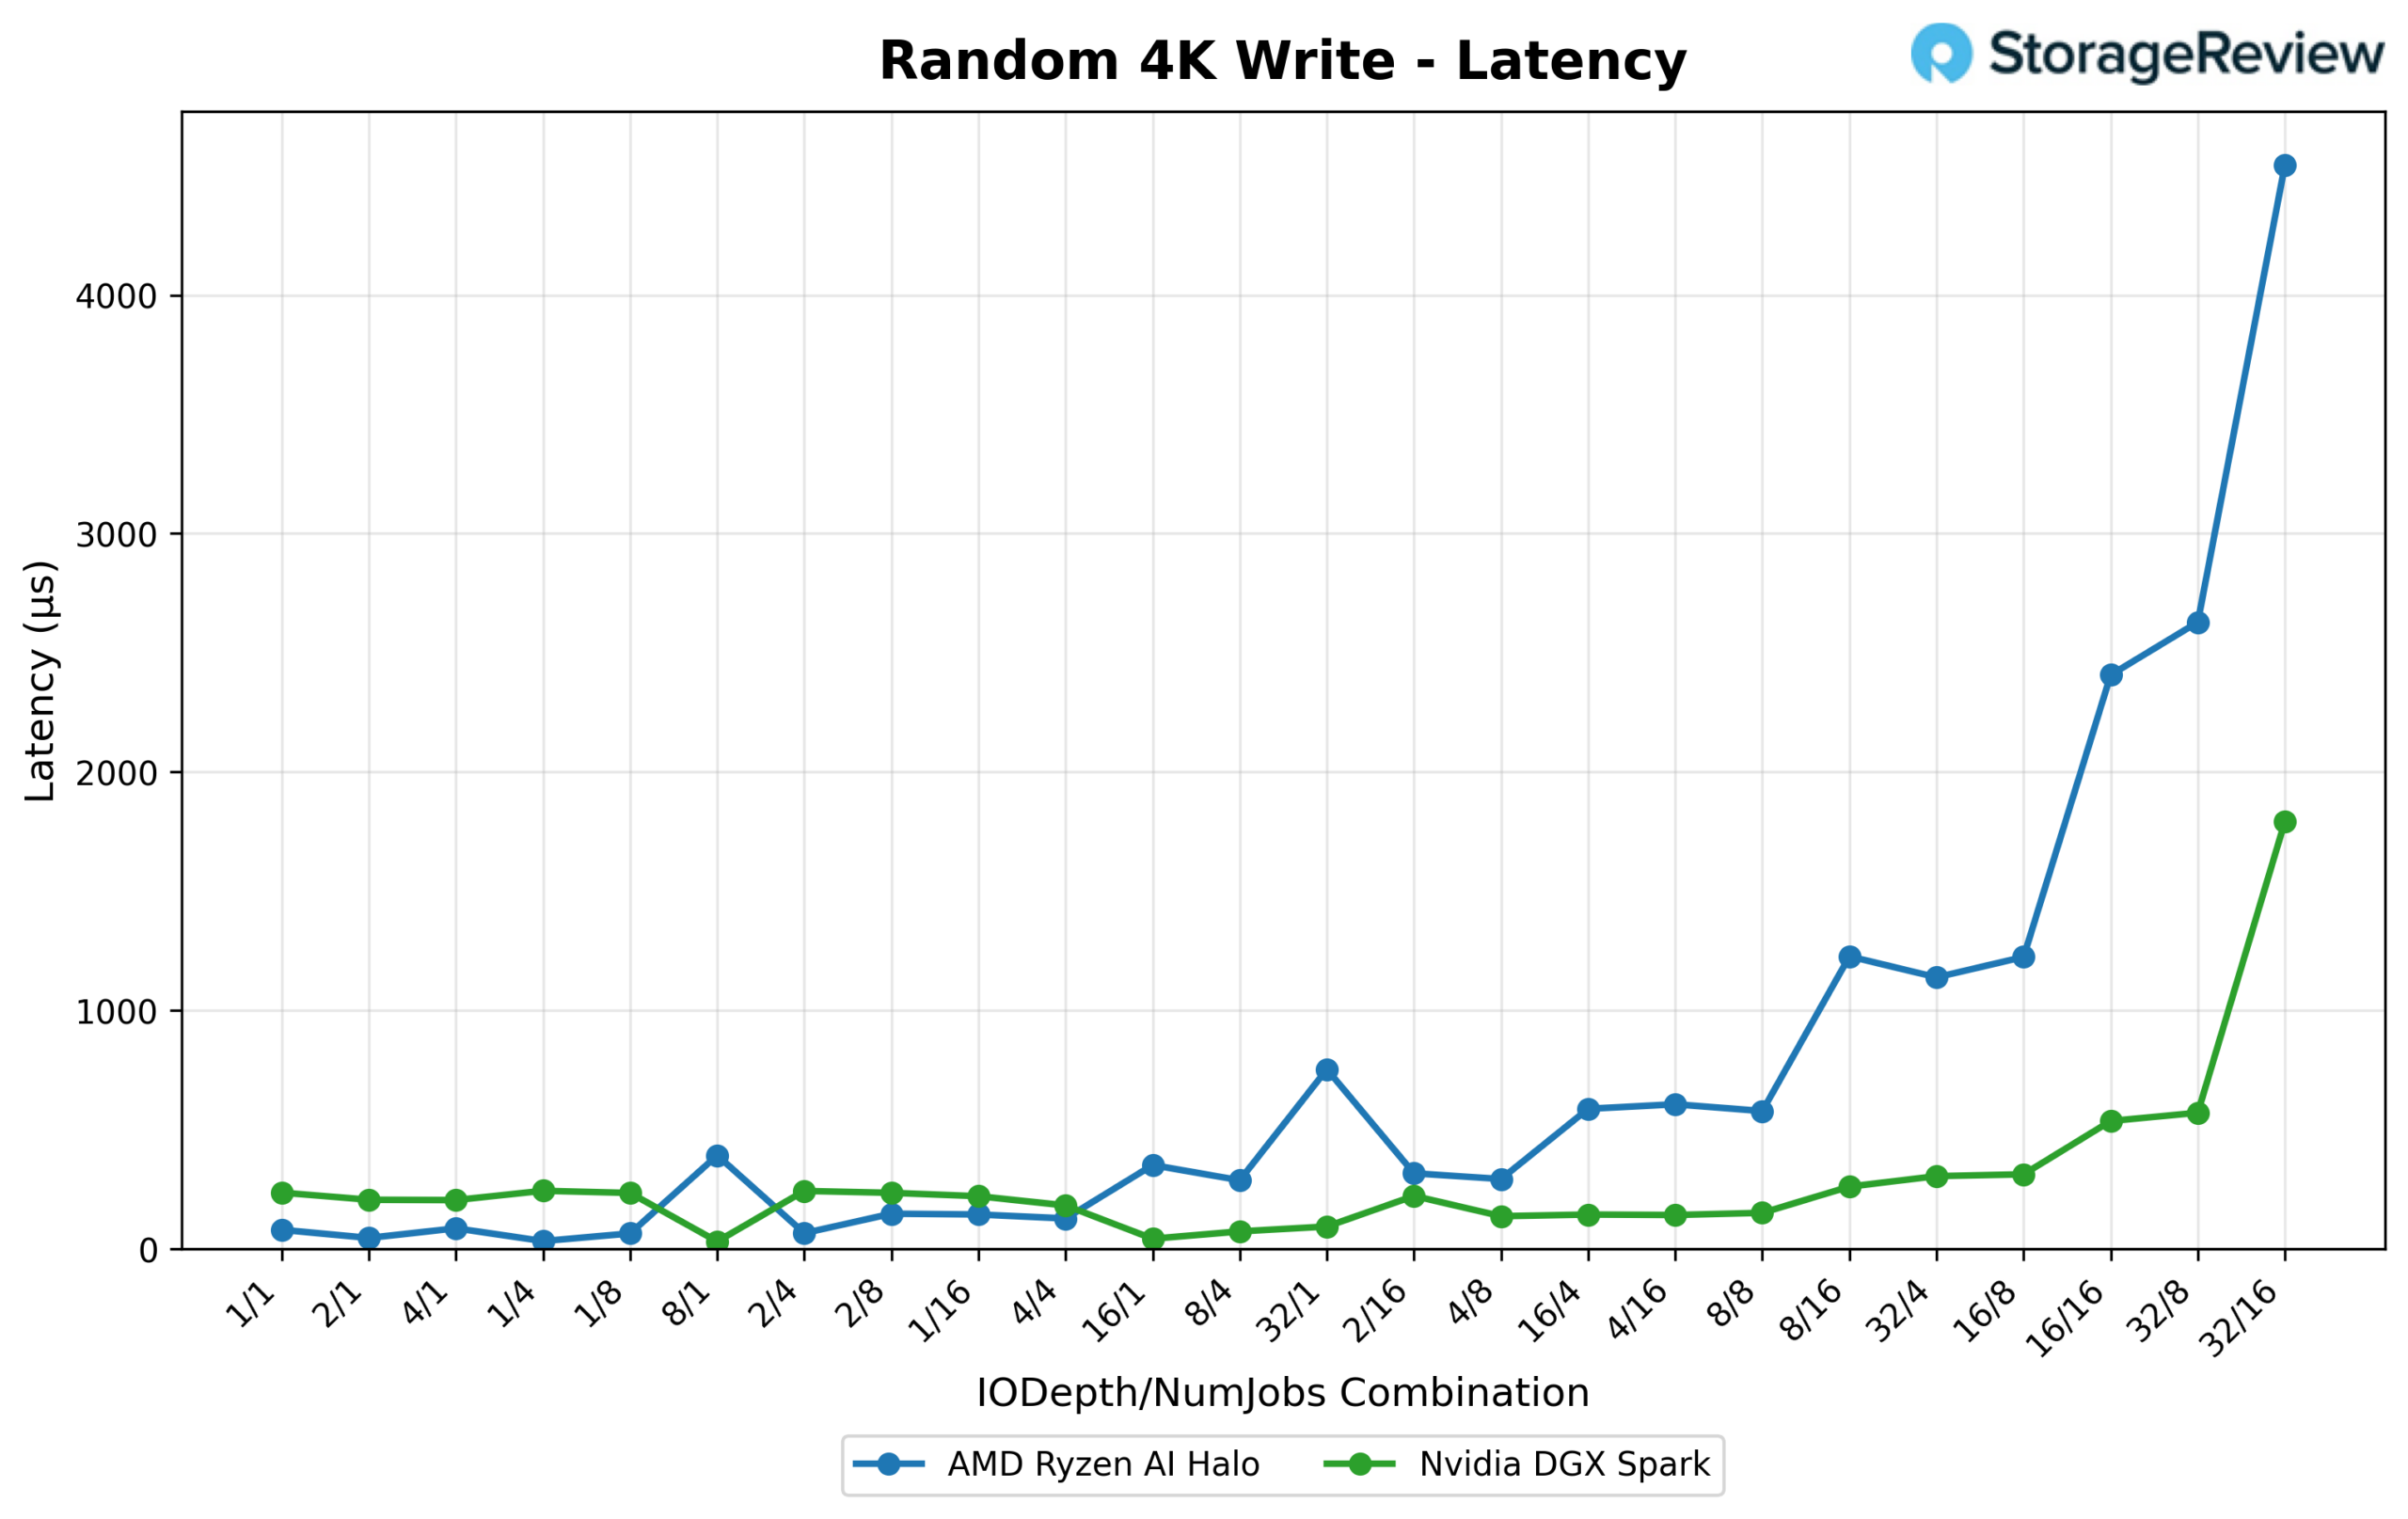
La latencia vuelve a favorecer al Halo con una baja profundidad de cola (0.079 ms frente a 0.235 ms con 1/1). Para 32/16, la latencia media del Halo ha aumentado a 4.546 ms, mientras que la del Spark se mantiene relativamente controlada en 1.792 ms. En combinación con la diferencia de IOPS, esta es la prueba donde la ventaja del Spark es más pronunciada y consistente en todo el rango de profundidad/hilos.
Servicio en línea de vLLM – Rendimiento de inferencia de LLM
vLLM es uno de los motores de inferencia y servicio de alto rendimiento más populares para LLM. La prueba de rendimiento en línea de vLLM evalúa el desempeño real de este motor de inferencia bajo solicitudes concurrentes. Simula cargas de trabajo de producción enviando solicitudes a un servidor vLLM en ejecución, con parámetros configurables como la tasa de solicitudes, la longitud de entrada y salida, y el número de clientes concurrentes. La prueba mide métricas clave, incluyendo el rendimiento (tokens por segundo), el tiempo hasta el primer token y el tiempo por token de salida (TPOT), lo que ayuda a los usuarios a comprender el desempeño de vLLM bajo diferentes condiciones de carga.
Evaluamos el rendimiento de la inferencia en un conjunto integral de modelos que abarcan diversas arquitecturas, escalas de parámetros y estrategias de cuantificación para evaluar el rendimiento en diferentes perfiles de concurrencia.
GPT OSS 120B
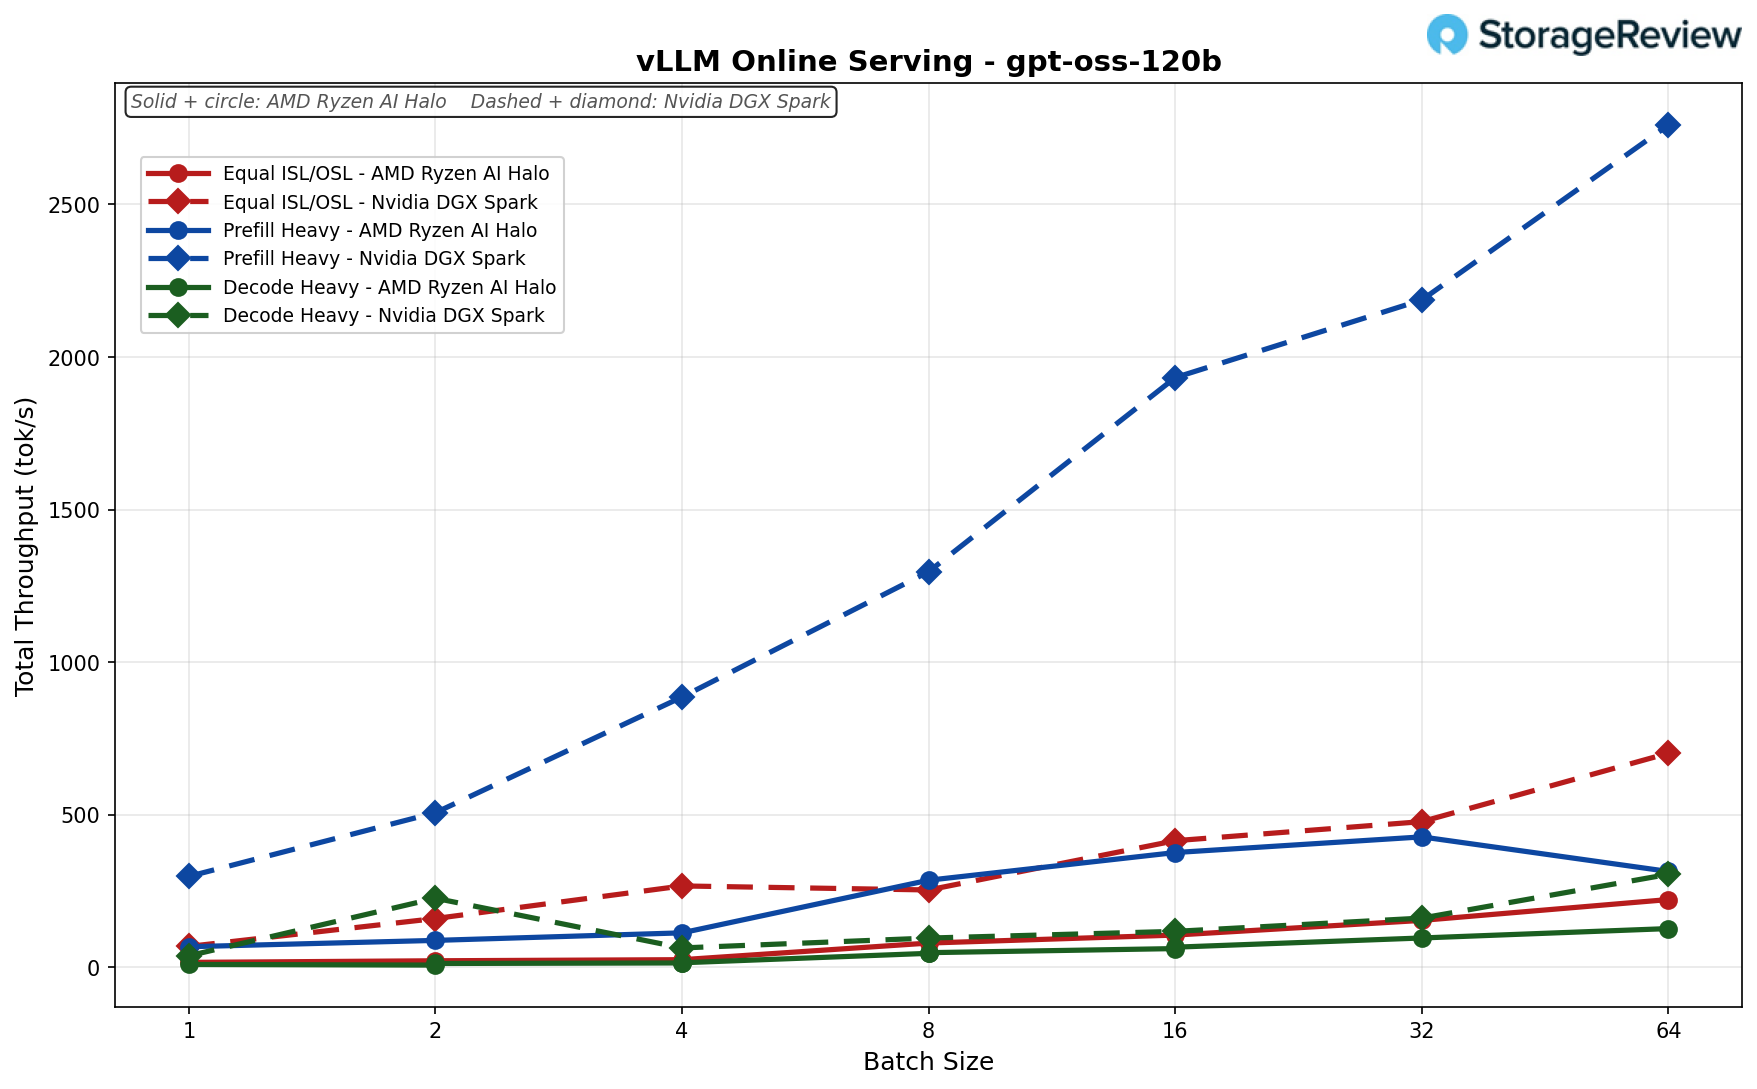
ISL/OSL iguales (256/256): El Halo escaló a 222 tok/s con un tamaño de lote de 64, mientras que el Spark llegó a 701 (aproximadamente 3.2 veces más lento).
Prefill Heavy (8k/1k): El rendimiento del Halo alcanzó su punto máximo en el lote 32 (427 tok/s), luego bajó a 314 en el lote 64, mientras que el Spark aumentó a 2,760 (aproximadamente 8.8x), la mayor diferencia en el conjunto.
Decodificación pesada (1k/8k): El Halo alcanzó 127 tok/s, en comparación con los 305 del Spark con un tamaño de lote de 64 (aproximadamente 2.4 veces).
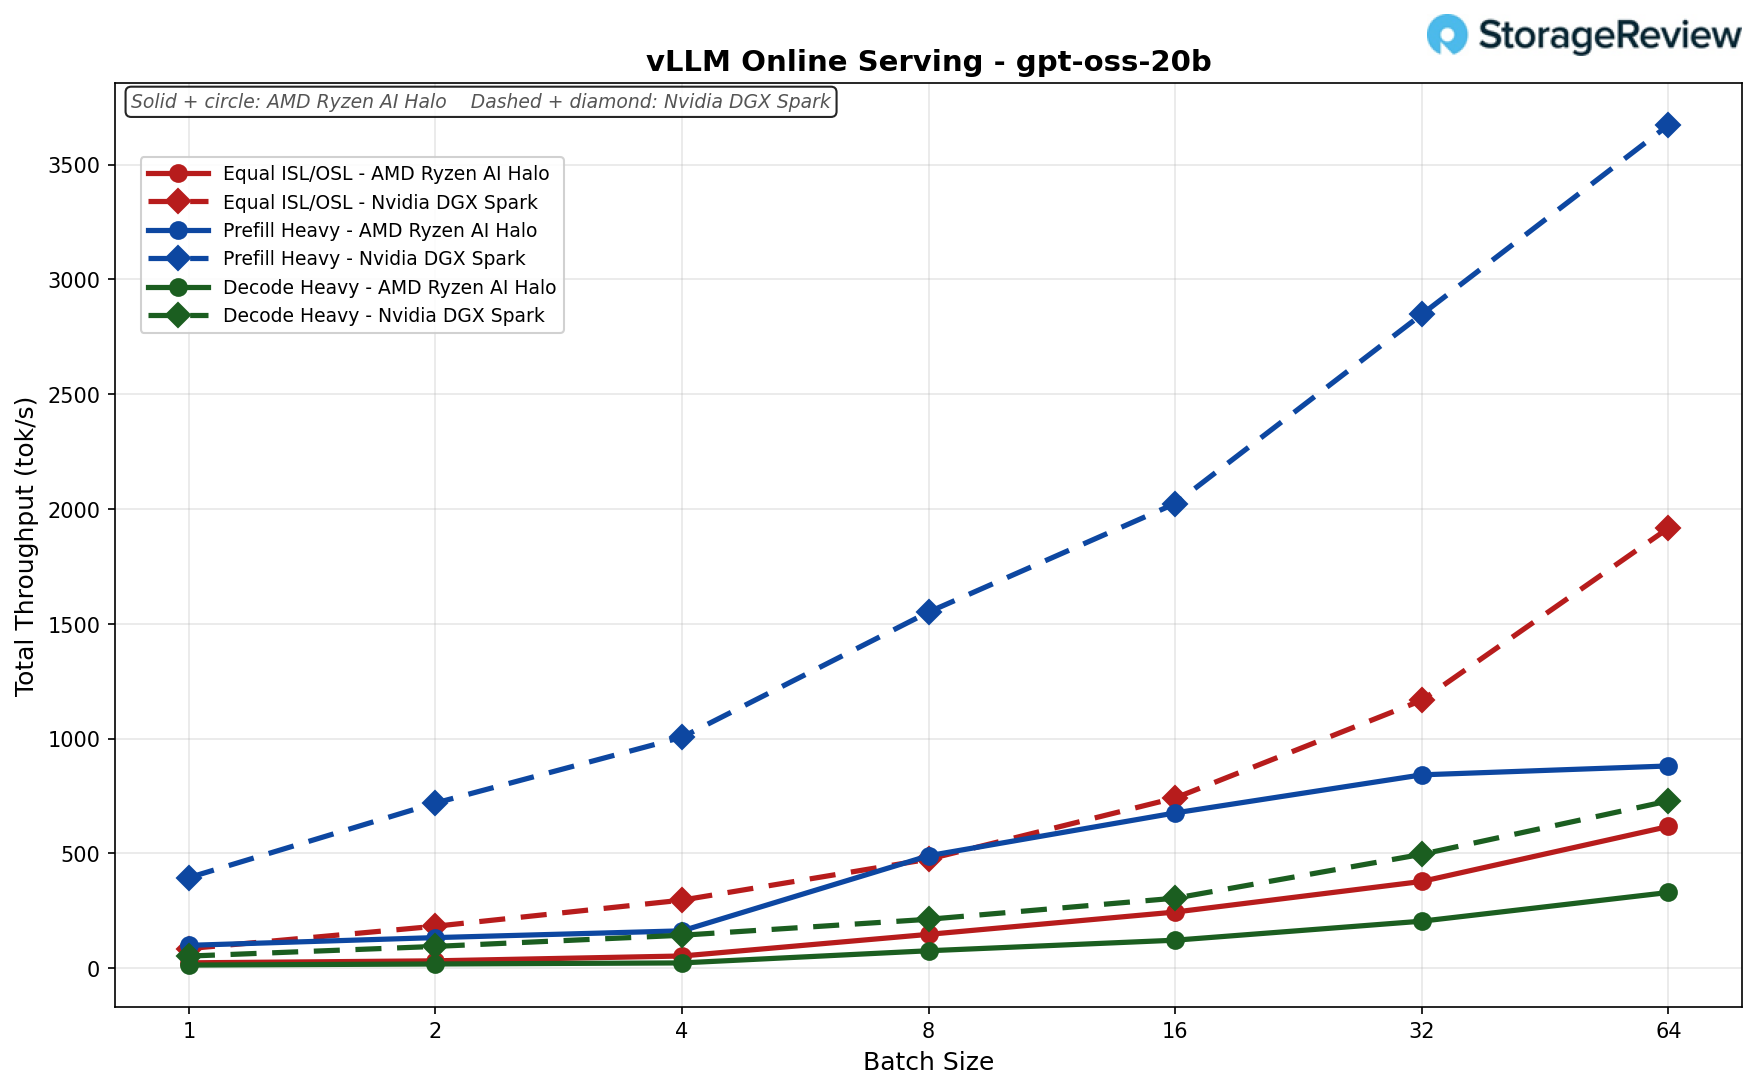
GPT OSS 20B
ISL/OSL iguales (256/256): Spark lideró en cada lote, escalando a 1,917 frente a 617 tok/s en el lote 64 (Spark aproximadamente 3.1 veces por delante).
Prefill Heavy (8k/1k): La ventaja más fuerte de Spark, que asciende a 3,672 frente a 881 tok/s en un tamaño de lote de 64 (Spark está aproximadamente 4.2 veces por delante).
Decodificación pesada (1k/8k): Spark está por delante en todo momento, alcanzando 728 frente a 330 tok/s en el lote 64 (Spark aproximadamente 2.2 veces por delante).
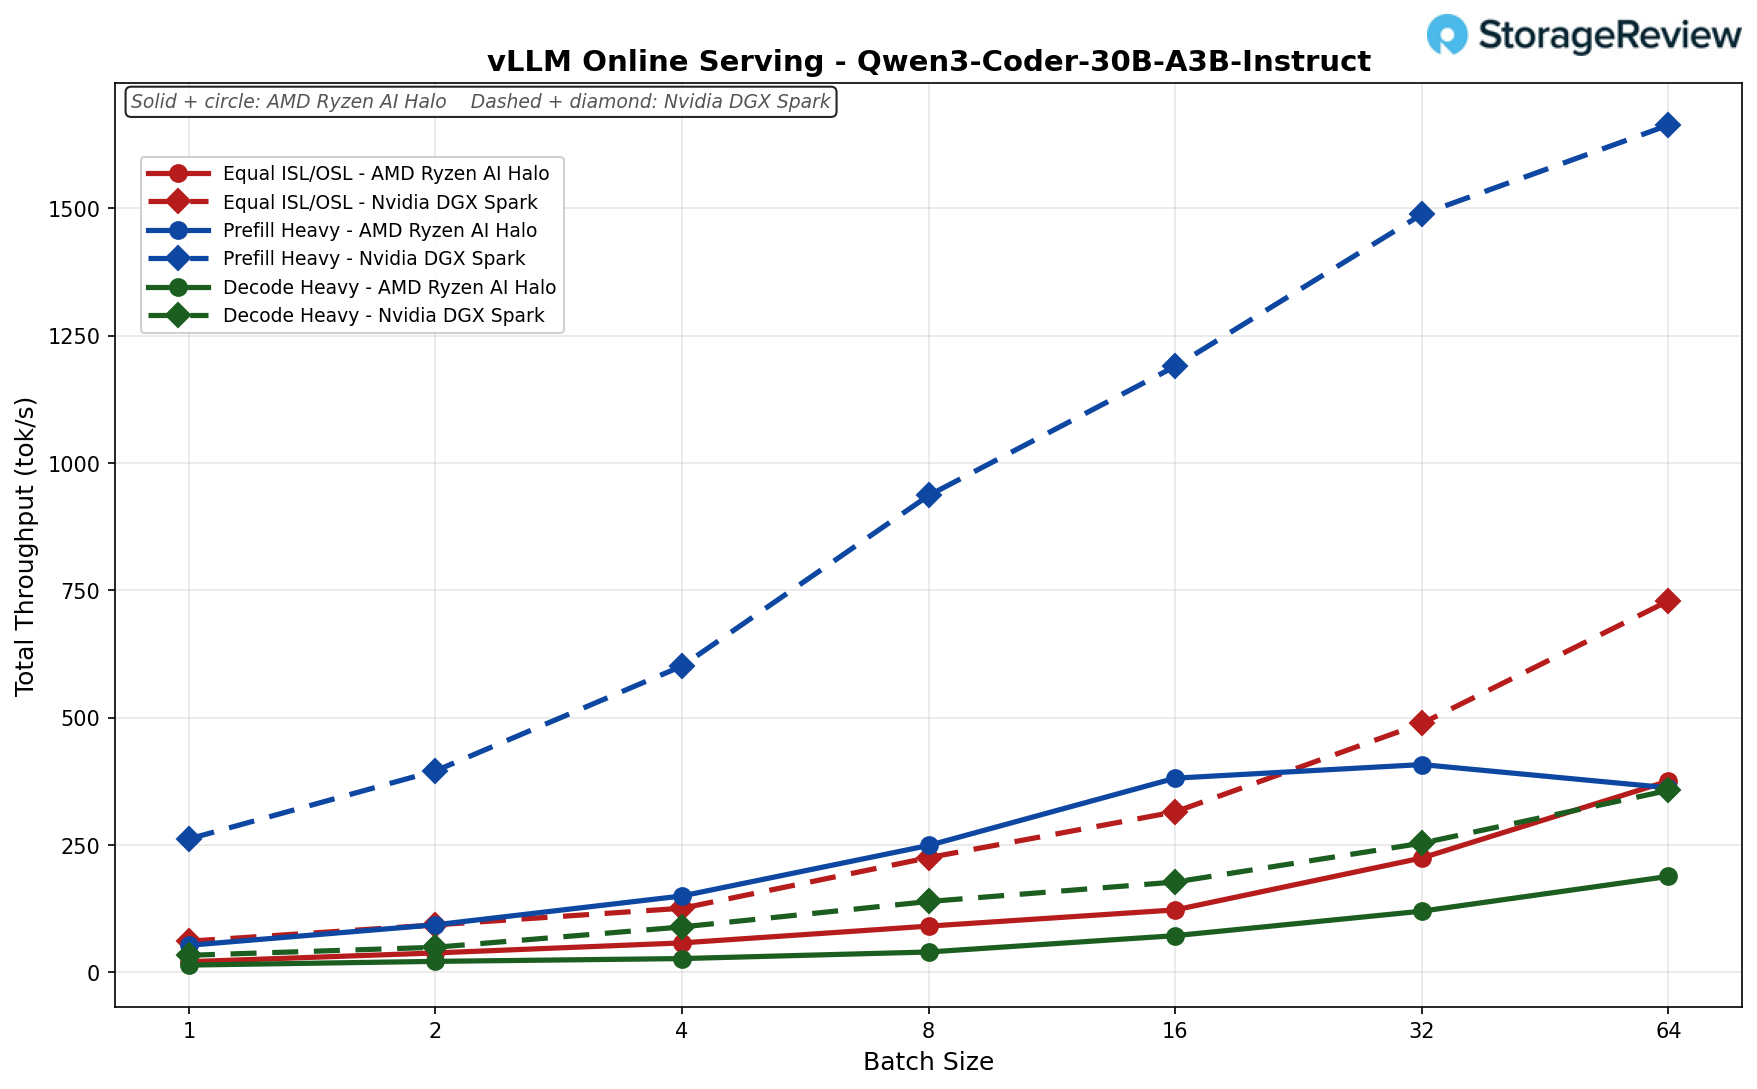
Codificador Qwen3 30B A3B Instrucción
ISL/OSL igual (256/256): Halo escaló a 376 tok/s con un tamaño de lote de 64, aproximadamente la mitad de los 729 de Spark (alrededor de 1.9x), uno de los resultados de ISL/OSL igual más ajustados.
Prefill Heavy (8k/1k): Halo alcanzó su pico en el lote 32 (408 tok/s), luego bajó a 362 en el lote 64, quedando por detrás de Spark, que alcanzó 1,663 (aproximadamente 4.6 veces).
Decodificación pesada (1k/8k): Halo alcanzó 188 tok/s, en comparación con los 357 de Spark con un tamaño de lote de 64 (aproximadamente 1.9x).
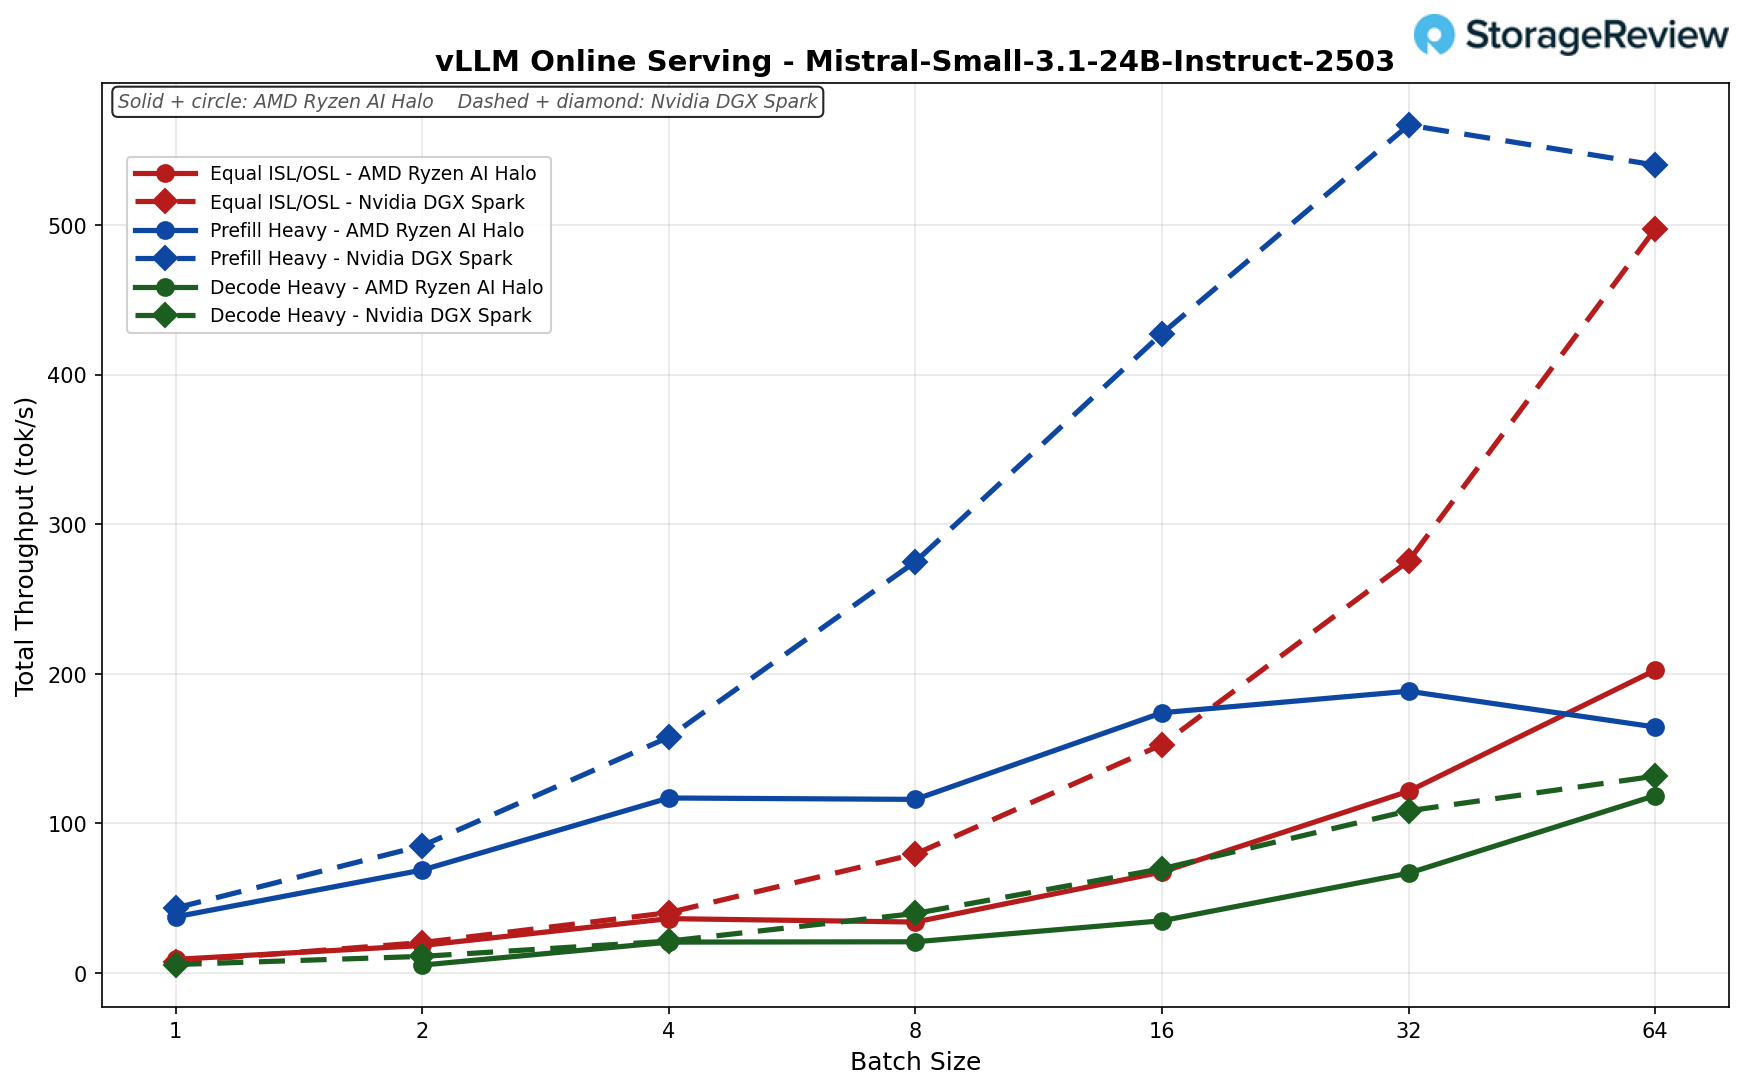
Mistral Small 3.1 24B Instrucción
Igual ISL/OSL (256/256): Halo lideró en el lote 1 (9 vs 8 tok/s), luego se estabilizó en 202 tok/s en el lote 64, mientras que Spark estaba en 498 (aproximadamente 2.5 veces por detrás).
Precarga pesada (8k/1k): El Halo alcanzó su pico en el lote 32 (188 tok/s) y bajó ligeramente a 164 en el lote 64, quedando por detrás de los 540 del Spark (aproximadamente 3.3 veces).
Decodificación pesada (1k/8k): Casi empatados en todo momento, el Halo alcanzó 119 tok/s frente a los 132 del Spark en el lote 64 (con una diferencia de aproximadamente el 11%).
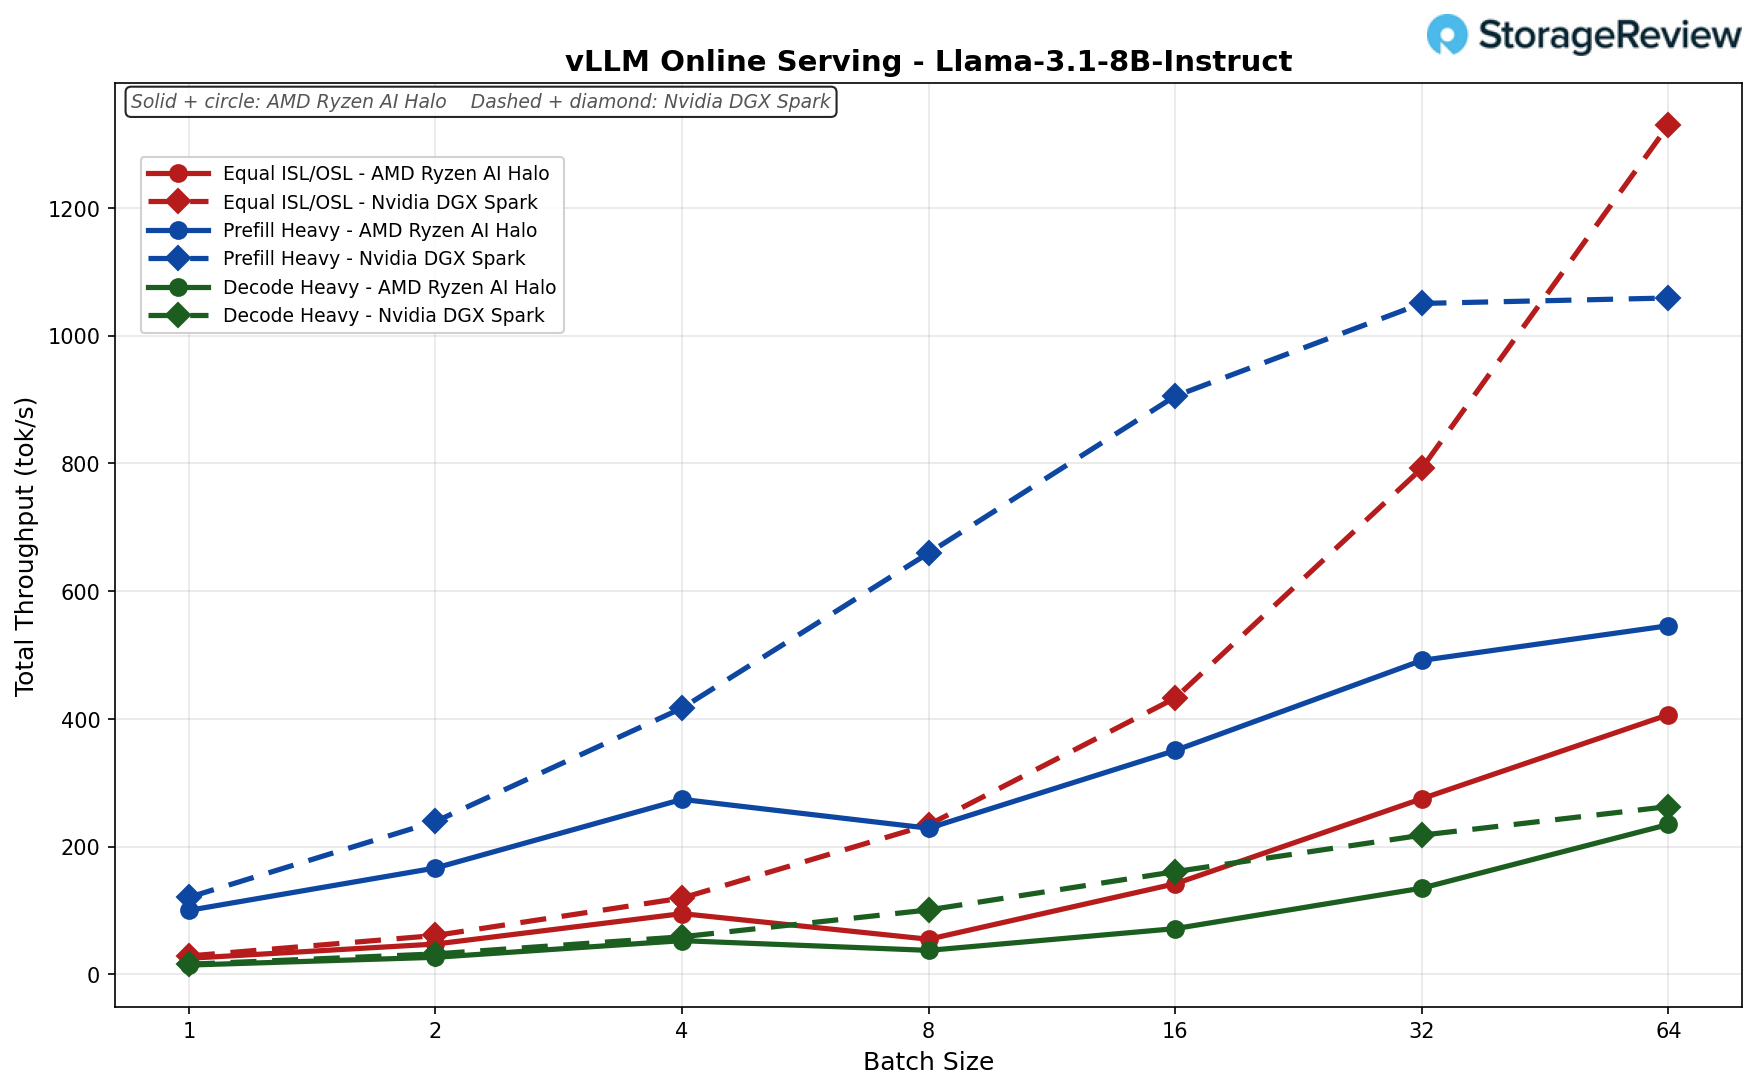
Llama 3.1 8B Instrucción
ISL/OSL iguales (256/256): Halo escaló limpiamente de 25 tok/s en el lote 1 a 407 tok/s en el lote 64, siguiendo de cerca a Spark hasta el lote 4, después del cual Spark se adelantó a 1,330 (Halo quedó rezagado aproximadamente 3.3 veces en el pico).
Precarga pesada (8k/1k): Halo alcanzó 546 tok/s con un tamaño de lote de 64, conteniendo aproximadamente la mitad de los 1,059 de Spark.
Decodificación pesada (1k/8k): El escenario más competitivo de Halo, alcanzando 235 tok/s frente a los 263 de Spark con un tamaño de lote de 64 (dentro de un margen de aproximadamente el 12%).
Llama 3.1 8B Instrucción FP4
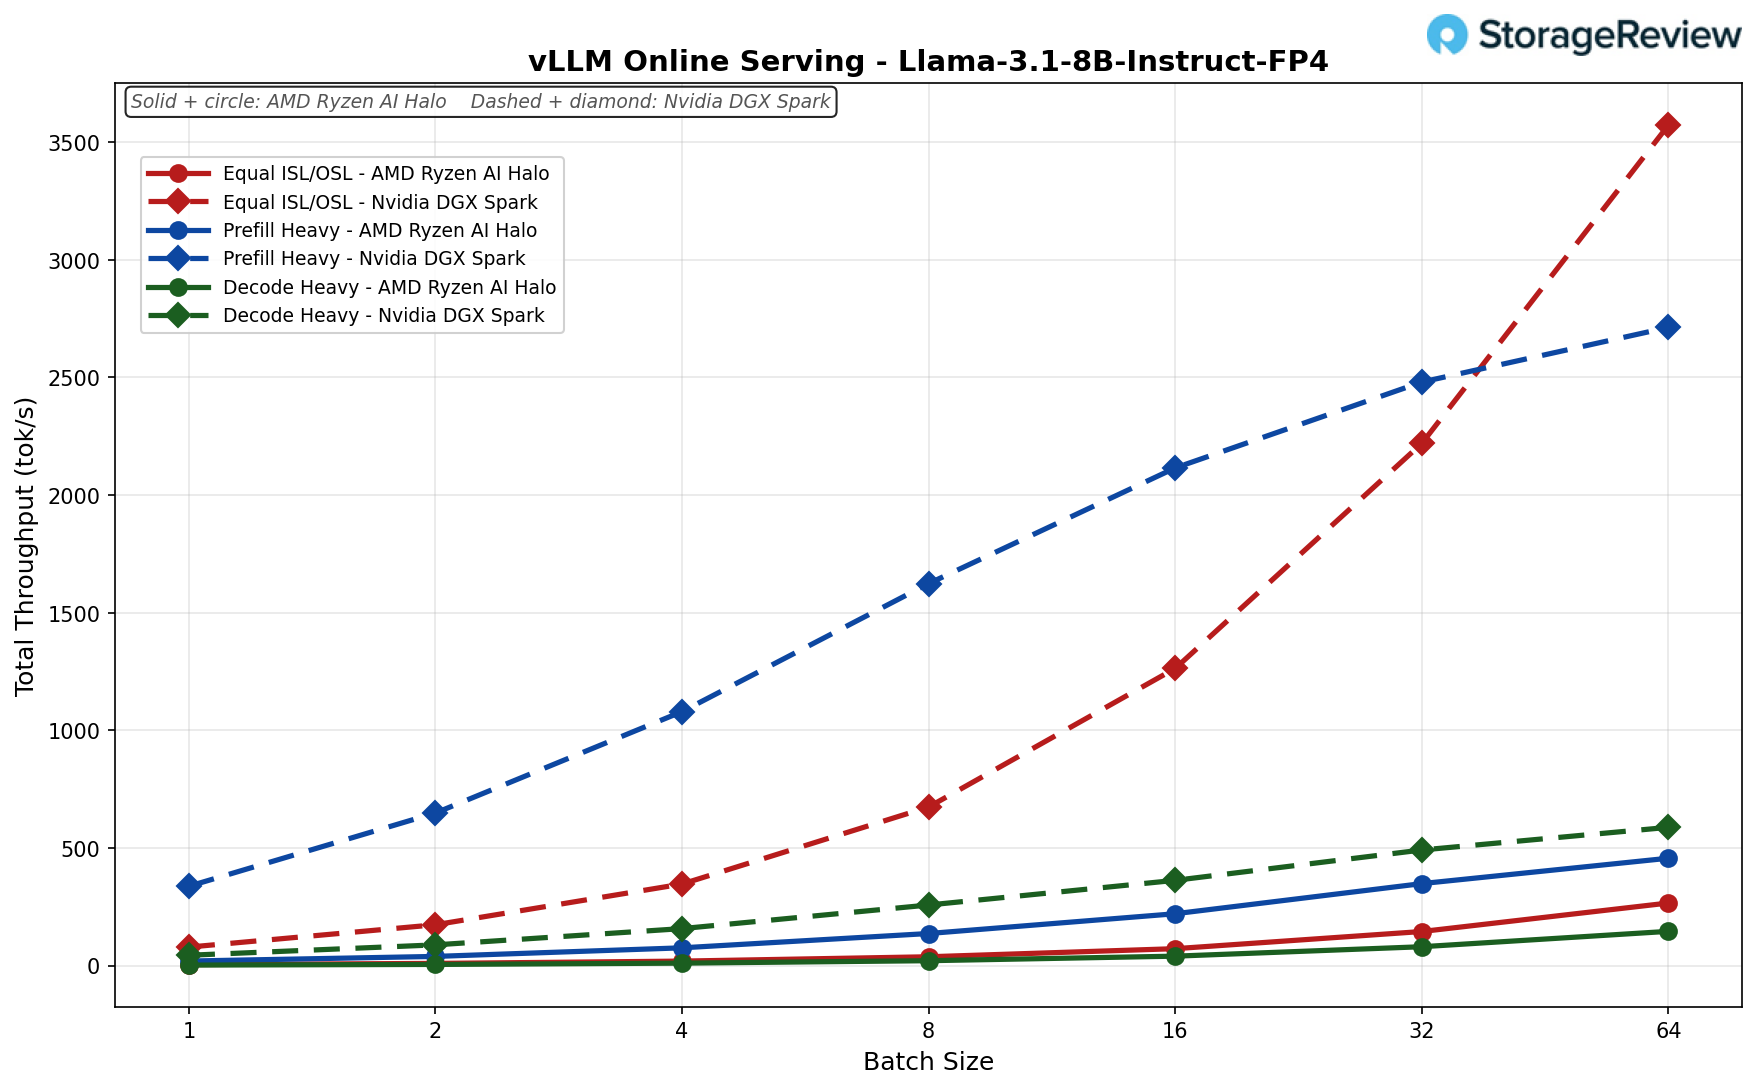
ISL/OSL iguales (256/256): Halo alcanzó un pico de 267 tok/s con un tamaño de lote de 64, muy por detrás de los 3,573 de Spark; FP4 muestra la mayor diferencia (aproximadamente 13.4x).
Precarga pesada (8k/1k): El Halo alcanzó 457 tok/s con un tamaño de lote de 64, en comparación con los 2,713 del Spark (aproximadamente 5.9 veces).
Decodificación pesada (1k/8k): Halo escaló a 146 tok/s, en comparación con los 588 tok/s de Spark con un tamaño de lote de 64 (aproximadamente 4x).
Conclusión
El AMD Ryzen AI Halo entra en una categoría que NVIDIA creó con el DGX Spark, y no intenta superarlo en su propio terreno. En nuestras pruebas vLLM, el Spark mantuvo una ventaja de rendimiento de 2x a 4x en la mayoría de los escenarios con mayor concurrencia, llegando a 8.8x en el trabajo GPT OSS 120B con prellenado intensivo y reduciéndose a aproximadamente un 10% solo en un par de ejecuciones con decodificación intensiva, y su subsistema de almacenamiento ganó casi todas las pruebas fio en saturación. Lo que ofrece el Halo en cambio es la misma memoria unificada de 128 GB y un límite de 200 mil millones de parámetros en un tamaño similar, a $3,999 frente a los $4,699 de la Spark Founders Edition (aunque algunos fabricantes la tienen por debajo de los $4,000), en una máquina x86 completa que arranca Windows 11 o Linux en lugar de solo DGX OS.
Dejando a un lado el Spark, el Halo es la implementación de Ryzen AI Max+ 395 más potente que hemos probado. Obtuvo las mejores puntuaciones frente al HP Z2 Mini G1a y el ZBook Ultra G1a en casi todas las cargas de trabajo de Windows que ejecutamos: 37,316 en Cinebench R23 multinúcleo, 184.2 GIPS en 7-Zip frente a 151.6 y 156.8 para los HP, las puntuaciones más altas en generación de texto e imágenes de Procyon AI, y los tiempos más rápidos de y-cruncher a 5 y 10 mil millones de dígitos. En Linux, frente al Spark, ganó directamente las pruebas Phoronix limitadas por la CPU, comprimiendo un 11 % más rápido en 7-Zip y terminando la compilación LLVM un 14 % antes. Esta es la primera estación de trabajo compacta, con el rol de desarrollador de IA superpuesto en lugar de reemplazarlo.
Los desarrolladores que necesitan el máximo número de tokens locales por segundo, o que planean agrupar nodos en una red de alta velocidad, deberían comprar el Spark; los límites de 10 GbE y vLLM del Halo no se acercan. Para los desarrolladores que trabajan con ROCm, los equipos que necesitan Windows integrado o cualquiera que quiera un solo equipo para gestionar cargas de trabajo profesionales y modelado local, el Halo es la mejor opción, y la bahía M.2 2280 estándar y la memoria gráfica variable preconfigurada solucionan dos de las quejas más comunes de los usuarios del Spark. AMD también ha anunciado que la plataforma incorporará el procesador Ryzen AI Max PRO Serie 400 con hasta 192 GB de memoria unificada en el tercer trimestre, por lo que los compradores que buscan modelos más potentes tienen una solución clara sin cambiar de plataforma.
Página del producto – AMD Ryzen AI Halo
Clasificación: El AMD Ryzen AI Halo ocupa el puesto de Mejor alternativa x86 en nuestra clasificación de Mejores ordenadores de sobremesa para IA local.



 Amazon