

NVIDIA DGX Spark representa un hito en la infraestructura de IA accesible. En 2017, el artículo clave "Attention is All You Need", que presentó la arquitectura Transformer, se basó en una configuración de servidor P100 de ocho GPU, que consumía decenas de kilovatios-hora y ocupaba un espacio considerable en el centro de datos. Hoy, DGX Spark ofrece un rendimiento computacional superior en un formato compacto de escritorio de 240 vatios. Esta drástica evolución en eficiencia energética y compresión del formato permite que las capacidades de IA, antes exclusivas de los centros de datos, sean accesibles para investigadores individuales, equipos pequeños y organizaciones de desarrollo distribuidas.
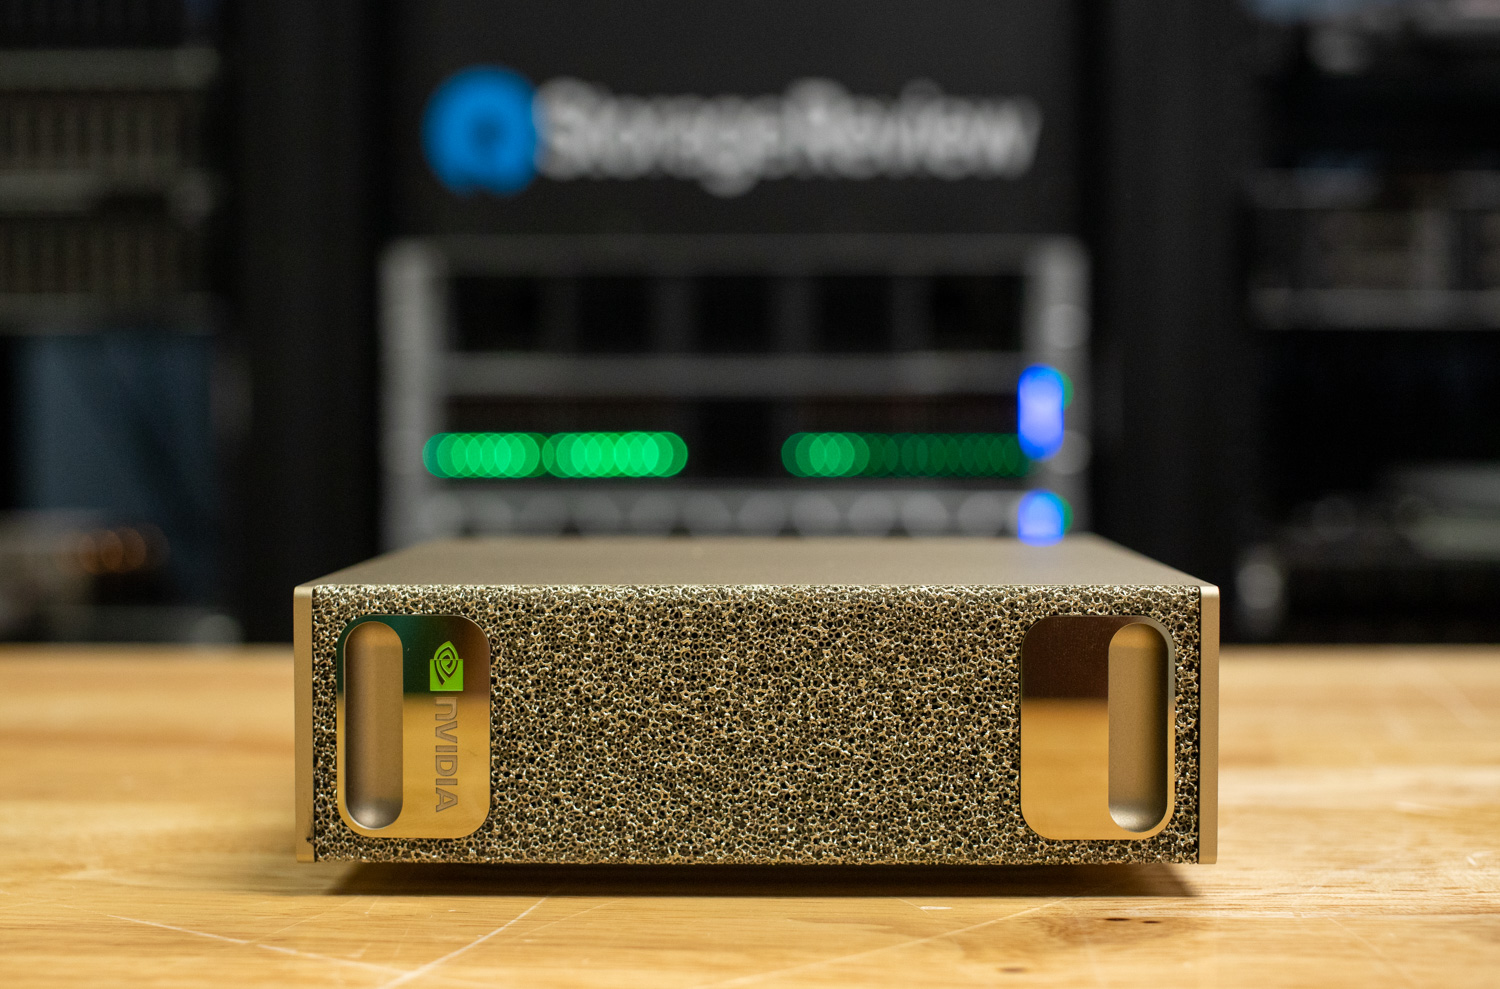
Lo que distingue a Spark de las soluciones de IA de escritorio anteriores es su enfoque integral para todo el ciclo de desarrollo. En lugar de forzar la conciliación entre la experimentación, el ajuste y la implementación, Spark ofrece una capacidad real en todas las fases. La arquitectura de memoria unificada de 128 GB permite un ajuste completo de los parámetros de los modelos que requeriría recursos en la nube en estaciones de trabajo convencionales, a la vez que ofrece un rendimiento de cientos de tokens por segundo, ideal para cargas de trabajo de inferencia por lotes, incluida la generación de datos sintéticos. La inclusión de la red ConnectX-7 con capacidad de estructura de 200 Gb permite a las organizaciones agrupar varios sistemas Spark para una exploración de modelos aún mayor; aunque, como demostraremos, incluso una sola unidad ofrece una capacidad excepcional.
Puntos Clave
Potencia de centro de datos en un ordenador de sobremesa : GB10 Grace Blackwell en una caja de 1.13 litros y 240 W, con un precio de 3,999 dólares, que ofrece un rendimiento disperso FP4 de hasta 1 petaFLOP.
Memoria que transforma los flujos de trabajo : 128 GB de memoria unificada permiten el ajuste fino de parámetros completos de modelos 8B localmente y la inferencia de alto rendimiento. En las pruebas, vimos que Llama 3.1 8B FP4 alcanzó ~924 tok/s con una concurrencia de 128, y Qwen3 Coder 30B-A3B FP8 llegó a ~483 tok/s con un lote de 64.
Preparado para escalar y conectar almacenamiento rápido : ConnectX-7 integrado proporciona una estructura de 200G para agrupación en clústeres o NVMe-oF. El NVMe interno 2242 Gen5 es práctico, pero tiene limitaciones para operaciones de entrada/salida intensivas, por lo que el NVMe-oF externo a través de RDMA es la mejor opción para un rendimiento sostenido.
Madurez del software desde el primer día : Incluye DGX OS, CUDA, cuDNN, TensorRT, AI Workbench, contenedores y playbooks de flujo de trabajo para que los equipos puedan ejecutar cargas de trabajo reales de inmediato.
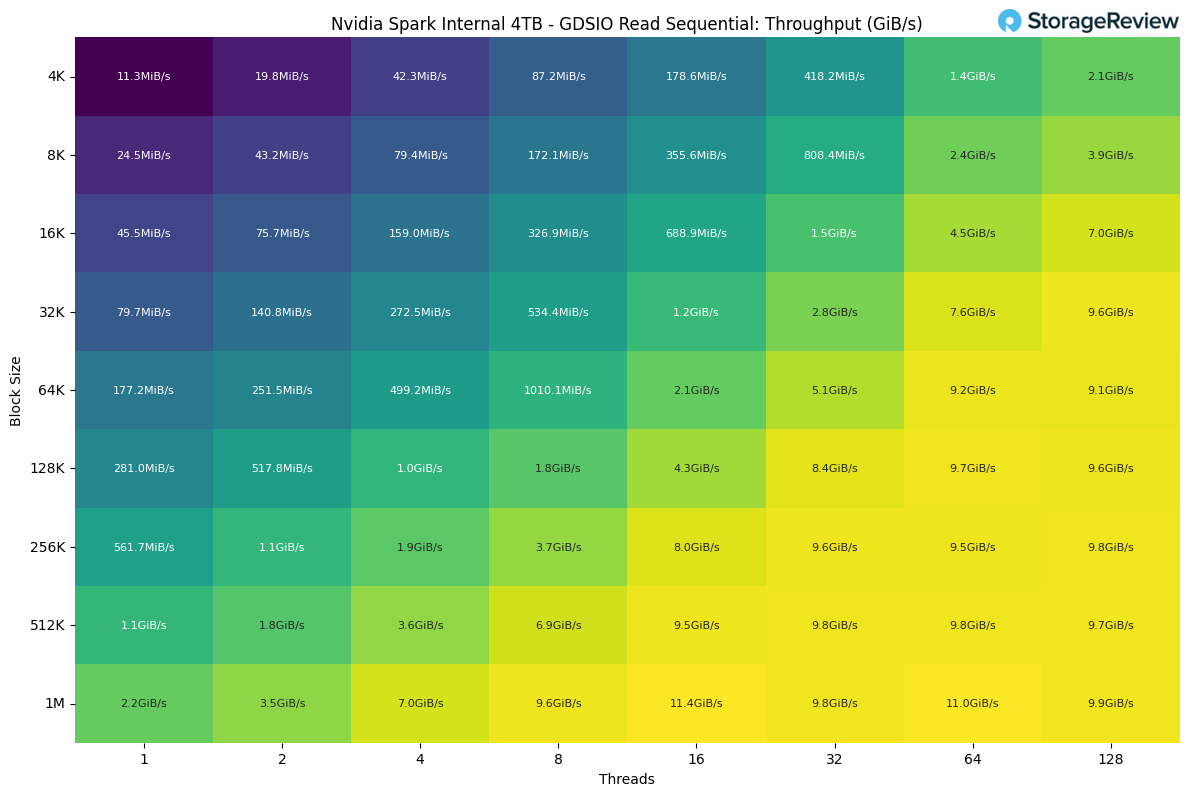
Rendimiento real comprobado : MAMF midió ~99.8 TFLOPs BF16 y ~207.7 TFLOPs FP8. Las lecturas GDSIO alcanzaron un pico de ~11.4 GiB/s internamente, y se espera un límite superior en la estructura de 200G.
¿Qué es DGX Spark y quién debería considerarlo?
NVIDIA DGX Spark es, fundamentalmente, una plataforma completa de desarrollo de IA, más que un simple componente de GPU. En su núcleo se encuentra el superchip GB10 Grace Blackwell, que integra una GPU de arquitectura Blackwell con núcleos Tensor de quinta generación y una CPU Arm de 20 núcleos (10 Cortex-X925 + 10 Cortex-A725) conectada mediante NVLink-C2C. Esta arquitectura de interconexión coherente, según NVIDIA, permite un ancho de banda hasta 5 veces superior al de PCIe Gen 5, creando una estructura computacional unificada en lugar de dominios de procesamiento discretos.
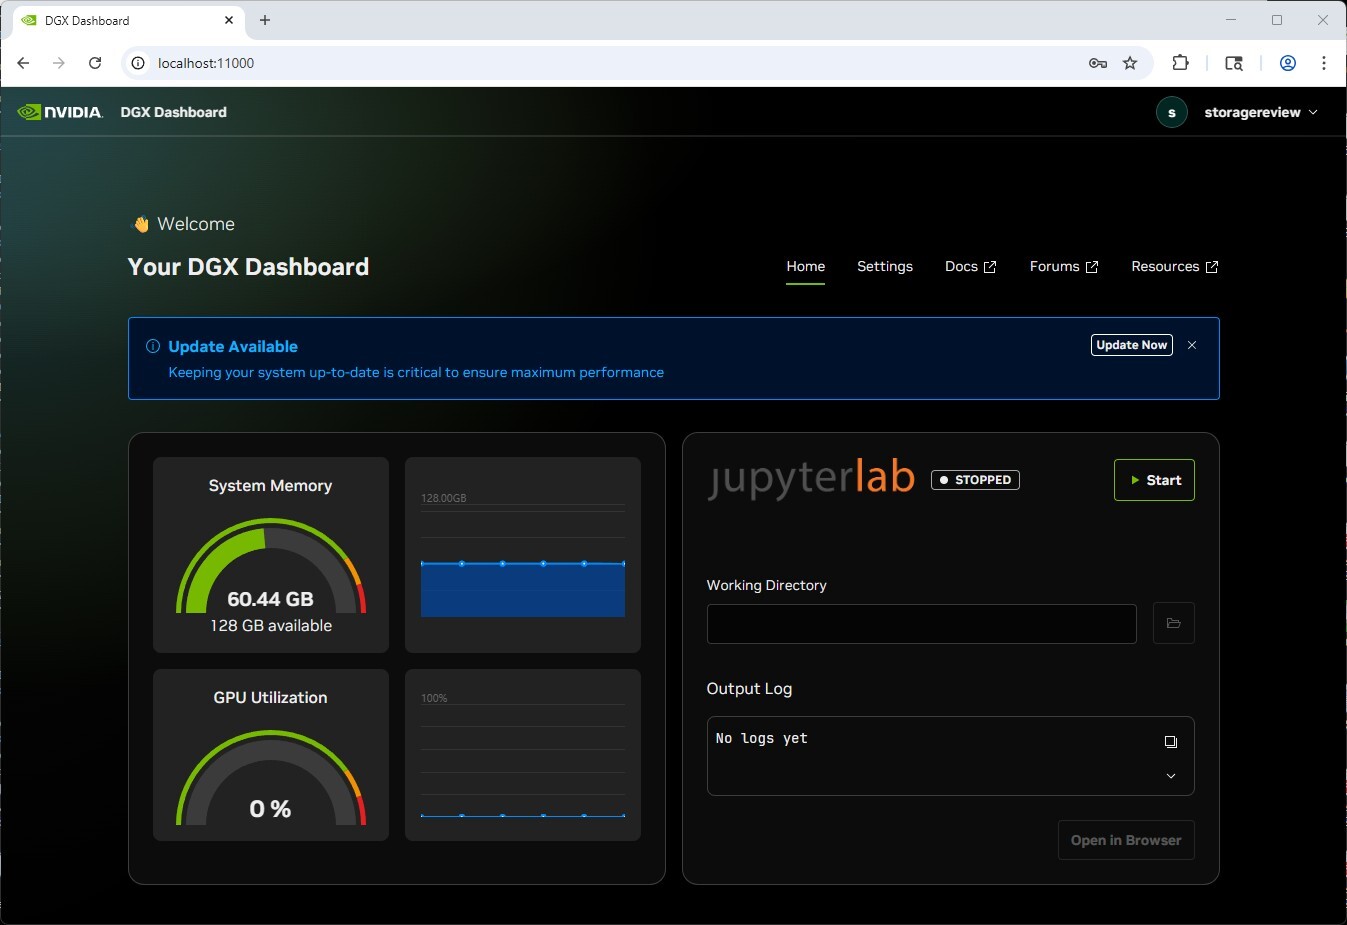
Para que los usuarios puedan empezar, NVIDIA ofrece DGX OS, basado en Ubuntu Desktop, con la pila completa de software de IA preconfigurada, incluyendo CUDA, cuDNN, TensorRT, NVIDIA Container Runtime y AI Workbench. Esto elimina los típicos problemas de controladores y la sobrecarga de configuración del entorno que suelen afectar a las estaciones de trabajo personalizadas. El sistema ofrece paradigmas de implementación flexibles: conecte periféricos y úselo como una estación de trabajo compacta con la experiencia completa de escritorio Ubuntu, o impleméntelo como un dispositivo de red headless accesible a través de NVIDIA Sync, que proporciona una integración perfecta con JupyterLab, VS Code, Cursor IDE y terminales SSH.
Esta es una infraestructura diseñada específicamente para profesionales de IA, investigadores que perfeccionan modelos de lenguaje, científicos de datos que aceleran flujos de trabajo de RAPIDS, desarrolladores que implementan sistemas agénticos o equipos que experimentan con arquitecturas con modelos ablativos a pequeña escala. Spark está dirigido a profesionales que necesitan una gran capacidad computacional de IA sin la complejidad de un centro de datos.
Especificaciones técnicas de NVIDIA DGX Spark
| Especificación | Detalles |
|---|---|
| Arquitectura de interiores | |
| GPU | Arquitectura NVIDIA Blackwell |
| CPU | Arm de 20 núcleos (10x Cortex-X925 + 10x Cortex-A725) |
| Núcleos tensoriales | 5th Generación |
| RT Cores | 4th Generación |
| NVENC/NVDEC | 1 × / 1 × |
| Salud Cerebral | |
| Memoria del sistema | 128 GB LPDDR5X (Memoria del sistema unificada) |
| interfaz de memoria | 256 bits |
| ancho de banda de memoria | 273 GB / s |
| Rendimiento | |
| FP4 | hasta 1 petaFLOP (con escasez) |
| Almacenaje | |
| Almacenaje | 1 TB o 4 TB NVMe M.2 (autocifrado) |
| Conectividad | |
| USB | 4 puertos USB 3.2 Gen 2 Tipo-C (20 Gbps) |
| Ethernet | 1 RJ-45 de 10 GbE |
| NIC | ConnectX-7 Smart NIC – 2x 200G QSFP (permite un ancho de banda máximo de 200G) |
| Conectividad | Wi-Fi 7, Bluetooth 5.3 |
| Salida de audio | Salida de audio multicanal HDMI |
| Conectores de pantalla | 1× HDMI 2.1a |
| Mecánico | |
| Dimensiones | 150 × 150 × 50.5 mm (5.9 × 5.9 × 1.98″) |
| Peso | 1.2 kg |
| Consumo de energía | 240 W |
Diseño y construcción de NVIDIA DGX Spark
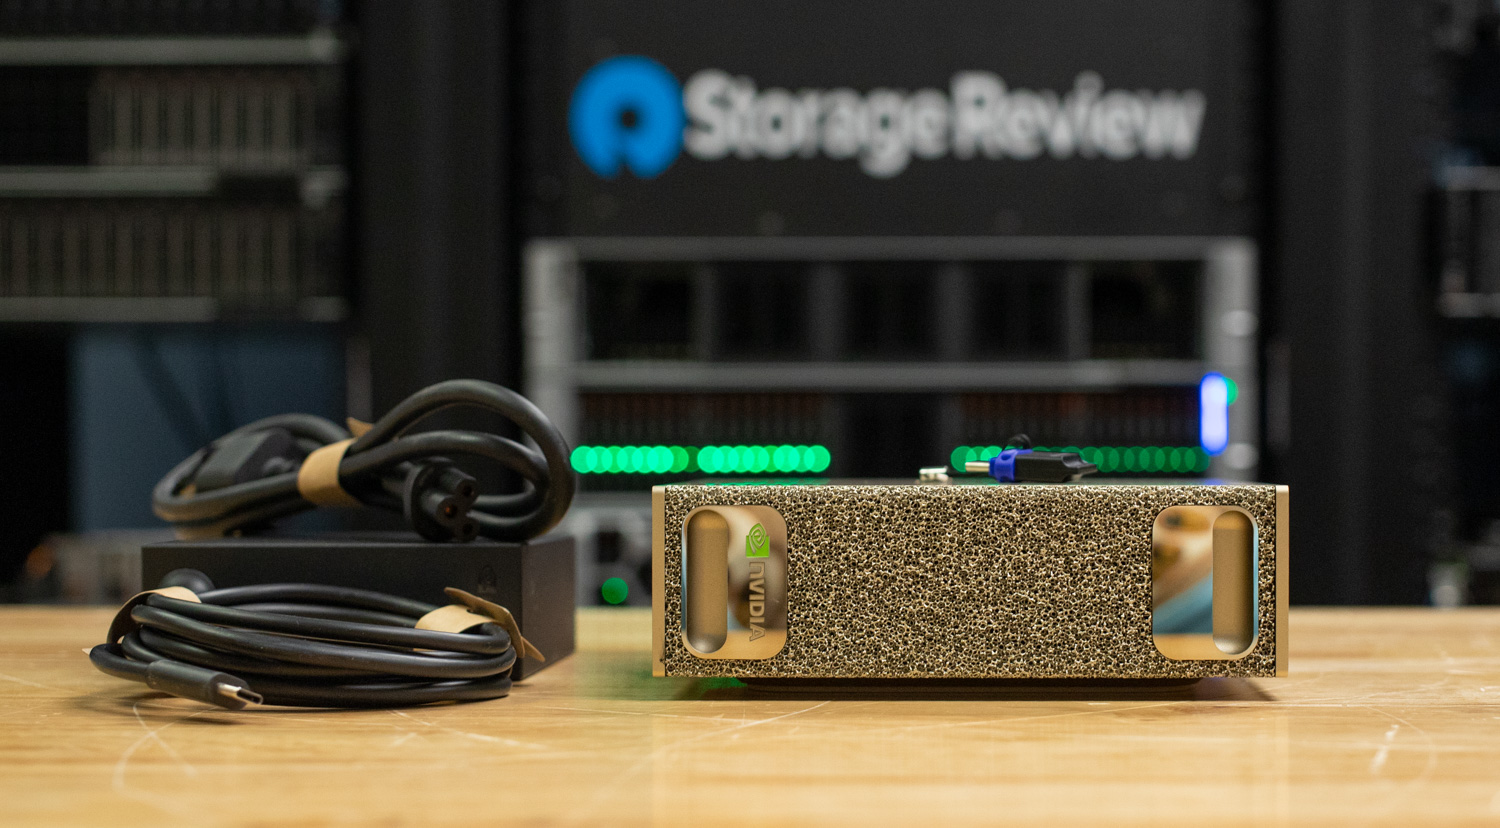
La NVIDIA DGX Spark continúa el inconfundible lenguaje de diseño industrial de NVIDIA, con un chasis compacto que refleja la estética de sus sistemas DGX de mayor tamaño. El panel frontal presenta pequeños recortes para sujetar las manos, un guiño a las asas de las unidades DGX originales de tamaño completo, y un acabado metálico con motas doradas que ofrece una textura refinada y premium, realzada por el icónico logotipo verde de NVIDIA.
Físicamente, el DGX Spark mide 150 × 150 × 50.5 mm (5.9 × 5.9 × 1.98 pulgadas) y pesa 1.2 kg (2.6 libras), lo que le otorga un volumen interno total de 1.13 litros. Esto lo sitúa firmemente dentro de la categoría de PC de formato pequeño de 1 litro. A pesar de su tamaño compacto, el sistema se siente compacto y robusto gracias a una carcasa de aleación totalmente metálica que también actúa como disipador de calor pasivo, manteniendo el enfoque tanto en la forma como en la función.
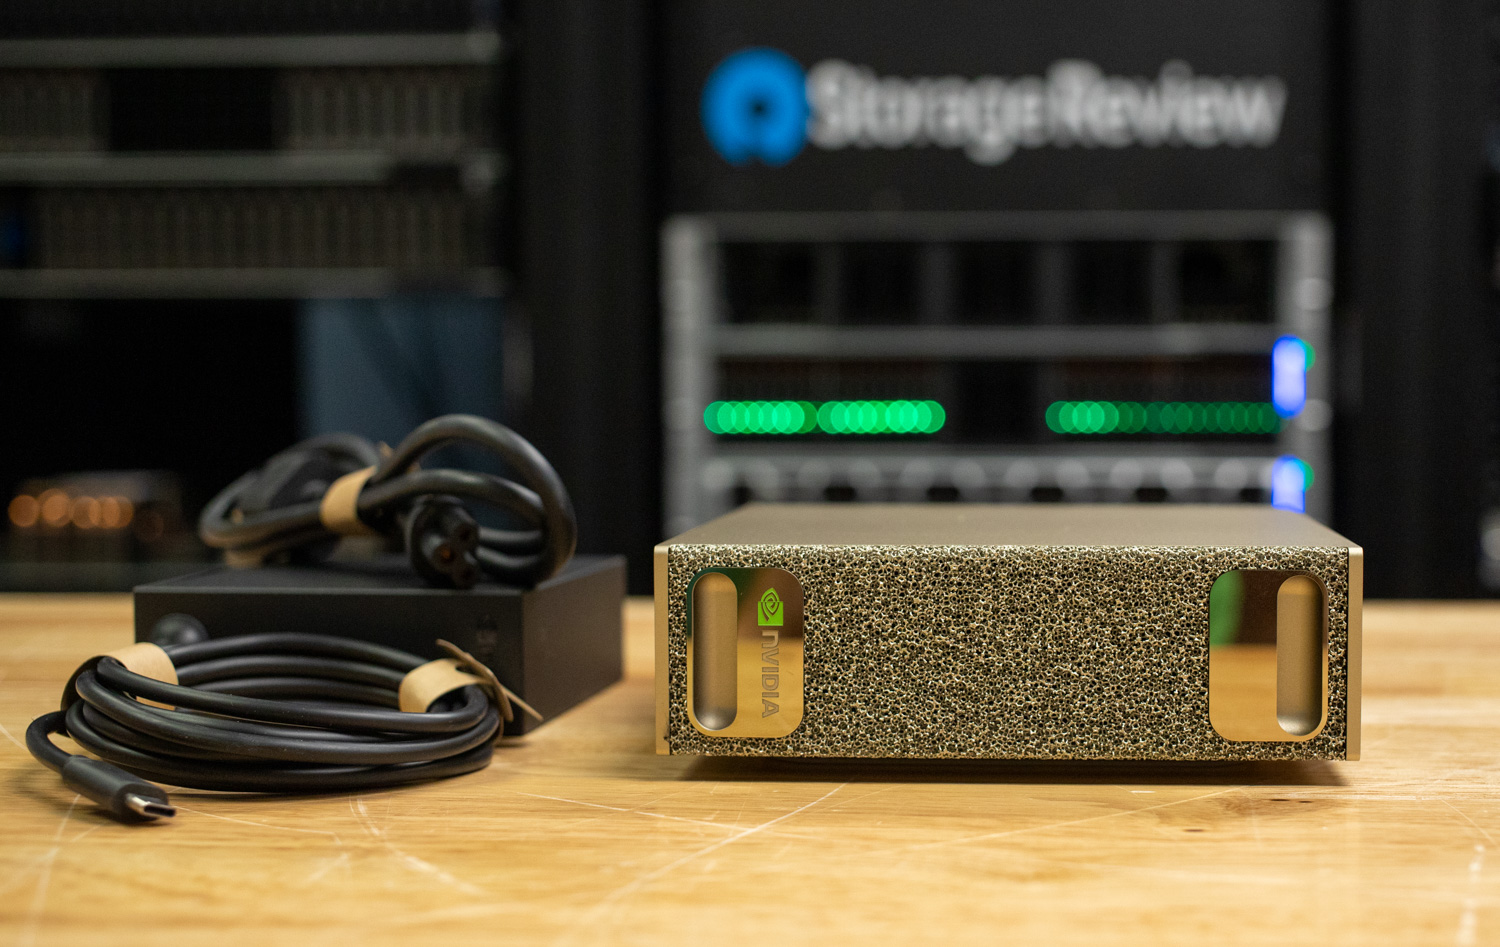
La alimentación se suministra mediante un bloque de alimentación externo USB-C de 240 W, que se ve junto a la unidad principal en la imagen. Este bloque es compacto y de buena calidad, con un conector C5 estándar (en forma de trébol) para la entrada de CA, a juego con el diseño limpio y eficiente del DGX Spark.
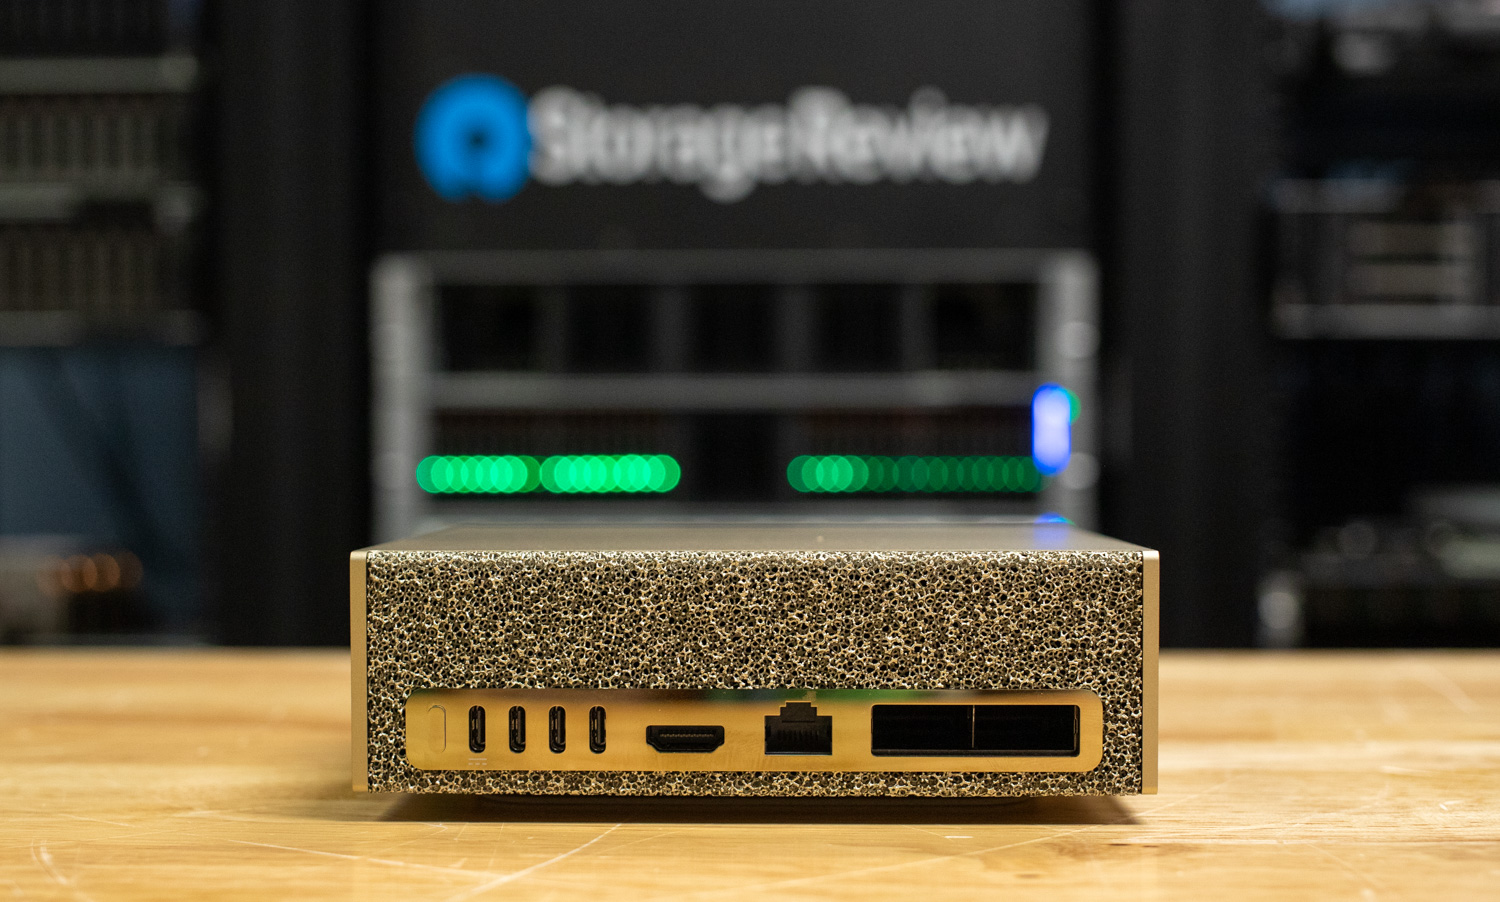
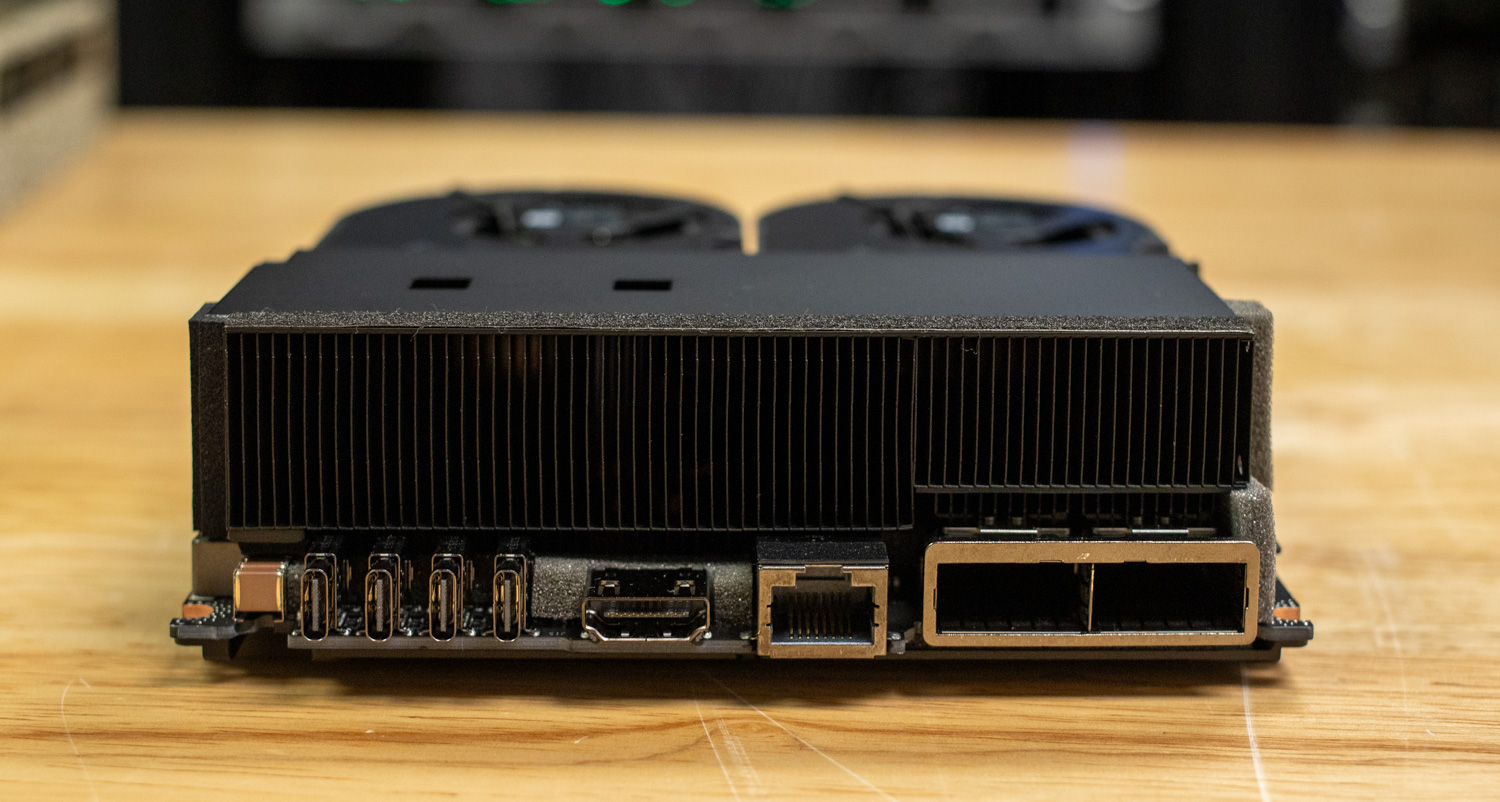
En la parte trasera, el DGX Spark conserva el mismo acabado texturizado con motas doradas que el frontal, manteniendo un diseño cohesivo en todo el chasis. Empezando por la izquierda, el botón de encendido se encuentra junto a cuatro puertos USB-C, uno de los cuales proporciona suministro de energía a la unidad. A estos les siguen una salida HDMI 2.1a, un puerto RJ-45 de 10 GbE y, lo que hace a esta unidad tan interesante, sus dos interfaces QSFP56 de 200 GbE, controladas por una tarjeta SmartNIC NVIDIA ConnectX-7 integrada.
A primera vista, se podría deducir que el Spark permite 400 G de conectividad; desafortunadamente, debido a las limitaciones de PCIe, solo ofrece 200 G. Para saber más, profundizamos en la topología del Spark:
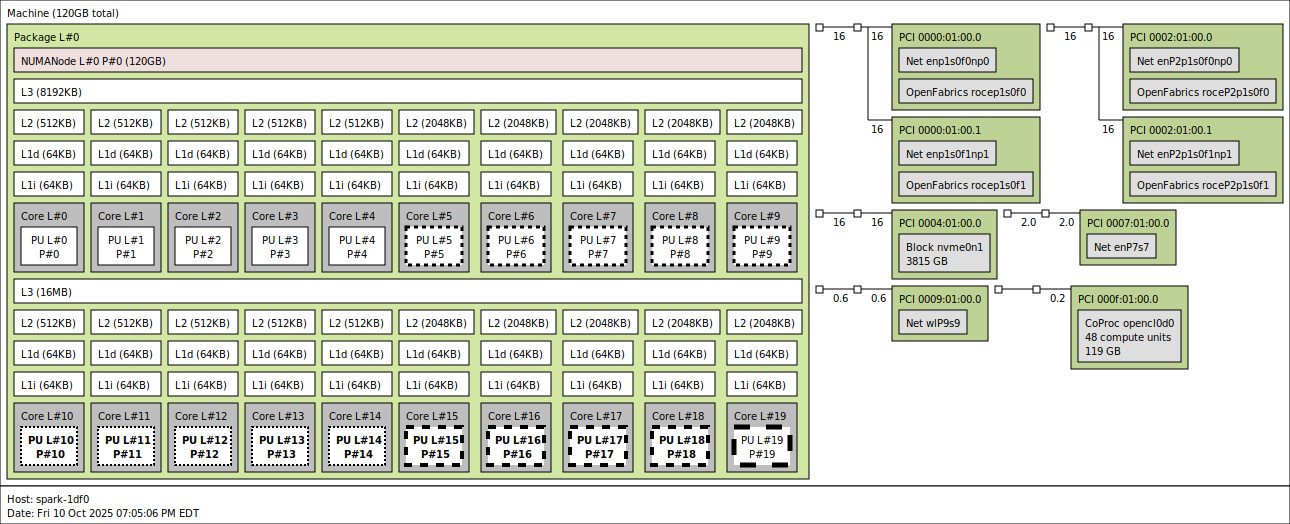
Usando lstopo, observamos las dos interconexiones de la tarjeta de red CX7. Eléctricamente, el CX7 está conectado mediante dos enlaces Gen5 x4. Dentro del sistema operativo, estas conexiones aparecen como cuatro interfaces, cada una con un ancho de banda máximo de 200 G. Debido al tiempo limitado de prueba, no pudimos descubrir todas las peculiaridades de red de esta plataforma fuera de nuestras pruebas NVMe-oF, que se detallan más adelante en este artículo. Sin embargo, planeamos explorar esta plataforma más a fondo y publicaremos artículos futuros que profundicen en sus capacidades, como la agrupación de múltiples Sparks para formar un miniclúster.
Si analizamos otros dispositivos conectados, el siguiente es el pequeño SSD M.2 con formato 2242 conectado con Gen5 x4, seguido por el controlador Realtek RJ45 10GbE conectado con un enlace PCIe Gen4 x1 y el controlador MediaTek Wi-Fi conectado con un enlace PCIe Gen3 x1.
En cuanto a la CPU, el Spark incluye un procesador Arm de 20 núcleos con una arquitectura heterogénea Big Little, similar a la de los procesadores Intel más recientes. Consta de 10 núcleos de eficiencia Cortex-A725 y 10 núcleos de rendimiento Cortex-X925, distribuidos en dos clústeres de caché L3. El primer clúster (8 MB L3) contiene las CPU 0-4 (Cortex-A725, máx. 2808 MHz) y las CPU 5-9 (Cortex-X925, máx. 3900 MHz), mientras que el segundo clúster (16 MB L3) contiene las CPU 10-14 (Cortex-A725, máx. 2860 MHz) y las CPU 15-19 (Cortex-X925, máx. 3978-4004 MHz). Cada núcleo cuenta con cachés privadas de datos L1 de 64 KB y de instrucciones L1 de 64 KB, pero la caché L2 difiere significativamente según el tipo de núcleo: los núcleos Cortex-A725 de alta eficiencia tienen cachés L2 de 512 KB, mientras que los núcleos Cortex-X925 de alto rendimiento tienen cachés L2 considerablemente mayores, de 2 MB (4 veces más grandes). Los núcleos más rápidos son las CPU 15-19, que se benefician tanto de la caché L3 de 16 MB como de frecuencias más altas, siendo la CPU 19 el núcleo de máximo rendimiento a 4004 MHz. Estos diferentes niveles de potencia/frecuencia se indican mediante las líneas discontinuas en el núcleo de la topología mostrada arriba.
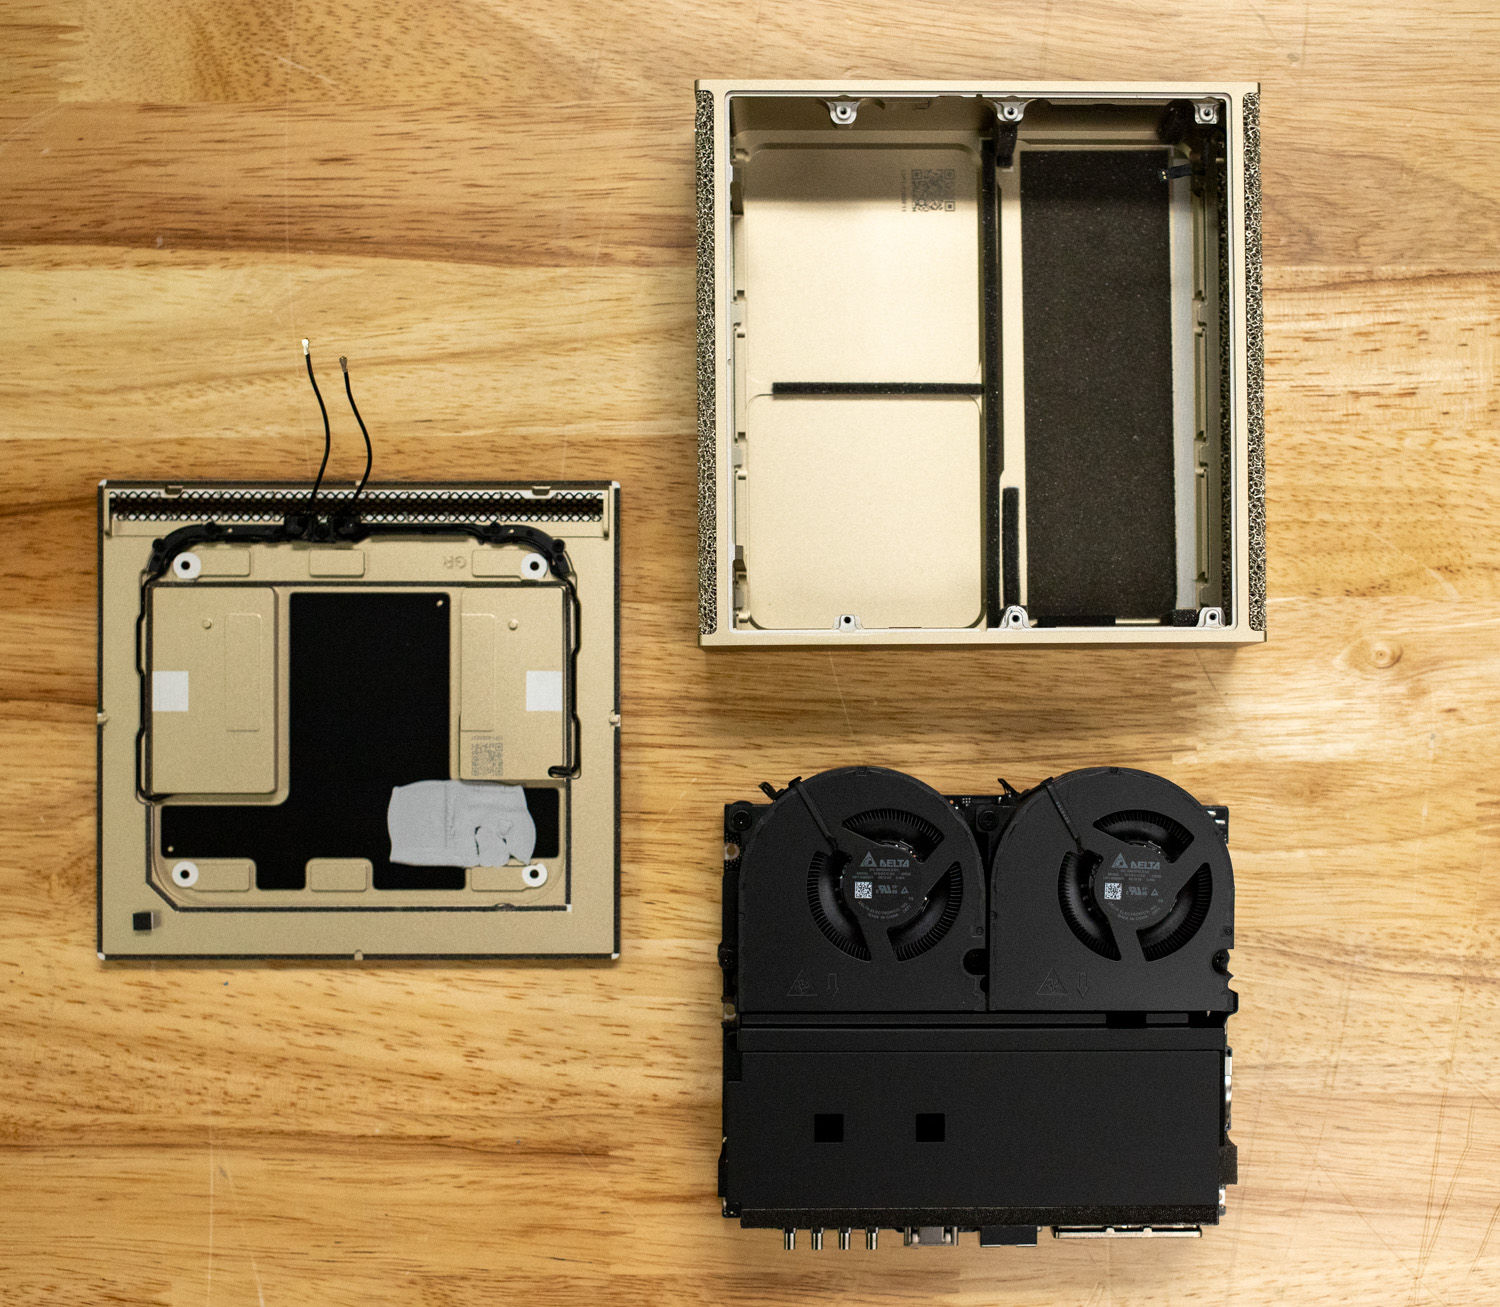
Al alejar la imagen, le damos la vuelta al DGX Spark; el único componente de plástico visible es la cubierta de la base, que se fija magnéticamente a la parte inferior del chasis. Este diseño mantiene el exterior limpio y permite un acceso rápido a las partes internas. Al retirar la base magnética, quedan expuestos cuatro tornillos que dan acceso al compartimento interno principal.
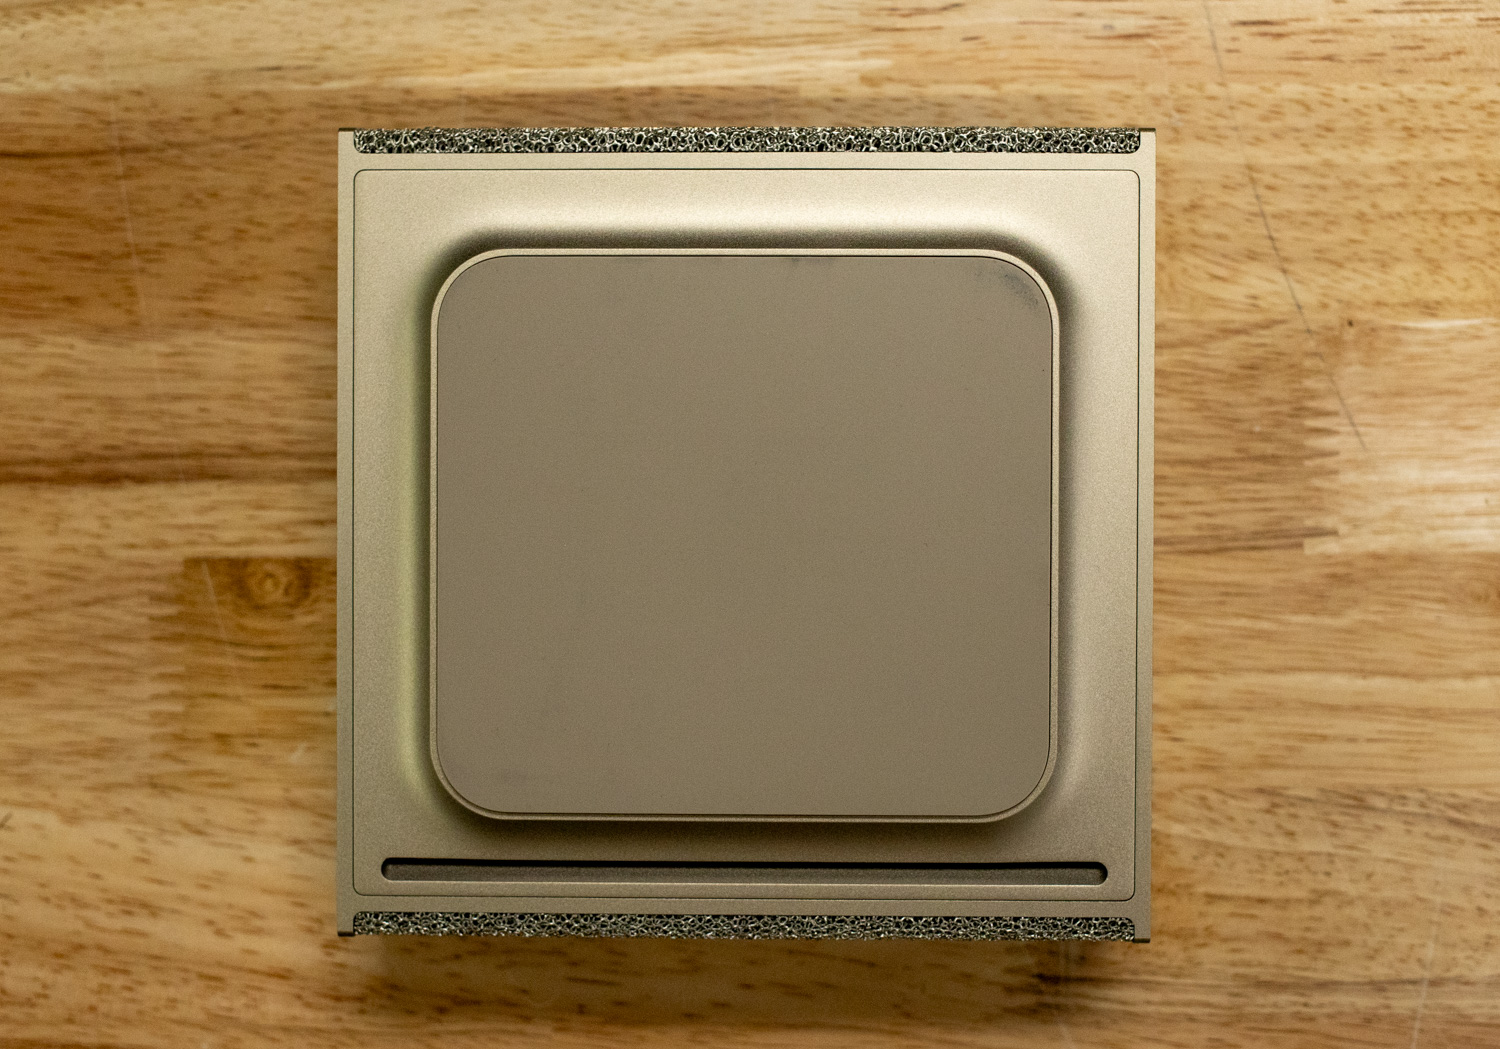
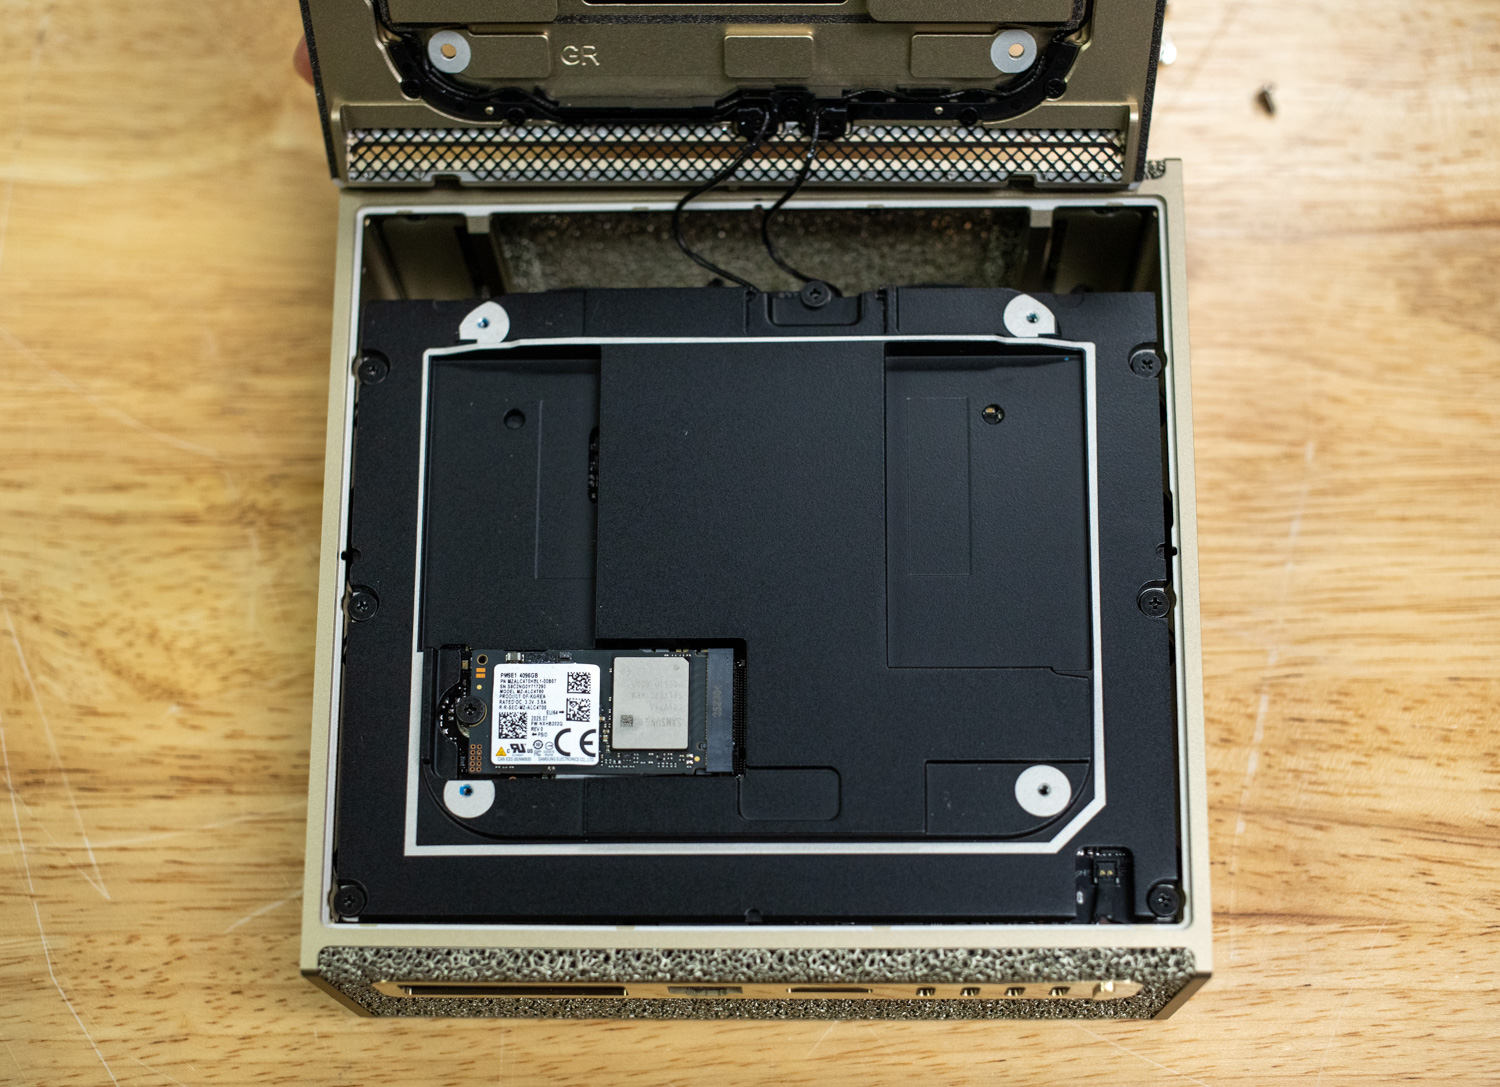
En el interior, podemos ver el cableado de la antena dirigido hacia la sección superior de la unidad, lo que confirma la inclusión de conectividad Wi-Fi 7 y Bluetooth 5.3. Esto proporciona opciones de red flexibles, especialmente útiles para implementaciones móviles o de laboratorio donde el acceso por cable puede no estar disponible.
También se ve la solución de almacenamiento de la unidad: un SSD PCIe Gen5 2242 M.2, un formato poco común para hardware de tan alto rendimiento. La configuración que se muestra aquí incluye una unidad NVMe Samsung de 4 TB.
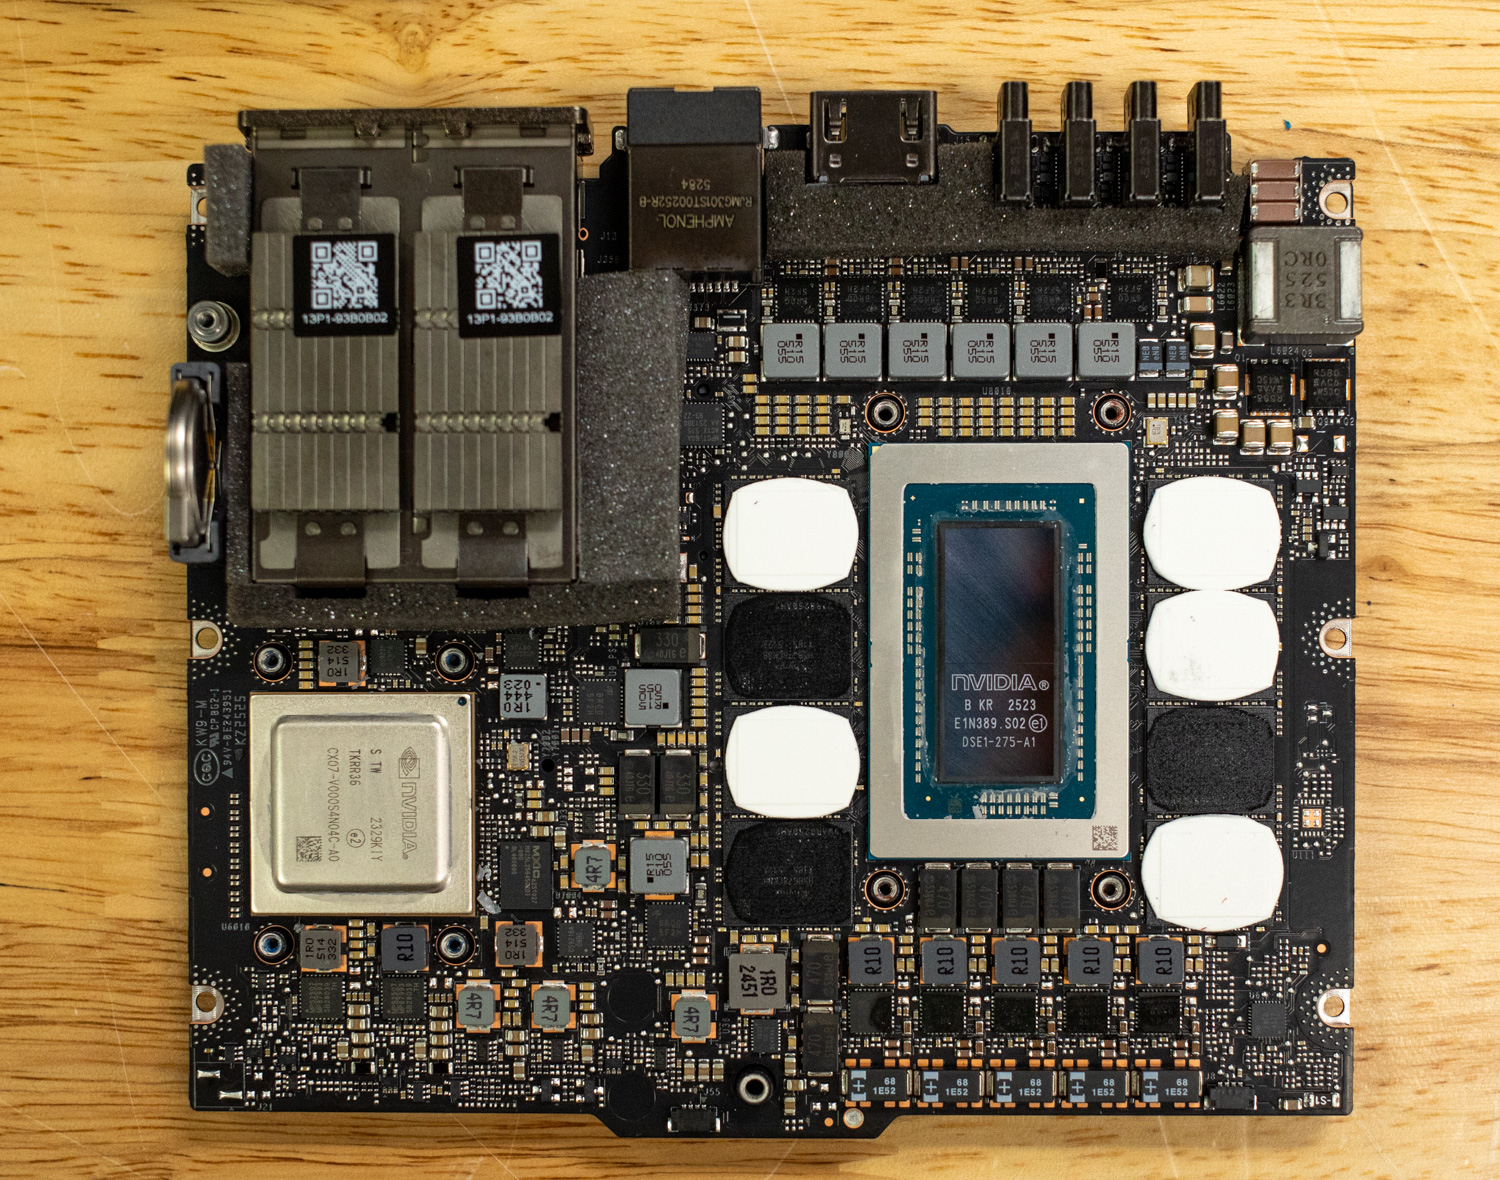
Al profundizar en el DGX Spark, se revela el corazón del sistema: el Superchip GB10 de NVIDIA Grace Blackwell. Flanqueando el Superchip GB10 se encuentran las 8 memorias de sistema unificadas LPDDR5X soldadas, que ofrecen 273 GB/s de ancho de banda, lo que garantiza un acceso rápido a los datos en las operaciones de CPU y GPU.
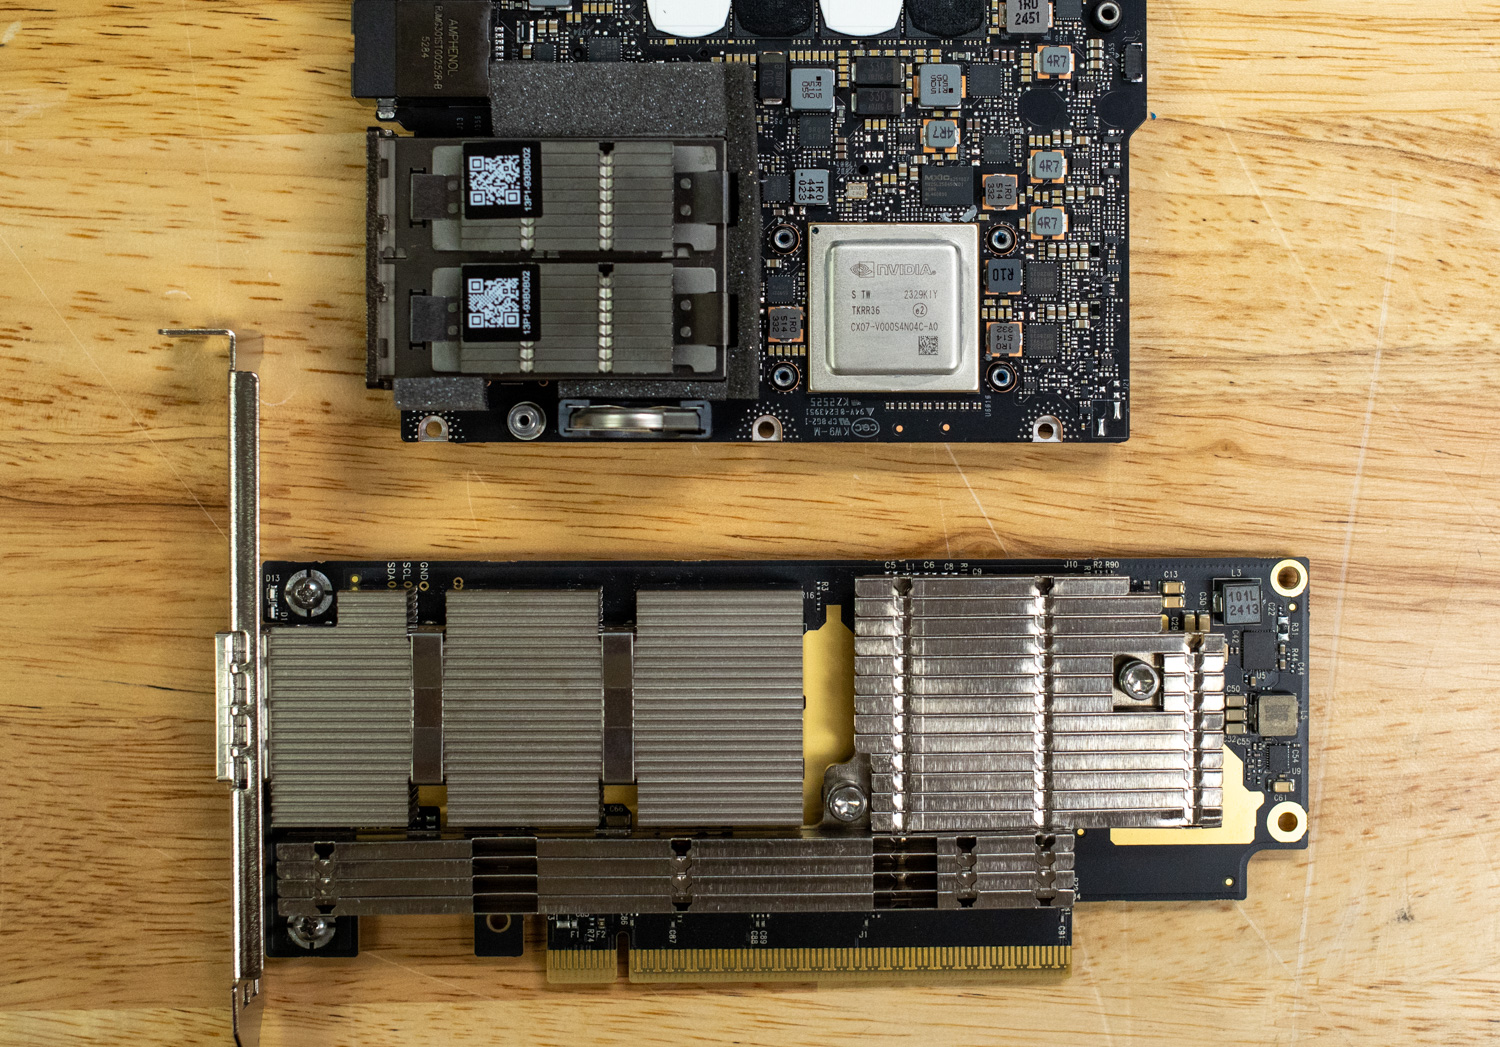
Junto al chip se encuentra la tarjeta de red CX7, que, como se mencionó anteriormente, proporciona 200 GB de conectividad. Esto permite a los usuarios conectar el Spark a un almacenamiento de alta velocidad o incluso agrupar varias instancias del Spark. NVIDIA ha validado y comercializa un clúster de dos Sparks que se pueden conectar directamente para admitir modelos de IA aún más grandes.
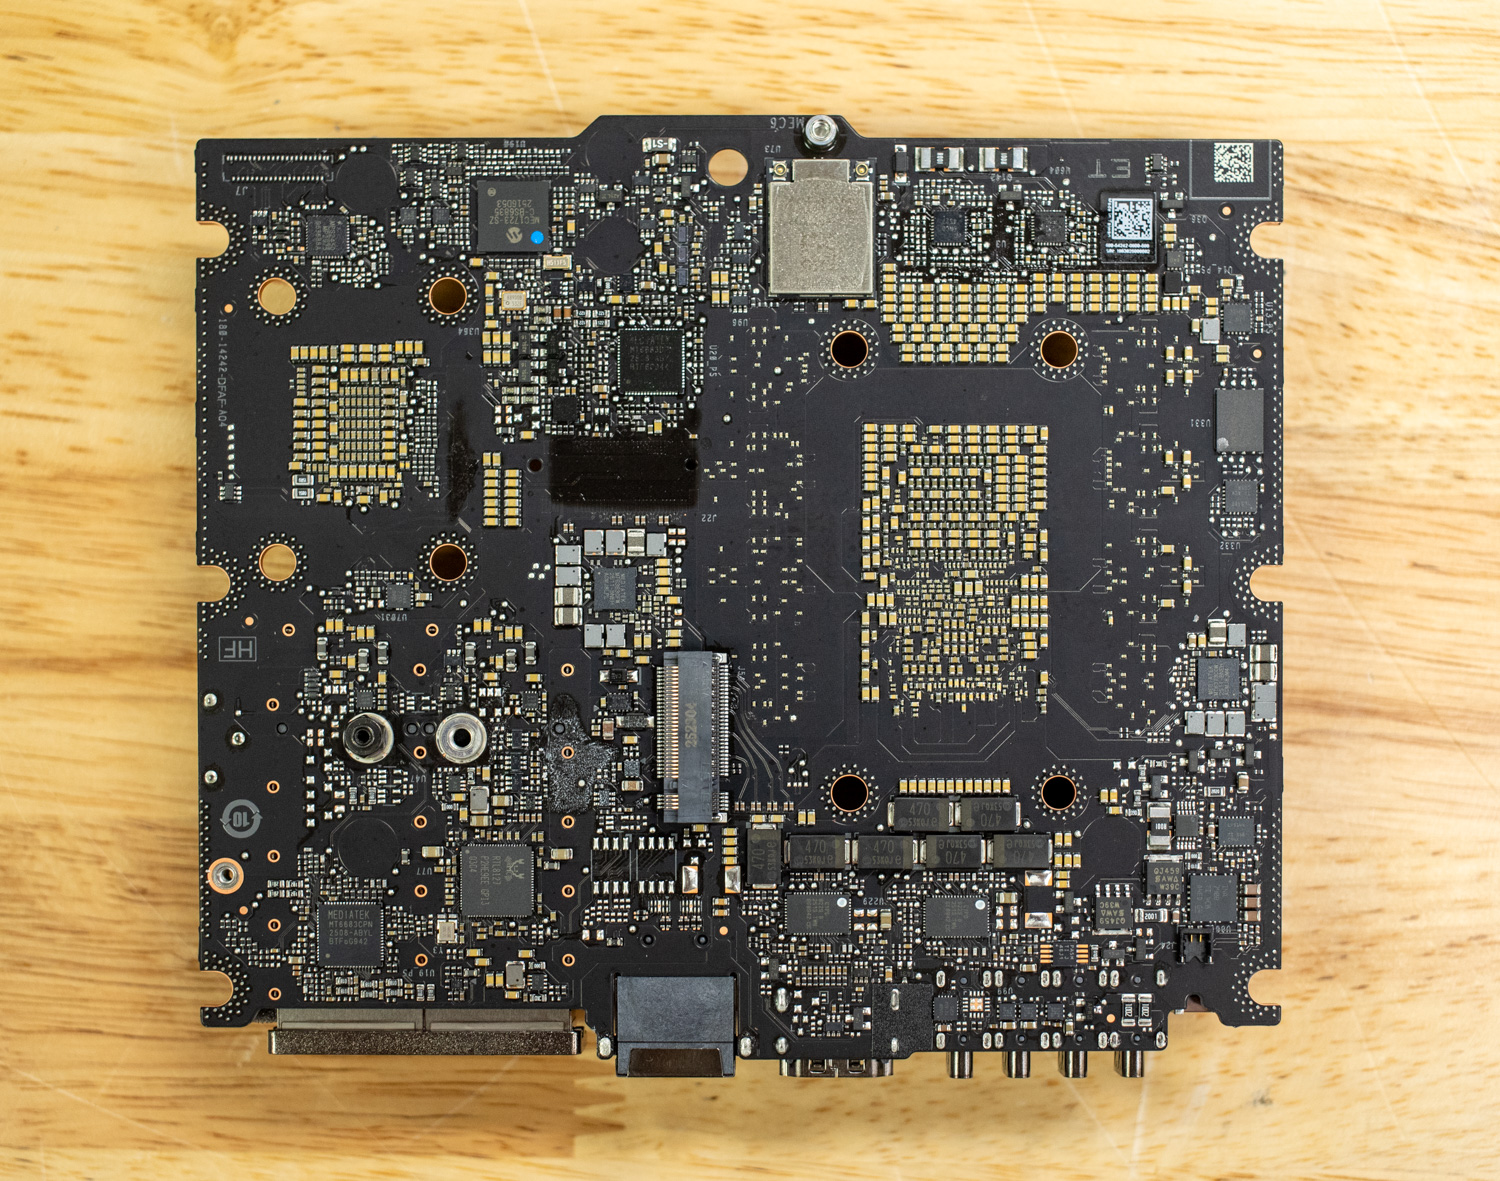
Finalmente, al girar la placa se revela toda la conectividad PCIe, incluido el SSD PCIe Gen5 x4 2242 M.2 y el adaptador Wi-Fi PCIe Gen3x1 MediaTek.
Dónde Spark se vuelve indispensable: el dispositivo moderno de desarrollo de IA
El DGX Spark resulta especialmente atractivo en diversos contextos profesionales distintos, cada uno de los cuales se beneficia de su combinación única de memoria unificada, formato compacto e integración de software integral.
Aceleración de la ciencia de datos: de Pandas a la producción
Para los científicos de datos, NVIDIA DGX Spark representa una gran mejora en la velocidad y la experiencia del flujo de trabajo. La red ConnectX-7, que ofrece un ancho de banda de 200 Gbps, combinada con las bibliotecas aceleradas por CUDA X, transforma el preprocesamiento de datos. La IA y la ciencia de datos se basan en la premisa de que los datos entran y salen correctamente. Tradicionalmente, la fase más laboriosa de cualquier proyecto de aprendizaje automático convencional es la limpieza de datos y la extracción de características. Los flujos de trabajo convencionales suelen implicar la carga de conjuntos de datos en herramientas como Pandas y la realización de transformaciones en los núcleos de la CPU, lo cual suele ser lento. La exploración manual y la ingeniería de características también pueden ser un obstáculo importante. Spark permite la aceleración integral de la GPU mediante RAPIDS.
Un escenario típico de ciencia de datos empresarial implica la ingeniería de características en conjuntos de datos de entre 40 y 80 GB: unir varias tablas, calcular agregaciones en ventanas temporales, gestionar la codificación categórica y normalizar distribuciones. En una infraestructura de CPU, este preprocesamiento puede consumir horas. Con RAPIDS cuDF cargando todo el conjunto de datos en la memoria unificada de 128 GB de Spark, estas operaciones se completan en minutos con una aceleración 10x o superior. El posterior entrenamiento del modelo se beneficia por igual tanto del aprendizaje automático clásico con cuML como del aprendizaje profundo con PyTorch, eliminando el cuello de botella tradicional donde los científicos de datos esperan la infraestructura en lugar de iterar sobre hipótesis.
Generación de datos sintéticos: robótica y simulación
La inclusión de núcleos RT de cuarta generación posiciona a Spark de forma única para un flujo de trabajo emergente: la generación de datos sintéticos para el entrenamiento de modelos del mundo. El entrenamiento de políticas de manipulación robustas tradicionalmente requiere decenas de miles de demostraciones del mundo real, lo que resulta prohibitivo por su elevado coste y tiempo. La simulación fotorrealista en plataformas como Isaac Sim u Omniverse ofrece una alternativa, pero la renderización de imágenes con trazado de rayos, iluminación, reflejos y materiales físicamente precisos históricamente exigía costosas GPU para estaciones de trabajo como la NVIDIA L40S y la RTX 6000 Ada.
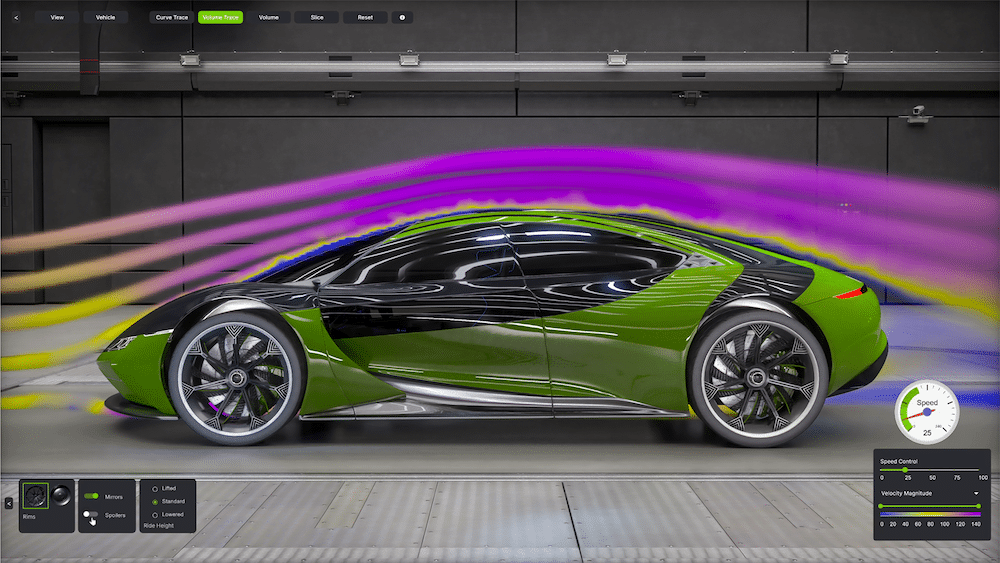
Fuente: NVIDIA
Spark consolida este flujo de trabajo. Los núcleos RT permiten que las cargas de trabajo de OpenUSD gestionen la generación de datos sintéticos, mientras que los núcleos Tensor se utilizan para la inferencia de IA en un plano/flujo de trabajo. Anteriormente, las organizaciones podían implementar varias máquinas para renderizar y un servidor independiente optimizado para la inferencia. Ahora, esto se puede lograr con un solo dispositivo de 240 W. Para startups de robótica, laboratorios universitarios o fabricantes de automóviles que exploran la manipulación autónoma, esta integración reduce significativamente los plazos de desarrollo y la inversión de capital.
Anteriormente, en nuestro análisis de NVIDIA L40S, exploramos flujos de trabajo similares para la generación de datos sintéticos utilizando sistemas de renderizado L40S dedicados, combinados con H100 para la inferencia . La consolidación arquitectónica de estas capacidades en un dispositivo de desarrollo unificado, presente en el GB10, representa una evolución significativa de este flujo de trabajo. En un análisis posterior, planeamos realizar pruebas adicionales del rendimiento del núcleo RT de Spark frente a estas configuraciones específicas, examinando el renderizado y otras cargas de trabajo para escenarios representativos de manipulación robótica.
La revolución de la codificación Vibe
Andrej Karpathy, exdirector de IA de Tesla y miembro fundador de OpenAI, acuñó el término "codificación de vibración" para describir un enfoque emergente para el desarrollo rápido de software con asistencia de IA. En lugar de escribir código meticulosamente línea por línea, la codificación de vibración aprovecha a los LLM como programadores interactivos en pareja: describen la funcionalidad en lenguaje natural, generan andamiaje de implementación, iteran mediante el refinamiento conversacional y prototipan rápidamente las características. Este flujo de trabajo transforma la codificación de la construcción deliberada a la conversación guiada con una IA que comprende el contexto, las API y los patrones arquitectónicos, lo que permite a los desarrolladores individuales construir sistemas extraordinariamente sofisticados a una velocidad sin precedentes.
La magnitud de la adopción de la codificación asistida por IA queda demostrada por las clasificaciones de uso de OpenRouter , donde los modelos centrados en la codificación dominan sistemáticamente el volumen de inferencias. Los profesionales técnicos, el principal grupo demográfico de la codificación basada en IA, suelen operar como usuarios avanzados, ejecutando múltiples agentes de codificación en paralelo en diferentes contextos. Y a medida que los modelos de código abierto igualan cada vez más a las alternativas propietarias en los principales parámetros de referencia , los desarrolladores están explorando implementaciones de inferencia locales para eliminar las limitaciones de velocidad, garantizar la disponibilidad durante los periodos críticos de desarrollo y mantener la confidencialidad del código para proyectos propietarios.
La comunidad r/LocalLLaMA presenta configuraciones personalizadas realmente impresionantes, que abarcan desde estaciones de trabajo multiGPU hasta servidores interconectados que ejecutan modelos locales, inferencia distribuida en hardware de consumo y soluciones de refrigeración sofisticadas que permiten una generación sostenida de alto rendimiento. Sin embargo, estas configuraciones presentan importantes barreras: gastos de capital que a menudo superan las decenas de miles de dólares, un consumo energético considerable, desafíos de gestión térmica que requieren espacios dedicados en lugar de entornos de oficina estándar, y una considerable experiencia técnica para la configuración, optimización y resolución de problemas.
Spark revoluciona esta propuesta de valor. Con un precio de $3,999 y 128 GB de memoria unificada, ofrece un rendimiento impresionante en la inferencia de modelos en un dispositivo silencioso, compacto y de bajo consumo que consume tan solo 240 W. Los usuarios que buscan establecer una infraestructura local de asistente de codificación ya no necesitan laboratorios domésticos complejos que consumen kilovatios-hora y generan una considerable generación de calor. El enfoque de dispositivo validado con sistema operativo DGX preconfigurado elimina la complejidad de configuración que antes restringía la implementación local de LLM a usuarios con amplios conocimientos de Linux y CUDA.
Además de eliminar la fricción de la infraestructura, Spark aborda las preocupaciones críticas sobre la privacidad del código y la personalización de modelos. Los asistentes de programación en la nube necesariamente transmiten el código fuente a servidores remotos, lo cual es un inconveniente para las organizaciones que manejan algoritmos propietarios, infraestructura crítica para la seguridad o datos regulados. La inferencia local en Spark garantiza que el código nunca abandone el entorno de desarrollo. Además, la capacidad de memoria de 128 GB permite el ajuste completo de los parámetros de los modelos de programación, lo que permite a los desarrolladores experimentados especializarlos en bases de código internas. Esta capacidad es especialmente valiosa para organizaciones con lenguajes específicos de dominio, marcos personalizados o patrones arquitectónicos que no están suficientemente representados en los datos de entrenamiento públicos.
Ajuste fino con NVIDIA NeMo en DGX Spark
La memoria unificada de 128 GB del DGX Spark permite un ajuste fino completo de los parámetros de los modelos 8B, que tradicionalmente requerían costosas configuraciones multi-GPU en la nube. El ajuste fino completo de Qwen3 8B con optimización estándar de Adam requiere aproximadamente 132 GB (16 GB de pesos de modelo, 96 GB de estados del optimizador, 16 GB de gradientes, más activaciones), superando las configuraciones duales H100 de 80 GB. El uso de Adam de 8 bits, con un uso eficiente de la memoria, reduce los requisitos a unos 70 GB, dependiendo del tamaño del lote, lo que se ajusta cómodamente al conjunto de memoria de Spark. Esto es importante porque el ajuste fino completo ofrece una precisión entre un 4 % y un 6 % superior a la de LoRA en tareas de razonamiento complejas. Mientras que las configuraciones 2× H100 de 80 GB basadas en la nube cuestan aproximadamente $5 por hora con una complejidad de entrenamiento distribuido, Spark ofrece entrenamiento de un solo sistema con una inversión única de $3,999.
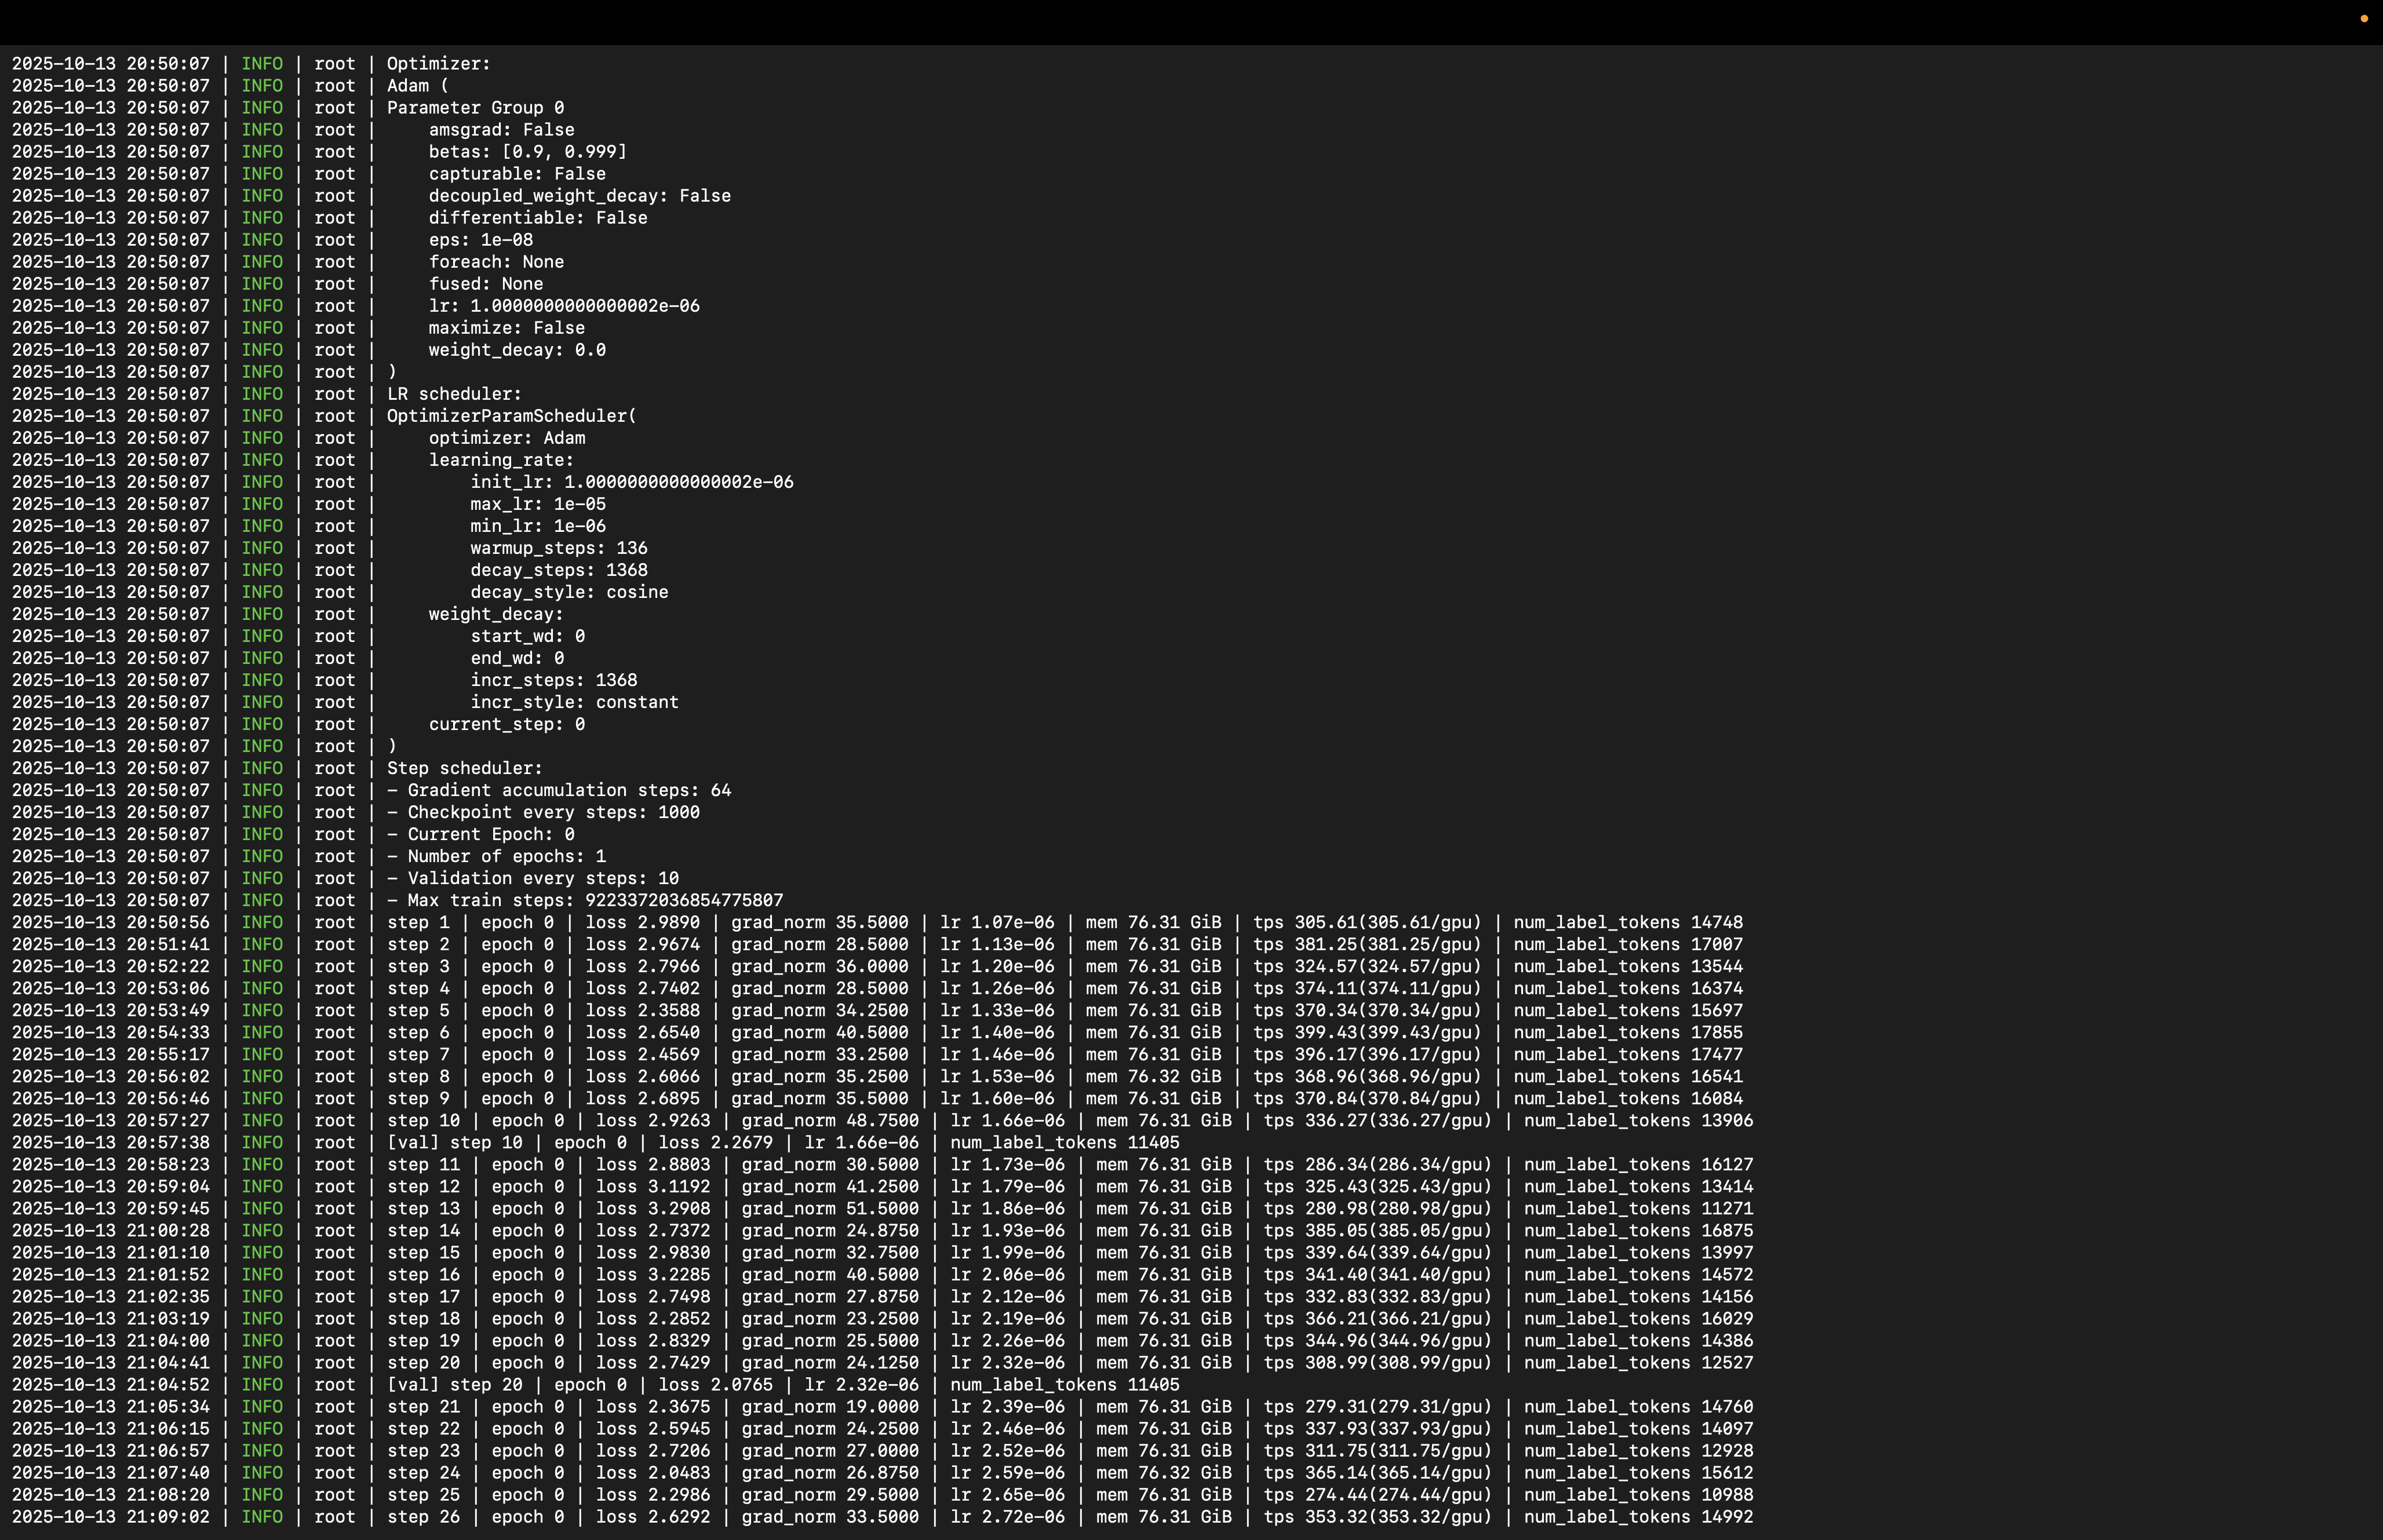
NVIDIA NeMo Automodel elimina la fricción del marco de entrenamiento empresarial al ofrecer compatibilidad desde el primer día con cualquier modelo de Hugging Face sin conversión de puntos de control. Cargue Qwen3 8B directamente desde HuggingFace Hub y configure los ajustes mediante archivos YAML, especificando las fuentes de los conjuntos de datos, la configuración del optimizador y los objetivos LoRA. NeMo automatiza la creación de puntos de control distribuidos con compatibilidad con safetensors, implementa kernels CUDA fusionados para aceleraciones de 2 a 5 veces y gestiona la acumulación de gradientes.
Generación de imágenes con una interfaz de usuario cómoda
ComfyUI ofrece una interfaz gráfica basada en nodos que transforma Stable Diffusion y los modelos de difusión relacionados en flujos de trabajo creativos altamente personalizables. A diferencia de las interfaces web tradicionales, que abstraen la complejidad tras controles deslizantes de parámetros simplificados, ComfyUI emplea una arquitectura gráfica visual donde los usuarios construyen flujos de trabajo conectando nodos funcionales discretos, cada uno representando operaciones específicas como la carga del modelo, la codificación de indicaciones, el muestreo de difusión latente, la decodificación de VAE o las transformaciones de escalado. Este diseño modular permite un control granular sobre todo el flujo de trabajo de generación, haciendo que cada paso computacional sea transparente y ajustable. También permite a los usuarios encadenar múltiples modelos, implementar programas de muestreo personalizados o integrar técnicas avanzadas como la guía ControlNet, algo imposible en interfaces simplificadas.
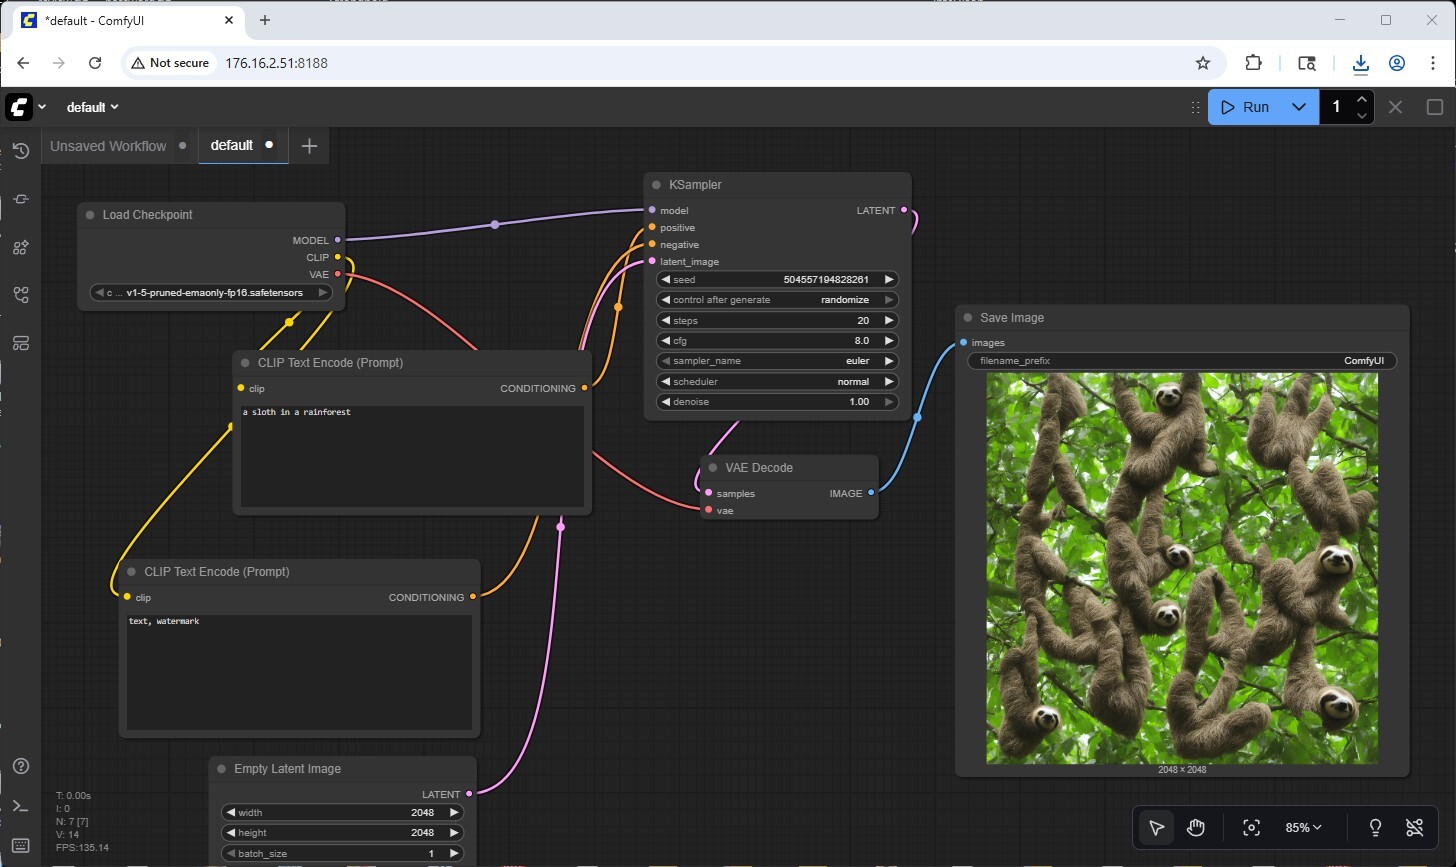
En DGX Spark, ComfyUI aprovecha los núcleos Tensor de la GPU Blackwell para acelerar el muestreo por difusión, completando típicamente generaciones en 15-30 segundos, dependiendo de la complejidad del muestreo. La arquitectura de memoria unificada de 128 GB resulta especialmente ventajosa, ya que mantiene múltiples modelos de puntos de control, adaptadores LoRA y decodificadores VAE en memoria simultáneamente, eliminando la sobrecarga de recarga que afecta a los sistemas con limitaciones de VRAM. Los usuarios pueden generar prácticamente un número ilimitado de ilustraciones de IA localmente, sin límites de velocidad de API, costos de nube por generación ni las preocupaciones de privacidad asociadas con flujos de trabajo creativos propietarios. El modelo de persistencia del flujo de trabajo añade valor operativo: las canalizaciones completas se serializan en archivos JSON que pueden controlarse por versión, compartirse entre equipos o integrarse directamente en las imágenes generadas como metadatos, lo que permite una reproducibilidad crucial para las organizaciones que crean canalizaciones de conjuntos de datos sintéticos o mantienen estilos artísticos consistentes en todos los recursos generados.
Pruebas de rendimiento de NVIDIA DGX Spark
Servicio en línea de vLLM: prueba de inferencia de LLM
vLLM es el motor de inferencia y servicio de alto rendimiento más popular para servidores LLM. El benchmark de servicio en línea de vLLM es una herramienta de evaluación del rendimiento diseñada para medir la capacidad de servicio real de este motor de inferencia al gestionar solicitudes concurrentes. Simula cargas de trabajo de producción enviando solicitudes a un servidor vLLM en ejecución con parámetros configurables, como la tasa de solicitudes, la longitud de entrada/salida y el número de clientes concurrentes. El benchmark mide métricas clave, como el rendimiento (tokens por segundo, tiempo hasta el primer token y tiempo por token de salida), lo que ayuda a los usuarios a comprender el rendimiento de vLLM en diferentes condiciones de carga.
Probamos el rendimiento de la inferencia en un conjunto integral de modelos que representan las arquitecturas y los tipos de modelos más populares en las implementaciones de producción actuales.
Mezcla de modelos de expertos
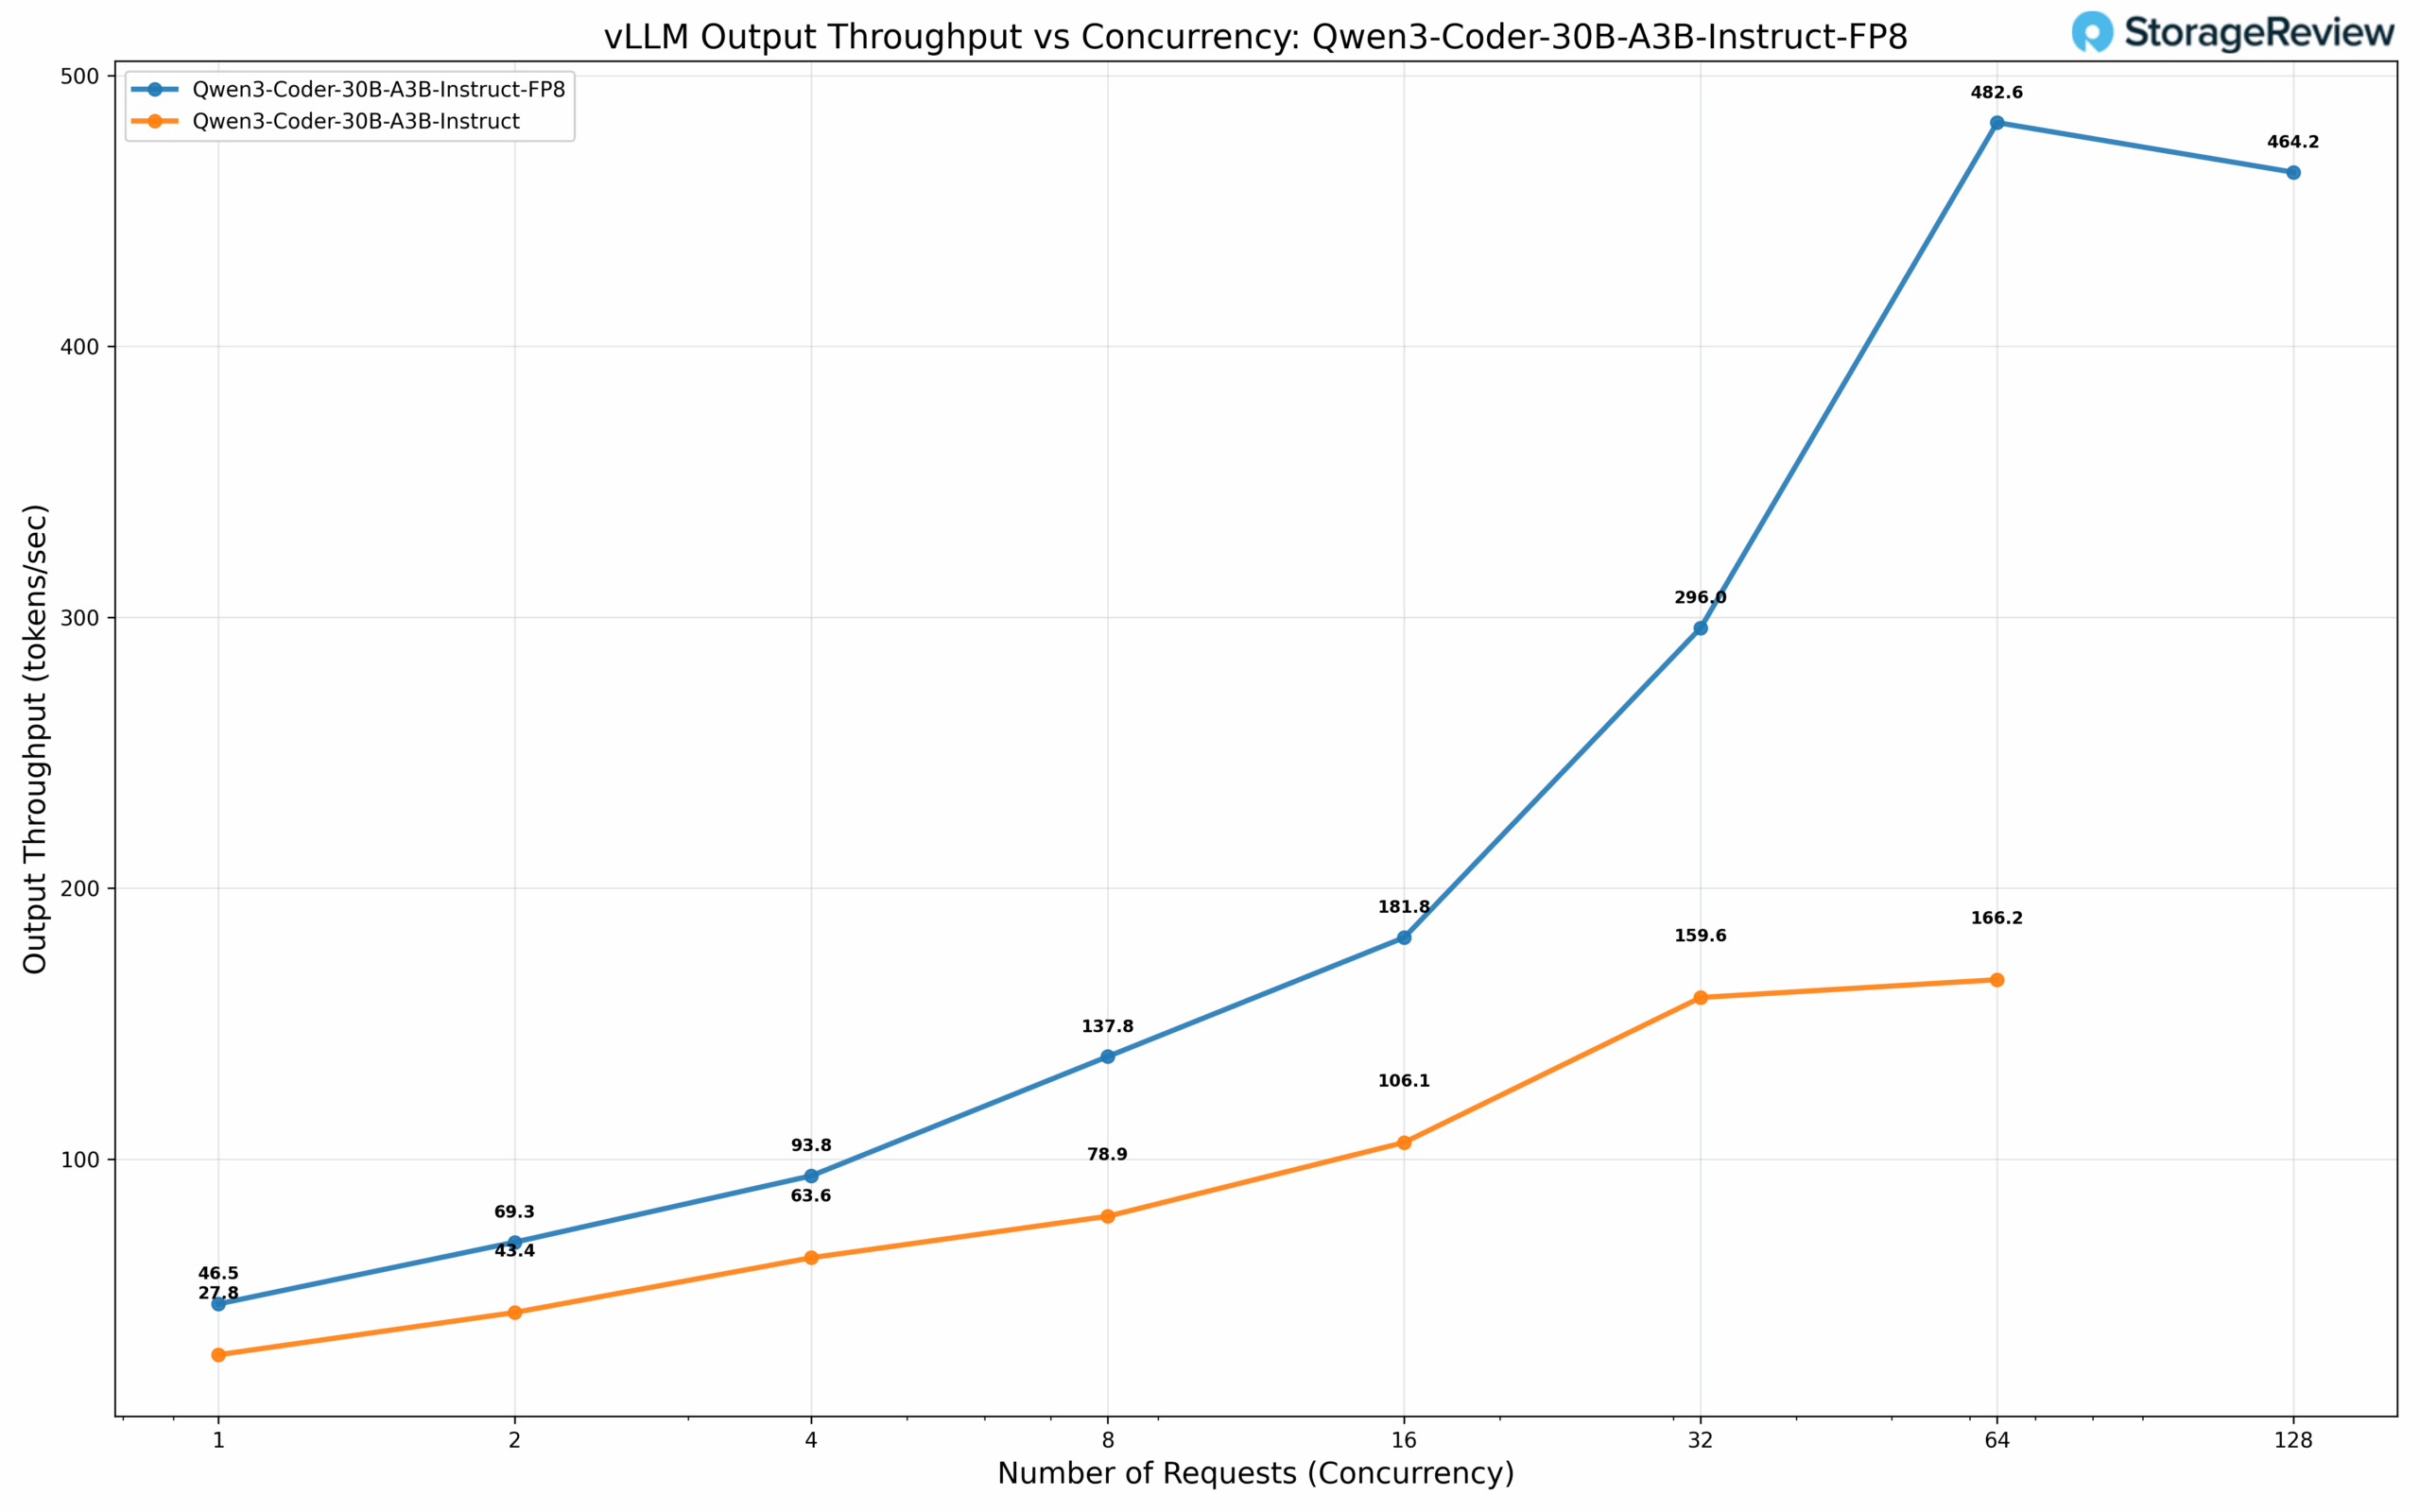
Evaluamos el Qwen3 Coder 30B-A3B, uno de los modelos de codificación más populares para implementaciones de inferencia local. Esta arquitectura dispersa mantiene un tamaño de modelo completo de 30 000 millones de parámetros con precisión BF16, activando solo 3 000 millones de parámetros por token generado. Realizamos pruebas comparativas tanto del modelo estándar como de una variante cuantificada FP8 de Qwen. El modelo cuantificado FP8 demuestra mejoras sustanciales en el rendimiento: alcanza 46.5 tok/s con concurrencia 1, escalando a unos impresionantes 482.6 tok/s con un tamaño de lote de 64. El modelo estándar BF16 ofrece 27.8 tok/s con concurrencia 1, alcanzando 166.2 tok/s con un tamaño de lote de 64, una diferencia de rendimiento de casi el triple.
Modelos densos
Los modelos densos representan la arquitectura LLM convencional, donde todos los parámetros y activaciones se utilizan durante la inferencia, lo que resulta en un procesamiento computacionalmente más intensivo en comparación con sus contrapartes dispersas. Para evaluar exhaustivamente las características de rendimiento en las distintas escalas del modelo y las estrategias de cuantificación, evaluamos cinco configuraciones de modelos densos.
Nuestro conjunto de pruebas incluyó Mistral Small 3.1 24B de Mistral AI con precisión BF16, junto con una variante cuantificada dinámicamente de Mistral Small 3.1 24B FP8 de RedHat AI. La cuantificación dinámica emplea técnicas de cuantificación selectiva de pesos para optimizar el equilibrio entre rendimiento y precisión, reduciendo estratégicamente la precisión y minimizando la degradación del modelo. Complementamos estos modelos densos más grandes con evaluaciones de Meta Llama 3.1 8B en tres formatos de precisión: la configuración BF16 estándar y las versiones cuantificadas FP8 y FP4 de NVIDIA. Esta estrategia de selección de modelos permite la comparación directa del rendimiento entre las escalas del modelo, aislando al mismo tiempo el impacto de la cuantificación progresiva en el rendimiento de la inferencia.
Análisis de rendimiento: modelos grandes y densos
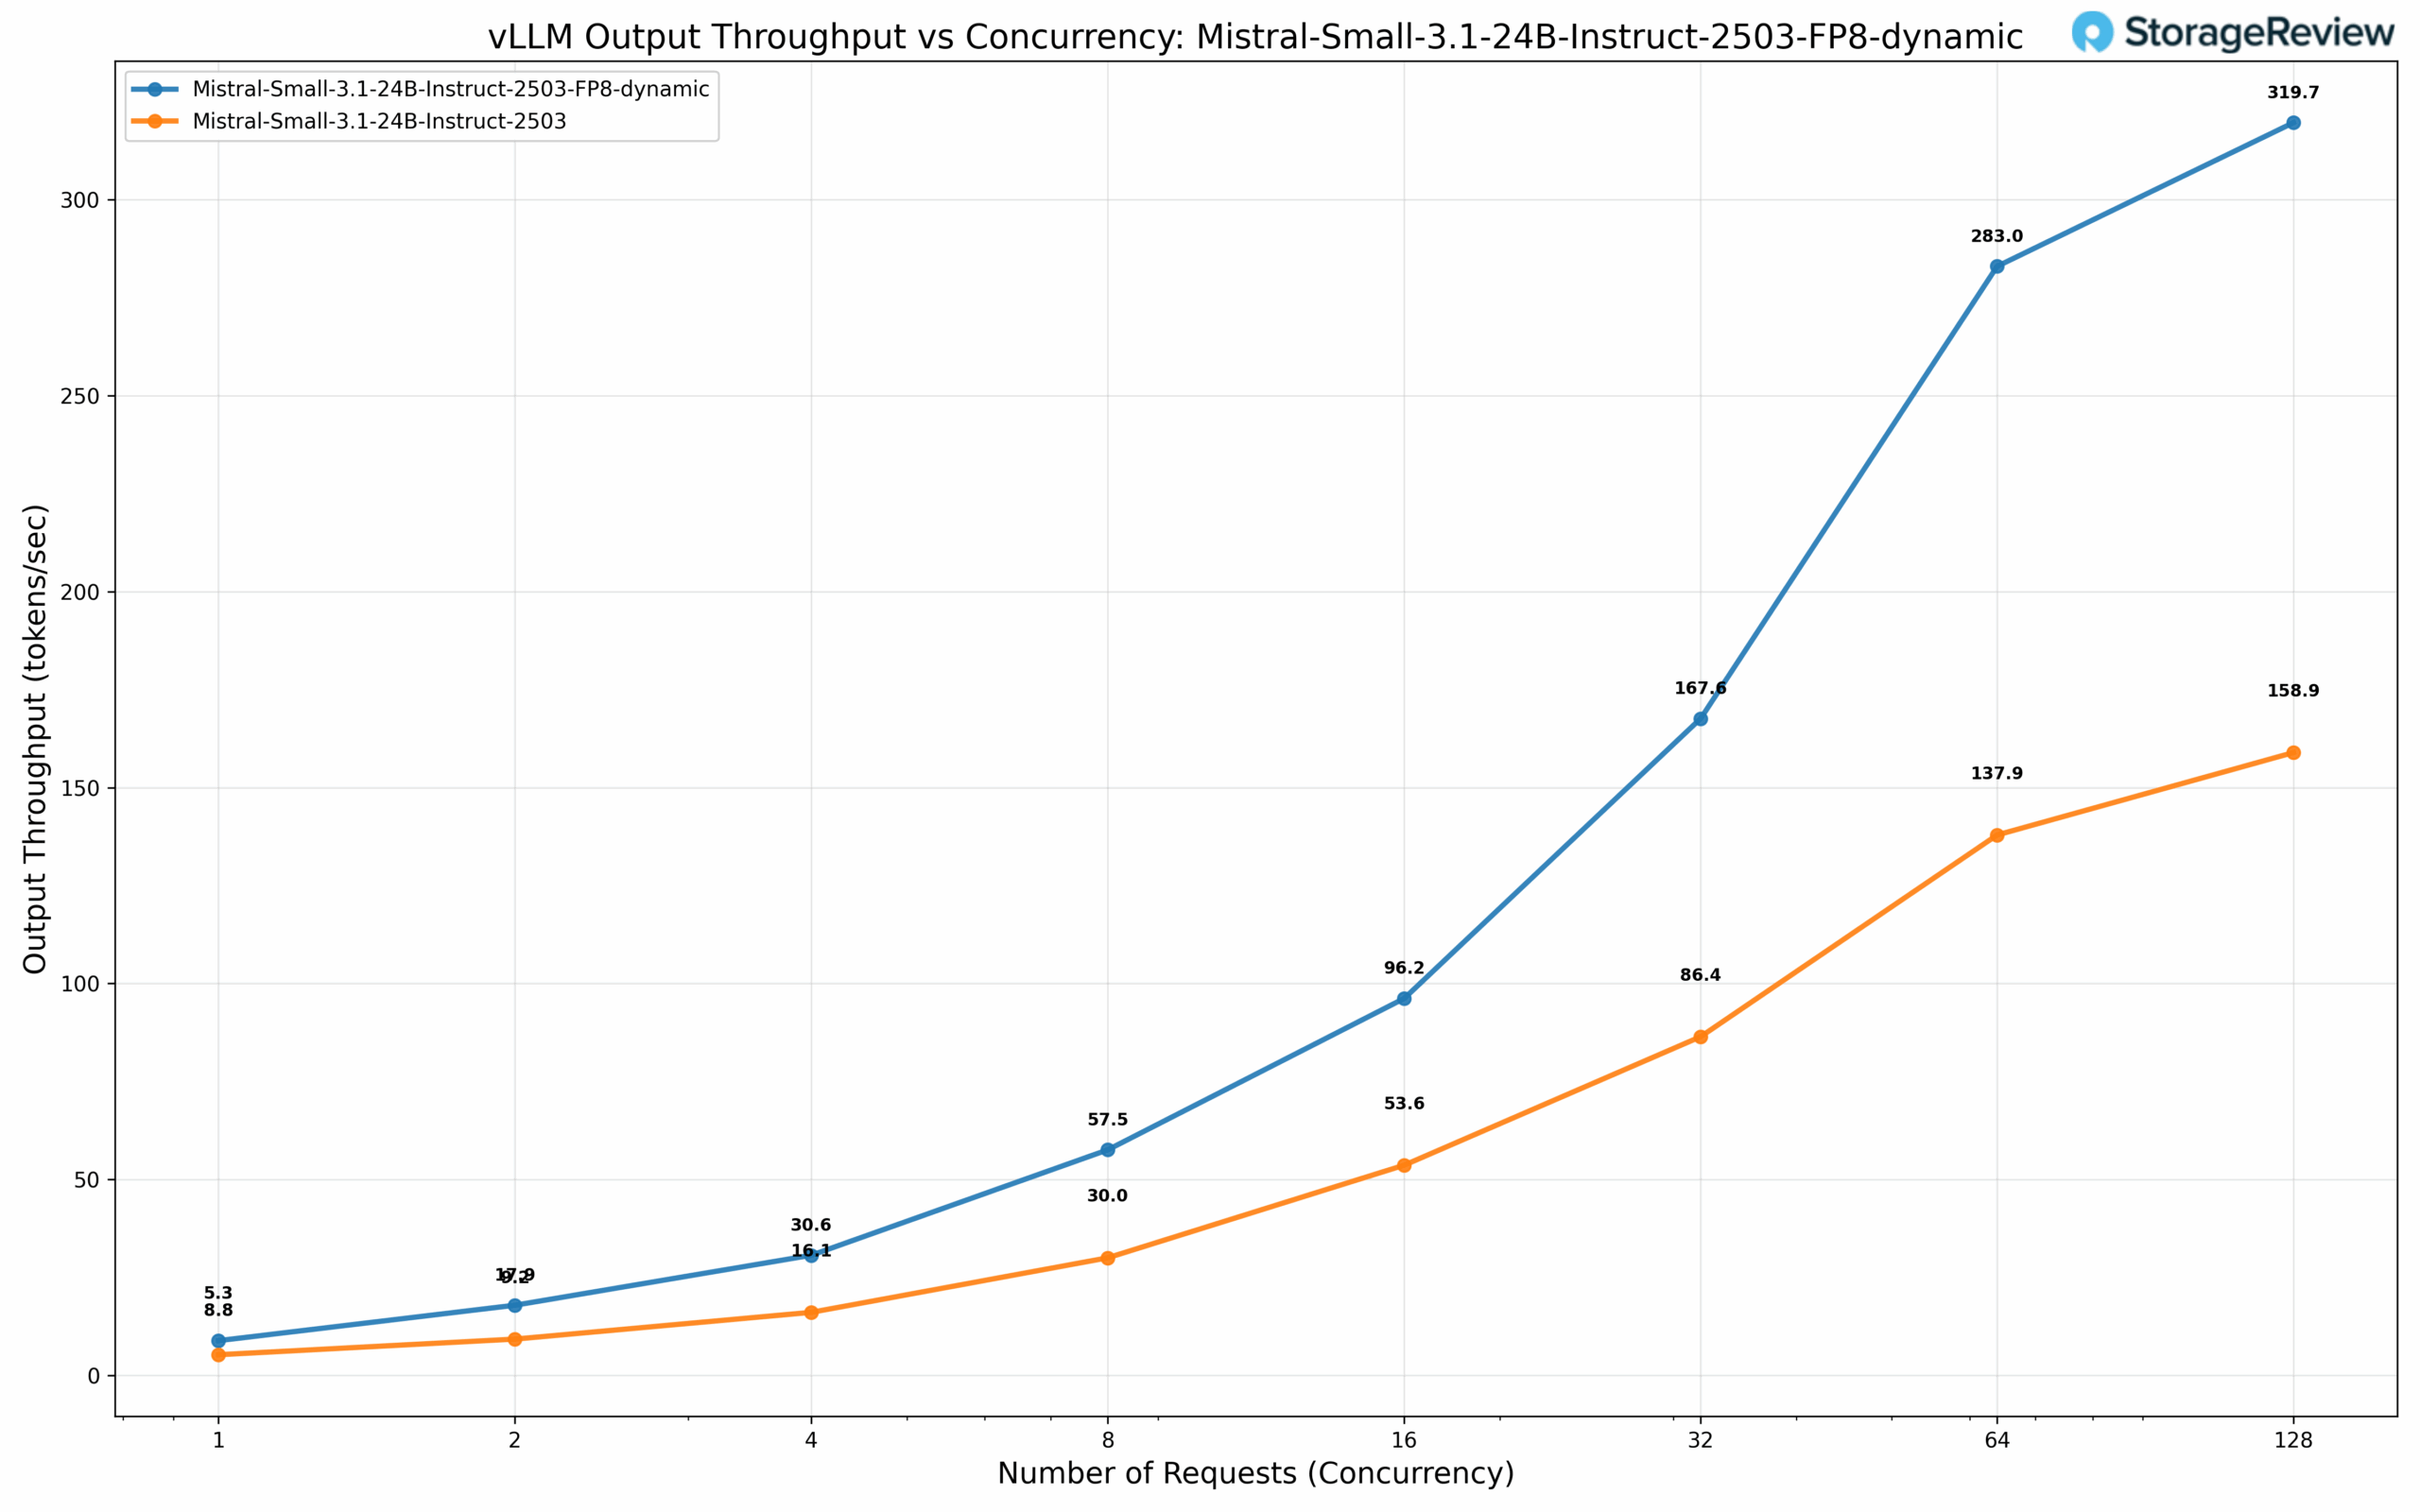
El Mistral Small 3.1 24B con precisión BF16 presenta un rendimiento base de 5.3 tok/s con concurrencia 1, que escala hasta unos considerables 158.9 tok/s con 128 solicitudes concurrentes. La variante FP8 con cuantificación dinámica muestra mejoras modestas con 8.8 tok/s con menor concurrencia, pero ofrece un convincente multiplicador de rendimiento de 2x a escala, alcanzando 319.7 tok/s con 128 solicitudes concurrentes, lo que subraya la eficacia de la cuantificación dinámica para escenarios de servicio de alto rendimiento.
Análisis de rendimiento: modelos compactos y densos
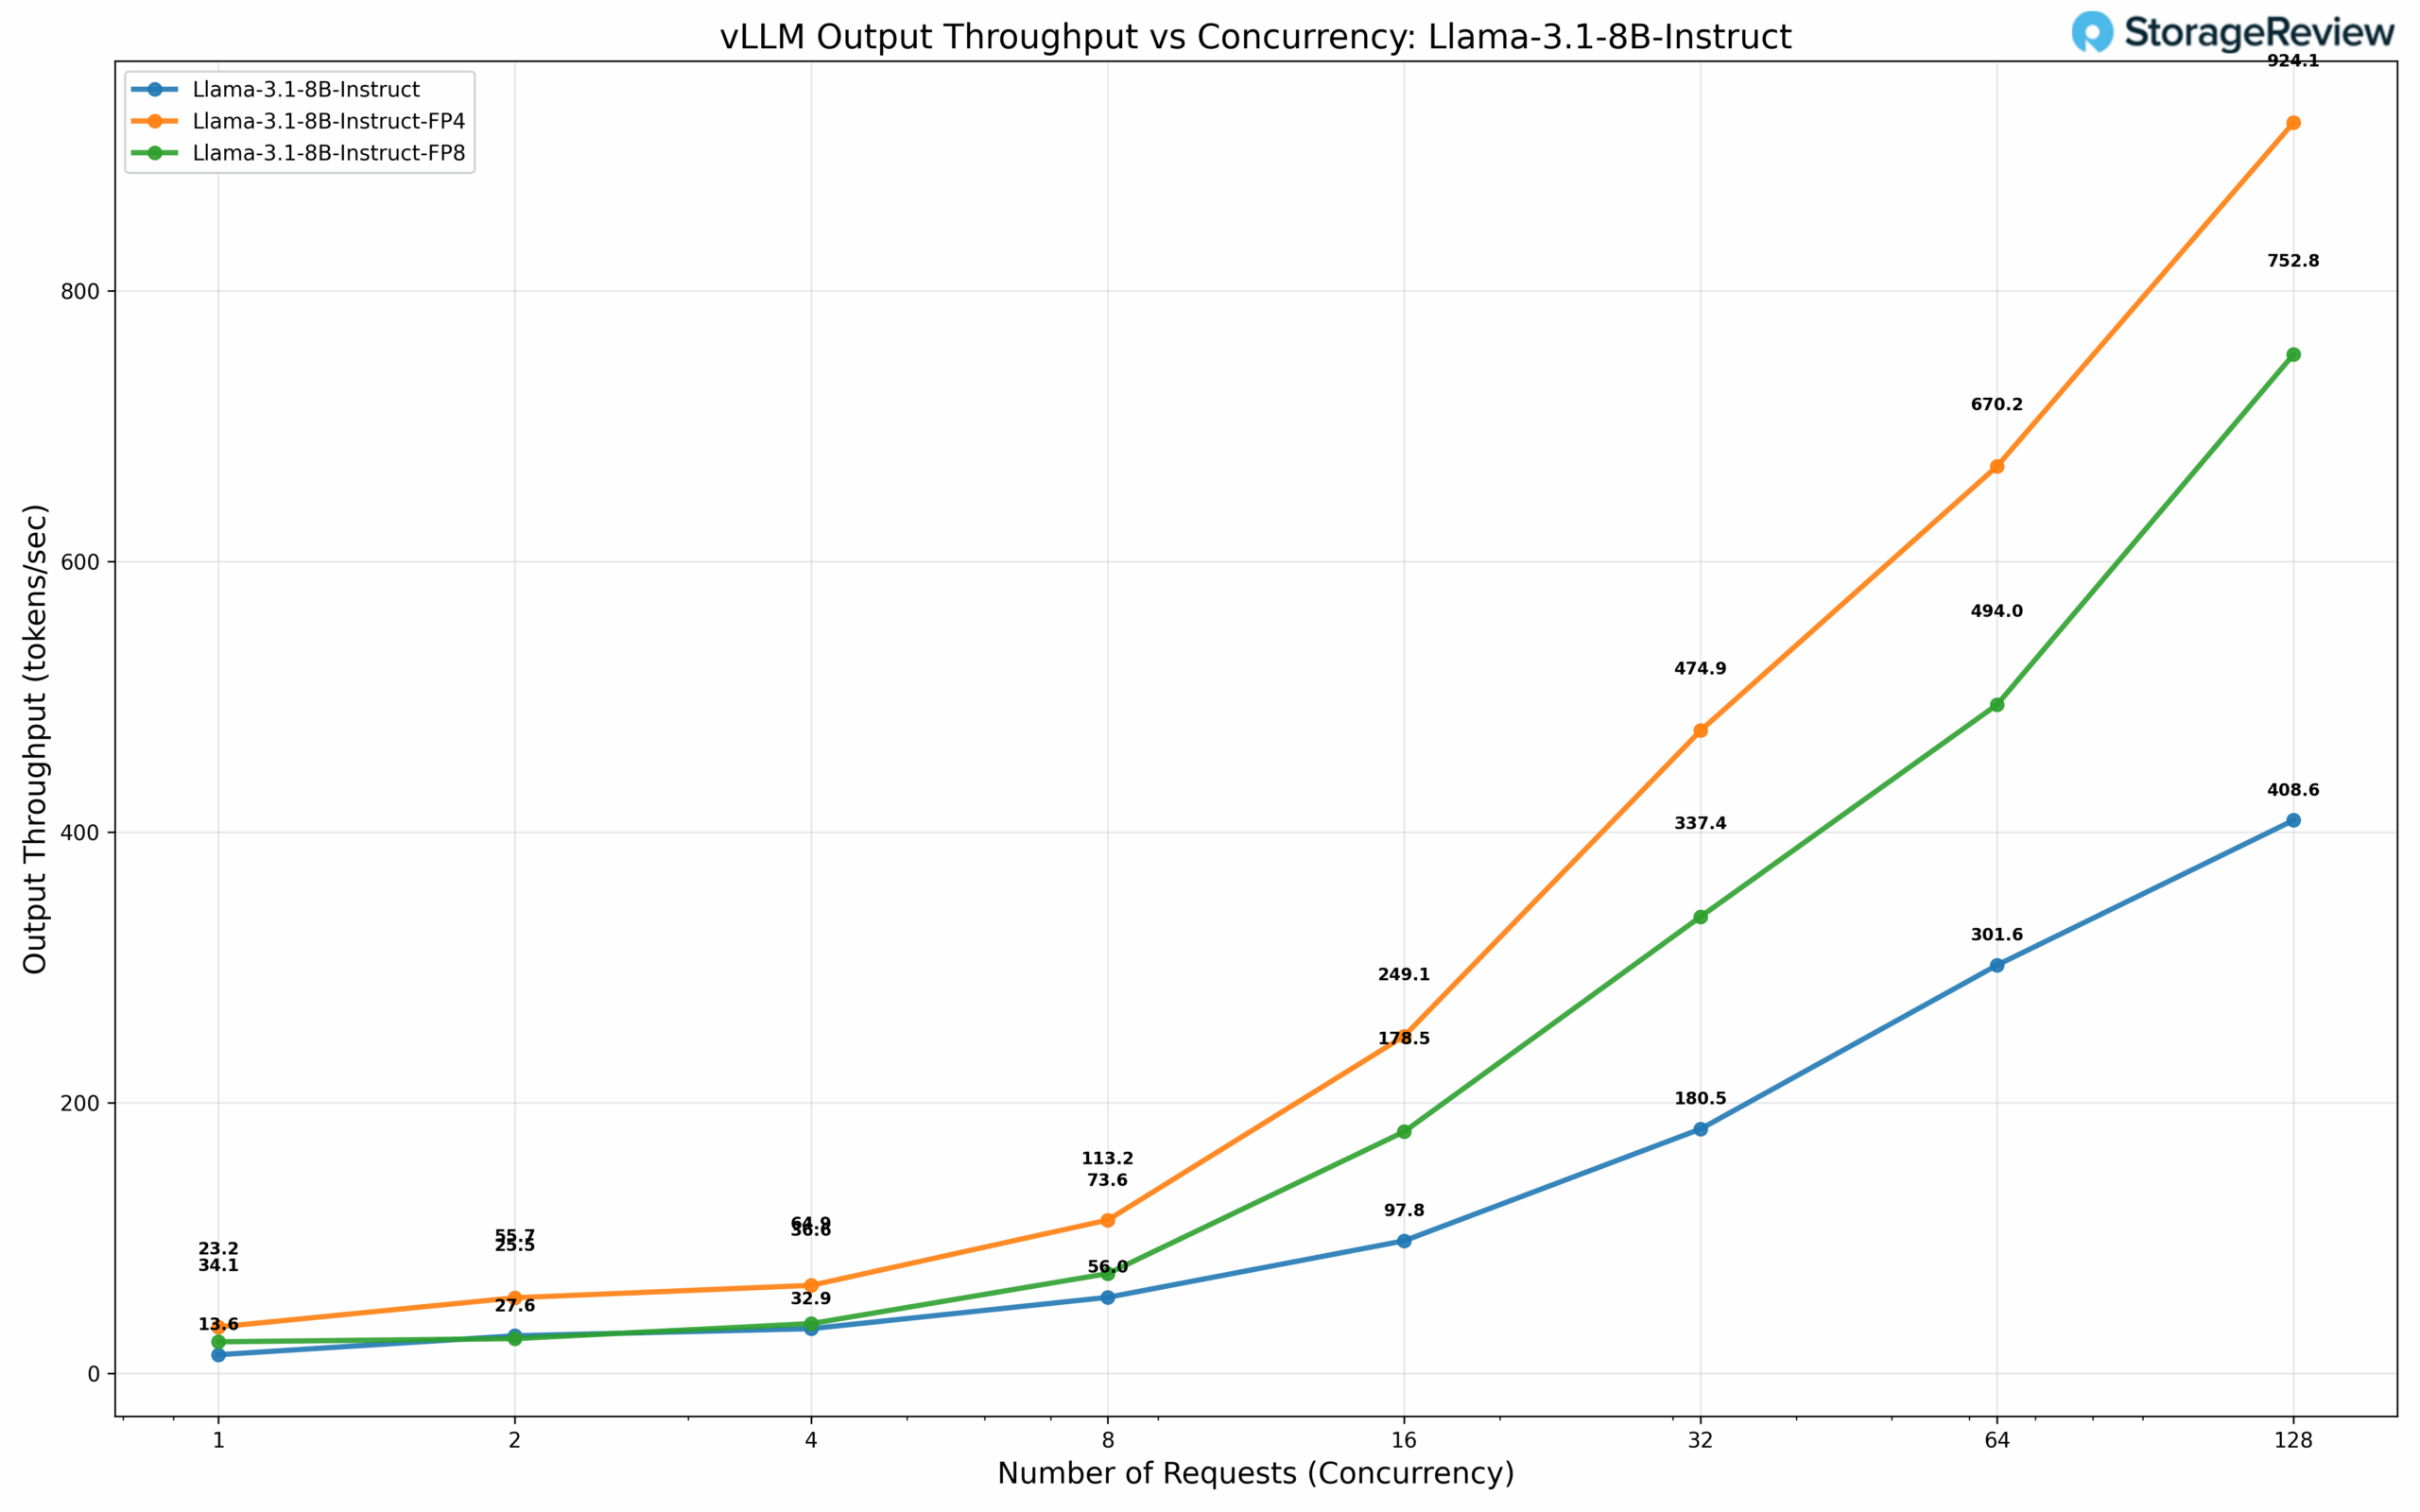
La arquitectura Llama 3.1 8B presenta características de rendimiento notablemente diferentes entre las estrategias de cuantificación. Con precisión BF16, el modelo ofrece 13.6 tok/s con concurrencia 1, que se amplía a 408.6 tok/s con 128 solicitudes concurrentes. La transición a la cuantificación FP8 produce 23.2 tok/s y 752.8 tok/s con niveles de concurrencia 1 y 128, respectivamente, lo que representa una mejora del rendimiento del 84 % a escala. La configuración FP4 optimiza aún más el rendimiento, alcanzando 34.1 tok/s y 924.1 tok/s con los mismos niveles de concurrencia, lo que demuestra que las estrategias de cuantificación agresivas pueden ofrecer mejoras de rendimiento 2.3 veces superiores a la precisión base, manteniendo una calidad de modelo aceptable para diversas cargas de trabajo de producción.
Tipo de datos de microescalamiento
El microescalado representa un enfoque de cuantificación avanzado que aplica factores de escala de grano fino a pequeños bloques de ponderaciones, en lugar de una cuantificación uniforme en grandes grupos de parámetros. El formato NVFP4 de NVIDIA implementa esta técnica mediante una representación en coma flotante bloqueada, donde cada bloque de microescala de 8 a 32 valores comparte un exponente común como factor de escala. Este enfoque granular preserva la precisión numérica a la vez que logra una representación de 4 bits, manteniendo el rango dinámico, crucial para las arquitecturas de transformador. El formato se integra con la arquitectura Tensor Core de NVIDIA, lo que permite un cálculo eficiente de precisión mixta con descompresión sobre la marcha durante las operaciones matriciales.
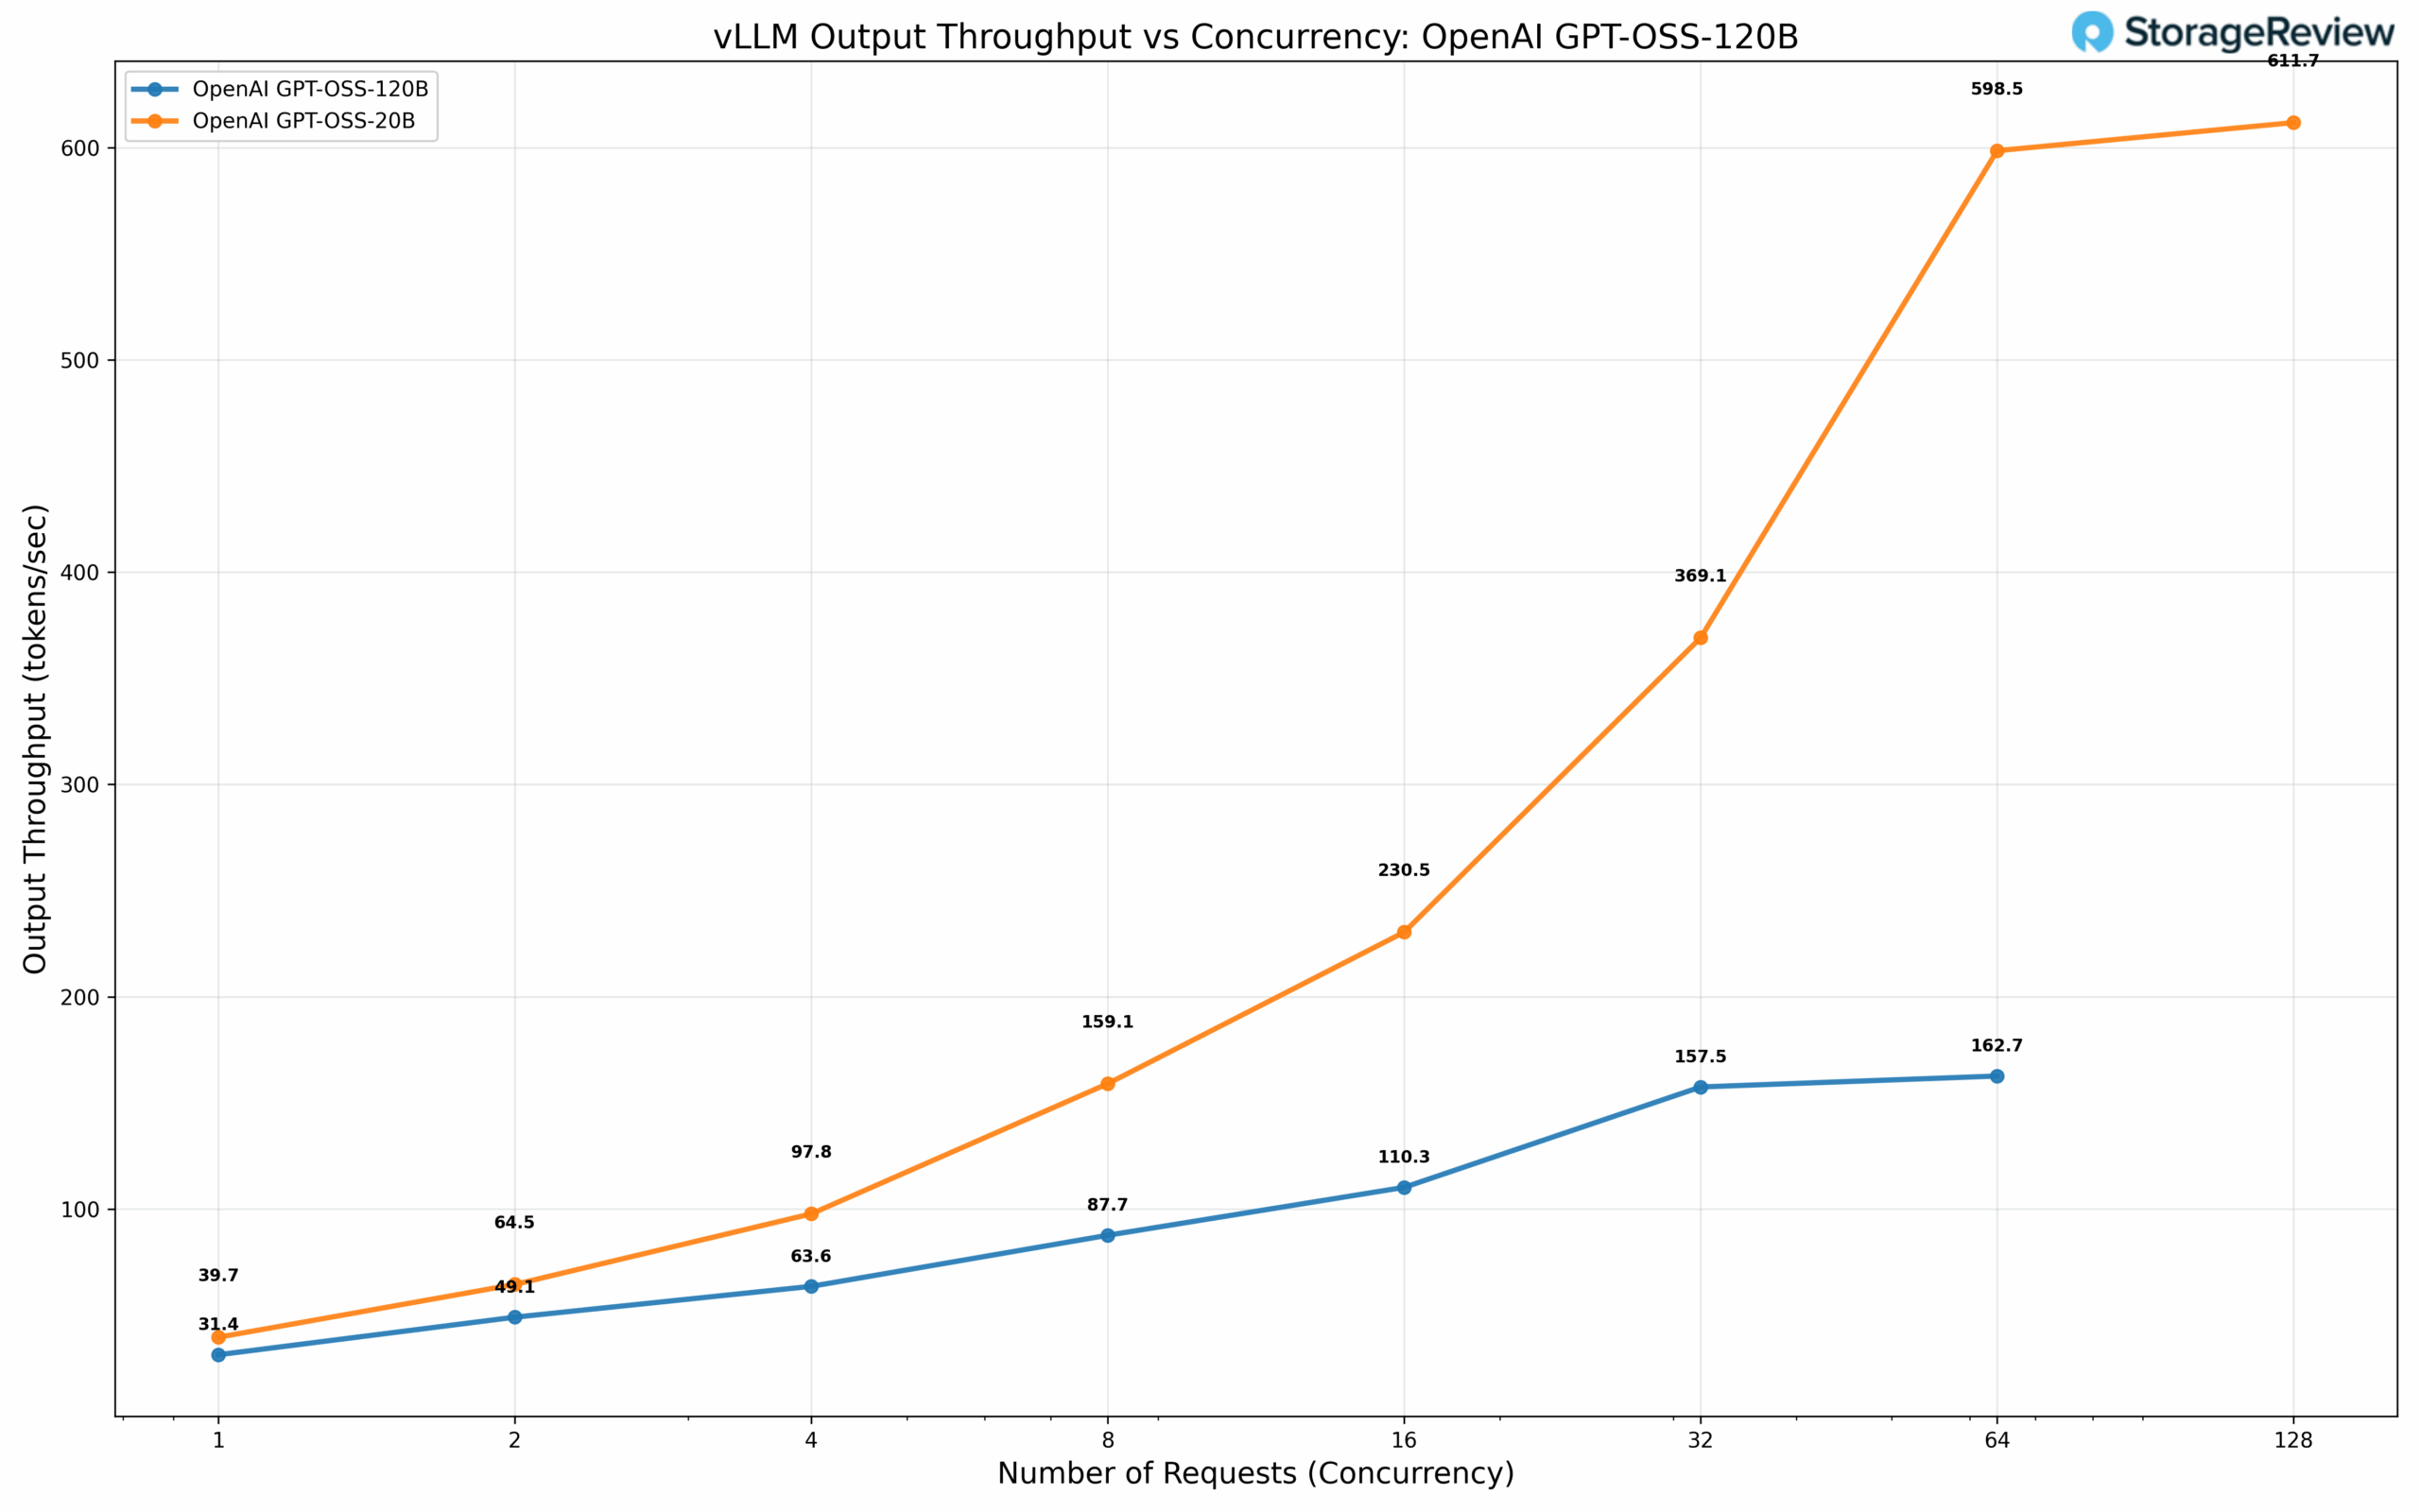
Evaluamos los modelos GPT OSS de OpenAI con escalas de parámetros de 20B y 120B mediante cuantificación NVFP4. El modelo de 20B alcanza 39.7 tok/s con concurrencia 1, escalando a 611.7 tok/s con 128 solicitudes concurrentes. La variante de 120B alcanza 31.4 tok/s con concurrencia 1 y 162.7 tok/s con 64 solicitudes concurrentes.
Nota: El rendimiento de salida es el rendimiento total de todas las solicitudes y no el rendimiento por solicitud.
Debido al tiempo limitado, no pudimos finalizar nuestras pruebas de TensorRT. Esté atento a las próximas publicaciones con Spark, donde exploraremos el rendimiento en más marcos de inferencia.
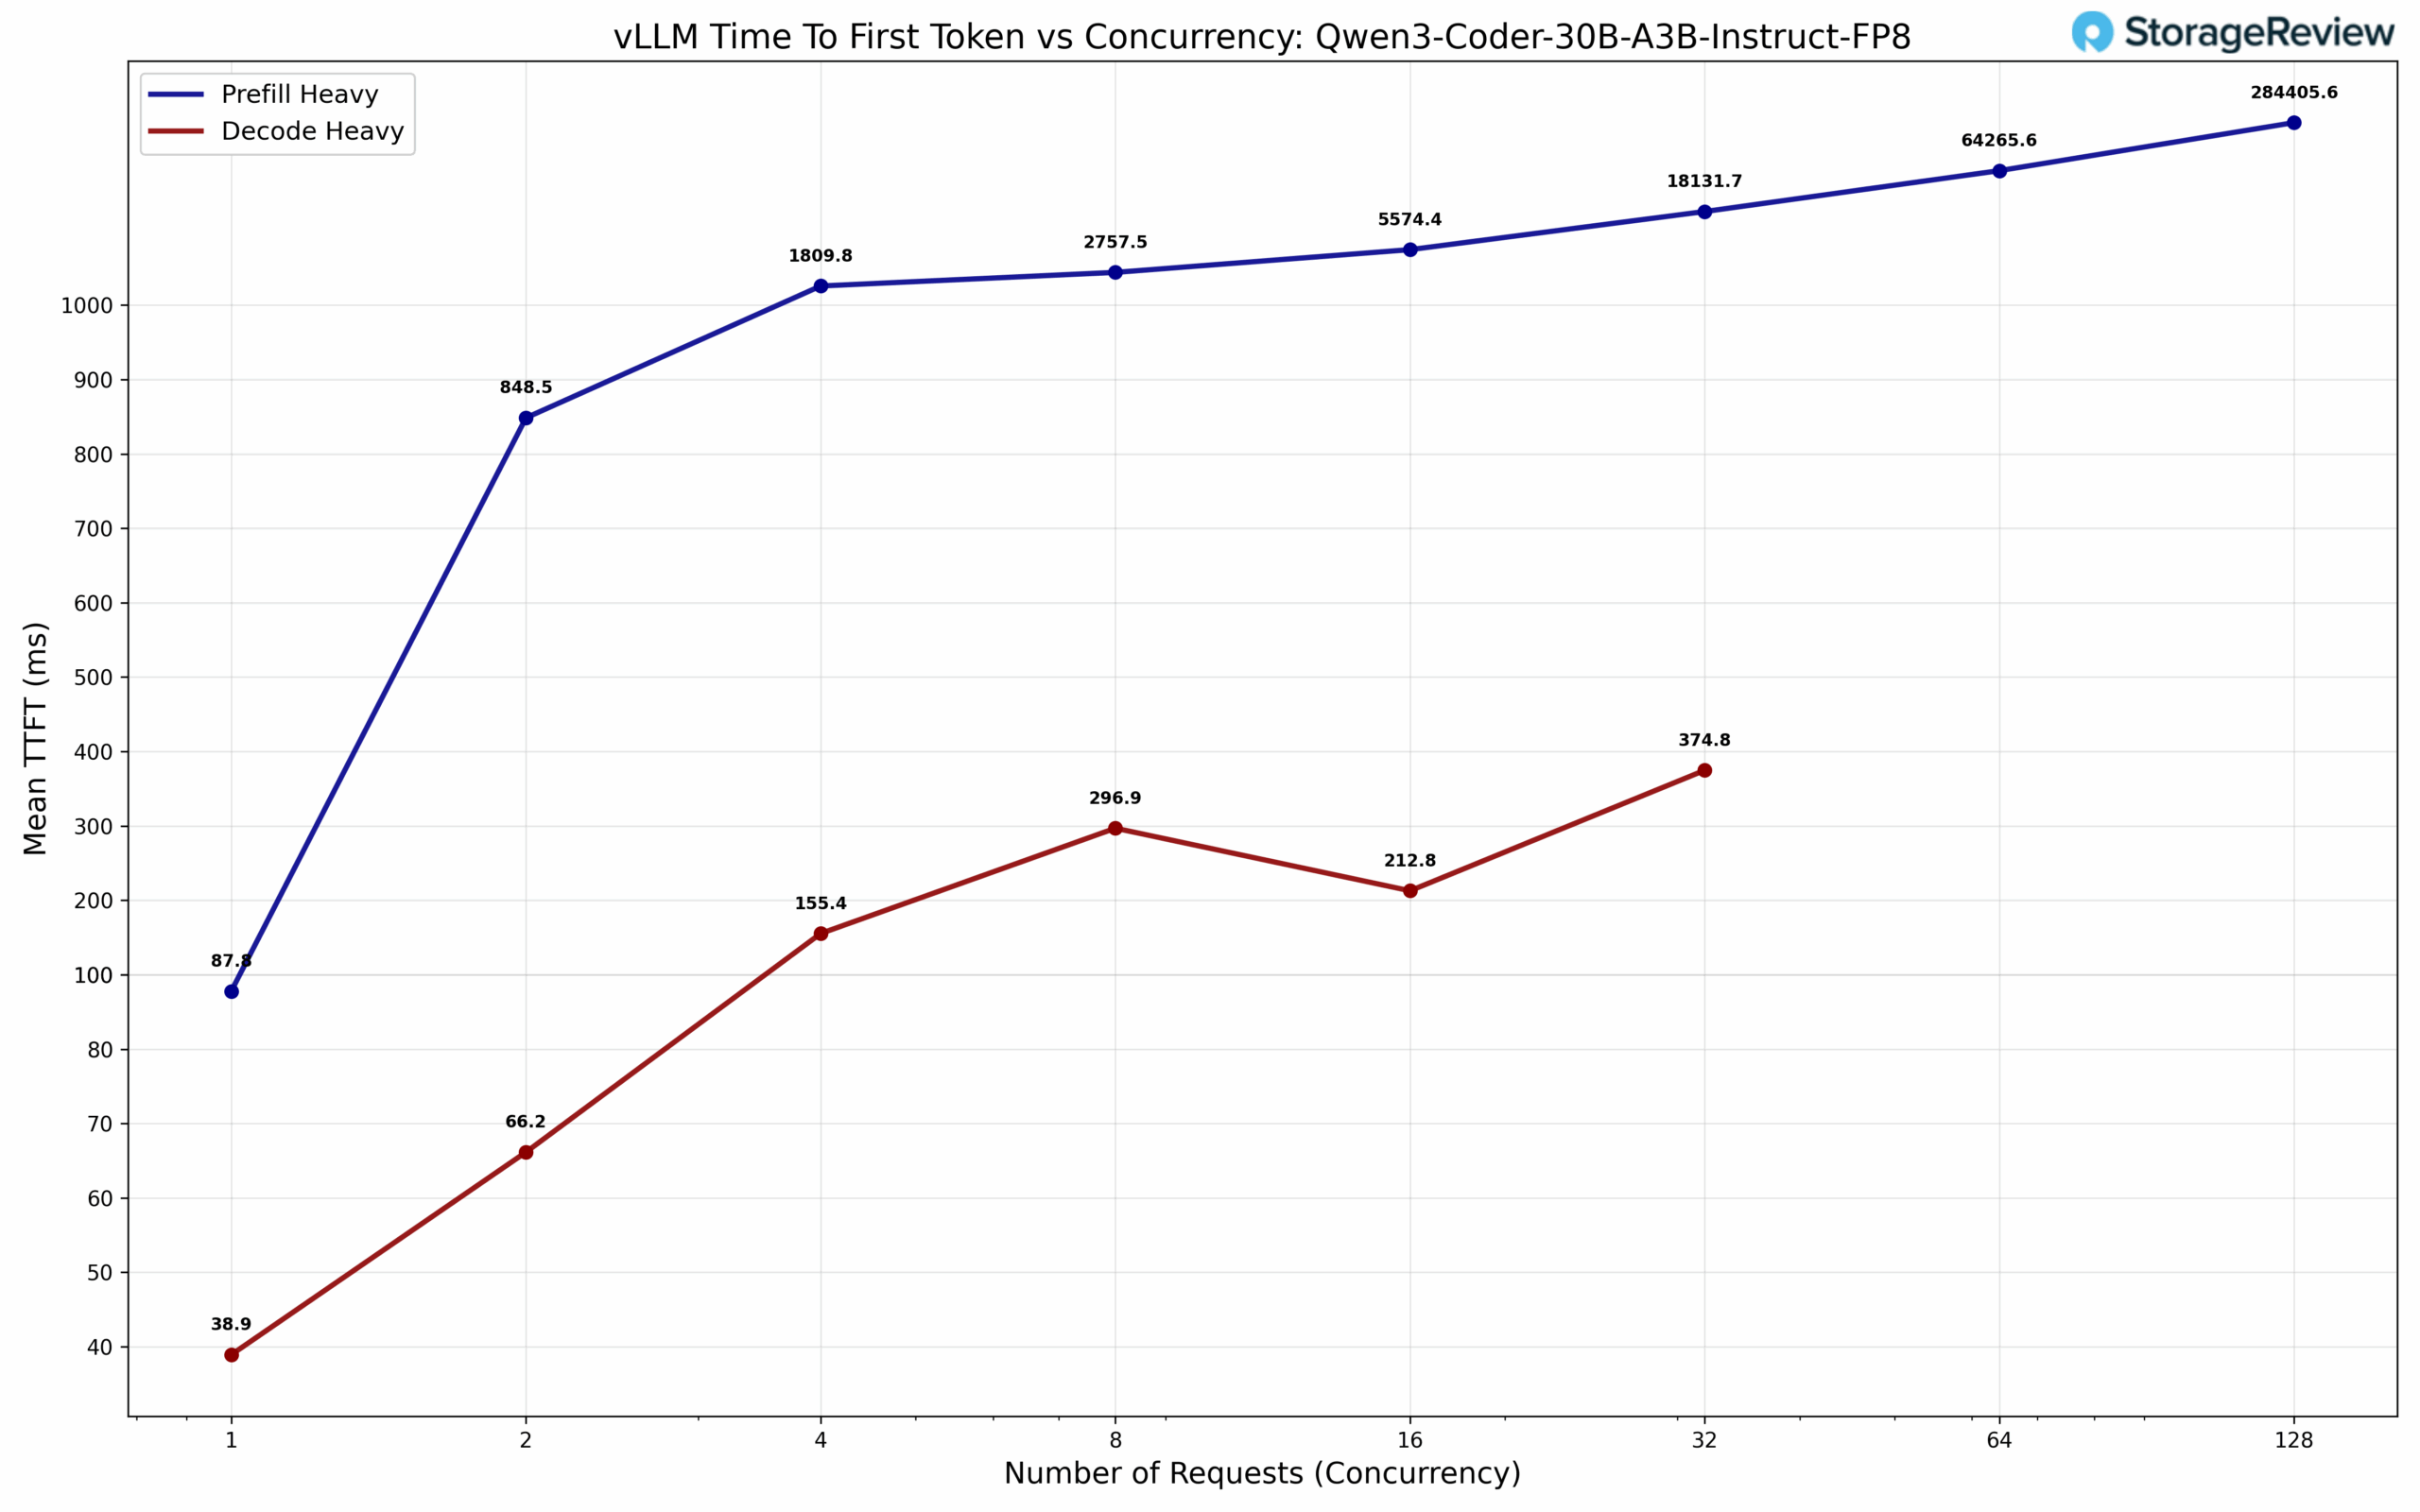
Prellenar y decodificar inferencia pesada
La inferencia LLM se puede descomponer fundamentalmente en dos fases computacionales distintas, cada una con características de rendimiento y patrones de utilización de recursos marcadamente diferentes. La fase de prellenado procesa toda la solicitud de entrada en una sola operación paralela, calculando simultáneamente los mecanismos de atención en todos los tokens de entrada; esta operación, de alto consumo computacional, satura completamente los núcleos tensoriales y las unidades computacionales. Por el contrario, la fase de decodificación genera tokens de salida autorregresivamente, produciendo un token a la vez mediante operaciones secuenciales que presentan una menor intensidad computacional, pero que exigen un ancho de banda de memoria considerable, ya que el modelo debe acceder repetidamente a los pesos y a la creciente caché clave-valor. Esto crea perfiles de cuello de botella fundamentalmente diferentes: las operaciones de prellenado suelen estar limitadas por el cálculo, mientras que las de decodificación consumen un ancho de banda de memoria intensivo, lo que las hace particularmente susceptibles a las limitaciones del subsistema de memoria.
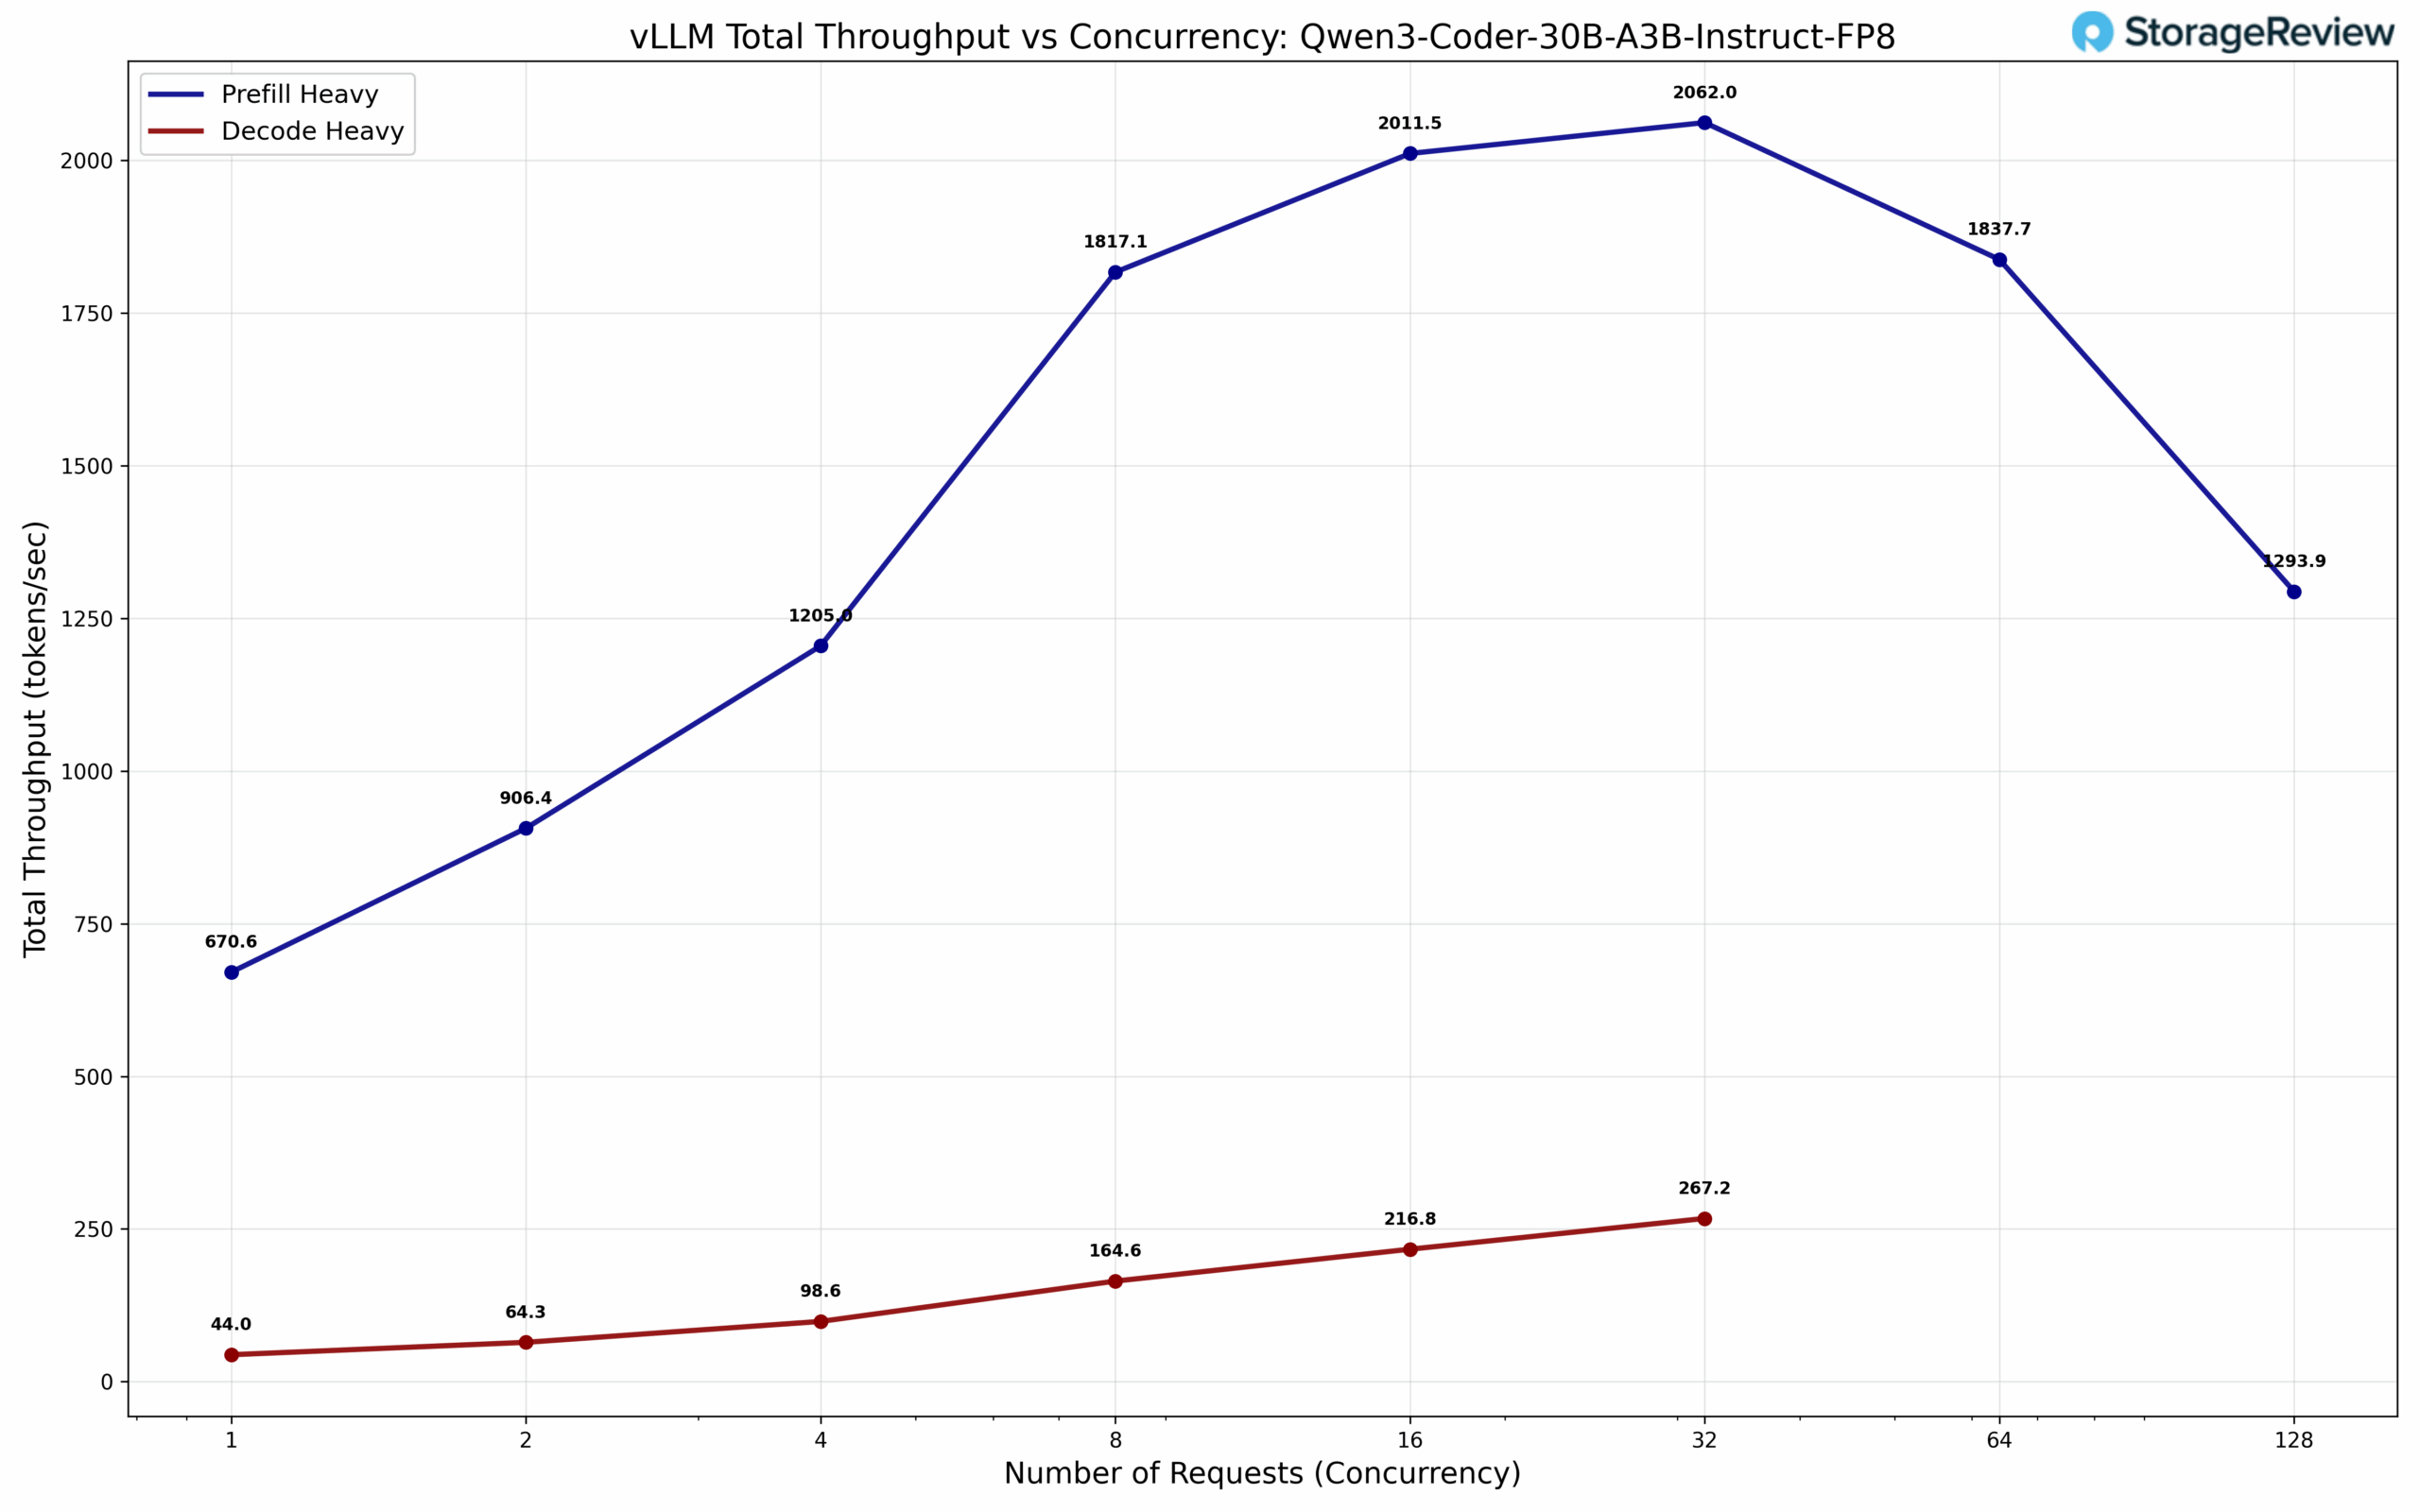
Realizamos pruebas exhaustivas en dos perfiles de carga de trabajo distintos: inferencia con alta decodificación con 512 tokens de entrada y 8,192 tokens de salida, e inferencia con alta precarga con 8,192 tokens de entrada y 512 tokens de salida. La caracterización del rendimiento revela las compensaciones arquitectónicas esperadas: Spark demuestra un rendimiento competitivo en cargas de trabajo con alta precarga, donde los recursos de cómputo siguen siendo el principal cuello de botella, pero presenta un rendimiento reducido en escenarios con alta decodificación. Esta diferencia de rendimiento se alinea con precisión con las limitaciones de ancho de banda de memoria. La naturaleza secuencial de las operaciones de decodificación y los patrones de acceso intensivo a memoria exponen directamente las limitaciones de ancho de banda inherentes a la arquitectura de Spark. Estos resultados proporcionan un contexto crítico para la interpretación de las mediciones de MAMF en la siguiente sección, ya que ambos conjuntos de pruebas de rendimiento identifican consistentemente el ancho de banda de memoria como el factor fundamental que limita el rendimiento en implementaciones de inferencia en el mundo real.
Máximos FLOPS alcanzables de Matmul (MAMF)
MAMF (Maximum Achievable Matmul FLOPS) es una métrica de rendimiento práctica diseñada para medir el pico real de operaciones de coma flotante por segundo que se pueden lograr en aceleradores de aprendizaje automático durante operaciones de multiplicación de matrices, ofreciendo una referencia más precisa que el pico teórico de FLOPS que se suele anunciar en las especificaciones de hardware. Estamos utilizando la herramienta de evaluación comparativa mamf-finder de Stas Beckman.
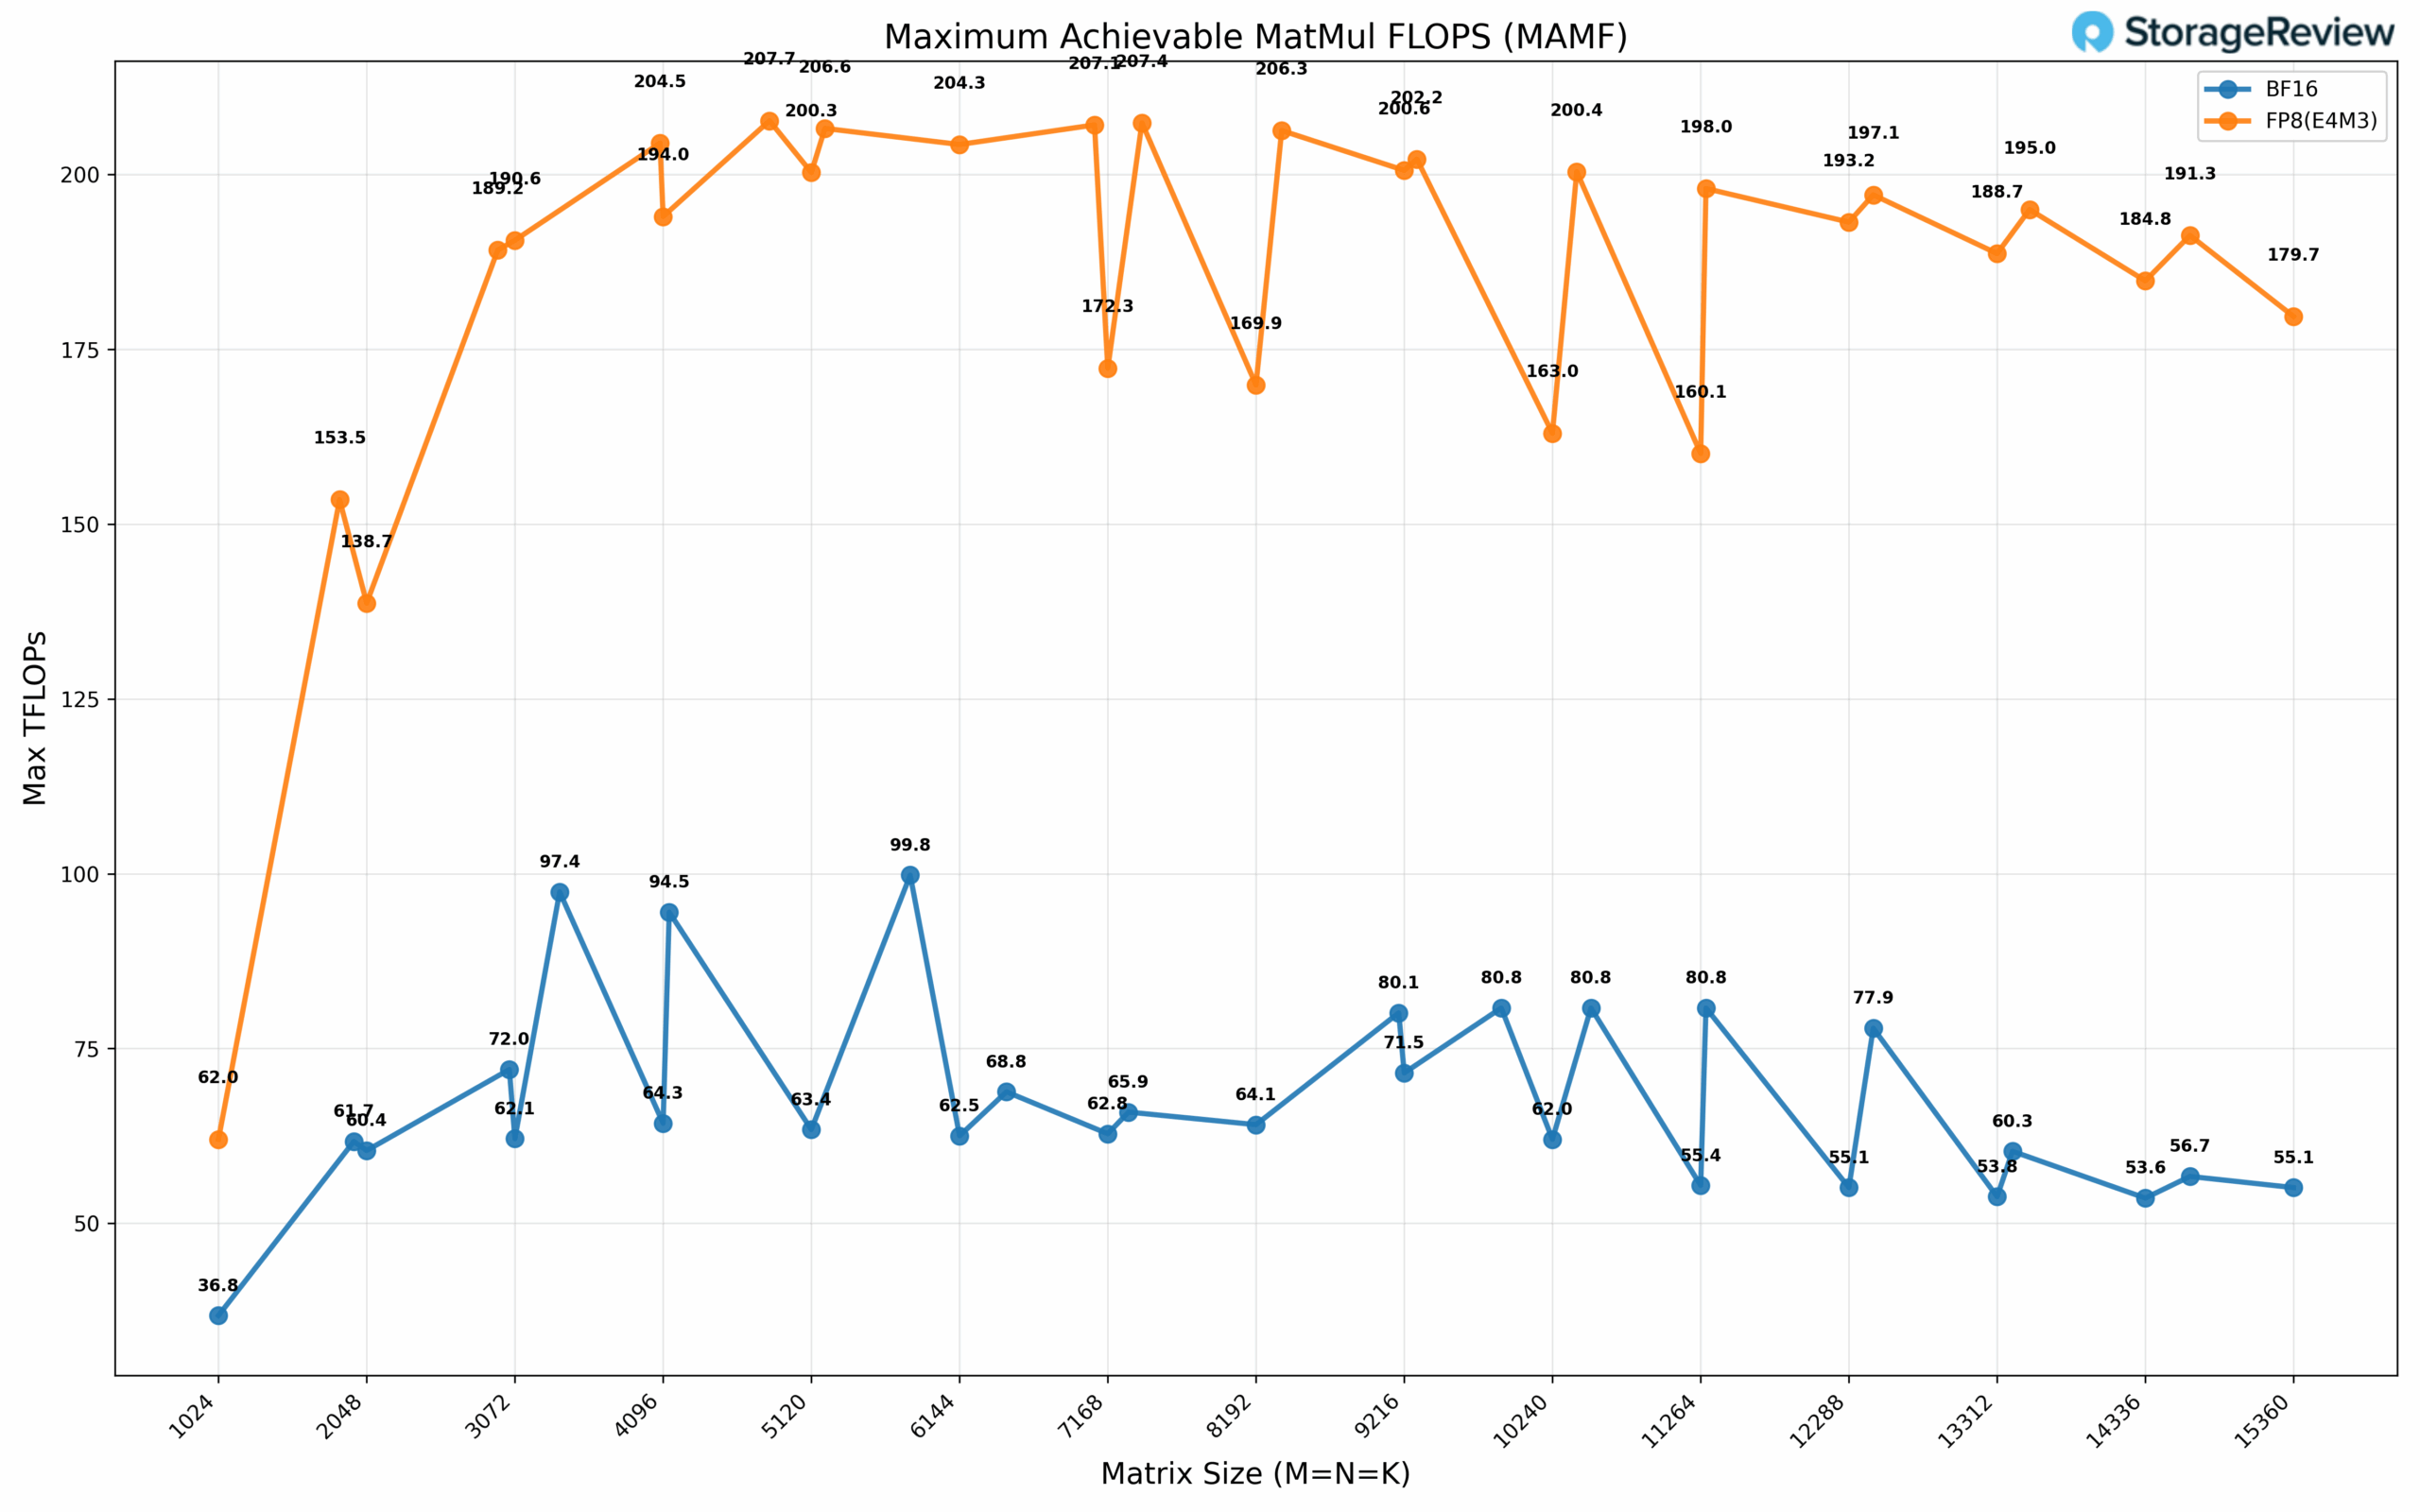
Con una precisión de BF16, observamos un MAMF de 99.8 TFLOPs, mientras que FP8 (E4M3) presenta un MAMF de 207.7 TFLOPs. Debido a limitaciones de tiempo, no pudimos realizar una caracterización completa del MAMF de FP4; sin embargo, extrapolando los patrones de escalamiento basados en la precisión observados, anticipamos una mejora adicional del rendimiento del doble respecto a FP8, lo que resulta en aproximadamente 400 TFLOPs para operaciones FP4 densas. Al considerar la optimización de dispersión estructurada 2:1, esto se traduce en aproximadamente el 80 % de la capacidad de rendimiento teórica de FP4, alcanzando aproximadamente 800 TFLOPs con cargas de trabajo computacionales dispersas. Es importante tener en cuenta que estas mediciones de MAMF pueden estar por debajo de las especificaciones teóricas anunciadas debido a diversas razones que no se detallarán en esta revisión.
Almacenamiento directo de GPU
Una de las pruebas que realizamos en el Spark fue la prueba MagnumIO GPU Direct Storage (GDS). GDS es una función desarrollada por NVIDIA que permite a las GPU ignorar la CPU al acceder a datos almacenados en unidades NVMe u otros dispositivos de almacenamiento de alta velocidad. En lugar de enrutar los datos a través de la CPU y la memoria del sistema, GDS permite la comunicación directa entre la GPU y el dispositivo de almacenamiento, lo que reduce significativamente la latencia y mejora el rendimiento de los datos.
Cómo funciona el almacenamiento directo en GPU
Tradicionalmente, cuando una GPU procesa datos almacenados en una unidad NVMe, los datos primero deben pasar por la CPU y la memoria del sistema antes de llegar a la GPU. Este proceso genera cuellos de botella, ya que la CPU se convierte en un intermediario, lo que agrega latencia y consume valiosos recursos del sistema. El almacenamiento directo en la GPU elimina esta ineficiencia al permitir que la GPU acceda a los datos directamente desde el dispositivo de almacenamiento a través del bus PCIe. Esta ruta directa reduce la sobrecarga asociada con el movimiento de datos, lo que permite transferencias de datos más rápidas y eficientes.
Las cargas de trabajo de IA, especialmente las que implican aprendizaje profundo, requieren un uso intensivo de datos. El entrenamiento de redes neuronales de gran tamaño requiere el procesamiento de terabytes de datos, y cualquier retraso en la transferencia de datos puede provocar que las GPU se subutilicen y que los tiempos de entrenamiento sean más prolongados. El almacenamiento directo en la GPU aborda este desafío al garantizar que los datos se entreguen a la GPU lo más rápido posible, lo que minimiza el tiempo de inactividad y maximiza la eficiencia computacional.
Además, GDS es particularmente beneficioso para cargas de trabajo que implican la transmisión de grandes conjuntos de datos, como el procesamiento de video, el procesamiento de lenguaje natural o la inferencia en tiempo real. Al reducir la dependencia de la CPU, GDS acelera el movimiento de datos y libera recursos de la CPU para otras tareas, lo que mejora aún más el rendimiento general del sistema.
GDSIO – M.2 interno de 4 TB
La NVIDIA DGX Spark ofrece una opción de almacenamiento interesante. Por cuestiones de tamaño dentro de su pequeña carcasa, NVIDIA optó por el SSD M.2 Gen5 2242, menos común. Para quienes no estén familiarizados con este tipo de SSD, se trata de una versión más corta de 42 mm en comparación con la de 80 mm, más común en ordenadores de sobremesa. Hay menos opciones de unidades, siendo 4 TB la capacidad máxima en este tamaño. Sin embargo, el principal problema es el rendimiento. Los SSD pequeños, como los modelos 2242 y 2230, priorizan el tamaño, dejando la velocidad de la unidad en un segundo plano. Son comunes en consolas portátiles, tabletas y algunos portátiles.
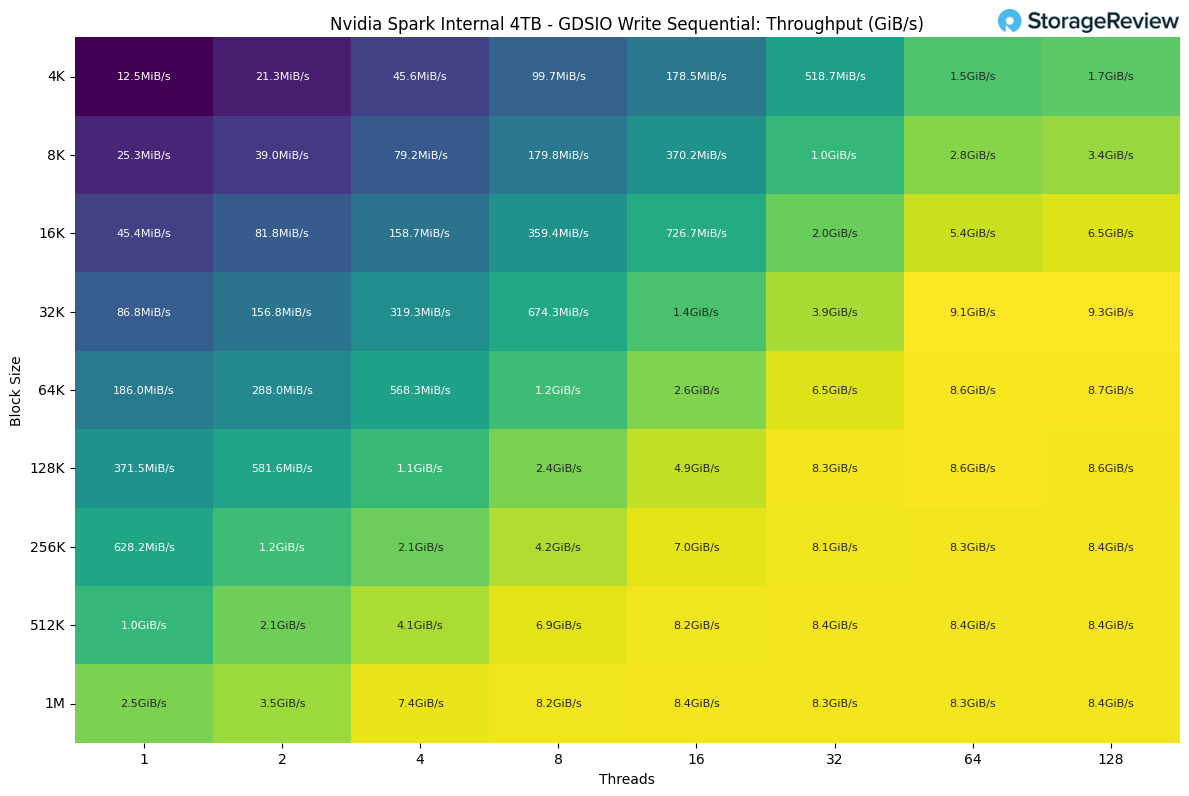
El espacio en la PCB de los SSD 2230 y 2242 es limitado, lo que resulta en menos espacio para controladores, DRAM y paquetes NAND. Observamos algunas de estas desventajas durante nuestras pruebas. Al aplicar nuestra carga de trabajo GDSIO en un espacio de 1 TB o 128 GB, el SSD se bloqueaba y era necesario volver a crear la imagen del Spark. Reducir el espacio de prueba a 64 GB, así como el mayor número de subprocesos, solucionó este problema. Estos problemas no suelen presentarse con los SSD de 80 mm de alto rendimiento más comunes.
Al analizar el rendimiento de lectura secuencial de la unidad interna, vemos que el mayor rendimiento se obtiene con un tamaño de bloque de 1 M con 16 subprocesos, logrando 11.4 GiB/s.
En cuanto al rendimiento de escritura secuencial, la unidad alcanza el máximo rendimiento con bloques de 32 k y 128 subprocesos. Con bloques de mayor tamaño, el rendimiento parece estabilizarse, con un promedio de alrededor de 8.3 GiB/s.
Para los compradores que buscan comprar NVIDIA DGX Spark para trabajos de desarrollo más pesados, especialmente empresas que podrían crear pequeños clústeres a partir de ellos, recomendamos encarecidamente aprovechar la NIC NVIDIA ConnectX-7 de 200 Gb integrada.
GDSIO – NVMe-oF sobre RDMA
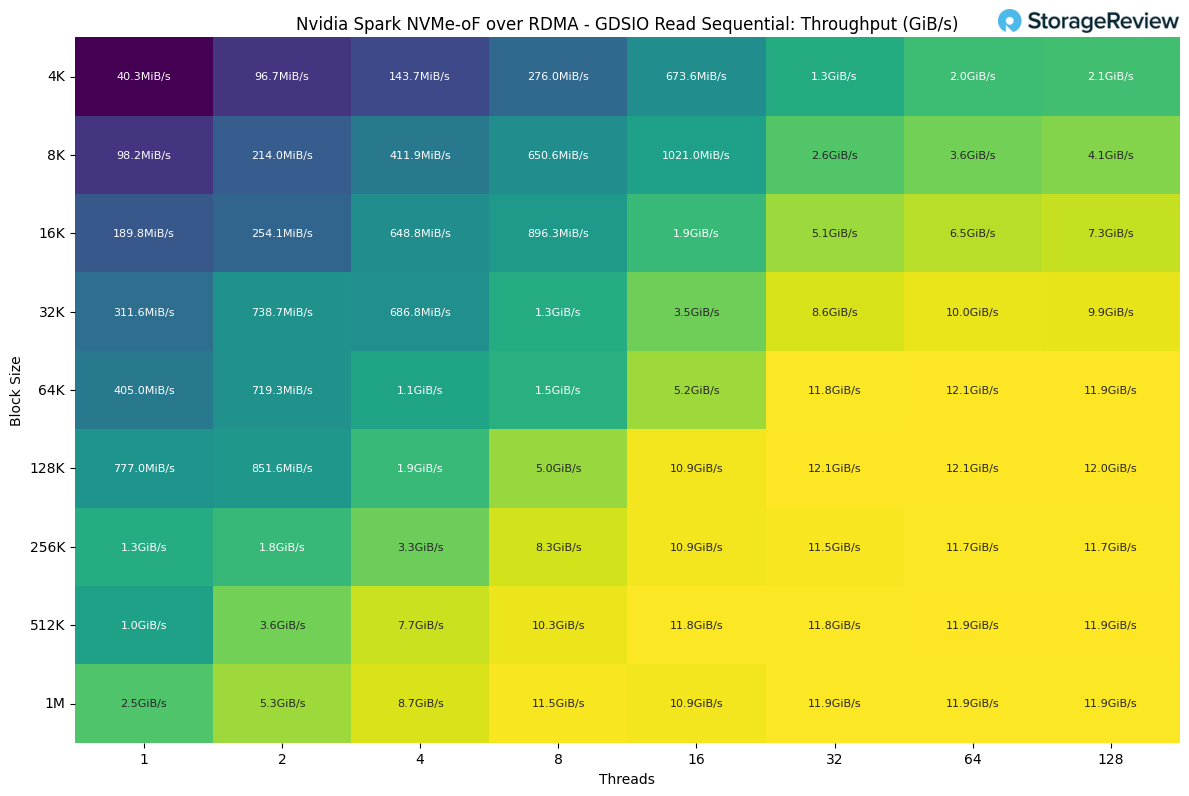
Para las pruebas RDMA de NVMe-oF con NVIDIA DGX Spark, utilizamos el software de PEAK:AIO para crear un destino NVMe-oF en un Dell PowerEdge R770 con seis SSD Micron 9550 de 3.84 TB y conexión RDMA. Como mencionamos anteriormente, la tarjeta de red CX7 del Spark tiene sus peculiaridades y, debido a limitaciones de tiempo, solo pudimos probar el Spark con conectividad de 100 G. Tanto el Spark como PEAK:AIO pueden alcanzar valores significativamente superiores. Realizaremos pruebas adicionales de almacenamiento y red con el Spark en artículos posteriores.
Al analizar el rendimiento de lectura secuencial de la unidad interna, vemos que el mayor rendimiento se produce con un tamaño de bloque de 128k con 32 subprocesos, logrando 12.1 GiB/s.
En cuanto al rendimiento de escritura secuencial, la unidad alcanza el máximo rendimiento con bloques de 128 k y 16 subprocesos. Con bloques de mayor tamaño, el rendimiento parece estabilizarse, con un promedio de alrededor de 11.3 GiB/s.
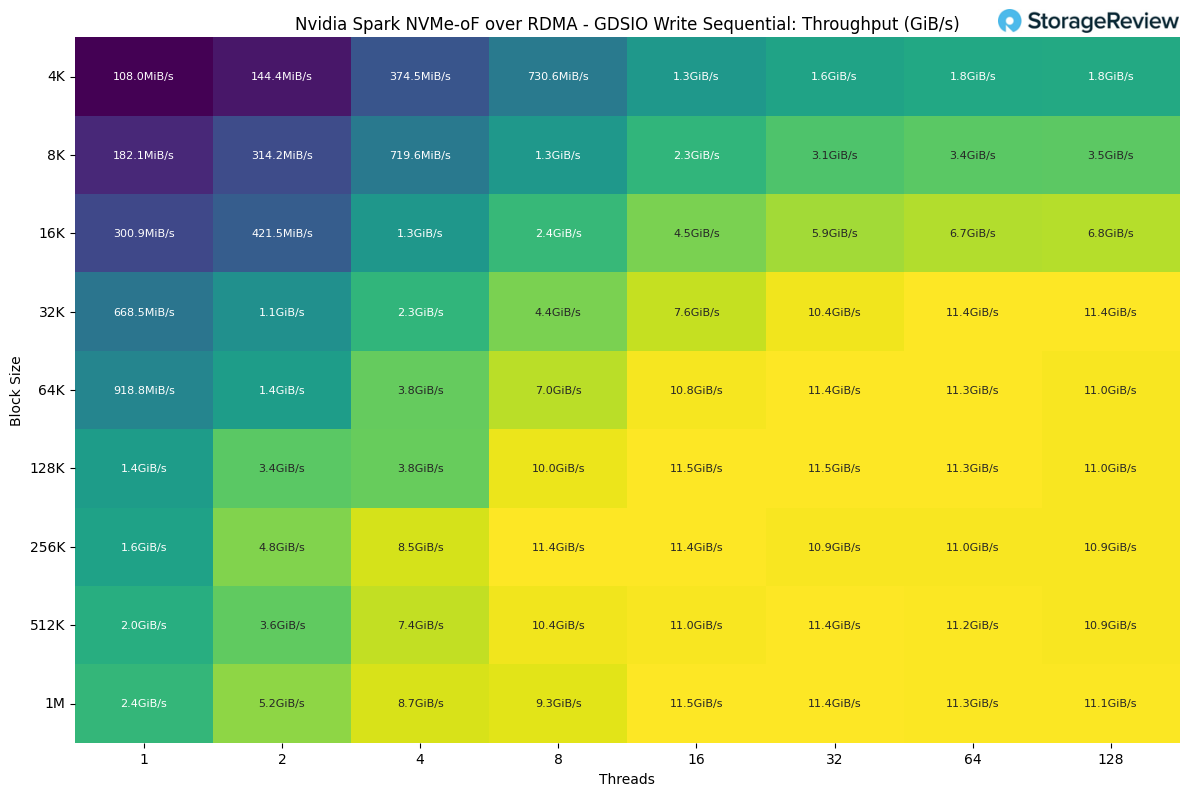
Estos resultados presentan muchos matices; solo vemos la mitad del máximo teórico debido a las razones de tiempo y red mencionadas anteriormente. Además, el rendimiento máximo con un tamaño de bloque de 128k se ve influenciado por múltiples factores, como las unidades empresariales que utilizamos o cómo PEAK:AIO gestiona esta E/S. Los resultados pueden variar y tenemos la intención de realizar más pruebas con Spark en el futuro.
Ecosistema de software del primer día
NVIDIA y otros proveedores han invertido sustancialmente en la preparación del software, lo que supone un cambio radical respecto a los lanzamientos de hardware habituales, donde los primeros usuarios se enfrentan a documentación incompleta y herramientas faltantes. Spark se lanza con manuales completos que abarcan flujos de trabajo comunes: ComfyUI para modelos de difusión, TRT-LLM para inferencia optimizada, Ollama con Open WebUI para la gestión local de modelos, Unsloth para el ajuste fino y arquitecturas multiagente con LangGraph.
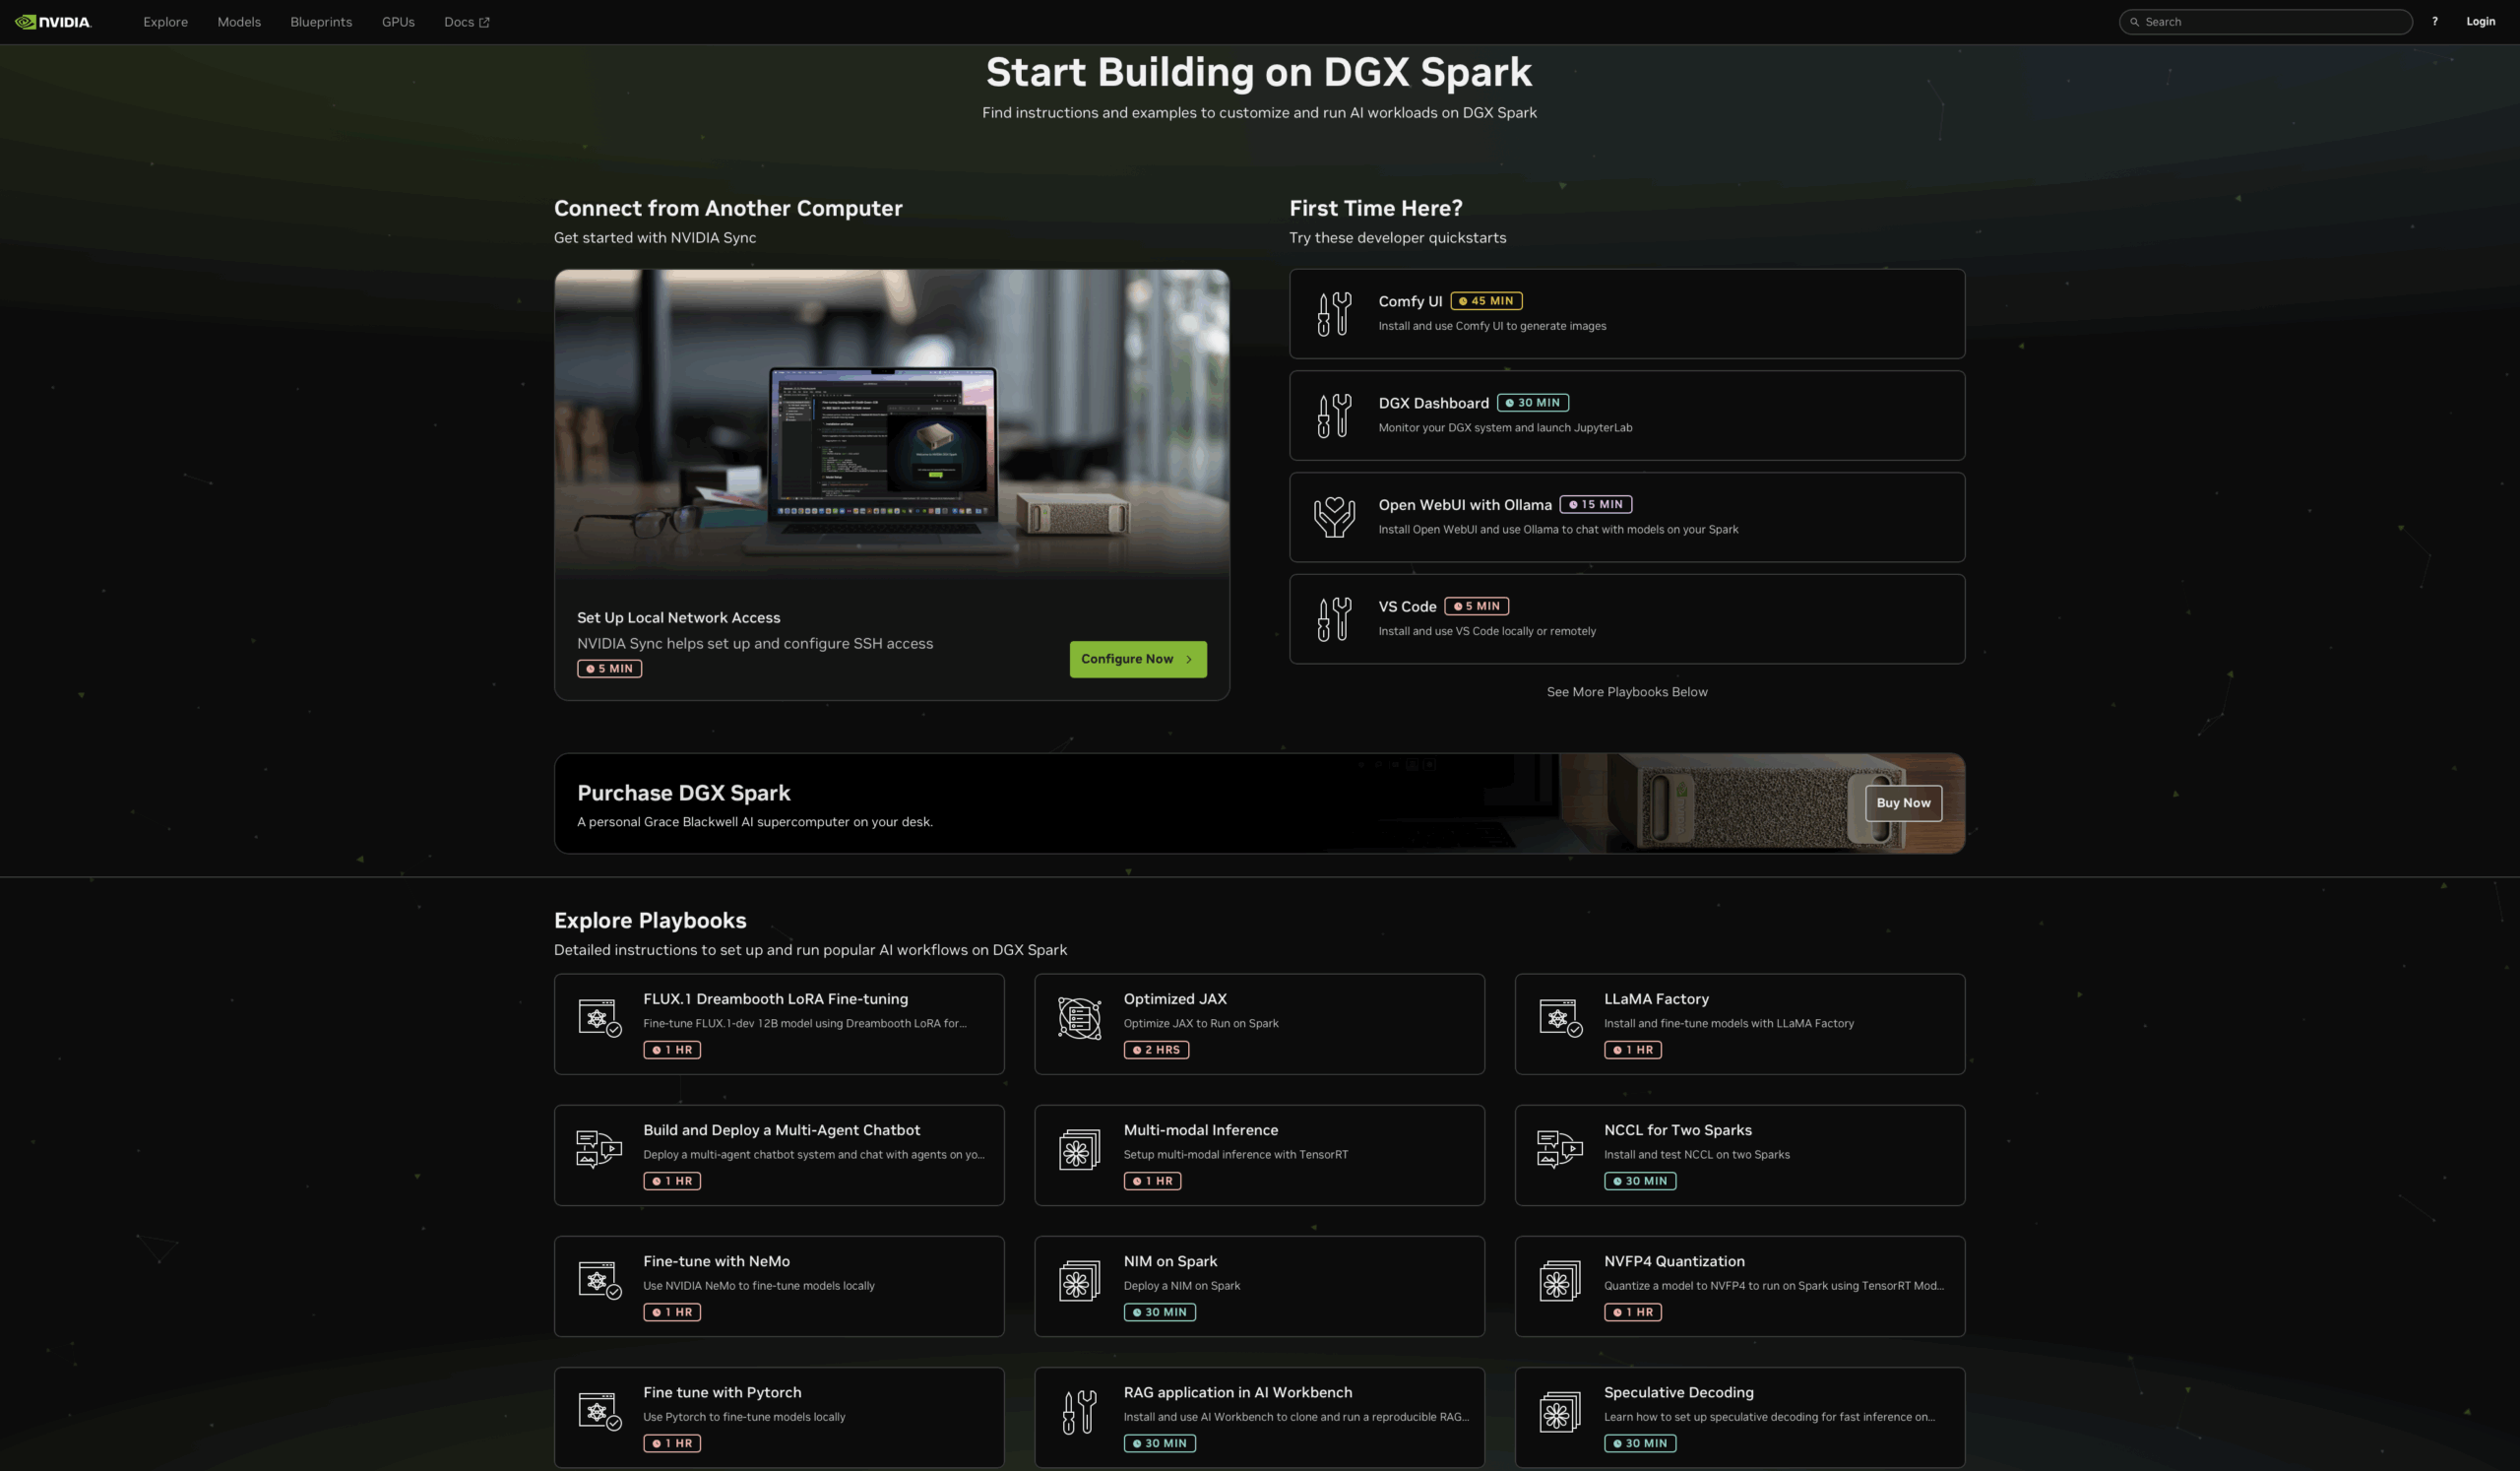
Esta madurez del software transforma la experiencia de evaluación. En lugar de invertir días configurando entornos, los desarrolladores pueden evaluar de inmediato si Spark cumple con sus requisitos ejecutando cargas de trabajo representativas. Los manuales de procedimientos proporcionan no solo instrucciones, sino también entornos en contenedores, conjuntos de datos de ejemplo y métricas de rendimiento esperadas.
Disponibilidad y sistemas OEM
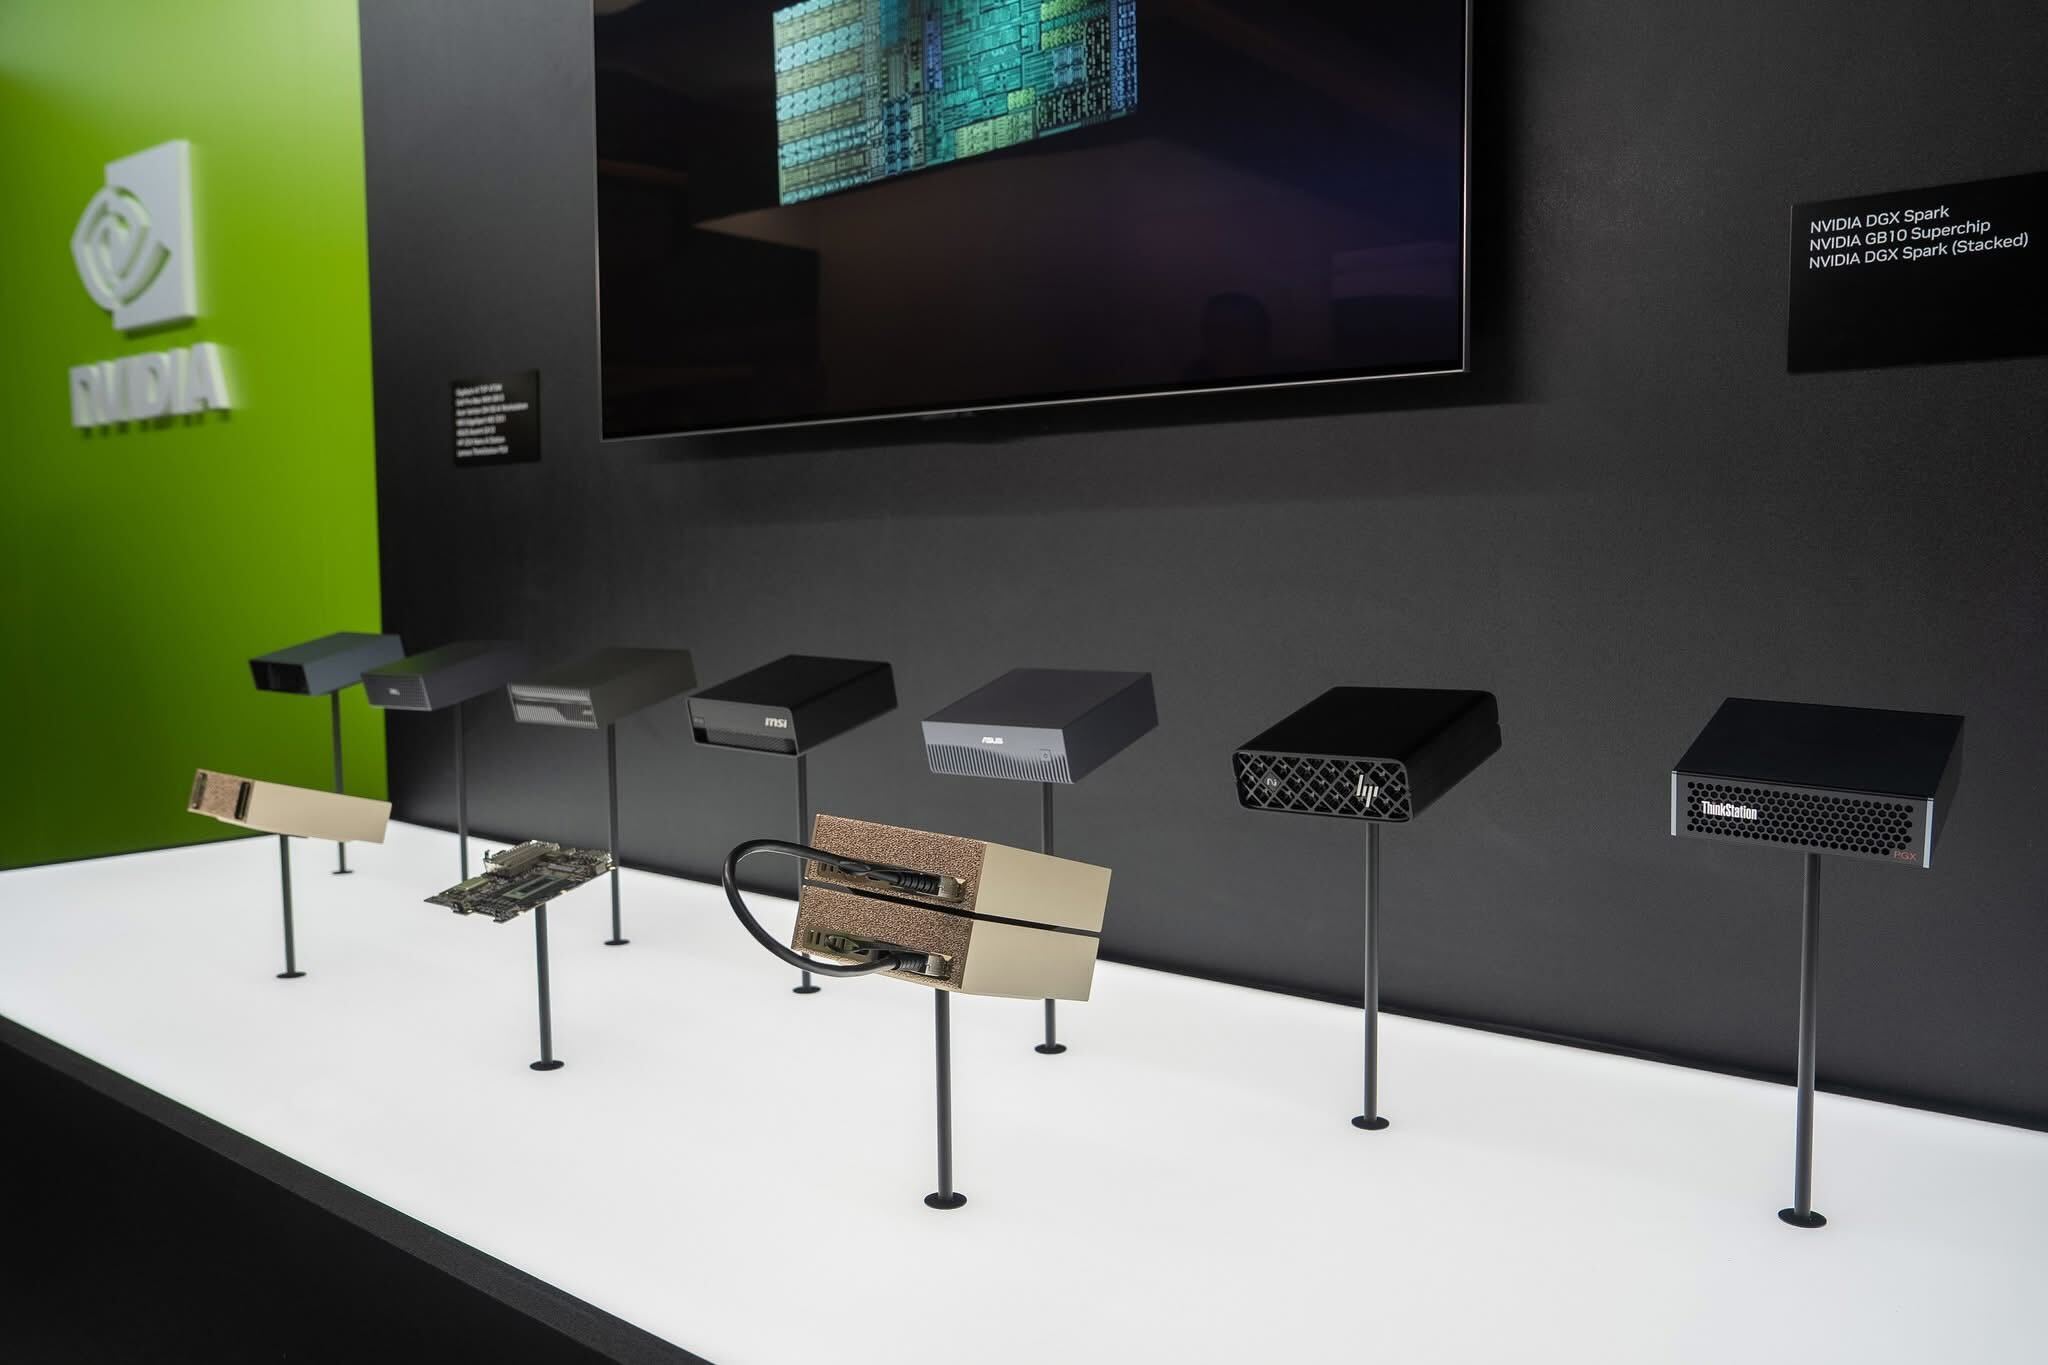
La Founders Edition de NVIDIA está disponible por $3,999 para la configuración de 4 TB, y su disponibilidad general comienza el 15 de octubre. Además de la unidad propia de NVIDIA, llegarán varias computadoras de escritorio GB10 de los principales fabricantes de equipos originales (OEM). El hardware principal será bastante similar en todos los OEM, pero podría haber cierto margen de maniobra para diferenciarse, aunque la mayor parte de la variación de precio probablemente provenga de la selección de almacenamiento. Ya hemos visto muchos anuncios, incluyendo la Dell Pro Max con GB10, la Lenovo ThinkStation PGX, la Acer Veriton GN100 y la ASUS Ascent GX10.
Fuente: Nvidia
Conclusión
NVIDIA DGX Spark representa un punto de inflexión fundamental en el paradigma de accesibilidad de la infraestructura de computación de IA avanzada. Al consolidar las capacidades del superchip GB10 Grace Blackwell: 128 GB de memoria unificada, rendimiento FP4 disperso de 1 petaFLOP, núcleos RT de cuarta generación y redes ConnectX-7 en un dispositivo de 240 W y 1.13 litros con un precio de $3,999, NVIDIA ha derribado eficazmente las barreras que históricamente separaban las capacidades de IA de clase centro de datos de los investigadores individuales y los pequeños equipos de desarrollo.
El enfoque de dispositivos validados aborda un problema recurrente en la implementación de infraestructura de IA: la sobrecarga operativa que supone mantener configuraciones personalizadas. Las organizaciones que implementan unidades Spark se benefician de las exhaustivas pruebas y validación de NVIDIA de toda la pila, incluyendo DGX OS, el kit de herramientas CUDA, los contenedores de framework y el firmware del hardware, eliminando así la carga de configuración que afecta a las compilaciones de estaciones de trabajo personalizadas. La gestión integrada de actualizaciones, la monitorización del sistema y el aprovisionamiento de JupyterLab del panel DGX reducen aún más la carga operativa, mientras que la distribución automática de claves SSH y la gestión de túneles de NVIDIA Sync hacen que el acceso remoto sea realmente fluido. Para las organizaciones en expansión, esto se traduce en una incorporación considerablemente más rápida: los nuevos investigadores reciben hardware estandarizado, se conectan a la infraestructura existente mediante la configuración validada de clústeres de dos nodos y comienzan a trabajar productivamente en cuestión de horas, en lugar de días dedicados a la resolución de conflictos de controladores o la configuración de la estructura de red.
DGX Spark ya ofrece una auténtica potencia de IA en un dispositivo compacto y silencioso, y nuestros primeros resultados demuestran su importancia para los equipos que buscan una gran capacidad sin la sobrecarga del centro de datos. Esto es solo el comienzo. Planeamos ampliar nuestras pruebas con la estructura de 200G, los objetivos NVMe-oF y la agrupación en clústeres multinodo para explorar la eficiencia de escalado, las mayores huellas de modelos y las arquitecturas de almacenamiento compartido. A medida que el software y el ecosistema de socios maduren, prevemos que las implementaciones de Spark evolucionen de potentes configuraciones de un solo nodo a miniclústeres de alto rendimiento y estrechamente integrados que mejoren aún más esta plataforma.
Clasificación: El NVIDIA DGX Spark ocupa el primer puesto como Mejor sistema de IA de escritorio en general en nuestra clasificación de Mejores ordenadores de sobremesa para IA local.
Clasificación: Las directrices de dimensionamiento para este tipo de sistema se encuentran en nuestra guía de RAM, GPU y almacenamiento para IA agente.


 Amazon