

En los últimos años, ejecutar modelos de lenguaje complejos de forma local se ha vuelto mucho más sencillo, pero aún existe una brecha entre descargar un modelo y disponer de un entorno de escritorio útil para él. Jan se presenta como una alternativa a ChatGPT, ofreciendo una aplicación de escritorio de código abierto con una interfaz de chat familiar que mantiene la mayor parte de la configuración dentro de la propia aplicación. Puede ejecutar modelos descargados localmente mediante llama.cpp y, al mismo tiempo, conectarse a servicios de IA alojados, lo que permite utilizar modelos locales y en la nube desde la misma interfaz.
Esta guía práctica es también la primera vinculada a nuestra clasificación de las mejores herramientas LLM locales , donde vamos añadiendo resultados de rendimiento repetibles de nuestro propio hardware de prueba a medida que avanzamos con las plataformas de la lista.
Además del chat local básico, Jan incluye un centro de modelos integrado, búsqueda web y obtención de páginas, entrada de imágenes, integraciones con MCP y una API local compatible con OpenAI.
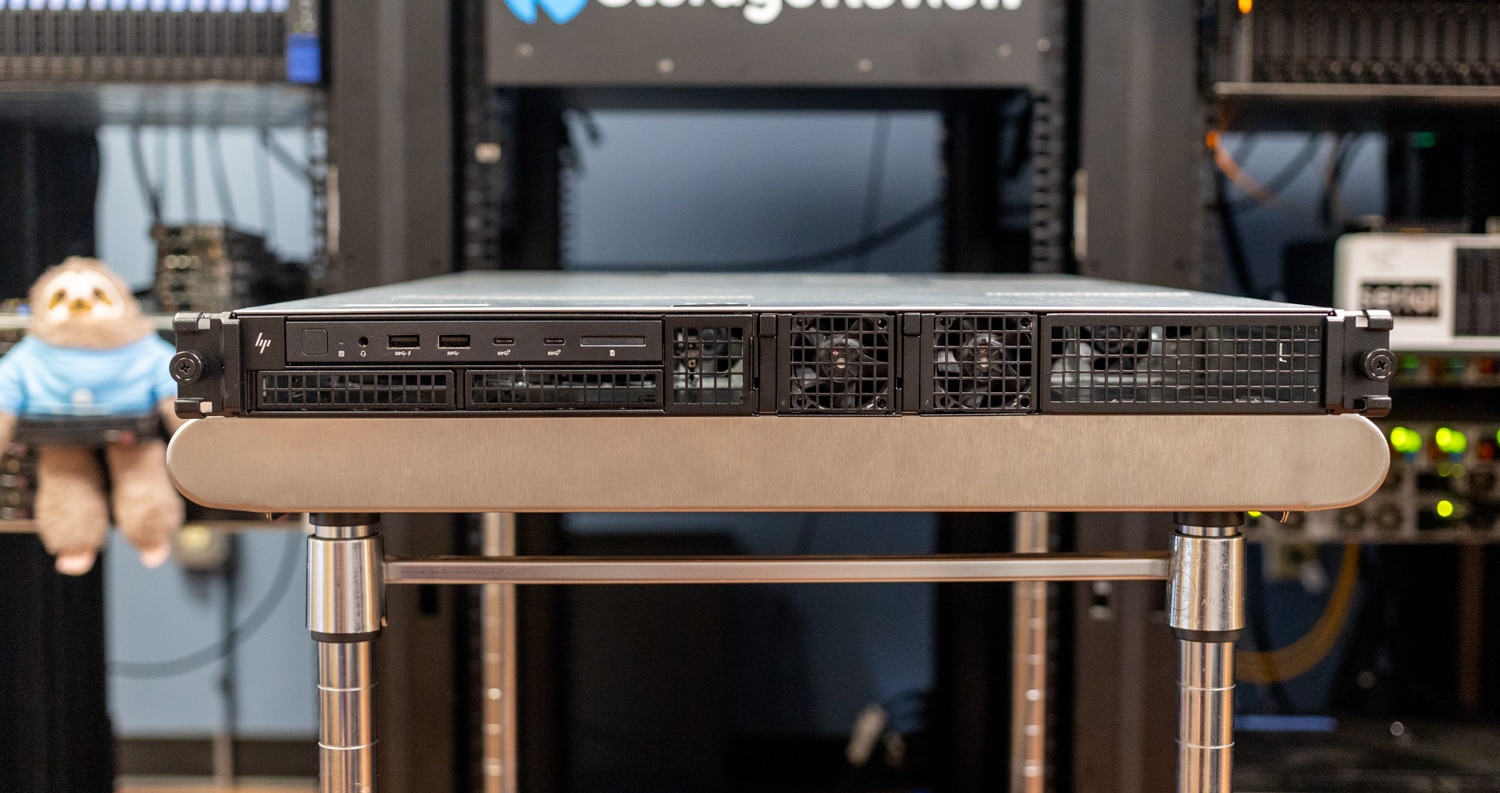
Para este análisis práctico, instalamos Jan desde cero en una estación de trabajo HP Z4 Rack G5 con Windows 11 Pro para estaciones de trabajo, equipada con un procesador Intel Xeon w5-2465X, 128 GB de RAM y una GPU NVIDIA RTX 5000 Ada Generation con 32 GB de VRAM, para ver cómo funciona el proceso de configuración, cómo Jan gestiona los modelos locales, si la aceleración de la GPU funciona automáticamente y cómo se comportan sus funciones principales una vez que todo está en funcionamiento.
Jan sufrió cambios entre nuestra primera revisión y la publicación, con las versiones v0.8.5 y v0.8.6 disponibles poco antes de que esta revisión se publicara. Las versiones más recientes corrigen varios aspectos de la versión anterior, como la integración directa de llama.cpp en Jan, la configuración de la descarga de GPU, el ajuste de los valores predeterminados de la secuencia paralela y la adición de almacenamiento en caché de las indicaciones de conversación. Dado que estos cambios afectan a la inferencia local, actualizamos a la versión v0.8.6 y volvimos a ejecutar todas nuestras pruebas de rendimiento antes de la publicación.
Sistema de prueba
| Componente | Configuration |
|---|---|
| Sistema operativo | Windows 11 Pro para estaciones de trabajo |
| CPU | Intel Xeon w5-2465X, 16 núcleos |
| Salud Cerebral | 128GB |
| GPU | NVIDIA RTX 5000 Generación Ada |
| VRAM | 32GB |
| NVIDIA controlador | 597.06 |
| Compatibilidad con CUDA | 13.2 (nvidia-smi) |
| Ene | v0.8.6 |
| llama.cpp | 0.5.0, compilación b11146 |
Jan detectó correctamente el hardware del sistema a través de su página de configuración de hardware, incluyendo la CPU, la memoria del sistema y la RTX 5000 Ada. En este sistema, que ya tenía instalados los controladores de NVIDIA, Jan habilitó la aceleración de GPU sin necesidad de ninguna configuración adicional de CUDA dentro de la aplicación antes de cargar un modelo.
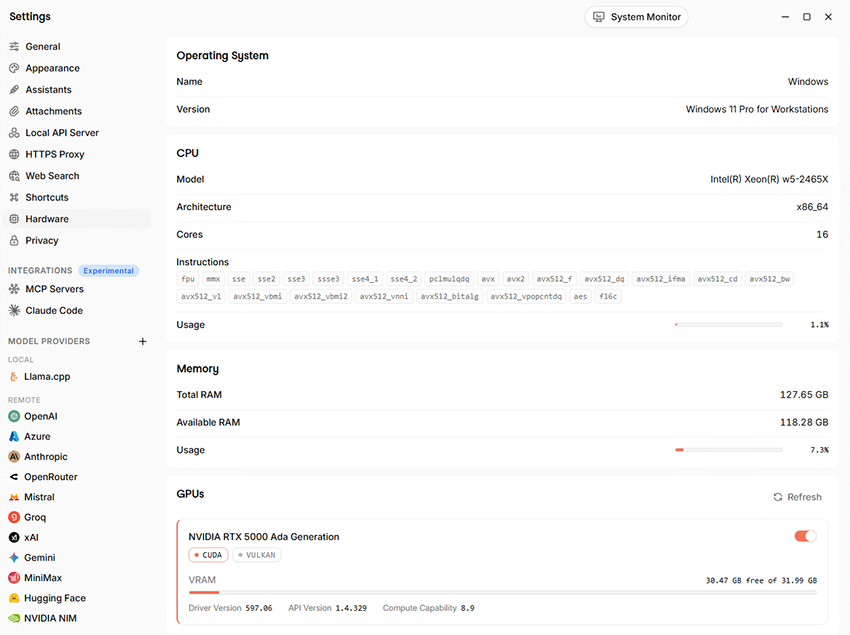
La versión Jan v0.8.6 detectó el procesador Xeon w5-2465X, 127.65 GB de RAM y la tarjeta gráfica NVIDIA RTX 5000 Ada Generation con 31.99 GB de VRAM.
Instalación de Jan y primeros pasos
La instalación en Windows utiliza un instalador .exe estándar, y al ejecutarlo por primera vez, se accede directamente a la interfaz de chat principal de Jan. Jan no requería una cuenta para usar el modelo local. Al iniciarlo por primera vez, preguntaba si deseábamos compartir datos de uso anónimos y luego ofrecía descargar su modelo local recomendado, Jan V3.5.
La descarga inicial de Jan V3.5 tenía un tamaño de 2.8 GB. Al hacer clic en Descargar, se inició el proceso dentro de la aplicación y Jan mostró una notificación de éxito al finalizar. Una vez instalado, el modelo estuvo disponible en el selector situado en la parte superior de la ventana de chat.
En su primer lanzamiento, Jan ofrece su modelo local recomendado, Jan V3.5, como una descarga de 2.8 GB.
Explorar y descargar modelos
Jan's Hub mantiene la búsqueda e instalación de modelos dentro de la aplicación, con acceso directo a los modelos de Hugging Face e información útil disponible antes de que comience la descarga. Cada entrada incluye el tamaño de la descarga, la cuantización, las etiquetas de capacidad y un indicador de compatibilidad de hardware, que ayuda a seleccionar los modelos adecuados para la memoria y la GPU disponibles.
En nuestro sistema RTX 5000 Ada, varios modelos estaban marcados con una etiqueta verde de "Compatible". El Hub mostraba una opción Q4_K_M de 2.5 GB para Jan V3.5 4B, mientras que Jan V2 VL High se mostraba con 4.7 GB e incluía compatibilidad con Multimodal y Tools. Había variantes alternativas disponibles para el mismo modelo de tarjeta.
Jan también puede usar modelos alojados de proveedores como OpenAI, Anthropic, Gemini, Groq y Mistral, junto con modelos que se ejecutan localmente a través de llama.cpp. Esto proporciona a los usuarios una interfaz única para modelos descargados y basados en la nube, mientras que el Hub elimina gran parte del trabajo manual que implica encontrar archivos GGUF y verificar los requisitos de memoria antes de instalarlos.
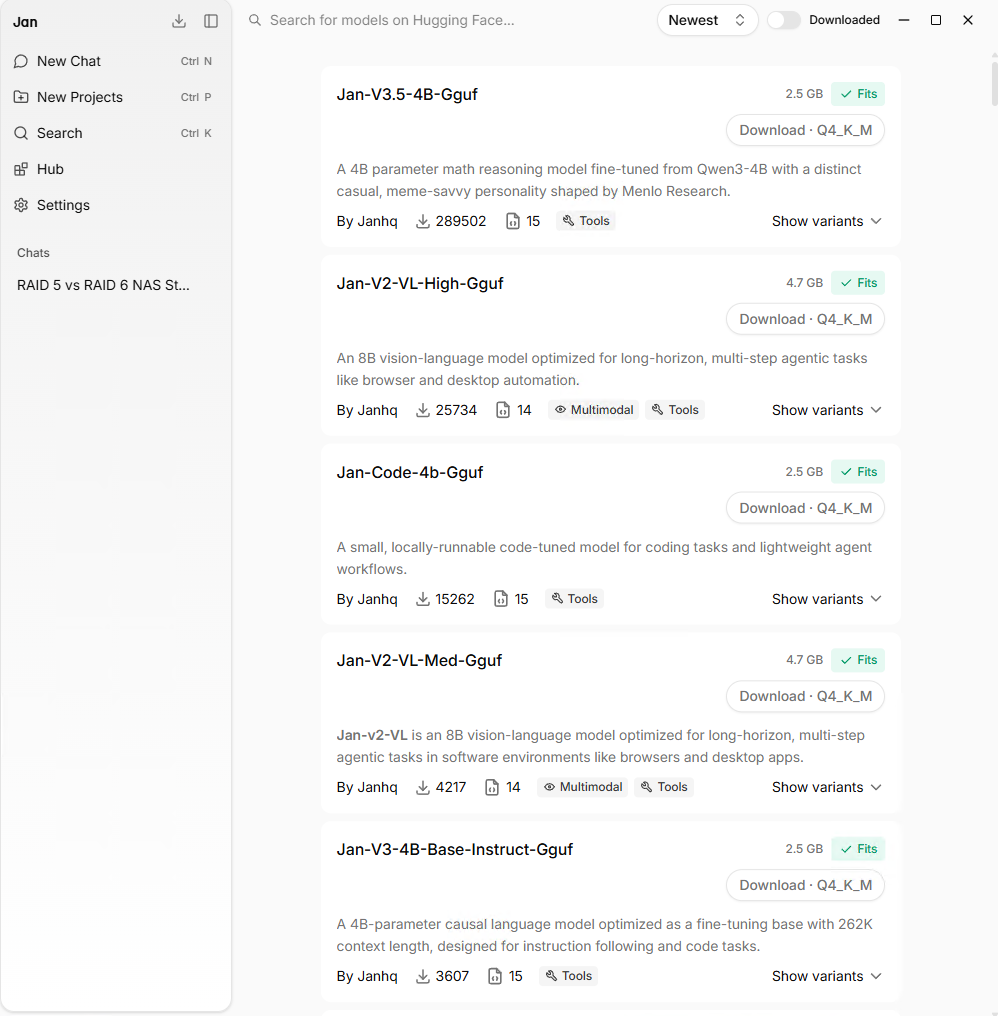
El Hub muestra el tamaño de la descarga, la cuantización, las características del modelo y el estado de compatibilidad con el hardware antes de la instalación.
Descargamos Jan V2 VL High como nuestro segundo modelo porque añadía compatibilidad con imágenes y, al mismo tiempo, cabía fácilmente dentro del búfer de fotogramas de 32 GB de la RTX 5000 Ada.
Configuración del modelo y uso de la GPU
Uno de los cambios más importantes introducidos durante el ciclo de actualización v0.8.5 y v0.8.6 es que ahora llama.cpp está incluido en la aplicación, mientras que las versiones anteriores lo gestionaban por separado. Nuestra instalación mostró llama.cpp 0.5.0, compilación b11146, con Parallel Sequences establecido en 0 para que llama.cpp pueda usar su comportamiento predeterminado, mientras que Remember Conversations Between Sessions estaba habilitado para mantener la caché de mensajes de cada conversación en el disco.
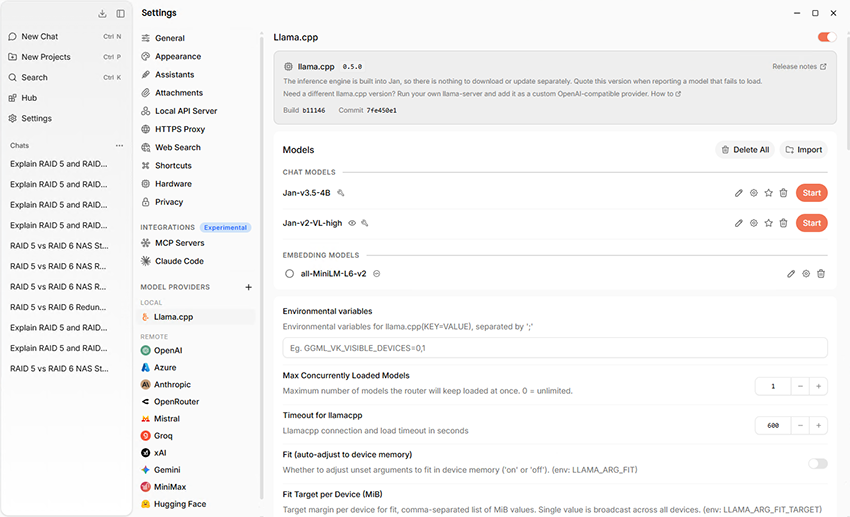
La versión Jan v0.8.6 incluye llama.cpp 0.5.0 directamente en la aplicación, con la compilación b11146 mostrada en la configuración del proveedor de modelos local.
Con Jan V3.5 4B instalado, el icono de engranaje junto al modelo activo permite acceder a su configuración de muestreo y tiempo de ejecución. En nuestra instalación, Jan mostró una temperatura de 0.8, P superior de 0.95, K superior de 40, P mínima de 0.05 y una penalización por repetición de 1.
Aunque los cambios recientes en el entorno de ejecución modificaron el comportamiento predeterminado de descarga de GPU, nuestros perfiles Jan V3.5 4B y Jan V2 VL High actualizados seguían mostrando 100 capas de GPU en la versión 0.8.6, por lo que mantuvimos esos valores guardados sin cambios para la nueva ejecución. Los controles adicionales incluían un tamaño de contexto de 8,192 tokens, ajustes de CPU para los pesos de Mixture of Experts, descarga de caché KV y un tamaño de lote de 2,048. Estas opciones permiten ajustar el uso de memoria y el comportamiento de inferencia directamente en Jan sin editar líneas de comando ni archivos de configuración independientes.
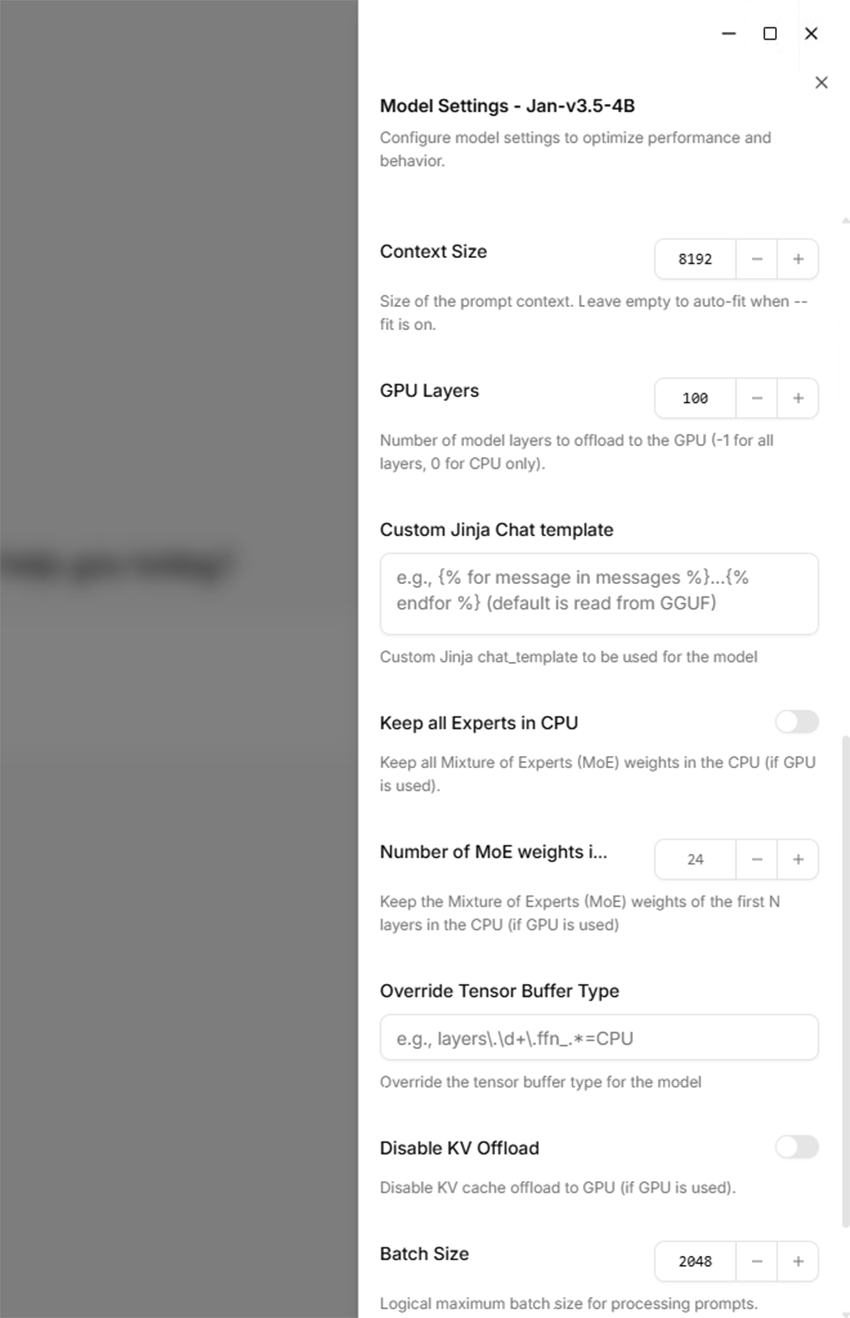
Nuestro perfil Jan V3.5 4B actualizado mantuvo un tamaño de contexto de 8,192 tokens, 100 capas de GPU y un tamaño de lote de 2,048 en v0.8.6.
Rendimiento de la generación local
Con ambos modelos ejecutándose en la RTX 5000 Ada, repetimos nuestra prueba de generación de texto en Jan v0.8.6 para medir la velocidad de decodificación con el entorno de ejecución actualizado. Deshabilitamos la búsqueda web, mantuvimos el tamaño del contexto en 8,192 tokens, conservamos las capas de GPU en el valor de 100 que conservan nuestros perfiles de modelo actualizados y mantuvimos el tamaño del lote en 2,048.
Utilizamos la misma instrucción de texto plano para cada prueba: «Explique RAID 5 y RAID 6 a alguien que esté configurando su primer NAS. Incluya las principales ventajas y desventajas de cada uno, en aproximadamente 400 palabras». La primera respuesta después de cargar cada modelo se descartó como calentamiento, seguida de tres pruebas medidas en tres hilos nuevos.
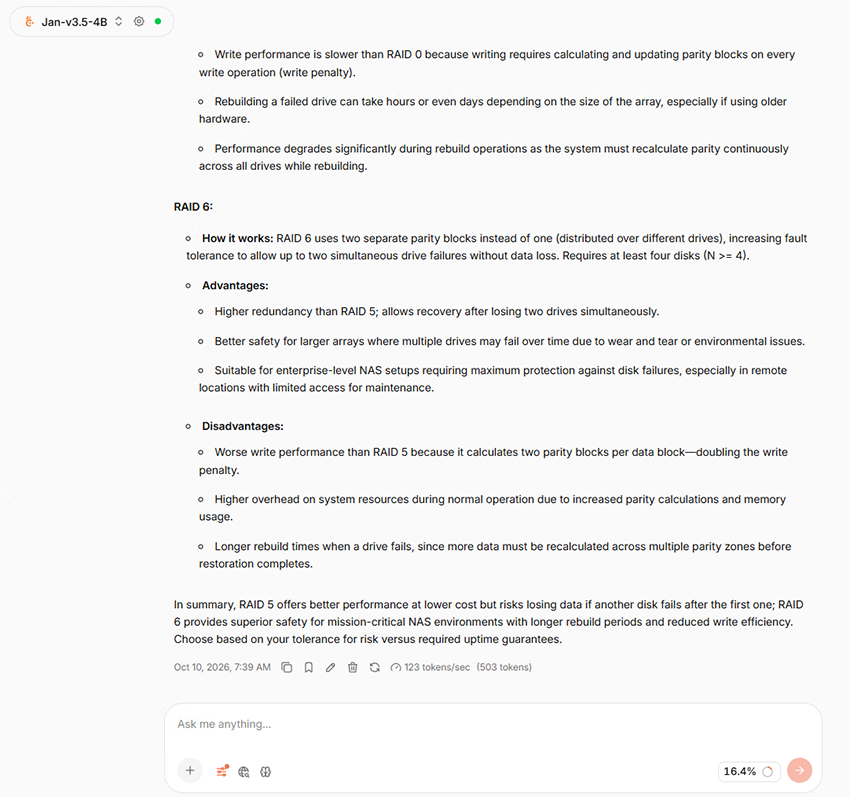
En esta prueba medida, la versión Jan V3.5 4B alcanzó los 123 tokens/seg con 503 tokens de salida reportados por Jan, lo que coincide con las cifras medianas de la prueba de tres ejecuciones.
Jan V3.5 4B Q4_K_XL registró una tasa de decodificación media de 123 tokens/seg en las tres ejecuciones medidas, con una media de 503 tokens de salida informados por Jan y un uso máximo medio de memoria GPU de 4,839 MiB. Jan V2 VL High Q4_K_M alcanzó una media de 82 tokens/seg, con 1,728 tokens de salida informados por Jan y un uso máximo medio de memoria GPU de 8,197 MiB.
Las líneas de tiempo de llama.cpp también siguieron de cerca las cifras de decodificación en pantalla de Jan, con tasas de evaluación medianas de 122.55 tokens/seg para Jan V3.5 4B y 82.30 tokens/seg para Jan V2 VL High. No informamos una mediana de prellenado porque el almacenamiento en caché de indicaciones de conversación estaba habilitado en v0.8.6, y varias ejecuciones repetidas mostraron que solo se evaluaba un token de indicación. Esos valores en caché no proporcionarían una comparación útil del rendimiento del procesamiento de indicaciones completas.
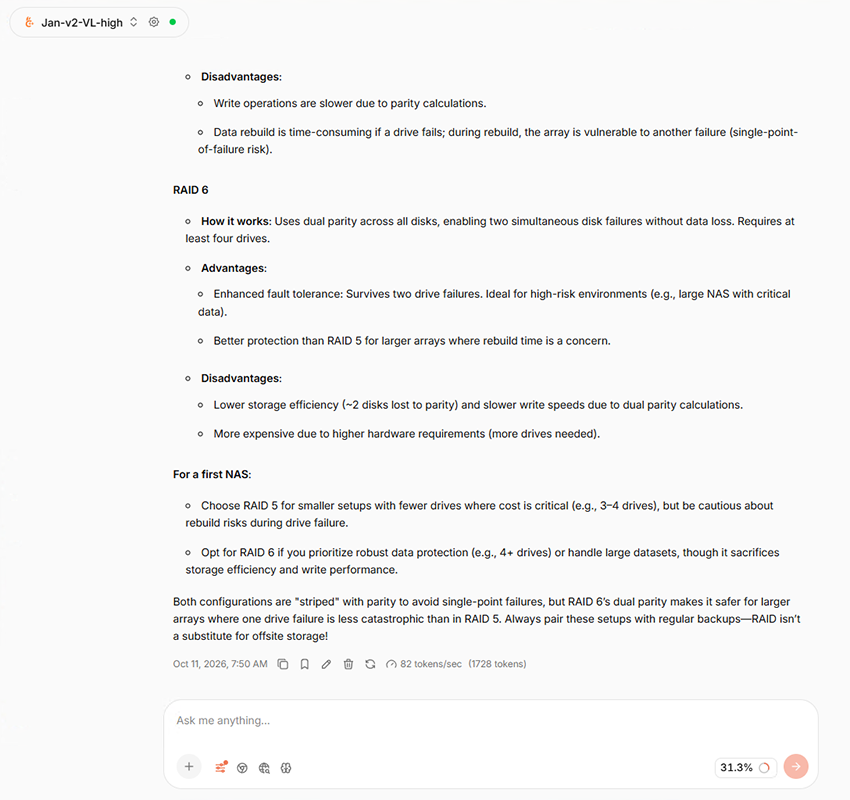
En esta ejecución medida, Jan V2 VL High alcanzó los 82 tokens/seg con 1,728 tokens de salida reportados por Jan, lo que coincide con las cifras medianas de la prueba de tres ejecuciones.
| Modelo | Cuantización | Fichas de salida | Velocidad de decodificación | Memoria de la GPU |
|---|---|---|---|---|
| Enero V3.5 4B | Q4_K_XL | 503 | 123 tok/s | 4,839 MiB |
| Enero V2 VL Alto | Q4_K_M | 1,728 | 82 tok/s | 8,197 MiB |
Nota: Los recuentos de tokens de salida, las tasas de decodificación y las cifras de memoria de la GPU son medianas de tres ejecuciones medidas tras descartar una ejecución de calentamiento. La memoria de la GPU es la mediana del uso máximo de memoria observado durante cada ejecución medida. El recuento de salida informado por Jan V2 VL High parece incluir tokens de razonamiento, ya que la respuesta visible fue de alrededor de 400 palabras, mientras que Jan informó un total de tokens mucho mayor. Por lo tanto, su recuento de tokens de salida no debe compararse directamente con Jan V3.5 4B.
Usando Jan para chat local
La interfaz principal de Jan es fácil de usar una vez instalado el modelo. Las conversaciones recientes aparecen en la barra lateral izquierda, el modelo activo permanece visible en la parte superior y los archivos adjuntos y las herramientas se ubican justo debajo del campo de solicitud.
Cambiar entre los modelos instalados solo requiere unos pocos clics. Jan también muestra información al final de la respuesta, incluyendo el número de tokens y la tasa de generación. Los modelos de razonamiento pueden mostrar su actividad cognitiva durante la generación, aunque el nivel de detalle depende del modelo utilizado.
En nuestra primera prueba local, le pedimos a Jan que explicara las diferencias entre RAID 5 y RAID 6 a alguien que estuviera construyendo un NAS. Ambos modelos descargados cumplieron con la solicitud, aunque Jan V2 VL High generó una respuesta más extensa y utilizó 8,197 MiB de memoria GPU, en comparación con los 4,839 MiB del modelo 4B.
Búsqueda e internet
Jan incluye búsqueda web y obtención de páginas directamente en la interfaz de chat, lo que permite a los modelos compatibles incorporar información en línea actualizada a la conversación cuando estas herramientas están habilitadas. Repetimos nuestra prueba anterior de búsqueda web tras actualizar a Jan v0.8.6, habilitando la función y formulando a Jan V2 VL High la misma pregunta sobre RAID 5 frente a RAID 6 que utilizamos durante nuestras pruebas locales.
Jan decidió de nuevo por su cuenta que la información actual podría ser útil e intentó realizar una búsqueda web, aunque el mensaje no lo solicitaba. La vista de razonamiento mostró que el modelo decidió verificar las recomendaciones actuales de NAS antes de enviar una consulta de búsqueda. En esta ejecución, la búsqueda no pudo completarse porque el servicio Exa configurado había alcanzado su límite de solicitudes MCP gratuitas, pero la prueba confirmó que Jan V2 VL High sigue llamando automáticamente a la búsqueda web cuando considera que la información externa puede ser útil.
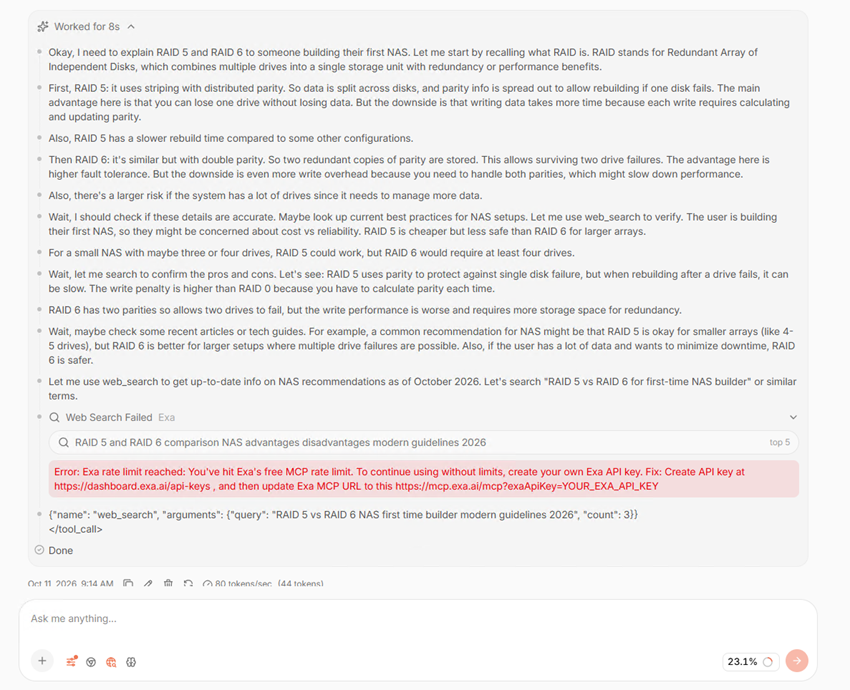
Con la búsqueda web habilitada en Jan v0.8.6, Jan V2 VL High intentó automáticamente realizar una búsqueda en línea durante la consulta RAID, aunque el límite de velocidad de MCP gratuito de Exa detuvo la solicitud.
Jan también es compatible con MCP, lo que permite conectar herramientas y servicios externos compatibles a la aplicación, incluyendo opciones como la interacción con el navegador y otras integraciones. No probamos MCP durante esta sesión, pero su inclusión ofrece a los usuarios otra forma de ampliar las funcionalidades a las que pueden acceder y realizar los modelos que se ejecutan localmente, más allá de la interfaz de chat estándar.
Entrada multimodal
Para volver a probar la entrada de imágenes después de actualizar a Jan v0.8.6, adjuntamos una captura de pantalla reciente de nvidia-smi a Jan V2 VL High y le pedimos que identificara el modelo de GPU, la versión del controlador NVIDIA, la VRAM total, la utilización de la GPU, la temperatura de la GPU y el consumo de energía que se muestran en la imagen. El modelo identificó correctamente los seis valores: NVIDIA RTX 5000 Ada Generation, controlador 597.06, 32,760 MiB de VRAM, 1 % de utilización de la GPU, temperatura de 35 °C y consumo de energía de 4 W / 250 W.
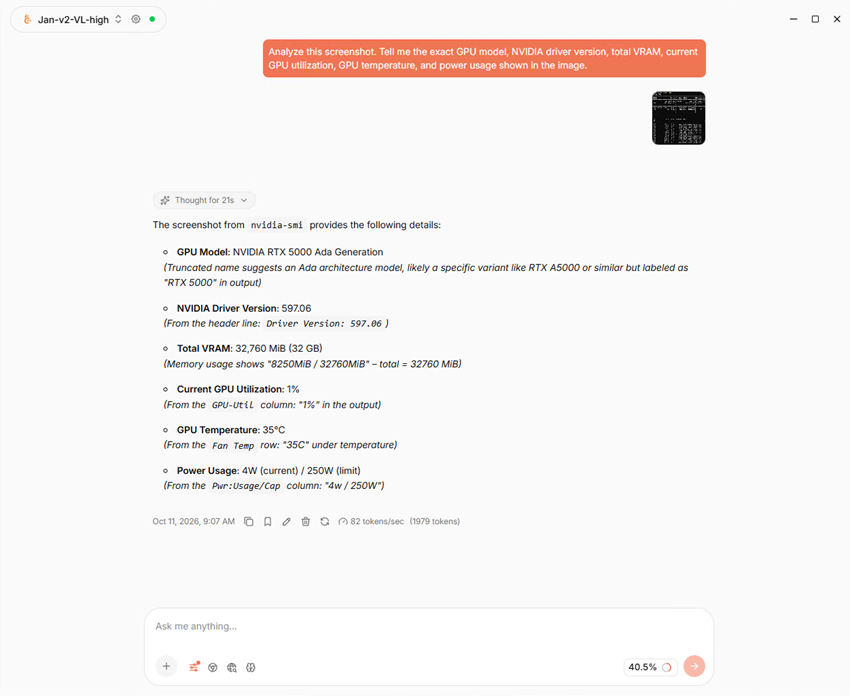
Jan V2 VL High identificó correctamente los seis valores de hardware solicitados a partir de una captura de pantalla reciente de nvidia-smi en Jan v0.8.6.
Esto supone una mejora respecto a nuestra prueba multimodal inicial en la versión anterior de Jan, que dedicó gran parte de su respuesta a analizar el diseño de la terminal. El modelo aún tardaba 21 segundos en razonar antes de responder, y Jan reportó 1,979 tokens de salida, pero la respuesta visible fue concisa y respondió directamente a la solicitud.
Servidor API local
Jan también incluye un servidor API local compatible con OpenAI, accesible desde su menú de Configuración. Seleccionamos Jan V3.5 4B como modelo API local predeterminado e iniciamos el servidor directamente desde la interfaz.
Jan informó que el servidor se estaba ejecutando en:
http://127.0.0.1:1337/v1
El registro integrado del servidor confirmó un lanzamiento exitoso, mientras que Jan también proporcionó acceso a la documentación interactiva de la API.
Usamos PowerShell para asegurarnos de que la API local funcionara como se esperaba, comenzando con una consulta a /v1/models, que devolvió los modelos instalados, incluido Jan V2 VL High. A partir de ahí, enviamos una solicitud de autocompletado de chat a Jan-v3.5-4B-Q4_K_XL pidiendo una explicación de una sola frase sobre RAID 6, y Jan devolvió la respuesta directamente en PowerShell:
“RAID 6 es una configuración de matriz de discos que proporciona redundancia de datos mediante el uso de dos bloques de paridad independientes por bloque de datos, lo que permite que la matriz sobreviva al fallo de hasta dos discos sin pérdida de datos.”
La respuesta contenía un error de hecho: RAID 6 utiliza dos bloques de paridad por franja, no dos bloques de paridad por bloque de datos.
Al funcionar ambas solicitudes, confirmamos que el software compatible con un punto final compatible con OpenAI puede comunicarse directamente con los modelos descargados por Jan, sin necesidad de enviar cada solicitud a través de la interfaz de chat del escritorio.
Qué salió mal
El principal problema de nuestras pruebas iniciales surgió de la prueba multimodal, donde Jan V2 VL High entendió la captura de pantalla de nvidia-smi, pero tardó demasiado en procesar una simple solicitud de extracción. La nueva prueba v0.8.6 descrita anteriormente devolvió los seis valores en una respuesta concisa, aunque los 21 segundos de razonamiento y los 1,979 tokens de salida reportados demuestran que el modelo aún realiza mucho trabajo antes de responder.
La prueba de búsqueda web en la versión 0.8.6 alcanzó un límite fuera de enero: el servicio Exa configurado había alcanzado su límite de solicitudes MCP gratuitas, por lo que la búsqueda automática que el modelo intentó durante la pregunta RAID no pudo completarse. Quienes dependan de la búsqueda web deben configurar un proveedor de búsqueda con capacidad suficiente para un uso regular.
Aparte de esos puntos, las pruebas de la versión 0.8.6 se desarrollaron sin problemas. Las seis ejecuciones repetidas de generación local se completaron sin fallos, errores de carga del modelo ni problemas de detección de la GPU.
Conclusión
Para quienes tengan curiosidad por ejecutar modelos LLM locales en Windows, la versión 0.8.6 de enero simplifica considerablemente la configuración, a la vez que ofrece amplias opciones para ajustar el funcionamiento de los modelos. En nuestro sistema de prueba, detectó automáticamente la RTX 5000 Ada; ambos modelos descargados utilizaron aceleración por GPU, y el Hub mostró información sobre el tamaño del modelo y la compatibilidad con el hardware antes de la descarga. Proporciona la guía necesaria para quienes se inician en el tema, a la vez que ofrece opciones de configuración como el tamaño del contexto, las capas de GPU y la memoria cuando se requiere un mayor control.
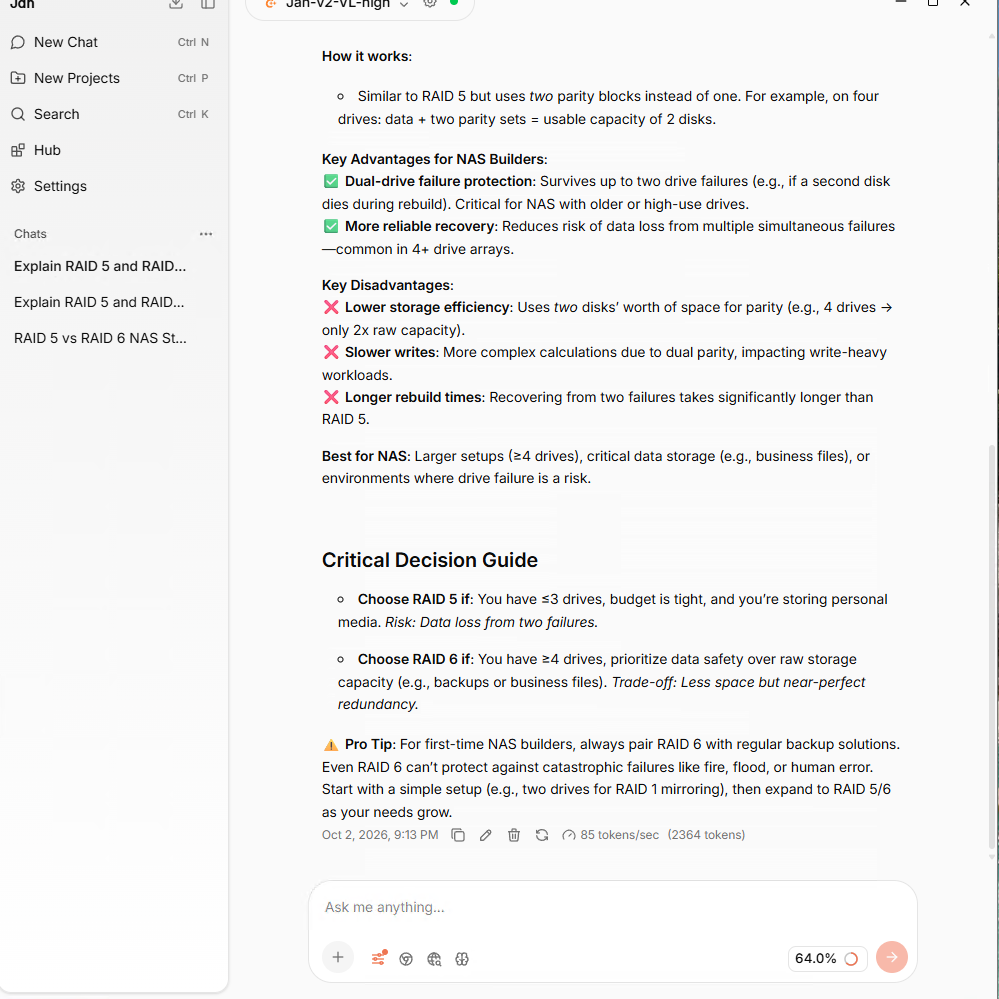
Jan V2 VL High completó la comparación RAID local mientras mostraba información de generación debajo de la respuesta.
Jan va mucho más allá de ejecutar modelos locales y proporcionar una ventana de chat, añadiendo numerosas funciones a la misma interfaz. Probamos la búsqueda web directamente desde una conversación, la entrada de imágenes con Jan V2 VL High, vimos proveedores de IA remotos disponibles junto con modelos locales llama.cpp y enviamos solicitudes a la API compatible con OpenAI desde PowerShell.
En nuestro sistema RTX 5000 Ada, Jan V3.5 4B alcanzó una mediana de 123 tokens/seg en nuestra prueba actualizada de generación de texto, mientras que Jan V2 VL High alcanzó 82 tokens/seg. Jan V2 VL High también produjo una respuesta mucho más concisa en nuestra prueba multimodal repetida después de la actualización v0.8.6, identificando correctamente los seis valores solicitados de la captura de pantalla de nvidia-smi.
Jan funcionó sin problemas durante toda la sesión, y pasar de una instalación nueva a ejecutar modelos locales en la GPU solo requirió un instalador, la descarga de un modelo y unos pocos clics.
Utilizaremos el mismo método de prueba a medida que vayamos revisando las demás entradas de nuestra clasificación de las mejores herramientas LLM locales , ofreciendo a los lectores resultados de rendimiento del mismo hardware junto con las diferencias en las características y el uso diario.


 Amazon