

La NVIDIA RTX PRO 4500 Blackwell Server Edition es la tarjeta que NVIDIA diseñó para los servidores que la mayoría de las empresas ya poseen. Se trata de una tarjeta de una sola ranura, con refrigeración pasiva, de 165 W, 32 GB de GDDR7 y todas las características de Blackwell: núcleos Tensor de quinta generación con FP4, núcleos RT de cuarta generación, tres codificadores y tres decodificadores, y compatibilidad con GPU de instancia múltiple que permite dividirla en dos particiones aisladas de 16 GB. Sustituye a la L4 como modelo de entrada a la gama de servidores RTX PRO de NVIDIA y se adapta a servidores PowerEdge, ProLiant o ThinkSystem de 2U sin problemas de alimentación ni refrigeración.

La propuesta de NVIDIA para esta tarjeta se centra en el dimensionamiento adecuado: la mayoría de las empresas no construyen centros de datos de IA; operan centros de datos existentes con refrigeración por aire y limitaciones estrictas en el consumo de energía de los racks, y necesitan un primer paso de computación acelerada que no requiera una nueva generación de servidores. O bien, trabajan en el borde de la red, donde la RTX PRO 4500 se ajusta mejor a las cargas de trabajo y las restricciones de energía que suelen determinar qué se puede implementar.
La RTX PRO 6000 Blackwell cubre la gama alta de ese mercado con 96 GB y hasta 600 W. La 4500 mantiene la misma arquitectura y reduce todo lo demás aproximadamente a la mitad, por lo que los clientes con modelos más pequeños, muchas tareas pequeñas o un presupuesto de escalabilidad por dólar por vatio pueden optar por Blackwell sin pagar por un rendimiento que no utilizarán.
Las cargas de trabajo para esta clase de GPU son bien conocidas: inferencia de modelos de lenguaje pequeños, IA de visión y análisis de vídeo, búsqueda vectorial y generación de incrustaciones, transcodificación y estaciones de trabajo virtuales con vGPU 20. Ofrece un rendimiento cinco veces superior al de la L4 para la inferencia de modelos pequeños y medianos, y hasta diez veces superior en modelos Nemotron. Entre sus socios de lanzamiento se encuentran NTT DATA para vídeo en el borde, Pacific Biosciences para secuenciación y Nokia para estaciones base AI-RAN. AWS construyó sus nuevas instancias G7 sobre esta GPU como reemplazo de la G6.
Ya probamos la tarjeta frente a la L4 en un HPE ProLiant DL145 Gen11 en nuestro análisis de la RTX PRO 4500 edge , donde ofreció un rendimiento 2.7 veces superior al de la L4. Este análisis explica qué tan cerca se acerca a la L40S de 350 W y doble ranura, que ha sido la tarjeta de inferencia estándar durante dos años, y qué aporta la RTX PRO 6000, superior a esta, en términos de memoria y potencia adicionales.
Para averiguarlo, colocamos la 4500 en un Dell PowerEdge R770 frente a un L40S y un L4, agregamos los datos de la RTX PRO 6000 Blackwell de nuestro Dell Pro Max Tower T2 tanto en su valor predeterminado de 600 W como en un límite de 450 W que coincide con lo que permite el R770 para una ranura de GPU, y ejecutamos el servicio en línea vLLM en cuatro modelos con dos longitudes de contexto.
A modo de adelanto, con la duración típica de los chats y los contextos de los agentes, el 4500 mantiene el ritmo del L40S en los modelos FP8 y BF16 con menos de la mitad de potencia; con una entrada de 8K, el búfer de fotogramas de 32 GB muestra sus limitaciones; y NVFP4, la precisión con la que NVIDIA destaca su propuesta para Blackwell, funciona en línea con el resto de la gama en esta compilación vLLM.
Puntos Clave
- Rendimiento del L40S a 165 W en una ranura: Con una entrada y salida de 512 tokens, la 4500 igualó o superó a la L40S en todos los modelos FP8 y BF16 que probamos, 1,107 frente a 995 tokens/s en Ministral 3 14B FP8 y 2,006 frente a 1,988 en Ministral 3 3B, de una tarjeta con una potencia nominal del 47 por ciento de la L40S y la mitad de sus ranuras.
- Aproximadamente 3 veces el L4 al que reemplaza: Entre 2.8 y 3.6 veces el rendimiento de salida del L4 en contextos cortos, con un consumo de energía de la placa 2.3 veces superior al del L4.
- 32 GB tiene un límite: Con una entrada de 8K, el 4500 se quedó atrás del L40S entre un 17 y un 33 por ciento, y sus curvas se aplanaron con una concurrencia de 8, mientras que el L40S siguió subiendo hasta 16. Este aplanamiento se debe a que la caché KV se está agotando, y 32 GB establecen ese límite.
- NVFP4 es una historia de software, presente en cada tarjeta: En Qwen3.8-27B NVFP4, el 4500 produjo 320 tokens/s con una concurrencia de 32, el L40S 480 sin ningún hardware FP4 y el RTX PRO 6000 621. La ruta NVFP4 en esta compilación vLLM no escala con el ancho de banda de la memoria en ninguno de ellos, mientras que el barrido MAMF muestra que el hardware FP4 del 4500 alcanza 568.6 TFLOPS frente a 280.1 en FP8.
- Lo que te ofrece la tarjeta de mayor capacidad: Con un límite de 450 W, el máximo que permite una ranura para GPU de Dell R770, la RTX PRO 6000 funcionó aproximadamente el doble que la 4500 en contexto corto y entre 2.5 y 3.2 veces más en 8K. Su potencia nominal completa de 600 W añadió entre un 1 y un 2 por ciento en contexto corto y entre un 4 y un 9 por ciento en contexto largo, por lo que la mayor parte de lo que la 6000 ofrece con respecto a la 4500 es memoria.
Especificaciones de la NVIDIA RTX PRO 4500 Blackwell Server Edition
Dos tarjetas llevan el nombre RTX PRO 4500 Blackwell, y son similares pero no el mismo producto. La Workstation Edition, anunciada en GTC 2025, es una tarjeta de 200 W, de doble ranura, con refrigeración activa, cuatro salidas DisplayPort y un ancho de banda de memoria de 896 GB/s. La Server Edition que analizamos aquí llegó a GTC 2026 como una placa pasiva de una sola ranura, sin monitor, de 165 W y 800 GB/s, y sacrifica las salidas de vídeo y algo de margen de reloj a cambio de las características para centros de datos: MIG, computación confidencial, un tercer NVENC y NVDEC, y compatibilidad con vGPU 20. Internamente, tienen la misma GPU de 10,496 núcleos y 32 GB de GDDR7 con ECC.
Según los datos de NVIDIA, el chip cuenta con 45.6 millones de transistores en 378 mm² de silicio personalizado de 4 nm de TSMC, con 82 núcleos RT de cuarta generación, lo que equivale a 82 SM y 328 núcleos Tensor. Estas cifras corresponden a la familia de chips GB203, la misma que la de la RTX 5080, ligeramente recortada. Las cifras de Tensor que se muestran a continuación son los picos de NVIDIA con dispersión; la densidad es la mitad, lo que la propia prueba peakTOPS de NVIDIA confirma con 805 TFLOPS FP8 y 403 TFLOPS FP16 medidos en esta tarjeta.
| Especificación | RTX PRO 4500 Blackwell SE | L4 | L40S | RTX PRO 6000 Blackwell SE |
|---|---|---|---|---|
| Descripción general de la plataforma | ||||
| Arquitectura de interiores | NVIDIA Blackwell | Nvidia Ada Lovelace | Nvidia Ada Lovelace | NVIDIA Blackwell |
| Núcleos CUDA | 10,496 | 7,424 | 18,176 | 24,064 |
| RT Cores | 82 (4ta generación) | 58 (3.ª generación) | 142 (3.ª generación) | 188 (4ta generación) |
| Memoria de la GPU | 32GB GDDR7 con ECC | 24GB GDDR6 | 48GB GDDR6 con ECC | 96GB GDDR7 con ECC |
| interfaz de memoria | 256 bits | 192 bits | 384 bits | 512 bits |
| ancho de banda de memoria | 800GB / s | 300GB / s | 864GB / s | 1,597GB / s |
| Rendimiento (cifras máximas de NVIDIA, tasas de tensores con escasez) | ||||
| FP32 | 51 TFLOPS | 30.3 TFLOPS | 91.6 TFLOPS | 120 TFLOPS |
| Tensor FP16 / BF16 | 406 TFLOPS | 242 TFLOPS | 733 TFLOPS | 1 PFLOPS |
| Tensor FP8 | 811 TFLOPS | 485 TFLOPS | 1,466 TFLOPS | 2 PFLOPS |
| Tensor FP4 | 1.6 PFLOPS | No se admite | No se admite | 4 PFLOPS |
| Rendimiento de RT Core | 154 TFLOPS | No enlistado | 209 TFLOPS | 355 TFLOPS |
| Potencia y factor de forma | ||||
| Potencia máxima de la placa | 165 W | 72 W | 350 W | Hasta 600W (configurable) |
| Factor de forma | Ranura única, FHFL 4.4 "x 10.5" |
Ranura única, HHHL | Doble ranura, FHFL 4.4 "x 10.5" |
Ranura doble, FHFL (aire) Ranura única, FHXL (líquido) |
| Rodillera | Pasiva | Pasiva | Pasiva | Pasivo (aire) o líquido |
| Conector de alimentación | 1x PCIe CEM5 de 16 pines | Alimentado por ranuras | 1x 16-pin | 1x PCIe CEM5 de 16 pines |
| Inteligencia de | PCIe 5.0 x16 | PCIe 4.0 x16 | PCIe 4.0 x16 | PCIe 5.0 x16 |
| Peso | 1,055g | No enlistado | No enlistado | No enlistado |
| Caracteristicas | ||||
| GPU de varias instancias | Hasta 2 tarjetas de 16 GB | No | No | Hasta 4 tarjetas de 24 GB |
| NVENC/NVDEC | 3x / 3x | 2x / 4x | 3x / 3x | 4x / 4x |
| Computación confidencial | Soportado | No | No | Soportado |
| Compatibilidad con vGPU | Sí (vGPU 20) | Sí: | Sí: | Sí: |
Diseño y construcción
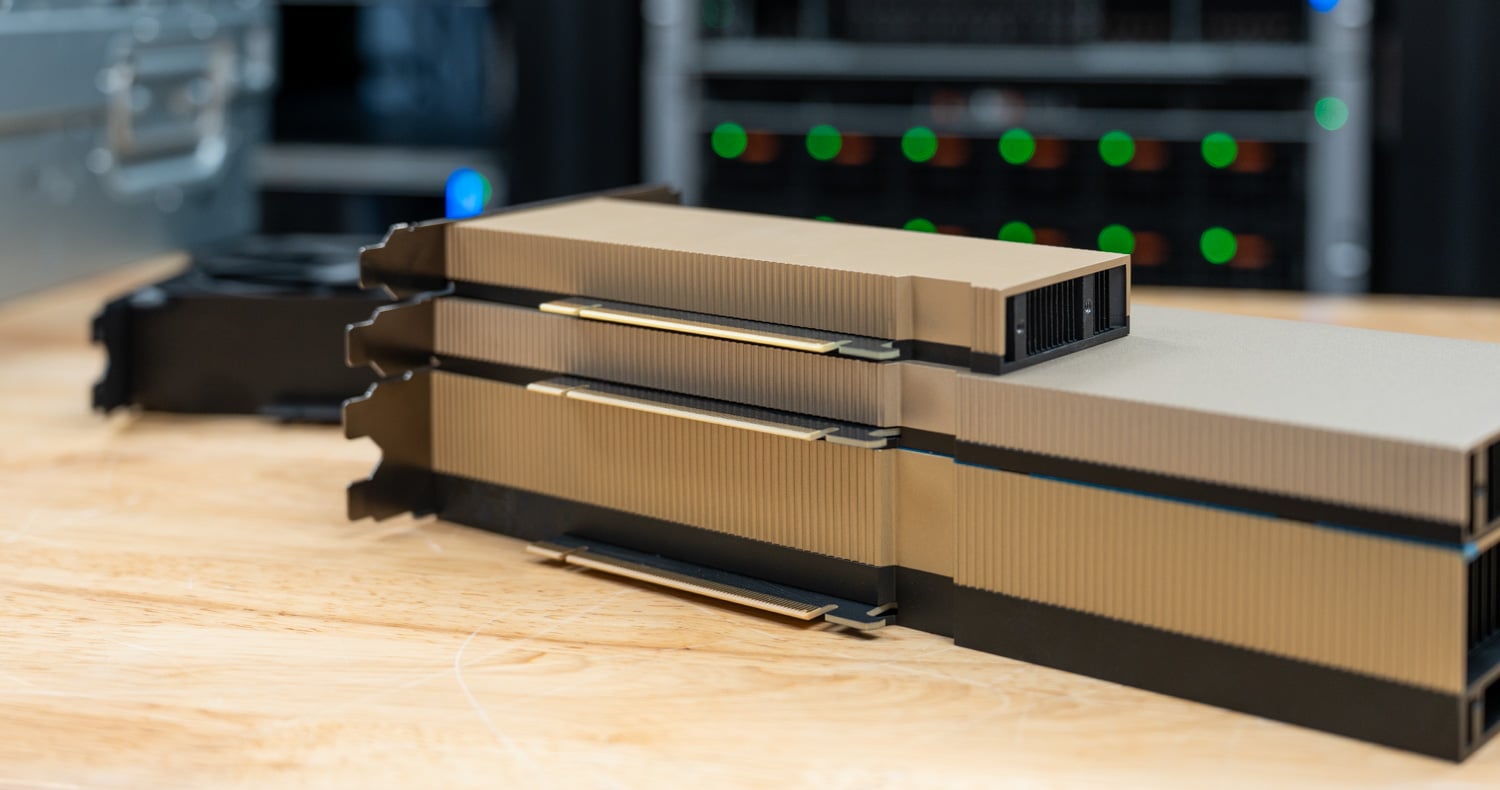
La 4500 Server Edition es una tarjeta de tamaño completo (4.4 pulgadas de alto y 10.5 pulgadas de largo) que ocupa una ranura. Esto supone un cambio importante con respecto a la L4, que era una tarjeta de media altura y media longitud. Si bien la L4 sigue siendo la referencia para las pruebas de rendimiento, su formato se ha modificado a FHFL (altura y longitud completas) para dar cabida a la memoria, la entrada de alimentación de 16 pines y un disipador capaz de disipar 165 W solo con la ventilación del chasis.

Ese formato es la única diferencia real con respecto al L4, que se adaptaba a cualquier ranura HHHL y consumía sus 72 W de dicha ranura, por lo que se utilizaba en servidores 1U y pequeñas cajas perimetrales. El 4500 ocupa toda la altura y longitud, y necesita el cable de 16 pines. Los servidores 1U convencionales con los que trabajamos, incluida la actual línea PowerEdge de Dell, solo admiten tarjetas HHHL o FHHL sin ese conector.
En la práctica, se trata de una tarjeta 2U, o una para los pocos chasis 1U de caja blanca construidos alrededor de ranuras FHFL, por lo que una tienda que compró L4 para cajas 1U o de borde no obtiene un reemplazo directo.
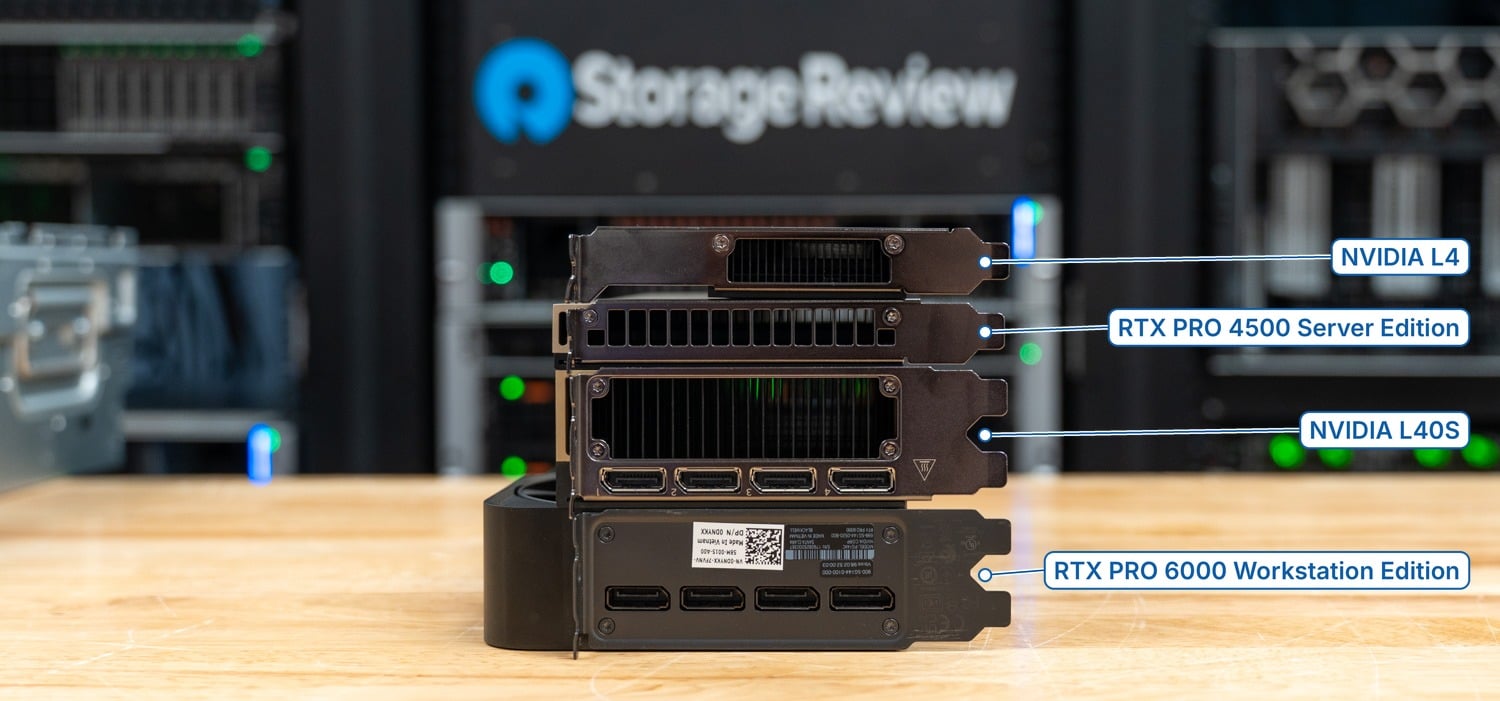
Apilado de canto con el L4 encima y el L40S debajo, el 4500 necesita una ranura donde el L40S necesita dos, razón por la cual un servidor 2U que usa cuatro tarjetas de doble ancho puede usar ocho de estas, y cómo las instancias G7 de AWS ejecutan hasta ocho de ellas por host.
La alimentación se suministra a través de un único conector PCIe CEM5 de 16 pines, el mismo que utiliza la RTX PRO 6000, sin opción de conector auxiliar de 8 pines. La refrigeración es totalmente pasiva, por lo que la tarjeta depende de los ventiladores del servidor y su rendimiento se verá afectado si el chasis no permite la circulación de aire, lo cual es normal para esta categoría, y todas las demás GPU tienen el mismo requisito.
La tarjeta no tiene salidas de video, por lo que el trabajo gráfico, ya sean estaciones de trabajo virtuales vGPU o renderizado, se realiza a través de la red, y el soporte está ventilado. Los tres motores NVENC de novena generación y los tres motores NVDEC de sexta generación agregan codificación y decodificación H.264 y HEVC 4:2:2 con respecto a la generación de la L4, y NVIDIA indica que el rendimiento de decodificación H.264 por motor NVDEC es el doble que el de la L4. La imagen del soporte a continuación muestra la diferencia: la L4 y la 4500 tienen ventilación y nada más, mientras que la L40S y la RTX PRO 6000 Workstation Edition tienen cuatro salidas DisplayPort cada una.
Dónde encaja la RTX PRO 4500 Blackwell Server Edition
La propuesta de NVIDIA es que el "valor central de la tarjeta reside en la combinación de IA, computación, gráficos y aceleración de vídeo en un diseño pasivo de una sola ranura de 165 W", creado para servidores "donde la densidad del rack, la potencia y la refrigeración son las principales limitaciones de implementación". Se sitúa en lo que NVIDIA denomina el segmento principal de centros de datos y computación perimetral de la cartera de servidores RTX PRO, por debajo de la RTX PRO 6000 Blackwell Server Edition y sin estar por encima de ninguna; es el punto de entrada de la línea de servidores Blackwell.
En comparación con la L4, NVIDIA menciona hasta 10 veces más rendimiento en inferencia de modelos pequeños con sus modelos Nemotron Nano (NVFP4 en el 4500 frente a FP8 en el L4), hasta 4 veces más rendimiento en resumen de vídeo con Cosmos Reason 2, 1.9 veces más rendimiento en SPECviewperf 15 a 4K y 1.8 veces más densidad de transmisión. En comparación con las CPU, menciona hasta 50 veces más rendimiento en el trabajo con bases de datos vectoriales con cuVS CAGRA en Milvus y hasta 100 veces más rendimiento en IA de visión, ambos medidos en servidores 4500 de ocho tarjetas frente a sistemas EPYC 9654 de doble socket.
El equipo de servidores de Dell nos comentó que prevé que la 4500 se utilice en racks convencionales, ya que tres tarjetas 4500 de 32 GB cuestan casi lo mismo que una 6000 de 96 GB, y en ese caso, la tarjeta de mayor capacidad suele ser la mejor opción. Esta tarjeta está diseñada para un servidor que, de otro modo, no tendría GPU ni caché L4, y no es la más adecuada para un servidor diseñado para albergar una o más tarjetas 6000.
Configuración de prueba
Instalamos las tarjetas 4500, L40S y L4 en nuestro Dell PowerEdge R770, configurado con dos procesadores Intel Xeon 6787P (86 núcleos cada uno) y 2 TB de DDR5-6400 distribuidos en 32 módulos DIMM, con el controlador NVIDIA 595.71.05. Las pruebas utilizaron el contenedor NGC vLLM 26.08-py3, que incluye vLLM 0.27.1 en CUDA 13.4.1, por lo que la pila de software es idéntica en todas las tarjetas. Cada tarjeta se probó individualmente a su límite de potencia predeterminado, y el R770 suministra a cada tarjeta su potencia nominal completa: Dell indica que la L4 consume 72 W, la 4500 165 W y la L40S 350 W en ese chasis.
La RTX PRO 6000 Blackwell es la tarjeta gráfica para estaciones de trabajo en nuestra Dell Pro Max Tower T2, con el mismo contenedor y controlador. NVIDIA especifica el mismo consumo para las versiones de estación de trabajo y servidor (600 W), y en nuestras pruebas se comportan igual, por lo que Blackwell funciona como tarjeta para servidores. Por cierto, tenemos un análisis de las tarjetas RTX PRO 6000 Server en una XE7740 si quieres profundizar en su escalabilidad.
Realizamos dos pruebas con la tarjeta gráfica 6000: una con su potencia predeterminada de 600 W y otra con un límite de 450 W aplicado mediante nvidia-smi. Esto se debe a que 450 W es la potencia máxima que el R770 suministra a una tarjeta gráfica 6000 en una ranura GPU, y es la cifra que un comprador que elige entre una 4500 y una 6000 para un servidor 2U típico debería comparar. La plataforma host difiere para la 6000, pero con estas cargas de servicio que dependen de la GPU, la CPU y la topología PCIe influyen mucho menos en el resultado que el límite de potencia.
Utilizamos el benchmark de servicio en línea de vLLM en niveles de concurrencia de 1, 2, 4, 8, 16 y 32 con dos formas de solicitud: 512 tokens de entrada y 512 tokens de salida, que se aproximan al chat y a los turnos cortos de los agentes, y 8,192 tokens de entrada con 1,024 de salida, que se aproximan al trabajo RAG y de documentos donde predomina el prellenado y se llenan las cachés KV. Los modelos se eligieron para que se ajustaran a la tarjeta más pequeña del grupo cuando fuera posible, por lo que los 24 GB de la L4 establecen el mínimo: Ministral 3 3B Reasoning y Ministral 3 8B Reasoning en BF16, Ministral 3 14B Instruct en FP8 y Qwen3.8-27B en NVFP4, que se ajusta a las tarjetas de 32 GB y superiores, pero no a la L4.
Informamos sobre el rendimiento de los tokens de salida en cada nivel de concurrencia y citamos el rendimiento total, incluidos los tokens de precarga, cuando esto cambia el panorama.
Lo que no se incluye aquí: modelos más grandes que solo pueden albergar las tarjetas de 48 GB o superiores, particionamiento MIG, vGPU, transcodificación de vídeo, alimentación medida, la configuración de dos tarjetas 4500 y las tarjetas para centros de datos de gama superior.
Máximos FLOPS alcanzables de Matmul (MAMF)
MAMF es una prueba GEMM densa y sostenida que informa el mejor rendimiento de matmul que alcanza una tarjeta en cada nivel de precisión, lo que la convierte en la forma más sencilla de comprobar si el hardware FP4 funciona una vez que la pila de servicio está fuera de escena. La 4500 alcanzó 135.9 TFLOPS en BF16, 280.1 en FP8 y 568.6 en NVFP4, con cada paso de menor precisión casi duplicando el rendimiento. En comparación con los picos densos de NVIDIA de 202, 406 y 811 TFLOPS, eso es del 67 % al 70 % del pico en cada nivel de precisión, y coincide con las propias cifras cuBLAS de NVIDIA para la tarjeta de 133, 275 y 534.
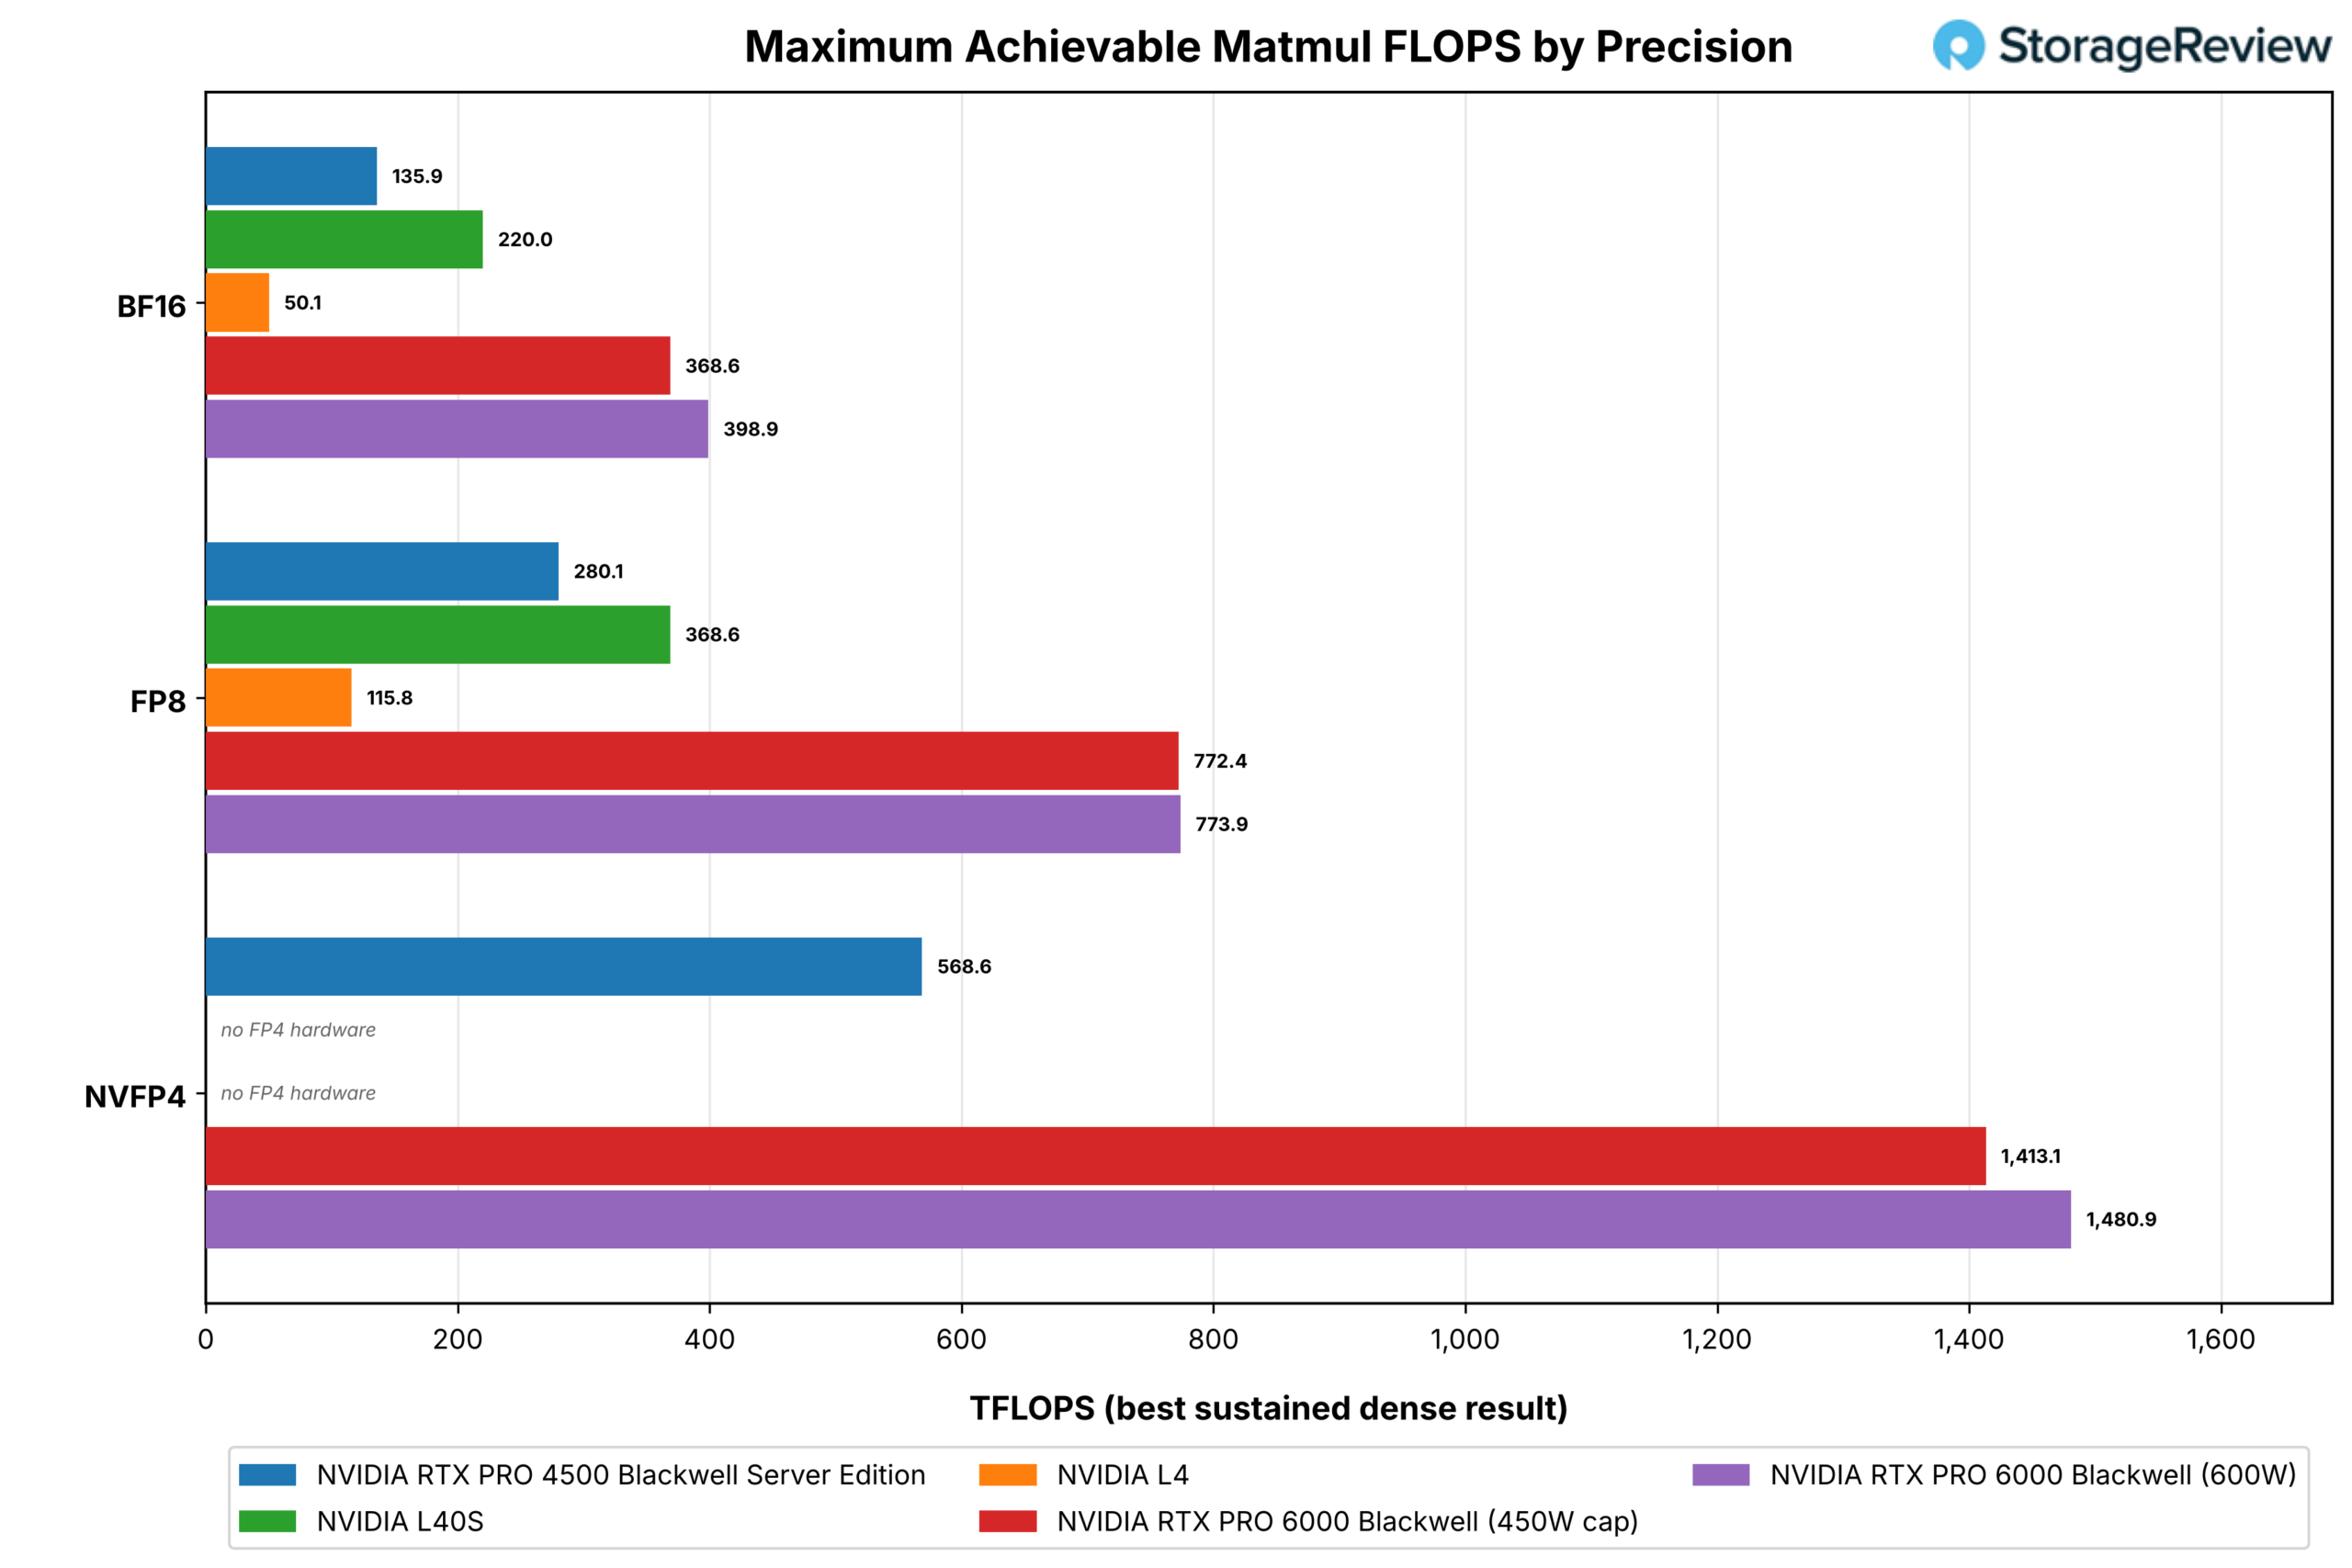
La RTX PRO 6000 escaló de manera similar, alcanzando 398.9, 773.9 y 1,480.9 TFLOPS a 600 W, 2.6x a 2.9x la 4500 en las tres precisiones, lo que coincide con lo que predicen el tamaño del chip y el presupuesto de energía. En el límite de 450 W, alcanzó 368.6, 772.4 y 1,413.1: FP8 no se movió, BF16 perdió un 8 por ciento y NVFP4 perdió un 5 por ciento, lo que dice que la ruta del tensor FP8 de la 6000 está por debajo de los 450 W en esta prueba, y las otras dos precisiones apenas rozan el límite. La L40S alcanzó 220.0 y 368.6 TFLOPS en BF16 y FP8, y la L4 alcanzó 50.1 y 115.8; ninguna de las tarjetas Ada tiene hardware de tensor FP4.
La comparación útil es el resultado NVFP4 del 4500 frente al FP8 de los demás: 568.6 TFLOPS es 1.5 veces el límite FP8 del L40S y el 74 % del límite del 6000, en una tarjeta de 165 W. Esa es la ventaja de FP4, y existe a nivel GEMM. Los resultados de servicio vLLM que siguen muestran que no ha alcanzado la pila de servicio en esta compilación, y el resultado MAMF sugiere que las cifras de servicio seguirán aumentando a medida que los kernels NVFP4 se pongan al día.
Presentación en línea del programa vLLM: Breve contexto (512/512)
El contexto breve es donde el 4500 demuestra su valía: en los tres modelos FP8 y BF16, su rendimiento de salida con una concurrencia de 32 fue de 1,107 tokens/s en Ministral 3 14B frente a 995 para el L40S, 1,017 frente a 1,005 en Ministral 3 8B y 2,006 frente a 1,988 en Ministral 3 3B. Cada uno de ellos es una tarjeta Blackwell de 165 W que iguala o supera a una tarjeta Ada de 350 W, y las curvas se superponen desde la concurrencia 1 hasta la 32, por lo que este no es un resultado de pico único. El L4 alcanzó 364, 279 y 704 en los mismos modelos, lo que sitúa al 4500 entre 2.8 y 3.6 veces por encima de su predecesor.

La RTX PRO 6000 muestra lo que el resto del presupuesto de Blackwell ofrece. Limitada a 450 W, alcanzó 2,161, 2,042 y 4,069 tokens/s en los mismos tres modelos, 1.95x a 2.03x la 4500; a su máximo de 600 W, alcanzó 2,283, 2,139 y 4,155, lo que es 2.06x a 2.1x. Las dos curvas de la 6000 se superponen a través de la concurrencia 16 en cada modelo y se separan por un 2 a 5 por ciento solo en 32, por lo que en un contexto corto los últimos 150 W agregan poco. En comparación con la 4500, eso es el doble de rendimiento de una tarjeta con 3 veces la memoria y, en el R770, 2.7 veces la potencia de la ranura.

El rendimiento total, que también incluye los 512 tokens de precarga por solicitud, sigue el mismo orden: 2,215 tokens/s para el modelo 4500 en el modelo 14B frente a 1,990 para el L40S y 727 para el L4, con el modelo 6000 en 4,323 con límite y 4,566 en el modelo 600W. La diferencia con el L4 es mayor en el modelo 8B (3.6x) y menor en el modelo 3B (2.8x), y la diferencia con el L40S nunca supera el 12 por ciento a favor del modelo 4500.

vLLM Servicio en línea: Contexto extenso (8K/1K)
A los 8,192 tokens de entrada, la imagen cambia, y la razón es visible en la forma de las curvas. En Ministral 3 14B FP8, el 4500 sigue al L40S hasta la concurrencia 8, luego se estabiliza en aproximadamente 180 tokens/s, mientras que el L40S continúa hasta 230 en la concurrencia 16 y se mantiene ahí. El modelo 8B hace lo mismo: 185 tokens/s para el 4500 en 32 frente a 277 para el L40S, con el 4500 estabilizándose en 8 y el L40S en 16. En el modelo 3B, ambas tarjetas se estabilizan en 16, 384 frente a 475.

La razón es la capacidad de la caché KV: cada solicitud concurrente de 8K necesita que su contexto resida en la tarjeta, y una vez que se cargan los pesos, un búfer de trama de 32 GB contiene menos que uno de 48 GB. Cuando vLLM se queda sin espacio KV, deja de agregar concurrencia útil y la línea de rendimiento se estanca. El 4500 cede entre un 17 y un 33 por ciento al L40S con una concurrencia de 32 en estos modelos solo por esa razón; el lado de cómputo no es el cuello de botella, como muestran los resultados de contexto corto. El L4, con 24 GB y 300 GB/s, se mantiene plano desde la concurrencia 4 en todos los modelos, en 34 a 130 tokens/s.

Los 96 GB de la 6000 nunca se quedan cortos en esta prueba, y sus curvas siguen subiendo hasta 32 en todos los modelos. Con el límite de 450 W, alcanzó 552, 589 y 973 tokens/s, de 2.5 a 3.2 veces la 4500; con 600 W, alcanzó 608, 639 y 1,033, o de 2.7 a 3.5 veces. Aquí es donde se nota el límite de potencia: el prellenado de contexto largo mantiene a la 6000 limitada por el cálculo durante más tiempo, por lo que la tarjeta limitada pierde de 4 a 9 por ciento en concurrencia 16 y 32, frente a 2 a 5 en contexto corto. De cualquier manera, la relación con la 4500 se amplía de 2x a aproximadamente 3x, y la memoria es la razón más que la potencia.

Si su carga de trabajo es Q&A de documentos, RAG en contextos largos o agentes que manejan grandes salidas de herramientas, la memoria es la especificación predominante, y los 32 GB del 4500 son una limitación de concurrencia. Si es chat, clasificación o turnos cortos de agentes, no lo es. El rendimiento total a 8K/1K está dominado por el prellenado y repite el mismo orden: 1,713 tokens/s para el 4500 en el modelo 14B frente a 2,070 para el L40S y 381 para el L4, con el 6000 en 4,971 limitado y 5,474 en 600W.
NVFP4: Donde el software marca el límite
La Qwen3.8-27B en NVFP4 es el único modelo del grupo que utiliza el hardware FP4 Tensor con el que Blackwell lidera, y el resultado es el conjunto de curvas más planas de la revisión. Con una concurrencia de 32 en la prueba de contexto corto, la 4500 produjo 320 tokens de salida/s; la L40S, la 480 y la RTX PRO 6000 alcanzaron 621, con límite, y 616 a 600W. Con una concurrencia de 1, todas las tarjetas obtuvieron entre 17 y 22 tokens/s en un modelo 27B, incluida la 6000 con 1.6 TB/s de GDDR7, donde la misma tarjeta ofrece 99 tokens/s de flujo único en el modelo FP8 de 14B.

El L40S no tiene hardware FP4 Tensor, por lo que vLLM ejecuta un punto de control NVFP4 descuantizando los pesos y calculando con mayor precisión, una ruta limitada por el ancho de banda de la memoria, y supera al 4500 por 1.5 veces. El 6000, que tiene el mismo hardware FP4 que el 4500 y el doble de ancho de banda, se sitúa aproximadamente al doble del rendimiento del 4500 que separa a las dos tarjetas en todos los demás aspectos, y sus ejecuciones de 450 W y 600 W están dentro del 1 por ciento entre sí en cada concurrencia, por lo que el kernel tampoco está limitado por la energía.
El patrón observado en las cuatro series, con un rendimiento de flujo único que no varía con el ancho de banda de la memoria y un límite de concurrencia-32 de 480 a 621 independientemente de la GPU subyacente, apunta a la ruta del kernel NVFP4 en esta compilación vLLM como el límite en cada tarjeta.

Con 8K/1K, el 4500 alcanzó 153 tokens/s con una concurrencia de 32, en comparación con 190 para el L40S y 402 y 425 para el 6000 con y sin límite de memoria. Estas son las mismas configuraciones limitadas por la caché KV que mostraron los modelos FP8 y BF16, siendo los 96 GB del 6000 la razón por la que sigue aumentando mientras que los demás se estancan.
NVIDIA ofrece FP4 en esta tarjeta a 1,221 tokens/s en Llama 3.1 8B a 2K/256 y 905 tokens/s en Nemotron 3 Nano 30B A3B bajo TensorRT-LLM, por lo que el hardware cumple con las especificaciones de NVIDIA. Los datos actuales indican que NVFP4 en esta tarjeta es una característica del software vLLM compartida con todas las GPU que hemos probado, y los compradores que esperan un alto rendimiento de FP4 deberían probar su infraestructura de servidor antes de confiar en él.
Rendimiento por vatio nominal
No medimos la potencia en esta ronda, por lo que el cálculo de eficiencia disponible esta vez se basa en el límite de potencia probado de cada tarjeta. En Ministral 3 14B FP8 con una concurrencia de 32, la 4500 ofrece 6.7 tokens de salida/s por vatio nominal, frente a 2.8 para la L40S, 5.1 para la L4, 4.8 para la RTX PRO 6000 con su límite de 450 W y 3.8 para la 6000 con 600 W. En el modelo 3B, la proporción se mantiene: 12.2 para la 4500, 5.7 para la L40S, 9.8 para la L4, 9.0 para la 6000 con límite y 6.9 para la 6000 con 600 W.
La 4500 es la tarjeta más eficiente del grupo según esta medida en un contexto corto, y la 6000, con su límite de consumo, es la única que se le acerca. Reducir el consumo de la 6000 a 450 W le cuesta entre un 2 y un 5 % de rendimiento y recupera el 25 % de su presupuesto energético, razón por la cual su cifra de eficiencia aumenta en una cuarta parte. La L4 se mantiene competitiva en esta métrica porque 72 W es un denominador muy pequeño, pero necesita tres veces más ranuras y servidores para alcanzar el mismo rendimiento, que es la desventaja que la 4500 fue diseñada para solucionar.
En 8K/1K, el orden cambia: el 4500 alcanza 1.2 tokens/s por vatio nominal en el modelo 14B, el 6000 limitado a 1.2 y el 6000 de 600 W a 1.0, con el L40S a 0.7. Una vez que el 4500 se queda sin caché KV, su rendimiento deja de aumentar mientras que su potencia nominal no lo hace, por lo que, a largo plazo, el 6000 de 450 W lo iguala en eficiencia y ofrece 2.9 veces el trabajo por ranura.
Conclusión
La RTX PRO 4500 Blackwell Server Edition cumple exactamente lo que NVIDIA promete: integra la arquitectura Blackwell en una ranura, un presupuesto de energía y una clase de chasis que anteriormente solo alcanzaba el nivel L4. En los modelos que ejecutarán la mayoría de los servidores convencionales, como los de instrucción para servidores pequeños y medianos, y los modelos de razonamiento en contextos de chat, ofrece el rendimiento de una L40S con una tarjeta de una sola ranura cuyo consumo energético es inferior a la mitad del de una L40S, y tres veces superior al de una L4.
Por supuesto, existen limitaciones. Empezando por la memoria: 32 GB ofrecen suficiente capacidad para los modelos a los que apunta esta tarjeta, pero limitan la concurrencia en contextos largos, donde los 48 GB de la L40S y, especialmente, los 96 GB de la 6000 se imponen, y donde la 6000 funciona aproximadamente 3 veces más rápido que la 4500 con la misma forma de solicitud, incluso con su potencia limitada a lo que permitiría el mismo servidor.
NVFP4, la tecnología Blackwell Precision principal, rinde al mismo nivel que las tarjetas que no tienen hardware FP4 en esta compilación vLLM, aunque el análisis MAMF muestra que el hardware FP4 ofrece el doble de velocidad FP8 de la tarjeta a nivel GEMM, por lo que la ventaja de FP4 es algo que se debe verificar en su propio entorno, pero claramente hay más potencial de mejora a través del software.
Cualquier persona con servidores 2U o chasis 1U compatible con tarjetas FHFL que necesite aumentar la capacidad de inferencia, IA de visión, transcodificación o estaciones de trabajo virtuales sin modificar la alimentación ni la refrigeración, encontrará en la RTX PRO 4500 una excelente opción. Además, quienes aún utilicen caché L4 y hayan superado los 24 GB de RAM deberían estar muy satisfechos con la 4500. Para organizaciones con cargas de trabajo de contexto prolongado o multiusuario que requieran 48 GB o más por tarjeta, la RTX PRO 6000 es la mejor opción.
NVIDIA ha hecho bien en delimitar dos segmentos de mercado claros para estas tarjetas, y la 4500 cubre el hueco en el ámbito de la IA de borde entre la L4 y la 6000, consumiendo tan solo 165 W.
Clasificación: La RTX PRO 4500 Blackwell Server Edition ocupa el primer puesto entre las mejores GPU de una sola ranura en nuestra clasificación de las mejores GPU empresariales , donde también aparecen los datos de la L40S y la RTX PRO 6000 de esta reseña.



 Amazon