

Dos cosas suelen surgir en primer lugar cuando se habla de la NVIDIA DGX Spark. La primera es su característica principal: 128 GB de memoria unificada en un equipo de escritorio de aproximadamente 4,000 dólares, una cifra que habría parecido impensable para un ingeniero incluso hace dos años. La segunda es la red de 200 GB en la parte posterior de la unidad. La presencia de una verdadera arquitectura de centro de datos en un dispositivo de escritorio es lo que llama la atención, porque implica algo más que una estación de trabajo compacta más rápida. Implica la capacidad de conectar Sparks y replicarlas físicamente, el tipo de configuración multinodo que antes solo se podía realizar en un rack.
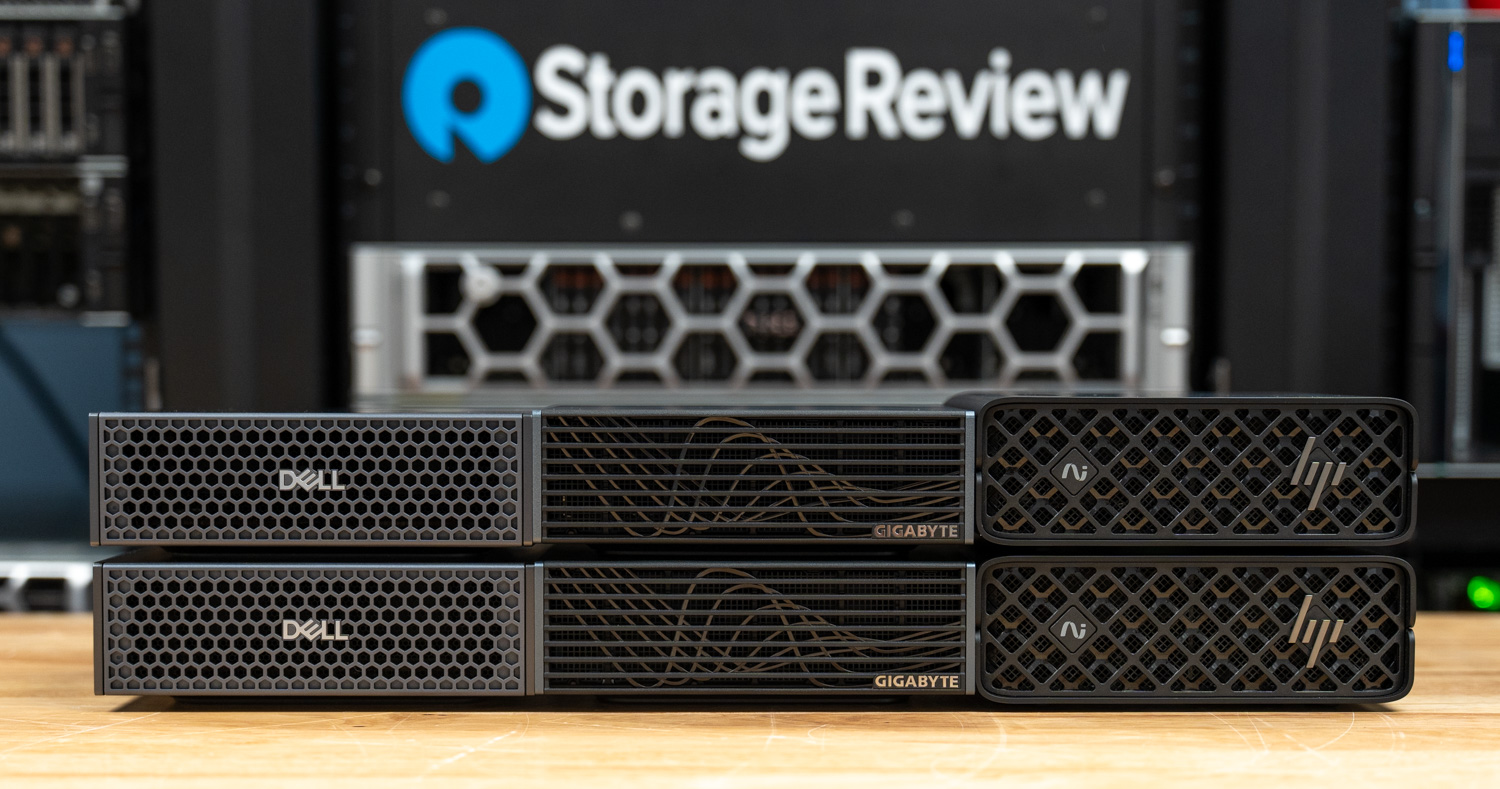
Esta revisión examina dicha capacidad. Evaluamos el rendimiento de la inferencia distribuida en las tres implementaciones OEM Spark que tenemos disponibles, emparejadas en clústeres de dos nodos conectados a través de la red de 200 Gb, y analizamos diferentes variantes de modelos y tres configuraciones de carga de trabajo. Además, adoptamos una metodología específica sobre cómo se divide el modelo entre los dos nodos, que difiere de la recomendación predeterminada de NVIDIA, y la justificamos con datos. Sin embargo, antes de todo esto, dos elementos contextuales son fundamentales: la red que permite la agrupación en clústeres y las razones por las que alguien podría o no querer usarla.
El tejido de 200 GB
Ya analizamos en detalle la implementación de red en nuestra reseña original del DGX Spark, pero vale la pena repasar los aspectos básicos, ya que todo en esta reseña depende de ellos. La parte posterior de cada Spark cuenta con dos ranuras QSFP56 controladas por una tarjeta de red inteligente NVIDIA ConnectX-7 integrada. En teoría, las dos ranuras sugieren una conectividad agregada de 400 GB, pero el límite real reside en PCIe: la ConnectX-7 se encuentra detrás de un par de enlaces Gen5 x4, y la plataforma alcanza un máximo de 200 GB de ancho de banda utilizable, independientemente de cómo estén conectadas las ranuras. Una sola ranura QSFP56 ocupada ya proporciona los 200 Gb que admite el dispositivo, por lo que el segundo puerto ofrece flexibilidad en la topología, no un mayor rendimiento.
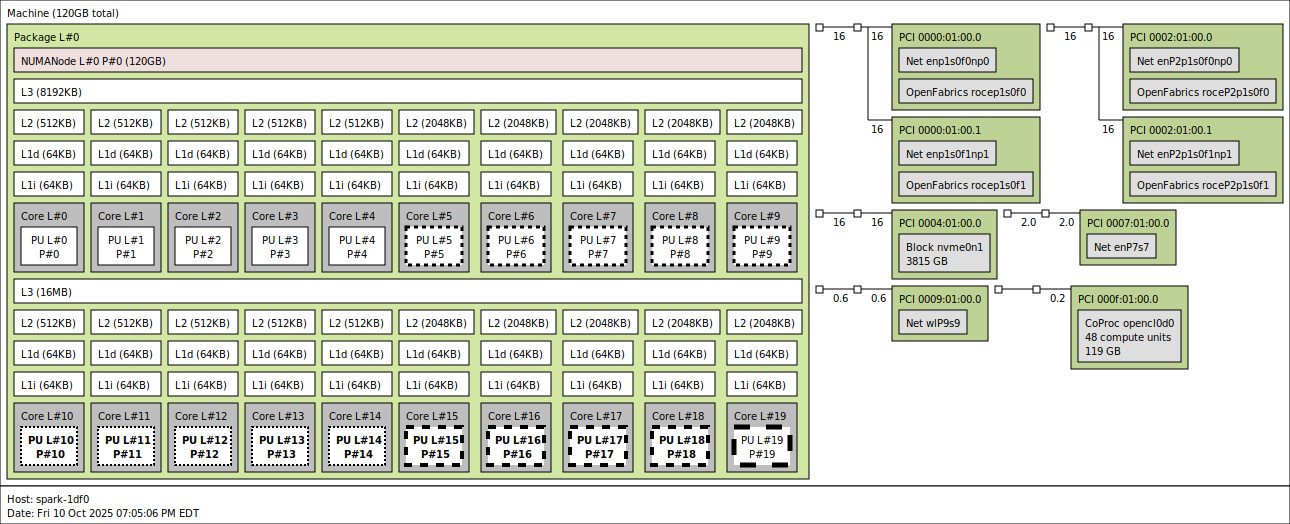
Esa flexibilidad se manifiesta en tres configuraciones comunes. La más sencilla consiste en un único puerto de 200 GB utilizado como enlace directo entre Sparks, tal como especifica la configuración de dos nodos validada por NVIDIA y la que utilizamos para esta revisión. La segunda opción consiste en dos puertos de 100 Gb que configuran una topología en anillo entre Sparks para formar un clúster sin necesidad de un conmutador. La tercera es una configuración de funciones divididas, donde una ranura se conecta a un Spark par para la agrupación en clústeres y la otra se conecta al almacenamiento de alta velocidad a través de NVMe-oF, lo cual resulta útil cuando el conjunto de datos de trabajo no cabe en el NVMe interno del Spark.
NVIDIA comercializa el Spark en tres configuraciones que se corresponden directamente con el uso de la red. Un único Spark para tareas individuales en ordenadores de sobremesa, un clúster validado de dos Sparks conectados directamente a través de la red de 200 Gb para modelos de gran tamaño y, desde la GTC de este año, una configuración de cuatro unidades que NVIDIA presentó públicamente en respuesta a la demanda de los usuarios de superar el límite de dos nodos. La configuración de dos Sparks es la que NVIDIA comercializa activamente, la que la mayoría de los lectores implementarán y la que, en nuestra opinión, representa el límite superior adecuado para la inferencia en entornos de producción con este hardware. Además, es la que se analiza exhaustivamente en esta reseña.
¿Por qué generar chispas en racimo?
La razón obvia para agrupar Sparks es la misma que para cualquier clúster: un único servidor de 128 GB no puede albergar todos los modelos importantes. Distribuir un modelo de 120 mil millones de parámetros en dos servidores permite manejar una gama de cargas de trabajo que de otro modo no cabrían. Este es el caso de uso principal, y el que más se muestra en las demostraciones.
La razón menos obvia, y posiblemente la más importante para la base de clientes de NVIDIA en esta plataforma, es el aprendizaje. NVIDIA posiciona el Spark como un punto de entrada. Su documentación oficial , cuadernos de ejemplo y guías de socios tratan el dispositivo como una herramienta de enseñanza. Incluyen guías de primera clase para todo, desde la puesta en marcha de un modelo preconstruido detrás de una interfaz de chat local hasta la ejecución de un asistente de codificación en un punto final alojado, pasando por el ajuste fino de modelos pequeños y la creación de aplicaciones completas en PyTorch y JAX. La idea es que alguien que nunca haya escrito un kernel CUDA en su vida pueda pasar de cero a un flujo de trabajo de IA funcional en su escritorio en un fin de semana, y lo mismo se aplica a los ingenieros de un campo ajeno al aprendizaje automático que desean un entorno aislado que controlen por completo. Un clúster de dos Spark extiende esa superficie de aprendizaje al territorio de múltiples nodos: la misma persona ahora también puede aprender cómo se comportan realmente el paralelismo de tensores, el paralelismo de pipelines y las bibliotecas de comunicación colectiva, con una red lo suficientemente real como para exponer cuellos de botella reales.
Lo que brilla por su ausencia en el posicionamiento de NVIDIA es la afirmación de que Spark está diseñado para la inferencia en entornos de producción. Jensen ha hablado del codiseño hardware-software en casi todas sus presentaciones durante los últimos años, y este principio se aplica en este caso. Cada plataforma de NVIDIA está optimizada para una carga de trabajo específica, y Spark está optimizada para la exploración y el aprendizaje individuales, no para gestionar el tráfico. Nuestras anteriores reseñas de Spark ya han demostrado que la plataforma está fuertemente limitada por el ancho de banda de la memoria en la mayoría de las tareas de inferencia, y la red agrava aún más esta limitación al crear un clúster. Un único enlace de 200 Gb, si bien es impresionante para un ordenador de sobremesa, es significativamente más lento que una conexión PCIe Gen5 x16 dentro de un mismo chasis, y los patrones de comunicación colectiva que funcionan correctamente entre un par de GPU de centro de datos conectadas mediante NVLink no se adaptan a una red de 200 Gb sin sufrir importantes penalizaciones de latencia.
Esa es la verdadera razón por la que NVIDIA limitó la configuración oficialmente compatible a dos Sparks durante tanto tiempo, y por la que la demostración de cuatro unidades en GTC fue una respuesta a la demanda de los usuarios en lugar de una expansión orgánica del producto. Nada impide que el software se ejecute en cuatro u ocho nodos, y varios usuarios y medios han publicado resultados de clústeres más grandes. Las cifras de rendimiento de esos experimentos generalmente no son alentadoras: la interconexión entre nodos se convierte en el costo dominante, el rendimiento colectivo se degrada drásticamente y, además, el rendimiento por usuario en el extremo inferior de esas configuraciones puede caer a un rango de un solo dígito de tokens por segundo para cualquier modelo lo suficientemente grande como para justificar el clúster en primer lugar. En ese punto, la configuración es funcionalmente un laboratorio de aprendizaje en lugar de una plataforma de servicio.
Nada de esto pretende ser un rechazo. Agrupar Sparks es una excelente manera de desarrollar una intuición para la inferencia y el entrenamiento distribuidos, algo que de otro modo estaría restringido a cientos de miles de dólares en hardware de centro de datos. El valor educativo de poder observar burbujas en la canalización, cuellos de botella en la reducción total y compensaciones de paralelismo en un sistema propio es significativo. Nuestro plan de seguimiento era ir más allá entrenando un modelo pequeño de mil millones de parámetros o menos desde cero en un clúster dual de Spark, con una configuración elegida para replicar lo más fielmente posible las condiciones bajo las cuales opera una ejecución real de preentrenamiento distribuido, para poder mostrar exactamente dónde este tipo de clúster tiene sentido y dónde no. Ese proyecto está actualmente en pausa mientras trabajamos en otros artículos que quizás ya hayan visto y esperamos la llegada de la óptica para nuestro nuevo conmutador central de laboratorio de 800 Gb. Esperamos retomarlo una vez que la configuración del laboratorio esté estabilizada.
A continuación, nos centramos en el caso de uso para el que la configuración dual-Spark resulta más ventajosa: la inferencia distribuida de modelos lo suficientemente grandes como para requerir ambos equipos, evaluada en las tres implementaciones OEM que tenemos disponibles. Antes de presentar las cifras por modelo, la siguiente sección explica por qué las reportamos bajo una configuración de paralelismo de canalización en lugar de la configuración de paralelismo de tensores que la propia documentación de NVIDIA suele utilizar por defecto.
Test de rendimiento
Por qué informamos sobre paralelismo de pipeline, no sobre paralelismo de tensor.
Las guías de DGX Spark publicadas por NVIDIA y la mayor parte de su material de referencia se basan en el paralelismo tensorial (TP) para describir cómo escalar un modelo en dos máquinas Spark. El TP divide cada multiplicación de matrices entre ambas GPU, de modo que cada capa se ejecuta en ambos dispositivos simultáneamente, y los resultados parciales se combinan mediante una reducción total después de cada bloque de atención y MLP. El paralelismo de canalización (PP) toma un camino diferente: divide el modelo por la mitad capa por capa, coloca la primera mitad en una máquina y la segunda mitad en la otra, y luego transmite las activaciones entre ellas. Cada solicitud sigue pasando por el modelo completo, pero en cualquier instante dado, solo una máquina está haciendo los cálculos para un token dado mientras que la otra está trabajando en el siguiente microlote.
La disyuntiva radica en lo que se transmite por el cable. Una pila dual Spark conecta los dos sistemas mediante un enlace ConnectX-7 de 200 GbE, que es rápido para un enlace de red, pero lento en comparación con el ancho de banda de memoria dentro de un solo Spark. La reducción total de TP se activa dos veces por capa de transformador, por lo que un modelo de 80 capas que ejecuta TP=2 genera 160 intercambios entre cajas por cada token de salida, y cada uno de esos intercambios bloquea el siguiente cálculo. PP=2 solo transfiere las activaciones una vez por token, en la unión entre las dos mitades del modelo. En un enlace de 200 GbE con una latencia considerable, esa diferencia domina todo lo demás.
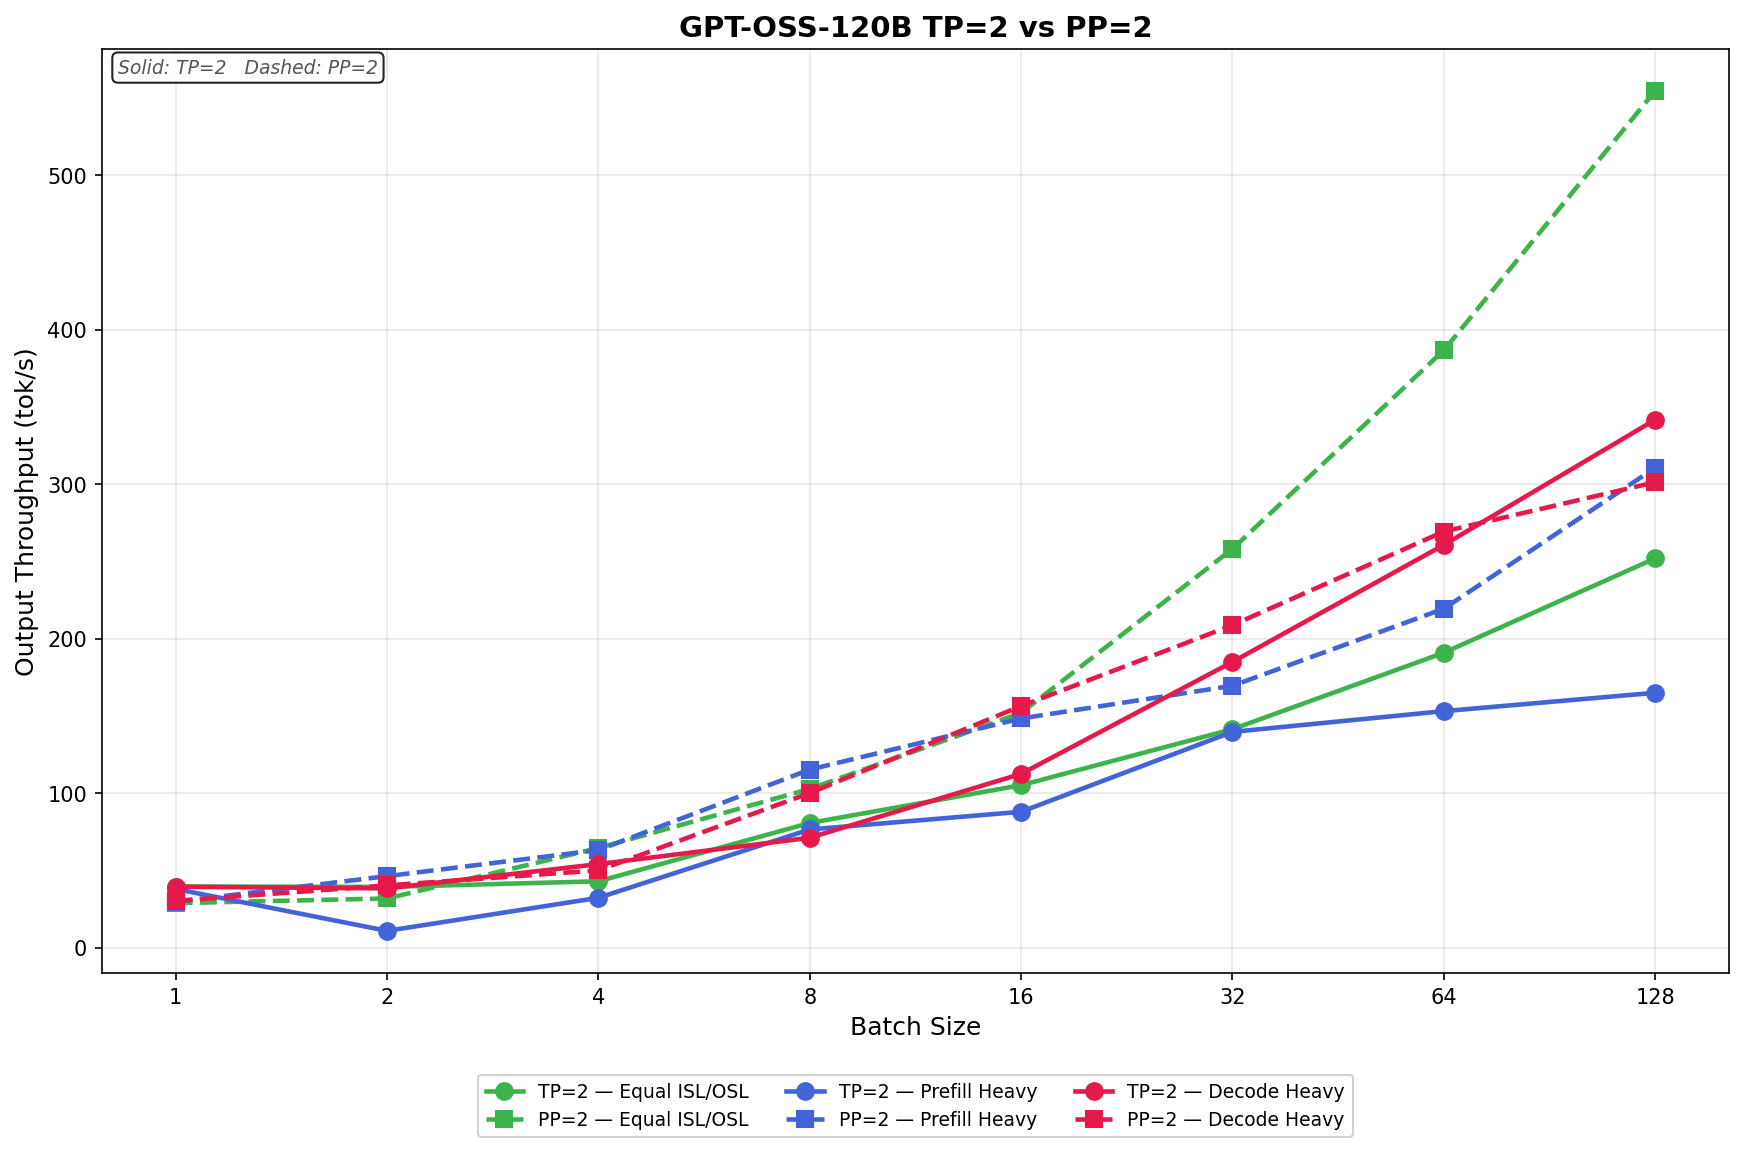
Nuestras mediciones de GPT-OSS-120B lo confirman claramente. Fuera del tamaño de lote 1, donde la carga de trabajo es demasiado baja para ocultar la sobrecarga de cualquiera de las estrategias, PP=2 toma la delantera y la mantiene a medida que crece la concurrencia. En la carga de trabajo Equal ISL/OSL, TP=2 alcanza 252.01 tok/s en un tamaño de lote de 128, mientras que PP=2 sube a 554.69 tok/s en el mismo hardware, una ventaja de 2.20x. Prefill Heavy muestra el mismo patrón, con PP=2 terminando en 310.63 tok/s frente a TP=2 en 164.99 tok/s. El escenario Decode Heavy es el más cercano de los tres, pero PP=2 aún lidera desde el tamaño de lote 8 hasta el tamaño de lote 64, cediendo solo una modesta ventaja en el tamaño de lote 128, donde la larga salida de 8K amplifica el costo de burbuja de la tubería.
TP=2 tiene una ventana estrecha donde gana. Con un tamaño de lote de 1 en todos los escenarios, TP ofrece una ventaja pequeña pero real: 39.55 tok/s frente a 28.79 tok/s en Equal, 37.97 frente a 29.60 en Prefill Heavy y 39.42 frente a 30.28 en Decode Heavy. Con una solicitud en curso, no hay un segundo microlote para mantener ocupada la etapa de canalización inactiva, por lo que PP paga por un espacio vacío en cada paso mientras TP puede usar ambas GPU en el único token que existe. Este es el régimen para el que está diseñada la guía TP de NVIDIA: servicio interactivo de flujo único donde la latencia en la primera y única solicitud importa más que el rendimiento agregado. Si una implementación es realmente de estilo chat, con un usuario por caja y objetivos TTFT ajustados, TP=2 es la decisión correcta, y esto también se alinea con cómo NVIDIA ve Spark.
Para cargas de trabajo que dan servicio a infraestructuras a gran escala, con inferencia por lotes y muchas solicitudes concurrentes, el paralelismo de Pipeline es la mejor opción al escalar entre servidores, especialmente cuando no se utilizan estrategias como el paralelismo experto. La estructura de 200 GbE no puede soportar el tráfico de reducción total por token de TP sin dejar recursos de cómputo inactivos, y una vez que el tamaño del lote es de 4 u 8, el coste de burbuja de PP desaparece en el flujo de estado estable. Por eso, cada número por modelo en el resto de este artículo se informa con TP=1 y PP=2. Es la configuración que realmente representa lo que una implementación dual de Spark puede ofrecer cuando se le pide que realice trabajo real.
Elegimos deliberadamente GPT-OSS-120B como gráfico principal de TP vs PP porque muestra la mayor diferencia. Sin embargo, también queremos demostrar que esto no se cumple para todos los modelos y que estos parámetros dependen de los parámetros del modelo. Llama-3.1-8B-Instruct en BF16 presenta un panorama mucho más conservador. El modelo es lo suficientemente pequeño como para que el cálculo de cada capa sea rápido y el tráfico de reducción total de TP sea, en consecuencia, moderado. Por el contrario, el coste de coordinación por paso de PP es fijo independientemente del tamaño del modelo. El resultado es que TP=2 mantiene la ventaja durante casi todo el ciclo de procesamiento por lotes. En Equal ISL/OSL, TP=2 lidera desde el tamaño de lote 1 (23.2 vs 13.4 tok/s) hasta el tamaño de lote 32 (388.7 vs 349.3 tok/s), y solo pierde el primer puesto en el tamaño de lote 64 (524.8 vs 638.2 tok/s) y el tamaño de lote 128 (679.2 vs 1,047.1 tok/s). Prefill Heavy sigue el mismo patrón, con TP=2 por delante hasta el tamaño de lote 32 antes de que PP=2 tome el relevo en 64 y 128. Decode Heavy es el más decisivo: TP=2 gana en todos los tamaños de lote, terminando en 366.7 tok/s frente a 330.5 tok/s para PP=2 en el tamaño de lote 128.
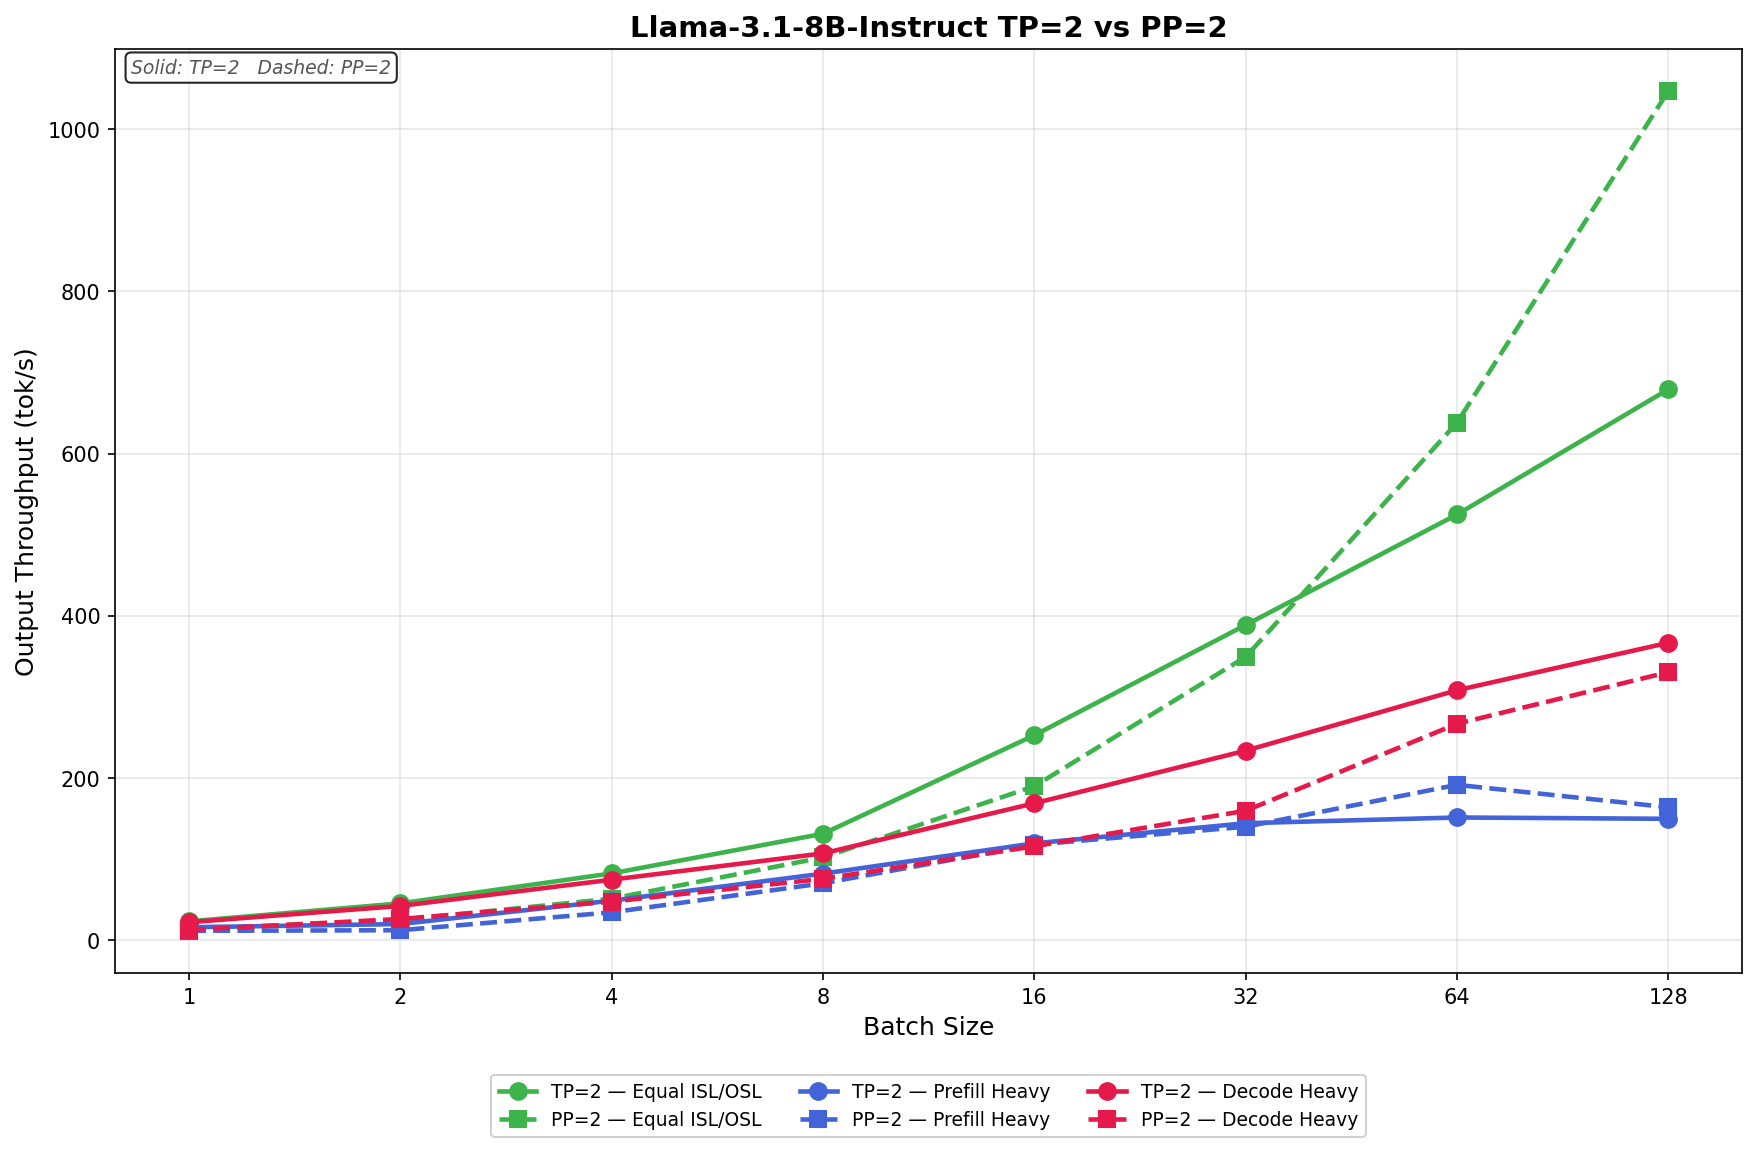
Este contraejemplo refuerza, en lugar de contradecir, la mecánica subyacente. PP=2 solo gana cuando los tamaños de lote son lo suficientemente grandes como para llenar la tubería y amortizar completamente el costo de burbuja, y cuando el modelo en sí es lo suficientemente pequeño como para que la reducción total por capa de TP sea barata; ese punto de cruce se desplaza más lejos. El resultado de Decode Heavy también es consistente: secuencias de salida más largas significan más pasos de decodificación, más burbujas de tubería pagadas consecutivamente y una ventana más pequeña para que PP compense la diferencia. En otras palabras, la misma física que le da a PP una victoria de 2.20x en GPT-OSS-120B con un tamaño de lote de 128 también explica por qué solo gana los dos tamaños de lote más grandes en un modelo de 8B y nunca gana el barrido de decodificación pesada.
GPT-OSS-120B
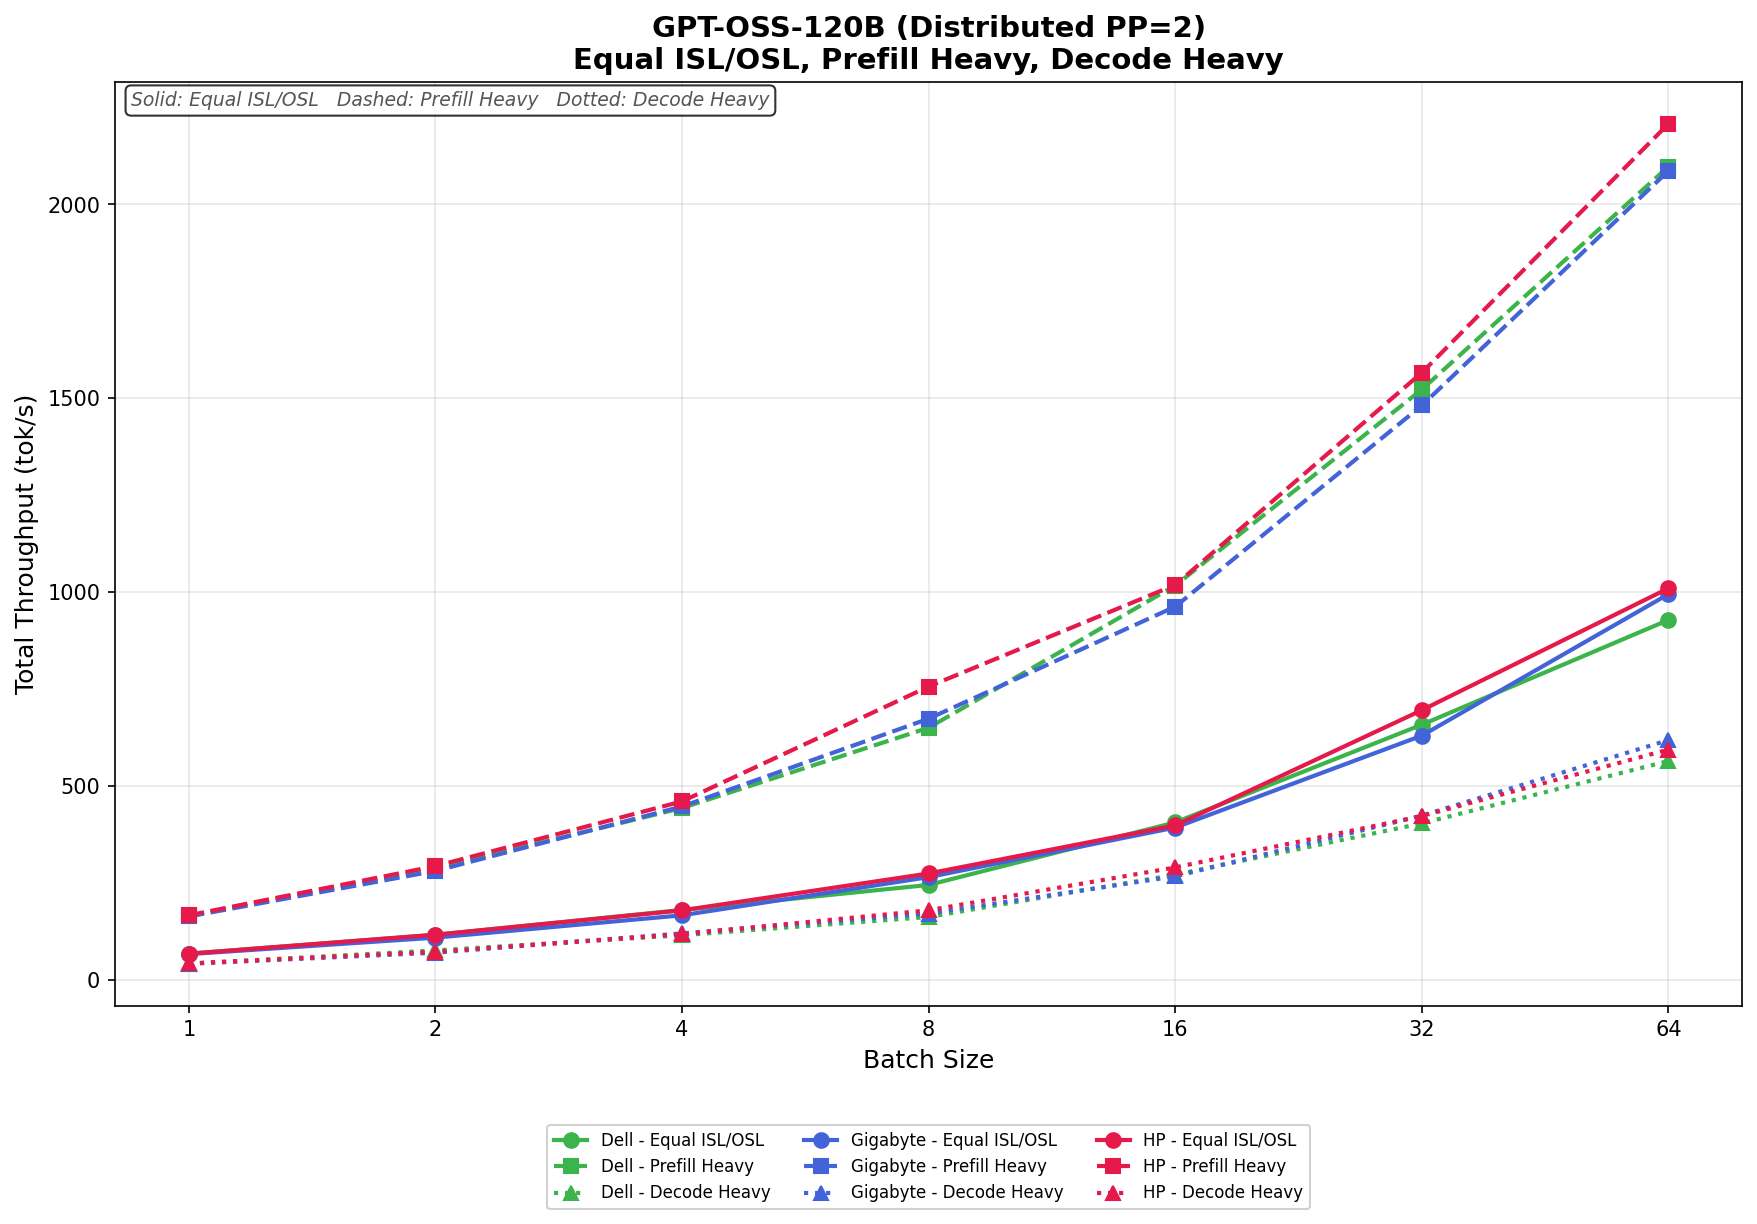
En Equal ISL/OSL, Dell comienza con 67.06 tok/s y alcanza los 927.93 tok/s con un tamaño de lote de 64. GIGABYTE comienza con un rendimiento ligeramente inferior, de 65.77 tok/s, pero finaliza con un mejor resultado, de 994.53 tok/s, mientras que HP lidera el grupo en el extremo superior con 1,009.75 tok/s. La diferencia se mantiene ajustada durante la mayor parte de la prueba, con HP tomando la delantera a partir del tamaño de lote 32.
En Prefill Heavy, el rendimiento aumenta de forma mucho más agresiva en todos los casos. Dell pasa de 164.42 tok/s a 2,097.80 tok/s, GIGABYTE de 162.96 tok/s a 2,086.72 tok/s, y HP obtiene el mejor resultado, pasando de 165.95 tok/s a 2,208.16 tok/s. HP lidera en casi todos los tamaños de lote, mientras que Dell y GIGABYTE se mantienen muy igualados, especialmente en los tamaños de lote de 32 y 64.
En Decode Heavy, el rendimiento general es menor, como era de esperar para la carga de trabajo de decodificación. Dell presenta un rendimiento que oscila entre 41.20 tok/s y 563.98 tok/s, GIGABYTE entre 40.83 tok/s y 617.96 tok/s, y HP entre 41.63 tok/s y 593.56 tok/s. GIGABYTE obtiene el mejor resultado con un tamaño de lote de 64, mientras que HP lidera en el rango medio, y Dell se mantiene cerca, pero ligeramente por detrás con una mayor concurrencia.
GPT-OSS-20B
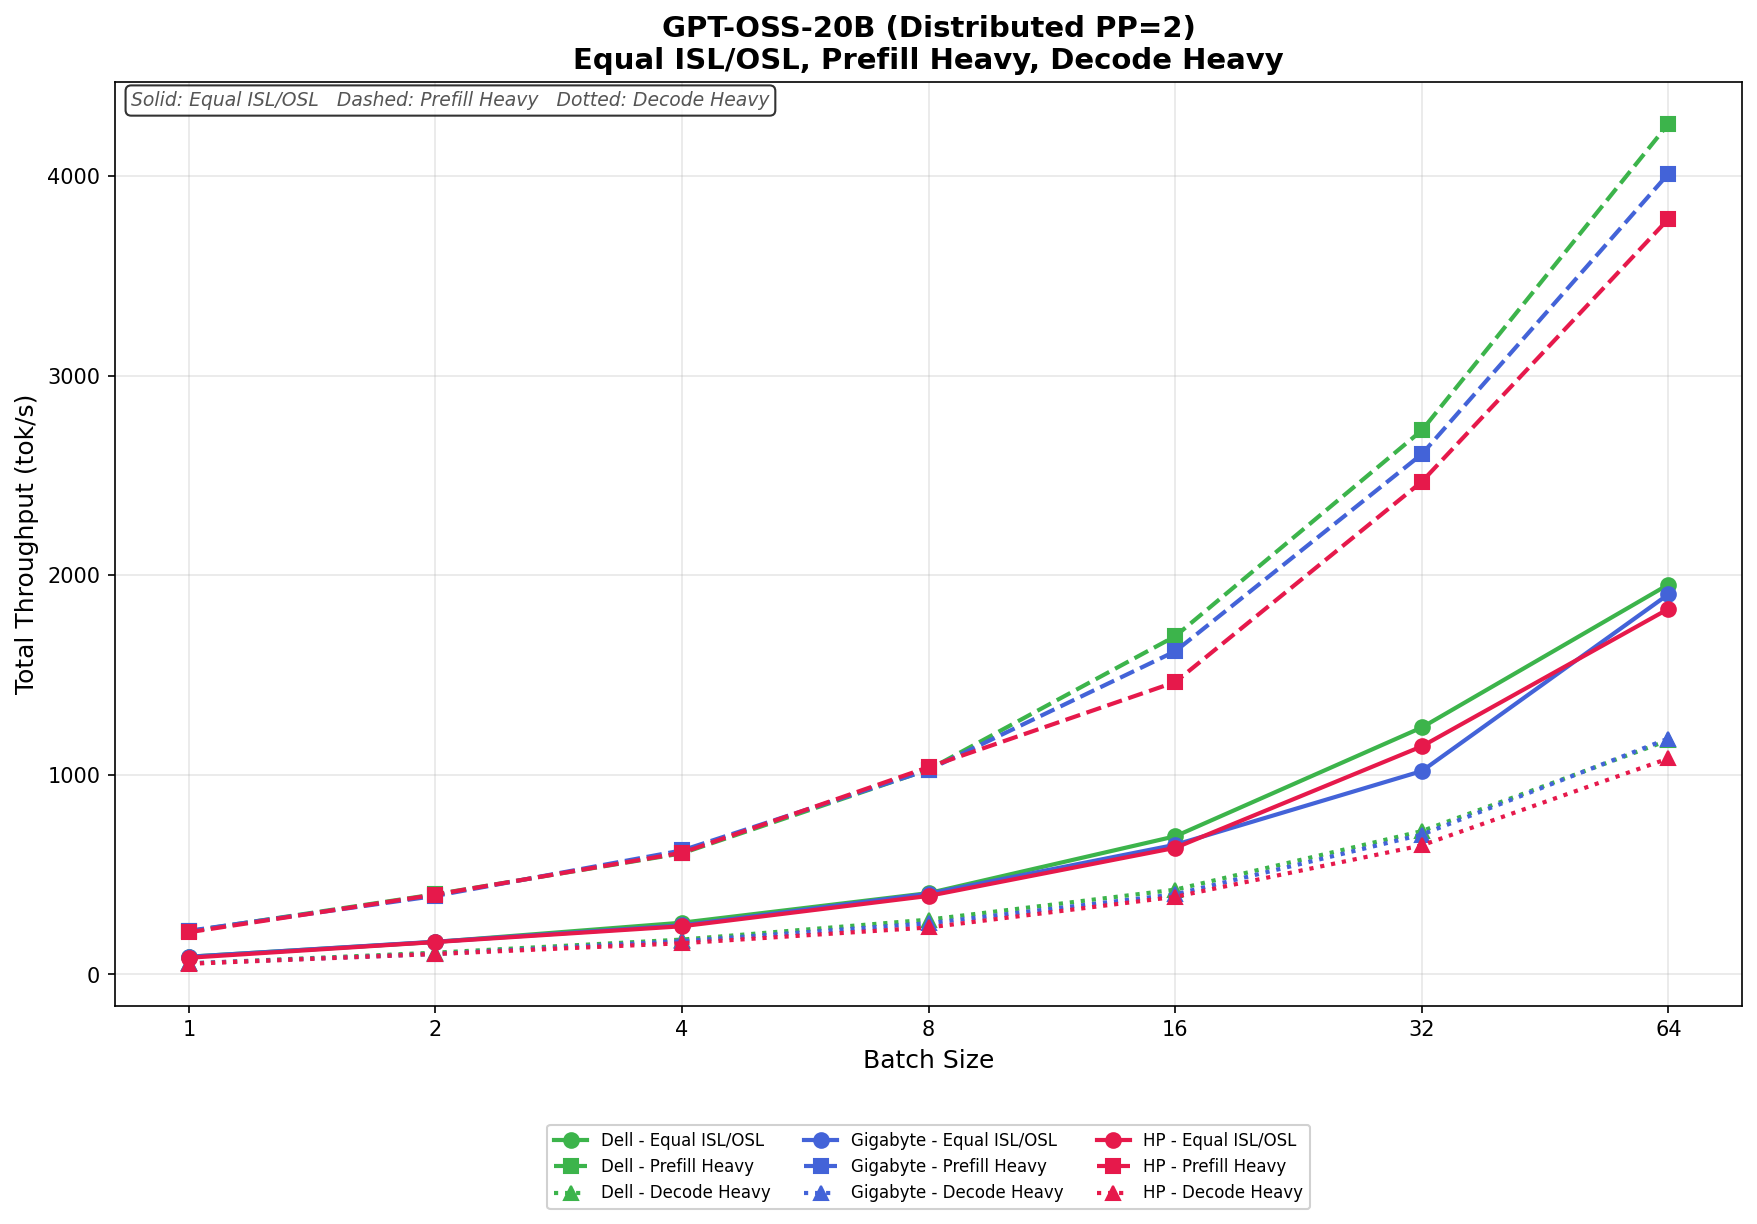
En Equal ISL/OSL, Dell lidera la mayor parte del análisis, pasando de 88.73 tok/s con un tamaño de lote de 1 a 1,953.55 tok/s con un tamaño de lote de 64. GIGABYTE le sigue de cerca, aumentando de 88.42 tok/s a 1,904.62 tok/s, mientras que HP varía de 83.49 tok/s a 1,831.45 tok/s. Dell mantiene el mejor rendimiento en la gama alta, especialmente a partir del tamaño de lote 16.
En la prueba Prefill Heavy, el rendimiento aumenta drásticamente en los tres sistemas. Dell ofrece el mejor resultado, pasando de 216.05 tok/s a 4,261.96 tok/s con un tamaño de lote de 64. GIGABYTE le sigue con 4,011.86 tok/s, mientras que HP alcanza los 3,785.25 tok/s. Los tres sistemas se mantienen muy igualados con tamaños de lote más pequeños, pero Dell comienza a diferenciarse con un tamaño de lote de 16 y amplía su ventaja durante el resto de la prueba.
En Decode Heavy, la escalabilidad es más gradual, pero se mantiene sólida en todas las plataformas. Dell varía de 54.88 tok/s a 1,173.31 tok/s, GIGABYTE de 55.24 tok/s a 1,181.94 tok/s, y HP aumenta de 53.20 tok/s a 1,082.23 tok/s. GIGABYTE supera ligeramente a Dell en el tamaño de lote más alto, mientras que HP se queda atrás de ambos sistemas en niveles de concurrencia más altos.
Base de instrucciones Llama 3.1 8B
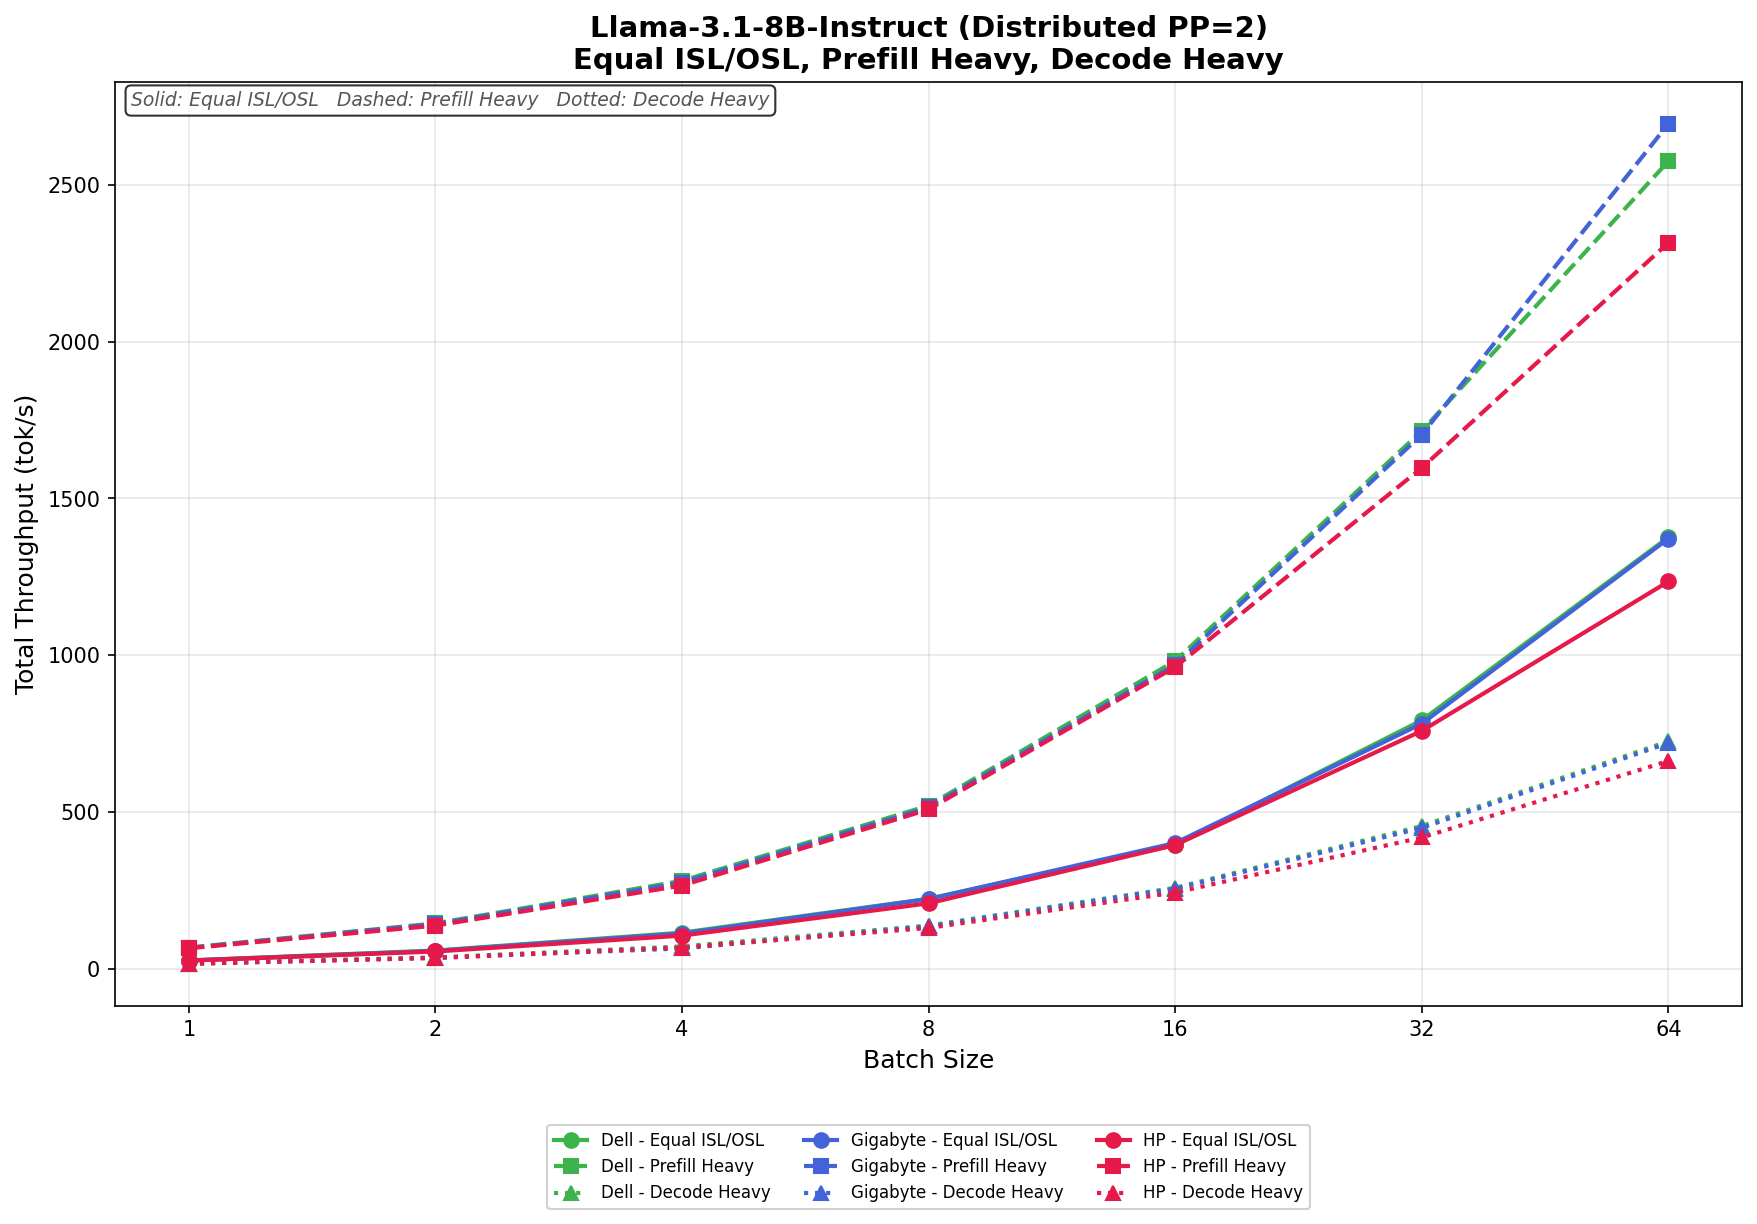
En Equal ISL/OSL, Dell escala de 27.69 tok/s a 1,376.38 tok/s con un tamaño de lote de 64, superando ligeramente a GIGABYTE, que varía de 27.23 tok/s a 1,372.27 tok/s. HP se queda un poco rezagada durante todo el análisis, escalando de 26.89 tok/s a 1,235.32 tok/s. Los tres sistemas siguen un rendimiento muy similar hasta un tamaño de lote de 16, antes de que Dell comience a obtener una pequeña ventaja en niveles de concurrencia más altos.
En Prefill Heavy, el rendimiento aumenta drásticamente a medida que aumenta el tamaño de los lotes. Dell pasa de 68.60 tok/s a 2,575.25 tok/s, mientras que GIGABYTE obtiene el mejor resultado, pasando de 67.49 tok/s a 2,694.25 tok/s con un tamaño de lote de 64. HP alcanza los 2,315.15 tok/s, manteniéndose competitivo pero consistentemente por detrás de Dell y GIGABYTE con tamaños de lote mayores. GIGABYTE toma la delantera en el extremo superior, especialmente para tamaños de lote de 64 o más.
En Decode Heavy, el rendimiento se mantiene constante a lo largo de todo el análisis. Dell varía de 17.19 tok/s a 726.22 tok/s, GIGABYTE de 16.96 tok/s a 720.57 tok/s y HP de 16.79 tok/s a 663.31 tok/s. Dell y GIGABYTE se mantienen prácticamente idénticos durante la mayor parte de la prueba, con Dell ligeramente por delante en los niveles de concurrencia más altos. Al mismo tiempo, HP se queda un poco atrás con tamaños de lote mayores.
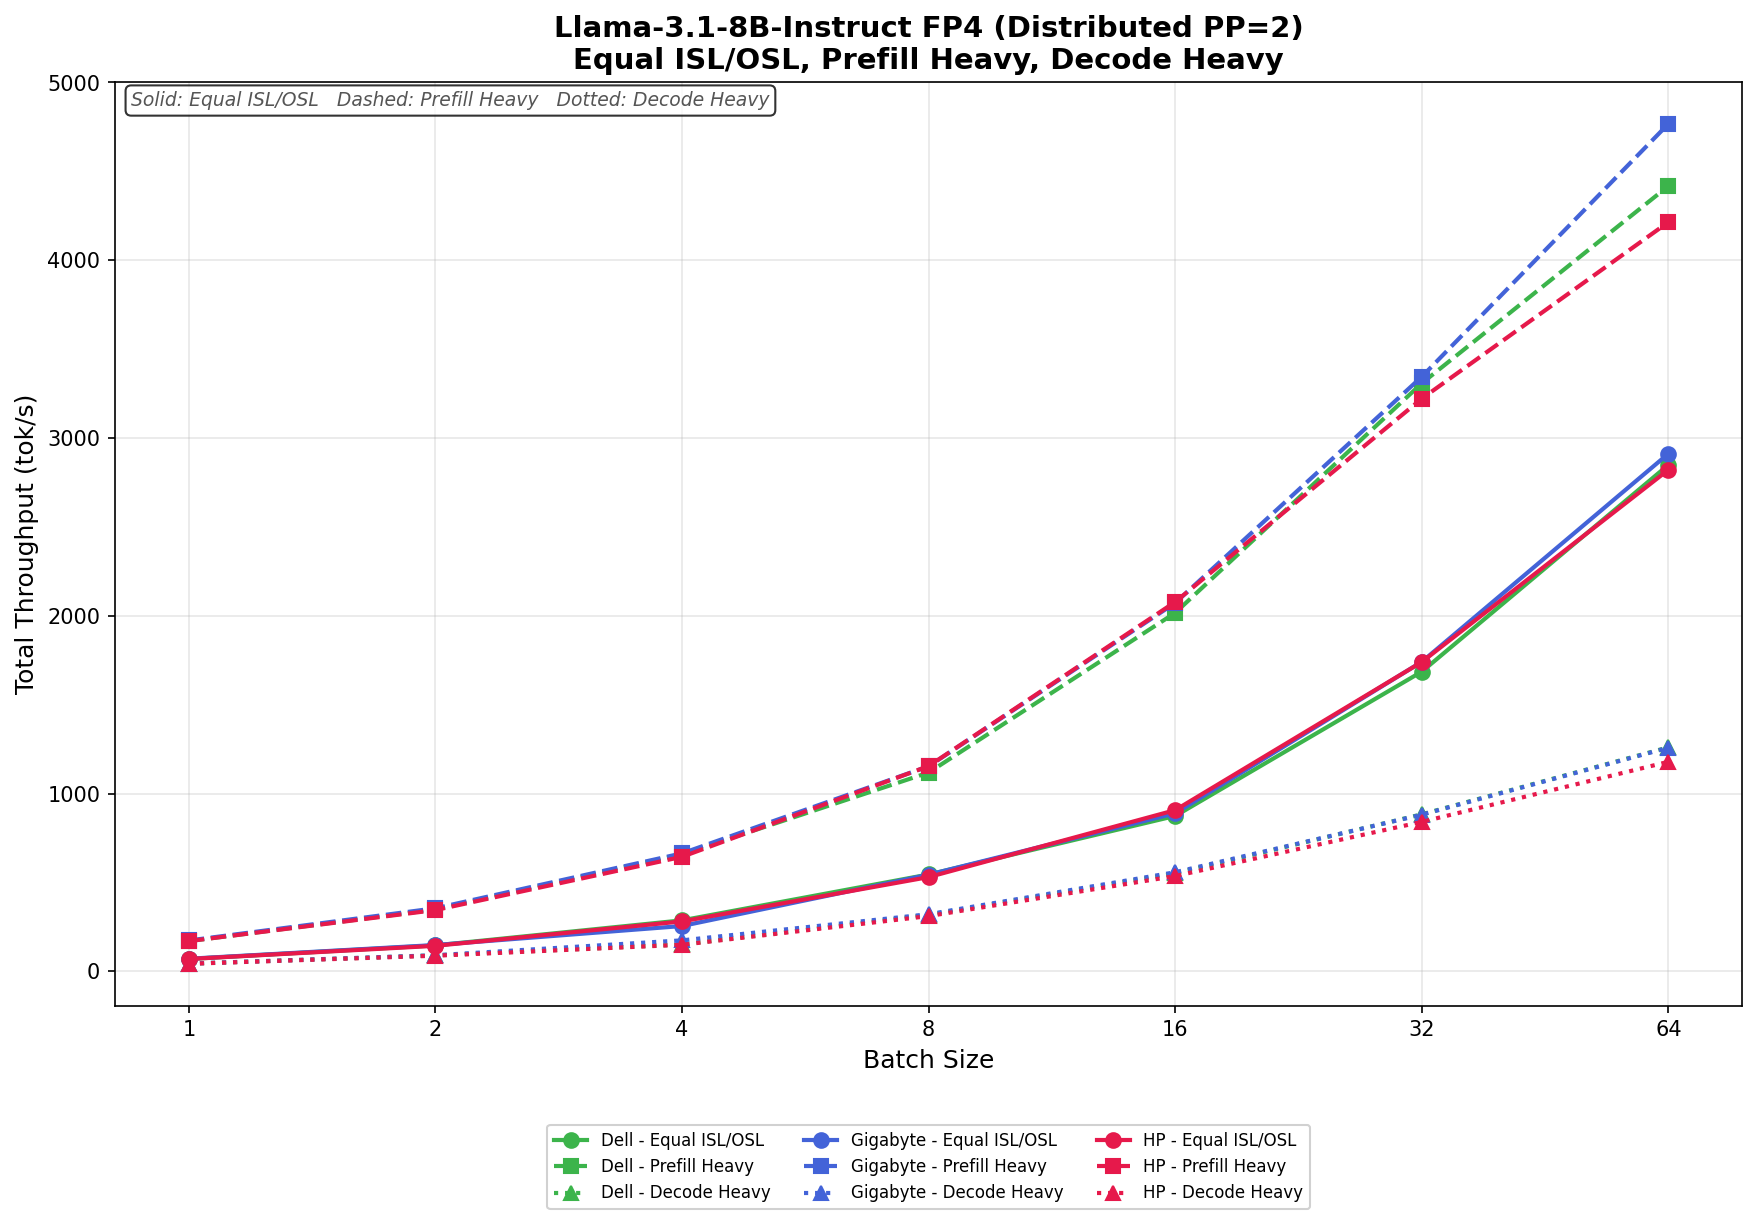
Llama 3.1 8B Instrucción FP4
En Equal ISL/OSL, Dell escala de 69.71 tok/s a 2,849.20 tok/s con un tamaño de lote de 64, mientras que GIGABYTE se adelanta ligeramente, pasando de 70.92 tok/s a 2,912.03 tok/s. HP se mantiene competitivo, con un rendimiento que oscila entre 69.52 tok/s y 2,821.50 tok/s. Los tres sistemas se mantienen muy agrupados en toda la carga de trabajo, con solo una pequeña separación en niveles de concurrencia más altos.
En Prefill Heavy, la escalabilidad se vuelve mucho más agresiva, especialmente con tamaños de lote mayores. Dell aumenta de 170.09 tok/s a 4,417.65 tok/s, mientras que GIGABYTE registra el mejor resultado del grupo, pasando de 173.55 tok/s a 4,767.43 tok/s con un tamaño de lote de 64. HP aumenta de 170.12 tok/s a 4,214.57 tok/s. GIGABYTE comienza a diferenciarse del resto después de un tamaño de lote de 32, ofreciendo el mejor rendimiento en esta carga de trabajo.
En Decode Heavy, los tres sistemas se mantienen muy alineados durante la mayor parte del análisis. Dell varía de 43.19 tok/s a 1,260.24 tok/s, GIGABYTE de 43.53 tok/s a 1,258.05 tok/s y HP de 42.54 tok/s a 1,178.74 tok/s. Dell y GIGABYTE se alternan el liderazgo según el tamaño del lote, mientras que HP se queda ligeramente rezagado con respecto a ambos sistemas en los niveles de concurrencia más altos.
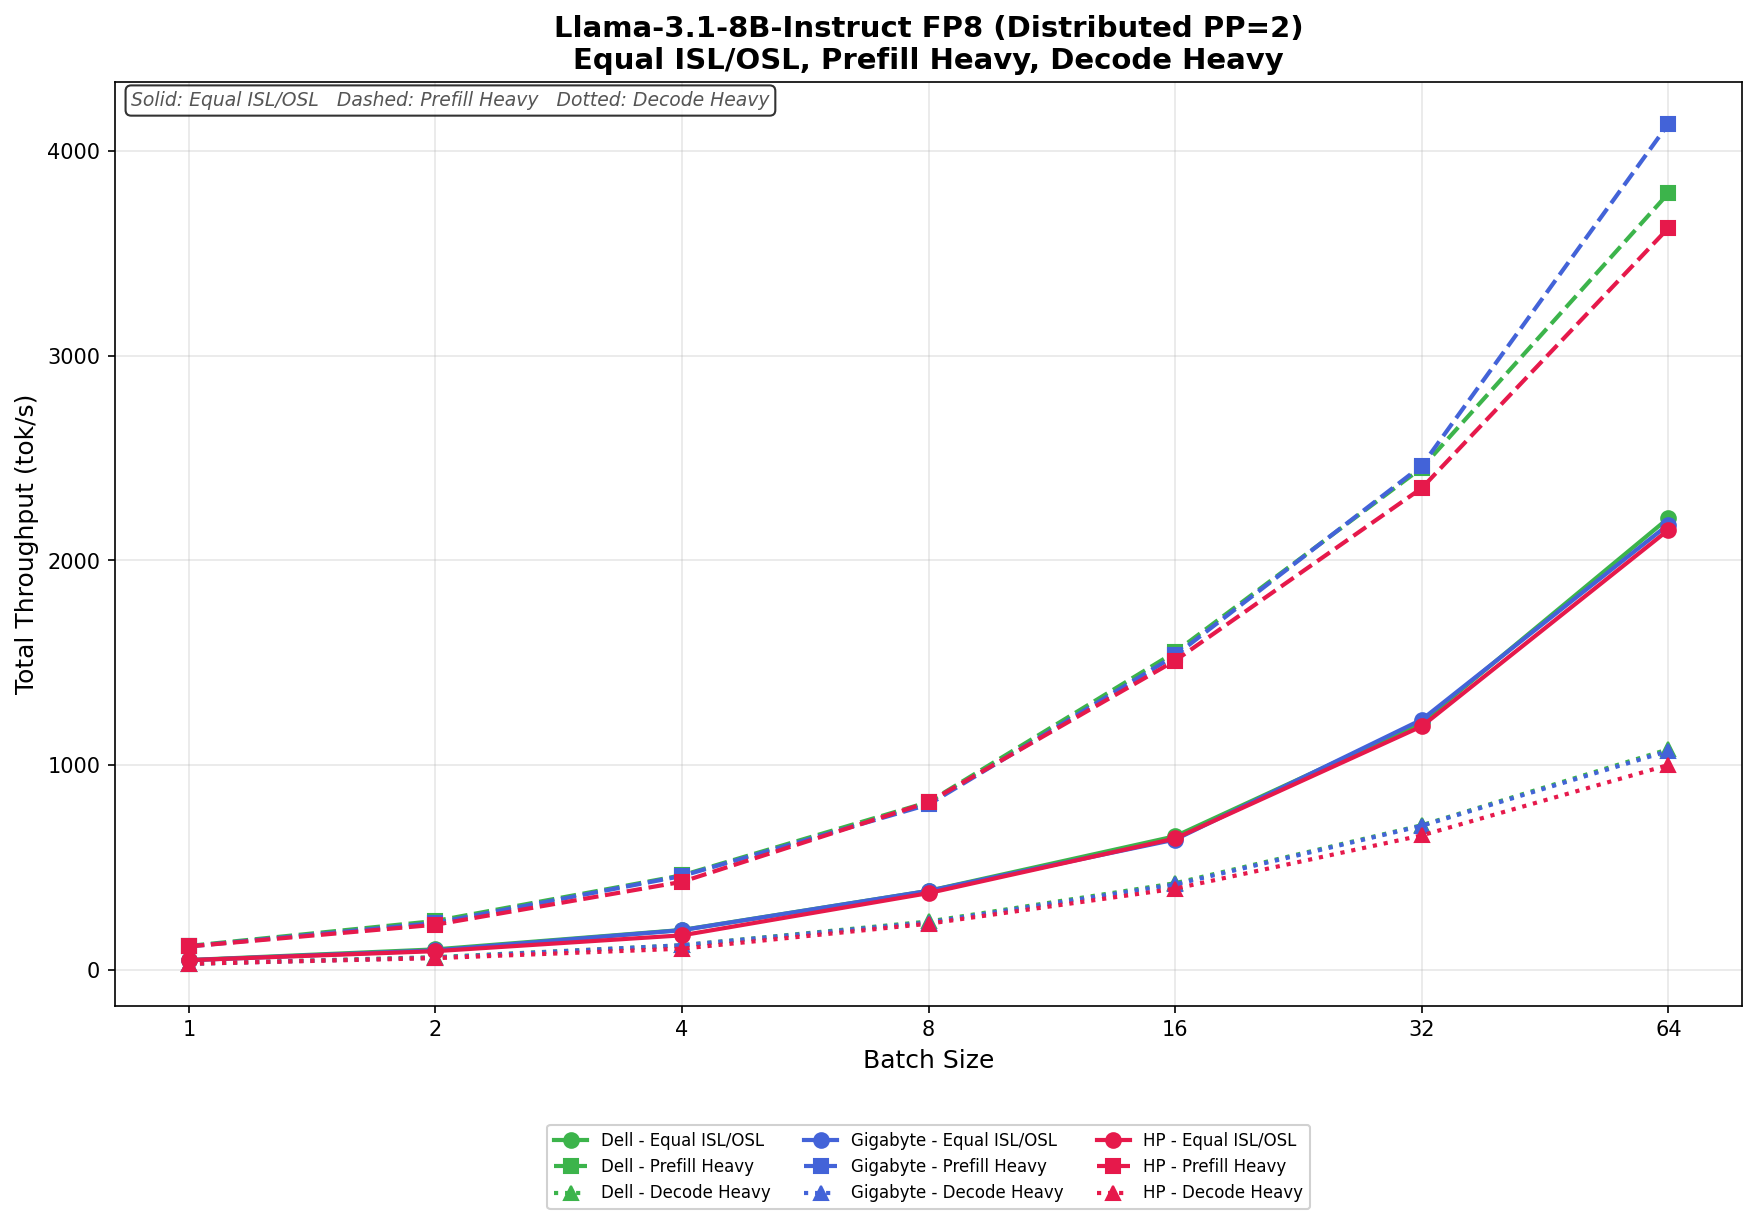
Llama 3.1 8B Instrucción FP8
En Equal ISL/OSL, Dell escala de 46.93 tok/s a 2,206.52 tok/s con un tamaño de lote de 64, mientras que GIGABYTE varía de 46.16 tok/s a 2,175.44 tok/s. HP le sigue de cerca, aumentando de 46.40 tok/s a 2,149.15 tok/s. La diferencia general se mantiene estrecha durante toda la prueba, y los tres sistemas mantienen un comportamiento de escalado casi idéntico hasta un tamaño de lote de 32.
En Prefill Heavy, el rendimiento aumenta de forma más agresiva a medida que aumenta la concurrencia. Dell pasa de 115.85 tok/s a 3,794.52 tok/s, mientras que GIGABYTE obtiene el mejor resultado general, pasando de 113.34 tok/s a 4,133.76 tok/s con un tamaño de lote de 64. HP alcanza los 3,624.73 tok/s. GIGABYTE comienza a establecer una ventaja más pronunciada con tamaños de lote mayores, especialmente a partir del tamaño de lote 32.
En Decode Heavy, los tres sistemas permanecen muy agrupados a niveles bajos de concurrencia antes de que surjan pequeñas diferencias a niveles altos. Dell varía de 29.11 tok/s a 1,077.07 tok/s, GIGABYTE escala de 28.64 tok/s a 1,068.92 tok/s y HP aumenta de 28.68 tok/s a 1,000.20 tok/s. Dell mantiene una ligera ventaja durante la mayor parte de la carga de trabajo, con GIGABYTE pisándole los talones, mientras que HP se queda ligeramente rezagado con tamaños de lote mayores.
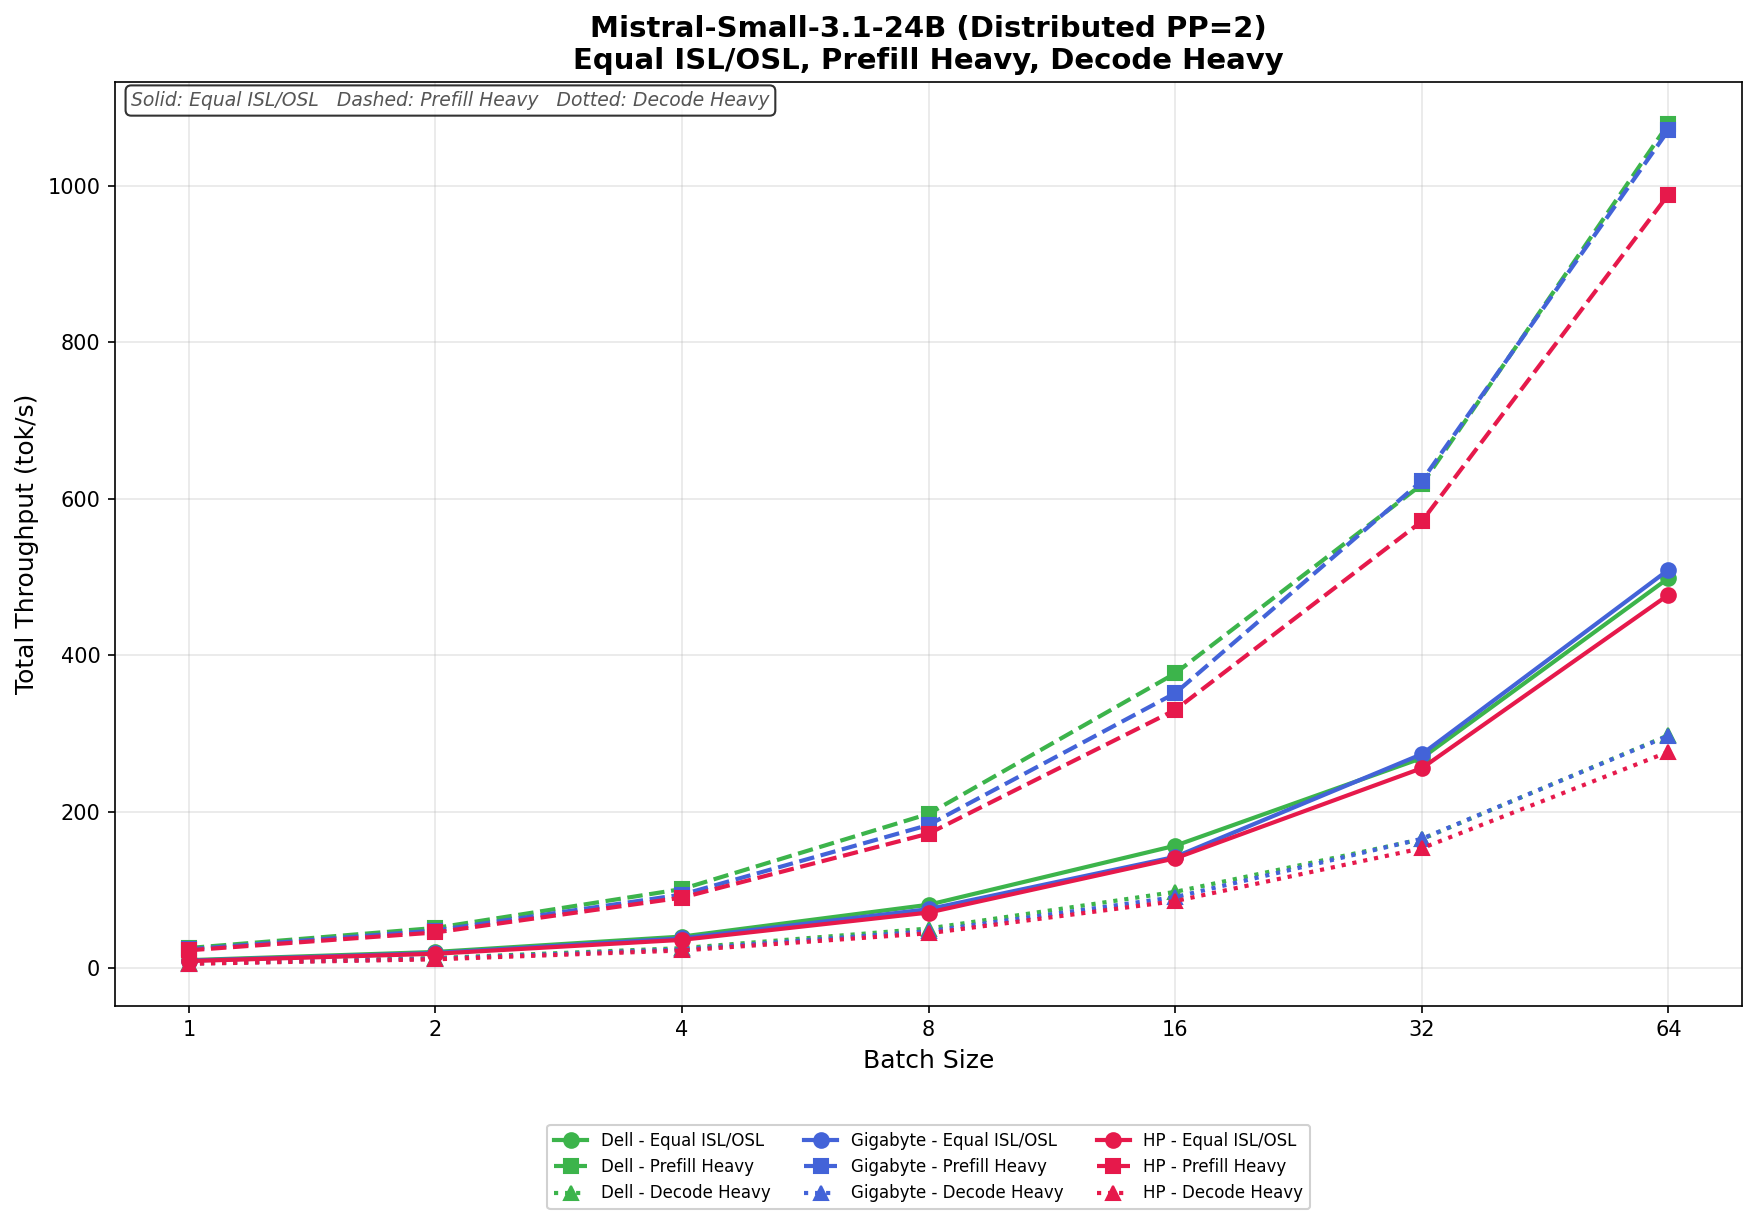
Mistral Pequeño 3.1 24B
En Equal ISL/OSL, Dell escala de 10.41 tok/s a 498.56 tok/s con un tamaño de lote de 64, mientras que GIGABYTE se adelanta ligeramente en el extremo superior, pasando de 9.76 tok/s a 509.18 tok/s. HP se sitúa ligeramente por detrás de ambos sistemas, con un rango de 9.25 tok/s a 477.25 tok/s. La diferencia entre los sistemas se mantiene relativamente pequeña a lo largo de toda la carga de trabajo, especialmente en niveles de concurrencia bajos y medios.
En Prefill Heavy, el rendimiento mejora sustancialmente en los tres sistemas. Dell aumenta de 25.91 tok/s a 1,079.19 tok/s, mientras que GIGABYTE pasa de 24.25 tok/s a 1,071.07 tok/s. HP alcanza los 988.82 tok/s con un tamaño de lote de 64. Dell y GIGABYTE mantienen un rendimiento casi idéntico durante la mayor parte de la prueba, con Dell ligeramente por delante en el nivel de concurrencia más alto.
En Decode Heavy, el rendimiento general sigue siendo significativamente menor, como era de esperar para una carga de trabajo centrada en la decodificación en un modelo más grande. Dell presenta un rendimiento que oscila entre 6.49 tok/s y 297.82 tok/s, GIGABYTE entre 6.10 tok/s y 297.23 tok/s, y HP entre 5.77 tok/s y 276.55 tok/s. Dell y GIGABYTE mantienen un rendimiento similar durante toda la prueba, mientras que HP se queda ligeramente rezagado con respecto a ambos sistemas en lotes de mayor tamaño.
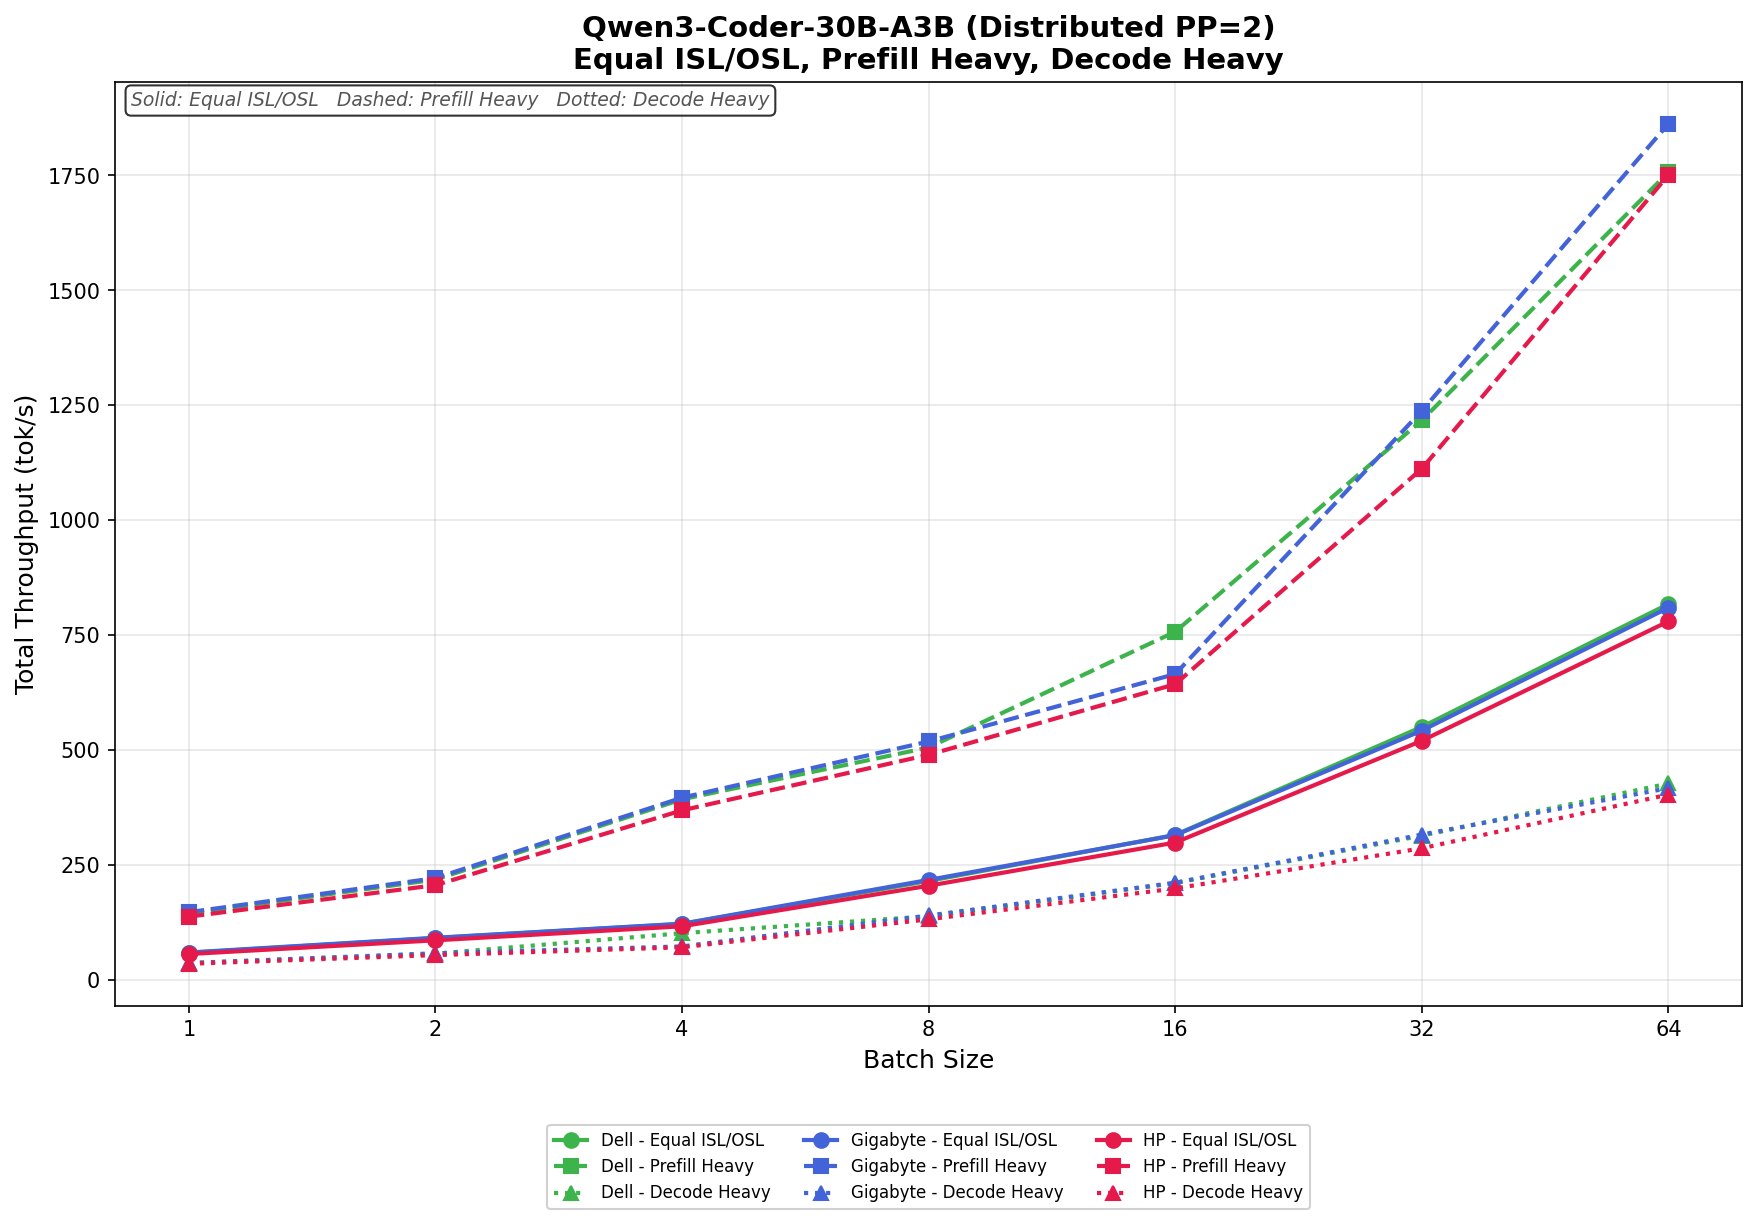
Codificador Qwen3 30B A3B Base
En Equal ISL/OSL, Dell escala de 59.05 tok/s a 817.82 tok/s con un tamaño de lote de 64, mientras que GIGABYTE varía de 59.81 tok/s a 809.88 tok/s. HP se queda ligeramente atrás de ambos sistemas, aumentando de 56.51 tok/s a 780.21 tok/s. El rendimiento entre Dell y GIGABYTE se mantiene prácticamente idéntico durante la mayor parte del análisis, con solo pequeñas variaciones en tamaños de lote mayores.
En Prefill Heavy, el rendimiento aumenta significativamente a medida que aumenta la concurrencia. Dell pasa de 144.81 tok/s a 1,756.99 tok/s, mientras que GIGABYTE registra la mayor escalabilidad general, pasando de 147.55 tok/s a 1,862.40 tok/s con un tamaño de lote de 64. HP alcanza los 1,751.17 tok/s, manteniéndose competitivo pero ligeramente por detrás de los otros dos sistemas en el extremo superior. GIGABYTE establece una modesta ventaja a partir de un tamaño de lote de 32 y la extiende hasta la etapa final de la prueba.
En Decode Heavy, los tres sistemas se mantienen muy similares durante la mayor parte de la carga de trabajo. Dell presenta un rendimiento que oscila entre 36.69 tok/s y 427.48 tok/s, GIGABYTE entre 36.92 tok/s y 417.42 tok/s, y HP entre 35.30 tok/s y 403.32 tok/s. Dell mantiene una ligera ventaja en los lotes de mayor tamaño, mientras que HP se queda ligeramente rezagada con respecto a Dell y GIGABYTE en la carga de trabajo centrada en la decodificación.
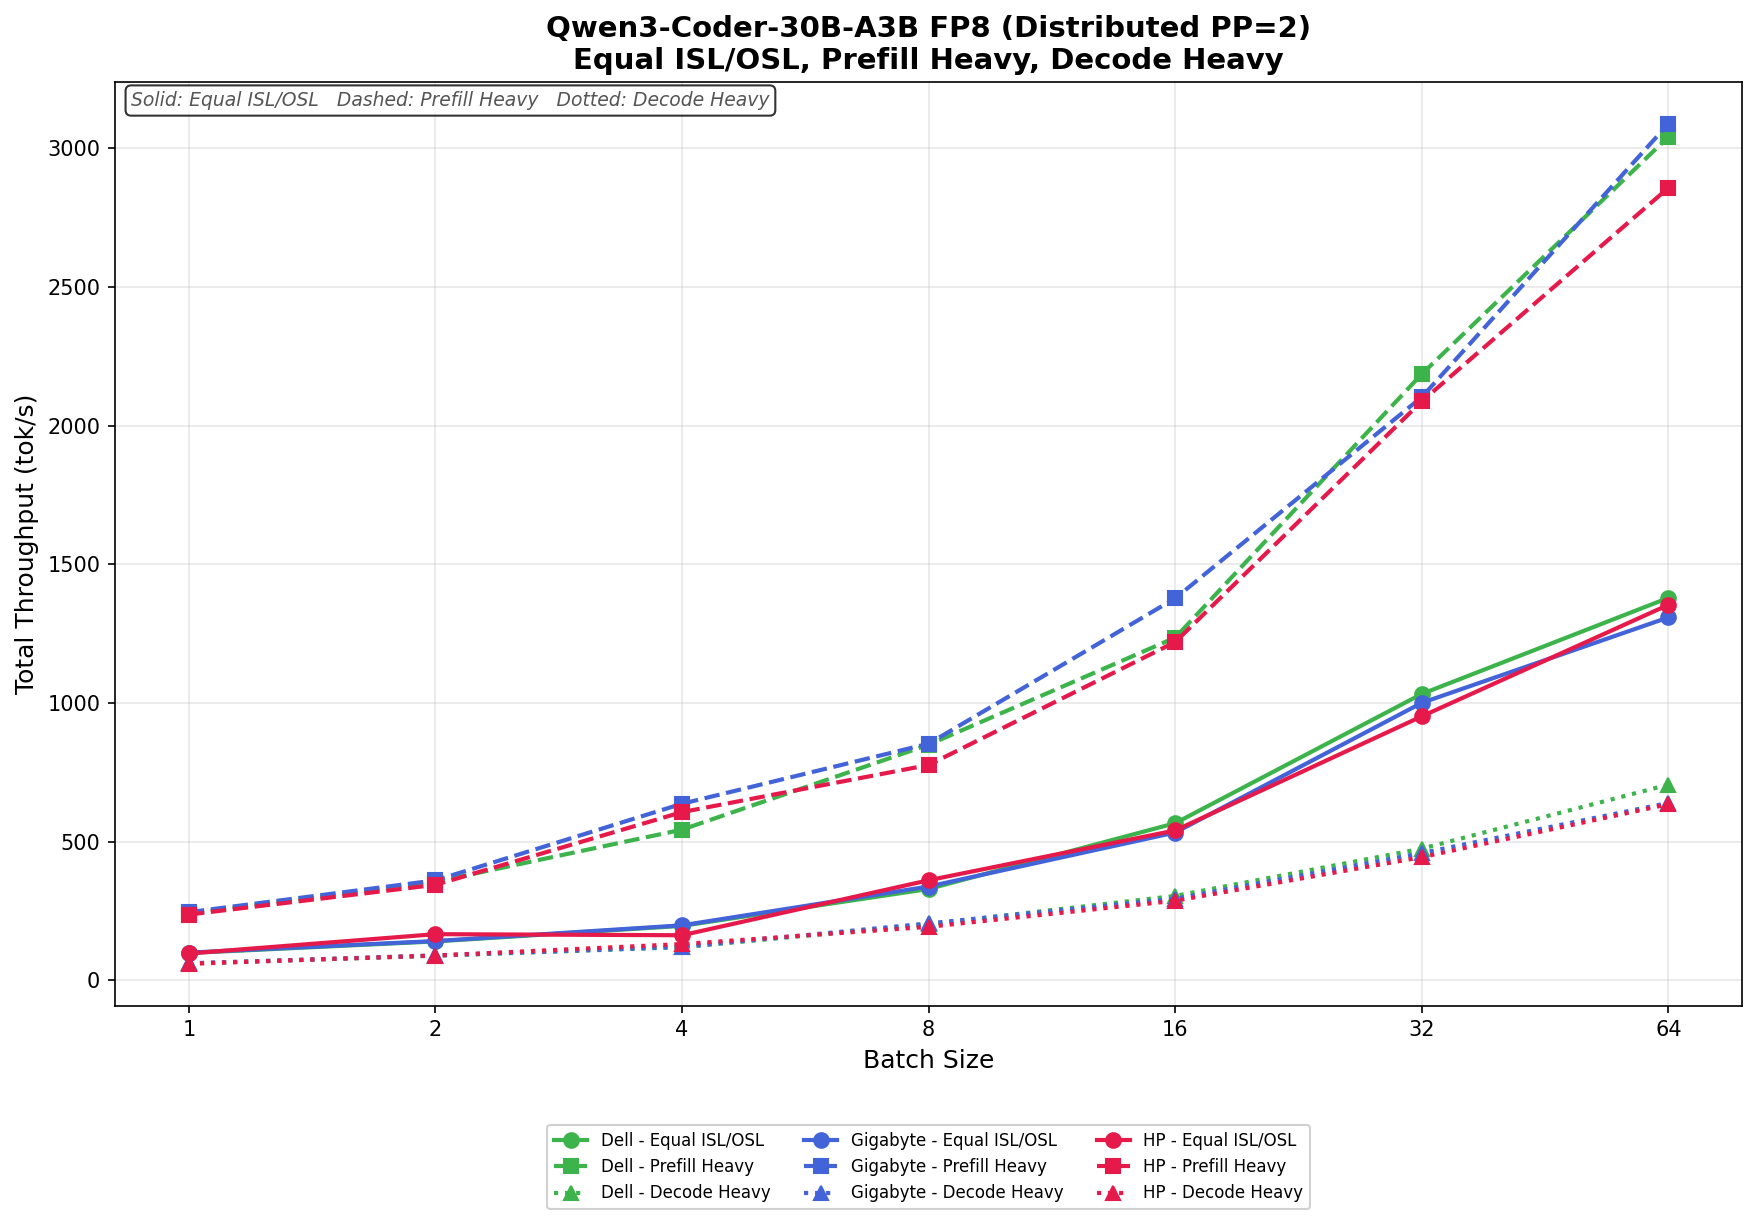
Codificador Qwen3 30B A3B FB8
En Equal ISL/OSL, Dell escala de 98.65 tok/s a 1,379.26 tok/s con un tamaño de lote de 64, mientras que GIGABYTE varía de 100.20 tok/s a 1,308.79 tok/s. HP se mantiene competitivo en todo momento, aumentando de 97.06 tok/s a 1,354.23 tok/s. HP lidera brevemente en varios tamaños de lote bajos y medios, aunque Dell finaliza con el mejor rendimiento general en el rango superior.
En Prefill Heavy, el rendimiento aumenta drásticamente en los tres sistemas. Dell pasa de 240.43 tok/s a 3,041.72 tok/s, mientras que GIGABYTE obtiene el mejor resultado general, pasando de 245.92 tok/s a 3,088.62 tok/s con un tamaño de lote de 64. HP alcanza los 2,857.80 tok/s. GIGABYTE establece una ventaja notable a partir del tamaño de lote 4 y la mantiene durante el resto de la prueba.
En Decode Heavy, Dell presenta el mejor rendimiento general en la gama alta. Dell alcanza entre 60.91 tok/s y 705.77 tok/s, mientras que GIGABYTE escala de 61.53 tok/s a 639.80 tok/s, y HP aumenta de 59.85 tok/s a 635.25 tok/s. HP lidera brevemente con tamaños de lote pequeños, pero Dell se impone con niveles de concurrencia mayores, finalizando con el mejor rendimiento de decodificación del grupo.
Resumen de la potencia máxima de los sistemas de doble bujía
La tabla que aparece a continuación resume el rendimiento máximo de tokens observado durante las pruebas con PP distribuido = 2 en los sistemas dual-Spark de Dell, GIGABYTE y HP. Cada valor representa el rendimiento máximo medido (tok/s) alcanzado para ese escenario de carga de trabajo con el tamaño de lote probado. Las cifras en negrita indican el sistema con mejor rendimiento en ese escenario de carga de trabajo específico.
| Modelo | Escenario (BS – 64) | Rendimiento máximo de Dell | Salida máxima de GIGABYTE | Potencia máxima en HP |
|---|---|---|---|---|
| Modelos GPT-OSS | ||||
| GPT-OSS-120B | ISL/OSL iguales | 463.97 tok/s | 497.26 tok/s | 504.88 tok/s |
| GPT-OSS-120B | Relleno previo pesado | 419.56 tok/s | 417.34 tok/s | 441.63 tok/s |
| GPT-OSS-120B | Decodificar pesado | 451.18 tok/s | 494.37 tok/s | 474.85 tok/s |
| GPT-OSS-20B | ISL/OSL iguales | 976.77 tok/s | 952.31 tok/s | 915.72 tok/s |
| GPT-OSS-20B | Relleno previo pesado | 852.39 tok/s | 802.37 tok/s | 757.05 tok/s |
| GPT-OSS-20B | Decodificar pesado | 938.65 tok/s | 945.55 tok/s | 865.78 tok/s |
| Modelos de llamas | ||||
| Llama-3.1-8B-Instruir | ISL/OSL iguales | 689.53 tok/s | 687.48 tok/s | 618.87 tok/s |
| Llama-3.1-8B-Instruir | Relleno previo pesado | 515.45 tok/s | 539.27 tok/s | 463.39 tok/s |
| Llama-3.1-8B-Instruir | Decodificar pesado | 581.43 tok/s | 576.91 tok/s | 531.07 tok/s |
| Llama-3.1-8B-FP4 | ISL/OSL iguales | 1427.39 tok/s | 1458.86 tok/s | 1413.51 tok/s |
| Llama-3.1-8B-FP4 | Relleno previo pesado | 884.22 tok/s | 954.23 tok/s | 843.57 tok/s |
| Llama-3.1-8B-FP4 | Decodificar pesado | 1008.98 tok/s | 1007.23 tok/s | 943.73 tok/s |
| Llama-3.1-8B-FP8 | ISL/OSL iguales | 1105.42 tok/s | 1089.85 tok/s | 1076.68 tok/s |
| Llama-3.1-8B-FP8 | Relleno previo pesado | 759.50 tok/s | 827.40 tok/s | 725.51 tok/s |
| Llama-3.1-8B-FP8 | Decodificar pesado | 862.33 tok/s | 855.81 tok/s | 800.78 tok/s |
| Modelos Mistral y Qwen | ||||
| Mistral-Pequeño-3.1-24B | ISL/OSL iguales | 249.77 tok/s | 255.09 tok/s | 239.09 tok/s |
| Mistral-Pequeño-3.1-24B | Relleno previo pesado | 216.01 tok/s | 214.38 tok/s | 197.92 tok/s |
| Mistral-Pequeño-3.1-24B | Decodificar pesado | 238.44 tok/s | 237.97 tok/s | 221.41 tok/s |
Conclusión
La conclusión más útil de esta ronda de pruebas tiene poco que ver con qué fabricante de equipos originales (OEM) obtuvo mejores resultados en cada carga de trabajo. En todos los modelos y tipos de carga de trabajo que probamos, las tres implementaciones de Spark de Dell, GIGABYTE y HP se mantuvieron dentro de un rango estrecho. Se observaron pequeñas ventajas en lotes específicos, pero ninguna plataforma ganó de forma absoluta, ni ninguna se quedó atrás de forma consistente. Los compradores que elijan entre las tres deberían basar su decisión en el diseño del chasis, el comportamiento térmico, los términos de la garantía y la relación con el soporte, en lugar de en las diferencias en los benchmarks, que son similares a la variabilidad entre ejecuciones que produce cualquier sistema de escritorio bajo carga sostenida.
El resultado más interesante es metodológico. En la estructura de 200 GbE que conecta dos Sparks, la elección entre paralelismo tensorial y paralelismo de pipeline importa más que cualquier diferencia entre los tres OEM, y para la inferencia por lotes con cualquier concurrencia razonable, el paralelismo de pipeline es la mejor opción. El tráfico de reducción total por capa de TP=2 no sobrevive al viaje a través de un enlace ConnectX-7 sin dejar la computación inactiva, y el costo de burbuja de pipeline de PP=2 se amortiza en el flujo de estado estable tan pronto como el lote llena el pipeline. La documentación de NVIDIA usa TP por defecto por una razón justificable: su posicionamiento principal para Spark es el servicio interactivo de flujo único con TTFT ajustado, que es el único régimen donde TP=2 gana directamente. En el momento en que la carga de trabajo se parece a servir infraestructura en lugar de una interfaz de chat, el cálculo se invierte.
Esa inversión refuerza lo que Spark es y no es. Un clúster Spark de dos nodos es una plataforma de desarrollo y aprendizaje que permite a un solo ingeniero observar de primera mano el comportamiento de la inferencia distribuida en una red lo suficientemente rápida como para imitar la infraestructura de un centro de datos real, pero lo suficientemente limitada como para exponer los cuellos de botella que las implementaciones de producción sortean a gran escala.
Vale la pena analizar configuraciones de Spark de mayor tamaño, considerando cargas de trabajo y estrategias de paralelismo adecuadas a esa escala, y tenemos previsto trabajar en ello. Por otro lado, el siguiente experimento, que sigue a este, pasa de la inferencia al entrenamiento: un modelo con menos de mil millones de parámetros, entrenado desde cero en un clúster dual de Spark, configurado para replicar las condiciones de preentrenamiento distribuido de sistemas mucho más grandes. Este trabajo está en pausa mientras esperamos la instalación de la óptica para nuestro nuevo conmutador central de laboratorio de 800 Gb, y esperamos publicarlo una vez que el nuevo núcleo esté operativo.


 Amazon