

QSAN ha desarrollado soluciones de almacenamiento empresarial desde 2004, y esa experiencia se refleja en la línea XN4. El XN4226D de nuestro laboratorio es una matriz 2U, 26 bahías, totalmente NVMe con controladores activos duales, que ofrece alta disponibilidad como almacenamiento unificado de bloques y archivos. El software QSM 4 incorpora los servicios de datos esperados, como instantáneas, opciones de replicación, reducción de datos y una experiencia de gestión sencilla. El XN4 está diseñado para equipos que buscan la velocidad de NVMe sin comprometer la flexibilidad multiprotocolo, todo a un precio muy accesible.
Puntos Clave
- Bloque y archivo unificados con HA real. Los controladores activos duales y QSM 4 brindan alta disponibilidad con una plataforma para bloques y archivos.
- NVMe-oF bien hecho. Protocolo completo distribuido con NVMe-oF sobre TCP y RDMA junto con iSCSI, Fibre Channel, NFS, SMB, FTP y WebDAV.
- Rendimiento comprobado. Medimos hasta 21.21 GB/s en lecturas secuenciales grandes con TCP y 11.14 GB/s en escrituras secuenciales grandes con RDMA.
- Diseñado para tuberías modernas. 26 bahías totalmente NVMe en 2U, administración sencilla y opciones de E/S que escalan a 100–200 GbE para medios, análisis de vigilancia, VDI, bases de datos e inferencia de IA.
La plataforma admite NVMe-oF sobre TCP y RDMA, además de iSCSI, Fibre Channel, NFS, SMB, FTP y WebDAV. También realizamos un estudio específico de NVMe-oF que compara el comportamiento y el escalado de TCP y RDMA. En nuestras pruebas, llevamos la unidad al límite con grandes lecturas secuenciales, logrando un impresionante rendimiento de 21.21 GB/s. La adaptación de este sistema es tan importante como las cifras. El XN4226D es compatible con entornos mixtos que combinan VMware o Proxmox para máquinas virtuales, VDI y niveles de base de datos, así como con servicios de archivos creativos, nodos de inferencia de IA que requieren rutas NVMe predecibles, copias de seguridad de medios e ingesta de alto ancho de banda para cargas de trabajo de vigilancia y sensores. El QSAN XN4226D es ideal para prácticamente cualquier carga de trabajo.
QSAN ha observado un crecimiento significativo en la producción de medios, incluyendo transmisiones en vivo, opciones de repetición, mejora de video con IA y almacenamiento en caché OTT/edge, así como en análisis de videovigilancia, como CCTV para ciudades inteligentes, detección de anomalías y repetición en tiempo real. Estas cargas de trabajo se soportan idealmente con un rendimiento de 100-200 GbE.
En definitiva, el valor es evidente. Obtendrá alta disponibilidad unificada, NVMe en todo el chasis y opciones de E/S de hasta 100 GbE o 32 Gb de Fibre Channel según aumenten sus necesidades. El rendimiento se ajusta al de muchas matrices de nivel 1, mientras que las licencias siguen siendo más accesibles y la cobertura de protocolos se mantiene amplia en NVMe-oF, iSCSI, Fibre Channel, SMB y NFS. Para las empresas que consideran InfiniBand pero tienen un presupuesto limitado, el enfoque Ethernet de QSAN ofrece una capacidad de respuesta cercana a la de IB en equipos estándar a una escala de 100 a 200 GbE.
Para los equipos que priorizan los resultados de aplicaciones del mundo real, la longevidad, el software intuitivo y el diseño de hardware limpio de QSAN hacen del XN4226D un caballo de batalla all-flash creíble sobre el cual construir.
Hardware QSAN XN4
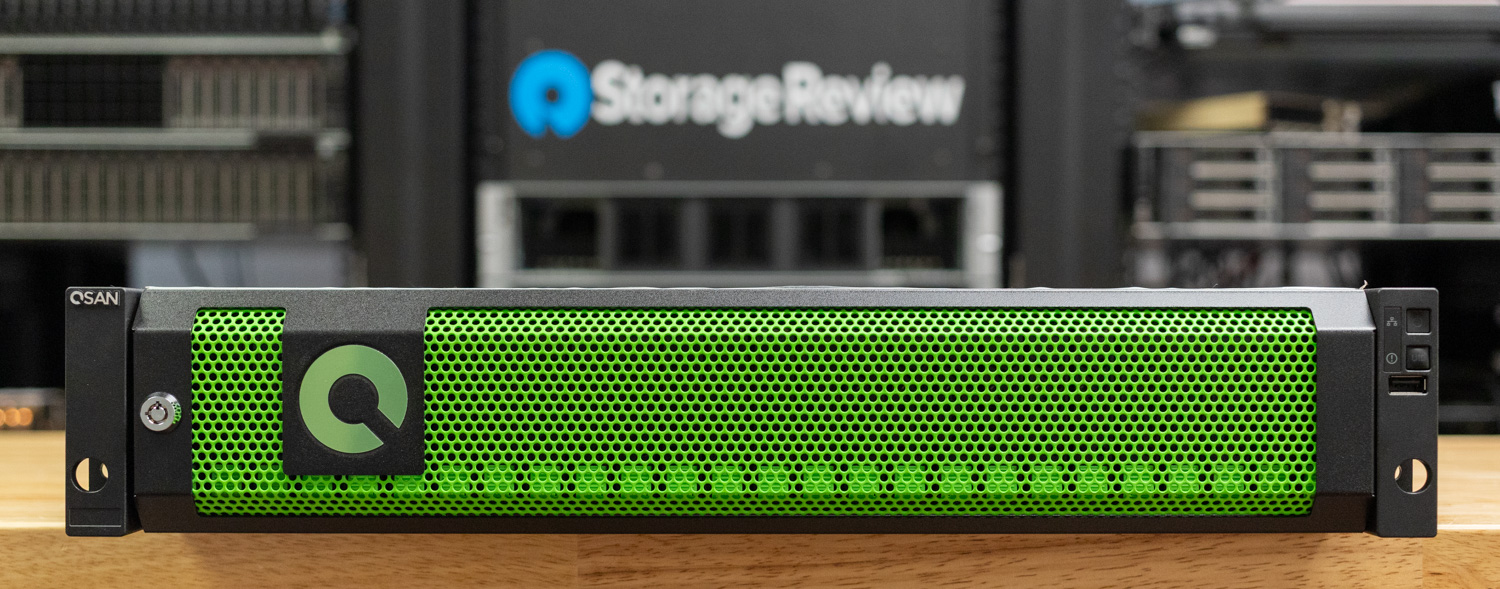
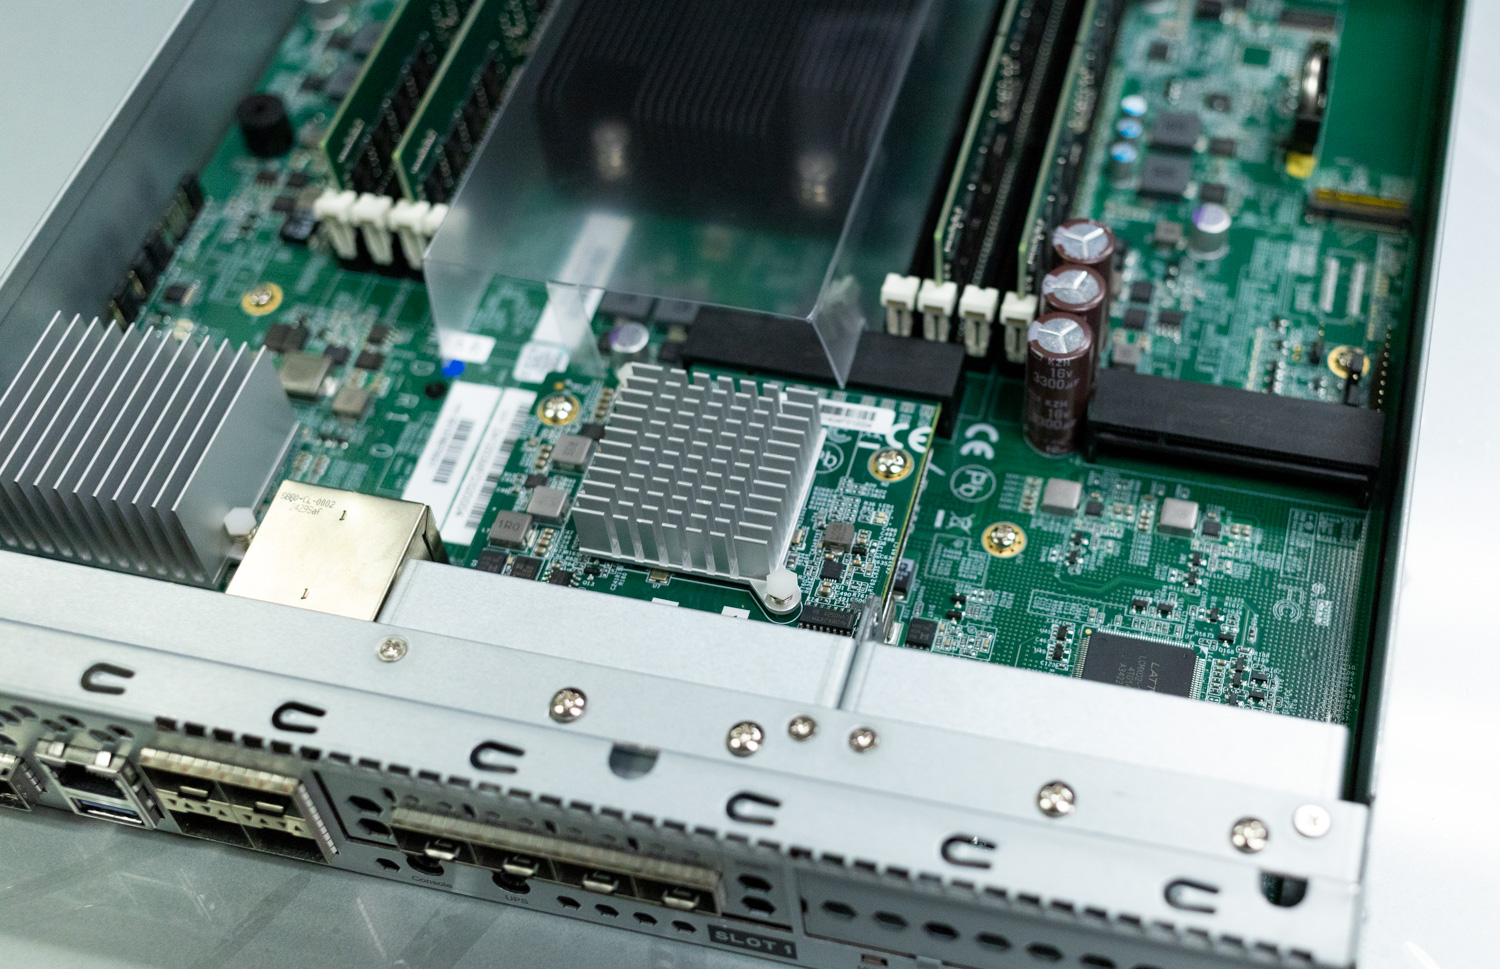
Las matrices de almacenamiento de la serie QSAN XN4 se presentan en un chasis de servidor de 26 bahías, 2U y 19", compatible con racks, con opciones de controlador único o doble que albergan CPU Intel Xeon de 4 u 8 núcleos para satisfacer las necesidades de redundancia y rendimiento de las operaciones más pequeñas y grandes. Con las 26 bahías ocupadas, un solo chasis de la serie XN4 puede albergar hasta 798 terabytes de datos en unidades de estado sólido NVMe U.2/U.3 de 2.5". También se pueden añadir hasta 20 unidades de expansión conectadas mediante SAS, lo que aumenta la capacidad total de una matriz a la impresionante cifra de 16.773 petabytes.
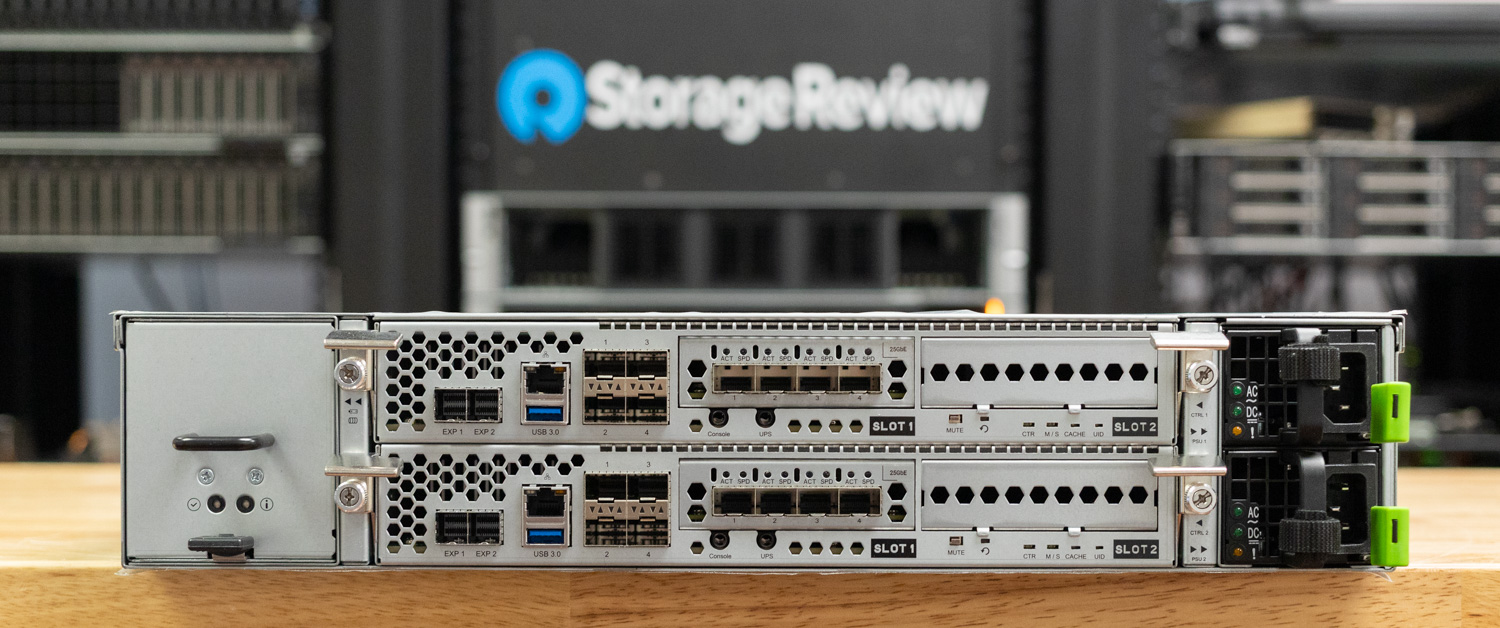
Cada controlador integrado cuenta con un puerto Ethernet RJ45 de 2.5 Gbps, cuatro puertos SFP+ de 10 Gbps y dos puertos SAS de 12 Gbps. También existen opciones de actualización para puertos RJ45 de 10 Gbps, SFP28 de 25 Gbps y QSFP de 100 Gbps. También se puede añadir compatibilidad con Fibre Channel con adaptadores SFP+ de 16 Gbps y SFP28 de 32 Gbps.
La siguiente tabla compara las especificaciones de los sistemas de almacenamiento XN4226D-4C y XN4226S-4C. Se trata de las variantes de 4C, diseñadas con controladores duales activos o de uno actualizable, según el modelo. Para implementaciones que requieren mayor capacidad de procesamiento, también está disponible una versión de 8C de estos sistemas.
| Especificación | XN4226D-4C | XN4226S-4C |
|---|---|---|
| Nombre de Modelo | XN4226D-4C | XN4226S-4C |
| Arquitectura de interiores | Controlador dual-activo | Controlador actualizable individualmente |
| CPU | Intel® Xeon® de 4 núcleos × 2 | Intel® Xeon® de 4 núcleos |
| Salud Cerebral | ||
| Módulo de memoria preinstalado | 32GB DDR4 RDIMM | 16GB DDR4 RDIMM |
| Ranuras de memoria total | 16 | 8 |
| Memoria ampliable hasta | 2,048GB | 1,024GB |
| Almacenaje | ||
| compartimentos de unidad | Ranura de 2.5″ × 26 | Ranura de 2.5″ × 26 |
| Número máximo de bahías de unidad con unidad de expansión | 546 | 546 |
| Tipo de unidad compatible | SSD NVMe U.2/U.3 de dos puertos de 2.5″ SSD SAS de 2.5″ (para unidades de expansión) Disco duro SAS de 3.5″ (para unidades de expansión) |
SSD NVMe U.2/U.3 de un solo puerto de 2.5″ SSD SAS de 2.5″ (para unidades de expansión) Disco duro SAS de 3.5″ (para unidades de expansión) |
| Interfaz de accionamiento | U.2 NVMe (PCIe Gen 4) SAS 12 Gb/s (para unidades de expansión) |
U.2 NVMe (PCIe Gen 4) SAS 12 Gb/s (para unidades de expansión) |
| Capacidad bruta interna máxima | 798TB | 798TB |
| Capacidad máxima bruta con expansión | 16,773TB | 16,773TB |
| Unidad intercambiable en caliente | Sí: | Sí: |
| Puerto de conectividad | ||
| Expansión PCIe | (ranura Gen 4×8) × 4 | (ranura Gen 4×8) × 2 |
| Puerto LAN RJ45 de 2.5 GbE | 2 (a bordo) | 1 (a bordo) |
| Puerto LAN SFP+ de 10 GbE | 8 (a bordo) / 16 (opcional) | 4 (a bordo) / 8 (opcional) |
| Puerto LAN RJ45 de 10 GbE | 16 (opción) | 8 (opción) |
| Puerto LAN SFP28 de 25 GbE | 16 (opción) | 8 (opción) |
| Puerto LAN QSFP de 100 GbE | 8 (opción) | 4 (opción) |
| Canal de fibra SFP+ de 16 Gb | 16 (opción) | 8 (opción) |
| Canal de fibra SFP28 de 32 Gb | 16 (opción) | 8 (opción) |
| Expansión y puerto externo | ||
| Puerto ancho SAS de 12 Gb/s | 4 (a bordo) | 2 (a bordo) |
| Puerto USB | 1 (delantero) / 2 (trasero) | 1 (delantero) / 1 (trasero) |
| Otros | Puerto de consola × 2, Puerto de servicio × 2 | Puerto de consola × 1, Puerto de servicio × 1 |
| Especificación de software | ||
| Sistema operativo de almacenamiento | QSM 4 | QSM 4 |
| Tipo de RAID | 0 / 1 / 5 / 6 / 10 / 50 / 60 / 5EE / 6EE / 50EE / 60EE | |
| Eficiencia de almacenamiento | Aprovisionamiento fino / Compresión y deduplicación (opcional) | |
| Aceleración de software | Caché SSD / Nivelación automática / RDMA | |
| Protección de Datos | Instantánea / Asíncrono / Síncrono (opcional) | |
| Servicio de copia de seguridad | Copia de seguridad de Rsync / S3 / Copia de seguridad en la nube / XMirror* / Copia de seguridad de correo electrónico de Microsoft 365 | |
| Seguridad | SSL / SSH / iSCSI CHAP / ISE y SED / WORM / RBAC / ACL de Windows / Antivirus | |
| Protocolos de soporte | CIFS/NFS/FTP/WebDAV/iSCSI/FCP/NVMe-oF | |
| Gestión | Interfaz web / Windows AD / LDAP / API RESTful / SES / LCM | |
| Apariencia | ||
| Dimensión (H × W × D) | 88 × 438 × 573mm | 88 × 438 × 573mm |
| Peso neto | 19.6kg | 16.5kg |
| Peso bruto | 28.6kg | 25.5kg |
| Otros | ||
| Protección de memoria | Módulo de caché a flash (integrado) | |
| Fan del sistema | 8 unidades | 4 unidades |
| Unidad de fuente de alimentación | 850 W × 2 (80 Plus Platinum) | |
| Entrada de energía | 100-240 VCA, 50/60 Hz | |
| Consumo de energía | 812W / 2,770 BTU | |
| Certificación | CE/FCC/BSMI | |
| Garantía estándar | Sistema: 5 años | Módulo de caché a flash: 1 año | |
Capacidades de QSAN XN4
Las matrices XN4 incorporan de serie los protocolos de conexión más recientes necesarios para soportar cómputo de alto rendimiento y modelos de IA con gran consumo de datos, incluyendo NVMe over Fabrics (NVMe-oF) con TCP y RDMA. También son posibles las conexiones mediante iSCSI, NFS, FCP, CIFS/SMB, FTP y WebDAV, lo que permite a la matriz satisfacer las necesidades de almacenamiento de bloques y archivos de centros de datos con una combinación de sistemas heredados y de vanguardia.
Las ventajas de NVMe-oF
Si bien protocolos como iSCSI, NFS y FCP aún se utilizan ampliamente en aplicaciones de almacenamiento empresarial, NVMe-oF ofrece mejoras significativas en la latencia. Los estándares NVMe se diseñaron desde cero para unidades de estado sólido conectadas directamente al bus PCIe del sistema. En cambio, protocolos más antiguos como iSCSI y NFS se desarrollaron considerando las limitaciones y los tiempos de acceso más lentos de los discos duros tradicionales. En casi todos los casos, las tecnologías NVMe-oF superan a los protocolos de conexión más antiguos, con mayor ancho de banda y tiempos de acceso más rápidos. NVMe-oF también puede aprovechar las interfaces de red con capacidades de acceso directo a memoria remota (RDMA), lo que permite transferir datos directamente a la memoria de un ordenador de destino sin necesidad de procesamiento de la CPU.
Funciones de reducción y optimización de datos
La pila de hardware de alto rendimiento de la matriz de almacenamiento XN4 se ve reforzada por numerosas funciones de software reconocidas y apreciadas por los administradores de almacenamiento. El aprovisionamiento fino, la compresión y la deduplicación permiten a las empresas maximizar la capacidad de su SAN, mientras que el almacenamiento en caché SSD y la organización automática del almacenamiento por niveles aceleran el acceso a los archivos y objetos de uso frecuente. El sistema operativo QSM 4 del dispositivo también facilita la prueba y la reversión de cambios con herramientas de instantáneas integradas.
Funciones de seguridad y administración
QSAN ha tenido en cuenta las cambiantes necesidades de seguridad y gestión de sus clientes con la línea XN4. El XN4 es compatible con Borrado Seguro Instantáneo (ISE) y Unidades de Autocifrado (SED), así como con protocolos de seguridad como SSL/TLS, autenticación mediante Control de Acceso Basado en Roles (RBAC) y compatibilidad con servidores Active Directory/LDAP. La matriz se puede gestionar mediante una interfaz web HTTPS o una API RESTful, lo que permite la automatización mediante una amplia variedad de herramientas, como Ansible o Terraform.
Gestión de QSM 4
QSM 4, el sistema operativo de la serie QSAN XN4, facilita la configuración y la gestión de la matriz de almacenamiento a administradores de almacenamiento de todos los niveles. La implementación inmediata es sencilla: creación rápida de grupos, asignación intuitiva de host y gestión sencilla mediante interfaz web y API REST; todo ello diseñado para equipos de TI pequeños sin amplia experiencia en almacenamiento.
La pantalla del Panel de control muestra información sobre el estado del sistema y los eventos recientes registrados por el servidor.
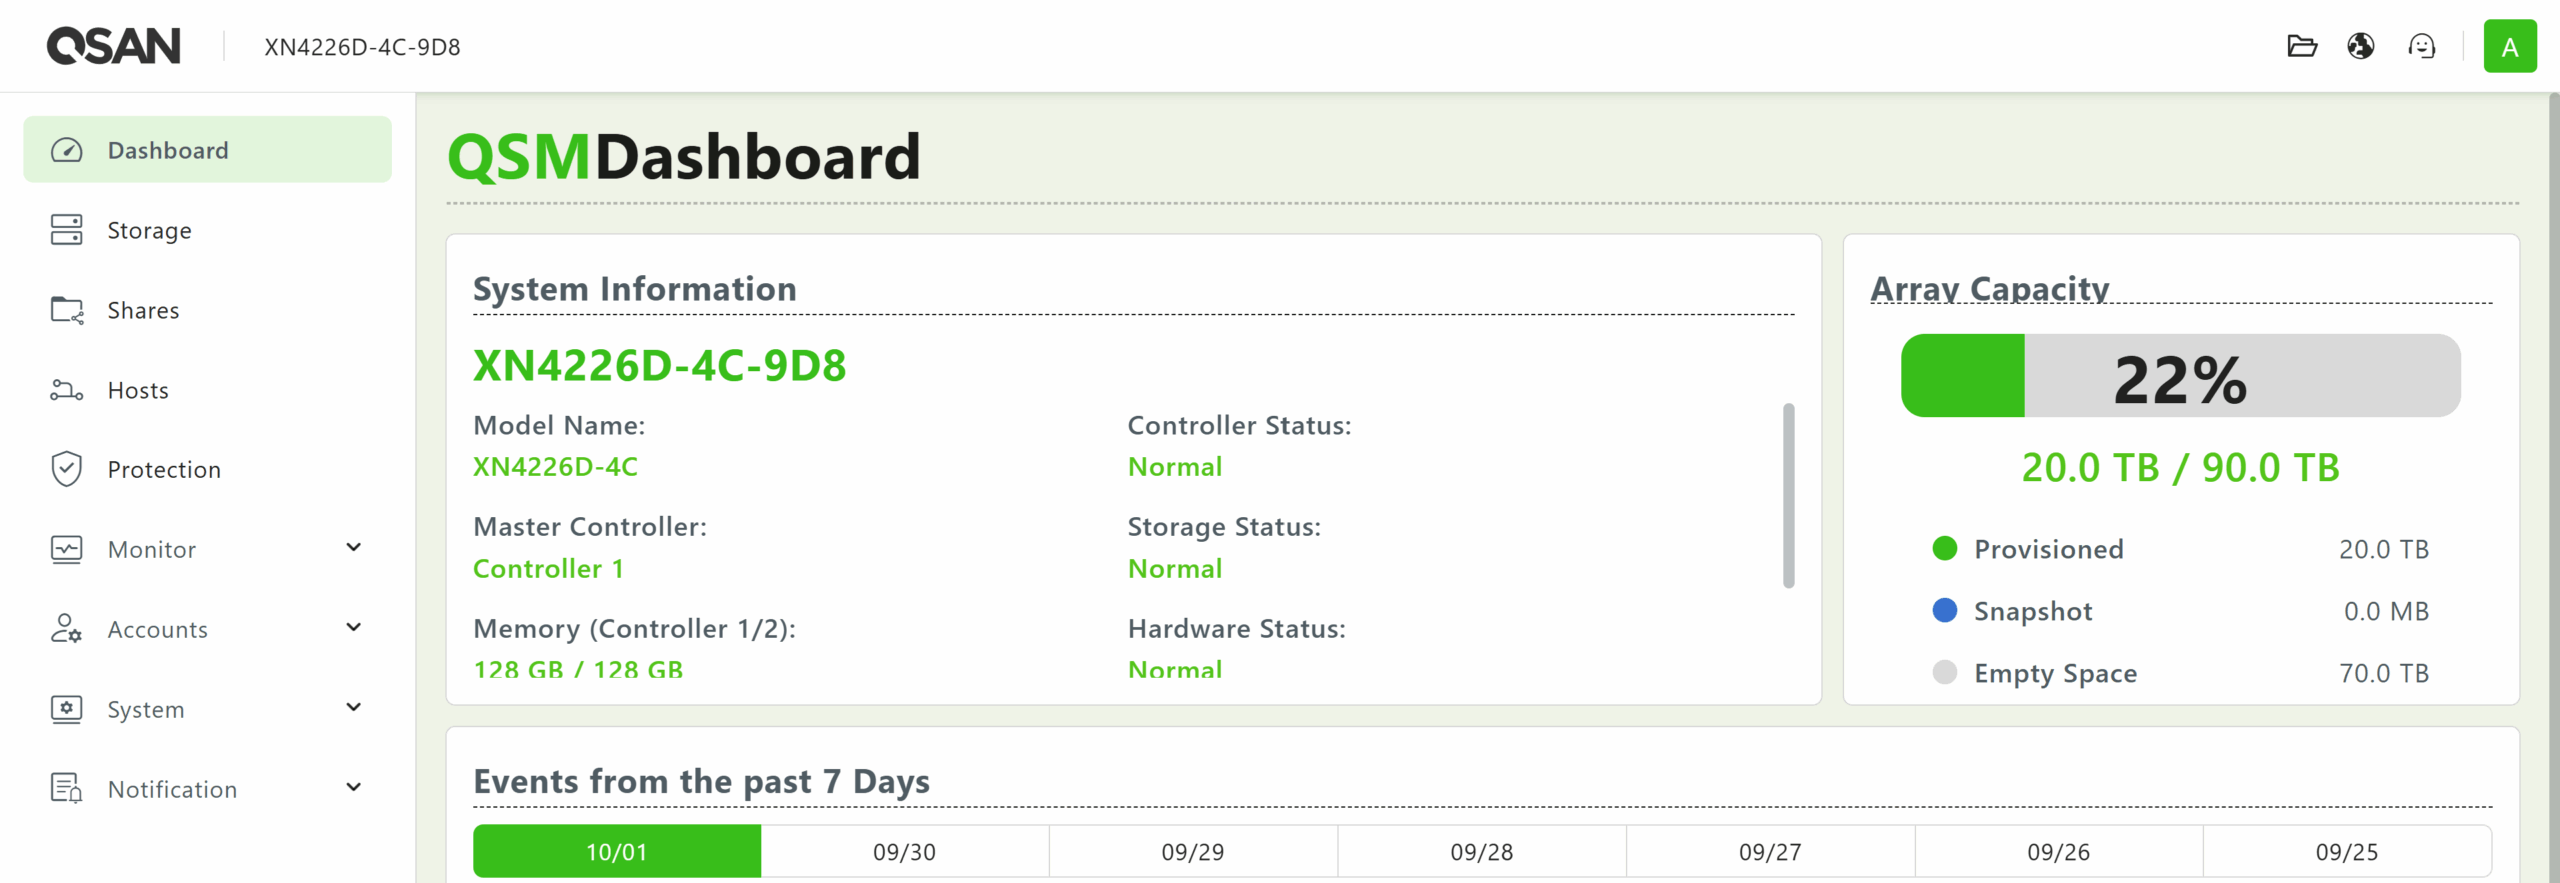
Tras iniciar sesión, se muestra el Panel de Control, que ofrece una visión general del estado de la SAN. Desde aquí, se puede acceder a cualquier submenú de la lista del panel de la izquierda.
Desde el menú Almacenamiento, los administradores pueden crear y administrar grupos de unidades y sus volúmenes asociados.
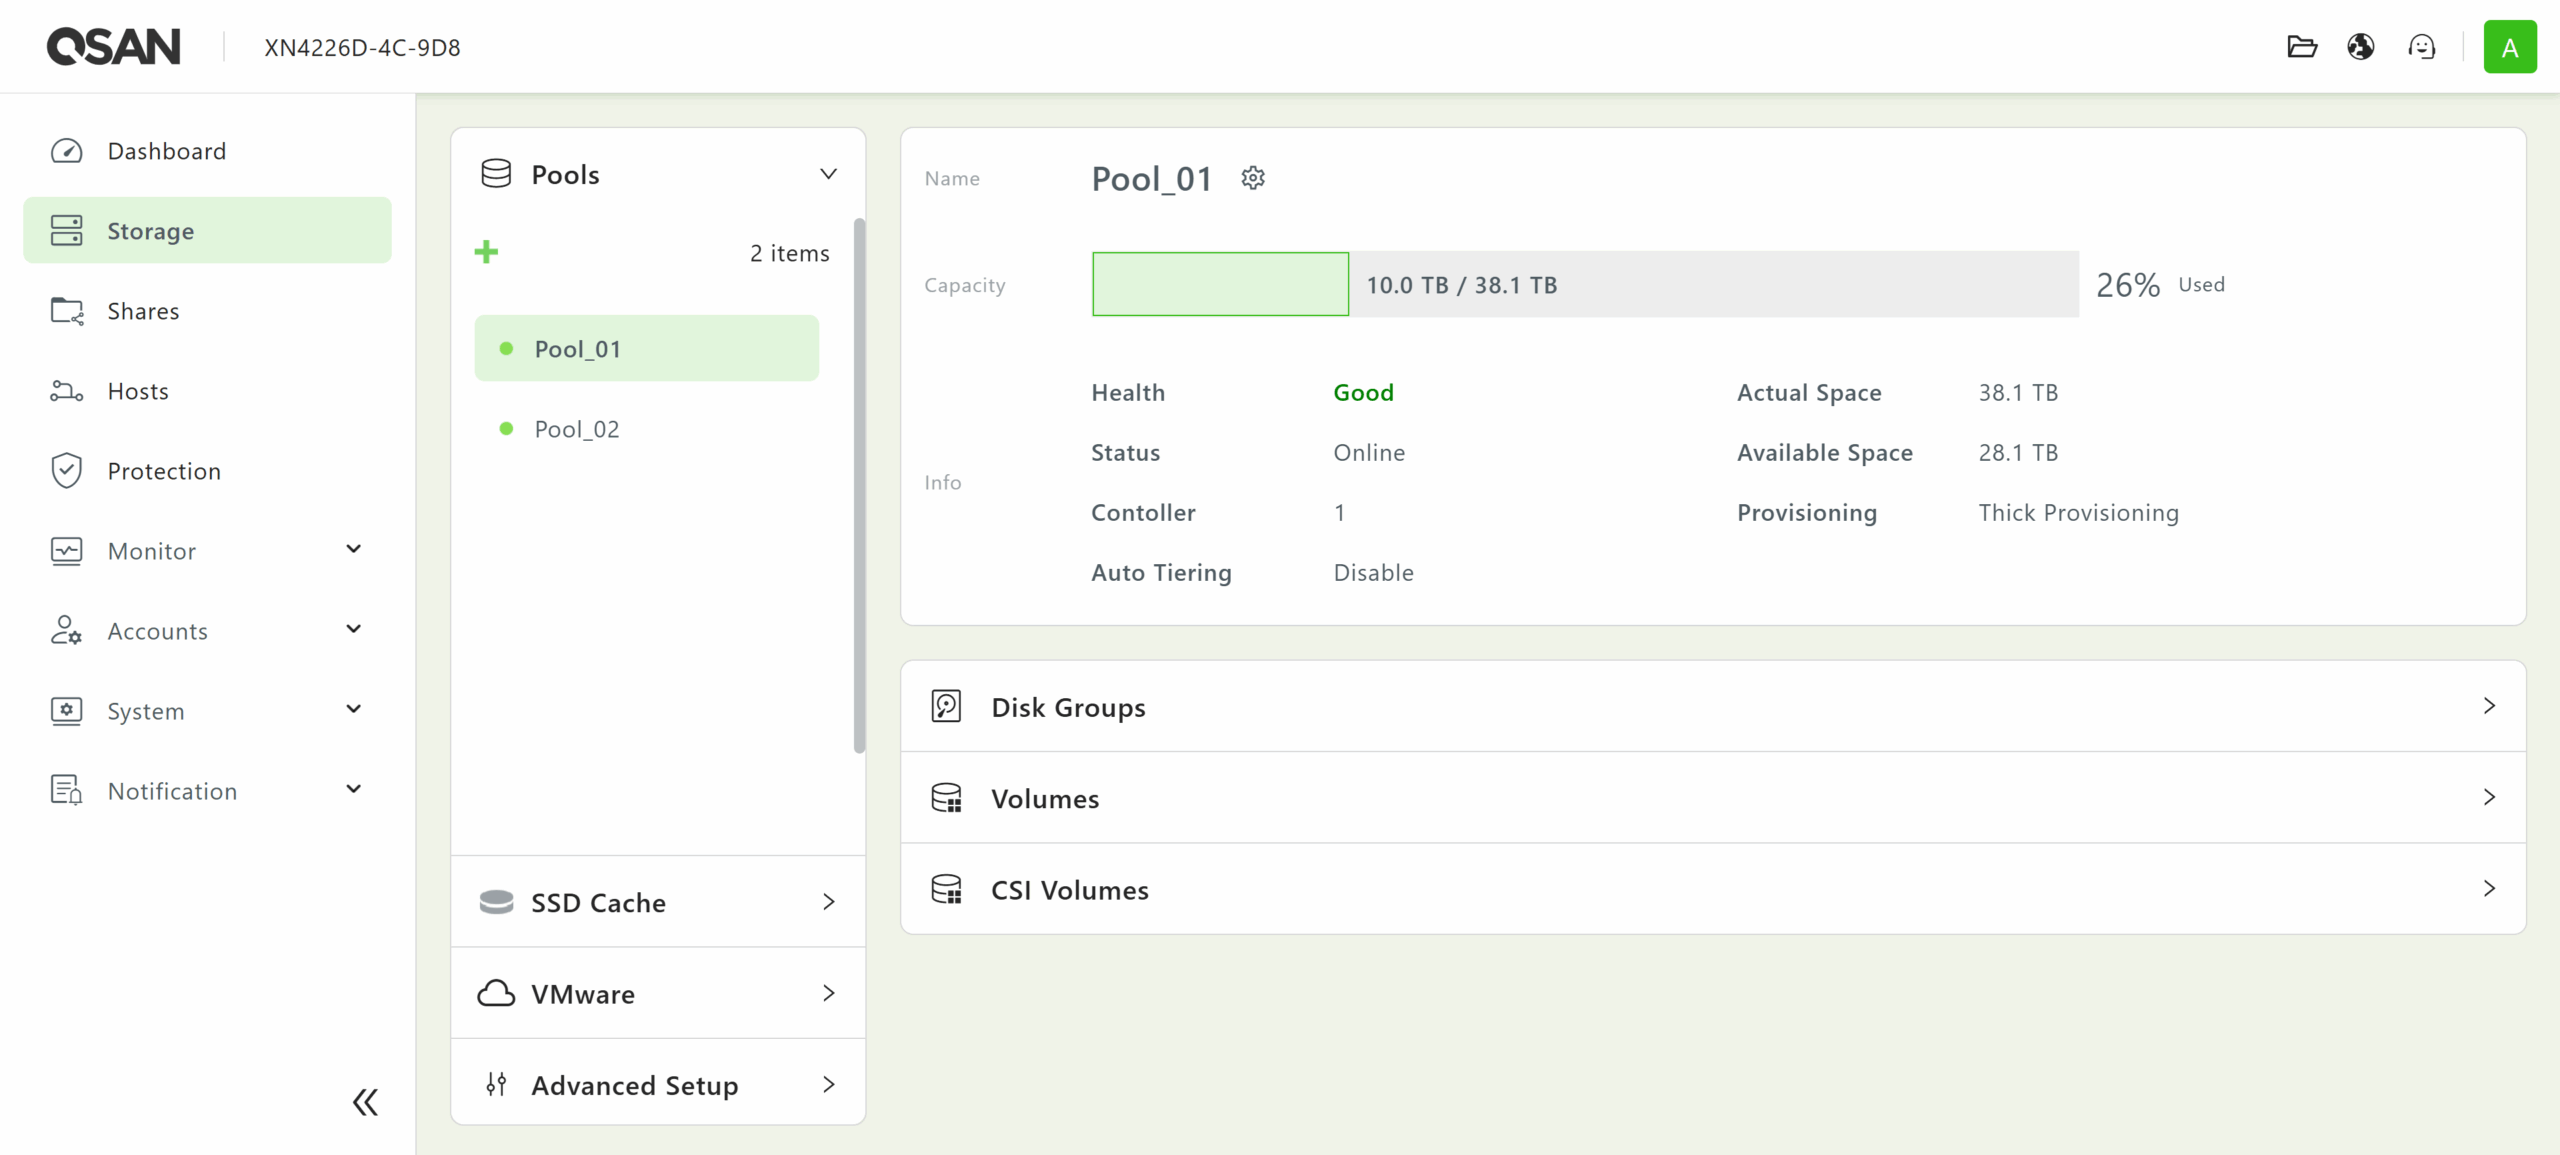
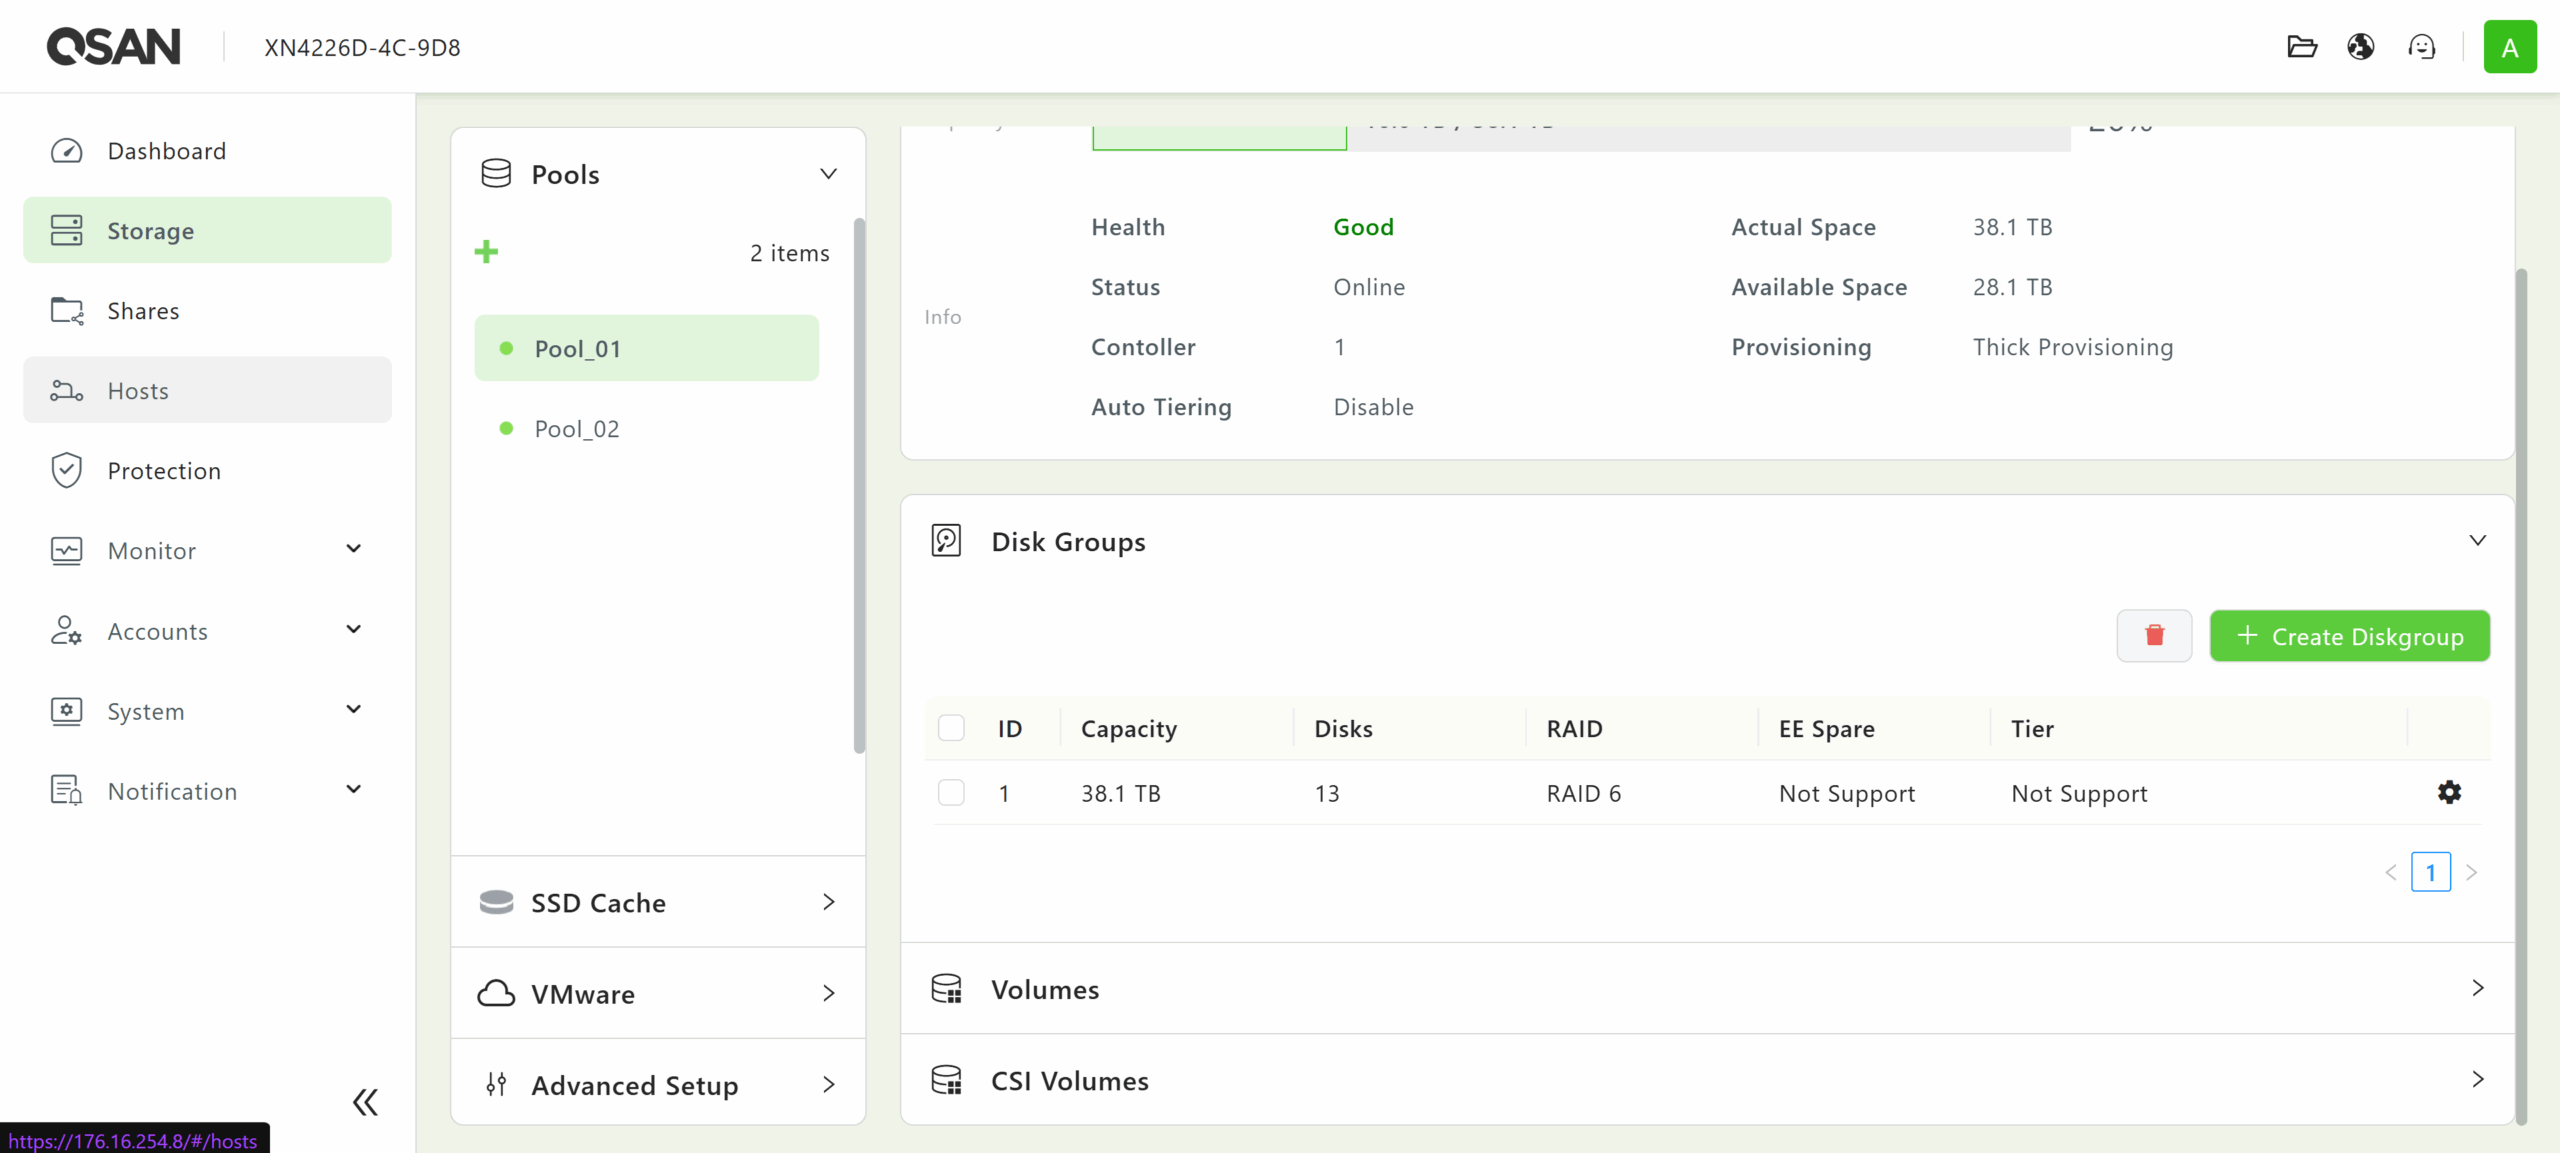
Los grupos de discos que componen cada pool se pueden administrar en la pestaña Grupos de discos. Esta función admite varios niveles RAID, como 0, 1, 5, 6, 10, 50, 60, 5EE, 6EE, 50EE y 60EE, según la cantidad de unidades asignadas.
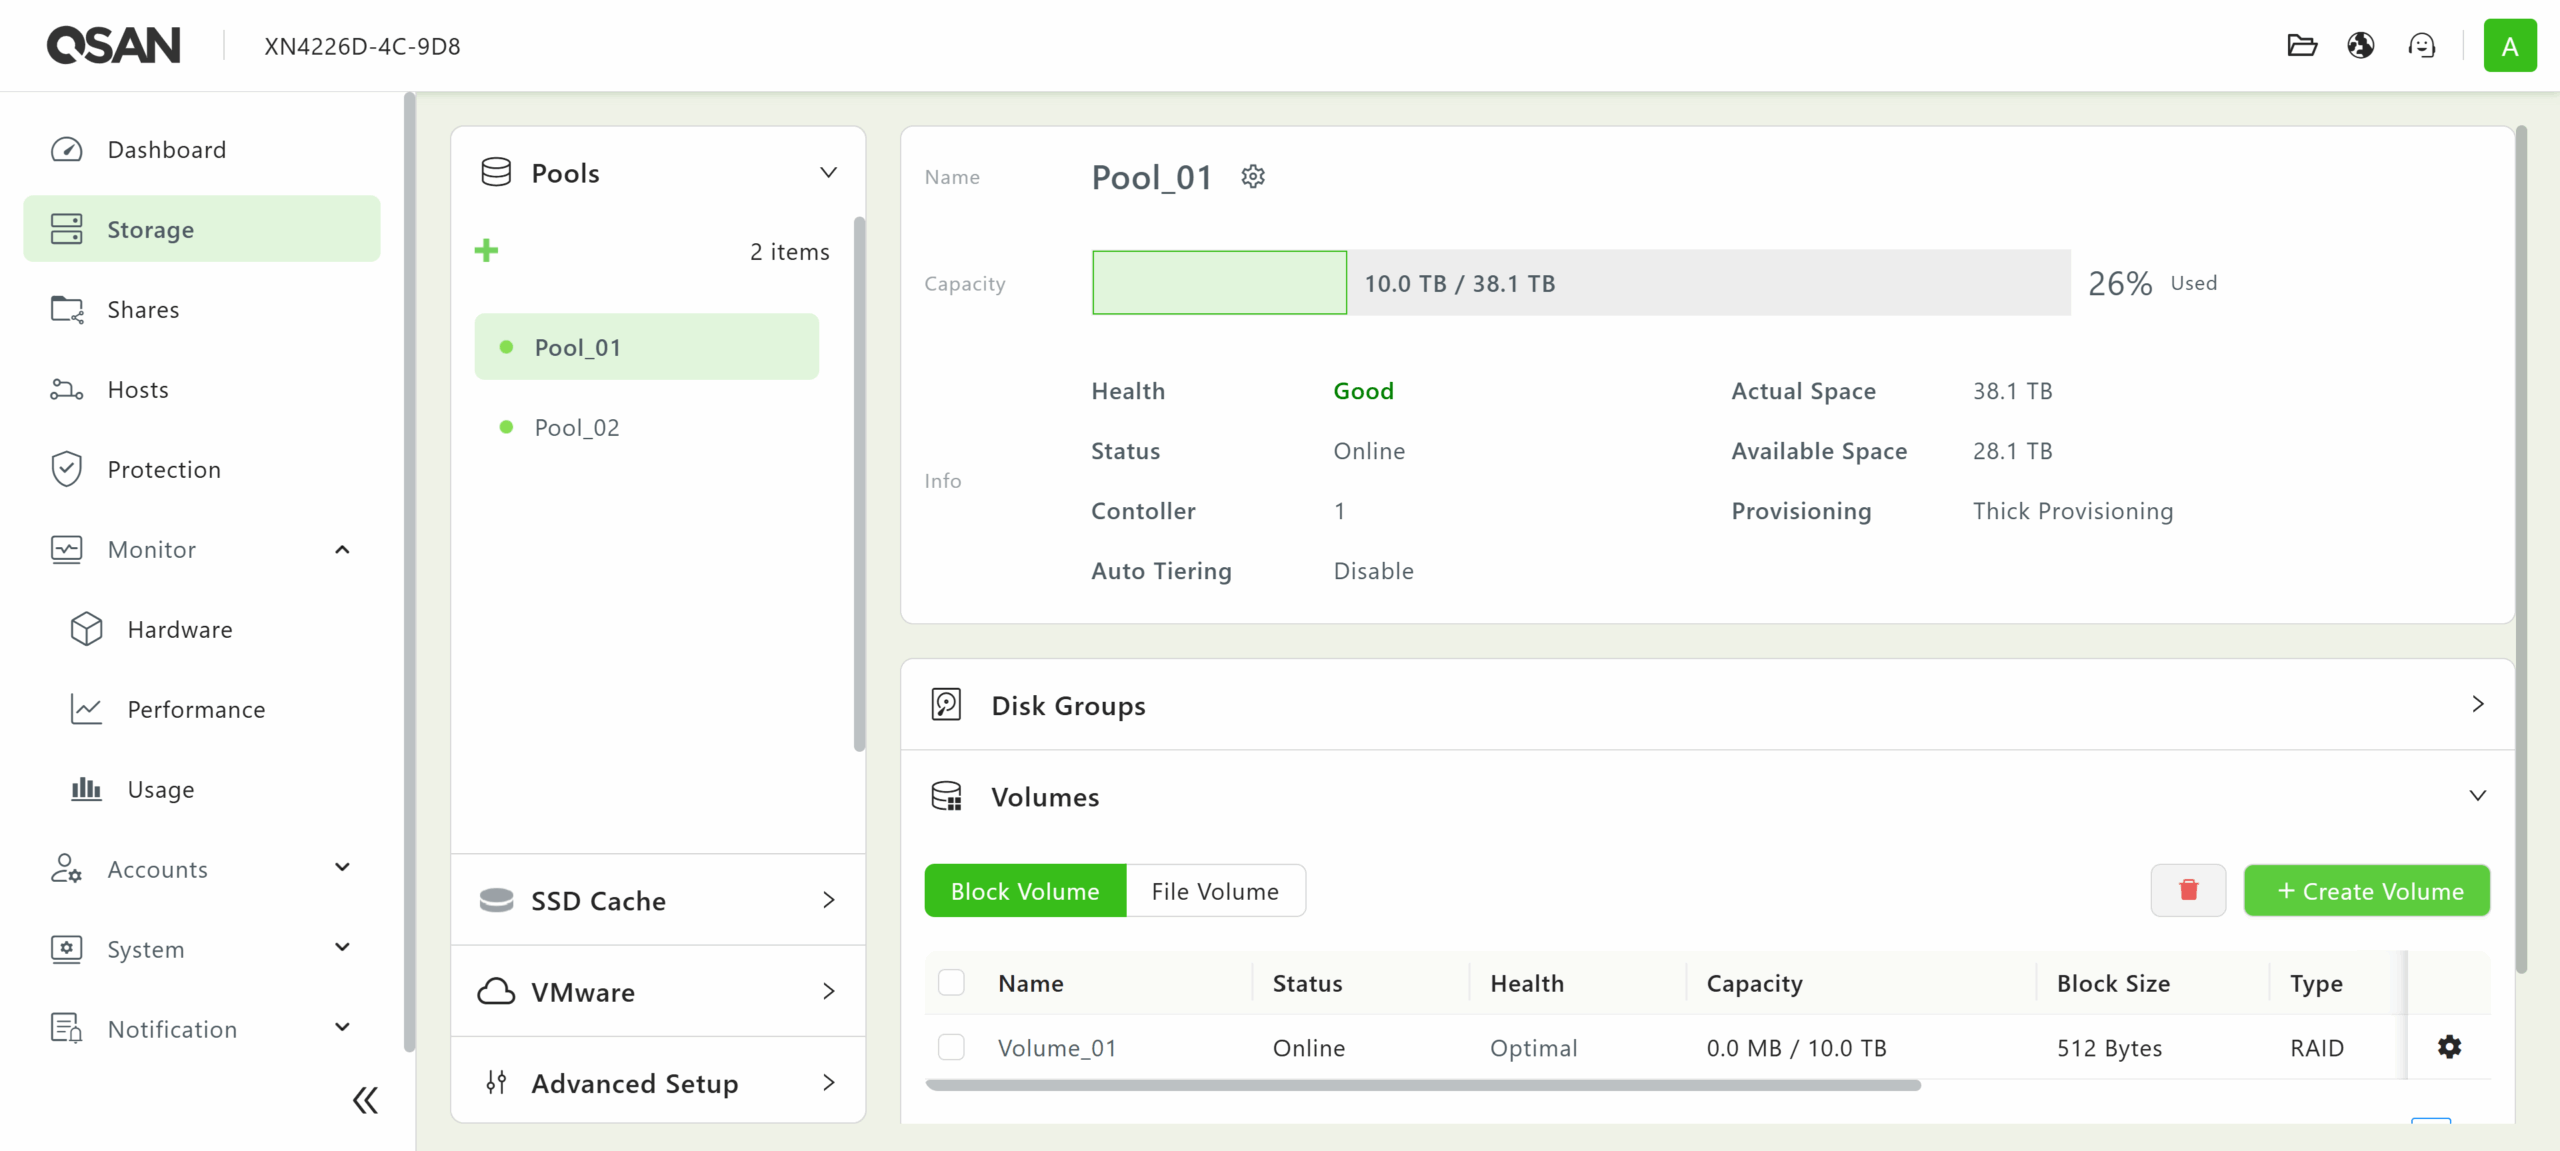
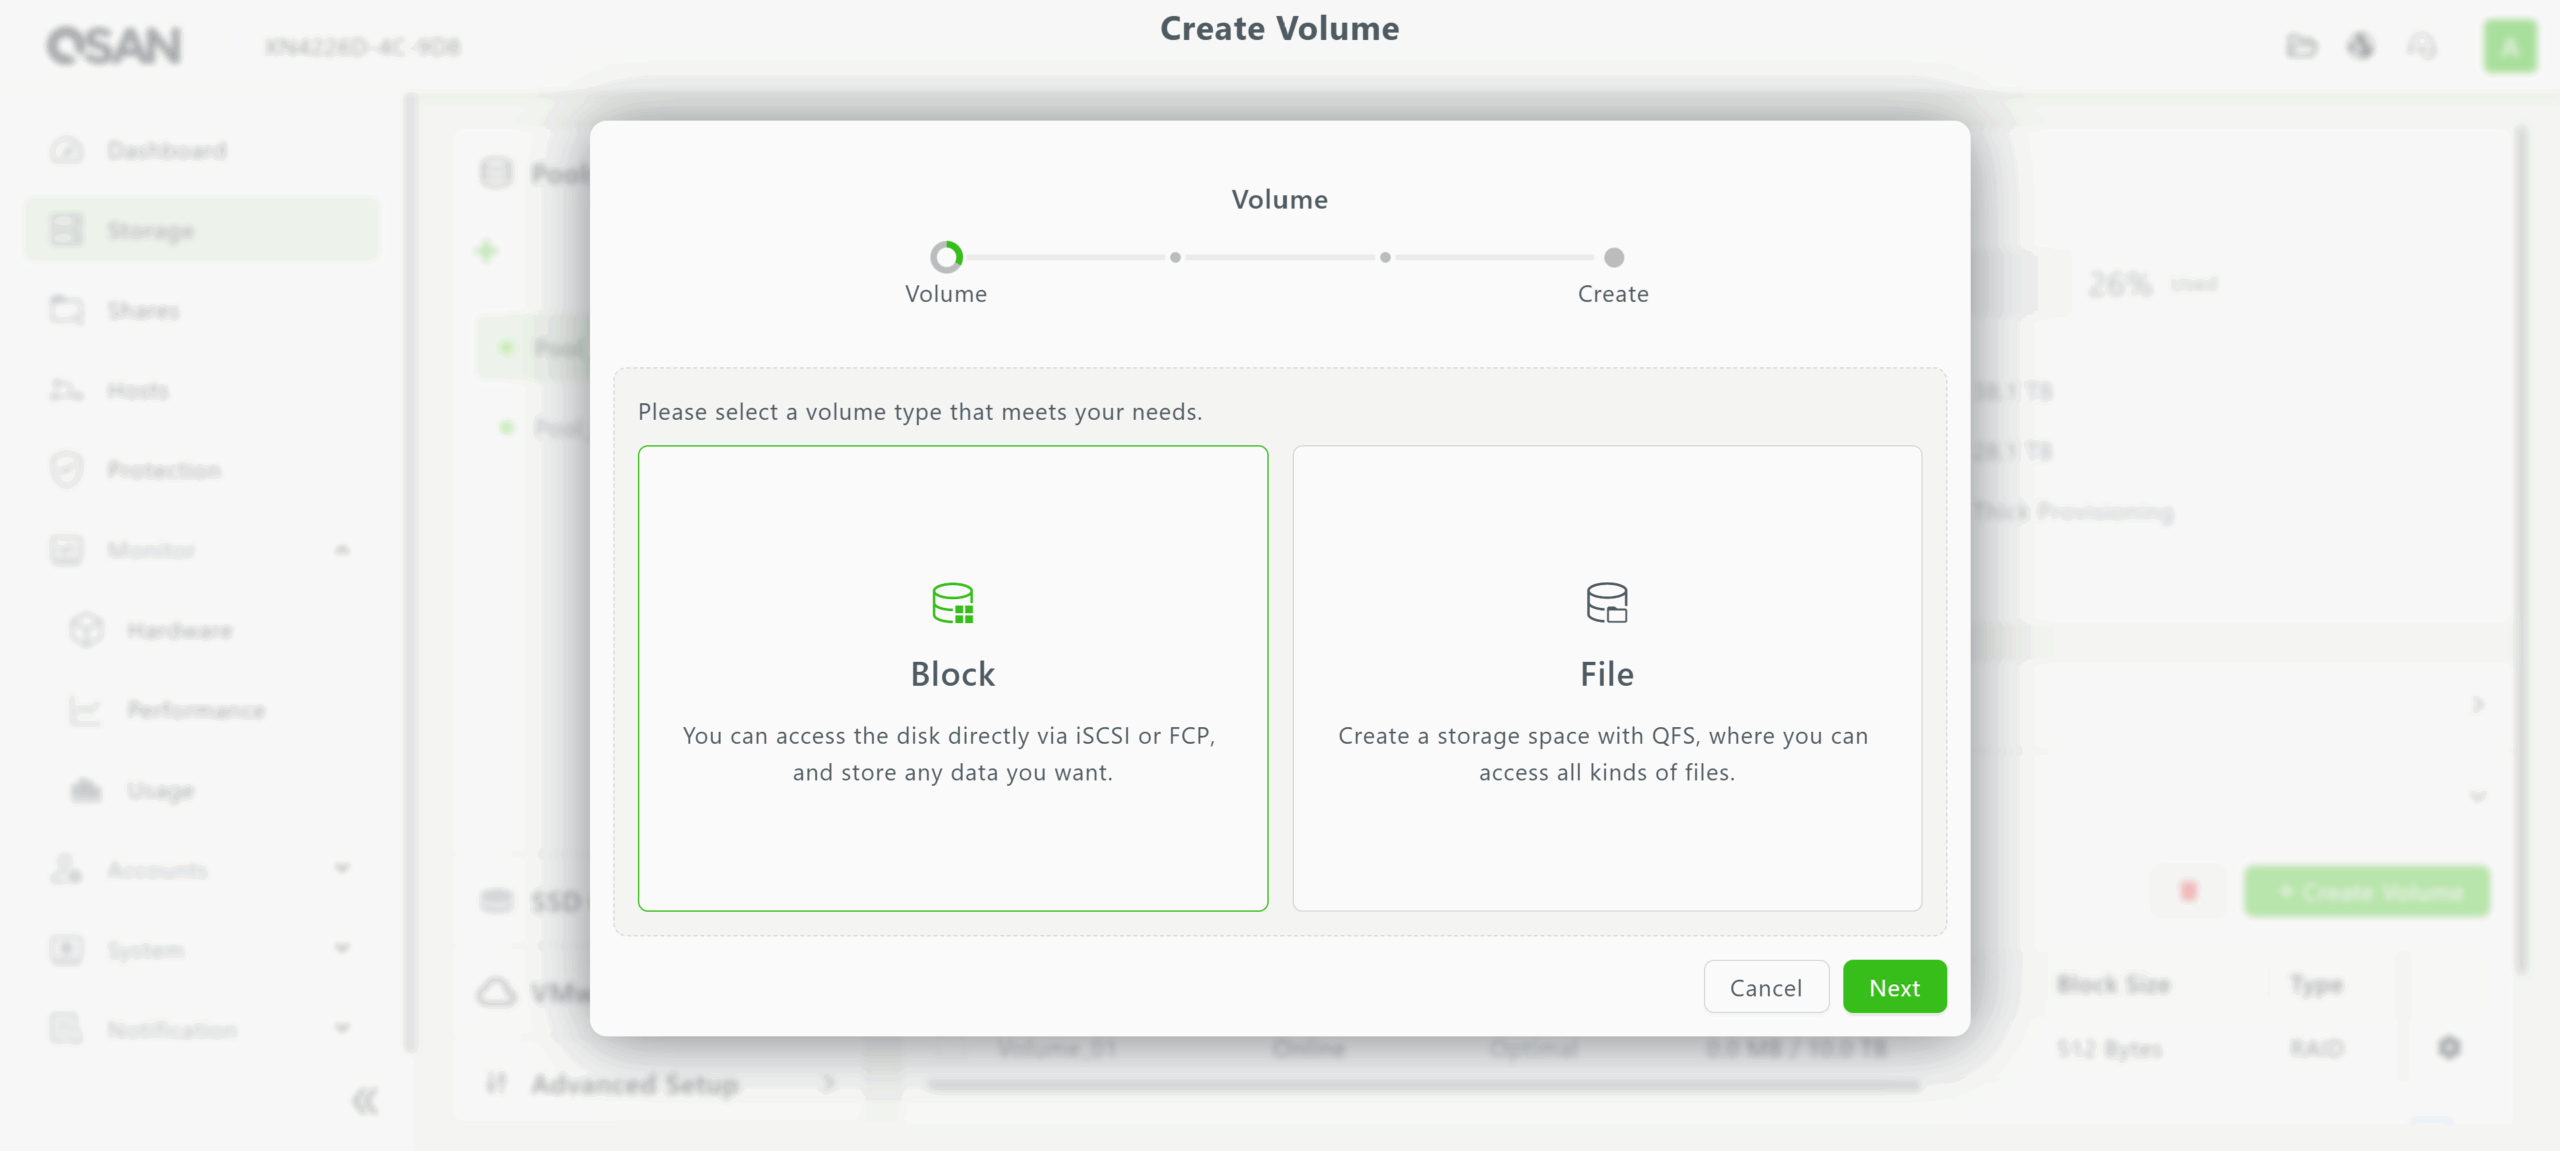
Se pueden crear volúmenes para el almacenamiento de bloques y archivos sobre los pools. Con el asistente, se puede configurar la capacidad y el tamaño de los bloques de cada volumen para adaptarlos a las necesidades de los clientes conectados.
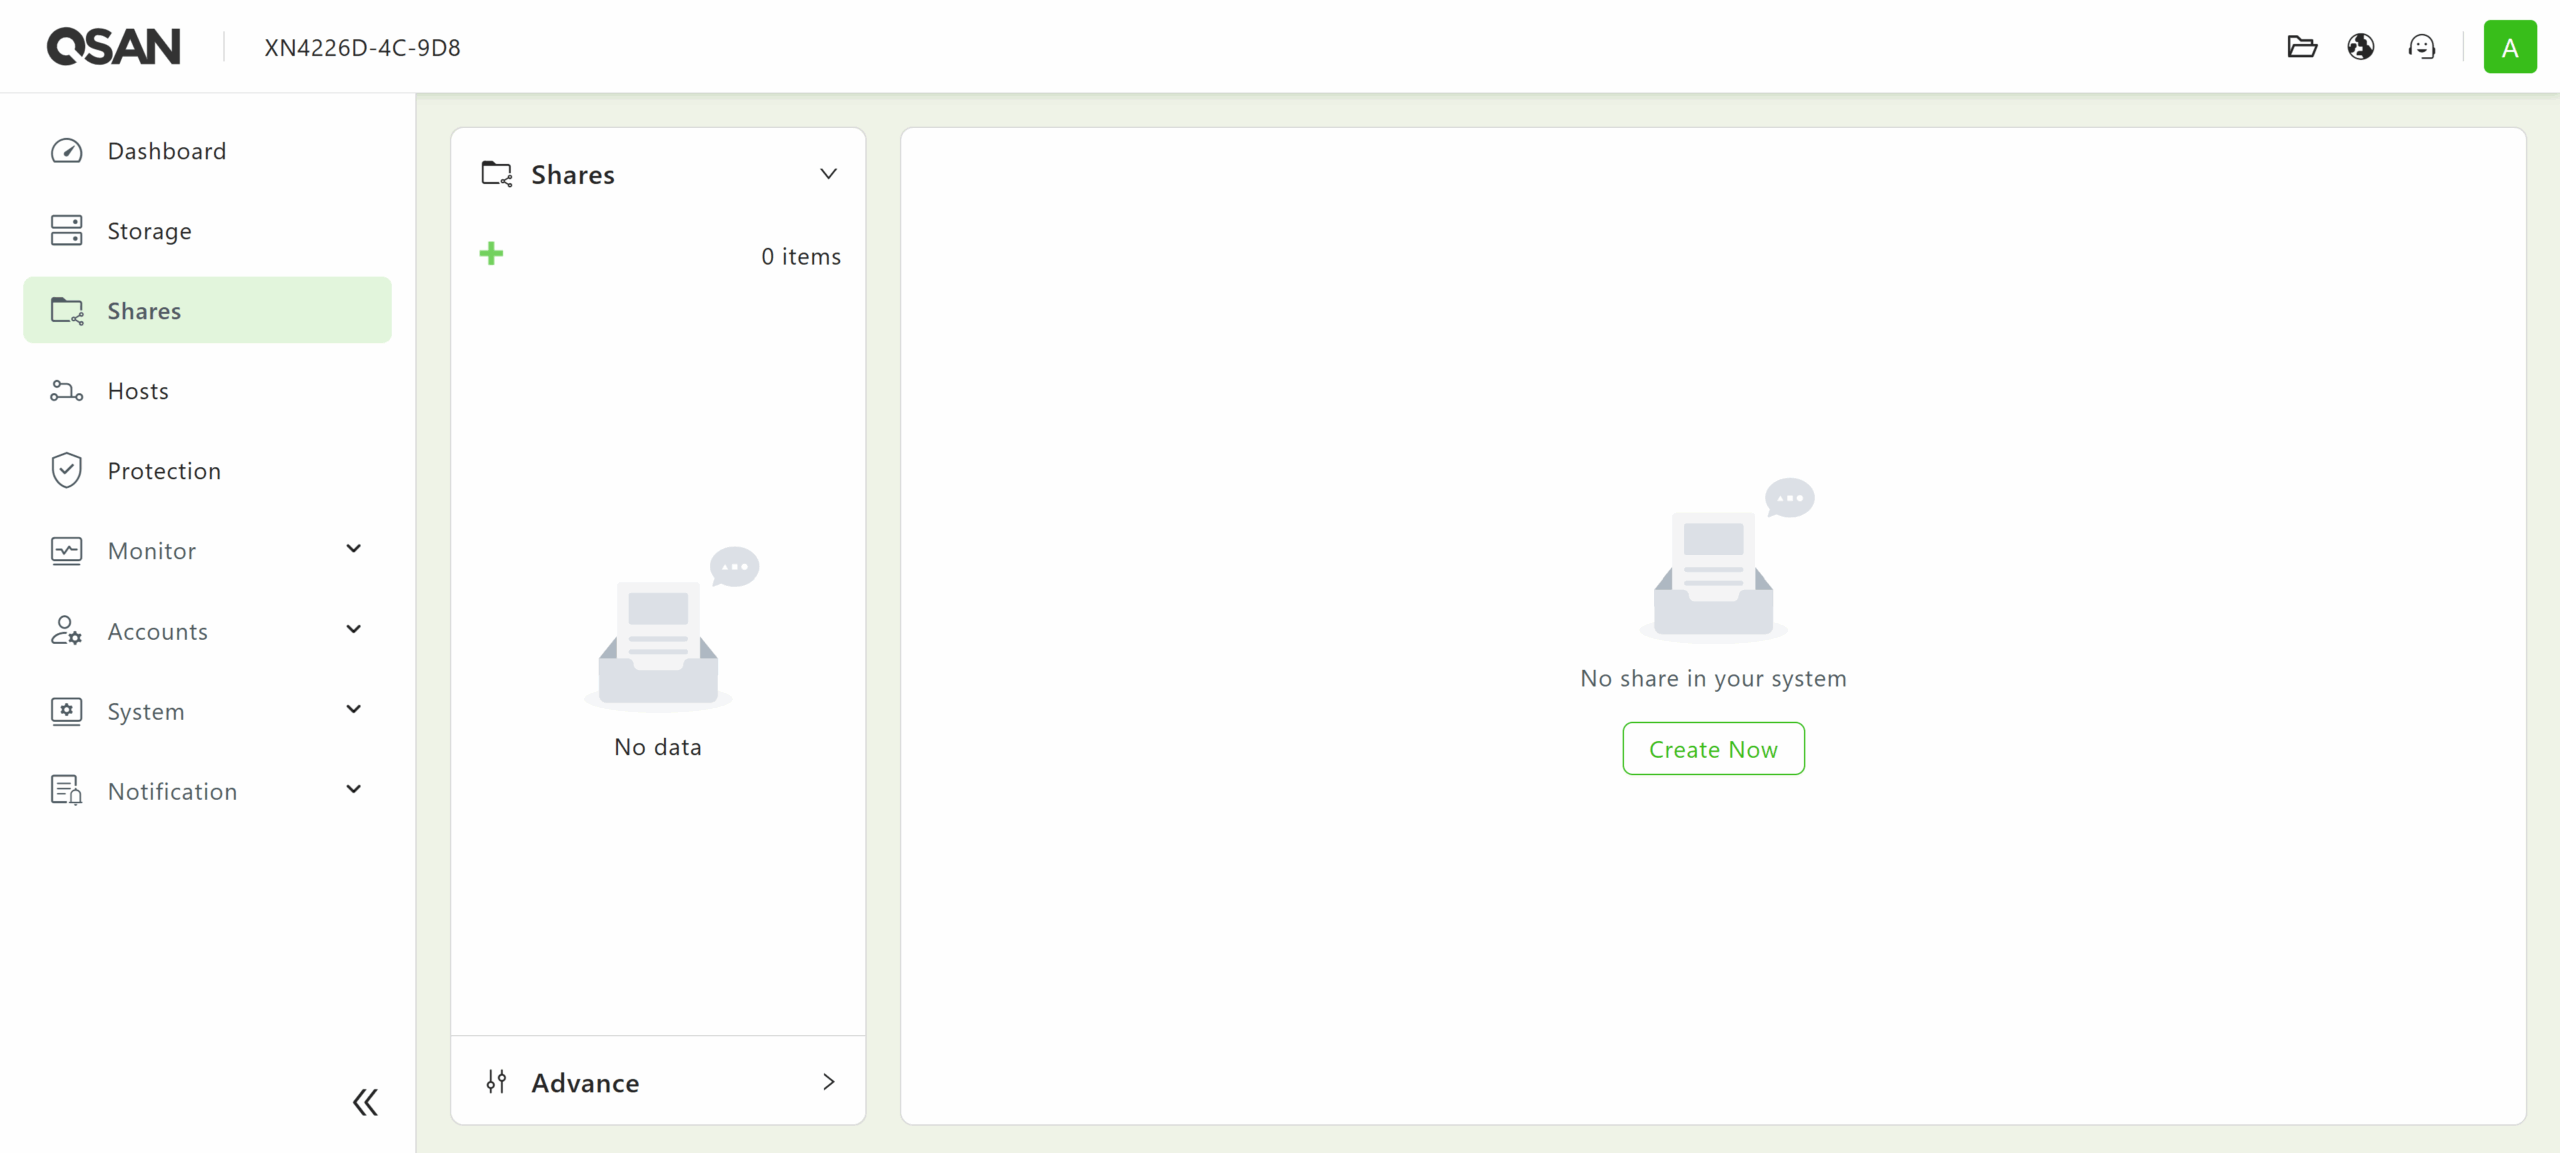
Al bajar por la lista, el menú Recursos compartidos permite crear un objeto compartido sobre un volumen de archivos. Los protocolos de uso compartido compatibles incluyen CIFS (SMB), FTP, NFS y WebDAV.
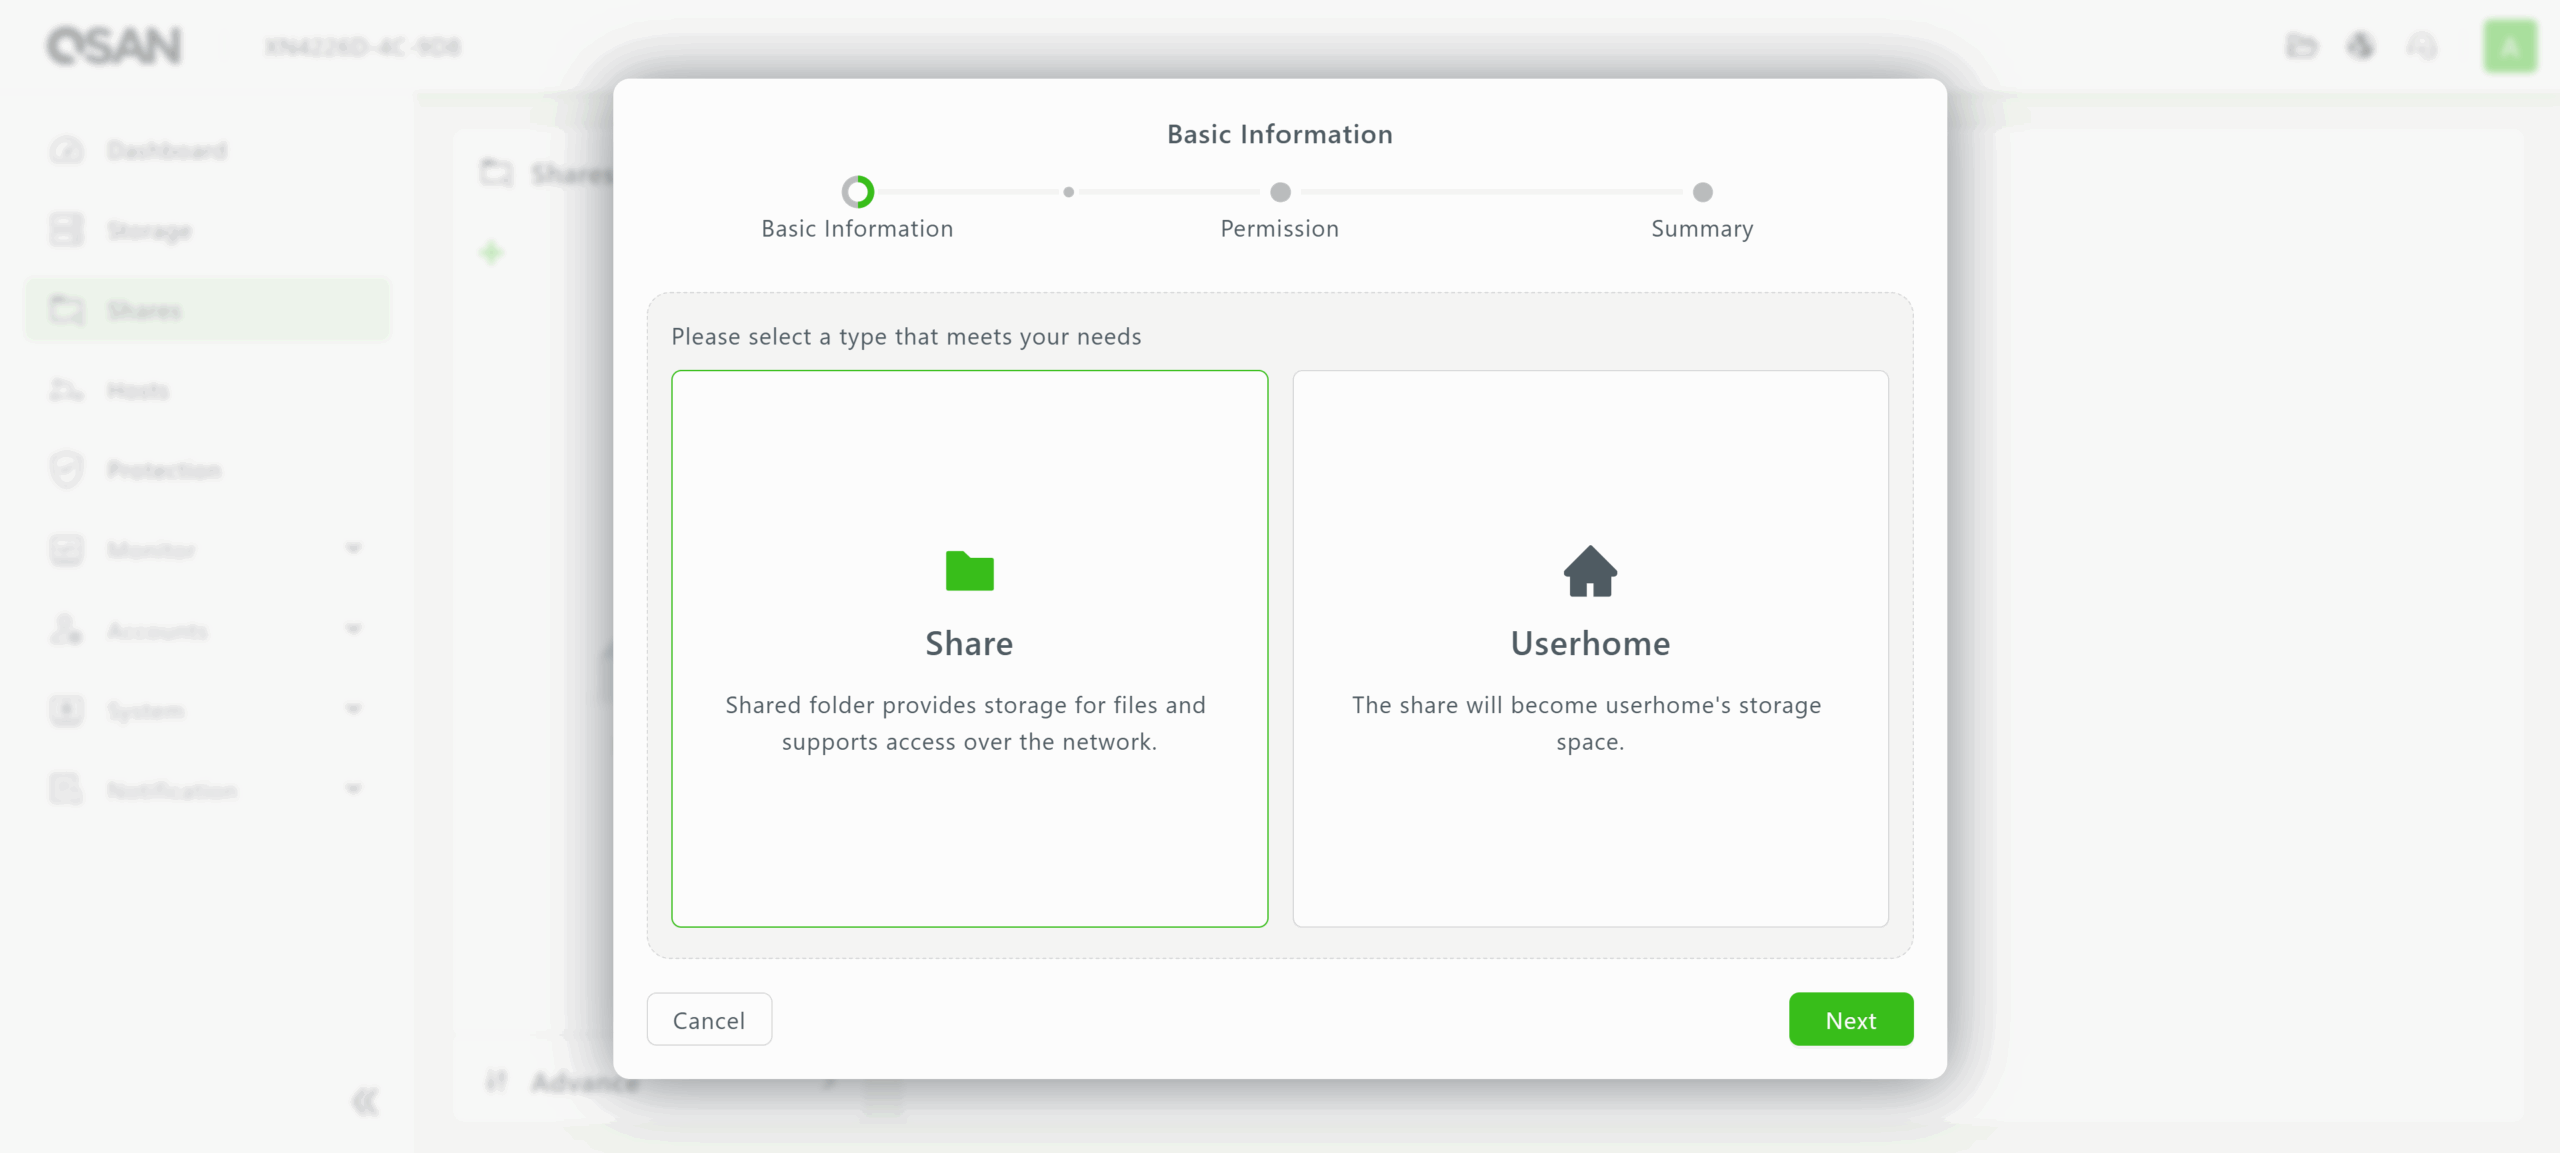
 Al crear un nuevo recurso compartido, QSM 4 ofrece dos opciones: un recurso compartido de red estándar para alojar archivos a los que podrán acceder varios usuarios y un recurso compartido de inicio de usuario, que está diseñado para contener carpetas de inicio para usuarios a las que solo se puede acceder individualmente.
Una vez creado un volumen de bloque o de archivo y un recurso compartido, debe asignarse a una dirección IP o nombre de host en el menú Hosts. Los hosts se organizan según correspondan al almacenamiento en bloque o de archivo (recurso compartido), como se muestra en las capturas de pantalla a continuación.
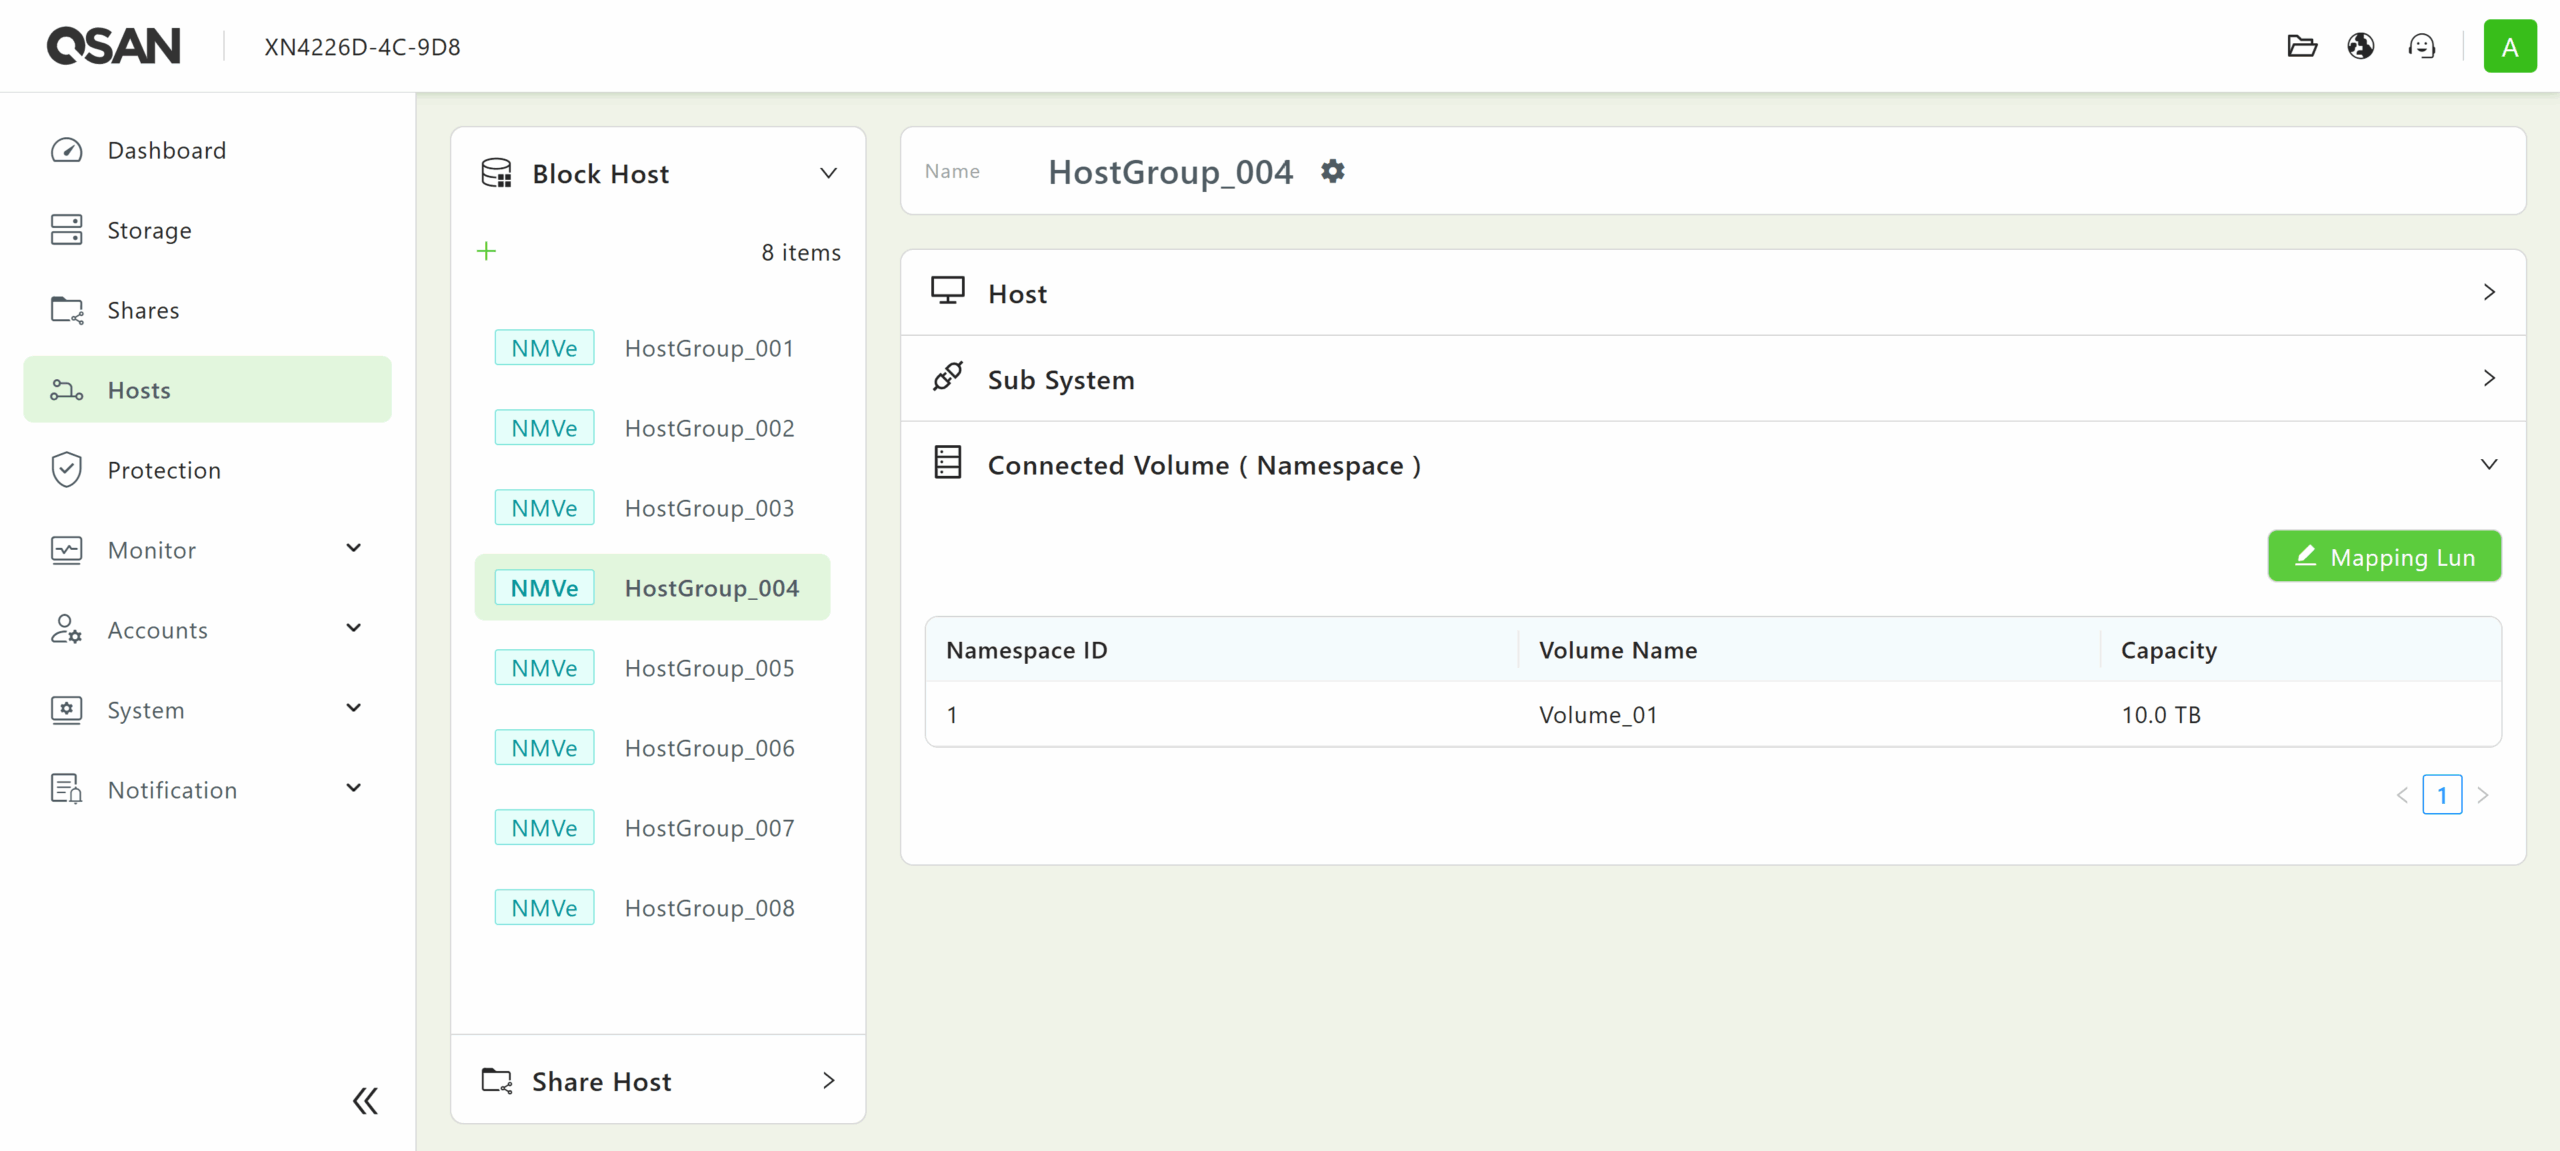
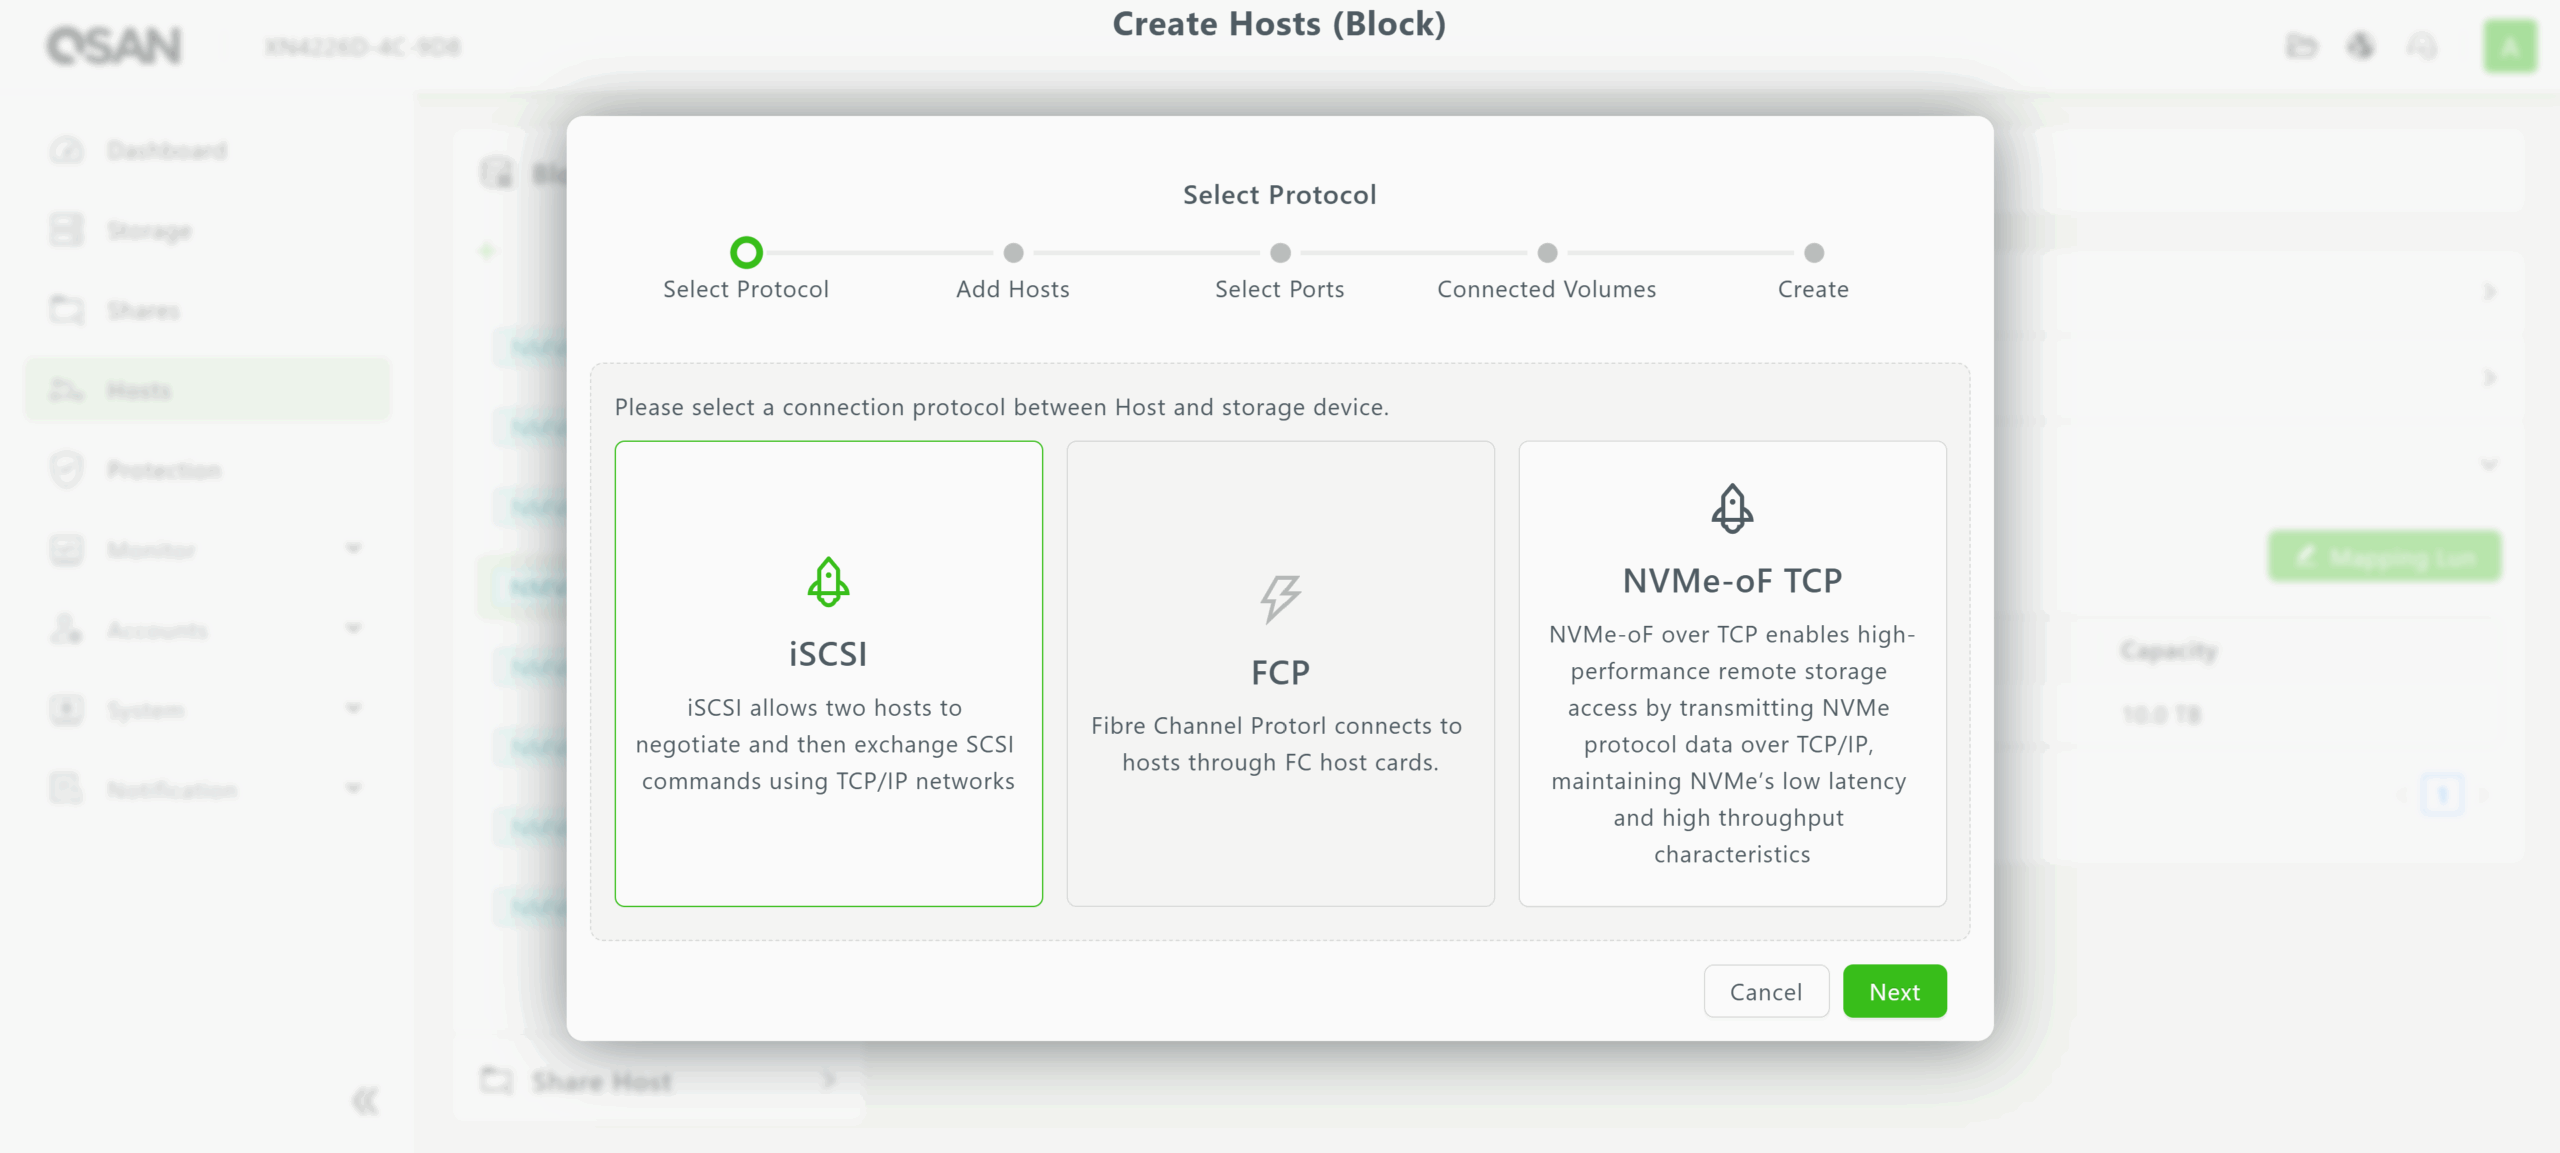
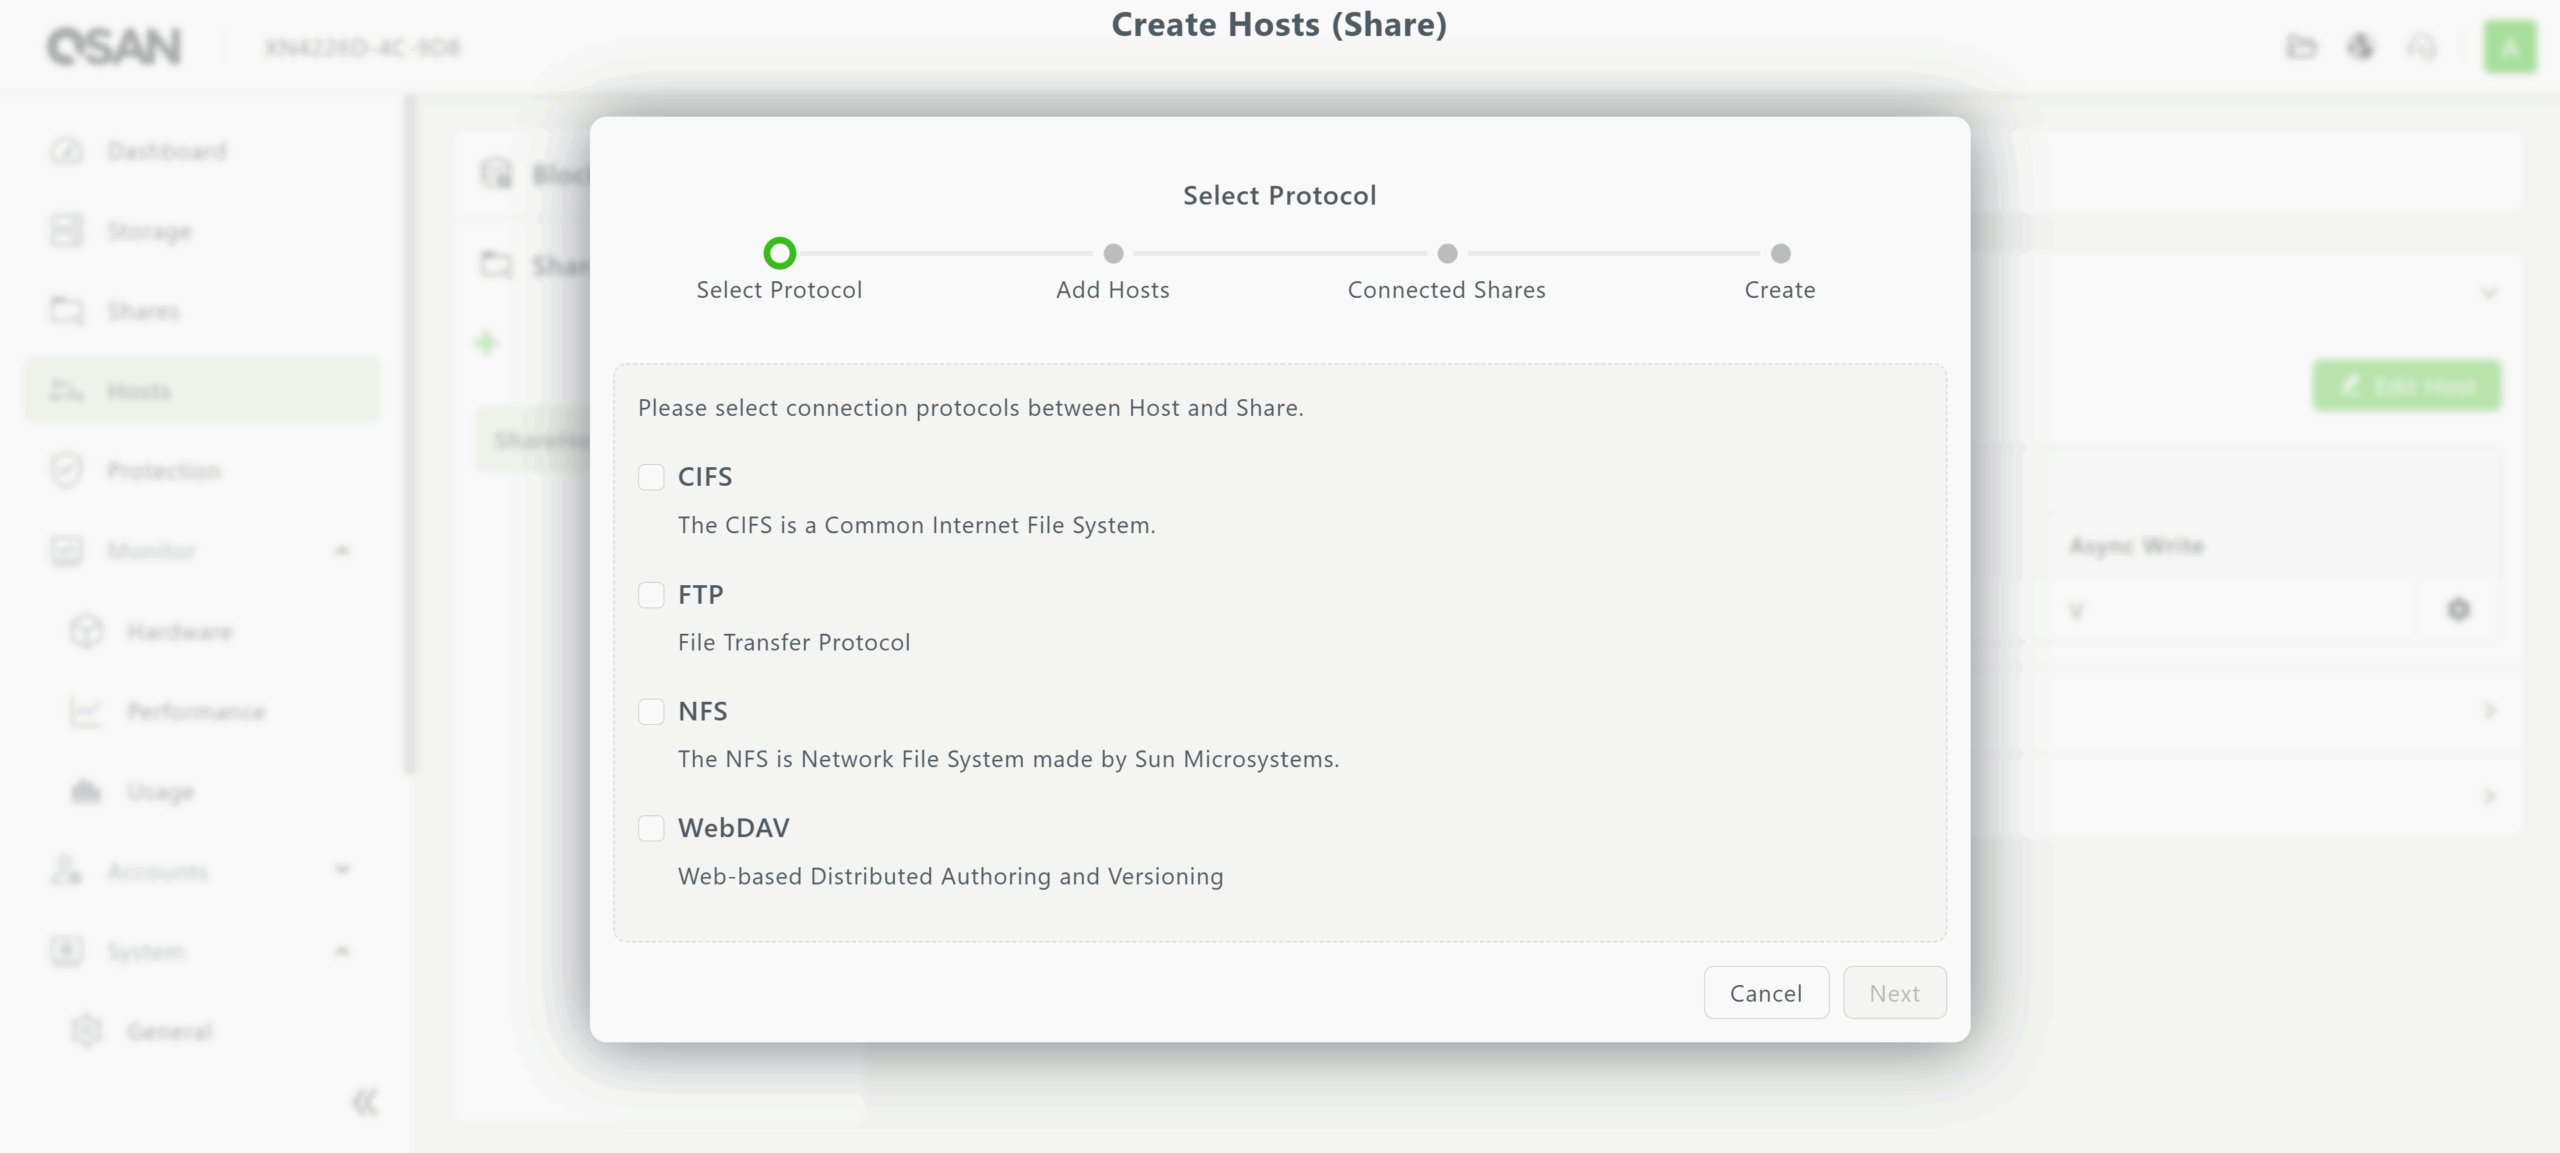
Los hosts para almacenamiento en bloque pueden utilizar iSCSI, FCP o NVMe-oF sobre TCP para un volumen. Por el contrario, los hosts para almacenamiento de archivos (recursos compartidos) admiten múltiples protocolos simultáneamente, lo que ofrece una flexibilidad esencial para centros de datos con diversas necesidades de intercambio de archivos.
QSM 4 también proporciona capacidades básicas de monitoreo en el menú Monitor, mostrando los estados de varios módulos de hardware y unidades dentro de la matriz, así como estadísticas de uso de unidades, grupos de almacenamiento, CPU y memoria.
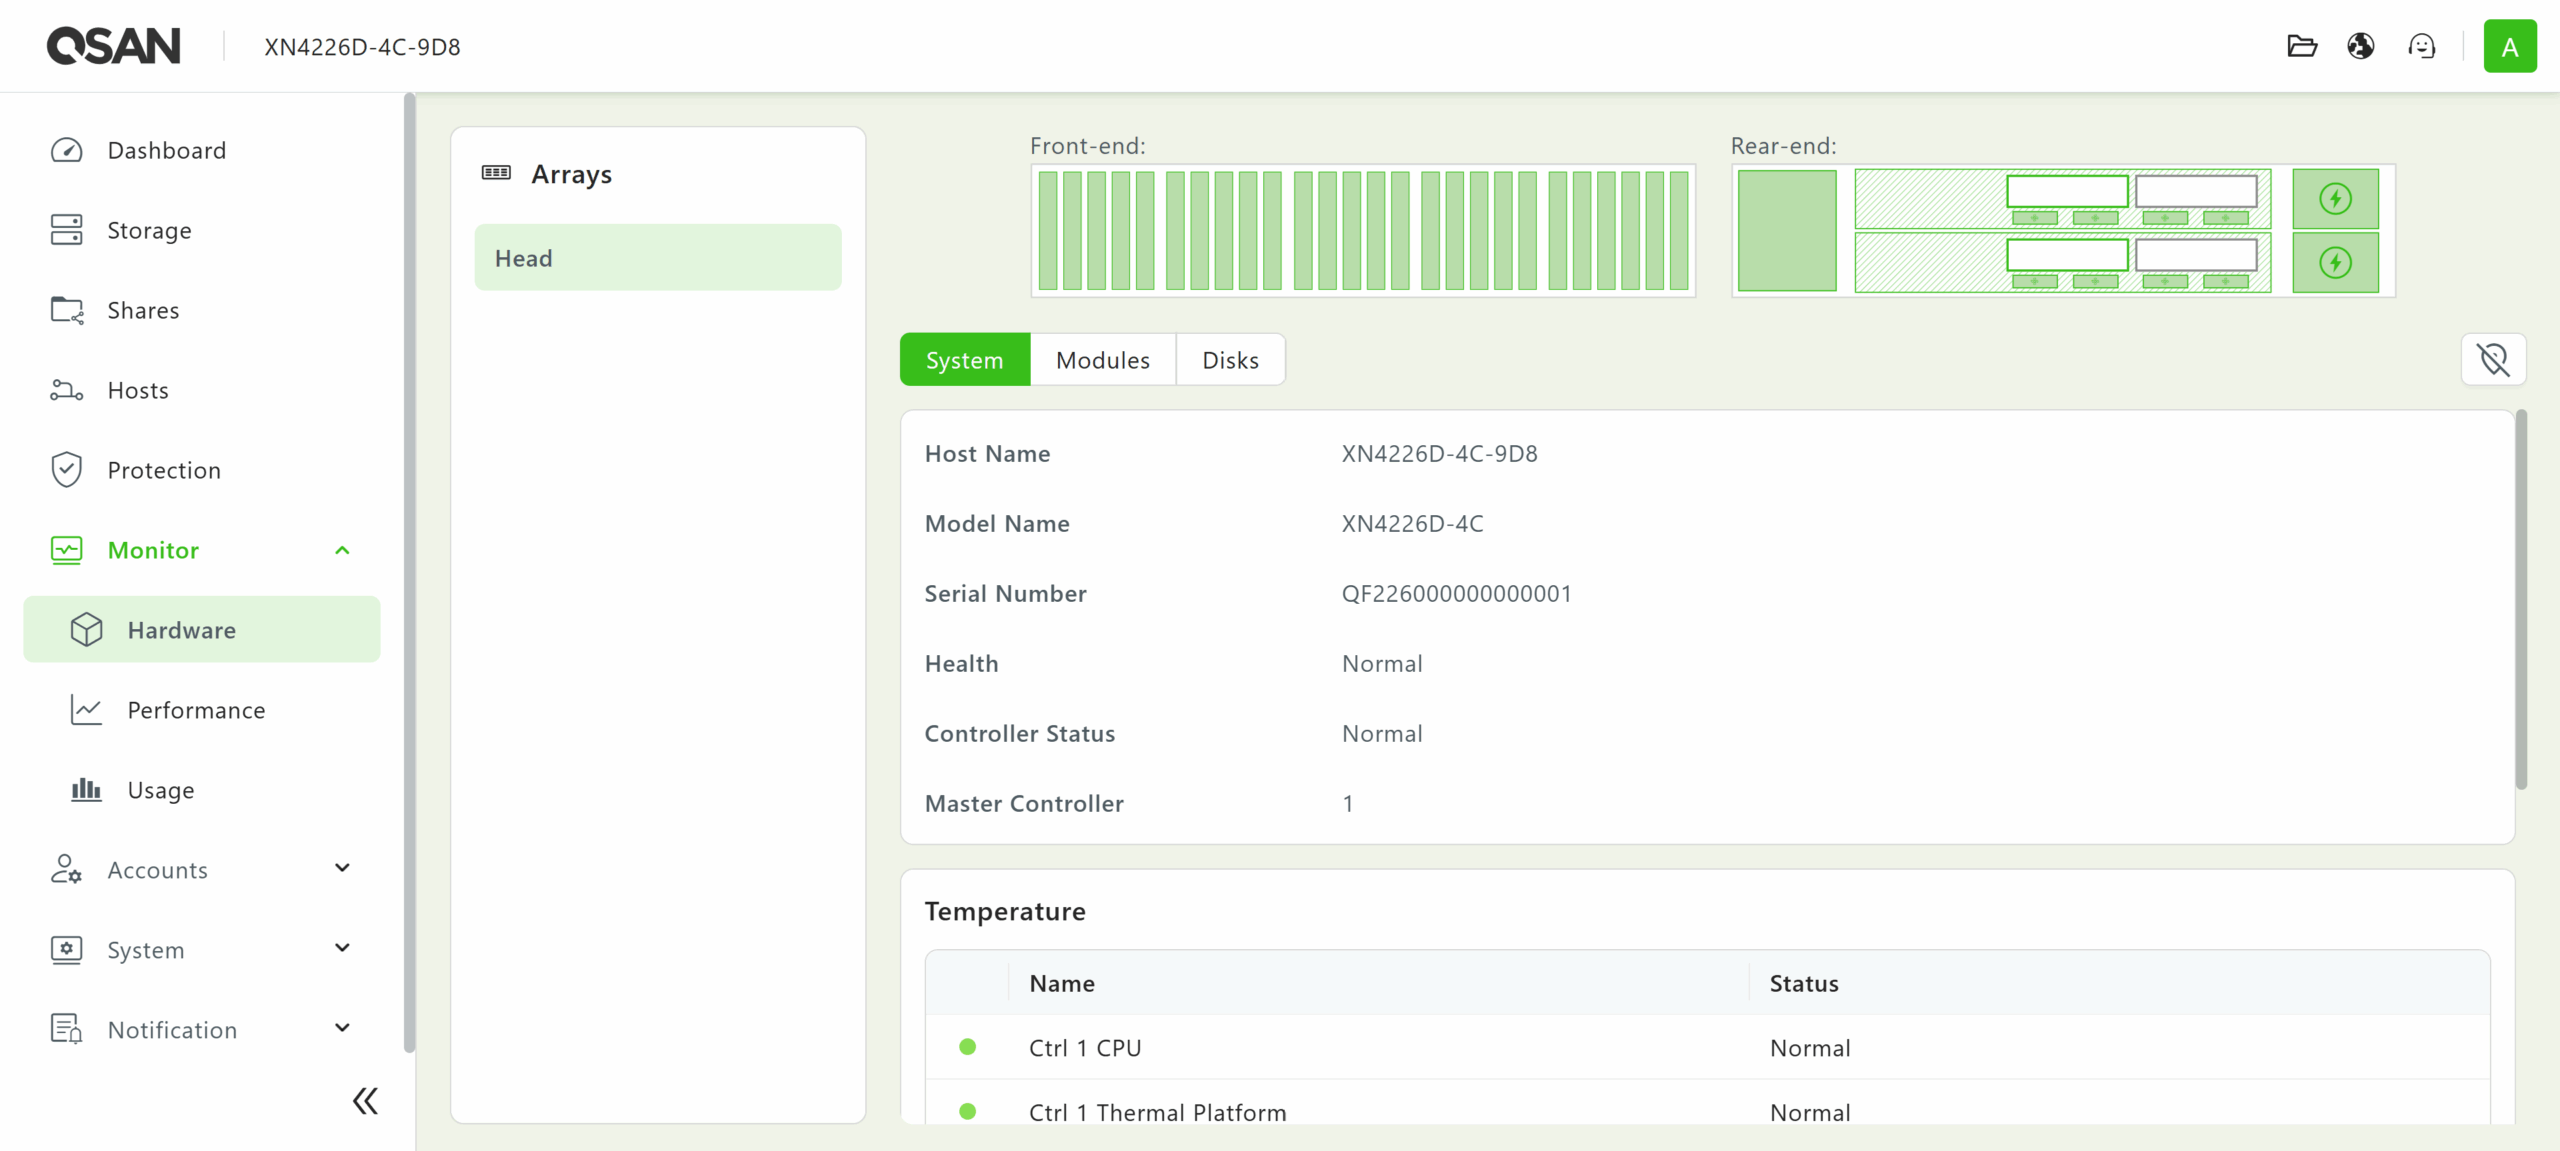
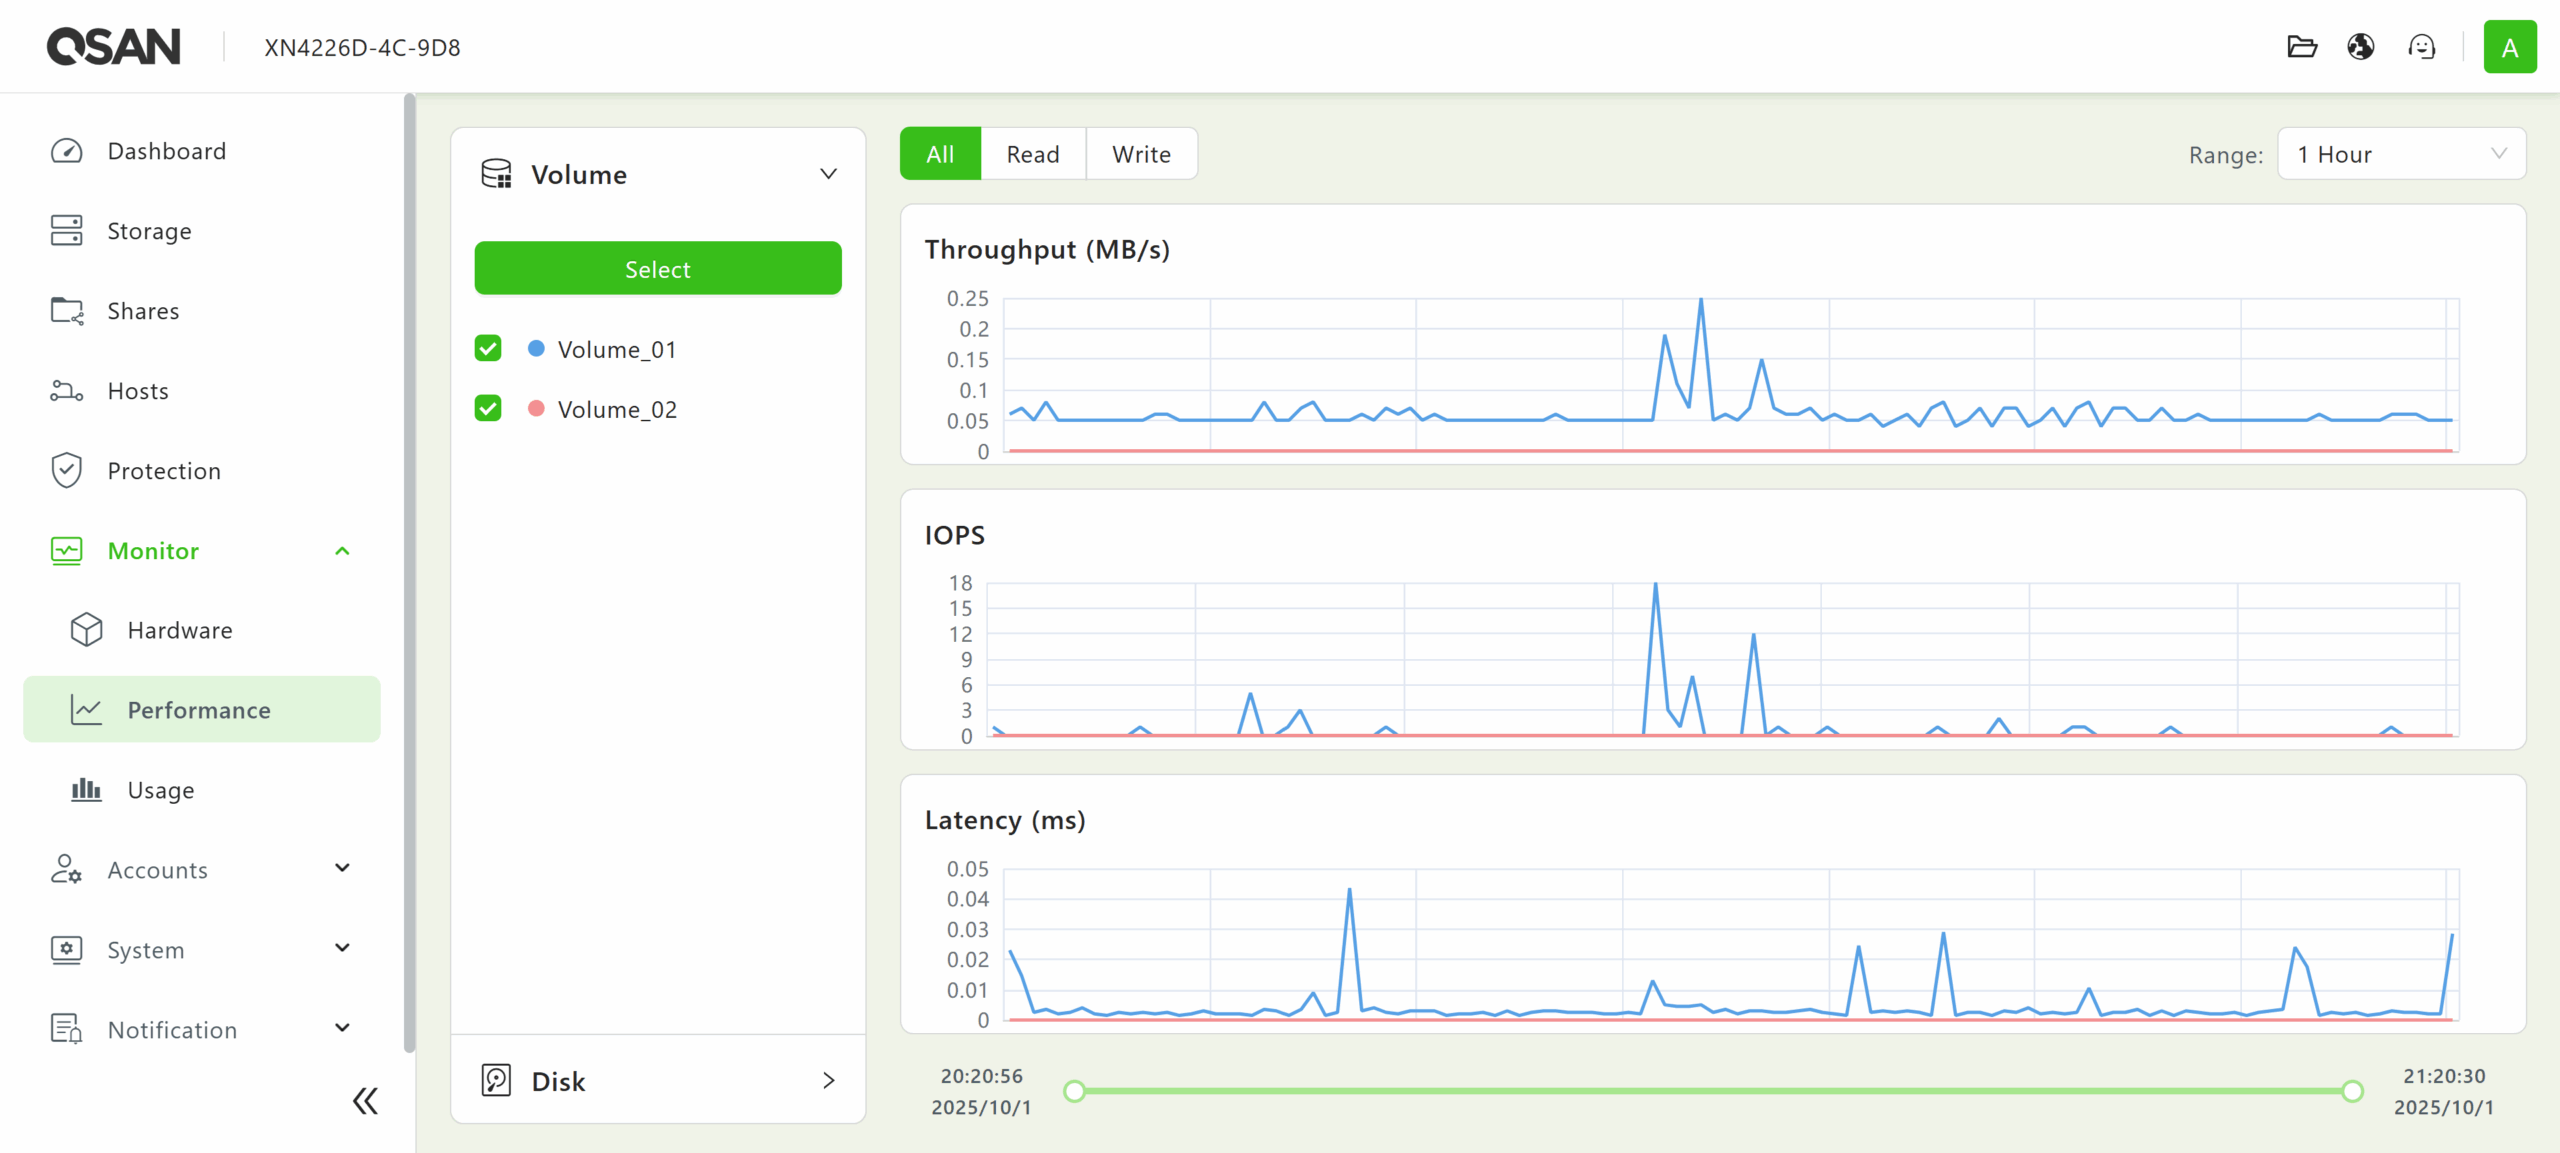
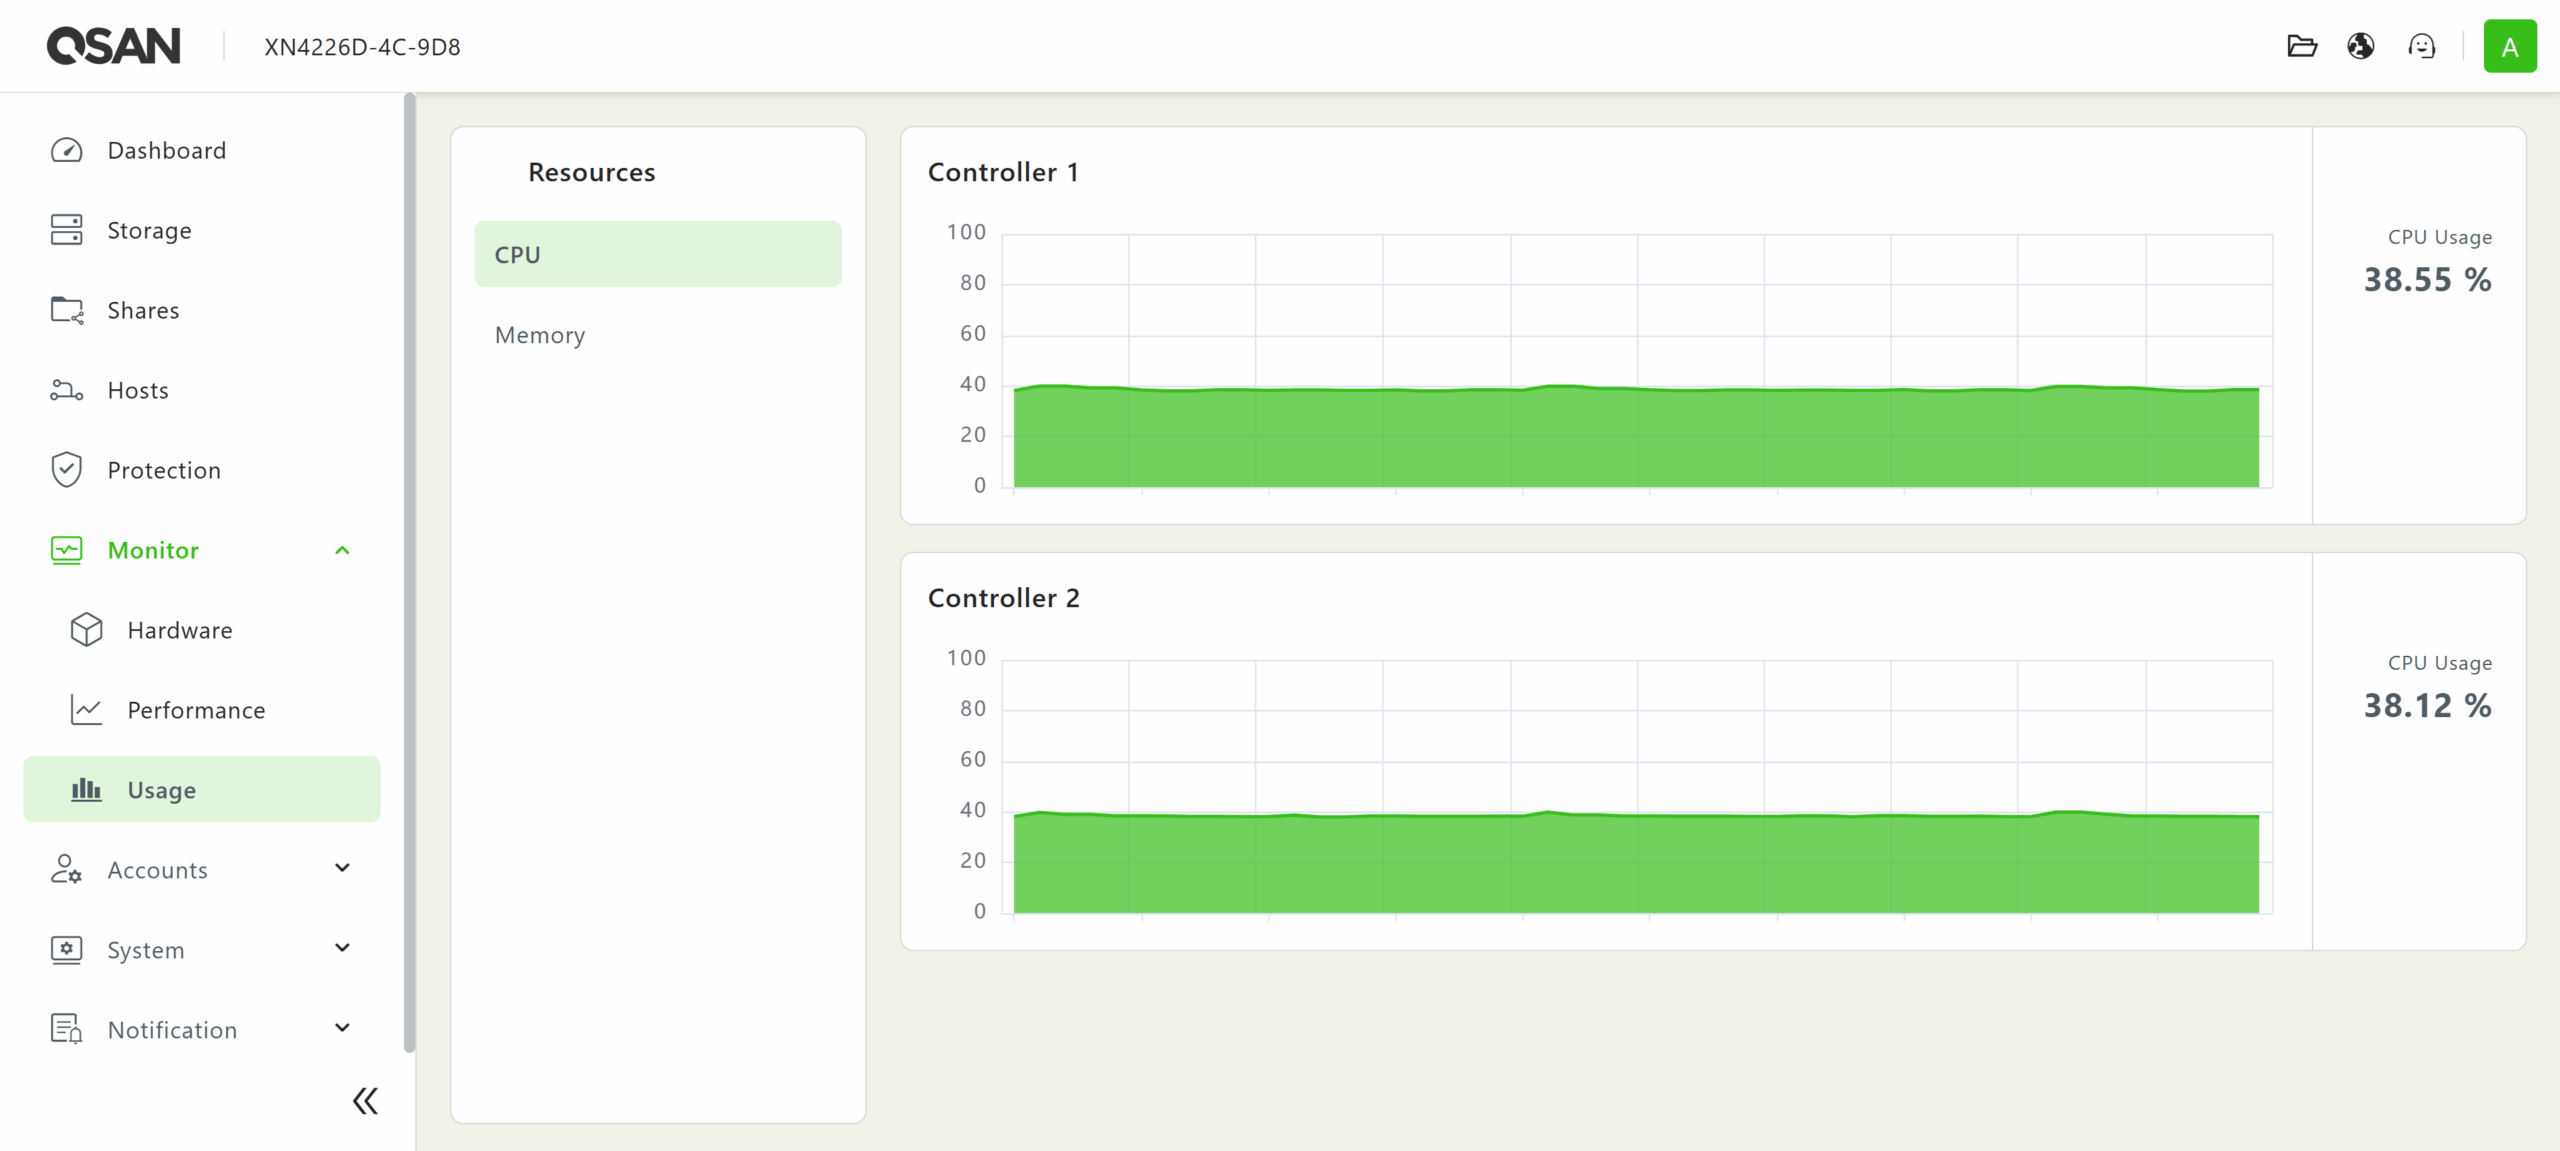
La interfaz web de QSM 4 también incluye la gestión de usuarios, grupos y dominios en el menú Cuentas. El menú Sistema también ofrece varias opciones de configuración para toda la SAN. El menú Notificaciones permite acceder a las funciones de registro y alertas. Por último, los iconos de Administrador de archivos de QSAN, Compatibilidad con idiomas y Cierre de sesión/Administración de energía se encuentran en la esquina superior derecha de la barra de menú.
Integración sencilla con Proxmox
Proxmox es compatible de forma nativa con NVMe over Fabrics (NVMe-oF), lo que facilita la integración de matrices de almacenamiento de alto rendimiento en un clúster. El proceso comienza con el aprovisionamiento de destinos NVMe-oF en su sistema de almacenamiento. A continuación, utilice el host Proxmox para detectar y conectarse a dichos destinos. Una vez conectado, debe configurar el sistema para garantizar que estas conexiones persistan tras los reinicios.
En nuestro ejemplo, el descubrimiento se realiza mediante comandos de shell, que especifican la dirección IP y el puerto de servicio de la matriz.
nvme discover -t tcp -a 172.16.16.100 -s 4420
nvme discover -t tcp -a 172.13.13.100 -s 4420
A continuación, conéctese a los espacios de nombres aprovisionados haciendo referencia a sus NQN.
nvme connect -t tcp -n nqn.2024-11.com.qsan:dev4 -a 172.16.16.100 -s 4420
nvme connect -t tcp -n nqn.2024-11.com.qsan:dev6 -a 172.13.13.100 -s 4420
Para garantizar que la configuración sea persistente durante los reinicios, las direcciones de descubrimiento se pueden agregar al archivo de configuración de descubrimiento de NVMe.
echo "discover -t tcp -a 172.16.16.100 -s 4420" | tee -a /etc/nvme/discovery.conf
echo "discover -t tcp -a 172.13.13.100 -s 4420" | tee -a /etc/nvme/discovery.conf
Por último, habilite el servicio de conexión automática para que Proxmox restablezca las sesiones NVMe automáticamente al iniciarse.
systemctl enable nvmf-autoconnect.serviceProxmox se puede integrar perfectamente con el almacenamiento QSAN, ofreciendo el rendimiento de baja latencia y alto ancho de banda de NVMe junto con la flexibilidad de las estructuras en red.
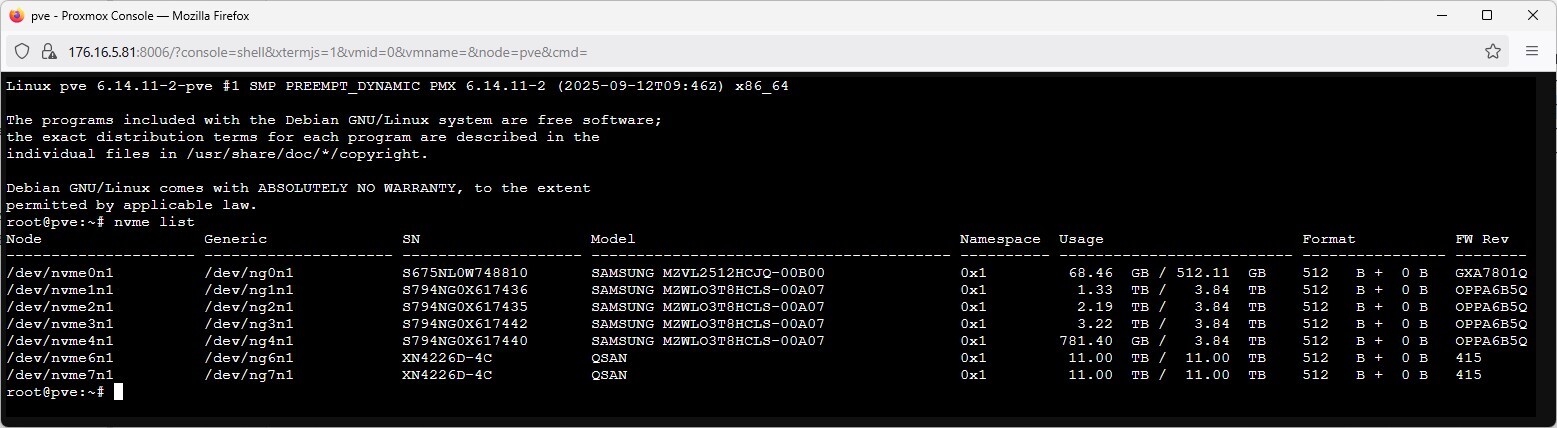
Después de conectar nuestro QSAN, podemos emitir el comando “nvme list” desde el shell Proxmox para mostrar todos los dispositivos NVMe, donde los volúmenes QSAN recién agregados aparecen como /dev/nvme6n1 y /dev/nvme7n1, cada uno con 11 TB de almacenamiento.
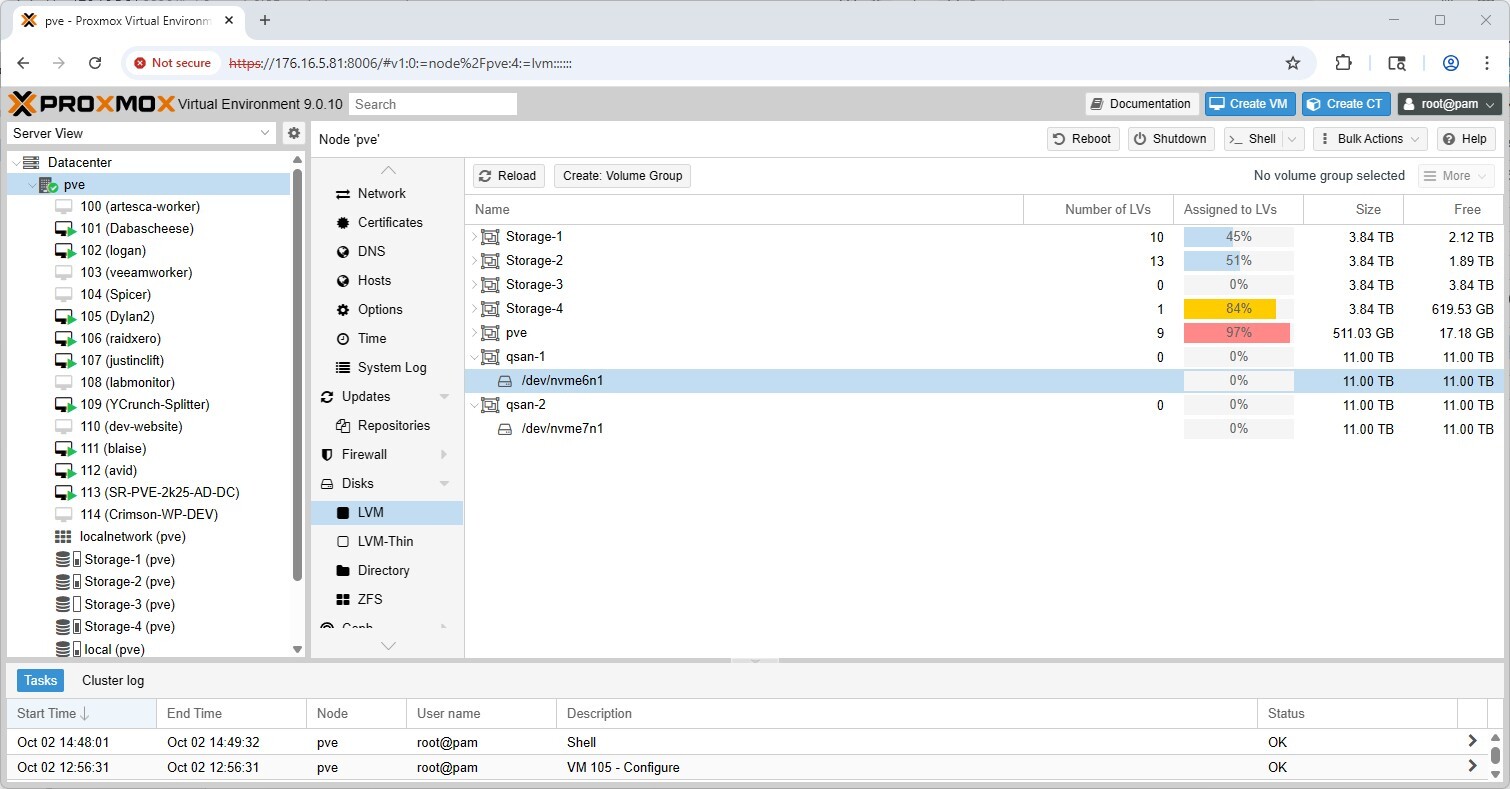
Una vez que el almacenamiento QSAN sea visible en la GUI de Proxmox, podemos crear un nuevo grupo de volúmenes LVM: pve > Discos > LVM, los dos dispositivos de 11 TB (/dev/nvme6n1 y /dev/nvme7n1) aparecen y se pueden inicializar como grupos de volúmenes separados (por ejemplo, qsan-1 y qsan-2) para usar con máquinas virtuales y contenedores.
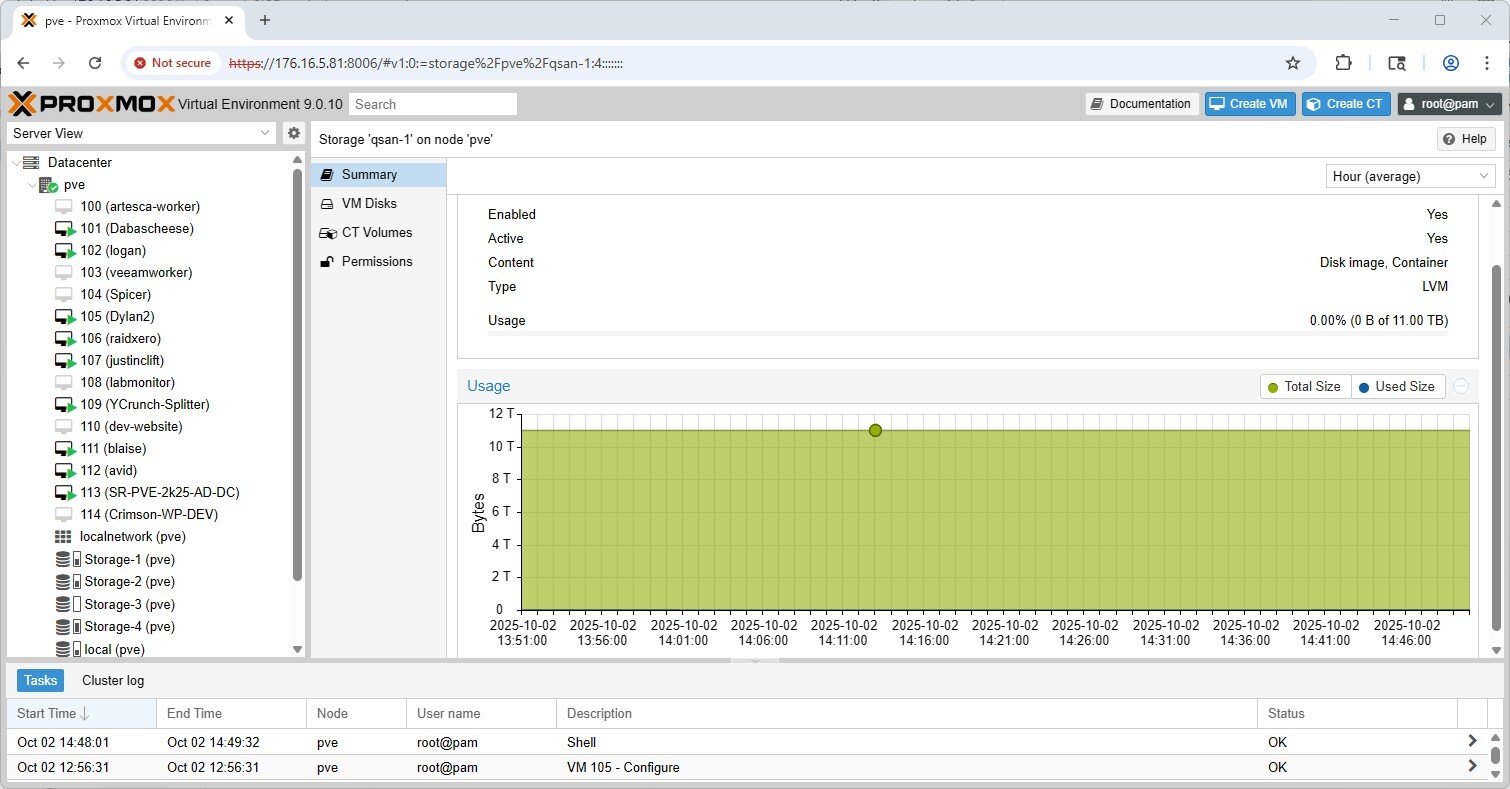
Al hacer clic en uno de nuestros nuevos grupos LVM (qsan-1) en el panel de almacenamiento, se muestra que está en línea, habilitado y disponible para su uso, con la capacidad completa de 11 TB y listo para el aprovisionamiento de máquinas virtuales y contenedores.
Test de rendimiento
Probamos el QSAN XN4226D en dos entornos, utilizando diferentes plataformas de prueba. Nuestro primer entorno se basó en un Dell PowerEdge R750, equipado con cuatro tarjetas de red NVIDIA ConnectX-5 de doble puerto y 25 G. Conectamos directamente el QSAN XN4226D a este servidor mediante ocho cables DAC. Esta configuración utilizó todos los puertos de red disponibles en el QSAN, lo que nos permitió demostrar su máximo rendimiento.
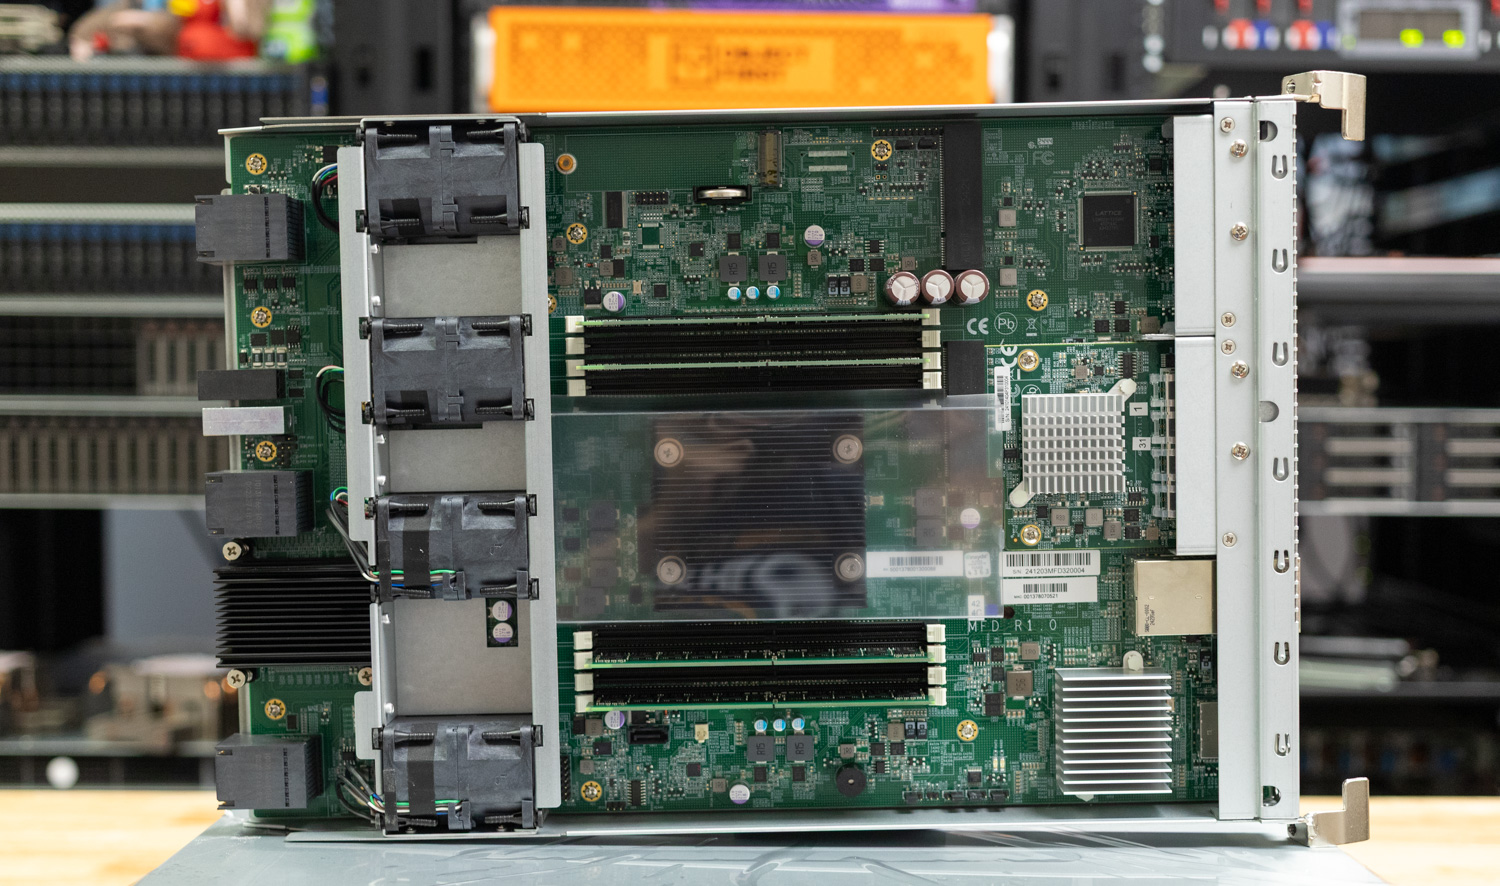
Para la prueba FIO, utilizamos dos grupos de almacenamiento RAID6, creando ocho volúmenes de bloque distribuidos uniformemente entre ambos controladores. Cada volumen se asignó a un destino único, con una única dirección IP dedicada a cada volumen. Medimos NVMe-oF RDMA y TCP en esta plataforma.
El segundo entorno para GDSIO utilizó un Dell PowerEdge R7715, equipado con dos GPU NVIDIA H100 y una tarjeta de red Broadcom de 25 Gb de cuatro puertos. En este entorno, mantuvimos la misma distribución de volúmenes QSAN, aunque redujimos el número de volúmenes de ocho a cuatro. Con una tarjeta de red de cuatro puertos, utilizamos cuatro conexiones de 25 Gb para conectar directamente el servidor a la matriz de almacenamiento.
Punto de referencia de rendimiento de FIO
Para medir el rendimiento de almacenamiento del QSAN XN4226D, aplicamos métricas comunes de la industria y utilizamos la herramienta FIO. Cada dispositivo de almacenamiento se somete al mismo proceso de prueba, que incluye un paso de preacondicionamiento con dos llenados completos de la unidad con una carga de trabajo de escritura secuencial, seguido de la medición del rendimiento en estado estable. A medida que cambia el tipo de carga de trabajo medida, ejecutamos otro llenado de preacondicionamiento con ese nuevo tamaño de transferencia.
En esta sección nos centraremos en los siguientes puntos de referencia de FIO:
- 1M secuencial
- 64K aleatorio
- 16K aleatorio
- 4K aleatorio
1M de ancho de banda de escritura secuencial
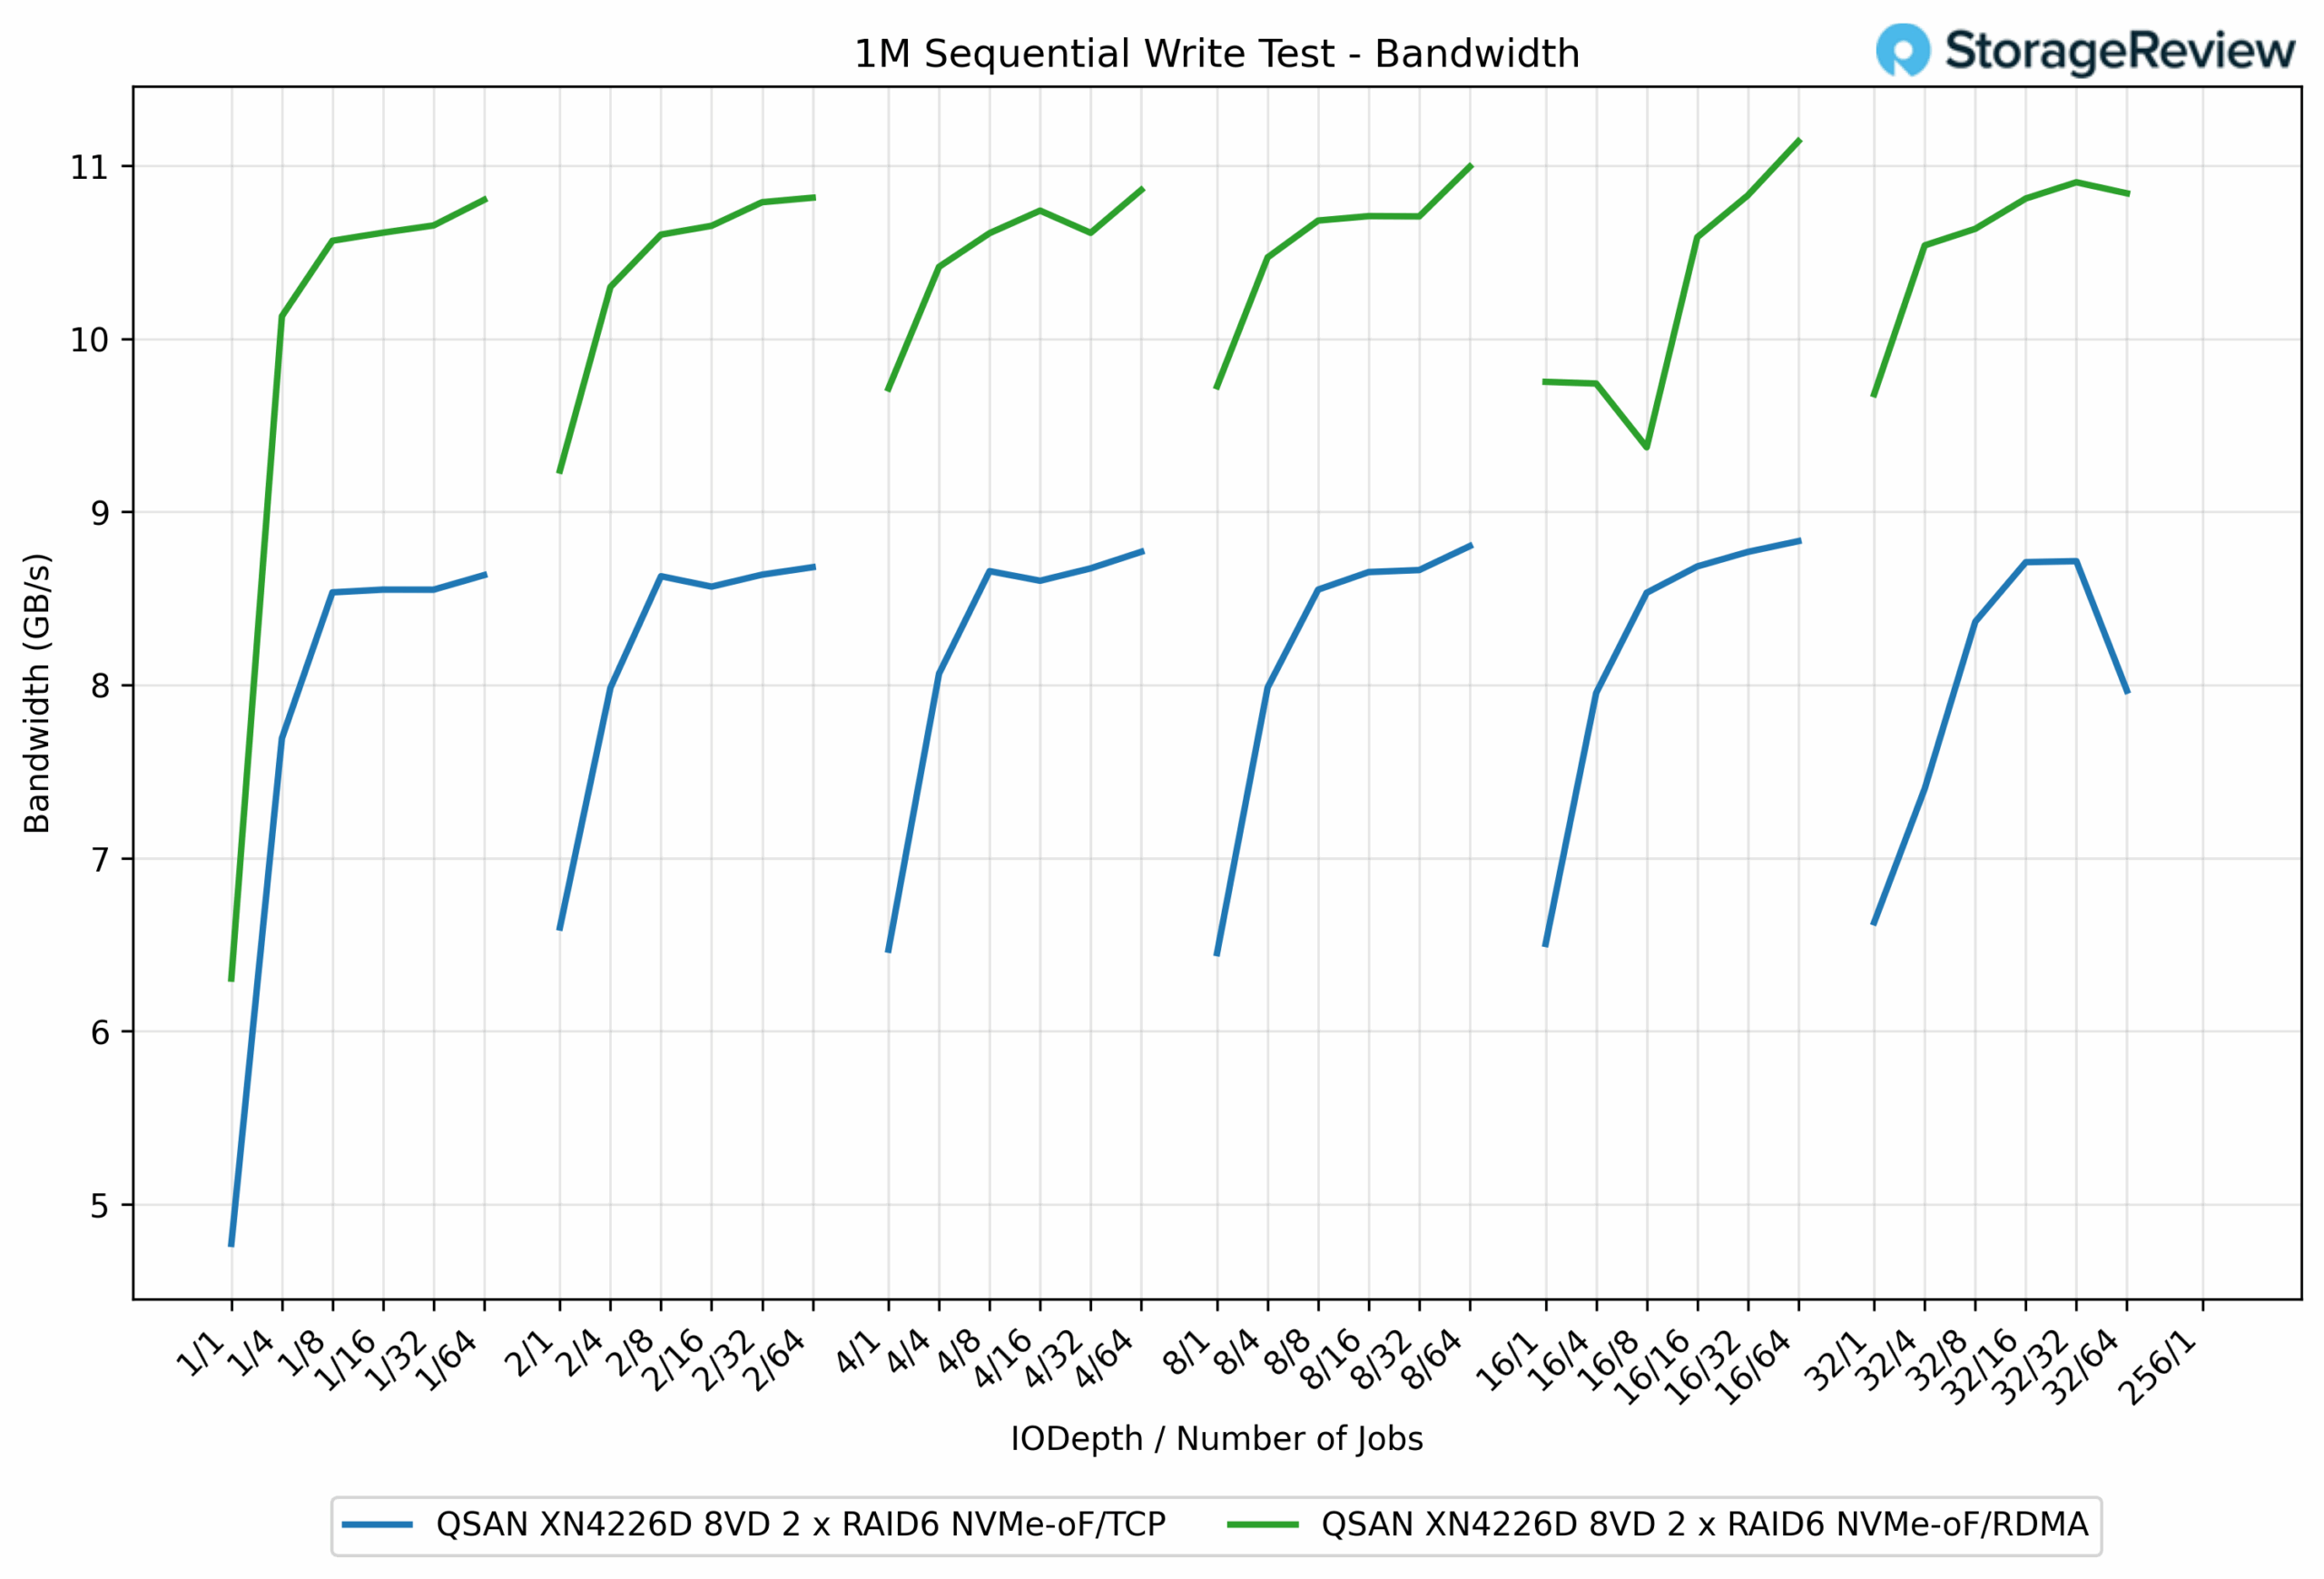
En la prueba de escritura secuencial de 1M, NVMe sobre RDMA proporcionó consistentemente un mayor ancho de banda en casi todas las profundidades de cola y cantidades de trabajos, en comparación con NVMe sobre TCP. En su punto máximo, RDMA alcanzó 11.14 GB/s, mientras que TCP alcanzó un máximo de 8.83 GB/s, una diferencia de aproximadamente el 26 % a favor de RDMA. Incluso con profundidades de cola más bajas, RDMA mantuvo su ventaja. Por ejemplo, en el trabajo QD1/1, registró 6.30 GB/s, superando los 4.77 GB/s de TCP en aproximadamente un 32 %.
La diferencia de rendimiento entre ambos protocolos se redujo ligeramente a medida que aumentaban las cargas de trabajo, pero RDMA mantuvo una clara ventaja en todo momento. TCP se mantuvo consistentemente en el rango de 8.5 a 8.8 GB/s en múltiples puntos de prueba, mientras que RDMA superó con frecuencia los 10.5 GB/s, alcanzando un máximo de poco más de 11 GB/s.
Latencia de escritura secuencial de 1 M
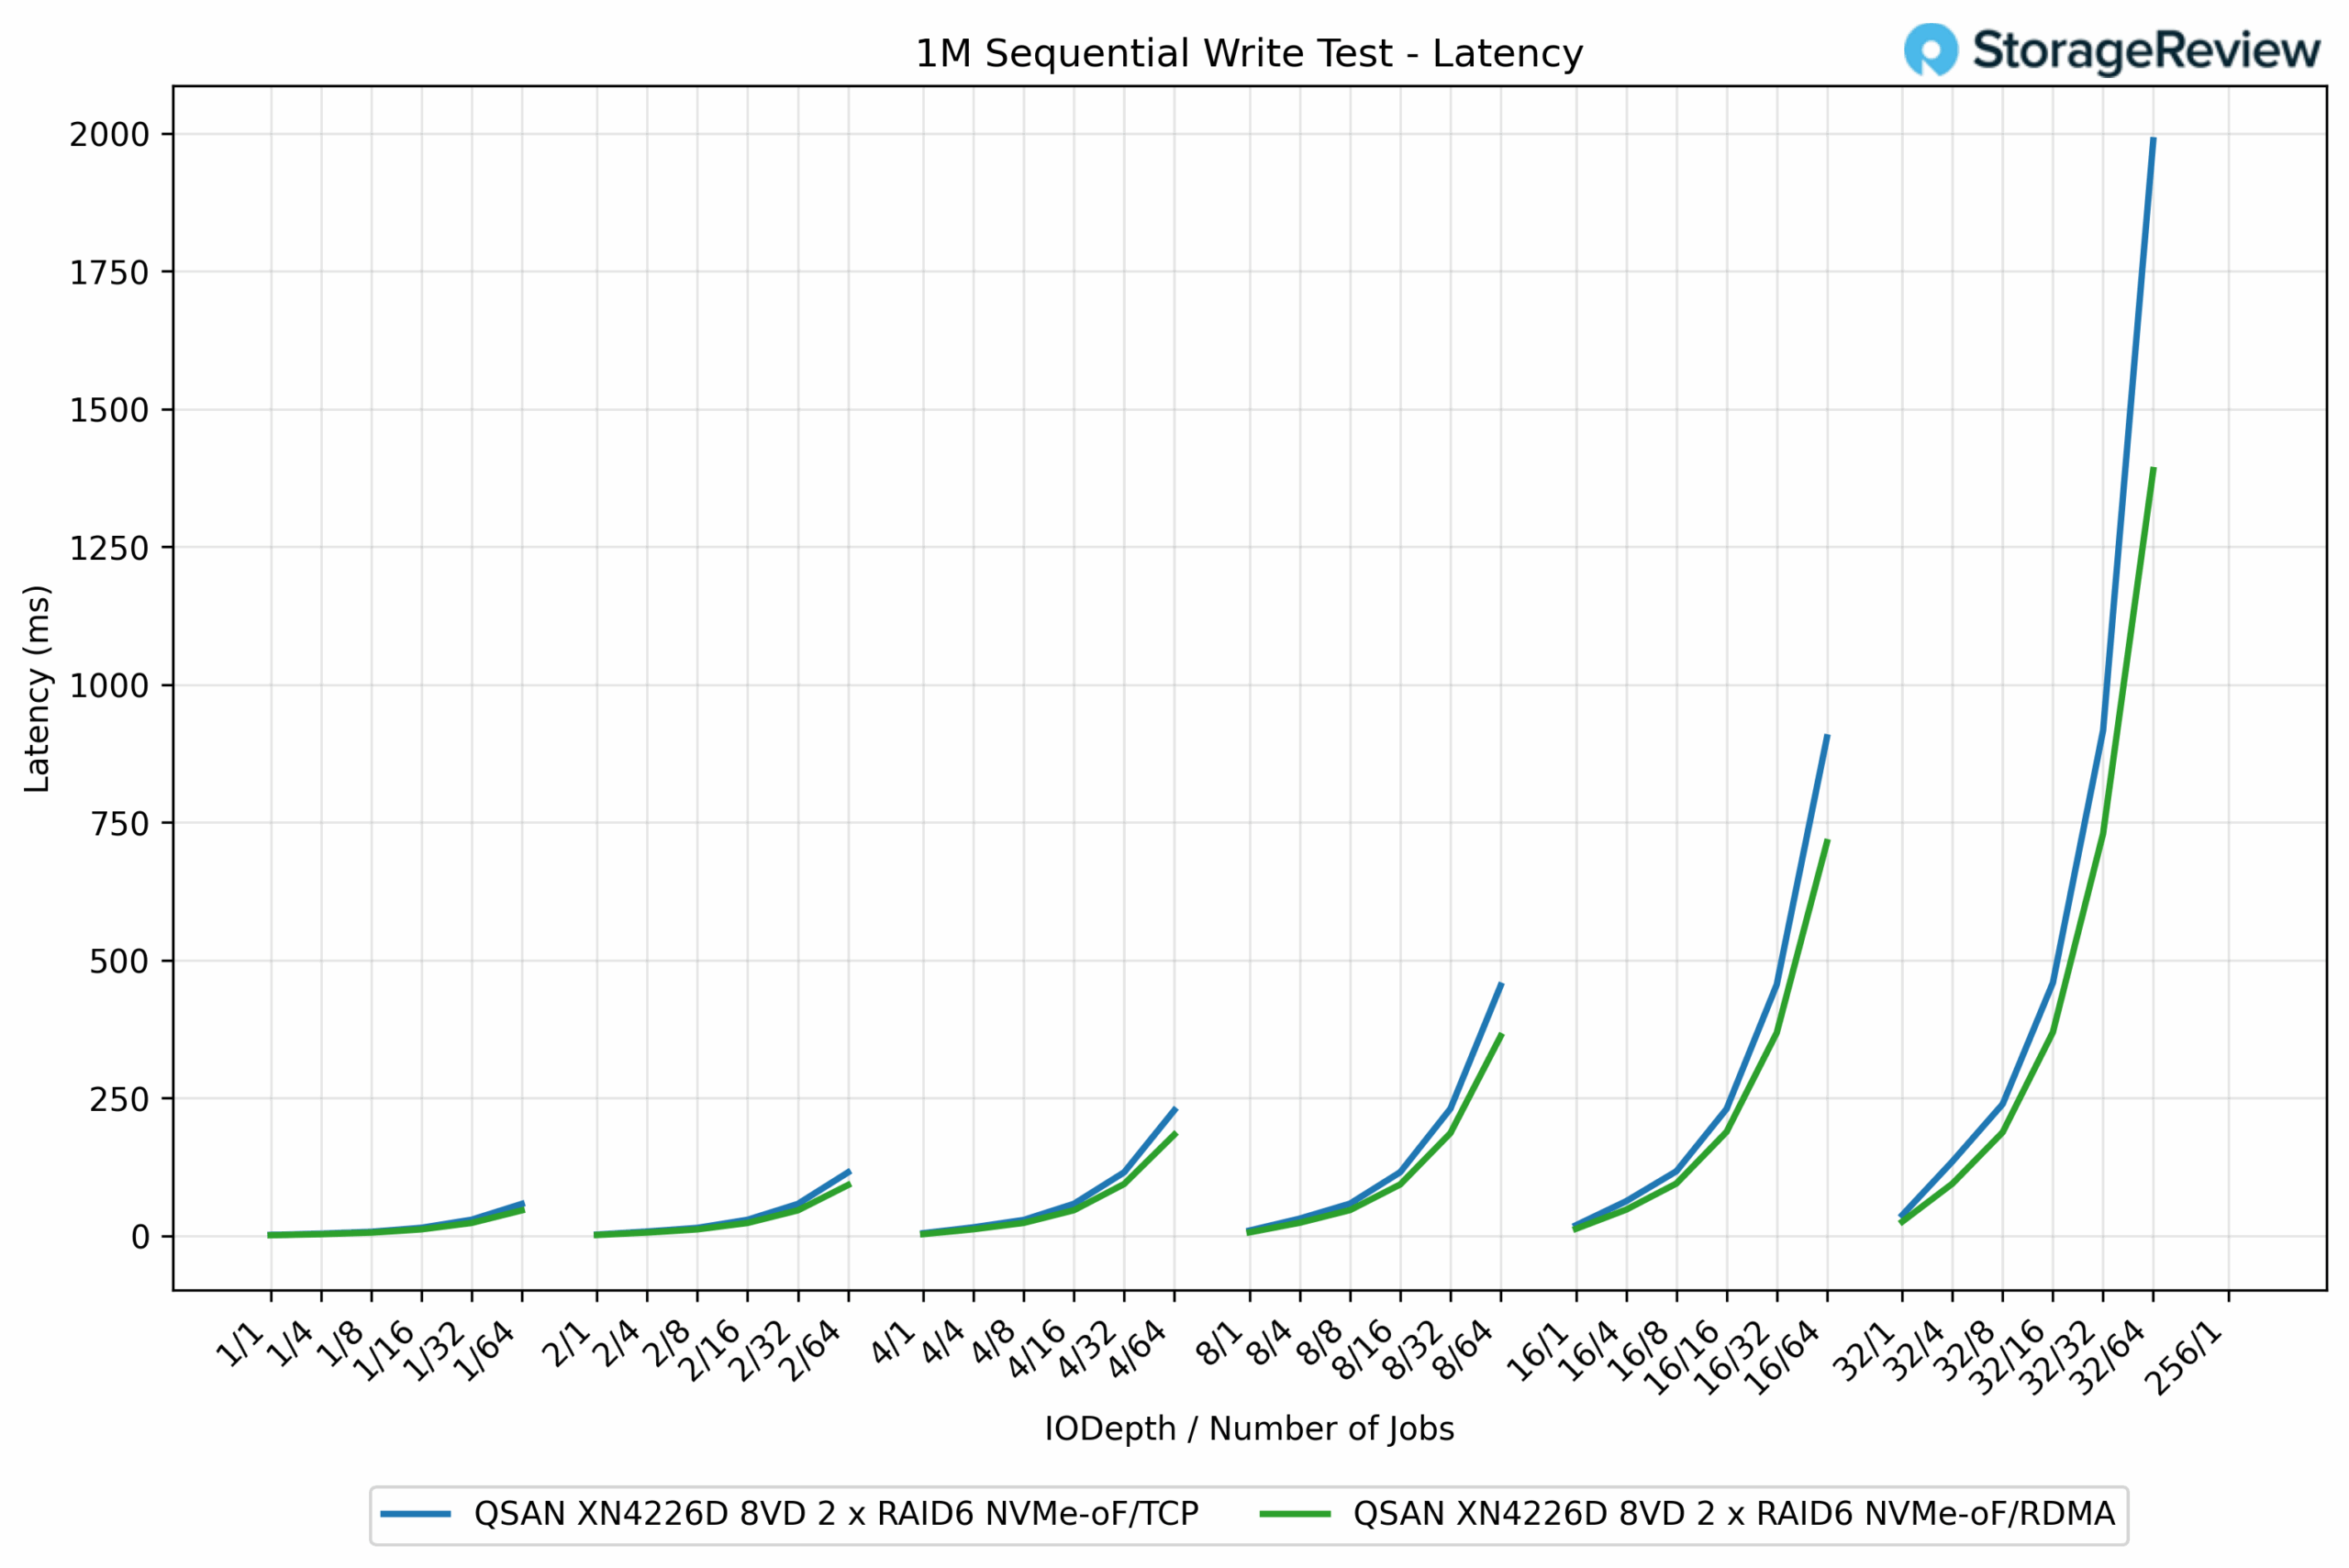
En la prueba de latencia de escritura secuencial de 1 M, RDMA mantuvo una clara ventaja de eficiencia sobre TCP en la mayoría de las profundidades de cola y el número de trabajos. Con cargas de trabajo más ligeras, ambos protocolos se mantuvieron prácticamente iguales, mostrando latencias inferiores a 5 ms. Sin embargo, a medida que aumentaba la concurrencia, las diferencias se hicieron más evidentes. Por ejemplo, en trabajos QD16/16, RDMA registró 368.48 ms, mientras que TCP registró 455.95 ms, una mejora del 19 % para RDMA.
La divergencia se acentuó aún más en escalas extremas. En la tarea QD256/1, RDMA se completó en 1,389.16 ms, mientras que TCP alcanzó los 1,987.39 ms, lo que refleja una reducción del 43 % en la latencia a favor de RDMA. Esta tendencia destaca la capacidad de RDMA para mantener un mayor rendimiento manteniendo la latencia bajo control, especialmente en escenarios de alta carga.
Ancho de banda de lectura secuencial de 1 M
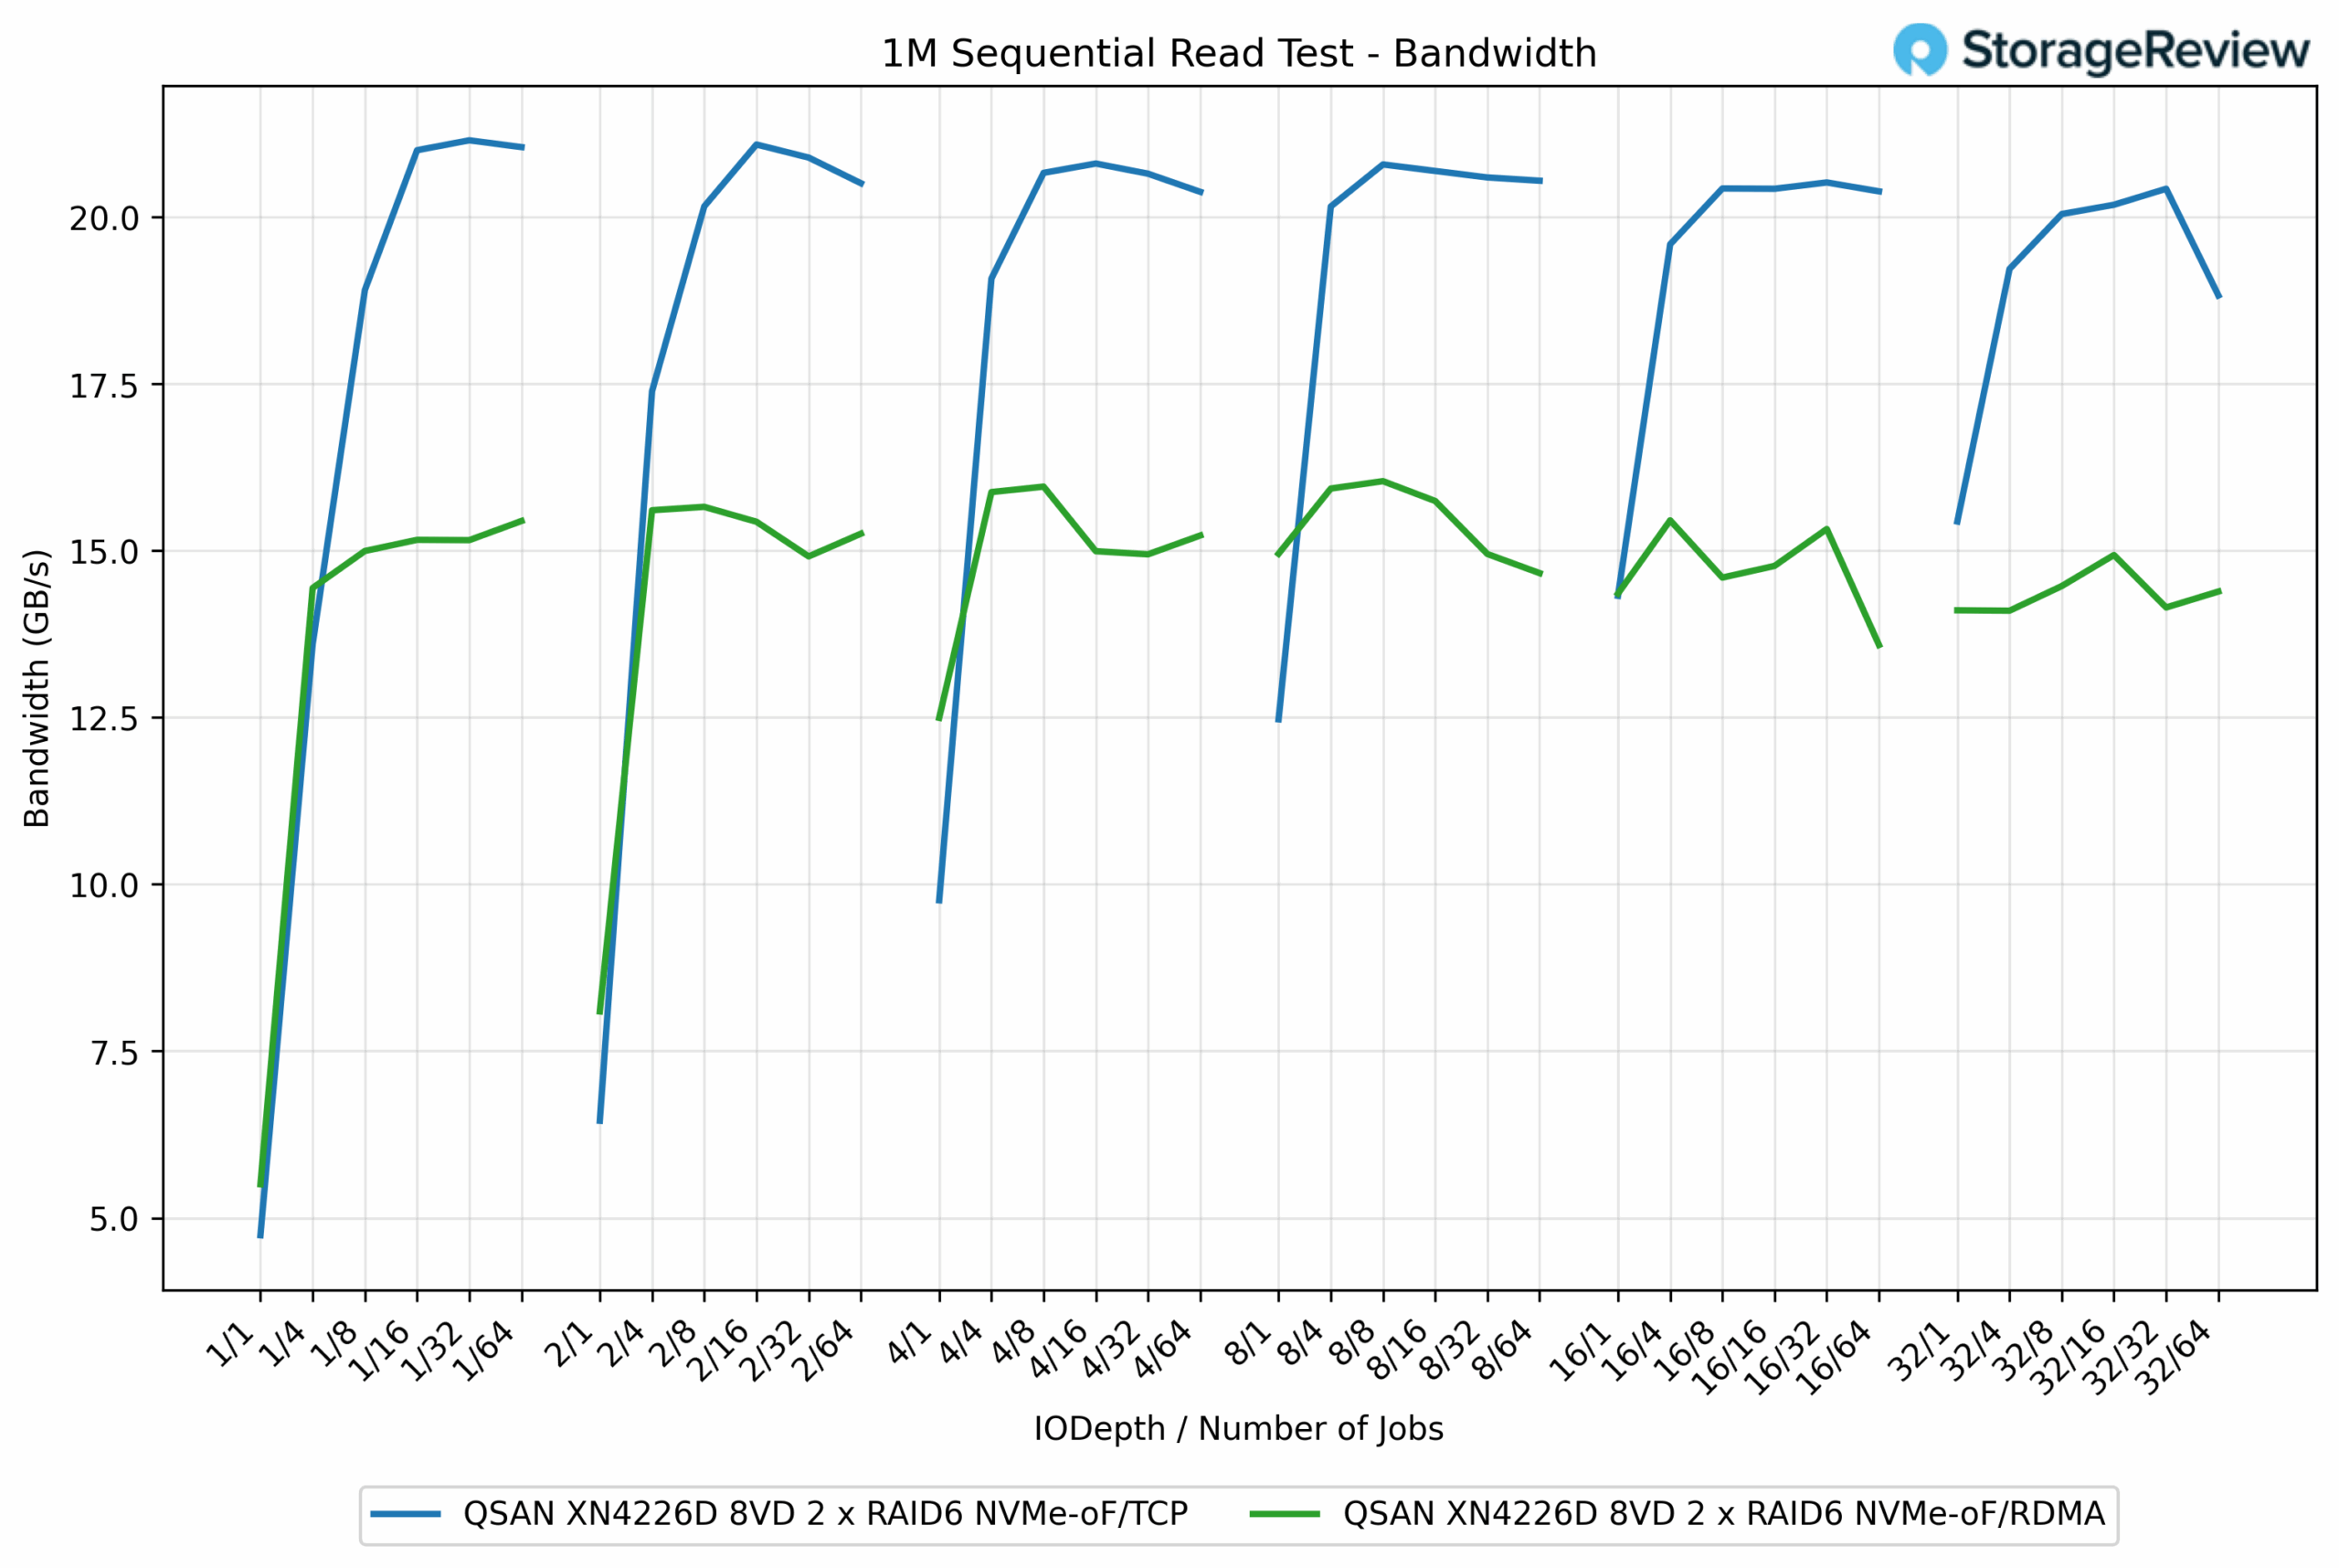
En la prueba de lectura secuencial de 1 millón de bytes, la dinámica de rendimiento cambió, con TCP superando claramente a RDMA en todos los ámbitos. TCP alcanzó un máximo de 21.21 GB/s, mientras que RDMA alcanzó los 15.96 GB/s, una diferencia de aproximadamente el 33 % a favor de TCP. Incluso con colas de menor profundidad, TCP avanzó rápidamente. Por ejemplo, en trabajos QD1/4, TCP entregó 18.91 GB/s, en comparación con los 15.05 GB/s de RDMA, una diferencia de más del 25 %.
La ventaja de TCP se mantuvo constante en prácticamente todas las escalas de carga de trabajo. Una vez saturada, TCP mantuvo resultados en el rango de 20-21 GB/s, mientras que RDMA se estancó cerca de los 15 GB/s. Esto indica que, si bien RDMA destaca en operaciones con escritura intensiva y sensibles a la latencia, TCP demuestra una mayor eficiencia de ancho de banda de lectura secuencial con la configuración RAID6 NVMe probada.
Latencia de lectura secuencial de 1 M
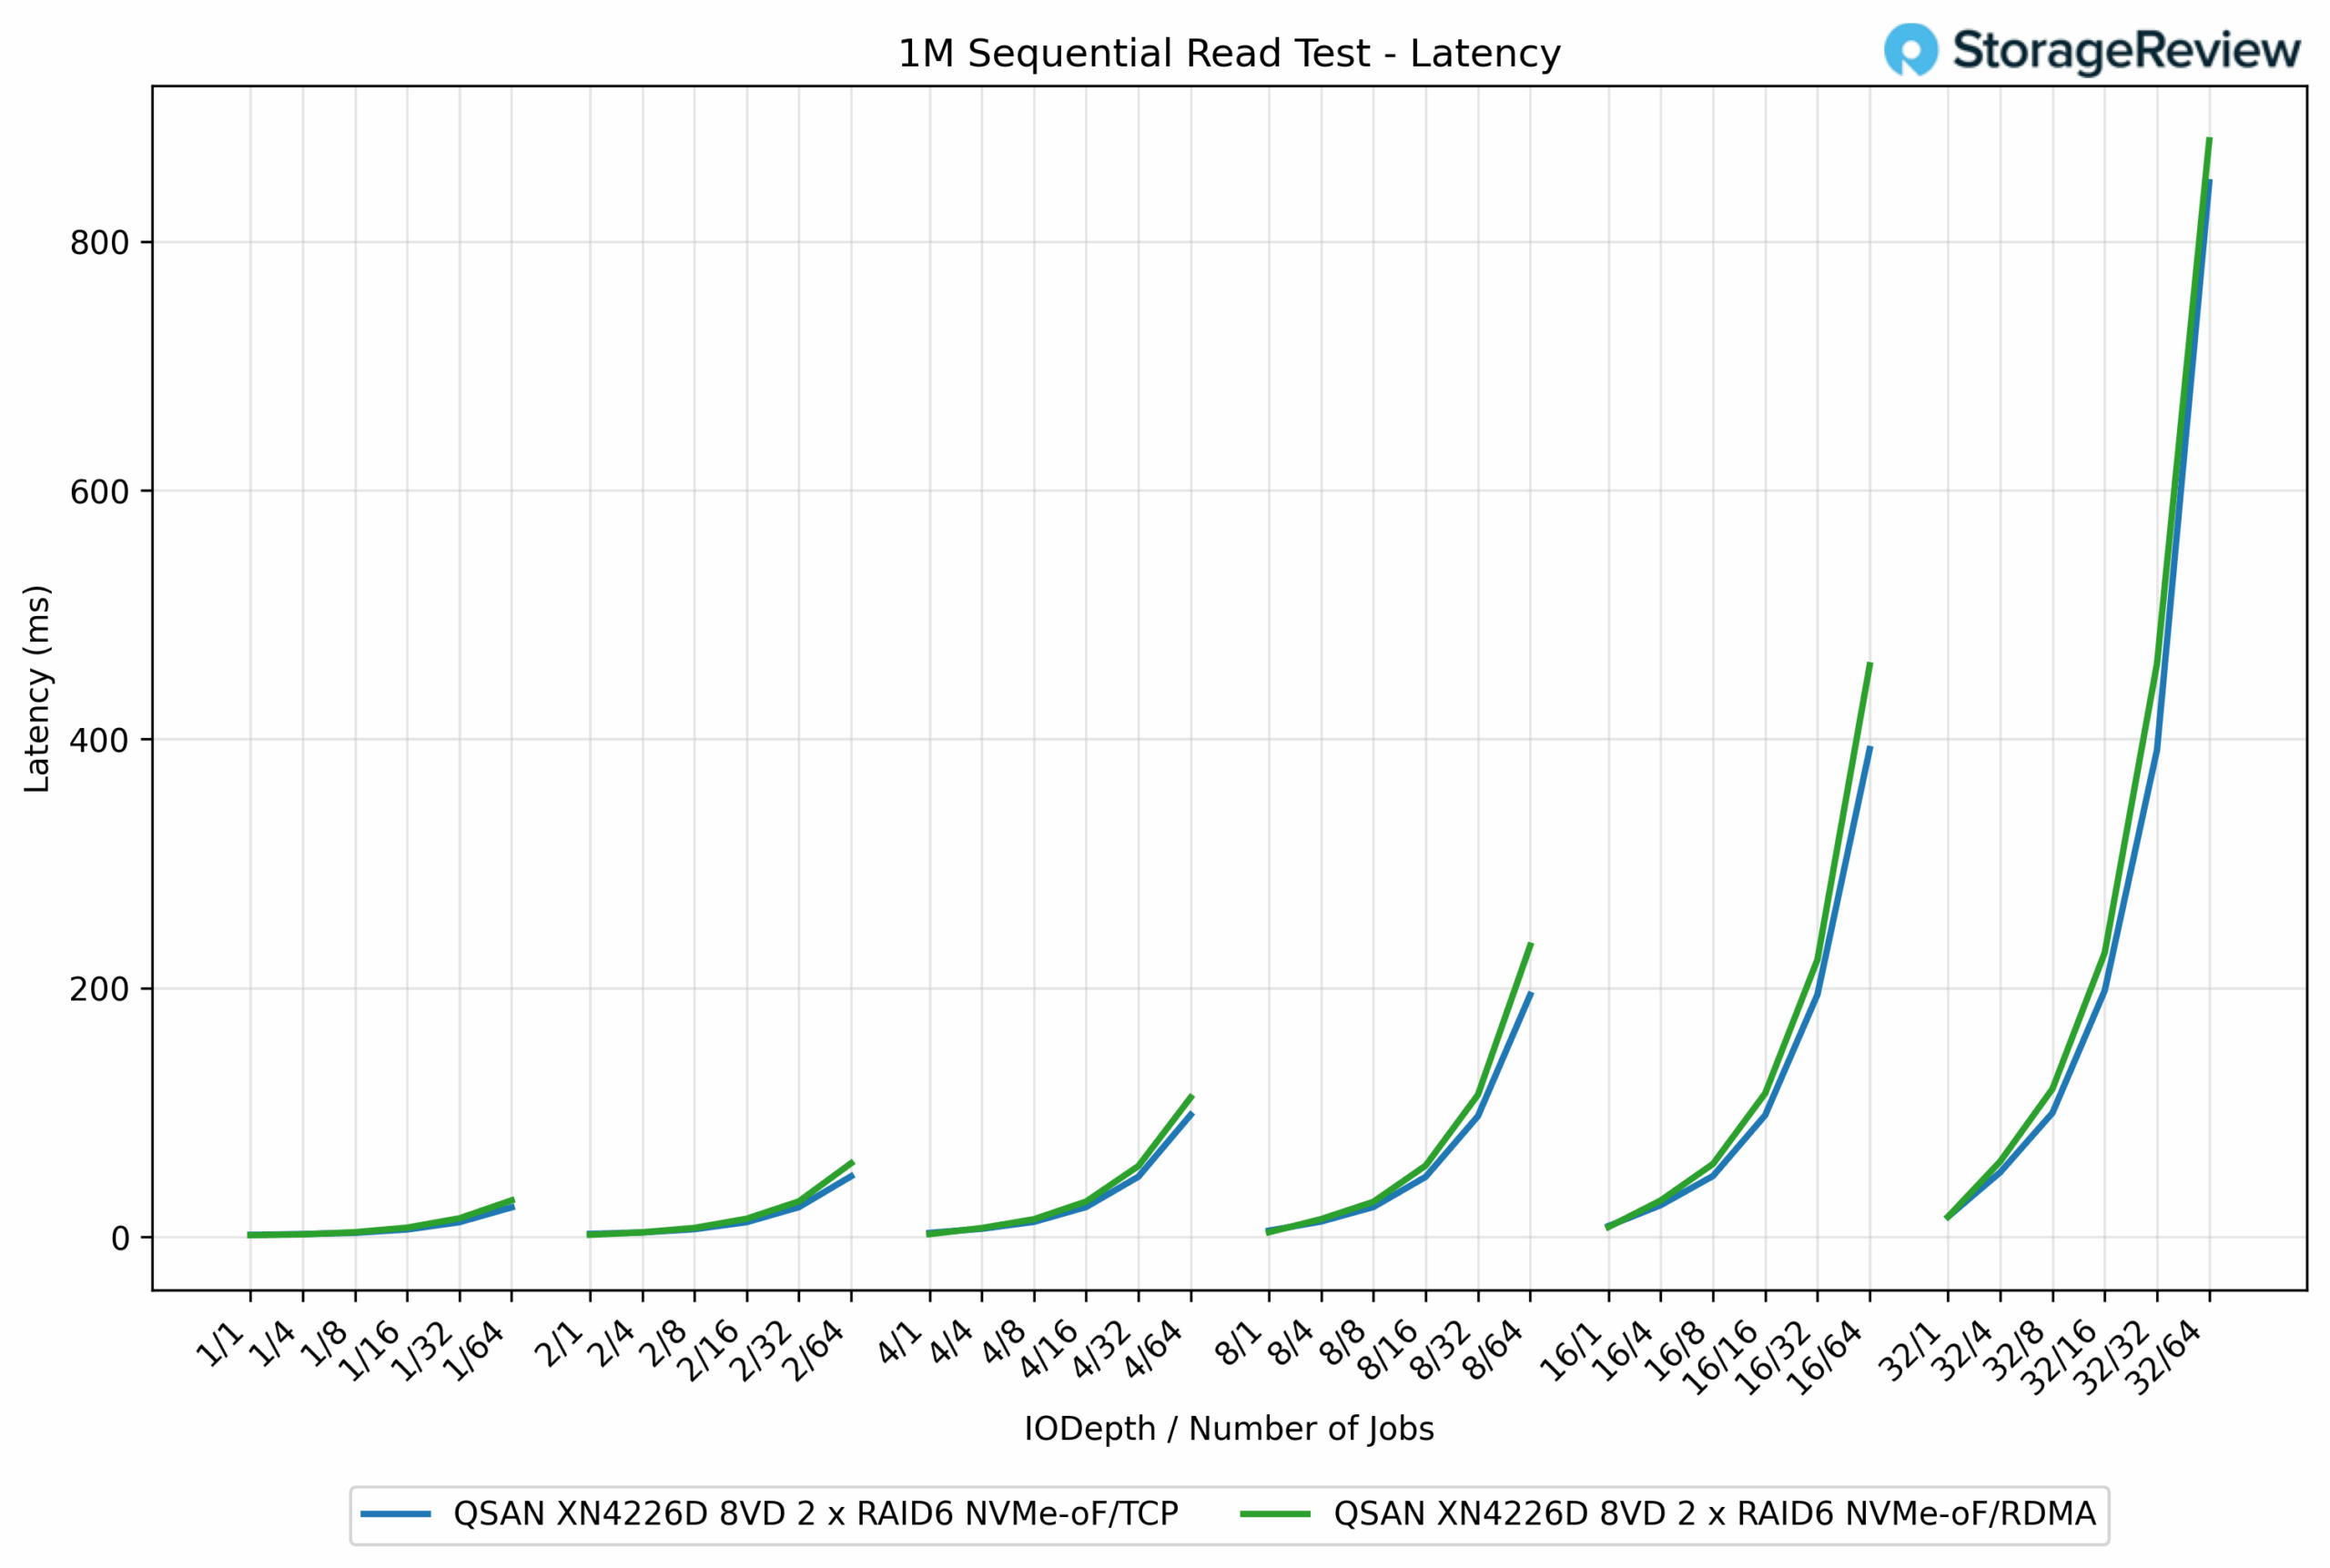
En la prueba de latencia de lectura secuencial de 1 M, los resultados fueron más similares entre ambos protocolos, aunque RDMA, en general, mantuvo una ligera ventaja a mayor profundidad de cola. Con cargas de trabajo más ligeras, los perfiles de latencia fueron casi idénticos, manteniéndose ambos por debajo de los 5 ms hasta que la concurrencia comenzó a aumentar. Por ejemplo, en trabajos QD8/64, TCP registró 234.09 ms, mientras que RDMA registró un valor inferior, 194.54 ms, lo que refleja una reducción del 17 %.
Esta tendencia continuó con cargas más pesadas. En trabajos QD32/64, RDMA registró 847.59 ms, en comparación con los 881.31 ms de TCP, una ligera mejora del 3.8 %, pero consistente con la menor sobrecarga de pila de RDMA. Dicho esto, ambos protocolos escalaron con un patrón similar, con una latencia que aumentaba previsiblemente a medida que se intensificaba la carga de trabajo.
64k IOPS de escritura aleatoria
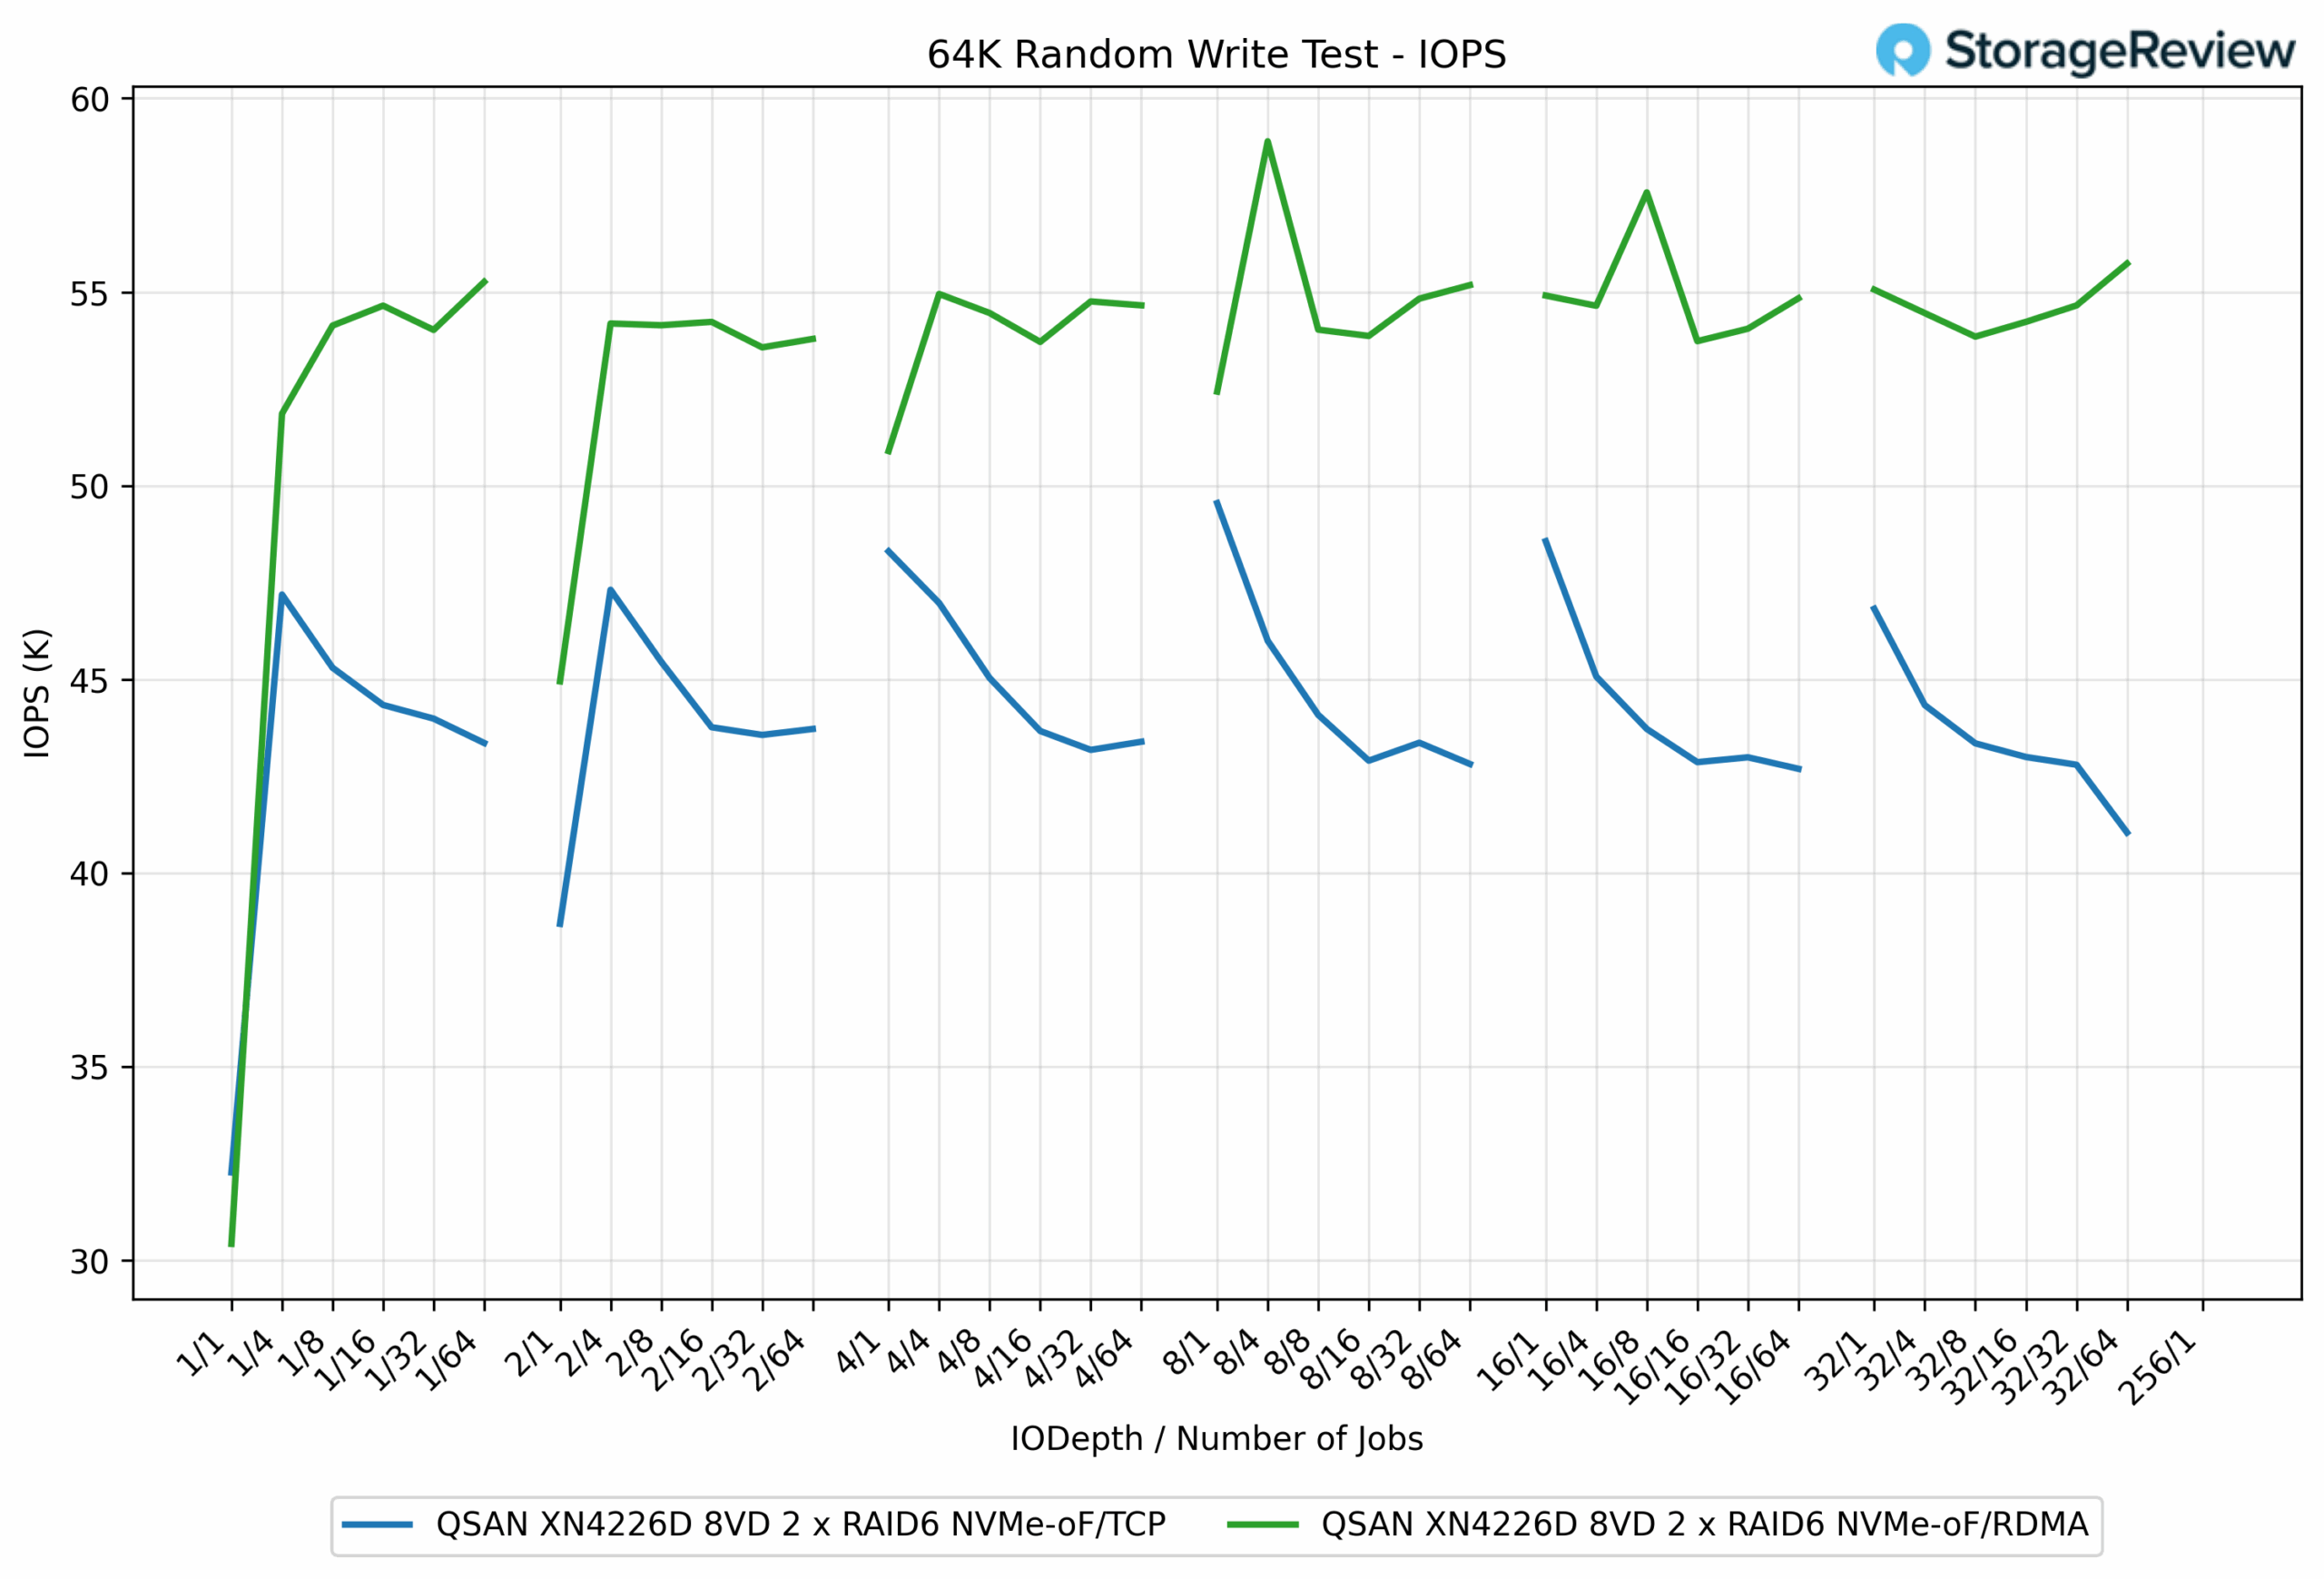
En la prueba de escritura aleatoria de 64 K, RDMA proporcionó consistentemente mayores IOPS que TCP, lo que destaca su eficiencia al gestionar operaciones aleatorias paralelizadas. En su punto máximo, RDMA alcanzó 58 890 IOPS, mientras que TCP se quedó atrás con 48 570 IOPS, lo que representa una ventaja de rendimiento del 21 %.
La brecha entre los dos protocolos estuvo presente durante toda la prueba. Por ejemplo, en los trabajos QD1/16, RDMA registró 54 130 IOPS, en comparación con las 45 300 IOPS de TCP, una diferencia de casi el 16 %. A medida que la carga de trabajo aumentó, RDMA mantuvo resultados entre 53 000 y 55 000 IOPS, mientras que TCP mantuvo resultados entre 42 000 y 46 000 IOPS.
Latencia de escritura aleatoria de 64K
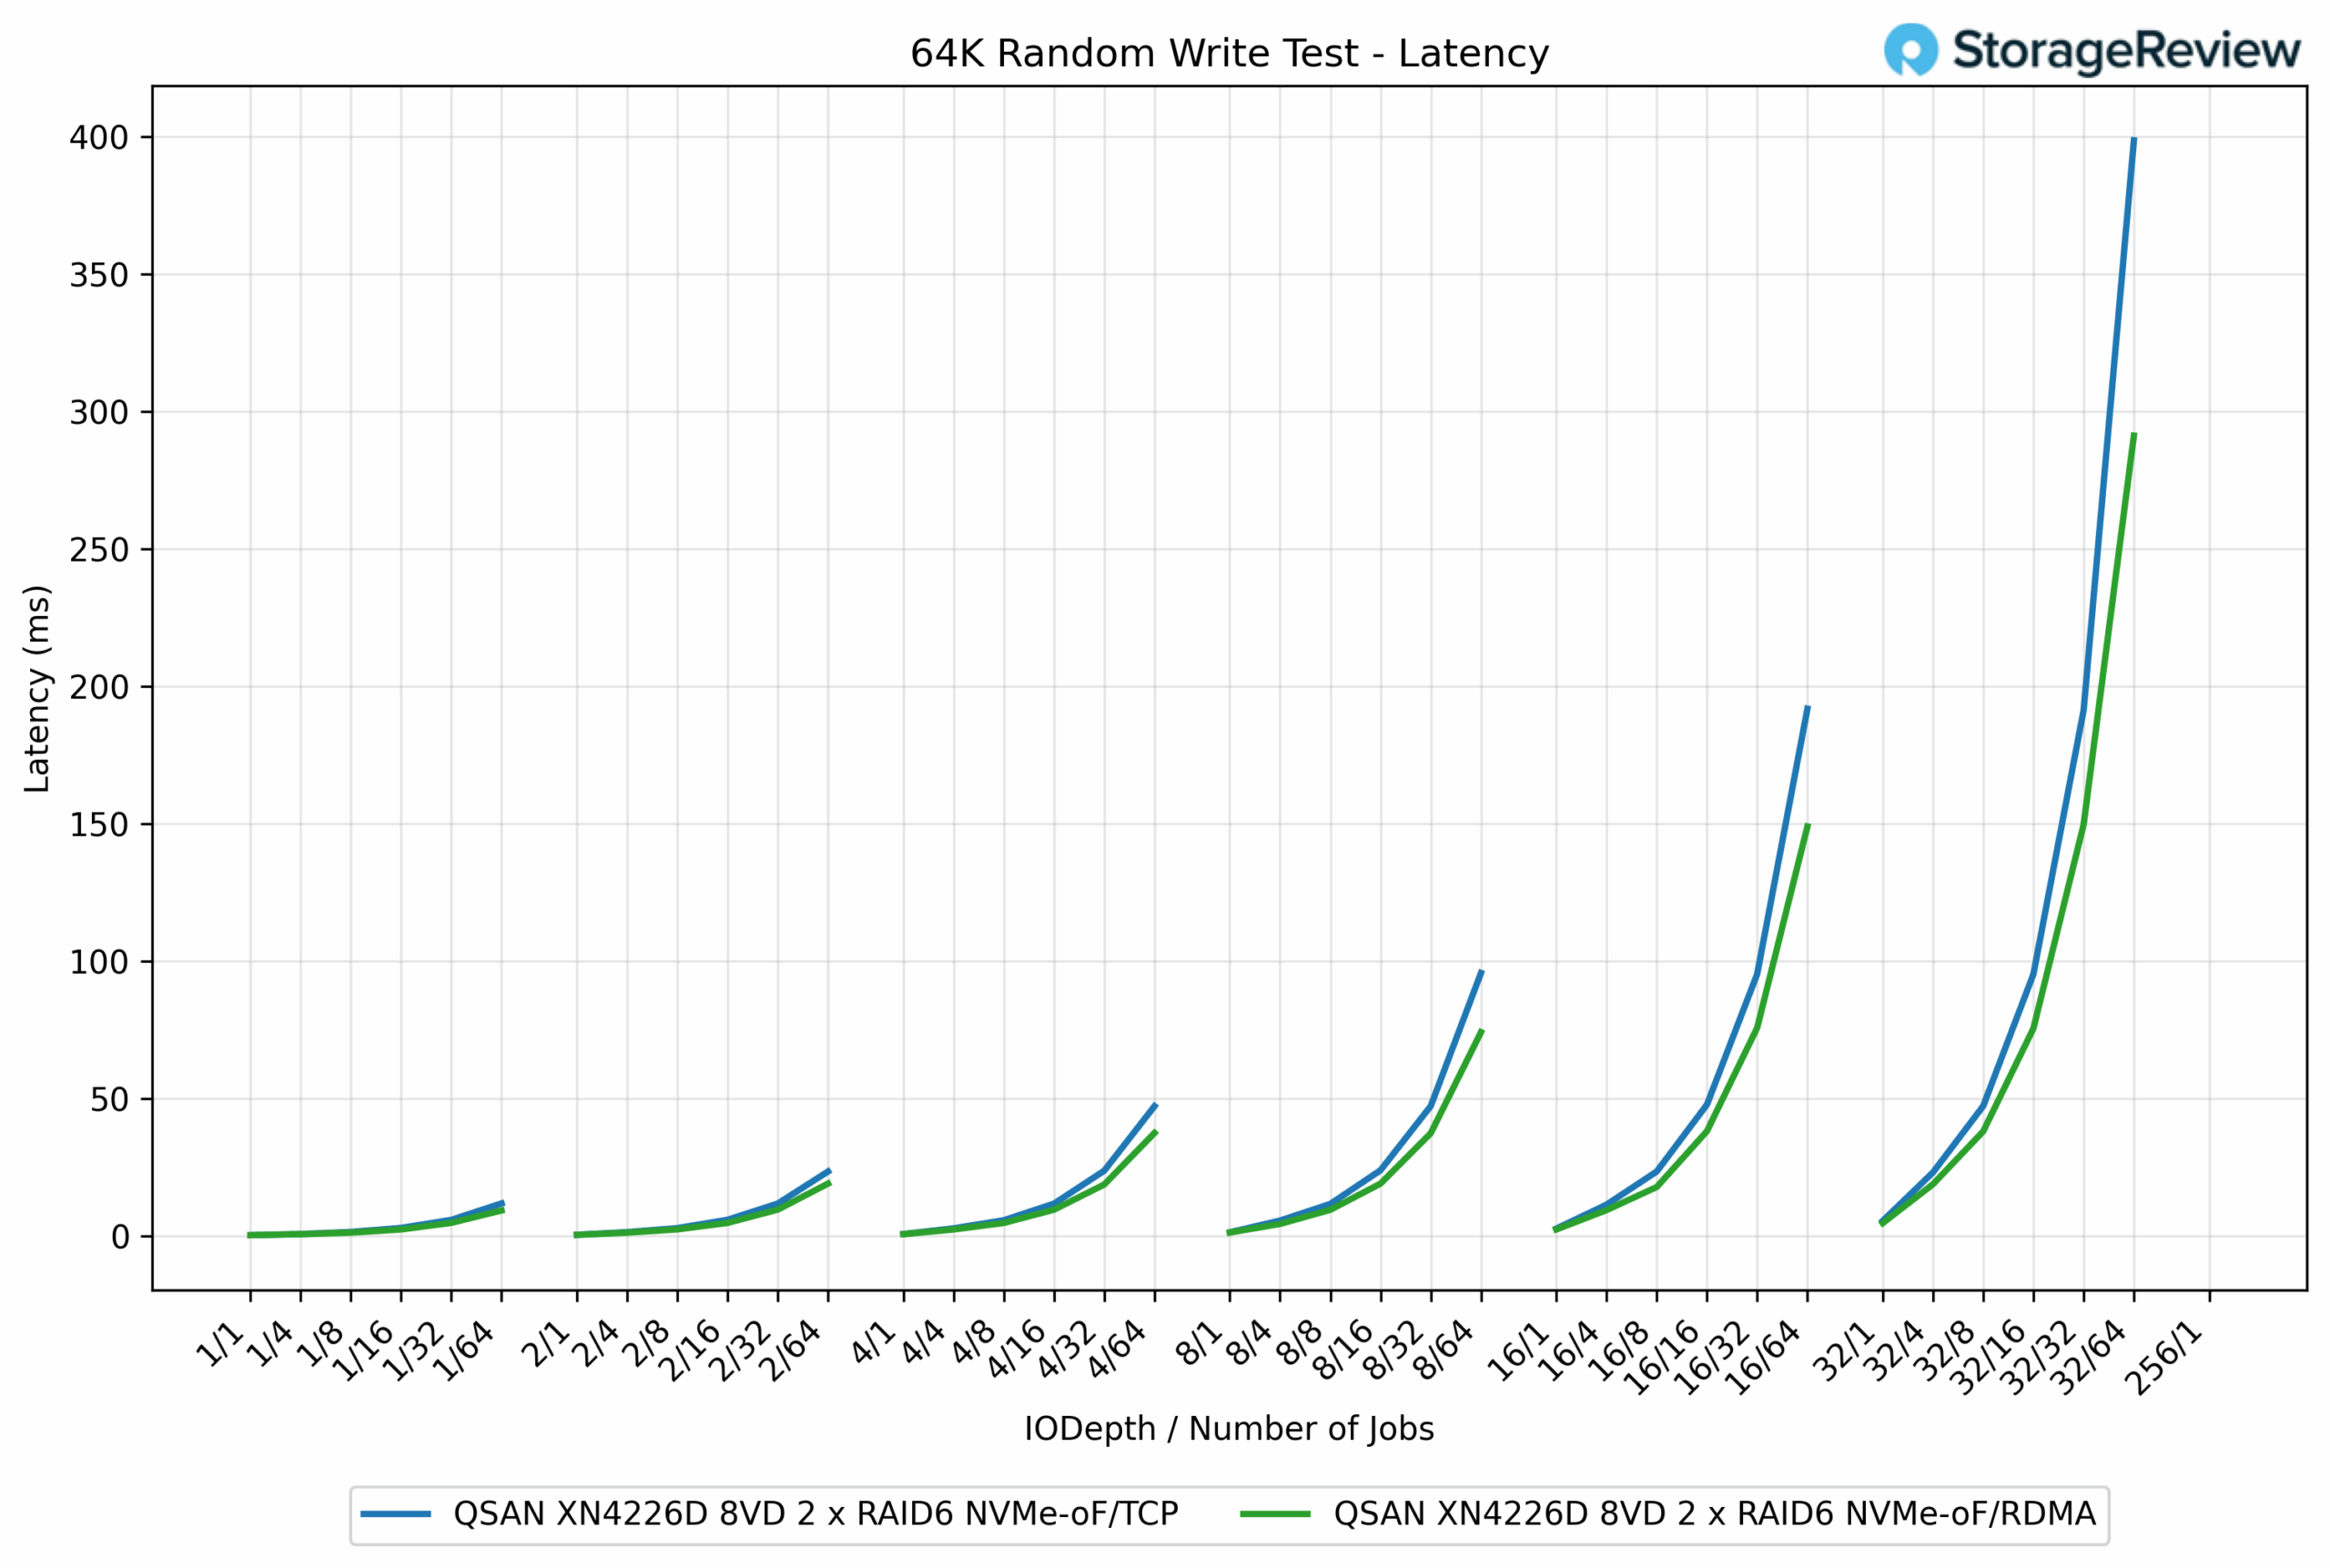
En la prueba de latencia de escritura aleatoria de 64K, RDMA volvió a demostrar tiempos de respuesta más bajos que TCP, especialmente al aumentar la profundidad de la cola y el número de trabajos. Con cargas más bajas, ambos protocolos tuvieron un rendimiento casi idéntico, manteniéndose por debajo de 1 ms. Por ejemplo, en el trabajo QD1/1, TCP registró 0.26 ms, mientras que RDMA se mantuvo prácticamente igual, con 0.25 ms.
Sin embargo, a medida que la carga de trabajo aumentó, RDMA mantuvo su ventaja en eficiencia. En los trabajos QD16/64, RDMA registró 74.09 ms, en comparación con los 95.64 ms de TCP, una diferencia de aproximadamente el 23 %. La diferencia se amplió aún más bajo la máxima tensión en el trabajo QD256/1, donde RDMA registró 291.13 ms, mientras que TCP alcanzó los 398.56 ms, casi un 37 % más.
IOPS de lectura aleatoria 64K
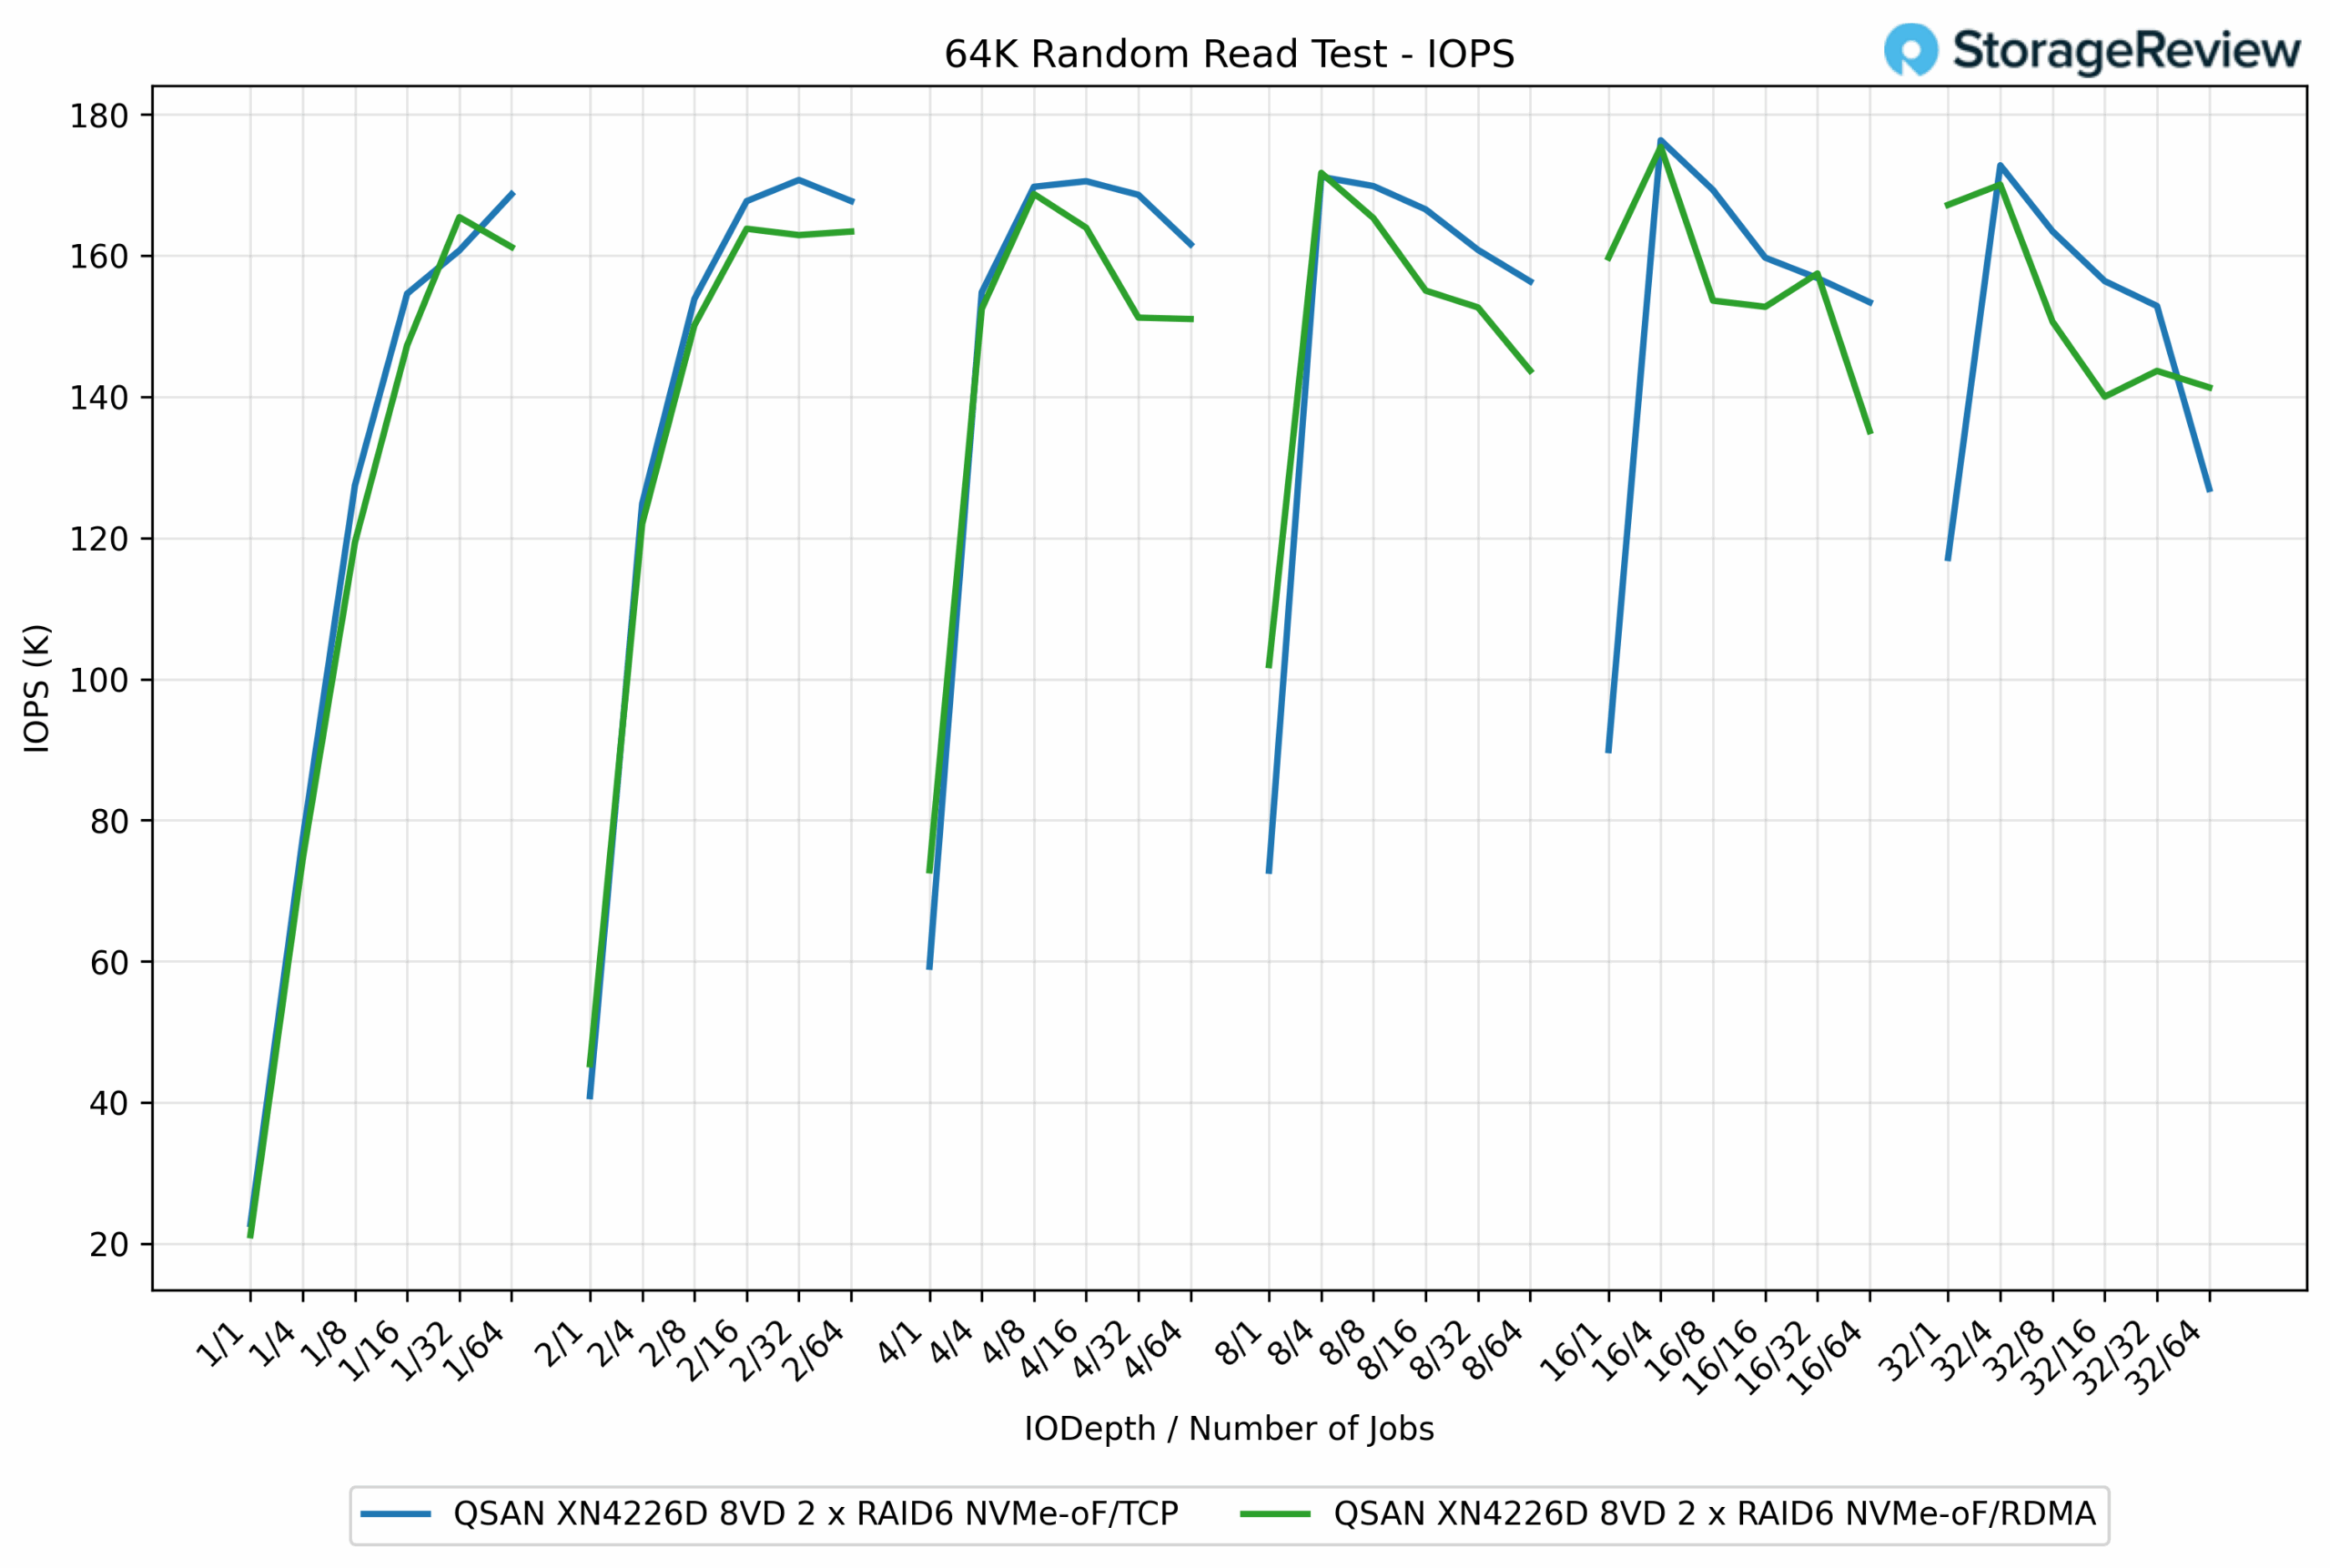
En la prueba de lectura aleatoria de 64 K, TCP y RDMA ofrecieron un rendimiento general muy similar, con ligeras variaciones de rendimiento entre ambos protocolos según la carga de trabajo. TCP alcanzó un máximo de 176 330 IOPS, mientras que RDMA le siguió de cerca con 175 400 IOPS, con una diferencia de tan solo el 0.5 %.
A profundidades moderadas, los resultados se mantuvieron muy agrupados. Por ejemplo, en los trabajos QD4/16, TCP registró 168.60 IOPS, seguido de RDMA con 163.94 IOPS, una diferencia inferior al 2.8 %. En otros puntos, RDMA registró un ligero aumento, como en los trabajos QD8/1, donde alcanzó 171.71 IOPS, en comparación con los 171.15 IOPS de TCP, prácticamente un empate.
Latencia de lectura aleatoria de 64K
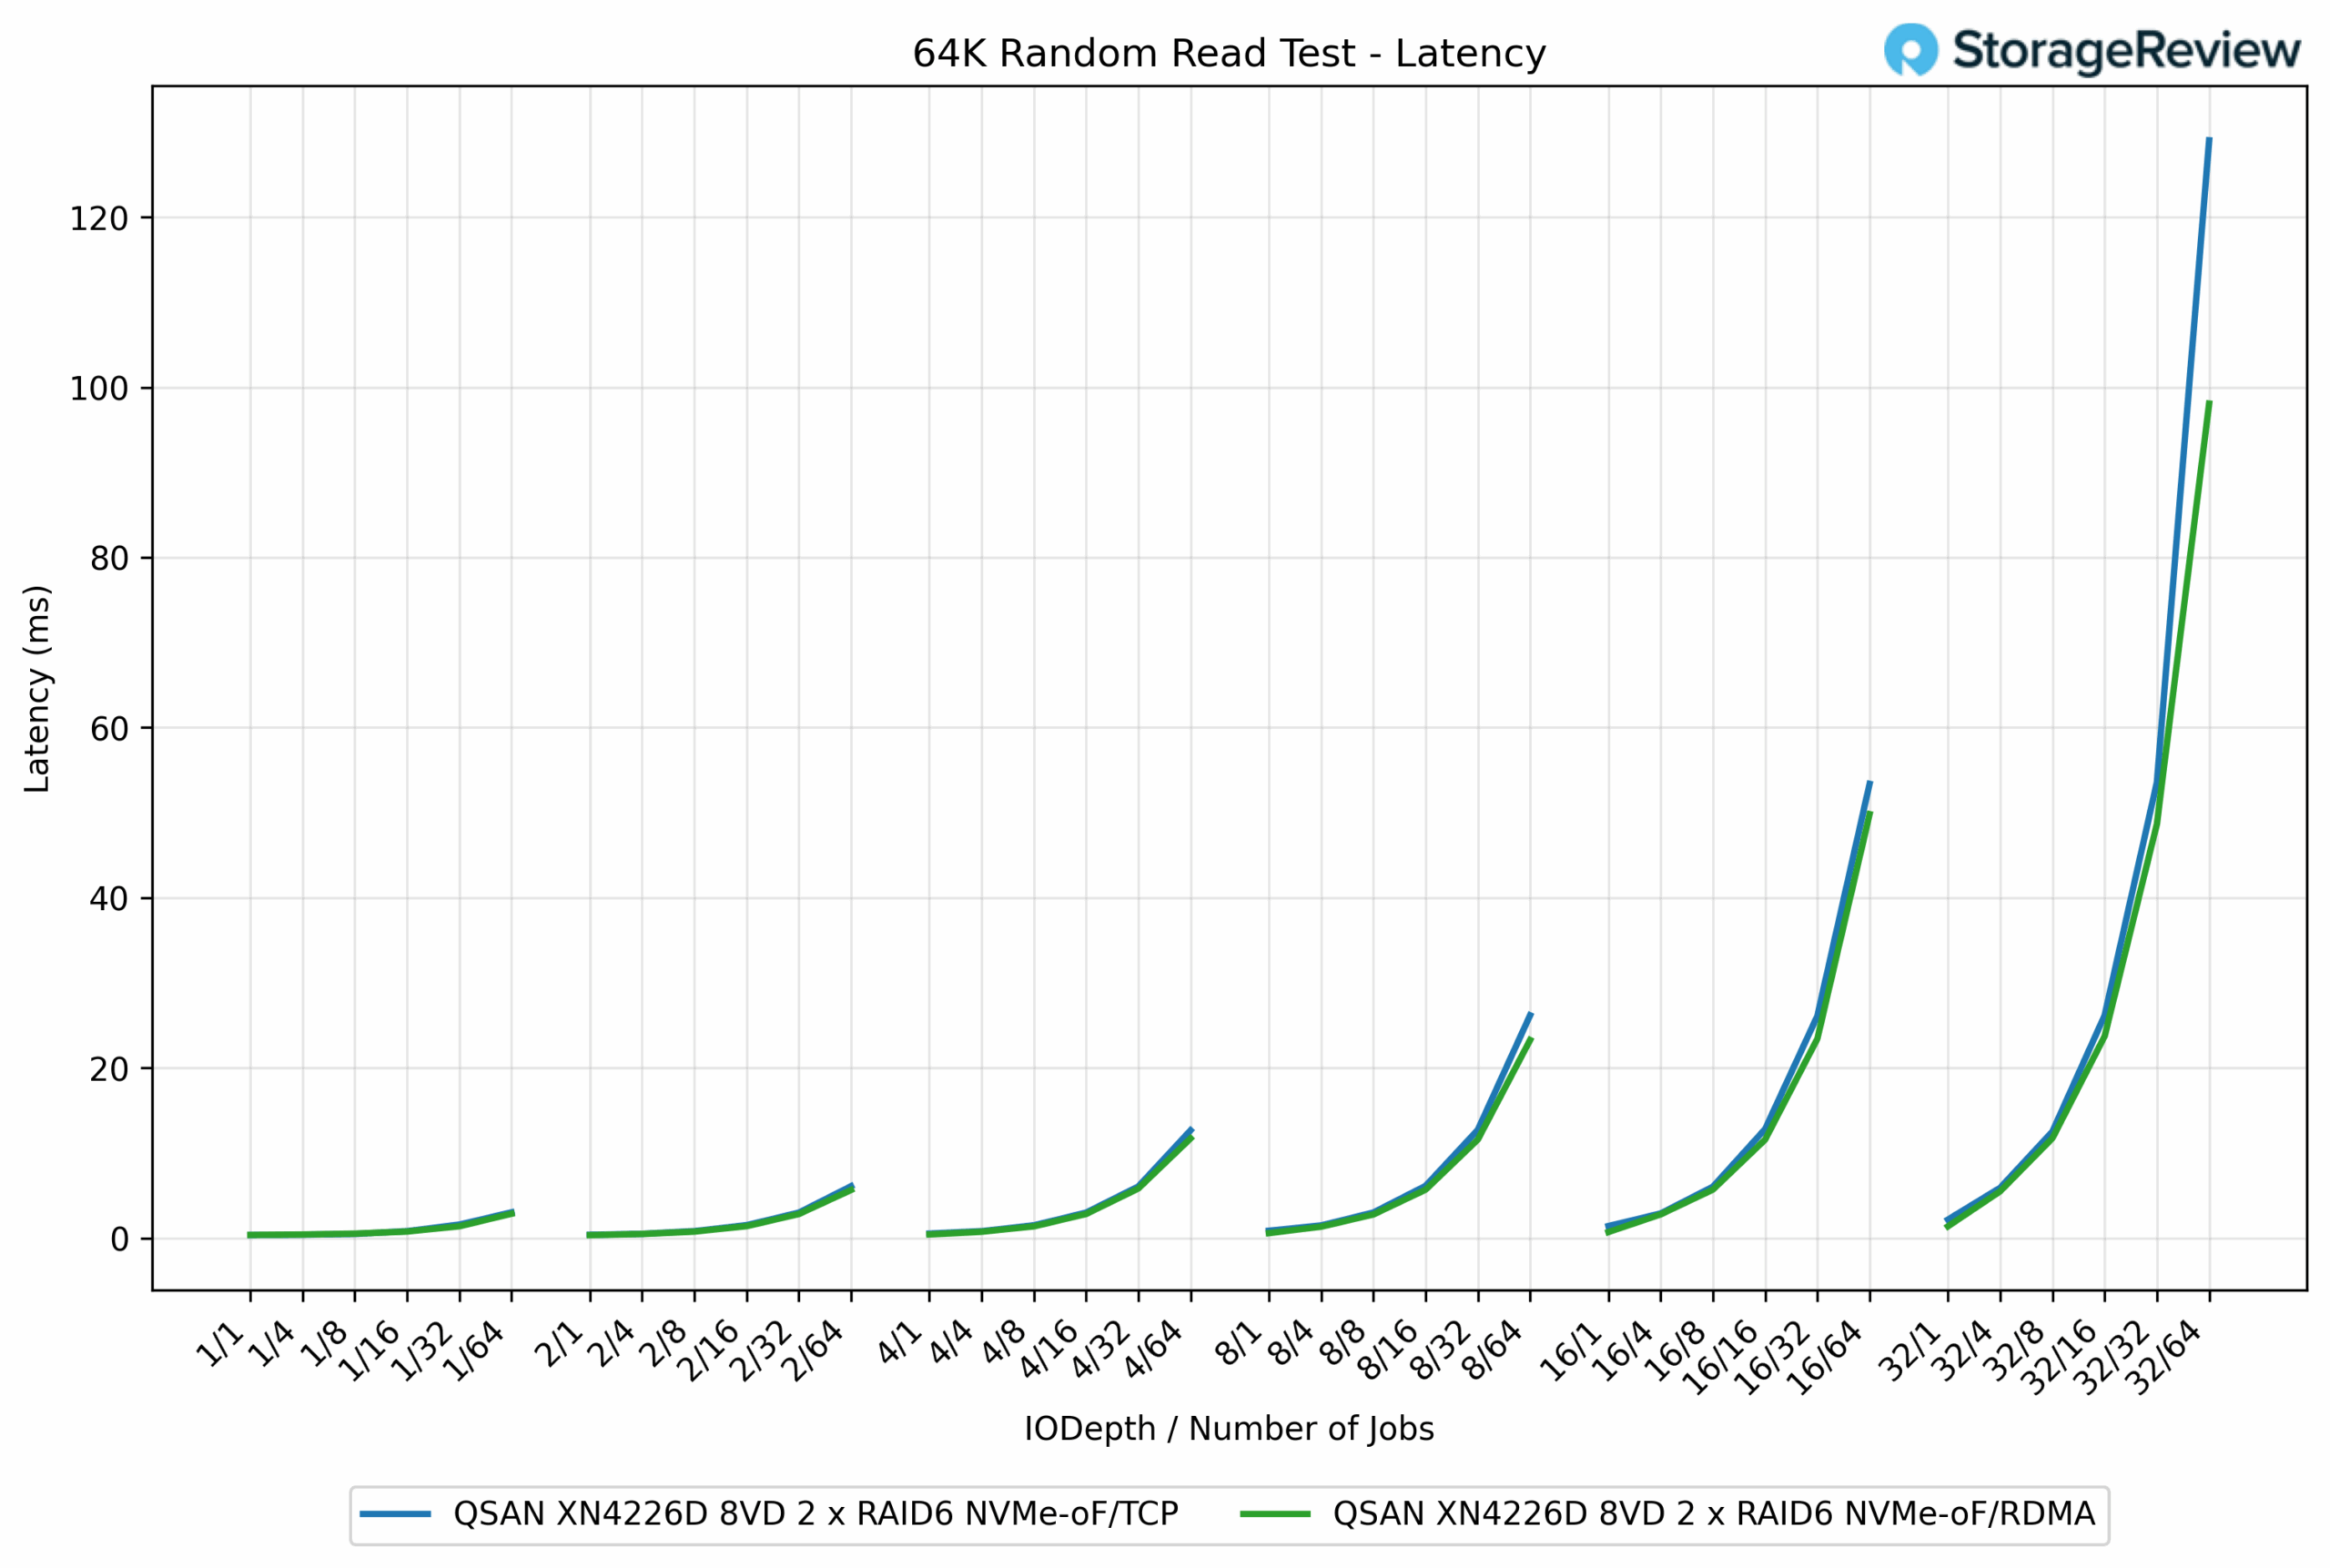
En la prueba de latencia de lectura aleatoria de 64K, ambos protocolos se compararon muy estrechamente, aunque RDMA mostró una ligera ventaja con cargas de trabajo más altas. Con cargas de trabajo ligeras, tanto TCP como RDMA ofrecieron latencias inferiores a 1 ms, prácticamente indistinguibles. Por ejemplo, en la tarea QD1/1, TCP registró 0.43 ms en comparación con los 0.38 ms de RDMA.
A medida que aumentaba la concurrencia, la diferencia se hacía más evidente. En trabajos QD16/64, RDMA registró 23.28 ms, mientras que TCP registró 26.19 ms, una mejora del 12 %. La diferencia se amplió en condiciones de máxima tensión, donde RDMA alcanzó 98.08 ms frente a los 129.02 ms de TCP, una reducción del 24 %.
IOPS de escritura aleatoria 16K
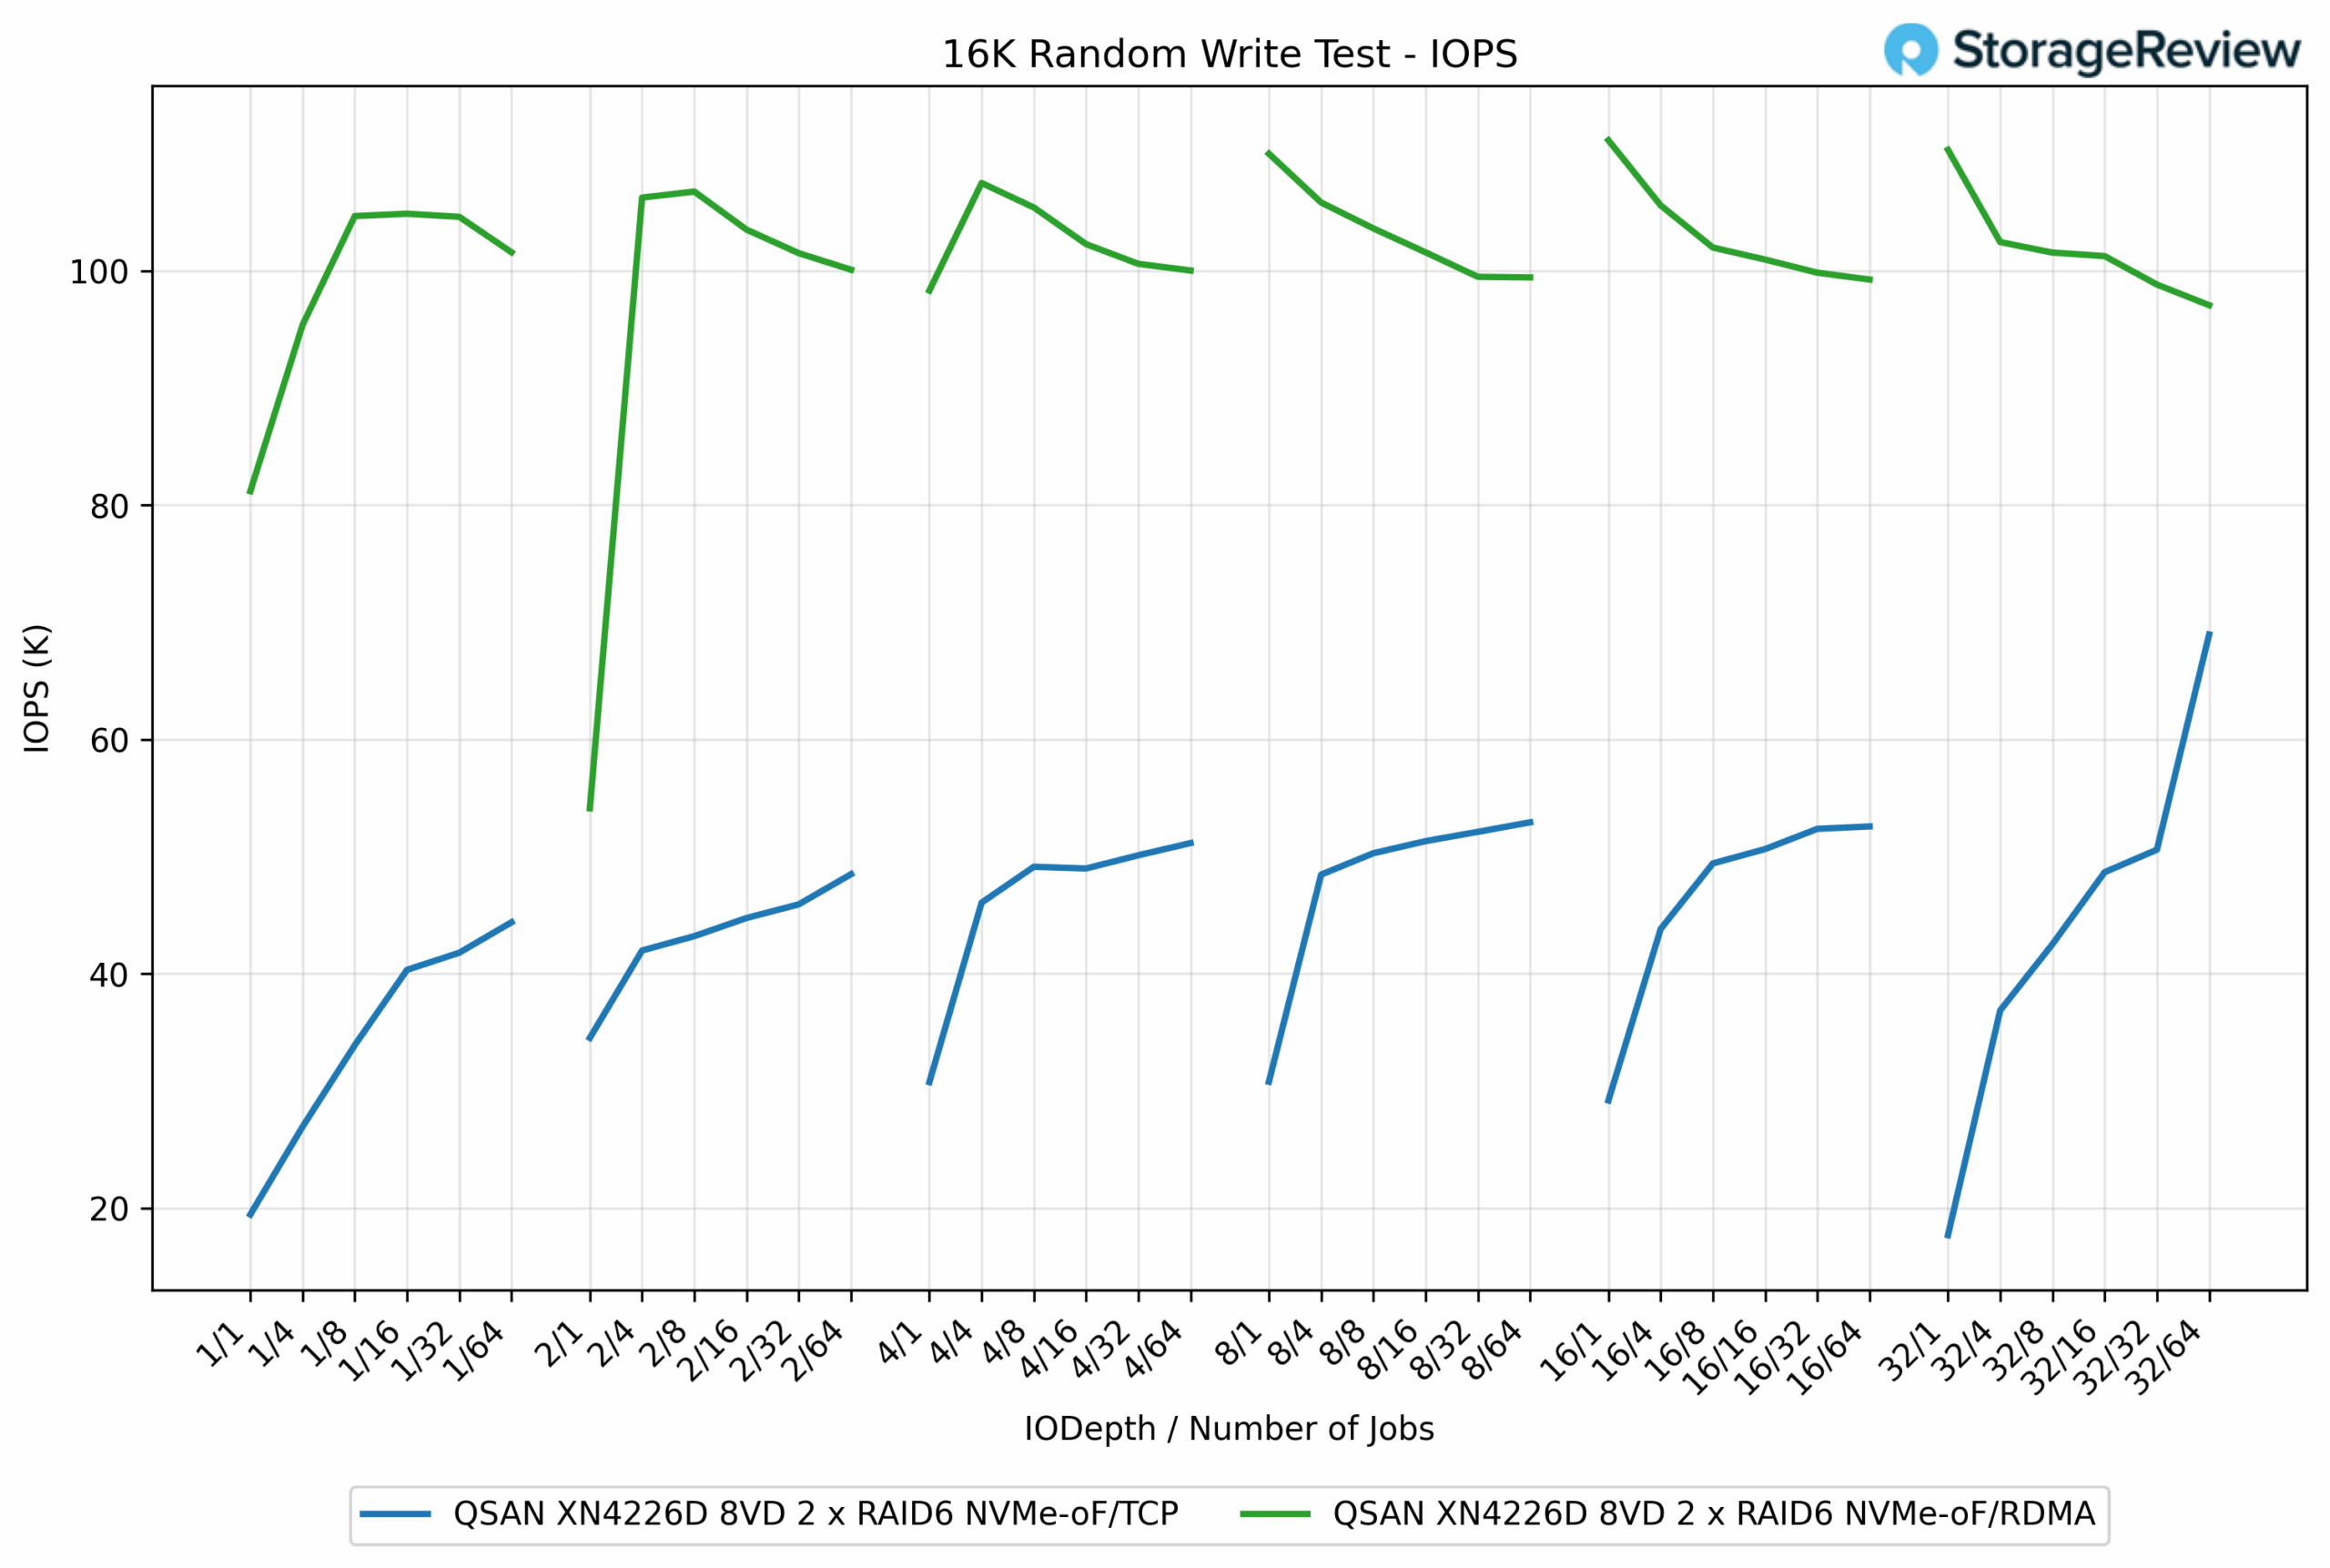
En la prueba de escritura aleatoria de 16 K, la diferencia de rendimiento entre ambos protocolos fue considerable: RDMA ofreció más del doble de IOPS que TCP en la mayoría de los casos. RDMA alcanzó un máximo de 111 130 IOPS, mientras que TCP alcanzó un máximo de 68 950 IOPS, lo que refleja una ventaja del 61 % para RDMA.
A menor profundidad de cola, la diferencia fue evidente. Por ejemplo, en trabajos QD1/16, RDMA registró 104 860 IOPS, en comparación con las 41 780 IOPS de TCP, lo que representa un aumento del 151 % a favor de RDMA. En todo el rango de cargas de trabajo, RDMA mantuvo resultados consistentes entre 100 000 y 111 000 IOPS, mientras que TCP se mantuvo generalmente entre 40 000 y 50 000 IOPS, salvo por un aumento repentino en la profundidad máxima.
Latencia de escritura aleatoria de 16K
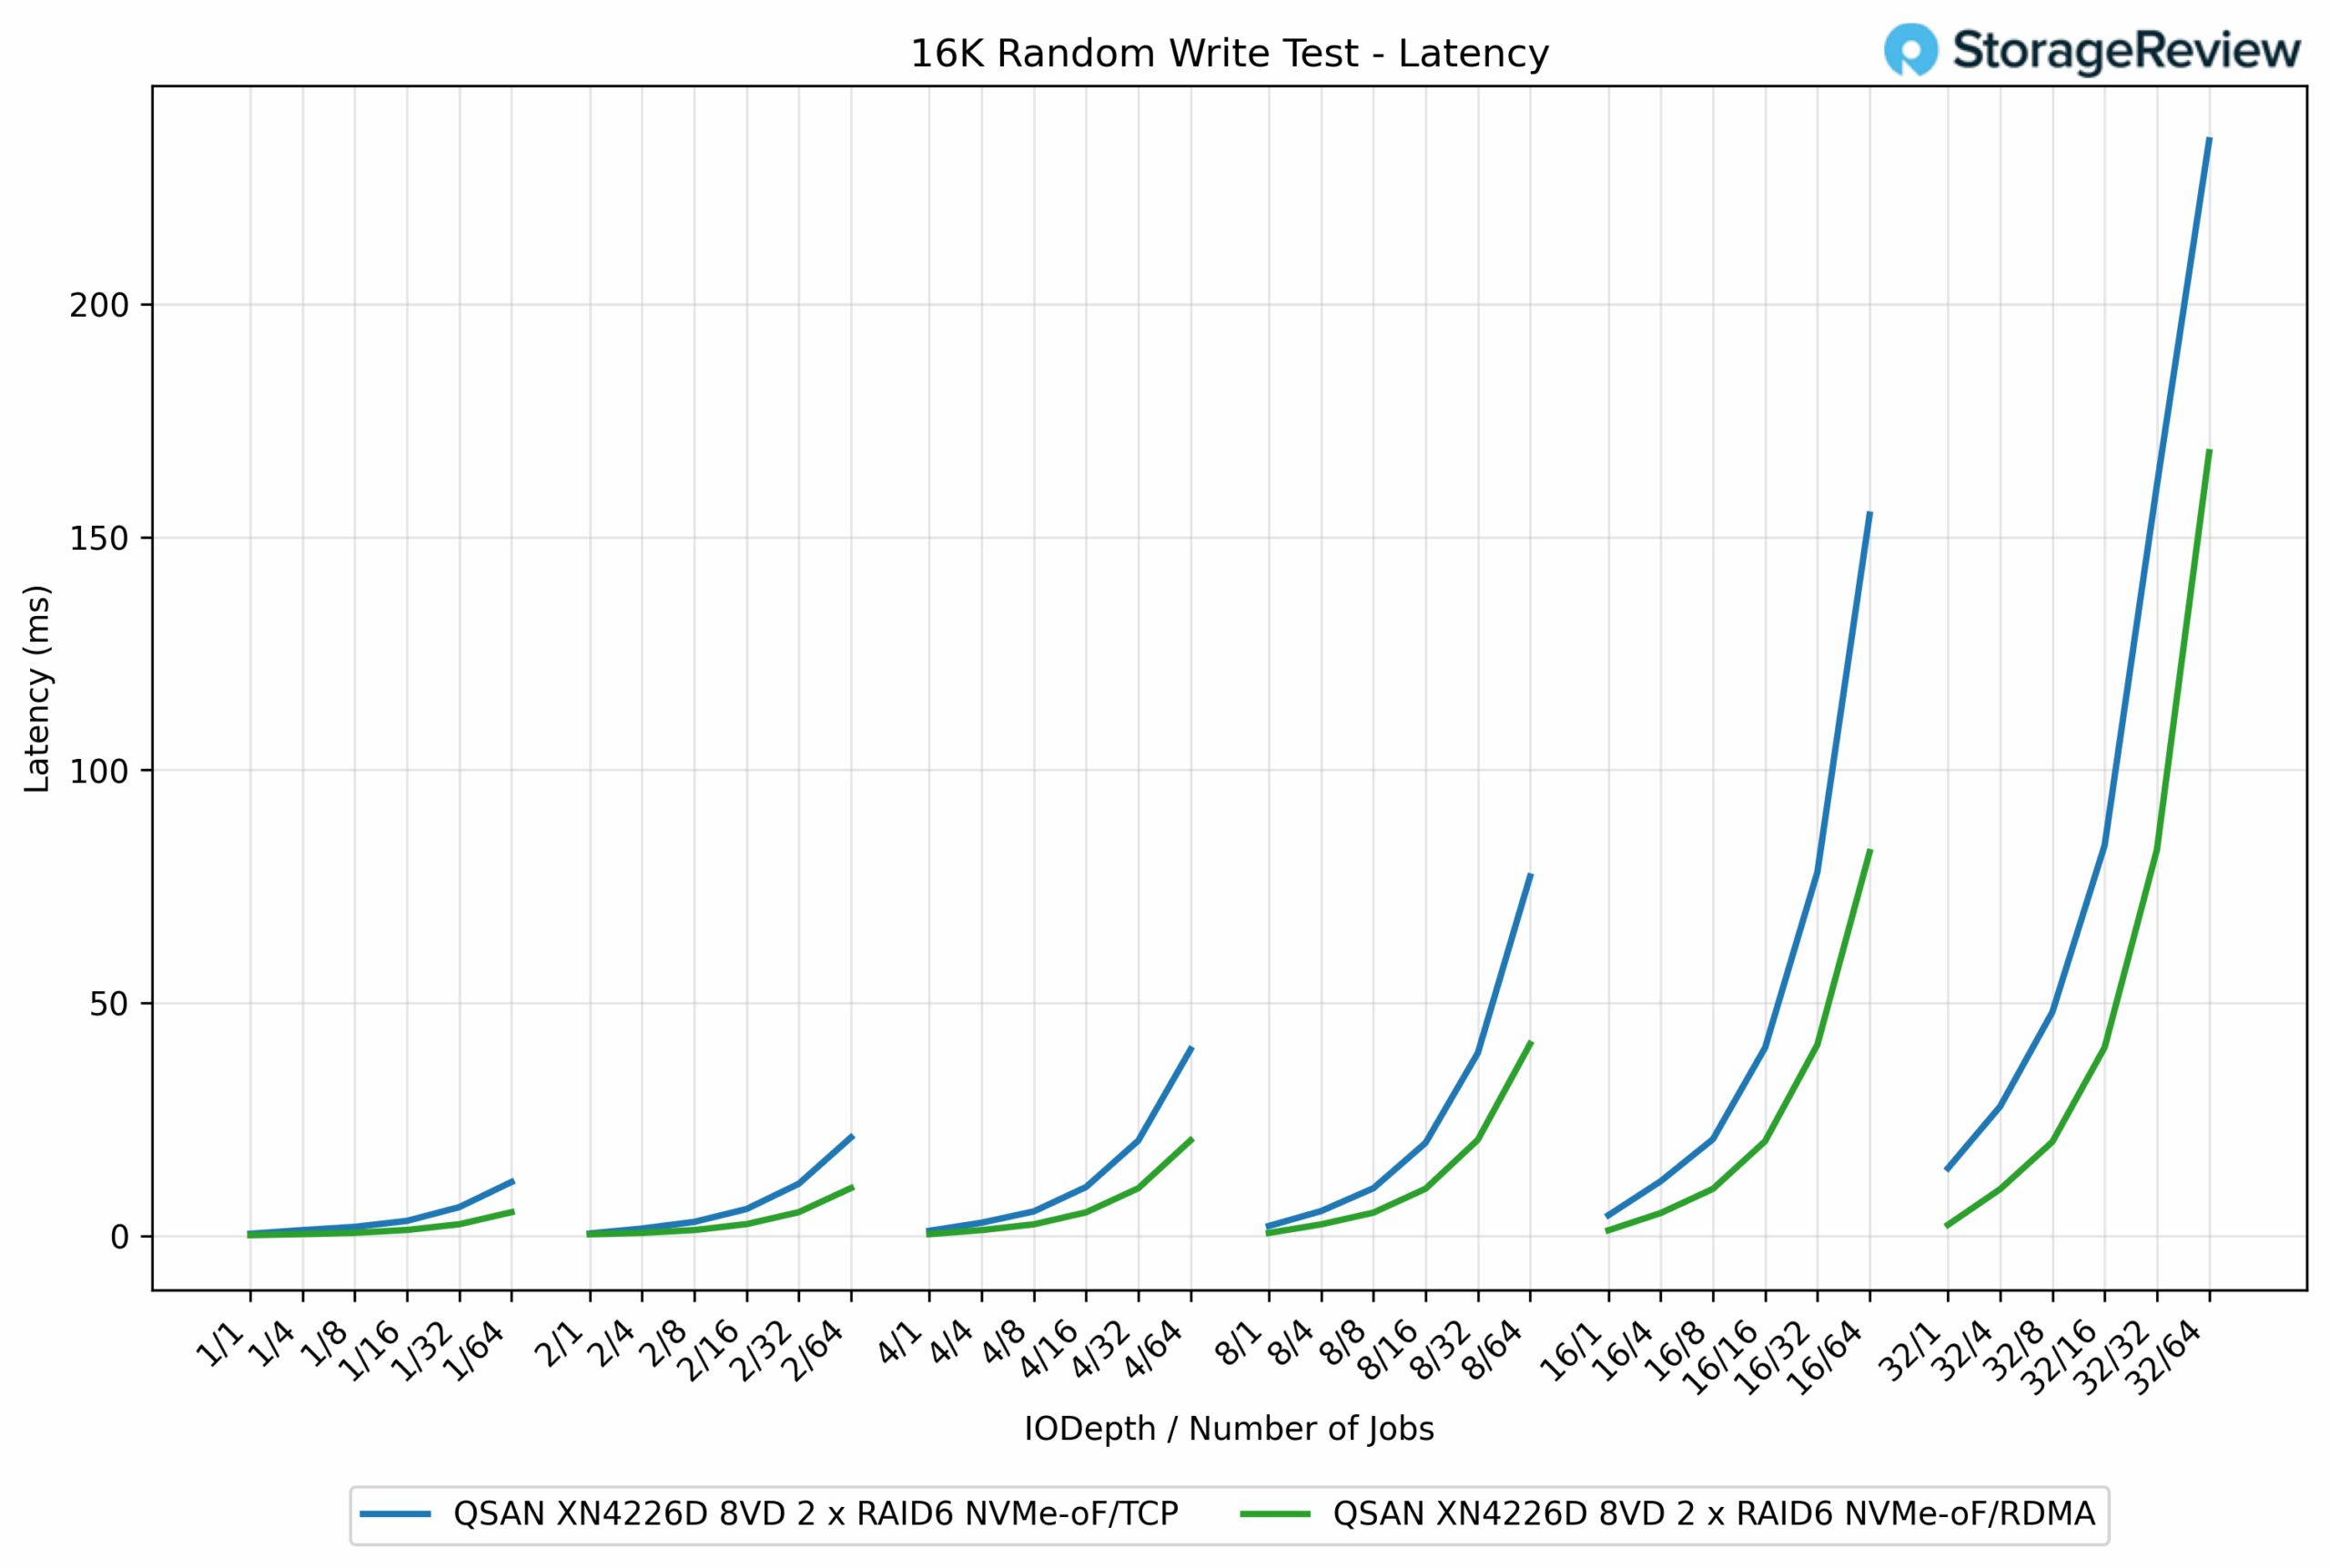
En la prueba de latencia de escritura aleatoria de 16K, RDMA volvió a mantener una clara ventaja sobre TCP a medida que aumentaban las cargas de trabajo. Con cargas más ligeras, ambos protocolos fueron prácticamente idénticos, con tiempos de respuesta inferiores a 2 ms. Por ejemplo, en la tarea QD1/1, TCP registró 0.40 ms, frente a los 0.41 ms de RDMA.
A medida que aumentaba la concurrencia, RDMA comenzó a separarse. En trabajos QD16/64, RDMA registró 21.15 ms, mientras que TCP registró 77.12 ms, una drástica reducción del 72 %. Esta ventaja se mantuvo en las profundidades más altas. En trabajos QD32/64, RDMA completó 161.13 ms, en comparación con los 235.17 ms de TCP, lo que representa una mejora del 31 %.
IOPS de lectura aleatoria 16K
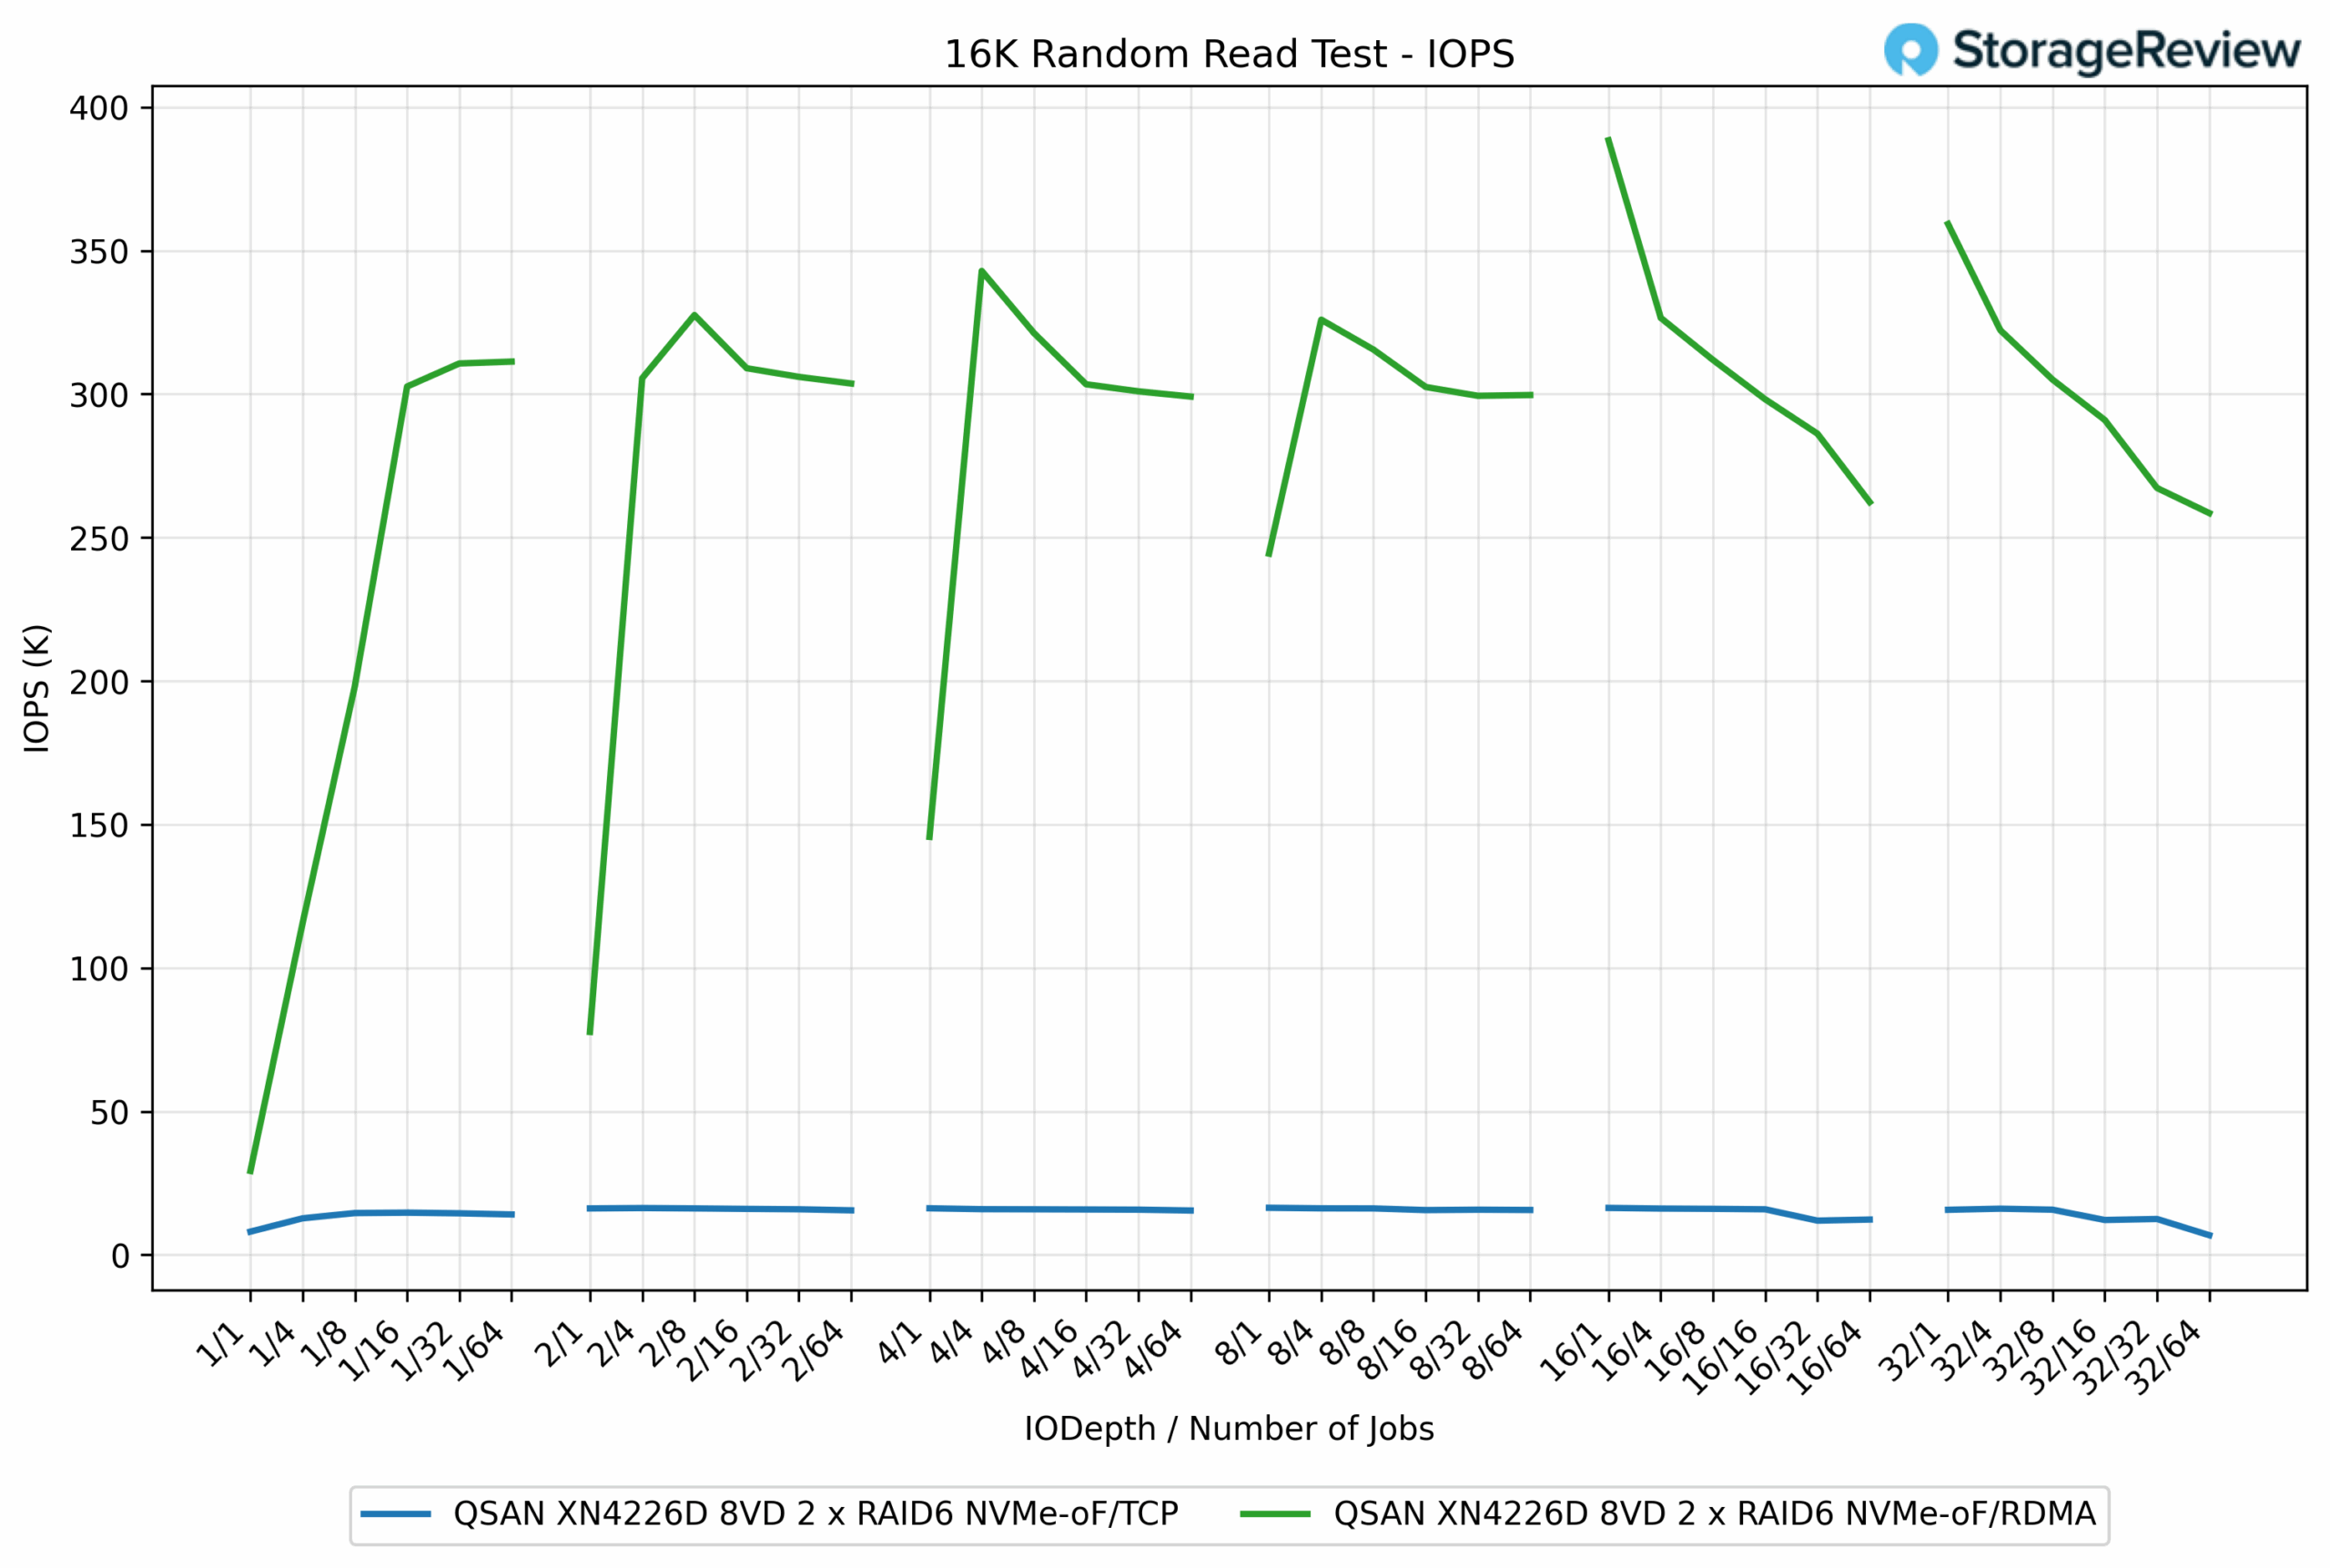
En la prueba de lectura aleatoria de 16 000 IOPS, RDMA superó por completo a TCP en todo el rango de cargas de trabajo. RDMA alcanzó un máximo de 388 440 IOPS, mientras que TCP alcanzó un máximo de tan solo 16 420 IOPS, lo que demuestra una ventaja de más de 23 veces para RDMA.
La disparidad fue visible desde el principio. En el trabajo QD1/1, RDMA entregó 29 270 IOPS, mientras que TCP solo gestionó 8100 IOPS. A medida que aumentaba la concurrencia, RDMA escaló rápidamente al rango de 300 000 a 380 000 IOPS, mientras que TCP se estancó en torno a 15 000 a 16 000 IOPS, incluso con colas de mayor profundidad.
Latencia de lectura aleatoria de 16 K
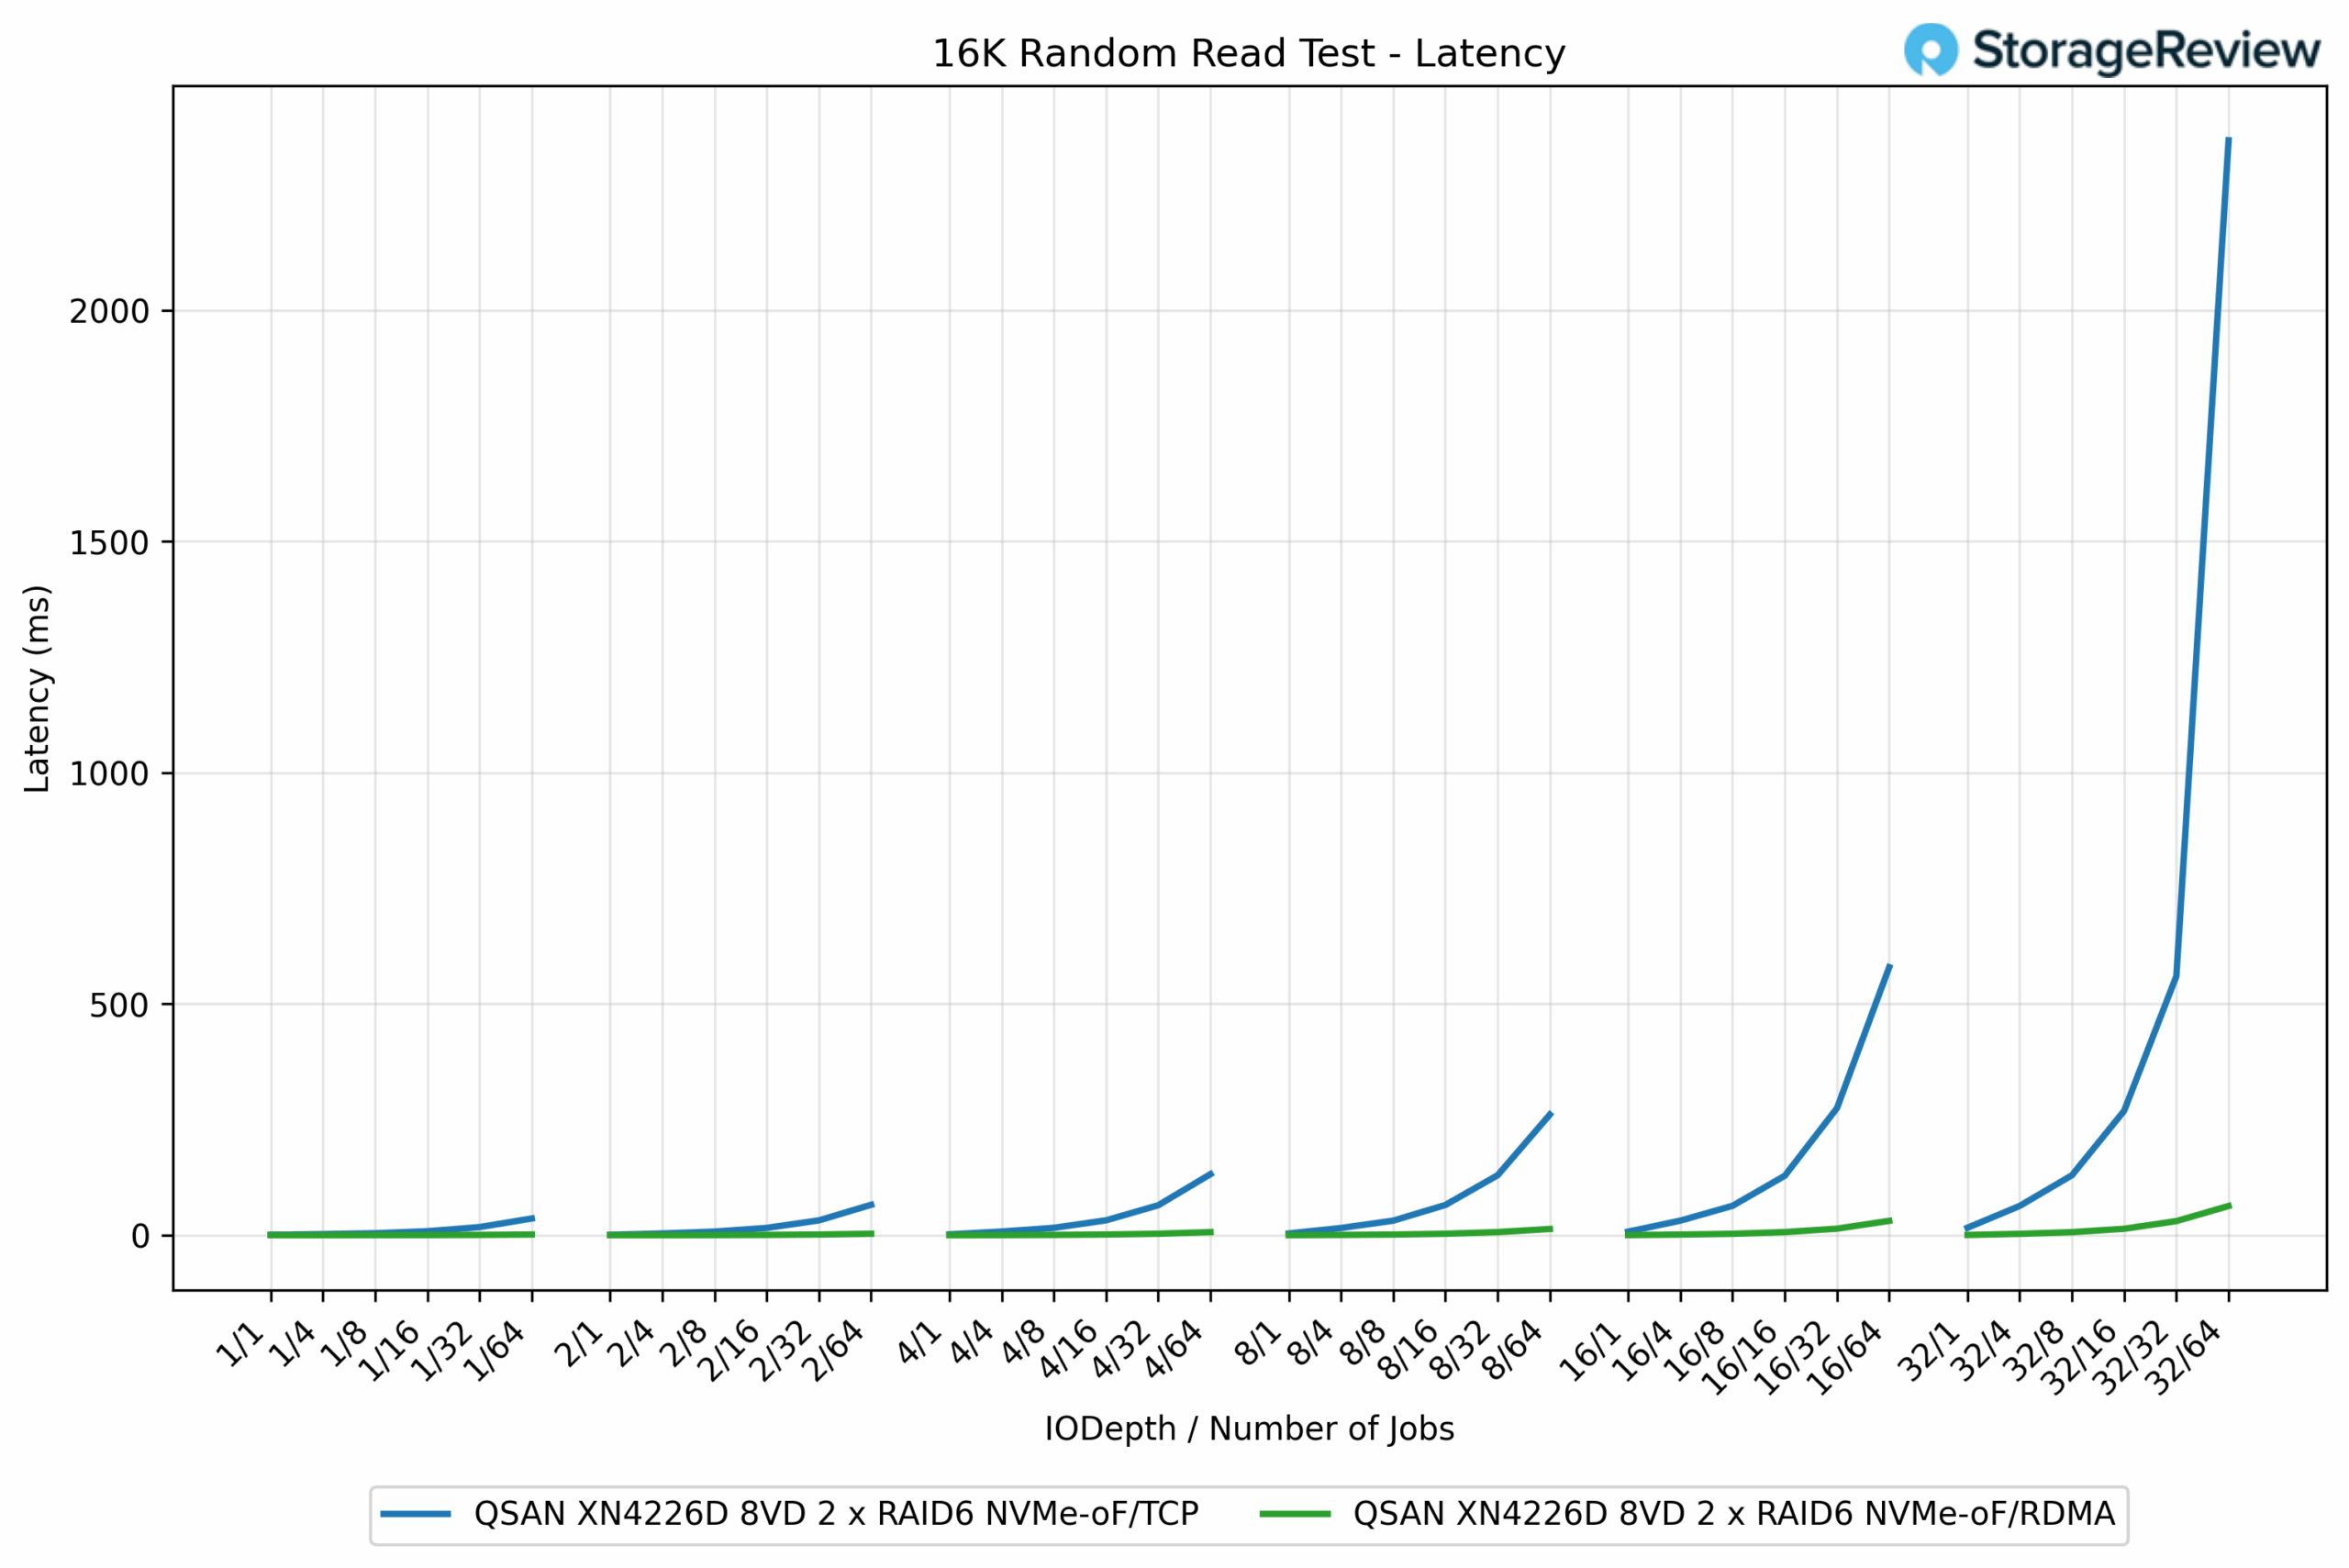
En la prueba de latencia de lectura aleatoria de 16K, la diferencia entre RDMA y TCP fue drástica, similar a los resultados de IOPS. Con cargas de trabajo ligeras, ambos protocolos fueron prácticamente idénticos, con latencias que oscilaron entre 1 y 10 ms.
A medida que las cargas de trabajo escalaban, RDMA controlaba la latencia, mientras que TCP se degradaba significativamente. En trabajos Q8/64, RDMA registró 13.65 ms, en comparación con los 260.90 ms de TCP, una mejora de casi 19 veces. Finalmente, los trabajos QD32/64 completaron RDMA en 63.28 ms, mientras que TCP tardó 2,366.99 ms, casi 37 veces más.
IOPS de escritura aleatoria 4K
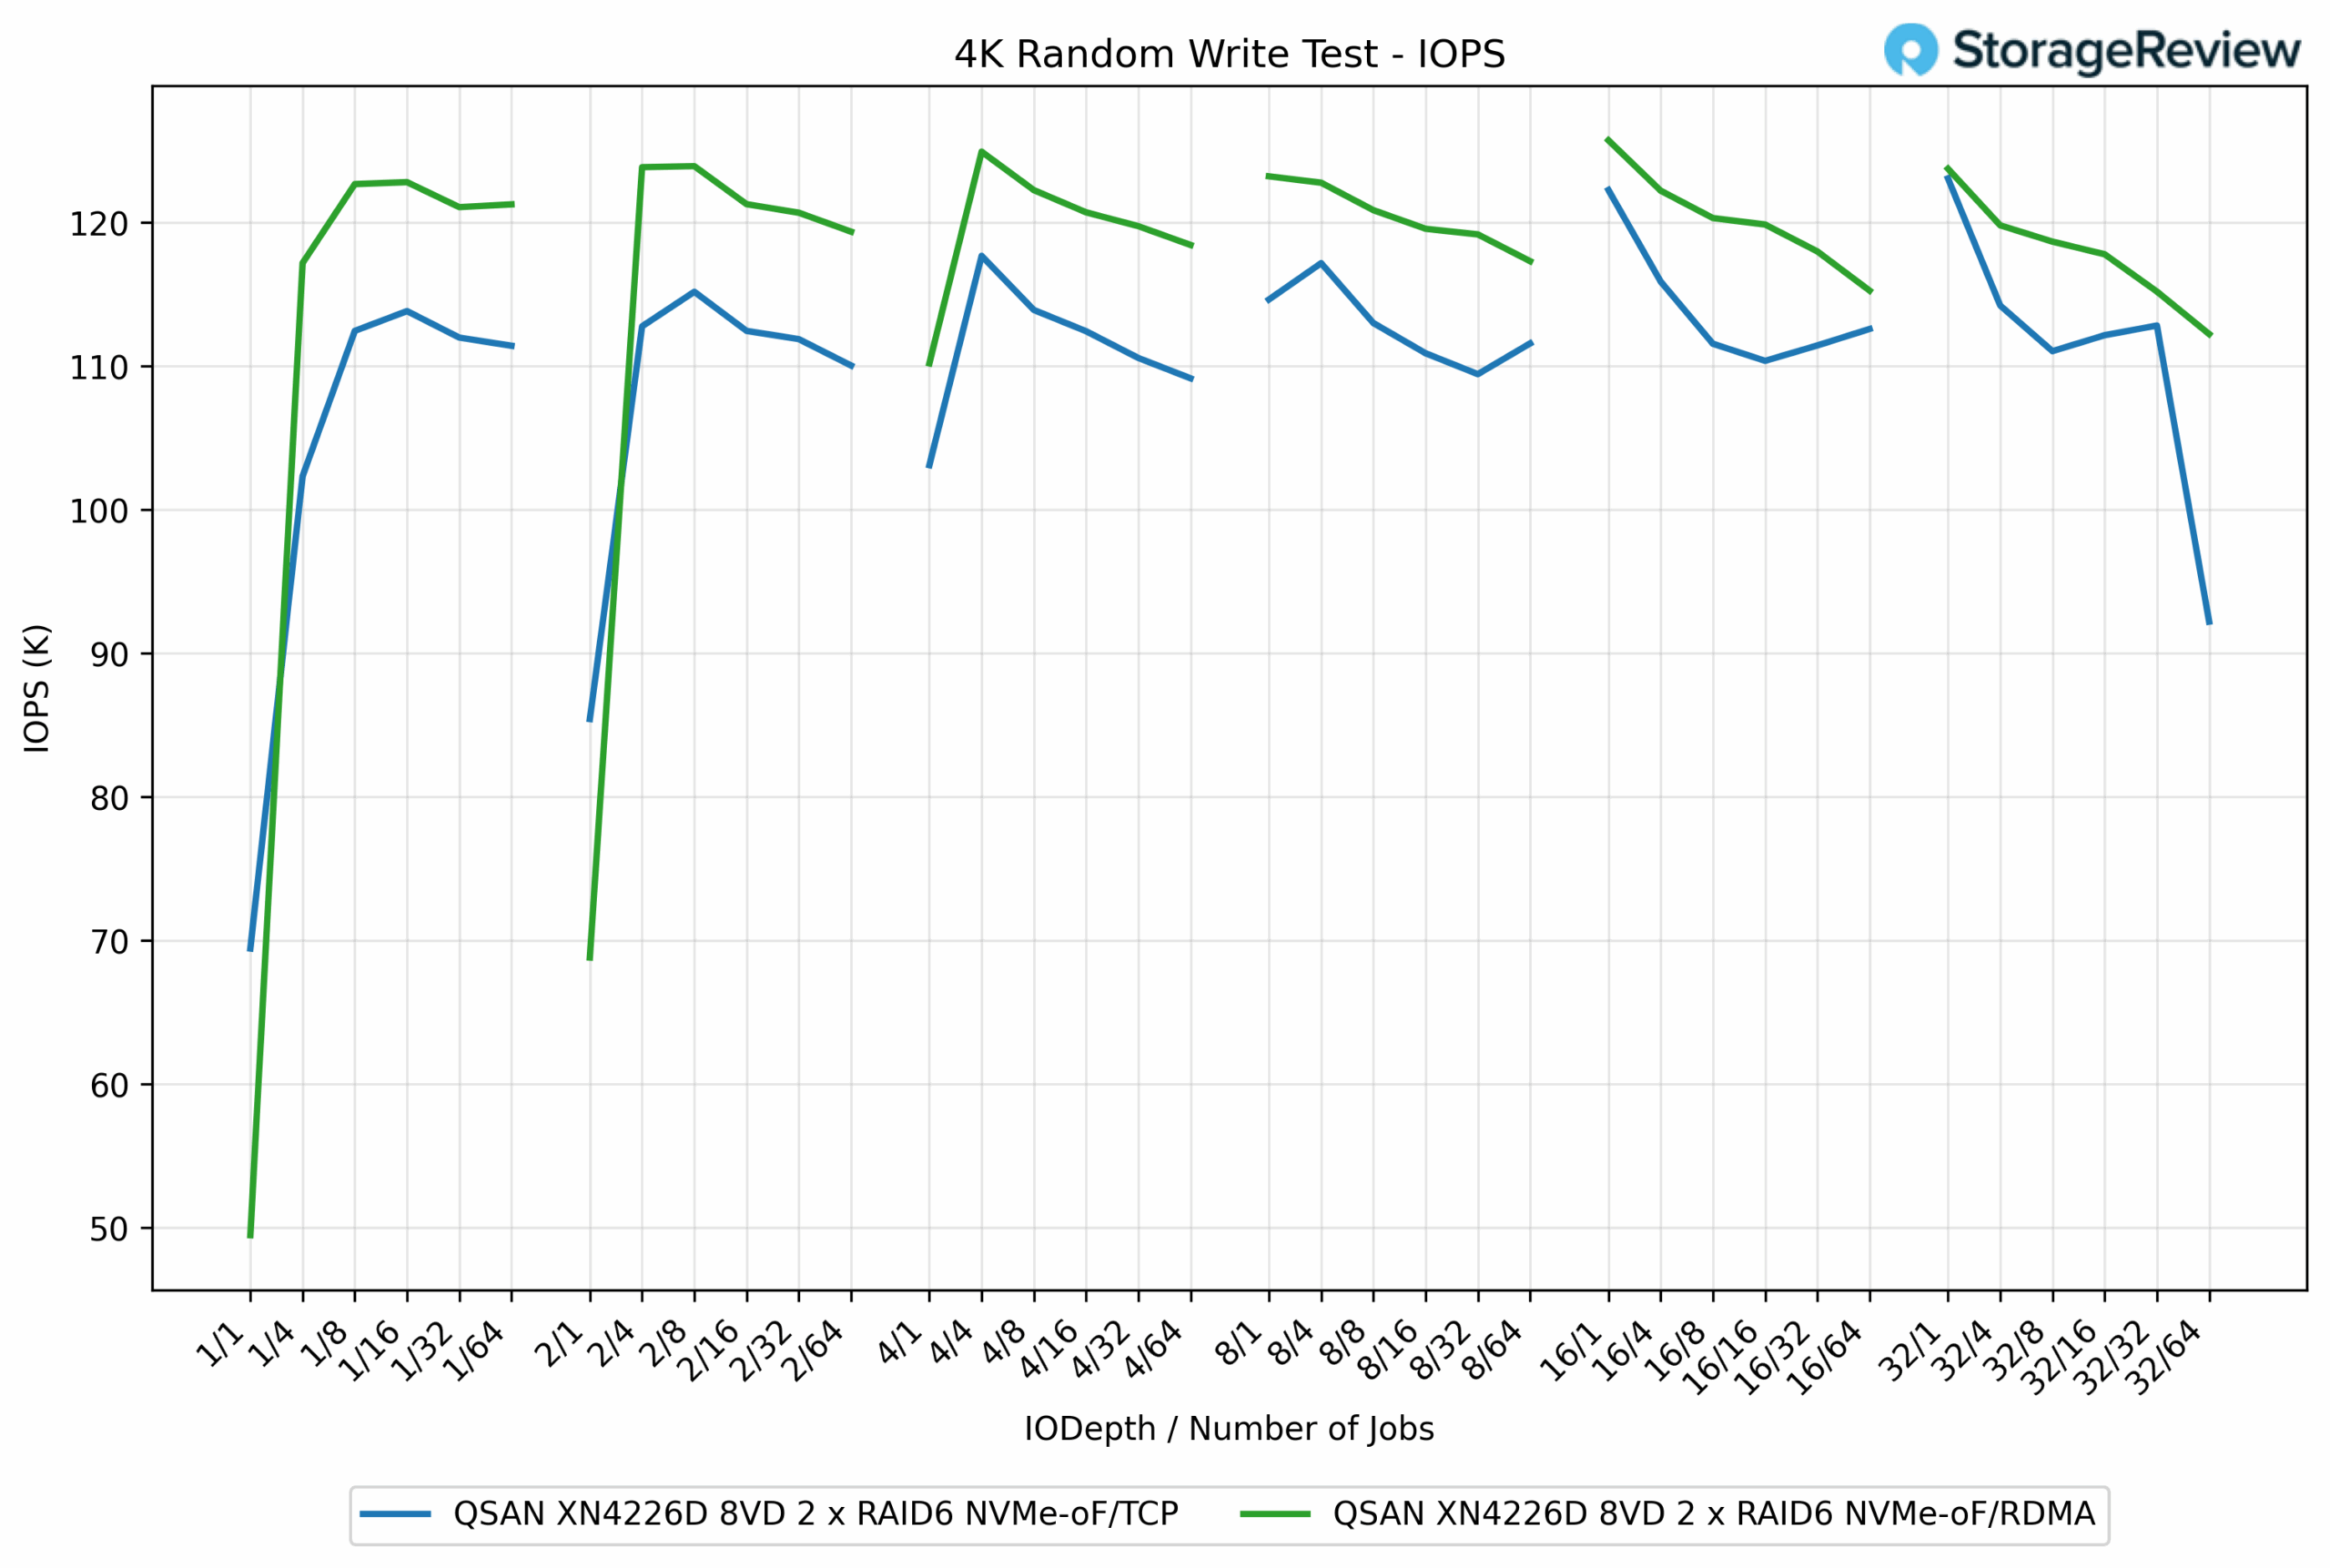
En la prueba de escritura aleatoria de 4K, RDMA superó consistentemente a TCP, aunque el margen fue menor en comparación con las cargas de trabajo de mayor tamaño de bloque. RDMA alcanzó un pico de 125 730 IOPS, mientras que TCP alcanzó 115 890 IOPS, lo que resultó en una ventaja de aproximadamente el 8.5 % para RDMA.
A menor profundidad de cola, TCP quedó ligeramente por detrás de RDMA, pero aun así ofreció un rendimiento competitivo. Por ejemplo, en trabajos QD1/16, RDMA alcanzó 122 820 IOPS, en comparación con las 111 910 IOPS de TCP, una mejora de casi el 10 %. En la mayoría de los puntos de prueba, RDMA rondó los 120 000 a 125 000 IOPS, mientras que TCP mantuvo resultados entre 110 000 y 116 000 IOPS, con una caída tardía en trabajos QD32/64 a 92 210 IOPS.
Latencia de escritura aleatoria de 4K
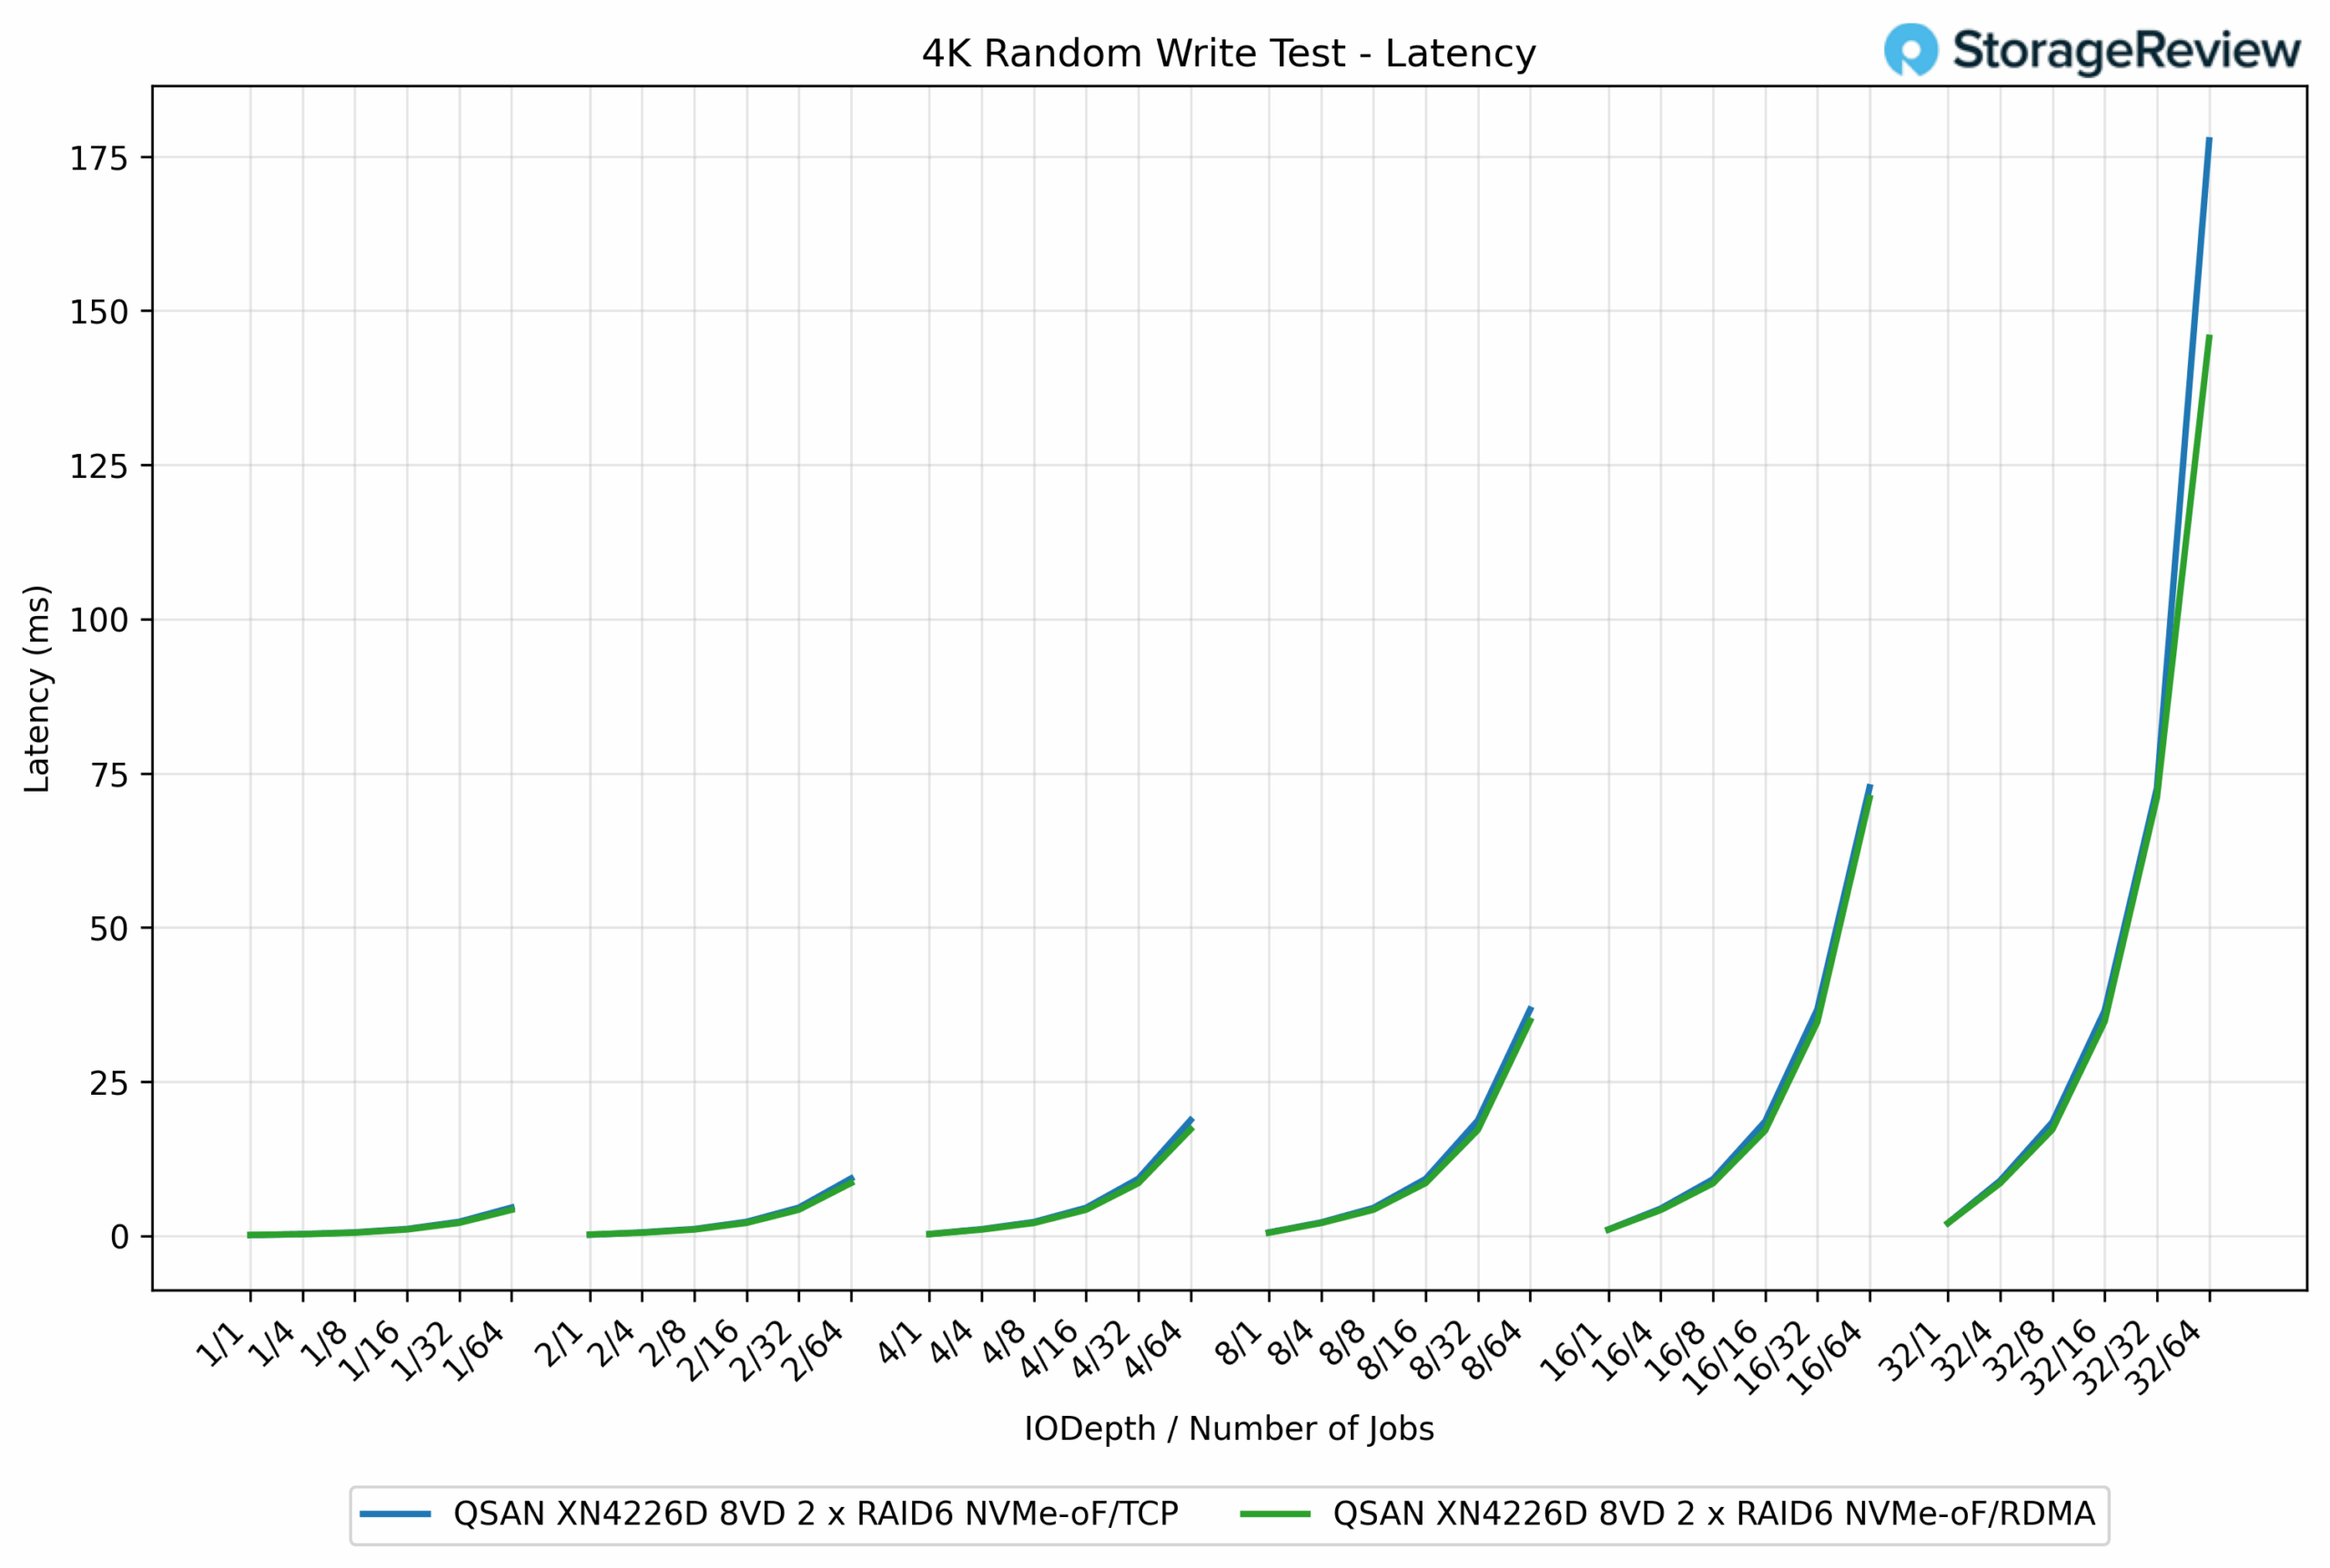
En la prueba de latencia de escritura aleatoria de 4K, RDMA mostró consistentemente tiempos de respuesta más bajos que TCP, aunque los márgenes fueron menores en comparación con las cargas de trabajo de bloques más grandes. Con cargas más ligeras, ambos protocolos fueron prácticamente idénticos, manteniéndose por debajo de 1 ms. Por ejemplo, en QD1/1, TCP registró 0.16 ms, mientras que RDMA registró 0.21 ms.
A medida que aumentaba la concurrencia, las diferencias se hicieron más evidentes. En trabajos QD16/64, RDMA registró 19.36 ms, en comparación con los 36.20 ms de TCP, lo que supuso una reducción del 46 % en la latencia de RDMA. A máxima profundidad, RDMA completó el proceso en 145.61 ms, mientras que TCP alcanzó los 177.62 ms, una mejora del 22 % para RDMA.
IOPS de lectura aleatoria 4K
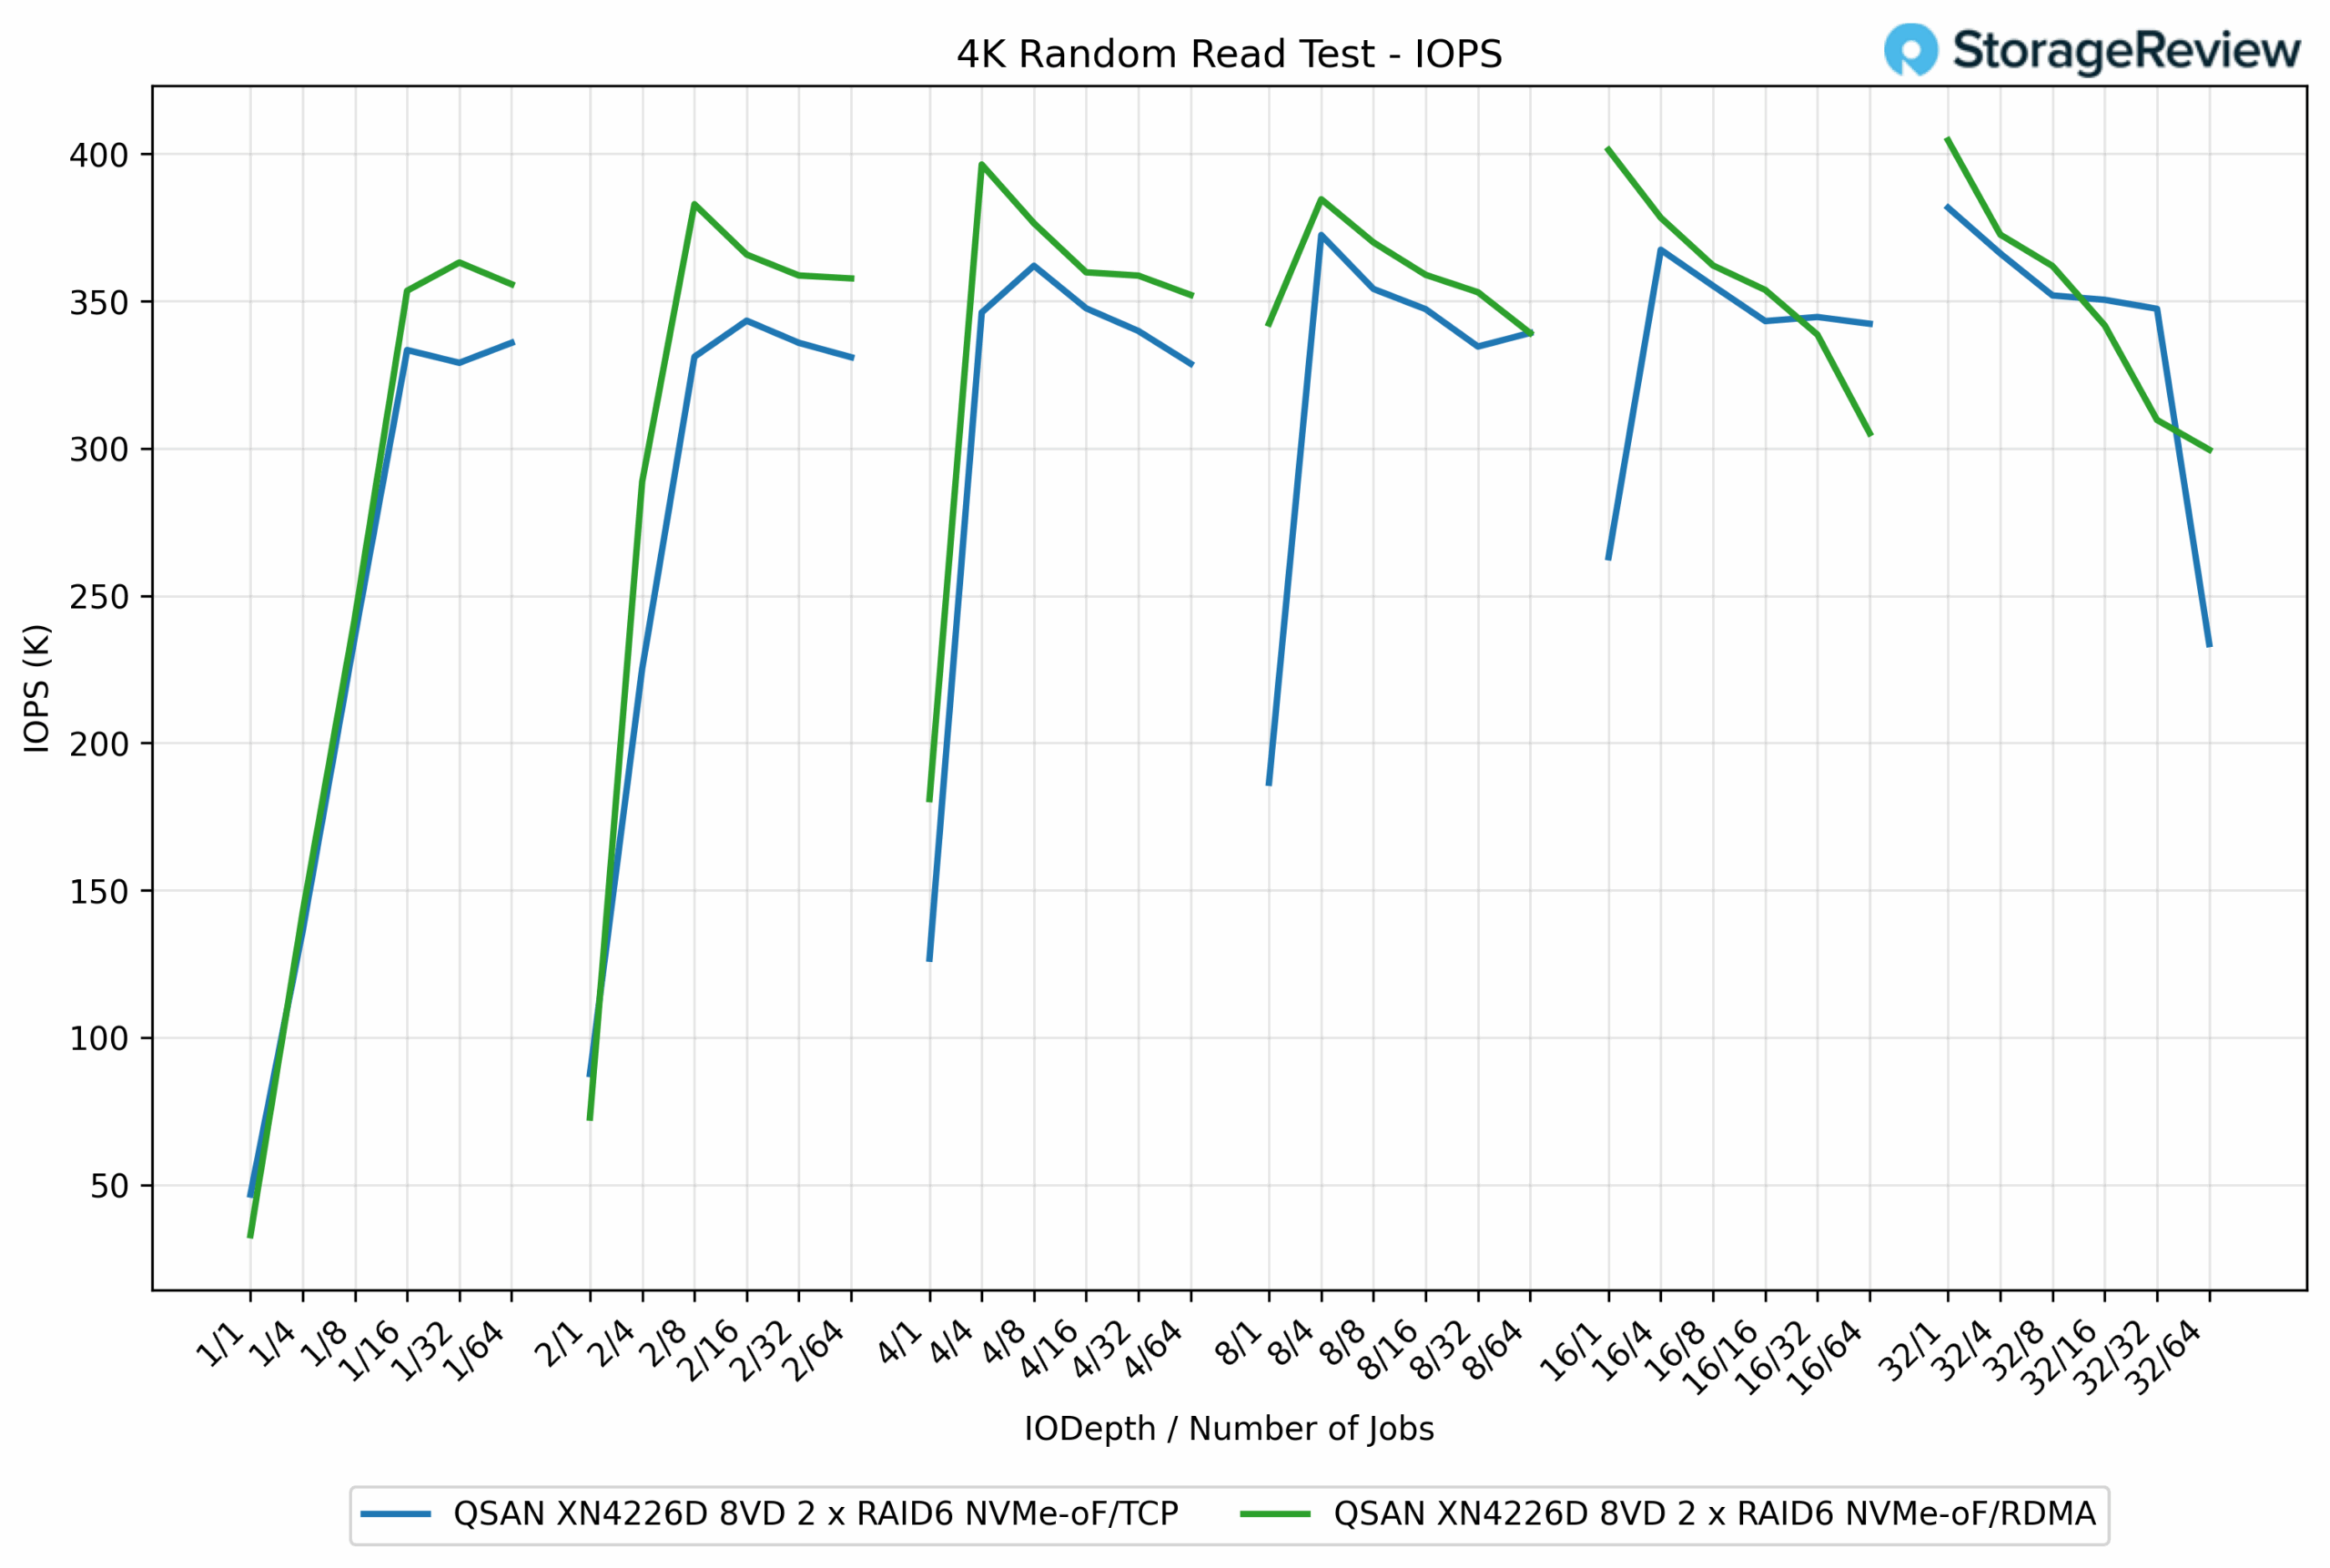
En la prueba de lectura aleatoria de 4K, ambos protocolos ofrecieron un rendimiento excelente, aunque RDMA mantuvo una ligera ventaja sobre TCP. RDMA alcanzó un máximo de 404.64 mil IOPS, mientras que TCP alcanzó un máximo de 382.96 mil IOPS, lo que le otorgó a RDMA una ventaja del 5.7 %.
A menor profundidad, los resultados ya favorecían a RDMA. Por ejemplo, en los trabajos QD1/16, RDMA alcanzó 353 570 IOPS, en comparación con las 329 100 IOPS de TCP, una diferencia de aproximadamente el 7.5 %. A medida que las cargas de trabajo escalaban, RDMA mantuvo su liderazgo, operando típicamente en el rango de 360 000 a 400 000 IOPS, mientras que TCP se mantuvo cerca de 330 000 a 380 000 IOPS.
Latencia de lectura aleatoria de 4K
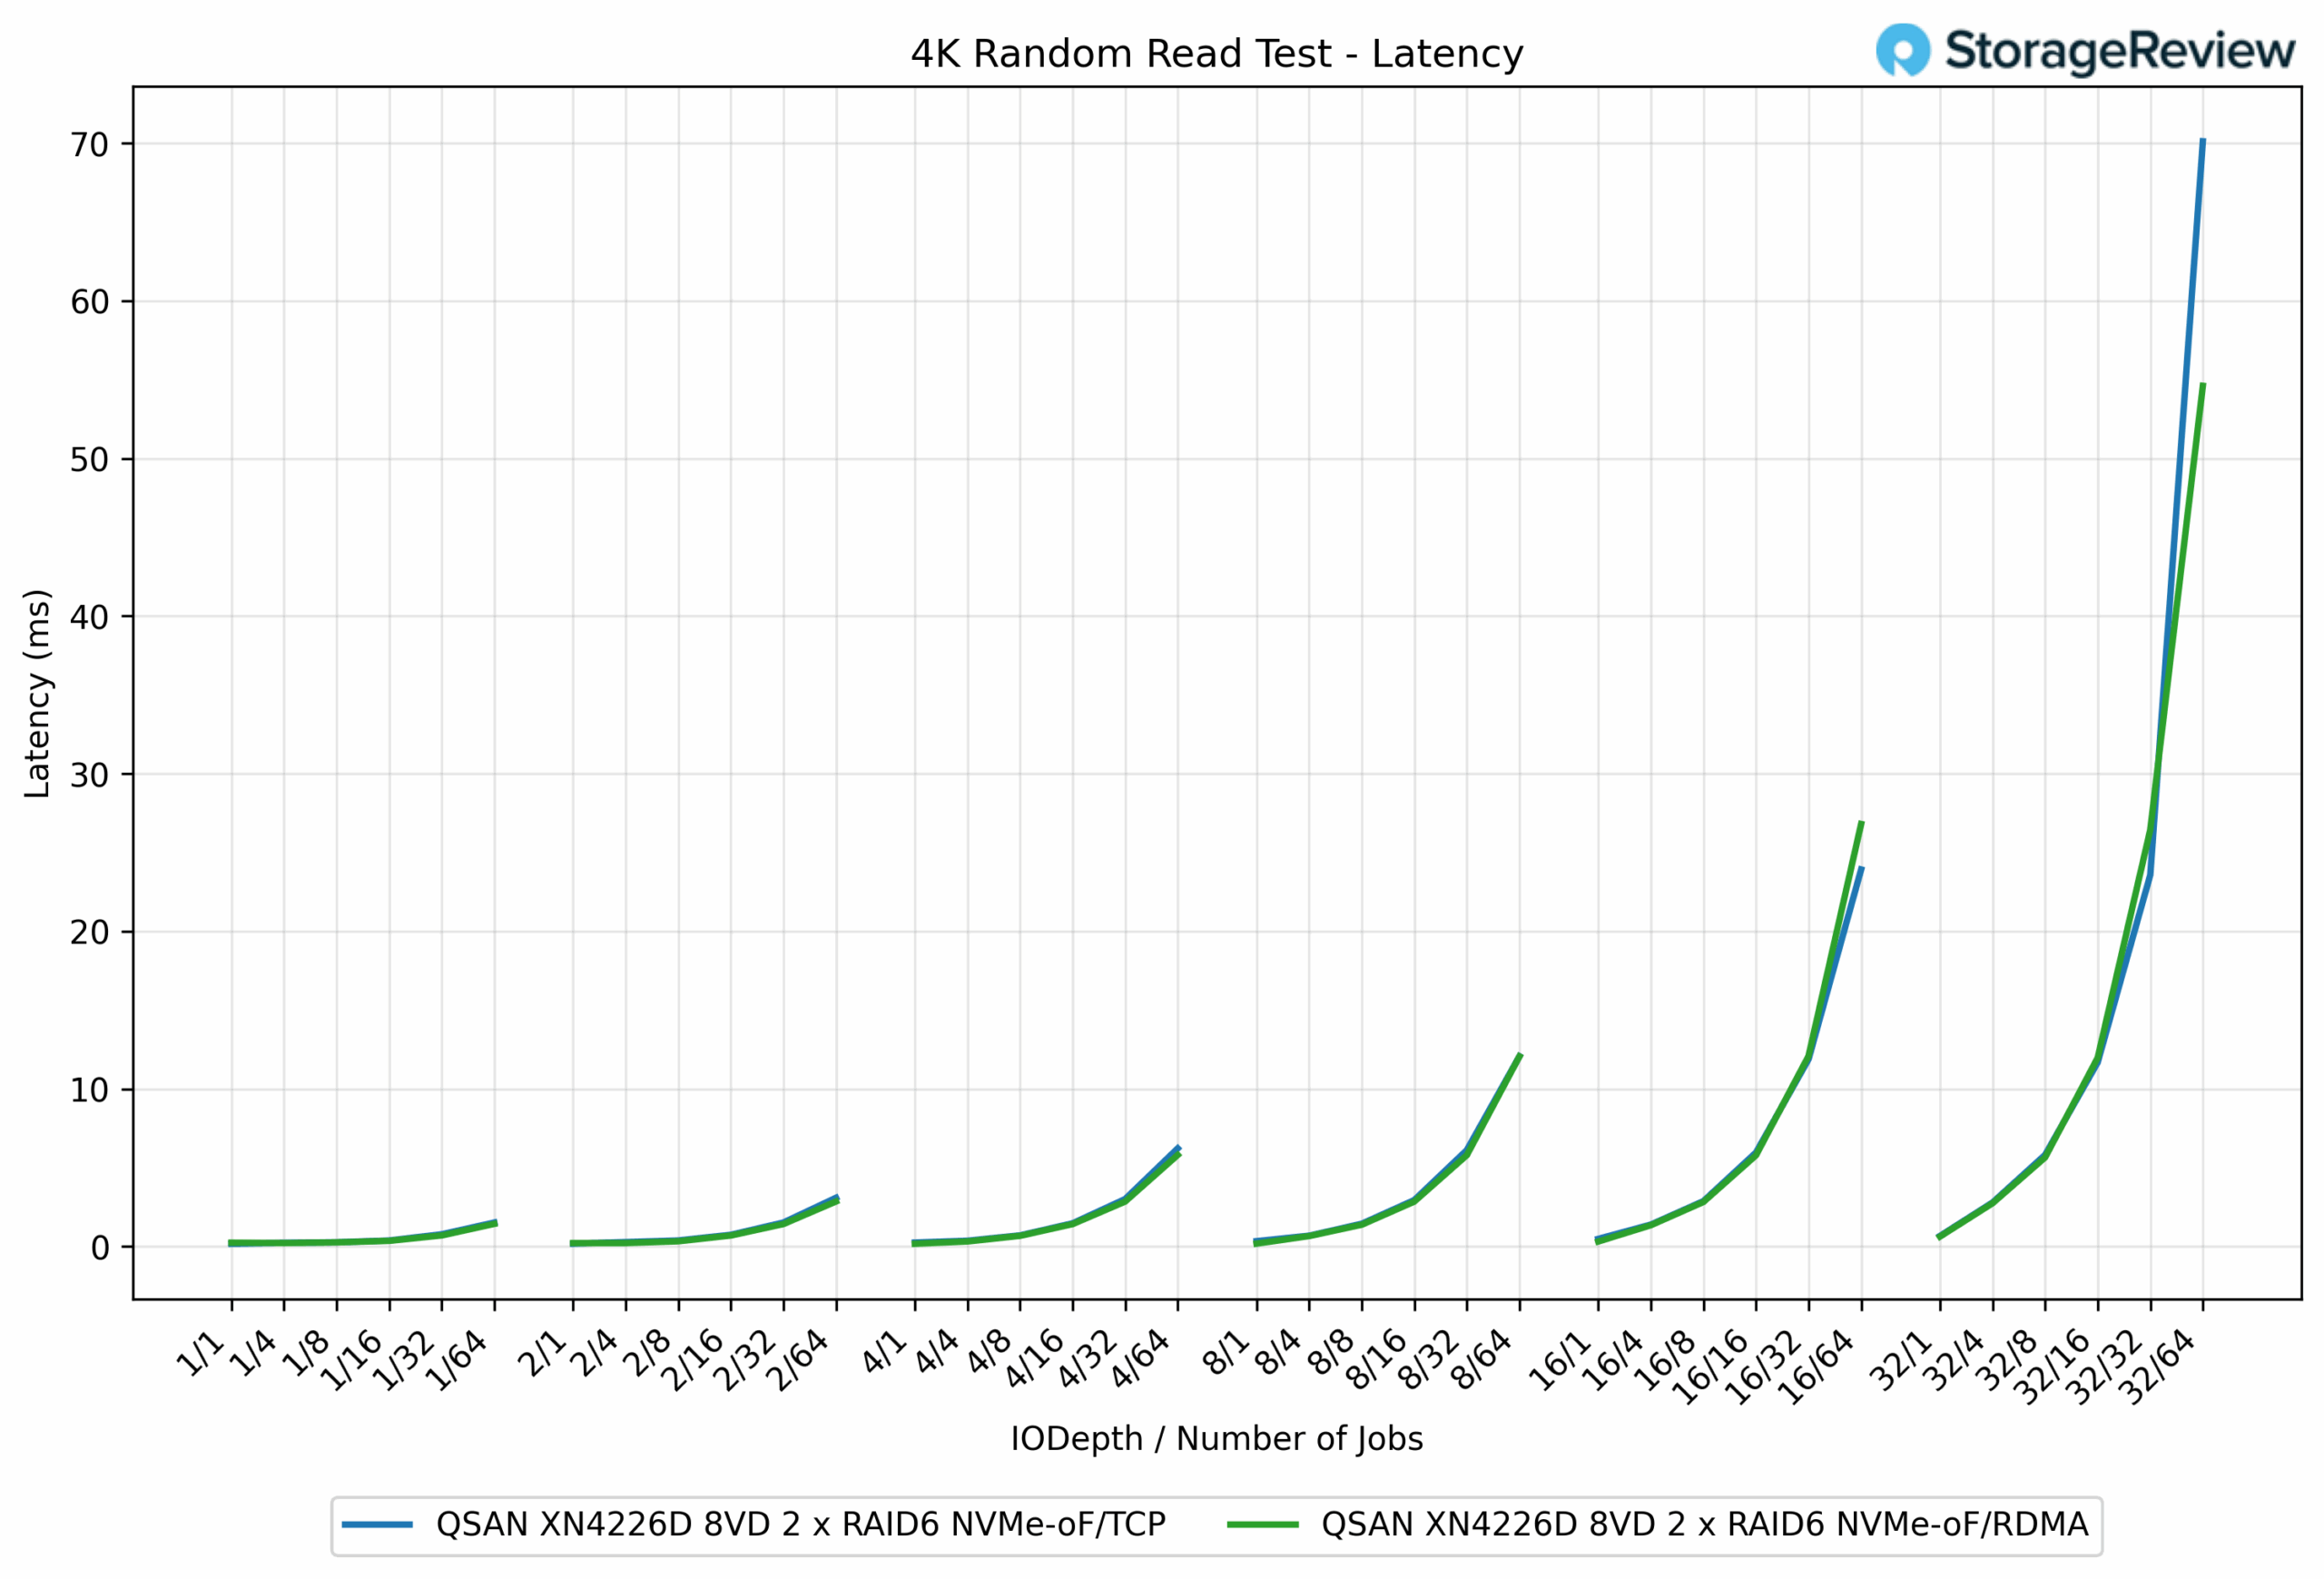
En la prueba de latencia de lectura aleatoria de 4K, RDMA demostró una clara ventaja en eficiencia sobre TCP, especialmente a medida que aumentaba la escala de las cargas de trabajo. Con colas de baja profundidad, ambos protocolos fueron prácticamente idénticos. Por ejemplo, en el trabajo QD1/1, TCP registró 0.24 ms, mientras que RDMA se quedó justo por detrás, con 0.27 ms.
A medida que aumentaba la concurrencia, RDMA se adelantó. En trabajos QD16/64, RDMA registró 23.92 ms, mientras que TCP alcanzó 26.81 ms, una mejora del 10.8 %. Con la carga máxima de trabajos QD32/64, RDMA completó 54.61 ms, mientras que TCP se disparó a 70.12 ms, una reducción del 22 % en la latencia de RDMA.
Rendimiento del almacenamiento de GPUDirect
Una de las pruebas que realizamos en este banco de pruebas fue la prueba Magnum IO GPUDirect Storage (GDS). GDS es una función desarrollada por NVIDIA que permite a las GPU ignorar la CPU al acceder a datos almacenados en unidades NVMe u otros dispositivos de almacenamiento de alta velocidad. En lugar de enrutar los datos a través de la CPU y la memoria del sistema, GDS permite la comunicación directa entre la GPU y el dispositivo de almacenamiento, lo que reduce significativamente la latencia y mejora el rendimiento de los datos.
Cómo funciona el almacenamiento GPUDirect
Tradicionalmente, cuando una GPU procesa datos almacenados en una unidad NVMe, estos deben pasar primero por la CPU y la memoria del sistema antes de llegar a la GPU. Este proceso genera cuellos de botella, ya que la CPU actúa como intermediario, lo que aumenta la latencia y consume valiosos recursos del sistema. El almacenamiento GPUDirect elimina esta ineficiencia al permitir que la GPU acceda a los datos directamente desde el dispositivo de almacenamiento a través del bus PCIe. Esta ruta directa reduce la sobrecarga asociada con el movimiento de datos, lo que permite transferencias más rápidas y eficientes.
Las cargas de trabajo de IA, especialmente las que implican aprendizaje profundo, requieren un uso intensivo de datos. El entrenamiento de grandes redes neuronales requiere el procesamiento de terabytes de datos, y cualquier retraso en la transferencia de datos puede provocar GPU infrautilizadas y tiempos de entrenamiento más largos. El almacenamiento GPUDirect aborda este desafío garantizando que los datos se entreguen a la GPU lo más rápido posible, minimizando el tiempo de inactividad y maximizando la eficiencia computacional.
Además, GDS es particularmente beneficioso para cargas de trabajo que implican la transmisión de grandes conjuntos de datos, como el procesamiento de video, el procesamiento de lenguaje natural o la inferencia en tiempo real. Al reducir la dependencia de la CPU, GDS acelera el movimiento de datos y libera recursos de la CPU para otras tareas, lo que mejora aún más el rendimiento general del sistema.
Además del ancho de banda bruto, GPUDirect con NVMe-oF (TCP/RDMA) también ofrece E/S de latencia ultrabaja. Esto garantiza que las GPU nunca se queden sin datos, lo que hace que el sistema sea ideal para la inferencia de IA en tiempo real, los procesos de análisis y la reproducción de vídeo.
Para muchas implementaciones prácticas, esto se traduce en un rendimiento utilizable de 100 a 200 GbE, que se alinea perfectamente con cargas de trabajo como inferencia de IA (2 a 4 GPU), producción de medios (reproducción de transmisiones, almacenamiento en caché de borde OTT), análisis de video de vigilancia y puntos de control de HPC.
Rendimiento de lectura
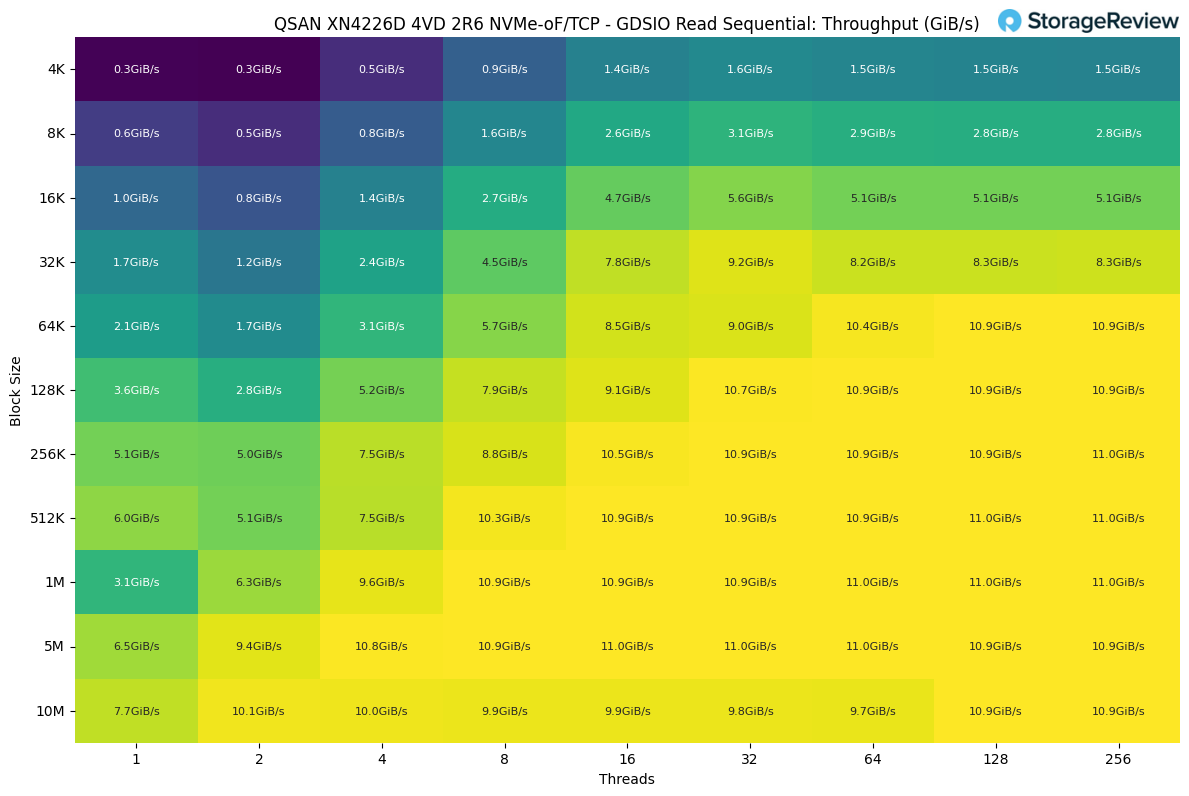
En la carga de trabajo de lectura secuencial GDSIO, el rendimiento aumentó de forma constante tanto con el tamaño del bloque como con el número de subprocesos, alcanzando un máximo de 11.0 GiB/s en múltiples puntos de prueba. Los resultados más altos se mantuvieron al alcanzar tamaños de bloque de 512 K o superiores, donde el rendimiento se estabilizó constantemente entre 10.9 y 11.0 GiB/s, independientemente del número de subprocesos.
Con tamaños de bloque más pequeños, el rendimiento inicial fue mucho menor. Por ejemplo, con bloques de 4K, el rendimiento comenzó en tan solo 0.3 GiB/s con un solo subproceso y se estabilizó en 1.5 GiB/s incluso con 256 subprocesos. En comparación, aumentar el tamaño del bloque a 64K permitió al sistema escalar hasta 10.9 GiB/s, casi saturando el rendimiento con un mayor número de subprocesos.
El punto óptimo pareció estar entre bloques de 128 K y 256 K, donde el rendimiento superó los 10 GiB/s con 32 o más subprocesos y se mantuvo constante en los tamaños de bloque más grandes probados. Esto demuestra cómo la plataforma alcanza la saturación total del ancho de banda una vez que los tamaños de bloque alcanzan un tamaño suficiente, con solo mejoras incrementales a partir de 256 K.
Leer latencia
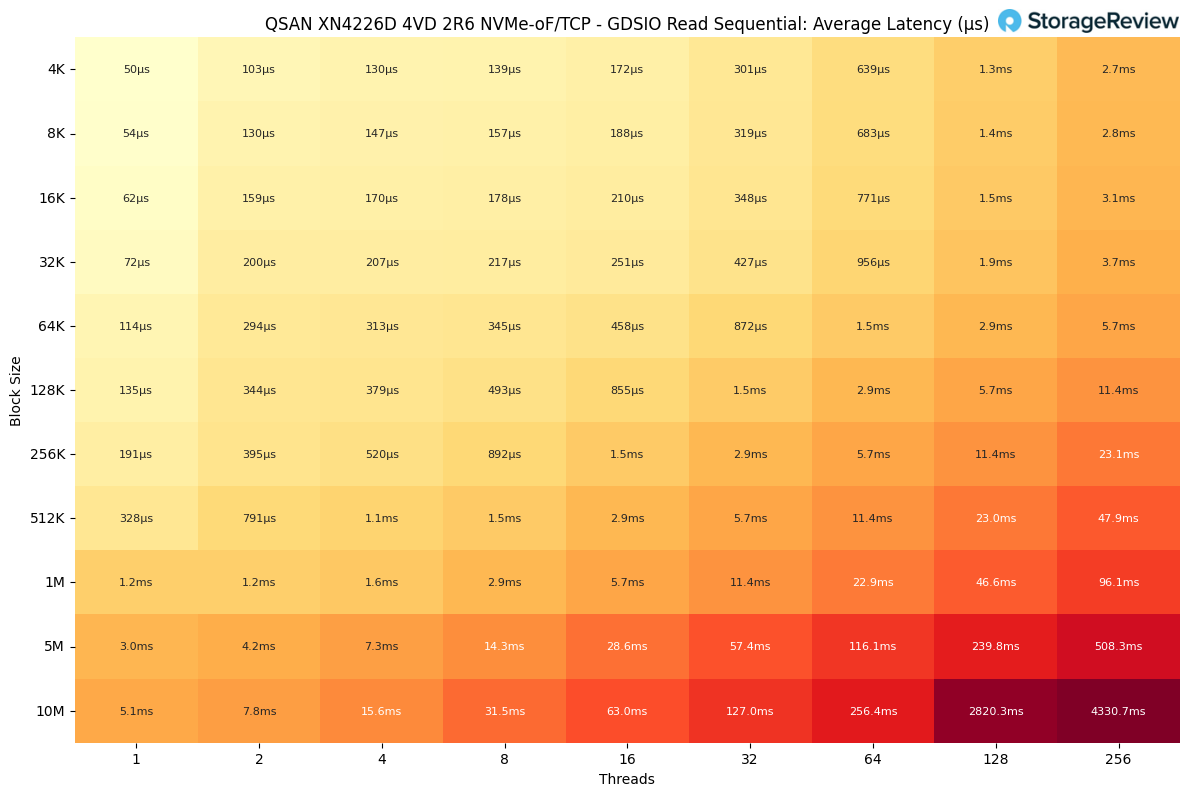
En los resultados de latencia de lectura secuencial de GDSIO, los tiempos de respuesta escalaron de forma predecible tanto con el tamaño del bloque como con el número de subprocesos. Con las cargas de trabajo más pequeñas, la latencia se mantuvo extremadamente baja. Por ejemplo, con bloques de 4K en un solo subproceso, la latencia fue de tan solo 50 µs, manteniéndose por debajo de los 200 µs hasta bloques de 32K con una concurrencia mínima.
A medida que aumentaba el número de subprocesos, la latencia comenzó a aumentar de forma más notable. Con bloques de 64 kb y 64 subprocesos, la latencia alcanzó 1.5 ms, duplicándose a 2.9 ms con 128 subprocesos y subiendo a 5.7 ms con 256 subprocesos. Por el contrario, tamaños de bloque más pequeños, como 4 kb y 8 kb, solo alcanzaron los 2.7-2.8 ms, incluso con el máximo de 256 subprocesos, lo que demuestra un control más preciso con granularidades más finas.
Los tamaños de bloque más grandes generaron saltos más drásticos. Con 1 millón de bloques y 256 subprocesos, la latencia alcanzó los 96.1 ms, mientras que con 10 millones de bloques y 256 subprocesos, la latencia alcanzó los 4.3 s, lo que demuestra claramente los límites de escalabilidad del sistema en condiciones extremas.
Rendimiento de escritura
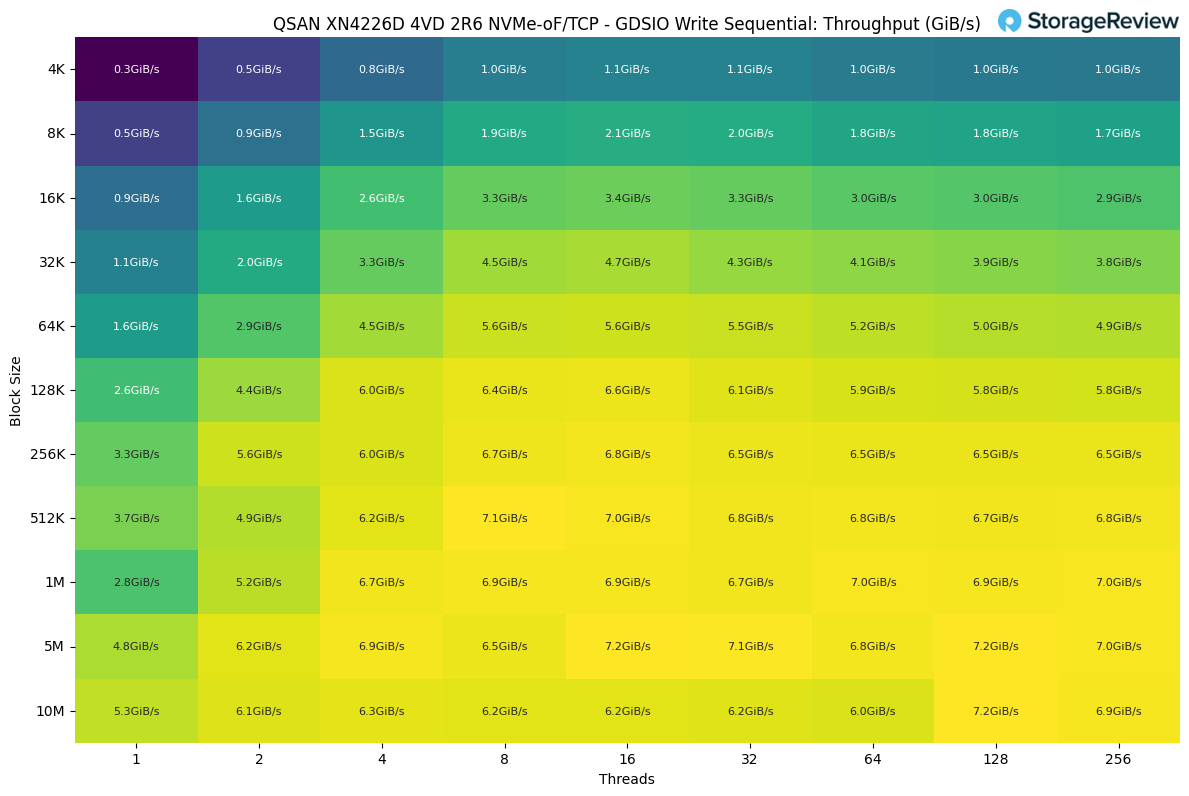
En la carga de trabajo de escritura secuencial GDSIO, el rendimiento aumentó con el tamaño del bloque y el número de subprocesos, pero se estancó muy por debajo del límite de rendimiento de lectura. El sistema alcanzó un pico de 7.2 GiB/s, utilizando tamaños de bloque mayores, como 5 M y 10 M, con 128 subprocesos.
Con los tamaños de bloque más pequeños, el rendimiento fue moderado. Con bloques de 4K, el rendimiento comenzó en 0.3 GiB/s con un solo subproceso y escaló a 1.0 GiB/s con 32 subprocesos, para luego estabilizarse. Aumentar el tamaño de bloque a 64K liberó más ancho de banda, alcanzando 5.6 GiB/s con ocho subprocesos, antes de disminuir ligeramente con una mayor concurrencia.
El mejor equilibrio se produjo entre bloques de 512 000 y 1 000 000, donde el rendimiento osciló entre 6.7 y 7.1 GiB/s en diferentes cantidades de subprocesos, lo que indica que el sistema alcanzó la saturación en este rango. Más allá de ese punto, los subprocesos adicionales no produjeron mejoras significativas y, en algunos casos, el rendimiento incluso disminuyó ligeramente debido al aumento de la sobrecarga.
Escribir latencia
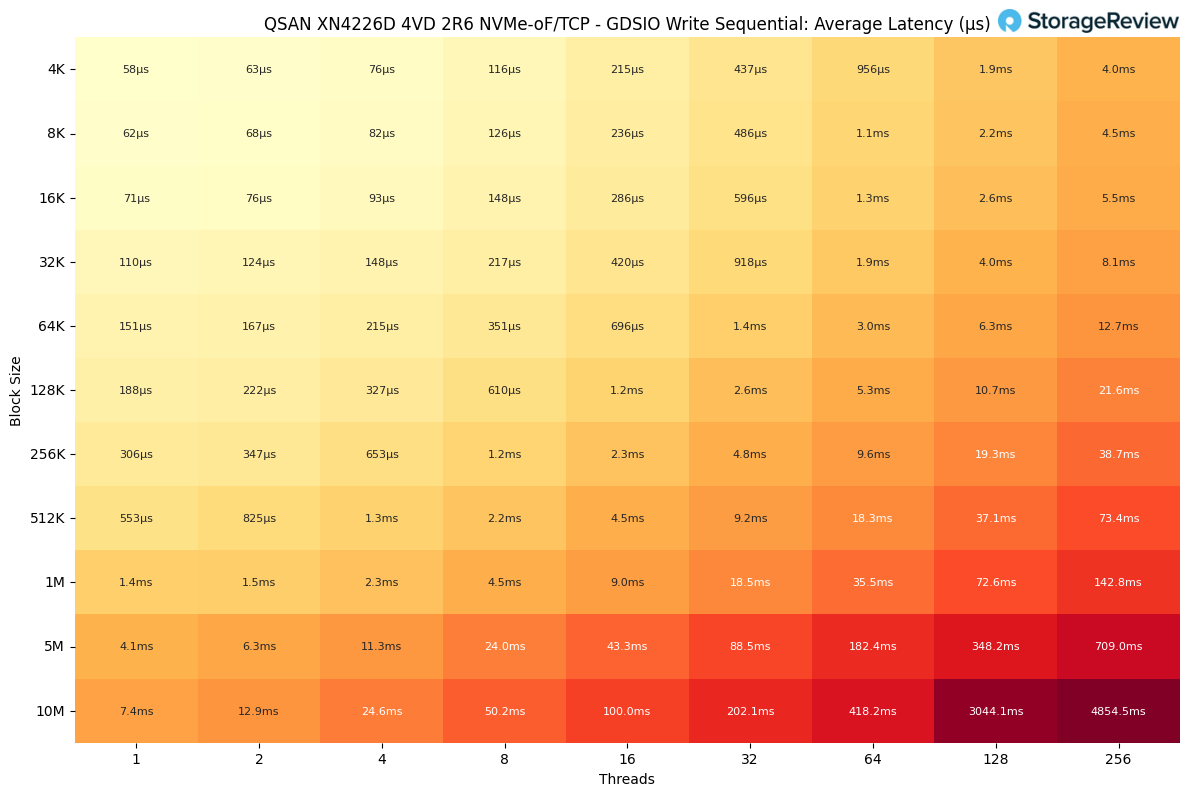
En los resultados de latencia de escritura secuencial GDSIO, los tiempos de respuesta escalaron suavemente en tamaños de bloque más bajos, pero aumentaron drásticamente una vez que aumentaron tanto el tamaño del bloque como el número de subprocesos.
Con las cargas de trabajo más pequeñas, la latencia fue mínima. Con bloques de 4K y un solo subproceso, la latencia promedio fue de tan solo 58 µs y se mantuvo por debajo de los 200 µs en bloques de 16K con hasta cuatro subprocesos. Incluso con bloques de 32K y concurrencia moderada, la latencia se mantuvo por debajo de 1 ms.
A medida que el sistema cambió a bloques de mayor tamaño, los retrasos se acentuaron. Con bloques de 128 K y 64 subprocesos, la latencia alcanzó los 5.3 ms, duplicándose de nuevo hasta los 10.7 ms con 128 subprocesos. Con bloques de 512 K, los resultados se ajustaron aún más, alcanzando los 73.4 ms con 256 subprocesos.
Los casos más pesados, bloques de 5M y 10M con 256 subprocesos, experimentaron un aumento dramático en la latencia a 709 ms y 4.8 segundos, respectivamente, lo que revela los límites superiores del escalamiento de escritura secuencial.
Conclusión
El XN4226D de QSAN es justo lo que muchos equipos de TI necesitan. Se trata de una plataforma NVMe unificada con doble controlador que admite protocolos modernos y heredados sin necesidad de cambios arquitectónicos. En nuestras pruebas, TCP lideró las lecturas secuenciales grandes a 21.21 GB/s, mientras que RDMA produjo las escrituras secuenciales grandes más potentes a 11.14 GB/s y mantuvo la latencia baja a medida que aumentaba la concurrencia. Con tamaños de bloque más pequeños, RDMA mejoró consistentemente la eficiencia de escritura aleatoria y controló el comportamiento de cola. La conclusión es sencilla: utilice NVMe-oF TCP para una amplia compatibilidad y un alto ancho de banda de lectura, y opte por RDMA cuando la latencia y la consistencia de escritura sean cruciales.
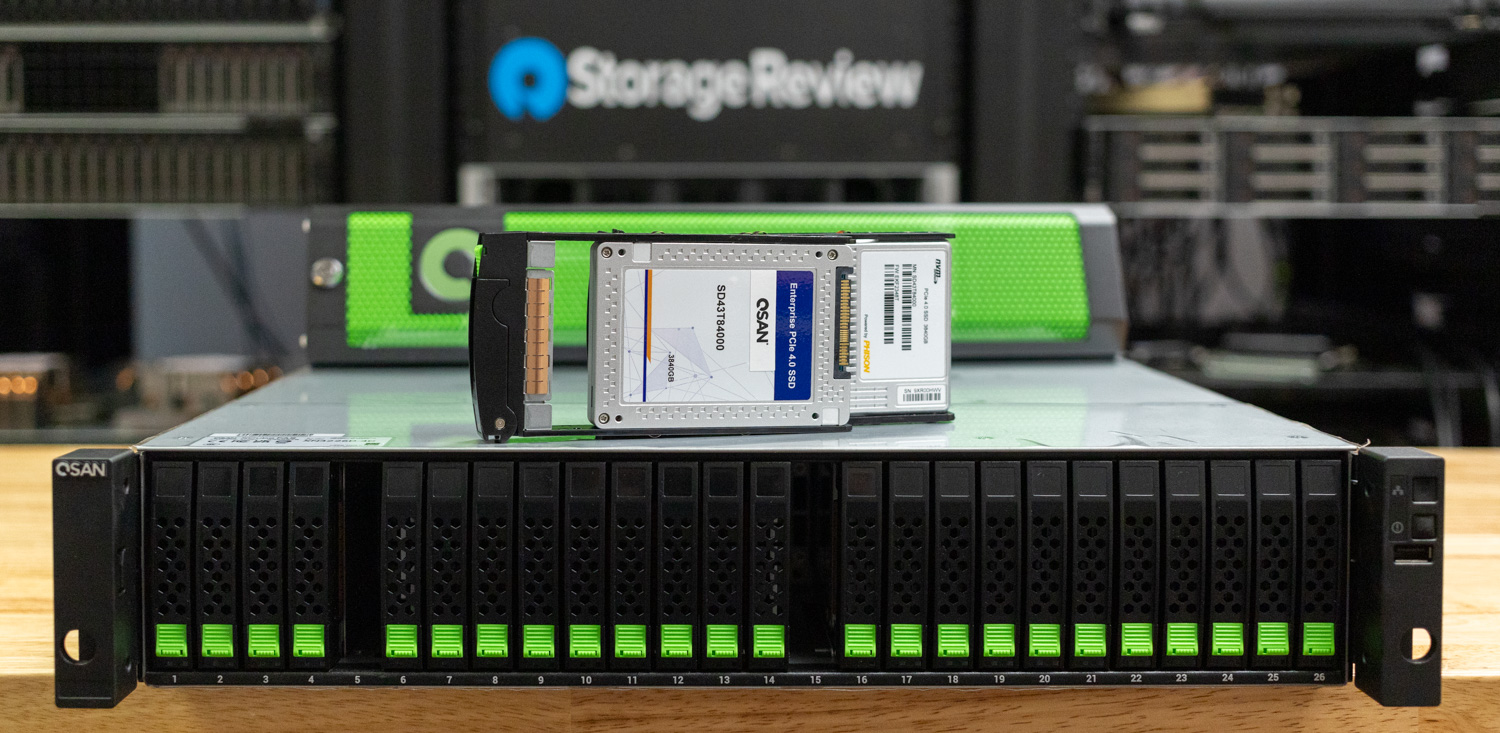
El espacio de hardware es práctico. Obtiene 26 bahías frontales para unidades NVMe U.2 o U.3 en un chasis 2U, con alta disponibilidad activa y expansión sencilla a bandejas SAS cuando la capacidad prioriza la velocidad bruta de NVMe. QSM 4 ofrece los servicios de datos esperados y una interfaz de usuario clara, junto con una API REST que facilita la integración perfecta con la automatización existente. Los equipos de TI pequeños encontrarán que QSM 4 es fácil de configurar y administrar. Para validar esto, integramos fácilmente nuestro clúster Proxmox, proporcionando a esas máquinas virtuales acceso a almacenamiento de alta velocidad. Para cargas de trabajo más avanzadas, QSAN está perfectamente preparado para satisfacer las necesidades de IA de las pymes.
Para las organizaciones que valoran el rendimiento predecible, la gestión limpia y el alcance multiprotocolo, el XN4226D es una excelente opción. Ofrece un rendimiento NVMe real, una alta latencia de escritura con RDMA y una experiencia de software que no ralentizará su sistema. Además, su precio razonable permite que esta plataforma QSAN se adapte a entornos mixtos sin complicaciones.


 Amazon