

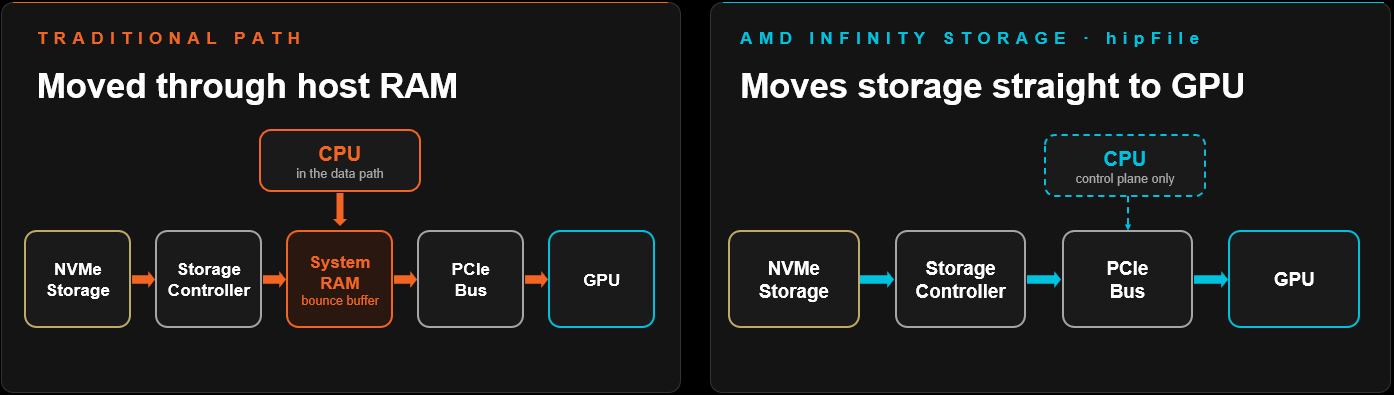
AMD ROCm 10.1, rilasciato il 5 ottobre, pone maggiore enfasi sul percorso tra l'archiviazione e la GPU. I file di checkpoint, le cache chiave-valore e i pesi dei modelli superano ormai regolarmente la capacità della memoria dell'acceleratore e, quando ciò accade, il tempo impiegato per il trasferimento dei dati inizia a influenzare maggiormente il tempo di iterazione rispetto ai calcoli matematici. Questa versione potenzia AMD Infinity Storage, lo stack di archiviazione diretta introdotto in ROCm 7.14, integrando l'accesso all'archiviazione nel runtime HIP e aggiungendo memoria host compatibile con NUMA, in modo che i dati raggiungano la GPU senza passare attraverso la memoria della CPU.
Pipeline di archiviazione GPU dirette e memoria compatibile con NUMA
La libreria hipFILE integrata in AMD Infinity Storage ora supporta un backend asincrono a percorso rapido. Le richieste di lettura e scrittura vengono eseguite direttamente su un flusso HIP, saltando la fase di staging nella memoria host richiesta dal percorso tradizionale. Secondo AMD, il risultato è una latenza inferiore per i motori di checkpoint e l'offload della cache KV, mantenendo al contempo una larghezza di banda elevata. Le note di rilascio specificano i nomi delle chiamate: hipFileReadAsync() e hipFileWriteAsync() ora supportano il percorso rapido.
Un'API di I/O batch invia più richieste di file contemporaneamente e le distribuisce su un pool interno di thread di lavoro, mantenendo così le code di archiviazione piene quando un processo di training sta elaborando un set di dati di grandi dimensioni. La telemetria si evolve di conseguenza: hipFileGetStatsL1, L2 e L3 restituiscono statistiche di I/O progressivamente più dettagliate, e questi contatori alimentano i profiler di ROCm, consentendo all'operatore di determinare se una pipeline è limitata da risorse di calcolo, memoria o trasferimento dati.
Su host a due socket, un buffer allocato sul socket sbagliato comporta una penalità tra socket per ogni trasferimento. ROCm 10.1 estende le API di gestione della memoria virtuale HIP con hipMemLocationTypeHostNuma e hipMemLocationTypeHostNumaCurrent, consentendo di allocare la memoria host su uno specifico nodo NUMA durante l'intero ciclo di vita di creazione, prenotazione, mappatura e disattivazione. Librerie come RCCL possono creare buffer di comunicazione a copia zero locali a NUMA, mantenendo il traffico host-dispositivo al di fuori dell'interconnessione del socket.
ROCm CLI v1.0.0 e flussi di lavoro dell'agente AI
ROCm CLI raggiunge la versione 1.0.0 come singolo binario per Linux, Windows e WSL2 che installa, configura ed esegue carichi di lavoro AI locali su GPU AMD. Rileva i pacchetti flash-attn e amd-aiter necessari a vLLM, supporta il layout aggiornato dei pacchetti ROCm 10 e aggiunge un flag per installazioni completamente non interattive in ambienti scriptati o CI. Una dashboard TUI a schermo intero mostra la telemetria GPU in tempo reale accanto all'erogazione del modello e una finestra di chat locale per verificare che un endpoint risponda.
AMD Skills, il pacchetto di integrazioni per agenti di codifica come Claude Code e Codex, ne aggiunge altri due. quark-install configura AMD Quark con una build PyTorch corrispondente, e quark-torch-llm-ptq esegue la quantizzazione post-addestramento su PyTorch e Hugging Face LLM con schemi come FP8 e INT4.
Modernizzazione della profilazione e della telemetria
ROCprofiler-SDK aggiunge la riproduzione del kernel, attualmente in versione beta. L'hardware GPU espone un numero limitato di contatori di prestazioni per ogni dispatch, quindi la raccolta di un set completo di contatori in precedenza implicava la riesecuzione dell'intera applicazione per ogni gruppo di contatori. La riproduzione del kernel riesegue ogni dispatch sul posto, reimpostando la memoria GPU tra un passaggio e l'altro, e raccoglie il set completo in una singola esecuzione. L'SDK consente inoltre di avviare e interrompere la profilazione in qualsiasi punto di un'esecuzione per PyTorch Kineto e Triton Proton, e include una skill per l'agente di campionamento PC che guida un assistente di programmazione attraverso il campionamento PC di rocprofv3 per individuare i blocchi di calcolo.
Il report roofline di ROCm Compute Profiler è ora una pagina HTML interattiva, che consente agli ingegneri di isolare un singolo kernel e di commutare l'asse dell'intensità aritmetica tra i diversi livelli di cache. Sono disponibili report di campionamento PC per kernel, fino al conteggio dei campioni e dei tempi di stallo sulle singole istruzioni, e una nuova guida illustra la profilazione di vLLM. ROCm Systems Profiler aggiunge la tracciatura Linux per le APU Gorgon Point 1, 2 e 3 (gfx1150, gfx1152 e gfx1153), e ROCm Optiq ora visualizza i profili rocprofv3 insieme alle tracce di Systems Profiler e all'analisi di Compute Profiler.
AMD SMI (amd-smi) sostituisce ROCm SMI, rimosso dalla build standard in questa versione. Supporta GPU, CPU e APU AMD su Linux e Windows, sia bare metal che virtualizzate, con un'interfaccia a riga di comando (CLI), una libreria C (amd_smi_lib) e binding per Python, Go e Rust. Il supporto per i container si estende a containerd, CRI-O, Podman, LXC e LXD, inclusi i pod di Kubernetes, consentendo all'amministratore del cluster di associare i processi e l'utilizzo della GPU al container che li esegue.
Aggiornamenti del compilatore principale, librerie e supporto runtime
La toolchain passa da LLVM 23 a LLVM 24 e la macro clang_major ora riporta la versione 24, che chiunque blocchi le versioni del compilatore o si colleghi a libLLVM dovrebbe verificare prima dell'aggiornamento. Le build incrementali diventano più veloci grazie alla memorizzazione nella cache delle partizioni create dall'ottimizzazione in fase di collegamento del codice del dispositivo, in modo che le partizioni invariate vengano riutilizzate nella build successiva.
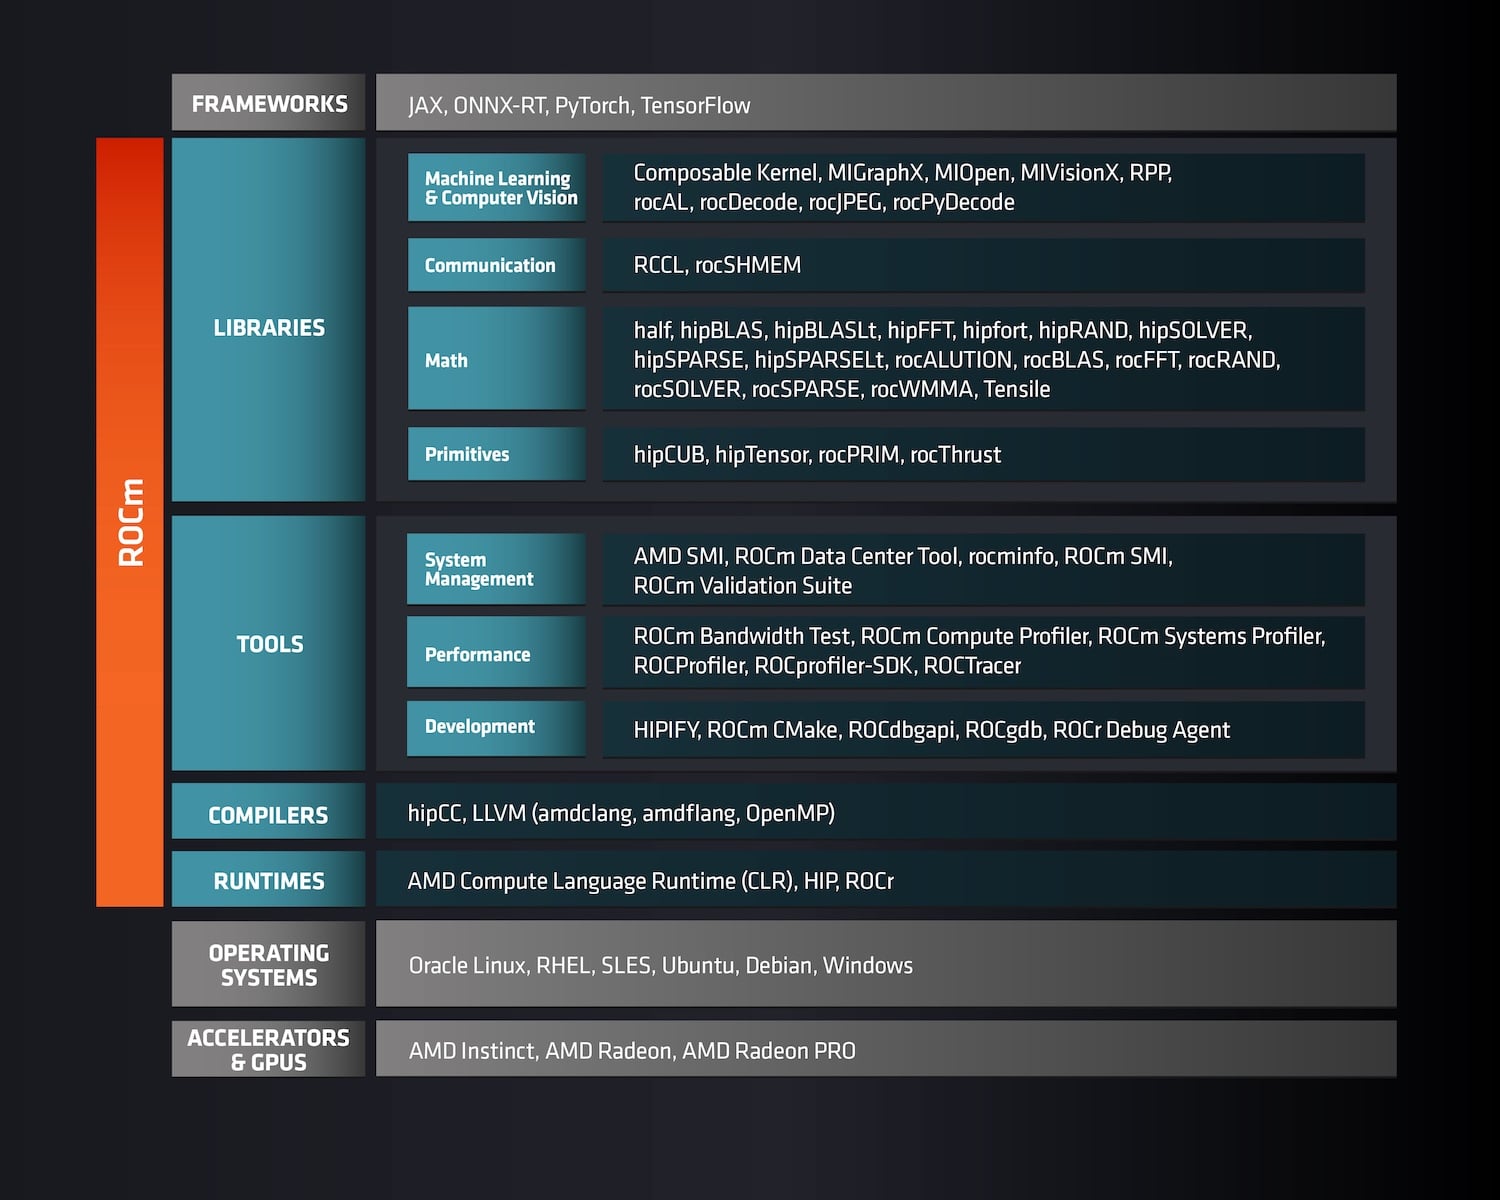
Composable Kernel velocizza l'attenzione sulle GPU Radeon e aggiunge più tipi di moltiplicazione di matrici quantizzate al suo dispatcher. MIGraphX sostituisce il suo compilatore di backend da rocMLIR a rocMLIRTriton, il che, secondo AMD, migliora le prestazioni di inferenza e spesso riduce i tempi di compilazione del modello, mantenendo al contempo il compilatore allineato con Triton a monte. rocSPARSE esegue le risoluzioni triangolari direttamente su matrici memorizzate nel formato ELLPACK (ELL), senza alcun passaggio di conversione preliminare.
hipThreads, una novità tra le librerie di threading dell'SDK ROCm Core, porta i concetti standard di threading del C++ sulle GPU AMD su Linux e Windows. L'obiettivo è accelerare il codice threaded esistente sulla CPU sulla GPU senza una riscrittura completa nei kernel HIP e nelle primitive di sincronizzazione.
Windows Subsystem for Linux 2 entra in fase di anteprima tecnica, con l'installazione dei pacchetti Linux standard nella macchina virtuale guest e la paravirtualizzazione della GPU che delega il lavoro al driver host di Windows. L'anteprima supporta i pacchetti .deb e i wheel Python, ma non gli RPM, e gli strumenti di profilazione, debug e quelli dipendenti da KFD non funzionano ancora all'interno di WSL2. Per quanto riguarda la virtualizzazione, KVM SR-IOV è ora supportato con Ubuntu 26.04 LTS sia come host che come guest, in combinazione con la versione 9.3.0.K del driver di virtualizzazione GIM di AMD.
L'elenco dell'hardware supportato include la Radeon AI PRO R9600, oltre a Instinct MI355X, MI350X e MI350P, le serie MI300 e MI200, il resto della famiglia Radeon AI PRO R9700 e i processori Ryzen AI.


 Amazon