

AMD ha annunciato la disponibilità di Pensando Pollara 400, la prima scheda di interfaccia di rete (NIC) per intelligenza artificiale (AI) completamente programmabile del settore. Progettata per accelerare i carichi di lavoro di intelligenza artificiale (AI), questa soluzione innovativa è compatibile con gli standard in via di sviluppo dell'Ultra Ethernet Consortium (UEC) ed è ottimizzata per migliorare la comunicazione GPU-GPU nei data center. La NIC AI Pollara 400 rappresenta un significativo passo avanti nella realizzazione di infrastrutture scalabili e ad alte prestazioni per carichi di lavoro di intelligenza artificiale/apprendimento automatico (AI), intelligenza artificiale generativa e modelli linguistici di grandi dimensioni.
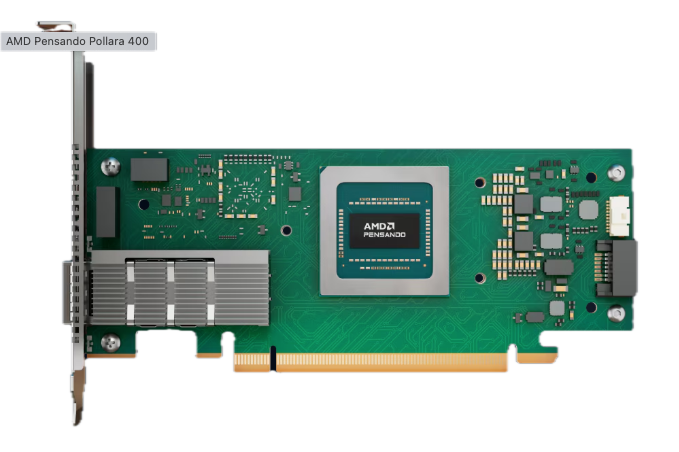
Con l'evoluzione dell'intelligenza artificiale, le organizzazioni si trovano ad affrontare la sfida di sviluppare infrastrutture di elaborazione simili che offrano prestazioni ottimali e la flessibilità necessaria per adattarsi alle esigenze future. Un fattore critico in questa evoluzione è l'efficiente scalabilità delle reti di comunicazione GPU intra-nodo. L'impegno di AMD nel preservare la scelta dei clienti e ridurre il costo totale di proprietà (TCO) senza sacrificare le prestazioni è evidente nella scheda di rete AI Pollara 400. Questa soluzione consente alle organizzazioni di creare un'infrastruttura di intelligenza artificiale pronta per il futuro, mantenendo al contempo la compatibilità con un ecosistema aperto.
Accelerare i carichi di lavoro dell'intelligenza artificiale con reti avanzate
Massimizzare le prestazioni dei cluster AI è una priorità assoluta per i provider di servizi cloud, gli hyperscaler e le aziende. Tuttavia, molte organizzazioni considerano la rete un collo di bottiglia, limitando l'utilizzo della GPU. Sebbene la velocità di trasferimento dati sia essenziale, è vantaggiosa solo quando la rete è ottimizzata per soddisfare le esigenze dei moderni carichi di lavoro AI.
| Specificazione | Dettagli |
|---|---|
| Larghezza di banda massima | 400 Gbps |
| Fattore di forma | Mezza altezza, mezza lunghezza (HHHL) |
| Interfaccia host | PCIe Gen5.0x16 |
| Interfaccia Ethernet | QSFP112 (NRZ/PAM4 Serdes) |
| Velocità Ethernet | 25/50/100/200/400 Gbps |
| Configurazioni Ethernet | Supporta fino a 4 porte: 1 x 400G 2 x 200G 4 x 100G 4 x 50G 4 x 25G |
| Management | MCTP su SMBus |
La scheda di rete AI Pensando Pollara 400 affronta queste sfide offrendo bilanciamento del carico intelligente, gestione della congestione, failover rapido e ripristino in caso di perdite. Queste funzionalità garantiscono il pieno utilizzo delle risorse di rete e di elaborazione, consentendo tempi di attività più elevati, un completamento più rapido dei processi e una maggiore affidabilità su larga scala. Con l'aumento della complessità e delle dimensioni dei carichi di lavoro AI, la scheda di rete AI Pollara 400 fornisce gli strumenti necessari per eliminare i colli di bottiglia e liberare appieno il potenziale dell'infrastruttura AI.
Una soluzione programmabile e pronta per il futuro
La scheda di rete AI Pollara 400 è basata sull'architettura P4 di AMD, offrendo una pipeline hardware completamente programmabile che offre una flessibilità senza pari. Questa programmabilità consente ai clienti di adattarsi a nuovi standard, come quelli definiti dall'UEC, o di creare protocolli di trasporto personalizzati progettati per i loro specifici carichi di lavoro. A differenza dell'hardware tradizionale, che richiede nuove generazioni per supportare le funzionalità emergenti, Pollara 400 consente alle organizzazioni di aggiornare la propria infrastruttura AI senza dover attendere gli aggiornamenti hardware.
Le caratteristiche principali del Pollara 400 includono il supporto per diversi protocolli di trasporto, come RoCEv2, UEC RDMA e altri protocolli Ethernet, garantendo la compatibilità con diversi carichi di lavoro. Funzionalità avanzate come l'intelligent packet spraying, la gestione dei pacchetti fuori ordine e la ritrasmissione selettiva ottimizzano l'utilizzo della larghezza di banda e riducono la latenza, fattori fondamentali per l'addestramento e l'implementazione di modelli di intelligenza artificiale di grandi dimensioni. Il controllo della congestione basato sul percorso e il rilevamento rapido dei guasti garantiscono prestazioni prossime alla velocità di trasmissione e riducono al minimo i tempi di inattività della GPU, anche in caso di congestione transitoria o guasti di rete.
Il vantaggio dell'ecosistema aperto
L'approccio basato su un ecosistema aperto di AMD garantisce la compatibilità indipendente dal fornitore, consentendo alle organizzazioni di creare un'infrastruttura di intelligenza artificiale che soddisfi le esigenze attuali, pur essendo scalabile e programmabile per le esigenze future. Questa strategia riduce le spese in conto capitale (CapEx) eliminando la necessità di costosi fabric di switching a buffer elevato basati su celle, garantendo al contempo prestazioni elevate.
La scheda di rete AI Pensando Pollara 400 è già stata validata in alcuni dei più grandi data center scale-out al mondo. I provider di servizi cloud (CSP) hanno scelto questa soluzione per la sua combinazione unica di programmabilità, elevata larghezza di banda, bassa latenza e un ampio set di funzionalità. Abilitando un'infrastruttura estensibile all'interno di un ecosistema aperto, AMD aiuta le organizzazioni a preparare i propri ambienti AI per il futuro, offrendo al contempo vantaggi immediati in termini di prestazioni.


 Amazon