

CTERA ha presentato Fusion Direct, un'architettura dati federata progettata per colmare il divario di lunga data tra i file system aziendali e lo storage a oggetti. La nuova offerta amplia la famiglia CTERA Fusion, che già include CTERA Fusion Gateway, e si posiziona come componente fondamentale della CTERA Intelligent Data Platform. L'obiettivo è quello di offrire un'unica infrastruttura dati ad alte prestazioni in grado di gestire sia i carichi di lavoro basati su file incentrati sull'utente, sia le pipeline di intelligenza artificiale guidate dall'apprendimento automatico, senza duplicare i dati o riprogettare le applicazioni.
Unificazione di file e oggetti sotto un unico spazio dei nomi
I team IT aziendali sono stati tradizionalmente costretti a gestire due domini di storage separati. I sistemi NAS forniscono accesso SMB e NFS per la collaborazione tra utenti e per applicazioni legacy o specifiche del settore. Lo storage a oggetti, a cui si accede in genere tramite S3, viene utilizzato per carichi di lavoro su larga scala, cloud-native e analitici. Collegare questi ambienti ha spesso comportato la creazione di infrastrutture parallele, la copia di dati tra di esse o l'utilizzo di gateway che traducono le chiamate ai file in API a oggetti. Questi livelli di traduzione possono introdurre latenza, complessità e rischi operativi aggiuntivi, soprattutto su larga scala.
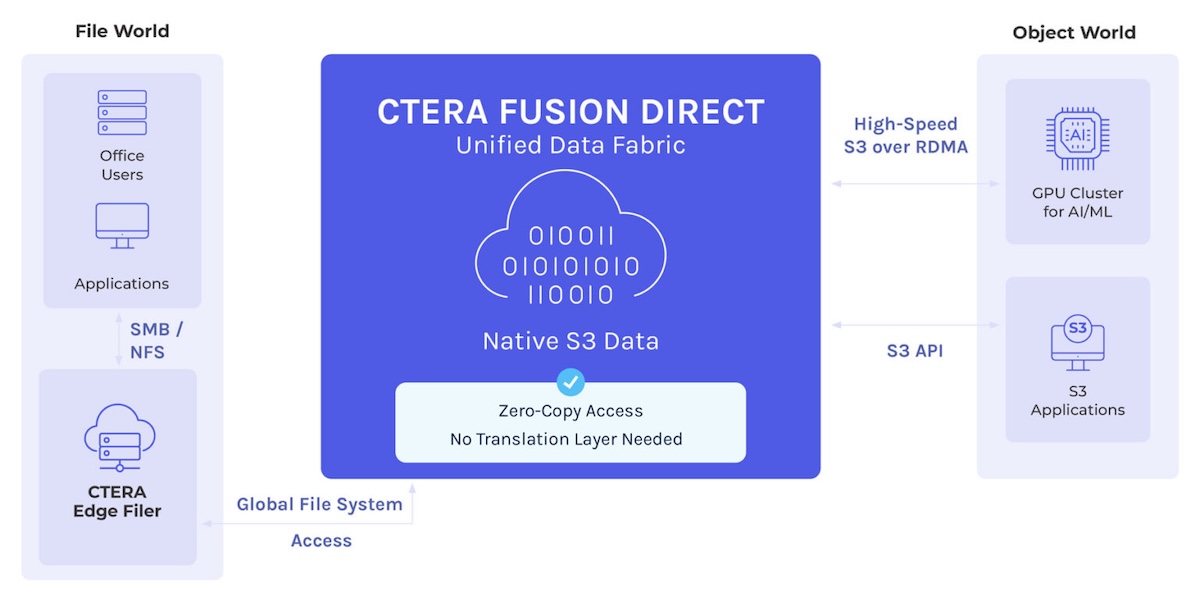
Fusion Direct affronta questo problema esponendo un singolo namespace globale federato in cui file e oggetti coesistono in modo nativo. I dati possono essere scritti sulla piattaforma come file e letti come oggetti, oppure scritti come oggetti e letti come file. Il sistema supporta un comportamento di lettura e scrittura bidirezionale completo senza convertire i file in blocchi di oggetti proprietari o instradare l'accesso attraverso un gateway di traduzione separato. CTERA specifica esplicitamente che non vi è alcun collo di bottiglia nella conversione da file a oggetto e che non è in gioco alcuno schema di incapsulamento proprietario.
Dal punto di vista dell'accesso, le applicazioni e gli utenti aziendali esistenti continuano a operare tramite SMB e NFS come fanno oggi. Allo stesso tempo, i cluster di addestramento AI, gli ambienti HPC e i servizi cloud-native possono accedere agli stessi set di dati tramite S3 e S3 su RDMA, progettato per fornire throughput alla velocità di linea ai cluster GPU e ad altri ambienti di calcolo ad alte prestazioni.
Sfruttare gli archivi di oggetti esistenti e l'edge computing distribuito
Un aspetto progettuale fondamentale è la possibilità di collegare i bucket S3 esistenti direttamente alla struttura dati di Fusion Direct. Anziché migrare o reintegrare i dati degli oggetti in un nuovo sistema, le organizzazioni possono presentare i propri namespace di archiviazione oggetti esistenti come parte dello spazio globale di file/oggetti. Una volta collegati, gli oggetti in tali bucket possono essere accessibili come file standard in diverse sedi periferiche e implementazioni multi-cloud.
Questo approccio consente ai team IT di esporre i dati degli oggetti come file a utenti e applicazioni a livello globale, pur continuando a presentarli in modo nativo come S3 ai carichi di lavoro di intelligenza artificiale e analisi. Riduce inoltre la necessità di infrastrutture duplicate che altrimenti verrebbero implementate in più regioni o siti periferici per la preparazione o la riformattazione dei dati. Il risultato finale è una struttura di archiviazione più semplice per i set di dati distribuiti che si estendono su più aree geografiche.
Architettura per le prestazioni dell'era dell'IA.
CTERA Fusion Direct sfrutta la piattaforma dati intelligente esistente di CTERA ed è protetta dal brevetto statunitense n. 12,007,9521. L'architettura si concentra sul supporto simultaneo di carichi di lavoro collaborativi su file e sul consumo di dati ad alta velocità su scala macchina.
Una delle funzionalità principali è l'accesso nativo senza copie. I dati scritti sulla piattaforma CTERA come file sono immediatamente disponibili come oggetti S3 standard, senza copie secondarie o conversioni in background. Viceversa, i bucket S3 possono essere connessi direttamente e il loro contenuto diventa immediatamente accessibile come file nello spazio dei nomi globale. Questo per evitare sia la latenza che il sovraccarico di archiviazione associati a copie duplicate o cache intermedie.
Un altro ambito di interesse è lo streaming di file ad alta velocità. Risorse multimediali di grandi dimensioni, set di dati di addestramento e altri contenuti che richiedono un'elevata capacità di archiviazione possono essere trasmessi in streaming direttamente dallo storage a oggetti alle applicazioni basate su file. Questo approccio elimina la necessità di download locali di grandi quantità di dati o di fasi di staging, che possono rallentare i flussi di lavoro e consumare ulteriore spazio di archiviazione in periferia o nei cluster di calcolo.
Sul fronte delle prestazioni, Fusion Direct espone gli oggetti nativi in modi che supportano i modelli di accesso S3-over-RDMA e GPU-direct. Per i cluster di intelligenza artificiale, ciò significa che le GPU possono leggere e scrivere dati a velocità pari o quasi a quella di rete da dataset basati su oggetti senza ulteriori traduzioni di protocollo nel percorso dati. Questo è particolarmente rilevante per i processi di training e inferenza limitati dalla velocità di I/O piuttosto che dalla potenza di calcolo pura.
CTERA pone inoltre l'accento sulle considerazioni relative alla sovranità dei dati. Poiché i dati risiedono in bucket S3 standard, senza incapsulamenti proprietari o gateway che detengono i metadati, le organizzazioni mantengono il controllo delle proprie informazioni sia nelle implementazioni on-premise che nei cloud pubblici. L'architettura è pensata per ridurre al minimo la dipendenza da un singolo livello dati e preservare la flessibilità man mano che le strategie infrastrutturali si evolvono.
Il crollo dei silos di dati umani e informatici
Oded Nagel, CEO di CTERA, afferma che il principale ostacolo all'adozione dell'IA nelle aziende non è la scarsità di dati, bensì la difficoltà di utilizzarli in modo efficace. Sottolinea come la separazione dei dati per l'uso umano da quelli per l'analisi automatica crei attrito. Mantenere ambienti e set di dati separati rallenta l'implementazione dell'IA. Nagel propone di combinarli in un'unica piattaforma che supporti SMB/NFS e S3 su RDMA, offrendo alle aziende un percorso diretto dai dati grezzi ai set di dati pronti per l'IA. Una piattaforma unificata può aiutare le organizzazioni a utilizzare al meglio i dati e a rimanere competitive in un mercato guidato dall'apprendimento automatico e dall'automazione.
Disponibilità
CTERA Fusion Direct è ora disponibile come parte della piattaforma dati intelligente CTERA e si posiziona come componente fondamentale della più ampia famiglia CTERA Fusion per l'unificazione di file e oggetti. Per ulteriori informazioni, visitare il sito web di CTERA.


 Amazon