

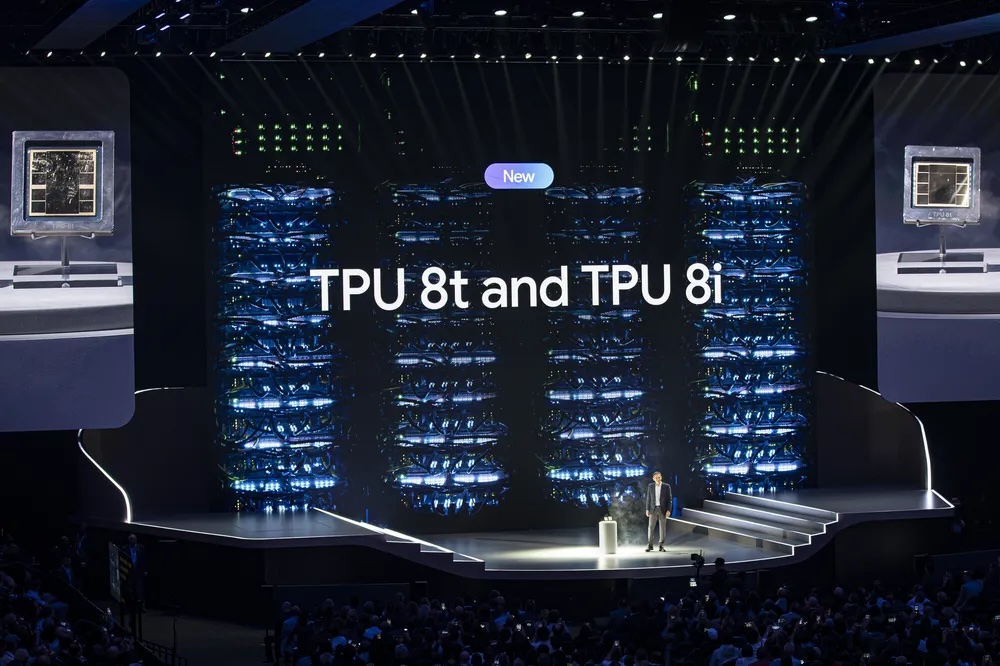
Al Google Cloud Next, Google ha annunciato i suoi acceleratori AI di nuova generazione: il TPU 8t "Sunfish" per l'addestramento e il TPU 8i "Zebrafish" per l'inferenza, insieme alla sua nuova infrastruttura per data center Virgo. Dai post sul blog di Google, è chiaro che questi chip sono ottimizzati per "l'era agentica": addestrare modelli di frontiera basati su un mix di esperti su una scala di centinaia di migliaia di chip e poi distribuire gli stessi modelli con bassa latenza e obiettivi di prezzo per token ambiziosi. L'8t e l'8i sono due chip architettonicamente distinti che condividono una piattaforma host e un'infrastruttura, ma differiscono per capacità di memoria, SRAM on-chip, topologia di interconnessione e specializzazione on-die. L'8t è progettato per la moltiplicazione di matrici dense (matmul) su larga scala, mentre l'8i è basato sulla cache KV on-silicio e sulla latenza collettiva per token.
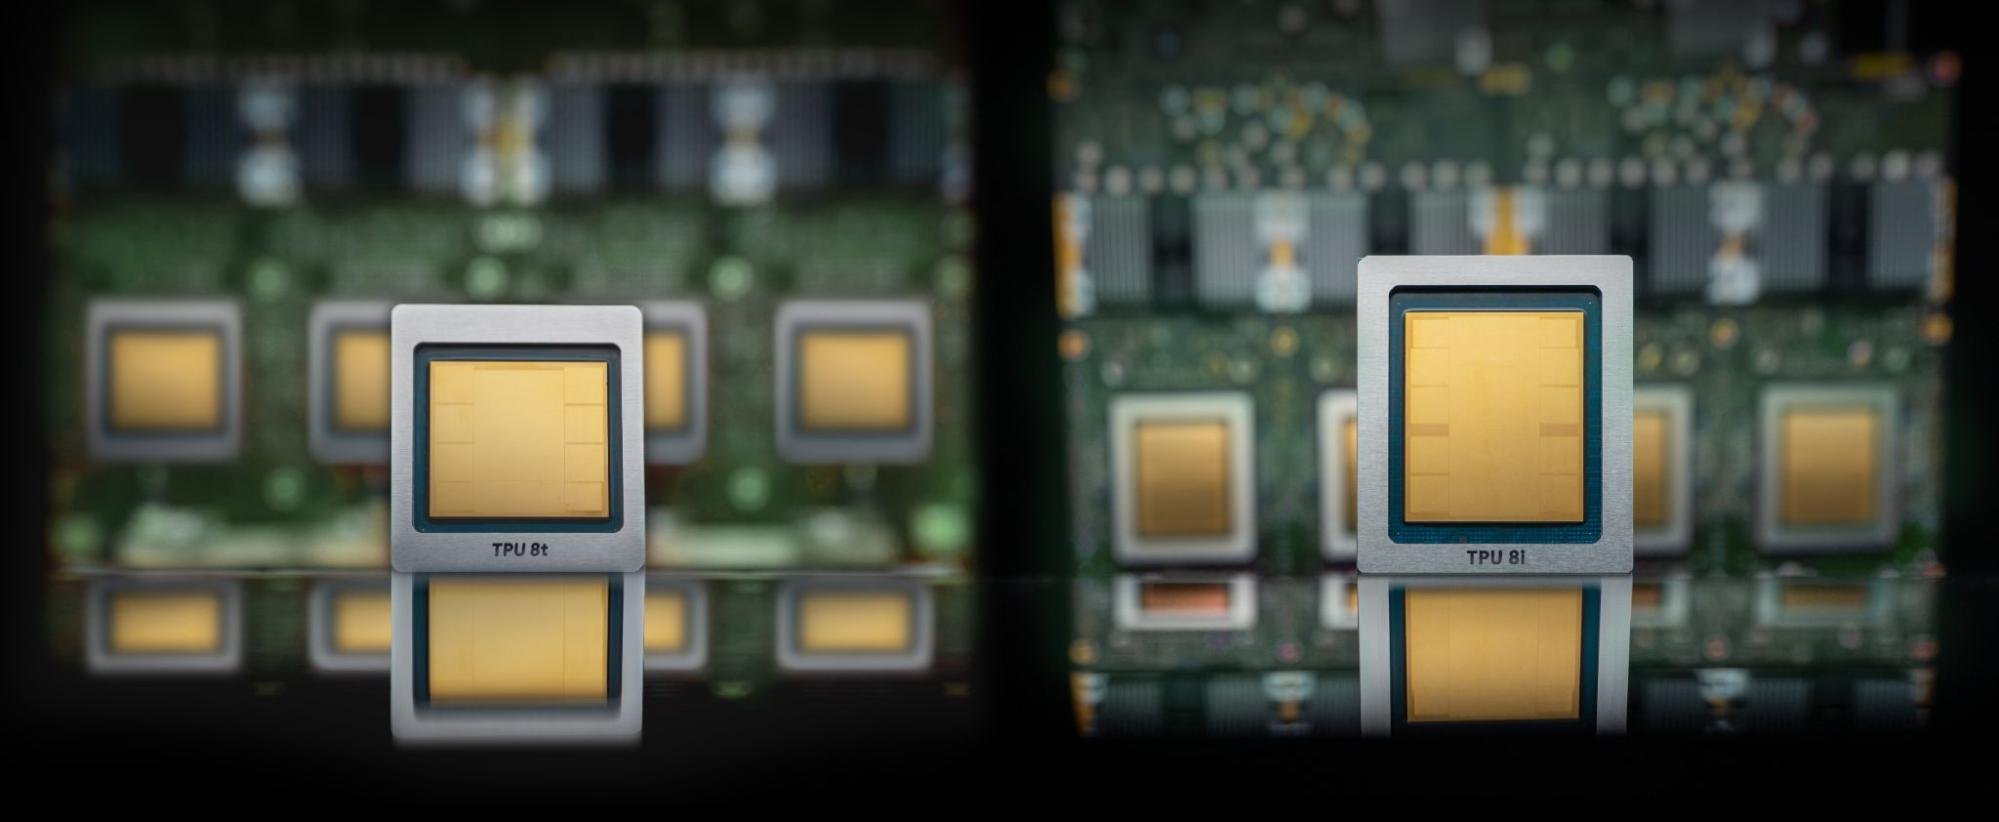
Un singolo superpod 8t può ospitare fino a 9,600 chip, contiene 2 PB di HBM e offre 121 EFLOPS di calcolo FP4, quasi il triplo della potenza di calcolo per pod di un superpod Ironwood. 8i combina 288 GB di HBM con 384 MB di SRAM on-chip (3 volte Ironwood) all'interno di un dominio di scalabilità a 1,152 chip e vanta prestazioni per dollaro superiori dell'80% rispetto a Ironwood per l'inferenza LLM. Virgo unisce entrambe le famiglie di chip in un'unica infrastruttura per data center che collega oltre 134,000 chip 8t a una larghezza di banda di bisezione non bloccante di 47 Pb/s, con una larghezza di banda per acceleratore fino a 4 volte superiore e una latenza a vuoto inferiore del 40% rispetto alla generazione precedente.
Cos'è realmente una TPU
Prima di addentrarci negli 8 componenti in silicio, è opportuno chiarire cosa sia una TPU e in cosa si differenzi da una GPU, poiché le 8 decisioni di progettazione hanno senso solo in questo contesto.
Una Tensor Processing Unit (TPU) è un ASIC personalizzato che Google ha sviluppato a partire dal 2015. Ogni generazione è stata costruita attorno alla stessa idea di base: invece di pianificare dinamicamente migliaia di piccoli core, come fa una GPU, una TPU si concentra su un numero ridotto di MXU (unità di moltiplicazione di matrici) molto grandi, alimentate da una memoria SRAM on-chip gestita via software e pilotate da un compilatore ahead-of-time. Ogni chip contiene una manciata di TensorCore, ciascuno basato su una grande MXU per array sistolici, più un set più piccolo di SparseCore dedicati alle ricerche irregolari di tipo gather-scatter che dominano gli embedding di raccomandazione. I dati fluiscono dall'HBM attraverso la memoria scratchpad, attraverso l'MXU, tornano alla memoria scratchpad e ne escono di nuovo, con una Vector Processing Unit che gestisce le attivazioni, le normalizzazioni e le riduzioni. Non è presente alcuno scheduler warp hardware, nessuna gerarchia di cache L1 o L2 nel senso delle GPU e nessun dispatch dinamico.
Il vantaggio di questa architettura risiede nell'efficienza dell'algebra lineare densa. Grazie a un compilatore ahead-of-time che decide la posizione di ogni tensore e il momento in cui ogni operazione collettiva viene eseguita, non si verificano fluttuazioni dovute a cache miss né penalizzazioni dovute allo scheduler warp, un aspetto più importante di quanto si possa pensare quando decine di migliaia di chip devono rimanere sincronizzati tramite un'operazione collettiva. L'utilizzo delle FLOP nei modelli reali su TPU per carichi di lavoro di training ben ottimizzati tende ad essere superiore rispetto alle GPU tradizionali. Lo svantaggio è che qualsiasi elemento che non si mappi in modo pulito su grandi matrici dense, in particolare forme dinamiche, pattern di sparsità irregolari, routing MoE con distribuzione non uniforme dei token o reti neurali a grafo, risulta più difficile da esprimere in modo efficiente. Le TPU hanno inoltre storicamente supportato meno memoria HBM per chip rispetto alle loro controparti GPU e hanno beneficiato di un supporto framework molto più limitato. XLA e JAX sono di prima classe; PyTorch, fino a poco tempo fa, richiedeva un livello di traduzione; inoltre, il compilatore, il runtime, le librerie di rete e lo stack software multi-pod rimangono closed-source all'interno di Google.
La sparsità è l'esempio più lampante del divario filosofico tra GPU e TPU, e la ragione è di natura strutturale piuttosto che di marketing. NVIDIA supporta la sparsità strutturata 2:4 sui Tensor Core sin da Ampere e, sulla carta, le prestazioni per i carichi di lavoro sparsi sono il doppio di quelle per i carichi di lavoro densi. Un Tensor Core è fondamentalmente un'unità di dispatch: esegue caricamenti espliciti degli operandi per ogni istruzione MMA, quindi l'aggiunta di una variante MMA sparsa che accetta un blocco compresso 2 su 4 più i metadati dell'indice è una semplice estensione del set di istruzioni esistente. Ad ogni ciclo, l'hardware preleva solo i valori diversi da zero e i relativi indici nell'array del moltiplicatore, saltando implicitamente gli zeri.
Un array sistolico funziona in modo opposto. Ogni PE (elemento di elaborazione) esegue un calcolo a ogni ciclo, con gli operandi che scorrono attraverso l'array in modo sincronizzato tramite percorsi diretti da registro a registro, da un PE all'altro. Questo flusso di dati deterministico è proprio ciò che conferisce il vantaggio in termini di efficienza energetica rispetto al SIMT: nessuna lettura ripetuta della SRAM, nessun overhead di invio delle istruzioni, massimo riutilizzo degli operandi. Tuttavia, ciò significa anche che l'hardware non può saltare un elemento con valore zero per ciclo senza interrompere la pipeline.

Fonte: Google
Le TPU possono ancora sfruttare la sparsità a livello di tile; se un intero tile delle dimensioni di un MXU è composto interamente da zeri, il compilatore non pianifica l'esecuzione su di esso. Tuttavia, la scelta di Google di non aggiungere l'accelerazione hardware per la sparsità strutturata è deliberata. L'aggiunta di sparsità strutturata M:N a un array sistolico può essere ottenuta utilizzando diverse tecniche, ognuna con compromessi differenti. Una di queste tecniche richiede un'unità di compressione posizionata tra la SRAM e le porte di input dell'array. Ma un array sistolico è una pipeline, non un dispatcher. La sua garanzia di efficienza deriva dall'arrivo degli operandi con una cadenza deterministica, con ogni elemento di elaborazione occupato ad ogni ciclo. Consentire l'omissione degli operandi comporta uno di questi due costi: bloccare la pipeline sugli zeri, annullando il vantaggio di efficienza che ha motivato l'architettura in primo luogo; oppure aggiungere hardware di decompressione dedicato per ricostruire un flusso a larghezza intera dall'input compresso prima che entri nell'array, il che consumerebbe area del die e aggiungerebbe latenza.
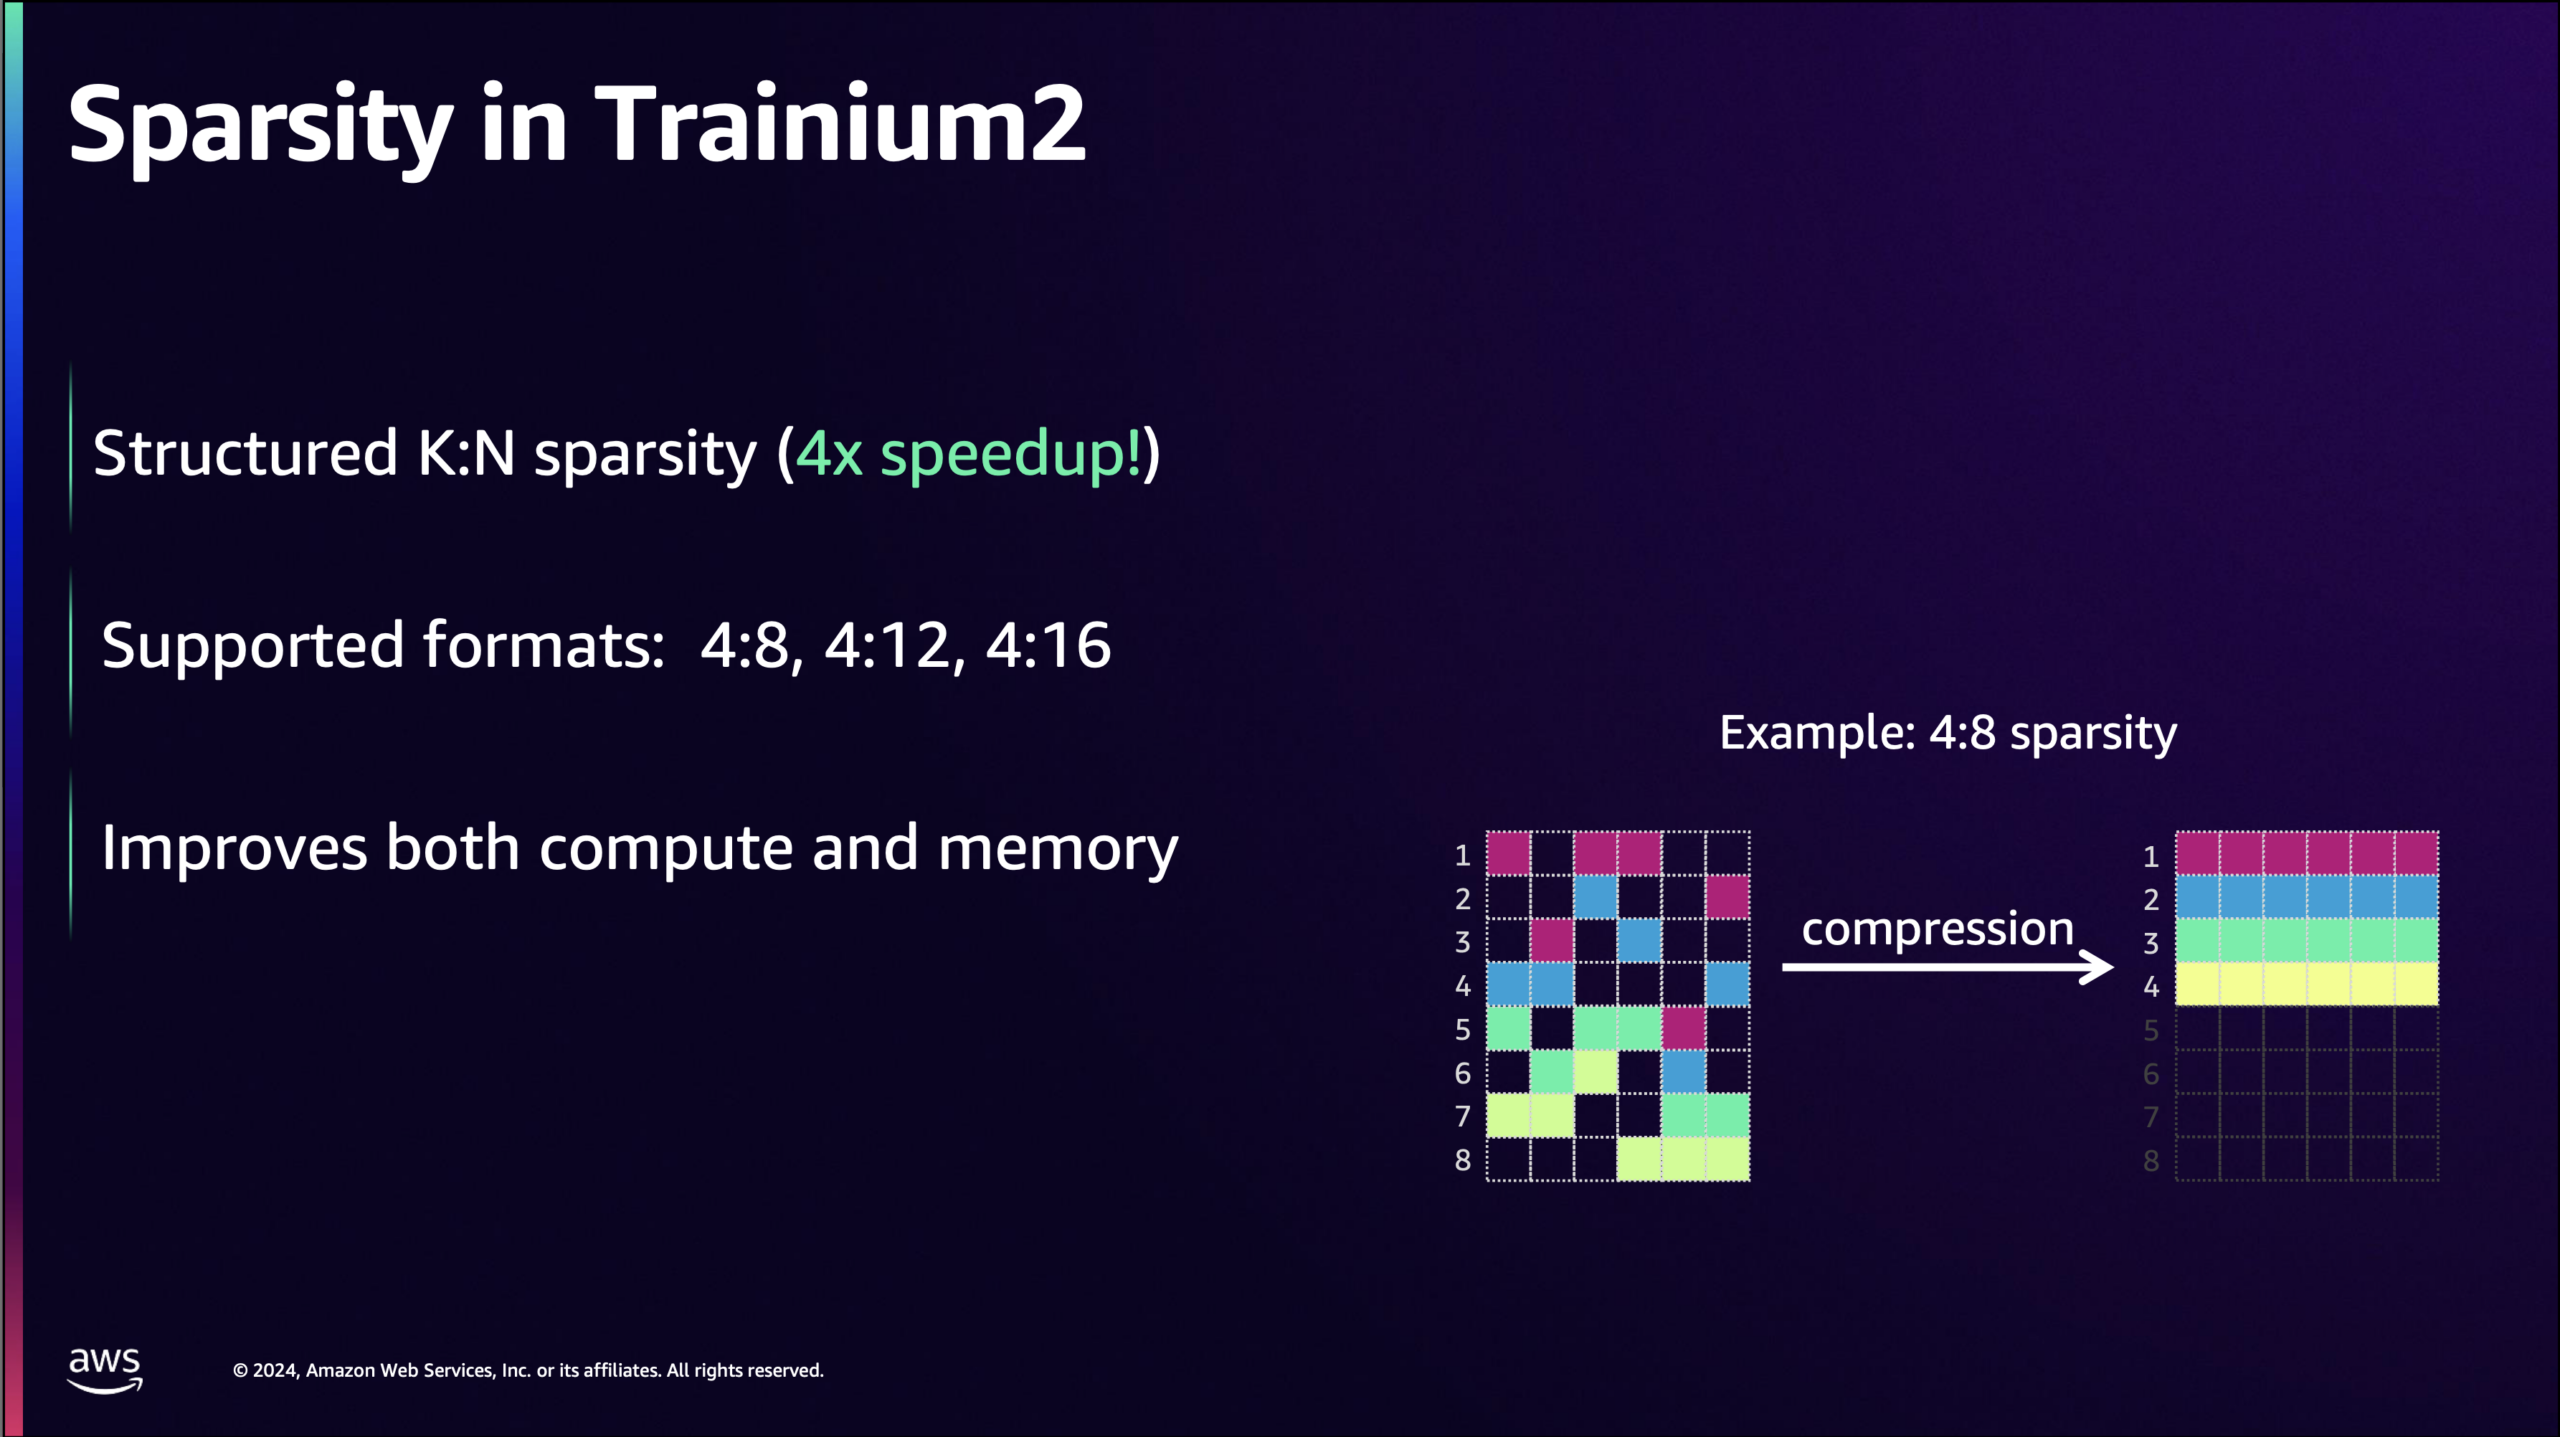
Fonte: AWS
Alcuni acceleratori combinano array sistolici con supporto hardware per la sparsità. AWS ne ha creato uno a partire da NeuronCore-v3, il motore presente in Trainium2 e Trainium3. L'implementazione mostra come si presenta un array sistolico con supporto hardware sparso. Il Tensor Engine di NeuronCore-v3 è un array sistolico 128×128 che opera su una matrice di pesi stazionaria e una matrice di attivazione in streaming, con la dimensione di contrazione allineata alla dimensione di partizione dell'array. In modalità sparsa, il percorso dati di input si allarga da 2×128 elementi per ciclo su BF16 e FP16 densi a 5×128 elementi per ciclo, e il lato stazionario si alimenta da una rappresentazione compressa della matrice dei pesi anziché dai pesi densi originali. In fase di compilazione, il tensore dei pesi viene elaborato in un formato M:N. Di ogni N elementi contigui lungo la dimensione di contrazione, ne vengono mantenuti solo M, con una maschera di bit compatta che codifica quali posizioni sono diverse da zero. Il buffer compresso memorizza solo gli M valori, riducendosi di un fattore N/M. Quando viene eseguita l'istruzione matmul, l'hardware legge i pesi compressi e utilizza la maschera di bit per instradare le attivazioni corrispondenti dal blocco stazionario agli elementi di elaborazione corretti. I PE che sarebbero stati moltiplicati per zero non ricevono lavoro per quello slot. Poiché la ricerca della maschera di bit e l'instradamento risiedono nel decompressore che alimenta l'array anziché nell'array stesso, la pipeline continua a funzionare alla massima velocità di elaborazione sui valori diversi da zero, invece di bloccarsi sugli zeri.
La moltiplicazione di matrici dense non è l'unica funzione di una TPU. Da diverse generazioni, le TPU includono uno SparseCore insieme ai TensorCore. Lo SparseCore è un motore specifico per il dominio, progettato per i modelli di accesso irregolari di tipo "gather-scatter" che caratterizzano i modelli di raccomandazione. Un modello di ranking di YouTube o un modello di pertinenza degli annunci di ricerca non assomigliano a un trasformatore denso. La maggior parte dei suoi parametri risiede in tabelle di embedding che possono variare da centinaia di gigabyte a petabyte, e la maggior parte del tempo di calcolo viene impiegata per eseguire piccole ricerche in queste tabelle, trasformare leggermente i valori recuperati e combinare i risultati. Questo modello di accesso rappresenta il caso peggiore per un MXU e solo marginalmente migliore per la gerarchia di cache di una GPU. Gli SparseCore sono ottimizzati proprio per questo: operazioni di "gather-scatter" ad alta velocità su tabelle di embedding residenti nell'HBM, con supporto hardware per le operazioni di deduplicazione e combinazione da cui dipende il resto della pipeline di embedding. Lo stesso hardware contribuisce anche al routing esperto di MoE perché, una volta che la selezione top-k produce gli indici esperti, il resto del processo di routing (permutazione dei token per esperto, distribuzione tra i chip, raccolta degli output esperti ed esecuzione della riduzione ponderata) segue lo stesso schema di raccolta/dispersione/riduzione della pipeline di embedding, con il supporto di ordinamento di SparseCore che copre la fase top-k stessa.
Alla luce di quanto detto, ecco gli annunci.
TPU 8t “Sunfish”
Il primo annuncio, TPU 8t nome in codice Sunfish, riguarda il chip di training. Il passo generazionale di Ironwood segue la traiettoria prevista sotto molti aspetti: più memoria, maggiore larghezza di banda, supporto nativo per tipi di dati più specifici. Ogni chip integra un singolo TensorCore alimentato da sei stack HBM3e 12-Hi per un totale di 216 GB a 6.5 TB/s, rispetto ai 192 GB distribuiti su otto stack di Ironwood. La SRAM Vmem on-chip rimane a 128 MB.
Gran parte del salto di potenza di calcolo deriva dall'utilizzo nativo di FP4 nell'MXU. L'esecuzione di moltiplicazioni tra matrici a 4 bit anziché a 8 bit raddoppia la velocità di elaborazione per ciclo a parità di array fisico, ed è così che Google è passata dai 4.6 PFLOPS FP8 di Ironwood ai 12.6 PFLOPS FP4 di 8t. L'addestramento a precisione mista mantiene comunque una copia master FP32 dei pesi per la fase di ottimizzazione; FP4 riduce le dimensioni dei tensori di lavoro che consumano la maggior parte del tempo di calcolo.
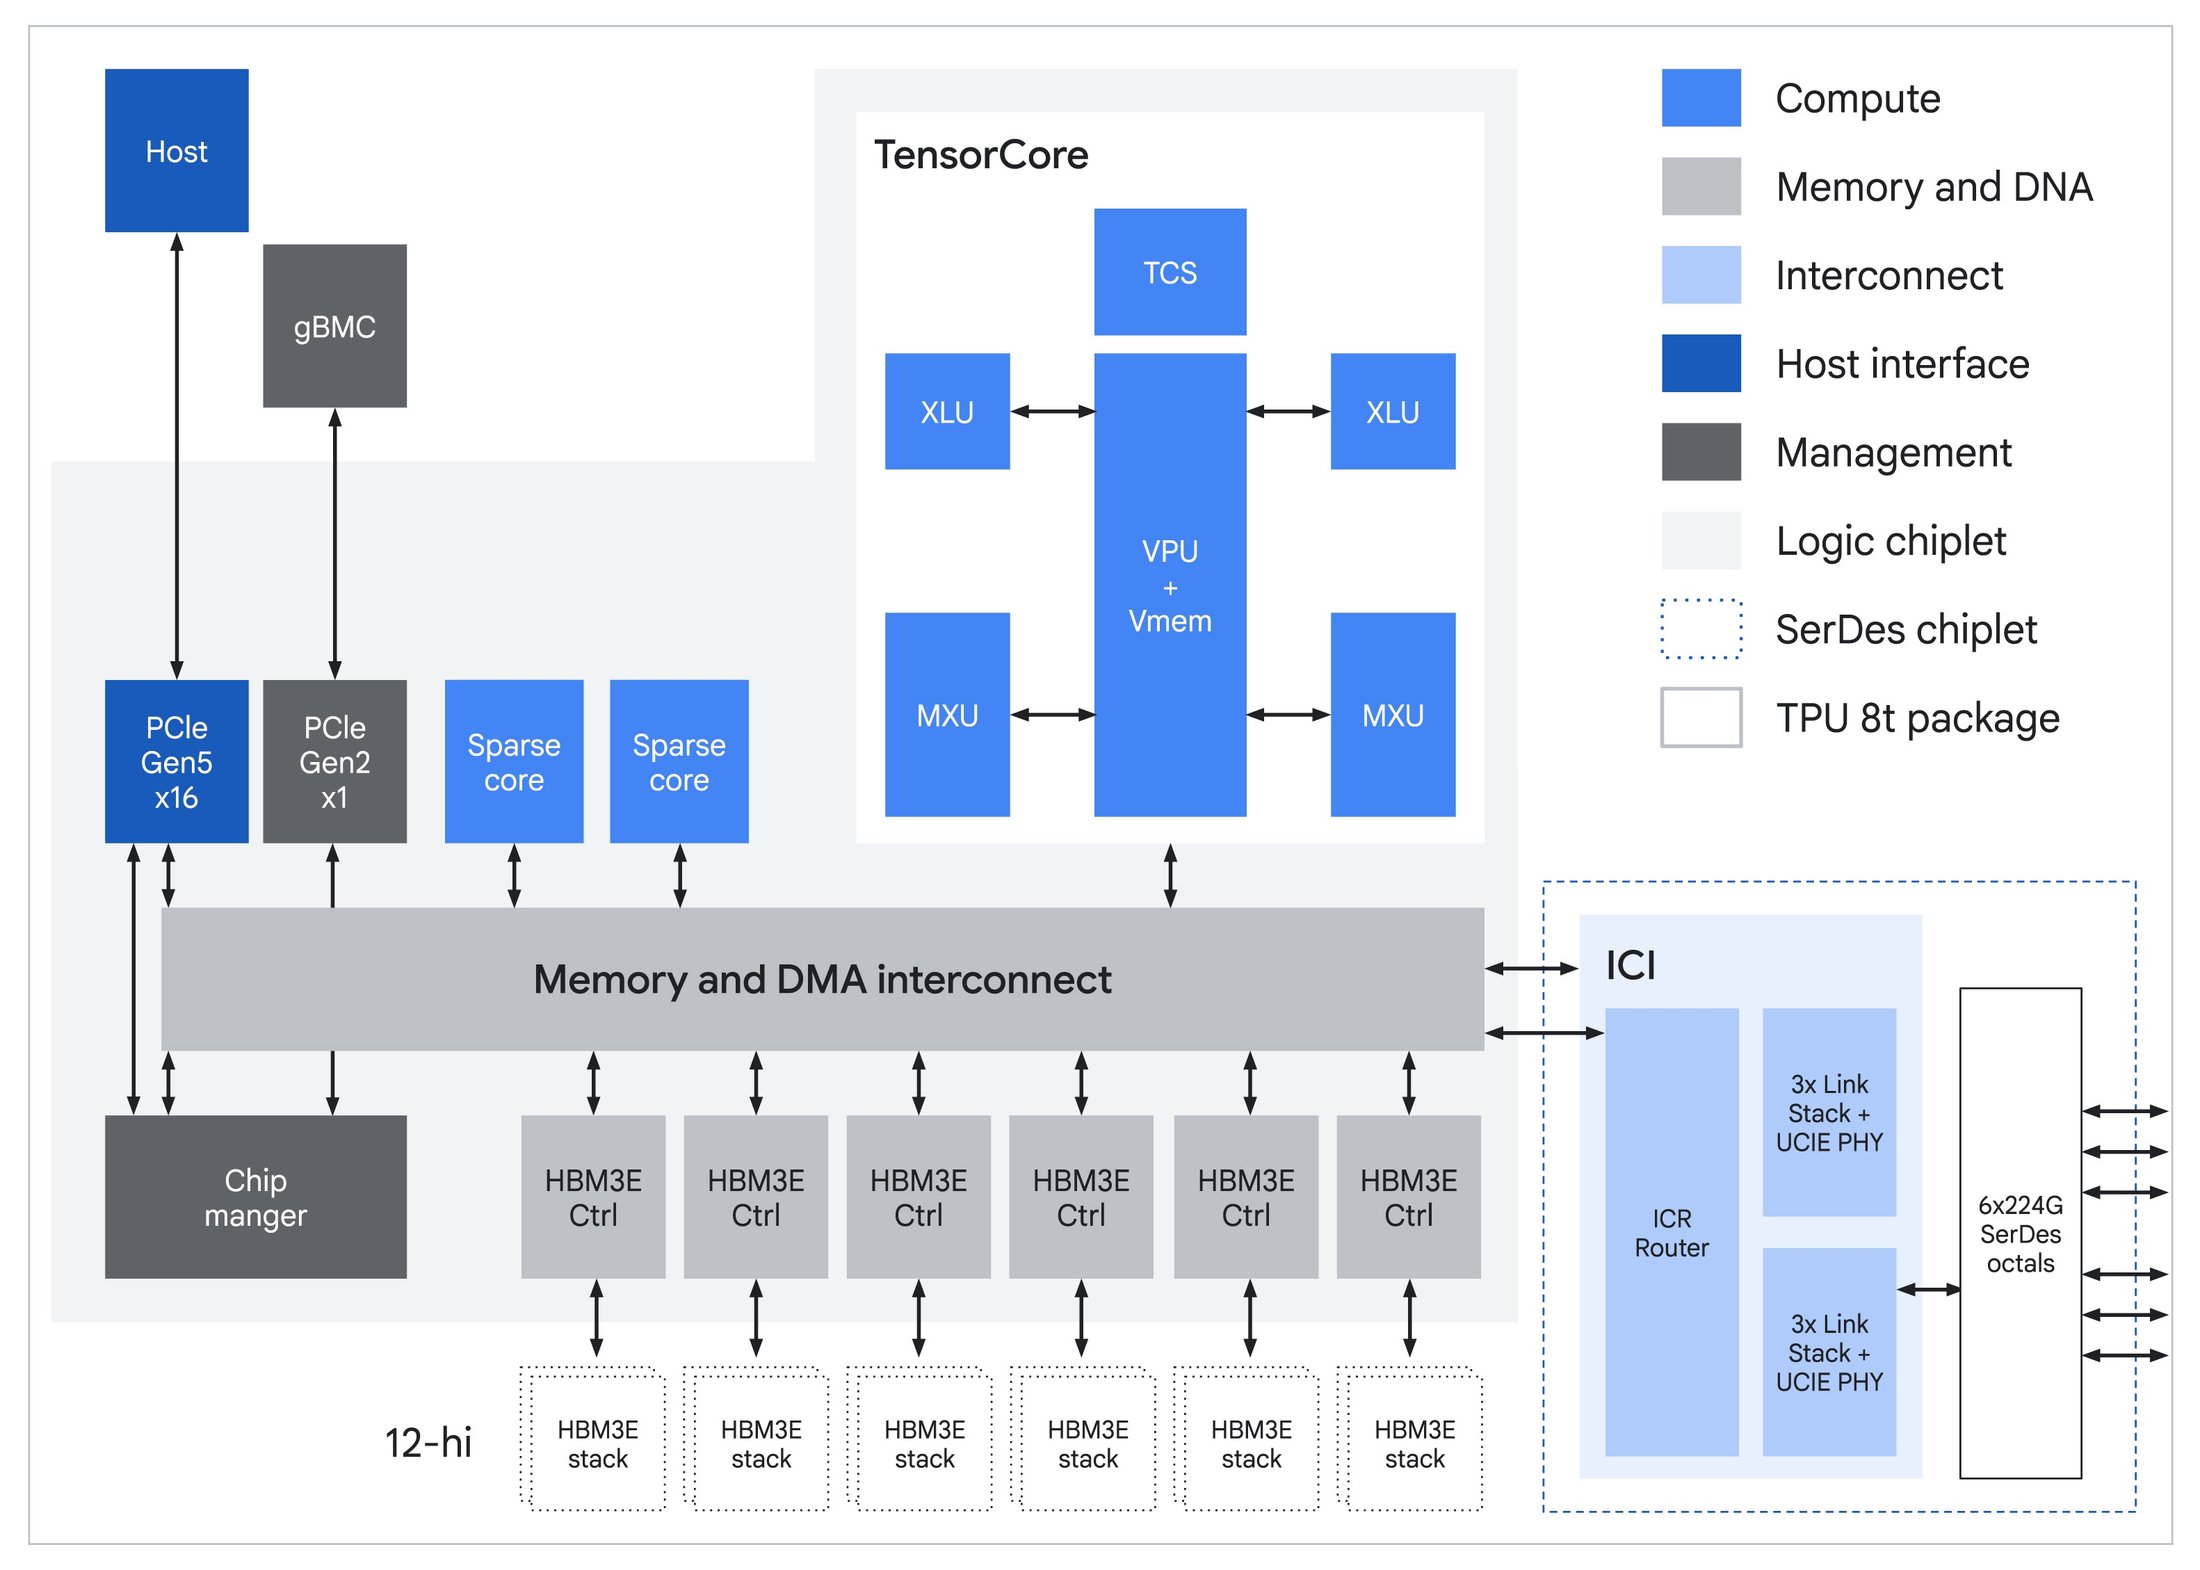
Fonte: Google
La storia dell'interconnessione è semplice. La larghezza di banda ICI raddoppia a 19.2 Tb/s per chip, il superpod da 9,600 chip aggrega 2 PB di HBM e 121 EFLOPS e la topologia toroidale 3D viene mantenuta. Il toro ha senso per l'addestramento perché i job di frontiera sono dominati da collettivi adatti all'anello: all-reduce per il parallelismo di dati e tensori, all-gather e reduce-scatter per FSDP e invii point-to-point paralleli alla pipeline. Tutti questi si mappano in modo pulito sugli assi del toro.
Google conserva anche gli SparseCore, presenti su ogni TPU a partire dalla versione 4. Il loro scopo originario era quello di supportare modelli di raccomandazione in stile DLRM, dove la maggior parte del tempo di calcolo è impiegata per operazioni di gather-scatter irregolari su enormi tabelle di embedding. Lo stesso hardware gestisce anche il routing MoE. JAX espone operazioni di prima classe come la comunicazione "ragged all-to-all" e la corrispondente operazione "ragged_dot", in cui ogni chip può inviare un blocco di dimensioni diverse a ciascun peer. Questo rispecchia la struttura effettiva del dispatch MoE, poiché il routing top-k è dipendente dai dati e il numero di token che fluiscono verso ciascun esperto varia a ogni passaggio. Il compilatore fonde la comunicazione irregolare e la moltiplicazione matriciale irregolare degli esperti in un'unica operazione pianificata, mentre SparseCore gestisce l'ordinamento e la permutazione circostanti. Con l'architettura "mixing-of-experts" ormai dominante nei modelli di frontiera, questo hardware dimostra il suo valore in ogni moderno processo di training, non solo nei carichi di lavoro di annunci e ranking per cui era stato originariamente progettato.
Si tratta di passi evolutivi. I cambiamenti più significativi sono TPUDirect e il passaggio a host basati su Axion, entrambi volti a risolvere i colli di bottiglia che diventano evidenti solo su scala di frontiera.
Archiviazione TPUDirect RDMA e TPUDirect
Le precedenti generazioni di TPU utilizzavano un percorso mediato dall'host per l'I/O di rete e di archiviazione: i pacchetti arrivavano prima nella DRAM dell'host, quindi un DMA separato li copiava nell'HBM della TPU. Ciò comportava due transazioni di memoria con la CPU dell'host coinvolta. TPUDirect RDMA elimina il buffer di rimbalzo. La scheda di rete legge e scrive direttamente nell'HBM della TPU tramite PCIe peer-to-peer, rimuovendo l'host dal percorso dati. NVIDIA offre da anni una funzionalità equivalente con GPUDirect RDMA, dichiarando un miglioramento di circa 10 volte rispetto al percorso mediato dall'host. Ora Google sta replicando questo risultato sul lato TPU.
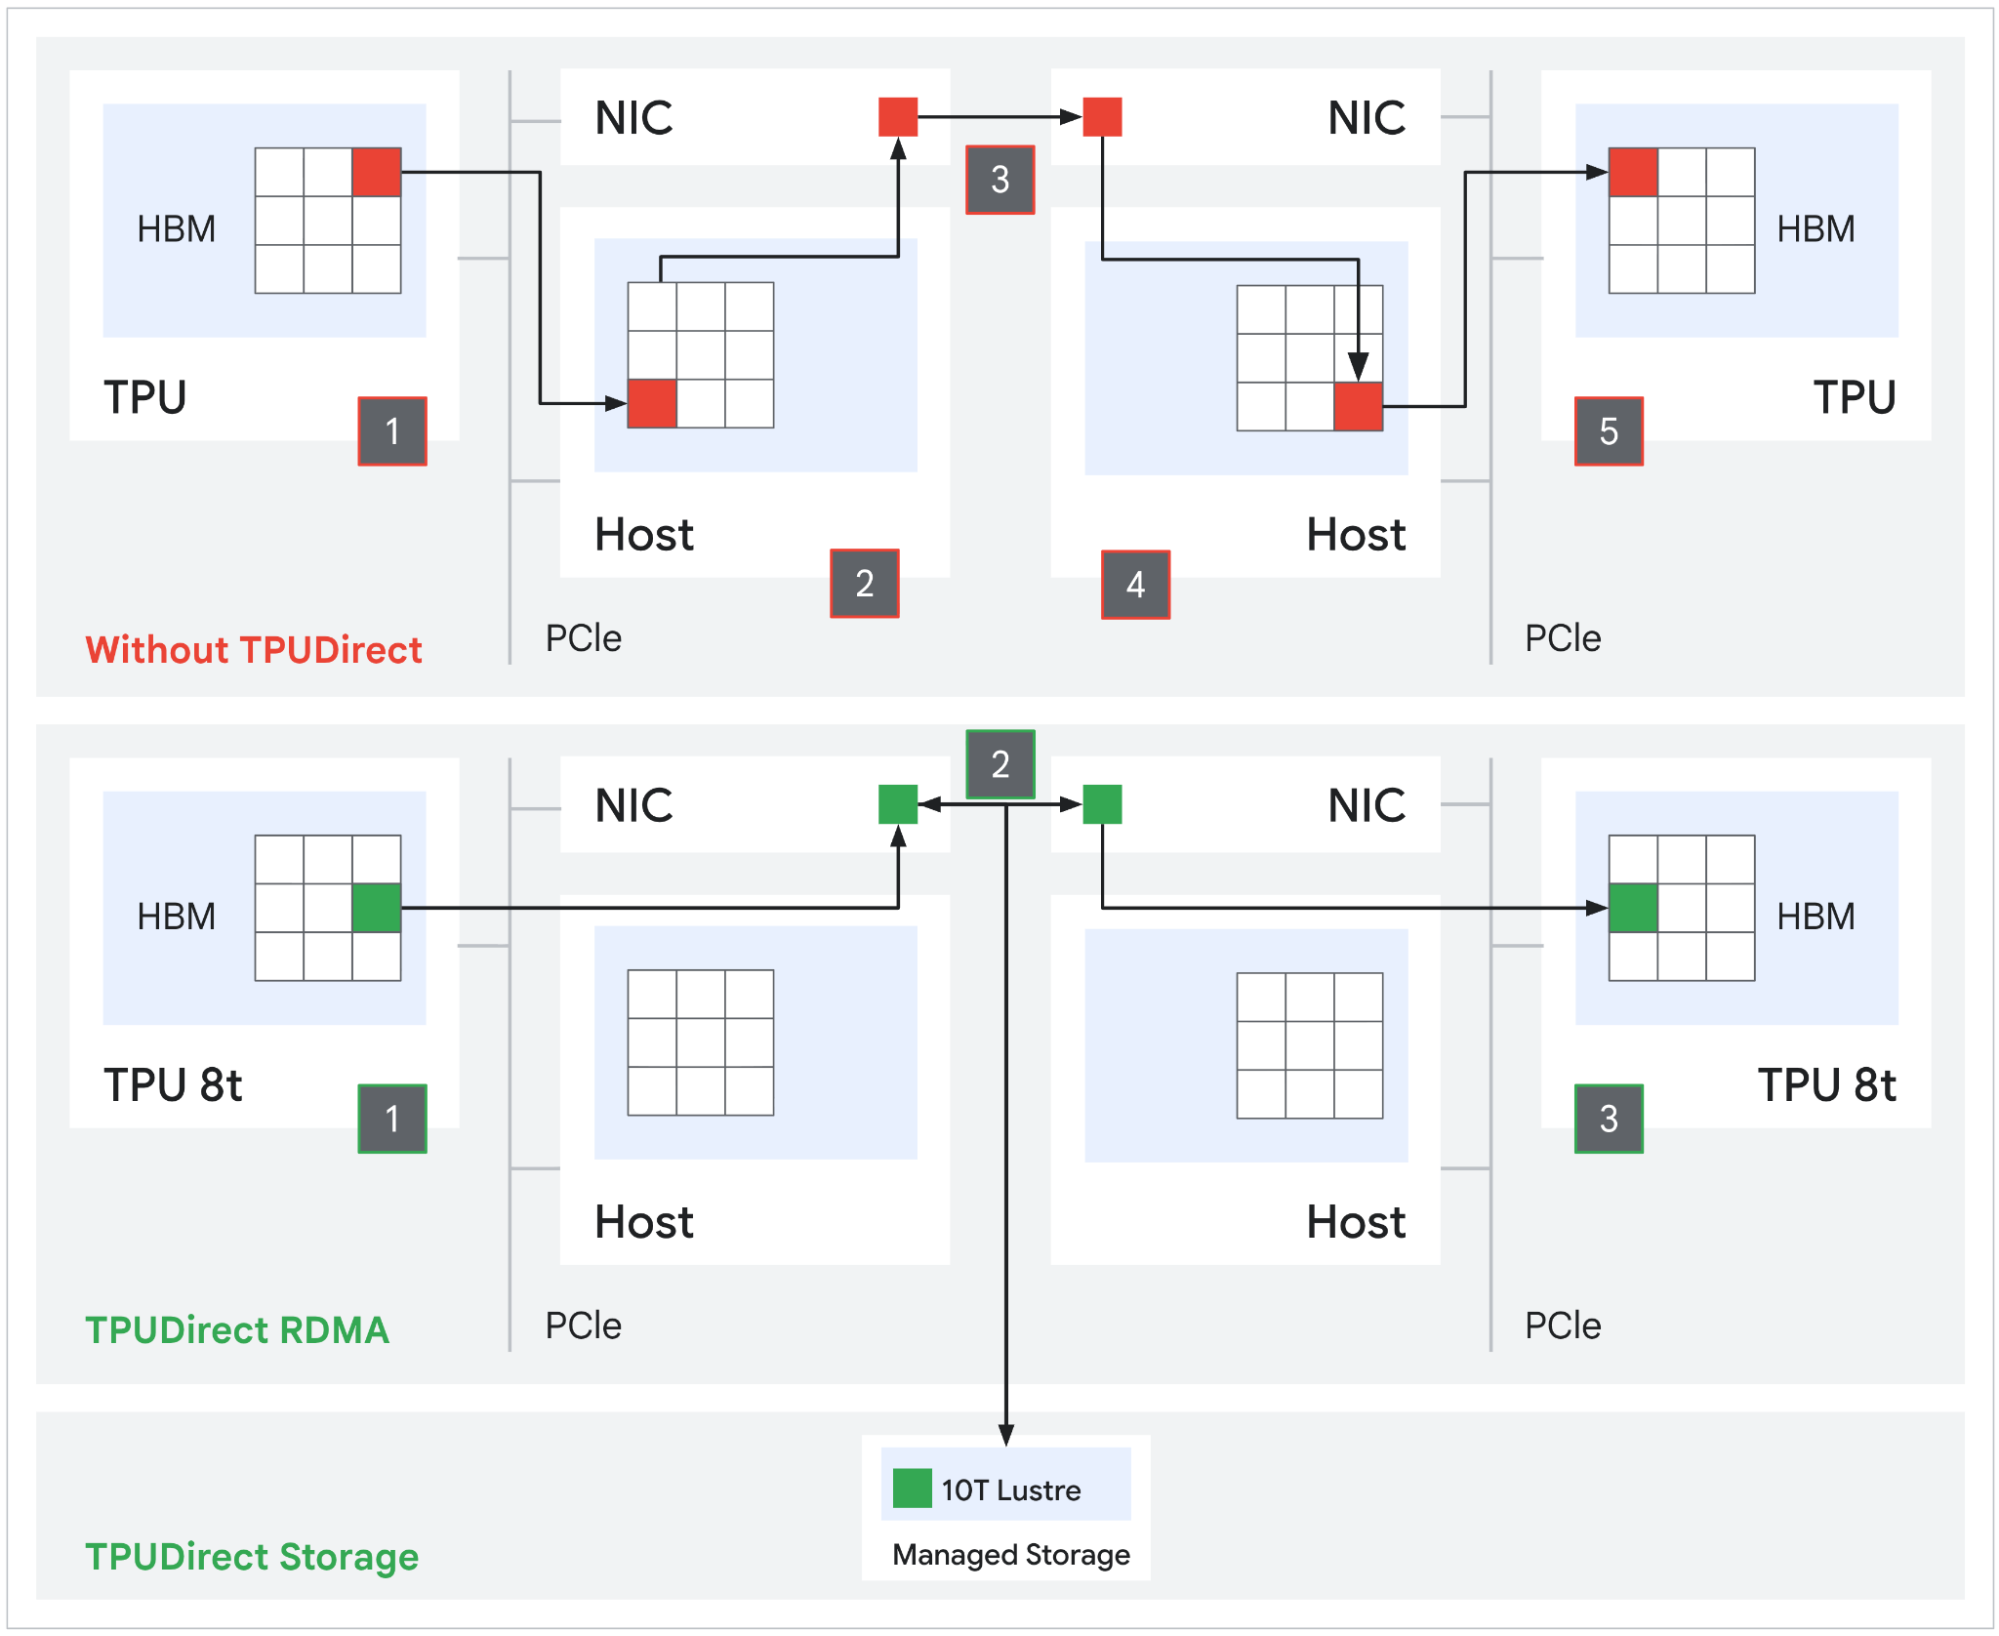
Fonte: Google
TPUDirect Storage estende lo stesso principio all'archiviazione persistente. I tensori si spostano direttamente tra TPU HBM e Managed Lustre a una velocità aggregata di 10 TB/s, che secondo Google offre un accesso all'archiviazione 10 volte più veloce rispetto al percorso equivalente su Ironwood. Su scala di frontiera, dove i checkpoint possono raggiungere centinaia di terabyte, la differenza sta nel fatto che un ciclo di addestramento di più settimane trasmetta in streaming checkpoint e dataset alla velocità di linea o blocchi la pipeline MXU in attesa dell'I/O dell'host.
Arm Axion Hosts
Ogni precedente generazione di TPU veniva eseguita su host x86 di terze parti. 8t è la prima a utilizzare il processore Axion di Google, una CPU basata su Arm Neoverse V2, come header di sistema. Il compito della CPU host su un pod TPU è reale e diventa più difficile con l'aumentare delle dimensioni: gestisce la pipeline di input, decodifica e riorganizza set di dati multi-petabyte, gestisce il piano di controllo JAX/XLA, si occupa della serializzazione dei checkpoint e coordina l'invio di SPMD su migliaia di chip. Se l'host si blocca, l'MXU rimane inattivo.
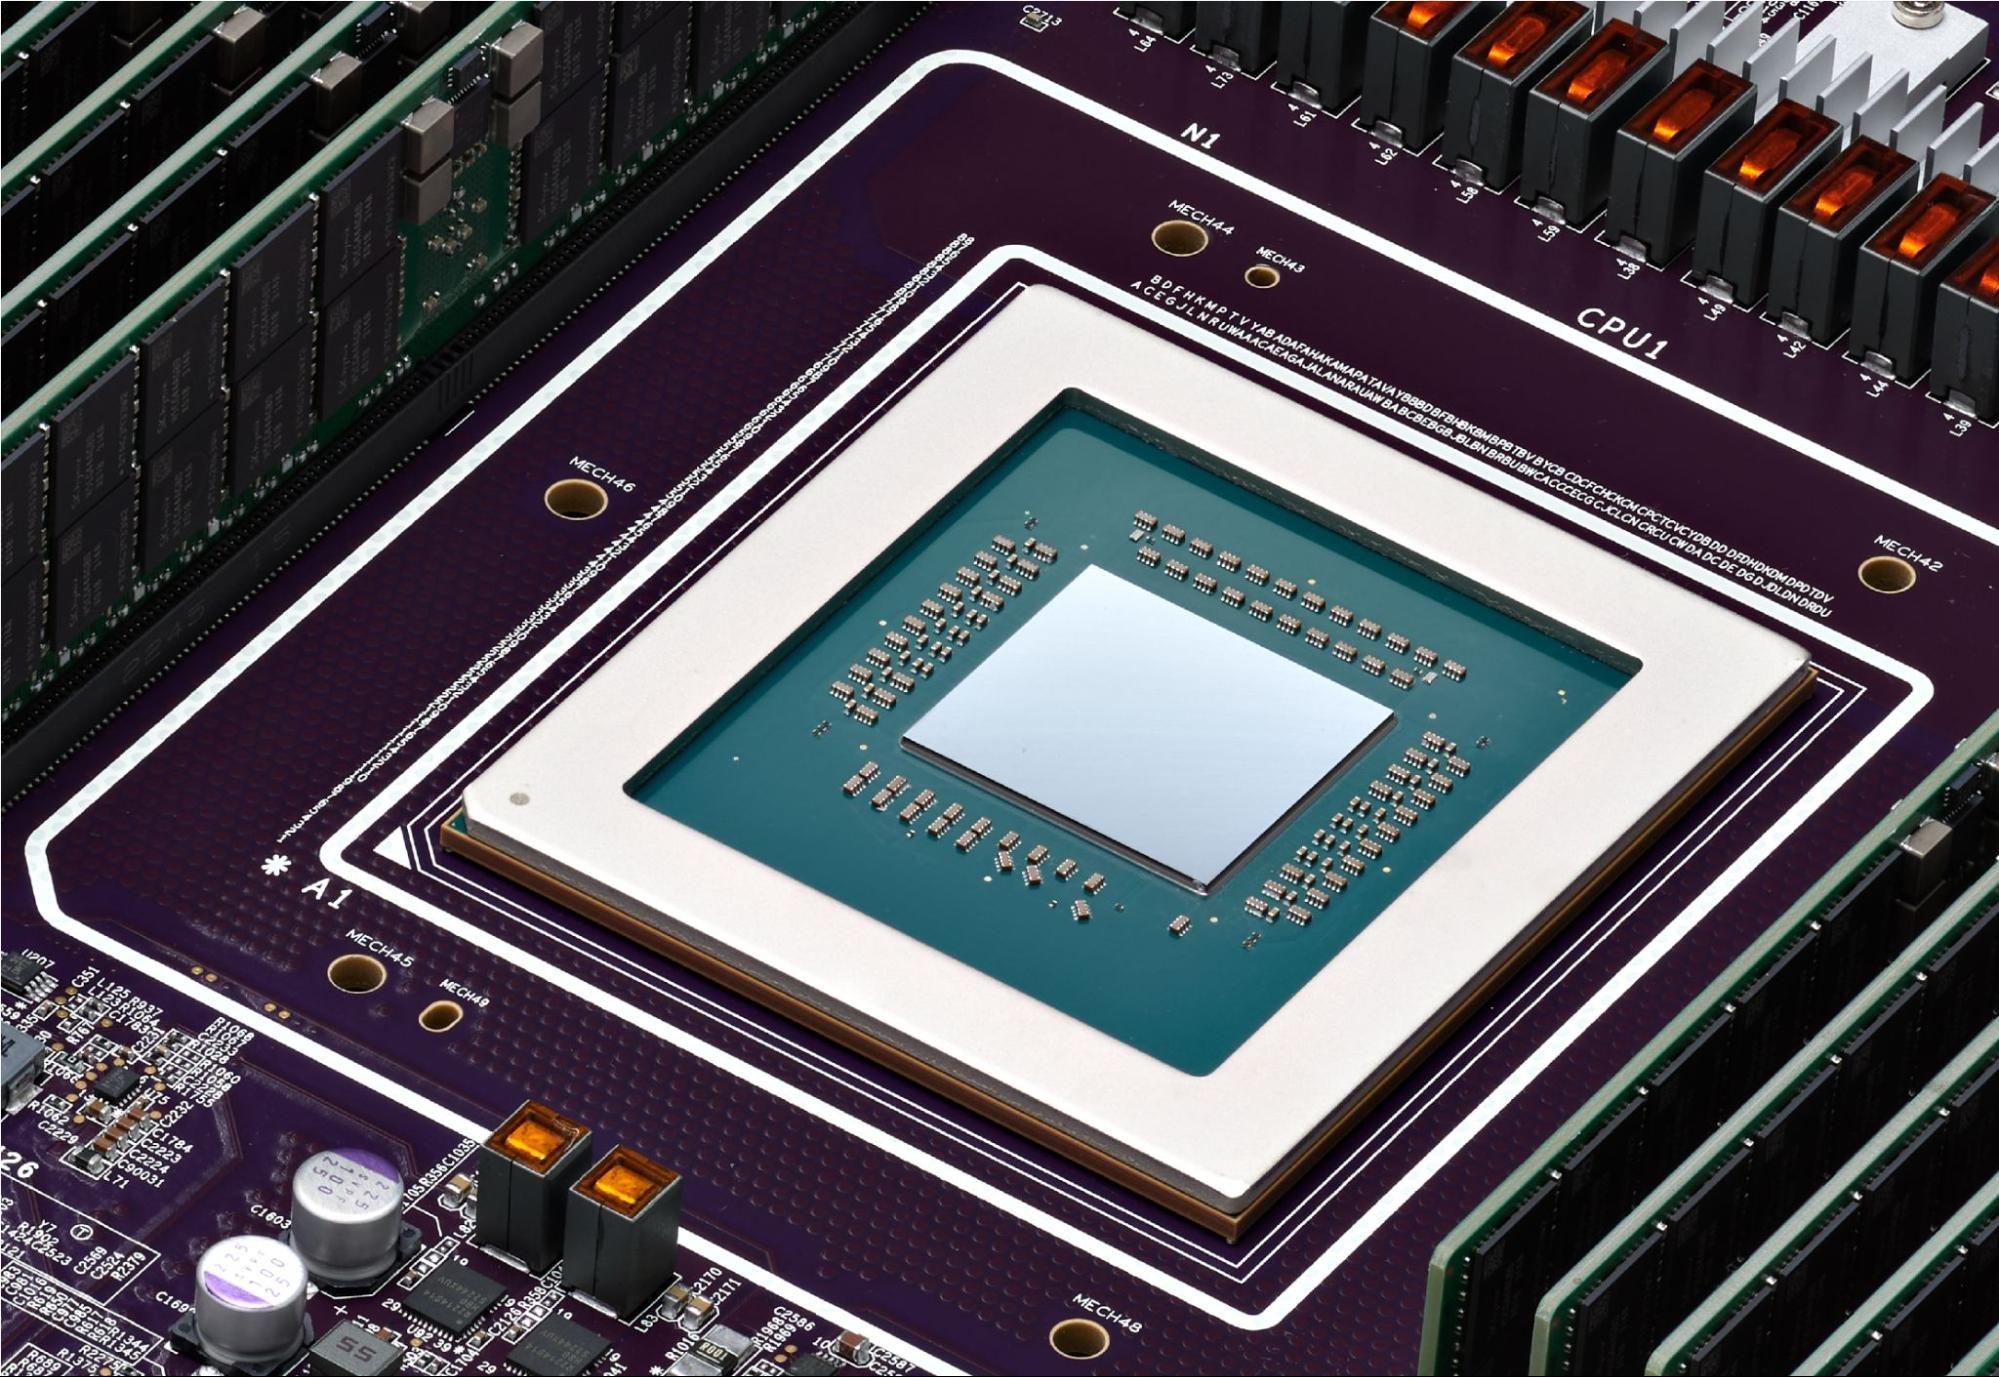
Google indica specificamente l'isolamento NUMA basato su Axion su 8t come il meccanismo che impedisce alle fluttuazioni del lato host di infiltrarsi nelle fasi collettive sincronizzate dell'addestramento. Con 9,600 chip per pod, anche piccoli intoppi per host si sommano, causando una perdita misurabile di prestazioni. TPUDirect gestisce il percorso dati escludendo l'host dai trasferimenti di massa. Axion gestisce il percorso di controllo fornendo a ciascuna TPU una larghezza di banda CPU dedicata sufficiente, in modo che la preelaborazione non diventi mai il collo di bottiglia. Google ha anche aumentato il rapporto tra host Axion fisici e server sulla piattaforma di ottava generazione, offrendo all'overhead di orchestrazione, che scala con il numero di chip, un margine maggiore rispetto alla configurazione host di Ironwood.
TPU 8i “Zebrafish”
Il chip di inferenza condivide con l'8t la piattaforma host Axion, la memoria FP4 nativa e la generazione di memoria HBM3e, ma il silicio sottostante è progettato per affrontare un collo di bottiglia diverso. L'addestramento è limitato dalla potenza di calcolo; la decodifica dell'inferenza è limitata dalla larghezza di banda della memoria. La maggior parte delle differenze architetturali dell'8i derivano da questo.
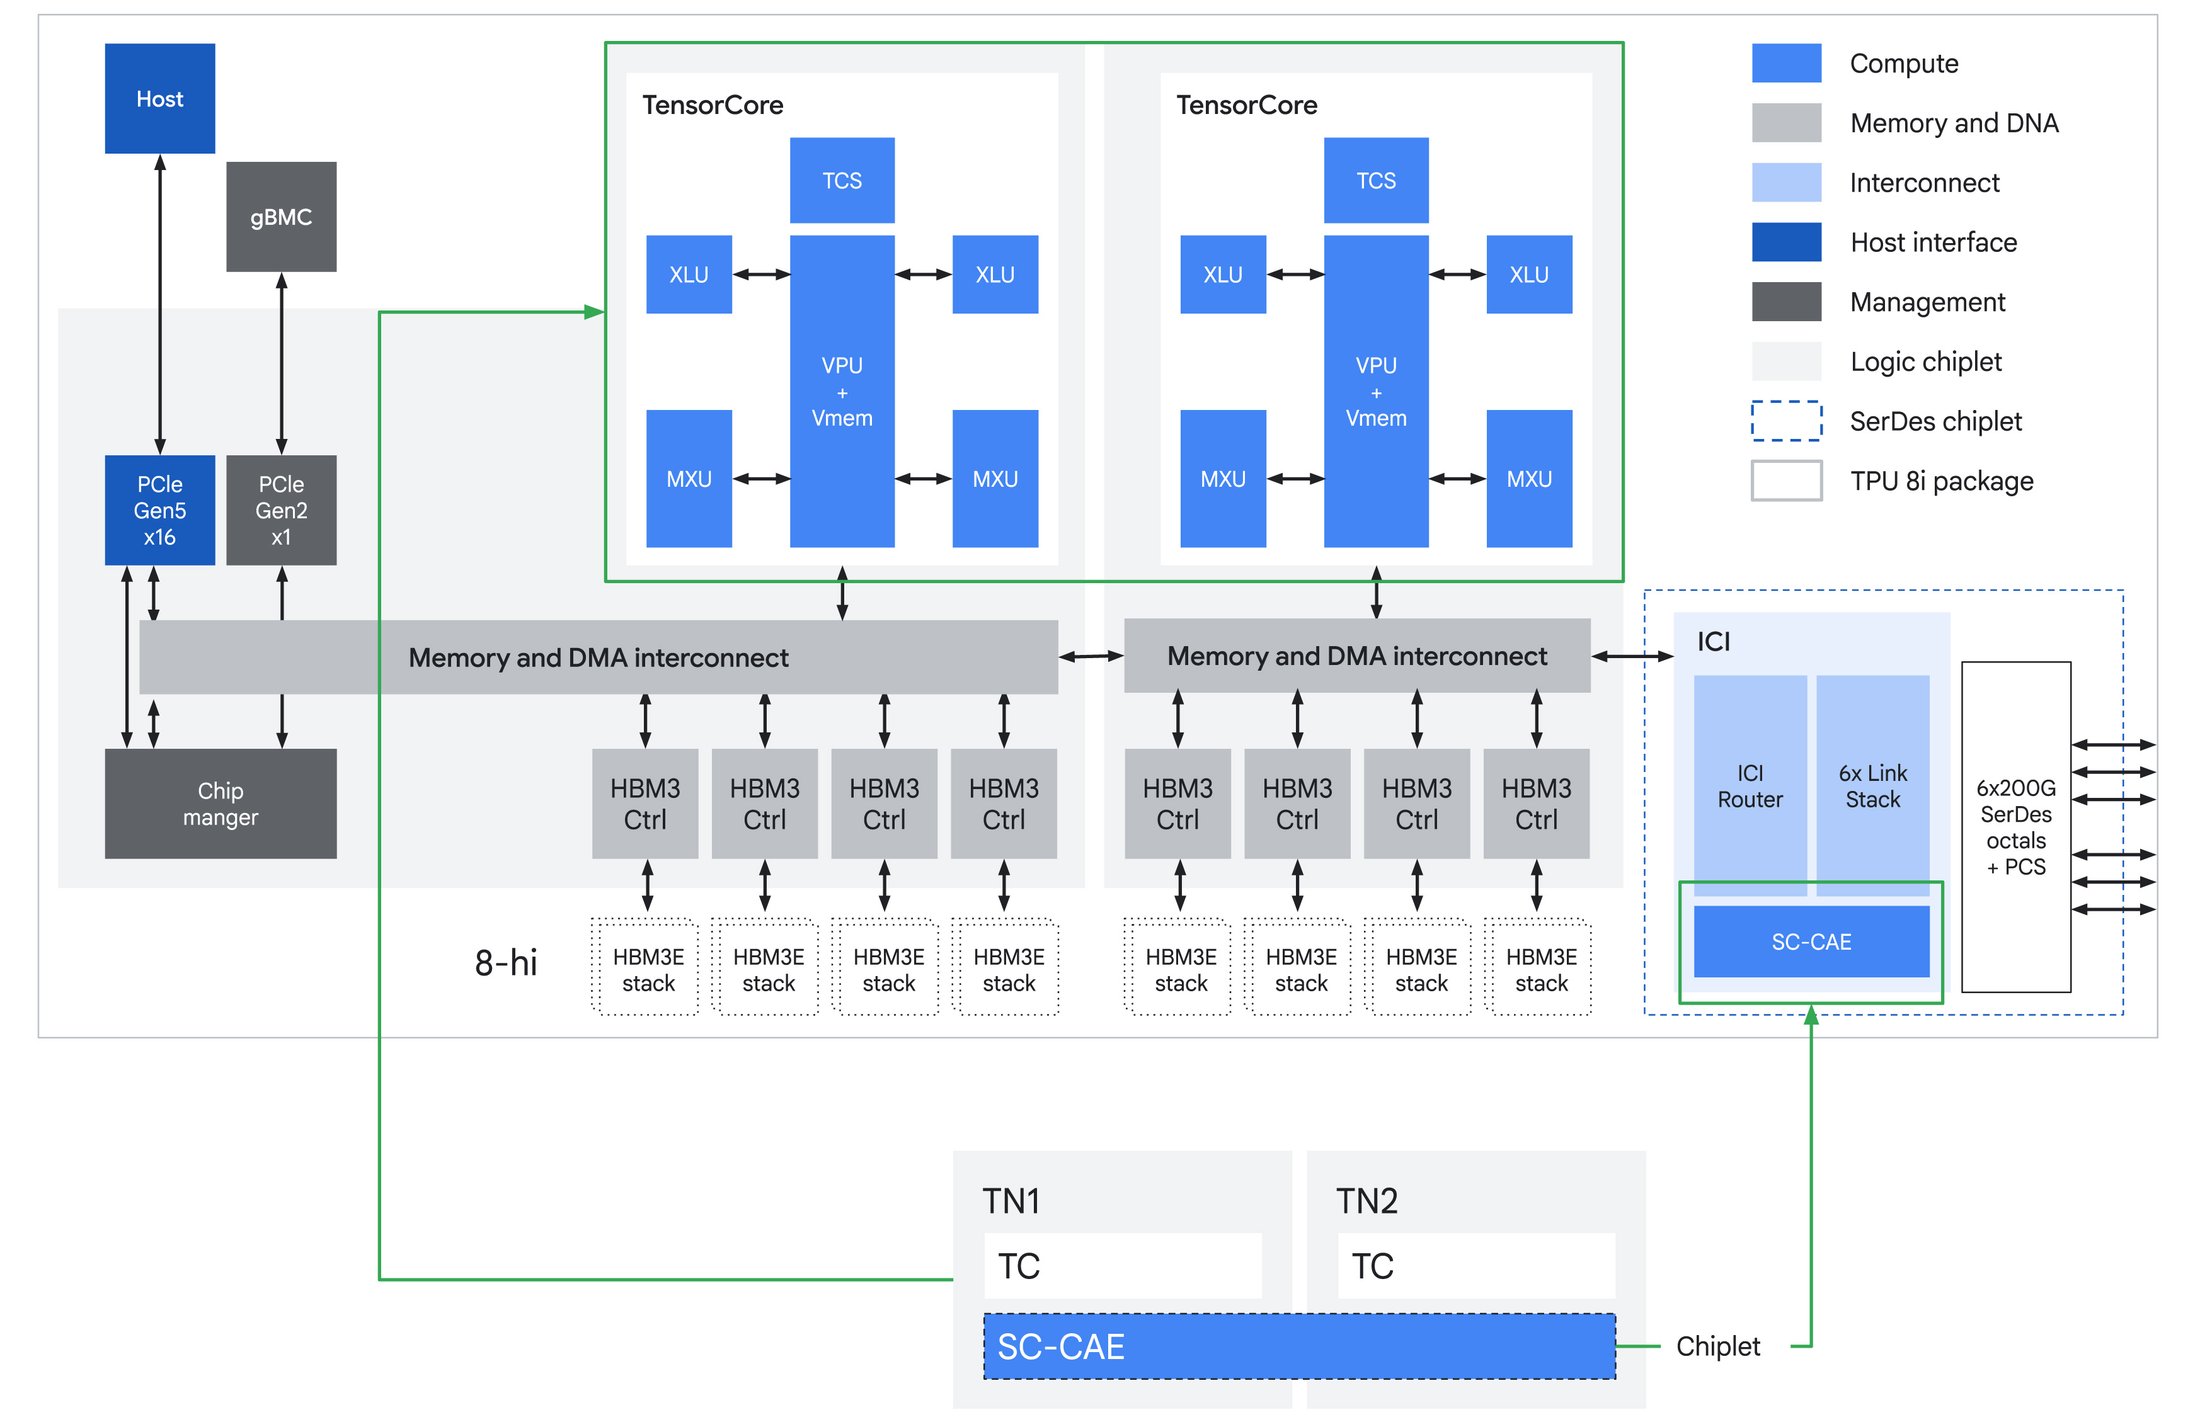
La principale novità riguarda la SRAM integrata. L'8i dispone di 384 MB di Vmem, il triplo rispetto a Ironwood. Questo è importante per via della cache KV. Durante la decodifica a contesto lungo, ogni token generato richiede la lettura degli stati chiave-valore accumulati dai token precedenti. Nella maggior parte degli acceleratori, questa lettura avviene dalla HBM, il che significa che la velocità di decodifica è limitata dalla larghezza di banda della memoria anziché dalla potenza di calcolo. L'8i è dimensionato per ospitare una quantità significativa di cache KV interamente sul silicio. La larghezza di banda della SRAM integrata è circa un ordine di grandezza superiore a quella della HBM, quindi ogni lettura KV effettuata dalla SRAM anziché dalla HBM si traduce in una latenza per token inferiore e in un maggior numero di token al secondo a parità di consumo energetico.
Fonte: Google
La configurazione TensorCore è l'altra differenza principale. Mentre 8t utilizza un singolo TensorCore a 12.6 PFLOPS, 8i suddivide il calcolo su due TensorCore per un totale di 10.1 PFLOPS. Un throughput di picco inferiore potrebbe sembrare un passo indietro, finché non si considera come si svolge effettivamente l'inferenza a livello di chip. I carichi di lavoro di training sono dominati dai batch: i grandi moltiplicatori di matrici ammortizzano l'overhead fisso e una singola MXU di grandi dimensioni può sostenere un utilizzo prossimo al picco. La decodifica dell'inferenza è l'opposto. Le dimensioni dei batch sono ridotte, le finestre di calcolo per token sono brevi e il chip dedica una frazione significativa del suo tempo a operazioni collettive, campionamento e routing piuttosto che al puro moltiplicatore di matrici. Un singolo motore di grandi dimensioni si blocca durante queste pause irregolari. La suddivisione in due TensorCore consente a 8i di sovrapporre le fasi di calcolo in modo più efficace, con ciascun TensorCore alimentato dai propri quattro stack HBM collegati direttamente, per un totale di 288 GB a 8.6 TB/s sull'intero package. Il risultato è un utilizzo sostenuto più elevato per le dimensioni dei batch effettivamente eseguite nel servizio interattivo.
A livello di dominio di scalabilità, i 1,024 chip attivi in un pod Boardfly si aggregano a circa 295 TB di HBM, 384 GB di SRAM on-chip e 10.3 EFLOPS di calcolo FP4. Il valore della SRAM è quello più importante per l'inferenza: 384 GB di cache on-chip nell'intero dominio sono sufficienti per contenere uno stato KV sostanziale senza dover utilizzare l'HBM, il che rende possibile la gestione di contesti lunghi a bassa latenza.
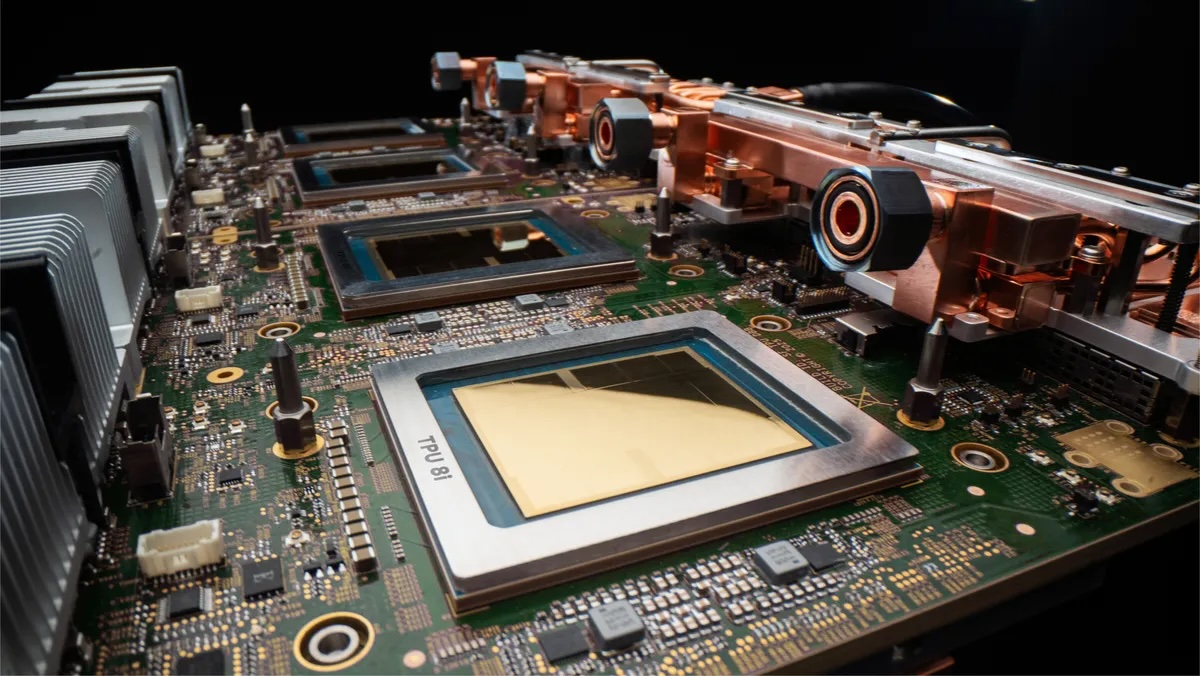
Anche il lato host segue la stessa logica. Google afferma di aver aumentato il numero di host Axion fisici per server su 8i rispetto a Ironwood. I server di inferenza dedicano una frazione non trascurabile del tempo per token alla tokenizzazione, alla logica di campionamento, al routing, al batching e all'orchestrazione del runtime degli agenti. Questi overhead aumentano con la concorrenza piuttosto che con le dimensioni del modello e, con le frequenze di richiesta generate dai carichi di lavoro degli agenti, l'host può diventare il collo di bottiglia. La soluzione più semplice è aumentare il numero di CPU host per acceleratore.
Motore di accelerazione collettiva
L'altra importante modifica a livello di chip è il Collectives Acceleration Engine, che sostituisce i quattro SparseCore presenti in Ironwood. Gli SparseCore gestiscono il routing MoE e le ricerche di embedding con hardware dedicato per il gather-scatter, rimuovendoli così dai segnali del chip di inferenza che 8i ottimizza per un diverso collo di bottiglia.
Il collo di bottiglia che il CAE affronta è la latenza collettiva. Ogni token decodificato richiede la sincronizzazione dei chip partecipanti: gli output di attenzione devono essere tutti ridotti, i metadati di routing dell'esperto devono essere trasmessi e i token campionati devono propagarsi al passaggio successivo. Sulle GPU, questo coordinamento avviene via software tramite NCCL, che pianifica le operazioni collettive come una sequenza di avvii del kernel e operazioni di rete. Su 8i, il CAE è un chip dedicato situato su un proprio die di chiplet accanto ai TensorCore, che gestisce queste primitive di sincronizzazione a livello hardware.
Google afferma di ottenere una latenza collettiva on-chip fino a 5 volte inferiore rispetto a Ironwood. Con batch di dimensioni tipiche dell'addestramento, tale miglioramento verrebbe annullato dal tempo di calcolo; la latenza collettiva rappresenta solo una piccola frazione del tempo totale. Con batch di piccole dimensioni e finestre temporali brevi per token nell'inferenza interattiva, la latenza collettiva può dominare il tempo per token, quindi la riduzione di 5 volte si riflette nel numero di token al secondo e nel costo per token.
8i passa inoltre dalla topologia toroidale 3D a quella che Google chiama Boardfly, una topologia gerarchica ispirata a Dragonfly che sacrifica la larghezza di banda collettiva ad anello a favore della latenza tra tutti i dispositivi. Analizzeremo Boardfly in dettaglio più avanti.
Topologia di Boardfly
8i utilizza una topologia diversa da 8t perché l'addestramento e l'inferenza hanno schemi di comunicazione differenti.
Il toro 3D è ideale per le architetture ad anello: ogni chip ha sei vicini, i dati ruotano attorno all'anello e nessun chip instrada traffico arbitrario. L'addestramento è dominato da questi modelli adatti agli anelli, motivo per cui 8t mantiene il toro. Un'architettura all-reduce ad anello si mappa perfettamente su un singolo asse del toro. I job di frontiera in genere collocano il parallelismo dei dati su un asse, il parallelismo dei tensori su un altro e il parallelismo della pipeline sul terzo. La topologia e il carico di lavoro sono perfettamente abbinati.
L'inferenza al servizio di un modello MoE di grandi dimensioni ha un profilo di comunicazione diverso. Gli esperti sono posizionati su molti chip e ogni token decodificato innesca una comunicazione "tutti a tutti": i token devono raggiungere gli esperti assegnati, sparsi nella rete, e gli output degli esperti devono tornare indietro. Non si tratta di un anello. È un traffico punto-punto arbitrario e, su un toro 3D a 1,024 chip, il percorso nel caso peggiore tra due chip qualsiasi è di 16 hop. Google ci spiega questo calcolo: "In un toro 3D, i nodi sono disposti in una griglia in cui ogni dimensione si avvolge come un anello. Per raggiungere il chip più lontano possibile in una configurazione 8 x 8 x 16 (1024 chip), un pacchetto deve percorrere metà della distanza di ciascun anello:
Toro 3D = 8/2(X) + 8/2(Y) + 16/2(Z) = 16 salti
Sebbene il toro sia altamente efficiente per la comunicazione tra nodi vicini, tipica dell'addestramento denso, introduce un costo in termini di latenza per le comunicazioni tra tutti i nodi. Nell'era dei modelli di ragionamento e del MoE, in cui qualsiasi chip potrebbe dover comunicare con qualsiasi altro chip per instradare un token, questo numero di hop diventa rilevante.
Per i servizi interattivi sensibili alla latenza, questi passaggi aggiuntivi spingono la latenza per token al di fuori del suo SLO.
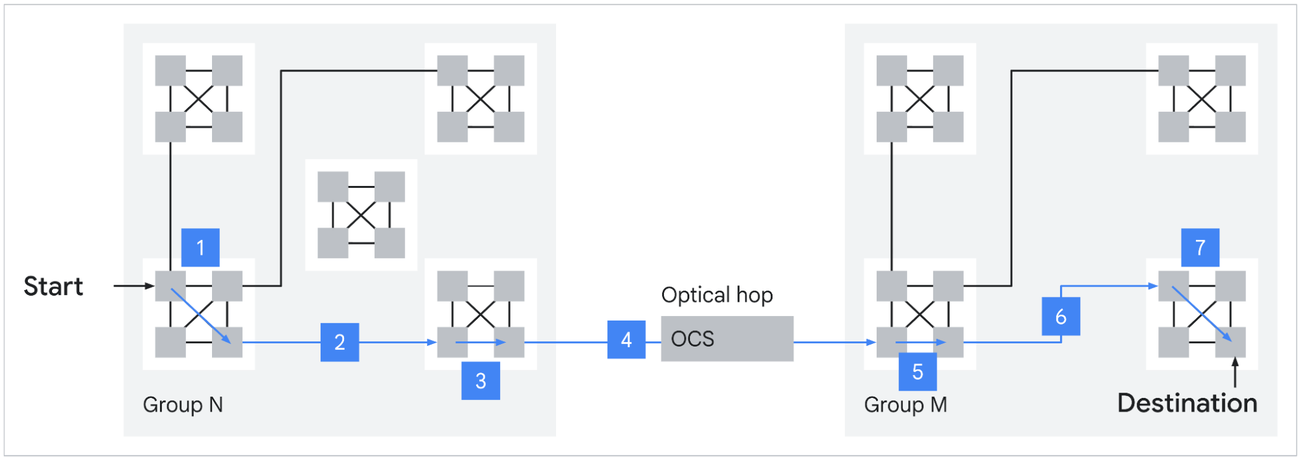
Fonte: Google
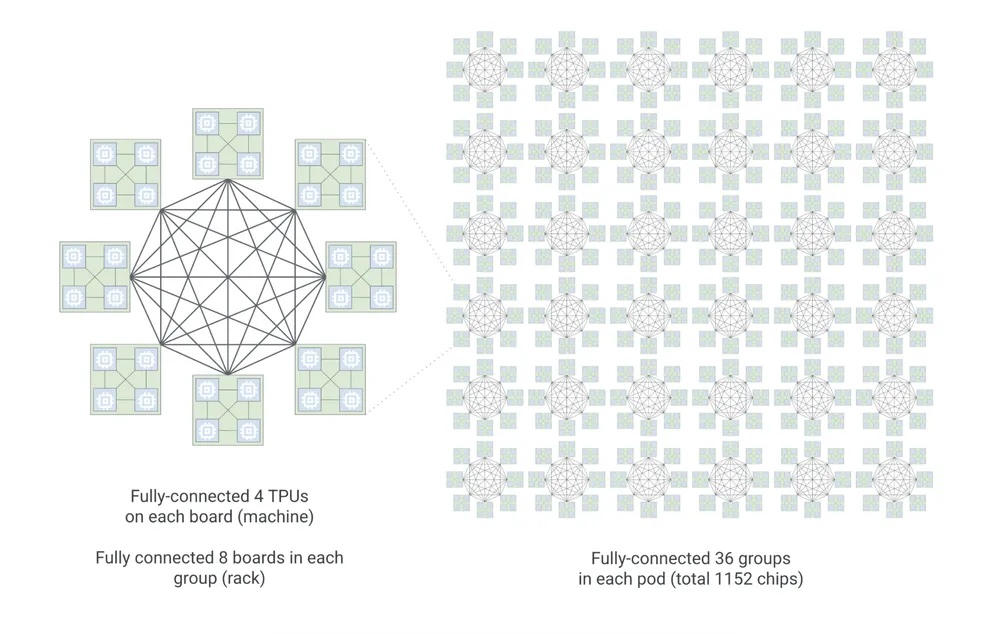
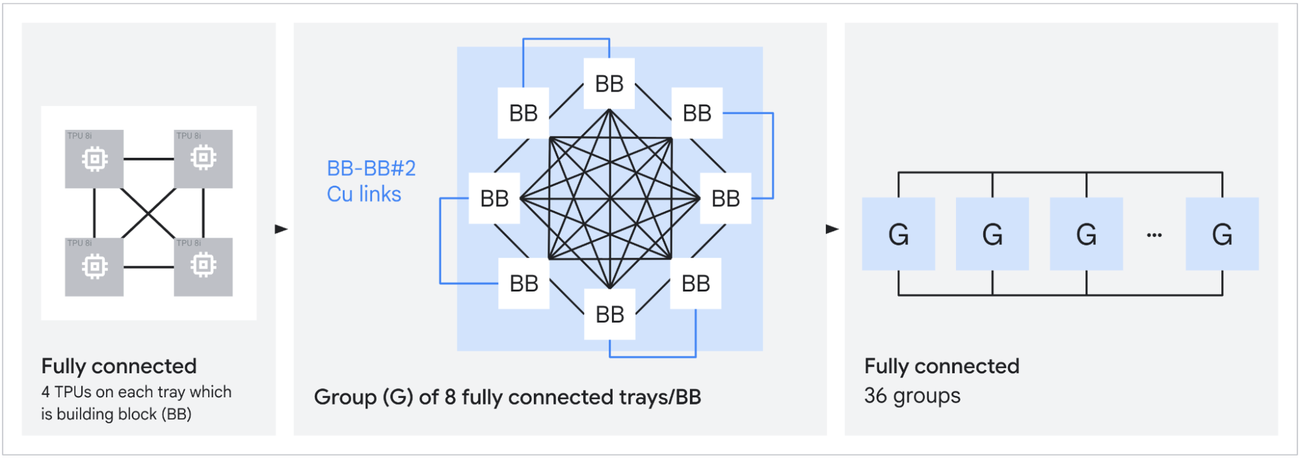
Boardfly è una gerarchia ispirata alla libellula, progettata per comprimere il diametro. La struttura ha tre livelli. Il blocco costitutivo è un anello di quattro chip con 16 connessioni esterne. Otto di questi blocchi costitutivi formano un gruppo, completamente connesso tramite cavi in rame con 11 collegamenti per gruppo. Trentasei gruppi si connettono tramite interruttori a circuito ottico (OCT) per formare un pod. Il risultato è un dominio scalabile di 1,152 chip (1,024 attivi) con un massimo di 7 hop tra due chip qualsiasi, una riduzione del 56% rispetto al toro. Google afferma che ciò si traduce in un miglioramento della latenza fino al 50% per carichi di lavoro ad alta intensità di comunicazione come le comunicazioni all-to-all di MoE.
Anche la scalabilità su larga scala è importante per la replica degli esperti. Un maggior numero di chip per fabric ICI significa che ogni esperto in un MoE di grandi dimensioni può essere replicato più volte, il che uniforma lo squilibrio di routing e mantiene costante la latenza di decodifica quando la distribuzione dei token è irregolare. Il routing top-k è dipendente dai dati; alcuni esperti visualizzeranno più token di altri in un dato passaggio. La replica assorbe tale varianza. La larghezza di banda ICI è stata raddoppiata a 19.2 Tb/s per chip, in parte per gestire il traffico risultante.
Rete Vergine
Un superpod da 9,600 chip è grande, ma le sessioni di training più innovative richiedono sempre più risorse. Virgo è l'infrastruttura di scalabilità orizzontale che collega i superpod all'interno di un data center, gestendo il traffico RDMA est-ovest tra i pod quando un'attività supera le capacità di un singolo dominio di scalabilità verticale.
Un singolo fabric Virgo collega oltre 134,000 chip 8t con una larghezza di banda bisezionale non bloccante di 47 Pb/s, fino a 4 volte la larghezza di banda per acceleratore e una latenza a vuoto inferiore del 40% rispetto alla generazione precedente. L'architettura è una topologia non bloccante piatta a due strati, realizzata su switch ad alta radice con un design multiplanare e domini di controllo indipendenti.
Le tradizionali architetture Clos sovrascrivono le porte ai livelli superiori per mantenere gestibili il numero di porte e i costi. Questo funziona bene quando la maggior parte del traffico è nord-sud, come avviene nel cloud generico: i client accedono ai bilanciatori di carico, i bilanciatori di carico ai server applicativi e i server applicativi allo storage. I carichi di lavoro di addestramento dell'IA sono quasi interamente est-ovest, da chip a chip attraverso l'infrastruttura, e le operazioni collettive sono dominate dalla bisezione. Qualsiasi sovrascrizione a qualsiasi livello si traduce direttamente in un tempo di esecuzione della fase di addestramento. Il design piatto a due strati di Virgo con switch ad alta radice elimina il collo di bottiglia del livello spine, realizzando switch con un numero di porte per ASIC sufficiente a terminare una frazione significativa dell'infrastruttura in due hop.
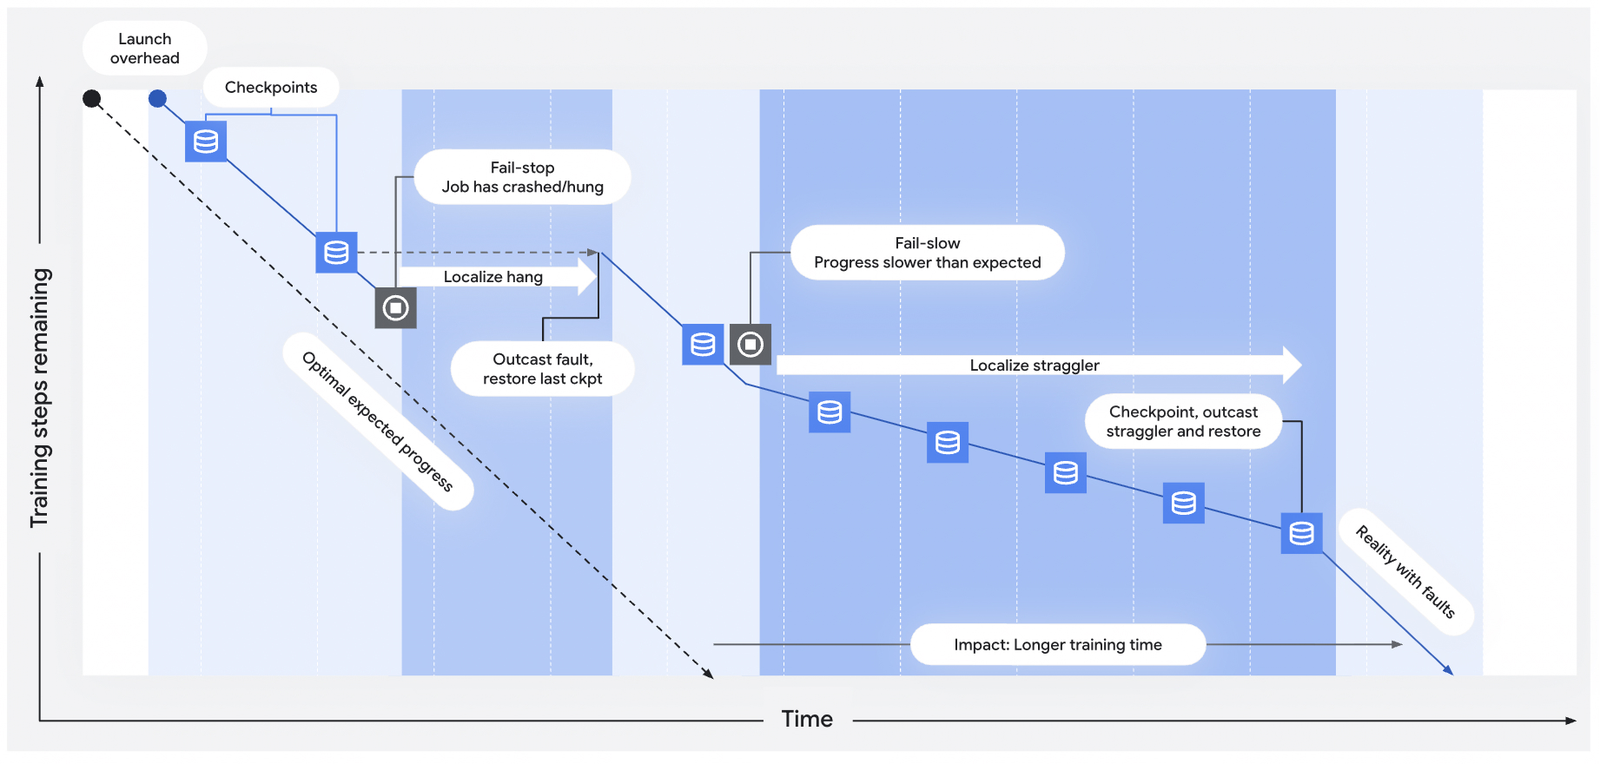
L'ingegneria dell'affidabilità è fondamentale a questa scala e dipende fortemente dagli Optical Circuit Switch (OCS) basati su MEMS di Google. Gli OCS consentono a Google di riconfigurare la topologia fisica tra un job e l'altro senza dover ricablare nulla e, soprattutto, di instradare il traffico aggirando chip o collegamenti guasti durante l'esecuzione. Quando viene rilevato un guasto, gli OCS possono rimappare la porzione di rete interessata in millisecondi, eliminando la necessità di intervento manuale. La telemetria con tempi di risposta inferiori al millisecondo alimenta il rilevamento automatico di rallentamenti e blocchi. La combinazione di rilevamento rapido e instradamento basato su OCS ottimizza il tempo medio tra le interruzioni e il tempo medio di ripristino su una scala di oltre 100,000 chip, dove la certezza statistica di un guasto durante un ciclo di diverse settimane si avvicina al 100%. L'obiettivo di throughput utile del 97% dichiarato da Google per i pod da 8t dipende da questa infrastruttura. La stessa tecnologia OCS è presente in tutto lo stack TPU: unisce i cubi in superpod a livello ICI, collega i gruppi Boardfly a livello di scalabilità 8i e gestisce il traffico tra i pod a livello Virgo.
Con 134,000 chip, la potenza di calcolo complessiva raggiunge circa 1,690 EFLOPS in FP4, ovvero circa 1.7 ZFLOPS. Google afferma che l'architettura supporta una scalabilità quasi lineare fino a un milione di chip in un singolo cluster di addestramento logico, sebbene le implementazioni attuali non abbiano ancora raggiunto tale limite.
Giove e la scalabilità multi-datacenter
Virgo gestisce il traffico di accelerazione est-ovest all'interno di un data center, ma non rappresenta il vertice dello stack. Jupiter è l'infrastruttura nord-sud esistente di Google, giunta ora alla sua quinta generazione, che gestisce il traffico front-end e l'accesso alle risorse di storage e di calcolo distribuite. Jupiter non è stato annunciato al Cloud Next; si tratta dell'infrastruttura esistente su cui si basa l'ottava generazione.
L'ultima iterazione di Jupiter offre una larghezza di banda bisezionale di 13 Pb/s per edificio del data center con una disponibilità del 99.999%, utilizzando switch Apollo MEMS OCS con un consumo di circa 108 W per OCS, rispetto ai circa 3,000 W di uno switch di pacchetto elettrico equivalente. Questa è l'infrastruttura che collega i data center di Google al mondo esterno e tra di loro.
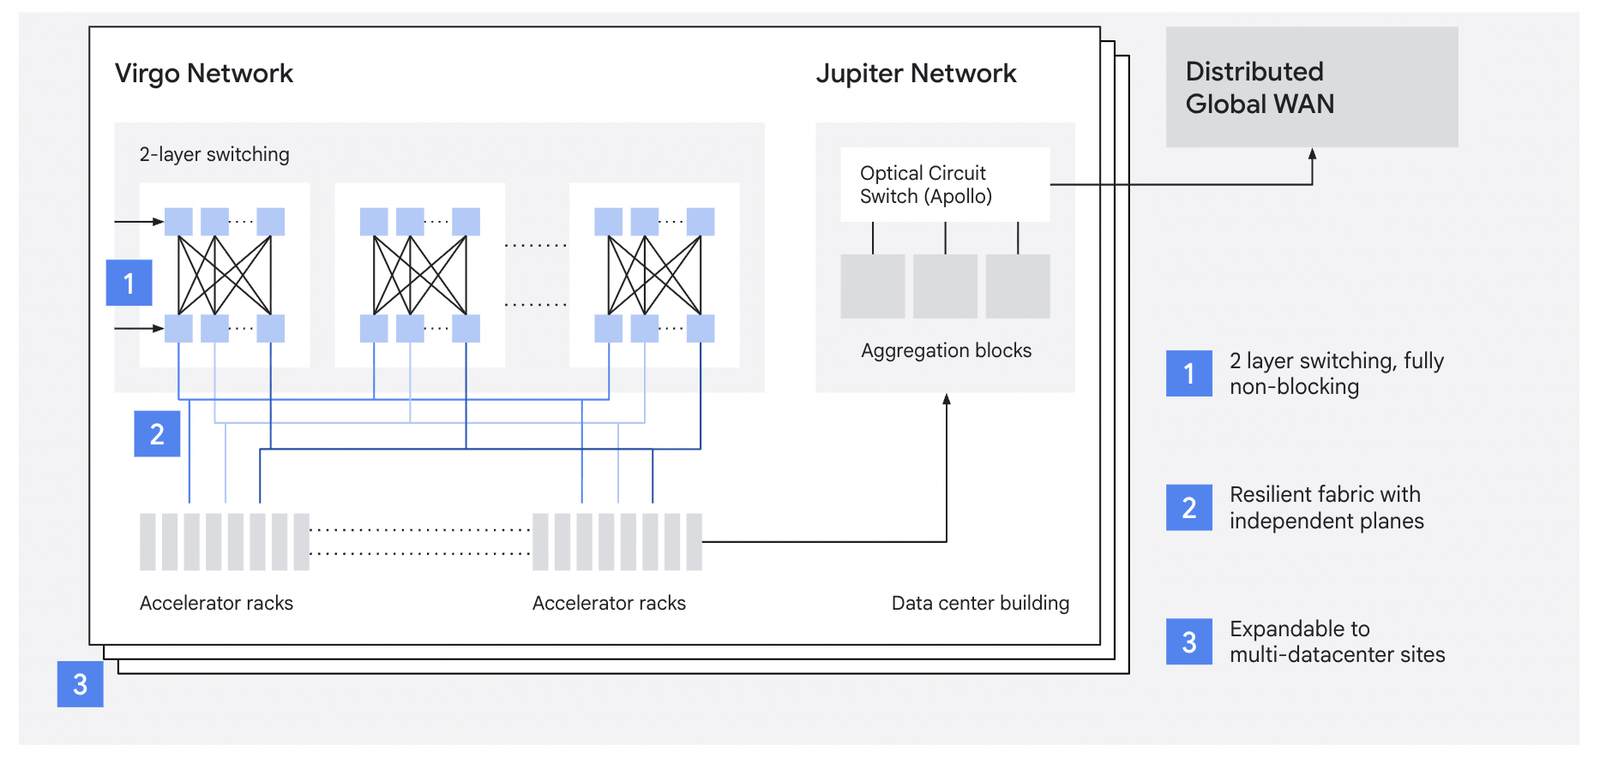
Per le sessioni di training che superano la potenza e lo spazio di un singolo data center, Jupiter è la soluzione che consente la scalabilità su più siti. La combinazione è strutturata a livelli: ICI all'interno di un pod, Virgo tra i pod all'interno di un sito, Jupiter tra i siti. Lo stack software Pathways di Google è in grado di gestire i carichi di lavoro su questi domini multi-datacenter come un singolo cluster logico.
Con una potenza di calcolo di circa 1.7 ZFLOPS, una singola infrastruttura Virgo rappresenta il più grande cluster di addestramento per l'intelligenza artificiale mai annunciato. Più infrastrutture Virgo collegate tramite Jupiter possono gestire oltre un milione di chip TPU, la scala a cui punta Google, anche se le implementazioni attuali non l'hanno ancora raggiunta.
Produzione e utilizzo
Il numero grezzo di FLOP è meno importante della frazione di FLOP che produce lavoro utile. Google dichiara un obiettivo di goodput del 97% per i superpod da 8t, il che significa che il 97% del tempo di esecuzione viene impiegato in calcoli produttivi anziché in operazioni di ripristino, blocchi o overhead di coordinamento. Tale percentuale dipende dalla tolleranza ai guasti basata su OCS e dalla telemetria sub-milliseconda descritte in precedenza.
L'altra variabile è l'utilizzo dei FLOP del modello (MFU). L'MFU misura la frazione dei FLOP teorici di picco che il chip effettivamente sostiene su un carico di lavoro reale. SemiAnalysis stima che con un MFU TPU del 40%, il costo per FLOP di training effettivo si riduce di circa il 62% rispetto al GB300 NVL72, con un punto di pareggio intorno al 15% di MFU TPU. I dati economici relativi alle TPU resi pubblici da Anthropic suggeriscono che operano ben al di sopra di tale punto di pareggio. La combinazione di un elevato goodput (mantenere i chip in funzione) e di un MFU competitivo (mantenere i chip occupati quando sono in funzione) è ciò che rende il TCO delle TPU economicamente vantaggioso su larga scala.
Dove si trova l'8
Il confronto tra TPU 8 e le piattaforme attuali e future di NVIDIA richiede un'attenta considerazione delle unità di misura. NVIDIA indica la larghezza di banda di NVLink come aggregata bidirezionale; un B200 a 1.8 TB/s, mentre NVLink 5 raggiunge 900 GB/s per direzione. I valori FLOPs dichiarati da NVIDIA sono solitamente 2:4 per la configurazione sparsa; la configurazione densa è la metà. I valori di TPU di Google sono invece per la configurazione densa e bidirezionale. Quando si legge un confronto, è fondamentale verificare se la larghezza di banda è unidirezionale o bidirezionale e se i valori FLOPs sono espressi in modo denso o sparso.
Le prestazioni FP4 per chip, con 8 thread e 12.6 PFLOPS in configurazione densa, si collocano tra i 10 PFLOPS in configurazione sparsa (5 PFLOPS in configurazione densa) del GB200 e i 20 PFLOPS in configurazione sparsa (15 PFLOPS in configurazione densa) del GB300. Il confronto per chip è preciso, mentre quello in termini di scalabilità è diverso. Un rack GB300 NVL72 ospita 72 GPU in un singolo dominio NVLink. Un superpod da 8 thread è composto da 9,600 chip in un singolo toro 3D. Si tratta di un numero di chip 133 volte superiore in un singolo dominio collettivo, ed è proprio questa differenza che separa le piattaforme per l'addestramento di sistemi di punta.
NVIDIA non resta con le mani in mano. Vera Rubin sarà disponibile nella seconda metà del 2026 con 50 PFLOPS di inferenza NVFP4 per package (anche se SemiAnalysis ha messo in dubbio che questo valore presupponga la compressione adattiva), 288 GB di HBM4 a 22 TB/s e NVLink 6 a 3.6 TB/s bidirezionale. Rubin Ultra, prevista per la seconda metà del 2027, combinerà quattro die di reticolo per raggiungere fino a 100 PFLOPS FP4 e 1 TB di HBM4e per package. Kyber NVL576 integrerà 576 GPU Rubin Ultra in un singolo rack con 15 EFLOPS di inferenza FP4. Questo inizia a ridurre il vantaggio di scalabilità di Google, anche se 576 GPU sono ancora di un ordine di grandezza inferiore rispetto a un superpod da 8 tonnellate.
Dove 8 è in vantaggio: dimensione del dominio scalabile (9,600 chip contro 72 GPU, o 576 dopo Kyber), scalabilità a singola fabric (oltre 134,000 chip a 47 Pb/s), latenza deterministica grazie alla pianificazione XLA statica e TCO per carichi di lavoro compatibili con il modello TPU.
Dove 8 percorsi: capacità HBM per chip (216 GB contro i 288 GB HBM4 di Rubin), sparsità (NVIDIA ha un percorso hardware 2:4, Google no) e ampiezza dell'ecosistema (CUDA, cuDNN, TensorRT-LLM e lo stack di servizio PyTorch-first arrivano prima su NVIDIA; PyTorch nativo su TPU è ancora in anteprima).
Entrambe le piattaforme sono molto richieste. Meta sarebbe in trattative per un accordo multimiliardario per implementare le TPU di Google nei suoi data center a partire dal 2027, con la possibilità di noleggiare le Cloud TPU già dal 2026. Allo stesso tempo, Google Cloud ha annunciato le istanze A5X basate su NVIDIA Vera Rubin NVL72, scalabili fino a 80,000 GPU Rubin in un singolo sito e 960,000 GPU in implementazioni multi-sito. Google sta sviluppando entrambe le soluzioni su larga scala.
Incartare
La TPU di ottava generazione è composta da due chip anziché uno, progettata per le esigenze attuali di training su larga scala e inferenza agentica, piuttosto che per carichi di lavoro di IA generici. La 8t spinge la scalabilità fino a 9,600 chip per superpod e fino a oltre 134,000 chip per fabric Virgo. La 8i sostituisce gli SparseCore con silicio ad accelerazione collettiva e rimpiazza il toro 3D con Boardfly per soddisfare i target di latenza richiesti dal MoE (Mixed-of-Experts) su larga scala. La roadmap di NVIDIA, con Vera Rubin, Rubin Ultra e Kyber, ridurrà alcuni di questi divari nel periodo 2026-2027, ma per ora il vantaggio in termini di scalabilità verticale persiste. Per i laboratori all'avanguardia che eseguono modelli mixed-of-expert su centinaia di migliaia di chip, la 8 rappresenta una valida alternativa a Grace Blackwell, e le discussioni di Meta suggeriscono che il mercato stia iniziando a prezzarlo.


 Amazon